
Version : 1.0 · Date : 2026-10-23 · Parcours Support N2/N3, plateformes IA sur Azure
En une phrase : un incident sur un chatbot se résout toujours de la même façon : qualifier, chercher ce qui a changé, suivre la question saut par saut (utilisateur, entrée privée, application, Azure AI Search, Azure OpenAI) en corrélant par
operation_Id, puis appliquer le runbook du premier saut en erreur.
Ce chapitre est la partie pratique du parcours : la méthode générale (section 1), puis 15 runbooks prêts à l'emploi (section 2), chacun relié aux pannes à provoquer dans le lab du chapitre 10. Les concepts sont dans les chapitres précédents : 01 architecture, 02 modèles et tokens, 03 RAG, 04 AKS, 05 GitOps, 06 Web App privée, 07 observabilité.
Règle d'or du support : on lit d'abord (logs, métriques, get, describe), on agit ensuite (restart, rollback,
sync, changement de quota) seulement avec l'accord prévu par le processus du client, en annonçant l'environnement, la commande,
l'impact et le retour arrière. En production, dans le doute, on ne touche à rien et on escalade.
| N° | Runbook | Saut concerné |
|---|---|---|
| R1 | Le chatbot ne répond plus | Tous |
| R2 | Le chatbot répond, mais mal | AI Search, ingestion, modèle |
| R3 | La latence augmente sans erreur | Application, AI Search, modèle |
| R4 | L'application ne récupère pas un secret | Identité, Key Vault |
| R5 | Grafana n'affiche aucune donnée | Observabilité |
| R6 | Un déploiement ne crée pas de nouveau pod | AKS |
| R7 | Le code Git est à jour mais rien ne change | Argo CD |
| R8 | 429 et quota épuisé sur le modèle | Azure OpenAI |
| R9 | ImagePullBackOff depuis un ACR privé | ACR, AKS |
| R10 | Ingestion Document Intelligence en échec | Ingestion |
| R11 | Web App : container didn't respond to HTTP pings | Web App for Containers |
| R12 | Indexer AI Search en erreur | Ingestion |
| R13 | Certificat ou Ingress en erreur | Entrée AKS |
| R14 | Le coût des tokens explose | Modèle, application |
| R15 | Un content filter bloque des réponses | Azure OpenAI |
1. La méthode N2/N3#
1.1 Le déroulé, en un schéma#
flowchart LR
    A["Ticket ou alerte"] --> B["Qualifier<br/>qui, quoi, depuis quand,<br/>périmètre, impact"]
    B --> C["Ce qui a changé<br/>déploiement, config,<br/>secret, quota, certificat"]
    C --> D["Suivre la requête<br/>saut par saut"]
    D --> E["Corréler<br/>operation_Id, trace"]
    E --> F["Hypothèse → test<br/>une seule variable"]
    F -- "Confirmée" --> G["Correctif ou contournement<br/>avec accord"]
    F -- "Infirmée" --> D
    G --> H["Vérifier la résolution<br/>métrique, utilisateur"]
    H --> I["Clôture et post-mortem"]
1.2 Qualifier (les 5 premières minutes)#
| Question | Pourquoi | Où trouver la réponse |
|---|---|---|
| Qui est touché ? un utilisateur, un groupe, tout le monde | Un seul utilisateur oriente vers l'identité (Entra ID, Conditional Access, droits) ; tout le monde oriente vers la plateforme | Ticket, sign-in logs Entra ID, nombre d'erreurs dans AppRequests |
| Quoi exactement ? erreur, page blanche, réponse fausse, lenteur | Chaque symptôme a son runbook (R1, R2, R3…) | Capture d'écran, code HTTP, operation_Id si l'application l'affiche |
| Depuis quand ? heure précise du premier cas | Permet de comparer avec les changements et de cadrer les requêtes KQL | Premier ticket, première alerte, graphe AppRequests |
| Périmètre : un chatbot ou plusieurs, un cluster ou plusieurs, une région | Plusieurs projets touchés = dépendance commune (DNS, Azure OpenAI, Entra ID, réseau hub) | Tableaux de bord Grafana, Azure Service Health, Resource Health |
| Impact : bloquant, dégradé, gênant | Fixe la priorité et la cadence de communication | Grille de priorité du client |
Grille de priorité indicative (à remplacer par celle du client) :
| Priorité | Situation type | Réaction attendue |
|---|---|---|
| P1 | Chatbot de production indisponible pour tous, ou fuite de données suspectée | Mobilisation immédiate, cellule de crise, communication régulière (par exemple toutes les 30 minutes), escalade N3 et éditeur rapide |
| P2 | Service dégradé pour tous (lenteur forte, réponses fausses), ou indisponible pour un groupe | Traitement prioritaire, communication à chaque étape |
| P3 | Gêne limitée, contournement possible | Traitement dans la journée |
| P4 | Demande, question, amélioration | Planifié |
1.3 Chercher ce qui a changé#
Neuf incidents sur dix suivent un changement. Avant de chercher plus loin, lister les changements des 24 à 72 dernières heures :
| Source de changement | Commande ou endroit |
|---|---|
| Déploiement GitOps (AKS) | argocd app history <app> ; historique Git du repo GitOps |
| Pipeline Azure DevOps | Runs récents du pipeline (build, push, déploiement Web App) |
| Ressources Azure (réseau, Key Vault, quotas, RBAC) | Activity log, ou Azure Resource Graph resourcechanges (ci-dessous) |
| Kubernetes | kubectl rollout history deployment/<deploy> -n <ns> ; événements KubeEvents |
| Secrets et certificats | Date d'expiration et dernière version dans Key Vault |
| Côté Microsoft | Azure Service Health (incidents, maintenance), Resource Health de la ressource |
// Azure Resource Graph Explorer : changements Azure des dernières 24 h sur un resource group
resourcechanges
| extend changeTime = todatetime(properties.changeAttributes.timestamp),
         changeType = tostring(properties.changeType),
         targetResourceId = tostring(properties.targetResourceId),
         changedBy = tostring(properties.changeAttributes.changedBy)
| where changeTime > ago(24h)
| where targetResourceId contains "/resourceGroups/<rg>/"
| project changeTime, changeType, targetResourceId, changedBy, properties.changes
| order by changeTime desc
1.4 Suivre la requête saut par saut#
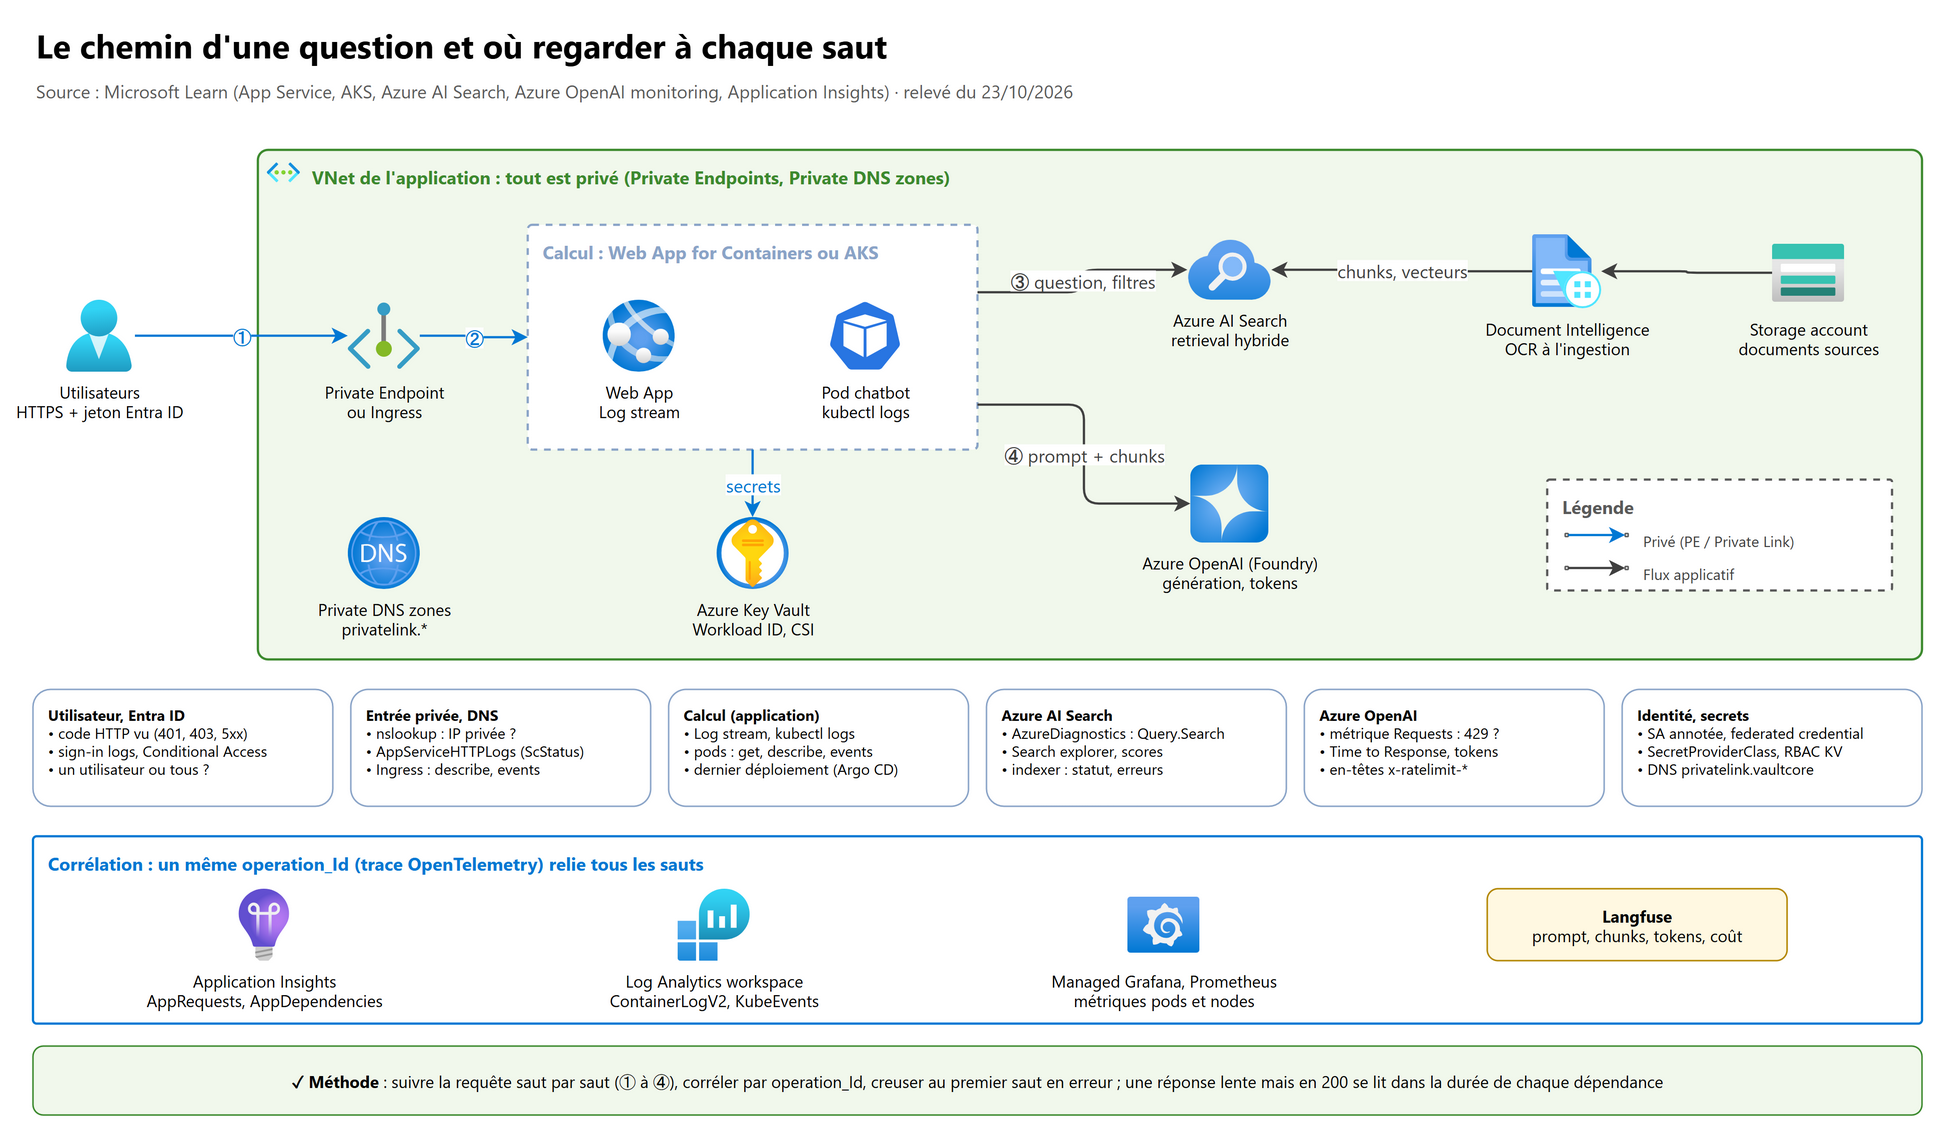
Le schéma en tête de chapitre donne les sauts et l'endroit où regarder pour chacun. Le principe : trouver le premier saut en
erreur. Si l'application reçoit la requête (elle apparaît dans AppRequests ou dans le Log stream), le problème n'est ni
Entra ID ni le réseau d'entrée ; si l'appel à Azure AI Search réussit mais celui à Azure OpenAI échoue, on ouvre R8 ou R15.
1.5 Corréler avec l'operation_Id#
Application Insights donne à chaque transaction un identifiant operation_Id (colonne OperationId dans le Log Analytics
workspace) partagé par la requête entrante, ses dépendances (AI Search, Azure OpenAI, Key Vault…) et ses exceptions. Avec
OpenTelemetry, c'est l'identifiant de trace W3C (traceparent). La même trace se retrouve dans Langfuse si l'application y
envoie ses traces LLM.
// Toute la transaction d'une question : requête, dépendances, exceptions, traces
let op = "<operation_Id>";
union AppRequests, AppDependencies, AppExceptions, AppTraces
| where OperationId == op
| project TimeGenerated, Type, Name, Target, ResultCode, Success, DurationMs, Message, OuterMessage
| order by TimeGenerated asc
// Taux d'échec et latence par tranche de 5 minutes, pour dater le début de l'incident
AppRequests
| where TimeGenerated > ago(6h)
| summarize total = count(), echecs = countif(Success == false), p95_ms = percentile(DurationMs, 95)
          by bin(TimeGenerated, 5m), AppRoleName
| order by TimeGenerated asc
1.6 Hypothèse, test, correctif, post-mortem#
- Une hypothèse à la fois, testée par une seule action de lecture (une requête KQL, un
describe, unnslookup). - Contournement d'abord si l'impact est fort (rollback Argo CD, retour à l'image précédente, basculement vers un autre déploiement de modèle), cause racine ensuite.
- Vérifier la résolution sur une métrique (taux d'échec revenu à la normale, latence p95) et auprès d'un utilisateur, pas seulement sur « le pod est Running ».
- Post-mortem sans recherche de coupable, sous 5 jours ouvrés pour un P1 :
| Rubrique | Contenu |
|---|---|
| Résumé | Une phrase : quoi, combien de temps, qui |
| Chronologie | Début, détection, qualification, contournement, résolution (heures précises) |
| Impact | Utilisateurs, durée, données, coût |
| Cause racine | Technique, puis « pourquoi ce n'a pas été détecté avant » (méthode des 5 pourquoi) |
| Ce qui a bien marché, ce qui a manqué | Alertes, runbooks, accès, communication |
| Actions | Chaque action a un responsable et une date (alerte manquante, test de non-régression, runbook à compléter) |
1.7 Communiquer#
| Avec | Quoi dire | Quand |
|---|---|---|
| N1 | Ce qu'il faut demander à l'utilisateur (heure, capture, operation_Id), le message d'attente à donner, le contournement s'il existe |
Dès la qualification |
| Utilisateurs, métier | Symptôme, impact, contournement, prochaine communication ; pas de jargon | Selon la priorité (P1 : à heure fixe) |
| N3, éditeur, équipe projet | Faits vérifiés, requêtes et résultats, hypothèses écartées, ce qui est demandé ; operation_Id, horodatage UTC, ressource |
À l'escalade |
| Support Microsoft | ID de la ressource, région, horodatage UTC, ID de requête, ce qui a été testé | Quand le problème est côté plateforme (Service Health, 429 de capacité persistants, erreur interne du service) |
Modèle de message court : « [P2] Chatbot RH : réponses lentes depuis 09:40 UTC. Impact : tous les utilisateurs, réponses en 30 s au lieu de 5 s. Cause en cours d'analyse (piste : quota du modèle). Contournement : aucun. Prochain point : 10:30 UTC. »
1.8 La boîte à outils de base#
# Contexte : toujours vérifier où l'on est avant toute commande
az account show --query "{sub:name, id:id, tenant:tenantId}" -o table
kubectl config current-context

# Kubernetes : l'état en 4 commandes
kubectl get pods -n <ns> -o wide
kubectl describe pod <pod> -n <ns>                       # Events en bas : la cause est souvent là
kubectl logs <pod> -n <ns> --previous                     # logs du conteneur précédent (après un crash)
kubectl get events -n <ns> --sort-by=.lastTimestamp

# Web App for Containers : logs du conteneur en direct
az webapp log config -g <rg> -n <app> --docker-container-logging filesystem
az webapp log tail -g <rg> -n <app>
2. Les runbooks#
Chaque runbook suit la même forme : symptômes, impact, première minute, arbre de décision, commandes, causes typiques, confirmation, prévention.
R1 · Le chatbot ne répond plus#
Symptômes : page d'erreur, message « service indisponible », réponse qui ne vient jamais, codes 401, 403, 404, 500, 502, 503 ou 504. Impact : souvent P1 si tous les utilisateurs sont touchés.
Première minute
- Un utilisateur ou tous ? Quel code HTTP ? Depuis quand ?
- Dernier déploiement (
argocd app history, run de pipeline) et dernier changement Azure. - La requête arrive-t-elle à l'application (
AppRequests,AppServiceHTTPLogs, logs de l'Ingress) ? - Les pods (ou le conteneur de la Web App) sont-ils démarrés et prêts ?
flowchart TD
    A["Le chatbot ne répond plus"] --> B{"Un seul utilisateur<br/>ou un groupe ?"}
    B -- Oui --> C["Identité de l'utilisateur :<br/>sign-in logs, Conditional Access,<br/>groupe, affectation à l'application"]
    B -- "Non, tous" --> D{"Code HTTP reçu ?"}
    D -- "401 / 403" --> E["Authentification Entra ID<br/>ou Access restrictions"]
    D -- "502 / 503 / 504" --> F{"L'application tourne ?<br/>pods Ready, Web App started"}
    D -- "Aucun, timeout" --> G["DNS et entrée privée :<br/>nslookup, Private Endpoint,<br/>Ingress"]
    D -- "500" --> H["Logs applicatifs :<br/>exception, dépendance en échec"]
    F -- Non --> I["R6, R9, R11 :<br/>pods ou conteneur KO"]
    F -- Oui --> H
    H --> J{"Dépendance en échec ?"}
    J -- "Azure OpenAI 429" --> K["R8"]
    J -- "Azure OpenAI 400 content_filter" --> L["R15"]
    J -- "Key Vault, 401 vers Azure" --> M["R4 : identité, secret"]
    J -- "Timeout vers un service privé" --> G
Commandes
// Erreurs côté application, par code et par dépendance (Application Insights)
AppRequests
| where TimeGenerated > ago(1h) and Success == false
| summarize nb = count() by ResultCode, Name, AppRoleName
| order by nb desc
// Quelle dépendance échoue ? (AI Search, Azure OpenAI, Key Vault...)
AppDependencies
| where TimeGenerated > ago(1h) and Success == false
| summarize nb = count(), exemple = any(Data) by Target, DependencyType, ResultCode
| order by nb desc
// Web App : codes HTTP vus par le serveur web et logs du conteneur au même moment
let erreurs = AppServiceHTTPLogs | where TimeGenerated > ago(1h) and ScStatus >= 500
    | project TimeGen = substring(TimeGenerated, 0, 19), CsUriStem, ScStatus, TimeTaken;
let console = AppServiceConsoleLogs | where TimeGenerated > ago(1h)
    | project TimeGen = substring(TimeGenerated, 0, 19), ResultDescription;
erreurs | join kind=leftouter console on TimeGen
| project TimeGen, CsUriStem, ScStatus, TimeTaken, ResultDescription
// AKS : pods en CrashLoopBackOff ou en erreur (Container insights)
KubePodInventory
| where TimeGenerated > ago(1h) and Namespace == "<ns>"
| where ContainerStatusReason in ("CrashLoopBackOff", "Error", "OOMKilled", "ImagePullBackOff", "ErrImagePull")
| summarize arg_max(TimeGenerated, ContainerStatusReason, ContainerRestartCount, PodStatus) by Name
# AKS : état, événements et logs du conteneur précédent
kubectl get pods -n <ns> -l app=<chatbot>
kubectl describe pod <pod> -n <ns>
kubectl logs <pod> -n <ns> --previous --tail=200

# Ingress / Service : la requête trouve-t-elle des pods ?
kubectl get ingress,svc,endpoints -n <ns>

# DNS d'un service privé depuis le cluster (pod de test jetable, image publique de diagnostic)
kubectl run dnstest -n <ns> --rm -it --restart=Never --image=busybox:1.36 -- nslookup <search>.search.windows.net

# Web App : depuis la console SSH ou Kudu du site (Linux)
nslookup <compte-openai>.openai.azure.com          # doit répondre une IP privée du VNet
curl -v https://<search>.search.windows.net        # joignable en TLS ?
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Nouveau déploiement défectueux | Erreurs qui commencent à l'heure du sync Argo CD ou du run de pipeline | Rollback (argocd app rollback, ou commit de retour dans Git), puis analyse |
| Pods en CrashLoopBackOff, OOMKilled | describe pod : Last State: Terminated, Reason: OOMKilled |
Corriger la configuration ; ajuster resources.limits avec l'équipe projet |
| Secret absent ou expiré | Exception au démarrage, FailedMount |
R4 |
| DNS privé cassé | nslookup renvoie une IP publique ou rien |
Lien de la Private DNS zone vers le VNet, enregistrement A du Private Endpoint |
Private Endpoint en Pending ou Rejected |
État de la connexion dans le portail | Approuver ou recréer la connexion |
| Dépendance IA en échec | AppDependencies en échec vers *.openai.azure.com ou *.search.windows.net |
R8, R15, R12 |
| Problème d'authentification utilisateur | 401, 403 ; sign-in logs en échec | Conditional Access, affectation à l'application, expiration du secret de l'App registration |
| Incident Azure | Azure Service Health, Resource Health | Suivre l'incident, communiquer, basculer si un plan existe |
Confirmer la résolution : taux d'échec de AppRequests revenu à la normale sur 15 minutes, question test réussie,
utilisateur qui confirme.
Prévention : test de disponibilité (Availability test ou sonde synthétique) sur une vraie question, alertes sur le taux
d'échec et sur les redémarrages de pods, readinessProbe qui teste les dépendances critiques sans les surcharger.
S'entraîner : lab, pannes n° 1, 2, 3, 6, 9.
R2 · Le chatbot répond, mais la réponse est mauvaise#
Symptômes : réponse fausse, incomplète, périmée, « je ne sais pas » alors que l'information existe, hallucination, citation d'un mauvais document. Impact : P2 à P3, parfois P1 si la réponse est dangereuse (juridique, sécurité).
Le principe : un RAG a trois étages, et il faut trouver lequel est en faute avant de toucher au prompt (chapitre 03).
| Étage | Question à se poser | Test |
|---|---|---|
| Ingestion | Le bon document est-il dans l'index, à jour, bien découpé ? | Requête dans l'index sur un mot du document attendu ; date de dernière mise à jour ; statut de l'indexer |
| Recherche (retrieval) | Les bons chunks remontent-ils en tête pour cette question ? | Rejouer la question dans Azure AI Search (hybride, sémantique), regarder les scores et les filtres |
| Génération | Le modèle a-t-il reçu les bons chunks et les a-t-il bien utilisés ? | Lire dans Langfuse le prompt réel, les chunks injectés, la réponse ; vérifier le modèle et la version déployés |
Première minute
- Récupérer la question exacte, l'heure, l'utilisateur et si possible l'
operation_Idou la trace Langfuse. - Le problème touche-t-il une question ou toutes ? Un document ou tous ?
- Un changement récent : prompt, modèle ou version du modèle, index, skillset, chunking, filtres de sécurité ?
flowchart TD
    A["Réponse mauvaise"] --> B["Ouvrir la trace Langfuse<br/>prompt, chunks, réponse"]
    B --> C{"Les bons chunks sont-ils<br/>dans le contexte envoyé ?"}
    C -- Oui --> D["Étage génération :<br/>prompt système, modèle, version,<br/>température, contexte tronqué"]
    C -- Non --> E{"Le document est-il<br/>dans l'index ?"}
    E -- Non --> F["Étage ingestion :<br/>R12 indexer, R10 OCR,<br/>fraîcheur des données"]
    E -- Oui --> G{"Le chunk remonte-t-il<br/>dans Search explorer ?"}
    G -- "Non, même en requête directe" --> H["Recherche : filtre trop strict,<br/>champ non searchable,<br/>vecteurs d'un autre modèle"]
    G -- "Oui, mais trop bas" --> I["Recherche : hybride, k, top,<br/>semantic ranker, seuil de score"]
    G -- "Oui, en tête" --> J["L'application ne passe pas<br/>les mêmes paramètres :<br/>filtre utilisateur, index, top"]
Commandes
# Jeton Microsoft Entra pour le plan de données d'Azure AI Search (rôle Search Index Data Reader requis)
TOKEN=$(az account get-access-token --scope https://search.azure.com/.default --query accessToken -o tsv)
SEARCH=https://<search>.search.windows.net
API=2026-04-01

# 1. Le document est-il dans l'index ? (recherche plein texte sur un mot rare du document)
curl -s -X POST "$SEARCH/indexes/<index>/docs/search?api-version=$API" \
  -H "Authorization: Bearer $TOKEN" -H "Content-Type: application/json" \
  -d '{"search": "\"mot rare du document\"", "select": "id,title,chunk_id,last_updated", "count": true, "top": 5}'

# 2. Rejouer la question comme l'application : hybride + semantic ranker (k=50 conseillé avec le ranker)
curl -s -X POST "$SEARCH/indexes/<index>/docs/search?api-version=$API" \
  -H "Authorization: Bearer $TOKEN" -H "Content-Type: application/json" \
  -d '{
        "search": "<question de l utilisateur>",
        "vectorQueries": [{"kind": "text", "text": "<question de l utilisateur>", "fields": "<champ_vecteur>", "k": 50}],
        "queryType": "semantic", "semanticConfiguration": "<config_semantique>",
        "filter": "<le meme filtre que l application, ex. group_ids/any(g: g eq '\''rh'\'')>",
        "select": "title,chunk_id,last_updated", "top": 5
      }'
À lire dans la réponse : @search.score (score RRF en hybride : des valeurs faibles comme 0,03 sont normales) et
@search.rerankerScore (semantic ranker, de 0 à 4 : 4 = répond complètement, 0 = hors sujet). Le paramètre debug
(vector, semantic, all) détaille les sous-scores quand la version d'API l'accepte.
// Les requêtes que reçoit réellement AI Search (resource logs vers le Log Analytics workspace)
AzureDiagnostics
| where ResourceProvider == "MICROSOFT.SEARCH" and OperationName == "Query.Search"
| where TimeGenerated > ago(1h)
| project TimeGenerated, IndexName_s, Query_s, Documents_d, DurationMs, ResultSignature
| order by TimeGenerated desc
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Document absent ou ancien | Recherche directe vide ; last_updated ancien |
R12 : relancer l'indexer après correction, vérifier le change tracking |
| OCR raté (PDF scanné, image) | Chunk vide ou illisible dans l'index | R10 : modèle prebuilt-layout ou prebuilt-read, qualité du scan |
| Chunk trop gros ou trop petit, coupé au mauvais endroit | La réponse est à cheval sur deux chunks | Revoir maximumPageLength et pageOverlapLength (point de départ Microsoft : 512 tokens, environ 2 000 caractères, chevauchement de 25 %) puis réindexer |
| Filtre de sécurité trop strict ou faux | Le chunk remonte sans filtre, pas avec | Corriger le filtre (groupes de l'utilisateur, champ de filtrage) |
| Vecteurs incohérents | Embedding de la question d'un autre modèle ou d'une autre dimension que l'index | Même modèle d'embedding à l'indexation et à la requête ; réindexer si le modèle a changé |
k trop petit avec le semantic ranker |
Bons documents absents du top | k à 50 avec le semantic ranker (il rerange au plus 50 résultats) |
| Contexte tronqué | Trop de chunks, prompt qui dépasse la fenêtre ou un budget de tokens côté application | Moins de chunks mais mieux classés ; vérifier les tokens d'entrée dans Langfuse |
| Prompt système modifié, nouvelle version de modèle | Changement de comportement à une date précise | Comparer les versions dans Git et dans Langfuse ; revenir à la version précédente |
Confirmer la résolution : rejouer un jeu de questions de référence (dataset Langfuse ou fichier de tests) avant et après, pas seulement la question du ticket.
Prévention : jeu de questions de référence évalué à chaque changement (scores Langfuse, LLM-as-a-judge, retours utilisateurs), alerte sur l'âge de la dernière indexation réussie, version du prompt tracée dans chaque trace.
S'entraîner : lab, pannes n° 10, 11, 13, 14.
R3 · La latence augmente sans erreur#
Symptômes : tout répond en 200 mais en 20 s au lieu de 5 s ; le premier mot arrive tard ; plaintes « c'est lent ». Impact : P2 à P3.
La durée d'une réponse se décompose : application + recherche + appels outils + modèle. Côté modèle, en streaming : TTFT (time to first token, métrique Time to Response) puis génération (métrique Time Between Tokens). Une hausse de latence avec une hausse proportionnelle des tokens n'est pas une panne (chapitre 02).
Première minute
- Comparer la période lente à une période normale (même heure la veille) : volume, durée p95.
- Quelle dépendance a ralenti ? (
AppDependenciesparTarget) - Des 429 et des retries cachés ? Un changement récent (prompt plus long, plus de chunks, nouveau modèle) ?
flowchart TD
    A["Latence en hausse, pas d'erreur"] --> B{"Le volume de requêtes<br/>a-t-il augmenté ?"}
    B -- Oui --> C["Capacité : HPA, nodes,<br/>plan App Service,<br/>quota TPM du modèle → R8"]
    B -- Non --> D["Décomposer la durée<br/>par dépendance"]
    D --> E{"Quel saut a ralenti ?"}
    E -- "Azure OpenAI" --> F{"Tokens d'entrée ou de sortie<br/>en hausse ?"}
    F -- Oui --> G["Prompt plus long, plus de chunks,<br/>max_tokens, modèle de raisonnement"]
    F -- Non --> H["429 et retries,<br/>charge du déploiement,<br/>PTU utilization"]
    E -- "Azure AI Search" --> I["DurationMs des Query.Search,<br/>503 de saturation,<br/>replicas, partitions"]
    E -- "Application elle-même" --> J["CPU throttling, mémoire,<br/>démarrages à froid,<br/>appels séquentiels"]
Commandes
// Décomposer la durée par dépendance : période lente vs veille
let lent = AppDependencies | where TimeGenerated between (ago(2h) .. now())
    | summarize p95_lent = percentile(DurationMs, 95), nb_lent = count() by Target;
let normal = AppDependencies | where TimeGenerated between (ago(26h) .. ago(24h))
    | summarize p95_normal = percentile(DurationMs, 95), nb_normal = count() by Target;
lent | join kind=leftouter normal on Target
| project Target, nb_normal, nb_lent, p95_normal, p95_lent, ecart = p95_lent - p95_normal
| order by ecart desc
// Retries cachés : plusieurs appels au modèle pour une même question
AppDependencies
| where TimeGenerated > ago(2h) and Target has "openai.azure.com"
| summarize appels = count(), echecs_429 = countif(ResultCode == "429") by OperationId
| where appels > 1
| summarize questions = count(), avg_appels = avg(appels), total_429 = sum(echecs_429)
# Métriques Azure OpenAI sur 6 h, par déploiement (TTFT, durée totale, tokens)
az monitor metrics list --resource <id-ressource-openai> --offset 6h --interval 5m \
  --metrics AzureOpenAITimeToResponse AzureOpenAITTLTInMS ProcessedPromptTokens GeneratedTokens \
  --aggregation Average Total --filter "ModelDeploymentName eq '*'" -o table
// Azure AI Search : durée des requêtes et volume, par tranche de 5 minutes
AzureDiagnostics
| where ResourceProvider == "MICROSOFT.SEARCH" and OperationName == "Query.Search"
| where TimeGenerated > ago(6h)
| summarize nb = count(), p95_ms = percentile(DurationMs, 95), erreurs_503 = countif(ResultSignature == 503)
          by bin(TimeGenerated, 5m)
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Prompt plus long (plus de chunks, historique de conversation qui grossit) | ProcessedPromptTokens en hausse, TTFT en hausse |
Limiter l'historique (résumé), moins de chunks, prompt caching sur le préfixe stable |
| Réponses plus longues | GeneratedTokens en hausse, durée totale en hausse |
max_tokens adapté, consigne de concision |
| 429 absorbés par les retries du SDK | Plusieurs appels par OperationId, en-têtes retry-after-ms |
R8 |
| Déploiement Standard sous forte demande | Latence variable sans hausse de tokens | Lisser le trafic ; Provisioned Throughput (PTU) si la latence doit être stable |
| AI Search saturé | DurationMs en hausse, 503 |
Ajouter des replicas (décision projet, coût), réduire les requêtes |
| Pods limités en CPU | Pas d'erreur mais CPU au plafond de la limit dans Grafana |
Ajuster requests et limits, HPA |
| Nouveau modèle de raisonnement | Tokens de raisonnement facturés en sortie, invisibles dans la réponse | Comparer reasoning_tokens dans l'usage ; niveau d'effort de raisonnement plus bas |
Confirmer la résolution : p95 de AppRequests revenu au niveau de référence, TTFT stable sur les métriques du modèle.
Prévention : objectif de latence (SLO) avec alerte sur le p95, tableau Grafana avec TTFT et tokens par déploiement, test de charge avant chaque changement de modèle ou de prompt.
S'entraîner : lab, pannes n° 15.
R4 · L'application ne récupère pas un secret (Key Vault)#
Symptômes : pod bloqué en ContainerCreating avec un événement FailedMount, application qui démarre puis plante
(« secret introuvable », 401 ou 403 vers Key Vault), erreur AADSTS70021. Impact : souvent P1 (rien ne démarre).
Rappel de la chaîne (chapitre 04) : pod (label azure.workload.identity/use: "true") →
service account (annotation azure.workload.identity/client-id) → federated identity credential sur la managed identity
(issuer = OIDC issuer du cluster, subject = system:serviceaccount:<ns>:<sa>) → jeton Entra ID → Key Vault (rôle
Key Vault Secrets User en RBAC) via son Private Endpoint (privatelink.vaultcore.azure.net). Le driver
Secrets Store CSI monte les secrets décrits par une SecretProviderClass.
Première minute
-
kubectl describe pod: lire les Events (FailedMount, messagerpc error, code AADSTS). - Changement récent : namespace ou nom du service account, nouvelle identité, rotation, RBAC, réseau du Key Vault ?
- Le secret existe-t-il, est-il activé, non expiré ?
flowchart TD
    A["Secret non récupéré"] --> B["kubectl describe pod<br/>lire les Events"]
    B --> C{"Message d'erreur ?"}
    C -- "driver not found in the list<br/>of registered CSI drivers" --> D["Pods du CSI driver<br/>sur ce node : kube-system"]
    C -- "SecretProviderClass not found" --> E["SPC absente ou dans<br/>un autre namespace"]
    C -- "AADSTS70021 / 700211 / 700213" --> F["Federated credential :<br/>issuer, subject, audience"]
    C -- "403 Forbidden, AuthorizationFailed" --> G["RBAC Key Vault :<br/>Key Vault Secrets User<br/>sur la bonne identité"]
    C -- "timeout, no such host" --> H["Réseau : Private Endpoint,<br/>DNS privatelink.vaultcore,<br/>firewall du Key Vault"]
    C -- "SecretNotFound, 404" --> I["Nom ou version du secret<br/>dans la SPC"]
    F --> J["Vérifier aussi : label du pod,<br/>annotation du SA,<br/>redémarrage après modification"]
Commandes
# 1. Pod, service account et identité injectée
kubectl describe pod <pod> -n <ns> | sed -n '/Events/,$p'
kubectl get pod <pod> -n <ns> -o jsonpath='{.spec.serviceAccountName}{"\n"}{.metadata.labels}{"\n"}'
kubectl get sa <sa> -n <ns> -o yaml                   # annotation azure.workload.identity/client-id
kubectl exec <pod> -n <ns> -- env | grep AZURE_       # AZURE_CLIENT_ID, AZURE_TENANT_ID, AZURE_FEDERATED_TOKEN_FILE

# 2. Le cluster : OIDC issuer, Workload Identity et add-on CSI
az aks show -g <rg> -n <aks> --query "{oidc:oidcIssuerProfile.issuerUrl, wi:securityProfile.workloadIdentity.enabled}" -o json
az aks show -g <rg> -n <aks> --query addonProfiles.azureKeyvaultSecretsProvider -o json

# 3. La federated credential doit correspondre EXACTEMENT (issuer, subject, audience api://AzureADTokenExchange)
az identity federated-credential list --identity-name <mi> -g <rg-mi> -o table

# 4. RBAC sur le Key Vault (lecture) : la managed identity a-t-elle Key Vault Secrets User ?
az role assignment list --assignee <client-id-mi> --scope <id-key-vault> -o table

# 5. Le CSI driver et le provider Azure sur le node du pod
kubectl get pod -n kube-system -l 'app in (secrets-store-provider-azure, secrets-store-csi-driver)' -o wide
kubectl logs -n kube-system <provider-pod> --since=1h | grep ^E
kubectl logs -n kube-system <csi-driver-pod> -c secrets-store --since=1h | grep ^E

# 6. La SecretProviderClass (même namespace que le pod)
kubectl get secretproviderclass -n <ns>
kubectl get secretproviderclass <spc> -n <ns> -o yaml   # keyvaultName, clientID, tenantId, objects

# 7. Réseau : depuis un pod du même namespace
kubectl run kvtest -n <ns> --rm -it --restart=Never --image=busybox:1.36 -- nslookup <kv>.vault.azure.net
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Subject de la federated credential faux (namespace ou SA renommé) | AADSTS70021 ... presented assertion subject |
Créer la federated credential system:serviceaccount:<ns>:<sa> (une par couple namespace, SA) |
| Issuer faux (cluster recréé, autre cluster) | AADSTS700211 ... issuer |
Issuer = oidcIssuerProfile.issuerUrl du cluster actuel |
Label azure.workload.identity/use: "true" absent du pod |
Pas de variables AZURE_* dans le pod |
Ajouter le label dans le template du Deployment (via Git) |
| Annotation du SA modifiée sans redémarrer | Ancien client ID dans le pod | Redémarrer les pods (la doc impose le redémarrage après un changement d'annotation) |
| Rôle absent ou pas encore propagé | 403 Forbidden ou AuthorizationFailed |
Key Vault Secrets User (ou Key Vault Certificate User pour un objet cert ou key) sur le vault ; attendre la propagation (jusqu'à une dizaine de minutes) |
| Key Vault en access policies et non en RBAC | Forbidden malgré le rôle |
Ajouter une access policy, ou passer le vault en RBAC (décision projet) |
| DNS privé du Key Vault | nslookup renvoie une IP publique, timeout |
Lien de privatelink.vaultcore.azure.net vers le VNet du cluster |
| Federated credential créée à l'instant | Échec juste après la création | Attendre la propagation, redémarrer |
| Plus de 20 federated credentials sur l'identité | Impossible d'en ajouter | Limite de 20 par user-assigned managed identity : une identité par charge, ou identity bindings |
Confirmer la résolution : le pod passe Running, kubectl exec <pod> -- ls /mnt/secrets-store liste les objets (sans
afficher leur contenu), l'application démarre sans erreur.
Prévention : alerte sur l'expiration des secrets et certificats Key Vault, convention de nommage namespace / SA versionnée dans Git, test de montage dans le pipeline de l'environnement hors production.
S'entraîner : lab, pannes n° 7, 8.
R5 · Grafana n'affiche aucune donnée#
Symptômes : panneaux vides « No data », erreur de data source, tableau qui marchait hier. Impact : P3 en général, mais P2 si l'équipe est aveugle pendant un incident.
Deux sources différentes (chapitre 07) : la data source Azure Monitor (métriques
et logs Azure, LAW) et la data source Prometheus (Azure Monitor workspace, métriques du cluster collectées par les pods
ama-metrics).
Première minute
- Un panneau, un tableau ou tous ? Une data source ou toutes ?
- La période sélectionnée et les variables du tableau (abonnement, resource group, cluster) sont-elles bonnes ?
- La donnée existe-t-elle à la source (Metrics explorer, Logs, Prometheus explorer) ?
flowchart TD
    A["Grafana : No data"] --> B{"La donnée existe<br/>dans Azure Monitor ?"}
    B -- Non --> C{"Quelle source ?"}
    C -- "Prometheus" --> D["Collecte : pods ama-metrics,<br/>targets, DCR, quotas d'ingestion"]
    C -- "Logs LAW" --> E["Diagnostic settings,<br/>Container insights, DCR"]
    B -- Oui --> F{"Save and test de la<br/>data source réussit ?"}
    F -- Non --> G["Identité de Grafana :<br/>activée ? rôles ?"]
    G --> H["Monitoring Reader : métriques, logs<br/>Monitoring Data Reader : Prometheus<br/>Reader ou Log Analytics Reader : LAW"]
    F -- Oui --> I["Requête du panneau :<br/>période, variables, nom de métrique,<br/>workspace, cluster"]
Commandes
# Identité et rôles de l'instance Azure Managed Grafana
az grafana show -g <rg> -n <grafana> --query "{identity:identity, sku:sku.name}" -o json
az role assignment list --assignee <principal-id-grafana> --all -o table
# Attendu : Monitoring Reader (abonnement ou RG) pour Azure Monitor ;
#           Monitoring Data Reader sur l'Azure Monitor workspace pour Prometheus

# La collecte Prometheus dans le cluster
kubectl get pods -n kube-system | grep ama-metrics           # ama-metrics-*, ama-metrics-node-*, ama-metrics-ksm-*, ama-metrics-operator-targets-*
kubectl logs <ama-metrics-pod> -n kube-system -c prometheus-collector | tail -50
kubectl port-forward <ama-metrics-pod> -n kube-system 9090   # puis http://127.0.0.1:9090/targets : erreurs de scrape
kubectl get configmap -n kube-system | grep ama-metrics      # ama-metrics-settings-configmap, ama-metrics-prometheus-config
// Container insights : les données arrivent-elles dans le LAW ?
union KubePodInventory, ContainerLogV2, KubeEvents
| where TimeGenerated > ago(1h)
| summarize derniere = max(TimeGenerated), nb = count() by Type
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Identité de Grafana sans rôle (création par quelqu'un qui ne pouvait pas attribuer de rôle) | « Load Subscriptions » vide dans la data source Azure Monitor | Monitoring Reader au bon périmètre |
| Prometheus : rôle manquant | Erreur 403 sur la data source Prometheus | Monitoring Data Reader sur l'Azure Monitor workspace |
| LAW non visible | « No Log Analytics workspaces found » | Reader ou Log Analytics Reader sur le workspace |
| Mauvaise période, mauvaise variable | Les données existent en élargissant la période | Corriger la période ou la variable du tableau |
Pods ama-metrics KO ou OOMKilled |
describe pod : restarts, OOMKilled |
Réduire le volume (keep list, intervalle), dimensionnement selon la doc |
| « No configuration present for the AKS resource » | Message dans les logs du prometheus-collector |
DCR, DCE et Azure Monitor workspace à vérifier ; cluster privé lié à un AMPLS non supporté |
| Quota d'ingestion atteint | Métriques Active Time Series % Utilization, Events Per Minute Received % Utilization à 100 % |
Réduire les séries ou demander une hausse de limite |
| Scrape d'une application qui échoue | Target en erreur sur /targets |
Port, chemin, annotations, NetworkPolicy |
Événements Normal absents de KubeEvents |
Seuls les Warning apparaissent |
Comportement par défaut : collect_all_kube_events dans la ConfigMap si besoin |
Confirmer la résolution : « Save & test » vert, panneau rempli sur la période de l'incident.
Prévention : alerte sur l'absence de données (heartbeat des métriques), rôles de Grafana déployés en IaC, un tableau
« santé de la supervision » (pods ama-metrics, ingestion LAW).
S'entraîner : lab, pannes n° 22, 23, 24.
R6 · Un déploiement ne crée pas de nouveau pod#
Symptômes : la nouvelle version n'apparaît pas ; l'ancien pod tourne toujours ; nouveau pod en Pending, en
ContainerCreating ou en boucle ; kubectl rollout status ne se termine pas. Impact : P2 à P3 (la version précédente sert
encore, en général).
Rappel Kubernetes : un rollout ne démarre que si le template de pod (.spec.template) change. Changer le nombre de replicas
ou republier la même image sous le même tag ne crée pas de nouveau ReplicaSet. Un Deployment qui n'avance pas passe à
Progressing=False avec la raison ProgressDeadlineExceeded après progressDeadlineSeconds (600 s par défaut).
Première minute
-
kubectl rollout statusetkubectl describe deployment: conditionsProgressing,Available,ReplicaFailure. - Un nouveau ReplicaSet existe-t-il ? Avec quelle image ?
- Si rien n'a changé dans le cluster : la cause est en amont (R7).
flowchart TD
    A["Pas de nouveau pod"] --> B{"Le Deployment a-t-il<br/>changé dans le cluster ?"}
    B -- Non --> C["R7 : Argo CD, Git, tag"]
    B -- Oui --> D{"Nouveau ReplicaSet créé ?"}
    D -- Non --> E["Template identique :<br/>même tag, seul replicas changé,<br/>Deployment en pause"]
    D -- Oui --> F{"Pods du nouveau RS ?"}
    F -- "Aucun pod" --> G["ReplicaFailure FailedCreate :<br/>ResourceQuota, LimitRange,<br/>admission, Azure Policy"]
    F -- "Pending" --> H["FailedScheduling :<br/>CPU, mémoire, taints,<br/>affinité, autoscaler"]
    F -- "ContainerCreating" --> I["FailedMount : R4<br/>ou image : R9"]
    F -- "CrashLoopBackOff, pas Ready" --> J["Logs --previous,<br/>readinessProbe, config"]
Commandes
kubectl rollout status deployment/<deploy> -n <ns> --timeout=60s
kubectl describe deployment <deploy> -n <ns>                 # Conditions et Events
kubectl get rs -n <ns> -l app=<chatbot> -o wide              # un ReplicaSet par version, colonne IMAGES
kubectl rollout history deployment/<deploy> -n <ns>
kubectl get deployment <deploy> -n <ns> -o jsonpath='{.spec.paused}{"\n"}{.spec.template.spec.containers[*].image}{"\n"}'

# Quotas et capacité
kubectl describe resourcequota -n <ns>
kubectl get events -n <ns> --field-selector reason=FailedScheduling --sort-by=.lastTimestamp
kubectl describe nodes | grep -A 8 "Allocated resources"
// Événements Warning du namespace (Container insights)
KubeEvents
| where TimeGenerated > ago(2h) and Namespace == "<ns>" and KubeEventType == "Warning"
| project LastSeen, ObjectKind, Name, Reason, Message, Count
| order by LastSeen desc
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
Même tag réutilisé (latest, v1 écrasé) |
Template inchangé, aucun nouveau ReplicaSet | Tag unique par build (numéro de build, SHA Git) ou digest ; mettre à jour le tag dans Git |
| Deployment en pause | .spec.paused: true |
kubectl rollout resume (avec accord), ou retirer la pause dans Git |
| ResourceQuota dépassé | ReplicaFailure ... FailedCreate ... exceeded quota |
Revoir le quota du namespace ou les requests |
| Pas assez de ressources | FailedScheduling ... Insufficient cpu |
Cluster autoscaler, node pool, requests plus justes |
| Admission refusée (Azure Policy, Gatekeeper) | Événement FailedCreate avec message de policy |
Rendre le manifest conforme (pas de contournement de la policy) |
maxUnavailable / PDB bloquants |
Rollout qui attend indéfiniment | Revoir la stratégie de rollout avec l'équipe projet |
| Nouveau pod jamais Ready | readinessProbe en échec |
Logs, probe, dépendances au démarrage |
Confirmer la résolution : rollout status « successfully rolled out », nouveau ReplicaSet à 100 %, ancien à 0, bonne image
dans kubectl get pods -o jsonpath.
Prévention : tags immuables (ACR permet de verrouiller une image), alerte sur ProgressDeadlineExceeded, quotas documentés
par namespace.
S'entraîner : lab, pannes n° 3, 4, 20.
R7 · Le code Git est à jour mais rien ne change (Argo CD)#
Symptômes : le développeur a poussé, le pipeline est vert, mais le cluster tourne l'ancienne version. Impact : P3 en général, P2 si c'est un correctif urgent.
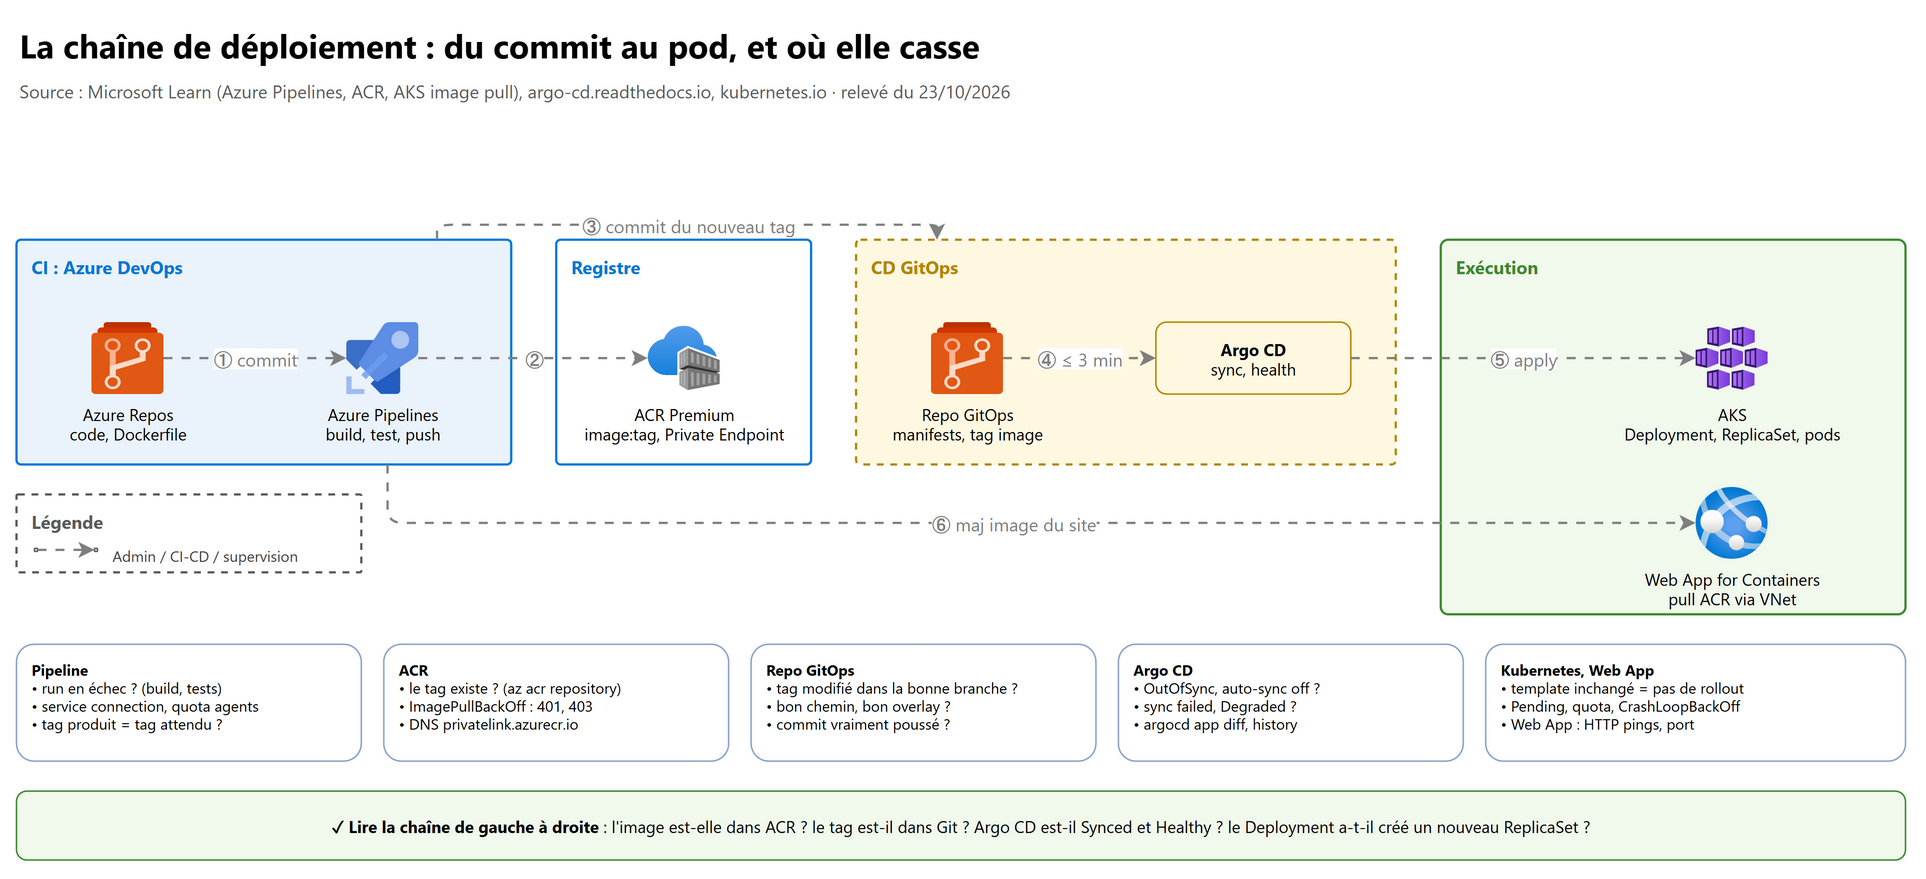
Rappels Argo CD (doc officielle, chapitre 05) :
- Argo CD interroge Git toutes les 120 s avec 60 s de jitter, donc 3 minutes au plus (
timeout.reconciliation), sauf webhook. - Sans auto-sync, une application devient
OutOfSyncet attend un sync manuel. - L'auto-sync ne retente pas un sync qui a échoué sur le même commit et les mêmes paramètres.
- Par défaut l'auto-sync ne supprime pas (pas de prune) et ne corrige pas les modifications faites à la main dans le cluster (pas de self-heal).
- Un rollback est impossible sur une application en auto-sync : on revient en arrière par un commit Git.
Première minute
-
argocd app get <app>: sync status (Synced,OutOfSync), health (Healthy,Progressing,Degraded,Suspended,Missing), révision déployée. - Le commit attendu est-il celui qu'Argo CD suit (repo, branche, chemin, overlay ou fichier de valeurs) ?
- Le tag d'image a-t-il vraiment changé dans les manifests ?
flowchart TD
    A["Git à jour, cluster inchangé"] --> B["argocd app get APP --refresh"]
    B --> C{"Sync status ?"}
    C -- "OutOfSync" --> D{"Auto-sync activé ?"}
    D -- Non --> E["Sync manuel attendu :<br/>argocd app diff puis sync<br/>avec accord"]
    D -- Oui --> F["Dernier sync en échec<br/>sur ce commit ? → lire<br/>l'opération, corriger, nouveau commit"]
    C -- "Synced" --> G{"Révision = commit attendu ?"}
    G -- Non --> H["Mauvaise branche, chemin,<br/>targetRevision, repo"]
    G -- Oui --> I{"Le manifest rendu<br/>a-t-il changé ?"}
    I -- Non --> J["Tag d'image non mis à jour<br/>dans le repo GitOps,<br/>valeur Helm au mauvais endroit"]
    I -- Oui --> K["Cluster : R6<br/>Health Degraded, Progressing"]
Commandes
argocd app get <app> --refresh                 # relit Git ; --hard-refresh vide aussi le cache des manifests
argocd app get <app> --show-operation          # détail du dernier sync (erreur, ressource en échec)
argocd app diff <app>                          # code retour : 0 aucun écart, 1 écart trouvé, 2 erreur
argocd app history <app>                       # révisions déployées et leurs ID
argocd app manifests <app> | grep -n "image:"  # image réellement rendue par Argo CD

# Côté Git (repo GitOps) : le tag est-il bien là, dans la branche suivie ?
git log --oneline -5 -- <chemin/de/l/app>
git show HEAD:<chemin/values-ou-kustomization> | grep -n -i tag

# La définition de l'Application (repo, branche, chemin, politique de sync)
kubectl get application <app> -n argocd -o jsonpath='{.spec.source}{"\n"}{.spec.syncPolicy}{"\n"}'
Actions possibles avec accord (environnement, impact, retour arrière annoncés) : argocd app sync <app> ;
argocd app rollback <app> <id> sur une application sans auto-sync ; sinon commit de retour dans Git.
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Auto-sync désactivé | OutOfSync, aucune opération récente |
Sync manuel validé, ou activer l'auto-sync (décision projet) |
| Sync en échec, pas de nouvelle tentative | --show-operation : erreur sur une ressource |
Corriger le manifest, nouveau commit |
Mauvaise branche ou mauvais path |
Révision déployée ≠ commit poussé | Pousser au bon endroit ; corriger targetRevision / path via Git |
| Tag d'image inchangé | diff vide, même image |
Le pipeline doit commiter le nouveau tag dans le repo GitOps |
| Délai de détection | Commit poussé il y a moins de 3 minutes | Attendre, ou --refresh |
| Accès au repo cassé (jeton expiré, réseau) | Erreur ComparisonError / repo inaccessible |
Renouveler l'accès au repo dans Argo CD |
Sync OK mais application Degraded |
Health Degraded, Progressing qui dure |
R6, R9, R4 |
| Ressource modifiée à la main | Écart que l'auto-sync sans self-heal ne corrige pas | Remettre l'état de Git ; interdire les modifications manuelles |
Confirmer la résolution : Synced + Healthy sur le commit attendu, nouvelle image dans les pods.
Prévention : tags uniques écrits par le pipeline dans le repo GitOps, notifications Argo CD sur SyncFailed et Degraded,
webhook Git pour réduire le délai.
S'entraîner : lab, pannes n° 18, 19, 20.
R8 · 429 et quota épuisé sur le modèle#
Symptômes : erreurs 429 « Too Many Requests », réponses lentes (retries), message « Rate limit is exceeded » ou « The service is temporarily unable to process your request ». Impact : P1 à P2 selon la proportion.
Rappels (chapitre 02) : chaque déploiement a une limite TPM (tokens par minute) et une limite
RPM dérivée (pour les anciens modèles de chat, 1 000 TPM = 6 RPM). Le calcul TPM se fait à la réception, sur une
estimation qui compte le prompt et max_tokens. Le RPM est contrôlé sur des fenêtres de 1 ou 10 secondes : une
rafale déclenche un 429 même sous la moyenne par minute.
| Type de 429 (doc Microsoft) | Message | Que faire |
|---|---|---|
| Limite du déploiement dépassée | « Requests to … have been limited », « Rate limit is exceeded » | Plus de TPM sur le déploiement, rééquilibrer le quota, demander une hausse |
| Capacité du service | « The service is temporarily unable to process your request », « System is experiencing high demand » | Retry après retry-after-ms ; si persistant, PTU ; une hausse de quota ne règle pas ce cas |
| Ajustement temporaire | 429 alors que le quota n'a pas changé, x-ratelimit-limit-tokens inférieur au TPM configuré |
Retry avec backoff ; se résorbe en général en quelques heures |
| Budget consommé par les paramètres | 429 alors que les métriques de tokens paraissent basses | Réduire max_tokens à la taille réelle des réponses |
Première minute
- Lire le message du 429 (quota ou capacité) et les en-têtes
x-ratelimit-*. - Métrique Azure OpenAI Requests filtrée sur
StatusCode429, parModelDeploymentName. - Le trafic a-t-il changé (nouveau projet sur le même déploiement, rafale, batch d'ingestion en journée) ?
flowchart TD
    A["429 sur le modèle"] --> B{"Message du 429 ?"}
    B -- "Rate limit exceeded" --> C{"Tokens consommés<br/>proches du TPM ?"}
    C -- Oui --> D["Vrai manque de quota :<br/>TPM du déploiement,<br/>autre déploiement, hausse"]
    C -- Non --> E["Rafales RPM ou max_tokens<br/>trop haut, retries agressifs"]
    B -- "Temporarily unable,<br/>high demand" --> F["Capacité du service :<br/>backoff, autre région,<br/>PTU si persistant"]
    B -- "x-ratelimit-limit-tokens<br/>sous le TPM" --> G["Ajustement temporaire :<br/>backoff, suivre"]
    D --> H["Escalade si 429 durables<br/>sous le quota approuvé"]
Commandes
# Requêtes et 429 par déploiement sur 3 h
az monitor metrics list --resource <id-ressource-openai> --offset 3h --interval 5m \
  --metrics AzureOpenAIRequests --aggregation Total \
  --filter "ModelDeploymentName eq '*' and StatusCode eq '429'" -o table

# Tokens consommés par déploiement (à comparer au TPM configuré)
az monitor metrics list --resource <id-ressource-openai> --offset 3h --interval 1m \
  --metrics ProcessedPromptTokens GeneratedTokens --aggregation Total --filter "ModelDeploymentName eq '*'" -o table

# Capacité (TPM) de chaque déploiement
az cognitiveservices account deployment list -g <rg> -n <compte-openai> \
  --query "[].{name:name, model:properties.model.name, version:properties.model.version, sku:sku.name, capacity:sku.capacity}" -o table
// Côté application : les 429 du modèle par minute et par opération
AppDependencies
| where TimeGenerated > ago(3h) and Target has "openai.azure.com"
| summarize appels = count(), r429 = countif(ResultCode == "429") by bin(TimeGenerated, 1m)
| extend taux_429 = round(100.0 * r429 / appels, 1)
// Côté ressource (diagnostic setting RequestResponse) : codes de réponse
AzureDiagnostics
| where ResourceProvider == "MICROSOFT.COGNITIVESERVICES" and Category == "RequestResponse"
| where TimeGenerated > ago(3h)
| summarize nb = count() by ResultSignature, bin(TimeGenerated, 5m)
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| TPM du déploiement trop bas pour le trafic | Tokens au plafond, 429 « rate limit » | Augmenter le TPM du déploiement (quota disponible dans la région) ou demander une hausse |
| Quota au niveau abonnement mais pas affecté au bon déploiement | Quota libre dans la région, déploiement plein | Réaffecter le quota entre déploiements |
max_tokens très élevé |
429 alors que les tokens facturés sont bas | max_tokens proche de la longueur utile |
| Rafales (batch, tests de charge, ingestion en journée) | Pics de 429 à des heures précises | Lisser, file d'attente, batch hors heures ou Global Batch |
| Retries sans attente (et SDK qui retente déjà) | Plusieurs appels par question, 429 en cascade | Respecter retry-after-ms, un seul niveau de retry (max_retries=0 sur le client si l'application gère ses retries) |
| Capacité régionale | Messages « high demand » | Backoff, déploiement Global ou Data Zone, PTU pour une capacité garantie |
| Plusieurs projets sur le même déploiement | Hausse de trafic sans changement côté projet | Un déploiement par projet ou une AI gateway (API Management) avec quotas par consommateur |
Confirmer la résolution : taux de 429 proche de zéro, latence revenue, plus de retries par question.
Prévention : alerte sur le taux de 429 et sur l'utilisation du TPM, revue mensuelle des quotas, quotas par consommateur dans une AI gateway, tests de charge réalistes.
S'entraîner : lab, pannes n° 16.
R9 · ImagePullBackOff depuis un ACR privé#
Symptômes : pod en ErrImagePull puis ImagePullBackOff. Impact : la nouvelle version ne démarre pas ; P1 si aucun pod
ne tourne.
Microsoft découpe un pull en trois étapes : authentification (jeton de la kubelet identity, rôle AcrPull, ou
Container Registry Repository Reader si le registre est en mode ABAC), point de terminaison du registre
(<acr>.azurecr.io), puis point de terminaison de données (couches de l'image, un hôte différent). Avec un Private Endpoint,
la zone privatelink.azurecr.io contient aussi les enregistrements des endpoints de données régionaux.
Première minute
-
kubectl describe pod: lire le message exact de l'événementFailed. - Le tag existe-t-il dans ACR ?
- Changement récent : réseau de l'ACR, DNS, identité du cluster, nouvelle architecture de node (ARM64) ?
flowchart TD
    A["ImagePullBackOff"] --> B["describe pod :<br/>message de l'événement"]
    B --> C{"Message ?"}
    C -- "not found" --> D["Nom, repository, tag :<br/>az acr repository show-tags"]
    C -- "401 Unauthorized" --> E["Rôle AcrPull de la kubelet identity,<br/>ou ABAC : Repository Reader ;<br/>architecture de l'image"]
    C -- "403 Forbidden" --> F["Réseau du registre :<br/>lien DNS privatelink.azurecr.io,<br/>règles de pare-feu ACR"]
    C -- "i/o timeout,<br/>TLS handshake timeout" --> G["Chemin réseau :<br/>Private Endpoint, NSG,<br/>Azure Firewall, UDR"]
    C -- "no match for platform" --> H["Image ARM64 vs AMD64 :<br/>image multi-architecture"]
    C -- "manifest not found<br/>après réécriture d'un tag" --> I["Tag réutilisé :<br/>tag unique ou digest"]
Commandes
kubectl describe pod <pod> -n <ns> | grep -A3 -E "Failed|BackOff"

# Le tag existe-t-il ?
az acr repository show-tags -n <acr> --repository <repo> --orderby time_desc --top 10 -o table

# Test intégré AKS → ACR : DNS, réseau, droits de pull (lancé depuis le cluster)
az aks check-acr -g <rg> -n <aks> --acr <acr>.azurecr.io

# Santé du registre et de l'environnement local
az acr check-health -n <acr> --ignore-errors --yes

# Identité kubelet et ses rôles sur l'ACR
az aks show -g <rg> -n <aks> --query identityProfile.kubeletidentity.objectId -o tsv
az role assignment list --assignee <object-id-kubelet> --scope <id-acr> -o table

# DNS depuis le cluster : login server et endpoint de données régional
kubectl run acrtest -n <ns> --rm -it --restart=Never --image=busybox:1.36 -- nslookup <acr>.azurecr.io
kubectl run acrtest2 -n <ns> --rm -it --restart=Never --image=busybox:1.36 -- nslookup <acr>.<region>.data.azurecr.io
Note : un curl https://<acr>.azurecr.io/v2/ qui répond 401 est normal et prouve que le point de terminaison est
joignable ; il faut alors chercher du côté du jeton ou de l'endpoint de données.
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
Tag inexistant, faute de frappe (azureacr.io) |
not found (ou 401 anonyme sur un mauvais nom) |
Corriger le nom ou le tag dans Git |
| Rôle absent sur la kubelet identity | 401 failed to fetch oauth token |
AcrPull (ou Container Registry Repository Reader en ABAC) ; az aks update --attach-acr avec accord |
Lien de la zone privatelink.azurecr.io absent pour le VNet du cluster |
403 failed to fetch anonymous token |
Ajouter le virtual network link |
| Endpoint de données bloqué ou mal résolu | Manifeste lu mais couches en échec | DNS de <acr>.<region>.data.azurecr.io, règles du pare-feu |
| Pare-feu ou UDR | i/o timeout, TLS handshake timeout |
Autoriser le flux, vérifier la route vers le Private Endpoint |
| Image d'une autre architecture | no match for platform in manifest, exec format error |
Image multi-architecture ou node pool adapté |
| Tag réécrit | manifest not found juste après un push sur un tag existant |
Tags immuables |
Confirmer la résolution : pod Running, événement Pulled, az aks check-acr sans erreur.
Prévention : az aks check-acr dans le runbook de changement réseau, tags immuables, alerte sur les événements
Failed de type pull, liens DNS déployés en IaC avec le Private Endpoint.
S'entraîner : lab, pannes n° 4, 21.
R10 · Ingestion Document Intelligence en échec#
Symptômes : documents absents de l'index, erreur dans le pipeline d'ingestion ou dans l'indexer (skill), statut failed
sur l'opération d'analyse, 429. Impact : P3 en général (les anciens documents restent), P2 si un contenu urgent manque.
Rappels : l'analyse est asynchrone (POST :analyze → 202 + en-tête Operation-Location → GET du résultat jusqu'à
succeeded ou failed) ; les résultats restent disponibles 24 heures. Limites d'entrée : 500 MB en S0 (4 MB en F0),
2 000 pages pour un PDF ou un TIFF (seulement 2 pages en F0), images de 50 × 50 à 10 000 × 10 000 pixels, pas de PDF
protégé par mot de passe. Débit par défaut : 15 transactions par seconde pour les requêtes d'analyse.
Première minute
- Tous les documents ou certains (taille, type, scan) ?
- Code d'erreur exact (
InvalidContent,InvalidContentLength,ContentSourceNotAccessible, 429…). - Changement : nouvelle source, nouveau type de fichier, rotation de clé ou d'identité, réseau du Storage account ?
flowchart TD
    A["Ingestion en échec"] --> B{"Code d'erreur ?"}
    B -- "429" --> C["Débit : POST trop rapprochés<br/>ou GET de suivi trop fréquents"]
    B -- "InvalidContent,<br/>InvalidContentLength,<br/>InvalidContentDimensions" --> D["Le fichier : format,<br/>taille, dimensions,<br/>mot de passe"]
    B -- "ContentSourceNotAccessible,<br/>InvalidSasToken" --> E["Accès à la source :<br/>SAS expiré, identité,<br/>pare-feu du Storage"]
    B -- "401, 403" --> F["Identité de l'appelant :<br/>rôle sur la ressource,<br/>réseau du service"]
    B -- "InternalServerError" --> G["Côté service : retry<br/>avec délai, lot plus petit"]
    B -- "Succès mais texte vide" --> H["Qualité du scan,<br/>modèle read ou layout"]
Commandes
# Rejouer l'analyse d'un document en échec (hors production si possible). Jeton Entra ID : custom subdomain requis,
# rôle Cognitive Services User sur la ressource
TOKEN=$(az account get-access-token --scope https://cognitiveservices.azure.com/.default --query accessToken -o tsv)
EP=https://<docintel>.cognitiveservices.azure.com
curl -s -i -X POST "$EP/documentintelligence/documentModels/prebuilt-layout:analyze?api-version=2024-11-30" \
  -H "Authorization: Bearer $TOKEN" -H "Content-Type: application/json" \
  -d '{"urlSource": "<url du document>"}' | grep -i -E "HTTP/|operation-location|retry-after"
# puis GET sur l'URL Operation-Location, au plus une fois toutes les 2 secondes, jusqu'à status = succeeded ou failed
// Si l'OCR passe par un skillset AI Search : erreurs et avertissements par document
AzureDiagnostics
| where ResourceProvider == "MICROSOFT.SEARCH" and Category == "IndexerErrorsWarningLogs"
| where TimeGenerated > ago(24h)
| project TimeGenerated, Level, IndexerName_s, Name_s, StatusCode_s, ErrorMessage_s, Details_s
| order by TimeGenerated desc
Note : la catégorie IndexerErrorsWarningLogs et ses colonnes viennent d'un exemple Microsoft Learn (Microsoft Discovery) ;
vérifier les catégories de diagnostic activées sur le service avant de s'y fier.
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Fichier trop gros ou trop de pages | InvalidContentLength |
Découper le document en amont ; vérifier le tier (F0 limité à 4 MB et 2 pages) |
| Format non supporté, fichier corrompu, PDF chiffré | InvalidContent |
Convertir, retirer le mot de passe à la source |
| SAS expiré, identité sans droit sur le Storage, pare-feu | ContentSourceNotAccessible, InvalidSasToken |
Renouveler le SAS ou passer à l'identité managée ; règles réseau du Storage |
| Débit dépassé | 429 sur POST ou GET | Lisser les envois, backoff sur le GET (pas plus d'un appel toutes les 2 s), demande de hausse TPS si justifié |
| Erreur interne transitoire | InternalServerError |
Retry avec délai, lots plus petits ; escalade si persistant |
| Texte vide ou incohérent | Analyse succeeded mais contenu pauvre |
Qualité du scan (hauteur de texte minimale), modèle prebuilt-layout |
Confirmer la résolution : le document apparaît dans l'index (requête directe R2), statut d'indexer en succès.
Prévention : contrôle de taille et de format avant envoi, file d'attente avec débit maîtrisé, alerte sur le nombre de documents en échec par exécution.
S'entraîner : lab, pannes n° 12.
R11 · Web App : container didn't respond to HTTP pings#
Symptômes : dans le Log stream ou les logs Docker : « Container … didn't respond to HTTP pings on port: 8080. Failing site start », site en erreur 503 après un déploiement. Impact : P1 si la production ne démarre plus.
Rappels (chapitre 06) : au démarrage, App Service envoie une requête de warmup
(/robots933456.txt) au conteneur et attend une réponse HTTP, quel que soit le code. Il attend 240 s par défaut
(WEBSITES_CONTAINER_START_TIME_LIMIT, de 240 à 1 800 s). Le port écouté par le conteneur se déclare avec WEBSITES_PORT
(un seul port HTTP exposé).
Première minute
- Lire le Log stream : le conteneur démarre puis sort (crash) ou tourne sans répondre (port, lenteur) ?
- Le port écouté par l'application =
WEBSITES_PORT? - Changement : image, variables d'environnement, références Key Vault, réseau sortant (VNet integration) ?
flowchart TD
    A["Didn't respond to HTTP pings"] --> B{"Le conteneur a-t-il<br/>exited ?"}
    B -- Oui --> C["Crash au démarrage :<br/>logs du conteneur,<br/>config, secret, dépendance"]
    B -- Non --> D{"Port écouté =<br/>WEBSITES_PORT ?"}
    D -- Non --> E["Aligner WEBSITES_PORT<br/>sur le port de l'application"]
    D -- Oui --> F{"Démarrage plus long<br/>que la limite ?"}
    F -- Oui --> G["WEBSITES_CONTAINER_START_TIME_LIMIT<br/>ou démarrage plus rapide"]
    F -- Non --> H["L'app écoute sur 127.0.0.1<br/>au lieu de 0.0.0.0,<br/>ou ne répond pas au chemin de warmup"]
    C --> I{"Image tirée ?"}
    I -- Non --> J["Pull ACR : identité, AcrPull,<br/>vnetImagePullEnabled, DNS"]
Commandes
# Logs du conteneur en direct (activer d'abord la journalisation du conteneur)
az webapp log config -g <rg> -n <app> --docker-container-logging filesystem
az webapp log tail -g <rg> -n <app>
# Logs Docker bruts : https://<app>.scm.azurewebsites.net/api/logs/docker  (Kudu, accès réseau privé requis)

# Réglages qui comptent
az webapp config appsettings list -g <rg> -n <app> \
  --query "[?name=='WEBSITES_PORT' || name=='WEBSITES_CONTAINER_START_TIME_LIMIT' || name=='WEBSITE_WARMUP_PATH'].{n:name, v:value}" -o table
az webapp config show -g <rg> -n <app> --query "{linuxFx:linuxFxVersion, acrMI:acrUseManagedIdentityCreds, vnetRouteAll:vnetRouteAllEnabled}" -o json
az resource show -g <rg> -n <app> --resource-type "Microsoft.Web/sites" --query properties.vnetImagePullEnabled
// Logs de plateforme (démarrage du conteneur) et console de l'application
AppServicePlatformLogs
| where TimeGenerated > ago(2h)
| project TimeGenerated, Level, OperationName, Message, ContainerId
| order by TimeGenerated desc
AppServiceConsoleLogs
| where TimeGenerated > ago(2h)
| where ResultDescription has_any ("error", "exception", "listening", "port")
| project TimeGenerated, ResultDescription
| order by TimeGenerated desc
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Port différent | L'application annonce un port ≠ WEBSITES_PORT |
Aligner WEBSITES_PORT (changement de configuration, avec accord) |
Écoute sur localhost |
Log « listening on 127.0.0.1 » | L'application doit écouter sur 0.0.0.0 (correctif dans l'image) |
| Démarrage long (chargement de modèle, cache) | Warmup qui dépasse 240 s | WEBSITES_CONTAINER_START_TIME_LIMIT (jusqu'à 1 800 s), ou démarrage allégé |
| Crash au démarrage | « has exited, failing site start » | Logs console : variable manquante, référence Key Vault non résolue, dépendance injoignable |
| Image non tirée | Erreurs de pull dans les logs | Managed identity avec AcrPull, acrUseManagedIdentityCreds, vnetImagePullEnabled si l'ACR est privé, DNS privatelink.azurecr.io lié au VNet d'intégration |
| Chemin de warmup qui ne répond pas | L'application ne répond à aucune route inconnue | WEBSITE_WARMUP_PATH, WEBSITE_WARMUP_STATUSES |
| Mémoire insuffisante du plan | Redémarrages, conteneur tué | Plan plus grand ou application allégée (décision projet) |
Confirmer la résolution : Log stream « Site started », réponse HTTP correcte via l'entrée privée, AppServiceHTTPLogs en 200.
Prévention : WEBSITES_PORT et EXPOSE du Dockerfile alignés et revus en code review, slot de pré-production avec swap,
Health check sur un chemin léger.
S'entraîner : lab, pannes n° 5.
R12 · Indexer Azure AI Search en erreur#
Symptômes : statut error ou exécutions transientFailure / persistentFailure, documents manquants, nombre de documents
de l'index qui ne bouge plus. Impact : réponses périmées (R2), P3 en général.
Rappels : le statut global de l'indexer vaut running ou error ; chaque exécution vaut success, inProgress,
transientFailure, persistentFailure ou reset. Une exécution peut être en succès avec des erreurs tant que leur nombre
reste sous maxFailedItems. Sur transientFailure répétée, l'indexer planifié espace ses exécutions jusqu'à une fois par
24 h ; sur persistentFailure, les exécutions planifiées s'arrêtent jusqu'à un reset. L'historique garde les 50 dernières
exécutions.
Première minute
- Statut,
lastResult.errorMessage,itemsFailed, erreurs et avertissements par document. - Changement : schéma de l'index, skillset, source de données (identité, SAS, réseau), quota du modèle d'embedding ?
flowchart TD
    A["Indexer en erreur"] --> B["GET indexers/NOM/status"]
    B --> C{"Statut de la dernière exécution ?"}
    C -- "persistentFailure" --> D["Intervention requise :<br/>source inaccessible, schéma,<br/>puis reset et run"]
    C -- "transientFailure" --> E["Cause temporaire :<br/>source indisponible, 429 du<br/>modèle d'embedding, délai"]
    C -- "success avec itemsFailed" --> F["Erreurs par document :<br/>skill, type de champ,<br/>taille, OCR"]
    C -- "success, mais documents absents" --> G["Change tracking,<br/>field mappings, requête<br/>qui filtre"]
    F --> H{"Erreur de skill ?"}
    H -- "Embedding" --> I["Quota, chunk trop long,<br/>identité du service Search"]
    H -- "Document Intelligence" --> J["R10"]
Commandes
TOKEN=$(az account get-access-token --scope https://search.azure.com/.default --query accessToken -o tsv)
SEARCH=https://<search>.search.windows.net
API=2026-04-01

# Statut, dernière exécution, erreurs (les rôles Search Service Contributor ou équivalent sont nécessaires sur les indexers)
curl -s "$SEARCH/indexers/<indexer>/status?api-version=$API" -H "Authorization: Bearer $TOKEN" \
  | jq '{status, last: .lastResult | {status, errorMessage, itemsProcessed, itemsFailed, startTime, endTime,
         errors: [.errors[]? | {key, errorMessage, name}][0:5]}}'

# Nombre de documents dans l'index (évolue-t-il ?)
curl -s "$SEARCH/indexes/<index>/docs/\$count?api-version=$API" -H "Authorization: Bearer $TOKEN"

# Avec accord, après correction : relancer (run) ou repartir de zéro (reset puis run)
# curl -X POST "$SEARCH/indexers/<indexer>/run?api-version=$API"   -H "Authorization: Bearer $TOKEN" -H "Content-Length: 0"
# curl -X POST "$SEARCH/indexers/<indexer>/reset?api-version=$API" -H "Authorization: Bearer $TOKEN" -H "Content-Length: 0"
// Historique des exécutions d'indexer (resource logs, si la catégorie est collectée)
AzureDiagnostics
| where ResourceProvider == "MICROSOFT.SEARCH" and TimeGenerated > ago(7d)
| where Category == "IndexerActivityLogs" and OperationName == "Indexer.End"
| project TimeGenerated, IndexerName_s, ResultType, ItemsProcessed_d, ItemsFailed_d
| order by TimeGenerated desc
Note : comme pour R10, cette requête vient d'un exemple Microsoft Learn (Microsoft Discovery) ; la page de référence d'Azure AI
Search ne documente que la catégorie OperationLogs. La source qui fait foi reste l'API Get Indexer Status.
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Source inaccessible (SAS expiré, identité, pare-feu du Storage, Private Endpoint partagé) | persistentFailure, message d'accès |
Corriger l'accès, puis reset si nécessaire |
| Type de champ incompatible | « Type of value has a mismatch with column type » | Corriger le mapping ou le schéma |
| Skill d'embedding en échec (429, entrée trop longue) | Erreurs par document sur le skill | Quota du déploiement d'embedding, taille des chunks (Text Split) |
| Skill personnalisé invalide | « Web API skill response is invalid » | Corriger le code du skill |
| Change tracking faussé | Documents récents ignorés ; finalTrackingState dans le futur |
Corriger la colonne de suivi, reset |
| Temps maximal d'exécution atteint | Exécution qui s'arrête avant la fin, reprend au run suivant | Attendre les exécutions suivantes ou découper |
maxFailedItems à 0 |
Une seule erreur fait échouer tout le lot | Choisir une tolérance consciente et suivre les erreurs |
Confirmer la résolution : dernière exécution success, itemsFailed à 0 (ou connu), nombre de documents attendu, document
du ticket retrouvé par une requête.
Prévention : alerte sur itemsFailed et sur l'âge de la dernière exécution réussie, test d'accès à la source après chaque
changement réseau ou rotation.
S'entraîner : lab, pannes n° 12.
R13 · Certificat ou Ingress en erreur#
Symptômes : erreur TLS dans le navigateur (certificat expiré, nom invalide), 404 ou 503 de l'Ingress, l'ancien certificat reste servi après une rotation. Impact : P1 si tous les utilisateurs sont bloqués.
Contexte AKS 2026 : le projet communautaire Ingress NGINX est retiré (maintenance arrêtée en mars 2026) ; Microsoft assure les correctifs de sécurité critiques de l'application routing add-on NGINX jusqu'en novembre 2026 et recommande de migrer vers Gateway API (application routing Gateway API implementation) ou Application Gateway for Containers. Un incident d'Ingress est donc aussi l'occasion de signaler ce sujet.
Première minute
- Quel certificat est servi ? (
openssl s_client), date d'expiration, nom (SAN). - Source du certificat : Key Vault (application routing add-on, CSI), cert-manager, autre ?
- L'Ingress (ou la Gateway) a-t-il des événements
Warning? Le Service a-t-il des endpoints ?
flowchart TD
    A["Erreur TLS ou Ingress"] --> B{"Type d'erreur ?"}
    B -- "Certificat expiré<br/>ou ancien" --> C{"Source du certificat ?"}
    C -- "Key Vault" --> D["URI versionnée ?<br/>identité, rôle Key Vault Secrets User,<br/>pod de synchronisation"]
    C -- "cert-manager" --> E["Certificate puis CertificateRequest<br/>puis Issuer, Order, Challenge"]
    B -- "Nom invalide" --> F["SAN du certificat :<br/>apex et wildcard"]
    B -- "404" --> G["Règle d'Ingress :<br/>host, path, ingressClassName"]
    B -- "502 / 503" --> H["Service sans endpoints :<br/>pods pas Ready, selector, port"]
Commandes
# Quel certificat est servi, jusqu'à quand, pour quels noms ?
openssl s_client -connect <host>:443 -servername <host> </dev/null 2>/dev/null \
  | openssl x509 -noout -subject -issuer -enddate -ext subjectAltName

# Ingress, Service, endpoints, événements
kubectl get ingress -n <ns> -o wide
kubectl describe ingress <ingress> -n <ns>
kubectl get endpoints <svc> -n <ns>
kubectl get secret <tls-secret> -n <ns> -o jsonpath='{.type}{"\n"}'     # kubernetes.io/tls attendu

# Certificat Key Vault : versions et expiration
az keyvault certificate show --vault-name <kv> -n <cert> --query "{id:id, exp:attributes.expires, enabled:attributes.enabled}" -o json

# cert-manager : remonter la chaîne
kubectl get certificate -n <ns>
kubectl describe certificate <cert> -n <ns>
kubectl get certificaterequest -n <ns>
kubectl describe clusterissuer <issuer>
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Certificat expiré | notAfter passé |
Renouveler dans Key Vault ou corriger l'émission cert-manager |
| URI Key Vault versionnée dans la configuration | Nouvelle version dans Key Vault mais ancien certificat servi | Utiliser l'URI sans version pour suivre la rotation |
| Identité sans droit sur le Key Vault | AuthorizationFailed sur getSecret |
Key Vault Secrets User sur le vault |
| SAN incomplet (wildcard sans l'apex) | Erreur seulement sur le nom racine | Recréer le certificat avec les deux noms |
Mauvaise ingressClassName, host ou path |
404 | Corriger le manifest via Git |
| Pods pas Ready, selector faux | 503, endpoints vides | R6, R1 |
| Émission ACME bloquée | Order / Challenge en attente |
DNS, accès sortant, règles de pare-feu |
Confirmer la résolution : openssl s_client montre la bonne date et les bons noms, réponse 200 sur l'URL.
Prévention : alerte d'expiration à J-30 (Key Vault, cert-manager), URI sans version, plan de migration hors Ingress NGINX.
R14 · Le coût des tokens explose#
Symptômes : alerte budget Cost Management, facture du mois en forte hausse, quota consommé plus vite. Impact : P2 à P3 (financier), parfois signe d'un abus ou d'une boucle.
Rappels (chapitre 02) : on paie les tokens d'entrée et de sortie (les tokens de
raisonnement sont facturés comme de la sortie) ; le prompt caching facture moins cher les tokens d'entrée déjà en cache
(préfixe identique d'au moins 1 024 tokens, visible dans cached_tokens) ; une requête filtrée par le content filter peut
être facturée.
Première minute
- Depuis quand, sur quelle ressource et quel déploiement (modèle) ?
- Hausse du nombre de requêtes ou des tokens par requête ?
- Changement : nouveau modèle (plus cher, raisonnement), prompt plus long, plus de chunks, historique non borné, batch d'ingestion, boucle d'agent ?
flowchart TD
    A["Coût des tokens en hausse"] --> B{"Plus de requêtes<br/>ou plus de tokens par requête ?"}
    B -- "Plus de requêtes" --> C{"Utilisateurs réels ?"}
    C -- Oui --> D["Croissance normale :<br/>prévoir, PTU, Batch"]
    C -- Non --> E["Boucle, retries, agent,<br/>test de charge, abus :<br/>couper la source"]
    B -- "Plus de tokens" --> F{"Entrée ou sortie ?"}
    F -- "Entrée" --> G["Prompt, chunks, historique,<br/>cache raté : cached_tokens"]
    F -- "Sortie" --> H["max_tokens, verbosité,<br/>modèle de raisonnement"]
Commandes
# Tokens par déploiement, par jour, sur 14 jours
az monitor metrics list --resource <id-ressource-openai> --offset 14d --interval 24h \
  --metrics ProcessedPromptTokens GeneratedTokens AzureOpenAIRequests --aggregation Total \
  --filter "ModelDeploymentName eq '*'" -o table
// Métriques exportées dans le LAW (diagnostic setting AllMetrics)
AzureMetrics
| where ResourceProvider == "MICROSOFT.COGNITIVESERVICES" and TimeGenerated > ago(14d)
| where MetricName in ("ProcessedPromptTokens", "GeneratedTokens", "AzureOpenAIRequests")
| summarize total = sum(Total) by MetricName, bin(TimeGenerated, 1d)
| order by TimeGenerated asc
Dans Langfuse : trier les traces par coût ou par tokens, regrouper par utilisateur, par session et par version de prompt ; une session qui enchaîne des centaines d'appels signale une boucle.
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Nouveau modèle plus cher ou de raisonnement | Changement de déploiement à une date ; reasoning_tokens élevés |
Revenir au modèle précédent ou baisser l'effort de raisonnement (décision projet) |
| Prompt plus long, plus de chunks | ProcessedPromptTokens / requête en hausse |
Moins de chunks, mieux classés |
| Historique de conversation non borné | Tokens d'entrée qui croissent dans une session | Fenêtre glissante ou résumé |
| Cache raté | cached_tokens à 0 alors que le prompt système est long |
Mettre le contenu stable au début du prompt, identique entre requêtes |
| Retries ou boucle d'agent | Nombre d'appels par question élevé | Corriger la boucle, limiter les itérations |
| Ingestion lancée en temps réel | Pic d'embeddings | Global Batch (50 % moins cher que Global Standard, délai cible 24 h) pour les traitements différables |
| Usage abusif | Un utilisateur ou une IP concentre le volume | Quotas par utilisateur dans l'application ou l'AI gateway |
Confirmer la résolution : tokens par requête revenus au niveau de référence, courbe de coût quotidienne stabilisée.
Prévention : budgets et alertes Cost Management par resource group, tableau de bord tokens et coût par déploiement, quotas par consommateur, revue du coût à chaque changement de modèle.
S'entraîner : lab, pannes n° 17, 25.
R15 · Un content filter bloque des réponses#
Symptômes : HTTP 400 avec le code content_filter (le prompt est bloqué), ou réponse coupée avec
finish_reason: "content_filter" (la sortie est filtrée) ; message générique de l'application « je ne peux pas répondre ».
Impact : P3 à P2 si des questions légitimes du métier sont bloquées.
Rappels : dans Microsoft Foundry, les content filters relèvent désormais des Guardrails ; les résultats détaillés sont dans
content_filter_results (catégories hate, sexual, violence, self_harm, protected material…). En streaming avec le mode
Asynchronous Filter, le signal peut arriver après l'affichage d'une partie du texte. Un prompt filtré (400) et une sortie
filtrée (200 + finish_reason) sont facturés.
Première minute
- Récupérer la question, l'heure, la réponse brute (trace Langfuse ou log) : 400 sur le prompt ou
finish_reasonsur la sortie ? - Quelle catégorie et quelle sévérité dans
content_filter_results? - Changement : configuration de guardrail, nouveau modèle, nouveaux documents indexés (le contenu injecté par le RAG est aussi filtré), prompt système ?
flowchart TD
    A["Réponse bloquée"] --> B{"Où est le blocage ?"}
    B -- "HTTP 400 content_filter" --> C["Le prompt :<br/>question, chunks injectés,<br/>prompt système"]
    B -- "finish_reason content_filter" --> D["La sortie du modèle"]
    C --> E{"Question légitime ?"}
    D --> E
    E -- "Non" --> F["Comportement attendu :<br/>message clair à l'utilisateur"]
    E -- "Oui" --> G["Catégorie, sévérité, jailbreak,<br/>protected material ?"]
    G --> H["Demande d'ajustement de la<br/>configuration de guardrail<br/>par le propriétaire, tracée"]
Commandes
// Côté application : appels au modèle en 400, dans le temps
AppDependencies
| where TimeGenerated > ago(24h) and Target has "openai.azure.com" and ResultCode == "400"
| summarize nb = count() by bin(TimeGenerated, 1h), Name
# Métriques de sécurité de contenu de la ressource (volume bloqué)
az monitor metrics list-definitions --resource <id-ressource-openai> --query "[].name.value" -o tsv | grep -i -E "block|harm|safety"
Dans Langfuse ou dans les logs applicatifs, lire le corps de l'erreur : error.code = "content_filter" et
content_filter_results (catégorie filtered: true, severity).
Causes typiques
| Cause | Indice | Correctif |
|---|---|---|
| Vocabulaire métier proche d'une catégorie (médical, sécurité, RH) | Questions légitimes bloquées dans une même catégorie | Ajuster la configuration de guardrail (seuil de sévérité par catégorie), par son propriétaire, avec trace de la décision |
| Document indexé qui déclenche le filtre | Blocage seulement quand certains chunks sont injectés | Identifier le chunk (trace), traiter le document à la source |
| Détection de jailbreak (Prompt Shields) | Catégorie jailbreak dans les résultats | Vérifier s'il s'agit d'une vraie attaque ; ne pas relâcher sans analyse sécurité |
| Protected material | Sortie filtrée sur du code ou du texte protégé | Comportement attendu |
| L'application masque l'erreur | Message générique sans détail | Journaliser content_filter_results (sans données sensibles) et afficher un message explicite |
Confirmer la résolution : les questions de référence du métier passent, les tests de contenu interdit restent bloqués.
Prévention : jeu de tests de sécurité (questions légitimes et attaques) rejoué à chaque changement, suivi du volume bloqué, ajustements de guardrail documentés.
3. Pièges du support IA#
| Situation | Réflexe | Pourquoi |
|---|---|---|
| « Le pod est Running, donc c'est réglé » | Vérifier le taux d'échec et une vraie question | Running ≠ Ready ≠ fonctionnel ; une dépendance peut échouer |
| Redémarrer pour voir | D'abord capturer : describe, logs --previous, operation_Id |
Un redémarrage efface les preuves |
| Modifier un objet à la main dans le cluster | Passer par Git | Argo CD l'écrasera ou, sans self-heal, laissera un écart invisible |
| 429 : « on demande du quota » | Lire le message : quota ou capacité | Une hausse de quota ne règle pas un 429 de capacité |
| Latence en hausse : « le modèle est lent » | Comparer les tokens avant et après | Plus de tokens = plus de temps, ce n'est pas une panne |
| Réponse fausse : « on change le prompt » | Trouver l'étage : ingestion, recherche ou génération | Le prompt ne corrige pas un document absent de l'index |
| Score RRF de 0,03 : « la recherche ne marche pas » | Normal en hybride | Les scores RRF sont petits par construction |
| Nouvelle image poussée avec le même tag | Tag unique ou digest | Pas de nouveau ReplicaSet, nodes qui gardent l'ancienne image |
| Rollback Argo CD refusé | Commit de retour dans Git | Pas de rollback sur une application en auto-sync |
| Grafana vide pendant l'incident | Interroger la source directement (Metrics explorer, Logs) | La supervision peut être en panne indépendamment |
| Commande sur le mauvais cluster | az account show, kubectl config current-context avant tout |
Un client a souvent un cluster par projet et par environnement |
4. Fiche à retenir#
- Méthode : qualifier → ce qui a changé → saut par saut →
operation_Id→ une hypothèse à la fois → contournement → vérification → post-mortem. - Lire avant d'agir ; toute action annoncée (environnement, commande, impact, retour arrière) et validée.
-
kubectl describe(Events),logs --previous,get events --sort-by=.lastTimestamp,rollout status. - Rollout seulement si
.spec.templatechange ;ProgressDeadlineExceededaprès 600 s par défaut. - Argo CD : détection ≤ 3 min, pas de retry d'un sync échoué sur le même commit, pas de prune ni de self-heal par défaut,
pas de rollback en auto-sync ;
app get --refresh,app diff(0, 1, 2),app history. - Workload ID : label du pod, annotation du SA, federated credential (issuer, subject, audience), Key Vault Secrets User,
DNS
privatelink.vaultcore.azure.net, AADSTS70021. - ACR : 401 = droits (AcrPull ou Repository Reader), 403 = réseau / DNS, timeout = chemin,
az aks check-acr. - Web App : warmup sur
/robots933456.txt, 240 s par défaut,WEBSITES_PORT,WEBSITES_CONTAINER_START_TIME_LIMIT,vnetImagePullEnabled,az webapp log tail. - Azure OpenAI : 4 types de 429,
retry-after-ms,x-ratelimit-*,max_tokenscompte, métriques Requests, Time to Response, tokens. - RAG : ingestion, recherche, génération ;
@search.rerankerScorede 0 à 4 ;k= 50 avec le semantic ranker. - Indexer :
persistentFailure= intervention puis reset ;maxFailedItems; 50 exécutions d'historique. - Document Intelligence : 500 MB, 2 000 pages, 15 TPS par défaut, GET au plus toutes les 2 s.
- Grafana : Monitoring Reader (Azure Monitor), Monitoring Data Reader (Prometheus), pods
ama-metrics. - Content filter : 400
content_filter(prompt) oufinish_reason(sortie), facturés tous les deux.
Références#
Relevé du 23/10/2026.
- Microsoft Learn, AppRequests, AppDependencies, AppExceptions, AppTraces (tables) : https://learn.microsoft.com/azure/azure-monitor/reference/tables/apprequests · https://learn.microsoft.com/azure/azure-monitor/reference/tables/appdependencies · https://learn.microsoft.com/azure/azure-monitor/reference/tables/appexceptions
- Application Insights telemetry data model : https://learn.microsoft.com/azure/azure-monitor/app/data-model-complete
- Telemetry correlation, operation_Id, W3C Trace Context : https://learn.microsoft.com/azure/azure-monitor/app/javascript-sdk-configuration
- KubeEvents, KubePodInventory, requêtes Container insights : https://learn.microsoft.com/azure/azure-monitor/reference/tables/kubeevents · https://learn.microsoft.com/azure/azure-monitor/reference/queries/kubepodinventory · https://learn.microsoft.com/azure/azure-monitor/containers/container-insights-log-query
- App Service : monitoring data reference et tables : https://learn.microsoft.com/azure/app-service/monitor-app-service-reference · https://learn.microsoft.com/azure/azure-monitor/reference/tables/appservicehttplogs · https://learn.microsoft.com/azure/azure-monitor/reference/tables/appserviceplatformlogs
- Configure a custom container (port, health ping, managed identity pull, vnetImagePullEnabled, logs) : https://learn.microsoft.com/azure/app-service/configure-custom-container
- App Service on Linux FAQ (warmup, WEBSITES_CONTAINER_START_TIME_LIMIT) : https://learn.microsoft.com/troubleshoot/azure/app-service/faqs-app-service-linux-new
- Troubleshoot virtual network integration with App Service : https://learn.microsoft.com/troubleshoot/azure/app-service/troubleshoot-vnet-integration-apps
- Azure Private Endpoint private DNS zone values : https://learn.microsoft.com/azure/private-link/private-endpoint-dns
- Azure OpenAI quota et 429 : https://learn.microsoft.com/azure/foundry/openai/how-to/quota · https://learn.microsoft.com/microsoft-cloud/dev/dev-proxy/concepts/azure-openai-429-token-rate-limit
- Azure OpenAI monitoring data reference : https://learn.microsoft.com/azure/foundry/openai/monitor-openai-reference
- Performance and latency : https://learn.microsoft.com/azure/foundry/openai/how-to/latency
- Monitor Azure OpenAI (KQL) : https://learn.microsoft.com/azure/ai-foundry/openai/how-to/monitor-openai
- Troubleshoot common HTTP errors for Azure OpenAI : https://learn.microsoft.com/azure/foundry/openai/how-to/troubleshoot-errors
- Content filtering et streaming : https://learn.microsoft.com/azure/ai-foundry/openai/concepts/content-filter · https://learn.microsoft.com/azure/foundry/openai/concepts/content-streaming
- Prompt caching : https://learn.microsoft.com/azure/foundry/openai/how-to/prompt-caching
- Deployment types (Global Batch) : https://learn.microsoft.com/azure/foundry/foundry-models/concepts/deployment-types
- Azure AI Search : Get Indexer Status : https://learn.microsoft.com/rest/api/searchservice/get-indexer-status · Monitor indexers : https://learn.microsoft.com/azure/search/search-monitor-indexers · Indexer errors and warnings : https://learn.microsoft.com/azure/search/cognitive-search-common-errors-warnings · Indexer troubleshooting : https://learn.microsoft.com/azure/search/search-indexer-troubleshooting
- Azure AI Search : hybrid query, semantic ranking, RRF, roles, query logs : https://learn.microsoft.com/azure/search/hybrid-search-how-to-query · https://learn.microsoft.com/azure/search/semantic-search-overview · https://learn.microsoft.com/azure/search/hybrid-search-ranking · https://learn.microsoft.com/azure/search/search-security-rbac · https://learn.microsoft.com/azure/search/search-monitor-queries · https://learn.microsoft.com/azure/search/monitor-azure-cognitive-search-data-reference
- Chunking : https://learn.microsoft.com/azure/search/vector-search-how-to-chunk-documents · https://learn.microsoft.com/azure/search/cognitive-search-skill-textsplit
- Exemple de requêtes IndexerErrorsWarningLogs (Microsoft Discovery) : https://learn.microsoft.com/azure/microsoft-discovery/how-to-query-bookshelf-indexing-logs
- Document Intelligence : limites d'entrée, erreurs, quotas : https://learn.microsoft.com/azure/ai-services/document-intelligence/prebuilt/read · https://learn.microsoft.com/azure/ai-services/document-intelligence/how-to-guides/resolve-errors · https://learn.microsoft.com/azure/ai-services/document-intelligence/service-limits
- Workload ID sur AKS : https://learn.microsoft.com/azure/aks/workload-identity-overview · https://learn.microsoft.com/azure/aks/workload-identity-deploy-cluster
- Troubleshoot Azure Key Vault Secrets Provider add-on : https://learn.microsoft.com/troubleshoot/azure/azure-kubernetes/extensions/troubleshoot-key-vault-csi-secrets-store-csi-driver
- CSI driver et identités : https://learn.microsoft.com/azure/aks/csi-secrets-store-identity-access
- Troubleshoot AKS image pull errors from ACR : https://learn.microsoft.com/troubleshoot/azure/azure-kubernetes/connectivity/cannot-pull-image-from-acr-to-aks-cluster
- Troubleshoot pods Pending : https://learn.microsoft.com/troubleshoot/azure/azure-kubernetes/create-upgrade-delete/troubleshoot-pods-remain-pending-state-scenario
- Application routing : DNS, TLS, retrait Ingress NGINX : https://learn.microsoft.com/azure/aks/app-routing-dns-ssl · https://learn.microsoft.com/troubleshoot/azure/azure-kubernetes/extensions/application-routing-gateway-api-dns-tls
- Azure Managed Grafana : permissions, Azure Monitor workspace, dépannage : https://learn.microsoft.com/azure/managed-grafana/how-to-permissions · https://learn.microsoft.com/azure/managed-grafana/how-to-connect-azure-monitor-workspace · https://learn.microsoft.com/azure/managed-grafana/troubleshoot-managed-grafana
- Troubleshoot Prometheus metrics collection : https://learn.microsoft.com/azure/azure-monitor/containers/prometheus-metrics-troubleshoot
- Azure Resource Graph, resource changes : https://learn.microsoft.com/azure/governance/resource-graph/changes/get-resource-changes
- az monitor metrics list : https://learn.microsoft.com/cli/azure/monitor/metrics
- Kubernetes, Deployments : https://kubernetes.io/docs/concepts/workloads/controllers/deployment/ · Images : https://kubernetes.io/docs/concepts/containers/images/
- Argo CD : auto sync https://argo-cd.readthedocs.io/en/stable/user-guide/auto_sync/ ·
health https://argo-cd.readthedocs.io/en/stable/operator-manual/health/ ·
argocd app get,diff,rollback: https://argo-cd.readthedocs.io/en/stable/user-guide/commands/argocd_app_get/ · https://argo-cd.readthedocs.io/en/stable/user-guide/commands/argocd_app_diff/ · https://argo-cd.readthedocs.io/en/stable/user-guide/commands/argocd_app_rollback/ - cert-manager troubleshooting : https://cert-manager.io/docs/troubleshooting/
- Langfuse : data model https://langfuse.com/docs/observability/data-model · token and cost tracking https://langfuse.com/docs/observability/features/token-and-cost-tracking