

Version : 1.1 · Date : 2026-10-22 · Domaine 2 : Applications and Integration (33,1 %)
En une phrase : tout passe par
POST /v1/messages, une API sans état dont on lit d'abord lestop_reason; le streaming, la vision, le thinking, le caching et les outils sont des options de cette même requête ; on choisit le temps réel quand quelqu'un attend et Message Batches quand le coût domine ; on réessaie les 429 / 5xx / 529 avec backoff, jamais les 4xx ; et l'application se conçoit à partir des exigences métier, puis s'exploite sur tout son cycle de vie, migration de modèle comprise.
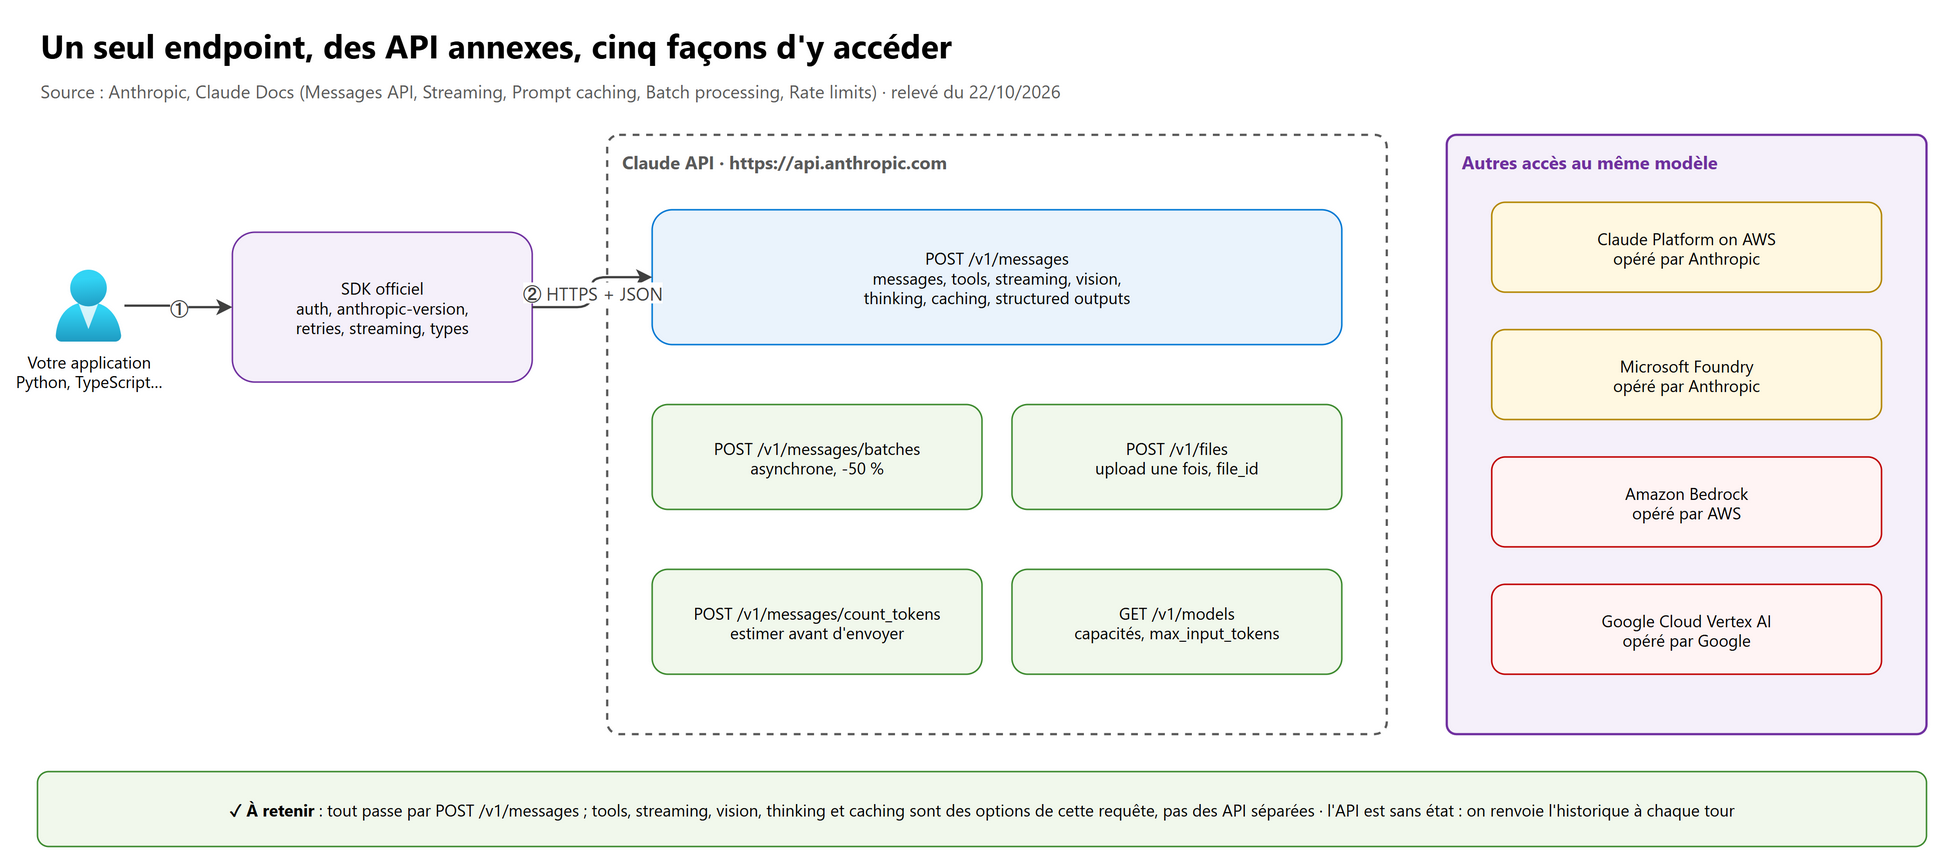
Ce chapitre couvre trois skills du domaine 2, soit 13 % de l'examen. Les trois autres skills du domaine (Software Engineering Foundations, Claude Application Design, Configuration Management) sont dans 03-ingenierie-et-conception.md. Le coût détaillé (prix, caching chiffré, choix du modèle, effort) est dans 04-modeles-et-couts.md ; les structured outputs et le détail du traitement par lot déjà vus pour l'Architecte sont dans ../CLAUDE-ARCHITECTE/04-prompt-structured-output.md.
Ce que l'examen demande#
Texte officiel du guide Claude Certified Developer – Foundations Exam Guide v1.0 (juillet 2026) :
| # | Skill (guide officiel, en anglais) | Poids | Section |
|---|---|---|---|
| 2.1 | Understanding Requirements : Functional and infrastructure requirements based on business requirements and solution architecture. | 3,4 % | 1 |
| 2.2 | Systems Life Cycle : Systems life cycle management concepts and frameworks used to develop, implement, operate, and maintain IT systems. | 2,8 % | 2 |
| 2.3 | Claude API Mechanics : Claude API behavior and mechanics, including messages, tools, streaming, vision, thinking, caching, invoking Claude through third-party vendors, Messages API data access patterns, batch API use, and tradeoffs between realtime and batch API selection. | 6,8 % | 3 à 12 |
Convention du cours : le produit a évolué depuis le guide v1.0 (juillet 2026), et une nouvelle version d'API est sortie le 21/10/2026. Quand c'est le cas, un encadré donne d'abord la réponse d'examen (celle de l'époque du guide, à cocher le jour J), puis l'état actuel du produit (à connaître pour le travail réel).
0. Les bases à maîtriser avant tout#
0.1 Les endpoints#
| Endpoint | Rôle | Section |
|---|---|---|
POST /v1/messages |
Le point d'entrée : conversation, outils, streaming, vision, thinking, caching, structured outputs | 3 |
POST /v1/messages/count_tokens |
Compter les tokens d'entrée d'une requête avant de l'envoyer (gratuit, mais soumis à un RPM) | 3.6 |
POST /v1/messages/batches |
Envoyer jusqu'à 100 000 requêtes en asynchrone, -50 % | 8 |
POST /v1/files |
Déposer un fichier une fois, le réutiliser par file_id |
5.3 |
GET /v1/models |
Lister les modèles et leurs capacités (max_input_tokens, max_tokens, capabilities) |
12 |
Base URL : https://api.anthropic.com. Trois en-têtes à chaque appel HTTP :
| En-tête | Valeur | Remarque |
|---|---|---|
x-api-key ou Authorization: Bearer … |
La clé API (ou un jeton de workload identity federation) | Toujours depuis ANTHROPIC_API_KEY ou un coffre, jamais dans le code |
anthropic-version |
2023-06-01 ou 2026-10-21 |
Obligatoire ; voir 12 |
content-type |
application/json |
|
anthropic-beta (optionnel) |
Nom d'une fonction en beta, ex. compact-2026-09-04 |
Plusieurs valeurs séparées par des virgules |
anthropic-workspace-id (cas particulier) |
ID du workspace | Seulement si la clé n'est pas rattachée à un workspace |
Le SDK officiel (anthropic en Python, @anthropic-ai/sdk en TypeScript, et Java, Go, Ruby, C#, PHP) pose ces en-têtes
lui-même, gère les retries, le streaming et les types. Il est la bonne réponse par défaut ; l'appel HTTP brut sert à
comprendre et à déboguer.
# Appel brut : utile pour voir exactement ce que le SDK envoie
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{"model": "claude-haiku-5-5", "max_tokens": 256,
       "messages": [{"role": "user", "content": "Bonjour"}]}'
0.2 Le vocabulaire#
| Terme | Signification |
|---|---|
| Token | Unité de texte facturée et limitée ; entrée et sortie se comptent séparément |
max_tokens |
Plafond de tokens générés pour cette réponse (obligatoire) ; ne réserve rien, ne coûte rien s'il n'est pas atteint |
| Content block | Un morceau typé de message : text, image, document, tool_use, tool_result, thinking… |
stop_reason |
Pourquoi la génération s'est arrêtée ; à lire avant le contenu |
| Stateless | L'API ne garde rien d'un appel à l'autre : l'historique est renvoyé à chaque tour |
| SSE | Server-sent events : le format du streaming, une suite d'événements nommés |
| Breakpoint | Point où l'on pose cache_control : tout le préfixe jusque-là est mis en cache |
| RPM / ITPM / OTPM | Rate limits : requêtes, tokens d'entrée et tokens de sortie par minute, par classe de modèle |
1. Understanding Requirements#
1.1 Trois couches, une seule direction#
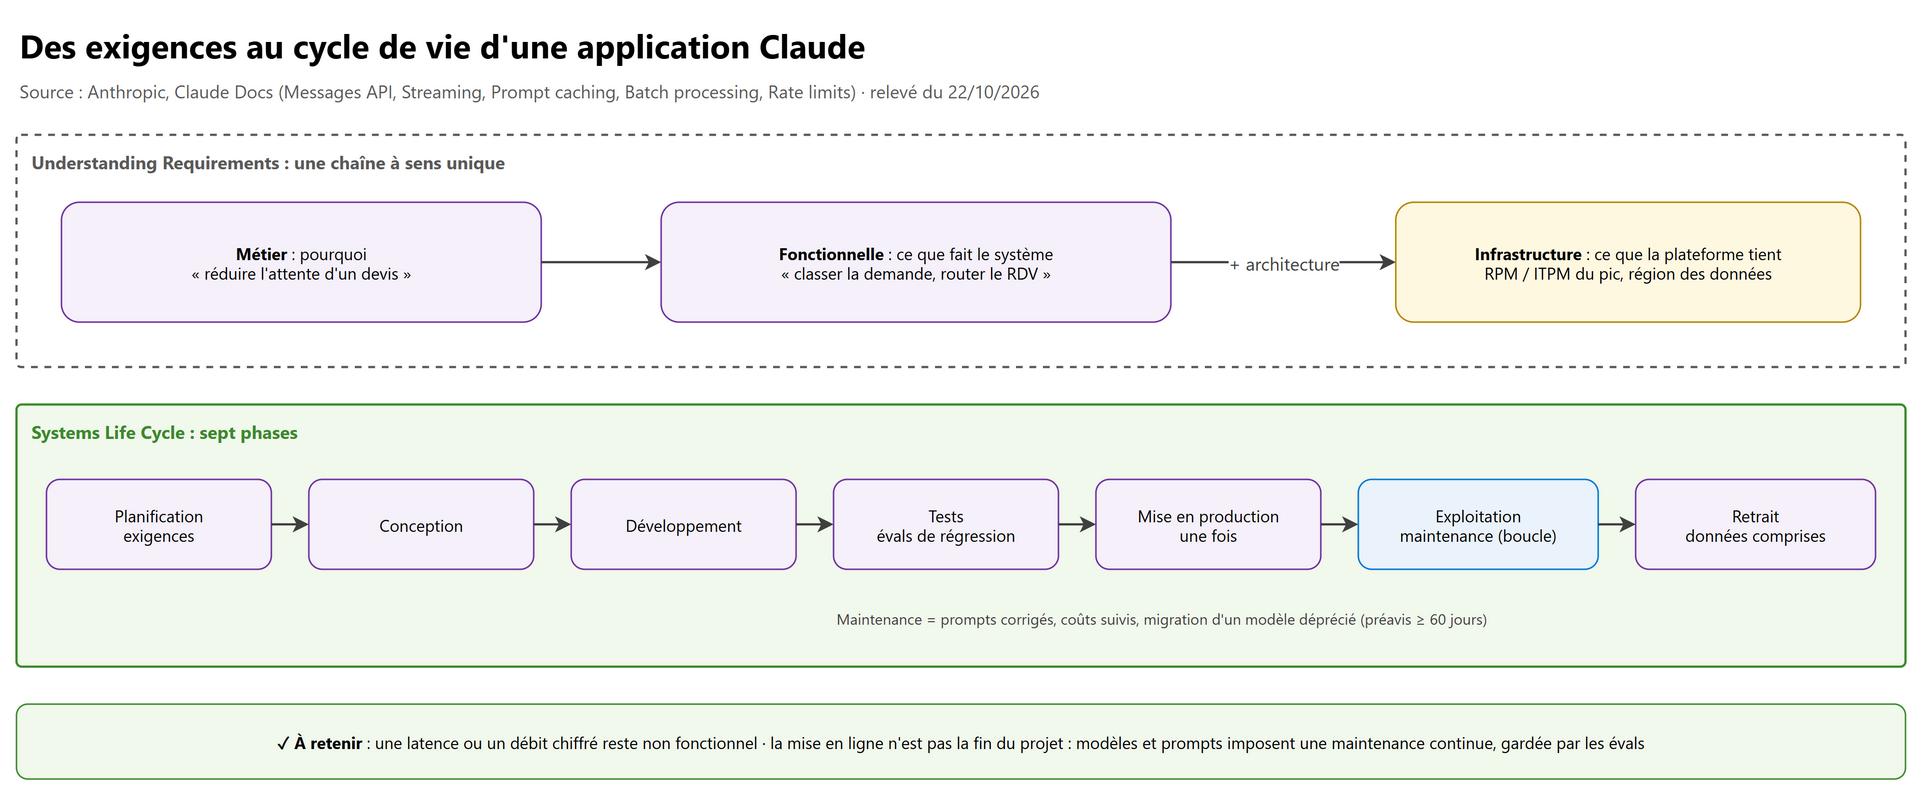
| Couche | Question | Exemple (agence immobilière qui reçoit des demandes de devis) |
|---|---|---|
| Business requirement | Pourquoi ? Quel résultat pour l'entreprise ? | « Répondre à une demande de devis en moins d'une heure au lieu d'un jour » |
| Functional requirement | Que doit faire le système ? | « Classer chaque e-mail entrant (devis, réclamation, autre), extraire l'adresse et le budget, proposer un créneau » |
| Infrastructure requirement | Que doit tenir la plateforme ? | « 2 000 e-mails au pic du lundi matin, données hébergées dans l'UE, coût mensuel plafonné » |
La dérivation va toujours du métier vers le fonctionnel, puis vers l'infrastructure, à travers l'architecture de la solution : une même exigence fonctionnelle ne donne pas la même exigence d'infrastructure selon qu'on choisit un appel unique, un workflow ou un agent (voir 01-agents-workflows.md). Une question d'examen qui part de l'infrastructure (« on a 4 000 RPM, que peut-on construire ? ») pour fixer le besoin prend le problème à l'envers.
1.2 Ce qui est fonctionnel et ce qui ne l'est pas#
Piège classique : une exigence chiffrée n'est pas fonctionnelle pour autant.
| Exigence | Type | Pourquoi |
|---|---|---|
| « Extraire le montant TTC d'une facture » | Fonctionnelle | Décrit un comportement |
| « Réponse en moins de 2 s pour le premier mot » | Non fonctionnelle (latence) | Qualité de service → streaming, modèle plus rapide |
| « 50 000 documents par nuit » | Non fonctionnelle (débit) | → Message Batches, rate limits, tier |
| « Les données restent dans l'UE » | Non fonctionnelle (résidence) | → choix de plateforme et de région, inference_geo sur l'API |
| « Moins de 3 000 € par mois » | Non fonctionnelle (coût) | → modèle, caching, batch (04) |
1.3 Traduire en paramètres Claude#
Les contraintes de la plateforme sont des entrées des exigences d'infrastructure, pas des détails d'implémentation :
| Exigence | Contrainte Claude à vérifier | Section |
|---|---|---|
| Volume au pic | RPM, ITPM, OTPM du tier pour le modèle choisi | 9.3 |
| Gros documents | Fenêtre de contexte (max_input_tokens via GET /v1/models), 32 Mo par requête, 600 pages de PDF |
5 |
| Réponse longue | max_tokens du modèle, streaming obligatoire au-delà d'un certain volume |
4 |
| Échéance « demain matin » | Batch : la plupart < 1 h, garanti < 24 h | 8 |
| Cloud imposé (AWS, GCP, Azure) | Fonctions disponibles sur Bedrock, Vertex AI, Foundry | 11 |
| Résidence des données | Plateforme et région ; inference_geo seulement sur l'API Anthropic et Claude Platform on AWS |
11 |
Méthode d'estimation du débit : requêtes au pic par minute × tokens d'entrée moyens doit tenir sous l'ITPM (les lectures de cache n'y comptent pas pour la plupart des modèles, § 7), × tokens de sortie moyens sous l'OTPM. Si ça ne tient pas : caching, batch, tier supérieur, ou lissage par file d'attente.
2. Systems Life Cycle#
2.1 Les sept phases#
Le guide parle de « concepts et frameworks » de cycle de vie des systèmes (SDLC classique, ITIL pour l'exploitation). Retenez les sept phases et ce qu'elles deviennent pour une application Claude :
| Phase | Pour une application Claude | Livrable typique |
|---|---|---|
| 1. Planning / requirements | Exigences des trois couches (§ 1), critères de succès mesurables | Cahier des exigences, critères d'éval |
| 2. Design | Appel unique, workflow ou agent ; modèle ; schémas de sortie ; outils | Architecture, contrats d'outils |
| 3. Development | Prompts versionnés, code SDK, outils, MCP | Code + prompts dans le dépôt |
| 4. Testing | Suite d'évals de régression sur un jeu figé, tests de charge (429) | Rapport d'éval, seuils |
| 5. Implementation / release | Bascule (cutover), une seule fois, avec retour arrière prévu | Plan de bascule |
| 6. Operations & maintenance | Suivi des coûts et des erreurs, correction des prompts, migration d'un modèle déprécié | Tableaux de bord, journal des changements |
| 7. Retirement | Arrêt de l'application et traitement des données (journaux, fichiers déposés, batches) | Plan de retrait |
2.2 Ce qui change avec un LLM#
- La maintenance ne s'arrête jamais : un modèle passe de Active à Legacy, Deprecated puis Retired (§ 12.3). Anthropic prévient au moins 60 jours avant le retrait d'un modèle public. Le plan de migration est un livrable d'exploitation, pas un projet exceptionnel.
- Les évals gardent la porte : tout changement de prompt, de modèle ou de paramètre repasse la suite de régression avant la
mise en production. Un changement de comportement entre versions de modèle (ex.
budget_tokensrefusé,temperaturerefusé) est une régression à détecter en test, pas en production. - Le modèle est figé par son ID (
claude-sonnet-5-5), pas par un alias « latest » en production : le pinning de version est traité dans 03-ingenierie-et-conception.md. - Les plateformes ont leurs propres dates : sur Bedrock et Google Cloud, la date de retrait d'un modèle est fixée par le partenaire, pas par Anthropic.
flowchart LR
    A["Planning<br/>exigences"] --> B["Design"] --> C["Development"] --> D["Testing<br/>évals de régression"]
    D --> E["Release<br/>cutover unique"] --> F["Operations & maintenance"]
    F -- "prompt corrigé<br/>modèle déprécié" --> D
    F --> G["Retirement<br/>données comprises"]
3. La Messages API#
3.1 La requête#
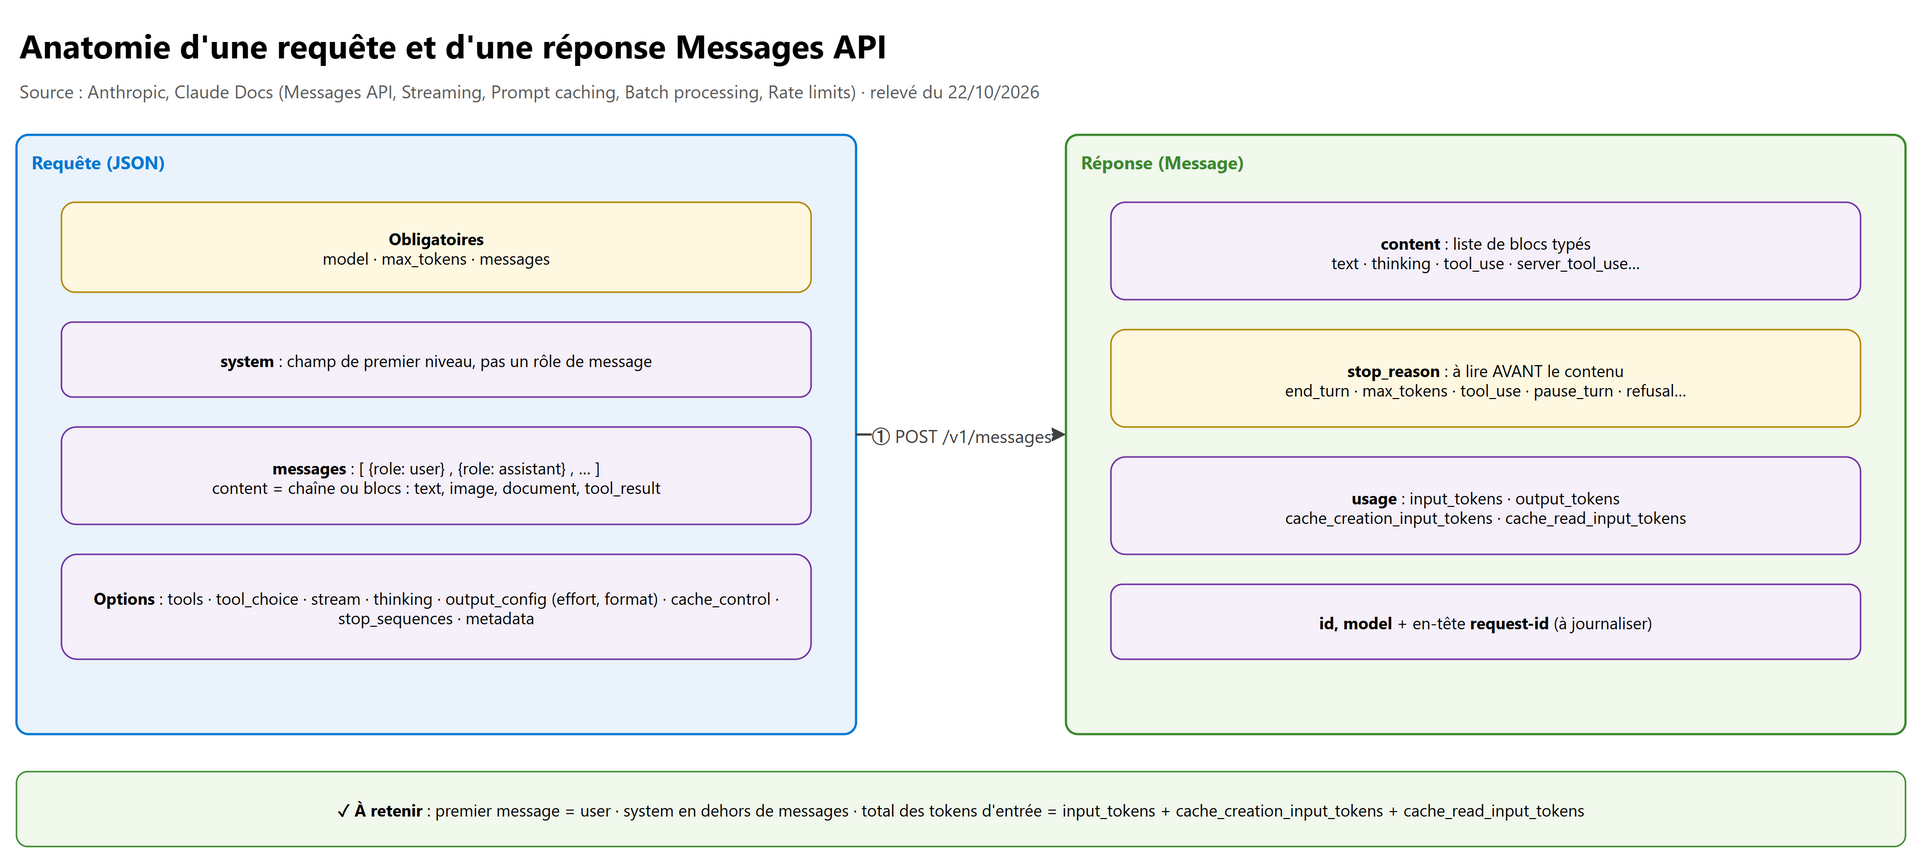
| Champ | Obligatoire | Ce qu'il faut savoir |
|---|---|---|
model |
Oui | ID exact, ex. claude-opus-5-5, claude-sonnet-5-5, claude-haiku-5-5 |
max_tokens |
Oui | Plafond de sortie ; atteint → stop_reason: "max_tokens" |
messages |
Oui | Liste de {role, content} ; role = user ou assistant |
system |
Non | Champ de premier niveau, pas un rôle dans messages ; chaîne ou blocs (pour y poser cache_control) |
tools, tool_choice |
Non | Outils client et serveur (§ 3.4) |
stream |
Non | true → réponse en SSE (§ 4) |
thinking, output_config |
Non | Thinking, effort, format (structured outputs) (§ 6) |
cache_control |
Non | Sur un bloc (breakpoint) ou au premier niveau (caching automatique) (§ 7) |
stop_sequences, metadata |
Non | Chaînes d'arrêt ; metadata.user_id (identifiant opaque, pas de donnée personnelle) |
Règles de messages :
- le premier message est
user; - deux messages consécutifs du même rôle sont fusionnés par l'API ;
contentest une chaîne, ou une liste de blocs (text,image,document,tool_use,tool_result…) ;- sur les modèles récents, un message
role: "system"peut être inséré en cours de conversation (nouvelle consigne en cours de route) ; lesystemde premier niveau reste la place normale des consignes stables.
3.2 La réponse#
| Champ | Contenu |
|---|---|
id, type: "message", role: "assistant", model |
Identité de la réponse |
content |
Liste de blocs : text, thinking, tool_use, server_tool_use, résultats d'outils serveur… |
stop_reason, stop_sequence |
Pourquoi ça s'est arrêté (§ 3.3) |
usage |
input_tokens, output_tokens, cache_creation_input_tokens, cache_read_input_tokens |
Deux détails testables :
input_tokensne compte que les tokens après le dernier breakpoint de cache. Le total d'entrée vautinput_tokens + cache_creation_input_tokens + cache_read_input_tokens.- L'en-tête
request-id(exposé en_request_idsur l'objet du SDK Python) est à journaliser : c'est ce que demande le support.
import anthropic

client = anthropic.Anthropic()  # lit ANTHROPIC_API_KEY

historique = [{"role": "user", "content": "Classe cet e-mail : « Bonjour, combien pour repeindre un T3 ? »"}]
rep = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system="Tu tries les e-mails d'une agence. Catégories : devis, réclamation, autre.",
    messages=historique,
)
if rep.stop_reason != "end_turn":
    print("Réponse incomplète :", rep.stop_reason, rep._request_id)
print(rep.content[0].text, rep.usage)

# Tour suivant : l'API est sans état, on renvoie tout l'historique
historique.append({"role": "assistant", "content": rep.content})
historique.append({"role": "user", "content": "Quel budget est indiqué ?"})
rep2 = client.messages.create(model="claude-sonnet-5-5", max_tokens=1024, messages=historique)
3.3 stop_reason#
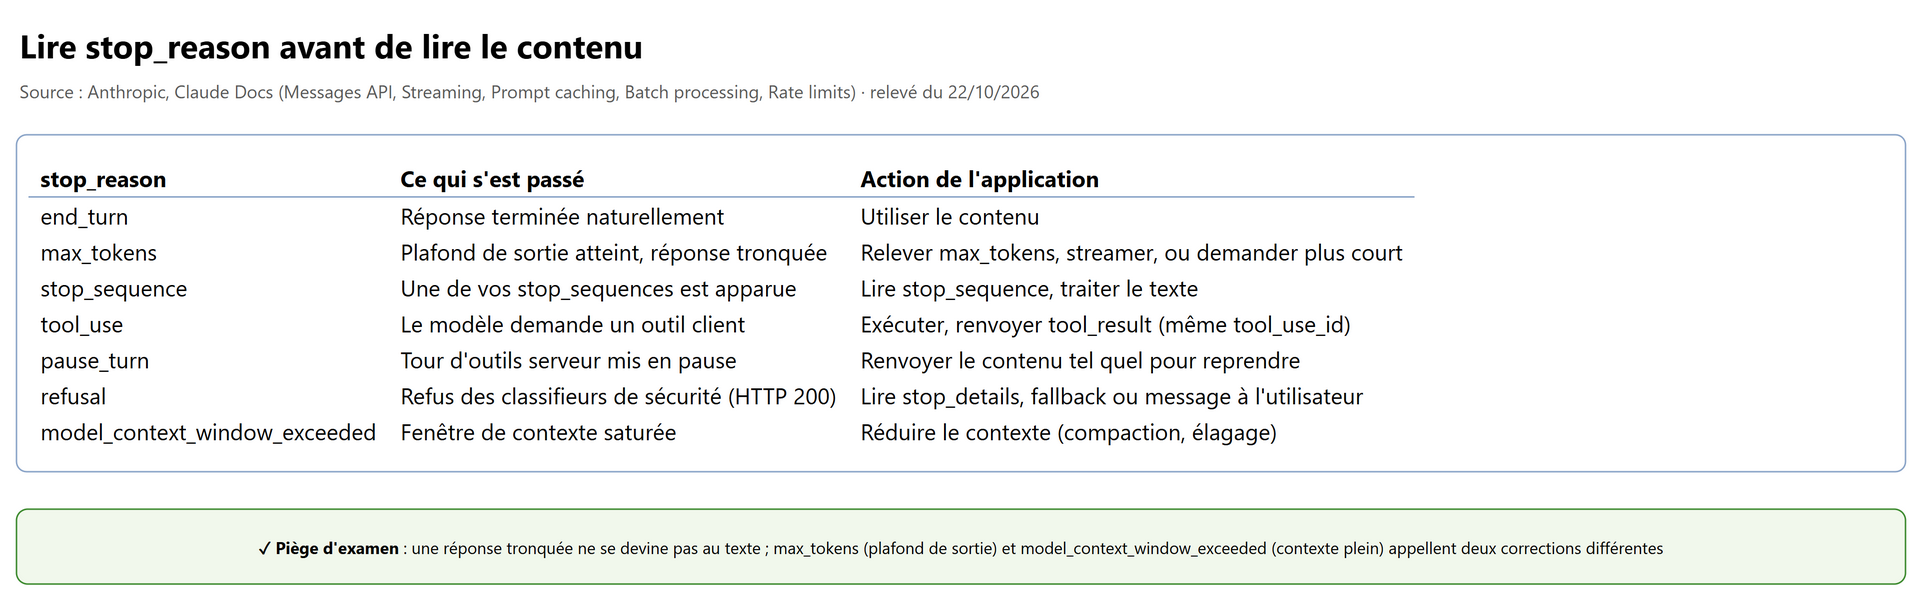
Deux confusions à éviter :
max_tokens(plafond de sortie atteint) n'est pasmodel_context_window_exceeded(contexte plein) : la première se corrige en relevantmax_tokensou en demandant plus court, la seconde en réduisant l'entrée.refusalarrive en HTTP 200 : ce n'est pas une erreur d'API, c'est une réponse à traiter (le détail est dansstop_details).
Réponse d'examen : les valeurs centrales sont
end_turn,max_tokens,stop_sequenceettool_use.État actuel : s'y ajoutent
pause_turn(boucle d'outils serveur mise en pause : renvoyer le contenu tel quel pour reprendre),refusal(avecstop_details) etmodel_context_window_exceeded. En production, tout ce qui n'est pasend_turnveut dire « pas fini, regarder pourquoi ».
3.4 Les outils dans la requête#
Le détail (écrire un outil, MCP, approbations) est dans 07-outils-mcp.md. La mécanique à connaître ici :
| Étape | Qui | Forme |
|---|---|---|
| 1. Déclarer | Vous | tools: [{name, description, input_schema}] |
| 2. Demander | Claude | Bloc tool_use (id, name, input) et stop_reason: "tool_use" |
| 3. Exécuter | Votre code (outil client) ou Anthropic (outil serveur : web search, code execution…) | — |
| 4. Rendre | Vous | Message user avec un bloc tool_result par tool_use, même tool_use_id, is_error: true si échec |
- Client tools : exécutés chez vous, la boucle est à vous. Server tools (ex.
web_search_20260209) : exécutés par Anthropic dans la même requête, blocsserver_tool_usedans la réponse, etpause_turnsi la boucle serveur s'interrompt. tool_choice:auto(défaut),any,tool(un outil nommé),none.
Réponse d'examen : pour forcer un appel d'outil (ex. pour obtenir une sortie structurée),
tool_choice: {"type": "any"}ou{"type": "tool", "name": …}.État actuel : sur Fable 5.1, Mythos 5.1, Opus 5.5 et Sonnet 5.5,
tool_choiceforcé (anyoutool) renvoie une 400. Pour une sortie conforme à un schéma, utiliser les structured outputs (output_config.format, oustrict: truesur l'outil) : voir 05-prompts-contexte-sorties.md.
3.5 Messages API data access patterns#
Le guide ne détaille pas cette expression. Ce cours la comprend comme la façon dont les données entrent dans la requête et en ressortent :
| Motif | Quand | Exemple |
|---|---|---|
| Inline | Petit contenu, usage unique | Texte, image ou PDF en base64 dans content |
| Par URL | Contenu public déjà en ligne | source: {type: "url", url: …} (API Anthropic et Claude Platform on AWS) |
| Par référence | Même fichier réutilisé dans plusieurs requêtes | Files API : source: {type: "file", file_id: …} |
| Historique renvoyé | Conversation | L'application stocke et renvoie l'historique ; l'API ne garde rien |
| Préfixe en cache | Gros contexte stable (manuel, code) | Prompt caching (§ 7) |
| Résultat asynchrone | Traitement de masse | Batch : résultats en JSONL, lus par custom_id, 29 jours |
| Listes paginées | GET /v1/models, batches, fichiers |
Pagination par curseur (limit, after_id / before_id, has_more) ; le SDK pagine seul quand on itère |
| Données récupérées par outil | Données vivantes (base, API métier) | Le modèle demande, votre code lit (outil client ou MCP) |
3.6 Compter avant d'envoyer#
n = client.messages.count_tokens(model="claude-sonnet-5-5", system="…", messages=historique)
print(n.input_tokens)  # estimation, mêmes champs que messages.create (tools, images, PDF compris)
Utile pour refuser une entrée trop grosse avant l'appel, ou décider de résumer l'historique. Le comptage est gratuit mais limité en requêtes par minute.
4. Streaming#
4.1 Pourquoi streamer#
- Le premier texte arrive vite : meilleure latence perçue. Le coût et la durée totale ne changent pas.
- Une requête longue sans streaming peut dépasser les délais réseau ; le SDK Python refuse une requête non streamée dont il
estime qu'elle sera trop longue (grand
max_tokens) et lève une erreur qui conseille de streamer. - Règle pratique : streamer dès que l'entrée ou la sortie est longue, et utiliser
get_final_message()/finalMessage()si l'on ne veut que le message complet.
4.2 Les événements#
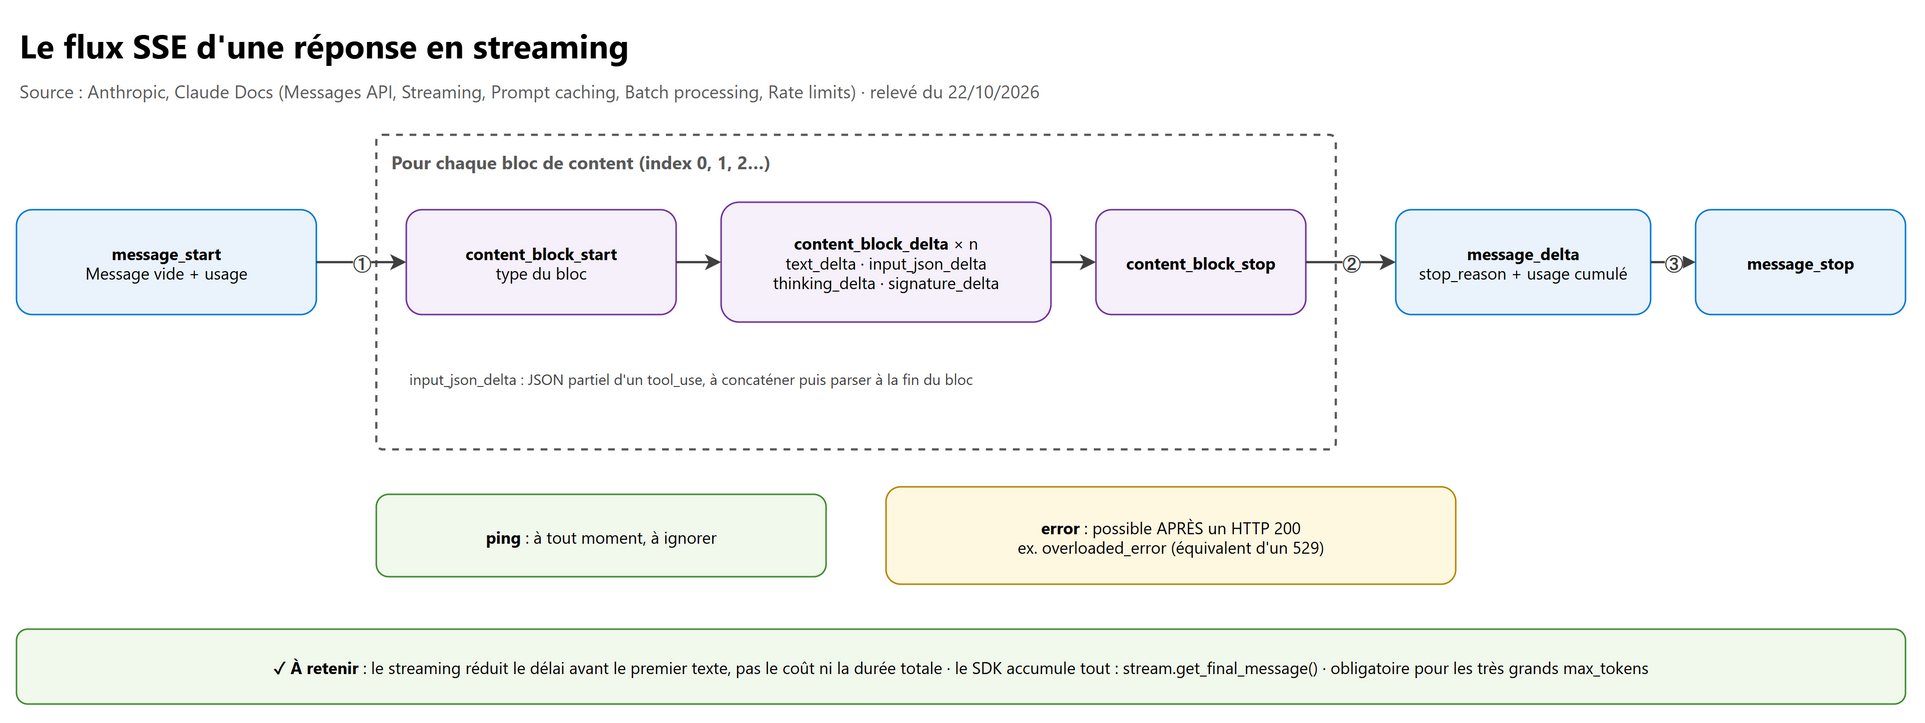
sequenceDiagram
    participant App
    participant API as Claude API
    App->>API: POST /v1/messages (stream: true)
    API-->>App: message_start (message vide, usage)
    loop pour chaque bloc de content
        API-->>App: content_block_start (index, type)
        API-->>App: content_block_delta × n
        API-->>App: content_block_stop
    end
    API-->>App: message_delta (stop_reason, usage cumulé)
    API-->>App: message_stop
    Note over App,API: ping à tout moment, error possible après un HTTP 200
| Delta | Bloc | À faire |
|---|---|---|
text_delta |
text |
Afficher au fil de l'eau |
input_json_delta |
tool_use |
Concaténer les morceaux de JSON partiel, parser à content_block_stop |
thinking_delta, signature_delta |
thinking |
Garder le bloc et sa signature pour le renvoyer tel quel |
citations_delta |
text avec citations |
Associer la citation au texte |
Points testés :
message_deltaporte lestop_reasonet l'usage cumulé ;message_startne connaît pas encore la sortie.- Un événement
error(ex.overloaded_error) peut arriver après un HTTP 200 : le code de statut ne suffit pas. - La politique de versions autorise Anthropic à ajouter de nouveaux types d'événements : le client doit ignorer ce qu'il ne connaît pas, pas planter.
4.3 Le SDK#
with client.messages.stream(
    model="claude-sonnet-5-5",
    max_tokens=8000,
    messages=[{"role": "user", "content": "Rédige la fiche de visite du T3, rue des Lilas."}],
) as stream:
    for texte in stream.text_stream:
        print(texte, end="", flush=True)
    final = stream.get_final_message()  # Message complet : stop_reason, usage, tous les blocs
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic(); // lit ANTHROPIC_API_KEY
const stream = client.messages
  .stream({ model: "claude-sonnet-5-5", max_tokens: 8000, messages: [{ role: "user", content: "Rédige la fiche…" }] })
  .on("text", (t) => process.stdout.write(t));
const final = await stream.finalMessage();
4.4 Reprendre un flux coupé#
| Modèles | Reprise |
|---|---|
| Claude 4.5 et antérieurs | Renvoyer la réponse partielle comme message assistant (prefill) et laisser le modèle continuer |
| Claude 4.6 et suivants (le prefill y est refusé) | Ajouter un message user : « Your previous response was interrupted and ended with [...]. Continue from where you left off. » |
Un bloc tool_use ou thinking partiel ne se récupère pas : il faut relancer ce tour.
5. Vision, documents et Files API#
5.1 Images#
import base64
from pathlib import Path

data = base64.standard_b64encode(Path("facture.png").read_bytes()).decode()
rep = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": [
        {"type": "image", "source": {"type": "base64", "media_type": "image/png", "data": data}},
        {"type": "text", "text": "Donne le montant TTC et la date d'émission."},  # l'image avant la question
    ]}],
)
| Règle | Valeur |
|---|---|
| Sources | base64, url, file (Files API) ; Bedrock et Google Cloud : base64 seulement |
| Formats | JPEG, PNG, GIF, WebP |
| Taille | 8 000 × 8 000 px max ; plus de 20 images dans une requête → 2 000 px max chacune |
| Poids | 10 Mo par image sur l'API (5 Mo sur Bedrock et Vertex AI) ; 32 Mo par requête |
| Nombre | 100 images par requête pour les modèles à 200k tokens de contexte, 600 pour les autres |
| Coût | ≈ ⌈largeur/28⌉ × ⌈hauteur/28⌉ tokens ; au-delà, l'image est réduite (bord long 1 568 px en standard, 2 576 px en haute résolution sur Claude 4.7 et suivants) |
| Placement | L'image avant le texte qui la concerne donne de meilleurs résultats |
Limites à connaître : Claude n'identifie pas les personnes par leur visage, compte de façon approximative les objets nombreux, ne sait pas dire si une image a été générée par IA. Une question d'examen qui suppose l'un des trois attend « ce n'est pas fiable ».
5.2 PDF#
Bloc document (source base64, url ou file) : 32 Mo par requête, 600 pages (100 pour les modèles à 200k tokens).
Chaque page est lue comme texte et comme image : graphiques et tableaux compris, mais le coût augmente avec le nombre de
pages. Les citations (citations: {enabled: true}) relient la réponse aux passages du document ; elles sont incompatibles
avec output_config.format.
5.3 Files API#
from pathlib import Path

f = client.files.upload(file=Path("contrat-bail.pdf"))     # une fois
rep = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": [
        {"type": "document", "source": {"type": "file", "file_id": f.id}},
        {"type": "text", "text": "Liste les clauses de résiliation."},
    ]}],
)
- 500 Mo par fichier ; le fichier est réutilisable dans autant de requêtes qu'on veut ; supprimer ce qui ne sert plus (cycle de vie, § 2).
- Disponible sur l'API Anthropic et Claude Platform on AWS ; en beta sur Microsoft Foundry (déploiements hébergés par Anthropic seulement) ; absent de Bedrock et Vertex AI.
Réponse d'examen : la Files API est présentée comme une beta, avec l'en-tête
anthropic-beta: files-api-2025-04-14.État actuel : elle est GA, sans en-tête beta, dans l'espace de noms
client.filesdu SDK.
6. Thinking et effort#
Le choix du niveau d'effort et son coût sont dans 04-modeles-et-couts.md. La mécanique d'API :
| Paramètre | Valeur | Rôle |
|---|---|---|
thinking: {type: "adaptive"} |
Le modèle décide quand et combien réfléchir | Mode recommandé sur Claude 4.6 et suivants |
output_config: {effort: …} |
low, medium, high, xhigh, max |
Règle l'effort global (réflexion et réponse) |
thinking.display |
"omitted" (défaut sur les modèles récents) ou "summarized" |
Ce que la réponse montre du raisonnement |
thinking: {type: "enabled", budget_tokens: N} |
Ancien mode | Voir l'encadré |
- Les blocs
thinkingsont danscontent; ils se renvoient tels quels (signature comprise) dans l'historique, surtout pendant une boucle d'outils. Les modifier ou les retirer au milieu d'un tour d'outils casse la requête suivante. - Les tokens de réflexion sont facturés comme de la sortie et comptent dans
max_tokens. - Opus 5.5 réfléchit toujours (on ne peut pas désactiver le thinking ; effort par défaut
medium) ; sur Sonnet 5.5, désactiver le thinking renvoie une 400 (utiliser le réglagebetween_toolspour ne réfléchir qu'entre les outils).
Réponse d'examen : extended thinking =
thinking: {type: "enabled", budget_tokens: N}avecbudget_tokens≥ 1 024 et inférieur àmax_tokens.État actuel :
budget_tokensest refusé (400) sur Opus 5.5, Opus 5, Opus 4.8, Opus 4.7, Sonnet 5.5, Sonnet 5, Fable 5 / 5.1 et Haiku 5.5, déprécié sur Opus 4.6 / Sonnet 4.6, et encore requis sur Haiku 4.5 et les modèles antérieurs. Sur les modèles récents :thinking: {type: "adaptive"}+output_config.effort.
7. Prompt caching : la mécanique#
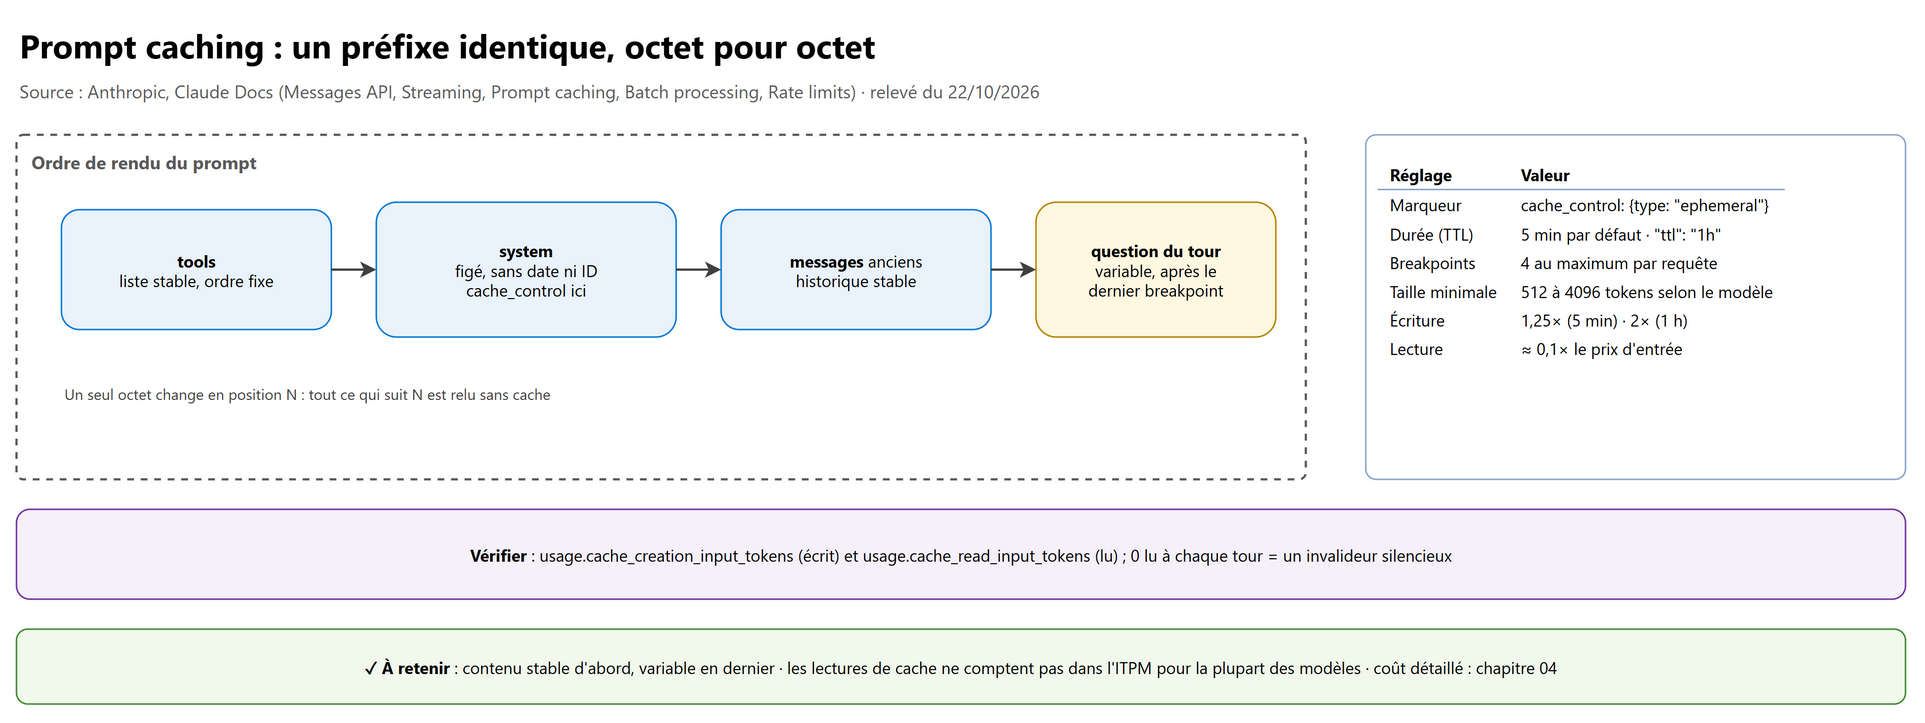
Le chiffrage (prix d'écriture et de lecture par modèle, seuil de rentabilité) est dans 04-modeles-et-couts.md. La mécanique :
- Préfixe exact : le cache est retrouvé si le début du prompt est identique octet pour octet. Ordre de rendu :
tools→system→messages. Un outil ajouté, un horodatage dans lesystem, un JSON aux clés dans un autre ordre : tout ce qui suit est relu sans cache. - Breakpoints :
cache_control: {"type": "ephemeral"}sur un bloc met en cache tout ce qui le précède ; 4 au maximum par requête. Oucache_controlau premier niveau de la requête : caching automatique, l'API place le breakpoint sur le dernier bloc qui peut l'être. - Durée : 5 minutes par défaut, prolongée à chaque lecture ;
"ttl": "1h"pour une heure. - Taille minimale du préfixe : 512 tokens (Opus 5.5 / 5, Fable 5 / 5.1, Sonnet 5.5, Haiku 5.5), 1 024 (Opus 4.8, Sonnet 5, Sonnet 4.6…), 2 048 (Opus 4.7), 4 096 (Opus 4.6 / 4.5, Haiku 4.5). En dessous, pas d'erreur : simplement pas de cache.
- Vérifier dans
usage:cache_creation_input_tokens(écrit) puiscache_read_input_tokens(lu) au tour suivant. Zéro lecture à chaque tour = un invalideur silencieux dans le préfixe. - Rate limits : les lectures de cache ne comptent pas dans l'ITPM pour la plupart des modèles. Le caching augmente donc aussi le débit utile.
rep = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system=[{"type": "text", "text": MANUEL_AGENCE,           # 30 000 tokens stables
             "cache_control": {"type": "ephemeral"}}],         # breakpoint : tout ce qui précède est mis en cache
    messages=[{"role": "user", "content": question_du_jour}],  # variable, après le breakpoint
)
print(rep.usage.cache_creation_input_tokens, rep.usage.cache_read_input_tokens)
8. Message Batches et choix temps réel ou batch#
8.1 Le fonctionnement#
| Point | Valeur |
|---|---|
| Remise | -50 % sur l'entrée et la sortie (cumulable avec le prompt caching) |
| Taille d'un lot | 100 000 requêtes ou 256 Mo |
| Délai | La plupart en moins d'une heure, au plus 24 h ; au-delà, la requête est expired (non facturée) |
| Résultats | Disponibles 29 jours, dans n'importe quel ordre : toujours relier par custom_id |
| Types de résultat | succeeded, errored, canceled, expired |
| Une requête du lot | = un appel Messages API : pas de boucle d'outils client à l'intérieur (il faudrait un nouveau lot) |
| Disponibilité | API Anthropic et Claude Platform on AWS ; pas sur Bedrock, Vertex AI ni Foundry |
| Rate limits | Propres au batch (requêtes en file, requêtes par lot), séparées de celles de la Messages API |
lot = client.messages.batches.create(requests=[
    {"custom_id": f"annonce-{a.id}",
     "params": {"model": "claude-haiku-5-5", "max_tokens": 512,
                "messages": [{"role": "user", "content": f"Réécris cette annonce : {a.texte}"}]}}
    for a in annonces
])
# … plus tard (un job planifié, pas une boucle serrée)
if client.messages.batches.retrieve(lot.id).processing_status == "ended":
    for r in client.messages.batches.results(lot.id):
        if r.result.type == "succeeded":
            enregistrer(r.custom_id, r.result.message.content[0].text)
        else:
            a_relancer.append(r.custom_id)  # errored ou expired : à renvoyer dans un nouveau lot
Le détail (statuts, annulation, cas d'usage) est aussi dans ../CLAUDE-ARCHITECTE/04-prompt-structured-output.md.
8.2 Choisir#
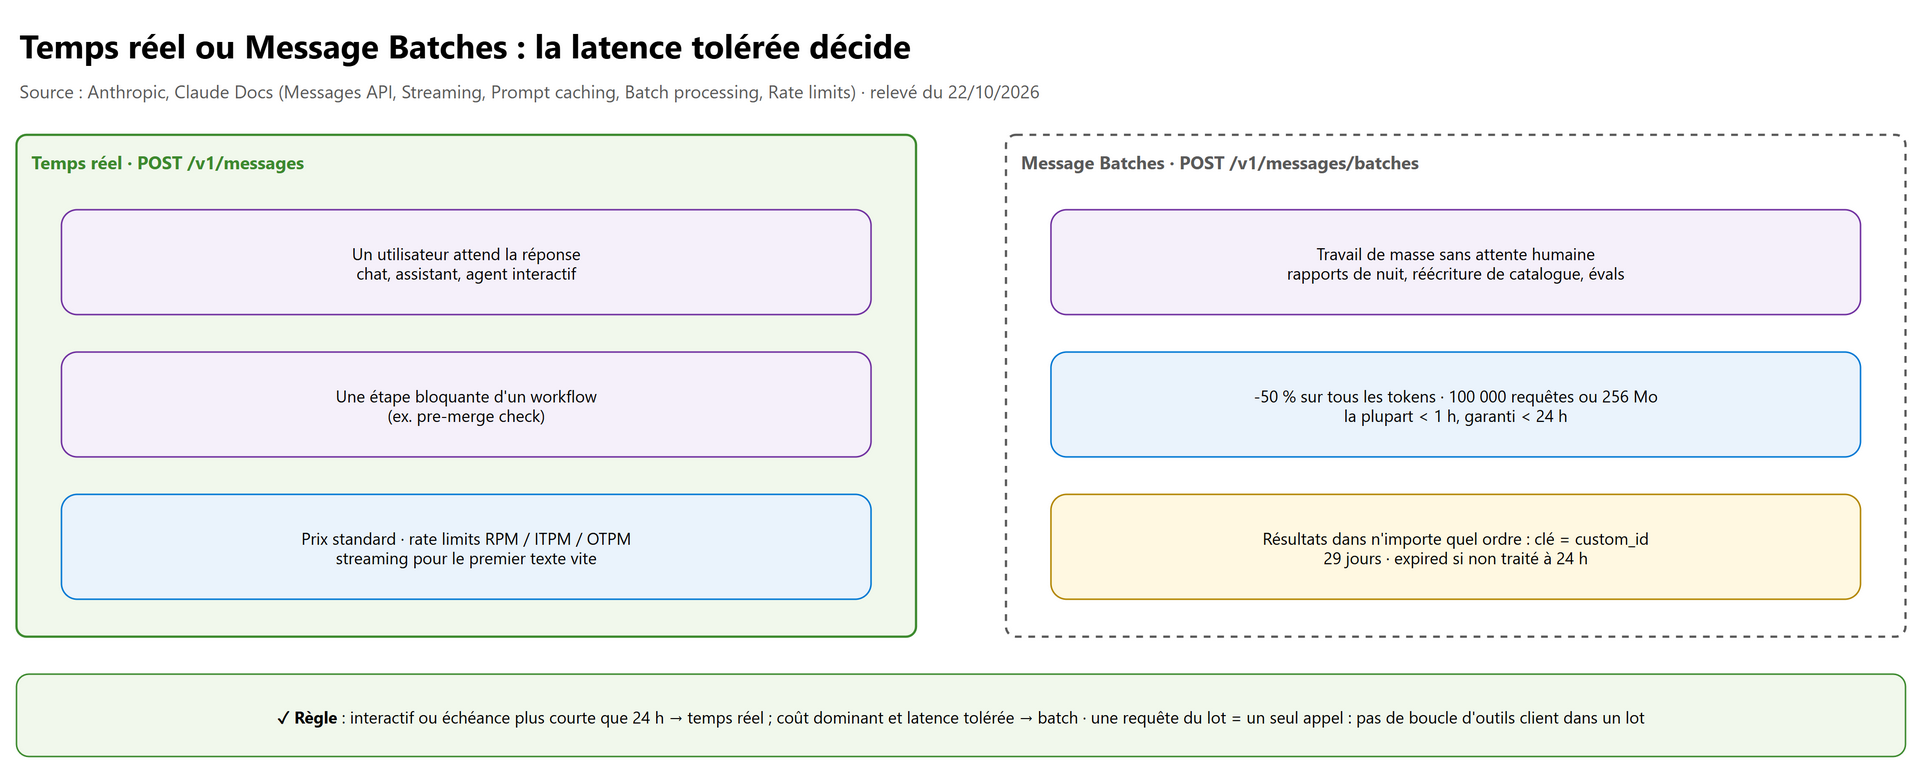
flowchart TD
    A["Nouvelle charge de travail"] --> B{"Quelqu'un attend la réponse<br/>ou une étape bloque ?"}
    B -- "oui" --> RT["Messages API temps réel<br/>streaming si réponse longue"]
    B -- "non" --> C{"Échéance plus courte que 24 h<br/>et non négociable ?"}
    C -- "oui" --> RT
    C -- "non" --> D{"Boucle d'outils client<br/>à plusieurs tours ?"}
    D -- "oui" --> RT2["Temps réel, ou un lot par tour<br/>si le coût domine"]
    D -- "non" --> BT["Message Batches<br/>-50 %, custom_id"]
| Critère | Temps réel | Batch |
|---|---|---|
| Latence | Secondes, streaming possible | Minutes à 24 h |
| Prix | Standard | -50 % |
| Rate limits | RPM / ITPM / OTPM de la Messages API | Limites batch, séparées |
| Ordre des résultats | Celui des appels | Quelconque → custom_id |
| Cas types | Chat, agent interactif, contrôle bloquant avant merge | Évals nocturnes, réécriture d'un catalogue, classement d'archives |
9. Erreurs, retries et rate limits#
9.1 Les erreurs#
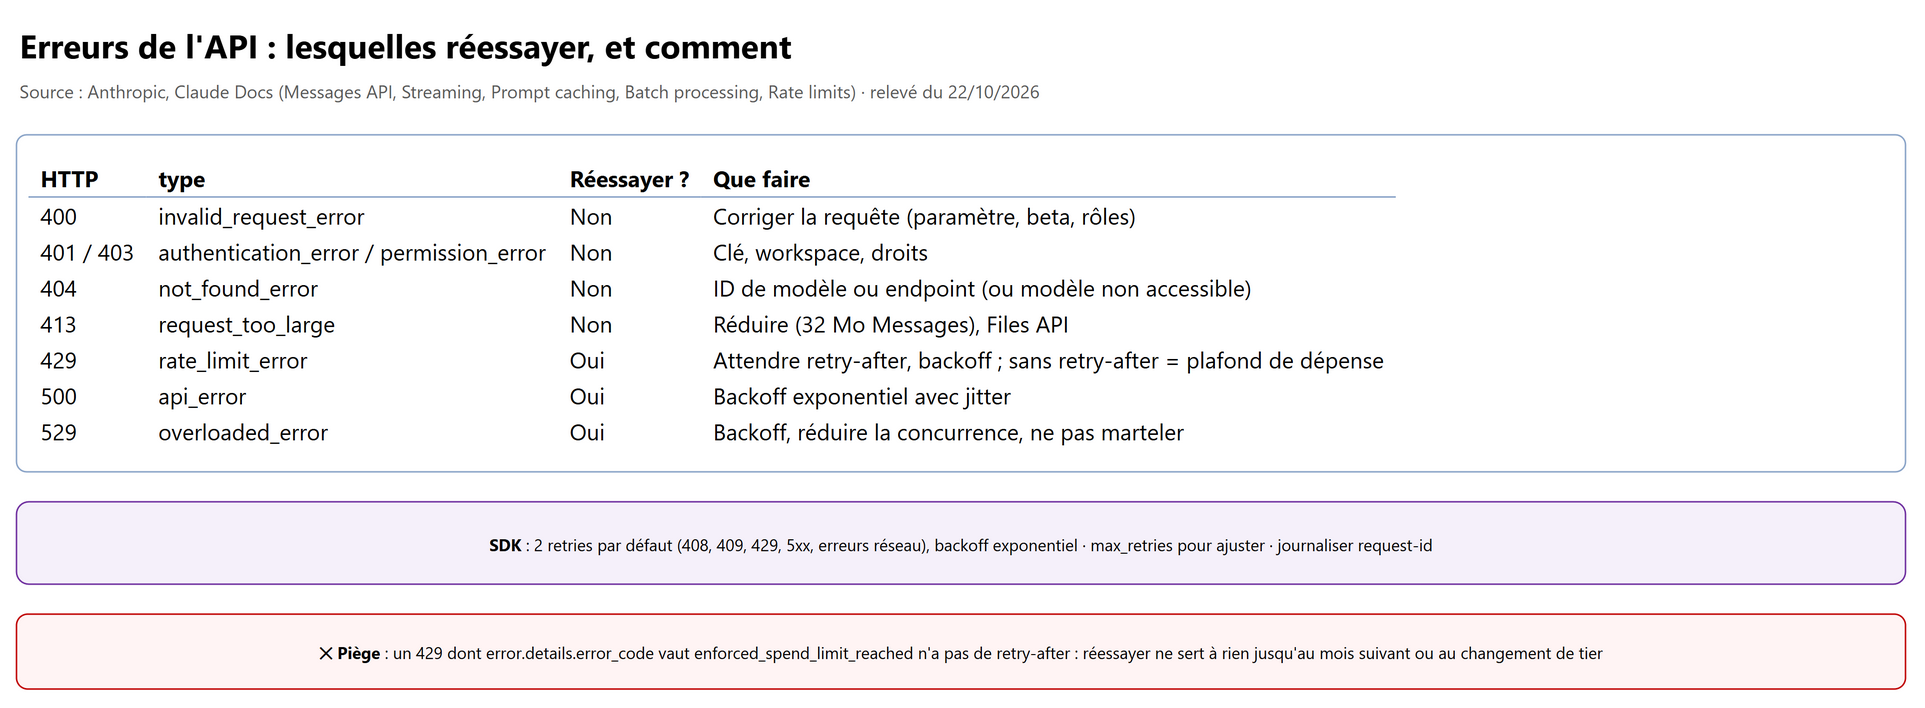
| HTTP | error.type |
Réessayer ? |
|---|---|---|
| 400 | invalid_request_error (paramètre refusé, rôles mal ordonnés, beta inconnue, plafond de dépense propre atteint) |
Non : corriger |
| 401 | authentication_error |
Non |
| 402 | billing_error |
Non |
| 403 | permission_error |
Non |
| 404 | not_found_error (aussi : modèle non accessible à cette clé) |
Non |
| 413 | request_too_large (32 Mo Messages, 256 Mo Batches, 500 Mo Files ; 20 Mo Bedrock, 30 Mo Google Cloud) |
Non : réduire, Files API |
| 429 | rate_limit_error |
Oui, après retry-after |
| 500 | api_error |
Oui, backoff |
| 504 | timeout_error (requête trop longue) |
Oui, mais passer en streaming ou en batch |
| 529 | overloaded_error (charge globale de l'API, pas votre quota) |
Oui, backoff, moins de concurrence |
Le corps d'erreur a la forme {"type": "error", "error": {"type": …, "message": …}, "request_id": …}.
Piège : un 429 dont
error.details.error_codevautenforced_spend_limit_reachedsignale le plafond de dépense de l'organisation. Il n'a pas d'en-têteretry-after: réessayer ne sert à rien avant le mois suivant ou un changement de tier.
9.2 Ce que fait le SDK#
- Retries automatiques sur erreurs de connexion, 408, 409, 429 et 5xx (529 compris), 2 par défaut, backoff exponentiel ;
max_retriessur le client ou par appel (with_options) ;max_retries=0les désactive. - Délai d'expiration par défaut : 10 minutes (
timeouten secondes en Python, en millisecondes en TypeScript). - Exceptions typées :
BadRequestError,AuthenticationError,PermissionDeniedError,NotFoundError,RateLimitError,InternalServerError,APIConnectionError,APITimeoutError, toutes filles d'APIError.
client = anthropic.Anthropic(max_retries=5, timeout=120.0)
try:
    rep = client.messages.create(model="claude-sonnet-5-5", max_tokens=1024, messages=historique)
except anthropic.RateLimitError as e:
    # le SDK a déjà réessayé max_retries fois : mettre en file, ne pas marteler
    planifier_plus_tard(historique, attente=e.response.headers.get("retry-after"))
except anthropic.BadRequestError as e:
    journaliser(e.message, e.request_id)  # erreur de requête : la corriger, jamais la réessayer
N'écrire sa propre boucle de retry que pour un comportement que le SDK n'a pas (file d'attente, coupe-circuit, bascule vers un autre modèle) : deux couches de retry multiplient les tentatives.
flowchart TD
    E["Erreur reçue"] --> S{"Statut HTTP"}
    S -- "400, 401, 402, 403, 404, 413" --> F["Ne pas réessayer<br/>corriger la requête ou la config"]
    S -- "429" --> R{"retry-after présent ?"}
    R -- "oui" --> W["Attendre retry-after<br/>puis réessayer"]
    R -- "non, enforced_spend_limit_reached" --> P["Arrêter : plafond de dépense"]
    S -- "500, 529, réseau" --> B["Backoff exponentiel + jitter<br/>réduire la concurrence"]
    B --> M{"Toujours en échec ?"}
    M -- "oui" --> Q["File d'attente, dégradation,<br/>alerte avec request-id"]
9.3 Rate limits et tiers#
- Trois limites par classe de modèle : RPM, ITPM, OTPM. Algorithme de token bucket : la capacité se reconstitue en continu, pas d'un coup à la minute ronde ; une rafale courte peut déclencher un 429 même sous la moyenne.
- L'OTPM se calcule sur les tokens réellement générés, pas sur
max_tokens. - Tiers : Start, Build, Scale, Custom (plafonds de dépense mensuels 500 $, 1 000 $, 200 000 $, puis sur mesure) ; une nouvelle organisation peut démarrer en Evaluation tier. Des acceleration limits freinent une montée en charge trop brutale.
- Exemple : Opus 5.5 au tier Start = 1 000 RPM, 2 000 000 ITPM, 400 000 OTPM.
- Des limites plus basses peuvent être posées par workspace pour qu'une application n'épuise pas le quota des autres.
- En-têtes de réponse à surveiller :
retry-after,anthropic-ratelimit-requests-limit/-remaining/-reset,anthropic-ratelimit-tokens-*,anthropic-ratelimit-input-tokens-*,anthropic-ratelimit-output-tokens-*(dates de remise à zéro au format RFC 3339).
Leviers quand on touche les limites, du plus simple au plus lourd : prompt caching (ITPM), lisser les rafales (file d'attente), basculer le non-urgent en batch, modèle plus petit pour les tâches simples, tier supérieur.
10. SDK Python et TypeScript#
| Besoin | Python (pip install anthropic) |
TypeScript (npm install @anthropic-ai/sdk) |
|---|---|---|
| Client | anthropic.Anthropic() / AsyncAnthropic() |
new Anthropic() |
| Appel | client.messages.create(...) |
await client.messages.create({...}) |
| Streaming | client.messages.stream(...), text_stream, get_final_message() |
client.messages.stream({...}).on("text", …), finalMessage() |
| Comptage | client.messages.count_tokens(...) |
client.messages.countTokens({...}) |
| Batch | client.messages.batches.create / retrieve / results |
client.messages.batches.create / retrieve / results |
| Fichiers | client.files.upload(...) |
client.files.upload(...) |
| Beta | client.beta.messages.create(..., betas=[...]) |
client.beta.messages.create({..., betas: [...]}) |
| Retries / timeout | max_retries, timeout (secondes) |
maxRetries, timeout (millisecondes) |
| ID de requête | rep._request_id |
rep._request_id |
Le SDK lit ANTHROPIC_API_KEY dans l'environnement : la clé ne s'écrit jamais dans le code ni dans un fichier versionné
(voir 06-securite.md).
Réponse d'examen :
temperature(0 à 1),top_pettop_ksont des paramètres d'échantillonnage ; baissertemperaturerend les réponses plus stables.État actuel : les modèles Claude 4.7 et suivants (Opus 4.7 à 5.5, Fable, Sonnet 5 / 5.5, Haiku 5.5) refusent (400) toute valeur autre que celle par défaut ; la version d'API
2026-10-21les retire pour tous les modèles (400 même à la valeur par défaut), et le SDK Python 1.x ne les accepte plus en argument. La stabilité s'obtient par le prompt, les exemples, les structured outputs et les évals.
11. Claude via un fournisseur cloud#
11.1 Les plateformes#
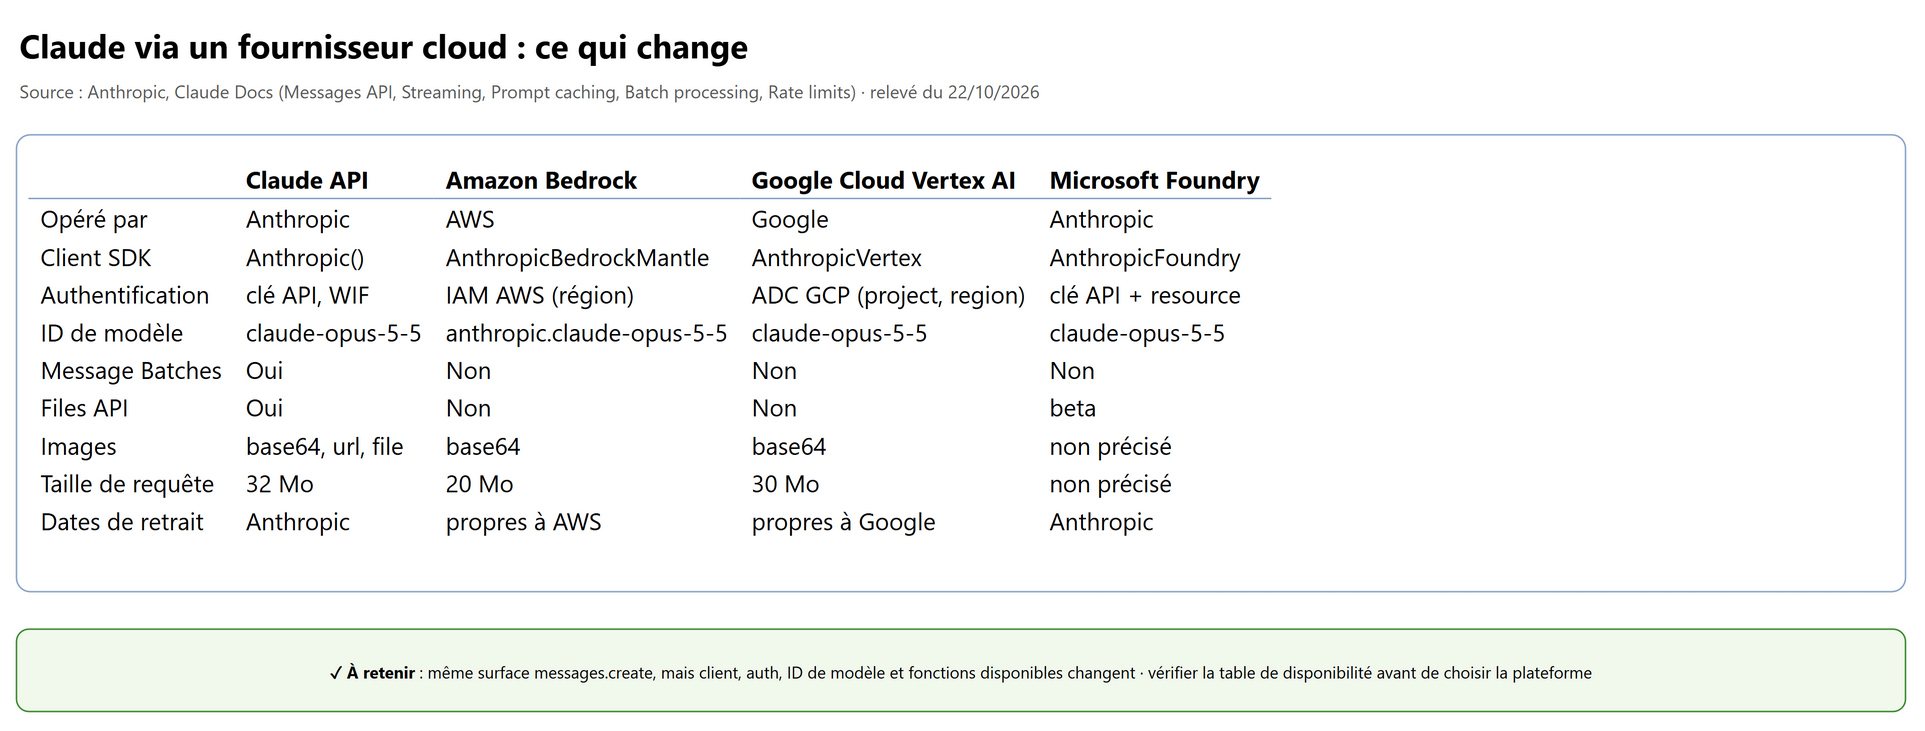
| Plateforme | Opérée par | Client Python | Authentification | ID de modèle |
|---|---|---|---|---|
| Claude API | Anthropic | Anthropic() |
Clé API ou workload identity federation | claude-opus-5-5 |
| Claude Platform on AWS | Anthropic (facturation et accès AWS) | AnthropicAWS (anthropic[aws]) |
IAM / SigV4 | claude-opus-5-5 (ID nu) |
| Amazon Bedrock | AWS | AnthropicBedrockMantle(aws_region=…) (anthropic[bedrock]) |
IAM AWS | anthropic.claude-opus-5-5 |
| Google Cloud Vertex AI | AnthropicVertex(project_id=…, region=…) (anthropic[vertex]) |
Application Default Credentials | claude-opus-5-5, région global possible |
|
| Microsoft Foundry | Anthropic (facturation Microsoft Marketplace, tarif standard) | AnthropicFoundry(api_key=…, resource=…) |
Clé de la ressource Foundry | claude-opus-5-5 |
from anthropic import AnthropicVertex

client = AnthropicVertex(project_id="mon-projet-gcp", region="global")  # ADC : gcloud auth application-default login
rep = client.messages.create(model="claude-sonnet-5-5", max_tokens=512,
                             messages=[{"role": "user", "content": "Bonjour"}])
Ce qui ne change pas : la forme de messages.create, les blocs, le streaming, les outils, le thinking adaptatif, le prompt
caching, le comptage de tokens, les structured outputs.
11.2 Ce qui change#
| Fonction | API Anthropic | Claude Platform on AWS | Bedrock | Vertex AI | Foundry |
|---|---|---|---|---|---|
| Message Batches | Oui | Oui | Non | Non | Non |
| Files API | Oui | Oui | Non | Non | beta |
| Models API | Oui | Oui | Non | Non | Non |
Images par URL ou file |
Oui | Oui | base64 seulement | base64 seulement | — |
| Web search | Oui | Oui | Non | version de base | Oui |
inference_geo (résidence) |
Oui | Oui | Non | Non | Non |
| Fast mode | GA sur Opus 5.5 ; preview (header) sur Opus 5 / 4.8 | — | Non | Non | Oui (Opus 5.5, hébergé sur Azure) |
| Taille de requête | 32 Mo | — | 20 Mo | 30 Mo | — |
| Dates de retrait des modèles | Anthropic | — | Fixées par AWS | Fixées par Google | — |
Une case « — » : non précisé dans la documentation lue. Règle d'examen : une exigence de batch -50 % ou de Files API exclut Bedrock et Vertex AI ; une obligation de rester dans un cloud donné passe avant le confort des fonctions, et l'on adapte l'architecture (ex. lisser en temps réel au lieu du batch).
12. Versions, betas et dépréciations#
12.1 anthropic-version#
- En-tête obligatoire. Une version fige le comportement de l'API : les paramètres existants sont préservés.
- Anthropic peut, sans nouvelle version : ajouter des paramètres optionnels, de nouvelles valeurs de sortie, de nouvelles variantes d'énumération (ex. un nouveau type d'événement de streaming), et changer des conditions d'erreur. Un client robuste ignore ce qu'il ne connaît pas.
Réponse d'examen :
anthropic-version: 2023-06-01(la seule version de l'époque du guide).État actuel : la version
2026-10-21(sortie le 21/10/2026) retiretemperature,top_pettop_k(400 sur tous les modèles), refuse un blocdocumentdans un messageassistantet un texte avec citations dans un messageuser.2023-06-01reste acceptée. Migrer = changer l'en-tête après avoir passé la suite d'évals (§ 2).
12.2 Betas#
- Une fonction en beta s'active par l'en-tête
anthropic-beta: <nom-date>(oubetas=[…]dans le SDK, espace de nomsclient.beta). - Une beta peut changer ou disparaître : ne pas en dépendre pour une exigence de production sans plan B, et la sortir du code quand elle passe en GA (ex. Files API).
- Sur Bedrock et Vertex AI, la façon de passer une beta diffère (champ
anthropic_betadans le corps sur Bedrock, en-tête sur Vertex AI).
12.3 Cycle de vie des modèles#
stateDiagram-v2
    direction LR
    Active --> Legacy: nouveau modèle de la gamme
    Legacy --> Deprecated: annonce + date de retrait
    Deprecated --> Retired: après le préavis (au moins 60 jours)
    note right of Deprecated: fonctionne encore, remplaçant désigné
    note right of Retired: les requêtes échouent
| État | Les requêtes | À faire |
|---|---|---|
| Active | Fonctionnent | — |
| Legacy | Fonctionnent, plus de nouveautés | Prévoir la migration |
| Deprecated | Fonctionnent ; remplaçant et date de retrait publiés | Migrer : évals sur le remplaçant, bascule |
| Retired | Échouent | Trop tard |
- Trouver qui utilise un modèle déprécié : export CSV de l'usage dans la Console (par clé API et par modèle).
- Exemple : Claude Sonnet 4.5 est retiré le 30/11/2026, remplaçant
claude-sonnet-5-5. GET /v1/modelsdonne, pour chaque modèle,max_input_tokens,max_tokensetcapabilities: interroger l'API plutôt que de coder ces valeurs en dur.
13. Labs conseillés#
Prérequis : un compte Claude API de test, avec un plafond de dépense bas sur son workspace ; la clé dans
ANTHROPIC_API_KEY (jamais dans le code) ; Python 3.10+ et pip install anthropic. Utilisez claude-haiku-5-5 sauf mention
contraire : chaque lab coûte quelques milliers à quelques centaines de milliers de tokens, soit quelques centimes.
- Requête brute et usage (20 min, ~5 000 tokens) : l'appel
curldu § 0.1, puis le même avecmax_tokens: 5sur une question longue. Résultat attendu :stop_reason: "max_tokens",usage.output_tokens = 5. Ajoutez un messagesystemdansmessageset lisez l'erreur 400. Notez l'en-têterequest-id. - Streaming (30 min, ~20 000 tokens) : le code du § 4.3, puis le même avec
stream=Truesurmessages.createen affichant letypede chaque événement. Résultat attendu : la séquence du § 4.2,stop_reasondansmessage_delta. - Vision et Files API (30 min, ~50 000 tokens) : une photo de ticket de caisse en base64, puis un PDF de 5 pages déposé
par
client.files.uploadet interrogé deux fois avec le mêmefile_id. Comparezusage.input_tokensimage / PDF. Nettoyage :client.files.delete(f.id). - Prompt caching (30 min, ~150 000 tokens) : un
systemde 3 000 tokens aveccache_control, deux appels à moins de 5 min. Résultat attendu :cache_creation_input_tokens> 0 puiscache_read_input_tokens> 0. Ajoutez la date du jour au début dusystemet constatez que la lecture retombe à 0. - Message Batches (1 h d'attente, ~30 000 tokens à -50 %) : le lot du § 8.1 avec 20 requêtes dont une volontairement
invalide (
max_tokensabsent). Résultat attendu : 19succeeded, 1errored, des résultats dans un ordre différent de l'envoi. Rien à nettoyer (résultats supprimés après 29 jours) ;client.messages.batches.deletepour le faire plus tôt.
Nettoyage général : supprimer les fichiers déposés, révoquer la clé de test à la fin, garder le plafond de dépense du workspace.
14. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
Mettre les consignes dans un message role: "system" en tête de messages |
Champ system de premier niveau |
messages commence par user |
| « L'API se souvient du tour précédent » | Non : renvoyer l'historique | Sans état |
Réponse coupée net, stop_reason non lu |
Lire stop_reason (max_tokens) |
Le texte ne dit pas qu'il est tronqué |
| Contexte plein confondu avec sortie plafonnée | model_context_window_exceeded ≠ max_tokens |
Deux corrections différentes |
refusal traité comme une erreur HTTP |
HTTP 200, lire stop_details |
Réponse du modèle, pas panne |
| Streaming proposé pour réduire le coût | Non : latence perçue seulement | Mêmes tokens |
| HTTP 200 reçu, donc le flux est sain | Un événement error peut suivre |
Erreur en cours de flux |
input_json_delta parsé à chaque morceau |
Concaténer, parser à content_block_stop |
JSON partiel |
| Réessayer une 400 ou une 401 | Non : corriger | L'erreur se reproduira |
| 529 traité comme un dépassement de quota | Surcharge globale : backoff, moins de concurrence | 429 = votre quota |
429 sans retry-after réessayé en boucle |
Plafond de dépense : arrêter | enforced_spend_limit_reached |
| Boucle de retry maison par-dessus le SDK | Configurer max_retries |
Le SDK réessaie déjà 2 fois |
| Batch pour un chat ou un contrôle bloquant | Temps réel | Jusqu'à 24 h |
| Résultats de batch lus dans l'ordre d'envoi | Relier par custom_id |
Ordre quelconque |
| Boucle d'outils à plusieurs tours dans un lot | Impossible : une requête = un appel | Il faut un nouveau lot par tour |
| Batch ou Files API exigés sur Bedrock / Vertex AI | Non disponibles là | Table de disponibilité |
Horodatage en tête du system et cache à 0 |
Mettre le variable après le dernier breakpoint | Préfixe exact |
| Préfixe de 300 tokens « jamais mis en cache » | Sous le minimum du modèle | 512 à 4 096 selon le modèle |
| Exigence « < 2 s » classée fonctionnelle | Non fonctionnelle (latence) | Chiffré ≠ fonctionnel |
| Projet « terminé » à la mise en production | Exploitation et maintenance continues | Modèles dépréciés, prompts à corriger |
budget_tokens sur Opus 5.5 |
400 : thinking: {type: "adaptive"} + effort |
État actuel |
15. Scénarios corrigés#
1. Une agence veut « répondre plus vite aux demandes de devis ». L'équipe propose de commencer par mesurer le RPM disponible sur son tier pour savoir quelles fonctions construire. Quelle est la bonne démarche ? A. Partir du RPM disponible et en déduire le périmètre fonctionnel. B. Formaliser l'exigence métier, en dériver les exigences fonctionnelles, puis, avec l'architecture choisie, les exigences d'infrastructure (pic, résidence, coût). C. Choisir d'abord le modèle le plus puissant, puis écrire les exigences. D. Écrire directement les prompts et mesurer en production.
B. La dérivation va du métier vers le fonctionnel puis l'infrastructure, à travers l'architecture. Le RPM est une contrainte qu'on vérifie, pas le point de départ (A).
2. Les fiches de visite générées s'arrêtent parfois au milieu d'une phrase. Les journaux montrent HTTP 200 et
stop_reason: "max_tokens". Que faire ?
A. Réessayer la même requête avec backoff. B. Relever max_tokens (et streamer si la sortie devient longue) ou demander une
fiche plus courte. C. Réduire l'historique envoyé. D. Passer en Message Batches.
B. Le plafond de sortie est atteint. A reproduit le même résultat ; C traite un contexte plein (
model_context_window_exceeded), pas ce cas ; D ne change pas le plafond.
3. Une application de chat affiche la réponse après 25 secondes d'écran blanc. Le coût est jugé correct. Quelle modification
améliore le plus l'expérience ?
A. Message Batches. B. Streaming de la réponse avec affichage des text_delta. C. Prompt caching du message utilisateur.
D. Augmenter max_retries.
B. Le streaming réduit le délai avant le premier mot. A allonge la latence ; C ne s'applique pas à la partie variable ; D ne change rien à un appel réussi.
4. En streaming avec un outil creer_rdv, le code fait json.loads() sur chaque input_json_delta et lève une exception
au deuxième événement. Correction ?
A. Désactiver le streaming quand des outils sont déclarés. B. Concaténer les partial_json du bloc et parser à
content_block_stop (ou utiliser get_final_message()). C. Forcer tool_choice: any. D. Réduire max_tokens.
B. Chaque delta est un morceau de JSON. A est inutile ; C est en plus refusé (400) sur les modèles récents.
5. Chaque nuit, 40 000 annonces immobilières doivent être réécrites pour le lendemain 9 h. Aucun utilisateur n'attend. Le
budget est serré. Quelle approche ?
A. 40 000 appels temps réel en parallèle. B. Message Batches, résultats reliés par custom_id, requêtes errored ou expired
renvoyées dans un nouveau lot. C. Streaming pour aller plus vite. D. Un seul appel avec les 40 000 annonces dans le prompt.
B. -50 %, la plupart des lots finissent en moins d'une heure, l'échéance laisse la marge. A coûte le double et touche les rate limits ; D dépasse la fenêtre de contexte.
6. Un agent de qualification appelle trois outils client à la suite pour chaque prospect. Pour économiser, l'équipe veut
passer les 10 000 prospects du mois en Message Batches « avec la boucle d'outils à l'intérieur ». Qu'en pensez-vous ?
A. C'est possible : le lot exécute la boucle. B. Impossible tel quel : une requête du lot est un seul appel ; il faudrait un lot
par tour d'outils, ou rester en temps réel. C. Possible avec tool_choice: any. D. Possible si l'on active le streaming dans
le lot.
B. Le lot renvoie un
stop_reason: "tool_use"que personne n'exécute. Le streaming n'existe pas en batch.
7. Pendant une campagne, l'application reçoit des 529 overloaded_error alors que les en-têtes
anthropic-ratelimit-requests-remaining montrent de la marge. Que faire ?
A. Demander un tier supérieur. B. Backoff exponentiel avec jitter et réduction de la concurrence, journaliser request-id.
C. Traiter comme une 400 et corriger la requête. D. Réessayer immédiatement en boucle.
B. 529 = surcharge globale de l'API, pas votre quota (A ne sert à rien). D aggrave la surcharge.
8. Un client impose AWS et veut à la fois la remise batch de 50 % et la Files API. Quelle recommandation ? A. Amazon Bedrock : il a tout. B. Claude Platform on AWS (opéré par Anthropic, mêmes fonctions que l'API), ou bien Bedrock en renonçant au batch et à la Files API. C. Google Cloud Vertex AI. D. Microsoft Foundry.
B. Message Batches et Files API ne sont pas sur Bedrock (A), ni sur Vertex AI (C) ; Foundry n'a pas le batch (D).
9. Un assistant envoie un manuel de 20 000 tokens à chaque question. cache_control est posé sur le system, mais
cache_read_input_tokens vaut 0 à chaque appel. Le system commence par « Nous sommes le {date et heure} ». Cause ?
A. Le TTL de 5 min est trop court. B. L'horodatage change le préfixe à chaque appel ; le déplacer après le dernier breakpoint
(dans le message user). C. Il faut 4 breakpoints. D. Le manuel est sous la taille minimale.
B. Le cache exige un préfixe identique octet pour octet. D est faux : 20 000 tokens dépassent tous les minimums.
10. Après la mise à jour du SDK, les appels à claude-opus-5-5 avec thinking: {type: "enabled", budget_tokens: 8000} et
temperature: 0 renvoient une 400. Que faire ?
A. Revenir à l'ancien SDK. B. Passer à thinking: {type: "adaptive"} avec output_config.effort, retirer temperature, puis
repasser la suite d'évals avant la mise en production. C. Augmenter budget_tokens au-dessus de 1 024. D. Ajouter un en-tête
beta.
B.
budget_tokensettemperaturesont refusés sur Opus 5.5, quel que soit le SDK (A ne corrige rien). Le changement de paramètre est une modification de comportement : il repasse les évals (cycle de vie, § 2).
16. Pour aller plus loin (hors examen)#
- Claude Platform on AWS : l'API Anthropic avec IAM, SigV4 et facturation AWS, parité des fonctions le jour même ; à comparer à Bedrock pour un client « AWS only ».
- Server-side
fallbacks(beta) : laisser l'API basculer vers un autre modèle en cas d'indisponibilité, au lieu d'une logique maison ; refusé sur Message Batches. - Usage and Cost Admin API : récupérer l'usage et le coût par workspace, modèle et clé pour les tableaux de bord d'exploitation (phase 6 du cycle de vie).
- OpenTelemetry (beta) : traces émises par les SDK, pour relier un ralentissement à une requête précise.
- Compaction et context editing (beta) : réduire l'historique côté serveur dans les longues conversations ; voir 05-prompts-contexte-sorties.md.
17. Fiche à retenir#
-
POST /v1/messages:model,max_tokens,messagesobligatoires ;systemau premier niveau ; premier messageuser. - En-têtes : clé (
x-api-key),anthropic-versionobligatoire,content-type;anthropic-betapour une beta. - API sans état : l'application renvoie l'historique, blocs
thinkingettool_resultcompris. - Lire
stop_reasond'abord :end_turn,max_tokens,stop_sequence,tool_use,pause_turn,refusal,model_context_window_exceeded. - Total d'entrée =
input_tokens+cache_creation_input_tokens+cache_read_input_tokens; journaliserrequest-id. - Streaming :
message_start→ blocs (start,delta× n,stop) →message_delta(stop_reason) →message_stop;ping;erroraprès un 200. -
input_json_deltase concatène ;get_final_message()/finalMessage()quand on ne veut que le résultat. - Images : JPEG, PNG, GIF, WebP, image avant le texte, ≈ (l/28)×(h/28) tokens ; PDF : 32 Mo, 600 pages ; Files API :
file_id, 500 Mo. - Thinking :
adaptive+effortsur les modèles récents ;budget_tokens= 400 sur Opus 5.5 et consorts. - Caching : préfixe exact
tools→system→messages, 4 breakpoints, 5 min ou 1 h, minimum 512 à 4 096 tokens. - Batch : -50 %, 100 000 requêtes / 256 Mo, < 24 h, ordre quelconque →
custom_id, une requête = un appel. - Temps réel si quelqu'un attend ; batch si le coût domine et que la latence est tolérée.
- Réessayer 429 (après
retry-after), 500, 529 ; jamais 400 à 413 ; le SDK fait 2 retries par défaut. - Bedrock et Vertex AI : pas de Batches, pas de Files API, images en base64 ; Bedrock préfixe l'ID par
anthropic.. - Exigences : métier → fonctionnel → infrastructure ; latence, débit, résidence, coût = non fonctionnel.
- Cycle de vie : 7 phases ; évals de régression en test ; migration d'un modèle déprécié en exploitation (préavis ≥ 60 jours).
- Examen :
anthropic-version: 2023-06-01; aujourd'hui2026-10-21existe et retiretemperature/top_p/top_k.
Références#
Lues le 22/10/2026 :
- Claude Certified Developer – Foundations Exam Guide v1.0 (juillet 2026), domaine 2 (texte des skills repris dans ../outils/guides/claude-developer.md)
- API overview
- Messages API et Working with the Messages API
- Handling stop reasons
- Streaming messages
- Vision, PDF support et Files API
- Adaptive thinking et Extended thinking
- Prompt caching
- Batch processing
- Token counting
- Errors et Rate limits
- Versions et Beta headers
- Model deprecations et Models overview
- Claude on Amazon Bedrock, Claude on Vertex AI, Claude in Microsoft Foundry et Claude Platform on AWS
- Client SDKs
- claudecertificationguide.com, domaine 2 (leçons 2.1 à 2.3, base du chapitre)