
Version : 1.0 · Date : 2026-10-23 · Parcours SUPPORT-IA (support N2/N3 de chatbots IA sur Azure)
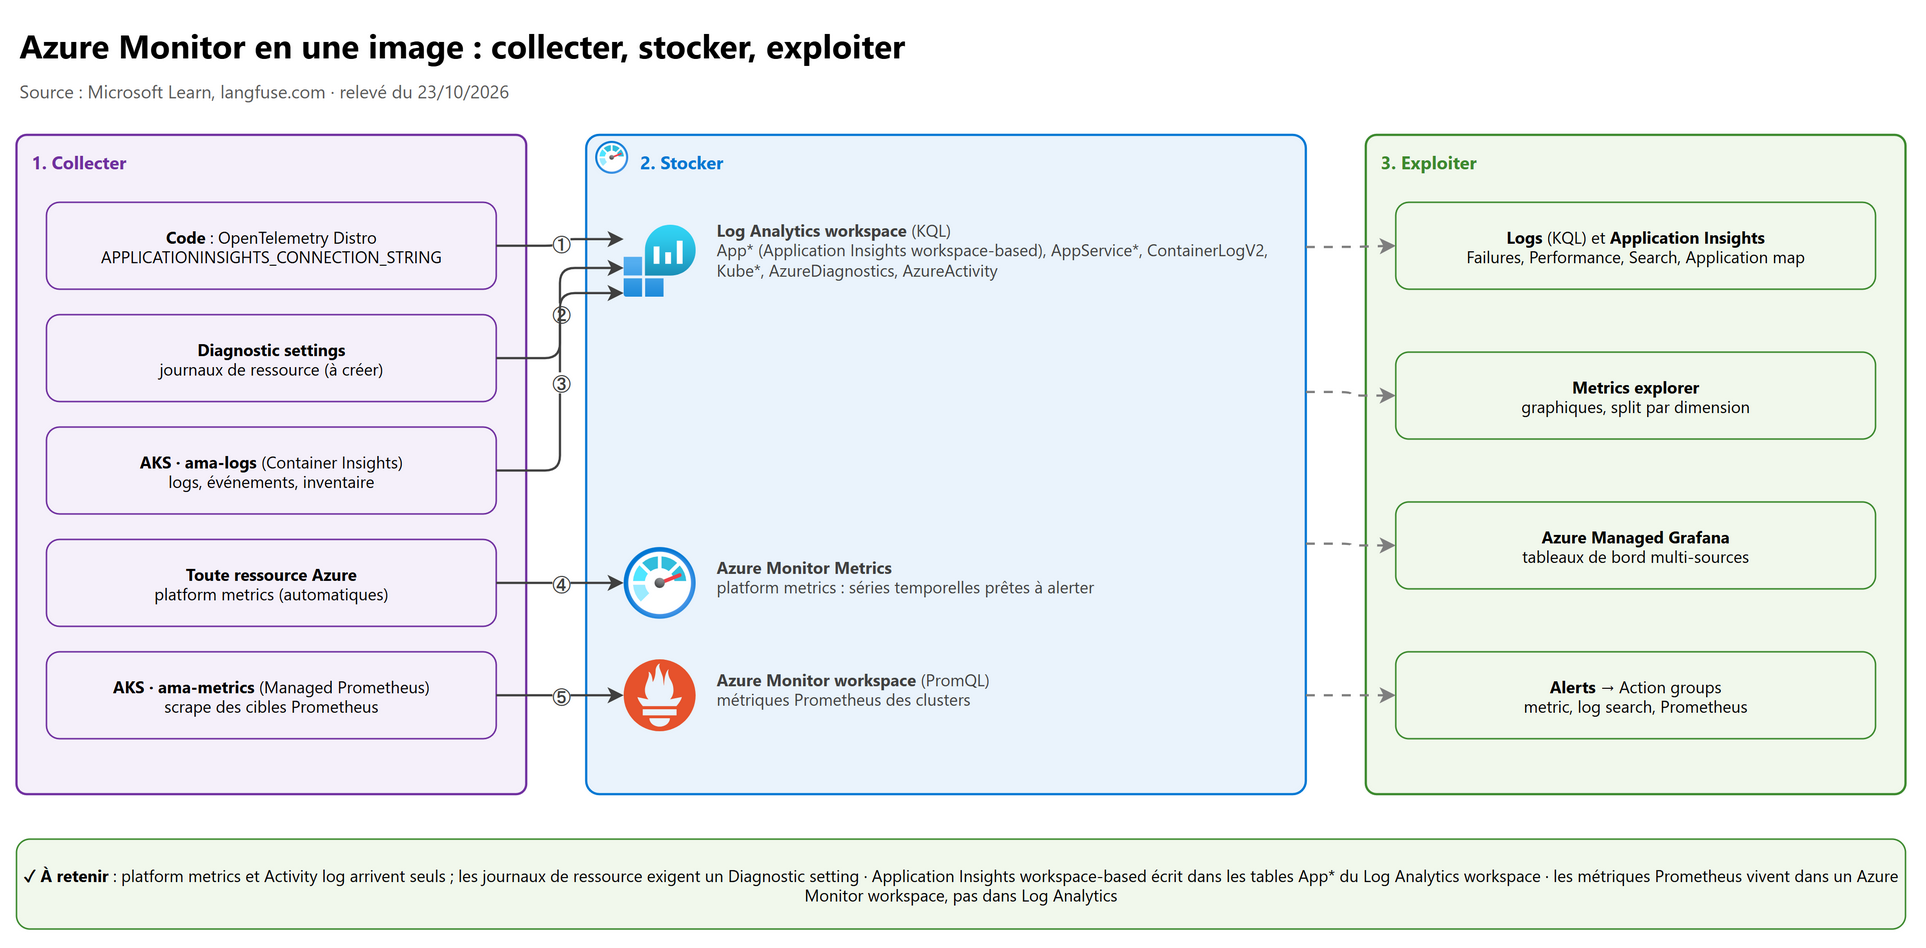
En une phrase : Azure Monitor collecte trois choses dans trois magasins (journaux dans un Log Analytics workspace, métriques de plateforme dans Azure Monitor Metrics, métriques Prometheus dans un Azure Monitor workspace) ; Application Insights relie les sauts d'une requête par l'operation_Id (le trace id W3C), Azure Managed Grafana affiche le tout avec sa propre managed identity, et Langfuse ajoute ce qu'Azure Monitor ne montre pas : ce que le modèle a reçu, répondu, consommé et si la réponse était bonne.
Ce chapitre suppose le chapitre 01 (architecture et carte des journaux). La supervision du cluster lui-même (Container Insights, journaux du control plane, coûts) est traitée dans AKS 05 ; les métriques propres aux modèles (jetons, TTFT, PTU) dans le chapitre 02. Ici : lire la télémétrie pour trouver une cause.
Noms et échéances à connaître (relevé du 23/10/2026)
- Pour .NET, Node.js et Python, Microsoft recommande désormais la Microsoft OpenTelemetry Distro (paquets
microsoft-opentelemetry,@microsoft/opentelemetry,Microsoft.OpenTelemetry) ; l'Azure Monitor OpenTelemetry Distro (azure-monitor-opentelemetry,configure_azure_monitor) reste supportée pour l'existant et pour Java. Ne pas initialiser les deux dans la même application.- Classic Application Insights est retiré (29/02/2024) : tout est workspace-based. Le support de l'ingestion par instrumentation key a pris fin le 31/03/2025 : utiliser la connection string.
- ContainerLog (ancienne table Container Insights) : fin de support le 30/09/2026, migrer vers ContainerLogV2.
- AppGenAIContent : à partir du 31/10/2026, les contenus GenAI (prompts, réponses, appels d'outils) ne sont plus copiés dans
AppDependencies,AppTraces,AppEvents: seule une référence y reste, la valeur est dansAppGenAIContent.- Préversions citées dans ce chapitre : vue Agents (preview) d'Application Insights, blade AI (preview) d'App Service, Azure Monitor dashboards with Grafana (preview), dynamic thresholds des log search alerts, query-based metric alerts.
| # | Section | Ce qu'on y apprend |
|---|---|---|
| 1 | Azure Monitor en une image | Collecter, stocker, exploiter |
| 2 | Quel outil pour quoi | Log Analytics, Application Insights, Log stream, Container Insights, Prometheus |
| 3 | Les types de télémétrie | Tables et « quand utiliser quoi » |
| 4 | OpenTelemetry | Distro, spans, corrélation W3C, échantillonnage |
| 5 | Lire une trace | Failures, transaction details, Application map |
| 6 | Requêtes KQL | Les requêtes du support |
| 7 | Prometheus et Grafana | Flux, identités, rôles, « No data » |
| 8 | Langfuse | Traces LLM, jetons, coût, scores |
| 9 | Alertes | Types d'alertes et règles utiles |
| 10–14 | Pièges, lab, entretien, fiche |
Ce que tu dois savoir expliquer en entretien#
| Question type | Section |
|---|---|
| « Différence entre Log Analytics, Application Insights et le Log stream ? » | 2 |
| « Comment suivez-vous une requête à travers plusieurs services ? » | 4, 5 |
| « Écrivez une requête pour trouver les 429 vers Azure OpenAI. » | 6 |
| « Un tableau Grafana affiche No data. Que vérifiez-vous ? » | 7.5 |
| « À quoi sert Langfuse si vous avez Application Insights ? » | 8 |
| « Sur quoi alertez-vous pour un chatbot ? » | 9 |
1. Azure Monitor en une image#
| Magasin | Contient | Langage | Rétention par défaut | Arrive comment |
|---|---|---|---|---|
| Azure Monitor Metrics | Platform metrics de chaque ressource (séries temporelles) | Metrics explorer | Gérée par la plateforme | Automatique |
| Activity log | Opérations de contrôle (création, modification, suppression, redémarrage) | Portail, KQL si exporté (AzureActivity) |
90 jours | Automatique |
| Log Analytics workspace | Journaux de ressource, Application Insights (tables App*), Container Insights, journaux Web App |
KQL | 30 jours en Analytics (90 jours sans surcoût pour les tables App* et AzureActivity), jusqu'à 2 ans en Analytics, 12 ans au total |
Diagnostic settings, agents (DCR), SDK |
| Azure Monitor workspace | Métriques Prometheus (Managed Prometheus) | PromQL | Gérée par le service | ama-metrics + DCR/DCE |
Trois règles qui expliquent la majorité des « je ne trouve pas les logs » :
- Les platform metrics et l'Activity log existent toujours, sans rien configurer.
- Les journaux de ressource n'existent que si un Diagnostic setting les envoie quelque part.
- La télémétrie applicative n'existe que si le code est instrumenté (OpenTelemetry) et a la bonne connection string.
1.1 Les plans de table (coût et capacités)#
| Analytics | Basic | Auxiliary | |
|---|---|---|---|
| Usage | Supervision continue, alertes, tableaux de bord | Dépannage, réponse à incident | Données verbeuses, audit, conformité |
| Requêtes | Non facturées au volume scanné | Facturées au Go scanné, 30 jours requêtables | Facturées au Go scanné, sur toute la rétention |
| Alertes | Toutes | Limitées (simple log search alerts) | Les alertes cessent de fonctionner pour la table |
| Exemple chatbot | AppRequests, AppDependencies, KubePodInventory |
ContainerLogV2, AppTraces (si gros volume) |
Journaux d'audit conservés longtemps |
Piège : passer
ContainerLogV2en Basic réduit la facture, mais une alerte log qui s'appuie dessus doit être revue. Un changement de plan est limité à un par semaine et par table.
2. Quel outil pour quoi#
| Outil | Ce que c'est | Stocké ? | Quand l'ouvrir | Limite à connaître |
|---|---|---|---|---|
| Log stream (Web App) | Flux temps réel de stdout/stderr et des journaux écrits dans /home/LogFiles |
Non : c'est un flux ; les fichiers sous-jacents ont un quota et une rétention (réglages App Service logs) | Le conteneur ne démarre pas, on veut voir maintenant | Exige --docker-container-logging filesystem ; passe par le site SCM (accès réseau requis en privé) ; rien si personne ne regarde |
| Log Analytics workspace | Le magasin de journaux, interrogé en KQL | Oui | Toute analyse dans le temps, corrélation entre sources | N'a que ce qu'on y envoie |
| Application Insights (workspace-based) | La couche APM : requêtes, dépendances, exceptions, cartes, transaction details ; données dans les tables App* du workspace |
Oui (dans le workspace) | Une requête échoue ou est lente : où et pourquoi | Dépend de l'instrumentation et de l'échantillonnage |
| Container Insights | Agent ama-logs : logs des conteneurs (ContainerLogV2), KubeEvents, KubePodInventory, vues du portail |
Oui | Pod qui redémarre, OOMKilled, logs d'un pod disparu | Événements Warning seulement par défaut ; métriques plutôt via Prometheus |
| Managed Prometheus | Agent ama-metrics : métriques Kubernetes et applicatives dans un Azure Monitor workspace |
Oui | Tendances CPU/mémoire, restarts, saturation, métriques métier exposées en /metrics |
Minimal ingestion profile : seules les métriques des tableaux et alertes par défaut sont collectées |
| Azure Managed Grafana | Tableaux de bord multi-sources (Prometheus, Azure Monitor, Log Analytics) | Non (lit les sources) | Vue d'équipe, NOC, comparaisons | Identité et rôles à part (section 7) |
| Live Metrics (Application Insights) | Flux temps réel des requêtes, échecs, CPU de l'app instrumentée | Non | Pendant un déploiement ou un test de charge | Exige le sampler Azure Monitor |
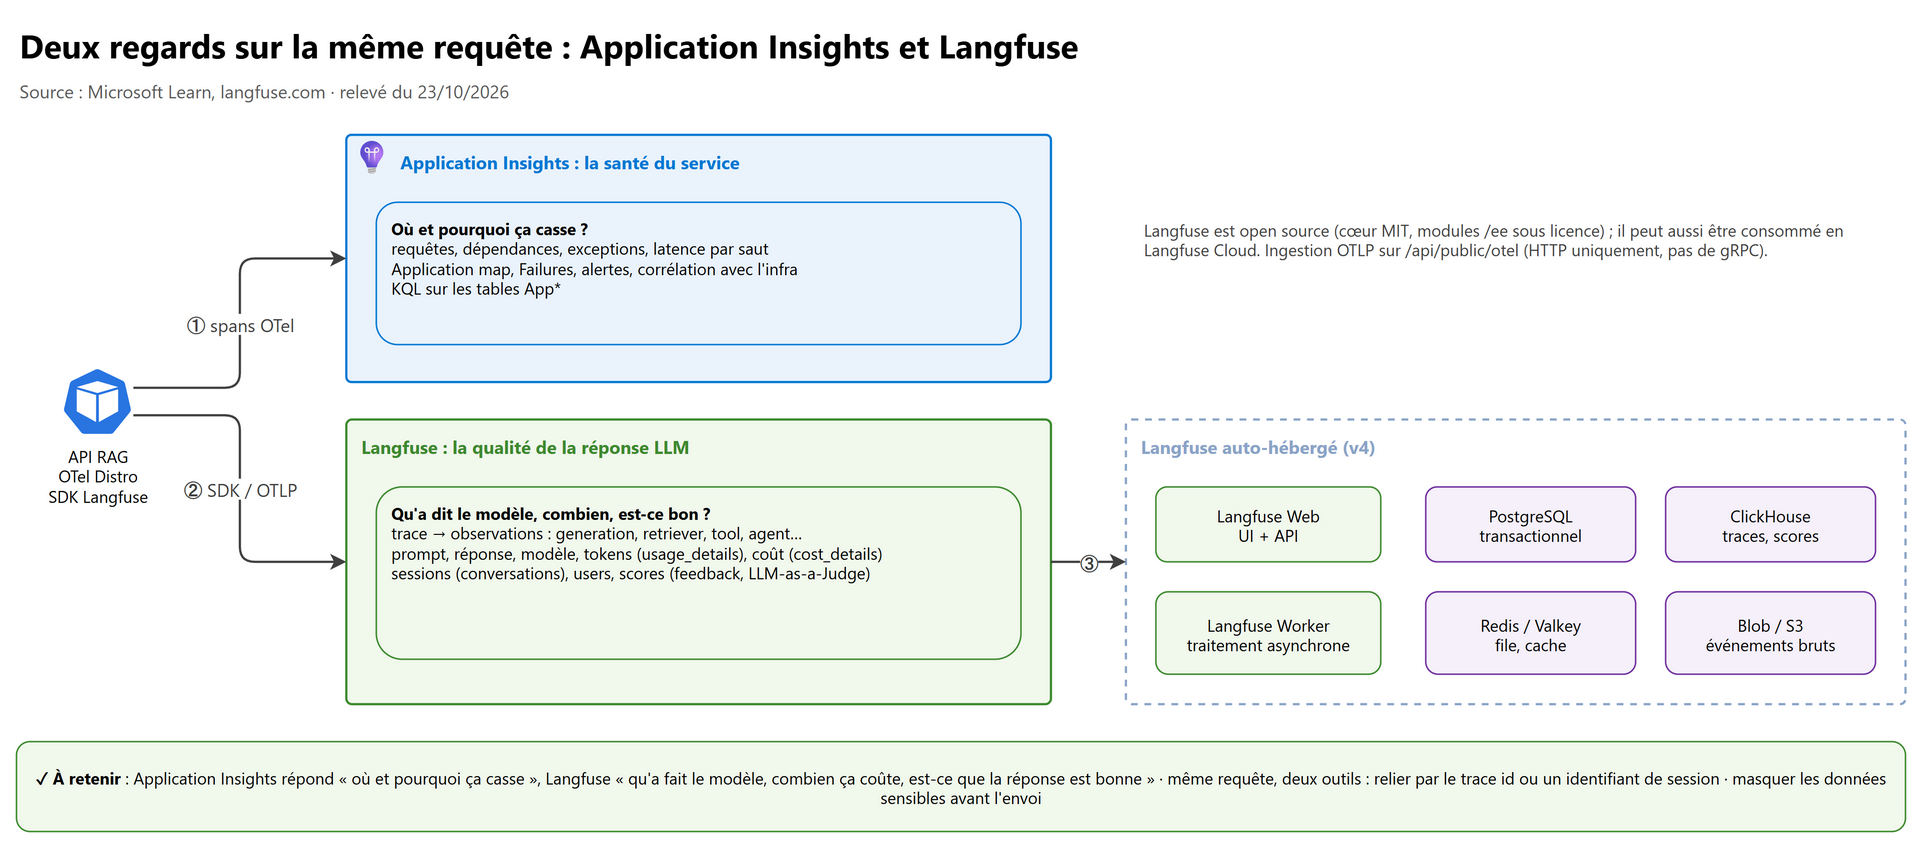
| Langfuse | Traces orientées LLM : prompt, réponse, jetons, coût, scores | Oui (sa propre base) | Réponse fausse, hallucination, coût qui dérive, invite trop longue | Outil tiers : clés, réseau, rétention à gérer |
flowchart TD
    Q["Je cherche…"] --> A{"Quoi ?"}
    A -- "Pourquoi le conteneur Web App<br/>ne démarre pas, maintenant" --> LS["Log stream<br/>puis AppServicePlatformLogs"]
    A -- "Quelle requête a échoué,<br/>à quel saut" --> AI["Application Insights<br/>Failures → transaction details"]
    A -- "Pourquoi le pod redémarre" --> CI["kubectl describe / logs --previous<br/>puis KubePodInventory, ContainerLogV2"]
    A -- "La tendance CPU, mémoire,<br/>restarts sur 7 jours" --> PR["Managed Prometheus<br/>(Grafana, PromQL)"]
    A -- "Throttling, latence d'un<br/>service Azure" --> MT["Platform metrics<br/>(Metrics explorer)"]
    A -- "Qui a changé la config" --> AL["Activity log"]
    A -- "Ce que le modèle a reçu<br/>et répondu, combien" --> LF["Langfuse<br/>(ou AppGenAIContent)"]
3. Les types de télémétrie et les tables#
3.1 Application Insights#
| Type | Table Application Insights | Table Log Analytics | Exemple dans un chatbot |
|---|---|---|---|
| Request | requests |
AppRequests |
POST /chat reçu par l'API : durée, code, succès |
| Dependency | dependencies |
AppDependencies |
Appel sortant vers AI Search, Azure OpenAI, Key Vault, Redis |
| Exception | exceptions |
AppExceptions |
RateLimitError, HttpResponseError 403 |
| Trace (logs) | traces |
AppTraces |
logger.info("chunks retenus: 5") |
| Event | customEvents |
AppEvents |
« réponse notée 👎 », « citation cliquée » (instrumentation manuelle) |
| Metric | customMetrics, performanceCounters |
AppMetrics, AppPerformanceCounters |
Jetons consommés, taille de l'invite |
| Generative AI | genAIContent |
AppGenAIContent |
Messages d'entrée et de sortie, instructions système, appels d'outils (conventions gen_ai.*) |
| Page view, Browser timing | pageViews, browserTimings |
AppPageViews, AppBrowserTimings |
Front instrumenté avec le SDK JavaScript |
| Availability | availabilityResults |
AppAvailabilityResults |
Test de disponibilité (si l'endpoint est joignable par le test) |
Les noms de colonnes changent aussi : operation_Id devient OperationId, operation_ParentId devient ParentId,
cloud_RoleName devient AppRoleName, timestamp devient TimeGenerated. Les requêtes de ce chapitre utilisent les tables
Log Analytics (recommandé par Microsoft).
AppGenAIContent contient souvent des données personnelles : Microsoft recommande d'en faire une protected table, visible uniquement des identités qui ont Privileged Monitoring Data Reader sur la ressource Application Insights.
3.2 Plateforme et Kubernetes#
| Table | Source | Contenu | Exemple de question |
|---|---|---|---|
AppServiceConsoleLogs |
Web App (Diagnostic setting) | stdout/stderr du conteneur | « Quelle exception au démarrage ? » |
AppServiceHTTPLogs |
Web App | Requêtes HTTP (CsMethod, CsUriStem, ScStatus, TimeTaken) |
« Combien de 502 depuis 9 h ? » |
AppServicePlatformLogs |
Web App | Opérations du conteneur (pull, démarrage, arrêt) | « L'image a-t-elle été tirée ? » |
AppServiceAuthenticationLogs |
Web App | Easy Auth | « Pourquoi la boucle de connexion ? » |
ContainerLogV2 |
ama-logs |
Logs des conteneurs (PodName, PodNamespace, ContainerName, LogMessage, LogLevel) |
« Logs du pod mort il y a 2 h » |
KubePodInventory |
ama-logs |
État des pods, ContainerRestartCount, ContainerStatusReason, ContainerLastStatus |
« Quels pods ont été OOMKilled ? » |
KubeEvents |
ama-logs |
Événements Kubernetes (Reason, Message, ObjectKind) |
« FailedScheduling, FailedMount ? » |
AzureDiagnostics |
Diagnostic settings (Azure OpenAI, AI Search…) | Journaux de ressource (mode « Azure diagnostics ») | « Requêtes AI Search les plus lentes » |
AKSAudit, AKSAuditAdmin, AKSControlPlane |
Diagnostic settings AKS (resource-specific) | Audit et composants du control plane | « Qui a supprimé ce déploiement ? » |
AzureActivity |
Activity log exporté | Opérations de contrôle Azure | « Qui a modifié le Private Endpoint ? » |
Rappels Container Insights :
ContainerLogV2est le schéma par défaut avec l'authentification managed identity et supporte le plan Basic ; les messages de plus de 16 Ko sont tronqués (64 Ko avec le multiligne) ;KubeEventsne contient que les événements Warning sauf réglagecollect_all_kube_events; dans le cluster, un événement ne vit qu'une heure.
4. OpenTelemetry et Application Insights#
4.1 Instrumenter#
# Python, Microsoft OpenTelemetry Distro : traces, métriques et logs vers Application Insights
# La connection string vient de la variable APPLICATIONINSIGHTS_CONNECTION_STRING (jamais en dur en production)
import logging
from microsoft.opentelemetry import use_microsoft_opentelemetry

use_microsoft_opentelemetry(enable_azure_monitor=True, logger_name="api-rag")
logger = logging.getLogger("api-rag")
logger.setLevel(logging.INFO)
# Variables d'environnement du conteneur (Deployment AKS ou app settings Web App)
APPLICATIONINSIGHTS_CONNECTION_STRING=<depuis Key Vault ou config, pas dans Git>
OTEL_SERVICE_NAME=api-rag                       # devient cloud_RoleName / AppRoleName
OTEL_RESOURCE_ATTRIBUTES=service.namespace=chatbot-rh,service.instance.id=$(HOSTNAME)
OTEL_TRACES_SAMPLER=microsoft.rate_limited      # défaut de la Distro : 5 traces/s
OTEL_TRACES_SAMPLER_ARG=5
| Concept OpenTelemetry | Dans Application Insights |
|---|---|
| Span server (requête entrante) | AppRequests |
| Span client (appel sortant HTTP, SDK Azure) | AppDependencies |
| Événement d'exception sur un span | AppExceptions |
| Log (logger nommé) | AppTraces |
| Métrique | AppMetrics (jamais échantillonnée) |
service.name (+ service.namespace) |
AppRoleName (Cloud Role Name), nœud de l'Application map |
| Trace id | OperationId |
| Span id du parent | ParentId |
Points de support :
- Cloud Role Name : si plusieurs services écrivent dans la même ressource Application Insights, Microsoft impose de leur donner des noms distincts ; sinon l'Application map fusionne tout.
- Échantillonnage : la Microsoft OpenTelemetry Distro (.NET, Node.js, Python) échantillonne par défaut à 5 traces par seconde (rate-limited). Sous charge, une requête précise peut ne pas être dans Application Insights. Les métriques ne sont jamais échantillonnées : alerter sur les métriques, investiguer avec les traces.
- Authentification de l'ingestion : si la ressource a
DisableLocalAuth=true, l'identité qui envoie doit avoir Monitoring Metrics Publisher ; sinon 401/403 dans les logs du SDK et aucune donnée. - Latence : la plupart des données arrivent en moins de 5 minutes. Une absence de 2 minutes n'est pas une panne.
4.2 La corrélation W3C#
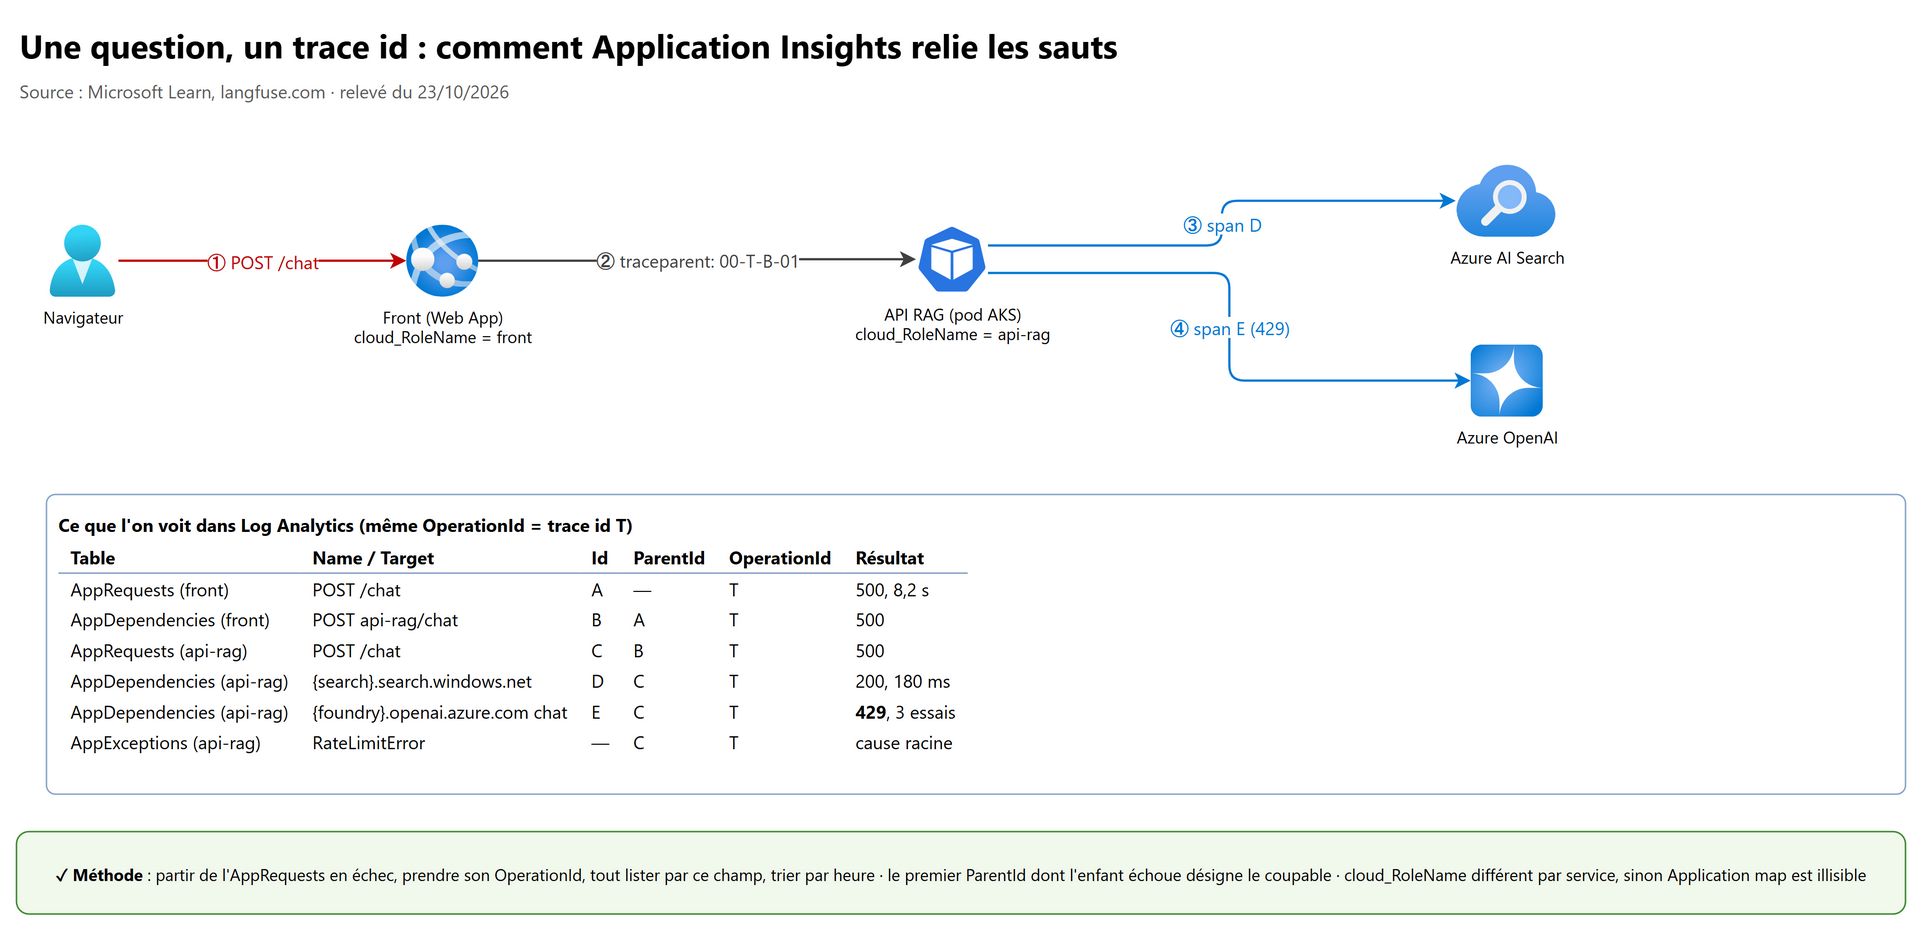
| W3C Trace Context | Application Insights (colonne Log Analytics) |
|---|---|
trace-id (dans traceparent) |
operation_Id (OperationId) |
parent-id du span courant |
id de la request ou dependency (Id) |
parent-id du span parent |
operation_ParentId (ParentId), vide pour la racine |
L'en-tête traceparent: 00-<trace-id>-<parent-id>-<flags> est propagé automatiquement par les instrumentations HTTP. La
corrélation casse quand : un proxy ou une passerelle supprime l'en-tête, un appel passe par une file sans propagation du contexte,
un service n'est pas instrumenté, ou l'échantillonnage n'a gardé qu'une partie de la trace (le sampler Azure Monitor essaie de
garder les traces complètes).
4.3 Les signaux GenAI#
Les frameworks d'agents (Microsoft Agent Framework, Semantic Kernel, LangGraph…) peuvent émettre les OpenTelemetry generative AI
semantic conventions (gen_ai.agent.name, gen_ai.usage.*, gen_ai.input.messages…). Application Insights les exploite dans la
vue Agents (preview) (appels d'agents, appels d'outils, jetons par modèle, erreurs GenAI) et range les contenus dans
AppGenAIContent. Ces conventions sont encore expérimentales côté OpenTelemetry : les attributs peuvent changer.
5. Lire une trace de bout en bout jusqu'à la cause#
La démarche dans le portail, à connaître par cœur :
- Application Insights > Failures (ou Performance pour la lenteur), onglet Server, bonne plage de temps.
- Choisir l'opération (
POST /chat), regarder Top 3 response codes, Top 3 exception types, Top 3 failed dependencies : souvent la réponse est déjà là (ex. « dependency*.openai.azure.com: 429 »). - Drill into > un échantillon Suggested (Microsoft choisit des échantillons complets même avec échantillonnage).
- End-to-end transaction details : diagramme de Gantt de tous les spans, tous services confondus. Le span rouge le plus profond ou le plus long est la piste ; le panneau de détail donne la cible, le code, la durée, la pile d'appels.
- Application map : vue d'ensemble des composants (un nœud par Cloud Role Name), taux d'échec et latence par lien ; Investigate failures depuis un nœud.
- Search (Transaction search) : retrouver une trace par mot clé (identifiant de conversation, utilisateur, message d'erreur).
- View in Logs : passer en KQL pour compter, comparer avant/après un déploiement.
flowchart LR
    F["Failures<br/>Top failed dependencies"] --> D["Drill into<br/>échantillon Suggested"]
    D --> E["End-to-end transaction details<br/>span rouge le plus profond"]
    E --> C{"Cible du span"}
    C -- "Azure OpenAI 429" --> Q["Quota du déploiement<br/>métriques Azure OpenAI"]
    C -- "AI Search 503" --> T["Throttled Search Queries %"]
    C -- "403" --> R["Rôle / DNS<br/>(chapitre 01, section 5)"]
    C -- "Exception dans le code" --> X["Pile d'appels<br/>AppExceptions"]
6. Requêtes KQL prêtes à copier#
À lancer dans Logs du Log Analytics workspace (ou de la ressource Application Insights). Adapter la plage de temps.
// 1. Requêtes en échec par service, opération et code (dernière heure)
AppRequests
| where TimeGenerated > ago(1h)
| summarize Total = count(), Echecs = countif(Success == false) by AppRoleName, Name, ResultCode
| where Echecs > 0
| order by Echecs desc
// 2. Dépendances lentes ou en échec vers AI Search et Foundry / Azure OpenAI
AppDependencies
| where TimeGenerated > ago(1h)
| where Target has_any ("search.windows.net", "openai.azure.com", "cognitiveservices.azure.com", "services.ai.azure.com")
| summarize Appels = count(), Echecs = countif(Success == false),
            P50 = percentile(DurationMs, 50), P95 = percentile(DurationMs, 95)
          by Target, Name, bin(TimeGenerated, 5m)
| order by TimeGenerated desc
// 3. Les 429 vus par l'application, par cible et par service appelant
AppDependencies
| where TimeGenerated > ago(6h) and ResultCode == "429"
| summarize Nb429 = count() by bin(TimeGenerated, 5m), Target, AppRoleName
| render timechart
// 4. Côté service Azure OpenAI (exige un Diagnostic setting RequestResponse vers ce workspace)
//    Commencer par un échantillon pour voir les colonnes remplies, puis filtrer sur le code
AzureDiagnostics
| where ResourceProvider == "MICROSOFT.COGNITIVESERVICES" and Category == "RequestResponse"
| where TimeGenerated > ago(1h)
| summarize count() by ResultSignature, OperationName, bin(TimeGenerated, 5m)
// 5. Exceptions regroupées par problème et par opération
AppExceptions
| where TimeGenerated > ago(24h)
| summarize Nb = count(), Exemple = any(OuterMessage) by ProblemId, AppRoleName, OperationName
| order by Nb desc
// 6. Relier requêtes en échec et dépendances : quelle dépendance fait échouer quelle opération ?
AppRequests
| where TimeGenerated > ago(1h) and Success == false
| project OperationId, Requete = Name, CodeRequete = ResultCode, AppRoleName
| join kind=inner (
    AppDependencies
    | where TimeGenerated > ago(1h) and Success == false
    | project OperationId, Cible = Target, Dependance = Name, CodeDep = ResultCode, DureeDep = DurationMs
  ) on OperationId
| summarize Echecs = count(), DureeMoyenne = avg(DureeDep) by Requete, Cible, CodeDep
| order by Echecs desc
// 7. Tout ce qui s'est passé pour une requête (coller l'OperationId)
union AppRequests, AppDependencies, AppExceptions, AppTraces
| where OperationId == "<operation-id>"
| project TimeGenerated, Type, AppRoleName, Name, Target, ResultCode, DurationMs, Message, OuterMessage, Id, ParentId
| order by TimeGenerated asc
// 8. Pods qui redémarrent (compteur cumulé : comparer au relevé précédent)
KubePodInventory
| where TimeGenerated > ago(1h)
| summarize Restarts = max(ContainerRestartCount) by Namespace, Name, ControllerName
| where Restarts > 0
| order by Restarts desc
// 9. OOMKilled : dernier état des conteneurs tués pour dépassement mémoire
KubePodInventory
| where TimeGenerated > ago(24h)
| extend Dernier = todynamic(ContainerLastStatus)
| where tostring(Dernier.reason) == "OOMKilled"
| summarize DernierOOM = max(TimeGenerated) by Namespace, Name, ControllerName
// 10. Logs d'un pod (même disparu), erreurs d'abord
ContainerLogV2
| where TimeGenerated > ago(30m)
| where PodNamespace == "<namespace>" and PodName startswith "<deployment>"
| where LogLevel in ("ERROR", "CRITICAL") or LogSource == "stderr"
| project TimeGenerated, PodName, ContainerName, LogLevel, LogMessage
| order by TimeGenerated desc
// 11. Événements Kubernetes en Warning (FailedScheduling, FailedMount, BackOff…)
KubeEvents
| where TimeGenerated > ago(1h) and KubeEventType == "Warning"
| project TimeGenerated, Namespace, ObjectKind, Name, Reason, Message
| order by TimeGenerated desc
// 12. Web App : codes HTTP et erreurs de démarrage du conteneur
AppServiceHTTPLogs
| where TimeGenerated > ago(1h)
| summarize Nb = count(), P95 = percentile(TimeTaken, 95) by ScStatus, CsUriStem
| order by Nb desc
// puis : AppServicePlatformLogs | where TimeGenerated > ago(1h) | where Level != "Informational" | project TimeGenerated, OperationName, Message, Exception
// 13. Azure AI Search : requêtes les plus lentes (Diagnostic setting requis)
AzureDiagnostics
| where ResourceProvider == "MICROSOFT.SEARCH" and OperationName == "Query.Search"
| where TimeGenerated > ago(1h)
| project TimeGenerated, IndexName_s, DurationMs, resultSignature_d, Documents_d
| order by DurationMs desc
// 14. Volume ingéré par table (facture, ou « plus rien n'arrive depuis… »)
Usage
| where TimeGenerated > ago(1d)
| summarize Go = sum(Quantity) / 1000 by DataType
| order by Go desc
7. Managed Prometheus et Azure Managed Grafana#
7.1 Le flux des métriques#
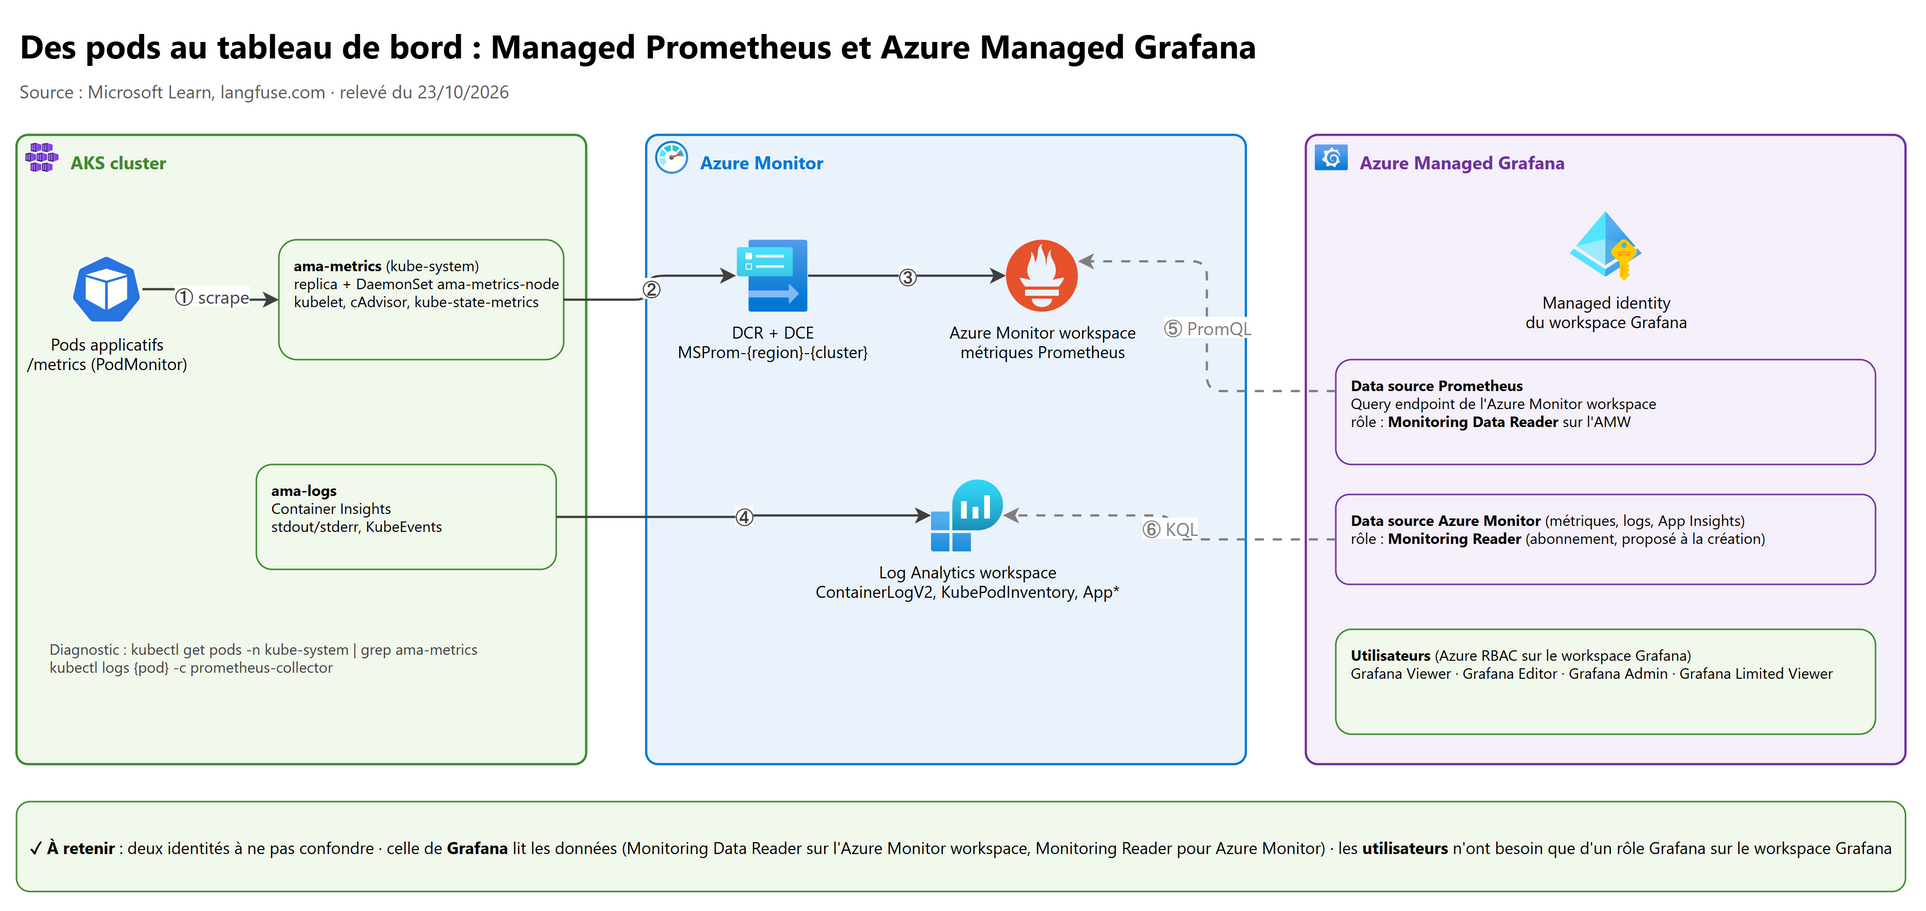
- Les pods
ama-metrics(replicaama-metrics-*, DaemonSetama-metrics-node-*, plusama-metrics-ksmetama-metrics-operator-targets) scrutent les cibles par défaut (cadvisor,kubelet,nodeexporter,kube-state-metrics) et les cibles ajoutées. - Ils envoient via le DCR et le DCE créés à l'activation (
MSProm-<région>-<cluster>) vers l'Azure Monitor workspace. - Grafana, les workbooks, Metrics explorer (PromQL) et les Prometheus alert rules lisent le workspace.
| Réglage | Où | À savoir |
|---|---|---|
| Minimal ingestion profile | ConfigMap ama-metrics-settings-configmap (kube-system) |
Actif par défaut : seules les métriques des tableaux, recording rules et alertes par défaut sont gardées ; une métrique « absente » est souvent filtrée, pas cassée |
| Ajouter une cible applicative | PodMonitor / ServiceMonitor avec l'API group azmonitoring.coreos.com/v1 |
Les CRD de l'opérateur Prometheus open source (monitoring.coreos.com) sont ignorés par l'add-on |
| Configuration Prometheus brute | ConfigMap ama-metrics-prometheus-config |
Nom et clé prometheus-config exacts, sinon ignorée |
| Fréquence de scrape | ConfigMap des réglages | 30 secondes par défaut |
| Limites d'ingestion | Azure Monitor workspace > Metrics | Active Time Series % Utilization, Events Per Minute Received % Utilization sous 100 % |
# Lecture seule : santé de la collecte
kubectl get pods -n kube-system | grep ama-metrics
kubectl logs -n kube-system <pod-ama-metrics> -c prometheus-collector | tail -50
kubectl get podmonitors.azmonitoring.coreos.com,servicemonitors.azmonitoring.coreos.com -A
az aks show -g <rg> -n <aks> --query azureMonitorProfile.metrics
Requêtes PromQL utiles (métriques présentes dans le profil minimal pour les trois premières) :
# Conteneurs qui ont redémarré dans l'heure
sum by (namespace, pod) (increase(kube_pod_container_status_restarts_total[1h])) > 0

# Dernière terminaison pour OOMKilled
kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} == 1

# Pods non prêts
sum by (namespace) (kube_pod_status_ready{condition="false"})

# Mémoire de travail des conteneurs de l'API (si la métrique cAdvisor est collectée)
sum by (pod) (container_memory_working_set_bytes{namespace="<namespace>", container!=""})
7.2 Les deux identités de Grafana#
| Qui | Pour quoi | Rôle Azure | Où l'affecter |
|---|---|---|---|
| Managed identity du workspace Grafana (system- ou user-assigned) | Lire les métriques et journaux Azure Monitor (data source Azure Monitor : métriques, Log Analytics, Application Insights) | Monitoring Reader (proposé par défaut sur l'abonnement à la création, si le créateur peut affecter des rôles) | Abonnement, groupe de ressources ou ressource, au plus étroit |
| Même identité | Lire les métriques Prometheus d'un Azure Monitor workspace | Monitoring Data Reader (action de plan de données, non couverte par Monitoring Reader) | L'Azure Monitor workspace |
| Même identité, cas particulier | La data source ne liste aucun workspace (No Log Analytics workspaces found) | Microsoft suggère d'ajouter Reader sur le Log Analytics workspace | Le workspace |
| Alternative : Current User | Chaque utilisateur interroge avec sa propre identité Entra (recommandé quand la source le supporte) | Les rôles de l'utilisateur sur les données (ex. Log Analytics Reader, Monitoring Reader) | Sources de données |
Les utilisateurs de Grafana, eux, ont un rôle Grafana (Azure RBAC) sur la ressource Azure Managed Grafana :
| Rôle | Peut |
|---|---|
| Grafana Admin | Tout : sources de données, équipes, permissions |
| Grafana Editor | Créer et modifier tableaux de bord, dossiers, alertes |
| Grafana Viewer | Voir les tableaux de bord et interroger les sources |
| Grafana Limited Viewer | Voir la page d'accueil seulement, puis accès accordé tableau par tableau (pas pour les workspaces Grafana v9) |
Les permissions fines (dossier, tableau de bord, source) se gèrent dans Grafana par un Grafana Admin, idéalement via Team Sync avec des groupes Entra. Un Grafana Admin ne peut pas être restreint par une permission de composant.
7.3 Configurer la data source Prometheus#
Dans Grafana : Connections > Data sources > Add data source > Azure Monitor Managed Service for Prometheus (Grafana 13 et plus) ou Prometheus (Grafana 11 et 12) > Prometheus server URL = Query endpoint de l'Azure Monitor workspace > Authentication : Azure Auth > Managed Identity > Save & test. Depuis le portail, Integrations > Bundled Prometheus (Preview) fait ces étapes et crée les rôles.
7.4 Grafana sans Grafana#
Le portail propose Azure Monitor dashboards with Grafana (preview), intégrés et sans coût : utile pour un premier coup d'œil. Azure Managed Grafana reste le choix pour des tableaux multi-sources partagés.
7.5 Pourquoi un tableau affiche « No data » : la checklist#
flowchart TD
    N["Panel : No data"] --> A{"La requête renvoie-t-elle<br/>des données ailleurs ?<br/>(Logs, PromQL dans le portail)"}
    A -- "Non" --> B["Problème de collecte"]
    B --> B1["Diagnostic setting absent ?<br/>Container Insights / Prometheus activés ?"]
    B --> B2["ama-metrics / ama-logs en échec ?<br/>DCR, DCE, AMPLS, DNS privé"]
    B --> B3["Métrique filtrée par le<br/>minimal ingestion profile ?"]
    B --> B4["Application non instrumentée,<br/>mauvaise connection string,<br/>échantillonnage, DisableLocalAuth"]
    A -- "Oui" --> C["Problème d'affichage<br/>ou d'accès Grafana"]
    C --> C1["Variables du tableau vides :<br/>abonnement, ressource, cluster"]
    C --> C2["Identité Grafana sans<br/>Monitoring Reader / Monitoring Data Reader"]
    C --> C3["Mauvaise data source<br/>(autre workspace)"]
    C --> C4["Plage de temps, label<br/>cluster (cluster_alias)"]
    C --> C5["Grafana privé :<br/>Private Endpoint, DNS"]
| Vérification | Comment (lecture seule) |
|---|---|
| La donnée existe-t-elle ? | Lancer la même requête dans Logs ou Metrics (PromQL) du portail |
| La data source fonctionne-t-elle ? | Grafana > data source > Save & test ; pour Azure Monitor, Load Subscriptions doit remplir l'abonnement |
| L'identité a-t-elle les rôles ? | az role assignment list --assignee <principal-id-grafana> --all -o table |
| Les variables du tableau sont-elles remplies ? | Listes déroulantes en haut (abonnement, groupe de ressources, ressource) |
| La collecte tourne-t-elle ? | kubectl get pods -n kube-system | grep ama- ; logs prometheus-collector (« No configuration present for the AKS resource » = DCR/DCE ou workspace manquants) |
| La métrique est-elle collectée ? | Liste du profil minimal ; mode debug des ama-metrics (port 9091) en dernier recours, et après accord |
| Limite d'ingestion atteinte ? | Métriques d'utilisation de l'Azure Monitor workspace |
Le label cluster correspond-il ? |
cluster_alias dans la ConfigMap : les tableaux filtrent sur ce label |
8. Langfuse : la trace vue par le LLM#
8.1 Le modèle de données#
| Objet | Sens | Exemple |
|---|---|---|
| Trace | Une requête ou une opération ; regroupe les observations qui partagent le même trace_id |
Une question posée au chatbot |
| Observation | Une étape, imbriquable ; types : span, generation, event, agent, tool, chain, retriever, evaluator, embedding, guardrail |
retriever (recherche AI Search), generation (appel du modèle) |
| Session | Regroupement optionnel de traces d'une même interaction | Une conversation |
| User, tags, metadata, environment | Attributs de trace recopiés sur chaque observation | user_id, production / staging |
| Usage details / Cost details | Unités consommées et coût en USD par type d'usage, sur les observations generation et embedding |
input, output, cached |
| Score | Évaluation NUMERIC, CATEGORICAL, BOOLEAN ou TEXT, attachée à une trace, une observation, une session ou un dataset run |
Feedback 👍/👎, LLM-as-a-Judge « fidélité aux sources » |
Jetons et coût : Langfuse prend en priorité les valeurs ingérées (renvoyées par l'API du modèle) ; à défaut il les
infère (tokenizer et définition de modèle avec ses prix, rattachée par un match_pattern). Un coût à zéro signifie souvent un
modèle non reconnu (nom de déploiement Azure différent du nom du modèle) : il faut une définition de modèle personnalisée.
8.2 Comment les données arrivent#
| Voie | Détail |
|---|---|
| SDK Python ou JS/TS | Variables LANGFUSE_PUBLIC_KEY, LANGFUSE_SECRET_KEY, LANGFUSE_BASE_URL (URL de l'instance) ; envoi asynchrone par lots ; appeler flush() dans les processus courts (jobs d'ingestion, scripts) |
| Intégrations | Remplacement de l'import OpenAI (from langfuse.openai import openai), LangChain, LlamaIndex… |
| OpenTelemetry (OTLP) | Endpoint /api/public/otel (traces : /api/public/otel/v1/traces) ; HTTP uniquement (JSON ou protobuf), pas de gRPC ; authentification Basic (clé publique:clé secrète en base64) ; en-tête x-langfuse-ingestion-version: 4 pour l'ingestion en temps réel (sinon jusqu'à 10 minutes de délai) ; attributs gen_ai.* mappés, attributs langfuse.* prioritaires |
| Masquage | Côté application avant export : mask_otel_spans (Python, recommandé) ou mask ; dans un OpenTelemetry Collector sinon. Indispensable si les prompts contiennent des données personnelles |
8.3 Langfuse auto-hébergé#
Langfuse (version 4 au 23/10/2026) est open source : tout ce qui est hors des dossiers /ee est sous licence MIT ; les
modules Enterprise (SCIM, audit étendu, politiques de rétention) demandent une licence. Composants :
| Composant | Rôle | Panne typique |
|---|---|---|
| Langfuse Web | Interface et API (dont l'ingestion) | 401 (clés), 4xx sur /api/public/otel si version trop ancienne (endpoint OTLP apparu en v3.22.0) |
| Langfuse Worker | Traitement asynchrone des événements | Traces qui n'apparaissent pas alors que l'API répond 200 |
| PostgreSQL | Données transactionnelles | Connexion, migrations |
| ClickHouse | Traces, observations, scores (OLAP) | Disque plein, requêtes lentes dans l'UI |
| Redis / Valkey | File d'attente et cache | File qui grossit |
| Stockage objet (S3 / Blob) | Événements bruts, médias, exports | Droits d'écriture |
Déploiement : Docker Compose pour tester, Helm sur Kubernetes pour la production, module Terraform
langfuse-terraform-azure pour Azure. Sur AKS, on le diagnostique comme
n'importe quelle application : kubectl get pods -n <ns-langfuse>, kubectl logs du web et du worker.
8.4 Application Insights ou Langfuse ?#
| Question | Application Insights | Langfuse |
|---|---|---|
| La requête a-t-elle échoué, où ? | Oui (requests, dependencies, exceptions, map) | Partiellement (erreurs d'observation) |
| Corrélation avec l'infra (pods, Web App, AI Search) | Oui (même workspace, KQL) | Non |
| Quel prompt exact, quels chunks, quelle réponse ? | Possible (AppGenAIContent), sensible |
Oui, c'est son objet |
| Jetons et coût par utilisateur, session, fonctionnalité | Métriques à construire | Oui (usage, cost, filtres) |
| Qualité de la réponse (scores, feedback, LLM-as-a-Judge) | Non natif | Oui |
| Gestion et versions des prompts, jeux de test | Non | Oui |
| Alertes et intégration au NOC Azure | Oui | Limitée |
Le bon réflexe : Application Insights pour la santé et la cause technique, Langfuse pour le comportement du modèle. On relie les deux par un identifiant commun (trace id W3C si Langfuse reçoit l'OTLP, ou identifiant de session ou de requête ajouté en metadata).
8.5 « Rien n'arrive dans Langfuse »#
| Cause | Vérification |
|---|---|
| Mauvaises clés ou mauvais projet | LANGFUSE_PUBLIC_KEY / SECRET_KEY du bon projet ; 401 dans les logs du SDK |
| Mauvaise URL | LANGFUSE_BASE_URL pointe vers l'instance auto-hébergée (DNS privé résolu depuis le pod) |
Processus court sans flush() |
Job d'ingestion qui se termine avant l'envoi du lot |
| Sortie réseau bloquée | Network Policy, pare-feu ; test de résolution et de port depuis le pod |
| OTLP en gRPC | Non supporté : passer en HTTP/protobuf |
| Délai d'ingestion OTLP | En-tête x-langfuse-ingestion-version: 4 absent |
| Worker arrêté ou file saturée | Pods du worker, Redis |
9. Alerter#
| Type d'alerte | Évalue | Exemple pour le chatbot |
|---|---|---|
| Metric alert | Platform metrics, métriques Application Insights (dynamic thresholds possibles) | Throttled Search Queries Percentage > 5 %, Azure OpenAI Requests en 429, Http5xx de la Web App |
| Log search alert | Une requête KQL à fréquence fixe (coût selon la fréquence) | Taux d'échec de POST /chat > 5 % sur 10 min |
| Simple log search alert | Chaque ligne individuellement | Chaque exception ForbiddenByRbac |
| Activity log alert | Une opération de contrôle, Service Health, Resource Health | Suppression d'un Private Endpoint, incident Azure OpenAI dans la région |
| Smart detection | Anomalies Application Insights (Failure Anomalies) | Pic d'échecs inhabituel |
| Prometheus alert | Une règle PromQL dans un rule group | KubePodCrashLooping, KubeContainerOOMKilledCount (Recommended alert rules AKS) |
Chaque règle déclenche un Action group (e-mail, SMS, Teams, webhook, ITSM). Bonnes pratiques :
- alerter sur les métriques (moins cher, plus rapide, non échantillonnées), investiguer avec les journaux ;
- une alerte doit appeler une action : sinon c'est un rapport, pas une alerte ;
- démarrer avec les Recommended alert rules du cluster AKS (AKS 05, section 1.4) et l'Azure Monitor Baseline Alerts (AMBA) ;
- pour Azure OpenAI, distinguer les 429 : quota du déploiement dépassé, capacité du service, réduction temporaire de limite sur
les déploiements Standard, ou
max_tokenstrop grand qui consomme le budget de débit (détail au chapitre 02).
Le socle minimal pour un chatbot :
| Signal | Source | Seuil de départ (à ajuster) |
|---|---|---|
Taux d'échec des requêtes POST /chat |
Application Insights (métrique Failed requests) | > 5 % sur 10 min |
Latence P95 de POST /chat |
Application Insights | > objectif métier (ex. 15 s) |
| 429 vers Azure OpenAI | Métrique Azure OpenAI split par StatusCode |
> 0 en continu sur 15 min |
| Throttling AI Search | Throttled Search Queries Percentage | > 5 % |
| Pods en CrashLoop, OOMKilled, non prêts | Prometheus (Recommended alert rules) | Règles par défaut |
| Web App 5xx | Métrique Http Server Errors | > N par 5 min |
| Coût LLM par jour | Langfuse (ou métriques de jetons) | Budget |
10. Pièges de production#
| Piège | Effet | Parade |
|---|---|---|
| Diagnostic settings oubliés sur Azure OpenAI et AI Search | Aucune trace côté service le jour de l'incident | Les déployer avec l'IaC ou par Azure Policy |
| Deux services avec le même Cloud Role Name | Application map inutilisable | OTEL_SERVICE_NAME distinct par service |
| Échantillonnage oublié | « La requête de l'utilisateur n'est pas dans App Insights » | Le dire, chercher par Langfuse ou par les logs ; alerter sur les métriques |
DisableLocalAuth activé sans rôle |
Plus aucune télémétrie, en silence | Monitoring Metrics Publisher pour l'identité émettrice |
AMPLS ou zone privatelink.monitor.azure.com modifiée |
Télémétrie coupée pour tout le VNet | Tester la résolution des endpoints d'ingestion depuis l'app |
ContainerLog encore utilisé |
Table hors support depuis le 30/09/2026 | Migrer les requêtes et alertes vers ContainerLogV2 |
Requêtes sur AppDependencies pour lire les prompts |
Après le 31/10/2026, la valeur n'y est plus | Lire AppGenAIContent (table protégée) |
| Grafana : Monitoring Reader seul | Tableaux Prometheus vides | Monitoring Data Reader sur l'Azure Monitor workspace |
PodMonitor en monitoring.coreos.com |
Ignoré par Managed Prometheus | azmonitoring.coreos.com/v1 |
| Prompts avec données personnelles envoyés partout | Fuite dans Langfuse ou App Insights | Masquage à la source, tables protégées, rétention courte |
11. Lab : suivre une requête en échec en lecture seule#
Sur un environnement de test (ou en production, en lecture seule, après avoir vérifié le contexte) :
- Contexte :
az account show; identifier le Log Analytics workspace et la ressource Application Insights du projet. - Failures : Application Insights > Failures > dernière heure > repérer l'opération et la dépendance en échec.
- Transaction details : ouvrir un échantillon Suggested, noter l'
OperationId, le span fautif, le code. - KQL : lancer les requêtes 6 et 7 de la section 6 avec cet
OperationId. - Côté service : métriques de la cible (Azure OpenAI ou AI Search) sur la même fenêtre.
- Côté plateforme : requêtes 8 à 11 (pods) ou 12 (Web App) sur la même fenêtre.
- Langfuse : retrouver la trace de la même conversation (même heure, même utilisateur) ; lire le prompt, les chunks, les jetons.
- Grafana : ouvrir le tableau Kubernetes du cluster ; vérifier que les restarts et la mémoire concordent.
- Rédiger : chronologie UTC, saut fautif, preuve (requête KQL, capture), cause probable, action proposée, sans rien modifier.
Résultat attendu : une fiche d'incident que le N3 ou le support Microsoft peut reprendre sans poser de question.
12. Questions d'entretien#
1. Log Analytics, Application Insights, Log stream : quelle différence ?
Log Analytics est le magasin de journaux interrogé en KQL. Application Insights est la couche APM, workspace-based : ses données sont dans les tables
App*du workspace, avec des vues dédiées (Failures, transaction details, Application map). Le Log stream est un flux temps réel des journaux d'une Web App, sans requête ni historique propre : on l'ouvre quand le conteneur ne démarre pas.
2. Comment suivez-vous une requête à travers le front, l'API et Azure OpenAI ?
Chaque service est instrumenté en OpenTelemetry ; le contexte W3C (
traceparent) est propagé ; le trace id devient l'OperationId. Je pars de l'AppRequestsen échec, je liste tout ce qui partage l'OperationId, la première dépendance en erreur est la cause. Dans le portail : Failures, Drill into, End-to-end transaction details.
3. L'utilisateur donne l'heure exacte, mais sa requête n'est pas dans Application Insights. Pourquoi ?
Échantillonnage (5 traces par seconde par défaut dans la Microsoft OpenTelemetry Distro), délai d'ingestion, service non instrumenté, mauvaise connection string, ingestion refusée (
DisableLocalAuthsans Monitoring Metrics Publisher) ou télémétrie privée cassée (AMPLS, DNS). Je vérifie l'arrivée de télémétrie récente pour ceAppRoleName, puis les logs de l'application.
4. Écrivez la requête qui montre les 429 vers Azure OpenAI.
AppDependencies | where ResultCode == "429" | summarize count() by bin(TimeGenerated, 5m), Target, AppRoleName, puis côté service la métrique des requêtes Azure OpenAI split parStatusCode, etretry-after-msdans la réponse. Ensuite je distingue quota du déploiement, capacité du service etmax_tokenstrop élevé.
5. Un pod redémarre en boucle. Quelles données regardez-vous ?
kubectl describe podetkubectl logs --previousd'abord ; puisKubePodInventory(restarts,ContainerLastStatuspour OOMKilled),ContainerLogV2pour les logs avant le crash,KubeEventsen Warning, et dans Prometheuskube_pod_container_status_restarts_totalpour la tendance.
6. Un tableau Grafana affiche « No data ». Votre démarche ?
Je sépare collecte et affichage : la même requête renvoie-t-elle des données dans le portail ? Si non, collecte (Diagnostic setting, agents, profil minimal, instrumentation). Si oui, Grafana : variables vides, mauvaise data source, rôles de la managed identity (Monitoring Reader pour Azure Monitor, Monitoring Data Reader sur l'Azure Monitor workspace pour Prometheus), plage de temps, label
cluster.
7. Quels rôles faut-il à Grafana, et aux utilisateurs ?
L'identité de Grafana lit les données : Monitoring Reader (abonnement ou plus étroit) et Monitoring Data Reader sur l'Azure Monitor workspace. Les utilisateurs n'ont qu'un rôle Grafana sur la ressource : Viewer, Editor, Admin ou Limited Viewer.
8. À quoi sert Langfuse si vous avez Application Insights ?
Application Insights dit où et pourquoi ça casse techniquement. Langfuse montre ce que le modèle a reçu et répondu, les jetons, le coût, les scores de qualité et le feedback, par conversation et par utilisateur. Pour un « le bot répond n'importe quoi », c'est Langfuse ; pour un « le bot répond 500 », Application Insights.
9. Comment maîtrisez-vous le coût de l'observabilité ?
Métriques Prometheus plutôt que métriques en journaux,
ContainerLogV2en Basic si on n'alerte pas dessus, échantillonnage des traces, filtrage à l'ingestion (DCR transformations), rétention par table, et surveillance de la tableUsage.
10. Sur quoi alertez-vous pour un chatbot ?
Taux d'échec et latence P95 de l'endpoint de chat, 429 Azure OpenAI, throttling AI Search, pods en CrashLoop ou OOMKilled, 5xx de la Web App, et un budget de coût LLM. Des alertes sur métriques autant que possible, chacune avec une action définie.
11. Que change l'échéance du 31 octobre 2026 pour Application Insights ?
Les contenus GenAI (prompts, réponses, appels d'outils) ne sont plus écrits dans
AppDependencies,AppTracesetAppEventsmais seulement dansAppGenAIContent, une table que l'on peut protéger. Les requêtes et classeurs qui lisaient ces attributs doivent être revus.
12. Pourquoi une métrique Prometheus « classique » est-elle absente ?
Le minimal ingestion profile ne garde que les métriques des tableaux, recording rules et alertes par défaut. Il faut l'ajouter à la keep list de la cible dans
ama-metrics-settings-configmap, ou la cible n'est pas scrutée (PodMonitor avec le mauvais API group).
13. Fiche à retenir#
- Trois magasins : Log Analytics workspace (KQL), Azure Monitor Metrics, Azure Monitor workspace (PromQL).
- Platform metrics et Activity log : automatiques ; journaux de ressource : Diagnostic setting ; télémétrie applicative : instrumentation.
- Application Insights workspace-based : tables
AppRequests,AppDependencies,AppExceptions,AppTraces,AppEvents,AppMetrics,AppGenAIContent; colonnesOperationId,ParentId,AppRoleName. - Trace id W3C =
operation_Id;traceparentpropagé ; Cloud Role Name distinct par service. - Microsoft OpenTelemetry Distro : connection string en variable, 5 traces/s par défaut, métriques jamais échantillonnées.
- Failures → Drill into → End-to-end transaction details → span fautif ; Application map pour la vue d'ensemble.
- Log stream : temps réel, exige la journalisation filesystem, passe par le site SCM.
- Container Insights :
ContainerLogV2,KubePodInventory,KubeEvents(Warning par défaut) ;ContainerLoghors support. - Managed Prometheus :
ama-metrics, DCR/DCEMSProm-…, profil minimal,azmonitoring.coreos.com/v1. - Grafana : managed identity avec Monitoring Reader et Monitoring Data Reader ; utilisateurs Grafana Viewer / Editor / Admin / Limited Viewer.
- « No data » : d'abord « la donnée existe-t-elle ? », ensuite l'affichage et les rôles.
- Langfuse : trace, observations (generation, retriever, tool…), sessions, scores ; usage et coût ingérés ou inférés ; OTLP HTTP
sur
/api/public/otel, pas de gRPC ; masquer avant d'envoyer. - Alerter sur les métriques ; investiguer avec les journaux.
Références#
Relevé du 23/10/2026 :
- Application Insights : Enable OpenTelemetry, Configure OpenTelemetry, Sampling, Telemetry data model, Investigate failures, performance and transactions, Application map, Microsoft Entra authentication, Monitor AI agents (Agents view), FAQ, Managed workspaces, Create workspace-based resources, Filter telemetry with DCR
- W3C correlation (JavaScript SDK configuration) et Azure Monitor OpenTelemetry Distro pour Python
- Troubleshoot missing application telemetry
- Log Analytics : table plans et coûts, Logs overview, data retention, configure a table plan, tables index
- Tables : ContainerLogV2, KubePodInventory, KubeEvents, AppServiceHTTPLogs, AppServicePlatformLogs, AppServiceConsoleLogs, AppGenAIContent
- Container Insights : ContainerLogV2 schema, query container logs, Monitor AKS, Kubernetes events
- Managed Prometheus : overview, default configuration, ConfigMap, CRD PodMonitor/ServiceMonitor, troubleshoot, connect Grafana, Private Link for Kubernetes
- Azure Managed Grafana : Azure Monitor access, connect an Azure Monitor workspace, users and roles, data sources, troubleshoot, secure, bundled Prometheus (preview), Team Sync, Azure built-in roles (Monitor)
- Alertes : overview, types, Prometheus alerts
- Services IA : Azure OpenAI monitoring data reference, Monitor Azure OpenAI, Azure OpenAI quota et 429, Monitor AI Search queries, AI Search monitoring reference, AI Search performance analysis
- App Service : diagnostic logs et Log stream, monitoring data reference, agentic web apps (AI preview blade)
- Langfuse (langfuse.com) : data model, observation types, token and cost tracking, scores, evaluation overview, OpenTelemetry, get started, masking, self-hosting, déploiement Azure, open source et licence
- OpenTelemetry : GenAI semantic conventions