

Version : 1.0 · Date : 2026-10-21
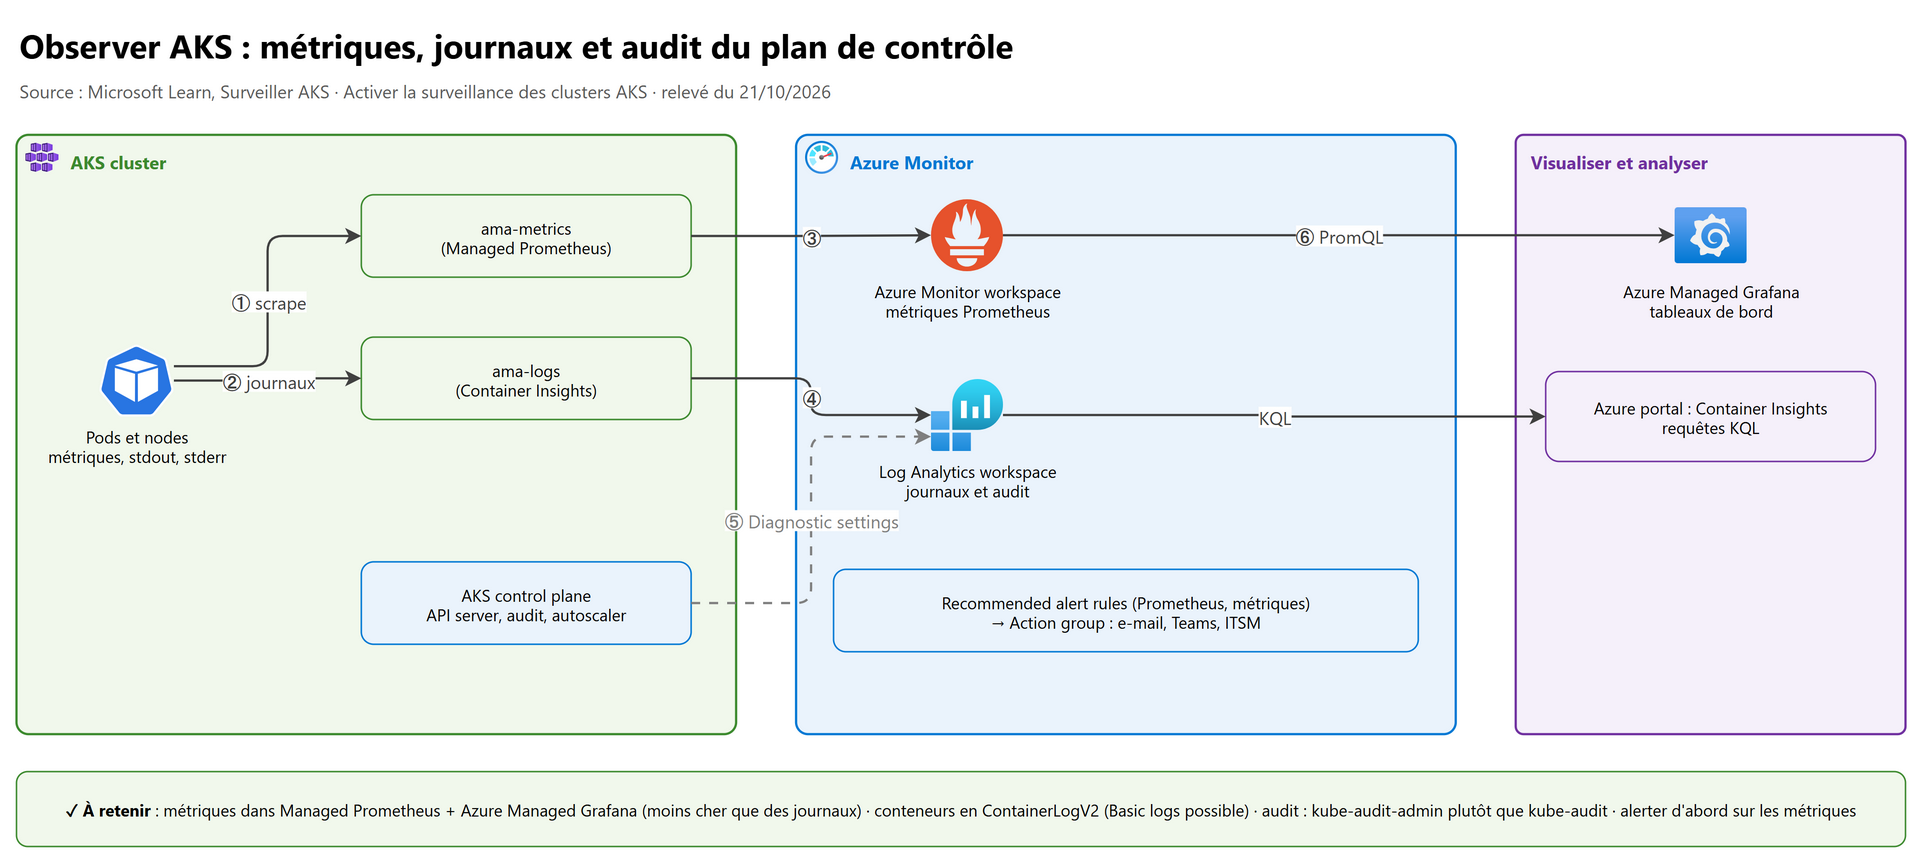
En une phrase : un cluster AKS s'observe avec trois flux séparés (métriques dans Managed Prometheus, journaux dans Container Insights, audit du control plane par Diagnostic settings), se déploie en pull depuis Git (Flux ou Argo CD) plutôt qu'en push depuis un pipeline, se décrit en trois couches d'IaC aux cycles de vie distincts, et s'exploite à l'échelle avec Azure Kubernetes Fleet Manager.
Ce que tu dois savoir expliquer en entretien#
| Question type | Section |
|---|---|
| « Comment supervisez-vous un cluster ? Où vont les métriques, les journaux, l'audit ? Combien ça coûte ? » | 1 |
| « Push ou pull ? Pourquoi GitOps ? Flux ou Argo CD ? » | 2 |
| « Comment organisez-vous votre IaC pour AKS ? » | 3 |
| « Comment mettez-vous à jour 30 clusters ? » | 4 |
| « Comment réduisez-vous la facture AKS ? » | 5 |
| « Un pod est en CrashLoopBackOff, un node NotReady, les appels sortants échouent : que faites-vous ? » | 7 |
1. Observer#
1.1 Trois flux, trois destinations#
| Signal | Collecteur | Destination | Visualisation |
|---|---|---|---|
| Métriques (nodes, pods, Kubernetes, applications au format Prometheus) | ama-metrics (Azure Monitor managed service for Prometheus) |
Azure Monitor workspace | Azure Managed Grafana, PromQL |
| Journaux des conteneurs et événements | ama-logs (Container Insights, Azure Monitor Agent) |
Log Analytics workspace : ContainerLogV2, KubeEvents, KubePodInventory… |
Container Insights, KQL |
| Journaux du control plane (API server, audit, scheduler, autoscaler) | Aucun agent : Diagnostic settings sur la ressource AKS | Log Analytics workspace (AKSAudit, AKSAuditAdmin, AKSControlPlane) |
KQL, Microsoft Sentinel |
| Opérations Azure (création, mise à niveau, changement de configuration) | Activity log | Log Analytics workspace (AzureActivity) |
KQL |
| Télémétrie applicative (traces, dépendances) | Instrumentation OpenTelemetry dans le code | Application Insights | Application Map, traces |
En AKS Automatic, Managed Prometheus, Container Insights et les tableaux de bord Grafana sont actifs par défaut ; en AKS Standard, on les active (portail, onglet Monitoring, CLI, Terraform ou Azure Policy).
# Métriques Prometheus (crée ou relie un Azure Monitor workspace) et journaux Container Insights
az aks update -g <rg> -n <cluster> --enable-azure-monitor-metrics
az aks enable-addons -g <rg> -n <cluster> -a monitoring --workspace-resource-id <id-log-analytics>
1.2 Container Insights : maîtriser le volume#
| Logging profile (cost preset) | Fréquence | Filtre de namespaces | Données |
|---|---|---|---|
| Logs and Events (défaut) | 1 min | Aucun | ContainerLogV2, KubeEvents, KubePodInventory |
| Syslog | 1 min | Aucun | Toutes les tables standard + Syslog |
| Standard | 1 min | Aucun | Toutes les tables standard |
| Cost-optimized | 5 min | Exclut kube-system, gatekeeper-system, azure-arc |
Toutes les tables standard |
Leviers de coût recommandés par Microsoft :
- ContainerLogV2 (schéma recommandé) : compatible avec le plan Basic logs, beaucoup moins cher à l'ingestion, au prix d'alertes plus limitées ;
- ne pas collecter dans Container Insights les métriques déjà fournies par Managed Prometheus (Azure Advisor l'annonce jusqu'à 80 % moins cher que des métriques stockées en journaux) : preset Logs and Events ;
- choisir le resource-specific mode pour les journaux du control plane, puis passer
AKSAuditen Basic logs.
1.3 Les journaux du control plane#
Ils ne sont pas collectés tant qu'aucun Diagnostic setting n'existe. Catégories principales :
| Catégorie | Contenu | Table (resource-specific) |
|---|---|---|
kube-audit |
Tous les appels à l'API, y compris get et list |
AKSAudit |
kube-audit-admin |
Les appels qui modifient (sans get/list) : bien moins volumineux |
AKSAuditAdmin |
guard |
Authentification Microsoft Entra ID et décisions Azure RBAC | AKSControlPlane |
kube-apiserver, kube-controller-manager, kube-scheduler |
Composants du control plane | AKSControlPlane |
cluster-autoscaler |
Pourquoi le cluster a grandi ou rétréci | AKSControlPlane |
cloud-controller-manager, pilotes CSI, Karpenter (NAP) |
Intégration Azure, stockage, provisionnement | AKSControlPlane |
Piège de coût :
kube-auditpeut coûter très cher. Choisirkube-audit-admin(plusguard) sauf obligation de tracer les lectures. L'architecture de référence PCI DSS d'AKS activecluster-autoscaler,kube-controller-manager,kube-audit-adminetguard, avec 90 jours de rétention.
// Qui a modifié quoi dans le cluster (resource-specific mode)
AKSAuditAdmin
| where TimeGenerated > ago(24h)
| summarize count() by User = tostring(User.username), Verb = Verb, Resource = tostring(ObjectRef.resource)
| order by count_ desc

// Événements du Cluster Autoscaler
AKSControlPlane
| where Category == "cluster-autoscaler"
| project TimeGenerated, Message
Les colonnes utilisées (User et ObjectRef dynamiques, Verb) sont celles de la référence de la table AKSAuditAdmin, qui
exige le resource-specific mode du Diagnostic setting. Les requêtes d'exemple de Microsoft excluent les refus avec
ResponseStatus.code != 401.
1.4 Alerter#
Commencer par les Recommended alert rules du cluster (menu Alerts > Set up recommendations) : des règles Prometheus (niveaux cluster, node, pod) et des alertes de métriques plateforme, reliées à un Action group (e-mail, SMS, Teams, ITSM).
| Signal | Règle recommandée | Condition |
|---|---|---|
| Pods qui redémarrent en boucle | KubePodCrashLooping |
Un pod en CrashLoopBackOff depuis 15 min |
| Redémarrages | KubePodContainerRestart |
Au moins un redémarrage dans l'heure |
| Disponibilité d'un déploiement | KubePodReadyStateLow |
Moins de 80 % de pods prêts pendant 5 min |
| Node perdu | KubeNodeUnreachable |
Node injoignable depuis 15 min |
| Mémoire | KubeContainerOOMKilledCount |
Conteneurs tués pour dépassement mémoire |
| Volumes | KubePVUsageHigh |
PV rempli à plus de 80 % pendant 15 min |
| Autoscaling saturé | KubeHpaMaxedOut |
HPA au maximum depuis 15 min |
| Control plane | Métriques etcd_mvcc_db_total_size_in_use_in_bytes, apiserver_request_total |
etcd au-delà de 2 Go, erreurs 429, 500, 503 |
Règle d'architecte : alerter sur les métriques plutôt que sur les journaux (moins cher, plus rapide), garder les journaux pour l'investigation. Pour l'observabilité réseau (flux entre pods, DNS, pertes de paquets), voir le chapitre 02 (Container Network Observability).
2. Déployer : CI/CD et GitOps#
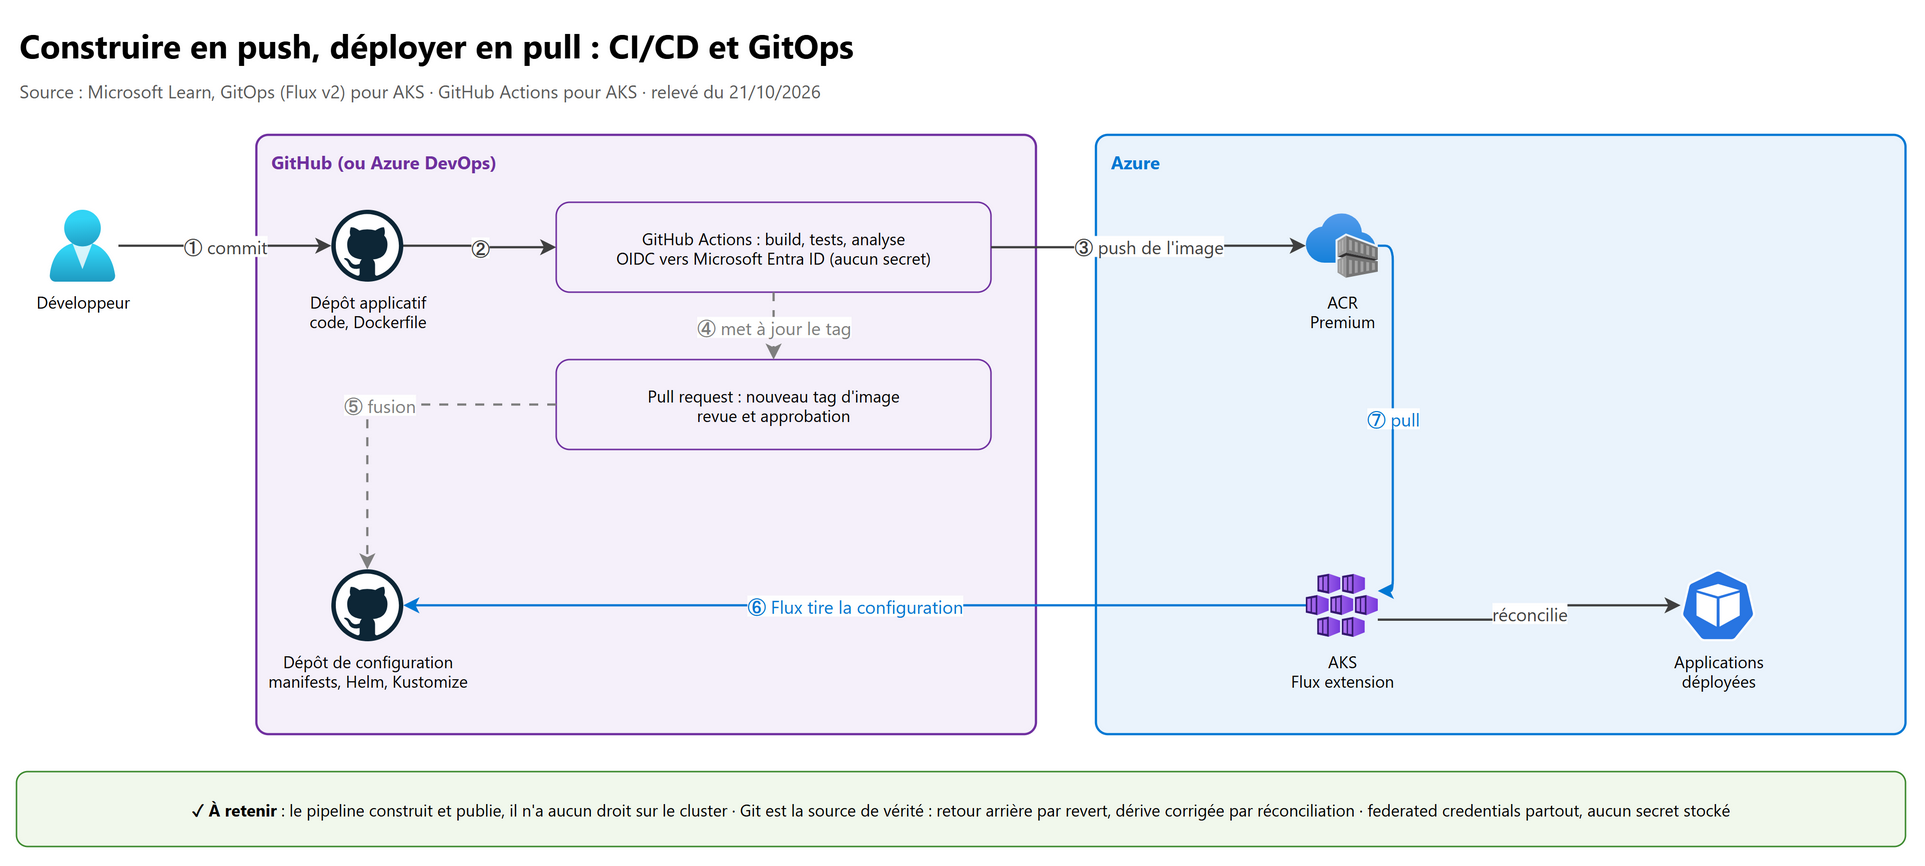
2.1 Push ou pull#
| Push (le pipeline applique) | Pull / GitOps (le cluster tire) | |
|---|---|---|
| Qui parle au cluster | Le pipeline, avec des droits sur l'API Kubernetes | Un agent dans le cluster (Flux, Argo CD) |
| Accès entrant | Le pipeline doit joindre l'API server (difficile en private cluster) | Aucun : le cluster sort vers Git et l'ACR |
| Dérive | Non détectée entre deux déploiements | Réconciliation continue : un changement manuel est annulé |
| Retour arrière | Relancer un ancien pipeline | git revert |
| Audit | Journaux du pipeline | Historique Git + revues de pull request |
| Multi-cluster | Un déploiement par cluster | Chaque cluster suit le même dépôt |
Le schéma recommandé : CI en push (build, tests, analyse, signature, publication dans Azure Container Registry), CD en pull (une pull request met à jour le tag d'image dans le dépôt de configuration, Flux ou Argo CD l'applique).
Pipeline CI avec fédération OIDC, sans aucun secret Azure stocké dans GitHub (identifiant fédéré sur une App registration ou une user-assigned managed identity, voir le chapitre 03 et le cours SC-500) :
# .github/workflows/ci.yml : construit l'image dans ACR et propose le nouveau tag au dépôt de configuration
on: { push: { branches: [main] } }
permissions:
  id-token: write      # jeton OIDC pour Microsoft Entra ID
  contents: read
jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: azure/login@v2
        with:
          client-id: ${{ vars.AZURE_CLIENT_ID }}
          tenant-id: ${{ vars.AZURE_TENANT_ID }}
          subscription-id: ${{ vars.AZURE_SUBSCRIPTION_ID }}
      - name: Build et push dans ACR
        run: az acr build --registry ${{ vars.ACR_NAME }} --image api:${{ github.sha }} .
      # Étape suivante : ouvrir une pull request sur le dépôt de configuration avec le tag api:${{ github.sha }}
Pour un déploiement en push (petites équipes, cluster public), Microsoft fournit les actions azure/aks-set-context,
azure/setup-kubectl, azure/setup-helm, azure/k8s-bake et azure/k8s-deploy. Le portail propose aussi les Automated
deployments (génération du Dockerfile, des manifestes et du workflow) et l'outil Draft.
2.2 Helm ou Kustomize#
| Helm | Kustomize | |
|---|---|---|
| Principe | Paquet (chart) + gabarits + values.yaml |
Base YAML + superpositions (overlays) par environnement, sans gabarit |
| Forces | Distribution de logiciels tiers, versions, dépendances | Lisible, aucun langage de gabarit, intégré à kubectl -k |
| Usage typique | Socle tiers (ingress, cert-manager, observabilité) | Applications internes, variantes dev/recette/prod |
Les deux se combinent : Flux applique des Kustomization et des HelmRelease.
2.3 GitOps avec Flux v2 (cluster extension)#
GitOps s'active comme cluster extension microsoft.flux (installée automatiquement à la première fluxConfiguration) :
- contrôleurs source, kustomize, helm, notification (et, en option,
image-reflectoretimage-automationpour suivre les nouvelles images) dans le namespaceflux-system; - agents Azure
fluxconfig-agentetfluxconfig-controller, qui reflètent l'état de conformité dans le portail ; - une ressource Azure
fluxConfigurations= une source (Git, Helm, bucket, Azure Blob Storage) + une ou plusieursKustomization, avec dépendances entre elles ; - portée
clusterounamespace; multi-tenancy appliquée par défaut (les objets doivent être dans le namespace de la configuration) ; - versions prises en charge : la dernière et les deux précédentes (N-2).
# Deux kustomizations : infra d'abord, applications ensuite ; prune supprime ce qui disparaît du dépôt
az k8s-configuration flux create -g <rg> -c <cluster> -t managedClusters \
  -n cluster-config --namespace cluster-config --scope cluster \
  -u https://github.com/<org>/<depot-config> --branch main \
  --kustomization name=infra path=./infrastructure prune=true \
  --kustomization name=apps path=./apps/production prune=true dependsOn=\["infra"\]
# Un HelmRelease géré par Flux (dans le dépôt de configuration)
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: ingress-nginx
  namespace: cluster-config
spec:
  interval: 10m
  chart:
    spec:
      chart: ingress-nginx
      version: "4.x"
      sourceRef: { kind: HelmRepository, name: ingress-nginx }
  values:
    controller: { replicaCount: 3 }
2.4 Argo CD (cluster extension)#
L'extension Microsoft.ArgoCD est en disponibilité générale pour AKS (préversion pour Azure Arc) : objets Application et
ApplicationSet, interface web, Workload Identity pour lire ACR ou Azure DevOps sans secret, SSO Microsoft Entra ID.
Le mode haute disponibilité (Redis HA) est le défaut et demande au moins 4 nodes (redis-ha.enabled=false sinon).
| Flux v2 | Argo CD | |
|---|---|---|
| Modèle | Contrôleurs légers, tout en CRD, sans interface | Interface web riche, visualisation de l'état et de la dérive |
| Multi-cluster | Une configuration par cluster (souvent via IaC ou Fleet Manager) | ApplicationSet pour générer des applications par cluster |
| Intégration Azure | Ressource fluxConfigurations, conformité dans le portail, Terraform azurerm_kubernetes_flux_configuration |
Extension, Workload Identity, SSO Entra ID |
| Choisir si… | On veut du « tout déclaratif » piloté par la plateforme | Les équipes applicatives veulent voir et synchroniser elles-mêmes |
3. Décrire : IaC en couches#
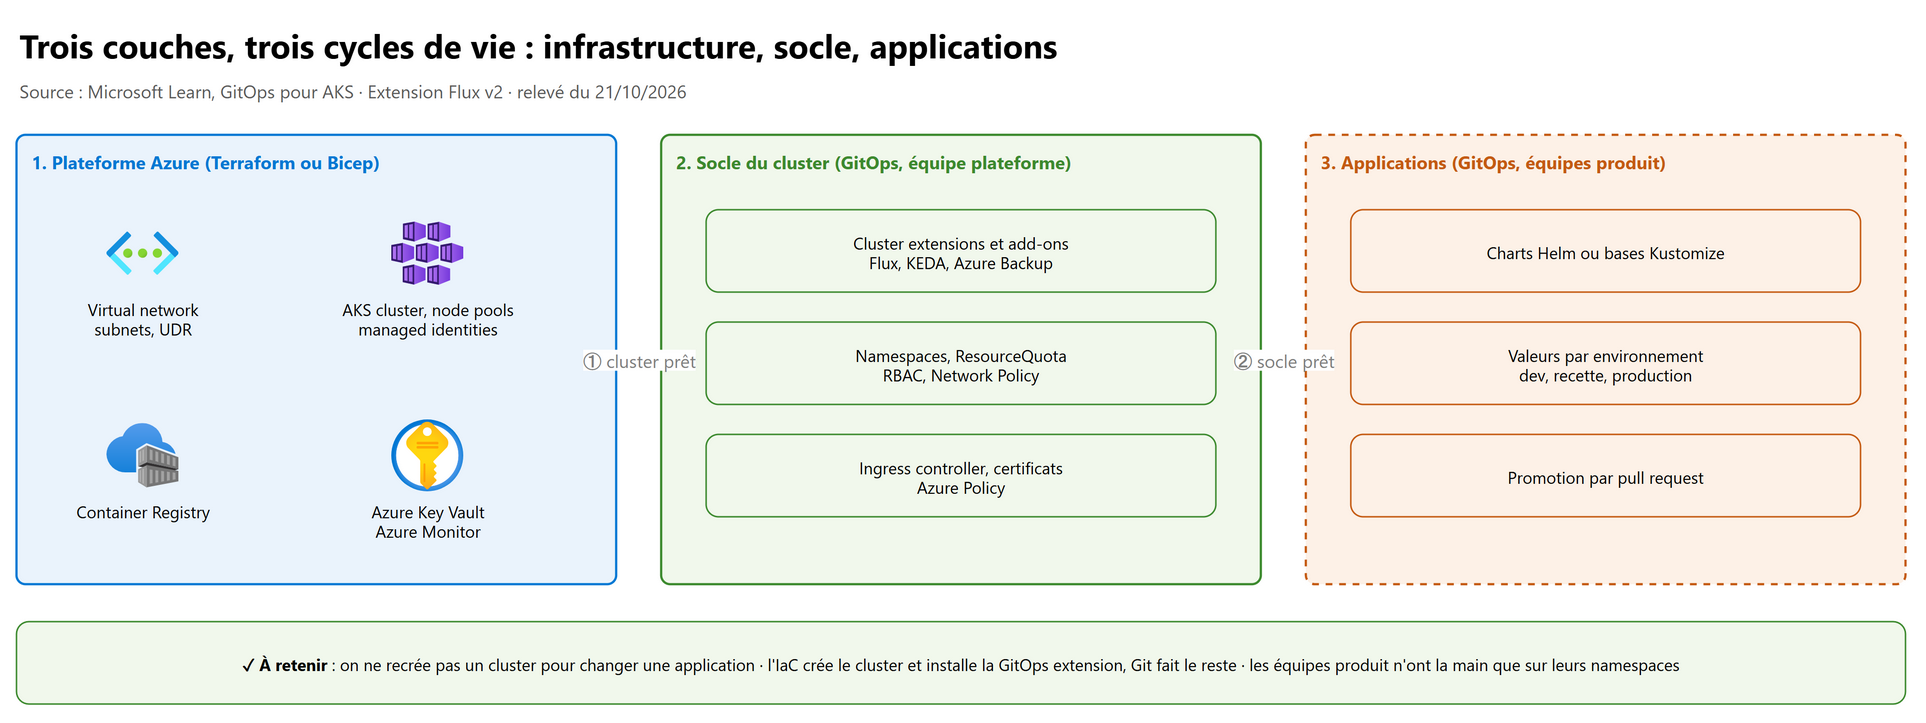
| Couche | Contenu | Outil | Fréquence de changement |
|---|---|---|---|
| 1. Plateforme Azure | Virtual network, subnets, UDR, AKS cluster, node pools, managed identities, ACR, Azure Key Vault, Azure Monitor | Terraform ou Bicep (Azure Verified Modules) | Rare, revue d'architecture |
| 2. Socle du cluster | Cluster extensions et add-ons, namespaces, ResourceQuota, RBAC, Network Policy, Ingress controller, Azure Policy | GitOps (équipe plateforme) | Régulière |
| 3. Applications | Charts Helm ou bases Kustomize, valeurs par environnement | GitOps (équipes produit) | Quotidienne |
Le pont entre la couche 1 et la couche 2 : Terraform crée le cluster et la configuration GitOps, puis Git fait le reste.
resource "azurerm_kubernetes_cluster" "prd" {
  # … (voir le chapitre 04 pour le node pool, les auto-upgrade channels et la maintenance window)
  oidc_issuer_enabled       = true    # requis pour Workload Identity
  workload_identity_enabled = true
  cost_analysis_enabled     = true    # exige sku_tier Standard ou Premium

  monitor_metrics {}                  # Managed Prometheus

  oms_agent {                         # Container Insights
    log_analytics_workspace_id      = var.log_analytics_workspace_id   # datasource (repo plateforme-observabilite)
    msi_auth_for_monitoring_enabled = true
  }
}

resource "azurerm_kubernetes_cluster_extension" "flux" {
  name           = "flux"
  cluster_id     = azurerm_kubernetes_cluster.prd.id
  extension_type = "microsoft.flux"
}

resource "azurerm_kubernetes_flux_configuration" "socle" {
  name       = "cluster-config"
  cluster_id = azurerm_kubernetes_cluster.prd.id
  namespace  = "cluster-config"
  scope      = "cluster"

  git_repository {
    url             = var.config_repo_url
    reference_type  = "branch"
    reference_value = "main"
    provider        = "Azure"         # workload identity federation, aucun jeton stocké
  }

  kustomizations {
    name                       = "infra"
    path                       = "./infrastructure"
    garbage_collection_enabled = true   # équivalent de prune
  }

  kustomizations {
    name                       = "apps"
    path                       = "./apps/production"
    depends_on                 = ["infra"]
    garbage_collection_enabled = true
  }

  depends_on = [azurerm_kubernetes_cluster_extension.flux]
}
Règle : on ne recrée pas un cluster pour changer une application, et on ne met aucun secret dans le dépôt (Azure Key Vault
- Secrets Store CSI Driver, ou Workload Identity, chapitre 03).
4. Plusieurs clusters : Azure Kubernetes Fleet Manager#
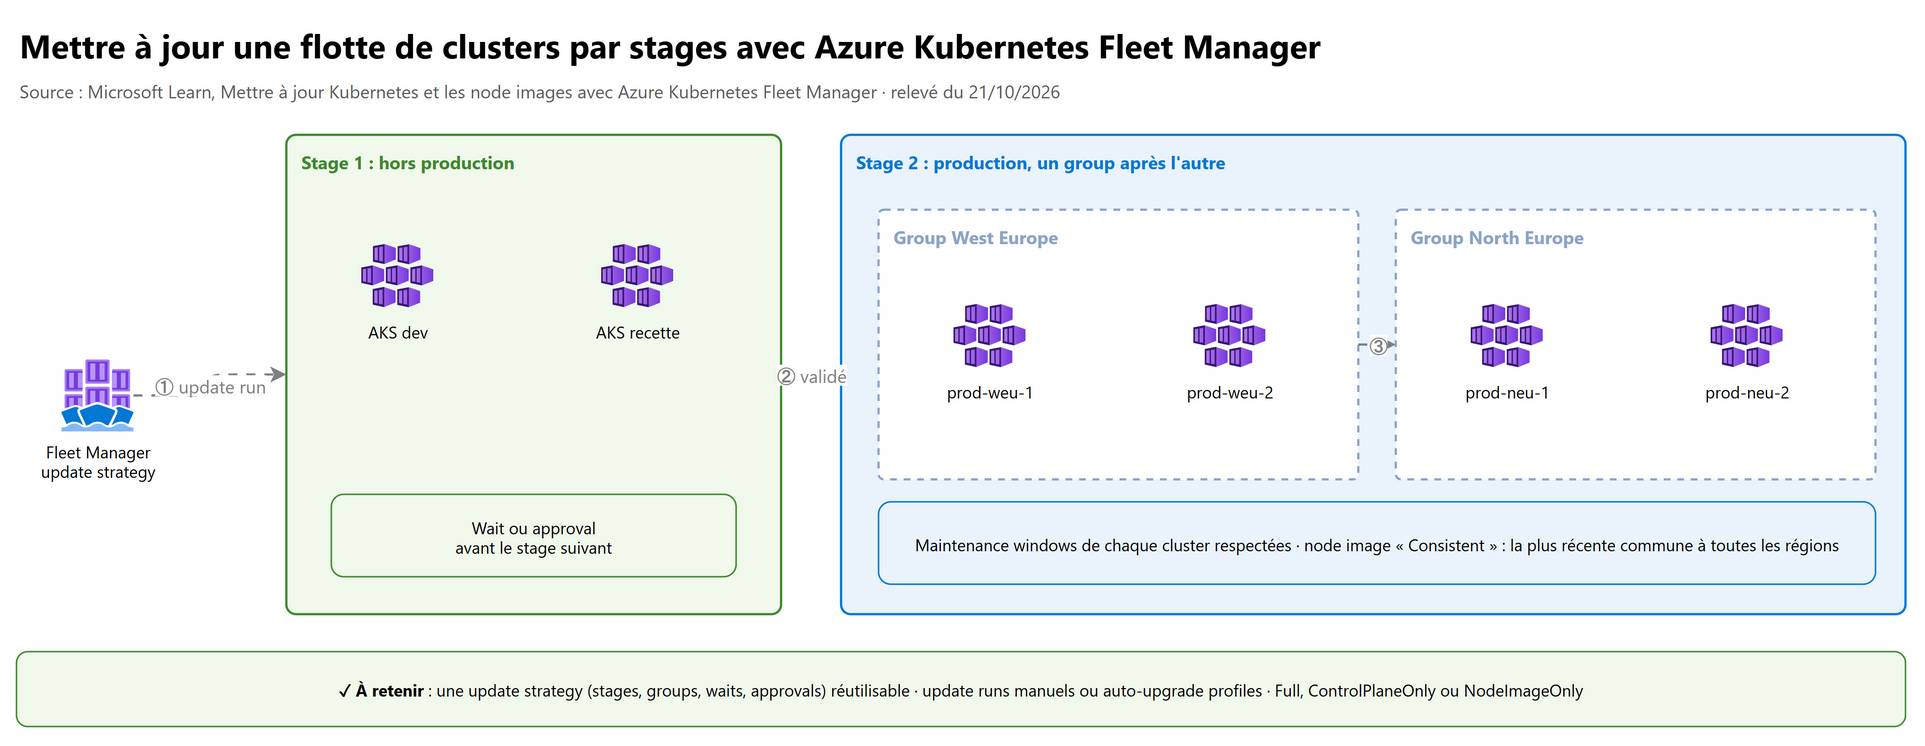
| Notion | Sens |
|---|---|
| Fleet et member clusters | La ressource Fleet Manager et les clusters AKS qui la rejoignent |
| Update run | Une exécution de mise à jour sur la flotte : Full (control plane + node pools + node images), ControlPlaneOnly ou NodeImageOnly |
| Stages et groups | L'ordre : un stage après l'autre (par exemple hors production puis production), avec approvals et waits entre les deux |
| Update strategy | Le modèle réutilisable (stages, groups, approvals, pauses) ; groupement possible par member labels (préversion) |
| Node image selection | Latest (la plus récente de chaque région) ou Consistent (la plus récente commune à toutes les régions) |
| Auto-upgrade profiles | Déclenchent automatiquement des update runs quand une nouvelle version sort |
Les update runs respectent les maintenance windows de chaque cluster ; une platform-initiated upgrade, elle, passe en dehors de l'orchestration Fleet : raison de plus pour rester dans la fenêtre de support.
az extension add --name fleet
az fleet updaterun create -g <rg> --fleet-name <fleet> -n run-1 \
  --upgrade-type Full --kubernetes-version <version> --node-image-selection Consistent --stages stages.json
az fleet updaterun start -g <rg> --fleet-name <fleet> -n run-1
5. Maîtriser les coûts#
| Levier | Effet | Détail |
|---|---|---|
| Cost analysis add-on | Coûts par cluster, namespace et ressource dans Microsoft Cost Management | Standard ou Premium tier ; basé sur OpenCost ; 24 h pour les premières données ; contrats EA et MCA ; distingue idle, system, service et unallocated charges |
| Autoscaling (HPA, KEDA, Cluster Autoscaler, Node Autoprovisioning) | On paie la charge réelle | KEDA descend à zéro ; NAP choisit la bonne taille de VM |
VPA en mode Off |
Requests ajustées à la consommation | Moins de nodes à réserver |
| Spot node pools | Capacité à prix réduit | Charges interruptibles seulement |
| Stop / start du cluster | Plus de nodes facturés la nuit en dev | az aks stop / az aks start ; attendre 15 à 30 min entre un arrêt et un redémarrage ; impossible avec NAP |
| Observabilité sobre | Ingestion réduite | Managed Prometheus, ContainerLogV2 en Basic logs, kube-audit-admin |
| Engagements Azure (réservations, savings plan) | Prix des VM réduit | Pour la capacité de base qui tourne en permanence |
6. Exploitation quotidienne#
6.1 Les commandes à connaître#
| Besoin | Commande |
|---|---|
| Se connecter | az aks get-credentials -g <rg> -n <cluster> (avec Entra ID : kubelogin) |
| État global | kubectl get nodes -o wide, kubectl get pods -A, kubectl top nodes, kubectl top pods -A |
| Comprendre un pod | kubectl describe pod <pod> -n <ns> (section Events), kubectl logs <pod> --previous |
| Événements récents | kubectl get events -A --sort-by=.lastTimestamp |
| Accès à un node | kubectl debug node/<node> -it --image=mcr.microsoft.com/cbl-mariner/busybox:2.0 |
| Versions disponibles | az aks get-upgrades -g <rg> -n <cluster> |
| Vérifier l'accès à ACR | az aks check-acr -g <rg> -n <cluster> --acr <acr>.azurecr.io |
| Diagnostic guidé | Portail : Diagnose and solve problems (connectivité, SNAT, nodes, mises à niveau) |
6.2 Administrer un private cluster#
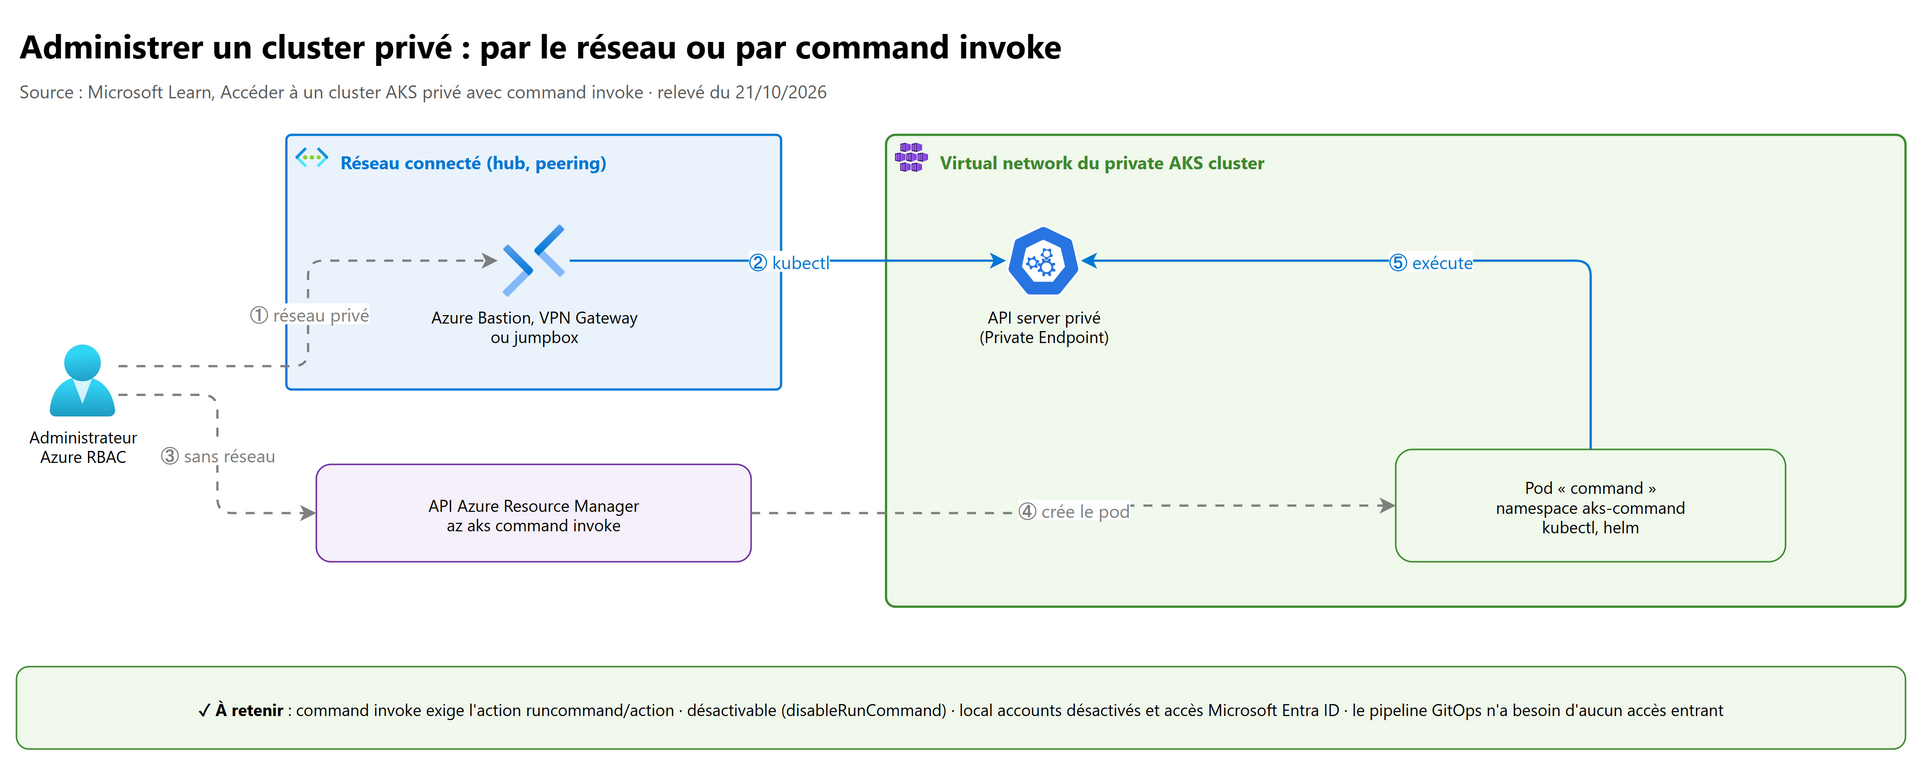
Un private cluster n'expose pas son API server sur Internet. Deux chemins :
- par le réseau : depuis le VNet du cluster ou un réseau connecté (peering, VPN Gateway, ExpressRoute, Azure Bastion, jumpbox), avec résolution DNS de la zone privée ;
- par l'API Azure :
az aks command invoke(ou Run command dans le portail) crée un podcommand-…dans le namespaceaks-commandqui exécutekubectlouhelm; droitsMicrosoft.ContainerService/managedClusters/runcommand/actionet…/commandResults/read; désactivable (apiServerAccessProfile.disableRunCommand).
az aks command invoke -g <rg> -n <cluster> --command "kubectl get pods -n kube-system"
az aks command invoke -g <rg> -n <cluster> --command "kubectl apply -f deployment.yaml -n default" --file deployment.yaml
Avec GitOps, le cluster n'a besoin d'aucun accès entrant pour être déployé : command invoke reste l'outil du dépannage.
7. Runbooks d'incidents#
flowchart TD
    A["Pod en échec"] --> B{"Statut du pod ?"}
    B -- Pending --> C["kubectl describe pod<br/>Events : Insufficient cpu/memory,<br/>taint, volume, zone"]
    C --> C1["Requests, autoscaler, tolerations,<br/>disque LRS dans une autre zone"]
    B -- "ImagePullBackOff" --> D["az aks check-acr<br/>az acr check-health"]
    D --> D1["Nom ou tag de l'image, AcrPull,<br/>pare-feu de sortie, Private Endpoint ACR"]
    B -- CrashLoopBackOff --> E["kubectl logs --previous<br/>code de sortie, OOMKilled ?"]
    E --> E1["Configuration, ConfigMap/Secret,<br/>limites mémoire, sondes trop strictes,<br/>dépendance indisponible"]
    B -- "Running mais 0/1 Ready" --> F["readinessProbe<br/>kubectl describe pod"]
| Incident | Diagnostic | Causes et corrections |
|---|---|---|
| CrashLoopBackOff | kubectl logs <pod> --previous, kubectl get pod -o yaml (message de fin), alerte KubePodCrashLooping |
Erreur applicative, variable ou ConfigMap/Secret manquant, limites trop basses (OOMKilled), liveness probe trop stricte ou dépendante d'un service externe, startup probe absente |
| ImagePullBackOff | kubectl describe pod (Events), az aks check-acr, az acr check-health |
Tag inexistant, rôle AcrPull manquant sur l'identité kubelet, sortie bloquée vers l'ACR ou mcr.microsoft.com, Private Endpoint ou DNS de l'ACR |
| Node NotReady | kubectl describe node (Conditions), Diagnose and solve problems, Resource Health |
Node auto-repair agit après 5 min (redémarrage, réimage, redéploiement) ; ressources saturées, réseau vers l'API server, défaut d'hôte ; vérifier quota et capacité du SKU |
| Plus d'adresses IP (pods ou nodes qui ne démarrent pas, mise à niveau en échec) | Utilisation du subnet, mode réseau du cluster | En Azure CNI « node subnet », chaque pod consomme une IP du subnet ; Azure CNI Overlay ou l'allocation dynamique (dynamic IP allocation) ; prévoir la marge des surge nodes (chapitre 02) |
| SNAT port exhaustion (appels sortants qui échouent par intermittence) | Métriques du Load Balancer SNAT Connection Count (état Failed), Diagnose and solve problems > SNAT Connection and Port Allocation | Réutiliser les connexions (pooling) avant tout ; puis plus d'IP de sortie ou de ports alloués ; idle timeout court ; NAT Gateway (64 512 ports par IP, jusqu'à 16 IP) |
8. Lab : GitOps avec Flux sur un cluster de test#
À faire dans un abonnement de test.
# 1. Cluster de test et extensions CLI
az group create -n rg-lab-gitops -l francecentral
az aks create -g rg-lab-gitops -n aks-gitops --node-count 2 --generate-ssh-keys
az extension add --upgrade --name k8s-configuration
az extension add --upgrade --name k8s-extension

# 2. Configuration Flux à partir du dépôt d'exemple de Microsoft (installe l'extension microsoft.flux)
az k8s-configuration flux create -g rg-lab-gitops -c aks-gitops -t managedClusters \
  -n cluster-config --namespace cluster-config --scope cluster \
  -u https://github.com/Azure/gitops-flux2-kustomize-helm-mt --branch main \
  --kustomization name=infra path=./infrastructure prune=true \
  --kustomization name=apps path=./apps/staging prune=true dependsOn=\["infra"\]

# 3. Observer la réconciliation
az k8s-configuration flux show -g rg-lab-gitops -c aks-gitops -n cluster-config -t managedClusters
kubectl get fluxconfigs -A
kubectl get gitrepositories,kustomizations,helmreleases -A
kubectl get pods -n flux-system

# 4. Tester la réconciliation : supprimer à la main un déploiement géré par Flux, attendre, il revient
kubectl get deploy -A
# 5. Nettoyage
az group delete -n rg-lab-gitops --yes --no-wait
À savoir raconter : l'état « Pending » puis « Compliant » dans le portail (menu GitOps du cluster), le rôle de dependsOn, et
ce qu'apporte prune.
9. Questions d'entretien#
1. Comment supervisez-vous AKS, et comment évitez-vous une facture Log Analytics énorme ?
Métriques dans Managed Prometheus et Azure Managed Grafana ; journaux des conteneurs dans Container Insights en ContainerLogV2, preset Logs and Events, tables peu interrogées en Basic logs ; audit du control plane par Diagnostic settings en resource-specific mode avec
kube-audit-adminplutôt quekube-audit; alertes sur les métriques.
2. Où trouvez-vous qui a supprimé un déploiement en production ?
Dans l'audit du control plane (
kube-audit-admin, tableAKSAuditAdmin) si le Diagnostic setting était actif ;guardpour l'identité Entra ID ; et, avec GitOps, dans l'historique Git si la suppression vient du dépôt.
3. Push ou pull ? Pourquoi GitOps ?
CI en push vers ACR, CD en pull : aucun accès entrant au cluster (idéal en private cluster), réconciliation continue contre la dérive, retour arrière par
git revert, audit par les pull requests, même état sur N clusters.
4. Flux ou Argo CD ?
Les deux existent en cluster extension. Flux : léger, tout en CRD, ressource Azure
fluxConfigurationset Terraform. Argo CD : interface web, ApplicationSet, SSO Entra ID ; mode HA à 4 nodes minimum. Le choix dépend de qui opère (plateforme ou équipes).
5. Comment structurez-vous l'IaC d'AKS ?
Trois couches : Terraform ou Bicep pour l'Azure (réseau, cluster, identités, registre), GitOps pour le socle du cluster, GitOps pour les applications. Terraform installe l'extension Flux et la configuration ; aucun secret dans Git.
6. Comment mettez-vous à jour 30 clusters sans tout casser ?
Azure Kubernetes Fleet Manager : une update strategy avec un stage hors production, une attente ou une approbation, puis des groups de production l'un après l'autre ;
Consistentpour la même node image partout ; maintenance windows respectées.
7. Comment administrez-vous un private cluster ?
Par le réseau (peering, VPN, ExpressRoute, Azure Bastion, jumpbox, DNS privé) ou par
az aks command invokevia l'API Azure, contrôlé par RBAC et désactivable. Pour le déploiement, GitOps évite tout accès entrant.
8. Un pod est en ImagePullBackOff. Votre démarche ?
kubectl describe podpour l'erreur exacte ;az aks check-acr; vérifier le tag, le rôle AcrPull de l'identité kubelet, la sortie réseau vers l'ACR, le Private Endpoint et sa zone DNS.
9. Les appels sortants échouent par intermittence sous charge. Hypothèse ?
SNAT port exhaustion : vérifier SNAT Connection Count (Failed) ; corriger d'abord l'application (pooling, réutilisation des connexions), puis augmenter les IP ou ports de sortie, ou passer sur NAT Gateway.
10. Comment réduisez-vous la facture AKS ?
Cost analysis add-on pour voir par namespace ; requests justes (VPA), autoscaling, KEDA à zéro, Spot pour l'interruptible, stop/start en dev, observabilité sobre, engagements Azure pour la base permanente.
10. Fiche à retenir#
- Métriques → Managed Prometheus (Azure Monitor workspace) → Azure Managed Grafana.
- Journaux → Container Insights (Log Analytics workspace) : ContainerLogV2, preset Logs and Events par défaut.
- Control plane → Diagnostic settings (rien sans eux) ;
kube-audit-adminplutôt quekube-audit; tablesAKSAudit,AKSAuditAdmin,AKSControlPlaneen resource-specific mode. - Recommended alert rules + Action group ; alerter sur les métriques avant les journaux.
- CI en push (ACR), CD en pull (GitOps) ; OIDC partout, aucun secret dans Git ni dans le pipeline.
- Flux = cluster extension
microsoft.flux+ ressourcefluxConfigurations(source + kustomizations,dependsOn, prune). - Argo CD = extension
Microsoft.ArgoCD, GA sur AKS, HA à 4 nodes minimum, Workload Identity et SSO Entra ID. - IaC en trois couches : plateforme (Terraform/Bicep), socle (GitOps), applications (GitOps).
- Fleet Manager : update runs, stages, groups, update strategy,
Full/ControlPlaneOnly/NodeImageOnly,Consistent. - Cost analysis add-on : Standard ou Premium tier, par namespace ; stop/start impossible avec NAP.
- Private cluster : réseau ou
az aks command invoke(runcommand/action, désactivable). - Runbooks : CrashLoopBackOff (logs --previous), ImagePullBackOff (check-acr), NotReady (node auto-repair 5 min), IP (CNI Overlay), SNAT (pooling, NAT Gateway).
Références#
Lues le 21/10/2026 :
- Surveiller AKS et référence des données de supervision
- Activer la supervision des clusters Kubernetes
- Bonnes pratiques de supervision de Kubernetes avec Azure Monitor
- Recommended alert rules pour Kubernetes et stratégies d'alerte économiques
- Supervision proactive d'AKS
- Tables AKSAudit, AKSAuditAdmin, AKSControlPlane
- Surveiller un cluster AKS réglementé (PCI DSS)
- GitOps (Flux v2) pour AKS et Azure Arc et tutoriel Flux v2
- GitOps avec Argo CD et tutoriel Argo CD
- GitOps pour AKS (Architecture Center)
- GitHub Actions pour AKS et Automated deployments
- Azure Kubernetes Fleet Manager : orchestration des mises à jour et update runs
- Cost analysis add-on pour AKS et optimiser les coûts AKS
- Arrêter et démarrer un cluster AKS
- Accéder à un private cluster avec command invoke
- Dépannage : CrashLoopBackOff, erreurs de pull d'image depuis ACR, Node Not Ready, SNAT port exhaustion
- Santé des nodes et des pods (Architecture Center)
- Terraform : azurerm_kubernetes_cluster, azurerm_kubernetes_cluster_extension, azurerm_kubernetes_flux_configuration
- Flux : HelmRelease