

Version : 1.1 · Date : 2026-10-21 · Domaine 2 de l'examen : Implement machine learning model lifecycle and operations (25 à 30 %)
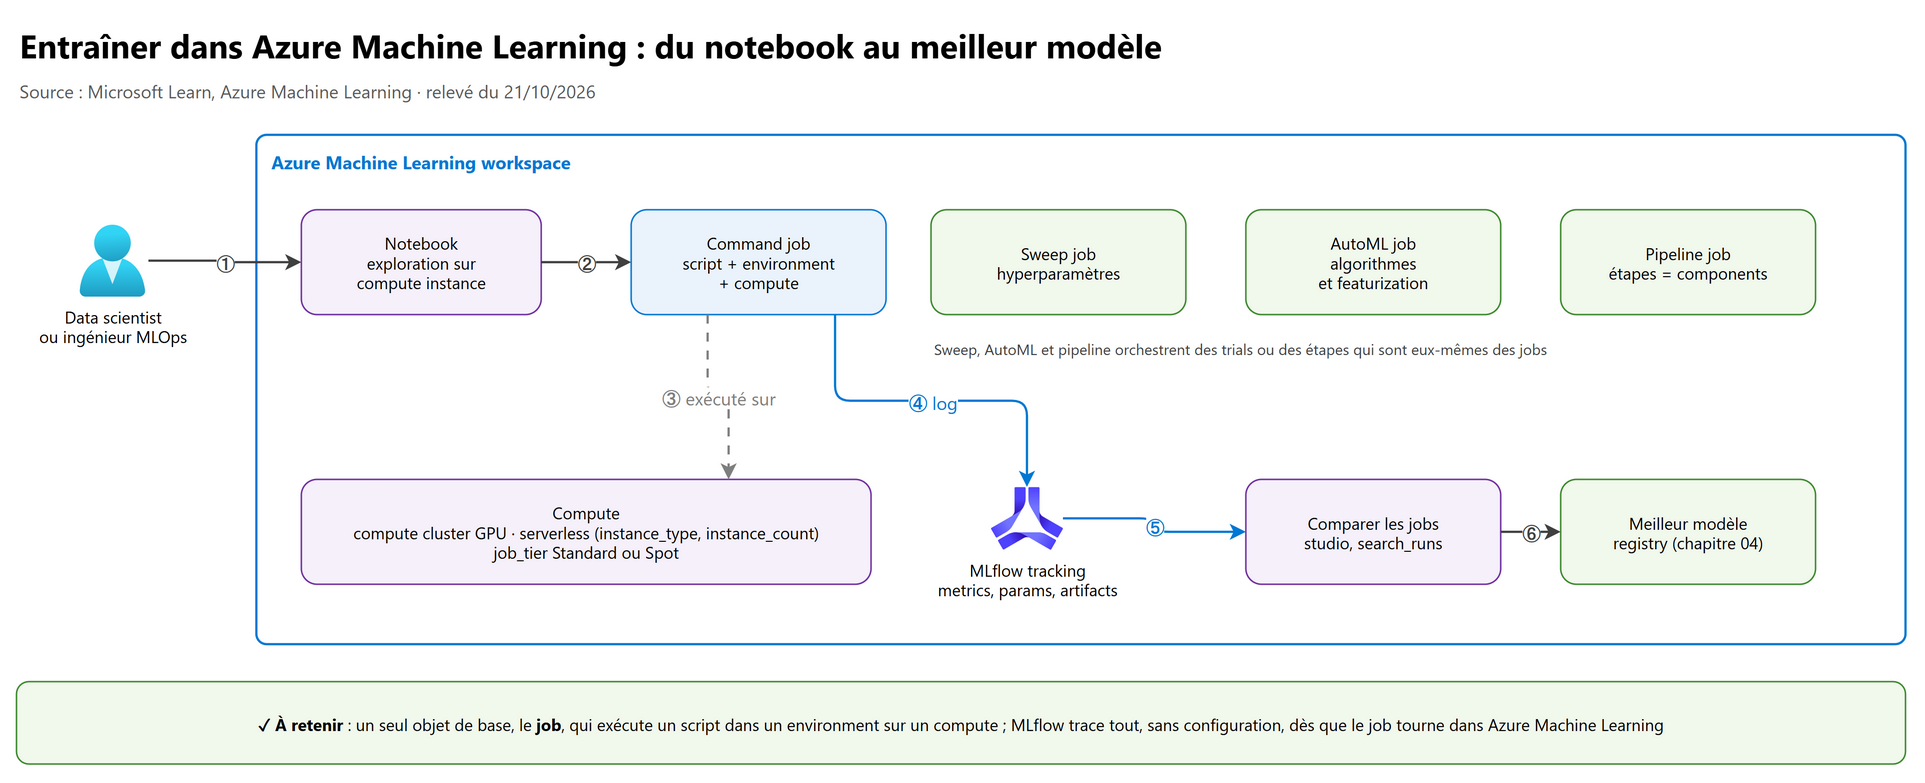
En une phrase : dans Azure Machine Learning, tout entraînement est un job (un script, un environment, un compute) ; MLflow trace ses métriques sans configuration, le sweep job et AutoML cherchent les meilleurs réglages, le distributed training répartit le travail sur plusieurs GPU et plusieurs nœuds, et le pipeline enchaîne le tout de façon reproductible.
Ce que l'examen demande#
Bloc Orchestrate model training du guide d'étude AI-300 :
| # | Compétence mesurée (guide officiel, en anglais) | Section |
|---|---|---|
| 1 | Configure experiment tracking with MLflow | 2 |
| 2 | Use automated machine learning to explore optimal models | 6 |
| 3 | Use notebooks for experimentation and exploration | 3 |
| 4 | Automate hyperparameter tuning | 5 |
| 5 | Run model training scripts | 4 |
| 6 | Manage distributed training for large and deep learning models | 7 |
| 7 | Implement training pipelines | 8 |
| 8 | Compare model performance across jobs | 9 |
Le workspace, les compute targets, les environments, les components et les registries sont détaillés au chapitre 01 ; l'automatisation par GitHub Actions au chapitre 02 ; l'enregistrement et le déploiement du modèle obtenu au chapitre 04. Les besoins propres aux LLM (fine-tuning, choix et dimensionnement GPU) sont aux chapitres 07 et 08.
1. Les bases à maîtriser#
1.1 Le vocabulaire ML minimal pour un architecte#
| Terme | En clair |
|---|---|
| Modèle | Une fonction apprise à partir d'exemples : elle reçoit des entrées (features) et produit une prédiction |
| Entraînement | Ajuster les paramètres du modèle (les poids d'un réseau de neurones) pour réduire l'erreur sur les données d'entraînement |
| Hyperparamètre | Un réglage choisi avant l'entraînement et non appris : learning rate, batch size, nombre de couches, nombre d'arbres |
| Epoch / batch | Un epoch = un passage complet sur les données ; un batch = le paquet d'exemples traité à chaque pas |
| Métrique | La note du modèle : accuracy, AUC (classification), RMSE, R² (régression), loss pendant l'entraînement |
| Validation, test | Données mises de côté pour mesurer le modèle sur des exemples qu'il n'a pas vus pendant l'entraînement |
| Surapprentissage (overfitting) | Le modèle « apprend par cœur » : excellent sur l'entraînement, mauvais sur la validation. On le voit quand les deux courbes de loss divergent |
| Deep learning | Réseaux de neurones profonds ; très gourmands en calcul, d'où les GPU et le distributed training |
1.2 Les objets d'Azure Machine Learning pour entraîner#
| Objet | Rôle | Détail |
|---|---|---|
| Job | L'unité d'exécution : un script lancé dans un environment sur un compute | Types : command, sweep, automl, pipeline (et spark, parallel) |
| Experiment | Le dossier qui regroupe les jobs d'un même sujet | experiment_name dans le YAML ou le SDK |
| Environment | Image Docker + dépendances Python | Curated environments fournis (ex. ACPT, Azure Container for PyTorch) ou personnalisés (chapitre 01) |
| Compute | Où le job tourne | Compute instance (poste de travail), compute cluster, serverless compute, Kubernetes attaché |
| Data asset, datastore | Les données en entrée et en sortie | Types d'entrée uri_file, uri_folder, mltable |
| Component | Une étape réutilisable et versionnée | Brique des pipelines |
Important pour l'examen : le SDK Python v2 (
azure-ai-ml) et la CLI v2 (az ml) n'ont aucune fonction de logging : on trace avec MLflow. Les anciennes API du SDK v1 (Run.log) ne sont plus la réponse.
flowchart TD
    A["Besoin d'entraînement"] --> B{"J'explore ou j'industrialise ?"}
    B -- "J'explore" --> N["Notebook sur compute instance"]
    B -- "J'industrialise" --> C{"Je connais l'algorithme ?"}
    C -- "Non, données tabulaires, vision ou NLP" --> AU["AutoML job"]
    C -- "Oui" --> D{"Réglages à chercher ?"}
    D -- "Oui" --> S["Sweep job autour d'un command job"]
    D -- "Non" --> E{"Un seul GPU suffit ?"}
    E -- "Oui" --> CJ["Command job"]
    E -- "Non" --> DT["Command job + distribution PyTorch, DeepSpeed, TensorFlow ou MPI"]
    AU --> P["Pipeline job pour enchaîner préparation, entraînement, évaluation"]
    S --> P
    CJ --> P
    DT --> P
2. Configurer l'experiment tracking avec MLflow#
2.1 Ce qui est automatique#
Un workspace Azure Machine Learning est un serveur MLflow : il a sa propre tracking URI (azureml://…). Dans un
notebook sur compute instance ou dans un job sur compute cluster ou serverless, la tracking URI est déjà configurée :
on écrit du MLflow standard, rien d'autre.
| Contexte | À faire |
|---|---|
| Job Azure Machine Learning | Rien : mlflow.start_run() est même inutile, le run est démarré automatiquement |
| Notebook sur compute instance | mlflow.set_experiment(), puis start_run() / end_run() (ou un bloc with) |
| Poste local, Azure Databricks, Azure Synapse | pip install mlflow azureml-mlflow, puis mlflow.set_tracking_uri(<tracking URI du workspace>) et une authentification |
Récupérer la tracking URI :
az ml workspace show --query mlflow_tracking_uri
from azure.ai.ml import MLClient
from azure.identity import DefaultAzureCredential

ml_client = MLClient.from_config(credential=DefaultAzureCredential())
uri = ml_client.workspaces.get(ml_client.workspace_name).mlflow_tracking_uri
Piège : avec un workspace en private link, la tracking URI a un format différent ; ne pas la construire à la main, la lire par le SDK ou la CLI.
2.2 Ce qu'on trace#
import mlflow

mlflow.autolog()                                    # paramètres, métriques et modèle capturés selon le framework (scikit-learn, PyTorch…)

mlflow.log_param("num_epochs", 20)                  # un paramètre
mlflow.log_params({"dropout_rate": 0.6, "objective": "binary_crossentropy"})
mlflow.log_metric("val_accuracy", 0.91)             # une métrique ; loggée plusieurs fois = une courbe
mlflow.log_artifact("confusion_matrix.png")         # un fichier
mlflow.autolog(log_models=False)trace tout sauf le modèle, si on veut l'enregistrer soi-même.run.data.metricsne rend que la dernière valeur d'une métrique ; la courbe complète s'obtient avecMlflowClient().get_metric_history().- Le nom de l'experiment se fixe dans le job (
experiment_name) : inutile de l'écrire dans le script.
2.3 Les droits#
Les rôles intégrés AzureML Data Scientist et Contributor permettent le tracking et le registry MLflow. Pour un rôle
personnalisé : Microsoft.MachineLearningServices/workspaces/experiments/* et …/jobs/* pour le tracking,
…/models/*/* pour le model registry. Hors d'Azure, pour un traitement sans utilisateur (CI, Databricks), MLflow s'authentifie avec
un service principal par les variables AZURE_TENANT_ID, AZURE_CLIENT_ID et AZURE_CLIENT_SECRET (secret rangé dans
Key Vault, jamais en clair) ou un certificat.
3. Explorer dans des notebooks#
| Élément | À retenir |
|---|---|
| Compute instance | Poste de travail géré, mono-nœud, propre à son créateur (seul lui l'utilise) ; Jupyter, JupyterLab, VS Code (web ou desktop), drivers CUDA, cuDNN, NCCL, Intel MPI préinstallés |
| Fichiers | Les User files sont stockés à part de la VM et partagés entre les compute instances du workspace |
| Paquets | %pip ou %conda (installe dans le kernel courant), pas !pip |
| Coûts | Idle shutdown (inactivité de 15 minutes à 3 jours) ou schedule de démarrage / arrêt. Arrêtée, l'instance ne facture plus le calcul mais toujours le disque, l'IP publique et le load balancer |
| Sécurité | No public IP, réseau virtuel, Azure Policy pour interdire SSH ou imposer un VNet (chapitre 02) |
| Pas de Spot | Les VM Spot / basse priorité ne sont pas possibles pour une compute instance (usage interactif) |
Piège : si le workspace a une managed identity, la compute instance ne s'arrête par inactivité que si cette identité a le rôle Contributor sur le workspace.
Interactive jobs : pour déboguer dans le conteneur du job lui-même (y compris un job distribué sur un compute cluster),
on ajoute des training applications au job : JupyterLab, VS Code, TensorBoard ou SSH
(JupyterLabJobService, VsCodeJobService, TensorBoardJobService, SshJobService). On garde le nœud avec sleep 1h en fin
de commande (sleep infinity oblige à annuler le job à la main pour arrêter la facturation). Seul le propriétaire du job
accède aux applications, sur le nœud choisi (--node-index) :
az ml job show-services --name <job> --node-index 0
az ml job connect-ssh --name <job> --node-index 0 --private-key-file-path ~/.ssh/id_rsa
Limites : distribution PyTorch, TensorFlow ou MPI seulement ; VS Code et le débogueur (debugpy) ne marchent pas avec un workspace
en private link.
4. Exécuter un script d'entraînement avec un command job#
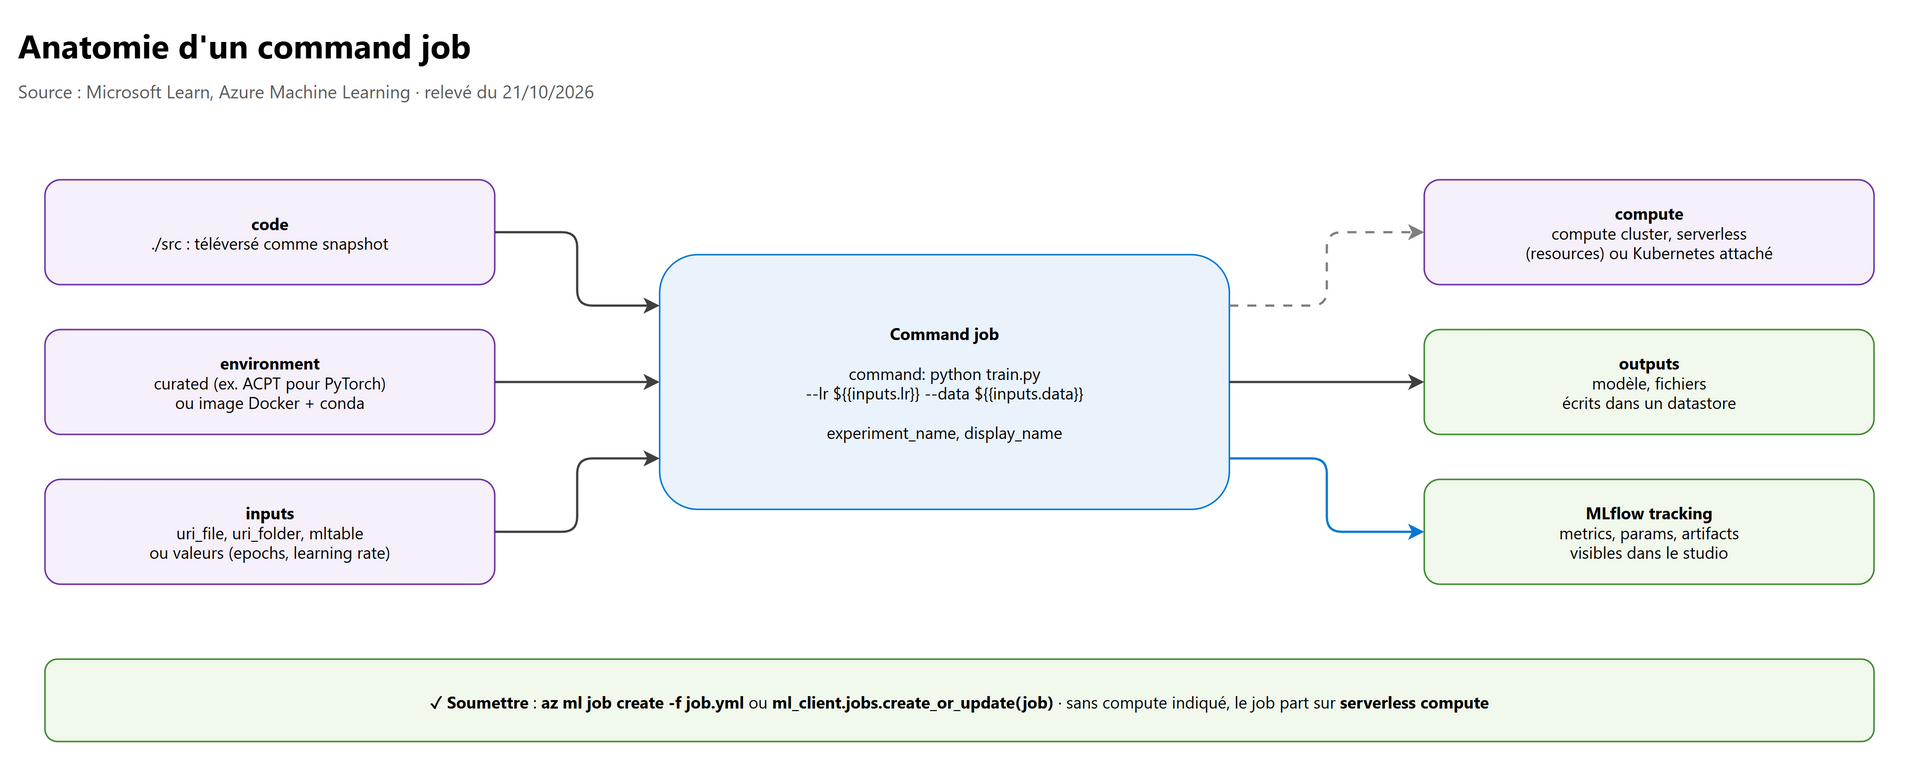
Le command job est la brique de base : le code est téléversé comme snapshot, l'environment fournit les dépendances, le
compute fournit la machine, les ${{inputs.x}} sont remplacés au lancement.
# job.yml : command job sur un compute cluster GPU
$schema: https://azuremlschemas.azureedge.net/latest/commandJob.schema.json
code: src
command: >-
  python train.py --data ${{inputs.training_data}} --epochs ${{inputs.epochs}} --lr ${{inputs.learning_rate}}
inputs:
  training_data:
    type: uri_folder
    path: azureml:credit-data:1          # data asset versionné
  epochs: 10
  learning_rate: 0.01
outputs:
  model_output:
    type: uri_folder
environment: azureml:AzureML-acpt-pytorch-2.8-cuda12.6@latest
compute: azureml:gpu-cluster
experiment_name: credit-training
display_name: credit-train-baseline
run_id=$(az ml job create -f job.yml --query name -o tsv)   # soumet le job
az ml job show -n $run_id --web                             # ouvre le job dans le studio
az ml job stream -n $run_id                                 # suit les logs
Équivalent Python :
from azure.ai.ml import MLClient, command, Input
from azure.identity import DefaultAzureCredential

ml_client = MLClient.from_config(credential=DefaultAzureCredential())

job = command(
    code="./src",
    command="python train.py --data ${{inputs.training_data}} --lr ${{inputs.learning_rate}}",
    inputs={"training_data": Input(type="uri_folder", path="azureml:credit-data:1"), "learning_rate": 0.01},
    environment="azureml:AzureML-acpt-pytorch-2.8-cuda12.6@latest",
    compute="gpu-cluster",              # omis = serverless compute
    experiment_name="credit-training",
)
returned_job = ml_client.jobs.create_or_update(job)
print(returned_job.services["Studio"].endpoint)     # lien vers le job dans le studio
4.1 Serverless compute#
Sans compute, un command, sweep ou AutoML job part sur serverless compute : Azure Machine Learning crée, dimensionne et
supprime le calcul. Par défaut : un nœud, une VM CPU choisie selon le quota, le coût et la taille de disque, VM dédiées, région du
workspace. On précise ce qu'il faut avec resources et queue_settings :
resources:
  instance_type: Standard_NC24ads_A100_v4   # VM GPU voulue
  instance_count: 2                          # nombre de nœuds
queue_settings:
  job_tier: Spot                             # Standard (dédié, défaut) ou Spot
identity:
  type: user_identity                        # ou managed (managed identity du compute)
| Point | Ce qu'il faut savoir |
|---|---|
| Quota | Serverless consomme le même quota que les compute clusters ; un serverless évite l'échec « quota insuffisant » en choisissant une taille disponible |
| Attente | Pas d'attente de scale-down ni de file derrière un autre job du même cluster |
| Pipelines | default_compute: azureml:serverless (CLI) ou default_compute="serverless" (SDK) |
| Réseau | Utilise l'isolation réseau managée du workspace |
| Low-priority | Les VM low-priority sont retirées depuis le 31/03/2026 : un cluster tier: low_priority tourne désormais en Spot (tarif Spot variable, éviction possible) |
4.2 Lire les logs#
Studio > Jobs > le job > Outputs + logs : user_logs/std_log.txt contient les print, stdout et stderr de chaque processus
(un fichier par processus dans un job distribué) ; system_logs contient les journaux de la plateforme (préparation, interactive
capability…).
5. Automatiser le hyperparameter tuning avec un sweep job#
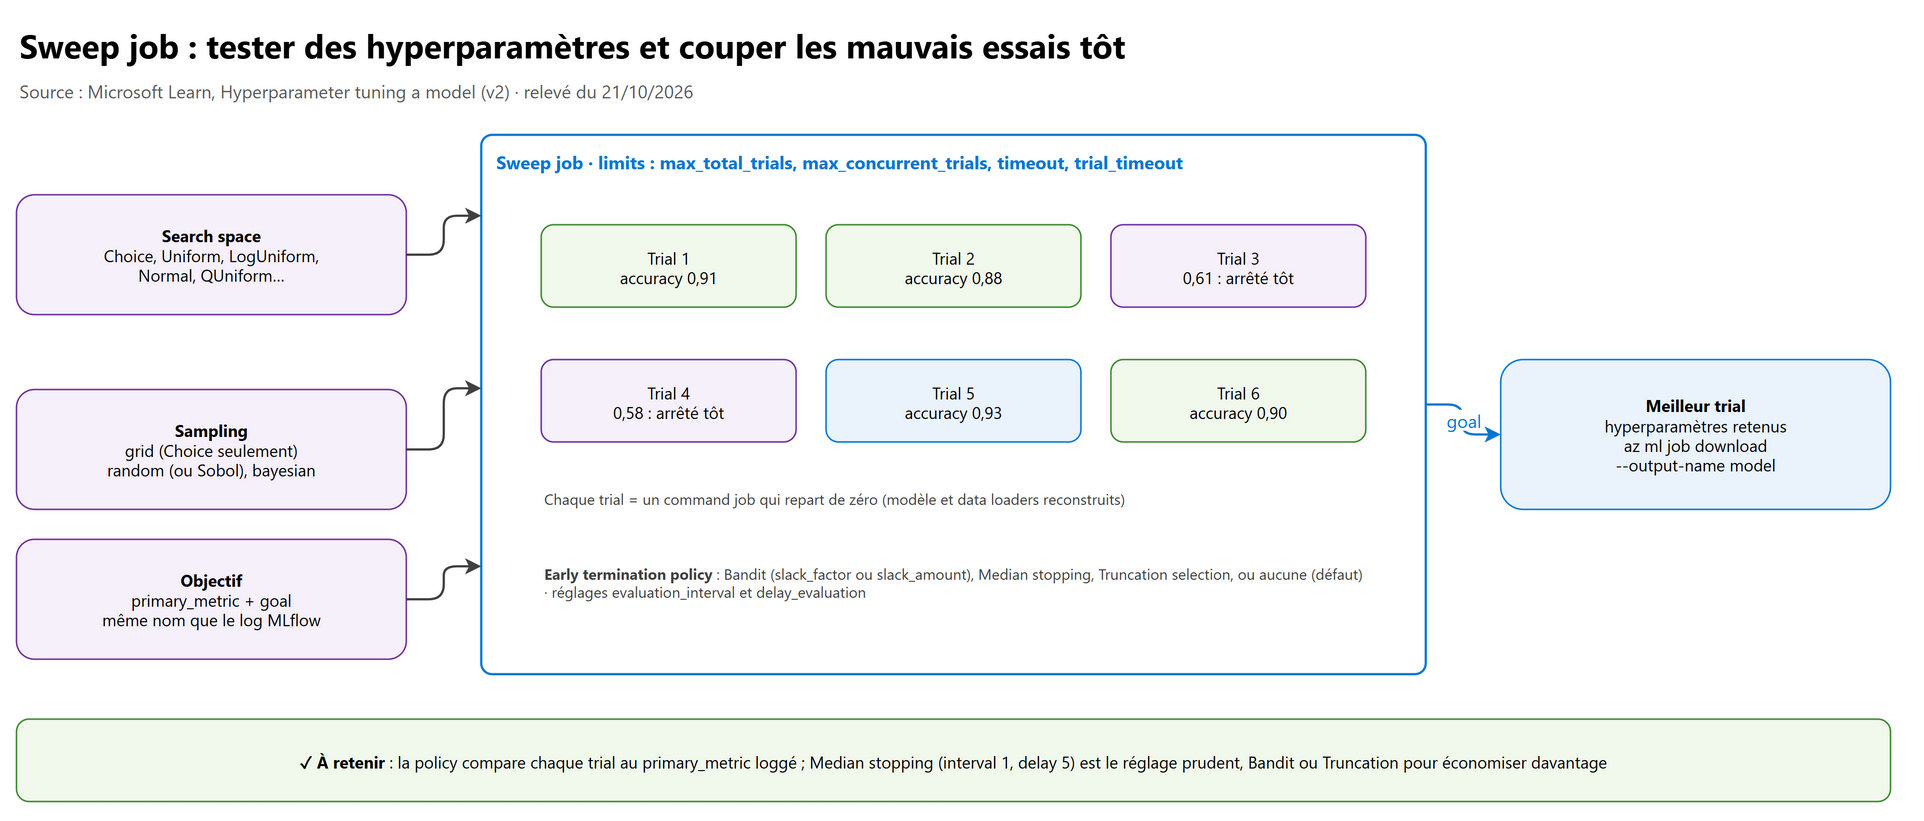
Un sweep job (classe SweepJob) lance de nombreux trials, chacun étant le même command job avec d'autres hyperparamètres.
| Réglage | Options |
|---|---|
| Search space | Discret : Choice (liste, range), QUniform, QLogUniform, QNormal, QLogNormal ; continu : Uniform, LogUniform, Normal, LogNormal |
| Sampling | Grid : toutes les combinaisons, Choice uniquement ; Random (option rule="sobol" quasi aléatoire, avec seed) : discret et continu ; Bayesian : s'appuie sur les essais précédents, accepte choice, uniform, quniform |
| Objectif | primary_metric (nom exactement égal à celui loggé par MLflow) et goal : maximize ou minimize |
| Early termination | Bandit (slack_factor ratio ou slack_amount absolu), Median stopping, Truncation selection (truncation_percentage 1 à 99), aucune par défaut ; paramètres evaluation_interval et delay_evaluation |
| Limits | max_total_trials (1 à 1 000), max_concurrent_trials, timeout du sweep, trial_timeout par trial ; le premier seuil atteint arrête tout |
from azure.ai.ml.sweep import Choice, Uniform, MedianStoppingPolicy

command_job_for_sweep = job(                       # le command job devient une fonction : on remplace des inputs
    learning_rate=Uniform(min_value=0.001, max_value=0.1),
    batch_size=Choice(values=[16, 32, 64]),
)
sweep_job = command_job_for_sweep.sweep(
    compute="gpu-cluster",
    sampling_algorithm="bayesian",
    primary_metric="val_accuracy",                 # le script fait mlflow.log_metric("val_accuracy", ...)
    goal="maximize",
)
sweep_job.set_limits(max_total_trials=40, max_concurrent_trials=4, timeout=7200)   # bayesian : >= 20 x nb d'hyperparamètres
sweep_job.early_termination = MedianStoppingPolicy(delay_evaluation=5, evaluation_interval=1)
returned = ml_client.create_or_update(sweep_job)
À retenir sur les policies :
- Bandit : avec
slack_factor=0.2et un meilleur trial à 0,8 (objectif maximiser), tout trial sous 0,8 / 1,2 = 0,66 est arrêté à l'intervalle évalué. - Median stopping (
evaluation_interval=1,delay_evaluation=5) : réglage prudent, environ 25 à 35 % d'économie sans perte sur la métrique selon Microsoft. - Bandit avec peu de marge ou Truncation avec un fort pourcentage : économies plus agressives.
- Bayesian : moins de trials en parallèle donne une meilleure convergence (chaque essai profite des précédents).
Le meilleur trial se récupère avec az ml job download --name <sweep> --output-name model ; le studio affiche le Parallel
Coordinates Chart et les nuages de points 2D / 3D. Chaque trial repart de zéro (modèle et data loaders reconstruits) : préparer
les données une fois en amont, dans une étape de pipeline.
6. Explorer les modèles avec AutoML#
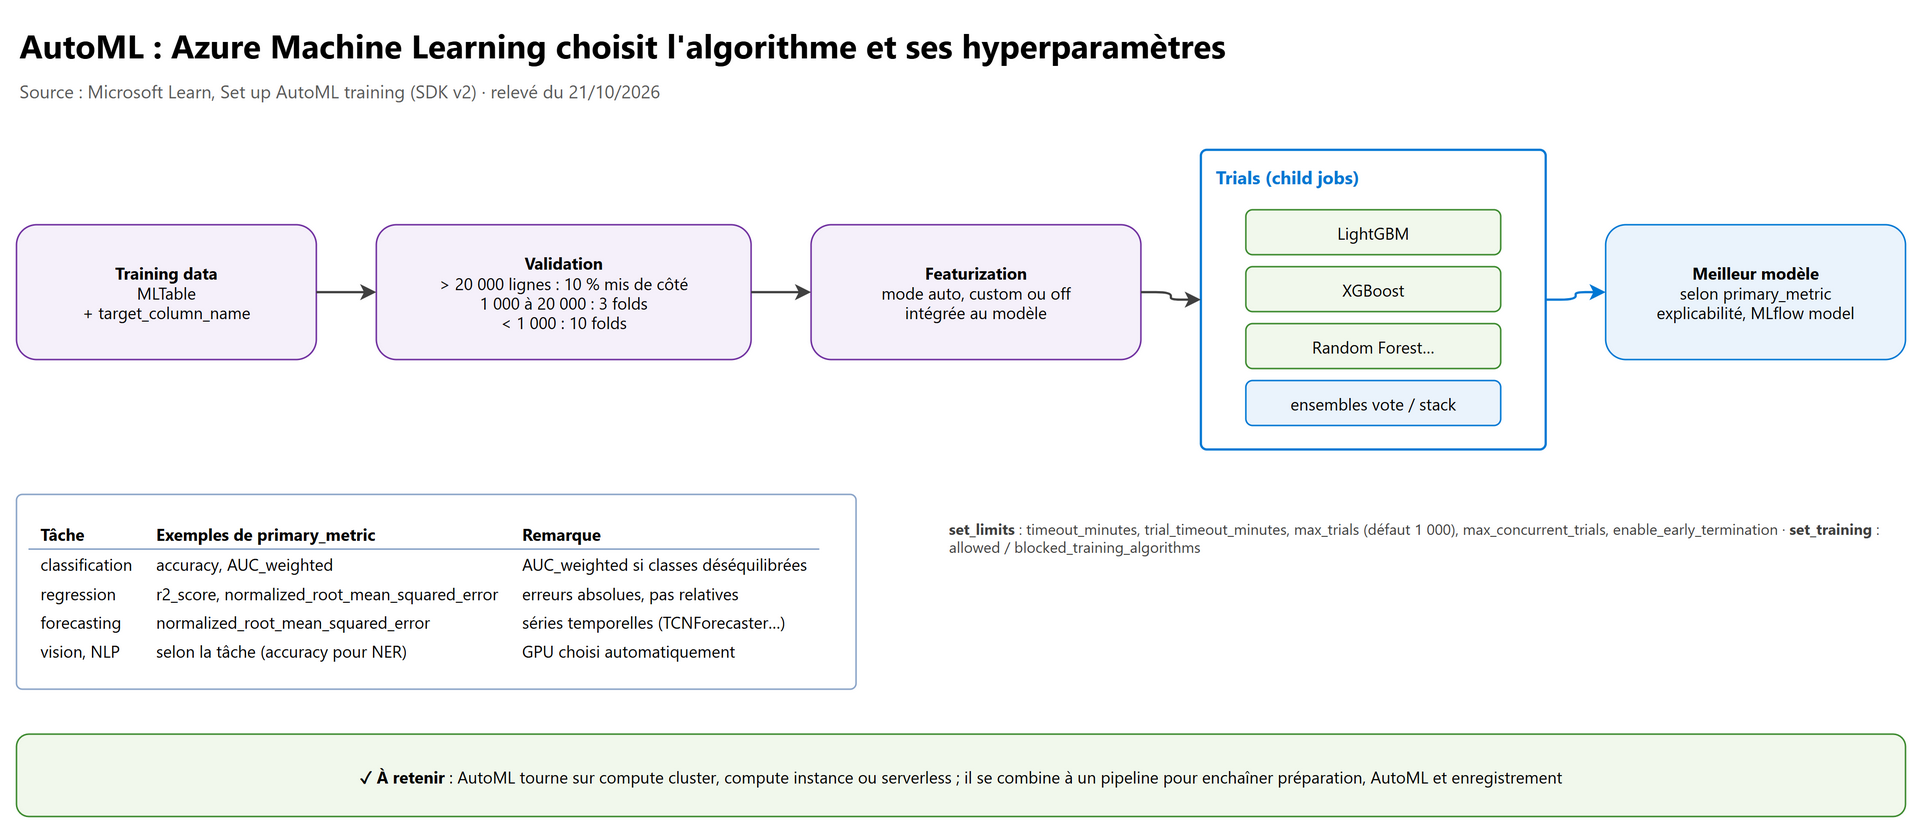
AutoML essaie des algorithmes et des hyperparamètres à votre place et rend un modèle prêt à déployer.
| Point | À retenir |
|---|---|
| Tâches | Tabulaire : classification, regression, forecasting ; vision : image classification, object detection ; NLP : text classification, entity recognition |
| Données | MLTable obligatoire en SDK / CLI v2 (fichier MLTable décrivant le format) ; target_column_name |
| Validation par défaut | > 20 000 lignes : 10 % mis de côté ; 1 000 à 20 000 lignes : 3 folds ; < 1 000 lignes : 10 folds ; sinon validation_data ou n_cross_validations |
primary_metric |
Classification : accuracy, AUC_weighted (meilleur choix si classes déséquilibrées), norm_macro_recall… ; régression : r2_score, normalized_root_mean_squared_error, normalized_mean_absolute_error, spearman_correlation |
| Featurization | auto (défaut), custom (imputer, types de colonnes, transformers bloqués), off ; elle fait partie du modèle et s'applique aussi en prédiction |
set_limits |
timeout_minutes (défaut 6 jours), trial_timeout_minutes, max_trials (défaut 1 000), max_concurrent_trials, enable_early_termination |
set_training |
allowed_training_algorithms / blocked_training_algorithms, ensembles (vote, stack), modèles compatibles ONNX |
| Compute | Compute cluster, compute instance (concurrence = nombre de cœurs) ou serverless ; vision et NLP prennent une VM GPU automatiquement |
from azure.ai.ml import automl, Input
from azure.ai.ml.constants import AssetTypes

classification_job = automl.classification(
    compute="cpu-cluster",
    experiment_name="churn-automl",
    training_data=Input(type=AssetTypes.MLTABLE, path="./data/training-mltable-folder"),
    target_column_name="churn",
    primary_metric="AUC_weighted",          # classes déséquilibrées
    n_cross_validations=5,
    enable_model_explainability=True,
)
classification_job.set_limits(timeout_minutes=120, trial_timeout_minutes=20, max_trials=30,
                              max_concurrent_trials=4, enable_early_termination=True)
classification_job.set_training(blocked_training_algorithms=["logistic_regression"])
returned = ml_client.jobs.create_or_update(classification_job)
Grandes volumétries : AutoML distribué pour LightGBM (classification, régression, jusqu'à environ 1 To,
training_mode=distributed, max_nodes ≥ 4, trials séquentiels) et TCNForecaster (forecasting, environ 200 Go). Pas de
cross-validation, d'ensembles, d'ONNX ni de génération de code dans ce mode. Deux exécutions identiques peuvent donner des scores un
peu différents : les algorithmes ont une part d'aléatoire.
7. Gérer le distributed training#
7.1 Data parallelism ou model parallelism#
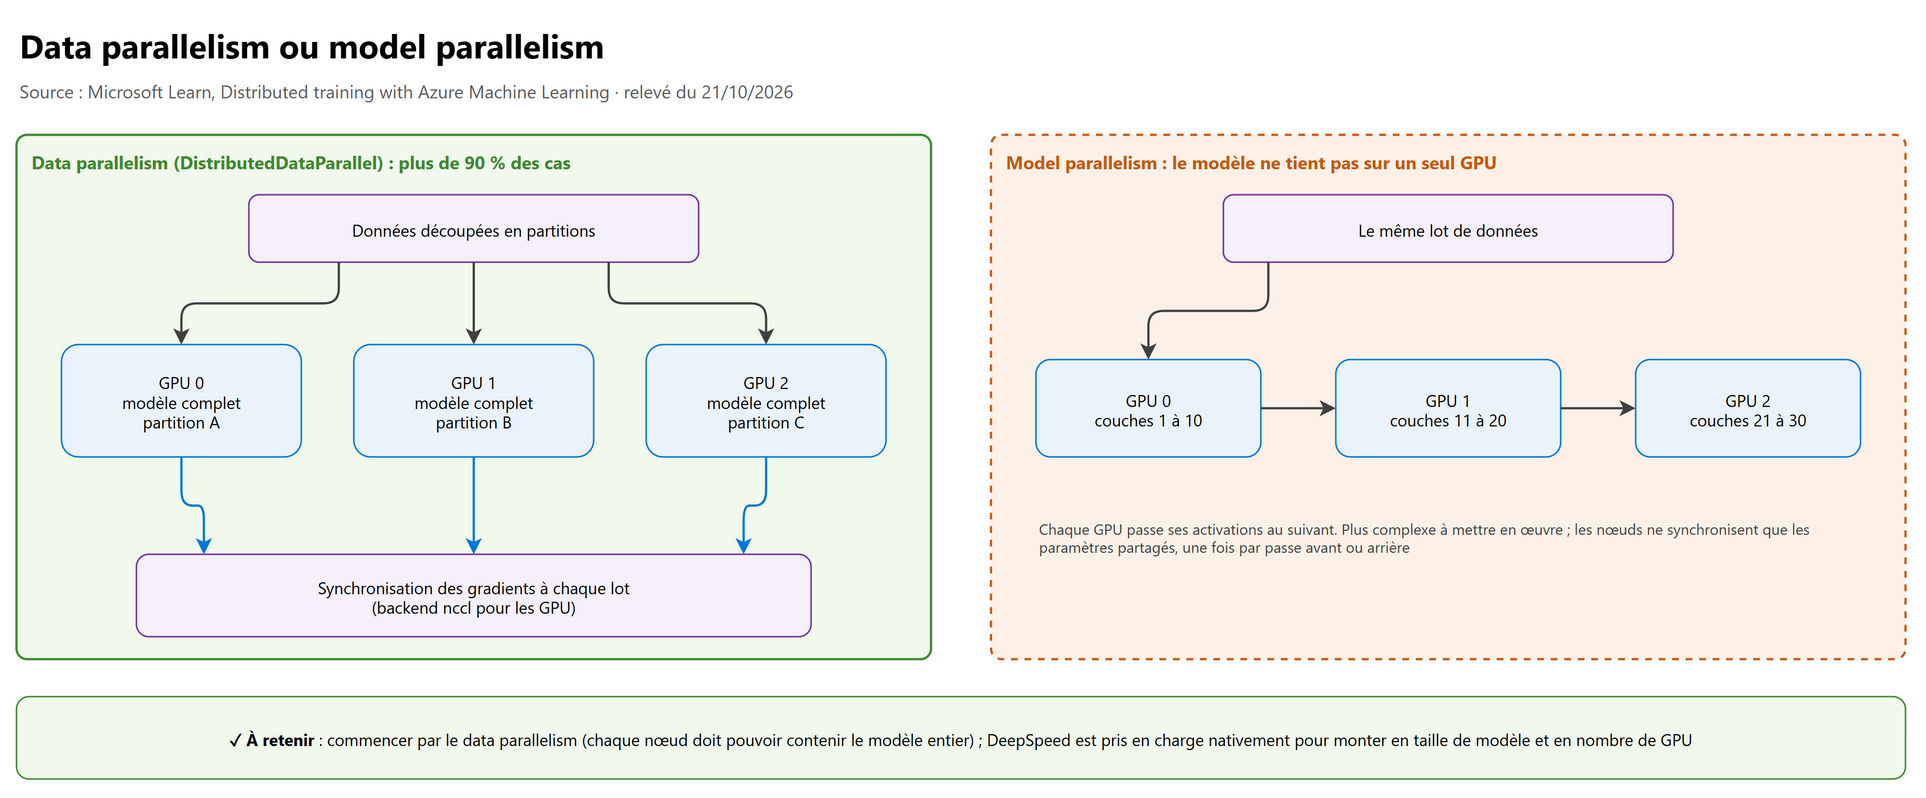
| Data parallelism | Model parallelism | |
|---|---|---|
| Principe | Le modèle est copié sur chaque GPU, chacun traite une partition des données ; les gradients sont synchronisés à chaque lot | Le modèle est découpé entre GPU, qui travaillent sur les mêmes données |
| Condition | Le modèle entier doit tenir sur chaque GPU | Le modèle est trop gros pour un GPU |
| Complexité | Simple : DistributedDataParallel (DDP) en PyTorch, tf.distribute.Strategy en TensorFlow |
Plus complexe ; outillé par des bibliothèques comme DeepSpeed |
| Usage | Plus de 90 % des cas selon Microsoft | Très gros modèles (LLM) |
7.2 PyTorch distribué dans un job#
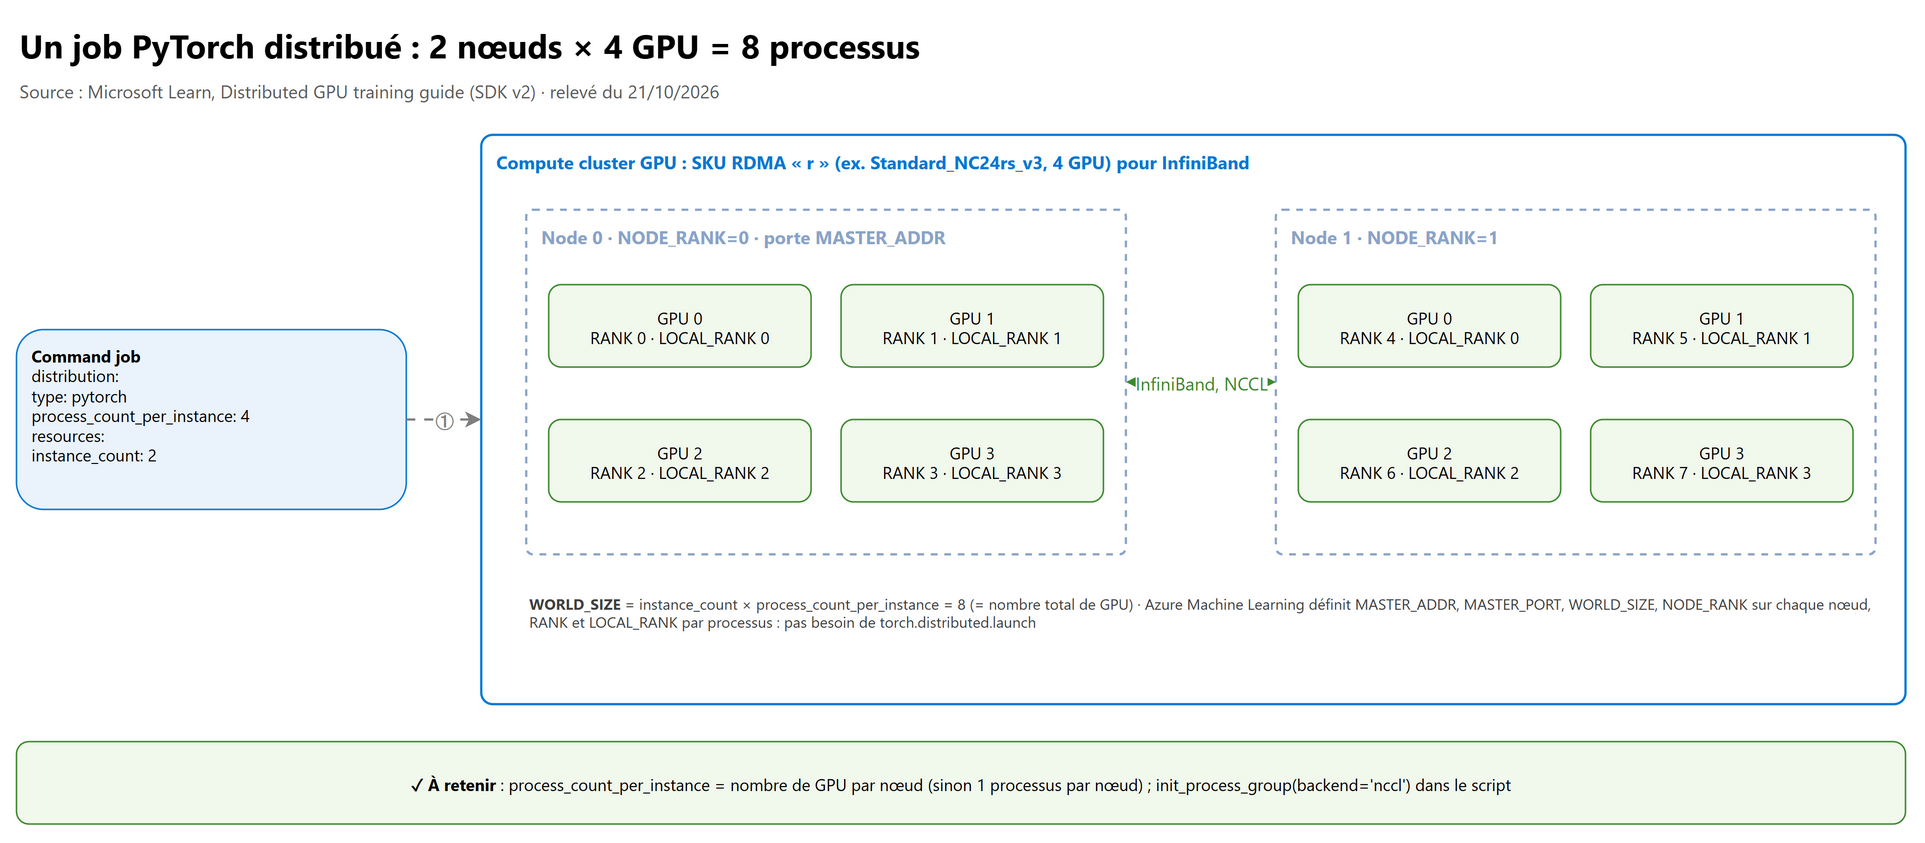
- Dans le script :
torch.distributed.init_process_group(backend="nccl", init_method="env://")(ncclpour les GPU ;glooetmpiexistent). - Dans le job :
distribution.type: pytorch,process_count_per_instance= nombre de GPU par nœud (sinon un seul processus par nœud),resources.instance_count= nombre de nœuds. Pas besoin detorch.distributed.launch. - Azure Machine Learning définit MASTER_ADDR, MASTER_PORT, WORLD_SIZE (nombre total de processus = de GPU) et NODE_RANK sur chaque nœud, puis RANK (rang global) et LOCAL_RANK (rang dans le nœud) par processus.
- Les tâches à faire une fois par nœud (préparation des données) se font sur
LOCAL_RANK == 0.
# distributed-job.yml : 2 nœuds × 4 GPU
$schema: https://azuremlschemas.azureedge.net/latest/commandJob.schema.json
code: src
command: python train.py --epochs ${{inputs.epochs}} --data ${{inputs.data}}
inputs:
  epochs: 10
  data:
    type: uri_folder
    path: azureml:imagenet-subset:1
environment: azureml:AzureML-acpt-pytorch-2.8-cuda12.6@latest
compute: azureml:gpu-cluster-ib          # SKU RDMA (« r ») pour InfiniBand
distribution:
  type: pytorch
  process_count_per_instance: 4          # = GPU par nœud
resources:
  instance_count: 2                      # nœuds
# train.py (extrait) : initialisation DDP, les variables viennent d'Azure Machine Learning
import os, torch, torch.distributed as dist

dist.init_process_group(backend="nccl", init_method="env://")
local_rank = int(os.environ["LOCAL_RANK"])
torch.cuda.set_device(local_rank)
model = torch.nn.parallel.DistributedDataParallel(build_model().cuda(local_rank), device_ids=[local_rank])
# ... boucle d'entraînement ; un seul processus (rang 0) écrit les checkpoints pour éviter 8 écritures du même fichier
sequenceDiagram
    autonumber
    participant U as Ingénieur
    participant AML as Azure Machine Learning
    participant N0 as Node 0 (4 processus)
    participant N1 as Node 1 (4 processus)
    U->>AML: az ml job create (distribution pytorch, 2 nœuds)
    AML->>N0: provisionne, MASTER_ADDR, WORLD_SIZE=8, NODE_RANK=0
    AML->>N1: provisionne, WORLD_SIZE=8, NODE_RANK=1
    N0->>N1: init_process_group (nccl) : les 8 processus se trouvent
    loop Chaque lot
        N0->>N1: synchronisation des gradients (InfiniBand si SKU RDMA)
    end
    N0->>AML: métriques MLflow, outputs, checkpoints
7.3 DeepSpeed, TensorFlow, MPI#
| Framework | Dans Azure Machine Learning |
|---|---|
| DeepSpeed | Pris en charge nativement, montée en charge quasi linéaire avec la taille du modèle et le nombre de GPU ; lancement par distribution PyTorch ou MPI, launcher DeepSpeed et autotuning de la configuration ds ; inclus dans l'environment ACPT (avec ONNX Runtime Training, MSCCL) ; exemples dans le dépôt azureml-examples/cli/jobs/deepspeed |
| TensorFlow | distribution.type: tensorflow avec worker_count (et parameter_server_count pour l'ancienne stratégie parameter server de TensorFlow 1.x) ; Azure Machine Learning définit TF_CONFIG sur chaque worker |
| MPI | distribution.type: mpi avec process_count_per_instance ; utilisé aussi par Horovod et DeepSpeed |
Microsoft Learn ne publie pas de YAML DeepSpeed : il renvoie au dépôt
Azure/azureml-examples(cli/jobs/deepspeed). À l'examen, retenir le principe : un command job avecdistribution.type: pytorch(oumpi), un environment qui contient DeepSpeed (ACPT) et le fichier de configurationdspassé au script. Le détail du fichierdsrelève de DeepSpeed, pas d'Azure.
7.4 InfiniBand et choix des VM#
- Le passage à l'échelle n'est linéaire que si les GPU communiquent vite entre nœuds : InfiniBand (faible latence, RDMA avec SR-IOV), disponible sur certaines VM NC, ND et H.
- En général, seules les tailles avec un « r » (RDMA) ont le matériel InfiniBand :
Standard_NC24rs_v3oui,Standard_NC24s_v3non (mêmes 24 cœurs, 448 Go, 4 GPU). L'ancienStandard_NC24rest RDMA sans SR-IOV, donc sans InfiniBand. - Sur un compute cluster de ces tailles, l'image système contient déjà le driver Mellanox OFED nécessaire.
- Quota : les GPU ont un quota par famille de VM ; le demander avant le jour J (Spot a un quota distinct).
7.5 Résister aux interruptions#
Un entraînement de plusieurs heures sur Spot peut être évincé : écrire des checkpoints réguliers sur un datastore et savoir
reprendre au dernier. L'ancien outil de checkpoint rapide Nebula (nebulaml) est déprécié et absent des images ACPT
récentes : on s'appuie sur les mécanismes de PyTorch, PyTorch Lightning ou DeepSpeed.
Pour les LLM : fine-tuning managé, choix entre Foundry, Azure Machine Learning et AKS (KAITO), dimensionnement des GPU et coût : voir les chapitres 07 et 08, et le parcours AKS 06.
8. Construire des training pipelines#
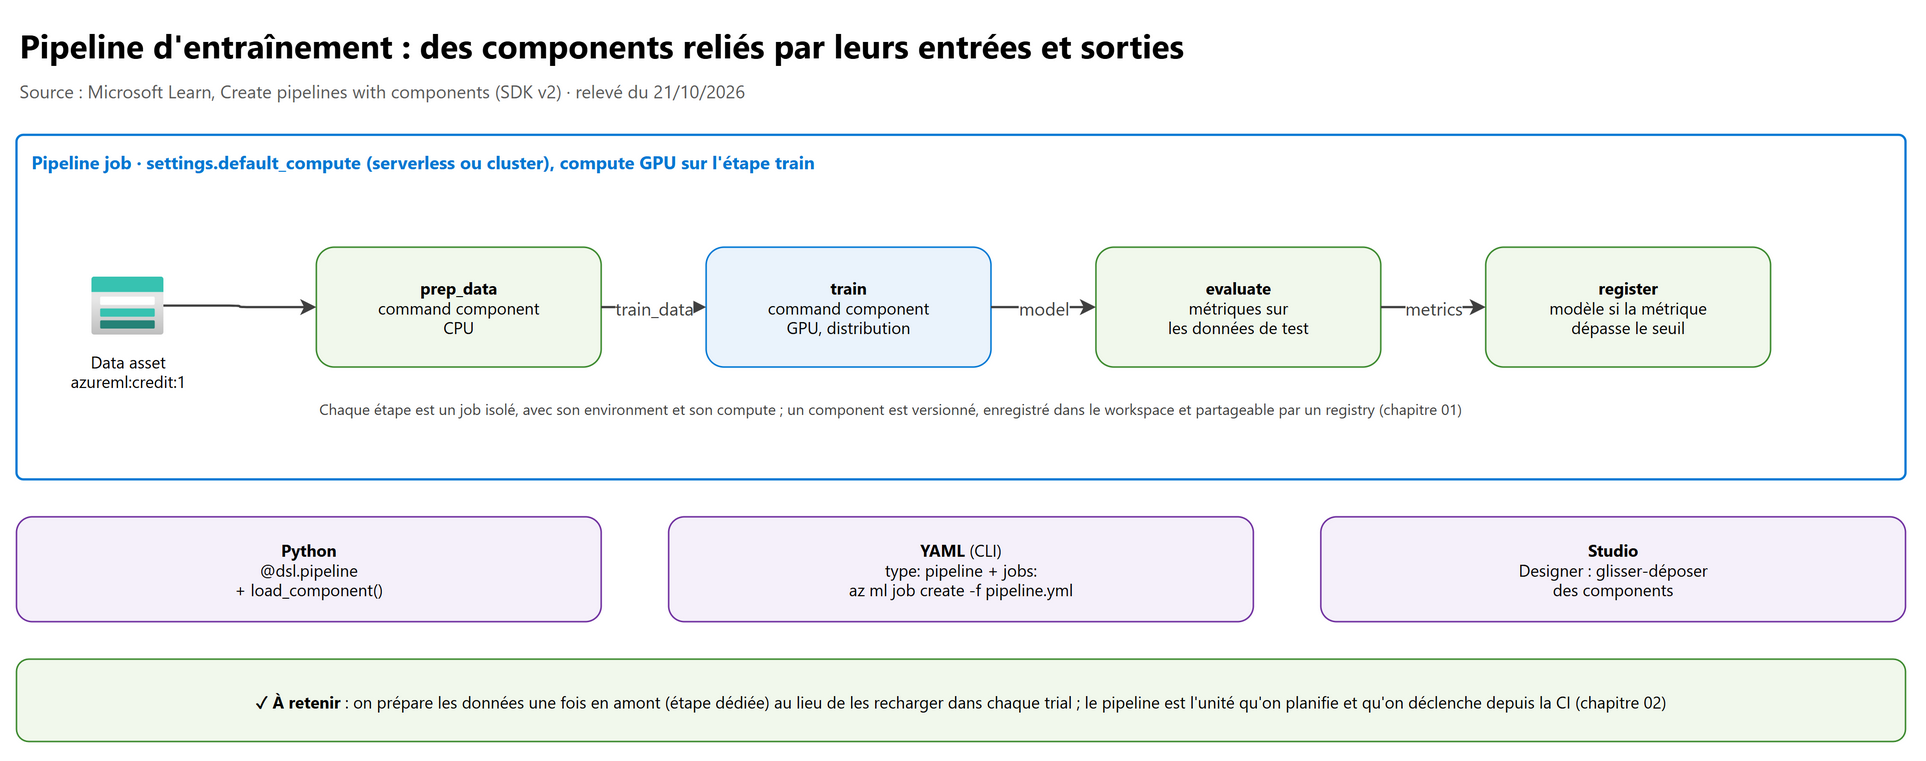
Un pipeline job enchaîne des étapes ; chaque étape est un job isolé (son environment, son compute) et la sortie de l'une devient l'entrée de la suivante. Les étapes sont des components : métadonnées (nom, version), interface (inputs, outputs), commande, code et environment. Un component enregistré est versionné, réutilisable par l'équipe et partageable entre workspaces par un registry (chapitre 01).
# train.yml : command component
$schema: https://azuremlschemas.azureedge.net/latest/commandComponent.schema.json
name: train_credit_model
version: 1
type: command
inputs:
  training_data: {type: uri_folder}
  learning_rate: {type: number, default: 0.01}
outputs:
  model_output: {type: mlflow_model}
code: ./train_src
environment: azureml:AzureML-acpt-pytorch-2.8-cuda12.6@latest
command: >-
  python train.py --data ${{inputs.training_data}} --lr ${{inputs.learning_rate}} --model ${{outputs.model_output}}
from azure.ai.ml import dsl, Input, load_component
from azure.ai.ml.entities import ResourceConfiguration

prep = load_component(source="./prep/prep.yml")
train = ml_client.components.get(name="train_credit_model", version="1")     # component déjà enregistré

@dsl.pipeline(description="Préparer puis entraîner", default_compute="serverless")
def credit_pipeline(raw_data):
    prep_step = prep(input_data=raw_data)
    train_step = train(training_data=prep_step.outputs.training_data, learning_rate=0.01)
    train_step.resources = ResourceConfiguration(instance_type="Standard_NC6s_v3", instance_count=1)   # GPU pour cette étape seulement
    return {"model": train_step.outputs.model_output}

pipeline_job = credit_pipeline(raw_data=Input(type="uri_folder", path="azureml:credit-raw:1"))
ml_client.jobs.create_or_update(pipeline_job, experiment_name="credit-pipeline")
| Façon de créer | Usage |
|---|---|
Python : @dsl.pipeline, load_component(), ml_client.components.create_or_update() |
Le plus souple, testable |
YAML : type: pipeline, jobs:, ${{parent.inputs.x}}, ${{parent.jobs.step.outputs.y}} |
Versionné dans Git, lancé par az ml job create depuis la CI (chapitre 02) |
| Studio Designer | Glisser-déposer de components enregistrés |
Une étape AutoML peut aussi faire partie du pipeline : son output best_model (type mlflow_model) alimente l'étape suivante.
Un pipeline component peut enfin être déployé derrière un batch endpoint (chapitre 04).
9. Comparer les performances entre jobs#
| Outil | Ce qu'il permet |
|---|---|
| Studio > Jobs | Liste des jobs par experiment, onglet Metrics (graphiques, lissage, plusieurs métriques sur un graphe, vues partageables) |
| Comparer (preview) | Sélectionner des jobs ou des modèles et comparer paramètres, métriques et tags (fonction à activer dans le panneau des préversions) |
| Sweep job | Metrics chart, Parallel Coordinates Chart, nuages 2D et 3D entre hyperparamètres et primary_metric |
MLflow search_runs() |
Comparer par programme, sur un ou plusieurs experiments (search_all_experiments=True) ; résultat en DataFrame pandas |
import mlflow

runs = mlflow.search_runs(
    experiment_names=["credit-training"],
    filter_string="metrics.val_accuracy > 0.85 AND params.optimizer = 'adam'",   # AND seulement, pas de OR
)
best = runs.sort_values("metrics.val_accuracy", ascending=False).head(5)        # trier sur une métrique : pandas
Limites Azure Machine Learning à connaître : order_by accepte les attributs (attributes.start_time, attributes.duration,
ce dernier ajouté par Azure Machine Learning) mais pas metrics.*, params.* ni tags.* → trier avec pandas ; filtres sur
les paramètres avec =, !=, LIKE seulement ; pas de OR.
10. Labs conseillés#
Dans un abonnement de test, avec un workspace dédié (chapitre 01). Coûts indicatifs : une compute instance CPU coûte peu par heure ; les VM GPU coûtent nettement plus et ont un quota à demander. Arrêter la compute instance et supprimer le groupe de ressources à la fin.
- MLflow sans effort : sur une compute instance, notebook scikit-learn avec
mlflow.autolog(); relancer avec deux valeurs d'un hyperparamètre. Attendu : deux runs dans l'experiment, paramètres et métriques visibles dans le studio, modèle en artifact. - Du notebook au command job : transformer le notebook en
train.py, le lancer paraz ml job create -f job.ymlsans compute (serverless). Attendu : le job tourne sans cluster créé, logs dansuser_logs/std_log.txt, mêmes métriques MLflow. - Sweep job : search space de 2 hyperparamètres, sampling
random,max_total_trials=12,max_concurrent_trials=4,MedianStoppingPolicy. Attendu : certains trials arrêtés tôt, Parallel Coordinates Chart lisible, meilleur trial téléchargé. - AutoML : un jeu tabulaire en MLTable, classification avec
max_trials=10. Attendu : classement des modèles, featurization summary, explications du meilleur modèle. - Distribué (si quota GPU) : job PyTorch avec
instance_count: 2etprocess_count_per_instance= nombre de GPU de la VM ; le script afficheRANK,LOCAL_RANK,WORLD_SIZE. Attendu : unstd_logpar processus avec des rangs différents ; ajouter un service SSH etsleep 30mpour lancernvidia-smisur le nœud 1, puis annuler le job.
11. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Logger des métriques avec le SDK v2 | MLflow (mlflow.log_metric) |
Le SDK v2 n'a pas de fonction de logging |
| Tracer depuis un poste local ou Databricks | Installer azureml-mlflow et fixer la tracking URI du workspace |
Automatique seulement sur le compute Azure Machine Learning |
Un job appelle mlflow.start_run() sans raison |
Inutile dans un job : le run est déjà démarré | — |
| Le sweep ne trouve pas sa métrique | primary_metric doit avoir exactement le nom loggé |
La policy et le classement s'appuient dessus |
Grid sampling avec un Uniform |
Impossible : grid = Choice seulement |
Grid énumère des valeurs discrètes |
| Économiser sans perdre de bons trials | Median stopping, evaluation_interval=1, delay_evaluation=5 |
Réglage prudent recommandé |
| Économiser davantage | Bandit avec faible slack ou Truncation avec fort pourcentage | Plus agressif |
| Bayesian sampling efficace | Peu de trials concurrents, max_total_trials ≥ 20 × nombre d'hyperparamètres |
Chaque essai profite des précédents |
| AutoML avec des classes très déséquilibrées | primary_metric = AUC_weighted |
Les métriques à seuil (accuracy) optimisent mal |
| Données d'entrée d'AutoML en SDK v2 | MLTable | Format attendu par AutoML v2 |
| La featurization AutoML en production | Elle est dans le modèle, appliquée automatiquement aux nouvelles données | — |
| Job PyTorch sur 2 nœuds de 4 GPU qui n'utilise qu'un GPU par nœud | Fixer process_count_per_instance: 4 |
Par défaut : 1 processus par nœud |
| Valeur de WORLD_SIZE | instance_count × process_count_per_instance (= nombre de GPU) | — |
Faut-il torch.distributed.launch ? |
Non | Azure Machine Learning lance les processus et définit les variables |
| Multi-nœuds lent, gains non linéaires | VM avec InfiniBand : taille avec « r » (RDMA, SR-IOV) | La communication inter-nœuds limite |
| Le modèle ne tient pas sur un GPU | Model parallelism, par exemple avec DeepSpeed | Le data parallelism exige le modèle entier par GPU |
tier: low_priority aujourd'hui |
Tourne en Spot (retrait des low-priority au 31/03/2026) | Tarif Spot variable, éviction possible : checkpoints |
| Compute instance en Spot | Impossible | Usage interactif |
| Compute instance qui ne s'arrête jamais malgré l'idle shutdown | Donner Contributor sur le workspace à sa managed identity, vérifier qu'aucune application custom ne tourne | Conditions de l'idle shutdown |
| Déboguer un job distribué en cours | Interactive job : JupyterLab, VS Code, TensorBoard ou SSH par node index | Seul le propriétaire du job y accède |
Trier des runs par métrique avec order_by |
Pas pris en charge : trier le DataFrame avec pandas | order_by = attributs seulement |
Filtre avec OR dans search_runs |
Pas pris en charge : faire deux requêtes | Seul AND existe |
| Recharger les données dans chaque trial | Préparer une fois dans une étape de pipeline | Chaque trial repart de zéro |
12. Scénarios corrigés#
1. Une data scientist entraîne sur son portable avec MLflow et veut voir ses runs dans le workspace de l'équipe. Que faire ?
- A. Installer
azure-ai-mlet appelerml_client.log_metric() - B. Installer
mlflowetazureml-mlflow, puismlflow.set_tracking_uri()avec la tracking URI du workspace - C. Rien, c'est automatique partout
- D. Exporter un CSV et le téléverser comme data asset
B. Hors du compute Azure Machine Learning, il faut le plugin et la tracking URI. A : le SDK v2 n'a pas de logging. C : vrai seulement sur compute instance et jobs.
2. Un sweep job sur 4 hyperparamètres utilise le sampling bayesian avec max_total_trials=20 et max_concurrent_trials=20.
Les résultats sont médiocres. Deux corrections ?
Monter
max_total_trialsà au moins 80 (20 × 4) et réduiremax_concurrent_trials: la méthode bayésienne profite des trials déjà terminés, ce qui est impossible si tous partent en même temps.
3. L'équipe veut couper les trials peu prometteurs sans risquer d'éliminer le futur meilleur. Quelle policy ?
Median stopping avec
evaluation_interval=1etdelay_evaluation=5: le réglage prudent recommandé (environ 25 à 35 % d'économie sans perte sur la métrique principale).
4. Un modèle de détection de fraude (0,5 % de fraudes) est entraîné avec AutoML et primary_metric="accuracy". Il prédit
« pas de fraude » partout avec 99,5 % d'accuracy. Que changer ?
primary_metric="AUC_weighted": les métriques à seuil comme l'accuracy optimisent mal les jeux très déséquilibrés.
5. Un job PyTorch sur deux Standard_NC24rs_v3 (4 GPU chacun) affiche WORLD_SIZE=2. Pourquoi, et comment corriger ?
process_count_per_instancen'est pas renseigné : Azure Machine Learning lance un seul processus par nœud. Le fixer à 4 :WORLD_SIZEpasse à 8 et les 8 GPU travaillent.
6. Le même entraînement passe de 1 à 4 nœuds mais ne va que 1,5 fois plus vite. Les VM sont des Standard_NC24s_v3. Piste
principale ?
Pas d'InfiniBand : la synchronisation des gradients passe par Ethernet. Utiliser la taille RDMA
Standard_NC24rs_v3(le « r »), dont l'image contient le driver OFED.
7. Un LLM de taille moyenne ne tient pas dans la mémoire d'un GPU, même avec un petit batch. Quelle approche ?
Model parallelism : le data parallelism exige le modèle complet sur chaque GPU. Azure Machine Learning prend en charge DeepSpeed (distribution PyTorch ou MPI, environment ACPT).
8. Pour réduire le coût, un cluster d'entraînement est créé avec tier: low_priority. Quel est le comportement en 2026 et que
faut-il prévoir ?
Depuis le 31/03/2026, les nœuds sont alloués en Spot : tarif variable et éviction possible. Écrire des checkpoints réguliers dans un datastore et savoir reprendre au dernier.
9. Un job distribué se fige au bout de 20 minutes sur le nœud 1 seulement. L'ingénieur veut inspecter ce nœud en direct.
Relancer le job avec un interactive job (service SSH ou VS Code) et
sleepen fin de commande, puisaz ml job connect-ssh --node-index 1. Attention : VS Code etdebugpyne fonctionnent pas avec un workspace en private link ; SSH reste possible selon le réseau.
10. Une équipe relance chaque semaine : préparation des données, entraînement GPU, évaluation, enregistrement si la métrique est bonne. Elle veut que chaque étape tourne sur la bonne machine et soit réutilisable par d'autres projets.
Un pipeline job fait de components enregistrés (et partagés par un registry) :
default_computeserverless ou CPU, etresourcesGPU sur la seule étape d'entraînement. Le pipeline est lancé depuis la CI (chapitre 02).
13. Pour aller plus loin#
- Responsible AI dashboard et évaluation du modèle obtenu : chapitre 04.
- Spark jobs (serverless Spark) pour préparer de gros volumes de données avant l'entraînement.
- Coût d'un entraînement : mesurer l'utilisation GPU (métriques du job) avant de choisir plus de nœuds ; un job qui n'utilise ses GPU qu'à 30 % est en général limité par le chargement des données (voir diagnosing data loading bottlenecks).
- Entraînement de LLM en mission : arbre de décision prompt, RAG, fine-tuning, entraînement complet, et choix de la plateforme : chapitre 08.
14. Fiche à retenir#
- Tout est un job : command, sweep, AutoML, pipeline ; sans compute indiqué → serverless compute.
- Le SDK v2 ne logge rien : MLflow ; automatique sur compute instance et jobs,
azureml-mlflow+ tracking URI ailleurs. -
autolog(),log_param(s),log_metric,log_artifact; rôle AzureML Data Scientist ou Contributor. - Compute instance : mono-nœud, personnelle, idle shutdown 15 min à 3 jours, pas de Spot ;
%pipdans le kernel. - Interactive jobs : JupyterLab, VS Code, TensorBoard, SSH ;
sleep; seul le propriétaire ; pas de VS Code en private link. - Sweep : search space, sampling grid (Choice) / random (Sobol) / bayesian,
primary_metricau nom exact, policies Bandit / Median stopping / Truncation, limits. - AutoML : MLTable, règles de validation (20 000 / 1 000 lignes),
AUC_weightedsi déséquilibre, featurization dans le modèle. - Data parallelism par défaut (> 90 %), model parallelism si le modèle ne tient pas sur un GPU (DeepSpeed).
- PyTorch :
nccl,process_count_per_instance= GPU par nœud,instance_count= nœuds, variables MASTER_ADDR, WORLD_SIZE, NODE_RANK, RANK, LOCAL_RANK fournies. - TensorFlow :
worker_count,TF_CONFIG; MPI :type: mpi. - InfiniBand : SKU avec « r » (RDMA + SR-IOV), driver OFED préinstallé.
- Low-priority retiré le 31/03/2026 → Spot ; checkpoints obligatoires ; Nebula déprécié.
- Pipelines : components versionnés,
@dsl.pipelineou YAML, compute par étape, registry pour partager. - Comparer : studio, sweep charts,
search_runs(pas d'order_bysur les métriques, pas deOR).
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Study guide for Exam AI-300
- MLflow and Azure Machine Learning
- Configure MLflow for Azure Machine Learning
- Log metrics, parameters, and files with MLflow
- Query and compare experiments and runs with MLflow
- What is an Azure Machine Learning compute instance?
- Create an Azure Machine Learning compute instance (idle shutdown)
- Run Jupyter notebooks in your workspace
- Debug jobs and monitor training progress (interactive jobs)
- Model training on serverless compute
- Manage and optimize Azure Machine Learning costs (low-priority VMs)
- Hyperparameter tuning a model (v2)
- Set up AutoML training for tabular data (CLI and Python SDK)
- Distributed training with Azure Machine Learning
- Distributed GPU training guide (SDK v2)
- Azure Container for PyTorch (ACPT)
- Boost checkpoint speed with Nebula (déprécié)
- Create and run machine learning pipelines by using components (SDK v2)
- Tutorial: Create production machine learning pipelines
- Create and run pipelines by using components in the studio