
Version : 1.1 · Date : 2026-10-22 · Domaine 1 de l'examen : Architect multi-agent solutions (15 à 20 %)
En une phrase : avant de choisir un seul composant Azure, l'architecte découpe l'objectif en workflows, agents et outils, décide pour chaque étape qui tranche (le code, le modèle ou un humain), borne ce que chaque agent peut faire et avec quelle identité, choisit le protocole de chaque échange (MCP, A2A, appel interne), organise la mémoire et donne à chaque tâche le modèle qui lui suffit, le tout sous les principes d'IA responsable et une expérience utilisateur (HAX) qui garde l'humain en contrôle.
Ce que l'examen demande#
Bloc Design logical architecture for multi-agent solutions, repris mot pour mot du guide d'étude AI-500 (relu le 22/10/2026, inchangé) :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| 1 | Decompose goals and objectives into workflows, agents, and tools | 1 |
| 2 | Design workflows, including agents, subagents, control loops, and human-in-the-loop | 2 |
| 3 | Specify agent personas, scopes, boundaries, autonomy levels, and behavioral guidelines | 3 |
| 4 | Specify tool scopes, permission boundaries, and authentication methods | 4 |
| 5 | Specify appropriate protocols for communication, including between multiple agents and between agents and other components | 5 |
| 6 | Design controls and functionality to support human-AI experience (HAX) and to adhere to responsible AI principles | 6 |
| 7 | Design short-term and long-term memory architectures, including context sharing | 7 |
| 8 | Match task demands to model family capacities | 8 |
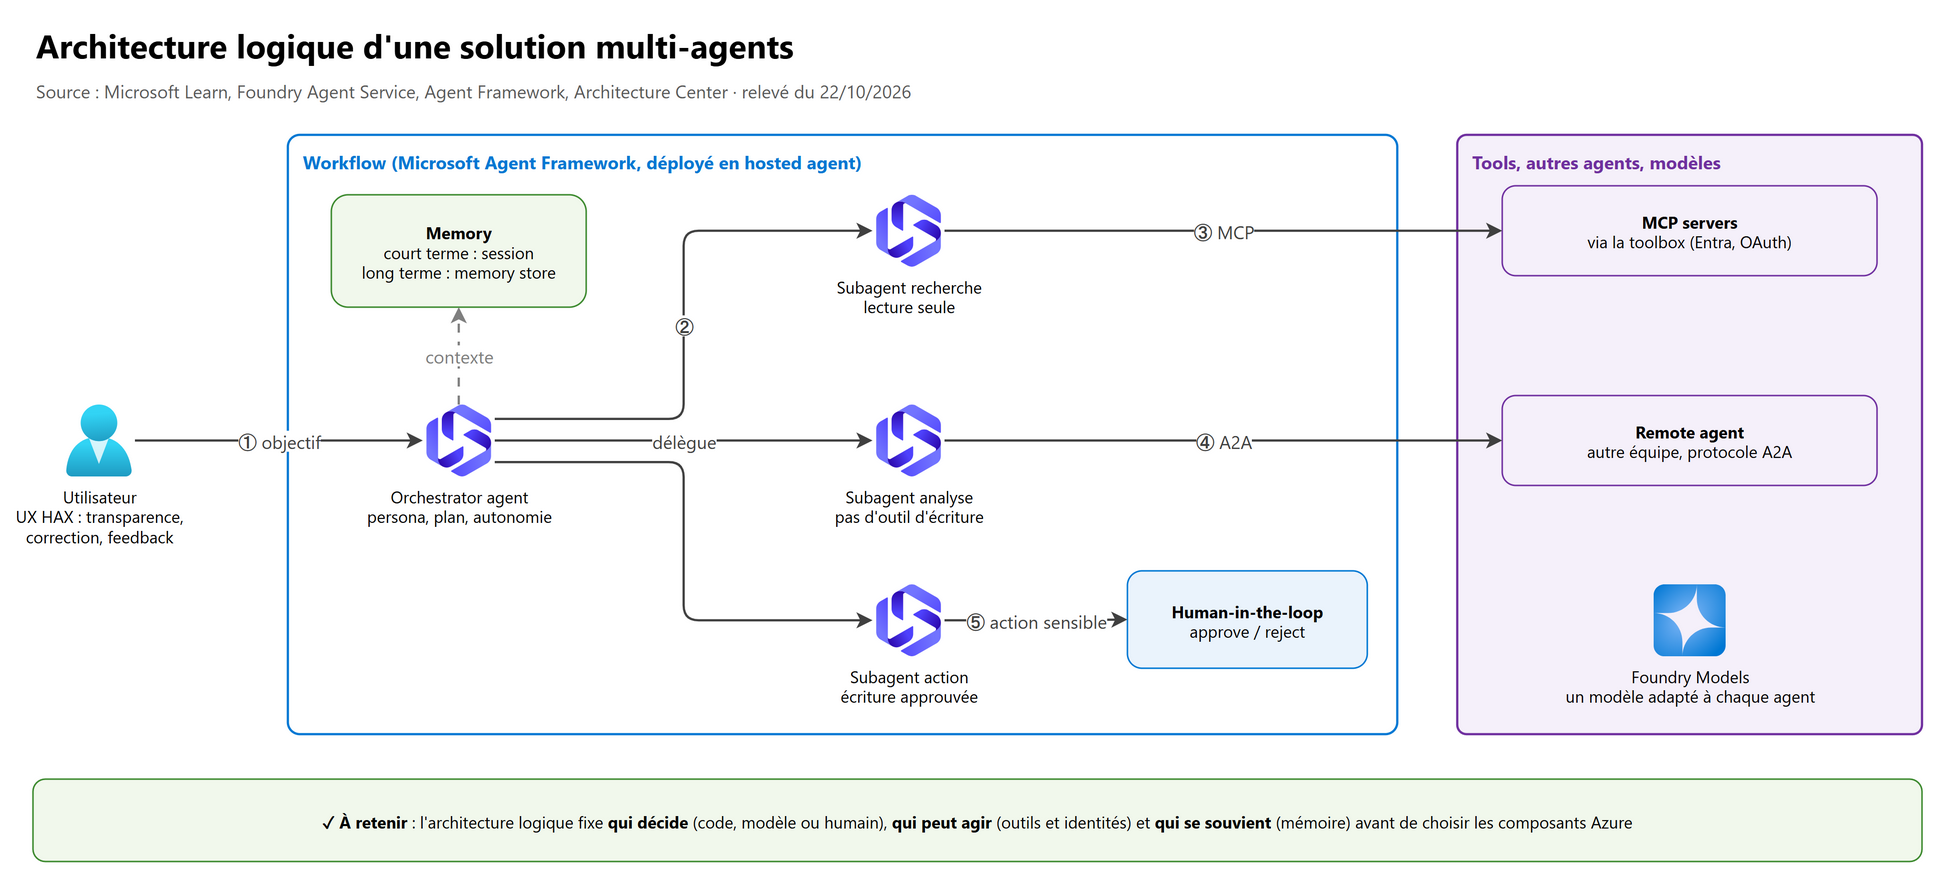
Ce chapitre est logique : il dit quoi et pourquoi. Le choix des composants techniques (intégration, Zero Trust, persistance, compute, observabilité, SDLC) est au chapitre 02 ; la mémoire et le contexte en profondeur au chapitre 03 ; les outils et MCP au chapitre 04 ; l'orchestration au chapitre 05. Les bases déjà vues ne sont pas répétées : agents Foundry dans AI-103, chapitre 06, modèles et workflows dans AI-103, chapitre 07, IA responsable dans AI-103, chapitre 04, boucles agentiques et coordinator-subagent dans Claude Architecte, chapitre 01.
0. AI-500 en bref#
| Élément | Valeur |
|---|---|
| Certification | Microsoft Certified: Multi-Agent AI Solutions Expert (niveau Expert) |
| Prérequis | Microsoft Certified: Azure AI Apps and Agents Developer Associate (AI-103), obligatoire |
| Statut | Bêta (page de l'examen) ; une réponse de modérateur sur Microsoft Q&A annonçait la mise en ligne en octobre 2026 (source non officielle) |
| Réussite | 700 sur 1 000 |
| Domaines | Architect (15 à 20 %) · Develop (30 à 35 %) · Evaluate, optimize, and monitor (20 à 25 %) · Secure, govern, and deploy (20 à 25 %) |
| Formation officielle | Cours AI-500T00-A : 4 parcours, 17 modules, environ 826 minutes |
| Profil attendu | Python (async, REST), Foundry Agent Service, Microsoft Agent Framework, MCP, A2A, RAG, LangGraph, et les briques Azure (compute, réseau, stockage, données) |
Le premier parcours officiel, Architect production-grade multi-agent AI solutions in Azure, pose ses prérequis noir sur blanc : AI-103 ou une expérience équivalente, Foundry Agent Service et Agent Framework, les motifs d'orchestration de base (sequential, concurrent, group chat, handoff), les bases du protocole A2A et Python asynchrone.
Ce qui change par rapport aux autres cours :
| AI-103 (Associate) | AI-500 (Expert) | Claude Architecte (Anthropic) | |
|---|---|---|---|
| Question type | « Comment construire cet agent dans Foundry ? » | « Quelle architecture, quels compromis, quels contrôles pour un système d'agents en production ? » | « Comment concevoir un agent fiable avec Claude et Claude Code ? » |
| Unité de travail | Un agent, ses outils, ses guardrails | Un système : plusieurs agents, équipes, frontières de sécurité, cycle de vie | Un agent ou un coordinator et ses subagents |
| Plateforme | Foundry | Foundry, Agent Framework, Azure (Cosmos DB, Redis, Container Apps, API Management…), LangGraph | Claude API, Agent SDK, MCP |
| Ce cours s'appuie dessus pour | Les mécanismes (tools, approbations, model router) | — | Les principes (boucle, passage de contexte, enforcement) |
Réflexe d'examen Expert : la bonne réponse est rarement « ajouter un agent » ; c'est souvent la solution la plus simple qui respecte une contrainte (frontière de sécurité, équipe propriétaire, coût, latence, autonomie acceptable).
1. Décomposer les objectifs en workflows, agents et outils#
1.1 Le vocabulaire de la décomposition#
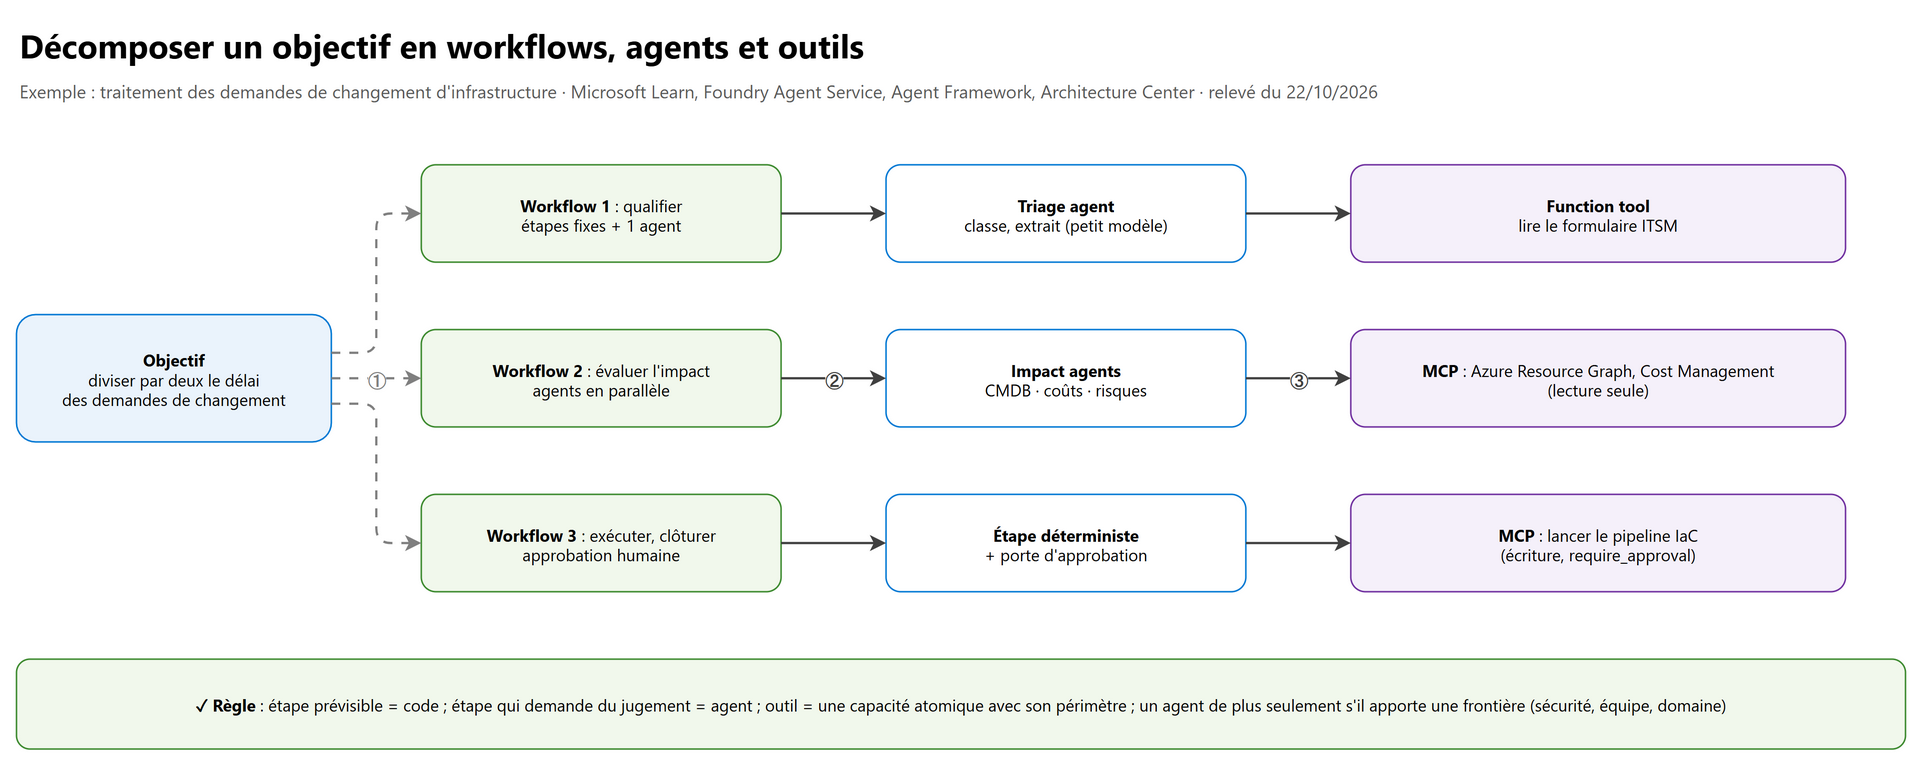
| Niveau | Définition | Exemple (demandes de changement d'infrastructure) |
|---|---|---|
| Objectif | Résultat métier mesurable | Diviser par deux le délai de traitement |
| Workflow | Processus avec un début, une fin, des étapes et des règles de passage | Qualifier → évaluer l'impact → exécuter et clôturer |
| Étape | Unité de travail ; déterministe (code) ou agentique (jugement du modèle) | « Calculer le coût estimé » est déterministe ; « juger le risque » est agentique |
| Agent | Un modèle, des instructions, des outils, une responsabilité | Triage agent, Impact agent |
| Outil | Une capacité atomique, avec son périmètre et son identité | Lire un formulaire ITSM, interroger Azure Resource Graph |
1.2 D'abord : faut-il vraiment plusieurs agents ?#
L'Azure Architecture Center recommande le niveau de complexité le plus bas qui répond au besoin : un appel direct au modèle, puis un agent unique avec outils, puis seulement l'orchestration multi-agents (détail et anti-patterns dans AI-103, chapitre 07, section 5.1).
Le Cloud Adoption Framework (Single agent or multiple agents) donne les critères qui justifient d'emblée plusieurs agents ; en dehors de ces cas, il conseille de prototyper d'abord un agent unique :
| Critère | Pourquoi il impose plusieurs agents |
|---|---|
| Frontière de sécurité ou de conformité | Des données ou des actions qui ne doivent pas coexister dans le même contexte ni sous la même identité |
| Plusieurs équipes | Chaque domaine a son propriétaire, son cycle de release, ses évaluations |
| Croissance prévue | Au-delà de 3 à 5 fonctions distinctes, un agent unique devient difficile à maintenir et à évaluer |
Avant de découper, le CAF propose d'essayer dans un agent unique la persona switching, le conditional prompting et le context gating. Les coûts du multi-agents qu'il cite : latence à chaque passage d'un agent à l'autre, contexte redondant (donc des jetons en plus) et surface d'attaque plus large. En cas de doute, son cadre de décision recommande un prototype comparatif (agent unique contre multi-agents, mêmes jeux de test).
flowchart TD
    A["Nouvel objectif"] --> B{"Un appel au modèle<br/>bien écrit suffit ?"}
    B -- Oui --> D["Direct model call"]
    B -- Non --> C{"Frontière de sécurité,<br/>plusieurs équipes,<br/>ou plus de 3 à 5 fonctions ?"}
    C -- Oui --> M["Multi-agents :<br/>un agent par frontière"]
    C -- Non --> E{"Un agent unique avec outils<br/>atteint la qualité visée ?"}
    E -- Oui --> S["Single agent with tools"]
    E -- "Je ne sais pas" --> P["Prototype comparatif<br/>(mêmes évaluations)"]
    E -- Non --> M
1.3 La méthode, étape par étape#
- Écrire l'objectif et ses mesures : qualité attendue, délai, coût par traitement, taux d'escalade acceptable. Sans mesure, aucune évaluation possible au chapitre 06.
- Dessiner le processus sans parler d'IA : étapes, entrées, sorties, règles de passage, exceptions.
- Classer chaque étape : prévisible et vérifiable → code (executor de workflow, règle, appel d'API) ; demande du jugement sur du texte ou des données variées → agent ; irréversible ou à fort impact → porte d'approbation humaine.
- Regrouper les étapes agentiques en agents selon les frontières du tableau 1.2 (données, identité, équipe, domaine), pas selon le nombre d'étapes.
- Définir les outils de chaque agent : le plus petit jeu possible, chacun avec un verbe clair, lecture et écriture séparées (un outil d'écriture se protège différemment, section 4).
- Choisir le motif d'orchestration de chaque workflow (sequential, concurrent, handoff, group chat, magentic, orchestrator-subagent : section 2.2).
- Attribuer un modèle à chaque agent (section 8) et fixer les contrôles (autonomie, mémoire, guardrails).
1.4 La bonne granularité#
Le module officiel Apply task decomposition and agent collaboration strategies in Microsoft Foundry demande explicitement de balancer la granularité contre le coût de coordination : chaque agent en plus ajoute un passage de contexte, des jetons, un point de panne et une évaluation à maintenir.
| Trop gros | Trop fin |
|---|---|
| Un agent avec 25 outils hésite, se trompe d'outil, son prompt grossit | Dix agents qui se renvoient la balle, contexte perdu à chaque handoff |
| Impossible d'isoler les droits : l'identité a tout | Coût et latence multipliés, débogage difficile |
| Une évaluation globale qui ne dit pas où est le problème | Une sous-tâche si étroite que le coordinator couvre mal le sujet |
Le piège de la décomposition trop étroite (un coordinator qui ne délègue qu'une partie du sujet) et la décomposition dynamique sont détaillés dans Claude Architecte, chapitre 01, sections 2.4 et 6 : les principes sont les mêmes avec Agent Framework.
2. Workflows, subagents, boucles de contrôle et human-in-the-loop#
2.1 Workflow explicite ou boucle d'agent#
| Workflow (graphe explicite) | Boucle d'agent | |
|---|---|---|
| Qui choisit l'étape suivante | Le code : edges, conditions, routage | Le modèle, à chaque tour |
| Prévisibilité | Forte : chemin connu, testable | Variable : adapté aux problèmes ouverts |
| Outil Microsoft | Microsoft Agent Framework workflows (executors, edges, checkpoints, request info) | Un agent Agent Framework ou un prompt agent Foundry avec ses tools |
| Quand | Processus métier, conformité, étapes d'approbation | Recherche, analyse, résolution de problème |
La plupart des solutions réelles combinent les deux : un workflow fixe la structure, les agents interviennent là où le raisonnement apporte quelque chose. Les patterns workflow-oriented de Microsoft insistent sur le séquencement explicite, les guards et préconditions, l'idempotence, les retries et le traitement des dead letters, les portes d'approbation (dans Teams ou Outlook) et le moindre privilège (managed identities, politiques d'accès aux outils MCP).
Squelette Agent Framework : une étape déterministe qui qualifie, puis deux chemins selon une condition sur le message.
import asyncio

from agent_framework import WorkflowBuilder, WorkflowContext, executor
from typing_extensions import Never


@executor(id="qualifier")
async def qualifier(demande: str, ctx: WorkflowContext[str]) -> None:
    # Étape déterministe : une règle, pas un modèle
    niveau = "STANDARD" if "redémarrer" in demande.lower() else "NORMAL"
    await ctx.send_message(f"{niveau}|{demande}")


@executor(id="execution_auto")
async def execution_auto(msg: str, ctx: WorkflowContext[Never, str]) -> None:
    await ctx.yield_output(f"Changement standard pré-approuvé : {msg}")


@executor(id="revue_humaine")
async def revue_humaine(msg: str, ctx: WorkflowContext[Never, str]) -> None:
    await ctx.yield_output(f"En attente du CAB : {msg}")


workflow = (
    WorkflowBuilder(start_executor=qualifier)
    .add_edge(qualifier, execution_auto, condition=lambda m: m.startswith("STANDARD"))
    .add_edge(qualifier, revue_humaine, condition=lambda m: not m.startswith("STANDARD"))
    .build()
)

print(asyncio.run(workflow.run("Redémarrer la VM vm-app-01")).get_outputs()[0])
Un agent peut lui-même être un executor (WorkflowBuilder(start_executor=writer_agent).add_edge(writer_agent, reviewer_agent)),
et un workflow complet peut être exposé comme un agent (workflow.as_agent(...)) pour être déployé en hosted agent
(AI-103, chapitre 07, section 5.5).
2.2 Orchestrator et subagents#
Le motif hiérarchique orchestrator-subagent (Microsoft le rapproche du motif magentic) : un orchestrator principal tient la conversation et les décisions de haut niveau (« faut-il impliquer un autre agent ? »), des subagents spécialisés exécutent. Les subagents sont des child agents (dans la même solution) ou des connected agents (agents autonomes possédés par d'autres équipes).
| À utiliser quand | À éviter quand |
|---|---|
| Le cas d'usage est ouvert, sans processus prédéfini | Il faut un taux de réussite constant (conformité, questions-réponses) |
| Des agents spécialisés existent déjà, optimisés et réutilisables | Le processus a des étapes bien définies et des dépendances fortes |
| Plusieurs tentatives sont acceptables (une réussite justifie les échecs) | Le délai ne tolère pas d'attendre des plans qui échouent |
| Modularité, propriété indépendante, réutilisation | Les subagents ont des réponses trop longues ou trop lourdes pour l'orchestrator |
Les cinq motifs de base (sequential, concurrent, handoff, group chat, magentic) et leur arbre de choix sont dans AI-103, chapitre 06, section 5.2 ; l'examen AI-500 ajoute hub-and-spoke, parallel, peer-to-peer et orchestrator-subagent, traités au chapitre 05. Les responsabilités du coordinator et l'isolation du contexte des subagents (un subagent ne voit que ce qu'on lui passe) sont dans Claude Architecte, chapitre 01, section 2.
2.3 Les boucles de contrôle#
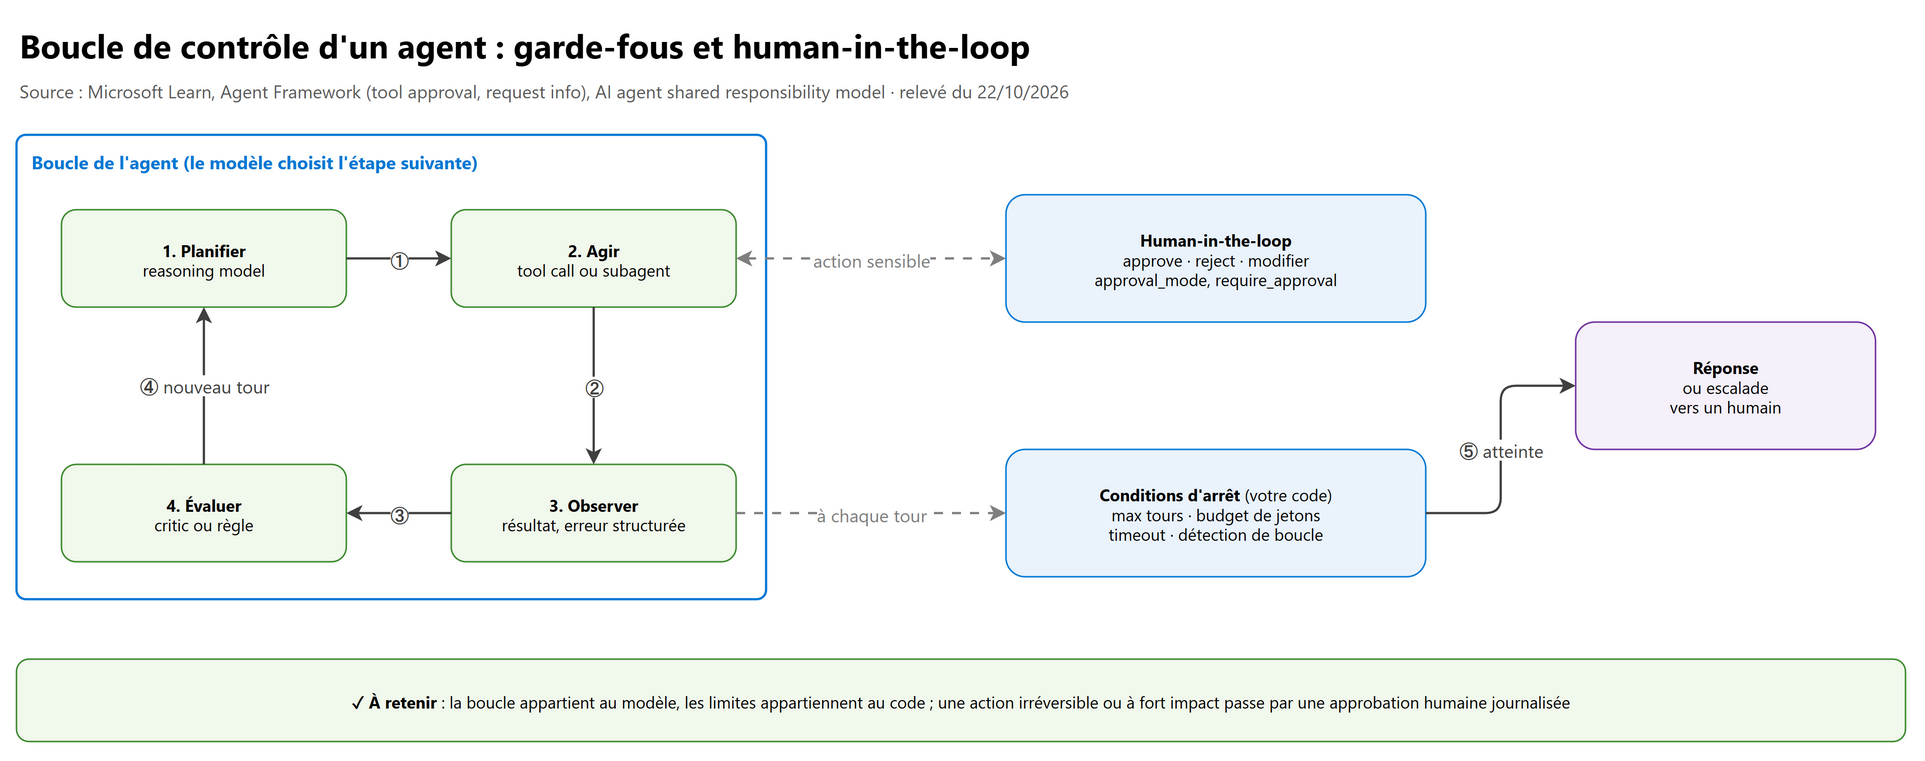
Une boucle de contrôle est le cycle planifier → agir → observer → évaluer, répété jusqu'à un critère d'arrêt. Le modèle pilote la boucle ; le code pose les limites. Le AI agent shared responsibility model de Microsoft liste, pour la couche d'orchestration, les garde-fous attendus :
- limites d'étapes et d'itérations, détection de boucle, plafonds de budget et de coût ;
- listes d'autorisation des outils qui peuvent être enchaînés ;
- tout contenu non maîtrisé qui entre dans la boucle (documents récupérés, sorties d'outils, messages des autres agents) est une entrée non fiable, pas une instruction ;
- en multi-agents, chaque message entre agents est une frontière de confiance : on y réapplique les contrôles d'entrée.
| Type de boucle | Exemple | Critère d'arrêt typique |
|---|---|---|
| Boucle d'outils | L'agent appelle des tools jusqu'à pouvoir répondre | Plus d'appel d'outil demandé, ou nombre maximal de tours |
| Boucle generator-critic (reflection) | Un agent rédige, un autre critique, on recommence | Score du critic au-dessus d'un seuil, ou N itérations (AI-103, chapitre 07, section 3.2) |
| Boucle de plan (magentic) | Le manager réévalue son task ledger à chaque étape | Plan terminé, ou blocage détecté |
| Boucle de workflow | Un edge renvoie vers une étape précédente | Condition métier, compteur de tentatives, dead letter |
2.4 Human-in-the-loop#
Le human-in-the-loop (HITL) n'est pas « un humain valide tout » : c'est un humain au bon endroit. Le Microsoft cloud security benchmark (contrôle AI-5) demande d'identifier les actions critiques (transferts de données externes, données confidentielles, décisions à impact financier ou opérationnel) et de les faire approuver avant exécution. Le guide de conception de Copilot Studio cite le piège inverse : surcharger les humains d'approbations pour des actions à faible risque, ce qui crée des goulets d'étranglement et décourage l'usage.
| Forme de HITL | Mécanisme Microsoft | Quand |
|---|---|---|
| Approbation d'un appel d'outil | approval_mode="always_require" (Agent Framework), require_approval (MCP tool Foundry) |
Écriture, suppression, envoi externe, paiement, changement en production |
| Pause de workflow | Request info (ctx.request_info()), checkpoints pour reprendre sans rejouer |
Une décision ou une information manquante au milieu d'un processus |
| Escalade | Étape de workflow ou outil d'escalade vers un humain | Ambiguïté, demande hors périmètre, échec répété |
| Revue a posteriori | Échantillonnage, file de revue, évaluations humaines dans Foundry (chapitre 06) | Actions autonomes à faible risque, contrôle qualité |
| Arrêt d'urgence | Kill switch, stop de session | Comportement anormal détecté |
Mécanismes détaillés (MCP, request info, checkpoints) : AI-103, chapitre 06, section 6.
Côté Agent Framework, l'approbation d'une fonction se gère dans une boucle : l'agent renvoie des user_input_requests, votre
interface les présente, puis vous renvoyez la réponse dans la même session.
import asyncio
from typing import Annotated

from agent_framework import Agent, Message, tool
from agent_framework.foundry import FoundryChatClient
from azure.identity import AzureCliCredential
from pydantic import Field


@tool(approval_mode="always_require")   # écriture : approbation humaine obligatoire
def fermer_ticket(ticket_id: Annotated[str, Field(description="Identifiant du ticket, ex. INC-2041")]) -> str:
    """Ferme un ticket ITSM."""
    return f"Ticket {ticket_id} fermé"


async def main() -> None:
    # FOUNDRY_PROJECT_ENDPOINT et FOUNDRY_MODEL sont lus dans l'environnement ; aucune clé dans le code
    agent = Agent(client=FoundryChatClient(credential=AzureCliCredential()), name="SupportAgent",
                  instructions="Tu aides l'équipe support à traiter les tickets.", tools=[fermer_ticket])
    session = agent.create_session()
    result = await agent.run("Ferme le ticket INC-2041, il est résolu.", session=session)
    while result.user_input_requests:
        reponses = []
        for demande in result.user_input_requests:
            print(demande.function_call.name, demande.function_call.arguments)   # ce que l'humain doit voir
            ok = input("Approuver ? (o/n) ").strip().lower() == "o"
            reponses.append(Message("user", [demande.to_function_approval_response(ok)]))
        result = await agent.run(reponses, session=session)
    print(result.text)


asyncio.run(main())
flowchart LR
    A["Demande"] --> B["Agent : propose<br/>l'action et ses arguments"]
    B --> C{"Action<br/>sensible ?"}
    C -- Non --> E["Exécution<br/>+ journal"]
    C -- Oui --> D{"Humain :<br/>approve / reject"}
    D -- approve --> E
    D -- reject --> F["Réponse sans action<br/>+ journal du refus"]
    E --> G["Réponse"]
3. Personas, périmètres, limites, autonomie et règles de comportement#
3.1 La fiche d'un agent#
Spécifier un agent, c'est remplir une fiche avant d'écrire ses instructions. Elle sert aux instructions, à la revue de sécurité, aux évaluations et à la gouvernance (owner, niveau de risque).
| Rubrique | Contenu | Exemple (Impact agent) |
|---|---|---|
| Persona | Rôle, ton, public | « Analyste d'impact infrastructure, factuel, s'adresse à des ingénieurs » |
| Mission | Ce que l'agent doit produire | Un avis d'impact structuré (ressources touchées, coût, risque, retour arrière) |
| Périmètre (scope) | Domaines et données couverts | Abonnements de production du périmètre applicatif X, en lecture |
| Limites (boundaries) | Ce qu'il ne fait jamais (« don't act ») | Aucune modification ; pas d'avis juridique ; pas de données RH |
| Outils | Liste fermée, lecture et écriture séparées | Azure Resource Graph (lecture), Cost Management (lecture) |
| Autonomie | Niveau de la section 3.2 | Autonomie bornée : lecture libre, aucune écriture |
| Escalade | Quand et vers qui | Risque élevé ou donnée manquante → humain du CAB |
| Règles de comportement | Format, citations, incertitude, langue | Citer la requête utilisée ; dire « inconnu » plutôt que deviner |
| Owner et niveau de risque | Responsable nommé, tier | Équipe plateforme, tier 2 |
Les guides de conception d'agents de Microsoft demandent aussi qu'un agent soit clairement différencié d'un humain (il ne se fait pas passer pour une personne) et qu'il indique qu'il est une IA lorsqu'il s'adresse à des personnes extérieures.
from agent_framework import Agent
from agent_framework.foundry import FoundryChatClient
from azure.identity import AzureCliCredential

INSTRUCTIONS = """Rôle : analyste d'impact infrastructure pour le comité de changement.
Mission : pour chaque demande, produire un avis d'impact (ressources, coût estimé, risque, retour arrière).
Périmètre : uniquement les ressources Azure du périmètre applicatif indiqué, en lecture.
Limites : tu ne modifies rien ; tu ne donnes pas d'avis juridique ; tu ne traites pas de données RH.
Escalade : si une information manque ou si le risque est élevé, écris ESCALADE et la raison.
Règles : cite la requête Resource Graph utilisée ; écris « inconnu » plutôt que de deviner ; réponds en français."""

impact_agent = Agent(client=FoundryChatClient(credential=AzureCliCredential()), name="ImpactAgent",
                     instructions=INSTRUCTIONS, tools=[])   # outils de lecture ajoutés au chapitre 04
3.2 Les niveaux d'autonomie#
Microsoft n'a pas une nomenclature officielle des niveaux d'autonomie : la grille ci-dessous est une synthèse de ce cours, construite sur des sources officielles qui, elles, sont précises.
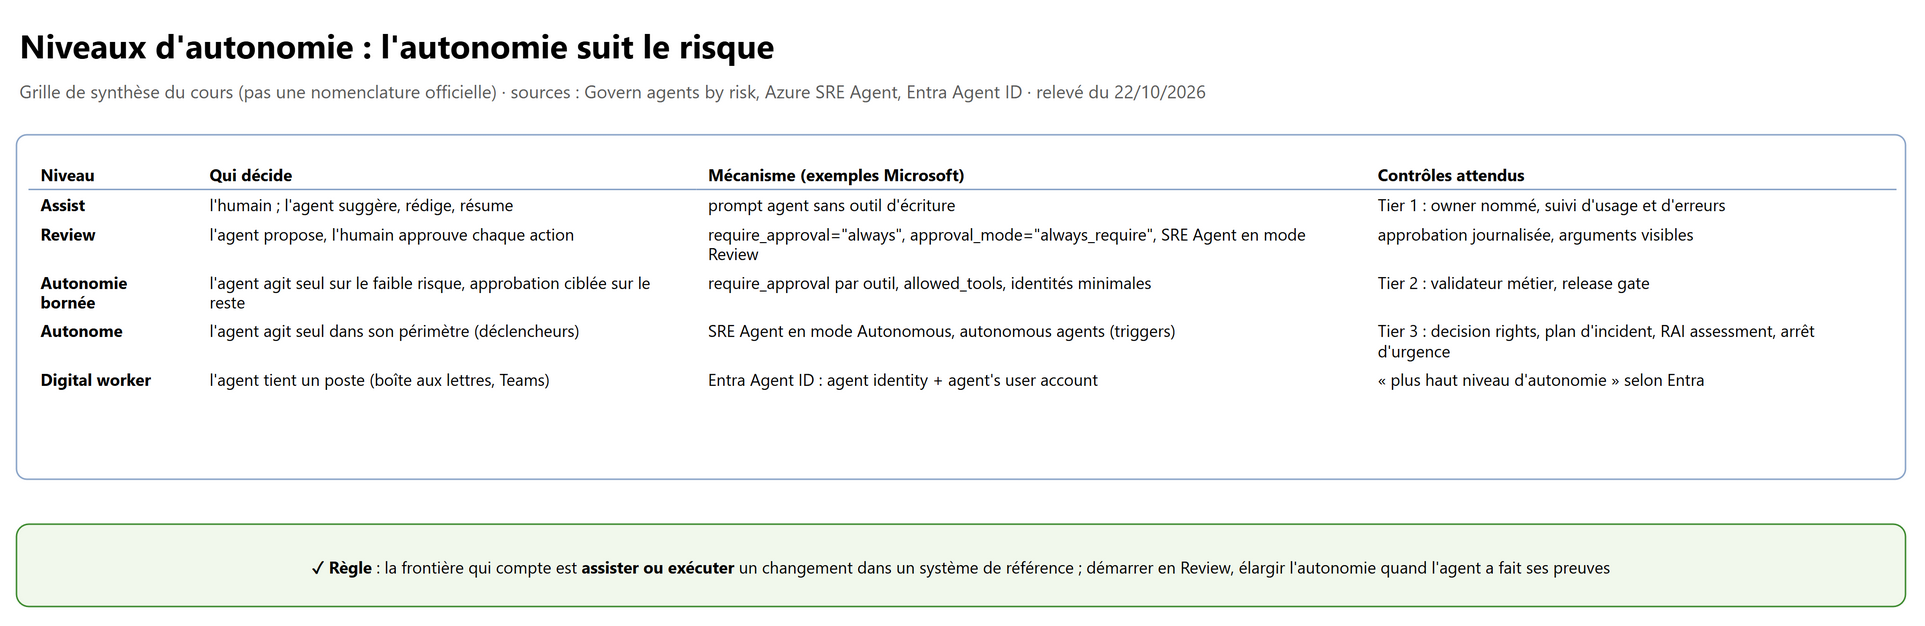
Govern agents by risk (centre d'excellence Microsoft pour les agents) : le signal de risque le plus clair est la ligne assist-to-execute : un agent qui rédige ou suggère assiste une personne qui reste propriétaire du résultat ; un agent qui met à jour un enregistrement, soumet un ticket ou déplace de l'argent exécute un changement dans un système de référence. Trois tiers de risque fixent les contrôles avant mise en service :
Tier Agents Contrôles exigés 1, faible Productivité individuelle (résumer, rédiger, chercher) Owner nommé, suivi d'usage et d'erreurs, checklist de release standard, déploiement en libre-service dans les guardrails publiés 2, moyen Connaissance experte, services internes Owner + validateur métier, surveillance de la qualité des connaissances, release gate formelle, suivi de précision et boucles de feedback 3, élevé Processus critiques, agents tournés vers les clients Owner + process owner, supervision de niveau SLA, revue de sécurité et RAI assessment avant release, decision-rights framework (ce que l'agent décide seul), plan de réponse aux incidents, revue trimestrielle Azure SRE Agent : chaque plan de réponse choisit Review (l'agent diagnostique, propose, puis agit après approbation) ou Autonomous ; la documentation conseille de commencer en Review et de passer en Autonomous une fois le comportement validé.
Microsoft Entra Agent ID : le digital worker (agent identity + agent's user account, boîte aux lettres, présence Teams) est décrit comme « le plus haut niveau d'autonomie » (SC-500, chapitre 07, section 5).
Le Well-Architected Framework (agentic personas) ajoute : permissions dynamiques et juste-à-temps selon la phase du workflow, et chaîne de responsabilité qui relie chaque décision d'agent à une personne responsable.
3.3 Les règles de comportement : instructions et garde-fous déterministes#
Une règle de comportement s'écrit à deux endroits, et l'examen teste la différence :
| Ce que l'on veut | Où l'écrire | Pourquoi |
|---|---|---|
| Ton, format, langue, citations, façon de gérer l'incertitude | Instructions (prompt) | Préférence : un écart occasionnel est acceptable |
| « Ne jamais modifier la production sans approbation » | Code et configuration : outil absent, identité sans le rôle, require_approval, guardrail |
Garantie : le modèle peut ignorer une instruction, pas une permission absente |
| « Rester dans l'intention de l'utilisateur » | Task adherence et guardrails sur les tool calls (AI-103, chapitre 04, section 6) | Bloque l'appel d'outil hors de l'intention |
Les key success factors de Microsoft pour les systèmes agentiques autonomes résument l'esprit : task adherence, human involvement, deterministic safeguards (les actions interdites sont bloquées quel que soit le comportement du modèle), transparence et disclosure, résistance au détournement (hijacking), moindre privilège et gouvernance, vigilance sur la supply chain. Le principe « prompt pour une préférence, code pour une garantie » est développé dans Claude Architecte, chapitre 01, section 4.1.
4. Périmètre des outils, permissions et authentification#
4.1 Les quatre règles de la couche outils#
Pour la couche tools and actions, le AI agent shared responsibility model fixe :
- Moindre privilège par outil : chaque outil ou connecteur n'a que les droits nécessaires ; pas d'identité large et permanente pour l'agent.
- Autorisation à chaque action, pas seulement à l'ouverture de session (contre le confused deputy).
- Portes human-in-the-loop pour les actions à fort impact, irréversibles ou sensibles (écriture, suppression, paiement, production, envoi externe).
- Journalisation de chaque appel d'outil (entrées, sorties, identité utilisée, justification) ; sandbox et contrôle de l'egress pour l'exécution de code et la navigation.
Concrètement, le périmètre d'un outil se règle à quatre niveaux :
| Niveau | Réglage | Exemple |
|---|---|---|
| Quels outils | allowed_tools sur un MCP tool, liste tools de l'agent |
Seulement microsoft_docs_search sur un serveur qui en expose trois |
| Quand | require_approval, approval_mode |
Approbation pour tout outil d'écriture |
| Avec quels droits | Rôles RBAC de l'identité utilisée, scopes OAuth | Reader sur un resource group, pas Contributor sur l'abonnement |
| Sur quel réseau | Private endpoints, réseau privé des agents (chapitre 07) | Serveur MCP privé dans le même VNet |
4.2 Les méthodes d'authentification#
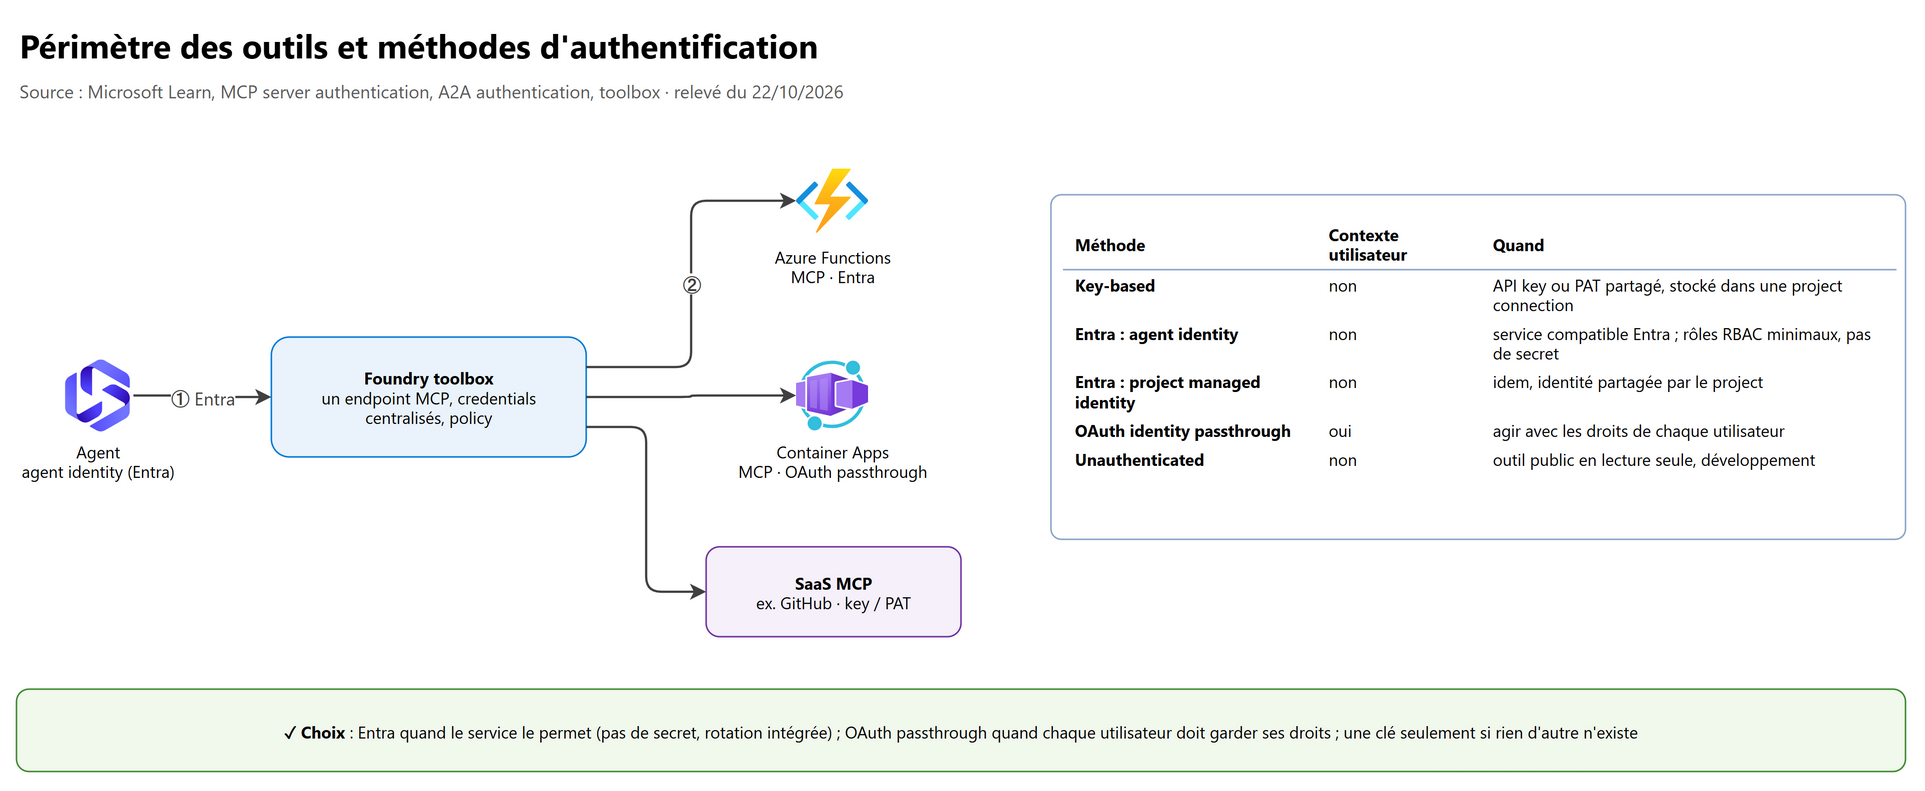
Foundry Agent Service distingue deux scénarios, pour les MCP tools comme pour les A2A tools :
- Shared authentication : tous les utilisateurs de l'agent passent par la même identité ; le contexte utilisateur ne persiste pas (exemple : un agent qui lit le même conteneur Cosmos DB pour toute l'organisation).
- Individual authentication : chaque utilisateur s'authentifie avec son compte ; ses droits s'appliquent (exemple : un agent de code qui ne voit que les dépôts GitHub de chaque développeur).
| Méthode (MCP) | Contexte utilisateur | À retenir |
|---|---|---|
| Key-based | Non | API key ou PAT dans une project connection ; toute personne ayant accès au project peut lire une clé stockée ainsi : n'y mettre que des secrets partagés |
| Microsoft Entra : agent identity | Non | L'identité de l'agent ; attribuer les rôles sur le service cible |
| Microsoft Entra : project managed identity | Non | L'identité du project, partagée par ses agents |
| OAuth identity passthrough | Oui | L'utilisateur se connecte et autorise l'accès ; managed OAuth ou app registration personnalisée (custom OAuth) |
| Unauthenticated access | Non | Seulement pour des outils publics en lecture seule ou le développement |
Pour les A2A connections, les méthodes sont key-based, Microsoft Entra ID (rôles attribués à l'agent identity ou à la project managed identity) et OAuth (managed ou custom). Le conseil officiel : en cas de doute, Microsoft Entra si le serveur le prend en charge (pas de secret à gérer, rotation intégrée), et c'est le choix naturel pour un serveur MCP privé dans le même réseau que l'agent.
Deux identités à ne pas confondre :
| Identité | Rôle |
|---|---|
| Agent identity (Microsoft Entra Agent ID) | L'identité propre de l'agent, reçue dès sa création dans le nouveau modèle d'agent (prompt ou hosted) ; c'est elle qui porte les rôles d'accès aux outils et aux données |
| Project managed identity | Identité du project Foundry ; pour un hosted agent, elle sert à l'infrastructure (par exemple tirer l'image du registre) |
Les trois façons dont un agent accède à une ressource (pour lui-même, au nom d'un utilisateur, avec un compte utilisateur d'agent) et le Conditional Access des agents sont dans SC-500, chapitre 07, section 5.2 ; les flux détaillés (on-behalf-of, impersonation, OAuth 2.0) au chapitre 07 de ce cours.
4.3 La toolbox : centraliser les credentials#
La documentation Foundry recommande d'ajouter les outils par une toolbox : un endpoint MCP géré qui regroupe des outils,
réutilisable par plusieurs agents et runtimes, avec gestion centralisée des credentials, versioning et application des
politiques. Les agents s'authentifient à la toolbox avec Microsoft Entra (DefaultAzureCredential) ; la toolbox injecte les
credentials de chaque outil et rafraîchit les jetons. La page What is Toolbox in Foundry? ne la marque pas en preview ;
tool search et skills le sont (22/10/2026). Détails et outils pris en charge : chapitre 04.
Exemple : un agent Foundry limité à un seul outil du serveur MCP public Microsoft Learn (lecture seule, sans authentification), avec approbation de chaque appel.
from azure.ai.projects import AIProjectClient
from azure.ai.projects.models import MCPTool, PromptAgentDefinition
from azure.identity import DefaultAzureCredential

PROJECT_ENDPOINT = "https://{resource}.services.ai.azure.com/api/projects/{project}"   # à remplacer

with AIProjectClient(endpoint=PROJECT_ENDPOINT, credential=DefaultAzureCredential()) as project:
    docs = MCPTool(
        server_label="mslearn",
        server_url="https://learn.microsoft.com/api/mcp",
        allowed_tools=["microsoft_docs_search"],   # périmètre : un seul outil sur ceux du serveur
        require_approval="always",                 # valeur par défaut ; "never" seulement pour du lecture seule maîtrisé
        # project_connection_id="…"               # pour un serveur authentifié : jamais de clé dans le code
    )
    agent = project.agents.create_version(
        agent_name="doc-agent",
        definition=PromptAgentDefinition(model="gpt-5-mini", instructions="Réponds en citant Microsoft Learn.",
                                         tools=[docs]),
    )
    print(agent.name, agent.version)
5. Protocoles de communication : MCP, A2A et appels internes#
5.1 La carte des échanges#
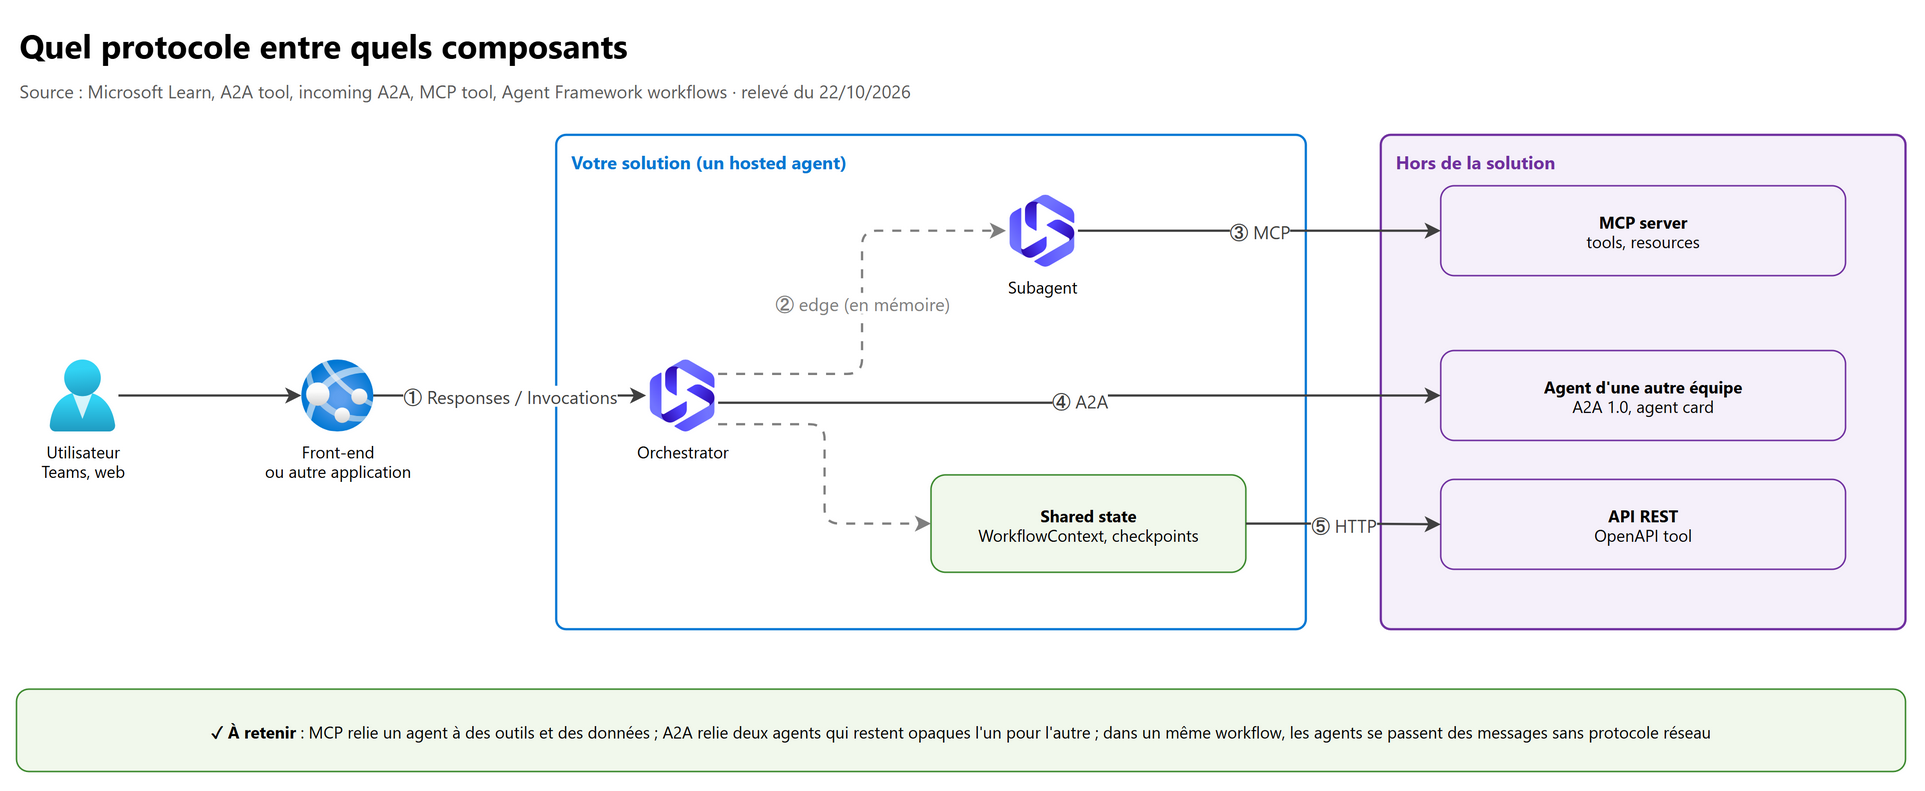
| Échange | Protocole ou mécanisme | Dans Foundry et Agent Framework |
|---|---|---|
| Application → agent | Responses API (/responses), Invocations (/invocations, webhooks, charges non conversationnelles), Invocations WebSocket (voix) |
Protocoles exposés par un agent Foundry (AI-103, chapitre 06, section 1.1) |
| Agent → outils, données, prompts | MCP | MCP tool, toolbox, serveurs MCP sur Azure Functions, Container Apps, API Management (chapitre 04) |
| Agent → API REST | OpenAPI tool, function calling | Définition OpenAPI ou fonction exécutée côté client |
| Agent → agent d'une autre équipe, d'un autre framework ou d'un autre cloud | A2A | A2A tool (sortant), incoming A2A (entrant) |
| Agent → agent dans le même workflow | Messages en mémoire (edges), état partagé | WorkflowContext, send_message, checkpoints : aucun protocole réseau |
| Agent → humain dans un canal | Microsoft 365, Teams, Copilot (publication) | Chapitre 07 (déploiement) |
MCP (Model Context Protocol) relie un agent à des capacités : tools, resources, prompts. Architecture, transports et portées sont expliqués dans Claude Architecte, chapitre 02, section 5 et son intégration Foundry dans AI-103, chapitre 06, section 4.3. A2A (Agent2Agent) relie deux agents qui restent opaques l'un pour l'autre : l'appelant délègue une tâche et reçoit un résultat, sans voir les outils, la mémoire ni le modèle de l'autre.
5.2 A2A dans Foundry : ce qu'il faut savoir#
| Point | Détail |
|---|---|
| Versions | Tool a2a (A2ATool, A2AToolboxTool) : protocole 1.0, GA. Tool a2a_preview : protocole 0.3, preview, gardé pour les intégrations existantes |
| Découverte | L'agent distant publie une agent card (capacités, compétences) ; chemin standard /.well-known/agent-card.json |
| Appeler (sortant) | Une project connection stocke l'URL et l'authentification ; l'agent appelant garde la main sur la conversation |
| Exposer (entrant) | Enable incoming A2A sur un prompt agent (protocole Responses requis) : Foundry publie l'agent card et accepte les requêtes A2A ; réglable par REST ou SDK, pas encore dans le portail |
| Agent hébergé ailleurs | L'enregistrer dans Foundry Control Plane avec le protocole A2A : Foundry génère une URL proxy, découvre l'agent card et applique contrôle d'accès et monitoring par l'AI gateway |
| Choix de version (entrant) | Agent card par version, en-tête A2A-Version: 1.0 ou ?a2a-version=1.0 ; sans version précisée, Foundry sert la v0.3 (preview) : fixer la v1.0 en production |
| Limites (entrant) | v1.0 en transport JSON-RPC seulement ; texte seulement (pas de fichiers) ; pas de streaming (SSE) |
| Rétention | Tâches et contextes A2A conservés 60 jours après la dernière écriture |
from azure.ai.projects import AIProjectClient
from azure.ai.projects.models import A2AProtocolVersion, A2ATool, PromptAgentDefinition
from azure.identity import DefaultAzureCredential

PROJECT_ENDPOINT = "https://{resource}.services.ai.azure.com/api/projects/{project}"

with AIProjectClient(endpoint=PROJECT_ENDPOINT, credential=DefaultAzureCredential()) as project:
    cible = project.connections.get("finops-agent-a2a")        # connection : URL + authentification de l'agent FinOps
    a2a = A2ATool(a2a_version=A2AProtocolVersion.V1_0, project_connection_id=cible.id)
    project.agents.create_version(
        agent_name="impact-orchestrator",
        definition=PromptAgentDefinition(model="gpt-5-mini", tools=[a2a],
                                         instructions="Pour toute question de coût, délègue à l'agent FinOps par l'outil A2A."),
    )
5.3 Choisir le protocole#
flowchart TD
    A["Deux composants<br/>doivent échanger"] --> B{"L'autre côté est-il<br/>un agent qui raisonne ?"}
    B -- "Non : API, données, action" --> C{"Une définition OpenAPI<br/>existe et suffit ?"}
    C -- Oui --> O["OpenAPI tool"]
    C -- Non --> M["MCP<br/>(réutilisable par plusieurs agents)"]
    B -- Oui --> D{"Même solution,<br/>même équipe, même runtime ?"}
    D -- Oui --> W["Edge de workflow<br/>ou agent comme tool"]
    D -- "Non : autre équipe, framework ou cloud" --> X["A2A 1.0<br/>(agent card, connection)"]
| Erreur classique | Pourquoi c'est faux |
|---|---|
| Exposer chaque subagent interne en A2A « pour faire propre » | Latence réseau, authentification, surface d'attaque en plus, sans frontière réelle à franchir |
| Envelopper un agent distant dans un serveur MCP | MCP décrit des outils au contrat précis ; un agent opaque qui négocie une tâche relève d'A2A |
| Faire confiance à la réponse d'un agent distant | Un message entre agents est une frontière de confiance : valider et filtrer comme toute entrée |
6. HAX et IA responsable#
6.1 Les six principes, appliqués aux agents#
Les six principes (détail et Responsible AI Standard dans AI-103, chapitre 04, section 1.1) se traduisent ainsi dans les guides de conception d'agents de Microsoft :
| Principe | Ce qu'il impose à un agent |
|---|---|
| Fairness | Des résultats cohérents et équitables, sans traitement différent selon des attributs sensibles |
| Reliability and safety | Gérer la variabilité, les cas limites et les entrées inattendues de façon prévisible |
| Privacy and security | N'utiliser que les informations auxquelles l'agent est autorisé, et les traiter avec soin |
| Inclusiveness | Accessibilité, variété de langues, différents niveaux d'aisance technique |
| Transparency | Dire ce que l'agent sait faire, comment il utilise l'information et comment il produit ses réponses |
| Accountability | Une équipe responsable, la conformité et une gouvernance humaine adaptée |
Le centre d'excellence Microsoft pour les agents en fait une porte de release proportionnée au tier de risque (section 3.2) : human-in-the-loop pour les actions lourdes de conséquences ou irréversibles, chemins d'escalade, disclosure pour les agents tournés vers l'extérieur.
6.2 HAX : les guidelines d'interaction humain-IA#
HAX (Human-AI eXperience) est la boîte à outils de Microsoft pour concevoir l'expérience utilisateur des systèmes d'IA : le HAX Toolkit et sa HAX Design Library (guidelines, patterns, exemples), recommandés par le Well-Architected Framework (Responsible AI in Azure workloads). Les guidelines couvrent quatre moments : au premier usage, pendant l'interaction, quand le système se trompe, et dans la durée. Celles que Microsoft Learn met en avant :
| Moment | Guideline HAX | Traduction dans une solution multi-agents |
|---|---|---|
| Au départ | Make clear what the system can do (G1) | Écran d'accueil : ce que l'agent fait, exemples de demandes, ce qu'il ne fait pas |
| Make clear how well the system can do what it can do (G2) | Signaler que les réponses peuvent être fausses ; marquer les contenus à vérifier (chiffres) | |
| Pendant | Match relevant social norms · Mitigate social biases | Ton adapté au contexte ; évaluations de biais (AI-103, chapitre 04) |
| Quand c'est faux | Support efficient correction | Modifier, régénérer, annuler sans recommencer tout le workflow |
| Make clear why the system did what it did | Sources citées, étapes de chaque agent consultables | |
| Dans la durée | Encourage granular feedback | Pouce haut ou bas, note par critère, sans questionnaire lourd |
| Provide global controls | Réglages utilisateur : ce que l'agent retient (mémoire), ce qu'il peut faire seul |
6.3 Les contrôles à concevoir#
| Contrôle | Mise en œuvre | Source |
|---|---|---|
| Transparence des actions | Montrer ce que font les agents entre le front-end et les systèmes ; un journal de chaque étape dans les workflows multi-agents, aussi utile pour expliquer une décision | WAF, Responsible AI |
| Divulgation progressive | Info-bulle de confiance, liens vers les sources à la demande ; ne pas noyer l'utilisateur | WAF |
| Citations | Renvoyer vers les documents réellement utilisés | Azure OpenAI, RAI practices |
| Disclosure | Dire que l'on parle à une IA ; marquer le contenu généré (obligation légale possible) | Azure OpenAI, RAI practices |
| Pas d'anthropomorphisme | Limiter les formulations qui laissent croire à un humain | Azure OpenAI, RAI practices |
| Feedback et contestation | Retour simple ; possibilité de contester une décision de l'IA, avec une procédure de revue | WAF |
| Contrôle utilisateur | Approuver, interrompre, arrêter ; voir et effacer la mémoire (remember / forget) | HAX (Provide global controls), Memory (section 7) |
| Limiter la sur-confiance | Expressions d'incertitude, rappels de vérification, revue humaine des décisions critiques | Fostering appropriate reliance |
Le feedback est une donnée utilisateur : il demande un stockage, des règles de confidentialité et de rétention, et il change l'architecture (chapitres 02 et 06).
7. Mémoire court terme et long terme, partage de contexte#
7.1 Les couches de mémoire#
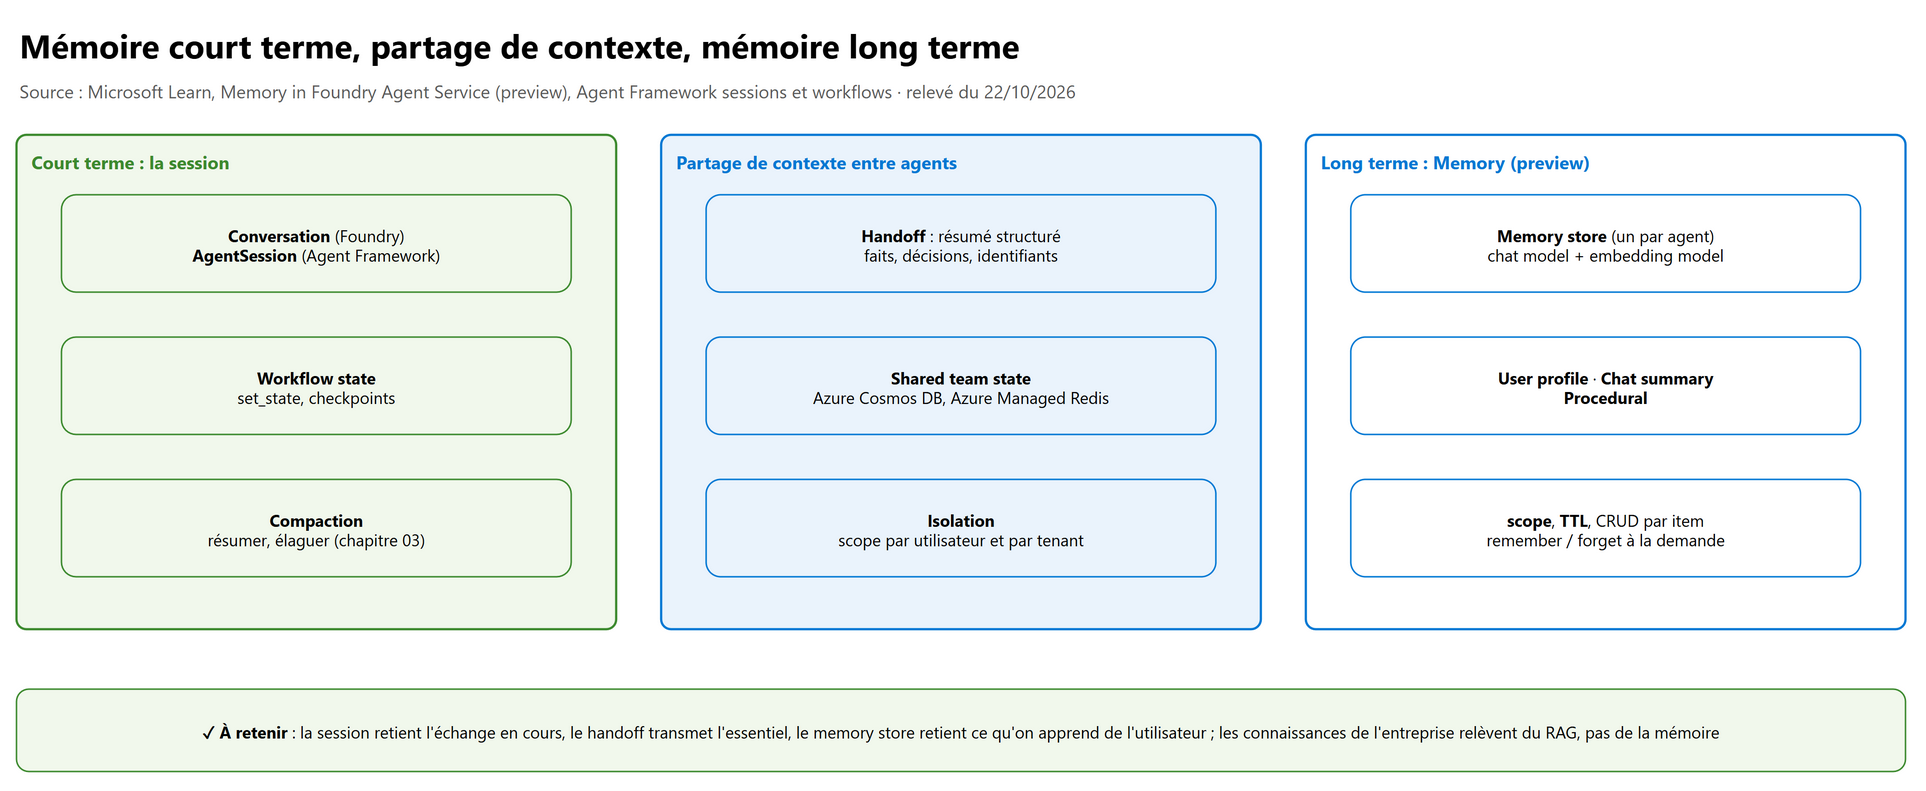
| Couche | Durée | Où | Contient |
|---|---|---|---|
| Session (court terme) | Une conversation | Conversation Foundry, AgentSession Agent Framework | Les tours d'échange, les appels d'outils |
| État de workflow | Une exécution de workflow | WorkflowContext (set_state), checkpoints |
Résultats intermédiaires, requêtes en attente |
| État d'équipe partagé | Une tâche multi-agents, parfois plusieurs sessions | Azure Cosmos DB, Azure Managed Redis (chapitre 02) | Plan, décisions, verrous, résultats partagés |
| Mémoire long terme | Des semaines, des mois | Memory de Foundry Agent Service (preview) | Ce qu'on apprend de l'utilisateur : préférences, résumés, routines |
| Connaissances (ce n'est pas de la mémoire) | Durée du contenu | Foundry IQ, Azure AI Search | Le contenu de l'organisation (RAG, chapitre 03) |
Les quatre premières couches sont celles que l'examen appelle session state, shared team state et long-term semantic memory (bloc 1.2, chapitre 02). La gestion du contexte dans une session (accumulation, compaction, résumé) est au chapitre 03 et dans Claude Architecte, chapitre 05, section 2.
7.2 Memory dans Foundry Agent Service (preview)#
| Point | Détail |
|---|---|
| Types | User profile (préférences durables, à récupérer au début de chaque conversation), chat summary (résumés des échanges passés, à récupérer à chaque tour), procedural (routines réutilisables, à récupérer pour une tâche récurrente ; option de la dernière preview) |
| Memory store | Un store par agent recommandé ; on lui donne un chat model et un embedding model déployés |
| Scope | Clé de partition : un utilisateur, une équipe ou un autre identifiant ; garder un user ID stable pour le long terme, un session ID par conversation |
| Écriture | Extraction et consolidation après une période d'inactivité (update_delay, 300 s par défaut) ; opération longue (environ une minute) |
| Lecture | Statique : search_memories avec un scope seul → profil utilisateur, à injecter au début ; contextuelle : avec les derniers messages → profil et résumés pertinents |
| Vie privée | user_profile_details dit quoi retenir et quoi exclure (âge, finances, localisation précise, credentials…) |
| Cycle de vie | TTL par défaut au niveau du store (default_ttl_seconds, 0 = pas d'expiration, seulement pour les stores créés après l'arrivée du TTL) ; CRUD par item ; commandes remember / forget à la demande de l'utilisateur |
Limites de la preview : pas d'intégration VNet, 100 scopes par store, 10 000 mémoires par scope. Le code (store,
memory search tool en scope="{{$userId}}", effacement par delete_scope) est au
chapitre 03, section 6.2.
sequenceDiagram
    actor U as Utilisateur (scope user_123)
    participant A as Agent
    participant M as Memory store
    A->>M: search_memories(scope) : profil statique
    M-->>A: préférences durables
    U->>A: nouveau message
    A->>M: search_memories(scope, derniers messages)
    M-->>A: profil + résumés pertinents
    A-->>U: réponse personnalisée
    Note over A,M: après update_delay sans activité
    A->>M: update_memories(conversation) : extraction, consolidation
7.3 Partager le contexte entre agents#
| Besoin | Bonne pratique | Piège |
|---|---|---|
| Passer la main (handoff) | Transmettre un résumé structuré : faits établis, décisions, identifiants, ce qui reste à faire | Transmettre tout l'historique : jetons, bruit, fuite de données vers un agent qui n'a pas à les voir |
| Déléguer à un subagent | Lui passer explicitement ce dont il a besoin : il ne voit pas le contexte de l'orchestrator | Supposer qu'il « sait » ce qui a été dit avant (Claude Architecte, chapitre 01, section 3.2) |
| Travailler ensemble sur une tâche longue | Un état partagé externe (Cosmos DB, Redis) avec un schéma, des versions, des verrous | Chaque agent garde sa propre version de la vérité |
| Plusieurs clients ou tenants | Isolation du scope de mémoire et de l'état par tenant et par utilisateur | Un scope global : la préférence d'un client apparaît chez un autre |
| Mémoire et sécurité | Traiter le contenu mémorisé comme une entrée non fiable et le soumettre aux mêmes contrôles | Laisser un utilisateur « faire retenir » une instruction qui s'appliquera plus tard |
8. Adapter la tâche à la famille de modèles#
8.1 Le principe#
La documentation Choice of agent host le dit simplement : adapter le modèle à la difficulté de la tâche, pas utiliser par défaut le plus capable. Les trois règles :
- Réserver les modèles frontier et reasoning aux étapes vraiment difficiles (raisonnement ambigu, synthèse, génération ouverte).
- Envoyer les sous-tâches simples ou déterministes (classification, extraction, mise en forme, décision de routage) à des modèles plus petits, moins chers et plus rapides.
- Mélanger les modèles dans un même agent quand l'orchestrateur permet de choisir le modèle par étape.
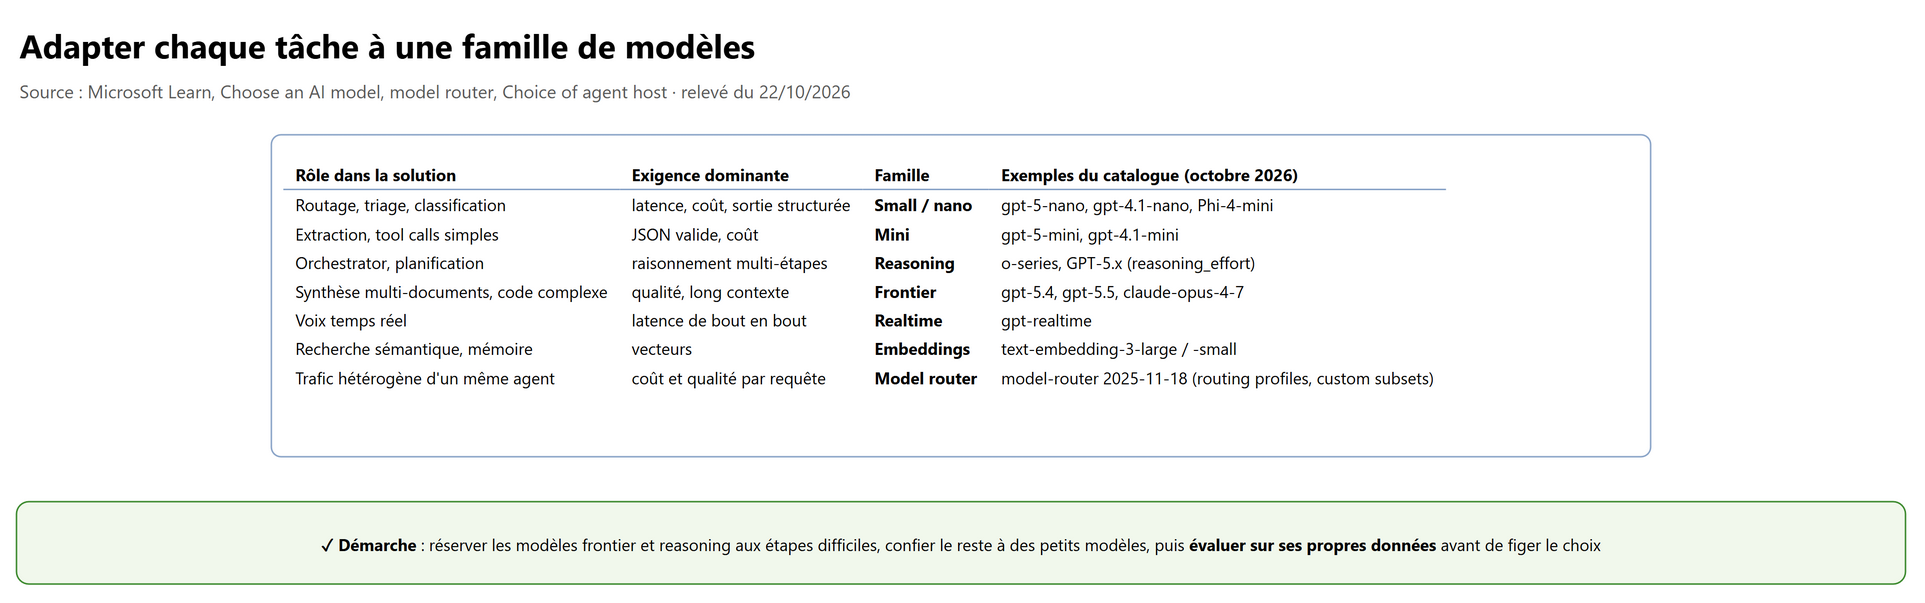
Le CAF (Process to build agents across your organization) ajoute la gouvernance : les modèles haut de gamme ont des rate limits plus stricts qui peuvent interrompre le service en pointe, il faut diversifier les modèles entre charges, suivre les coûts par département, et valider sur des requêtes représentatives avant le déploiement. Le tableau des familles et le choix reasoning ou non-reasoning sont dans AI-103, chapitre 07, section 1.2.
| Critère | Question à se poser pour chaque agent |
|---|---|
| Qualité | Quelle erreur est acceptable ? Mesurée sur quelles évaluations ? |
| Latence | L'agent est-il sur le chemin de l'utilisateur, ou en arrière-plan ? |
| Coût | Combien d'appels par tâche, combien de tâches par jour ? |
| Contexte | Quelle taille d'entrée (documents, historique, sorties d'outils) ? |
| Outils | Le modèle produit-il des tool calls fiables ? Est-il pris en charge pour ces outils dans cette région ? |
| Modalités | Texte, image, audio temps réel ? |
| Conformité | Région, data zone, fournisseur autorisé ? |
8.2 Model router dans une solution multi-agents#
Model router est un modèle déployable qui choisit, à chaque requête, le modèle sous-jacent le plus adapté. Version GA
2025-11-18 : routing profiles (qualité ou coût), custom subsets (liste des modèles autorisés), déploiement Global
Standard et Data Zone Standard ; 28 modèles pris en charge en mai 2026, dont des modèles Anthropic à déployer d'abord
soi-même dans la ressource.
| Point | Pour l'architecte |
|---|---|
| Avec Agent Service | Chaque requête est routée indépendamment : une conversation peut utiliser trois modèles en cinq tours ; le champ model de la réponse dit lequel |
| Affinité de session | La preview de session affinity concerne les appels Chat Completions directs, pas les sessions Agent Service |
| Outils | Routage tool-aware : seuls les modèles qui prennent en charge l'outil demandé sont éligibles |
| Multi-agents | Plusieurs déploiements model router, chacun avec son subset et son routing mode, un par profil d'agent |
| Contexte | La fenêtre utile est celle du plus petit modèle du pool |
| Prévisibilité | Le routage dynamique complique la prévision des coûts et le débogage : journaliser le modèle choisi |
| Paramètres | Un reasoning model choisi ignore temperature et top_p ; reasoning_effort est pris en charge depuis la version 2025-11-18 |
Model router ou déploiement direct ? Model router pour un trafic hétérogène, la réduction des coûts et un seul endpoint ; déploiement direct quand chaque requête doit utiliser le même modèle (conformité, paramètres sensibles, modèle fine-tuné). Le motif recommandé est hybride : model router par défaut, déploiements directs pour les charges spécialisées.
# Un agent de triage sur un deployment model router dédié (subset de petits modèles), l'orchestrator sur un reasoning model
triage = PromptAgentDefinition(model="model-router-triage", instructions="Classe la demande en STANDARD ou NORMAL.")
orchestrateur = PromptAgentDefinition(model="o4-mini", instructions="Planifie l'analyse d'impact et délègue.")
Détails d'exploitation (Balanced, Cost, Quality, failover, TPM) : AI-103, chapitre 07, section 5.2.
9. Labs conseillés#
À faire dans un abonnement de test, jamais en production. Coûts indicatifs : un project Foundry en basic setup n'a pas de coût fixe connu à ce jour (vérifier la page de tarification) ; on paie surtout les jetons des modèles et les ressources ajoutées (Cosmos DB, AI Search en standard setup).
| # | Lab | Résultat attendu | Coût | Nettoyage |
|---|---|---|---|---|
| 1 | Décomposition sur papier : prendre un processus réel de votre équipe (demandes de changement, onboarding), remplir le tableau 1.1, une fiche agent (3.1) par agent, et justifier chaque agent par un critère du CAF | Un schéma objectif → workflows → agents → outils, et la liste des étapes qui restent du code | Aucun | Aucun |
| 2 | Workflow Agent Framework local : exécuter le squelette de la section 2.1, puis remplacer revue_humaine par un agent et ajouter l'outil fermer_ticket avec approval_mode="always_require" (section 2.4) |
L'exécution s'arrête sur une demande d'approbation ; refuser, puis approuver | Quelques centimes de jetons (gpt-5-mini) | Aucun (local) ; supprimer le deployment de test s'il a été créé pour l'occasion |
| 3 | Agent Foundry avec MCP borné : créer l'agent de la section 4.3 (serveur MCP Microsoft Learn), poser une question, observer l'item mcp_approval_request, approuver ; puis retirer allowed_tools et comparer les outils proposés |
Un appel d'outil approuvé, visible dans les traces | Quelques centimes | project.agents.delete_version(...) |
| 4 | Memory (preview) : créer le memory store du chapitre 03, section 6.2, écrire « je préfère les réponses en tableau », ouvrir une nouvelle conversation avec le même scope, puis demander « oublie ma préférence » | La préférence revient dans la deuxième conversation, puis disparaît | Jetons du chat model et de l'embedding model | Supprimer le memory store et l'agent |
| 5 | A2A entre deux agents : activer incoming A2A sur un prompt agent (REST ou SDK), créer une connection, puis un agent appelant (section 5.2) ; appeler sans version, puis avec A2A-Version: 1.0 |
L'appel fonctionne ; la carte d'agent v1.0 et la v0.3 sont distinctes | Quelques centimes | Supprimer les deux agents et la connection |
10. Pièges d'examen#
| Situation | Réponse attendue | Pourquoi |
|---|---|---|
| « Pour mieux structurer, découper en cinq agents » sans frontière de sécurité, d'équipe ni de domaine | Un agent unique avec outils, ou un prototype comparatif | CAF : le multi-agents ajoute latence, contexte redondant et surface d'attaque |
| Données soumises à des règles de conformité différentes dans le même agent | Séparer en agents avec des identités et des outils distincts | Une frontière de sécurité est le premier critère du CAF |
| « Écrire dans les instructions : ne jamais supprimer de ressource » | Retirer l'outil ou le rôle, ou exiger l'approbation | Une instruction est une préférence ; une permission absente est une garantie |
| Approbation humaine sur chaque lecture | Approbation ciblée sur les actions sensibles | Surcharger les humains crée des goulets et fait abandonner l'outil |
| Un agent de production passe directement en mode autonome | Commencer en Review, élargir après validation | SRE Agent et Govern agents by risk : l'autonomie se gagne |
| Une clé API partagée dans une project connection pour des données propres à chaque utilisateur | OAuth identity passthrough | Une connection est lisible par les membres du project et n'a pas de contexte utilisateur |
| Serveur MCP compatible Entra, l'équipe propose une clé | Microsoft Entra (agent identity ou project managed identity) | Pas de secret, rotation intégrée |
| Deux subagents du même hosted agent exposés en A2A entre eux | Edges de workflow (ou agent comme outil) | A2A sert à franchir une frontière : autre équipe, framework ou cloud |
| Intégration A2A entrante en production sans version précisée | Fixer A2A 1.0 (agent card v1.0, en-tête ou paramètre) | Sans version, Foundry sert la v0.3, en preview |
| Envoyer des fichiers ou du streaming à un agent Foundry par incoming A2A | Impossible aujourd'hui : texte seul, pas de SSE | Limites documentées d'incoming A2A |
| Mettre la documentation de l'entreprise dans la Memory | Foundry IQ / Azure AI Search (RAG) | La mémoire retient ce qu'on apprend de l'utilisateur, pas le contenu de l'organisation |
| Un seul memory scope pour tous les clients d'un SaaS | Scope par tenant et par utilisateur | Sinon, fuite de préférences d'un client à l'autre |
| Model router quand la conformité exige le même modèle à chaque requête | Déploiement direct | Model router peut choisir un modèle différent par requête |
| Le prompt est long et passe mal avec model router | Filtrer le subset ou déployer directement | La fenêtre est celle du plus petit modèle du pool |
| Le plus gros modèle pour tous les agents « pour la qualité » | Un modèle par rôle, évalué | Coût, rate limits plus stricts, latence, sans gain sur les tâches simples |
11. Scénarios corrigés#
Scénario 1. Une banque veut un assistant qui répond aux conseillers sur les produits et qui prépare les virements entre comptes clients. Les deux fonctions utilisent des données de sensibilités différentes et des équipes différentes. Que recommandez-vous ?
A. Un agent unique avec tous les outils et des instructions strictes · B. Deux agents, chacun avec son identité, ses outils et son owner, l'agent de virement avec approbation humaine · C. Un agent par produit bancaire · D. Un agent unique en mode autonome
Réponse : B. Frontière de sécurité et équipes distinctes : les deux premiers critères du CAF. L'agent de virement exécute un changement dans un système de référence (tier 3) : approbation et decision rights. C multiplie les agents sans frontière ; A et D mélangent les droits.
Scénario 2. Un processus d'onboarding comporte six étapes fixes (créer le compte, attribuer la licence, envoyer le mail de bienvenue…) et une seule étape qui demande du jugement : rédiger un plan de formation adapté au poste. Quelle architecture ?
A. Magentic orchestration · B. Six agents en sequential · C. Un workflow Agent Framework avec cinq executors déterministes et un agent pour le plan de formation · D. Un agent unique qui appelle six outils dans l'ordre qu'il choisit
Réponse : C. Étape prévisible = code ; seule l'étape de jugement est un agent. D laisse au modèle un ordre qui doit être garanti ; A et B ajoutent des agents sans raison.
Scénario 3. Un agent d'exploitation peut redémarrer des services et modifier des règles de pare-feu. L'équipe veut qu'il agisse seul pour les redémarrages mais jamais seul pour le pare-feu. Quelle conception ?
A. Une instruction « ne touche pas au pare-feu sans accord » · B. Deux outils séparés, approbation exigée seulement sur l'outil pare-feu · C. Approbation sur tous les outils · D. Supprimer l'outil de redémarrage
Réponse : B. Autonomie bornée : approbation ciblée sur l'action sensible, garantie par la configuration et non par le prompt (A). C crée un goulet inutile, D retire une capacité voulue.
Scénario 4. Un agent de code doit lire les pull requests GitHub, et chaque développeur ne doit voir que les dépôts auxquels il a accès. Quelle authentification pour le serveur MCP GitHub ?
A. PAT d'un compte de service dans une project connection · B. Project managed identity · C. OAuth identity passthrough · D. Unauthenticated
Réponse : C. Authentification individuelle : le contexte de chaque utilisateur doit persister. A et B partagent une même identité pour tous ; D est réservé aux outils publics.
Scénario 5. L'équipe FinOps d'une autre filiale possède un agent construit avec LangGraph et hébergé hors Foundry. Votre orchestrator Foundry doit lui demander des estimations de coût, avec contrôle d'accès et monitoring centralisés. Que faites-vous ?
A. Copier son code dans votre hosted agent · B. L'enregistrer dans Foundry Control Plane avec le protocole A2A et l'appeler par l'A2A tool · C. L'exposer comme serveur MCP · D. Lui envoyer des requêtes REST écrites à la main
Réponse : B. Agent opaque d'une autre équipe et d'un autre framework : A2A. L'enregistrement dans Foundry Control Plane fournit une URL proxy, l'agent card et le contrôle par l'AI gateway. A casse la propriété de l'autre équipe ; C traite un agent comme un outil.
Scénario 6. Après la mise en production d'une intégration A2A entrante, des partenaires signalent des comportements de preview. Les appels ne précisent aucune version. Cause probable ?
A. Le transport HTTP+JSON n'est pas activé · B. Foundry sert la v0.3 par défaut quand aucune version n'est précisée · C. L'agent card est absente · D. La rétention de 60 jours est dépassée
Réponse : B. Sans
A2A-Versionnia2a-version, Foundry sert la v0.3 (preview) ; il faut faire négocier la v1.0 (agent card v1.0) ou la fixer. A est faux : la v1.0 n'accepte que JSON-RPC.
Scénario 7. Un assistant RH doit se souvenir, d'une session à l'autre, de la langue et du format préférés de chaque salarié, sans jamais retenir de données de santé. Que configurez-vous ?
A. L'historique complet de toutes les conversations dans le prompt · B. Un memory store avec user_profile_details qui précise
quoi retenir et quoi exclure, un scope par salarié et un TTL · C. Un index Azure AI Search des conversations · D. Un fichier de
préférences dans les instructions de l'agent
Réponse : B. User profile memory, avec exclusions explicites, scope stable par utilisateur et rétention maîtrisée. Signaler que Memory est en preview. A explose le contexte, C relève du RAG, D est le même pour tous.
Scénario 8. Dans un workflow de traitement des réclamations, l'agent de triage passe la main à l'agent de remboursement. Les coûts explosent et l'agent de remboursement voit des données sans rapport avec sa tâche. Que changez-vous ?
A. Passer un résumé structuré (identifiants, faits établis, décision attendue) au lieu de l'historique complet · B. Donner un modèle plus gros à l'agent de remboursement · C. Fusionner les deux agents · D. Augmenter la fenêtre de contexte
Réponse : A. Le handoff transmet l'essentiel : moins de jetons et moindre exposition des données. B et D traitent le symptôme ; C supprime une frontière peut-être voulue.
Scénario 9. Un agent reçoit un trafic très varié : salutations, questions simples, appels d'outils, et quelques synthèses complexes. Le budget est serré et aucune exigence n'impose un modèle fixe. Quel choix ?
A. Un déploiement direct du modèle le plus capable · B. Un déploiement direct du plus petit modèle · C. Model router, avec un
subset adapté et le champ model journalisé · D. Un fine-tuning
Réponse : C. Trafic hétérogène, coût à optimiser, pas de contrainte de modèle unique : c'est le cas d'usage de model router. Journaliser le modèle choisi garde la prévisibilité.
Scénario 10. Un agent répond aux clients d'un opérateur télécom et peut ouvrir des gestes commerciaux. Quels contrôles HAX et d'IA responsable sont attendus avant la mise en service ?
A. Aucun, l'agent est déjà filtré par les guardrails · B. Disclosure (« vous parlez à un assistant IA »), sources et étapes consultables, correction facile, feedback avec contestation, approbation des gestes au-delà d'un seuil, RAI assessment de tier 3 · C. Un avertissement juridique en bas de page · D. Une évaluation de performance seulement
Réponse : B. Agent tourné vers l'extérieur qui exécute des actions : tier 3 (revue de sécurité, RAI assessment, decision rights) et guidelines HAX (transparence, correction, feedback, contrôle). Les guardrails seuls ne couvrent pas l'expérience utilisateur.
12. Pour aller plus loin#
- Lire en entier AI agent orchestration patterns et l'idée d'architecture Build a multiple-agent workflow automation solution by using Microsoft Agent Framework citée par le guide : App Service, API d'orchestration sur Container Apps, modèle Foundry, Cosmos DB pour les plans et l'historique.
- Suivre les modules du premier parcours officiel : Design stateful agentic loops, Implement advanced multi-agent orchestration patterns, Apply task decomposition and agent collaboration strategies, Design enterprise-scale agent communication with A2A.
- Parcourir la HAX Design Library : chaque guideline a des patterns et des exemples de produits.
- Pour le recul conceptuel (boucles, passage de contexte, enforcement), relire Claude Architecte, chapitre 01 : les mêmes questions, posées côté Anthropic.
13. Fiche à retenir#
- Niveau de complexité le plus bas : direct model call → single agent with tools → multi-agents.
- Plusieurs agents d'emblée seulement pour une frontière de sécurité ou de conformité, plusieurs équipes ou plus de 3 à 5 fonctions ; sinon prototype comparatif.
- Étape prévisible = code ; jugement = agent ; irréversible ou à fort impact = approbation humaine.
- La boucle appartient au modèle, les limites au code : max tours, budget, timeout, détection de boucle, outils autorisés.
- Chaque message entre agents est une frontière de confiance.
- HITL ciblé :
approval_mode="always_require"(Agent Framework),require_approval(MCP tool), request info, checkpoints. - Fiche agent : persona, mission, périmètre, limites (« don't act »), outils, autonomie, escalade, règles, owner, tier.
- Ligne assist-to-execute ; trois tiers de risque ; commencer en Review.
- Préférence dans le prompt, garantie dans le code (outil absent, rôle absent, approbation, guardrail).
- MCP auth : key-based, Entra agent identity, Entra project managed identity, OAuth identity passthrough (seul avec contexte utilisateur), unauthenticated ; Entra en cas de doute.
- Une clé dans une project connection est lisible par les membres du project.
- MCP = agent ↔ outils ; A2A = agent ↔ agent opaque ; même workflow = edges en mémoire.
- A2A :
a2a1.0 GA,a2a_preview0.3 ; sans version, l'entrant sert la v0.3 ; texte seul, pas de streaming, JSON-RPC. - HAX : au départ, pendant, quand c'est faux, dans la durée ; transparence, correction, feedback, contrôle.
- Session ≠ état de workflow ≠ état d'équipe ≠ Memory ≠ connaissances (RAG).
- Memory (preview) : user profile, chat summary, procedural ; scope ;
update_delay300 s ; TTL ; remember / forget. - Un modèle par rôle ; frontier et reasoning pour les étapes difficiles ; model router pour un trafic hétérogène, déploiement direct pour un modèle imposé.
Références#
Consultées le 22/10/2026.
- Study guide for Exam AI-500
- Learning path : Architect production-grade multi-agent AI solutions in Azure
- Single agent or multiple agents (Cloud Adoption Framework)
- Process to build agents across your organization (Cloud Adoption Framework)
- AI agent orchestration patterns (Architecture Center)
- Build a multiple-agent workflow automation solution by using Microsoft Agent Framework
- Orchestrator and subagent multi-agent patterns
- Workflow-oriented multi-agent patterns
- Choice of agent host : model choice
- Govern agents by risk
- Responsible AI (agents center of excellence)
- Responsible AI for agent design · Human-centered design for agents
- AI agent shared responsibility model
- Microsoft cloud security benchmark v2 : AI-5 Ensure human-in-the-loop
- Secure autonomous agentic AI systems
- Workload team personas for AI workloads : agentic personas (WAF)
- Responsible AI in Azure workloads (WAF)
- Overview of responsible AI practices for Azure OpenAI models
- Creating a dynamic UX : guidance for generative AI applications
- Fostering appropriate reliance on GenAI
- HAX Toolkit · HAX Design Library
- Use the agent design framework (Copilot Studio)
- Incident response plans in Azure SRE Agent
- Microsoft Entra Agent ID design patterns
- Tool approval (Agent Framework)
- Workflows : get started (Agent Framework)
- Connect agents to Model Context Protocol servers
- Set up authentication for MCP tools
- Connect to an A2A agent endpoint from Foundry Agent Service
- Agent2Agent (A2A) authentication
- Enable incoming A2A on a Foundry agent
- Memory in Foundry Agent Service (preview) · Create and use memory
- Choose the right AI model for your workload
- How model router works · Use model router with Foundry agents · What's new in model router