

Version : 1.1 · Date : 2026-10-21 · Domaine 1 de l'examen : Plan and manage an Azure AI solution (25 à 30 %)
En une phrase : une Foundry resource porte la gouvernance (réseau, sécurité, model deployments), les Foundry projects isolent le travail des équipes, le deployment type décide où l'inférence est traitée et comment on paie, et le tout se déploie par IaC puis se promeut d'environnement en environnement derrière une evaluation dans le pipeline.
Ce que l'examen demande#
Bloc Set up AI solutions in Foundry du guide d'étude AI-103 (compétences au 16 avril 2026) :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| 1 | Design Azure infrastructure for AI apps and agent-based solutions | 2 |
| 2 | Choose appropriate deployment options | 3 |
| 3 | Configure model and agent deployments | 4 |
| 4 | Integrate Foundry projects with continuous integration and continuous deployment (CI/CD) pipelines | 5 |
Les quotas, la supervision et la sécurité détaillée (managed identity, keyless, réseau privé, rôles) sont au chapitre 03 ; les guardrails au chapitre 04. La sécurité réseau Azure générique (Private Endpoint, DNS privé, Azure Firewall) est supposée acquise : voir SC-500 · 06.
1. Le modèle de ressources Foundry#
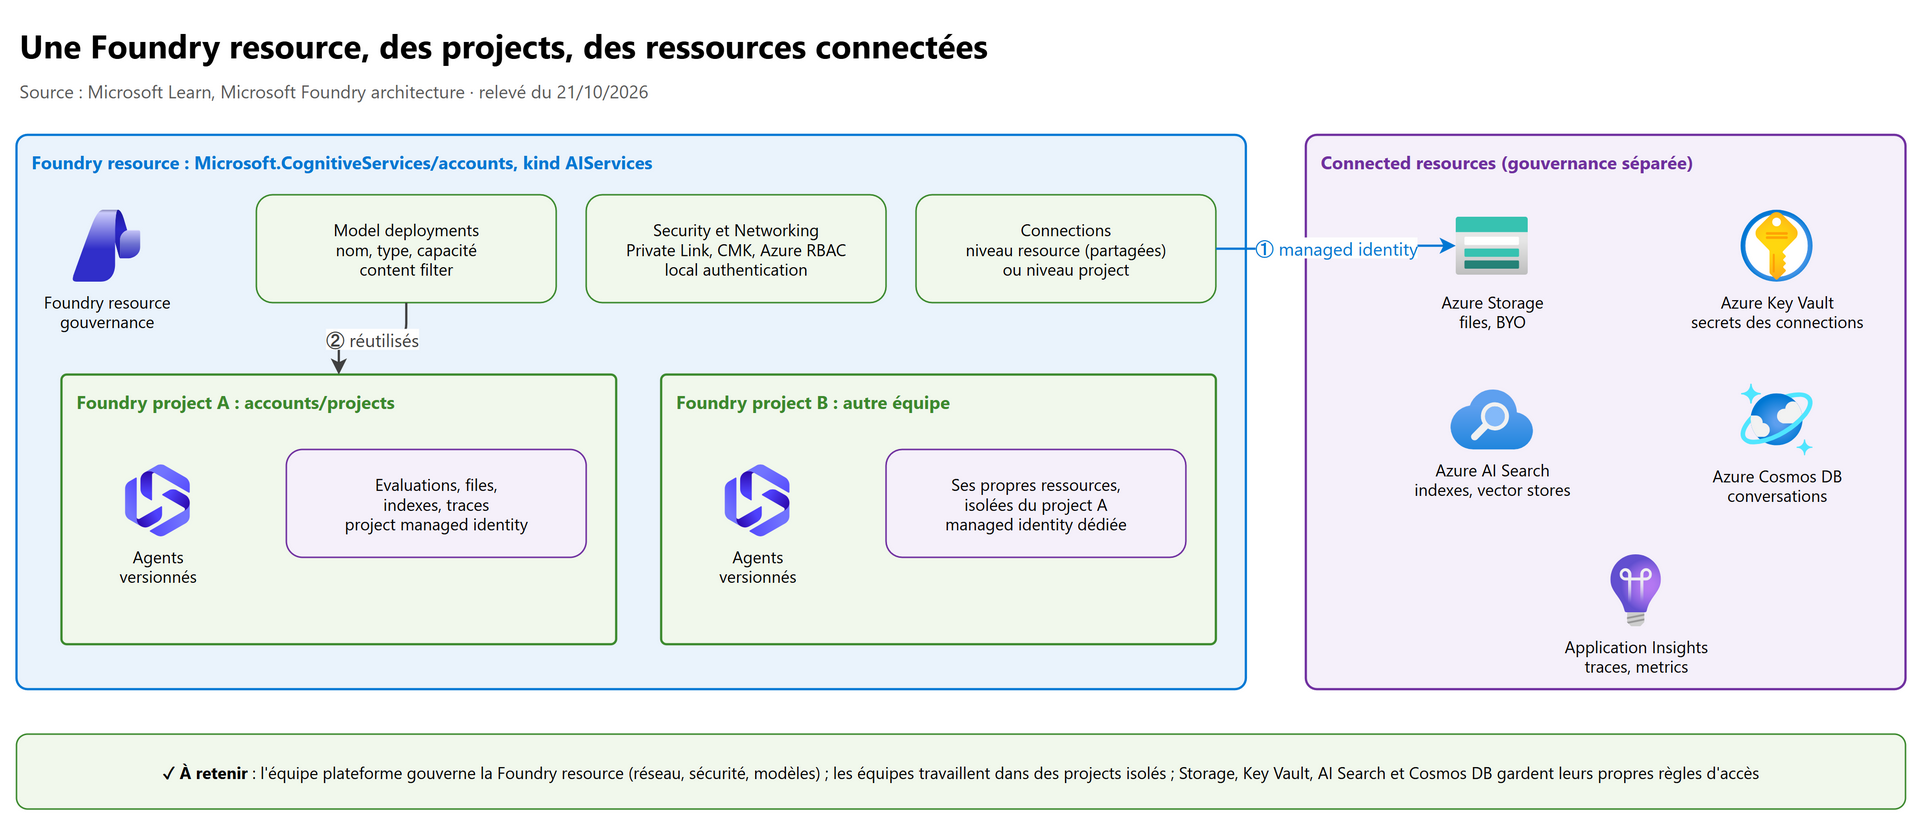
1.1 Foundry resource, project, connected resources#
| Objet | Type ARM | Rôle |
|---|---|---|
| Foundry resource | Microsoft.CognitiveServices/accounts, kind AIServices |
Ressource de premier niveau : model deployments, réseau, sécurité, CMK, connections partagées. Point d'entrée recommandé pour agents, modèles et evaluations |
| Foundry project | Microsoft.CognitiveServices/accounts/projects |
Sous-ressource : limite de développement d'une équipe (agents, files, evaluations, indexes), avec sa managed identity |
| Connections | accounts/connections ou accounts/projects/connections |
Accès à des ressources externes (Storage, AI Search, Key Vault, API…). Niveau resource = partagé entre projects |
| Connected resources | Storage, Key Vault, AI Search, Cosmos DB, Application Insights | Ressources Azure indépendantes, avec leur propre réseau et RBAC : on les sécurise séparément |
Points à retenir :
- Le même provider
Microsoft.CognitiveServicessert Foundry, Azure OpenAI, Speech, Language et Vision : mêmes API de gestion, mêmes actions RBAC, mêmes alias Azure Policy. Une ressource Azure OpenAI peut être mise à niveau en Foundry resource en gardant endpoint, clés et état. - La plupart des nouvelles API sont au niveau project ; certaines restent au niveau resource (exemple : l'API Translator).
- Sans
custom_subdomain_name(sous-domaine personnalisé), pas de Private Endpoint ni d'authentification Microsoft Entra, donc pas d'Agent Service. - Pas de basculement interrégion automatique : pour du multirégion, une Foundry resource par région et le routage côté application ou passerelle.
Hub-based projects (classic) : l'ancien modèle « hub » (
Microsoft.MachineLearningServices/workspaces, kindhubetproject) reste accessible dans le portail Foundry (classic), mais les nouveaux investissements vont aux Foundry projects. Le hub reste utile pour l'entraînement de modèles ML personnalisés et prompt flow. Il n'existe pas de migration automatique des agents, files ou vector stores d'un hub vers un Foundry project : on recrée.
1.2 Les rôles à connaître pour ce chapitre#
Les rôles Foundry ont été renommés (mêmes ID, mêmes permissions) : Azure AI User devient Foundry User, Azure AI Owner devient Foundry Owner, Azure AI Account Owner devient Foundry Account Owner, Azure AI Project Manager devient Foundry Project Manager.
| Besoin | Rôle (étendue) |
|---|---|
| Créer la Foundry resource et les projects | Foundry Account Owner (abonnement ou groupe de ressources) |
| Créer et modifier des model deployments | Foundry Account Owner sur la Foundry resource (ou Foundry Owner, Owner, Contributor) ; Foundry Project Manager ne déploie pas de modèles ; la doc cite aussi Cognitive Services Contributor pour le managed compute |
| Construire des agents, lancer des evaluations | Foundry User sur le project (permissions agents/*/read, action, delete) |
| Publier un agent (nouveau modèle et ancien modèle agent application) | Foundry Project Manager au minimum, sur la Foundry resource |
| Appeler une application ou un agent depuis une app | Foundry User (sur le project ou l'agent application) |
| Standard setup : provisionner les capability settings | Storage Blob Data Contributor + Cosmos DB Operator sur les ressources BYO |
Détail des rôles et du principe du moindre privilège : chapitre 03.
2. Design Azure infrastructure for AI apps and agents#
2.1 Les deux architectures de référence Microsoft#
| Basic Foundry chat | Baseline Foundry chat | |
|---|---|---|
| But | Apprentissage, POC | Production |
| Réseau | Aucun : services publics, l'identité est le seul périmètre | VNet, Private Endpoints partout, accès public désactivé |
| Sortie de l'agent | Non contrôlée (risque d'exfiltration) | Subnet délégué, UDR vers Azure Firewall, FQDN autorisés |
| Entrée | App Service public | Application Gateway + WAF, DDoS Protection |
| Agent Service | Basic setup | Standard setup (BYO Cosmos DB, Storage, AI Search) |
| Identité | App Service → agent par managed identity (Foundry User) ; project → AI Search (Search Index Data Reader) | Idem, plus aucune clé |
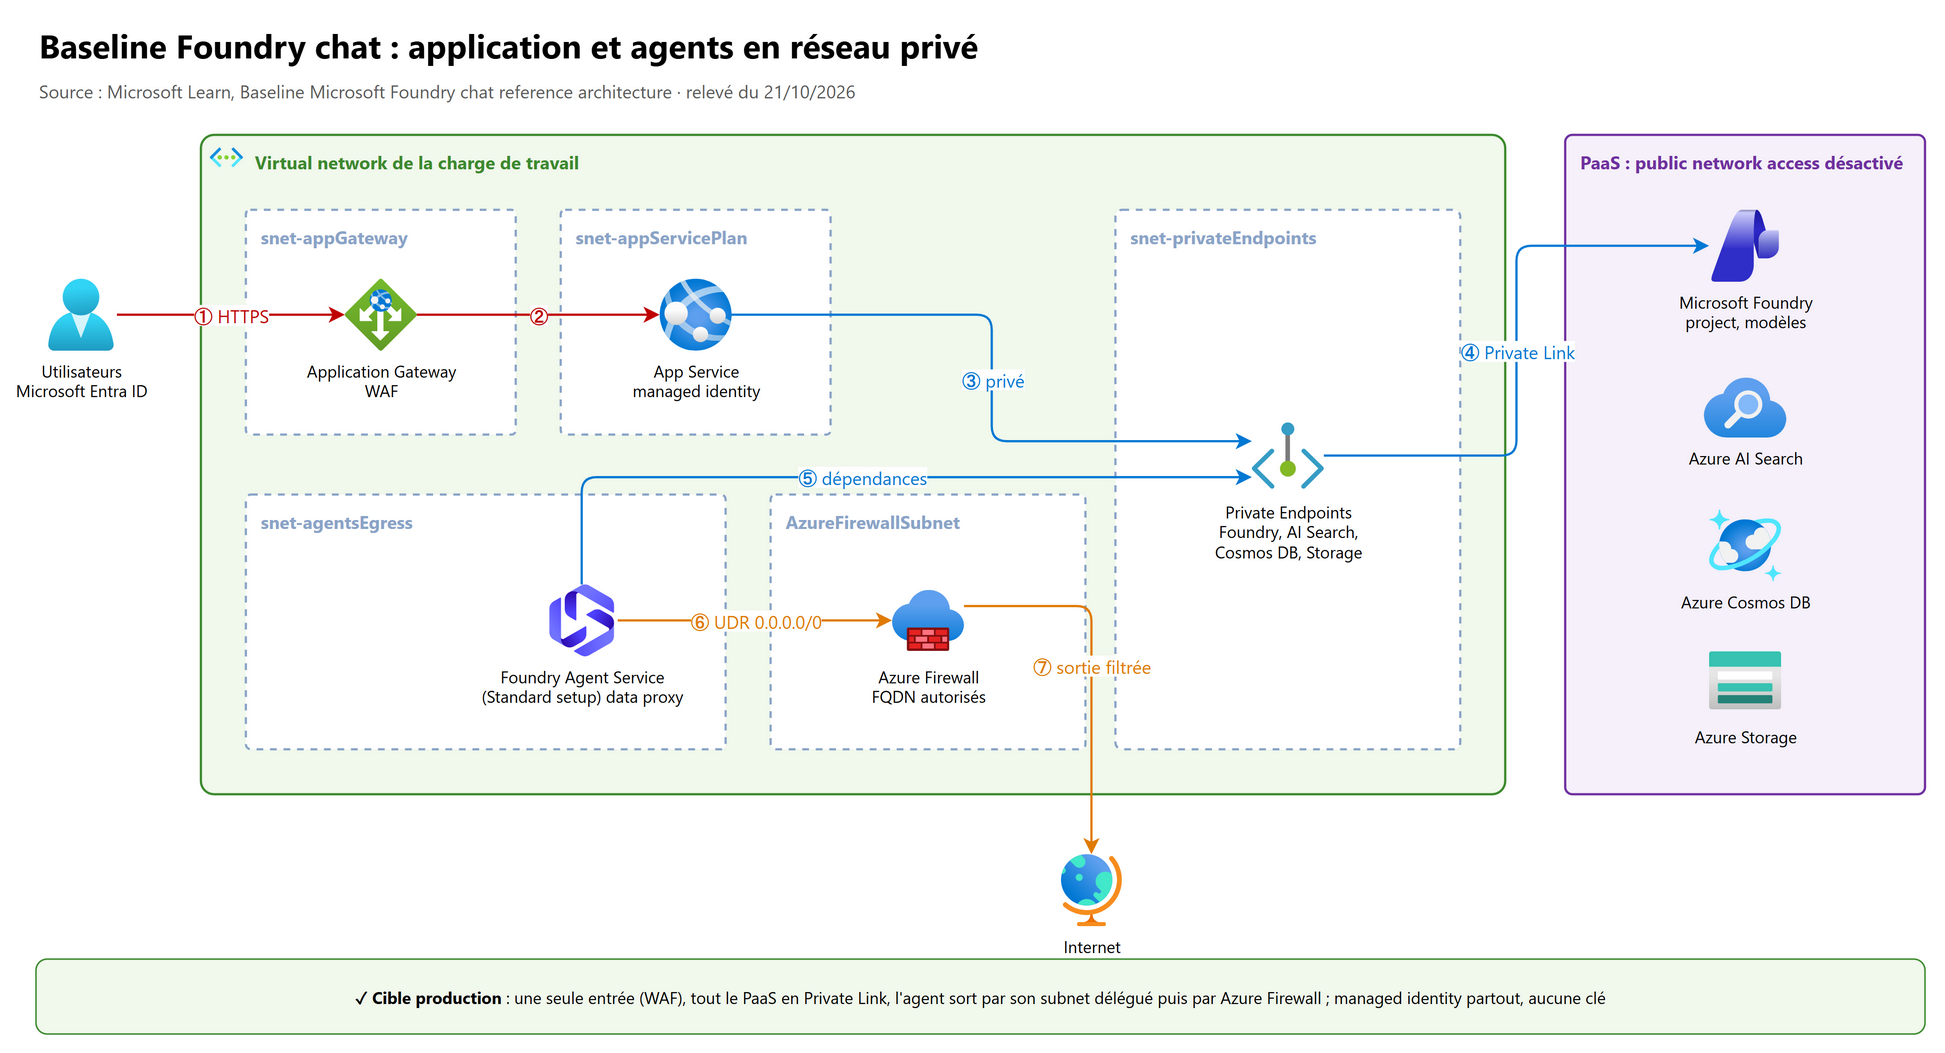
Les subnets de la baseline :
| Subnet | Entrée | Sortie | UDR vers le firewall |
|---|---|---|---|
snet-appGateway |
Internet (utilisateurs) | Private Endpoints | Non |
snet-appServicePlan |
Aucune | Private Endpoints, Azure Monitor | Oui |
snet-privateEndpoints |
Le VNet | Aucune | Oui |
snet-agentsEgress (délégué) |
Aucune | Private Endpoints, subnet des serveurs MCP, Internet filtré | Oui |
snet-mcpServers |
TCP 443 et 31443 depuis le subnet des agents | Ce que le serveur exige | Oui |
snet-jumpBoxes, snet-buildAgents |
Depuis Azure Bastion | Private Endpoints, Internet | Oui |
Pour les prompt agents, un data proxy mono-locataire par project tourne dans le subnet délégué et porte toute la sortie de l'agent ; pour les hosted agents, chaque session a sa propre interface réseau dans ce subnet (les appels d'outils passent toujours par le data proxy).
2.2 Foundry Agent Service : Basic setup ou Standard setup#
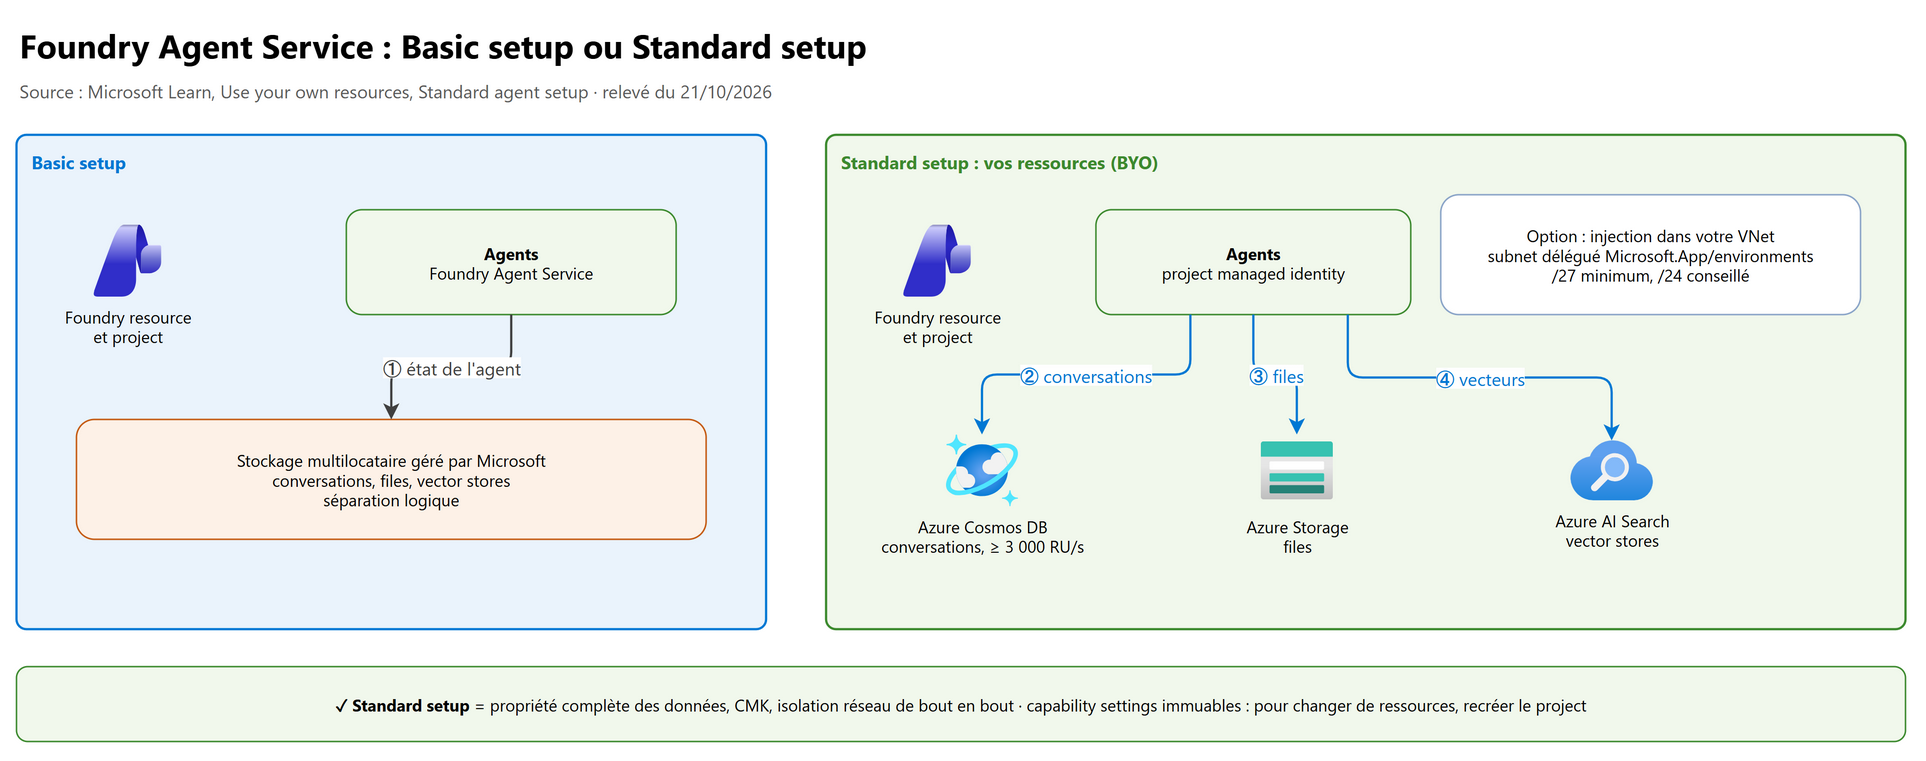
| Basic setup | Standard setup | |
|---|---|---|
| État de l'agent (conversations, files, vector stores) | Stockage multilocataire géré par Microsoft, séparation logique | Vos ressources : Cosmos DB for NoSQL (conversations), Azure Storage (files), Azure AI Search (vector stores) |
| Propriété des données, CMK | Non | Oui |
| Isolation réseau de bout en bout | Non | Oui (avec injection dans le VNet) |
| Isolation par project | Logique | Conteneurs dédiés par project dans vos ressources |
Contraintes du Standard setup (très « examen ») :
- Cosmos DB : au moins 3 000 RU/s au total ; chaque conteneur demande 1 000 RU/s ; jusqu'à 5 conteneurs par project avec la Responses API. Exemple de la doc : 2 projects avec agents Responses API → 10 000 RU/s. Débit insuffisant = échec du provisionnement. Provisioned throughput et serverless sont acceptés.
- Les capability settings (quelles ressources BYO portent l'état) se définissent sur la resource (valeurs par défaut) ou le project ; ils sont immuables : pour changer de ressources, supprimer et recréer le project.
- Deux identités, deux jeux de rôles : l'appelant du déploiement (Storage Blob Data Contributor, Cosmos DB Operator) et la
project managed identity au runtime (Cosmos DB Operator, Storage Account Contributor, Search Index Data Contributor, Search
Service Contributor, Storage Blob Data Contributor / Owner sur les conteneurs, Cosmos DB Built-in Data Contributor sur la base
enterprise_memory). - Ressource Azure OpenAI existante réutilisable (
existingAoaiResourceId) : même région que la Foundry resource.
2.3 Réseau privé de l'Agent Service#
| Règle | Valeur |
|---|---|
| Subnet de l'agent | Délégué à Microsoft.App/environments, /27 minimum, /24 recommandé |
| Plages autorisées | RFC 1918 (10/8, 172.16/12, 192.168/16) ou RFC 6598 (100.64/10, hors quelques plages réservées) ; jamais d'IP publique |
| Partage | Un subnet d'agent par Foundry resource (le VNet, lui, peut être partagé) |
| Région | Foundry resource et VNet dans la même région (les ressources BYO peuvent être ailleurs) |
| Hosted agents | L'injection réseau doit être définie à la création de la Foundry resource |
| Azure Firewall | Autoriser control-{region}.identity.azure.net, {region}.login.microsoft.com, login.microsoftonline.com (ou la service tag AzureActiveDirectory) ; pas d'inspection TLS qui injecte un certificat auto-signé |
| Portail | Avec accès public désactivé, certaines opérations demandent le SDK ou la CLI depuis le VNet (jump box via Bastion, VPN, ExpressRoute) |
Zones DNS privées de la Foundry resource : privatelink.cognitiveservices.azure.com, privatelink.openai.azure.com et
privatelink.services.ai.azure.com (plus celles d'AI Search, Cosmos DB et Blob).
Deux modèles d'isolation sortante existent : VNet géré par le client (BYO), avec contrôle total, ou managed virtual network, plus simple mais moins personnalisable.
2.4 Déclarer l'infrastructure (IaC)#
Terraform (azurerm 5.x, arguments vérifiés dans le registre) :
resource "azurerm_cognitive_account" "foundry" {
  name                          = "aif-chat-prd"
  location                      = "swedencentral"
  resource_group_name           = azurerm_resource_group.ai.name
  kind                          = "AIServices"
  sku_name                      = "S0"
  custom_subdomain_name         = "aif-chat-prd"   # requis pour Entra ID, Private Endpoint, Agent Service
  project_management_enabled    = true             # requis pour créer des projects
  local_auth_enabled            = false            # keyless : Entra ID seulement
  public_network_access_enabled = false

  identity {
    type = "SystemAssigned"
  }

  network_injection {
    scenario  = "agent"
    subnet_id = azurerm_subnet.agents.id           # subnet délégué Microsoft.App/environments
  }
}

resource "azurerm_cognitive_account_project" "support" {
  name                 = "support"
  cognitive_account_id = azurerm_cognitive_account.foundry.id
  location             = azurerm_cognitive_account.foundry.location

  identity {
    type = "SystemAssigned"
  }
}
Bicep : un project est une ressource enfant de la Foundry resource ; Microsoft publie des modèles prêts dans
microsoft-foundry/foundry-samples (basic agent setup, standard agent setup, private network standard agent setup, aussi en
Terraform).
3. Choose appropriate deployment options#
3.1 Trois manières d'appeler un modèle#
| Option | Pour quels modèles | Facturation | Traitement des données | À savoir |
|---|---|---|---|---|
| Serverless API (option préférée) | Foundry Models sold by Azure (dont tous les Azure OpenAI) et une sélection de partenaires (Anthropic, Mistral, Cohere, Meta…) | Jetons ou PTU | Global, Data Zone ou régional | Content filtering, keyless, réseau privé, tous les deployment types |
| Managed compute (preview) | Open source, partenaires, poids personnalisés (Hugging Face, NVIDIA NIM) | À l'heure par SKU d'accélérateur (A100, H100, MI300X) | Global | Quota Foundry distinct du quota de VM ; pas de content filtering en préversion ; runtimes vLLM, SGLang, NIM gérés par Microsoft |
| Instant access (preview) | Modèles pris en charge, appelés par leur nom | Usage | — | Aucun déploiement : pour essayer vite |
Les modèles de partenaires vendus via Azure Marketplace exigent des permissions Microsoft.MarketplaceOrdering/* et
Microsoft.SaaS/* sur l'abonnement (incluses dans Owner et Contributor).
3.2 Les deployment types de la Serverless API#
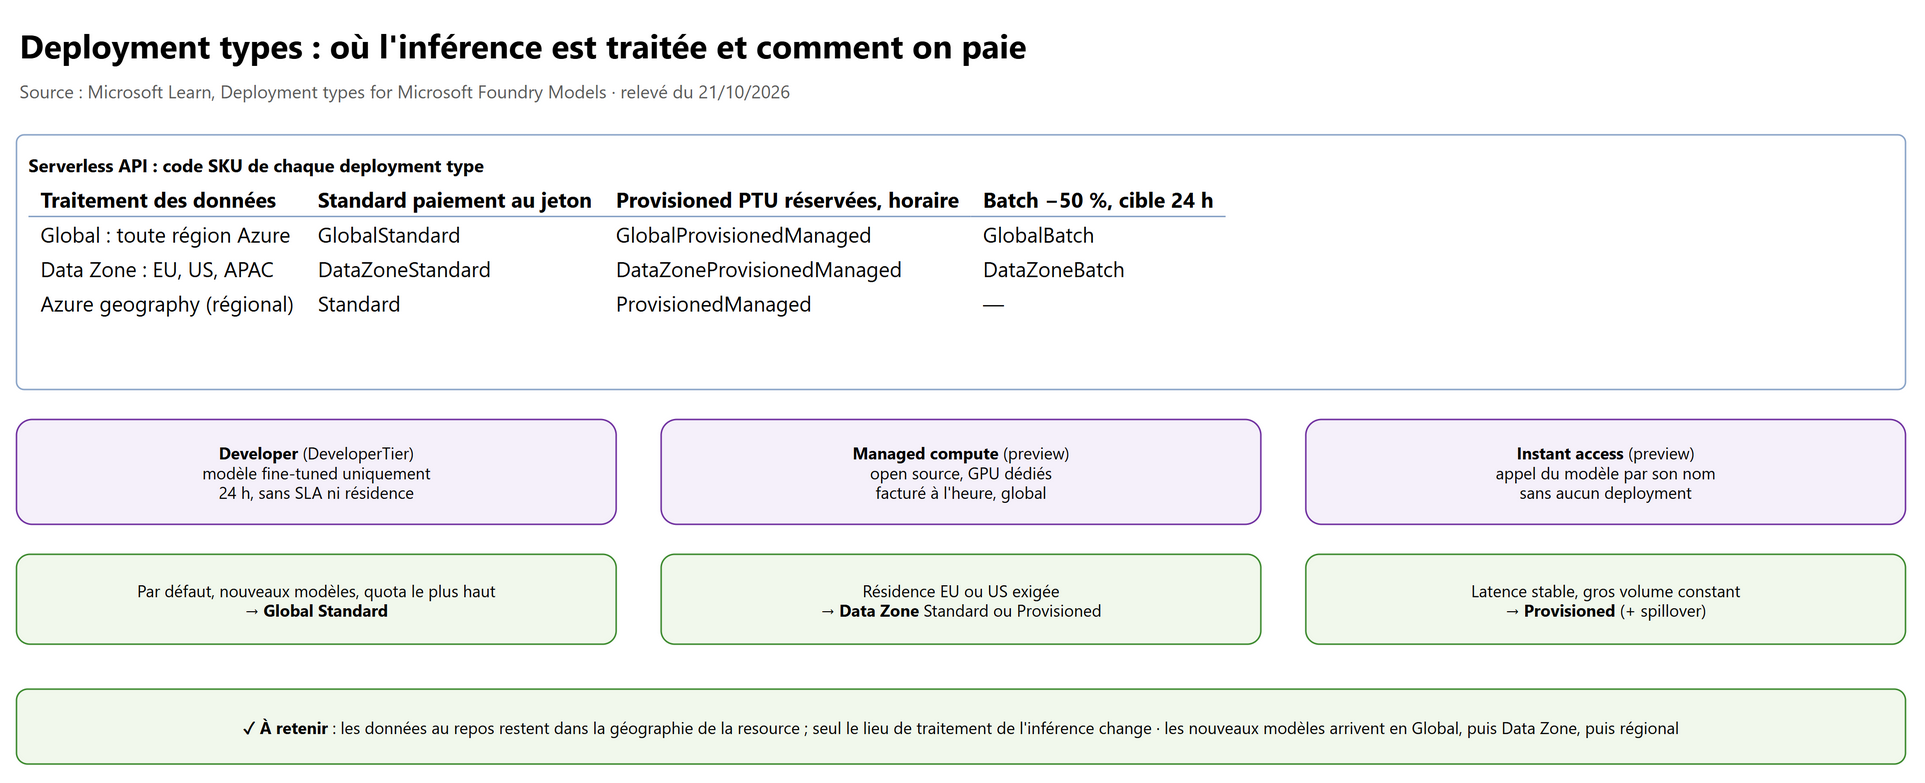
| Deployment type | SKU (CLI, ARM) | Traitement de l'inférence | Facturation | Pour quoi |
|---|---|---|---|---|
| Global Standard | GlobalStandard |
Toute région Azure | Jeton | Point de départ : nouveaux modèles en premier, prix le plus bas, quota le plus haut |
| Global Provisioned | GlobalProvisionedManaged |
Toute région | PTU réservées, horaire | Débit prévisible, haute disponibilité |
| Global Batch | GlobalBatch |
Toute région | −50 %, cible 24 h | Gros travaux asynchrones (fichier de requêtes), quota séparé |
| Data Zone Standard | DataZoneStandard |
Dans la zone EU, US ou APAC | Jeton | Résidence par zone |
| Data Zone Provisioned | DataZoneProvisionedManaged |
Zone de données | PTU | Résidence + débit garanti |
| Data Zone Batch | DataZoneBatch |
Zone de données | −50 % | Batch avec résidence |
| Standard | Standard |
Géographie Azure de la ressource | Jeton | Conformité géographique, faible volume |
| Regional Provisioned | ProvisionedManaged |
Géographie Azure | PTU | Géographie + débit |
| Developer | DeveloperTier |
Toute région, sans garantie de résidence | Jeton | Évaluer un modèle fine-tuned : 24 h de vie, supprimé ensuite, sans SLA |
Règles à connaître par cœur :
- Au repos, les données restent toujours dans la géographie de la ressource ; le deployment type ne change que le lieu de traitement de l'inférence.
- La zone EU suit l'EU Data Boundary (elle peut inclure des pays de l'AELE comme la Norvège ou la Suisse).
- Ordre d'arrivée des nouveaux modèles : Global, puis Data Zone, puis régional (sans date garantie).
- Standard (jeton) = best effort, latence variable à fort volume ; Provisioned = latence stable et SLA de latence.
- Tous les modèles ne prennent pas en charge tous les types : vérifier la disponibilité par modèle et par région.
flowchart TD
    A["Quel deployment type ?"] --> B{"Modèle fine-tuned<br/>à évaluer ?"}
    B -- Oui --> DEV["Developer"]
    B -- Non --> C{"Travail asynchrone,<br/>non urgent ?"}
    C -- Oui --> BAT["Global Batch ou Data Zone Batch"]
    C -- Non --> D{"Résidence exigée ?"}
    D -- "Zone EU ou US" --> E{"Volume constant,<br/>latence stable ?"}
    D -- "Géographie précise" --> F{"Volume constant,<br/>latence stable ?"}
    D -- Aucune --> G{"Volume constant,<br/>latence stable ?"}
    E -- Oui --> DZP["Data Zone Provisioned"]
    E -- Non --> DZS["Data Zone Standard"]
    F -- Oui --> RP["Regional Provisioned"]
    F -- Non --> STD["Standard"]
    G -- Oui --> GP["Global Provisioned + spillover"]
    G -- Non --> GS["Global Standard"]
3.3 Provisioned throughput et spillover#
Les PTU (provisioned throughput units) réservent une capacité de traitement : chaque couple modèle/version demande un minimum de PTU et donne un débit par PTU différent. Le quota PTU et les réservations sont par région et par forme (Global, Data Zone, régional). La réservation (remise long terme) s'achète à part, pas par Terraform.
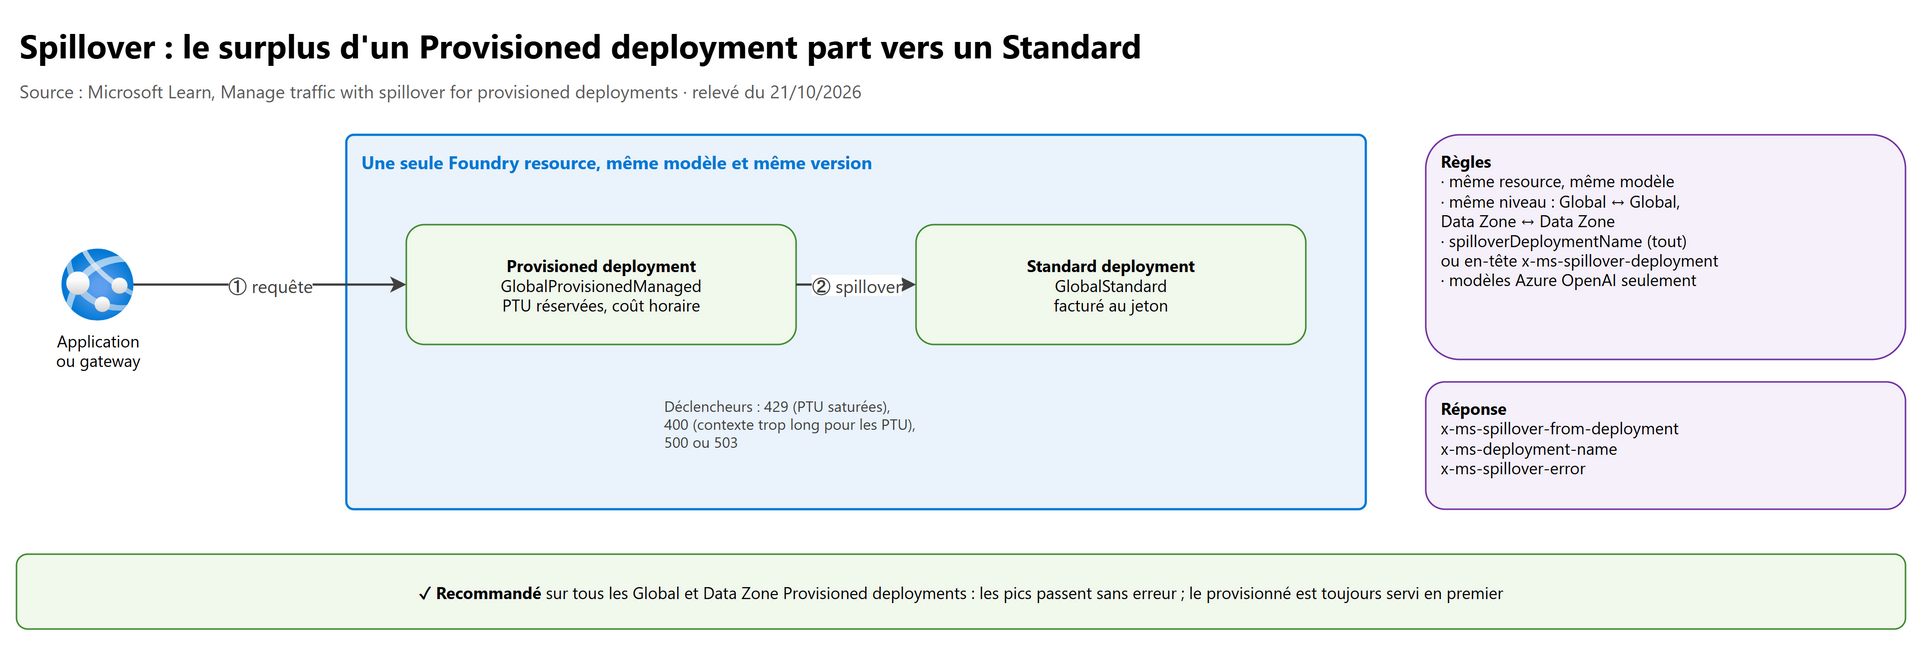
| Spillover | Règle |
|---|---|
| Quoi | Les requêtes en échec du Provisioned deployment sont redirigées automatiquement vers un Standard deployment |
| Déclencheurs | 429 (PTU saturées), 400 (contexte long non pris en charge en PTU), 500 / 503 |
| Prérequis | Même Foundry resource, même modèle et version, même niveau de traitement (Global ↔ Global, Data Zone ↔ Data Zone) ; modèles Azure OpenAI seulement (pas DeepSeek ni Llama aujourd'hui) |
| Activation | Propriété spilloverDeploymentName (toutes les requêtes) ou en-tête x-ms-spillover-deployment (par requête) ; si les deux, la propriété l'emporte |
| Traçabilité | En-têtes x-ms-spillover-from-deployment, x-ms-deployment-name, x-ms-spillover-error |
| Coût | PTU : coût horaire seul ; requêtes déversées : tarif jeton du Standard |
| Recommandation | L'activer sur tous les Global et Data Zone Provisioned deployments |
Piège : le spillover ne fait pas de bascule PTU → PTU, ni d'une région à une autre. Pour la résilience multirégion, chaîne de repli dans une passerelle (Azure API Management) : PTU dédié → pool PTU d'entreprise (autre région) → Standard.
4. Configure model and agent deployments#
4.1 Un model deployment#
Un déploiement se définit par : un nom (celui que le code passe dans model), le modèle (name, version, format =
fournisseur), le SKU (deployment type) et sa capacité, la content filter policy (raiPolicyName, par défaut
Microsoft.DefaultV2) et la version upgrade policy. On peut déployer plusieurs fois le même modèle sous des noms différents
(pour tester un autre filtre, une autre capacité).
# Lister les modèles disponibles pour la ressource (nom, format, version, SKU, capacité par défaut)
az cognitiveservices account list-models -n aif-chat-prd -g rg-ai-prd

# Créer un déploiement Global Standard
az cognitiveservices account deployment create -n aif-chat-prd -g rg-ai-prd \
  --deployment-name gpt-chat --model-name <modele> --model-version <version> --model-format OpenAI \
  --sku-name GlobalStandard --sku-capacity 50
resource "azurerm_cognitive_deployment" "chat" {
  name                   = "gpt-chat"
  cognitive_account_id   = azurerm_cognitive_account.foundry.id
  rai_policy_name        = "Microsoft.DefaultV2"
  version_upgrade_option = "OnceCurrentVersionExpired"   # OnceNewDefaultVersionAvailable (défaut) | NoAutoUpgrade

  model {
    format  = "OpenAI"
    name    = "<modele>"
    version = "<version>"
  }

  sku {
    name     = "GlobalStandard"
    capacity = 50            # en milliers de TPM : 50 = 50 000 jetons par minute
  }
}
Capacité, TPM et RPM : le quota est attribué à l'abonnement par région, par modèle et par deployment type, en TPM. La TPM donnée à un déploiement devient sa limite ; la RPM en découle selon un ratio propre au modèle (page Manage Azure OpenAI quota : anciens modèles de chat 1 unité = 1 000 TPM et 6 RPM ; o3 et o4-mini 1 unité = 1 000 TPM et 1 RPM). On peut avoir du quota approuvé et recevoir des 429 parce qu'il n'est pas affecté au bon déploiement. Gestion des quotas et des 429 : chapitre 03.
Versions de modèle et retrait :
| Version upgrade policy (portail / Terraform) | Comportement |
|---|---|
Upgrade once new default version becomes available / OnceNewDefaultVersionAvailable |
Passe à la nouvelle version par défaut (dans les deux semaines suivant le changement) |
Once the current version expires / OnceCurrentVersionExpired |
Reste sur la version choisie, passe à la suivante au retrait |
Opt out of automatic model version upgrades / NoAutoUpgrade |
Ne bouge jamais : cesse de répondre au retrait |
stateDiagram-v2
    [*] --> Deployed: version choisie
    Deployed --> NewDefault: nouvelle version par défaut publiée
    NewDefault --> Deployed: OnceNewDefaultVersionAvailable (mise à niveau)
    NewDefault --> Retired: OnceCurrentVersionExpired ou NoAutoUpgrade (on attend)
    Retired --> Deployed: OnceCurrentVersionExpired (mise à niveau au retrait)
    Retired --> Broken: NoAutoUpgrade (erreurs)
    Broken --> [*]
- Les mises à niveau automatiques ne valent que pour Global Standard, Data Zone Standard et Standard ; les Provisioned deployments ne sont jamais mis à niveau automatiquement : migration manuelle.
- Il y a deux versions distinctes : celle du modèle et celle de l'API (
api-version). La route/openai/v1/utilise un versionnement implicite (pas deapi-version). - Les retraits sont annoncés par e-mail aux Owners et Contributors, par Azure Service Health et dans le Model Retirement
Schedule ; l'API Models expose
lifecycleStatusetdeprecationDate.
4.2 Un agent deployment#
Foundry Agent Service propose trois types d'agents :
| Type | Ce qu'on fournit | Ce que gère Foundry | Pour quoi |
|---|---|---|---|
| Prompt agent | Instructions, modèle, tools (portail, SDK ou REST) | Tout : runtime, mise à l'échelle | Démarrage rapide, agents de production sans orchestration personnalisée |
| Voice prompt agent (preview) | Modèle, instructions, audio, tools ; connexion par Voice Live (WebSocket) | Orchestration vocale | Centre d'appels, voix temps réel |
| Hosted agent | Votre code en conteneur ou en .zip (Agent Framework, LangGraph, OpenAI Agents SDK…) | Endpoint, autoscale, identité Entra dédiée, état de session | Orchestration personnalisée, multi-agents |
S'y ajoute l'agent éphémère : appeler la Responses API depuis votre code, la définition vivant dans l'application (aucune ressource agent à gérer).
Créer une version d'agent (SDK azure-ai-projects, authentification sans clé) :
from azure.identity import DefaultAzureCredential
from azure.ai.projects import AIProjectClient
from azure.ai.projects.models import PromptAgentDefinition

# Format : https://<resource>.services.ai.azure.com/api/projects/<project>
project = AIProjectClient(endpoint="<project-endpoint>", credential=DefaultAzureCredential())

agent = project.agents.create_version(
    agent_name="support-agent",
    definition=PromptAgentDefinition(
        model="gpt-chat",                       # nom du model deployment
        instructions="Tu réponds aux questions du support interne.",
    ),
)
print(agent.name, agent.version)
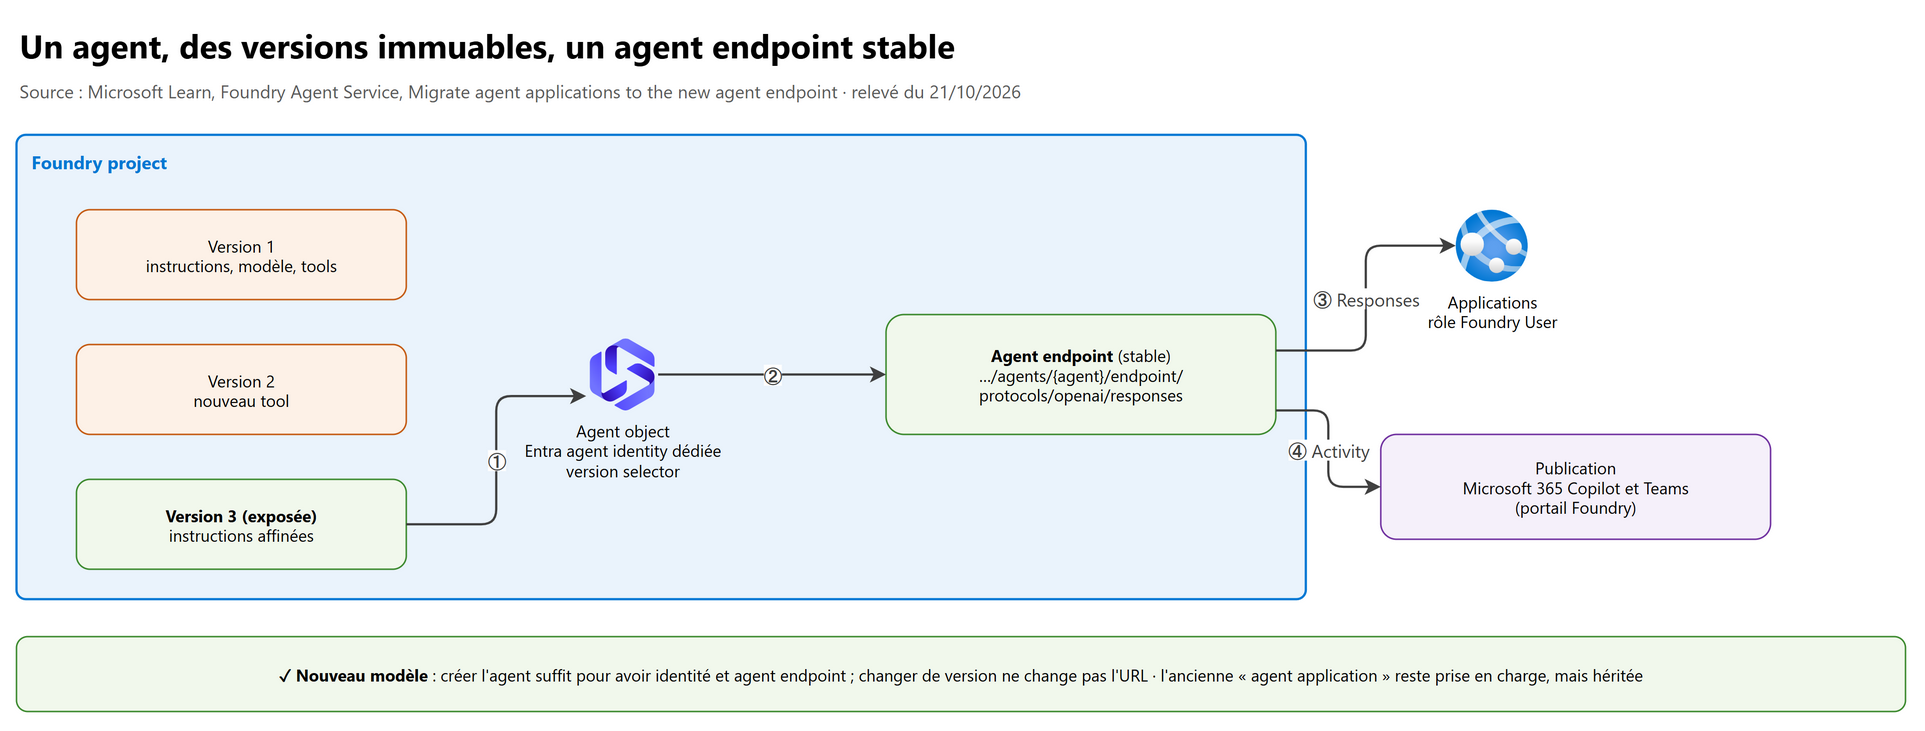
- Chaque modification crée une version immuable ; on peut revenir à une version ou comparer.
- Nouveau modèle objet : à sa création, l'agent reçoit sa propre Entra agent identity et son blueprint, plus un agent
endpoint stable (
…/agents/{agent}/endpoint/protocols/openai/responses). Par défaut il sert la dernière version (Always use latest) ; on épingle une version avecversion_selector(règleFixedRatio). « Publier » désigne désormais la distribution vers Microsoft 365 Copilot et Teams (protocole Activity, Azure Bot Service), depuis le portail Foundry ou par l'API REST de publication Microsoft 365 (publishScopeSharedouTenant, ce dernier avec approbation dans le Microsoft 365 admin center). Un agent legacy se reconnaît àagent.identity= null : il faut recréer l'agent pour obtenir une identité unique (pas de mise à niveau sur place pour l'instant). - Ancien modèle (legacy) : publier créait une agent application (ressource ARM distincte, son endpoint, son identité) et un
agent deployment (
deploymentTypeManagedpour un prompt agent,HostedavecminReplicas/maxReplicaspour un hosted agent), 100 % du trafic vers une version. Toujours pris en charge, mais hérité. Piège : l'identité change à la publication, il faut réattribuer le RBAC aux ressources que l'agent appelle ; les clés API ne permettent pas d'appeler une agent application (Entra ID uniquement) et seule la Responses API sans état y est exposée. - Protocoles : Responses (compatible OpenAI), Activity (Microsoft 365, Teams, Azure Bot Service), A2A (agent à agent).
4.3 Connecter une application à un project#
# Endpoint du project, à donner aux développeurs avec le nom du déploiement
az cognitiveservices account project show --name aif-chat-prd --resource-group rg-ai-prd \
  --project-name support --query 'properties.endpoints."AI Foundry API"' --output tsv
L'application s'authentifie avec sa managed identity (rôle Foundry User) et DefaultAzureCredential ; aucune clé dans la
configuration. Le code d'inférence (Responses API, get_openai_client()) est au chapitre 05.
5. Integrate Foundry projects with CI/CD#
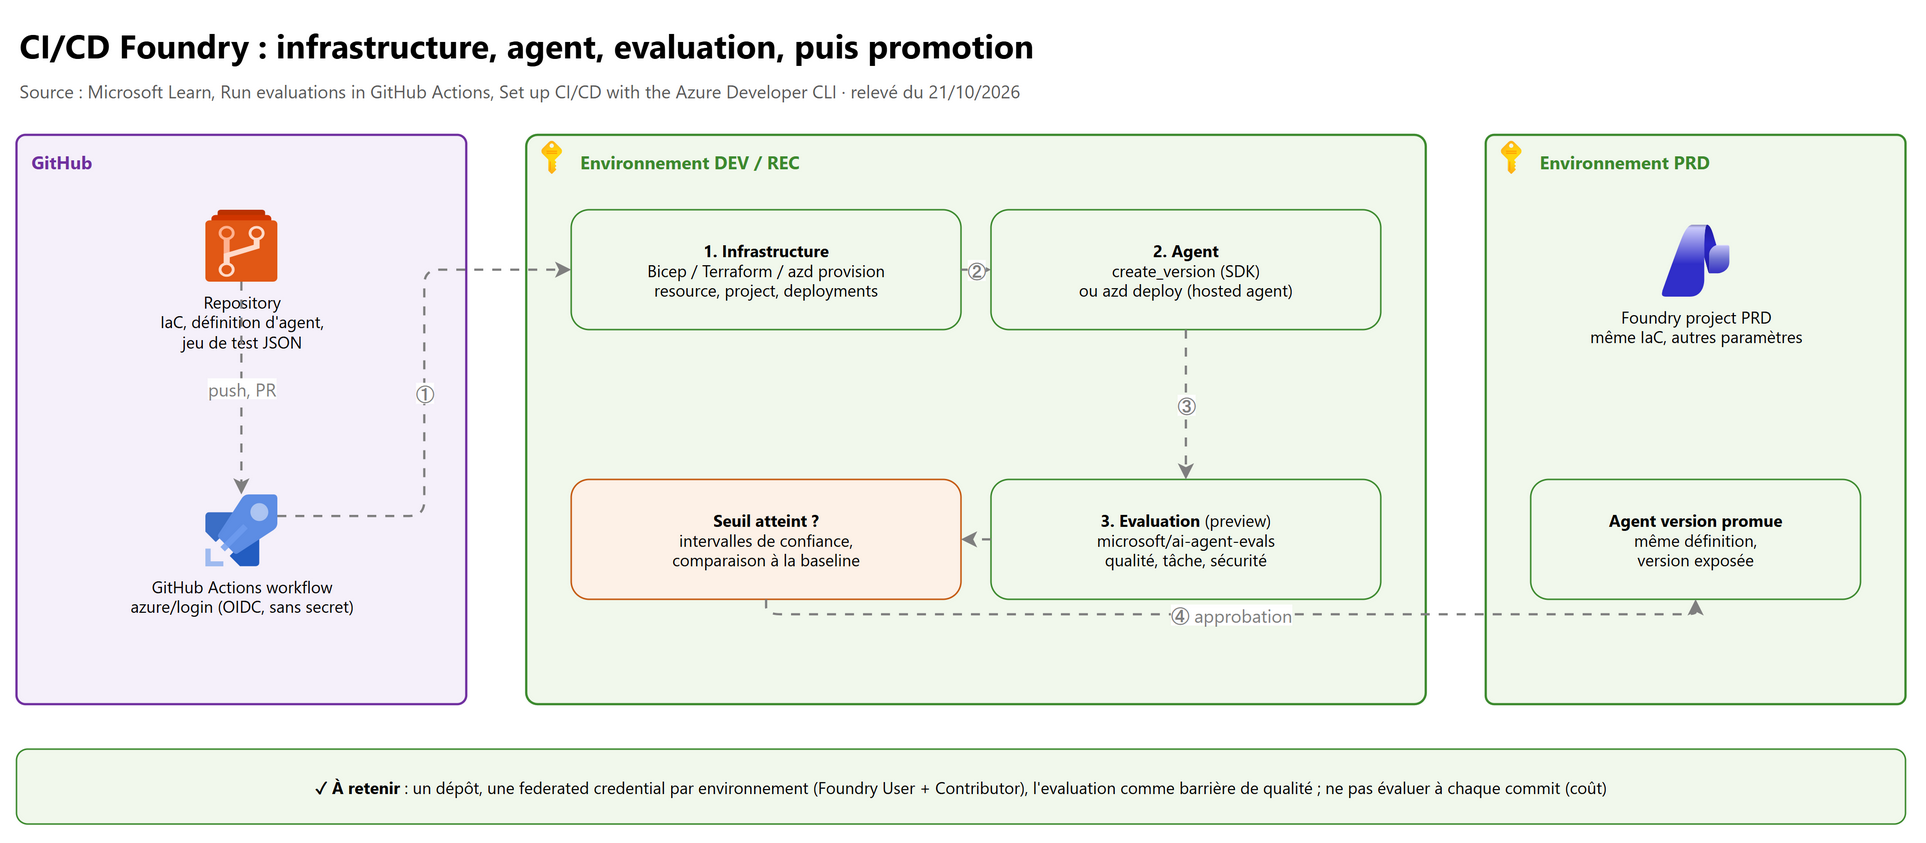
Une chaîne type :
- Infrastructure : Bicep ou Terraform (Foundry resource, projects, model deployments, connections, réseau), ou
azd provisionavec les modèles générés parazd ai agent init. - Agent :
create_versionpar le SDK pour un prompt agent, ouazd deploypour un hosted agent (azd pipeline configgénère le workflow GitHub Actions ou Azure Pipelines ; en CI, installer l'extensionmicrosoft.foundry). - Evaluation (preview) : l'action GitHub
microsoft/ai-agent-evalsou l'extension Azure DevOps équivalente invoquent les agents avec un jeu de requêtes, appliquent des evaluators (agent, RAG, risk and safety, general purpose, OpenAI graders, custom) et publient un rapport avec intervalles de confiance et comparaison statistique entre versions. - Promotion : même IaC avec d'autres paramètres vers le project PRD, après approbation.
name: "AI Agent Evaluation"
on:
  workflow_dispatch:
  push:
    branches: [main]
permissions:
  id-token: write          # obligatoire pour l'OIDC
  contents: read
jobs:
  evaluate:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: azure/login@v2               # workload identity federation, aucun secret
        with:
          client-id: ${{ vars.AZURE_CLIENT_ID }}
          tenant-id: ${{ vars.AZURE_TENANT_ID }}
          subscription-id: ${{ vars.AZURE_SUBSCRIPTION_ID }}
      - uses: microsoft/ai-agent-evals@v3-beta
        with:
          azure-ai-project-endpoint: ${{ vars.FOUNDRY_PROJECT_ENDPOINT }}
          deployment-name: gpt-chat         # modèle juge des evaluators
          agent-ids: "support-agent:3,support-agent:4"   # nom:version ; la première sert de référence
          data-path: ${{ github.workspace }}/evals/dataset.json
{
  "name": "support-regression",
  "evaluators": ["builtin.fluency", "builtin.task_adherence", "builtin.violence"],
  "data": [
    { "query": "Comment réinitialiser mon mot de passe ?" },
    { "query": "Quel est le délai de remboursement ?" }
  ]
}
Bonnes pratiques :
- Une federated credential (workload identity federation, voir SC-500 · 01) par environnement ; rôles Foundry User et Contributor sur le project cible pour un déploiement de code (plus les droits ACR pour un conteneur).
- Ne pas évaluer à chaque commit : c'est facturé (jetons du modèle juge).
- Avec un réseau privé (accès public désactivé), le plan de données n'est joignable que depuis le VNet : runners auto-hébergés GitHub ou agents Azure DevOps dans le VNet.
- En production, compléter par la continuous evaluation du trafic réel (chapitre 07).
6. Labs conseillés#
Dans un abonnement de test, région où l'Agent Service est disponible. Supprimer les ressources à la fin (les PTU et Cosmos DB coûtent même à vide).
| Lab | Étapes | Résultat attendu |
|---|---|---|
| 1. Foundry resource et projects | Créer une Foundry resource et deux projects (portail ou Terraform ci-dessus, sans network_injection) ; donner Foundry User à un collègue sur un seul project |
Il voit et modifie les agents d'un project, pas de l'autre ; les model deployments sont communs |
| 2. Déploiements et upgrade policy | list-models, puis deux déploiements du même modèle : un GlobalStandard, un DataZoneStandard, avec deux upgrade policies différentes |
Deux noms de déploiement appelables ; les politiques visibles dans Details ; un modèle sans Data Zone dans la région n'est pas proposé |
| 3. Agent et versions | Créer un prompt agent par le SDK, le modifier deux fois, l'appeler par son agent endpoint avec un compte sans Foundry User | Trois versions listées ; appel refusé (403) tant que le rôle manque |
| 4. Standard setup (facultatif, ≈ 1 h) | Déployer le modèle Bicep standard agent setup avec un Cosmos DB à 1 000 RU/s, puis à 3 000 RU/s | Premier essai en échec de provisionnement ; deuxième OK, conteneurs <project-id>-… créés dans Cosmos DB |
| 5. Evaluation en CI | Workflow GitHub ci-dessus, avec OIDC et un jeu de 10 requêtes, comparant deux versions | Rapport dans le résumé de l'exécution, scores et intervalles de confiance |
7. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Nouveau projet d'agents, quelle ressource créer ? | Foundry resource (kind AIServices) + Foundry project |
Le hub est l'ancien modèle (classic) |
| Les données d'inférence doivent rester dans l'UE | Data Zone Standard ou Provisioned (ou Standard régional) | Global peut traiter dans n'importe quelle région |
| « Les données au repos quittent-elles la géographie avec Global Standard ? » | Non | Seul le traitement de l'inférence change |
| Évaluer un modèle fine-tuned au moindre coût | Developer deployment | 24 h, sans SLA ni résidence |
| 10 millions de documents à résumer d'ici demain | Global Batch | −50 %, cible 24 h, quota séparé |
| Latence stable sous forte charge constante | Provisioned | Standard = best effort |
| Absorber les pics d'un PTU sans erreur | Spillover vers un Standard deployment de la même ressource | Mêmes modèle, version et niveau de traitement |
| Spillover d'un Global Provisioned vers un Data Zone Standard | Impossible | Les niveaux de traitement doivent correspondre |
| Un Provisioned deployment va-t-il passer seul à la nouvelle version ? | Non, migration manuelle | Auto-upgrade : types Standard uniquement |
Déploiement en NoAutoUpgrade au retrait du modèle |
Il cesse de répondre | Il faut migrer avant la date |
| Créer un model deployment : quel rôle ? | Foundry Account Owner sur la Foundry resource (ou Foundry Owner) | Ni Foundry User ni Foundry Project Manager ne gèrent les modèles |
| Standard setup : échec de provisionnement Cosmos DB | RU/s insuffisantes (≥ 3 000, 1 000 par conteneur) | Multiplier par le nombre de projects |
| Changer le Cosmos DB d'un project Standard existant | Recréer le project | Capability settings immuables |
| Subnet de l'agent | Délégué Microsoft.App/environments, /27 mini, /24 conseillé, un par Foundry resource |
Exigé par l'injection |
| Ajouter l'injection réseau à une Foundry resource existante pour des hosted agents | Non pris en charge : à la création | Contrainte documentée |
| Agent publié (agent application) dont les tools échouent en 403 | Réattribuer le RBAC à la nouvelle identité | L'identité change à la publication |
| Appeler une agent application avec une clé API | Impossible : Entra ID et Foundry User sur l'application | Pas de clé pour les agent applications |
| Pipeline qui se connecte à Azure sans secret | azure/login avec OIDC et permissions: id-token: write |
Workload identity federation |
| Pas de Private Endpoint possible sur la Foundry resource | Il manque le custom subdomain | Requis aussi pour Entra ID |
8. Scénarios d'entraînement#
1. Une banque européenne veut des agents dont les conversations restent dans ses propres ressources, chiffrées avec ses clés, sans trafic public. Quelle configuration ?
Standard setup de Foundry Agent Service avec BYO Cosmos DB, Azure Storage, Azure AI Search, CMK, injection dans le VNet (subnet délégué
Microsoft.App/environments), Private Endpoints pour tout le PaaS et accès public désactivé ; modèles en Data Zone (EU).
2. Une application de chat a des pics le lundi matin. Elle utilise un Global Provisioned deployment qui renvoie des 429 pendant les pics. Que faire sans racheter de PTU ?
Créer un Global Standard deployment du même modèle et de la même version dans la même Foundry resource, puis activer le spillover (
spilloverDeploymentName). Les pics sont facturés au jeton.
3. Un data scientist veut tester pendant une journée un modèle fine-tuned avant de décider de le mettre en production. Quel deployment type ?
Developer (
DeveloperTier) : faible coût, supprimé au bout de 24 h, sans SLA ni garantie de résidence. Pas pour la production.
4. Une équipe a choisi NoAutoUpgrade sur tous ses déploiements pour garder des réponses stables. Quel risque, et quelle
politique recommander ?
Au retrait du modèle, ses déploiements cessent de répondre. Recommander
OnceCurrentVersionExpired(stabilité jusqu'au retrait, puis mise à niveau automatique) et surveiller Azure Service Health et le calendrier de retrait.
5. Le déploiement Standard setup d'un deuxième project échoue alors que le premier fonctionne. Les deux utilisent la Responses API et le même Cosmos DB à 6 000 RU/s. Pourquoi ?
Chaque project crée jusqu'à 5 conteneurs à 1 000 RU/s : 2 projects demandent 10 000 RU/s. Augmenter le débit (ou passer en serverless).
6. Vous devez ajouter des hosted agents isolés dans le VNet à une Foundry resource créée l'an dernier sans injection réseau. Que répondre ?
Pour les hosted agents, l'injection réseau doit être configurée à la création de la Foundry resource : créer une nouvelle Foundry resource avec
network_injection, puis y redéployer.
7. Un pipeline GitHub doit déployer l'IaC Foundry, créer une nouvelle version d'agent, la comparer à la précédente et ne promouvoir en PRD que si elle est meilleure. Quels éléments ?
azure/loginen OIDC (federated credential,id-token: write), Terraform/Bicep ouazd provision,create_versionouazd deploy, puismicrosoft/ai-agent-evalsavecagent-ids: "agent:N,agent:N+1"(comparaison statistique), et une approbation d'environnement GitHub avant le job PRD.
8. Après publication d'un agent en agent application (ancien modèle), l'outil AI Search renvoie des erreurs d'autorisation alors qu'il fonctionnait dans le project. Cause ?
La publication a donné à l'agent une nouvelle identité ; elle n'a pas les rôles du project. Attribuer Search Index Data Reader (ou le rôle requis) à cette identité.
9. Une agence française doit garantir que l'inférence ne sort pas de France. Quel deployment type ?
Standard (régional) ou Regional Provisioned dans une région française, si le modèle y est disponible. Data Zone EU ne suffit pas (traitement possible ailleurs dans l'UE).
9. Pour aller plus loin#
- Pool PTU d'entreprise : un Data Zone Provisioned deployment partagé entre applications derrière Azure API Management (priorités, limites, journalisation, repli), placé dans une autre région que le Standard principal. Voir la passerelle IA dans SC-500 · 07.
- Toolboxes : regrouper les tools (web search, file search, code interpreter, serveurs MCP, fonctions) derrière un endpoint MCP géré et versionné, partagé entre agents (chapitre 06).
- Mise à niveau Azure OpenAI → Foundry : endpoint, clés et état conservés, Azure Policy et RBAC existants toujours appliqués.
- Microsoft Foundry Skill pour GitHub Copilot : aide à adapter les modèles de pipeline et de réseau privé.
10. Fiche à retenir#
- Foundry resource (
accounts, kindAIServices) = gouvernance et model deployments ; Foundry project = travail d'équipe isolé, managed identity dédiée. - Connected resources (Storage, Key Vault, AI Search, Cosmos DB) = gouvernance séparée.
- Hub-based project = classic ; pas de migration des agents vers un Foundry project.
-
custom_subdomain_nameobligatoire pour Entra ID, Private Endpoint et Agent Service ;project_management_enabledpour les projects. - Baseline Foundry chat : Application Gateway + WAF, Private Endpoints partout, Standard setup, sortie par Azure Firewall.
- Standard setup : Cosmos DB ≥ 3 000 RU/s, 1 000 RU/s par conteneur, jusqu'à 5 par project ; capability settings immuables.
- Subnet d'agent : délégué
Microsoft.App/environments, /27 mini, /24 conseillé, un par Foundry resource, même région. - Serverless API (préférée) / Managed compute (preview, à l'heure, quota distinct) / Instant access (preview, sans déploiement).
- Deployment types : Global (tout Azure) · Data Zone (EU, US, APAC) · Standard / Regional (géographie) × Standard / Provisioned / Batch ; plus Developer (fine-tuned, 24 h, sans SLA).
- Données au repos toujours dans la géographie de la ressource ; Global Standard = point de départ.
- Spillover : PTU → Standard, même ressource, même modèle, même niveau ; 429, 400, 500, 503 ; propriété > en-tête.
- Capacité en milliers de TPM ; RPM proportionnelle ; quota par région, modèle et deployment type.
- Upgrade policies : nouvelle version par défaut · à l'expiration · jamais (cesse au retrait) ; Provisioned jamais auto-upgradé.
- Agents : prompt, voice prompt (preview), hosted ; versions immuables ; agent endpoint stable et Entra agent identity dès la création.
- Rôles : Foundry Account Owner (déploiements de modèles), Foundry User (agents, appel), Foundry Project Manager (publication, pas de déploiement de modèles).
- CI/CD : OIDC, IaC,
create_version/azd deploy,microsoft/ai-agent-evals(preview), promotion ; pas d'évaluation à chaque commit.
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Study guide for Exam AI-103 (en-us)
- L'architecture de Microsoft Foundry
- Hub resources overview (classic)
- Migrate from hub-based to Foundry projects (classic)
- Baseline Microsoft Foundry chat reference architecture
- Basic Microsoft Foundry chat reference architecture
- Utiliser vos propres ressources avec le service Agent
- Configurer des ressources d'agent standard
- Configurer le réseau privé pour Foundry Agent Service
- Vue d'ensemble du déploiement pour les modèles Microsoft Foundry
- Deployment types for Microsoft Foundry Models
- What is provisioned throughput for Foundry Models?
- Manage traffic with spillover for provisioned deployments
- High availability and resiliency for Foundry projects and Agent Services
- Déployer des modèles à l'aide d'Azure CLI et de Bicep
- Model versions in Microsoft Foundry Models
- Foundry Models lifecycle and support policy
- Working with models (upgrade policies)
- Manage Azure OpenAI in Microsoft Foundry Models quota
- Azure OpenAI 429: token and request rate limits explained
- Agents de Microsoft Foundry
- Publier votre agent sous forme d'application d'agent
- Migrer vers le nouveau point de terminaison d'agent et l'expérience de publication
- Quickstart: Set up Microsoft Foundry resources
- How to run an evaluation in GitHub Action (preview)
- How to run an evaluation in Azure DevOps (preview)
- Set up CI/CD for hosted agents with the Azure Developer CLI
- Registre Terraform
hashicorp/azurerm5.10.0 :azurerm_cognitive_account,azurerm_cognitive_account_project,azurerm_cognitive_deployment