

Version : 1.1 · Date : 2026-10-21 · Hors programme (besoin de mission)
Chapitre hors programme. L'examen AI-300 teste le fine-tuning managé, le choix d'un modèle et l'entraînement distribué dans Azure Machine Learning (chapitres 03, 05 et 07). Ce chapitre va plus loin pour une mission où on entraîne vraiment des LLM : quand personnaliser, comment choisir un modèle, où entraîner sur Azure, comment dimensionner, combien ça coûte et comment gouverner les données. Niveau : décision d'architecture, pas recherche en machine learning.
En une phrase : on personnalise un modèle par paliers (prompt, RAG, fine-tuning, puis seulement en dernier recours un entraînement plus profond), on choisit le modèle sur ses propres données et pas seulement sur un classement public, et sur Azure on préfère le fine-tuning managé de Foundry tant qu'il couvre le besoin, avant Azure Machine Learning, AKS avec KAITO ou un cluster GPU que l'on exploite soi-même.
Ce chapitre renvoie aux autres cours plutôt que de redire :
| Sujet | Où il est traité |
|---|---|
| Prompt, RAG ou fine-tuning côté consommation, familles de modèles | AI-103 · 01 |
| Deployment types, PTU, quotas | AI-103 · 02, AI-103 · 03 |
| Evaluators, red teaming | AI-103 · 04 |
| GPU sur AKS, KAITO, vLLM, quantization à l'inférence | AKS · 06 |
| Entraînement distribué dans Azure Machine Learning (examen) | 03-entrainement.md |
| Méthodes de fine-tuning et données synthétiques (examen) | 07-rag-fine-tuning.md |
1. Faut-il vraiment entraîner ? Les cinq paliers#
1.1 L'idée clé#
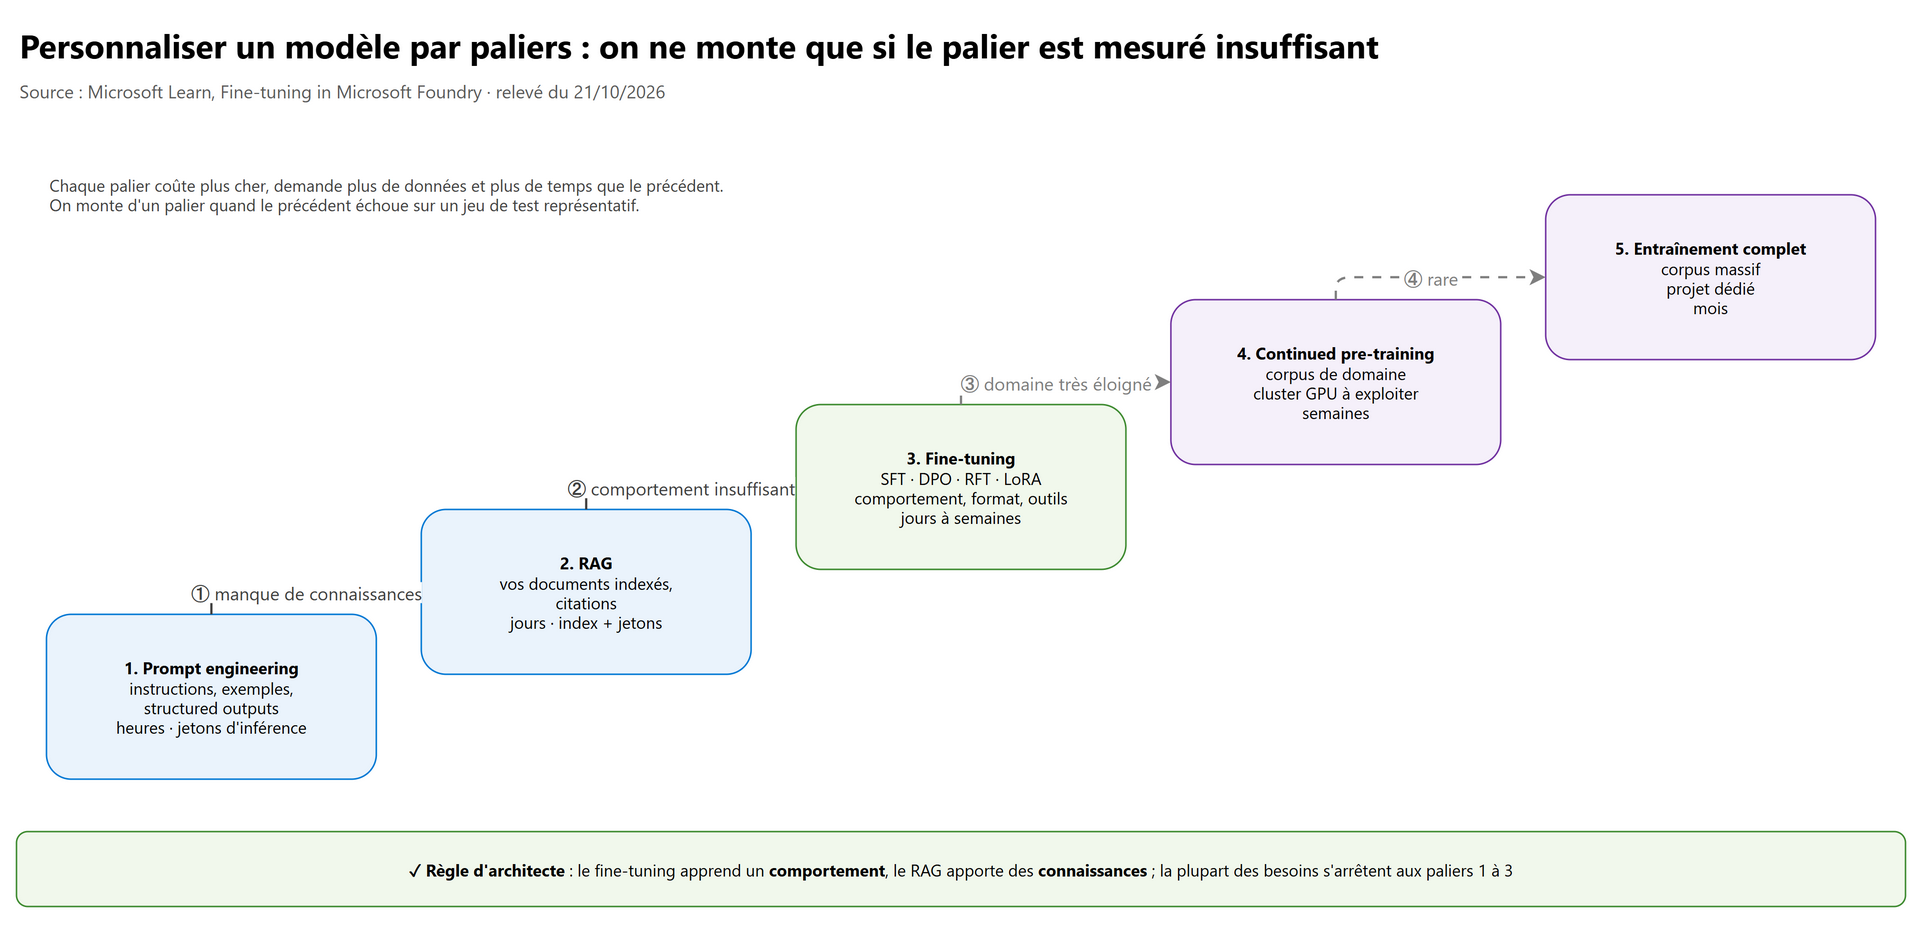
Chaque palier coûte plus cher, demande plus de données et plus de temps que le précédent. On ne monte d'un palier que lorsque le précédent est mesuré comme insuffisant sur un jeu de test représentatif.
| Palier | Ce qu'on change | Données nécessaires | Délai typique | Coût | Risque principal |
|---|---|---|---|---|---|
| 1. Prompt engineering | L'invite : instructions, exemples, format, structured outputs | Quelques exemples | Heures | Jetons d'inférence | Invites longues, donc latence et coût |
| 2. RAG | Le contexte injecté à chaque requête | Vos documents, indexés | Jours | Index + jetons | Qualité de la récupération |
| 3. Fine-tuning (SFT, DPO, RFT, LoRA) | Une partie ou la totalité des poids | Des dizaines à des milliers d'exemples de qualité | Jours à semaines | Entraînement + hébergement + réévaluation | Sur-apprentissage, régression, maintenance |
| 4. Continued pre-training | Les poids, sur un grand corpus de domaine non annoté | Un corpus de domaine volumineux | Semaines | Cluster GPU que l'on exploite | Oubli de capacités générales, coût |
| 5. Entraînement complet | Un modèle depuis zéro | Un corpus massif | Mois | Très élevé | Tout ce qui précède, à grande échelle |
Microsoft résume les raisons de passer au palier 3 (Fine-tuning in Microsoft Foundry) : améliorer la précision sur une tâche, réduire la longueur des invites, aligner le ton et le format, mieux utiliser les outils, mieux exploiter le contexte récupéré, spécialiser un modèle plus petit. Et ses limites : les gains ne sont pas garantis, le fine-tuning ajoute des coûts d'entraînement et d'hébergement, et il ne remplace ni la récupération pour l'information à jour, ni les contrôles de sécurité applicatifs.
Règle d'architecte : le fine-tuning apprend un comportement (format, ton, raisonnement sur une tâche, usage d'outils), pas des faits qui changent. Les faits vont dans le RAG. Dans une mission « on va entraîner des LLM », la première question à poser reste : quel comportement le modèle actuel ne sait-il pas produire, et comment le mesure-t-on ?
1.2 L'arbre de décision#
flowchart TD
    A["Besoin métier + jeu de test de référence"] --> B{"Le modèle de base,<br/>bien prompté, suffit ?"}
    B -- Oui --> P["Palier 1 : prompt engineering<br/>+ structured outputs"]
    B -- Non --> C{"Il manque des connaissances<br/>(documents, données récentes) ?"}
    C -- Oui --> R["Palier 2 : RAG"]
    C -- Non --> D{"Problème de comportement :<br/>format, ton, raisonnement, outils ?"}
    R --> D
    D -- Oui --> E{"Des exemples ou un grader fiable<br/>existent-ils ?"}
    E -- "Exemples entrée → sortie" --> F["SFT"]
    E -- "Réponses préférées / rejetées" --> G["DPO"]
    E -- "Grader qui note les réponses" --> H["RFT"]
    D -- Non --> I{"Langue ou domaine très éloigné<br/>du pré-entraînement ?"}
    I -- Oui --> J["Palier 4 : continued pre-training<br/>(cluster GPU, projet dédié)"]
    I -- Non --> K["Changer de modèle :<br/>plus grand, reasoning, autre famille"]
1.3 Les méthodes de fine-tuning en une ligne chacune#
| Méthode | Signal d'entraînement | Quand | Source |
|---|---|---|---|
| SFT (supervised fine-tuning) | Paires invite → réponse attendue | On sait montrer le comportement voulu ; le point de départ | Foundry |
| DPO (direct preference optimization) | Réponse préférée et réponse rejetée pour la même entrée | La qualité dépend d'une préférence (ton, complétude) plutôt que d'une seule bonne réponse | Foundry ; DPO remplace le couple « reward model + reinforcement learning » du RLHF par une simple perte de classification (Rafailov et al., 2023) |
| RFT (reinforcement fine-tuning) | Invites + un grader qui note les réponses générées | Plusieurs solutions sont possibles et on sait les noter de façon fiable | Foundry |
| LoRA (low-rank adaptation) | Adaptateurs légers entraînés à côté des poids gelés | Réduire fortement la mémoire et le stockage, servir plusieurs adaptateurs sur une même base | Sur GPT-3 175B : 10 000 fois moins de paramètres entraînables, 3 fois moins de mémoire GPU, sans latence d'inférence ajoutée (Hu et al., 2021) |
| QLoRA | LoRA sur une base quantifiée en 4 bits | Fine-tuner un grand modèle sur peu de GPU | Un modèle de 65B fine-tuné sur un seul GPU de 48 Go (Dettmers et al., 2023) |
LoRA et QLoRA sont des familles de PEFT (parameter-efficient fine-tuning) : on n'entraîne qu'un petit nombre de paramètres, avec des performances comparables à un fine-tuning complet (Hugging Face PEFT).
2. Choisir un modèle#
2.1 Les critères, dans l'ordre où ils éliminent#
| Critère | Question à poser | Pourquoi c'est éliminatoire |
|---|---|---|
| Conformité et résidence | Où les données d'entraînement et d'inférence ont-elles le droit d'aller ? | Le training type Global copie les données et les poids hors de la région ; Developer n'offre aucune garantie de résidence (training types) |
| Licence et usage commercial | La licence du modèle autorise-t-elle votre usage, la modification, la redistribution ? | Chaque modèle du catalogue a ses conditions sur sa model card ; un modèle open-weight n'est pas forcément libre d'usage commercial |
| Personnalisable ? | Le modèle accepte-t-il la méthode visée (SFT, DPO, RFT) et le déploiement voulu ? | Tous les modèles ne sont pas fine-tunables, et un modèle fine-tunable ne l'est pas forcément par toutes les méthodes ni pour tous les déploiements (supported models) |
| Tâche et modalités | Texte, code, image, audio, outils, raisonnement ? | Un modèle sans vision ne lira pas vos schémas |
| Contexte | Combien de jetons par requête, documents compris ? | Détermine le découpage RAG et le coût |
| Qualité | Sur votre jeu de test, pas seulement sur un benchmark public | Voir 2.2 |
| Latence et débit | Temps de réponse acceptable, requêtes par seconde ? | Un modèle de haute qualité mais lent ne convient pas au temps réel (interpret leaderboard results) |
| Coût | Coût par jeton, coût d'hébergement d'un modèle fine-tuné, coût d'un cluster ? | Voir section 7 |
| Taille | Un SLM (small language model) suffit-il, éventuellement après distillation ? | Un petit modèle spécialisé peut approcher un grand sur une tâche étroite, pour moins cher (section 6) |
Open-weight ou propriétaire ?
| Modèle propriétaire managé (ex. famille GPT dans Foundry) | Modèle open-weight (ex. Llama, Qwen, gpt-oss, Mistral) | |
|---|---|---|
| Accès aux poids | Non | Oui : on peut l'héberger soi-même (AKS, VM, managed compute) |
| Personnalisation | Celle que le fournisseur expose (SFT, DPO, RFT selon le modèle) | Toutes les méthodes, si l'on accepte de les exploiter (LoRA, continued pre-training…) |
| Exploitation | Managée par Azure | Managée (serverless, managed compute) ou à votre charge |
| Points d'attention | Dépendance au cycle de vie du modèle (retraits) | Licence, sécurité de la chaîne d'approvisionnement, coût GPU si auto-hébergé |
2.2 Les benchmarks publics : utiles pour trier, pas pour décider#
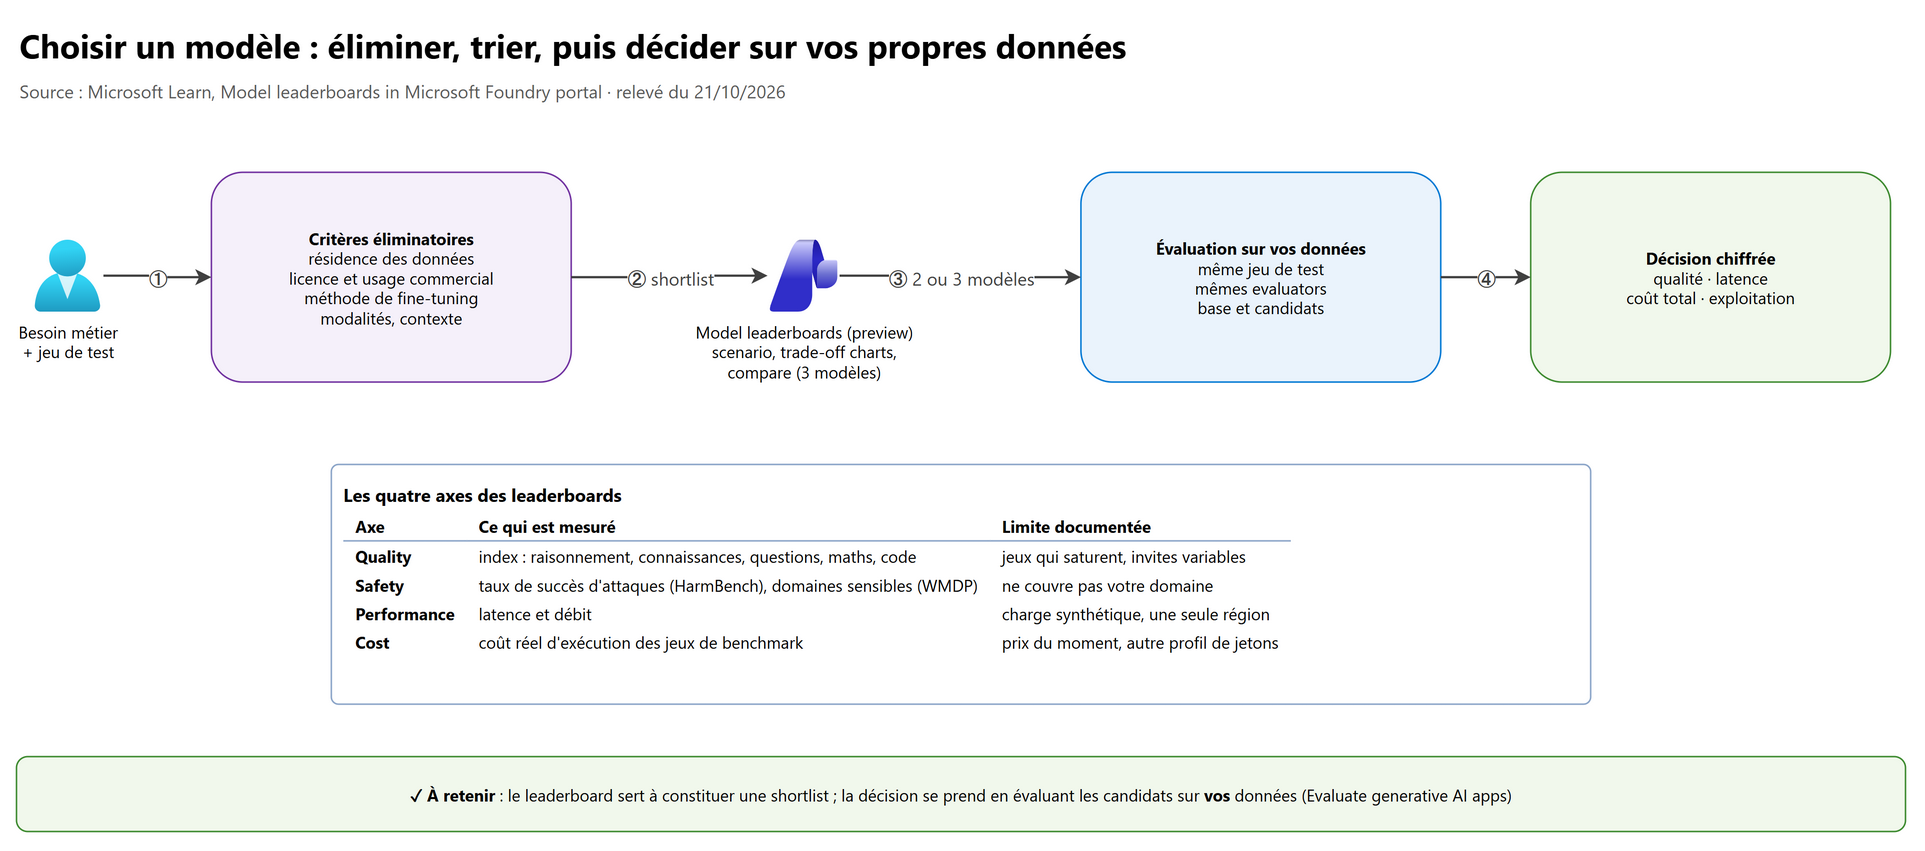
Les model leaderboards de Foundry (preview) comparent les modèles du catalogue sur quatre axes (Model leaderboards) :
| Axe | Ce qui est mesuré | Comment lire |
|---|---|---|
| Quality | Index normalisé sur raisonnement, connaissances, questions-réponses, mathématiques, code | Plus haut = mieux |
| Safety | Taux de succès d'attaques (HarmBench) et connaissances de domaines sensibles (WMDP) | Taux d'attaque plus bas = plus robuste |
| Performance | Latence et débit, sur des charges synthétiques | À confronter à votre profil de trafic |
| Cost | Coût réel d'exécution des jeux de benchmark (jetons d'entrée, de raisonnement et de sortie consommés) | Plus bas = plus efficient |
On y trouve aussi des scenario leaderboards (raisonnement, code, questions-réponses…), des trade-off charts (qualité contre coût, débit ou sécurité) et une comparaison côte à côte de trois modèles (benchmarks, model details, supported endpoints, feature support) (Compare models). Il faut au moins le rôle Reader sur le Foundry project.
Les limites que Microsoft documente elle-même (benchmark limitations) :
- les jeux de benchmark saturent quand les modèles sont entraînés sur des données proches ;
- les résultats varient selon la construction des invites et le nombre d'exemples few-shot ;
- les mesures de performance utilisent des charges synthétiques à ratio d'entrée / sortie fixe, dans une seule région ;
- l'estimation de coût suppose un ratio de trois jetons d'entrée pour un jeton de sortie, et les prix du moment.
Conclusion : le leaderboard sert à constituer une shortlist de deux ou trois modèles. La décision se prend en les évaluant sur vos données, avec les mêmes evaluators et le même jeu de test (voir AI-103 · 04 et le chapitre 06). Dans le nouveau portail, l'option « Try with your own data » de l'onglet Benchmarks n'existe pas : on passe par Evaluate generative AI apps.
2.3 La décision, en quatre étapes#
flowchart LR
    A["1. Exigences éliminatoires<br/>résidence, licence, méthode,<br/>modalités, contexte"] --> B["2. Shortlist<br/>leaderboards, scenario,<br/>trade-off charts"]
    B --> C["3. Évaluation sur vos données<br/>même jeu de test,<br/>mêmes evaluators"]
    C --> D["4. Décision chiffrée<br/>qualité, latence, coût total,<br/>exploitation"]
3. Où entraîner et fine-tuner sur Azure#
3.1 Les quatre options#
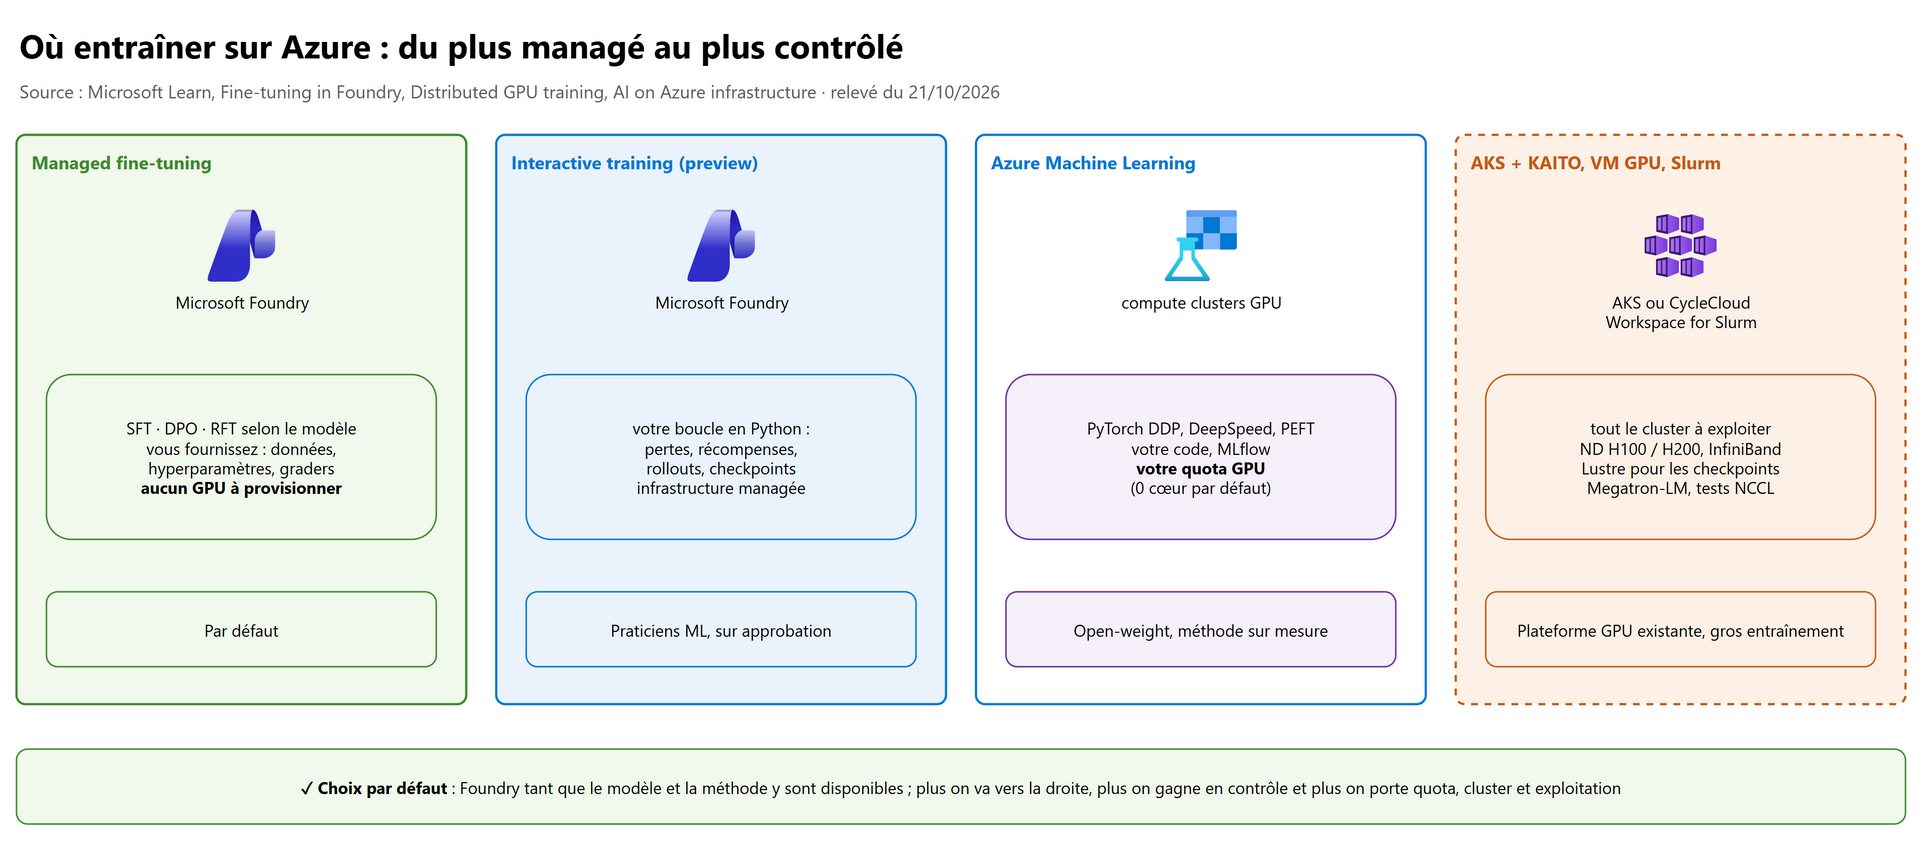
| Option | Ce que vous gérez | GPU et quota | Méthodes | Quand la choisir |
|---|---|---|---|---|
| Managed fine-tuning dans Foundry | Les données, les hyperparamètres exposés, les graders RFT | Infrastructure d'entraînement managée : « you don't provision training GPUs » | SFT, DPO, RFT selon le modèle ; distillation par données SFT générées par un modèle enseignant | Par défaut : le modèle visé y est fine-tunable par la méthode voulue |
| Interactive training dans Foundry (preview, sur approbation) | La boucle d'entraînement en Python : pertes, récompenses, rollouts, checkpoints | Managée par Foundry | Recettes SFT, reinforcement learning, préférences, distillation, pertes personnalisées | Praticiens ML qui veulent une boucle personnalisée sans exploiter de GPU |
| Azure Machine Learning (compute clusters GPU) | Le code d'entraînement, l'environnement, le cluster, les jobs | Votre quota par famille de VM ; les familles GPU démarrent à 0 cœur | Tout : PyTorch DDP, DeepSpeed, PEFT, continued pre-training | Modèle open-weight, méthode non proposée en managé, contrôle total, traçabilité MLflow |
| AKS avec KAITO, ou VM GPU / CycleCloud Workspace for Slurm | Tout le cluster et son exploitation | Votre quota de VM | Tout | Plateforme GPU partagée déjà en place (AKS), ou grand entraînement avec Slurm et Megatron-LM |
Sources : Fine-tuning in Microsoft Foundry, Azure ML quotas, Distributed GPU training, AI on Azure infrastructure, AKS · 06.
Repère pratique : la page Foundry (classic) résume le compromis. Le fine-tuning serverless ne demande aucun quota GPU et donne accès aux modèles OpenAI, avec moins d'hyperparamètres ; le managed compute offre plus de modèles et de réglages, mais demande des quotas élevés que beaucoup de clients n'ont pas (Serverless or managed compute?).
3.2 Les training types de Foundry#
| Training type | Où l'entraînement tourne | Résidence | Prix | Usage |
|---|---|---|---|---|
| Standard | Région de la Foundry resource | Garantie dans la région | Référence | Données qui doivent rester dans la région |
| Data zone | Une data zone (seule la zone US est prise en charge) | Dans la zone | — | Données qui doivent rester dans la zone |
| Global | Capacité hors de la région | Aucune : données et poids copiés | Moins cher | Pas de contrainte de résidence, files d'attente plus courtes |
| Developer | Capacité inutilisée, préemptible | Aucune | Le moins cher | Expérimentation ; jobs suspendus puis repris, sans SLA |
Le training type (où l'on entraîne) est séparé du deployment type (comment on sert le modèle). Pour servir un modèle fine-tuné, Foundry propose Serverless, Managed compute (preview : GPU dédiés qui portent un modèle de base et un ou plusieurs adaptateurs LoRA compatibles) et Fireworks on Foundry (preview), avec des deployment types dont Developer : facturation au jeton, pas de frais d'hébergement horaires, pas de garantie de résidence, 24 heures maximum, réservé à l'évaluation (deployment options).
3.3 Quels modèles sont fine-tunables ?#
La liste évolue vite : elle se lit dans le tableau Supported models de la page de fine-tuning. Au 21/10/2026, elle contient par exemple :
| Modèle | Méthodes managées | Remarque |
|---|---|---|
gpt-4.1, gpt-4.1-mini, gpt-4.1-nano |
SFT, DPO | Tous les training types |
gpt-4o, gpt-4o-mini |
SFT, DPO / SFT | Pas de déploiement Developer |
o4-mini |
RFT | Reasoning model |
gpt-5 |
RFT | Sur invitation |
Llama-3.3-70B-Instruct, Qwen3-32B, Ministral-3B, gpt-oss-20b |
SFT | Déploiement Global Standard uniquement |
gpt-oss-120b, Qwen3.6-35B-A3B, Qwen3.8-27B (preview) |
SFT, RFT | Aussi en interactive training ; managed compute ou Fireworks |
Un adaptateur n'est pas interchangeable entre deux modèles de base au nom proche : vérifier méthode, training type, version et déploiement avant d'entraîner (challenges and limitations).
4. Le pipeline d'un fine-tuning, de bout en bout#
4.1 Les données d'abord#
| Règle | Source |
|---|---|
| Format JSONL au format conversationnel de Chat Completions, UTF-8 avec BOM, fichier de moins de 512 Mo | Prepare your data |
| Au moins 10 exemples pour qu'un job démarre, mais c'est insuffisant ; commencer avec 50 exemples soignés, viser des centaines ou des milliers | Même page |
| Doubler le jeu de données peut améliorer la qualité de façon linéaire, mais des exemples de mauvaise qualité dégradent le modèle : trier avant d'entraîner | Même page |
| Garder dans chaque exemple les instructions qui marchaient le mieux en prompt engineering, et utiliser le même system message à l'inférence qu'à l'entraînement | Même page |
| RFT : commencer par quelques dizaines à quelques centaines d'exemples ; au plus 50 000 exemples d'entraînement et 1 000 de test | RFT |
| Séparer train, validation et test final ; comparer les checkpoints sur des tâches tenues à l'écart, pas sur la perte d'entraînement | Challenges |
| Données synthétiques (preview) : 50 à 1 000 exemples générés par un modèle, découpage 80/20 automatique possible | Synthetic data |
4.2 Les contrôles de sécurité intégrés#
Pour les modèles concernés (preview), Foundry ajoute deux contrôles (Safety evaluation for fine-tuning) :
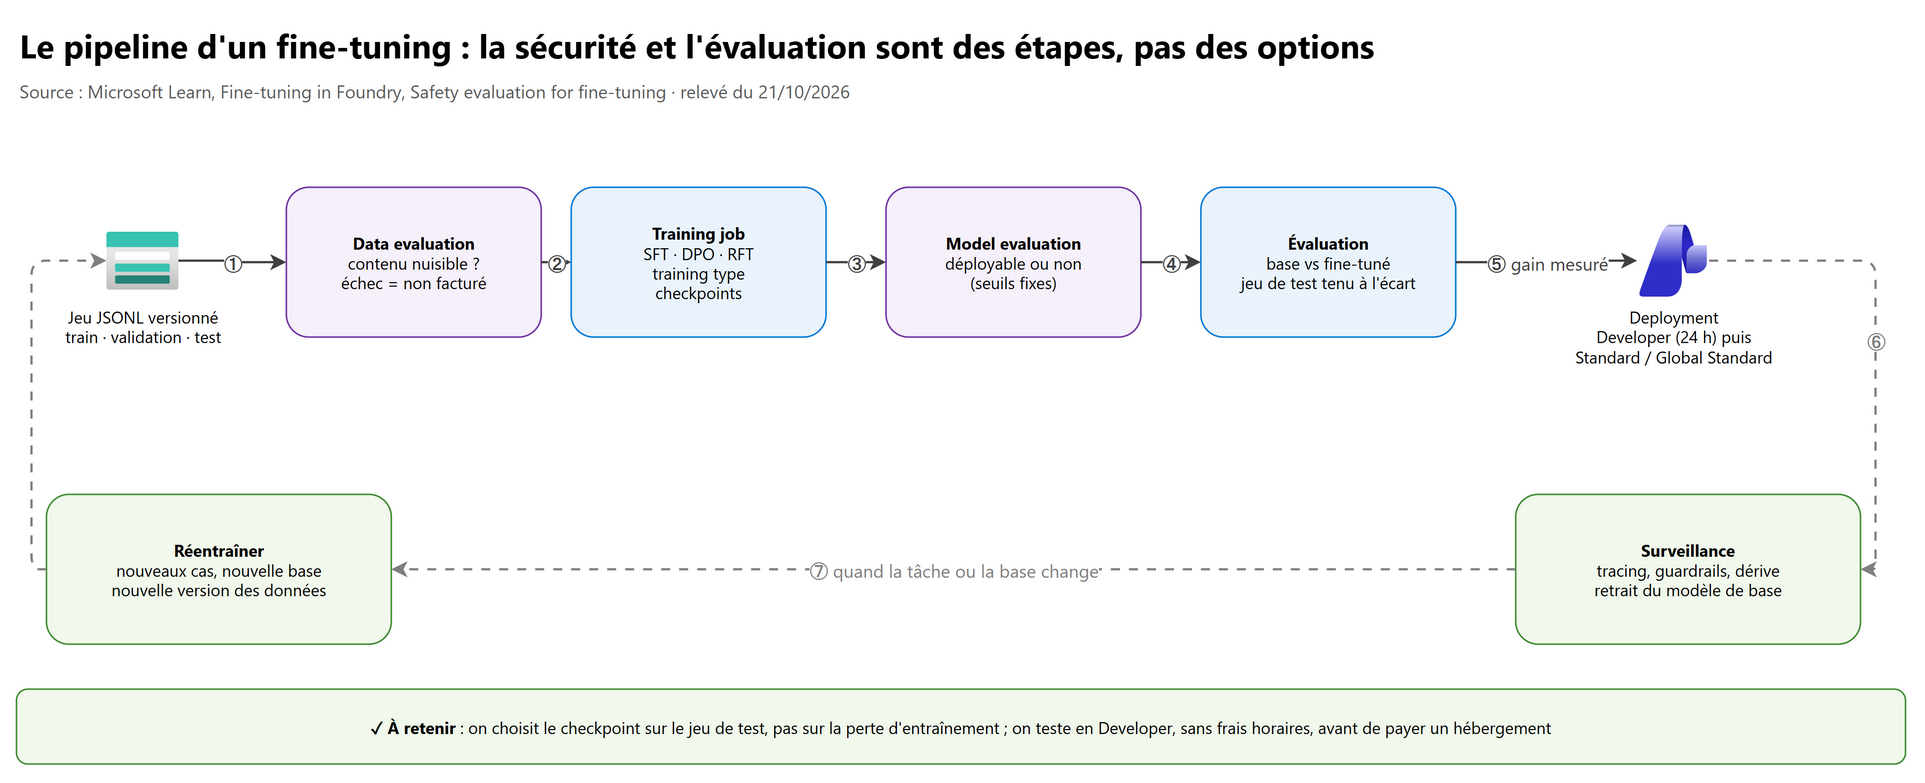
- Data evaluation, avant l'entraînement : si le jeu contient du contenu nuisible au-delà du seuil, le job échoue, sans frais.
- Model evaluation, après l'entraînement : une conversation simulée mesure la propension du modèle à produire du contenu nuisible ; au-delà d'un seuil, le modèle n'est pas déployable, et l'entraînement n'est pas facturé.
Les seuils sont prédéfinis et non modifiables ; seul le verdict (déployable ou non) est conservé. Ces contrôles ne remplacent ni les guardrails de l'application, ni une évaluation du runtime final de service.
4.3 Lire les métriques et choisir un checkpoint#
| Métrique SFT | Ce qu'on cherche |
|---|---|
train_loss |
Une tendance à la baisse |
full_valid_loss |
Si la perte d'entraînement baisse et que celle de validation monte : sur-apprentissage, examiner les exemples de validation ratés |
train_mean_token_accuracy, full_valid_mean_token_accuracy |
Une tendance à la hausse, confirmée sur la tâche réelle |
Pour le RFT, on suit la récompense moyenne de validation, les récompenses par grader et les taux d'erreur des graders : une récompense qui monte ne prouve rien si le modèle exploite les failles du grader. Le dernier checkpoint n'est pas forcément le meilleur : on compare les candidats sur le jeu de test tenu à l'écart (Review training metrics).
4.4 Déployer, surveiller, maintenir#
sequenceDiagram
    participant D as Équipe data
    participant F as Foundry (managed fine-tuning)
    participant E as Évaluation
    participant P as Production
    D->>F: Jeu train / validation (JSONL), modèle de base, méthode, training type
    F->>F: Data evaluation (sécurité), puis entraînement et checkpoints
    F->>F: Model evaluation (sécurité) : déployable ou non
    F->>E: Déploiement Developer (24 h, sans frais d'hébergement)
    E->>E: Comparaison base contre fine-tuné sur le jeu de test tenu à l'écart
    E-->>D: Gain mesuré ? Sinon, revoir les données
    E->>P: Déploiement Standard ou Global Standard, guardrails, tracing
    P-->>D: Dérive, nouveaux cas, retrait du modèle de base : réentraîner
5. Dimensionner un entraînement#
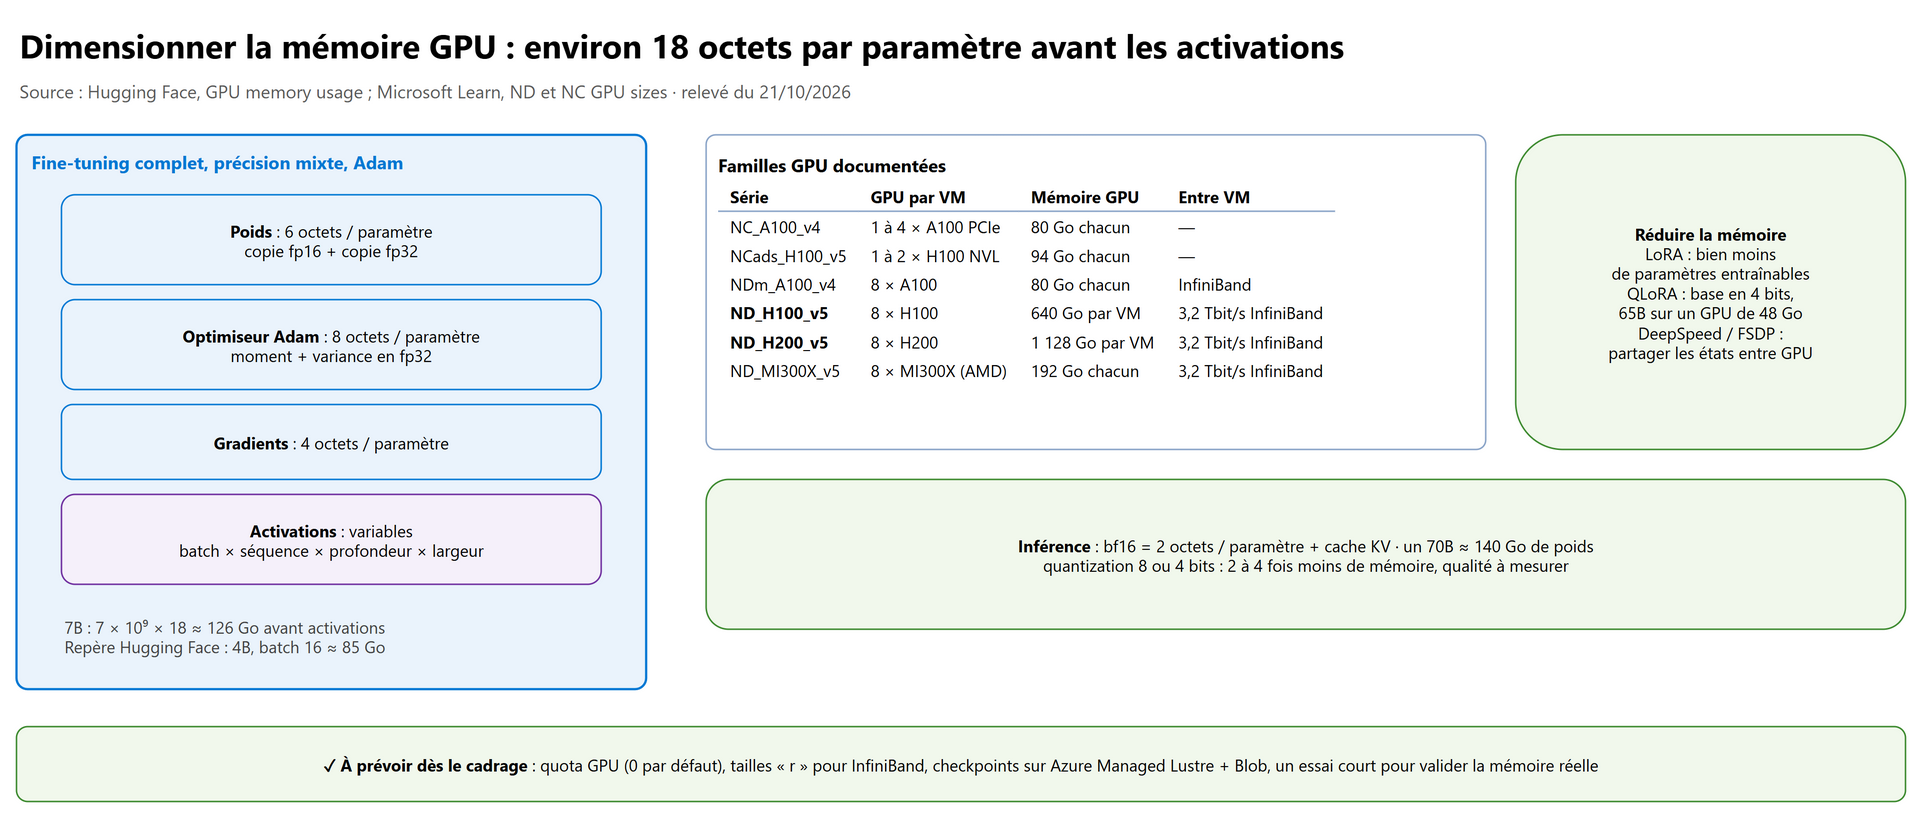
5.1 La mémoire GPU, ordre de grandeur#
La documentation Hugging Face détaille ce qui occupe la mémoire pendant un entraînement en précision mixte avec Adam (GPU memory usage) :
| Poste | Octets par paramètre |
|---|---|
| Poids (copie fp16 pour les passes + copie fp32 de référence) | 6 |
| États de l'optimiseur Adam (moment et variance en fp32) | 8 (2 avec un Adam quantifié de bitsandbytes) |
| Gradients (fp32) | 4 |
| Total hors activations | 18 |
| Activations, tenseurs temporaires | Variable : taille de batch × longueur de séquence × profondeur × largeur |
La même page donne un repère : entraîner un modèle de 4B paramètres en précision mixte avec un batch de 16 demande environ 85 Go de mémoire GPU.
Ce que l'on en déduit, par simple arithmétique :
| Cas | Calcul | Conséquence |
|---|---|---|
| Fine-tuning complet d'un modèle de 7B | 7 × 10⁹ × 18 octets ≈ 126 Go avant activations | Plus que la mémoire d'un GPU de 80 Go : plusieurs GPU et un partage des états (DeepSpeed, FSDP) |
| Inférence d'un modèle de 70B en bf16 | 70 × 10⁹ × 2 octets ≈ 140 Go de poids, plus le cache KV | Au moins deux GPU de 80 Go, ou de la quantization (voir AKS · 06) |
| QLoRA sur un modèle de 65B | Base quantifiée en 4 bits + adaptateurs | Un seul GPU de 48 Go selon l'article QLoRA |
Ces chiffres servent à choisir une famille de VM et un ordre de grandeur de quota, pas à garantir qu'un job tient en mémoire : les activations dépendent du batch et de la longueur de séquence. Le seul vrai test reste un essai court.
5.2 Les familles GPU documentées#
| Série | GPU par VM | Mémoire GPU | Réseau entre VM | Usage |
|---|---|---|---|---|
| NC_A100_v4 | 1 à 4 × A100 PCIe | 80 Go chacun | — | Fine-tuning moyen, inférence |
| NCads_H100_v5 | 1 à 2 × H100 NVL | 94 Go chacun | — | Entraînement de taille moyenne, inférence |
| NDm_A100_v4 | 8 × A100 | 80 Go chacun | InfiniBand | Entraînement distribué |
ND_H100_v5 (Standard_ND96isr_H100_v5) |
8 × H100 | 640 Go par VM | 3,2 Tbit/s par VM (400 Gbit/s InfiniBand par GPU), NVLink 4.0 | Grands entraînements, IA générative |
ND_H200_v5 (Standard_ND96isr_H200_v5) |
8 × H200 | 141 Go chacun, 1 128 Go par VM, 4,8 To/s de bande passante mémoire | 3,2 Tbit/s par VM, NVLink 900 Go/s | Modèles plus grands, plus de mémoire par GPU |
| ND_MI300X_v5 | 8 × AMD MI300X | 192 Go chacun | 3,2 Tbit/s par VM | Pile AMD ROCm |
| ND GB200-v6 | 4 × Blackwell (+ 2 Grace CPU) | 192 Gio chacun | 4 liens InfiniBand Quantum-2 à 400 par VM, NVLink 5e génération | Entraînement et inférence à l'échelle « frontier » |
Sources : ND-H100-v5, ND-H200-v5, ND family, NC family, ND GB200-v6.
5.3 Ce qu'un architecte doit prévoir#
| Sujet | À retenir | Source |
|---|---|---|
| Quota | Les familles GPU démarrent à 0 cœur ; demande d'augmentation par famille et par région dans Usage + quotas ; le quota managed compute de Foundry est séparé du quota de VM | AML quotas, Managed compute |
| InfiniBand | Seules les tailles avec un r (RDMA) ont le matériel InfiniBand ; sur un AmlCompute de ces tailles, le pilote OFED est préinstallé |
Distributed GPU training |
| Parallélisme | Dans plus de 90 % des cas, du distributed data parallelism ; DeepSpeed pour les modèles plus grands | Même page |
| Low priority | Retiré pour Azure ML le 31/03/2026 : les clusters low_priority sont alloués en Spot, prix variable, éviction possible : checkpoints obligatoires |
AML costs |
| Checkpoints | Azure Managed Lustre comme couche rapide, Blob Storage comme archive : exemple Microsoft d'un checkpoint de ~912 Gio (Llama 3 70B) écrit en ~15 s sur un AMLFS à 64 Go/s | Tiered checkpoints |
| Santé du cluster | Avant un grand job : node health checks et tests NCCL de bande passante | Well-architected AI infrastructure |
6. Distiller et réduire : le bon modèle au bon prix#
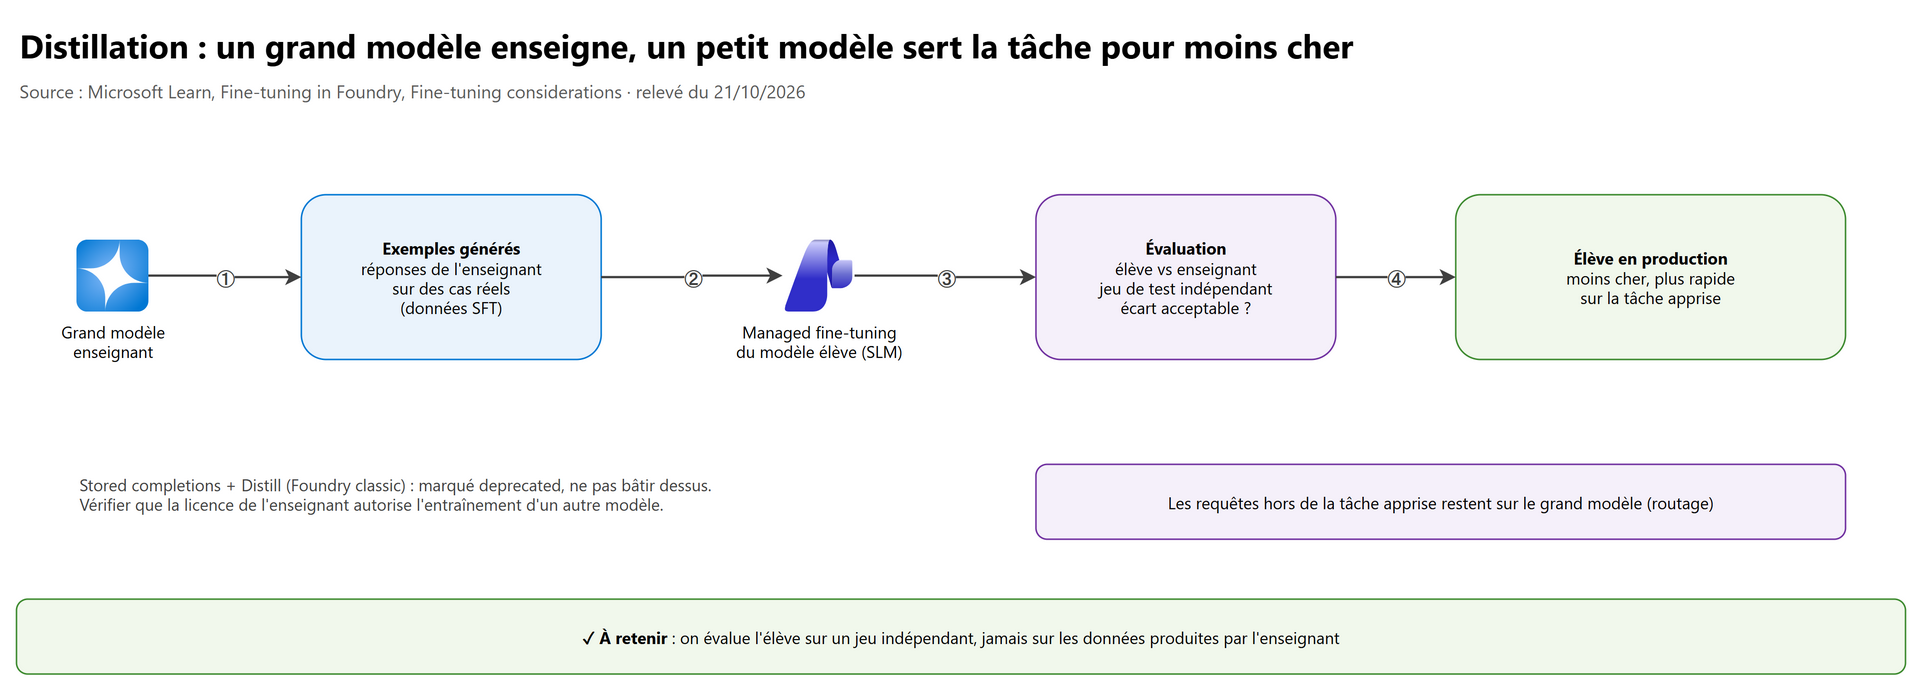
La distillation utilise les réponses d'un grand modèle (l'enseignant) pour fine-tuner un modèle plus petit (l'élève), qui atteint des performances proches sur la tâche visée, avec un coût et une latence plus faibles (fine-tuning considerations).
| Comment | Où | Statut |
|---|---|---|
| Données SFT générées par un enseignant, puis managed fine-tuning de l'élève | Foundry (nouveau) | Méthode décrite par la page de fine-tuning |
| Recettes de distillation dans l'interactive training | Foundry | Preview, sur approbation |
| Stored completions puis bouton Distill | Foundry (classic) | Retiré le 15/10/2026 ; remplacé par Responses API + Agent Traces comme source de datasets (07 § 6.8) |
Bonnes pratiques :
- l'élève n'est bon que sur la tâche apprise : garder le grand modèle (ou un routage) pour le reste ;
- évaluer l'élève et l'enseignant sur le même jeu de test tenu à l'écart, jamais sur les données générées par l'enseignant ;
- vérifier que la licence de l'enseignant autorise l'usage de ses sorties pour entraîner un autre modèle.
Pour l'inférence, la quantization (poids en 8 ou 4 bits) réduit la mémoire de 2 à 4 fois par rapport au bf16, au prix d'une perte de qualité à mesurer ; elle se met en œuvre côté moteur d'inférence (vLLM sur AKS, voir AKS · 06).
7. Le coût total, pas seulement l'entraînement#
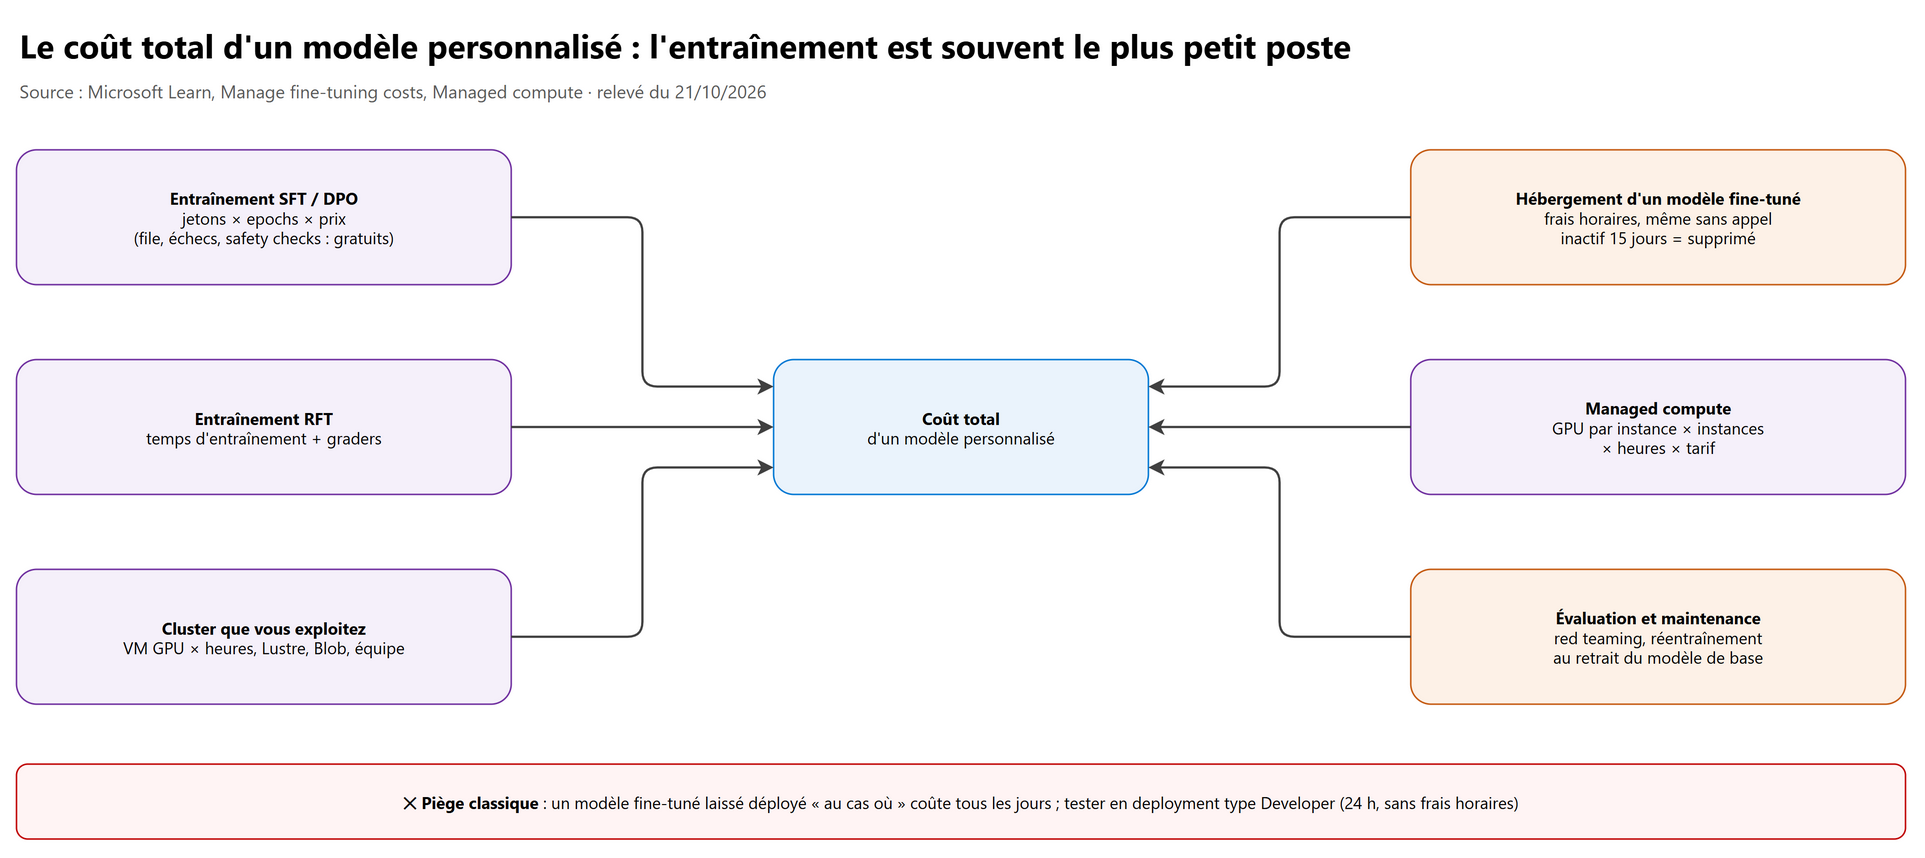
| Poste | Comment il se calcule | Piège |
|---|---|---|
| Entraînement SFT / DPO | nombre de jetons d'entraînement × nombre d'epochs × prix par jeton d'entraînement | Le prix d'entraînement diffère du prix d'inférence ; Global et Developer sont moins chers |
| Entraînement RFT | Au temps d'entraînement, plus le coût des graders | Un grader à base de modèle coûte aussi |
| Ce qui n'est pas facturé | Temps d'attente en file, jobs en échec, jobs annulés avant le début, data safety checks | — |
| Hébergement d'un modèle fine-tuné | Frais horaires dès le déploiement, même sans aucun appel | Un déploiement oublié coûte tous les jours ; Developer (24 h) n'a pas de frais horaires |
| Inactivité | Un déploiement de modèle Azure OpenAI fine-tuné inactif plus de 15 jours est supprimé (le modèle, lui, reste et se redéploie) ; règle non reprise par la nouvelle page Foundry pour Managed Compute et Fireworks | À prévoir dans l'exploitation |
| Managed compute | GPU par instance × instances × heures × tarif horaire | Foundry dimensionne à 1, 2, 4 ou 8 GPU par instance |
| Cluster que vous exploitez | VM GPU × heures, stockage (Lustre, Blob), réseau, équipe | Le GPU qui attend des données coûte autant que le GPU qui calcule |
| Réévaluation et maintenance | Évaluations, red teaming, réentraînement quand la tâche change ou quand le modèle de base approche de son retrait | Le poste le plus souvent oublié |
Sources : Manage fine-tuning costs, Deploy a fine-tuned model, Managed compute billing.
Exemple de calcul (méthode de la page de coûts, sans prix figé) : 500 paires invite-réponse soit 1 million de jetons, 2 epochs, training type Global : coût d'entraînement = 1 M × 2 × T, où T est le prix Global par million de jetons du modèle. La durée du job (2 h 15 dans l'exemple Microsoft) ne change pas le prix d'un SFT.
8. Gouverner les données d'entraînement#
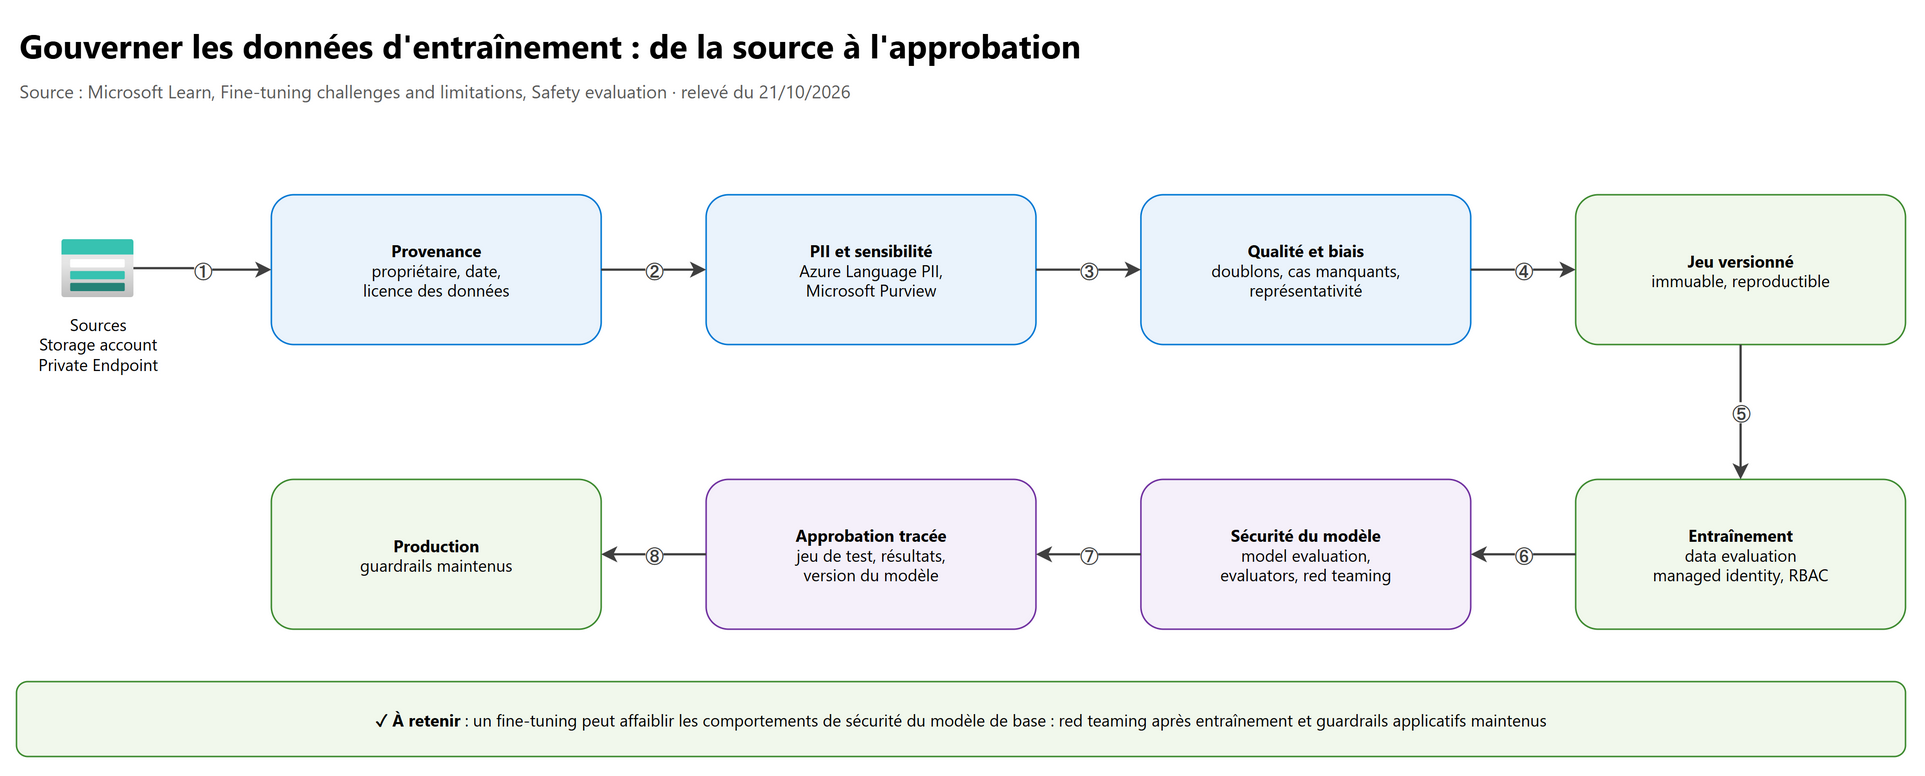
| Question | Ce qu'on met en place |
|---|---|
| D'où viennent les données ? | Inventaire des sources, propriétaire, date ; versionner le jeu (par exemple un data asset Azure ML ou un dossier Blob immuable) pour pouvoir reproduire un modèle |
| Contiennent-elles des données personnelles ou sensibles ? | Détection et masquage des PII avant l'entraînement (Azure Language PII, voir AI-103 · 09) ; classification et étiquettes Microsoft Purview pour les sources, DSPM for AI pour l'usage de l'IA (voir SC-500 · 07) |
| A-t-on le droit de s'en servir ? | Licence des données, contrats clients, droit d'auteur ; licence du modèle de base et de l'enseignant en cas de distillation |
| Sont-elles représentatives et sans biais ? | Revue des scénarios manquants, des doublons, des biais (première ligne du tableau « challenges » de Microsoft) |
| Le modèle obtenu est-il sûr ? | Data et model evaluation de Foundry, evaluators de sécurité, red teaming après fine-tuning (un fine-tuning peut affaiblir des comportements de sécurité du modèle de base), guardrails de l'application maintenus |
| Qui valide la mise en production ? | Une approbation explicite, tracée, avec le jeu de test, les résultats et la version du modèle (voir AI-103 · 04) |
Les données d'entraînement passent par un Storage account en Private Endpoint, avec accès par managed identity et RBAC : les règles de SC-500 · 04 s'appliquent telles quelles.
9. Pièges de production#
| Piège | Pourquoi c'est un problème | Parade |
|---|---|---|
| Fine-tuner pour « apprendre » des faits ou des documents | Les faits changent et le modèle invente quand il ne sait pas | RAG pour les faits, fine-tuning pour le comportement |
| Juger le modèle sur la perte d'entraînement | Sur-apprentissage invisible | Jeu de test tenu à l'écart, comparaison base contre fine-tuné |
| Choisir le modèle sur le leaderboard seul | Benchmarks saturés, invites différentes, charge synthétique | Shortlist, puis évaluation sur vos données |
| Entraîner en Global ou Developer des données soumises à résidence | Données et poids copiés hors de la région | Standard ou Data zone, validé avec la conformité |
| Laisser un modèle fine-tuné déployé « au cas où » | Frais horaires même sans appel | Developer pour tester, suppression des déploiements inutiles |
| Croire qu'un adaptateur LoRA suit le modèle de base | Un adaptateur ne s'applique qu'à sa base | Réentraîner quand la base change ou est retirée |
| Lancer un grand job sans checkpoints sur Spot | Éviction, tout est perdu | Checkpoints fréquents (Lustre + Blob), reprise automatique |
| Demander le quota GPU la semaine du lancement | Les familles GPU démarrent à 0, la capacité est rare | Demande de quota dès le cadrage, régions alternatives |
| Faire confiance à une récompense RFT qui monte | Le modèle exploite le grader | Tester le grader sur des réponses correctes, fausses et adverses |
| Oublier la sécurité après le fine-tuning | Comportements de sécurité affaiblis | Model evaluation, red teaming, guardrails applicatifs |
10. Lab : un premier SFT, à moindre coût#
Objectif : mesurer le gain d'un fine-tuning sur une tâche de format, sans payer d'hébergement horaire.
- Dans un abonnement de test, créer un Foundry project dans une région qui accepte le training type Developer pour
gpt-4.1-nano(voir le tableau Supported models). - Préparer 60 exemples JSONL d'une tâche de format (par exemple : transformer un incident en ticket JSON strict), avec le même system message partout ; en garder 10 de côté comme jeu de test (non envoyé à l'entraînement).
- Lancer un SFT de
gpt-4.1-nano, training type Developer, 2 epochs ; noter le nombre de jetons d'entraînement pour calculer le coût (jetons × epochs × prix). - Suivre
train_lossetfull_valid_lossdans Monitor, comparer les Checkpoints. - Déployer le modèle en deployment type Developer (24 h, sans frais horaires) ; évaluer le modèle de base et le modèle fine-tuné sur les 10 exemples de test, avec le même evaluator (par exemple la validité du JSON et l'exactitude des champs).
- Nettoyage : supprimer le déploiement s'il existe encore, puis les fichiers d'entraînement ; supprimer le groupe de ressources si le project ne sert plus.
Résultat attendu : un tableau base / fine-tuné sur les mêmes 10 cas, le coût réel de l'entraînement, et une décision argumentée (le gain justifie-t-il le fine-tuning, ou un meilleur prompt suffisait-il ?).
11. Questions d'entretien et de cadrage#
1. Le client veut « entraîner son propre LLM ». Que lui répondez-vous ?
On commence par le besoin mesurable et un jeu de test. On essaie dans l'ordre : prompt engineering, RAG, fine-tuning. Entraîner un modèle depuis zéro ou faire du continued pre-training ne se justifie que si un domaine ou une langue est très éloigné des modèles existants, avec un corpus et un budget à la hauteur. Dans la plupart des cas, un fine-tuning managé ou un RAG répond au besoin pour une fraction du coût.
2. Fine-tuning ou RAG ?
RAG pour les connaissances (documents, données qui changent, citations) ; fine-tuning pour le comportement (format, ton, usage d'outils, raisonnement sur une tâche). Souvent les deux : un modèle fine-tuné pour mieux exploiter le contexte récupéré.
3. SFT, DPO ou RFT ?
SFT si l'on sait écrire la bonne réponse ; DPO si l'on sait dire laquelle de deux réponses est meilleure ; RFT si plusieurs réponses sont possibles et qu'un grader fiable sait les noter. On commence presque toujours par SFT.
4. Comment choisissez-vous un modèle ?
D'abord les critères éliminatoires : résidence, licence, méthode de personnalisation, modalités, contexte. Puis une shortlist avec les leaderboards de Foundry. Puis une évaluation sur nos données, mêmes evaluators, même jeu de test. La décision chiffre qualité, latence, coût total et exploitation.
5. Pourquoi ne pas se fier aux benchmarks publics ?
Microsoft le dit elle-même : les jeux saturent, les résultats dépendent de la construction des invites, la performance est mesurée sur des charges synthétiques et le coût suppose un ratio d'entrée / sortie fixe. Ils servent à trier, pas à décider.
6. Foundry managed fine-tuning ou Azure Machine Learning ?
Foundry tant que le modèle et la méthode y sont disponibles : pas de GPU à provisionner, pas de quota GPU pour le serverless, des contrôles de sécurité intégrés. Azure ML quand il faut un modèle ou une méthode non proposés, un contrôle fin de l'entraînement ou une traçabilité MLflow complète, en acceptant de gérer quota, cluster et code.
7. Comment estimez-vous la mémoire GPU d'un fine-tuning complet ?
Environ 18 octets par paramètre en précision mixte avec Adam (poids, états de l'optimiseur, gradients), plus les activations qui dépendent du batch et de la longueur de séquence. Un 7B demande donc plus de 120 Go avant activations : plusieurs GPU et DeepSpeed, ou bien LoRA / QLoRA pour rester sur un GPU.
8. Pourquoi LoRA ?
On n'entraîne que de petits adaptateurs : l'article d'origine annonce 10 000 fois moins de paramètres entraînables et 3 fois moins de mémoire sur GPT-3, sans latence ajoutée. On stocke et on sert plusieurs adaptateurs sur la même base, ce que permet le managed compute de Foundry.
9. Quelles VM pour un grand entraînement distribué ?
La famille ND (ND_H100_v5, ND_H200_v5) : 8 GPU par VM, NVLink dans la VM et InfiniBand à 3,2 Tbit/s entre VM. Seules les tailles RDMA (un « r » dans le nom) ont InfiniBand. Prévoir le quota tôt, un stockage rapide pour les checkpoints et des tests NCCL.
10. Qu'est-ce qui fait exploser le coût d'un modèle fine-tuné ?
L'hébergement horaire, dû même sans appel, les réentraînements quand le modèle de base est retiré, et les évaluations répétées. L'entraînement lui-même est souvent le plus petit poste.
11. Comment éviter qu'un fine-tuning dégrade la sécurité ?
Données nettoyées et revues, data et model evaluation de Foundry, evaluators de sécurité et red teaming après fine-tuning, guardrails de l'application maintenus, approbation tracée avant la production.
12. Quand distiller ?
Quand un grand modèle fait bien une tâche étroite et répétitive : on génère des exemples avec lui, on fine-tune un petit modèle, on vérifie sur un jeu de test indépendant que l'écart de qualité est acceptable, puis on sert le petit modèle pour moins cher.
12. Fiche à retenir#
- Personnaliser par paliers : prompt → RAG → fine-tuning → continued pre-training → entraînement complet, chaque palier mesuré.
- Fine-tuning = comportement ; RAG = connaissances. Le fine-tuning ne remplace ni la récupération ni les guardrails.
- SFT (exemples), DPO (préférences), RFT (grader) ; LoRA et QLoRA pour réduire la mémoire.
- Choisir un modèle : critères éliminatoires, shortlist par leaderboards, décision par évaluation sur ses données.
- Training types : Standard (région), Data zone (US), Global (moins cher, sans résidence), Developer (préemptible).
- Deployment Developer : 24 h, sans frais horaires, pour évaluer.
- Modèle fine-tuné déployé = frais horaires même sans appel ; déploiement inactif 15 jours = supprimé.
- SFT / DPO facturés en jetons × epochs ; RFT au temps + graders ; pas de frais pour la file, les échecs, les data safety checks.
- Mémoire d'un fine-tuning complet : ~18 octets / paramètre + activations ; inférence bf16 : 2 octets / paramètre + cache KV.
- ND_H100_v5 : 8 × H100 80 Go ; ND_H200_v5 : 8 × H200 141 Go ; 3,2 Tbit/s InfiniBand par VM ; seules les tailles « r » ont RDMA.
- Quota GPU à 0 par défaut : le demander dès le cadrage ; quota managed compute séparé du quota de VM.
- Checkpoints sur Azure Managed Lustre + archive Blob ; Spot impose les checkpoints.
- Gouvernance : provenance, PII, licences, biais, red teaming après fine-tuning, approbation tracée.
Références#
Lues le 21/10/2026.
Microsoft Learn :
- Fine-tuning in Microsoft Foundry
- Manage fine-tuning costs in Microsoft Foundry
- Deploy fine-tuned models in Microsoft Foundry
- Customize a model with fine-tuning
- Reinforcement fine-tuning
- Safety evaluation for fine-tuning (preview)
- Generate synthetic data for fine-tuning (preview)
- Fine-tuning considerations
- Fine-tune models with Microsoft Foundry (classic)
- Azure OpenAI stored completions and distillation (retiré le 15/10/2026)
- Managed compute in Microsoft Foundry (preview)
- Model leaderboards in Microsoft Foundry portal (preview)
- Compare models using the model leaderboard (preview)
- Model migration process
- Distributed GPU training guide (SDK v2)
- Manage and increase quotas for Azure Machine Learning
- Manage and optimize Azure Machine Learning costs
- How to use open source foundation models curated by Azure Machine Learning
- ND-H100-v5 sizes series
- ND-H200-v5 size series
- 'ND' sub-family GPU accelerated VM size series
- 'NC' sub-family GPU accelerated VM size series
- ND GB200-v6 sizes series
- Tiered checkpoints for AI training with Azure Managed Lustre
- Implementation option for AI on Azure infrastructure
- Well-architected considerations for AI on Azure infrastructure
- What is Azure CycleCloud Workspace for Slurm?
Autres sources :