

Version : 1.1 · Date : 2026-10-21 · Domaine 1 de l'examen : Design and implement an MLOps infrastructure (15 à 20 %)
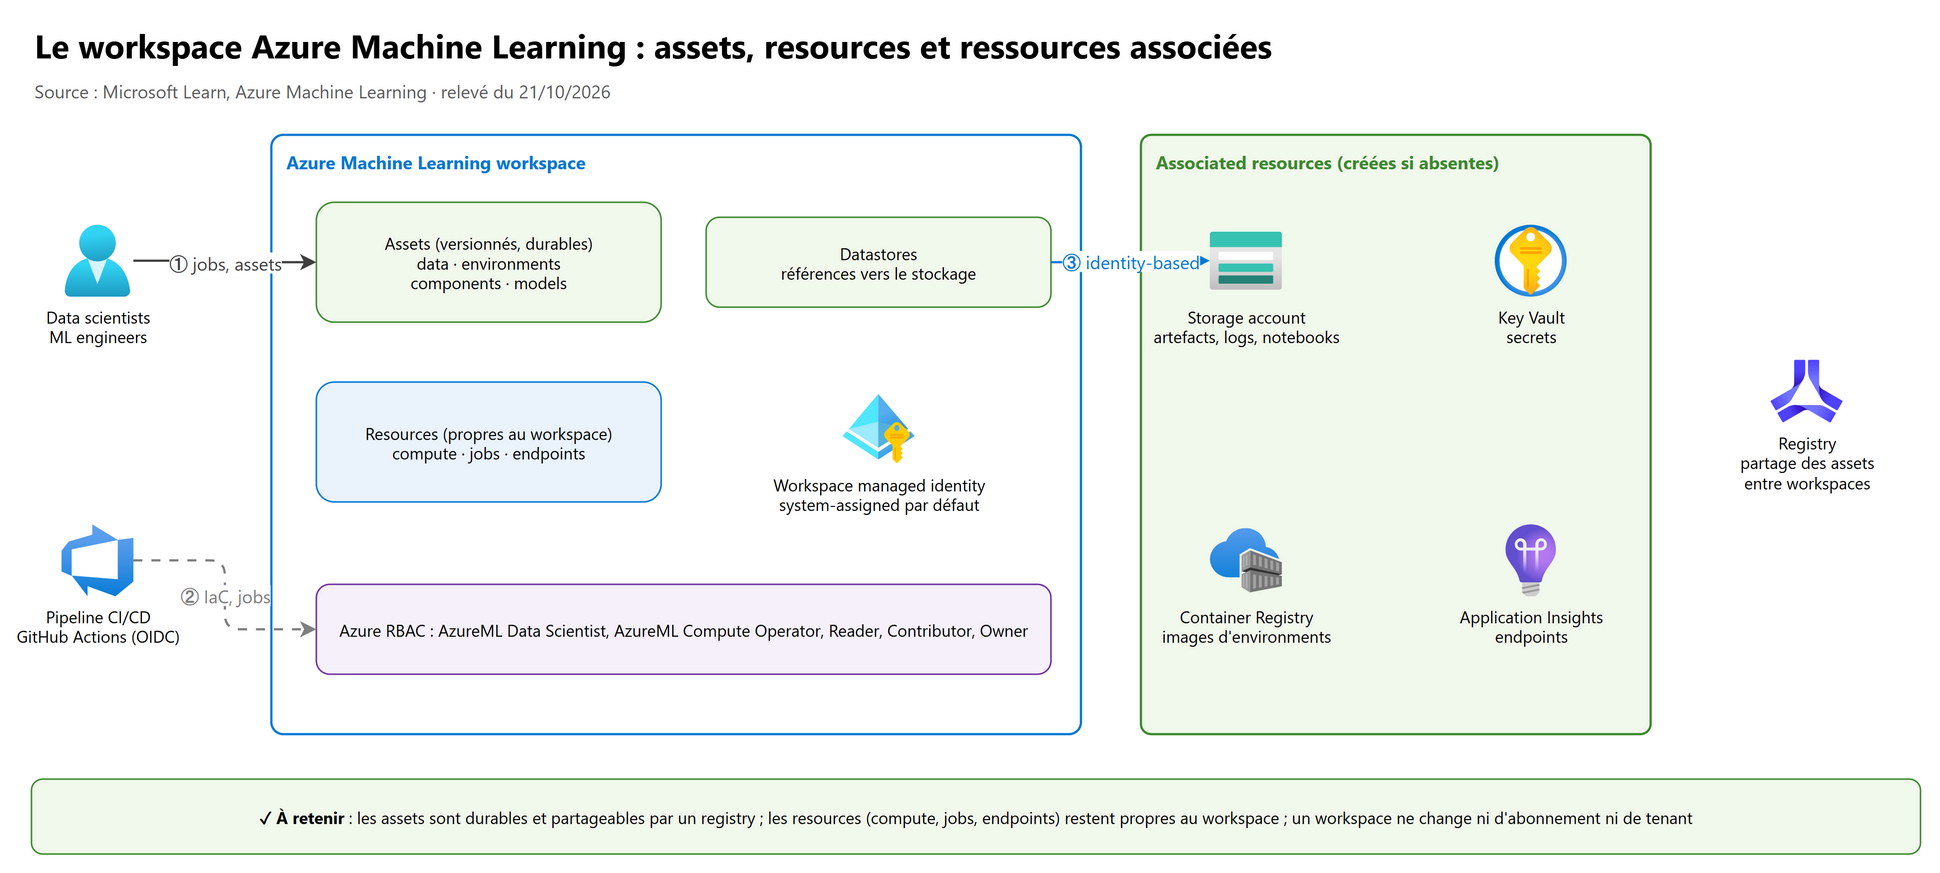
En une phrase : tout projet de machine learning sur Azure tourne autour d'un Azure Machine Learning workspace ; il relie le stockage, le calcul et les identités (les resources), et il versionne ce que l'équipe produit et réutilise (les assets : data, environments, components, models), que des registries partagent ensuite entre workspaces de dev, de test et de prod.
Ce que l'examen demande#
Blocs Create and manage resources in a Machine Learning workspace et Create and manage assets in a Machine Learning workspace, repris mot pour mot du guide d'étude AI-300 :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| 1 | Create and manage a workspace | 2 |
| 2 | Create and manage datastores | 3 |
| 3 | Create and manage compute targets | 4 |
| 4 | Configure identity and access management for workspaces | 5 |
| 5 | Create and manage data assets | 6 |
| 6 | Create and manage environments | 7 |
| 7 | Create and manage components | 8 |
| 8 | Share assets across workspaces by using registries | 9 |
La section 1 pose le vocabulaire utile à tout le cours. Le déploiement du workspace en IaC, le réseau privé et GitHub Actions sont au chapitre 02 ; l'entraînement au chapitre 03.
1. Les bases du ML et du MLOps pour un architecte#
1.1 Le vocabulaire minimal du machine learning#
| Terme | Ce qu'il faut savoir |
|---|---|
| Model (modèle) | Fonction apprise à partir de données : on lui donne des entrées, il renvoie une prédiction |
| Features / label | Les colonnes d'entrée (features) et la valeur à prédire (label) dans un jeu de données d'entraînement |
| Training (entraînement) | Ajuster les paramètres du modèle sur des données ; c'est un job qui tourne sur un compute |
| Inference (inférence, scoring) | Utiliser le modèle entraîné pour prédire ; en temps réel (online endpoint) ou par lots (batch endpoint) |
| Classification / regression / forecasting | Prédire une classe (fraude oui ou non), une valeur (un prix), une série temporelle (des ventes futures) |
| Hyperparameters | Réglages choisis avant l'entraînement (taux d'apprentissage, profondeur d'arbre) ; on les explore par sweep (chapitre 03) |
| Metrics | Mesures de qualité (accuracy, AUC, RMSE…) enregistrées par MLflow pour comparer les jobs |
| Overfitting (surapprentissage) | Le modèle « apprend par cœur » ses données d'entraînement et généralise mal : on le détecte avec des données de validation |
| Experiment | Groupe de jobs comparables (même problème, essais différents) |
| Data drift | Les données de production s'écartent de celles de l'entraînement : la qualité baisse, il faut réentraîner (chapitre 04) |
1.2 Le cycle de vie d'un modèle, et ce que MLOps automatise#
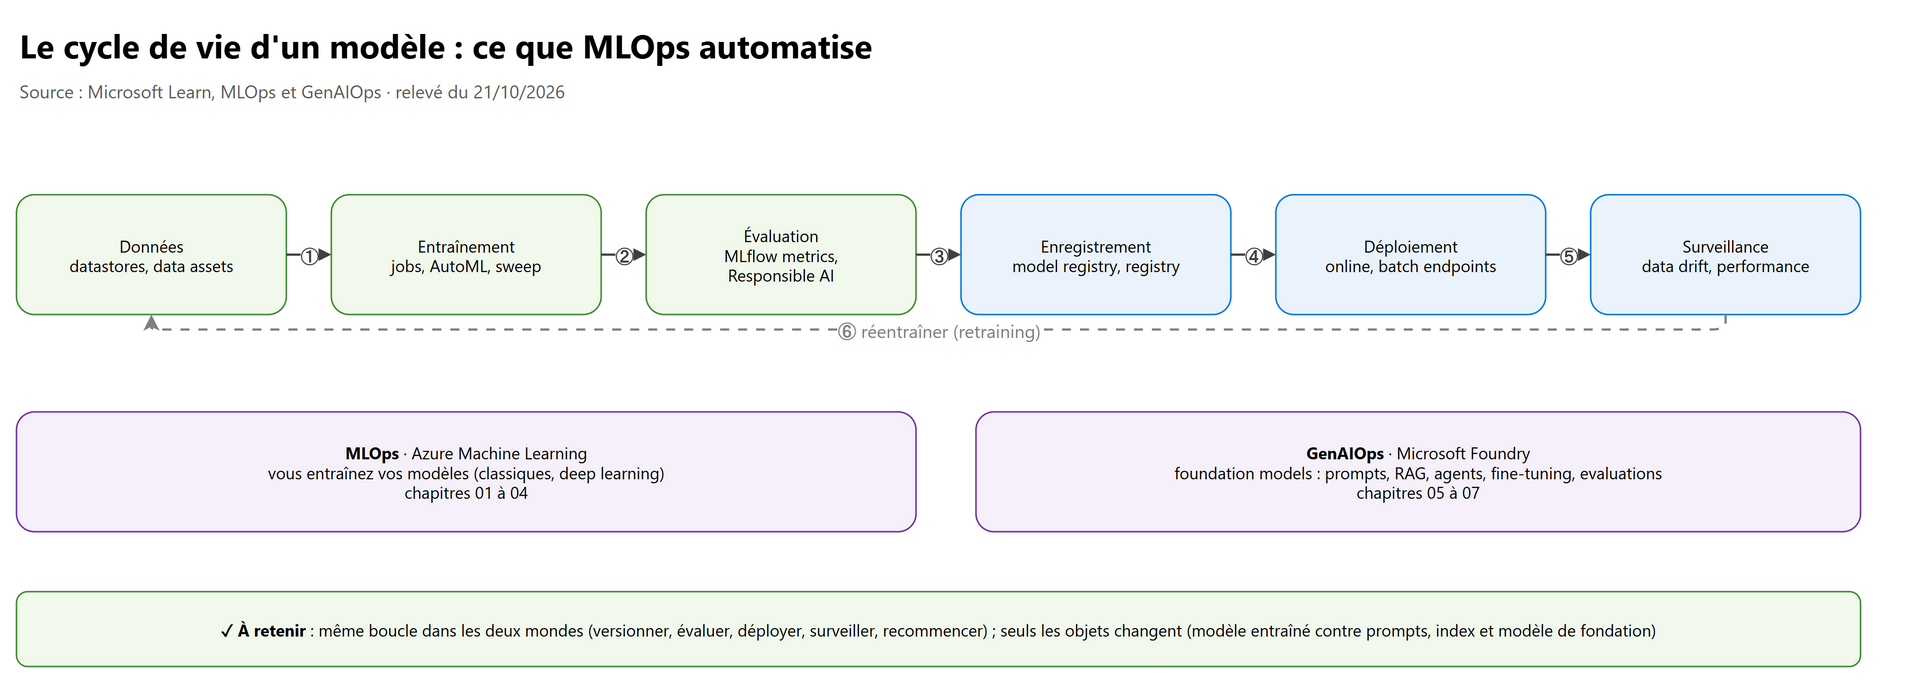
MLOps applique au machine learning les pratiques DevOps : tout est versionné (code, données, environnement, modèle), chaque étape est reproductible et automatisée (pipelines, CI/CD), le modèle en production est surveillé et réentraîné. GenAIOps fait la même chose pour l'IA générative : on ne gère plus un modèle que l'on entraîne, mais des prompts, des index, des agents, des évaluations et parfois un fine-tuning de modèle de fondation. Les chapitres 01 à 04 couvrent MLOps (Azure Machine Learning), les chapitres 05 à 07 GenAIOps (Microsoft Foundry).
1.3 Azure Machine Learning ou Microsoft Foundry : qui fait quoi#
| Besoin | Plateforme recommandée par Microsoft |
|---|---|
| Entraîner, déployer et gérer vos propres modèles (machine learning classique, deep learning), avec MLOps complet, online et batch endpoints, outils Responsible AI | Azure Machine Learning |
| Construire des applications d'IA générative et des agents : catalogue de modèles, fine-tuning, RAG, évaluations, sécurité, observabilité | Microsoft Foundry (voir le cours AI-103) |
| Consommer une capacité prête à l'emploi (OCR, speech, traduction, modération) | Foundry Tools |
| Machine learning intégré à une plateforme d'analytique (lakehouse, Spark, Power BI) | Microsoft Fabric ou Azure Databricks |
Point clé de l'Architecture Center : un workspace Azure Machine Learning n'est nécessaire que si vous avez besoin de son training compute, de son cycle MLOps ou de managed online / batch endpoints pour des modèles personnalisés. Foundry ne propose ni compute d'entraînement provisionné généraliste, ni AutoML sur données tabulaires.
1.4 AI-300 et les outils à connaître#
L'examen AI-300 (certification Microsoft Certified: Machine Learning Operations Engineer Associate) remplace DP-100, retiré le 01/06/2026. Les trois façons de piloter Azure Machine Learning, toutes en v2 :
| Outil | Usage |
|---|---|
Azure Machine Learning studio (ml.azure.com) |
Interface web : notebooks, jobs, assets, endpoints, registries |
Azure CLI, extension ml v2 (az ml …) |
Fichiers YAML par ressource, idéal pour la CI/CD |
Python SDK azure-ai-ml v2 |
Objet MLClient ; même modèle que le YAML |
# Se connecter à un workspace sans secret (identité Entra du développeur, ou managed identity en CI)
from azure.ai.ml import MLClient
from azure.identity import DefaultAzureCredential

ml_client = MLClient(
    DefaultAzureCredential(),
    subscription_id="<subscription-id>",
    resource_group_name="rg-ml-dev",
    workspace_name="mlw-churn-dev",
)
Dans un YAML ou un job, on désigne un asset par azureml:<nom>:<version> (ou azureml:<nom>@latest), et un asset d'un registry
par azureml://registries/<registry>/<type>/<nom>/versions/<version>.
2. Créer et gérer un workspace#
2.1 Ce que contient un workspace#
Le workspace garde l'historique de tous les jobs (logs, metrics, sorties, lignée, instantané des scripts) et héberge deux familles d'objets :
| Famille | Exemples | Portée |
|---|---|---|
| Assets | models, environments, components, data assets | Durables, versionnés, indépendants du workspace : partageables via un registry |
| Resources | compute, jobs, endpoints | Propres au workspace : un endpoint a une URI unique, un job a une durée de vie |
| Configuration | datastores, connections, paramètres de sécurité (réseau, identité, chiffrement) | Le workspace |
Conseils d'organisation de Microsoft :
- un workspace par projet (rapport de coûts par projet, datastores à la bonne portée) ;
- donner l'accès par groupes Microsoft Entra, pas utilisateur par utilisateur ;
- partager les ressources associées entre workspaces et les précréer et sécuriser côté IT, puis laisser les data scientists créer leurs workspaces en libre-service ;
- un hub workspace regroupe des project workspaces qui partagent sécurité, connections et compute : c'est le même type de ressource qu'un hub Foundry (classic).
La propriété kind du workspace vaut Default, Hub, Project ou FeatureStore. Piège : un workspace Hub ou
Project n'a ni compute clusters (utiliser le serverless compute), ni batch endpoints, ni BYO virtual network (seulement
le managed VNet), et un workspace Default ne se convertit pas en hub.
2.2 Les ressources associées#
À la création, on apporte des ressources existantes ou Azure Machine Learning les crée :
| Ressource | Rôle | À savoir pour l'examen |
|---|---|---|
| Storage account | Artefacts (logs de jobs), uploads de données, notebooks des compute instances | On ne peut pas réutiliser un compte de type BlobStorage, un compte premium, ni un compte avec hierarchical namespace (ADLS Gen2) : ces stockages s'ajoutent comme datastores |
| Azure Container Registry | Images Docker des environments personnalisés | Optionnelle à la création ; provisionnée automatiquement au premier build. Si une Azure Policy exige des tags, la création de l'ACR par Azure ML échoue (il ne sait pas la taguer) |
| Application Insights | Surveillance des online endpoints | — |
| Azure Key Vault | Secrets utilisés par les computes et le workspace | Secrets de connections et de datastores credential-based |
Sous-ressources créées avec les compute instances et clusters : VMs, un load balancer par compute (il facture même compute arrêté), réseau virtuel, bande passante sortante entre régions.
Piège : un workspace ne peut pas être déplacé vers un autre abonnement, et l'abonnement propriétaire ne peut pas changer de tenant : c'est une décision de conception à prendre au début.
2.3 Créer le workspace#
# Créer un workspace en réutilisant des ressources associées existantes (et sécurisées par l'équipe plateforme)
from azure.ai.ml import MLClient
from azure.ai.ml.entities import Workspace
from azure.identity import DefaultAzureCredential

ml_client = MLClient(DefaultAzureCredential(), "<subscription-id>", "rg-ml-dev")   # pas encore de workspace_name

ws = Workspace(
    name="mlw-churn-dev",
    location="westeurope",
    display_name="Churn - dev",
    storage_account="/subscriptions/<sub>/resourceGroups/rg-ml-dev/providers/Microsoft.Storage/storageAccounts/stmlchurndev",
    key_vault="/subscriptions/<sub>/resourceGroups/rg-ml-dev/providers/Microsoft.KeyVault/vaults/kv-ml-churn-dev",
    container_registry="/subscriptions/<sub>/resourceGroups/rg-ml-dev/providers/Microsoft.ContainerRegistry/registries/crmlchurndev",
    tags={"projet": "churn", "env": "dev"},
)
ml_client.workspaces.begin_create(ws).result()
En CLI : az ml workspace create --name mlw-churn-dev --resource-group rg-ml-dev --location westeurope (ou --file workspace.yml).
Bicep, Terraform, le réseau managé et les private endpoints sont détaillés au chapitre 02.
Droits pour créer un workspace : Owner, Contributor ou un custom role sur le resource group avec
Microsoft.MachineLearningServices/workspaces/write, Microsoft.Resources/deployments/* et les droits d'écriture sur les
ressources associées. Au tout premier workspace de l'abonnement, il faut aussi pouvoir enregistrer le resource provider
(Microsoft.MachineLearningServices/register/action).
3. Créer et gérer des datastores#
3.1 Ce qu'est un datastore#
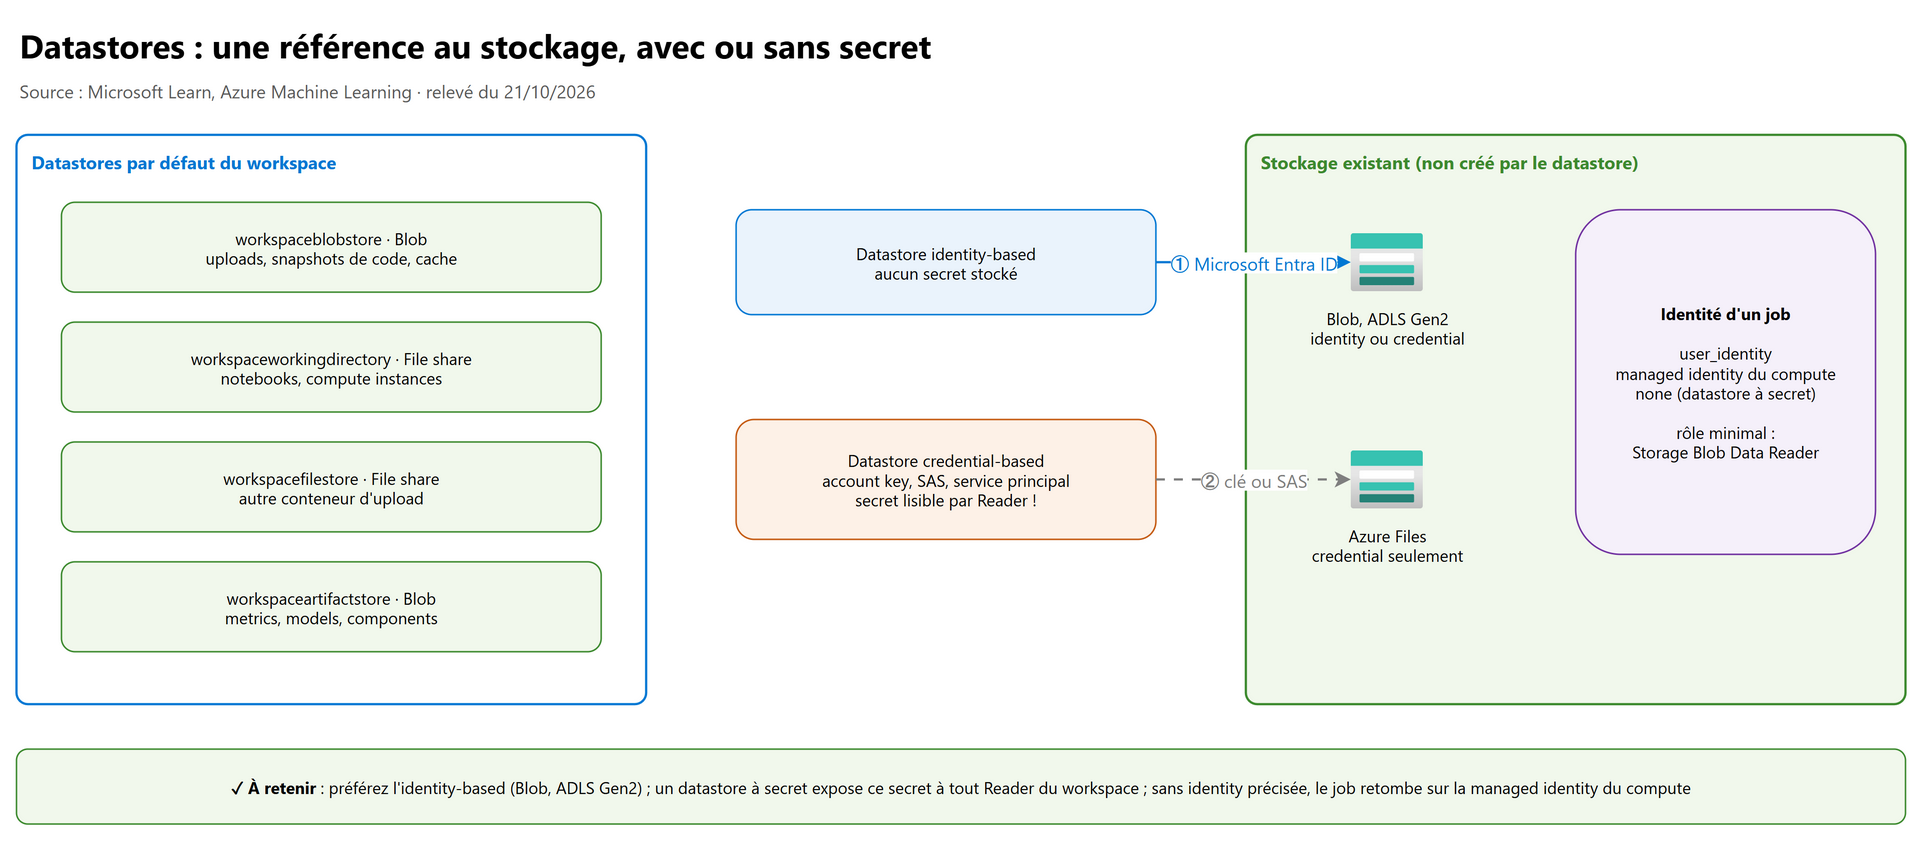
Un datastore est une référence vers un stockage Azure existant (il ne crée pas le compte). Il apporte une API commune (Blob, Files, ADLS), la découverte des sources par l'équipe et, pour l'accès par secret, la protection de ce secret (il n'apparaît pas dans les scripts).
| Service de stockage | Credential-based (clé, SAS, service principal) | Identity-based (Microsoft Entra ID, managed identity) |
|---|---|---|
| Azure Blob container | ✓ | ✓ |
| Azure Data Lake Storage Gen2 | ✓ | ✓ |
| Azure File share | ✓ | — |
| OneLake (Microsoft Fabric), preview | ✓ (service principal) | ✓ |
OneLake : seulement le dossier Files d'un lakehouse (les Tables passent par une copie vers ADLS Gen2), création par CLI ou
SDK (type: one_lake, pas dans l'interface du studio), et les batch endpoints ne l'acceptent pas en entrée ni en sortie.
Les droits se donnent par les rôles du workspace Fabric (Contributor), pas par Azure RBAC sur un storage account.
Piège classique : avec un datastore credential-based, tout utilisateur ayant le rôle Reader sur le workspace peut lire le secret. Préférez l'identity-based dès que le stockage le permet.
3.2 Les datastores par défaut#
Chaque workspace a quatre datastores sur son storage account par défaut :
| Datastore | Type | Contenu |
|---|---|---|
workspaceblobstore |
Blob container azureml-blobstore-{workspace-id} |
Uploads de données, snapshots de code des jobs, cache des pipelines |
workspaceworkingdirectory |
File share code-{GUID} |
Notebooks, compute instances, prompt flow |
workspacefilestore |
File share | Autre conteneur d'upload |
workspaceartifactstore |
Blob container azureml |
Metrics, models, components |
3.3 Créer un datastore identity-based#
# adls-datastore.yml : aucun credentials => accès par identité (Microsoft Entra ID ou managed identity)
$schema: https://azuremlschemas.azureedge.net/latest/azureDataLakeGen2.schema.json
name: adls_ventes
type: azure_data_lake_gen2
description: Données de ventes, accès par identité
account_name: stdatalakeventes
filesystem: curated
az ml datastore create --file adls-datastore.yml --resource-group rg-ml-dev --workspace-name mlw-churn-dev
3.4 Quelle identité lit les données ?#
Dans un job, l'identité qui accède au stockage dépend du champ identity :
| Valeur | Qui s'authentifie | Rôle à donner sur le stockage |
|---|---|---|
user_identity |
L'utilisateur qui soumet le job (passthrough Entra) | Storage Blob Data Reader (ou ACL ADLS) à l'utilisateur ou à son groupe |
managed_identity |
La managed identity du compute | Storage Blob Data Reader (lecture) ou Contributor (écriture) à cette identité |
| non précisé, datastore sans secret | Repli sur la managed identity du compute | Idem |
| datastore credential-based | Le secret du datastore (il l'emporte sur l'identité) | — |
flowchart TD
    A["Un job lit un datastore"] --> B{"Le datastore contient-il un secret ?"}
    B -- "Oui (clé, SAS, service principal)" --> C["Le secret est utilisé, l'identité est ignorée"]
    B -- "Non (identity-based)" --> D{"Champ identity du job ?"}
    D -- "user_identity" --> E["Identité Entra de l'utilisateur qui soumet le job"]
    D -- "managed_identity" --> F["Managed identity du compute"]
    D -- "Absent" --> F
    E --> G["Rôle Storage Blob Data Reader (ou ACL ADLS) sur le stockage"]
    F --> G
# Extrait d'un command job : les données sont lues avec l'identité de l'utilisateur qui soumet le job
inputs:
  ventes:
    type: uri_folder
    path: azureml://datastores/adls_ventes/paths/2026/
identity:
  type: user_identity
Le studio (aperçu, profilage) utilise votre identité ; si le stockage est derrière un pare-feu ou un private endpoint, c'est la workspace managed identity qui fait l'aperçu, avec Storage Blob Data Reader et le rôle Reader sur le private endpoint du stockage. L'accès cross-tenant à un storage account n'est pas pris en charge.
4. Créer et gérer des compute targets#
4.1 Les types de compute#
| Compute | Nature | Pour quoi | À savoir |
|---|---|---|---|
| Compute instance | Une VM managée de développement, mono-nœud | Notebooks, VS Code, exploration | Idle shutdown (15 min à 3 jours d'inactivité) et schedules start/stop (4 par instance) ; arrêtée, elle ne facture plus de calcul mais toujours disque, IP publique et load balancer ; ne libère pas son quota |
Compute cluster (amlcompute) |
Un ensemble de VMs qui autoscale de min_instances à max_instances |
Jobs d'entraînement, pipelines, entraînement distribué multi-nœuds | min_instances: 0 pour ne rien payer au repos ; idle_time_before_scale_down (120 s par défaut) ; tier: dedicated ou low_priority (moins cher, peut être préempté) |
| Serverless compute | Rien à créer : Azure ML crée, scale et supprime le calcul | Tous types de jobs, build d'images, fine-tuning du catalogue | Même quota que les clusters (affiché « Serverless ») ; standard ou spot ; user identity ou user-assigned identity du workspace ; isolation réseau managée |
| Kubernetes (AKS ou cluster Azure Arc) | Cluster attaché avec l'extension Azure ML | Entraînement et inférence là où sont les données (on-premises, multicloud) | Compute unmanaged : vous l'exploitez ; il faut Azure Kubernetes Service Cluster Admin Role sur le cluster pour l'attacher |
| Autres attachés | Remote VM, Azure Databricks, HDInsight, Synapse Spark… | Cas particuliers | Unmanaged |
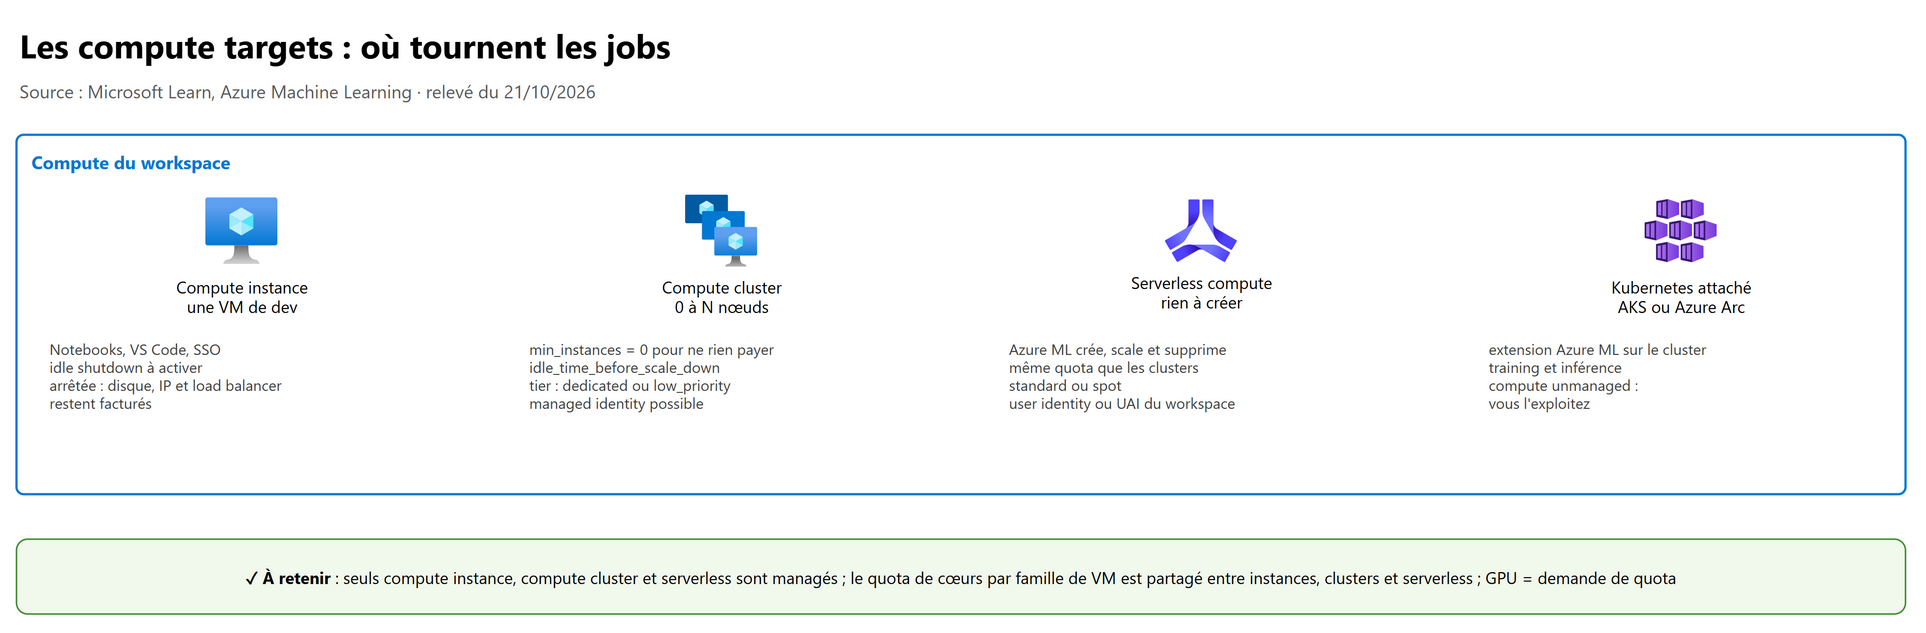
Seuls compute instance, compute cluster et serverless sont managés par Azure Machine Learning. Le quota de cœurs par région et famille de VM est unifié entre instances, clusters et serverless.
# Cluster GPU qui retombe à zéro nœud : pas de coût de calcul hors des jobs
from azure.ai.ml.entities import AmlCompute

gpu_cluster = AmlCompute(
    name="gpu-cluster",
    type="amlcompute",
    size="Standard_NC24ads_A100_v4",
    min_instances=0,                       # rien ne tourne au repos
    max_instances=4,
    idle_time_before_scale_down=180,       # secondes avant de rendre un nœud inactif
    tier="dedicated",                      # ou "low_priority" pour réduire le coût (préemption possible)
)
ml_client.compute.begin_create_or_update(gpu_cluster).result()
# compute-instance.yml : instance de dev qui s'arrête seule après 30 minutes d'inactivité
$schema: https://azuremlschemas.azureedge.net/latest/computeInstance.schema.json
name: ci-hamid-dev
type: computeinstance
size: STANDARD_DS3_v2
idle_time_before_shutdown_minutes: 30
az ml compute create --file compute-instance.yml
az ml compute list-sizes -g rg-ml-dev -w mlw-demo-dev --type AmlCompute --location westeurope   # tailles disponibles
4.2 Choisir la taille#
- GPU : les séries GPU (et d'autres SKUs spéciaux) n'apparaissent souvent qu'après une demande de quota. Plusieurs séries
sont retirées (NC, NCv2, ND, NV en 2023 ; NCv3 le 30/09/2025) : utilisez les séries T4, A100, H100 ou H200
(
NCasT4_v3,NCads_A100_v4,NDasrA100_v4,NCads_H100_v5,ND-H100-v5,ND-H200-v5). - CUDA : vérifiez la version CUDA supportée par l'architecture (Hopper 12.0+, Ampere 11.0+) et la compatibilité avec votre framework (PyTorch, TensorFlow).
- Inférence : commencer par une VM avec 150 % de la RAM du modèle, profiler, puis scale out (« scale up, then scale out »).
- Isolation : certaines tailles sont dédiées à un seul client (ex.
Standard_M128ms,Standard_NC24rs_v3) pour les exigences réglementaires. - Région : un cluster dans une autre région que le workspace ou les données ajoute latence et coûts de transfert.
5. Identités et accès au workspace#
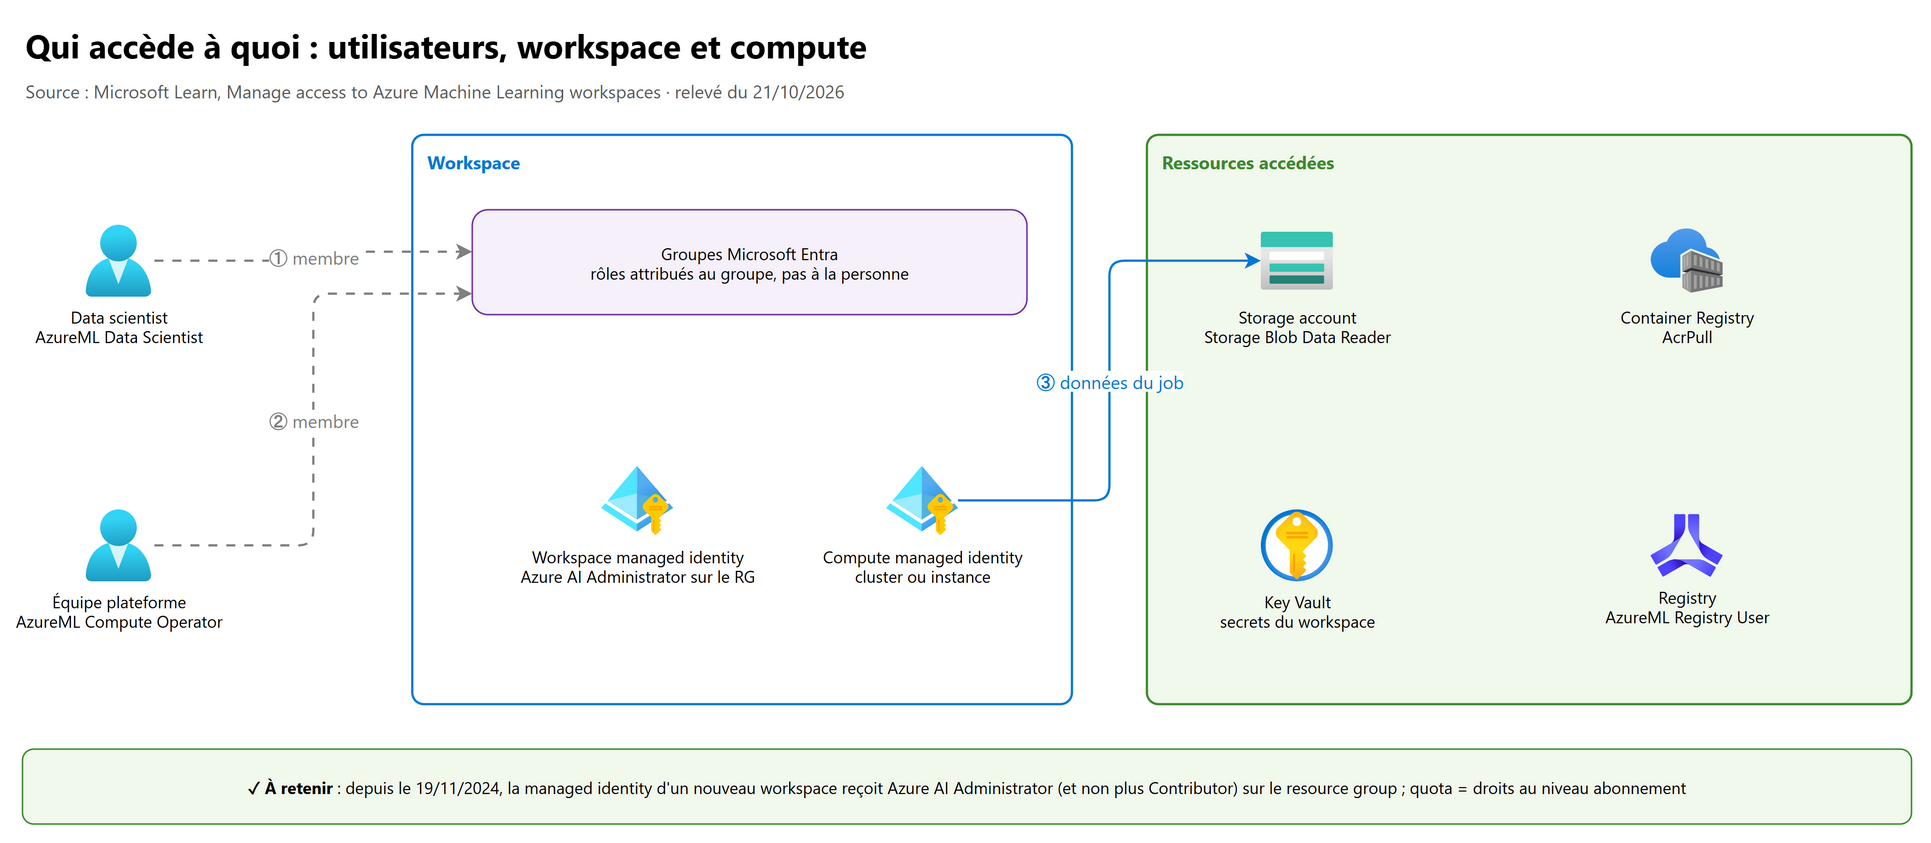
Les principes Azure RBAC (portée, héritage, custom roles) sont supposés connus : voir SC-500, chapitre 03. Ce qui est propre à Azure Machine Learning :
5.1 Les rôles intégrés#
| Rôle | Ce qu'il permet |
|---|---|
| AzureML Data Scientist | Toutes les actions dans le workspace sauf créer ou supprimer du compute et modifier le workspace lui-même |
| AzureML Compute Operator | Créer, gérer, supprimer et utiliser le compute du workspace |
| Reader | Lecture seule… y compris les credentials des datastores |
| Contributor | Créer, modifier, supprimer les assets ; créer un compute ; soumettre un job ; déployer |
| Owner | Tout, plus la gestion des role assignments |
| AzureML Registry User (sur un registry) | Lire, écrire et supprimer des assets dans le registry, sans créer ni supprimer le registry |
Combinaison typique : AzureML Data Scientist + AzureML Compute Operator pour un data scientist qui crée lui-même ses computes. Les quotas (demande au niveau abonnement ou plafond par workspace) exigent des droits d'écriture au niveau abonnement.
5.2 Les custom roles#
Quand aucun rôle intégré ne convient, un custom role au périmètre du workspace, du resource group ou de l'abonnement. Exemple officiel : un data scientist qui ne peut ni créer de compute ni modifier le workspace.
{
  "Name": "Data Scientist Custom",
  "IsCustom": true,
  "Description": "Can run experiment but can't create or delete compute.",
  "Actions": ["*"],
  "NotActions": [
    "Microsoft.MachineLearningServices/workspaces/*/delete",
    "Microsoft.MachineLearningServices/workspaces/write",
    "Microsoft.MachineLearningServices/workspaces/computes/*/write",
    "Microsoft.MachineLearningServices/workspaces/computes/*/delete",
    "Microsoft.Authorization/*/write"
  ],
  "AssignableScopes": [
    "/subscriptions/<sub>/resourceGroups/rg-ml-dev/providers/Microsoft.MachineLearningServices/workspaces/mlw-churn-dev"
  ]
}
Les actions v2 diffèrent des v1 : …/jobs/* (v2) au lieu de …/experiments/* (v1), …/components au lieu de …/modules,
…/models/versions au lieu de …/models. Les modèles officiels proposent aussi des rôles MLflow Data Scientist, MLOps (pour un
service principal de pipeline) et Workspace Admin.
5.3 Les managed identities#
| Identité | Rôle |
|---|---|
| Workspace managed identity (system-assigned par défaut, ou user-assigned) | Accède aux ressources associées (storage, key vault, ACR) ; fait les aperçus de données derrière pare-feu. Depuis le 19/11/2024, la system-assigned identity d'un nouveau workspace reçoit le rôle Azure AI Administrator sur le resource group (au lieu de Contributor) ; les anciens workspaces se convertissent avec az ml workspace update --name <ws> --allow-roleassignment-on-rg true |
| Compute managed identity (cluster, instance, Kubernetes attaché) | Lit les données (Storage Blob Data Reader), tire les images (AcrPull), sans que chaque data scientist ait accès aux données ; son nom est <workspace>/computes/<compute> |
| User-assigned identity d'un cluster | Demande le rôle Managed Identity Operator (…/userAssignedIdentities/assign/action) à la personne qui l'attache |
Piège : une compute instance configurée avec une managed identity ne s'arrête pas pour inactivité si cette identité n'a pas Contributor sur le workspace.
Les mêmes identités sans secret servent dans les pipelines GitHub Actions (OIDC, chapitre 02) et sont expliquées en détail dans SC-500, chapitre 01.
6. Créer et gérer des data assets#
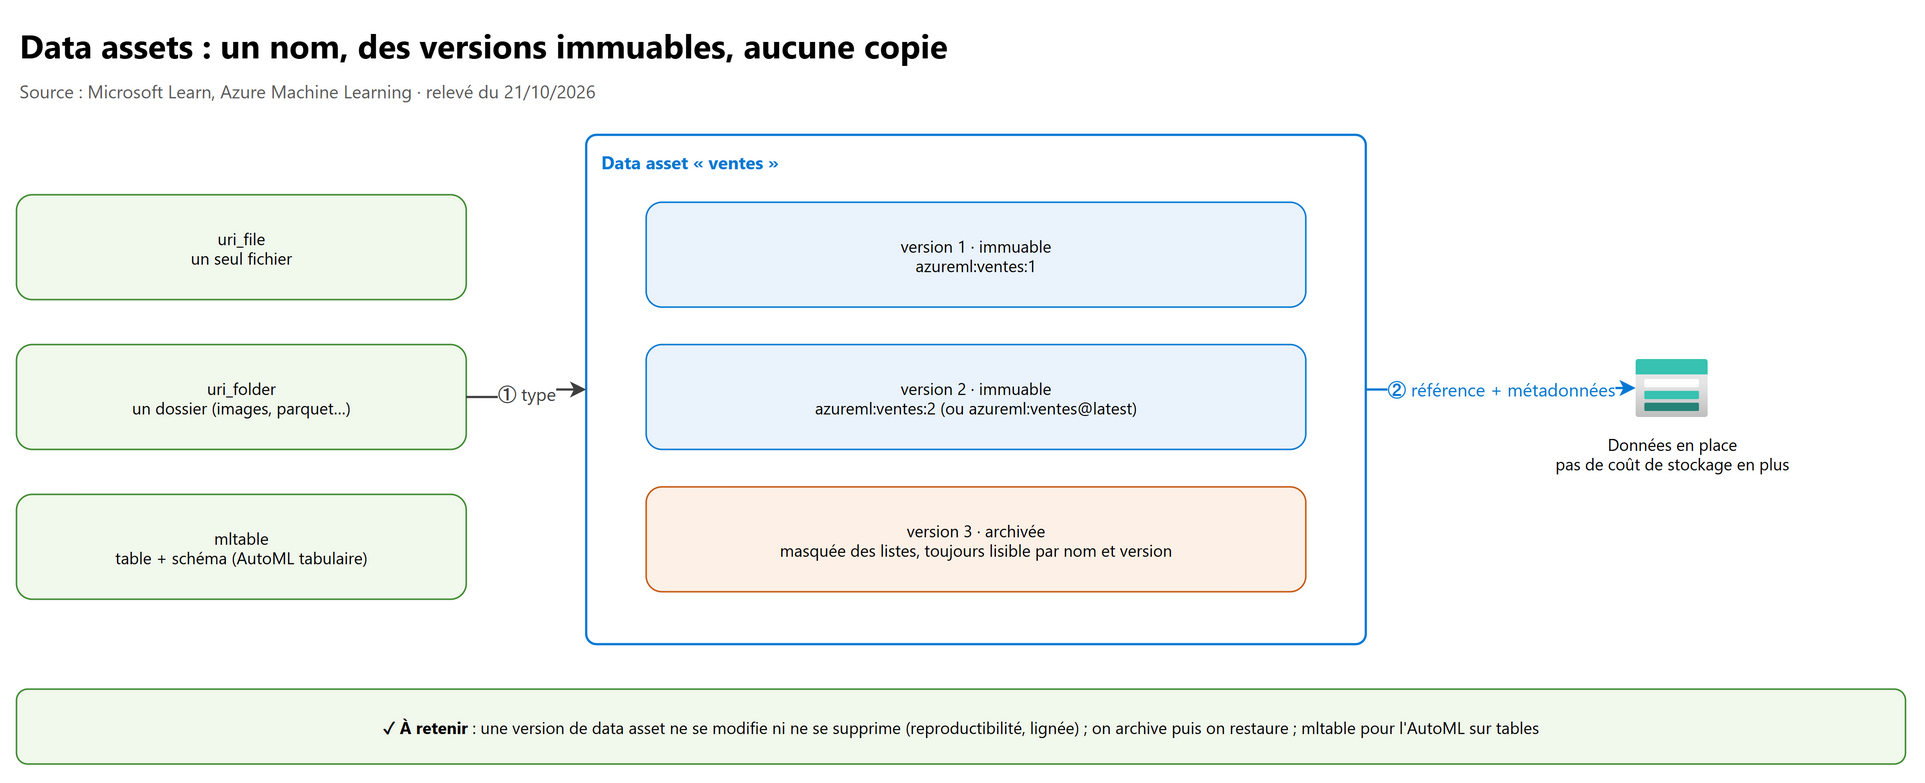
Un data asset est un « favori » : un nom et une version qui pointent vers des données qui restent à leur place (pas de copie, pas de coût de stockage en plus). Il apporte versioning, immutabilité (une version ne se modifie ni ne se supprime), auditabilité et lignée (quels jobs l'ont consommé).
| Type | Pour | Exemple |
|---|---|---|
uri_file |
Un fichier unique, tout format | un CSV |
uri_folder |
Un dossier : fichiers parquet ou CSV pour pandas ou Spark, images, audio, vidéo pour le deep learning | un dossier d'images |
mltable |
Une table avec schéma, ou un sous-ensemble de grosses données tabulaires ; AutoML sur tables | un fichier MLTable qui décrit comment lire les données |
from azure.ai.ml.entities import Data
from azure.ai.ml.constants import AssetTypes

ventes = Data(
    name="ventes",
    version="2",
    type=AssetTypes.URI_FOLDER,
    path="azureml://datastores/adls_ventes/paths/2026/",   # local, wasbs://, abfss:// ou datastore
    description="Ventes 2026, nettoyées",
)
ml_client.data.create_or_update(ventes)
Modes d'accès d'une entrée ou d'une sortie de job : ro_mount (lecture, défaut courant), rw_mount, download, upload (sortie)
et direct (l'URI est passée telle quelle, par exemple à Spark).
Cycle de vie : on archive une version (az ml data archive --name ventes --version 1) ou tout l'asset (ml_client.data.archive(name="ventes")) pour le
masquer des listes, puis on restaure (az ml data restore). Si tout le conteneur est archivé, on ne peut restaurer qu'en bloc.
Pour démarrer, un data asset n'est pas obligatoire : un job peut lire directement une datastore URI.
7. Créer et gérer des environments#
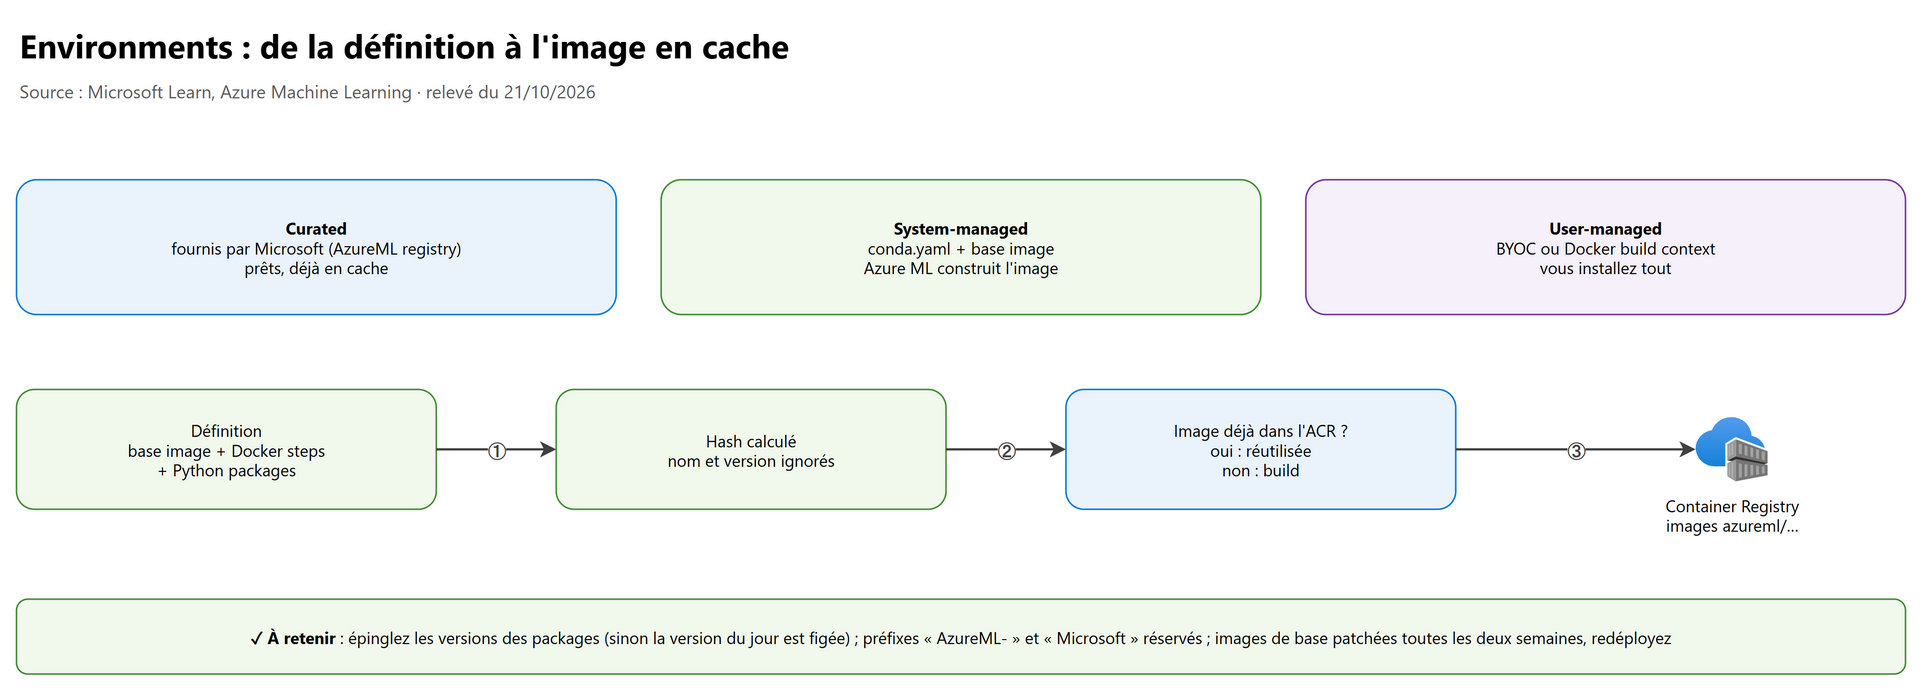
Un environment décrit l'image Docker et les packages Python d'un job ou d'un déploiement ; il est versionné, ce qui rend l'entraînement reproductible et permet de déployer avec exactement le même environnement.
| Type | Qui gère | Quand |
|---|---|---|
| Curated | Microsoft (hébergés dans le registry AzureML) ; déjà en cache, démarrage rapide | Frameworks courants (scikit-learn, PyTorch…) sans dépendance particulière |
| System-managed | Vous donnez un conda.yaml + une base image ; Azure ML construit l'environnement conda |
Le cas le plus courant |
| User-managed | Vous fournissez l'image (BYOC) ou un Docker build context ; vous installez tout | Dépendances système, image d'entreprise durcie |
# environment.yml : environment system-managed (base image Microsoft + conda)
$schema: https://azuremlschemas.azureedge.net/latest/environment.schema.json
name: env-churn-train
version: "3"
image: mcr.microsoft.com/azureml/openmpi4.1.0-ubuntu22.04
conda_file: conda.yaml            # versions épinglées : pandas==2.2.3, scikit-learn==1.5.2, mlflow…
az ml environment create --file environment.yml
Le mécanisme de cache (très demandé) :
- Azure ML calcule un hash à partir de la base image, des Docker steps et des packages Python (le nom et la version n'y entrent pas).
- Si une image de même hash existe dans l'ACR du workspace, elle est réutilisée ; sinon Azure ML la construit (par défaut sur le quota serverless du workspace ; un workspace à réseau restreint peut exiger un image build compute dédié).
- Changer l'ordre des dépendances change le hash et déclenche un build.
Règles à retenir :
- épinglez les versions : un package non épinglé garde la version disponible le jour de la création ;
- une base image non épinglée (
:latest) peut être reconstruite à chaque mise à jour du tag ; - les préfixes
AzureML-etMicrosoftsont réservés aux curated environments ; modifier un curated environment crée un environment personnalisé ; - Microsoft patche les base images toutes les deux semaines (pas de vulnérabilité connue de plus de 30 jours) : il faut redéployer les endpoints pour profiter d'une image corrigée ; avec vos propres images, c'est à vous.
8. Créer et gérer des components#
Un component est une étape autonome et réutilisable d'un pipeline, comme une fonction : un nom, des entrées et sorties typées, une commande, du code et un environment. Il se versionne automatiquement à l'enregistrement : un pipeline qui utilise une ancienne version continue de fonctionner.
# train.yml : command component
$schema: https://azuremlschemas.azureedge.net/latest/commandComponent.schema.json
type: command
name: train_churn
display_name: Entraîner le modèle de churn
version: "1"
inputs:
  training_data:
    type: uri_folder
  learning_rate:
    type: number
    default: 0.01
    min: 0.0001
    max: 1
outputs:
  model_output:
    type: mlflow_model
code: ./train_src
environment: azureml:env-churn-train:3
command: >-
  python train.py --data ${{inputs.training_data}} --lr ${{inputs.learning_rate}}
  --model ${{outputs.model_output}}
az ml component create --file train.yml
az ml component list --output table
| Champ | À savoir |
|---|---|
name |
Commence par une minuscule ; minuscules, chiffres et _ ; unique dans le workspace |
inputs / outputs |
Référencés dans la commande par ${{inputs.x}} et ${{outputs.y}} ; bornes min / max et enum vérifiées avant l'envoi du pipeline |
is_deterministic |
true par défaut : si les entrées n'ont pas changé, le résultat précédent est réutilisé ; mettre false pour une étape qui lit une source externe qui change |
environment |
azureml:<nom>:<version> (workspace) ou azureml://registries/azureml/environments/<nom>/versions/<v> (curated) |
| Noms réservés | Pas d'entrée nommée path, home, user, pwd, shell… |
Dans un pipeline, on référence un component enregistré par azureml:train_churn:1 ou azureml:train_churn@latest. Les pipelines
eux-mêmes sont au chapitre 03.
9. Partager les assets avec les registries#
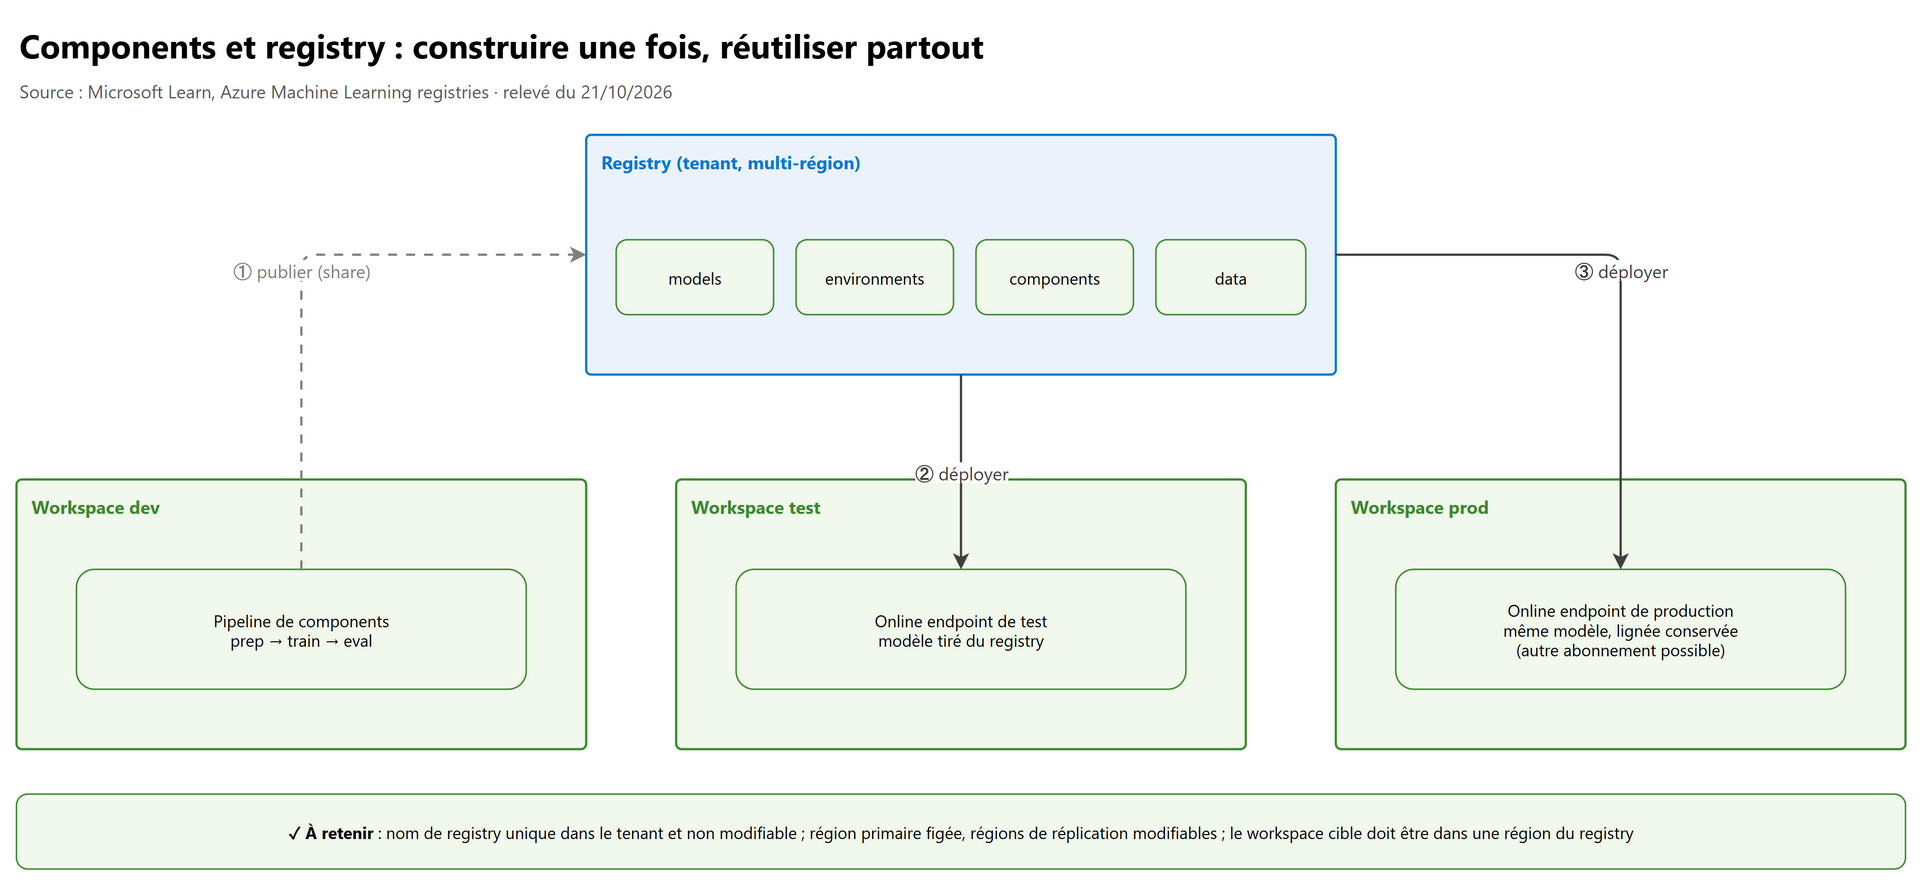
9.1 Pourquoi un registry#
Un Azure Machine Learning registry est au machine learning ce qu'un dépôt Git est au code : il découple les assets des workspaces et les héberge au niveau de l'organisation. On y met models, environments, components et data assets. Deux scénarios :
- MLOps cross-workspace : entraîner en dev, publier dans le registry, déployer en test puis en prod (souvent dans d'autres abonnements ou régions) en gardant la lignée jusqu'au job d'entraînement ;
- réutilisation entre équipes : un catalogue central de components et d'environments approuvés.
Le registry réplique son contenu : un storage account par région déclarée et un seul ACR avec réplication. Le registry AzureML de Microsoft, qui héberge les curated environments, fonctionne sur le même principe.
9.2 Créer un registry#
| Choix | Règle |
|---|---|
| Nom | Unique dans le tenant, 2 à 32 caractères, non modifiable (il apparaît dans les identifiants des assets) |
| Régions | Une région primaire non modifiable + des régions de réplication modifiables ; un workspace ne consomme un asset que si sa région fait partie du registry |
| Droits pour créer | Owner ou Contributor sur l'abonnement ou le resource group |
# registry.yml : la région primaire apparaît deux fois (location et replication_locations)
name: reg-ml-contoso
location: westeurope
replication_locations:
  - location: westeurope
  - location: northeurope
az ml registry create --file registry.yml --resource-group rg-ml-shared
9.3 Publier et consommer#
# Partager vers le registry un modèle déjà validé dans le workspace de dev
az ml model share --name churn-model --version 7 \
  --registry-name reg-ml-contoso --share-with-name churn-model --share-with-version 7
# Client sur le registry (pas de workspace) : créer ou lire des assets partagés
ml_client_registry = MLClient(DefaultAzureCredential(), registry_name="reg-ml-contoso", registry_location="westeurope")
modele = ml_client_registry.models.get(name="churn-model", version="7")
Un job ou un déploiement du workspace de prod référence ensuite azureml://registries/reg-ml-contoso/models/churn-model/versions/7.
Le compute et les données du workspace qui exécute déterminent où tourne le pipeline : les components et environments viennent
du registry, les données de production restent dans le workspace de prod.
9.4 Droits sur un registry#
| Besoin | Rôle |
|---|---|
| Utiliser les assets (lister, consommer) | Reader (ou custom role : registries/read + registries/assets/read) |
| Créer et supprimer des assets, sans gérer le registry | AzureML Registry User, ou custom role avec registries/assets/write et delete |
| Créer, modifier, supprimer le registry | Contributor ou Owner (attention : ils permettent aussi de supprimer le registry) |
La managed identity du registry a AcrPull sur son ACR ; quand un compute tire une image d'environment, le registry lui remet un jeton ACR limité : ni le workspace ni le compute n'ont d'accès direct à l'ACR du registry.
10. Labs conseillés#
Abonnement de test. Coût indicatif faible si les computes restent à 0 nœud ; supprimer le resource group à la fin.
- Workspace et ressources associées (≈ 30 min)
- Créer un workspace par le SDK avec un storage account, un key vault et une ACR existants (section 2.3).
- Ouvrir le resource group : repérer les ressources et le rôle Azure AI Administrator de la workspace managed identity.
- Essayer de réutiliser un storage account premium comme stockage par défaut : constater le refus. Résultat attendu : comprendre ce qui est créé et ce qui est seulement référencé.
- Datastore identity-based et identité de job (≈ 45 min)
- Créer un compte ADLS Gen2, puis le datastore
adls_ventessans credentials (section 3.3). - Soumettre un job avec
identity: user_identitysans rôle sur le stockage : échec d'accès. - Donner Storage Blob Data Reader à votre groupe : le job passe. Résultat attendu : voir que c'est le rôle sur le stockage, pas sur le workspace, qui ouvre les données.
- Créer un compte ADLS Gen2, puis le datastore
- Compute sans gaspillage (≈ 30 min, quelques euros)
- Créer un cluster CPU
min_instances: 0et une compute instance avecidle_time_before_shutdown_minutes: 30. - Lancer un job : observer le cluster passer à 1 nœud puis revenir à 0 après
idle_time_before_scale_down. - Relancer le même job en serverless (sans
compute), comparer.
- Créer un cluster CPU
- Data asset, environment et component versionnés (≈ 45 min)
- Créer
ventesv1 et v2, archiver la v1, vérifieraz ml data list. - Créer un environment, changer l'ordre de deux packages : observer un nouveau build d'image.
- Enregistrer le component
train_churnv1 puis v2, et un pipeline qui utilise@latest.
- Créer
- Registry (≈ 45 min)
- Créer
reg-...en deux régions, partager un environment et un modèle depuis le workspace dev. - Créer un second workspace « prod » dans une région du registry et y référencer le modèle par son URI
azureml://registries/….
- Créer
11. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Réutiliser un compte ADLS Gen2 comme stockage par défaut du workspace | Impossible : l'ajouter comme datastore | Hierarchical namespace, premium et BlobStorage refusés comme stockage par défaut |
| Un auditeur Reader voit la clé du storage | Le datastore est credential-based : passer en identity-based | Reader lit les credentials des datastores |
| Le job échoue sur les données alors que l'utilisateur est Owner du workspace | Donner Storage Blob Data Reader sur le stockage | Les droits sur le workspace n'ouvrent pas les données |
Job sans identity, datastore sans secret |
Il utilise la managed identity du compute | Repli documenté |
| Data scientist qui doit lancer des expériences sans créer de compute | AzureML Data Scientist | Il ne peut ni créer de compute ni modifier le workspace |
| Data scientist qui doit aussi créer ses clusters | AzureML Data Scientist + AzureML Compute Operator | Combinaison de rôles |
| Augmenter le quota GPU | Droits d'écriture au niveau abonnement | Les quotas ne se gèrent pas au niveau du workspace |
| Cluster qui coûte la nuit | min_instances: 0 (ou serverless) |
Toute valeur > 0 garde des nœuds allumés |
| Compute instance arrêtée qui coûte encore | Disque, IP publique et load balancer restent facturés | Seul le calcul s'arrête |
| Compute instance qui ne s'arrête jamais malgré l'idle shutdown | Donner Contributor sur le workspace à sa managed identity (ou fermer VS Code, kernels, applis) | Condition documentée |
| Ne gérer aucune infrastructure de compute pour l'entraînement | Serverless compute | Rien à créer, même quota, Azure ML gère le cycle de vie |
| Entraîner sur un cluster Kubernetes on-premises | Azure Arc + extension Azure ML, compute attaché | Compute unmanaged |
| Déplacer le workspace vers un autre abonnement | Impossible : recréer | Limite documentée |
| Deux environments de noms différents mais mêmes packages | Même image réutilisée | Le hash ignore nom et version |
| Environment qui « change tout seul » de version de package | Le package n'était pas épinglé | Version figée à la création, rebuild si la définition change |
Nommer un environment AzureML-monenv |
Refusé | Préfixe réservé aux curated environments |
| Corriger une vulnérabilité d'une base image Microsoft | Redéployer l'endpoint après le patch | Les assets existants ne se mettent pas à jour seuls |
| Modifier une version de data asset | Impossible : créer une nouvelle version | Versions immuables |
| Masquer une vieille version sans la supprimer | Archive (puis restore) | — |
| Step de pipeline qui ne relit pas une source qui a changé | is_deterministic: false |
Sinon le résultat est réutilisé |
| Déployer en prod (autre abonnement) un modèle entraîné en dev en gardant la lignée | Registry : az ml model share, puis déploiement depuis le registry |
Les assets sont indépendants du workspace |
| Renommer un registry ou changer sa région primaire | Impossible | Le nom est dans les identifiants d'assets |
| Laisser une équipe publier des assets sans pouvoir supprimer le registry | AzureML Registry User (ou custom role) | Contributor permet de supprimer le registry |
| La workspace managed identity d'un workspace de 2023 a Contributor sur le RG | --allow-roleassignment-on-rg true pour passer à Azure AI Administrator |
Moindre privilège |
12. Scénarios d'entraînement#
1. L'équipe plateforme veut que les data scientists créent leurs workspaces eux-mêmes, mais avec un storage account, un key vault et une ACR déjà sécurisés et partagés. Que faire ?
Précréer et sécuriser les ressources associées côté IT, puis créer les workspaces en les référençant (paramètres
storage_account,key_vault,container_registry) ; donner aux data scientists un rôle qui permet de créer un workspace dans le resource group, et l'accès au quotidien par groupes Microsoft Entra.
2. Des données sensibles sont dans un ADLS Gen2. Les data scientists ne doivent pas y avoir accès directement, mais les jobs d'entraînement doivent les lire. Quelle configuration ?
Datastore identity-based, compute cluster avec managed identity, rôle Storage Blob Data Reader donné à cette identité seulement, et jobs soumis avec
identity: managed_identity(ou sans identity : repli sur la managed identity du compute).
3. Un cluster GPU Standard_NC24ads_A100_v4 ne se crée pas : « quota insuffisant ». L'utilisateur est Owner du workspace.
Demander une augmentation de quota pour la famille de VM dans la région ; il faut des droits au niveau de l'abonnement. Penser aussi que le quota est partagé avec les instances et le serverless.
4. La direction financière constate des coûts de calcul la nuit et le week-end sur l'espace de dev. Deux actions ?
Clusters avec
min_instances: 0(ou passage au serverless), compute instances avec idle shutdown et schedules d'arrêt ; rappeler que disque, IP et load balancer d'une instance arrêtée restent facturés (supprimer les instances inutiles).
5. Deux équipes ont créé env-a et env-b avec la même base image et les mêmes packages dans le même ordre. Combien d'images
Docker ?
Une seule : le hash ignore le nom et la version ; la seconde réutilise l'image en cache dans l'ACR du workspace.
6. Un modèle doit passer de dev à prod, deux abonnements distincts, en gardant la trace du job, du code et des données d'entraînement. Quelle approche ?
Un registry dans une région commune aux deux workspaces :
az ml model sharedepuis dev, déploiement en prod à partir de l'URIazureml://registries/…; la lignée vers le job de dev est conservée.
7. Un auditeur avec le rôle Reader récupère la clé d'un storage account depuis le studio. Comment éviter cela ?
Remplacer le datastore credential-based par un datastore identity-based (Blob ou ADLS Gen2) et révoquer la clé ; Reader peut lire les credentials stockés dans un datastore.
8. Un pipeline réutilise toujours l'ancien résultat de l'étape « import » alors que le fichier source sur une URL publique a changé. Pourquoi ?
Le component est déterministe par défaut (
is_deterministic: true) : entrées identiques, résultat réutilisé. Mettreis_deterministic: falsesur l'étape d'import.
9. Une compute instance avec idle shutdown à 60 minutes reste allumée toute la nuit. Pistes ?
Session VS Code encore connectée, kernel Jupyter ou application personnalisée active ; ou managed identity de l'instance sans Contributor sur le workspace. Ajouter aussi un schedule d'arrêt.
13. Pour aller plus loin#
- Hub workspaces : partager sécurité, connections et compute entre plusieurs projets ; même type de ressource qu'un hub Foundry (classic).
- Feature store : workspace spécialisé pour partager des features entre modèles (la feature retrieval specification est au chapitre 04).
- Data isolation sur des ressources partagées (
enable_data_isolation) quand plusieurs workspaces utilisent le même stockage. - Clés gérées par le client (CMK) pour le workspace : le créateur doit avoir Owner ou Contributor sur le key vault et les permissions create, get, delete, purge sur la clé.
- Ressources partagées entre workspaces et Azure Policy pour imposer des règles (réseau privé, CMK, tailles de VM) : voir chapitre 02 et SC-500, chapitre 03.
14. Fiche à retenir#
- Assets (data, environments, components, models) : durables, versionnés, partageables ; resources (compute, jobs, endpoints) : propres au workspace.
- Ressources associées : Storage (pas premium, pas HNS, pas BlobStorage), Key Vault, Application Insights, ACR (optionnelle, créée au premier build).
- Un workspace ne se déplace ni d'abonnement ni de tenant.
- Datastore = référence ; identity-based (Blob, ADLS Gen2) préféré ; credential-based = secret lisible par Reader.
- Identité d'un job :
user_identity,managed_identity, ou repli sur la managed identity du compute ; le secret d'un datastore l'emporte. - Données : rôle Storage Blob Data Reader sur le stockage, pas sur le workspace.
- Compute managés : instance (dev, idle shutdown), cluster (
min_instances: 0, autoscale, low_priority), serverless (rien à créer) ; Kubernetes attaché = unmanaged. - Quota par région et famille de VM, partagé ; le modifier = droits abonnement.
- Rôles : AzureML Data Scientist (pas de compute), AzureML Compute Operator (compute), AzureML Registry User (registry).
- Workspace MI → Azure AI Administrator sur le RG (depuis le 19/11/2024).
- Data assets :
uri_file,uri_folder,mltable; versions immuables ; archive / restore. - Environments : curated, system-managed (conda + image), user-managed (BYOC) ; cache par hash (nom ignoré) ; épingler les versions ; préfixes
AzureML-/Microsoftréservés. - Components : inputs / outputs typés, versionnés,
is_deterministic: truepar défaut. - Registry : nom unique dans le tenant et figé, région primaire figée, réplication ; dev → registry → test / prod avec lignée.
Références#
Toutes lues le 21/10/2026 :
- Study guide for Exam AI-300
- Microsoft AI and machine learning products (Architecture Center)
- What is an Azure Machine Learning workspace?
- Data concepts in Azure Machine Learning
- Create datastores
- Access data in a job
- Set up authentication between Azure Machine Learning and other services
- What are compute targets in Azure Machine Learning?
- Create an Azure Machine Learning compute cluster
- Create an Azure Machine Learning compute instance
- Model training on serverless compute
- Attach a Kubernetes cluster to an Azure Machine Learning workspace
- Manage access to Azure Machine Learning workspaces
- Create and manage data assets
- What are Azure Machine Learning environments?
- What is an Azure Machine Learning component?
- CLI (v2) command component YAML schema
- Machine learning registries for MLOps
- Manage Azure Machine Learning registries
- Share models, components, and environments across workspaces with registries
- Exam retirement (DP-100)