
Version : 1.0 · Date : 2026-10-23 · Parcours SUPPORT-IA (support N2/N3 de chatbots IA sur Azure)
En une phrase : un chatbot RAG enchaîne plusieurs familles de modèles (OCR, embeddings, reranker, chat ou reasoning), chacune avec son quota, son prix et ses pannes ; tout se mesure en jetons (entrée, entrée en cache, sortie, raisonnement), et savoir lire le champ
usage, les en-têtes de limite et les métriques de latence suffit à expliquer la plupart des incidents de coût, de lenteur et de 429.
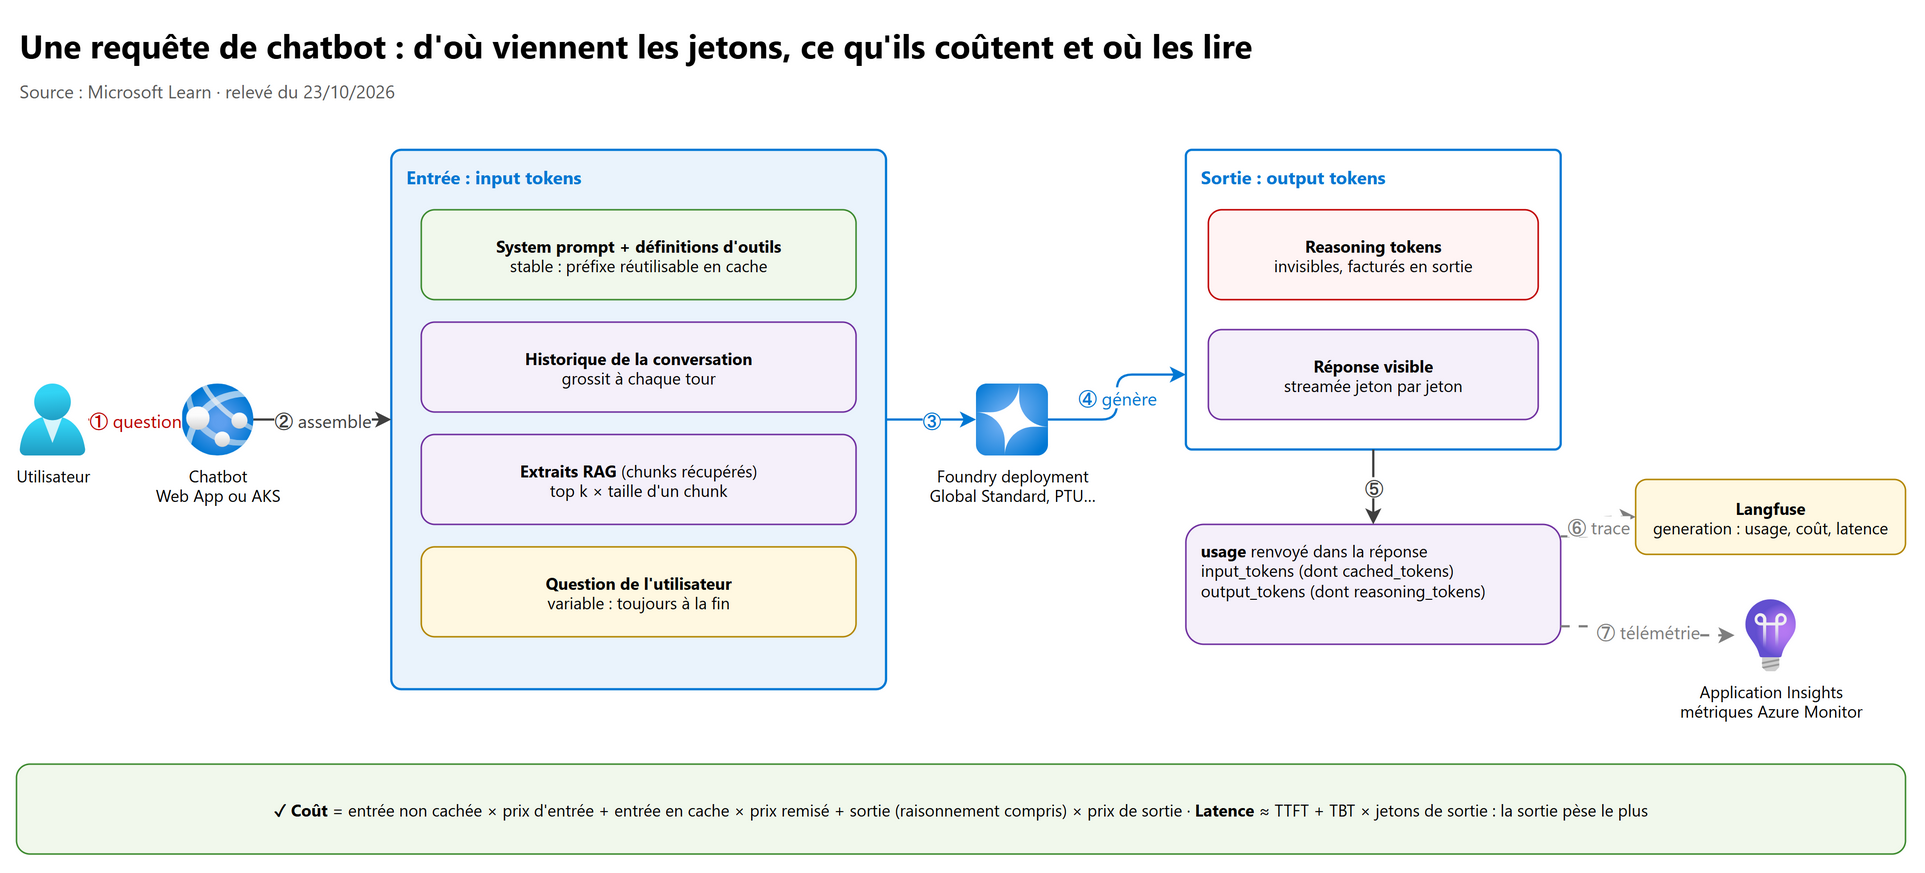
Ce chapitre suppose les bases de Foundry vues dans le cours AI-103 : familles de modèles et choix d'un modèle (AI-103, 01), deployment types (AI-103, 02), quotas et 429 (AI-103, 03), paramètres de génération et latence (AI-103, 07). Ici, on prend l'angle support : comprendre, mesurer, diagnostiquer.
Noms à jour (relevé du 23/10/2026) : Azure AI Foundry s'appelle désormais Microsoft Foundry ; les Azure AI services sont devenus les Foundry Tools (ex. Azure Document Intelligence in Foundry Tools) ; les modèles Azure OpenAI sont rangés dans Foundry Models sold by Azure. Les anciennes pages restent sous l'étiquette (classic). Les deux noms circulent encore dans le code et la documentation interne d'un client.
| # | Section | Ce qu'on y apprend |
|---|---|---|
| 1 | Les familles de modèles | Chat, reasoning, embeddings, multimodal, OCR, rerankers |
| 2 | Quel modèle pour quelle tâche | Le catalogue Foundry vu par le support |
| 3 | Déploiements, quotas et 429 | Deployment types, TPM/RPM, retry-after, PTU |
| 4 | Les jetons | Entrée, cache, sortie, raisonnement, contexte |
| 5 | Le coût | Modèle de prix, exemple chiffré |
| 6 | La latence | TTFT, TBT, streaming, exemple chiffré |
| 7 | Prompt caching | Règles, structure d'invite, mesure |
| 8 | Paramètres de génération | temperature, top_p, plafonds de sortie |
| 9 | Content filters et erreurs | 400, content_filter, 401, 403, 404, 5xx |
| 10 | Lire les jetons dans les logs | usage, Azure Monitor, Langfuse |
| 11–14 | Erreurs, lab, entretien, fiche |
1. Les familles de modèles#
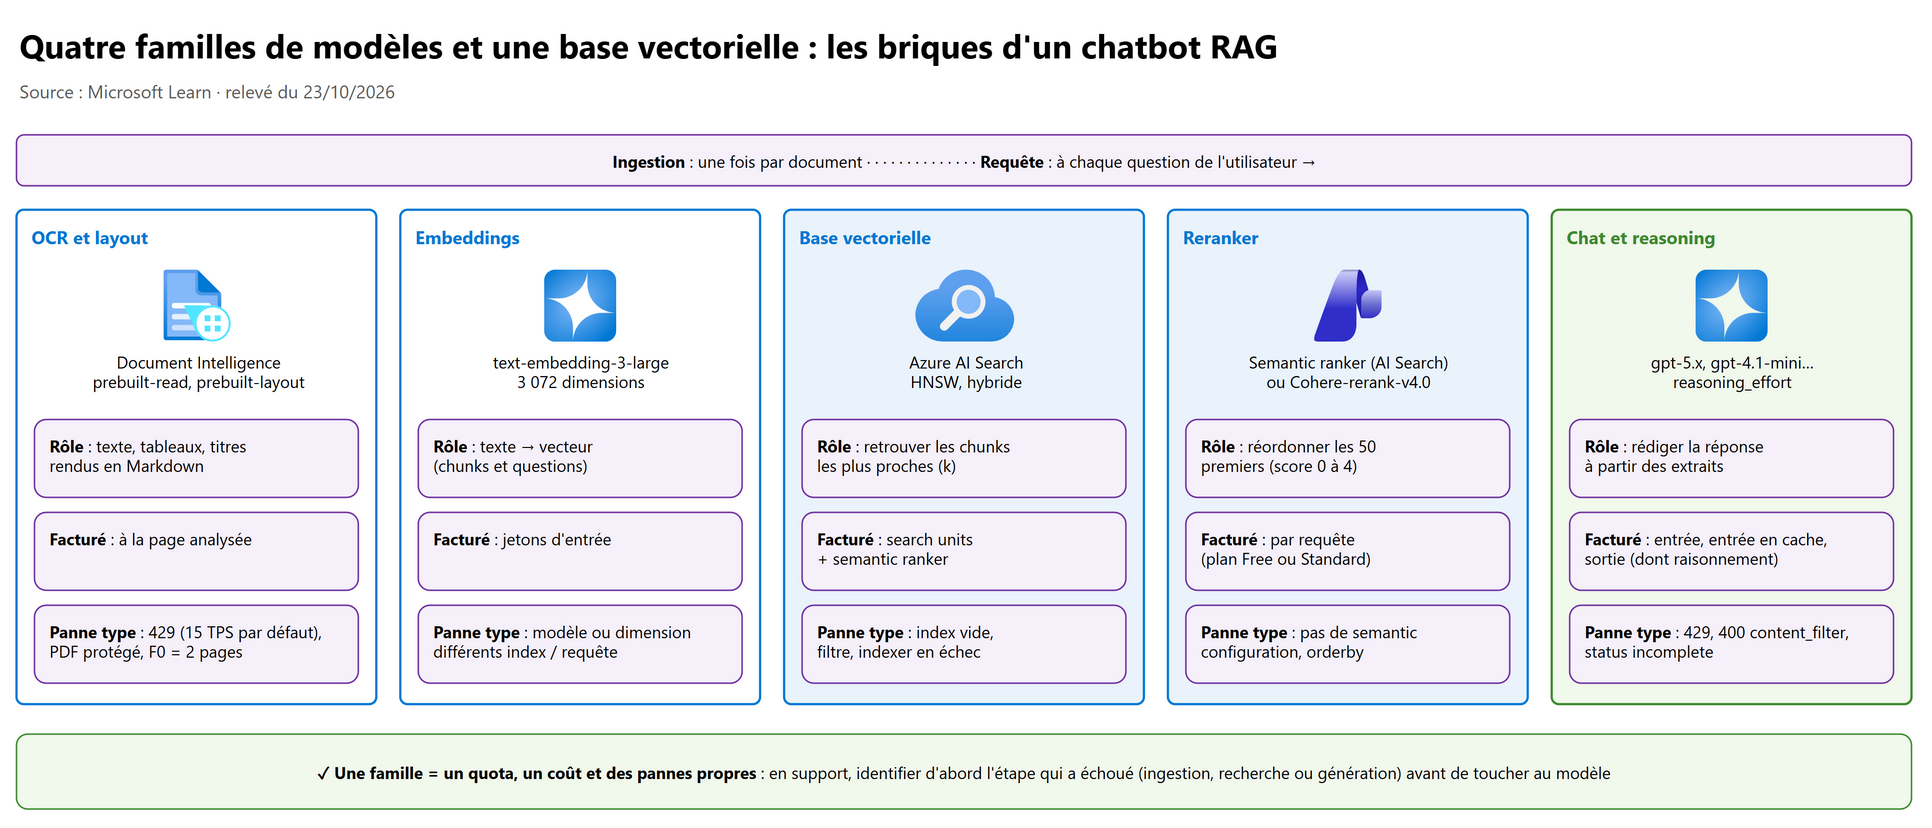
| Famille | Ce qu'elle fait | Exemples dans Foundry | Entrée → sortie | Facturation | Ce qui casse le plus souvent |
|---|---|---|---|---|---|
| Chat / génération | Rédige une réponse à partir d'une invite | gpt-4.1, gpt-4.1-mini, gpt-4o-mini, Llama, Mistral |
Texte (+ image) → texte | Jetons d'entrée, en cache, de sortie | 429, contexte trop long, content_filter |
| Reasoning | « Réfléchit » avant de répondre (jetons de raisonnement cachés) | gpt-5, gpt-5-mini, gpt-5.x, série o (o3, o4-mini), DeepSeek-V4-* |
Texte (+ image) → texte | Idem, raisonnement facturé en sortie | Latence, coût, status: incomplete sans texte |
| Embeddings | Transforme un texte en vecteur pour la recherche par similarité | text-embedding-3-large (3 072 dim.), text-embedding-3-small (1 536), embed-v-4-0 (Cohere) |
Texte → vecteur | Jetons d'entrée | Modèle ou dimension différents entre index et requête |
| Multimodal | Comprend des images (et parfois de l'audio) | gpt-4o, gpt-4.1, GPT-5 (texte + image en entrée) |
Texte + image → texte | Jetons, images converties en jetons | Coût des images en haute résolution |
| OCR / document | Extrait texte, tableaux, structure | Document Intelligence prebuilt-read, prebuilt-layout ; mistral-document-ai-2512, Cohere-parse-v5 (preview) |
PDF, image, Office → texte, JSON, Markdown | À la page | 429 à 15 TPS, PDF protégé, tier F0 limité à 2 pages |
| Reranker | Réordonne des résultats de recherche selon leur pertinence | Semantic ranker d'Azure AI Search ; Cohere-rerank-v4.0-pro / -fast |
Requête + documents → scores | Par requête (semantic ranker) ou par appel | Pas de semantic configuration, trop peu de candidats |
1.1 Chat et génération#
Un modèle de chat prend une liste de messages (system ou developer, user, assistant, résultats d'outils) et produit la suite
la plus probable, jeton par jeton. Deux API : Chat Completions (historique) et Responses (recommandée pour les nouveaux
développements, outils et raisonnement). En support, l'API utilisée change le nom des champs à lire (section 4.2).
1.2 Reasoning models#
Les reasoning models génèrent des reasoning tokens avant la réponse visible. Ce qu'il faut savoir :
| Point | Détail vérifié |
|---|---|
| Visibilité | Jamais dans le contenu du message ; un résumé peut être demandé (reasoning.summary), il n'est pas garanti à chaque requête |
| Facturation | Facturés comme des jetons de sortie, même si la réponse visible est courte |
| Où les lire | completion_tokens_details.reasoning_tokens (Chat) ou output_tokens_details.reasoning_tokens (Responses) |
| Réglage | reasoning_effort (Chat) ou reasoning={"effort": …} (Responses) : none, minimal, low, medium, high, xhigh, max selon le modèle ; plus d'effort = plus de jetons, de latence et de coût |
| Défauts piégeux | gpt-5.1 : effort par défaut none ; gpt-5-pro : seulement high ; gpt-chat-latest (preview) : niveau fixe non réglable |
| Plafond | max_completion_tokens (Chat) ou max_output_tokens (Responses) couvre raisonnement + réponse visible ; max_tokens n'est pas accepté |
| Paramètres refusés | temperature, top_p, presence_penalty, frequency_penalty, logprobs, top_logprobs, logit_bias, max_tokens |
| Plafond atteint | Réponse HTTP 200 avec status: incomplete, incomplete_details.reason: max_output_tokens, parfois sans aucun texte alors que l'entrée et le raisonnement sont facturés |
| Conseil officiel | Réserver au moins 25 000 jetons pour raisonnement + sortie pendant les essais, puis ajuster ; vérifier status à chaque réponse |
Piège support : « le bot répond vide de temps en temps » avec un reasoning model = presque toujours un plafond de sortie trop bas. Le raisonnement a consommé tout le budget avant la réponse visible.
1.3 Embeddings#
Un embedding est un vecteur de nombres réels qui représente le sens d'un texte : deux textes proches ont des vecteurs proches (similarité cosinus pour les modèles Azure OpenAI). Règles à connaître par cœur :
| Règle | Conséquence en production |
|---|---|
text-embedding-3-large : 3 072 dimensions ; -3-small et ada-002 : 1 536 ; entrée max 8 192 jetons ; 2 048 éléments max par appel |
Un chunk plus long est rejeté ou doit être découpé |
Les modèles de 3e génération acceptent un paramètre dimensions pour réduire la taille du vecteur |
La dimension de l'index doit être exactement celle produite |
| On ne peut pas passer d'un modèle d'embedding à un autre sans tout revectoriser | Changer de modèle = réindexer tout le corpus |
| La question doit être vectorisée avec le même modèle que les documents | Sinon les scores de similarité n'ont plus de sens (résultats aléatoires, sans erreur) |
1.4 Multimodal#
gpt-4o, gpt-4.1 et les GPT-5 acceptent du texte et des images en entrée. Une image est convertie en jetons selon sa taille
et le paramètre detail (low coûte un forfait de jetons, high dépend des dimensions). En support : un pic de jetons d'entrée sans
hausse du nombre de requêtes vient souvent d'images envoyées en haute résolution.
1.5 OCR et Document Intelligence#
Azure Document Intelligence in Foundry Tools (v4.0, API 2024-11-30 GA) est le service d'extraction le plus courant dans
l'ingestion RAG :
| Modèle | Ce qu'il extrait | Usage RAG |
|---|---|---|
prebuilt-read |
Lignes, mots, positions, langue (OCR). Base de tous les autres modèles | Texte brut, documents simples |
prebuilt-layout |
Texte, tableaux, cases à cocher, titres et sections, figures ; sortie Markdown avec outputContentFormat=markdown |
Le modèle de référence pour le RAG : découpage par sections, tableaux lisibles par un LLM |
prebuilt-invoice, prebuilt-contract, prebuilt-idDocument… |
Champs typés d'un type de document | Extraction de champs (pas du RAG à proprement parler) |
| Modèles custom (template, neural) | Champs de vos formulaires | Formulaires maison |
| Limite (tier S0, par défaut) | Valeur | Ce que le support voit |
|---|---|---|
| Analyze (POST) | 15 transactions par seconde (ajustable par demande de support) | 429 pendant une ingestion massive |
| Get operation (GET, polling) | 50 TPS ; ne pas interroger plus d'une fois toutes les 2 s par requête | 429 sur le polling ; respecter retry-after |
| Taille / pages | 500 Mo, 2 000 pages par document (F0 : 4 Mo et 2 pages) | « Seules 2 pages sont extraites » = ressource en tier F0 |
| PDF chiffré | Refusé : retirer le mot de passe | Document absent de l'index |
L'analyse est asynchrone : POST …/documentModels/prebuilt-layout:analyze renvoie 202 et un en-tête Operation-Location
que l'on interroge jusqu'à succeeded. Le détail de l'ingestion est au chapitre 03.
D'autres modèles du catalogue font aussi de l'OCR vers Markdown (mistral-document-ai-2512 : 30 pages ou 30 Mo par appel ;
mistral-ocr-4-0 et Cohere-parse-v5 en preview), et Azure Content Understanding est le chemin recommandé par Microsoft pour
les nouveaux skillsets d'Azure AI Search (AI-103, 10).
1.6 Rerankers#
Un reranker (cross-encoder) lit la question et chaque candidat ensemble pour produire un score de pertinence plus fin que la similarité vectorielle. Deux options sur Azure :
| Option | Où | Score | À savoir |
|---|---|---|---|
| Semantic ranker | Intégré à Azure AI Search (queryType: semantic) |
@search.rerankerScore de 0 à 4 |
Reclasse les 50 premiers résultats ; plan Free (quota mensuel) ou Standard ; captions et answers extraits mot pour mot |
Cohere-rerank-v4.0-pro / -fast |
Modèle du catalogue Foundry, appelé par votre code | Score de pertinence renvoyé en JSON | Le contenu des documents part vers un autre déploiement : vérifier conformité et latence |
2. Quel modèle Foundry pour quelle tâche#
Le catalogue évolue chaque mois (relevé du 23/10/2026 : séries gpt-6, gpt-5.6, gpt-5.5, gpt-5.4, gpt-5, gpt-4.1,
o3/o4-mini, gpt-oss, plus DeepSeek, Meta, Mistral, Cohere, Moonshot, Microsoft). Ce qui compte en support n'est pas de connaître
tous les noms, mais de savoir quelle famille est derrière chaque étape et où vérifier ses caractéristiques.
| Tâche dans le chatbot | Famille | Exemple de choix raisonnable | Pourquoi |
|---|---|---|---|
| Extraire le texte et les tableaux des PDF | OCR / layout | Document Intelligence prebuilt-layout (Markdown) |
Structure conservée, tableaux lisibles, coût à la page |
| Vectoriser chunks et questions | Embeddings | text-embedding-3-large ou -small |
Qualité vs taille d'index ; le même des deux côtés |
| Réordonner les résultats | Reranker | Semantic ranker d'Azure AI Search | Intégré, pas de code, score 0–4 lisible |
| Répondre en FAQ, ton fixe, faible latence | Chat non-reasoning ou reasoning à effort bas | gpt-4.1-mini, ou un GPT-5 avec reasoning_effort none/low |
Peu de jetons de sortie, TTFT bas |
| Questions complexes, multi-étapes, outils | Reasoning | gpt-5.x effort medium |
Qualité, au prix de jetons et de latence |
| Classer une intention, router | Petit modèle | gpt-5-nano, gpt-4.1-nano |
Coût et latence minimaux |
| Gros volume asynchrone (résumés en masse) | Tout modèle en Batch | Global Batch | −50 %, cible 24 h, quota séparé |
| Laisser Foundry choisir | Model router | model-router |
Routage par requête ; journaliser le champ model de la réponse |
Où vérifier, pour un modèle donné : la page Foundry Models sold by Azure (fenêtre de contexte, sortie max, API supportées), la page Region availability (région et deployment type), le cycle de vie (preview, GA, date de retrait). Microsoft ne recommande pas les modèles preview en production : ils sont mis à niveau automatiquement et ne suivent pas le cycle standard.
# Lister les modèles déployables dans une région (lecture seule)
az cognitiveservices model list --location westeurope --query "[].{name:model.name, version:model.version, format:model.format}" -o table

# Lister les deployments d'une ressource Foundry et leur capacité (lecture seule)
az cognitiveservices account deployment list -g <rg> -n <foundry-resource> \
  --query "[].{name:name, model:properties.model.name, version:properties.model.version, sku:sku.name, capacity:sku.capacity}" -o table
3. Déploiements, quotas et 429#
3.1 Deployment types en une table#
| Type (SKU) | Traitement de l'inférence | Facturation | Pour |
|---|---|---|---|
Global Standard (GlobalStandard) |
Toute région Azure | Jeton | Défaut : nouveaux modèles d'abord, prix le plus bas, quota le plus haut |
Data Zone Standard (DataZoneStandard) |
Dans la zone EU, US ou APAC | Jeton | Résidence par zone ; priority processing disponible |
Standard (Standard) |
Géographie de la ressource | Jeton | Conformité géographique, faible volume |
Global / Data Zone / Regional Provisioned (…ProvisionedManaged) |
Selon le préfixe | PTU à l'heure (réservations possibles) | Débit réservé, latence stable |
| Global / Data Zone Batch | Selon le préfixe | Jeton −50 % | Travaux asynchrones, cible 24 h, quota de jetons en file séparé |
Developer (DeveloperTier) |
Toute région, sans garantie de résidence | Jeton | Évaluer un modèle fine-tuned : 24 h de vie, sans SLA |
Les données au repos restent toujours dans la géographie de la ressource ; le type ne change que le lieu de traitement. Détail, arbre de décision et spillover : AI-103, 02.
3.2 TPM, RPM : comment la limite est calculée#
- Le quota est attribué par abonnement, région, modèle et deployment type, en TPM ; chaque deployment en reçoit une part. Le RPM est dérivé du TPM selon un ratio fixé par modèle (anciens modèles de chat : 6 RPM pour 1 000 TPM).
- À l'arrivée de chaque requête, le service estime le maximum de jetons : invite +
max_tokens+best_of. Cette estimation s'ajoute au compteur de la minute. Unmax_tokensde 4 000 consomme 4 000 jetons de limite, même si la réponse en fait 200. - Le RPM est contrôlé sur des fenêtres de 1 ou 10 secondes : 600 RPM = pas plus de 10 requêtes dans une seconde.
- Une requête rejetée (400) peut compter dans la limite. Les métriques de jetons, elles, ne montrent que les jetons facturés des requêtes réussies.
D'où le classique « 429 alors que les métriques sont sous le quota ».
3.3 Lire un 429#
| Message ou indice | Cause | Bonne action |
|---|---|---|
| « Requests to … have been limited », « Rate limit is exceeded » | TPM ou RPM du deployment dépassé | Augmenter le TPM du deployment, rééquilibrer, demander du quota |
| « The service is temporarily unable to process your request », « System is experiencing high demand » | Capacité du service saturée (souvent transitoire) | Retry avec retry-after-ms ; si persistant, PTU. Demander du quota ne sert à rien |
x-ratelimit-limit-tokens inférieur au TPM configuré |
Ajustement temporaire de la limite (pool partagé Standard) | Retry avec backoff ; se résout en quelques heures |
| 429 avec des métriques de jetons faibles | max_tokens surdimensionné gonfle l'estimation |
Ramener max_tokens à la taille réelle des réponses |
| 429 sur un deployment Provisioned | Utilisation à 100 % (Provisioned-managed Utilization V2) |
Normal : signal de régulation ; spillover vers Standard ou retry |
flowchart TD
    A["HTTP 429 reçu"] --> B{"Message d'erreur ?"}
    B -- "Rate limit is exceeded" --> C{"Métriques de jetons<br/>proches du TPM ?"}
    C -- Oui --> D["Quota réellement atteint :<br/>TPM du deployment, rééquilibrage,<br/>demande de quota, PTU"]
    C -- Non --> E{"max_tokens élevé<br/>ou rafales sur 1 à 10 s ?"}
    E -- Oui --> F["Baisser max_tokens,<br/>lisser le trafic"]
    E -- Non --> G{"x-ratelimit-limit-tokens<br/>inférieur au TPM configuré ?"}
    G -- Oui --> H["Ajustement temporaire :<br/>retry avec retry-after-ms"]
    G -- Non --> I["Ouvrir un ticket si persistant"]
    B -- "temporarily unable / high demand" --> J["Capacité du service :<br/>retry, PTU si critique"]
    B -- "429 sur un deployment PTU" --> K["Utilisation à 100 % :<br/>spillover ou retry"]
| En-tête | Usage en diagnostic |
|---|---|
x-ratelimit-limit-tokens, x-ratelimit-limit-requests |
Limites effectives du deployment |
x-ratelimit-remaining-tokens, x-ratelimit-remaining-requests |
Marge avant le 429 : ralentir avant |
x-ratelimit-reset-tokens, x-ratelimit-reset-requests |
Délai avant remise à zéro |
retry-after-ms (et retry-after) |
Présent sur un 429 : temps d'attente conseillé |
# Lire les en-têtes de limite d'un appel (client OpenAI v1, authentification Entra ID, aucune clé)
from openai import OpenAI
from azure.identity import DefaultAzureCredential, get_bearer_token_provider

token = get_bearer_token_provider(DefaultAzureCredential(), "https://ai.azure.com/.default")
client = OpenAI(base_url="https://<resource>.openai.azure.com/openai/v1/", api_key=token, max_retries=0)  # retry géré ailleurs

raw = client.chat.completions.with_raw_response.create(
    model="<deployment>", messages=[{"role": "user", "content": "ping"}], max_completion_tokens=50)
for h in ("x-ratelimit-limit-tokens", "x-ratelimit-remaining-tokens", "x-ratelimit-remaining-requests"):
    print(h, raw.headers.get(h))
print(raw.parse().usage)                       # jetons facturés de cet appel
Le SDK openai réessaie 2 fois par défaut les 429 et erreurs transitoires (backoff exponentiel, respect de retry-after).
Avec une bibliothèque de retry externe (tenacity, Polly) ou une AI gateway qui réessaie déjà, mettre max_retries=0 côté client
pour éviter les tempêtes de retry.
À retenir pour l'entretien : un 429 n'est pas une panne. On lit le message (quota ou capacité ?) et les en-têtes (limite effective, marge, délai), puis on agit :
max_tokens, répartition, quota, PTU, ou simple retry.
3.4 Les autres quotas d'une chaîne RAG#
| Service | Limite qui produit des 429 ou des lenteurs | Où la voir |
|---|---|---|
| Deployment d'embedding | TPM du deployment, partagé entre indexation et requêtes si un seul deployment | En-têtes, métriques ; Microsoft conseille un deployment pour l'indexation et un pour les requêtes |
| Document Intelligence | 15 TPS (analyze), 50 TPS (get) | Onglet Monitoring de la ressource |
| Azure AI Search | Requêtes limitées si mémoire, CPU ou E/S saturés (ThrottledSearchQueriesPercentage, 503) ; semantic ranker : jusqu'à 10 requêtes concurrentes par replica, sinon réponse partielle CapacityOverloaded |
Métriques du service, chapitre 03 |
4. Les jetons#
4.1 Qu'est-ce qu'un jeton ?#
Un jeton (token) est l'unité que le modèle lit et écrit : un mot court, un morceau de mot, un signe de ponctuation. Les modèles GPT utilisent une tokenisation en sous-mots (Byte-Pair Encoding) : « hamburger » donne trois jetons (« ham », « bur », « ger »), « pear » un seul, et beaucoup de jetons commencent par une espace. Ordre de grandeur donné par Microsoft : un jeton ≈ quatre caractères pour un texte anglais courant. Le ratio change avec la langue, le code, les chiffres : on mesure, on ne suppose pas.
4.2 Les types de jetons#
| Type | Ce que c'est | Champ (Chat Completions) | Champ (Responses) | Facturation |
|---|---|---|---|---|
| Entrée (input, prompt) | Tout ce qu'on envoie : system, historique, extraits RAG, question, définitions d'outils, schéma de sortie, images | prompt_tokens |
input_tokens |
Prix d'entrée |
| Entrée en cache (cached) | Partie de l'entrée servie par le prompt caching | prompt_tokens_details.cached_tokens |
input_tokens_details.cached_tokens |
Prix remisé (Standard), jusqu'à 100 % de remise en PTU |
| Écriture en cache | GPT-5.6 et suivants, Standard : jetons écrits dans le cache | prompt_tokens_details.cache_write_tokens |
— | Peut être facturée en plus |
| Sortie (output, completion) | Ce que le modèle génère | completion_tokens |
output_tokens |
Prix de sortie (le plus cher) |
| Raisonnement | Jetons cachés des reasoning models, inclus dans la sortie | completion_tokens_details.reasoning_tokens |
output_tokens_details.reasoning_tokens |
Prix de sortie |
Exemple réel de bloc usage (Chat Completions, page Microsoft du prompt caching) : prompt_tokens: 1566 dont cached_tokens: 1408,
completion_tokens: 1518 dont reasoning_tokens: 576. Lecture : 158 jetons d'entrée payés plein tarif, 1 408 au tarif remisé,
1 518 jetons de sortie dont 942 visibles.
4.3 Fenêtre de contexte et sortie maximale#
La fenêtre de contexte est le nombre total de jetons qu'un modèle traite dans une requête : entrée, raisonnement et sortie partagent ce budget. La sortie maximale est un plafond, pas une réservation.
| Modèle (relevé du 23/10/2026) | Fenêtre de contexte | Sortie max | Piège |
|---|---|---|---|
gpt-4.1, -mini, -nano |
1 047 576 ; 300 000 en Standard, 128 000 en Provisioned et Batch | 32 768 | Au-delà de 128 000 en PTU : 400 (et déclencheur de spillover) |
gpt-5, gpt-5-mini, gpt-5-nano |
400 000 (entrée 272 000, sortie 128 000) | 128 000 | Entrée limitée à 272 000 même si la fenêtre fait 400 000 |
gpt-5.5 |
1 050 000, mais budget effectif ≈ 922 000 en Responses API | 128 000 | Génération possible = 922 000 − jetons d'invite |
o3-mini, o1 |
Entrée 200 000, sortie 100 000 | 100 000 | — |
model-router |
200 000 | Selon le modèle choisi | Contexte effectif = celui du plus petit modèle du pool |
Deux symptômes différents à ne pas confondre :
| Symptôme | Cause | Réponse du service |
|---|---|---|
Erreur 400 context_length_exceeded (« This model's maximum context length is … ») |
L'entrée dépasse la limite | Requête refusée, rien n'est généré |
HTTP 200, finish_reason: length (Chat) ou status: incomplete + max_output_tokens (Responses) |
La sortie a atteint son plafond | Réponse tronquée ou vide |
Pour un chatbot, l'entrée grossit à chaque tour (historique) : sans stratégie de troncature ou de résumé de l'historique, une
conversation longue finit en context_length_exceeded ou devient chère et lente.
5. Le coût#
5.1 Le modèle de prix#
| Élément | Unité | Ce qui fait varier le prix |
|---|---|---|
| Modèle de chat ou reasoning (Standard, Global, Data Zone) | Prix par million de jetons, différent pour entrée, entrée en cache et sortie | Le modèle, le deployment type ; certaines familles (GPT-5.6, GPT-6) ont des catégories contexte court / contexte long selon le nombre de jetons d'entrée de la requête |
| Batch | Jetons | −50 % par rapport à Global Standard |
| Provisioned (PTU) | Heure de PTU déployée, réservation mensuelle ou annuelle possible | Le nombre de PTU, pas le nombre de jetons ; une réservation ne garantit pas la capacité |
| Embeddings | Jetons d'entrée | Le modèle |
| Document Intelligence | Page analysée, selon le modèle (read, layout, prebuilt, custom) | Le modèle et le volume |
| Azure AI Search | Search units (replicas × partitions) à l'heure + semantic ranker (plan Free puis paiement à l'usage) + vectorisation intégrée (jetons du modèle d'embedding) | Le tier, le nombre de SU, le volume de requêtes sémantiques |
| Fine-tuned models | Entraînement + heures d'hébergement + jetons | Un modèle fine-tuned déployé coûte à l'heure même sans trafic |
Ce qui est facturé même en cas d'échec (FAQ officielle) : une requête 400 due au content filter ou à la limite d'entrée,
un 408 (timeout) ; une réponse 200 avec finish_reason: content_filter (entrée + sortie générée). Pas facturé : 401
(authentification), 429 (limite de débit), car le service n'a rien traité.
Prix exacts : ils changent souvent ; toujours lire la page officielle Azure OpenAI pricing au moment du calcul. Les exemples ci-dessous utilisent des prix fictifs pour la méthode.
5.2 Exemple chiffré : une question au chatbot#
Hypothèses (prix fictifs, à remplacer par la page de prix) : entrée 1,00 $ / 1M jetons, entrée en cache 0,10 $ / 1M, sortie 8,00 $ / 1M. Requête RAG typique :
| Bloc | Jetons | Remarque |
|---|---|---|
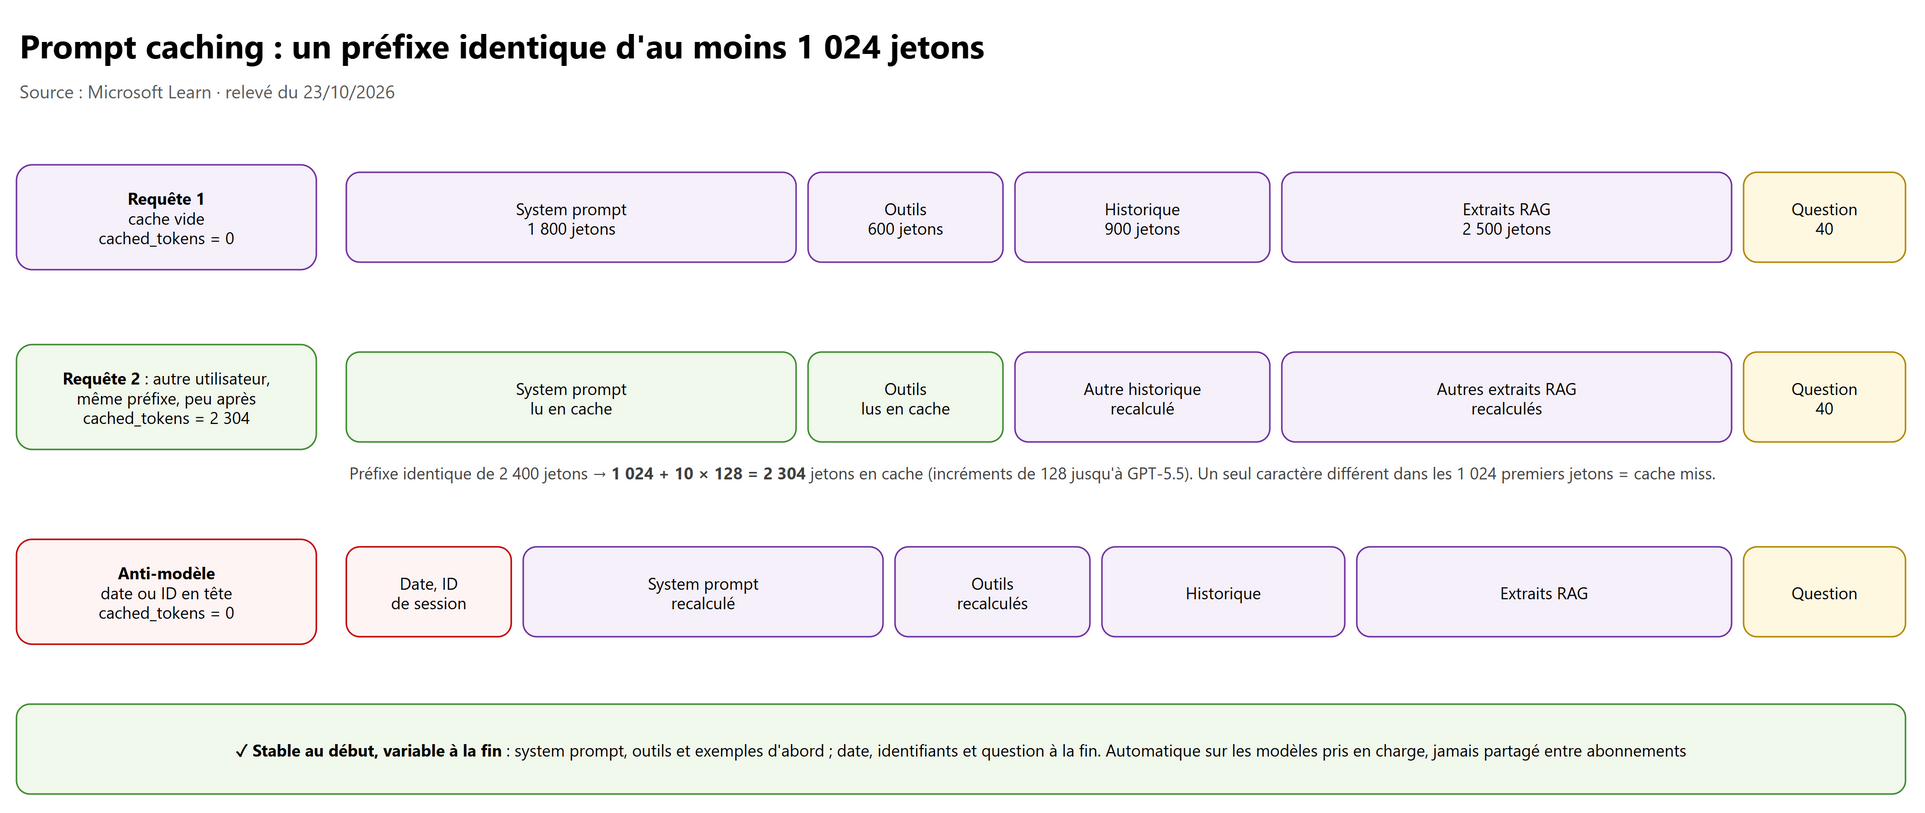
| System prompt + définitions d'outils | 2 400 | Identique pour tous : en cache 1 024 + 10 × 128 = 2 304 |
| Historique (3 tours) | 900 | |
| Extraits RAG (5 chunks × 500) | 2 500 | Le levier le plus direct sur l'entrée |
| Question | 40 | |
| Entrée totale | 5 840 | dont 2 304 en cache |
Raisonnement (reasoning_effort: low) |
600 | Facturé en sortie |
| Réponse visible | 400 | |
| Sortie totale | 1 000 |
Calcul :
- entrée non cachée : (5 840 − 2 304) × 1,00 / 1 000 000 = 0,003536 $ ;
- entrée en cache : 2 304 × 0,10 / 1 000 000 = 0,000230 $ ;
- sortie : 1 000 × 8,00 / 1 000 000 = 0,008000 $ ;
- total ≈ 0,0118 $ par question, soit ≈ 1 177 $ pour 100 000 questions par mois.
Ce que montre le calcul :
- La sortie pèse 68 % du coût avec seulement 15 % des jetons : raisonnement et verbosité sont les premiers leviers.
- Le cache économise ici ≈ 15 % (sans cache : 0,0138 $). Il compte davantage quand le préfixe stable est long.
- Passer de 5 à 10 chunks ajoute 2 500 jetons d'entrée (+ 0,0025 $, soit + 21 %) et du bruit pour le modèle.
# Coût d'une requête à partir du bloc usage (prix à renseigner depuis la page officielle)
PRIX = {"in": 1.00, "cached": 0.10, "out": 8.00}           # $ par million de jetons (fictifs)

def cout(u) -> float:
    cached = u.input_tokens_details.cached_tokens or 0      # Responses API
    return ((u.input_tokens - cached) * PRIX["in"] + cached * PRIX["cached"] + u.output_tokens * PRIX["out"]) / 1_000_000
5.3 Dimensionner le TPM pour la même charge#
Pic de 20 questions par minute sur ce chatbot :
| Hypothèse | Estimation par requête (limite de débit) | TPM consommé au pic |
|---|---|---|
max_completion_tokens = 4 000 |
5 840 + 4 000 = 9 840 | 196 800 |
max_completion_tokens = 1 500 |
5 840 + 1 500 = 7 340 | 146 800 |
| Jetons réellement facturés | 5 840 + 1 000 = 6 840 | 136 800 |
Le même trafic « consomme » 44 % de limite en plus avec un max_completion_tokens surdimensionné : c'est la cause n° 1 des 429
« inexplicables ».
6. La latence#
6.1 La formule#
TTLT = TTFT + (TBT × jetons générés) (formule officielle).
| Sigle | Signification | Métrique Azure Monitor | Ce qui la fait monter |
|---|---|---|---|
| TTFT | Time to first token : jusqu'au premier jeton | Time to Response (AzureOpenAITimeToResponse) |
Taille de l'invite, cache manqué, charge, content filtering |
| TBT | Time between tokens : temps moyen entre deux jetons | Time Between Tokens (AzureOpenAINormalizedTBTInMS) |
Modèle, charge du deployment |
| TTLT | Time to last token : temps total | Time to Last Byte (AzureOpenAITTLTInMS) |
Le nombre de jetons de sortie |
| Jetons de sortie | Generated Completion Tokens (GeneratedTokens) |
À toujours afficher à côté d'une latence |
Microsoft le dit explicitement : chaque jeton d'invite ajoute peu de temps comparé à chaque jeton généré, et le modèle et le
nombre de jetons générés sont les deux principaux facteurs. Un TTLT qui monte avec les jetons de sortie n'est pas une régression ;
un TTLT qui monte sans hausse des jetons signale une pression de capacité (429, PTU saturé, ajustement temporaire). Ne pas
utiliser la métrique héritée Latency (catégorie Cognitive Services - HTTP Requests), trompeuse pour Azure OpenAI.
6.2 Exemple chiffré#
Valeurs d'exemple (à mesurer sur votre deployment) : TTFT 0,6 s, TBT 10 ms.
| Configuration | Jetons générés | TTLT | Premier mot visible |
|---|---|---|---|
| Non-reasoning, réponse de 400 jetons | 400 | 0,6 + 4,0 = 4,6 s | ≈ 0,6 s (streaming) |
Reasoning low : 600 + 400 |
1 000 | 0,6 + 10 = 10,6 s | ≈ 6,6 s : le raisonnement passe avant la réponse |
Reasoning high : 4 000 + 400 |
4 400 | 0,6 + 44 = 44,6 s | ≈ 40,6 s |
Le streaming ne réduit pas le temps total : il réduit le temps perçu (le texte s'affiche dès le premier jeton visible). Avec un reasoning model, il faut aussi réduire l'effort ou demander au modèle un court préambule pour afficher quelque chose plus tôt.
# Mesurer TTFT et TTLT côté client, en streaming, avec l'usage en fin de flux
import time
t0 = time.perf_counter(); ttft = None
stream = client.chat.completions.create(
    model="<deployment>", stream=True, stream_options={"include_usage": True},
    messages=[{"role": "user", "content": "Explique le RAG en 5 lignes."}])
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content and ttft is None:
        ttft = time.perf_counter() - t0                    # premier jeton visible
    if chunk.usage:                                        # dernier chunk : usage complet
        print(f"TTFT={ttft:.2f}s TTLT={time.perf_counter() - t0:.2f}s sortie={chunk.usage.completion_tokens}")
6.3 Leviers officiels contre la latence#
Modèle plus rapide (mini, nano), moins de jetons générés (consigne de concision, verbosity, effort de raisonnement plus bas),
max_tokens bas, stop sequences, n = 1, streaming (latence perçue), prompt caching (TTFT), un deployment par type de charge
(les appels courts n'attendent pas les longs), Provisioned pour une latence stable, et revoir le content filtering pour les cas à
faible risque (le filtrage ajoute de la latence).
7. Prompt caching#
7.1 Les règles (Azure OpenAI, relevé du 23/10/2026)#
| Règle | Détail |
|---|---|
| Conditions | Invite d'au moins 1 024 jetons, dont les 1 024 premiers identiques à une requête récente ; un seul caractère différent = cached_tokens: 0 |
| Granularité | Jusqu'à GPT-5.5 : au-delà des 1 024 premiers, par incréments de 128 jetons ; pas d'arrondi à partir de GPT-5.6 |
| Activation | Automatique sur les modèles pris en charge (GPT-4o et plus récents) ; rien à configurer |
| Ce qui est mis en cache | Messages (system, developer, user, assistant), images (même detail), définitions d'outils, schéma de structured outputs (ajouté en préfixe du system message) |
| Durée en mémoire | Vidé en général après 5 à 10 minutes d'inactivité, toujours dans l'heure ; jamais partagé entre abonnements |
| Rétention étendue | Jusqu'à 24 h (prompt_cache_retention: "24h") sur certains modèles (gpt-4.1, gpt-5, gpt-5.1… gpt-5.5, activée par défaut sur gpt-5.5) ; même prix que la rétention en mémoire |
| Prix | Lecture en cache remisée en Standard, jusqu'à 100 % de remise en Provisioned ; aucune écriture facturée avant GPT-5.6 |
| GPT-5.6 et suivants | Écritures en cache possiblement facturées (cache_write_tokens), prompt_cache_key pour regrouper les requêtes de même préfixe (au-delà d'environ 15 requêtes par minute sur une même clé, des requêtes peuvent rater le cache), breakpoints explicites (prompt_cache_breakpoint, mode implicit ou explicit, TTL minimal 30m) ; non supportés en PTU, et 400 si on les envoie à un modèle plus ancien |
| Résidence | Cache en mémoire compatible avec toutes les régions ; la rétention étendue reste dans la zone (Data Zone) ou la région (Regional) |
7.2 Structurer l'invite pour en profiter#
- Stable au début : system prompt, consignes, exemples few-shot, définitions d'outils, schéma de sortie.
- Variable à la fin : date, identifiant de session ou d'utilisateur, extraits RAG de la question, question.
- Historique en ajout seul (append-only) : ne pas réécrire ni réordonner les tours précédents.
- Ne pas glisser d'horodatage, de GUID ou de nom d'utilisateur dans le system prompt : c'est l'anti-modèle le plus fréquent.
- Garder un flux régulier de requêtes au même préfixe ; un deployment par type de charge améliore aussi le taux de cache.
7.3 Mesurer#
| Où | Quoi |
|---|---|
| Réponse | cached_tokens (et cache_write_tokens sur GPT-5.6+ en Standard) |
| Azure Monitor | Prompt Token Cache Match Rate (AzureOpenAIContextTokensCacheMatchRate), pour les deployments PTU |
| Langfuse | Clés input_* du usage_details (jetons en cache stockés séparément de input) |
Piège : un
cached_tokensqui tombe à 0 après une mise en production = le début du prompt a changé (nouvelle version du system prompt, outil ajouté en tête, variable injectée). Comparer les 1 024 premiers jetons avant / après.
8. Paramètres de génération#
| Paramètre | Effet | Conseil support |
|---|---|---|
temperature (0 à 2, défaut 1) |
Plus haut = plus varié ; plus bas = plus déterministe | Bas (≈ 0 à 0,3) pour un chatbot factuel ancré ; modifier temperature ou top_p, pas les deux |
top_p (0 à 1) |
Ne garde que les jetons dans la masse de probabilité top_p |
Laisser à 1 si l'on règle temperature |
max_tokens (ancien) / max_completion_tokens (Chat) / max_output_tokens (Responses) |
Plafond de sortie (raisonnement compris pour les reasoning models) | Taille réelle des réponses + marge : impacte coût, latence et limite de débit |
stop (jusqu'à 4 séquences) |
Arrête la génération | Évite des jetons inutiles |
reasoning_effort, verbosity |
Profondeur de raisonnement, longueur de la réponse visible | Premiers réglages coût / latence d'un reasoning model |
seed |
Échantillonnage reproductible « au mieux » | Aucune garantie de déterminisme ; retiré dans la Responses API |
Un reasoning model refuse temperature, top_p et les pénalités : une erreur 400 après un changement de modèle vient souvent
d'un paramètre resté dans le code. Détails et exemples : AI-103, 07.
9. Content filters et erreurs HTTP#
Les guardrails (ex-content filters) de Foundry analysent l'entrée et la sortie (haine, violence, contenu sexuel, auto-agression, jailbreak, injection indirecte, contenu protégé). Configuration et catégories : AI-103, 04.
| Ce que voit l'application | Signification | Facturé ? | Action support |
|---|---|---|---|
HTTP 400, "code": "content_filter" |
L'invite est bloquée | Oui (l'invite a été évaluée) | Lire le détail des catégories ; souvent un extrait RAG ou un jailbreak, pas la question ; ne pas renvoyer telle quelle |
HTTP 200, finish_reason: "content_filter" |
La réponse a été filtrée (vide ou partielle) | Oui, entrée + sortie générée | Afficher un message utile ; analyser la trace |
Annotations content_filter_results / content_filters |
Résultats par catégorie (mode annotation possible) | — | Si l'objet contient une erreur, le filtrage n'a pas tourné |
| Streaming en Asynchronous Filter | Le signal de filtrage arrive en retard (dans une fenêtre d'environ 1 000 caractères) | Oui | L'application doit retirer le texte déjà affiché |
| Code | Causes fréquentes (page officielle Troubleshoot common HTTP errors) | Première vérification |
|---|---|---|
| 400 | Payload invalide, context_length_exceeded, paramètre non supporté (reasoning model), content filter |
Lire error.code et error.message |
| 401 | Clé invalide, jeton Entra expiré, mauvaise audience ou rôle RBAC manquant | Scope https://ai.azure.com/.default, rôle Cognitive Services OpenAI User ou Foundry User |
| 403 | Réseau refusé (pare-feu, Private Endpoint, DNS qui ne résout pas l'IP privée, NSG) ; ressource suspendue pour abus (« resource has been temporarily blocked ») | Onglet Networking, nslookup <resource>.openai.azure.com depuis le pod ou la Web App |
| 404 | Mauvais endpoint, nom de deployment inexistant, version d'API non supportée | az cognitiveservices account deployment list |
| 429 | Section 3.3 | Message + en-têtes |
| 500 / 503 | Incident transitoire | Retry avec backoff ; Azure Service Health si cela dure plusieurs minutes |
10. Lire les jetons dans les logs et dans Langfuse#
10.1 Azure Monitor (ressource Foundry / Azure OpenAI)#
| Métrique | Nom REST | Usage |
|---|---|---|
| Processed Prompt Tokens | ProcessedPromptTokens |
Jetons d'entrée, par ModelDeploymentName |
| Generated Completion Tokens | GeneratedTokens |
Jetons de sortie |
| Processed Inference Tokens | TokenTransaction |
Entrée + sortie |
| Azure OpenAI Requests | — | Requêtes, à découper par StatusCode et deployment |
| Provisioned-managed Utilization V2 | AzureOpenAIProvisionedManagedUtilizationV2 |
Saturation PTU (≥ 100 % = 429) |
Les métriques sont gardées 30 jours ; pour les croiser dans Log Analytics, un diagnostic setting doit envoyer les métriques
(table AzureMetrics) :
// Jetons d'entrée et de sortie par deployment et par heure (métriques exportées par diagnostic setting)
AzureMetrics
| where ResourceProvider == "MICROSOFT.COGNITIVESERVICES"
| where MetricName in ("ProcessedPromptTokens", "GeneratedTokens")
| summarize Jetons = sum(Total) by MetricName, bin(TimeGenerated, 1h)
| render timechart
Dans Application Insights, les jetons n'apparaissent que si l'application les trace (instrumentation OpenTelemetry GenAI, ou attributs ajoutés au span de l'appel). Vérifier ce que le code envoie avant de chercher.
10.2 Langfuse#
| Notion Langfuse | Ce qu'il faut savoir |
|---|---|
Observation generation (ou embedding) |
Seules ces observations portent usage et coût |
usage_details |
Clés exclusives : input, output, plus des clés input_* (jetons en cache) et output_* (ex. output_reasoning_tokens) ; total = somme |
cost_details |
Coût en USD par clé d'usage |
| Coût ingéré ou inféré | Ingéré : envoyé par le SDK ou l'intégration (prioritaire) ; inféré : calculé par Langfuse à partir d'une model definition |
| Model definition | Prix par type d'usage + match_pattern (regex sur le champ model de la génération) ; définitions personnalisées prioritaires ; un changement de prix ne s'applique qu'aux nouvelles générations |
| Reasoning models | Langfuse ne peut pas deviner les jetons de raisonnement : sans usage ingéré, le coût est faux |
Pièges Langfuse en support : coût à 0 ou absent = pas d'usage ingéré ou aucun
match_patternne correspond au nom de modèle enregistré (avec Azure, ce nom peut être celui du deployment, propre au client) ; coût sous-estimé sur un reasoning model = usage non ingéré ; jetons en double = format OpenAI « inclusif » (cached compris dans prompt) envoyé à plat sans conversion. Toujours comparer le coût Langfuse à Cost Management, qui fait foi pour la facture.
11. Erreurs fréquentes#
| Symptôme | Cause probable | Vérification | Correction |
|---|---|---|---|
| 429 alors que les métriques de jetons sont basses | max_tokens élevé, rafales sur 1 à 10 s, ajustement temporaire |
En-têtes x-ratelimit-*, métrique Requests par seconde |
Baisser max_tokens, lisser, répartir, PTU |
| 429 « high demand » | Capacité du service | Message d'erreur | Retry ; PTU si critique ; pas de demande de quota |
| Réponse vide, HTTP 200 | Reasoning model : budget de sortie consommé par le raisonnement | status, incomplete_details, reasoning_tokens |
Monter le plafond, baisser l'effort |
| Réponse coupée au milieu | finish_reason: length |
Bloc usage, plafond configuré |
Plafond plus haut ou réponse plus concise |
| Facture qui double sans hausse de trafic | Passage à un reasoning model ou à un effort plus élevé ; plus de chunks ; historique non tronqué | reasoning_tokens, input_tokens moyens avant / après |
Effort, top k, troncature de l'historique |
cached_tokens à 0 après un déploiement |
Préfixe modifié (horodatage, outil, nouvelle version du prompt) | Comparer les débuts de prompt | Remettre le contenu stable en tête |
| Latence en hausse sans hausse des jetons | Pression de capacité, cache perdu | TTFT vs jetons de sortie, 429 | Retry, PTU, deployment dédié |
| 400 après changement de modèle | Paramètre non supporté (temperature, max_tokens) |
Message d'erreur | Adapter les paramètres au modèle |
| 401 depuis AKS, OK en local | Workload Identity mal fédérée ou rôle absent | Jeton, audience, rôle sur la ressource | Rôle Cognitive Services OpenAI User, scope du jeton |
| 403 depuis la Web App | Réseau : Private Endpoint, DNS privé, pare-feu de la ressource | nslookup depuis la Web App (console Kudu) |
Zone DNS privée, VNet integration |
| Ingestion lente, 429 Document Intelligence | 15 TPS dépassés, polling trop fréquent | Monitoring de la ressource | Lissage, polling toutes les 2 s minimum, demande de hausse TPS |
12. Lab#
Objectif : mesurer jetons, cache, coût et latence d'un deployment de test (abonnement de test, rien en production).
- Déployer un modèle en Global Standard avec une petite capacité (ou réutiliser un deployment de test) ; donner à son compte le rôle Cognitive Services OpenAI User.
- Écrire un system prompt stable de plus de 1 024 jetons (consignes + exemples) et envoyer 5 questions différentes à quelques secondes d'intervalle, en Responses API.
- Pour chaque réponse, afficher
input_tokens,cached_tokens,output_tokens,reasoning_tokens, TTFT et TTLT (code des sections 5.2 et 6.2). Attendu :cached_tokens= 0 à la 1re requête, puis ≥ 1 024 (multiple de 128 au-delà) ensuite. - Ajouter la date et l'heure au début du system prompt, relancer. Attendu :
cached_tokensretombe à 0. - Avec un reasoning model, comparer
reasoning={"effort": "low"}et"high"sur la même question : jetons de raisonnement, TTLT, coût calculé. - Mettre
max_output_tokensà 50 sur l'efforthigh. Attendu :status: incomplete, parfois sans texte. - Dans Azure Monitor, afficher
GeneratedTokenset Time to Last Byte découpés par deployment.
Coût : quelques centimes. Nettoyage : supprimer le deployment de test.
13. Questions d'entretien#
1. Quelle différence entre un modèle de chat et un reasoning model, et quel impact en support ?
Le reasoning model génère des jetons de raisonnement cachés avant la réponse ; ils sont facturés en sortie et rallongent la latence.
En support : coût et latence plus variables, paramètres refusés (temperature, max_tokens), réponses incomplete si le plafond
est trop bas. On règle reasoning_effort avant de changer de modèle.
2. Qu'est-ce qu'un jeton et pourquoi tout se compte en jetons ?
L'unité de lecture et d'écriture du modèle (sous-mot, ≈ 4 caractères en anglais). Le prix, la limite de débit (TPM), la fenêtre de
contexte et la latence s'expriment en jetons. On les lit dans usage, jamais en estimant à partir du nombre de mots.
3. On a des 429 mais le graphe de jetons est à 40 % du quota. Explication ?
La limite se calcule à l'arrivée sur une estimation (invite + max_tokens), le RPM sur des fenêtres de 1 à 10 s, et les
métriques ne montrent que les jetons facturés des requêtes réussies. Je lis le message (quota ou capacité), les en-têtes
x-ratelimit-*, je vérifie max_tokens et les rafales.
4. Comment distinguer un 429 de quota d'un 429 de capacité ?
Par le message : « Rate limit is exceeded » = quota du deployment ; « temporarily unable to process / high demand » = capacité du
service. Et par x-ratelimit-limit-tokens inférieur au TPM configuré = ajustement temporaire. Demander du quota ne règle pas un 429
de capacité ; retry ou PTU.
5. Comment fonctionne le prompt caching sur Azure OpenAI ?
Automatique sur les modèles pris en charge, à partir de 1 024 jetons dont les 1 024 premiers identiques ; incréments de 128 jusqu'à
GPT-5.5 ; cache vidé après 5 à 10 min d'inactivité (24 h en rétention étendue) ; jamais partagé entre abonnements ; jetons lus en
cache remisés (jusqu'à 100 % en PTU). Visible dans cached_tokens. On met le contenu stable au début.
6. Pourquoi la sortie domine-t-elle la latence et le coût ? Chaque jeton de sortie est généré séquentiellement (TTLT = TTFT + TBT × jetons générés) et coûte plus cher qu'un jeton d'entrée. L'invite est traitée en parallèle et pèse surtout sur le TTFT.
7. Le streaming rend-il le modèle plus rapide ? Non. Il réduit le temps perçu (premier jeton affiché tôt), pas le temps total. Avec un reasoning model, le premier jeton visible arrive après le raisonnement.
8. Quel deployment type pour un chatbot interne européen ? Data Zone Standard (traitement dans la zone EU) pour démarrer, Data Zone Provisioned si le volume est stable et la latence critique, avec spillover vers Standard. Global Standard si la résidence n'est pas exigée.
9. Quelle est la différence entre context_length_exceeded et finish_reason: length ?
Le premier est un 400 : l'entrée dépasse la limite, rien n'est généré. Le second est un 200 : la sortie a atteint son plafond, la
réponse est tronquée. Correction différente : réduire l'entrée (historique, chunks) ou monter le plafond de sortie.
10. Comment estimer le coût mensuel d'un chatbot ? Jetons moyens par question (entrée, dont cache ; sortie, dont raisonnement) × prix par million × nombre de questions, plus Document Intelligence (pages), AI Search (SU + semantic ranker), embeddings d'indexation et de requête. Puis comparer avec Cost Management.
11. Pourquoi mon coût Langfuse ne correspond-il pas à la facture ?
Coût inféré à partir d'une model definition (prix ou match_pattern faux, nom de deployment Azure non reconnu), jetons de
raisonnement non ingérés, prix modifié après coup (non rétroactif). Cost Management fait foi.
12. Le bot renvoie parfois une réponse vide avec un HTTP 200. Que regardez-vous ?
finish_reason (content_filter ou length), et pour la Responses API status et incomplete_details.reason. Puis
reasoning_tokens : souvent un plafond de sortie consommé par le raisonnement.
13. Un 400 content_filter sur une question anodine ?
L'entrée contient aussi les extraits RAG et l'historique : un document indexé peut déclencher le filtre (ou une injection indirecte).
Je lis les catégories dans l'erreur et la trace des chunks envoyés. La requête est facturée.
14. Quand choisir des PTU ? Débit élevé et constant, besoin de latence stable ou d'un SLA de latence. On dimensionne avec le capacity calculator et un benchmark, on surveille Provisioned-managed Utilization V2, on active le spillover. Les 429 en PTU sont un signal de régulation normal.
14. Fiche à retenir#
- Familles : chat, reasoning (jetons cachés facturés en sortie), embeddings (même modèle et même dimension partout), multimodal,
OCR (Document Intelligence
prebuilt-layout→ Markdown), reranker (semantic ranker 0–4). - Jetons : entrée, entrée en cache, sortie, raisonnement ; lire
usage(Chat :prompt_tokens… ; Responses :input_tokens…). - Contexte partagé entre entrée, raisonnement et sortie ;
context_length_exceeded(400) ≠length/incomplete(200). - Limite de débit = estimation invite +
max_tokens; RPM sur 1 à 10 s ; 429 quota ≠ 429 capacité ;retry-after-ms. - Coût = prix par million × (entrée non cachée, en cache, sortie) ; Batch −50 % ; PTU à l'heure ; 400 content filter facturé, 429 non.
- Latence : TTLT = TTFT + TBT × jetons générés ; toujours une latence avec un nombre de jetons.
- Prompt caching : ≥ 1 024 jetons identiques en tête, automatique, 5–10 min,
cached_tokens; stable au début, variable à la fin. - Reasoning :
reasoning_effort, plafondmax_output_tokens/max_completion_tokens, pas detemperature. - Erreurs : 400 (payload, contexte, filtre), 401 (jeton, audience, rôle), 403 (réseau, abus), 404 (deployment), 429, 5xx.
- Langfuse :
usage_details/cost_details, ingéré > inféré,match_pattern, reasoning non devinable ; Cost Management fait foi.
Références#
Relevé du 23/10/2026.
- Foundry Models sold by Azure (modèles, fenêtres de contexte, Cohere, Mistral, model router) : https://learn.microsoft.com/azure/foundry/foundry-models/concepts/models-sold-directly-by-azure
- Deployment types for Microsoft Foundry Models : https://learn.microsoft.com/azure/foundry/foundry-models/concepts/deployment-types
- Overview of Microsoft Foundry Models : https://learn.microsoft.com/azure/foundry/concepts/foundry-models-overview
- Manage Azure OpenAI quota (rate limits, 429, en-têtes) : https://learn.microsoft.com/azure/foundry/openai/how-to/quota
- Azure OpenAI 429: token and request rate limits explained : https://learn.microsoft.com/microsoft-cloud/dev/dev-proxy/concepts/azure-openai-429-token-rate-limit
- Azure OpenAI reasoning models : https://learn.microsoft.com/azure/foundry/openai/how-to/reasoning
- Prompt caching : https://learn.microsoft.com/azure/ai-foundry/openai/how-to/prompt-caching
- Performance and latency : https://learn.microsoft.com/azure/foundry/openai/how-to/latency
- Azure OpenAI monitoring data reference : https://learn.microsoft.com/azure/foundry/openai/monitor-openai-reference
- Plan to manage costs for Azure OpenAI : https://learn.microsoft.com/azure/ai-foundry/openai/how-to/manage-costs
- Azure OpenAI FAQ (facturation des appels en échec) : https://learn.microsoft.com/azure/ai-foundry/openai/faq
- What is Azure OpenAI (jetons texte et image) : https://learn.microsoft.com/azure/ai-foundry/openai/overview
- Content filtering overview : https://learn.microsoft.com/azure/ai-foundry/openai/concepts/content-filter
- Content streaming (Asynchronous Filter, facturation) : https://learn.microsoft.com/azure/foundry/openai/concepts/content-streaming
- Troubleshoot common HTTP errors for Azure OpenAI : https://learn.microsoft.com/azure/foundry/openai/how-to/troubleshoot-errors
- Document Intelligence layout model : https://learn.microsoft.com/azure/ai-services/document-intelligence/prebuilt/layout?view=doc-intel-4.0.0
- Document Intelligence read model (formats, limites) : https://learn.microsoft.com/azure/ai-services/document-intelligence/prebuilt/read?view=doc-intel-4.0.0
- Document Intelligence service quotas and limits : https://learn.microsoft.com/azure/ai-services/document-intelligence/service-limits?view=doc-intel-4.0.0
- Semantic ranking in Azure AI Search : https://learn.microsoft.com/azure/search/semantic-search-overview
- Azure OpenAI pricing (prix à jour) : https://azure.microsoft.com/pricing/details/azure-openai/
- Langfuse, token and cost tracking : https://langfuse.com/docs/observability/features/token-and-cost-tracking