
Version : 1.1 · Date : 2026-10-22 · Domaine 3 de l'examen : Design and implement build and release pipelines (50 à 55 %), bloc Design and implement deployments
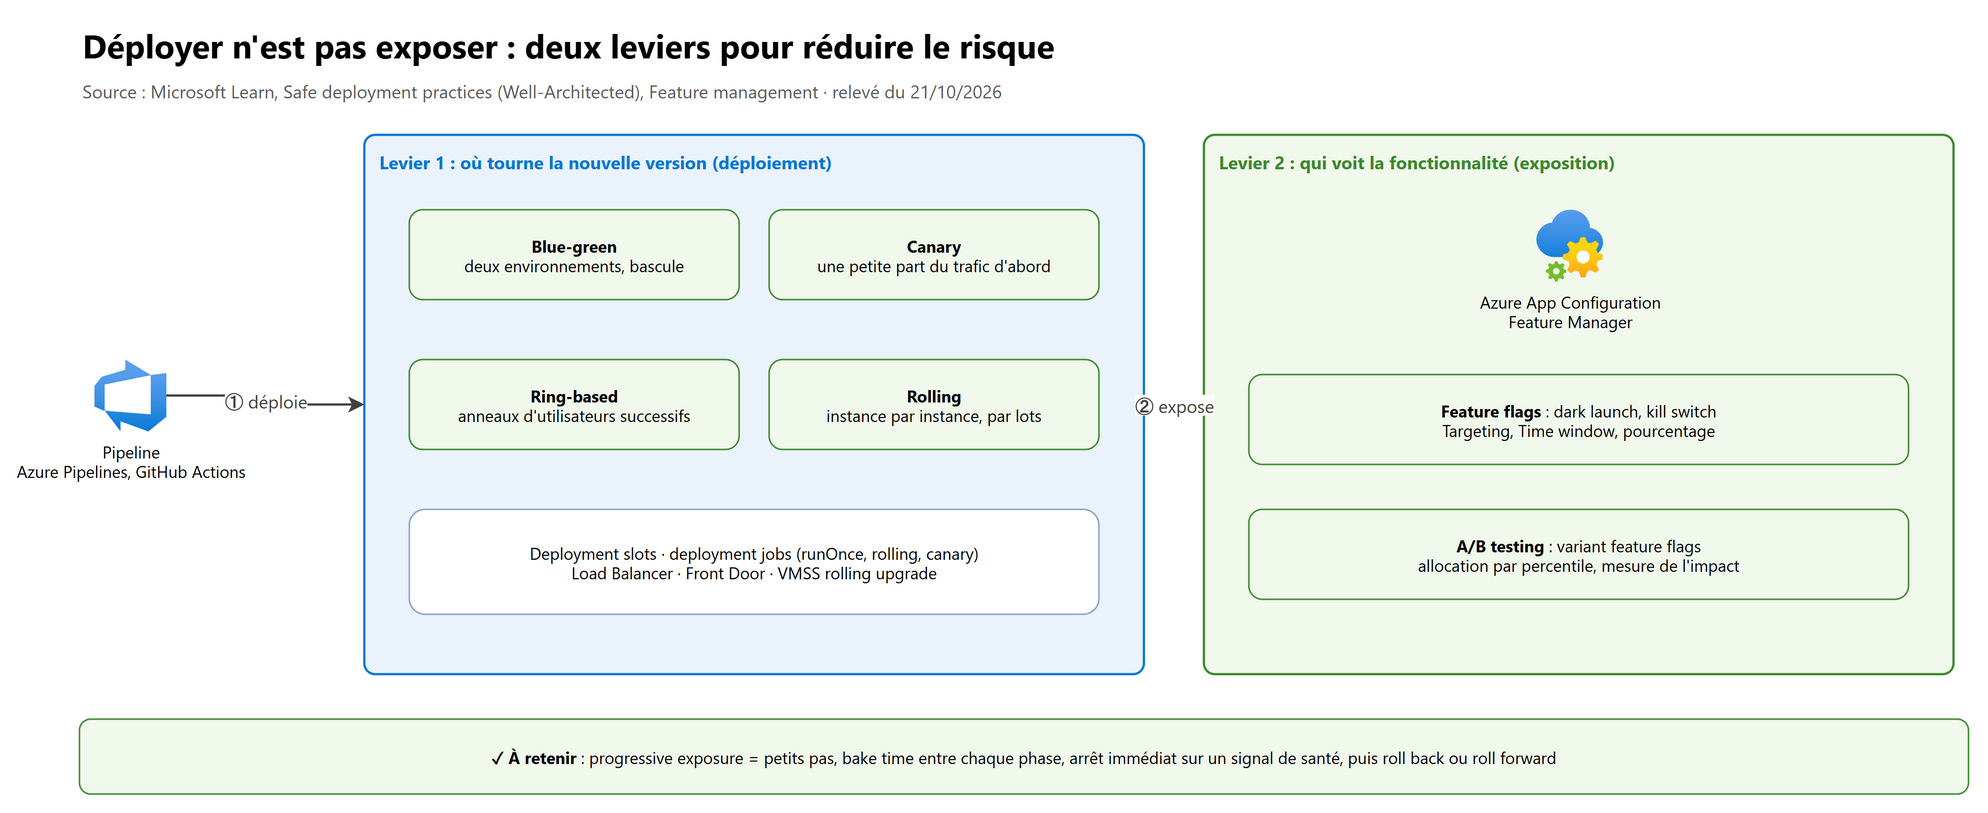
En une phrase : un bon déploiement sépare deux décisions, où tourne la nouvelle version (blue-green, canary, ring, rolling, deployment slots) et qui voit la fonctionnalité (feature flags), avance par petits pas surveillés, sait revenir en arrière ou corriger vers l'avant, et traite la base de données comme la partie la plus délicate.
Ce que l'examen demande#
Texte officiel du guide d'étude AZ-400 (compétences au 27 juillet 2026) :
| # | Compétence mesurée (guide officiel, en anglais) | Section |
|---|---|---|
| 1 | Design a deployment strategy, including blue-green, canary, ring, progressive exposure, feature flags, and A/B testing | 2 |
| 2 | Design a pipeline to ensure that dependency deployments are reliably ordered | 3 |
| 3 | Plan for minimizing downtime during deployments by using load balancing, rolling deployments, and deployment slot usage and swap | 4 |
| 4 | Design a hotfix path plan for responding to high-priority code fixes | 5 |
| 5 | Design and implement a resiliency strategy for deployment | 6 |
| 6 | Implement feature flags by using Azure App Configuration Feature Manager | 7 |
| 7 | Implement application deployment by using containers, binaries, and scripts | 8 |
| 8 | Implement a deployment that includes database tasks | 9 |
Les pipelines eux-mêmes (YAML, stages, environments, checks et approvals) sont au chapitre 04, l'infrastructure as code au chapitre 06, les secrets et service connections au chapitre 07.
1. Les bases à maîtriser#
1.1 Le vocabulaire#
| Terme | Ce qu'il veut dire |
|---|---|
| Deployment | Installer une nouvelle version sur une infrastructure |
| Release (au sens « mise en service ») | Rendre une fonctionnalité visible aux utilisateurs ; avec un feature flag, c'est une décision distincte du déploiement |
| Progressive exposure | Exposer la nouvelle version à des groupes de plus en plus larges, en vérifiant la santé entre chaque étape |
| Bake time | Le temps d'observation entre deux groupes ; Microsoft le compte en heures et en jours, pas en minutes, et le fait croître d'un groupe à l'autre |
| Health model | L'ensemble des signaux qui disent si la charge de travail va bien (erreurs, latence, usage) ; un signal négatif arrête le déploiement |
| Roll back | Revenir à la dernière configuration connue bonne |
| Roll forward | Corriger pendant le déploiement (hotfix) au lieu de revenir en arrière |
| N / N-1 | Pendant un déploiement progressif, la version N et la version N-1 tournent en même temps : tout (API, base, messages) doit supporter les deux |
1.2 Les quatre principes des safe deployment practices#
Le guide Well-Architected (OE:11) résume la démarche en quatre idées :
- Sécurité et cohérence : aucun déploiement n'est « à faible risque » ; tout passe par le même chemin automatisé.
- Exposition progressive : limiter le blast radius d'un problème.
- Health model : chaque phase ne commence qu'après des contrôles de santé réussis.
- Détection : au premier problème, on arrête et on lance la récupération.
Petits déploiements fréquents plutôt que gros déploiements rares ; post-mortems blameless après un incident.
2. Concevoir une stratégie de déploiement#
2.1 Les stratégies côte à côte#
| Stratégie | Principe | Retour arrière | Coût et contraintes | Outils Azure typiques |
|---|---|---|---|---|
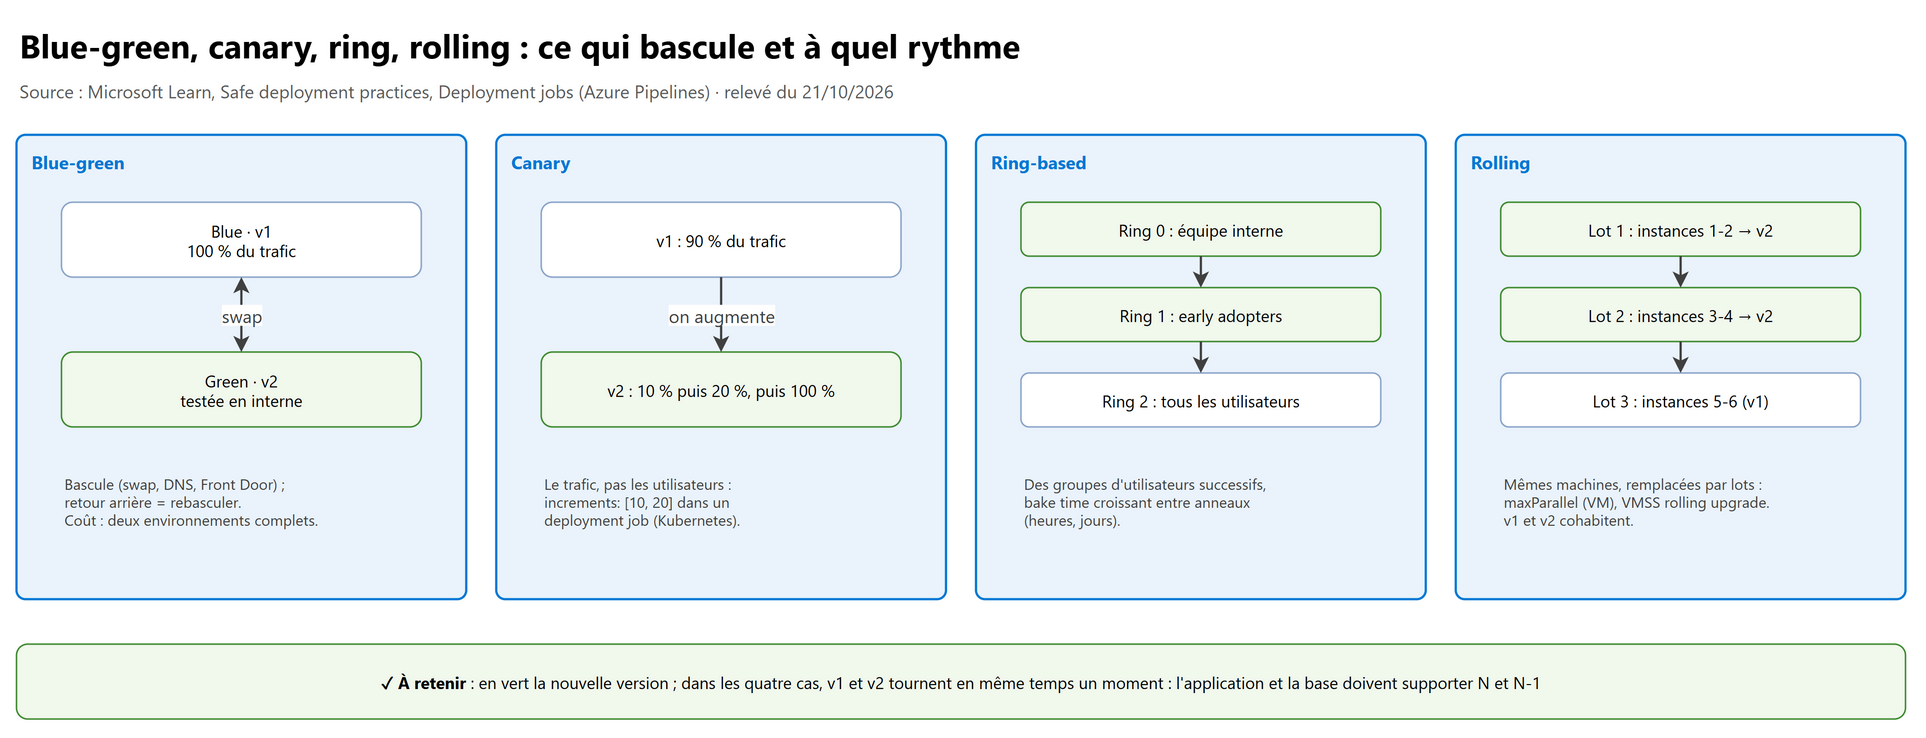
| Blue-green | Deux environnements identiques, chacun capable de toute la charge ; on teste green, puis on bascule le trafic (en une fois ou par vagues) | Rebasculer vers blue | Deux environnements complets ; état et base partagés à gérer | Deployment slots + swap, Front Door / Traffic Manager, deux clusters AKS |
| Canary | Une petite part du trafic va d'abord vers la nouvelle version, puis on augmente | Renvoyer 0 % vers le canary | Il faut mesurer finement la santé du canary | Traffic % d'un slot, deployment job canary sur Kubernetes, poids Front Door |
| Ring-based | Des groupes d'utilisateurs successifs (interne, early adopters, tous) | Arrêter avant l'anneau suivant | Bake time long, plusieurs versions en production | Stages de pipeline par anneau, feature flags par groupe |
| Rolling | Les instances d'un même pool sont remplacées par lots | Redéployer l'ancienne version, lot par lot | Capacité réduite pendant le lot (sauf surge) | Deployment job rolling (VM), VMSS Rolling upgrade policy, rolling update Kubernetes |
| Progressive exposure | Le principe général derrière canary et ring | — | — | Combinaison des précédents |
| Feature flags | Le code est déployé partout mais désactivé ; on l'active pour qui on veut (dark launch, kill switch) | Désactiver le flag, sans redéployer | Dette technique si on ne retire pas les flags | Azure App Configuration Feature Manager (section 7) |
| A/B testing | Deux variantes (ou plus) servies à des segments, pour mesurer laquelle est meilleure | Revenir à une variante | Il faut de la télémétrie et une hypothèse à tester | Variant feature flags (allocation par percentile) |
Distinction d'examen : un canary répartit du trafic (ou des instances) ; un ring répartit des utilisateurs ; un feature flag ne change pas l'endroit où tourne le code, seulement ce qu'il montre. Blue-green et canary se combinent souvent : green reçoit d'abord une petite part du trafic.
2.2 Choisir#
flowchart TD
    A["Nouvelle version à livrer"] --> B{"Changement visible<br/>pour l'utilisateur ?"}
    B -- "Oui" --> C["Feature flag :<br/>déployer éteint, activer par groupes"]
    B -- "Non (technique)" --> D{"Deux environnements<br/>possibles ?"}
    C --> D
    D -- "Oui (App Service, AKS, stamps)" --> E{"Valider sur du vrai trafic<br/>avant de tout basculer ?"}
    D -- "Non (un seul pool de VM)" --> F["Rolling par lots<br/>avec health checks"]
    E -- "Oui" --> G["Canary : 10 %, 20 %, puis 100 %"]
    E -- "Non" --> H["Blue-green : swap, rebascule possible"]
    G --> I["Grandes populations ou régions :<br/>rings avec bake time croissant"]
2.3 Ce qui doit être vrai pour que ça marche#
- Versionner les artefacts : on ne peut revenir en arrière que vers une version identifiable.
- Compatibilité N / N-1 : l'API, le schéma de base, les messages en file doivent fonctionner avec les deux versions.
- Branching : Microsoft recommande release flow ou trunk-based plutôt que Gitflow ou des branches par environnement (voir chapitre 02).
- Environnements de staging qui ressemblent à la production, contrôles avant déploiement (revue, scans, conformité), et plusieurs types de tests.
3. Ordonner les déploiements dépendants#
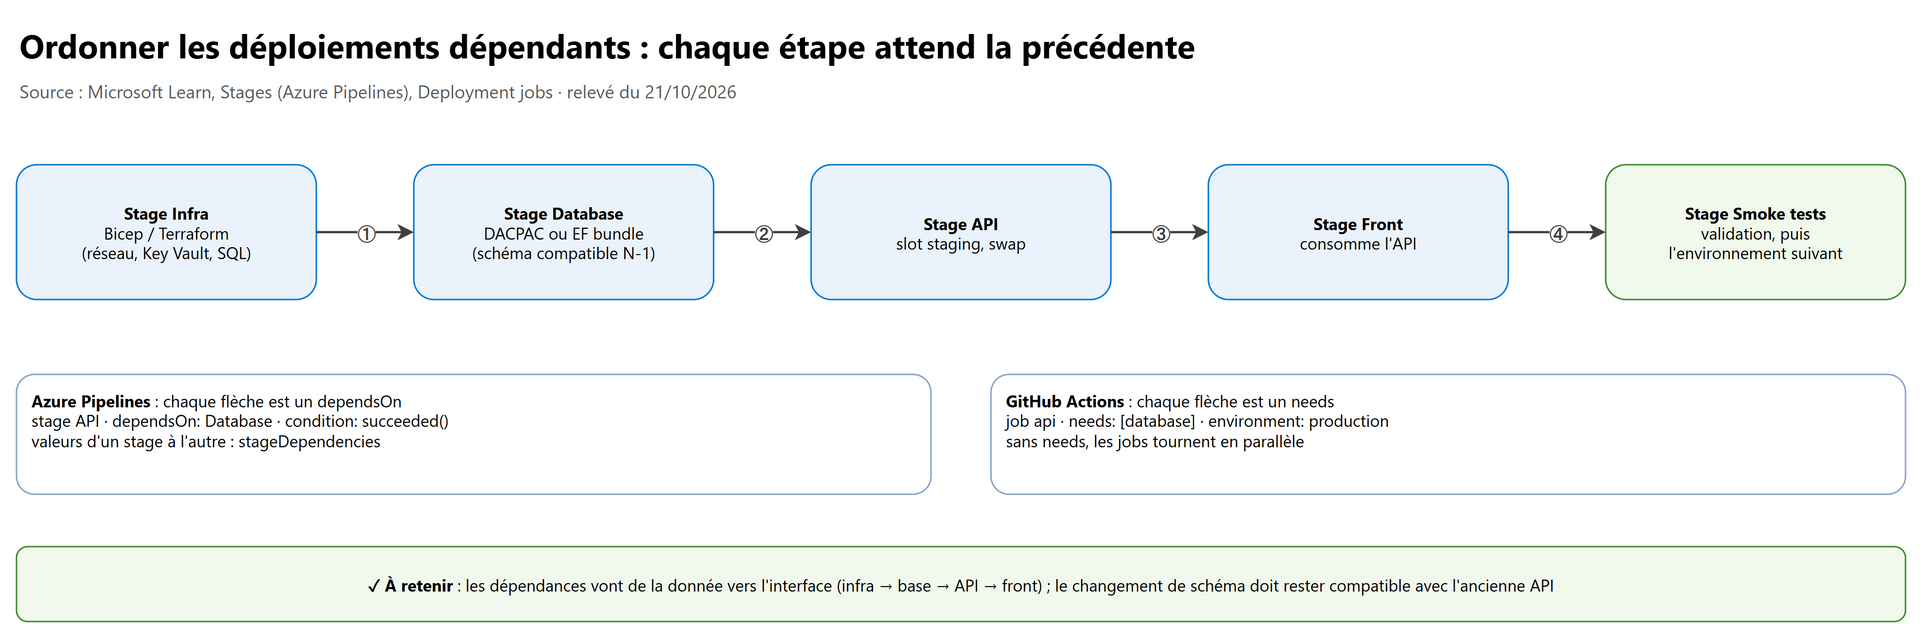
Le principe : on déploie de la donnée vers l'interface. L'infrastructure d'abord, puis la base (avec un schéma compatible avec l'ancienne application), puis les API, puis les clients qui les consomment, puis les tests de fumée qui ouvrent l'environnement suivant.
Azure Pipelines : dependsOn et condition au niveau des stages (ou des jobs). Sans dependsOn, les stages s'enchaînent
dans l'ordre du fichier ; dependsOn: [] les rend parallèles.
stages:
- stage: Infra
  jobs:
  - deployment: DeployInfra
    environment: prod
    strategy:
      runOnce:
        deploy:
          steps:
          - script: echo "az deployment group create … (Bicep)"

- stage: Database
  dependsOn: Infra
  condition: succeeded()
  jobs:
  - deployment: DeployDb
    environment: prod
    strategy:
      runOnce:
        deploy:
          steps:
          - script: echo "sqlpackage /Action:Publish …"

- stage: Api
  dependsOn: Database
  condition: succeeded()
  jobs:
  - deployment: DeployApi
    environment: prod
    strategy:
      runOnce:
        deploy:
          steps:
          - script: echo "déploiement de l'API dans le slot staging, puis swap"
Pour passer une valeur d'un stage à l'autre (par exemple l'URL de l'API créée par l'infra), on publie une output variable
(##vso[task.setvariable variable=…;isOutput=true]) et on la lit avec stageDependencies.<stage>.<job>.outputs['…'].
GitHub Actions : needs: au niveau des jobs. Les jobs sans needs tournent en parallèle ; un job ne démarre que si ceux
qu'il attend ont réussi. L'environment: d'un job porte ses règles de protection.
jobs:
  infra:
    runs-on: ubuntu-latest
    environment: production
    steps:
      - run: echo "déploiement Bicep"
  database:
    needs: infra
    runs-on: ubuntu-latest
    environment: production
    steps:
      - run: echo "déploiement du schéma"
  api:
    needs: [infra, database]
    runs-on: ubuntu-latest
    environment: production
    steps:
      - run: echo "déploiement de l'API"
Dans l'IaC elle-même, Bicep ordonne les ressources grâce aux références entre elles (dépendances implicites) ; l'ordre des applications reste l'affaire du pipeline.
4. Minimiser l'indisponibilité : load balancing, rolling et deployment slots#
4.1 La règle#
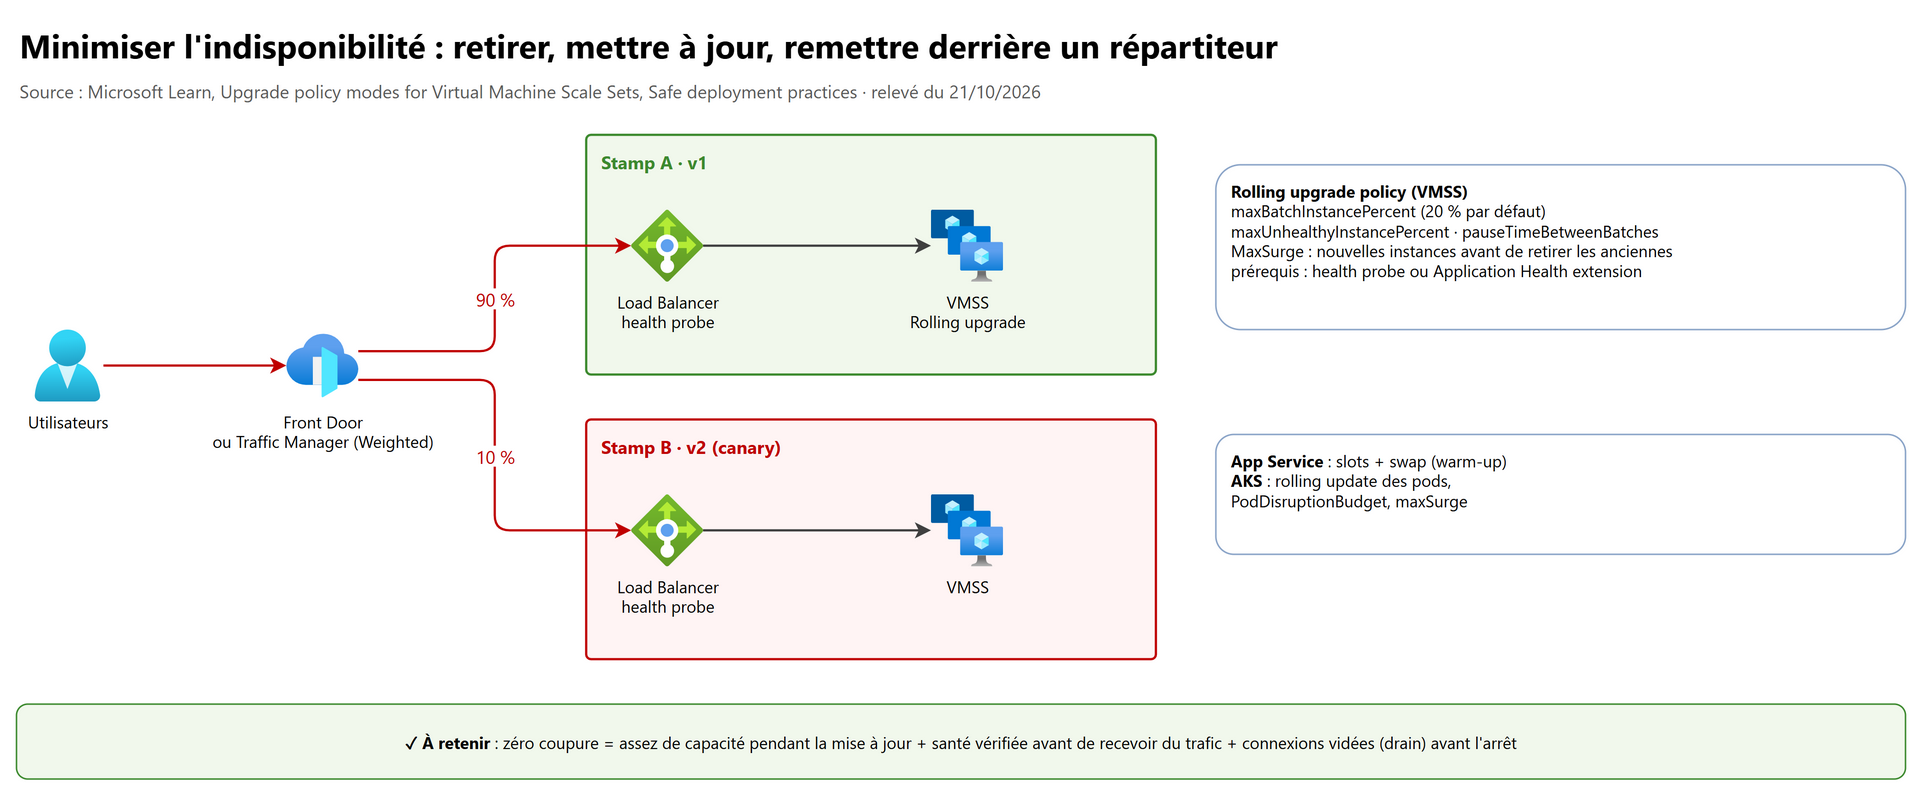
Zéro coupure suppose trois choses : assez de capacité pendant la mise à jour, une santé vérifiée avant qu'une instance reçoive du trafic (health probe), et des connexions vidées avant d'arrêter une instance.
| Levier | Comment il évite la coupure |
|---|---|
| Load Balancer, Application Gateway, Front Door, Traffic Manager | Sortir une instance ou une région du pool, la mettre à jour, la remettre ; répartir le trafic par poids (Traffic Manager Weighted, poids des origins de Front Door) |
| Rolling deployment | Mettre à jour par lots ; le reste du pool sert le trafic |
| Deployment slots + swap | Chauffer la nouvelle version dans un slot, puis échanger le routage : aucune requête perdue |
4.2 Rolling sur des VM#
- Deployment job
rolling(Azure Pipelines) : uniquement pour des ressources VM d'un environment ;maxParallelfixe le nombre ou le pourcentage de cibles mises à jour en même temps (5 cibles maximum par itération dans l'exemple officiel). - Virtual Machine Scale Sets : trois upgrade policy modes : Automatic (aucune garantie d'ordre, toutes les instances peuvent tomber en même temps : réservé au dev/test), Manual (vous choisissez quand), Rolling (par lots).
# Passer un scale set en Rolling, lots de 10 %, avec MaxSurge (nouvelles instances avant de retirer les anciennes)
az vmss update --name vmss-web --resource-group rg-web \
  --set upgradePolicy.mode=Rolling \
  --max-batch-instance-percent 10 --max-unhealthy-instance-percent 20 \
  --max-unhealthy-upgraded-instance-percent 20 --prioritize-unhealthy-instances true \
  --pause-time-between-batches PT2S --max-surge true
Le mode Rolling exige un health probe de load balancer ou l'Application Health extension ; Microsoft conseille de créer
le scale set en Manual, de vérifier que la santé remonte bien, puis de passer en Rolling. maxBatchInstancePercent vaut 20 % par
défaut.
4.3 Deployment slots (App Service et Functions)#
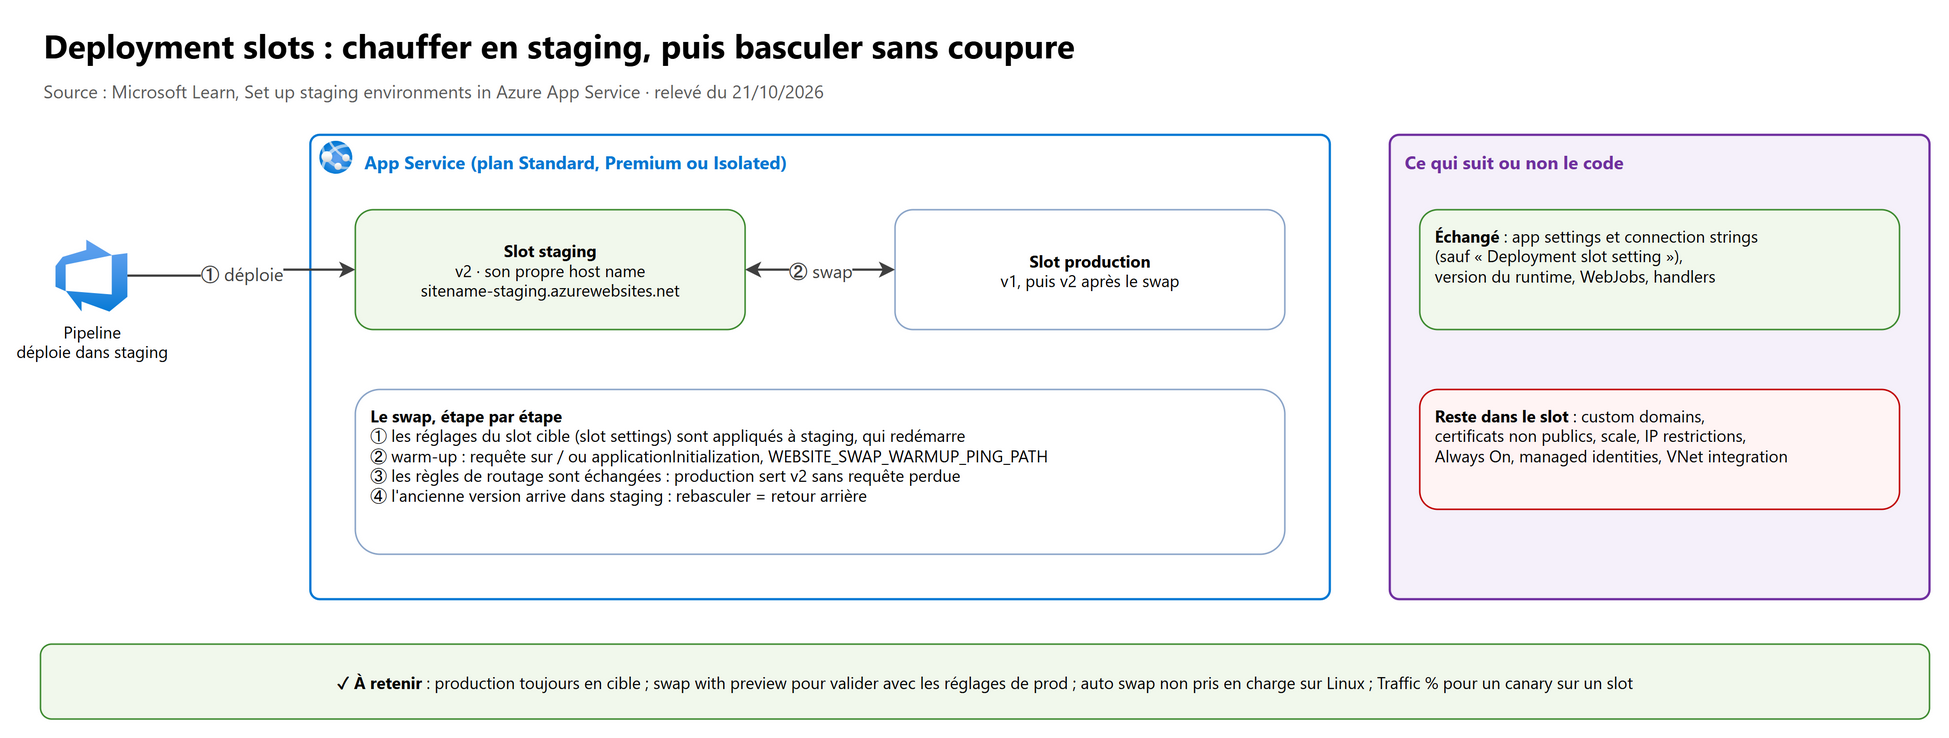
- Disponibles à partir des plans Standard, Premium ou Isolated ; le nombre de slots dépend du niveau (5 en Standard). Pas de coût supplémentaire.
- Chaque slot est une application vivante, avec son propre host name (
sitename-slotname.azurewebsites.net). - Un nouveau slot est vide, même si l'on clone la configuration ; un private endpoint n'est pas cloné.
Ce que fait le swap, dans l'ordre : les réglages propres au slot cible (slot settings, continuous deployment, App Service
authentication) sont appliqués au slot source, qui redémarre ; App Service attend que toutes les instances redémarrent ; il
chauffe chaque instance (requête sur / ou applicationInitialization) ; puis il échange les règles de routage. Tout le
travail se fait sur le slot source : la production reste en ligne même si le swap échoue. Garder la production en cible.
# Créer un slot, y déployer, puis l'échanger avec la production
az webapp deployment slot create --name app-web --resource-group rg-web --slot staging
az webapp deployment slot swap --resource-group rg-web --name app-web --slot staging --target-slot production

# Swap with preview (en deux temps) : appliquer les réglages de prod au slot, vérifier, puis terminer… ou annuler
az webapp deployment slot swap -g rg-web -n app-web --slot staging --target-slot production --action preview
az webapp deployment slot swap -g rg-web -n app-web --slot staging --target-slot production --action swap
az webapp deployment slot swap -g rg-web -n app-web --slot staging --target-slot production --action reset

# Un réglage qui ne doit pas suivre le code (« Deployment slot setting »)
az webapp config appsettings set -n app-web -g rg-web --slot staging \
  --settings ENVIRONNEMENT=staging --slot-settings ENVIRONNEMENT

# Canary sur un slot : 15 % du trafic de production vers staging
az webapp traffic-routing set --resource-group rg-web --name app-web --distribution staging=15
| Réglages échangés (suivent le code) | Réglages non échangés (restent dans le slot) |
|---|---|
| App settings et connection strings (sauf ceux marqués Deployment slot setting), version du runtime, 32/64 bits, WebSockets, handler mappings, certificats publics, contenu des WebJobs, Hybrid Connections, service endpoints, CDN, path mappings | Custom domain names, certificats non publics et TLS, scale, planificateurs WebJobs, IP restrictions, Always On, réglages de logs de diagnostic, CORS, managed identities, VNet integration, protocoles (HTTPS Only, version TLS), publishing endpoints, réglages finissant par _EXTENSION_VERSION |
Autres points d'examen :
- Swap with preview : impossible si l'authentification de site est activée sur l'un des slots.
- Auto swap : chaque déploiement dans le slot source est automatiquement échangé après warm-up ; pas pris en charge sur Linux ni Web App for Containers.
- Warm-up personnalisé :
applicationInitializationdansWeb.config, ou les app settingsWEBSITE_SWAP_WARMUP_PING_PATH(ex./statuscheck) etWEBSITE_SWAP_WARMUP_PING_STATUSES(ex.200,202). - Retour arrière : refaire immédiatement le même swap.
- Routage manuel : le paramètre
x-ms-routing-name=staging(ouselfpour la production) épingle une session ; un client routé automatiquement reste sur son slot pendant une heure (cookiex-ms-routing-name).
Dans un pipeline : AzureWebApp@1 avec deployToSlotOrASE: true et slotName: staging, puis AzureAppServiceManage@0 avec
SwapWithProduction: true ; côté GitHub, azure/webapps-deploy@v3 avec slot-name: staging, puis le swap en CLI.
5. Le chemin d'un hotfix#
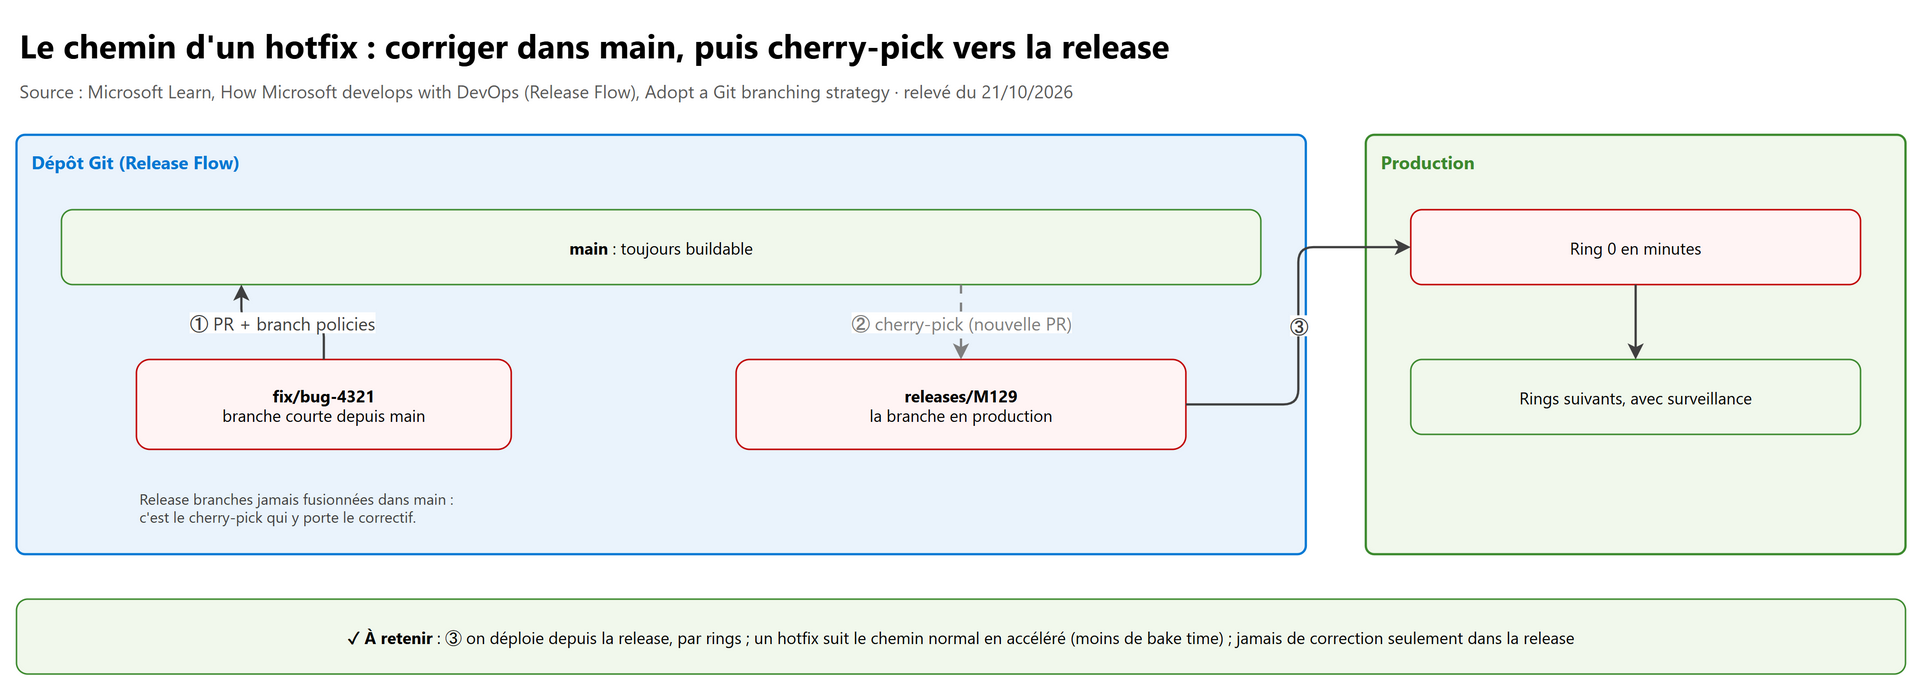
Avec le Release Flow de Microsoft : main est toujours buildable ; à chaque fin de sprint, une branche releases/M129 part de
main et va en production ; les release branches ne sont jamais fusionnées dans main.
Pour un correctif urgent :
- créer une branche courte depuis
main, faire la revue, compléter la pull request (avec ses branch policies) ; - depuis la page de la PR, cherry-pick vers la release branch : cela crée une nouvelle PR ciblant la release, revue et testée à son tour ;
- déployer depuis la release branch, d'abord sur le premier ring (en minutes), puis progressivement.
Corriger d'abord dans main garantit que le bug ne revient pas à la release suivante. Si deux releases sont en production en même
temps (déploiement par rings en cours), le hotfix est porté sur les deux.
Ce que dit Well-Architected pour l'urgence (emergency SDP protocols) : on peut accélérer les approbations, les tests et réduire le bake time, mais pas supprimer les gates ; il faut définir à l'avance qui peut approuver l'accélération et sur quels critères.
flowchart LR
    A["Incident en production"] --> B["Branche fix depuis main"]
    B --> C["PR vers main<br/>branch policies, tests"]
    C --> D["Cherry-pick vers releases/Mxxx<br/>nouvelle PR"]
    D --> E["Déploiement accéléré<br/>ring 0 puis rings suivants"]
    E --> F{"Santé OK ?"}
    F -- "Oui" --> G["Fin du hotfix"]
    F -- "Non" --> H["Arrêt, roll back<br/>ou nouveau correctif"]
6. Une stratégie de résilience pour le déploiement#
Un déploiement résilient détecte le problème tôt et sait récupérer :
| Option de récupération | Quand | Exemple |
|---|---|---|
| Roll back | Le changement est réversible (code, configuration) | Rebasculer un swap, KubernetesManifest@1 action: reject, redéployer l'artefact N-1 |
| Roll forward | Le retour arrière est risqué ou impossible (schéma de base déjà migré) | Hotfix via la release branch |
| Redéployer une infrastructure neuve | L'environnement est corrompu | IaC à partir de la dernière configuration connue bonne |
| Désactiver un feature flag | La fonctionnalité pose problème, pas le déploiement | Kill switch dans App Configuration |
| Restaurer les données | Données abîmées | Point-in-time restore (Azure SQL Database, SQL Managed Instance, Cosmos DB, MySQL, PostgreSQL) |
Les briques du pipeline :
- Lifecycle hooks d'un deployment job :
postRouteTrafficpour surveiller la santé après bascule,on: failurepour nettoyer ou revenir en arrière (section 8.2). - Checks et approvals sur l'environment (chapitre 04) : approbation manuelle, business hours, requête Azure Monitor, etc.
- Circuit breakers côté application, pour couper le trafic vers un service malade.
- Versioning des artefacts et rétention suffisante pour pouvoir redéployer l'ancienne version.
flowchart TD
    A["Signal de santé négatif<br/>pendant le bake time"] --> B["Arrêter le déploiement"]
    B --> C{"Qu'est-ce qui pose problème ?"}
    C -- "Une fonctionnalité" --> D["Éteindre le feature flag"]
    C -- "Le code ou la config,<br/>sans changement de schéma" --> E["Roll back :<br/>swap inverse, reject, version N-1"]
    C -- "Après une migration<br/>de base" --> F["Roll forward :<br/>hotfix compatible"]
    C -- "L'environnement" --> G["Recréer depuis l'IaC"]
7. Feature flags avec Azure App Configuration Feature Manager#
7.1 Les trois usages#
| Usage | À quoi il sert | Capacités |
|---|---|---|
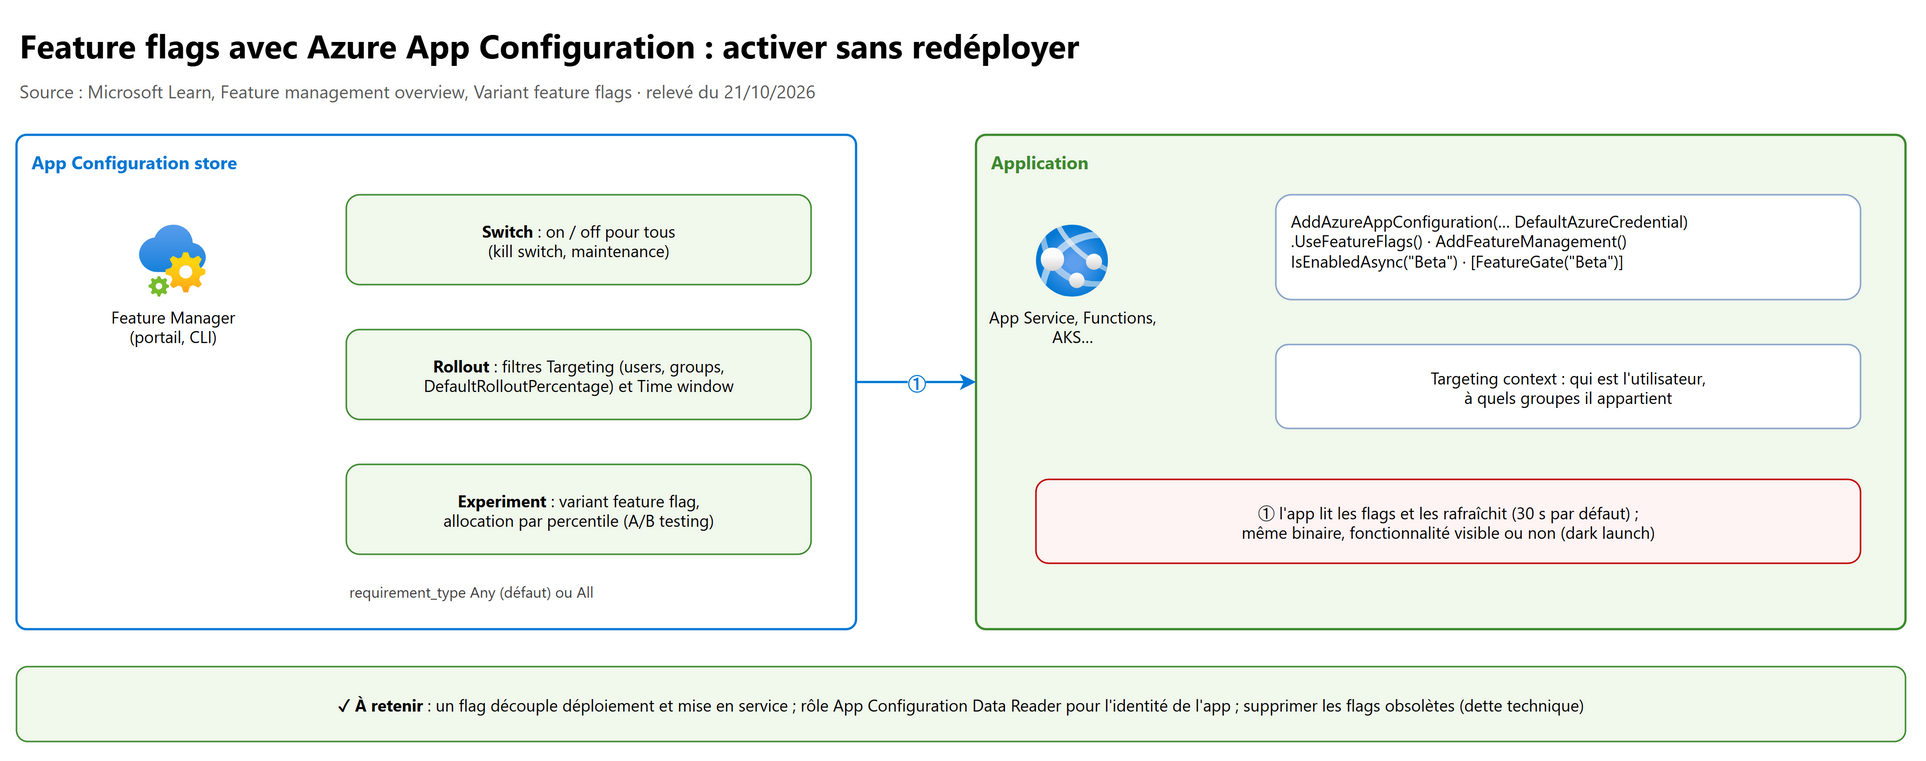
| Switch | On/off instantané pour tous | Kill switch d'une fonctionnalité ou d'une dépendance, mode maintenance |
| Rollout | Exposer progressivement | Pourcentage d'utilisateurs, utilisateurs et groupes ciblés (canary ou staged rollout) |
| Experiment | Comparer des variantes | Variant feature flags, allocation par percentile, A/B testing, mesure d'impact |
7.2 Les filtres#
Un feature filter est une condition évaluée à chaque lecture du flag :
| Filtre intégré | Effet | Paramètres |
|---|---|---|
Time window (Microsoft.TimeWindow) |
Active pendant une fenêtre de temps | Start, End (un seul des deux suffit) |
Targeting (Microsoft.Targeting) |
Active pour une audience | Users, Groups (chacun avec RolloutPercentage), DefaultRolloutPercentage, Exclusion (users, groups) |
Percentage (bibliothèque .NET : PercentageFilter) |
Active pour un pourcentage des évaluations | Value |
| Filtres personnalisés | Votre propre règle (navigateur, région…) | Implémentation de IFeatureFilter |
Avec plusieurs filtres, requirement_type vaut Any par défaut (un seul filtre vrai suffit) ou All (tous doivent être
vrais). Une exclusion l'emporte toujours dans Targeting.
7.3 Variant feature flags#
Un variant a un nom et une valeur de configuration optionnelle (un objet JSON). L'allocation dit qui reçoit quel variant :
par user, puis par group, puis par percentile (dans cet ordre) ; un seed rend la répartition stable. Deux défauts :
DefaultWhenEnabled (pour les percentiles non attribués) et DefaultWhenDisabled (quand le flag est désactivé : c'est le
kill switch, tout le monde reçoit ce variant). status_override (None, Enabled, Disabled) permet à un variant de forcer
l'état du flag.
7.4 Mise en œuvre#
# Créer un flag, le décrire, lui ajouter un filtre Targeting, puis l'activer (authentification Entra : --auth-mode login)
az appconfig feature set --name appcs-web --feature Beta --description "Nouveau parcours de paiement" --auth-mode login
az appconfig feature filter add --name appcs-web --feature Beta --filter-name Microsoft.Targeting --auth-mode login \
  --filter-parameters Audience='{"Users":["[email protected]"],"Groups":[{"Name":"Ring0","RolloutPercentage":100}],"DefaultRolloutPercentage":10}'
az appconfig feature enable --name appcs-web --feature Beta --auth-mode login
La clé d'un flag commence par le préfixe réservé .appconfig.featureflag/ ; un label permet d'avoir des valeurs par
environnement. Côté application (.NET), sans clé :
// Lecture des feature flags avec l'identité de l'application (rôle App Configuration Data Reader sur le store)
builder.Configuration.AddAzureAppConfiguration(options =>
{
    options.Connect(new Uri(endpoint), new DefaultAzureCredential())
           .UseFeatureFlags();          // rafraîchissement par défaut : 30 secondes
});
builder.Services.AddAzureAppConfiguration();
builder.Services.AddFeatureManagement();   // TimeWindow, Targeting et Percentage enregistrés automatiquement (v3+)

// Dans le code : if (await featureManager.IsEnabledAsync("Beta")) { … }  ou l'attribut [FeatureGate("Beta")]
Pour Targeting, l'application fournit un targeting context (identifiant de l'utilisateur et ses groupes) : .WithTargeting().
Bonne pratique : un flag a une durée de vie. Retirez-le du code et du store une fois la fonctionnalité généralisée, sinon il devient de la dette technique et une source de comportements inattendus.
8. Déployer des conteneurs, des binaires et des scripts#
8.1 Quelle tâche pour quelle cible#
| Cible | Azure Pipelines | GitHub Actions |
|---|---|---|
| App Service (package zip, binaires) | AzureWebApp@1 (slotName possible) |
azure/webapps-deploy@v3 (package, slot-name) |
| App Service (conteneur) | AzureWebAppContainer@1 |
azure/webapps-deploy@v3 (images) |
| Azure Functions | AzureFunctionApp@2 (zipDeploy, runFromPackage, slots, Flex Consumption) |
Azure/functions-action |
| Functions en conteneur | AzureFunctionAppContainer@1 |
— |
| AKS / Kubernetes | KubernetesManifest@1 (deploy, promote, reject, createSecret, stratégie canary) |
azure/k8s-deploy |
| Swap, démarrer, arrêter une app | AzureAppServiceManage@0 |
az webapp deployment slot swap dans un step |
| Scripts | AzureCLI@2, AzurePowerShell@5 |
azure/cli, run: après azure/login |
| VM (scripts, IIS) | Deployment job sur un environment de type VM (IISWebAppDeploymentOnMachineGroup@0, scripts) |
Runner self-hosted |
| Images de VM | PackerBuild@1, AzureVmssDeployment@0 |
— |
Authentification : service connection avec workload identity federation côté Azure Pipelines ; azure/login@v2 en OIDC
côté GitHub (permissions: id-token: write). Pour Functions et App Service, Microsoft propose une user-assigned managed identity
fédérée avec le dépôt et le rôle Website Contributor sur l'application (chapitre 07).
# GitHub Actions : déployer dans le slot staging sans secret, puis échanger
permissions:
  id-token: write
  contents: read
jobs:
  deploy:
    runs-on: ubuntu-latest
    environment: production
    steps:
      - uses: azure/login@v2
        with:
          client-id: ${{ secrets.AZURE_CLIENT_ID }}
          tenant-id: ${{ secrets.AZURE_TENANT_ID }}
          subscription-id: ${{ secrets.AZURE_SUBSCRIPTION_ID }}
      - uses: azure/webapps-deploy@v3
        with:
          app-name: app-web
          slot-name: staging
          package: ./output
      - run: az webapp deployment slot swap -g rg-web -n app-web --slot staging --target-slot production
8.2 Le deployment job et ses lifecycle hooks#
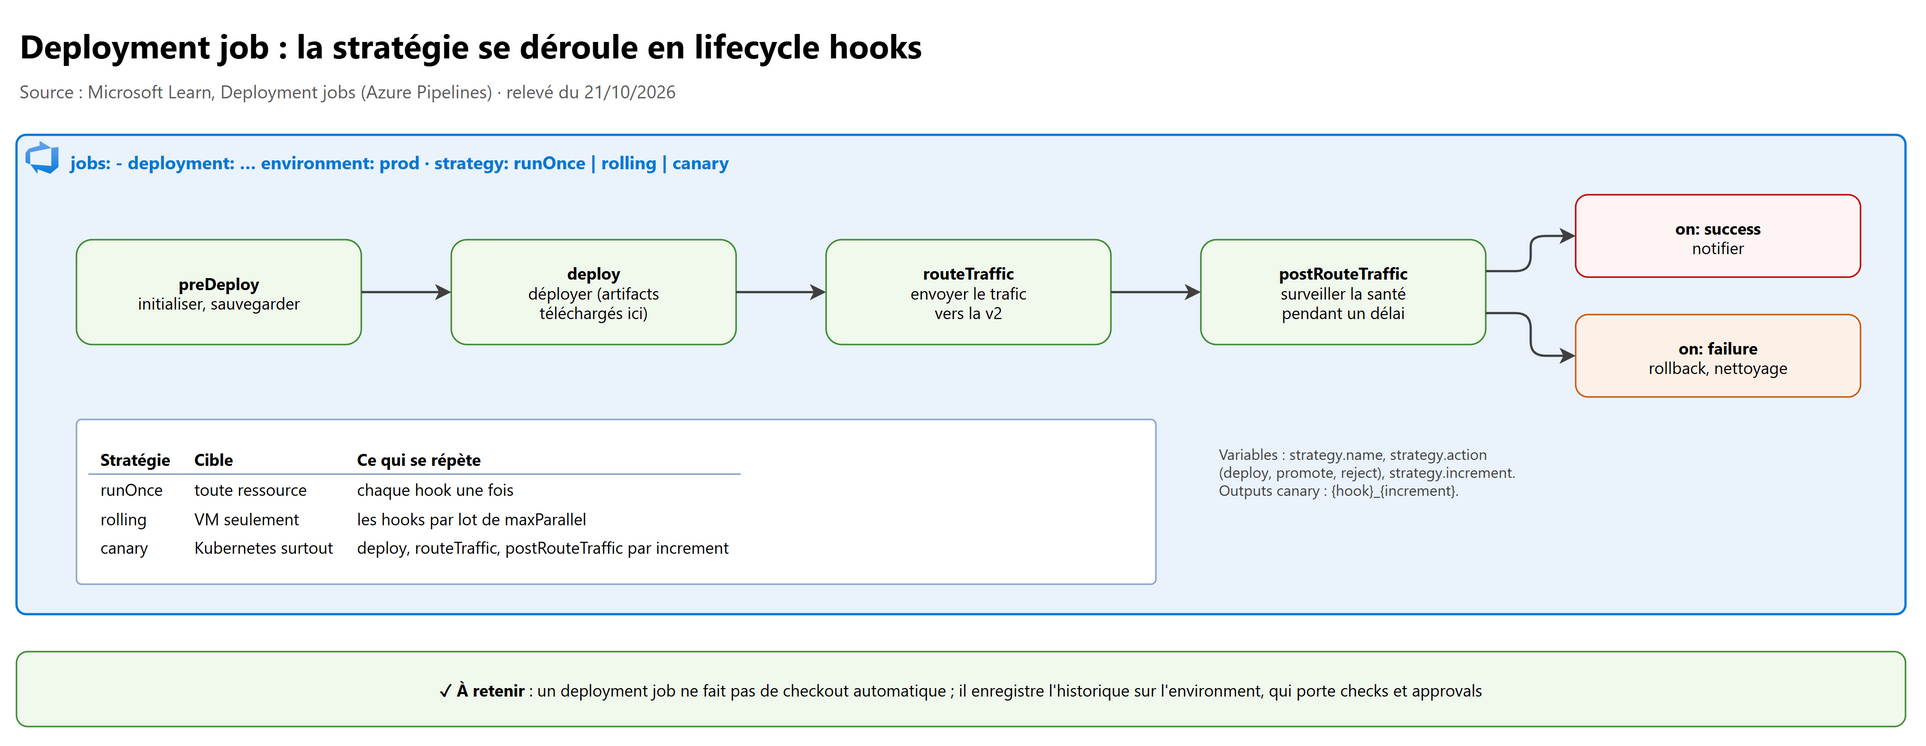
Un deployment job (- deployment:) est le type de job recommandé pour déployer : il enregistre l'historique sur
l'environment (jusqu'à la ressource) et applique une stratégie. Points d'examen :
- il ne clone pas le dépôt automatiquement (
- checkout: selfsi besoin) ; les artefacts sont téléchargés automatiquement dans le hookdeployseulement (- download: nonepour l'éviter) ; - hooks :
preDeploy,deploy,routeTraffic,postRouteTraffic, puison: successouon: failure; - runOnce : chaque hook une fois ; rolling : VM uniquement, hooks par lot de
maxParallel; canary :preDeployune fois, puisdeploy/routeTraffic/postRouteTrafficpour chaque valeur deincrements; - variables :
strategy.name,strategy.action(deploy, promote, reject),strategy.increment.
# Canary sur AKS : 10 %, puis 20 %, surveillance, puis promotion ou rejet
jobs:
- deployment: DeployCanary
  environment: aks-prod.bookings      # ressource Kubernetes (namespace) de l'environment
  pool:
    vmImage: ubuntu-latest
  strategy:
    canary:
      increments: [10, 20]
      deploy:
        steps:
        - task: KubernetesManifest@1
          inputs:
            action: $(strategy.action)
            namespace: bookings
            strategy: $(strategy.name)
            percentage: $(strategy.increment)
            manifests: $(Pipeline.Workspace)/manifests/*
      postRouteTraffic:
        pool: server
        steps:
        - task: Delay@1
          inputs:
            delayForMinutes: '10'
      on:
        failure:
          steps:
          - script: echo "rejet du canary"   # KubernetesManifest@1 action: reject
Pour AKS, les stratégies côté cluster (rolling update des pods, PodDisruptionBudget, blue-green de clusters) sont dans le parcours AKS, chapitre 04 ; le safe rollout d'endpoints de modèles ML dans AI-300, chapitre 04.
Cluster AKS privé : l'API server n'est pas joignable depuis un agent Microsoft-hosted ; utilisez un agent self-hosted (ou un Managed DevOps Pool) dans un réseau qui voit le cluster.
9. Un déploiement qui inclut la base de données#
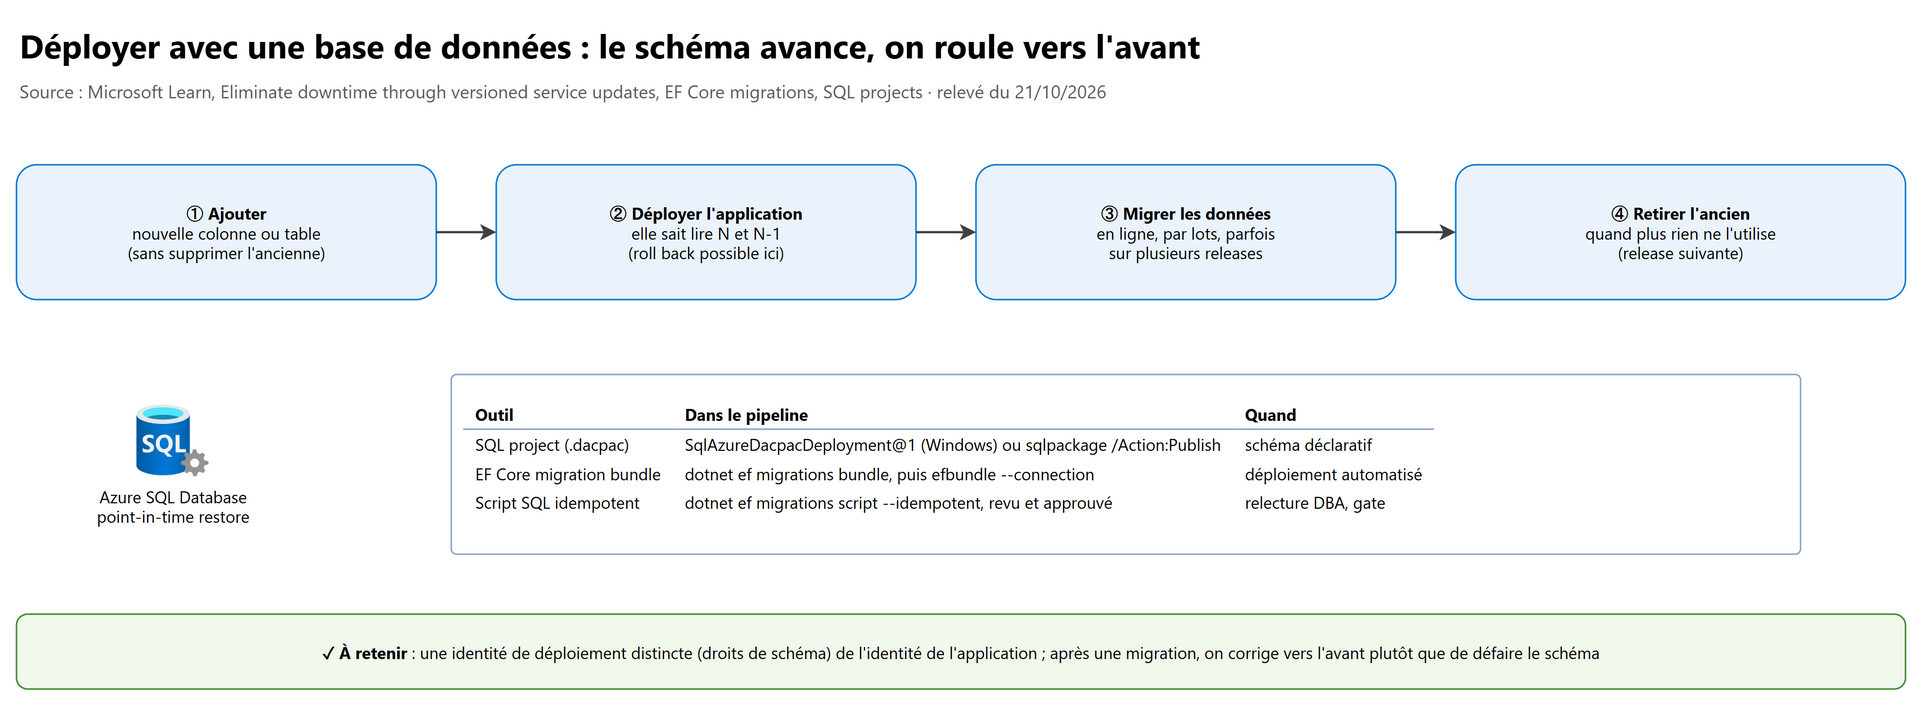
9.1 Le principe : N et N-1, puis roll forward#
Microsoft (Eliminate downtime through versioned service updates) applique trois règles :
- Mettre à jour les couches séparément : la base et l'application ne changent pas au même instant ; c'est généralement l'application qui absorbe la complexité, en sachant parler aux schémas N et N-1.
- On déploie d'abord les binaires (on peut encore revenir en arrière), puis on lance la mise à jour de la base.
- Une fois la base migrée, on roule vers l'avant : une migration en ligne est complexe, son retour arrière échouerait probablement aussi.
En pratique, on ajoute (nouvelle colonne ou table), on déploie une application compatible avec les deux formes, on migre les données (parfois en plusieurs releases), et on retire l'ancien seulement quand plus rien ne l'utilise. Ce découpage est souvent appelé expand / contract hors de la documentation Microsoft.
9.2 Les outils#
| Approche | Commande ou tâche | Points d'attention |
|---|---|---|
| SQL project (.dacpac), schéma déclaratif | SqlAzureDacpacDeployment@1 (deployType: DacpacTask, DeploymentAction: Publish) ou sqlpackage /Action:Publish |
La tâche ne tourne que sur agent Windows (sur Linux, appeler SqlPackage) ; elle peut ouvrir et refermer la règle de pare-feu de l'agent (IpDetectionMethod: AutoDetect, DeleteFirewallRule: true) ; authentification servicePrincipal possible ; actions DeployReport et DriftReport pour prévisualiser |
| EF Core migration bundle | dotnet ef migrations bundle, puis efbundle --connection … |
Recommandé pour le déploiement automatisé ; n'exige ni SDK ni sources à l'exécution ; depuis EF Core 9, prend un verrou de migration sur la base (un script SQL, lui, n'en prend pas) |
| Script SQL idempotent | dotnet ef migrations script --idempotent -o artifacts/migrate.sql |
Quand un DBA doit relire et approuver ; on déploie le script approuvé, pas un script régénéré |
| Migration au démarrage de l'app | context.Database.MigrateAsync() |
À éviter en production : droits élevés pour l'application, pas de revue ; le verrou d'EF Core 9+ évite la corruption entre instances, mais Microsoft préfère une étape de déploiement séparée |
# Agent Linux : publier un .dacpac avec SqlPackage
steps:
- task: UseDotNet@2
  inputs:
    packageType: sdk
    version: '8.x'
- script: dotnet tool install --global microsoft.sqlpackage
  displayName: Installer SqlPackage
- script: |
    sqlpackage /Action:Publish \
      /SourceFile:$(Pipeline.Workspace)/drop/Database.dacpac \
      /TargetConnectionString:"$(ConnectionString)"
  displayName: Déployer le schéma
Bonnes pratiques :
- une identité de déploiement qui a les droits de schéma, distincte de l'identité de l'application qui ne lit et n'écrit que les données ; la connection string vient de Key Vault ou d'une variable secrète, jamais du YAML ;
- un publish profile qui contient des secrets va dans les secure files de la Library ;
- un gate d'approbation (environment check) avant l'étape de base en production ;
- un script de retour arrière (
migrations scriptavec unfromplus récent que leto) existe, mais ne reconstitue pas les données supprimées : à tester sur une copie de la production ; - en dernier recours, le point-in-time restore de la base.
10. Labs conseillés#
Dans un abonnement et une organisation Azure DevOps (ou un dépôt GitHub) de test ; supprimer le groupe de ressources à la fin.
- Slots et swap with preview (App Service S1, quelques euros par jour) : créer un slot
staging, y déployer une version qui affiche son numéro, marquer un app settingENVcomme Deployment slot setting, faire un swap with preview. Résultat attendu : la production sert v2 sans coupure,ENVest resté dans chaque slot, un second swap ramène v1. - Canary sur un slot :
az webapp traffic-routing set --distribution staging=20, puis appeler l'URL de production depuis plusieurs navigateurs. Résultat attendu : environ 20 % des sessions portent le cookiex-ms-routing-name=staging. - Feature flag avec Targeting (App Configuration Free) : créer le flag
Betaavec un filtre Targeting (Ring0à 100 %, défaut 0 %), le lire depuis une petite application avecDefaultAzureCredentialet le rôle App Configuration Data Reader. Résultat attendu : seuls les utilisateurs du groupe voient la fonctionnalité ; désactiver le flag la masque sans redéployer. - Pipeline multi-stage ordonné : stages Infra → Database → Api avec
dependsOn, un environmentprodavec une approbation, et un deployment jobrunOncequi a un hookon: failure. Résultat attendu : faire échouer volontairement Database bloque Api ; l'historique de déploiement apparaît sur l'environment. - Base de données N / N-1 (Azure SQL Database serverless, coût faible) : ajouter une colonne nullable par
.dacpac, déployer une application qui fonctionne avec ou sans la colonne, migrer les données, puis retirer l'ancienne colonne dans une release suivante. Résultat attendu : aucune erreur applicative pendant les étapes.
11. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Tester une fonctionnalité sur 5 % des utilisateurs sans redéployer | Feature flag avec filtre Targeting (ou pourcentage) | L'exposition est découplée du déploiement |
| Envoyer 10 % du trafic vers la nouvelle version d'une Web App | Traffic % sur un deployment slot (ou canary) | Le routage par slot répartit le trafic |
| Comparer deux variantes et mesurer laquelle convertit mieux | A/B testing avec variant feature flags | Allocation par percentile + télémétrie |
| Déployer d'abord à l'équipe interne, puis aux early adopters, puis à tous | Ring-based deployment | Des groupes d'utilisateurs successifs |
| Revenir instantanément en arrière après un swap raté | Refaire le même swap | L'ancienne version est dans le slot source |
| Valider la nouvelle version avec les réglages de production avant de basculer | Swap with preview | Pause après l'application des réglages cibles |
| Auto swap demandé sur une Web App Linux | Impossible : auto swap non pris en charge sur Linux et Web App for Containers | Limite documentée |
| Un app setting doit rester propre à chaque slot | Deployment slot setting (--slot-settings) |
Sinon il suit le code |
| La managed identity ou la VNet integration « disparaît » après un swap | Ces réglages ne sont pas échangés : configurer chaque slot | Réglages propres au slot |
| Deployment slots sur un plan Basic | Impossible : Standard, Premium ou Isolated | Niveau minimal |
| Rolling deployment sur Kubernetes avec un deployment job | Le rolling des deployment jobs ne vise que des VM ; sur Kubernetes, utiliser canary ou le rolling update natif |
Limite documentée |
| VMSS : toutes les instances redémarrent en même temps | Upgrade policy Automatic ; passer en Rolling (avec health probe) | Automatic ne garantit rien |
| Le deployment job ne trouve pas le code source | Ajouter - checkout: self |
Un deployment job ne clone pas le dépôt |
| La correction d'un bug de production disparaît à la release suivante | Corriger d'abord dans main, puis cherry-pick vers la release | Release Flow |
| Hotfix urgent : supprimer les tests pour aller plus vite ? | Non : accélérer les gates et le bake time, pas les supprimer | Emergency SDP protocols |
| Revenir en arrière après une migration de schéma | Roll forward de préférence | Le retour arrière d'une base migrée est risqué |
SqlAzureDacpacDeployment@1 échoue sur un agent Ubuntu |
La tâche ne tourne que sur Windows ; appeler SqlPackage sur Linux | Prérequis de la tâche |
| L'application applique elle-même les migrations au démarrage en production | À éviter : migration bundle ou script idempotent dans le pipeline | Droits élevés, pas de revue |
| Le DBA doit approuver le SQL exact | Script idempotent généré en CI + approval sur l'environment | On déploie le script approuvé |
| Le stage API démarre avant la fin du stage Database | Ajouter dependsOn: Database et condition: succeeded() |
Ordre explicite |
| GitHub : deux jobs de déploiement tournent en même temps | Ajouter needs: |
Sans needs, les jobs sont parallèles |
| Un flag reste dans le code un an après la généralisation | Le retirer | Dette technique |
| Feature flag, deux filtres, la fonctionnalité doit exiger les deux | requirement_type: All |
Any par défaut |
| Variant feature flag désactivé : quel variant reçoivent les utilisateurs ? | DefaultWhenDisabled | C'est le kill switch |
12. Scénarios corrigés#
1. Contoso déploie une Web App en plan Premium. Elle veut zéro coupure, pouvoir revenir en arrière en quelques secondes et valider la version avec la vraie configuration de production avant de basculer. Que faire ?
Déployer dans un deployment slot
staging, faire un swap with preview (les réglages de production sont appliqués au slot, on vérifie), puis terminer le swap. Retour arrière : refaire le même swap.
2. Après un swap, l'application de production n'arrive plus à lire Key Vault. Pourtant tout marchait en staging. Pourquoi ?
Les managed identities ne sont pas échangées : la production utilise sa propre identité, qui n'a peut-être pas les droits. Donner le rôle Key Vault Secrets User aux identités des deux slots (ou utiliser une user-assigned identity partagée).
3. Fabrikam veut livrer un nouveau moteur de recommandation, d'abord aux employés, puis à 10 % des clients, sans redéployer à chaque étape. Quelle solution ?
Un feature flag dans Azure App Configuration avec un filtre Targeting : groupe
Employesà 100 %,DefaultRolloutPercentageà 10 ; on augmente le pourcentage au fil du temps. Kill switch en cas de problème.
4. L'équipe marketing veut savoir laquelle de deux pages de paiement convertit le mieux. Que proposer ?
Un variant feature flag (deux variants, allocation 50/50 par percentile,
seedstable) et la télémétrie de la conversion : c'est de l'A/B testing.
5. Un pipeline déploie l'API avant que la migration de base soit terminée, ce qui provoque des erreurs. Comment le corriger ?
Mettre l'API dans un stage qui a
dependsOn: Databaseetcondition: succeeded(); et rendre la migration compatible avec l'ancienne API (N-1), pour que l'ordre ne soit plus critique.
6. Un bug critique est découvert en production (release releases/M130). Le développeur veut corriger directement dans la
release branch. Quelle est la bonne démarche selon Release Flow ?
Corriger dans une branche courte depuis main, PR vers main, puis cherry-pick vers
releases/M130(nouvelle PR), et déployer depuis la release par rings. Sinon le bug reviendrait à la release M131.
7. Une flotte de VM derrière un Load Balancer doit être mise à jour sans perte de capacité. Quelle stratégie ?
VMSS avec upgrade policy Rolling,
maxBatchInstancePercentfaible, health probe ou Application Health extension, et MaxSurge pour créer les nouvelles instances avant de retirer les anciennes. Ou un deployment jobrollingavecmaxParallelsur un environment de VM.
8. Le DBA exige de relire chaque changement de schéma avant la production. L'équipe utilise EF Core. Que mettre en place ?
Générer en CI un script idempotent (
dotnet ef migrations script --idempotent), le publier comme artefact, mettre une approbation sur l'environment de production, et déployer ce script-là.
9. Après une migration de base réussie, la nouvelle version de l'API provoque des erreurs. Le chef de projet demande un retour arrière complet, base comprise. Quel conseil ?
Roll forward : revenir à l'API N-1 si elle supporte le nouveau schéma (c'est le but de la compatibilité N/N-1), et corriger l'API par un hotfix ; défaire la migration est risqué. Le point-in-time restore reste le dernier recours en cas de données abîmées.
10. Un canary sur AKS doit passer par 10 %, puis 20 %, avec dix minutes de surveillance à chaque palier, puis être promu automatiquement. Comment l'écrire dans Azure Pipelines ?
Un deployment job avec
strategy: canary,increments: [10, 20],KubernetesManifest@1avecaction: $(strategy.action),strategy: $(strategy.name),percentage: $(strategy.increment); unpostRouteTrafficavecDelay@1(ou une vérification de santé) ;on: failurepour rejeter.
13. Pour aller plus loin#
- Deployment Stamps : déployer une variante de blue-green stamp par stamp, en multi-région (pattern Deployment Stamps).
- Blue-green de clusters AKS : guide d'architecture Microsoft, avec Application Gateway ou Front Door devant deux clusters.
- Network Watcher rule impact analyzer : simuler l'effet d'un changement de NSG ou de règles AVNM avant de le déployer.
- Azure Functions Flex Consumption n'a pas de deployment slots, mais une site update strategy
RollingUpdate(siteUpdateStrategy.type) : instances vidées et remplacées par lots, sans coupure. Pas de canary ni de répartition du trafic, pas de bouton de retour arrière (on redéploie la version précédente) ; les changements doivent rester compatibles avec la version précédente (Site update strategies in Flex Consumption).
14. Fiche à retenir#
- Déployer ≠ exposer : stratégie de déploiement (où tourne le code) + feature flags (qui le voit).
- Blue-green = deux environnements, bascule ; canary = part du trafic ; ring = groupes d'utilisateurs ; rolling = lots d'instances.
- Progressive exposure : bake time en heures ou jours, arrêt au premier signal négatif.
- v1 et v2 cohabitent : compatibilité N / N-1 de l'API et du schéma.
- Ordre : infra → base → API → front → smoke tests ;
dependsOn(Azure Pipelines),needs(GitHub Actions). - Slots : Standard, Premium, Isolated ; production toujours en cible ; swap with preview ; auto swap pas sur Linux.
- Non échangés : custom domains, certificats non publics, scale, IP restrictions, Always On, managed identities, VNet integration.
-
--slot-settings= réglage qui reste dans le slot ;az webapp traffic-routing set= canary sur slot. - VMSS : Automatic (dev/test), Manual, Rolling (health probe requis, MaxSurge).
- Deployment job : runOnce, rolling (VM seulement), canary ; pas de checkout auto ; hooks preDeploy → deploy → routeTraffic → postRouteTraffic → on success/failure.
- Hotfix (Release Flow) : corriger dans main, cherry-pick vers la release, déployer par rings ; accélérer sans supprimer les gates.
- Résilience : roll back, roll forward, redéployer l'infra, éteindre le flag, point-in-time restore.
- App Configuration : Switch, Rollout, Experiment ; filtres Time window, Targeting, Percentage ;
requirement_typeAny (défaut) / All. - Variants : allocation user → group → percentile ; DefaultWhenDisabled = kill switch.
- Base : DACPAC (
SqlAzureDacpacDeployment@1Windows ou SqlPackage), EF migration bundle, script idempotent approuvé ; roll forward après migration.
Références#
Toutes lues le 21/10/2026 :
- Study guide for Exam AZ-400
- Architecture strategies for safe deployment practices (Well-Architected OE:11)
- Deployment jobs (Azure Pipelines)
- Set up staging environments in Azure App Service
- Deploy to App Service using Azure Pipelines
- Deploy to App Service using GitHub Actions
- Feature management overview (Azure App Configuration)
- Enable conditional features with feature filters
- Use variant feature flags
- .NET feature management reference
- Quickstart: add feature flags to a .NET app
- az appconfig feature et az appconfig feature filter
- How Microsoft develops with DevOps (Release Flow)
- Adopt a Git branching strategy
- How Microsoft operates reliable systems with DevOps
- Eliminate downtime through versioned service updates
- Upgrade policy modes for Virtual Machine Scale Sets
- Configure rolling upgrades on Virtual Machine Scale Sets
- SqlAzureDacpacDeployment@1
- SQL projects automation
- Applying migrations (EF Core)
- Migrations in team environments (EF Core)
- AzureFunctionApp@2
- Deploy to Azure Functions by using GitHub Actions
- Canary deployment strategy for Kubernetes (Azure Pipelines)
- GitHub Actions for AKS (
azure/k8s-deploy) - RollingUpgradePolicy :
maxBatchInstancePercent= 20 % par défaut (référence ARM) - Azure Pipelines task reference (deploy tasks)