

Version : 1.1 · Date : 2026-10-21 · Domaine 5 de l'examen : Implement information extraction solutions (10 à 15 %)
En une phrase : pour qu'un agent ou une application RAG réponde à partir de vos fichiers, il faut d'abord extraire (OCR, layout, champs) avec Azure Content Understanding ou Document Intelligence, puis indexer dans Azure AI Search (indexer, skillset, chunking, embeddings, index projections), configurer la recherche hybride + semantic ranker, et enfin brancher l'index sur l'agent (Azure AI Search tool, Foundry IQ via MCP) pour obtenir des réponses citées.
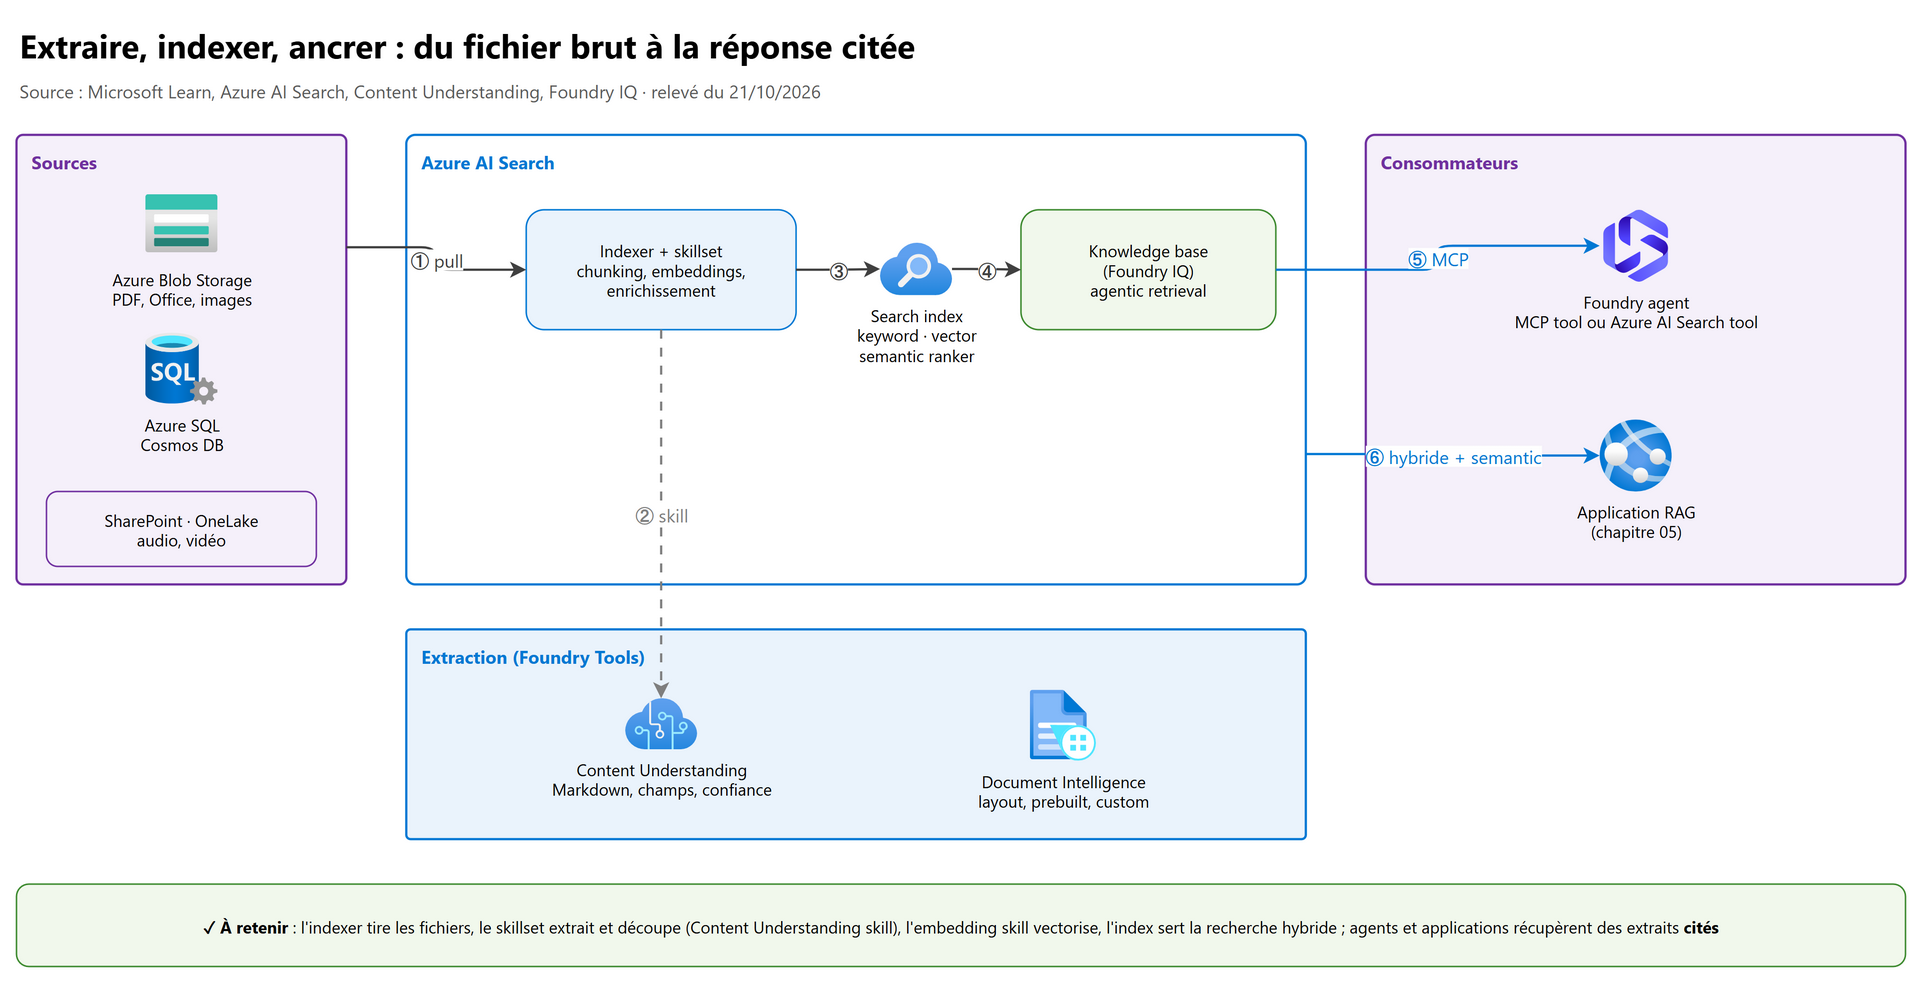
Ce que l'examen demande#
Deux blocs, repris mot pour mot du guide d'étude AI-103 (compétences au 16 avril 2026) :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| Build retrieval and grounding pipelines | ||
| 1 | Ingest and index content, such as documents, images, audio, and video | 2 |
| 2 | Configure semantic search, hybrid search, and vector search for grounding | 3 |
| 3 | Implement enrichment by using custom or built-in skills for text, images, and layout | 4 |
| 4 | Configure RAG ingestion flow, including documents and using optical character recognition (OCR) | 5 |
| 5 | Connect retrieval pipelines directly to workflows and agent tools | 6 |
| Extract content from documents | ||
| 6 | Extract information by using multimodal pipelines that combine OCR, layout analysis, and field extraction | 7 |
| 7 | Produce clean, grounded representations to use with agents and RAG by using Content Understanding | 8 |
| 8 | Implement analyzers for generating structured or markdown outputs for downstream reasoning by using Content Understanding | 9 |
Déjà vu ailleurs, à ne pas redire ici : les méthodes de recherche (BM25, vecteurs, RRF, semantic ranker) et le choix classic RAG / agentic retrieval au chapitre 01 ; le RAG côté application (code de la requête et du prompt) au chapitre 05 ; la surveillance des indexers et la sécurité réseau au chapitre 03 ; le Content Understanding visuel et vidéo (légendes, segments vidéo) au chapitre 08 ; la construction d'agents au chapitre 06.
1. Les bases à maîtriser#
1.1 Le vocabulaire#
| Terme | Ce que c'est |
|---|---|
| Data source | Connexion à la source (Blob, ADLS Gen2, Azure SQL, Cosmos DB, OneLake…) avec ses identifiants et sa politique de détection des changements |
| Indexer | Le robot qui tire (pull model) les données d'un data source, pilote le skillset et remplit un index |
| Skillset | Liste de skills exécutées pendant l'indexation (OCR, découpage, embeddings, LLM, code à vous) |
| Enrichment tree | Document en mémoire (racine /document) que chaque skill enrichit de nouveaux nœuds |
| Search index | Le magasin interrogé : champs texte, champs vector, configuration semantic, scoring profiles |
| Index projections | Indexation one-to-many : un document source donne plusieurs documents d'index (un par chunk) |
| Knowledge store | Copie des enrichissements dans Azure Storage (tables, objets, fichiers : par exemple les images extraites) |
| Integrated vectorization | Vectorisation intégrée : embedding skill à l'indexation + vectorizer à la requête |
| Knowledge source / knowledge base | Objets de l'agentic retrieval (Foundry IQ) : une base regroupe des sources et expose un endpoint MCP |
| Analyzer | Configuration réutilisable de Content Understanding : quoi extraire, avec quels modèles, sous quelle forme |
1.2 Deux façons de remplir un index#
| Pull model (indexer) | Push model (API) | |
|---|---|---|
| Principe | Le service lit la source tout seul | Votre code envoie des documents JSON déjà préparés |
| Sources | Sources Azure prises en charge par un indexer | N'importe quelle source |
| Skills, integrated vectorization | Oui | Non (vous vectorisez vous-même, ou un vectorizer côté requête) |
| Fraîcheur | Planification toutes les 5 minutes au mieux | Immédiate |
| Quand | Cas standard, peu de code | Données hors Azure, fraîcheur à la seconde, pipeline déjà écrit |
À retenir : un indexer lit un seul data source et écrit dans un seul index ; plusieurs indexers peuvent écrire dans le même index (plusieurs sources), et un data source peut servir à plusieurs indexers.
2. Ingérer et indexer documents, images, audio et vidéo#
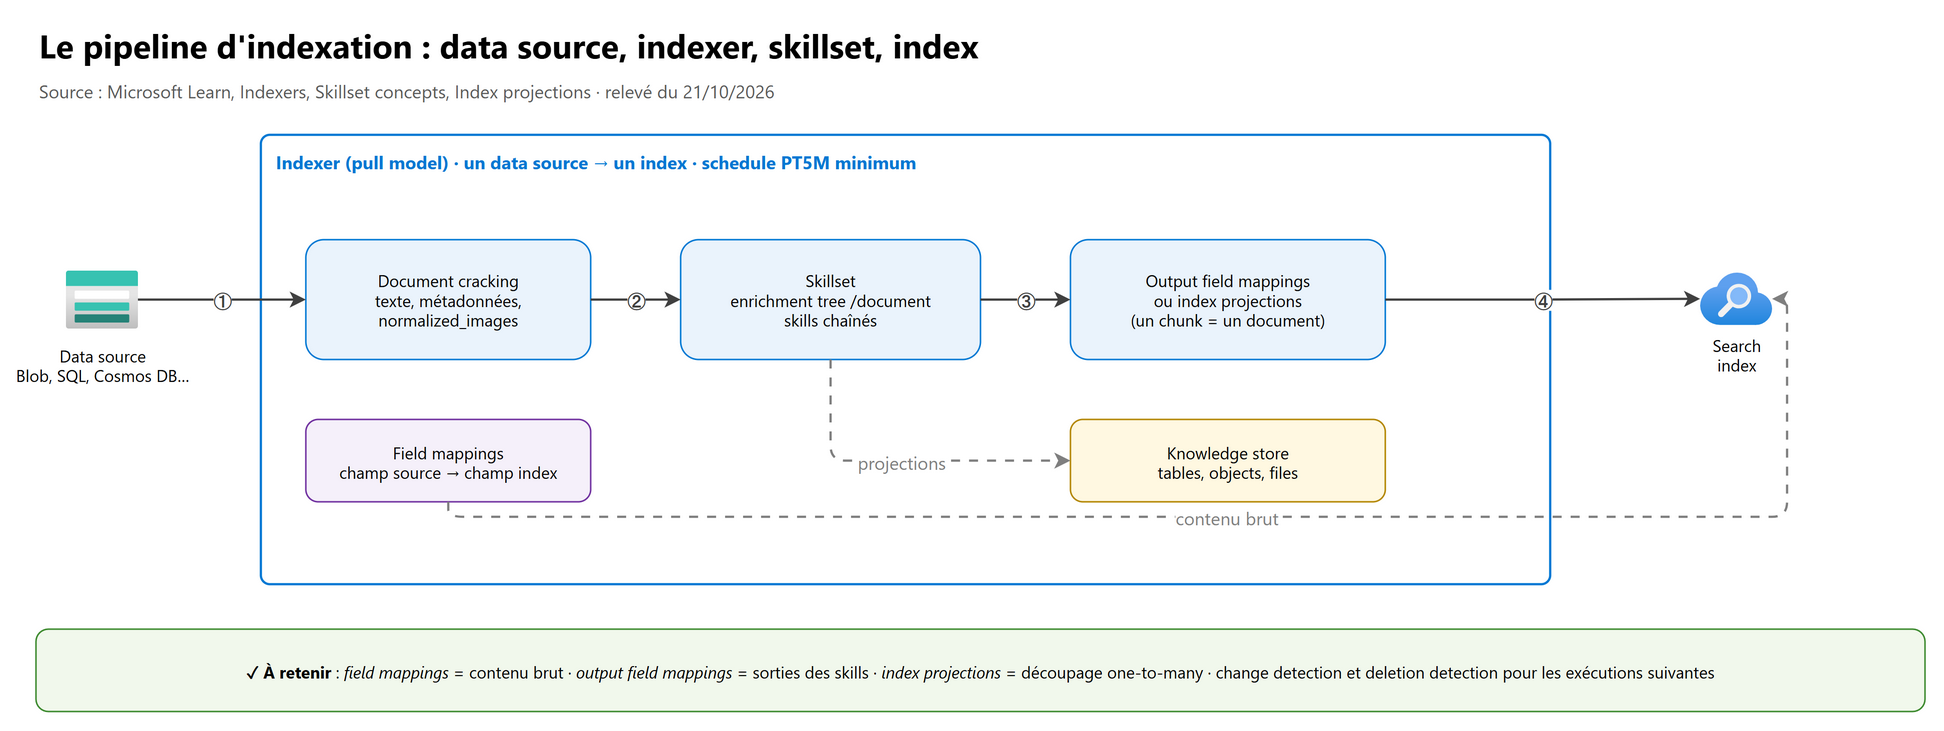
2.1 Les étapes d'un indexer#
- Document cracking : ouverture des fichiers, extraction du texte, des métadonnées (
metadata_storage_name…) et, si demandé, des images (normalized_images). - Field mappings : le contenu brut vers les champs de l'index (renommage, fonctions
base64Encode,urlEncode,jsonArrayToStringCollection…). Sans field mapping, les champs de même nom sont reliés automatiquement. - Skillset : les skills enrichissent l'enrichment tree.
- Output field mappings (sorties de skills vers des champs) ou index projections (un chunk = un document d'index).
- Knowledge store (facultatif).
Points d'examen sur l'exécution :
- schedule :
intervalde 5 minutes (PT5M) à 24 heures (PT24H) ; sans schedule, l'indexer ne tourne qu'à la demande ; - change detection intégrée pour Azure Storage et SharePoint ; à activer à la main pour Azure SQL et Cosmos DB (high water mark, change tracking) ;
- deletion detection pour Blob : soft delete natif ou métadonnée personnalisée (
IsDeleted) ; - une exécution se fait dans une fenêtre d'environ 2 heures ; au-delà, planifier toutes les 2 heures et l'indexer reprend où il s'était arrêté ;
- un service exécute un job d'indexer par search unit : prévoir des replicas pour du parallélisme.
sequenceDiagram
    participant S as Scheduler (PT15M)
    participant I as Indexer
    participant D as Data source (Blob)
    participant K as Skillset
    participant X as Search index
    S->>I: Déclenche une exécution
    I->>D: Lit les fichiers nouveaux ou modifiés
    D-->>I: Contenu et métadonnées
    I->>K: Enrichment tree /document
    K-->>I: Chunks, vecteurs, champs enrichis
    I->>X: Index projections (un document par chunk)
    I-->>S: Statut success, transientFailure ou error
2.2 Le push model en Python#
# pip install azure-search-documents azure-identity
import os
from azure.identity import DefaultAzureCredential
from azure.search.documents import SearchClient

# Rôle requis sur le service : Search Index Data Contributor (écrire des documents)
client = SearchClient(endpoint=os.environ["SEARCH_ENDPOINT"], index_name="docs-index",
                      credential=DefaultAzureCredential())
docs = [{"chunk_id": "contrat-42-p1", "parent_id": "contrat-42", "chunk": "## Article 1 ...", "title": "contrat-42.pdf"}]
results = client.merge_or_upload_documents(documents=docs)   # upload, merge, merge_or_upload, delete
print([r.succeeded for r in results])
2.3 Images, audio et vidéo#
| Contenu | Comment l'indexer |
|---|---|
| Images dans les documents | Indexer avec imageAction = generateNormalizedImages, puis OCR skill (texte), Image Analysis skill (description, tags), GenAI Prompt skill (« verbaliser » l'image en texte), ou Azure Vision multimodal embeddings skill (preview) pour un vecteur d'image |
| Images et documents riches (chemin recommandé) | Azure Content Understanding skill : texte, images, emplacement (locationMetadata), descriptions d'images (preview) |
| Multimodal RAG sans code | Assistant Import data, scénario Multimodal RAG : extraction, chunking, verbalisation ou embeddings multimodaux, images dans un knowledge store |
| Audio | Content Understanding prebuilt-audioSearch (transcription avec diarisation, résumé) ou analyzer personnalisé basé sur prebuilt-audio, puis envoi du Markdown dans l'index (push ou custom skill) |
| Vidéo | Content Understanding prebuilt-videoSearch : segments, transcription WebVTT, descriptions, sortie Markdown prête pour un index ; Video Indexer pour des insights profonds (personnes, émotions) |
2.4 L'assistant Import data du portail#
Sur la page Overview du service Azure AI Search, Import data propose trois scénarios : Keyword search, RAG et Multimodal RAG. Il crée en une fois data source, index (schéma déduit d'un échantillon), indexer, skillset (chunking avec Text Split, integrated vectorization) et, pour le Multimodal RAG seulement, un knowledge store pour les images ; il peut ajouter une semantic configuration. Le chemin est à sens unique : on ne peut pas rouvrir l'assistant pour modifier les objets créés (on passe alors par les éditeurs JSON).
3. Configurer la recherche pour l'ancrage#
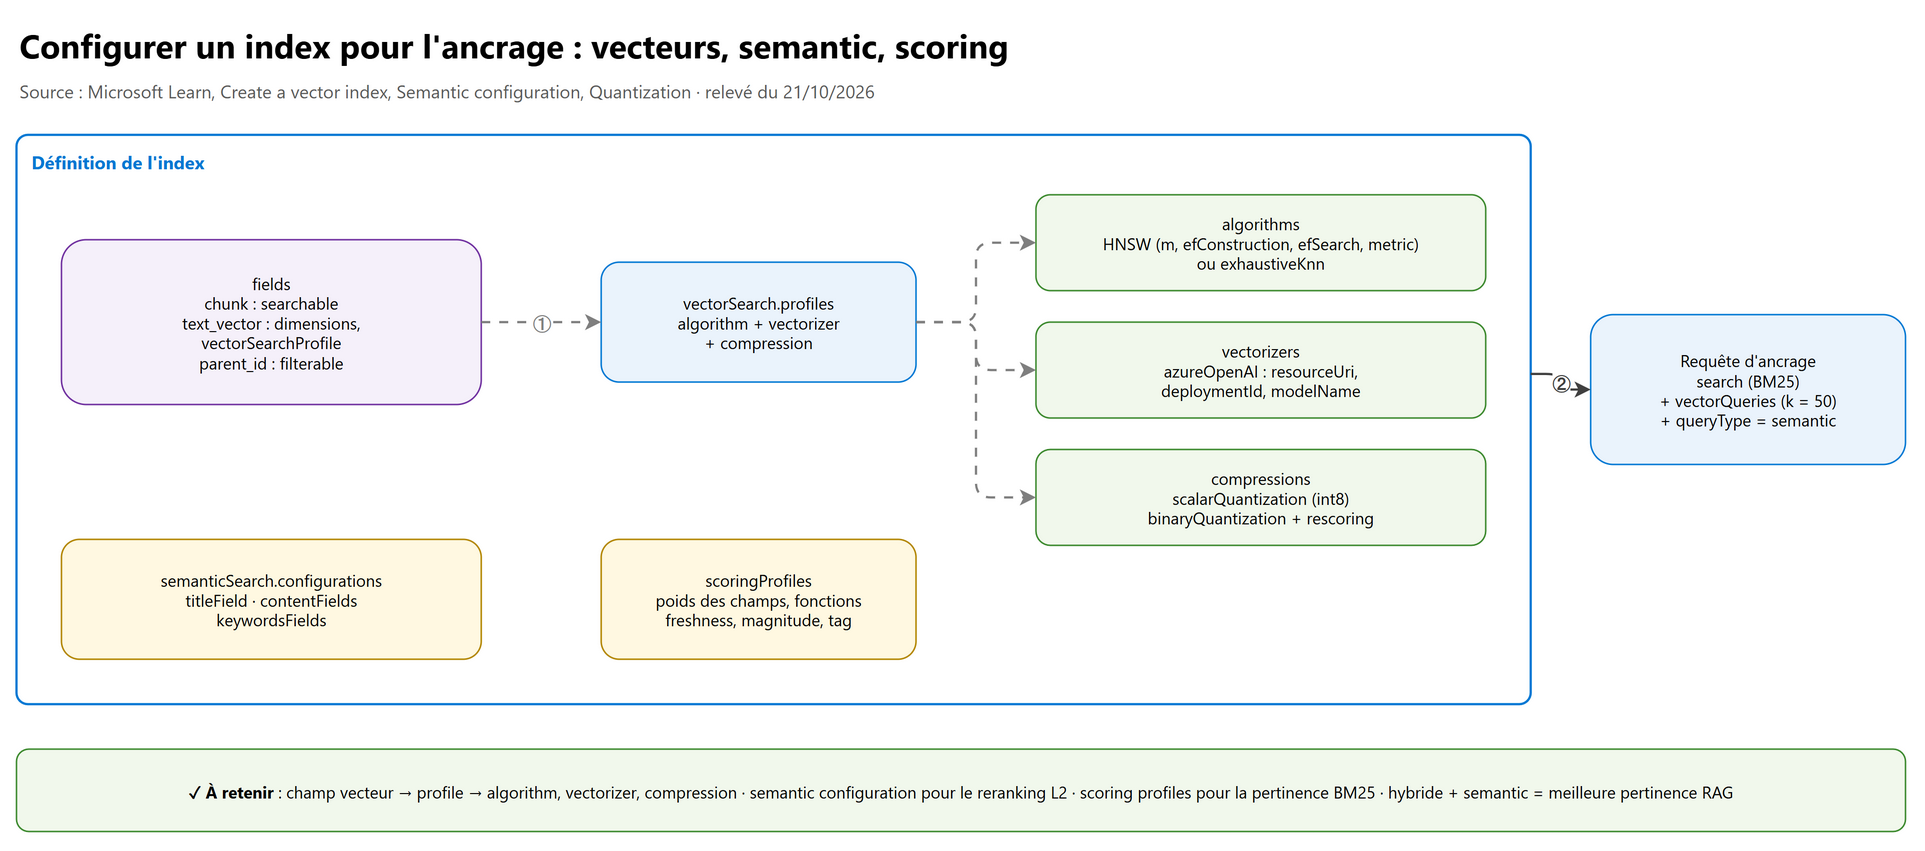
Les méthodes elles-mêmes (BM25, HNSW, RRF, semantic ranker) sont expliquées au chapitre 01. Ici, la configuration.
3.1 Les briques de l'index#
| Brique | Rôle | Paramètres à connaître |
|---|---|---|
| Champ vector | Contient l'embedding | type Collection(Edm.Single) (float32) ou Collection(Edm.Half) (float16), dimensions (1536 pour text-embedding-3-small, 3072 pour -large), vectorSearchProfile, stored |
| algorithms | Recherche du plus proche voisin | hnsw (approximatif, rapide : m, efConstruction, efSearch, metric = cosine…) ou exhaustiveKnn (exhaustif, lent, référence de qualité) |
| vectorizers | Vectoriser la question à la requête | azureOpenAI (resourceUri, deploymentId, modelName), Custom Web API, Azure Vision, Foundry model catalog |
| compressions | Réduire la mémoire | scalarQuantization (int8, environ 4 fois plus petit), binaryQuantization (1 bit, jusqu'à 28 fois), rescoringOptions (rescoring avec les vecteurs d'origine, defaultOversampling = 4 par défaut), truncationDimension (MRL, text-embedding-3) |
| profiles | Associe un algorithme, un vectorizer et une compression | un profil par combinaison ; un champ vector pointe vers un profil |
| semantic configuration | Champs lus par le semantic ranker | titleField, contentFields, keywordsFields |
| scoring profiles | Ajuster la pertinence BM25 | poids de champs, fonctions freshness, magnitude, distance, tag |
Pièges : le même modèle d'embedding doit servir à l'indexation et au vectorizer ;
stored: falseéconomise du disque mais empêche de retourner le vecteur et casse les mises à jour partielles qui ne renvoient pas le vecteur entier ; le rescoring n'existe qu'avec HNSW et une compression intégrée.
3.2 Créer l'index en Python#
import os
from azure.identity import DefaultAzureCredential
from azure.search.documents import SearchClient
from azure.search.documents.indexes import SearchIndexClient
from azure.search.documents.indexes.models import (
    AzureOpenAIVectorizer, AzureOpenAIVectorizerParameters, HnswAlgorithmConfiguration, SearchField, SearchIndex,
    SemanticConfiguration, SemanticField, SemanticPrioritizedFields, SemanticSearch, VectorSearch, VectorSearchProfile)

index = SearchIndex(
    name="docs-index",
    fields=[
        SearchField(name="chunk_id", type="Edm.String", key=True, filterable=True, analyzer_name="keyword"),
        SearchField(name="parent_id", type="Edm.String", filterable=True),
        SearchField(name="title", type="Edm.String", searchable=True),
        SearchField(name="chunk", type="Edm.String", searchable=True),
        SearchField(name="text_vector", type="Collection(Edm.Single)", searchable=True,
                    vector_search_dimensions=1536, vector_search_profile_name="hnsw-openai"),
    ],
    vector_search=VectorSearch(
        algorithms=[HnswAlgorithmConfiguration(name="hnsw")],
        profiles=[VectorSearchProfile(name="hnsw-openai", algorithm_configuration_name="hnsw",
                                      vectorizer_name="openai-small")],
        vectorizers=[AzureOpenAIVectorizer(vectorizer_name="openai-small", parameters=AzureOpenAIVectorizerParameters(
            resource_url=os.environ["AOAI_ENDPOINT"], deployment_name="text-embedding-3-small",
            model_name="text-embedding-3-small"))]),     # même modèle que l'embedding skill
    semantic_search=SemanticSearch(default_configuration_name="sem", configurations=[SemanticConfiguration(
        name="sem", prioritized_fields=SemanticPrioritizedFields(title_field=SemanticField(field_name="title"),
                                                                 content_fields=[SemanticField(field_name="chunk")]))]),
)
# Rôle requis pour créer l'index : Search Service Contributor
SearchIndexClient(endpoint=os.environ["SEARCH_ENDPOINT"], credential=DefaultAzureCredential()).create_or_update_index(index)
3.3 La requête d'ancrage : hybride + semantic#
from azure.search.documents.models import VectorizableTextQuery

search = SearchClient(os.environ["SEARCH_ENDPOINT"], "docs-index", DefaultAzureCredential())  # Search Index Data Reader
results = search.search(
    search_text="délai de préavis du contrat",                       # partie BM25
    vector_queries=[VectorizableTextQuery(text="délai de préavis du contrat", k_nearest_neighbors=50,
                                          fields="text_vector")],     # vectorisée par le vectorizer de l'index
    query_type="semantic", semantic_configuration_name="sem",          # reranking L2 des 50 premiers
    select=["chunk", "title"], top=5)
for r in results:
    print(r["@search.reranker_score"], r["title"])
k = 50 donne au semantic ranker assez de candidats ; éviter orderby, qui écrase le classement par pertinence. Les filtres
(filter="parent_id eq 'contrat-42'") servent aussi au security trimming (voir le chapitre 01).
3.4 Integrated vectorization#
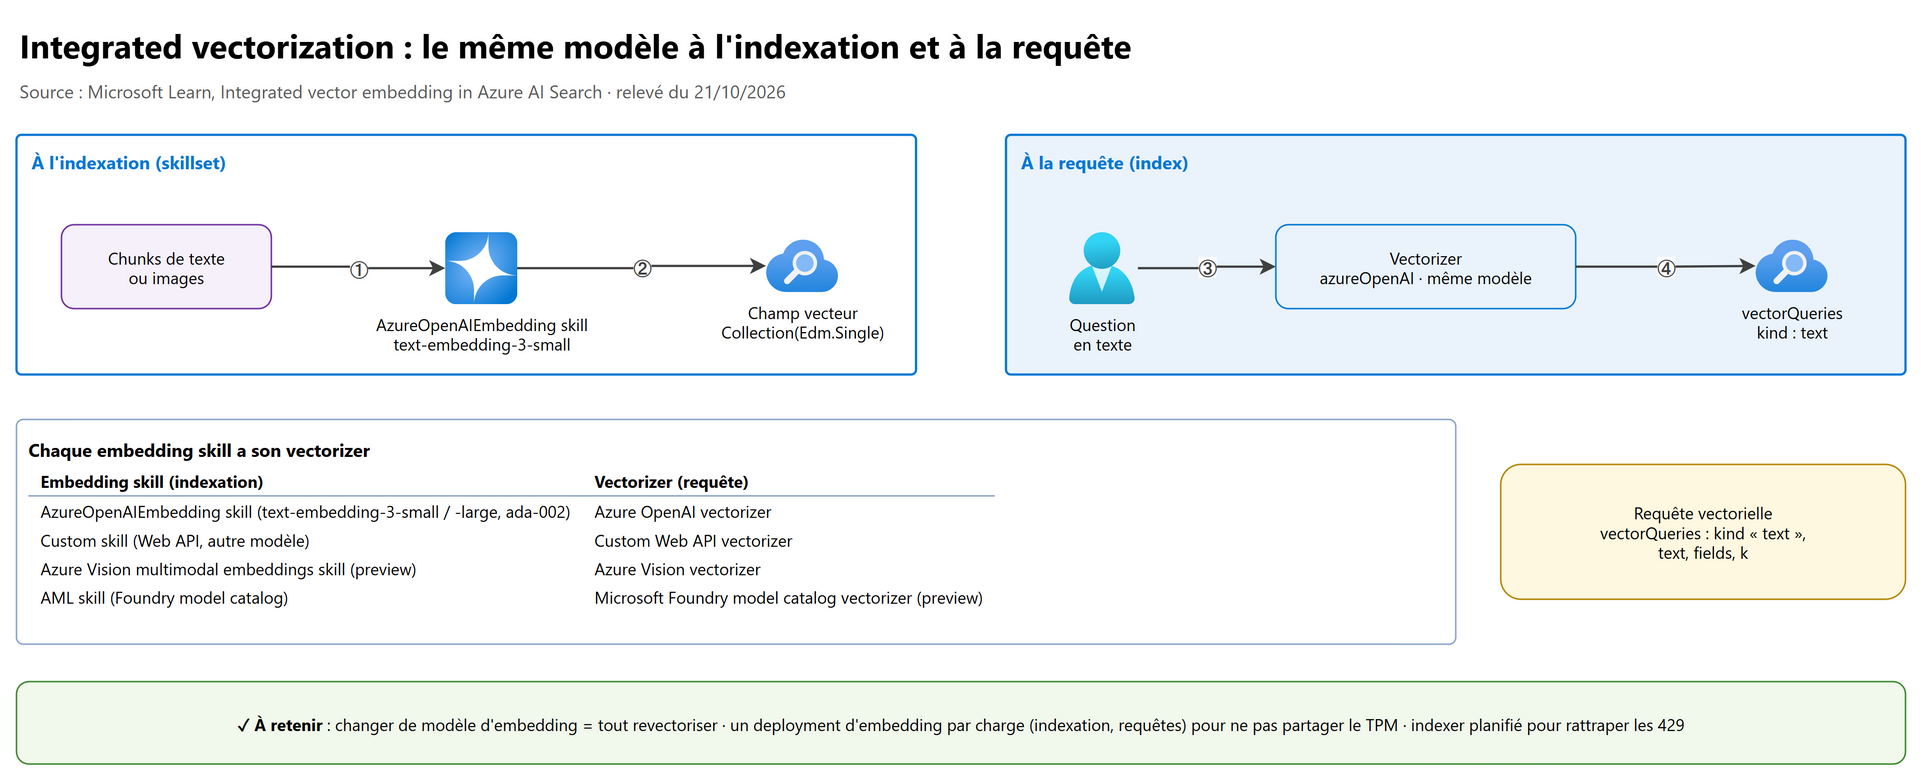
L'integrated vectorization ajoute la vectorisation pendant l'indexation (embedding skill) et pendant la requête
(vectorizer). Rôle de la managed identity du service de recherche sur la ressource du modèle : Cognitive Services OpenAI
User pour l'Azure OpenAI Embedding skill et le vectorizer (seul rôle requis selon la page du skill, que la cible soit Azure
OpenAI ou Foundry). Bénéfices : pas de pipeline à part, mises à jour automatiques quand la source change, réessais intégrés quand
Azure OpenAI renvoie des 429 (d'où la recommandation de planifier l'indexer, par exemple toutes les 5 minutes, pour rattraper les
appels limités). Limites : le TPM d'un modèle est par abonnement : prévoir un deployment d'embedding pour l'indexation et un pour
les requêtes. Pour un accès privé aux modèles : shared private link (openai_account pour Azure OpenAI, sites pour une
Function ou une Web App qui héberge un autre modèle).
4. Enrichir avec des skills intégrés ou personnalisés#
4.1 Les familles de skills#
| Famille | Exemples | Facturation |
|---|---|---|
| Built-in, via la Foundry resource (facturation seule, traitement interne) | OCR, Image Analysis, Entity Recognition, Key Phrase Extraction, Language Detection, PII Detection, Sentiment, Text Translation, Azure Vision multimodal embeddings (preview) | Petit volume gratuit, puis tarif Foundry Tools ; il faut attacher une Foundry resource au skillset (cognitiveServices) |
| Built-in, sur votre ressource (traitement et facturation) | Azure Content Understanding, Azure OpenAI Embedding, GenAI Prompt | Tarif du service appelé |
| Custom | Web API (souvent une Azure Function), AML (modèle Foundry ou Azure Machine Learning) | Celui de votre hébergement |
| Utility (internes, souvent gratuits) | Text Split, Text Merge, Shaper, Conditional, Document Extraction | Aucune, sauf l'extraction d'images de Document Extraction |
Chaque skill a un context (le nœud sur lequel il s'exécute : /document une fois par document,
/document/text_sections/* une fois par chunk), des inputs (chemins dans l'arbre, ou constantes ='texte') et des outputs
(nouveaux nœuds, renommables par targetName).
4.2 GenAI Prompt skill : un LLM dans le pipeline#
Le GenAI Prompt skill (#Microsoft.Skills.Custom.ChatCompletionSkill, GA dans l'API 2026-04-01) envoie une requête chat
completions à un modèle Foundry ou Azure OpenAI pour verbaliser une image, résumer, simplifier ou extraire en JSON
(responseFormat : text, json_object ou json_schema). À savoir :
- endpoints chat completions uniquement (pas la Responses API) ; délai fixe de 30 secondes (attention aux modèles de
raisonnement) ;
maxTokens= 1024 par défaut ; - authentification recommandée : managed identity du service de recherche avec le rôle Cognitive Services OpenAI User
(Azure OpenAI) ou Foundry User (Foundry), jamais
apiKeyetauthIdentityensemble ; - prévoir un deployment dédié à l'indexation pour ne pas consommer le quota des requêtes.
{
  "@odata.type": "#Microsoft.Skills.Custom.ChatCompletionSkill",
  "name": "image-verbalizer",
  "context": "/document/normalized_images/*",
  "inputs": [
    { "name": "image", "source": "/document/normalized_images/*/data" },
    { "name": "systemMessage", "source": "='Tu décris des schémas techniques avec précision.'" },
    { "name": "userMessage", "source": "='Décris ce schéma en 3 phrases.'" }
  ],
  "outputs": [ { "name": "response", "targetName": "image_description" } ],
  "uri": "https://<resource>.openai.azure.com/openai/deployments/gpt-4.1/chat/completions",
  "responseFormat": { "type": "text" }
}
(Sans apiKey ni authIdentity, le skill utilise la system-assigned managed identity du service de recherche.)
4.3 Custom Web API skill : votre code dans le pipeline#
Pour une transformation propre au métier (classification maison, appel d'un modèle externe, normalisation), on expose une API HTTPS,
souvent une Azure Function, et on la déclare en #Microsoft.Skills.Custom.WebApiSkill.
| Paramètre | Défaut | À retenir |
|---|---|---|
uri |
— | HTTPS obligatoire |
timeout |
30 s | de 1 à 230 s (PT230S) |
batchSize |
1000 enregistrements par appel | ≤ batch size de l'indexer, idéalement |
degreeOfParallelism |
5 | de 1 à 10 |
authResourceId |
— | ID d'application (api://<appId>) : le service appelle la Function avec sa managed identity et un jeton Entra (Function configurée avec Microsoft Entra) |
httpHeaders |
— | jamais affichés en clair au GET (<redacted>) |
L'API reçoit et renvoie un tableau values ; chaque enregistrement garde son recordId :
{ "values": [ { "recordId": "0", "data": { "text": "Contrat de maintenance ..." } } ] }
{ "values": [ { "recordId": "0", "data": { "category": "maintenance" }, "errors": [], "warnings": [] } ] }
Le AML skill appelle un modèle déployé dans Foundry ou Azure Machine Learning (par exemple un modèle d'embedding du catalogue). Pour mettre au point un skillset : Debug sessions (visualiser l'enrichment tree, rejouer un document) et enrichment cache (preview, ne réexécuter que les skills modifiés).
5. Le flux d'ingestion RAG, documents et OCR#
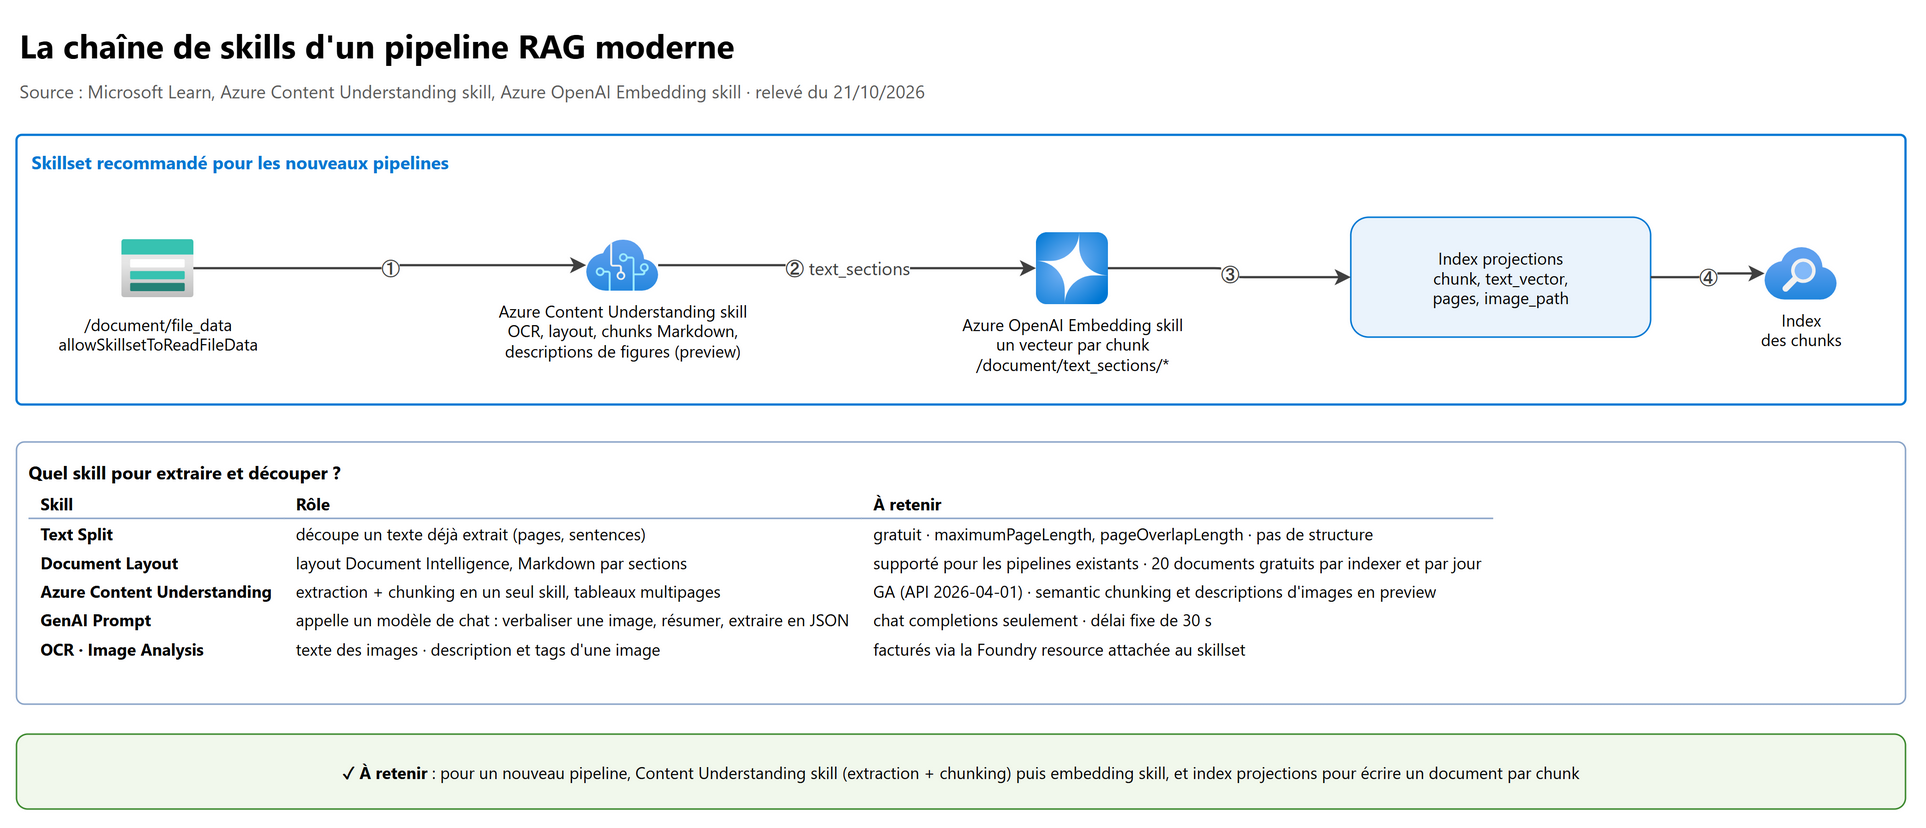
5.1 Le chemin recommandé pour un nouveau pipeline#
Microsoft recommande, pour les nouveaux skillsets, l'Azure Content Understanding skill : il fait extraction (dont l'OCR) et chunking en un seul skill, rend les tableaux et figures en Markdown (plus lisible par un LLM que le texte brut du Document Layout skill), reconnaît les tableaux sur plusieurs pages, permet des chunks qui franchissent les pages, et coûte moins cher que le Document Layout skill. Le Document Layout skill reste supporté pour les pipelines existants.
| Paramètre du Content Understanding skill | Valeurs |
|---|---|
extractionOptions |
["images"], ["locationMetadata"] ou les deux |
chunkingProperties.method |
fixedSize (défaut, en characters, 300 à 50 000, défaut 500) ou semantic (preview, en tokens, 100 à 8 000 ; respecte paragraphes et titres) |
overlapLength |
moins de la moitié de maximumLength ; interdit (0) en semantic |
modelName + modelDeployment (preview, API 2026-05-01-preview) |
un modèle de chat déployé dans la Foundry resource attachée : descriptions d'images insérées dans le Markdown du chunk ; les deux ou aucun |
| Entrée | file_data : indexer avec allowSkillsetToReadFileData: true (Blob uniquement) |
| Sorties | text_sections (content en Markdown, locationMetadata : pageNumberFrom, pageNumberTo…, imagePath), normalized_images |
Skillset de référence (extrait de la doc, clés retirées : en production, managed identity partout) :
{
  "name": "rag-skillset",
  "skills": [
    {
      "@odata.type": "#Microsoft.Skills.Util.ContentUnderstandingSkill",
      "context": "/document",
      "extractionOptions": ["images", "locationMetadata"],
      "chunkingProperties": { "method": "semantic", "unit": "tokens", "maximumLength": 500 },
      "inputs":  [ { "name": "file_data", "source": "/document/file_data" } ],
      "outputs": [ { "name": "text_sections", "targetName": "text_sections" },
                   { "name": "normalized_images", "targetName": "normalized_images" } ]
    },
    {
      "@odata.type": "#Microsoft.Skills.Text.AzureOpenAIEmbeddingSkill",
      "context": "/document/text_sections/*",
      "inputs":  [ { "name": "text", "source": "/document/text_sections/*/content" } ],
      "outputs": [ { "name": "embedding", "targetName": "text_vector" } ],
      "resourceUri": "https://<resource>.openai.azure.com",
      "deploymentId": "text-embedding-3-small",
      "modelName": "text-embedding-3-small"
    }
  ],
  "indexProjections": {
    "selectors": [ {
      "targetIndexName": "docs-index",
      "parentKeyFieldName": "parent_id",
      "sourceContext": "/document/text_sections/*",
      "mappings": [
        { "name": "chunk", "source": "/document/text_sections/*/content" },
        { "name": "text_vector", "source": "/document/text_sections/*/text_vector" },
        { "name": "title", "source": "/document/metadata_storage_name" }
      ] } ],
    "parameters": { "projectionMode": "skipIndexingParentDocuments" }
  }
}
Les index projections remplacent les output field mappings dans ce scénario ; skipIndexingParentDocuments n'écrit que les
chunks (pas le document parent).
5.2 Les autres chemins (pipelines existants ou cas simples)#
| Besoin | Skills |
|---|---|
| Texte déjà extractible (PDF numériques, Office) | Document cracking + Text Split (pages ou sentences, maximumPageLength, pageOverlapLength) + embedding |
| PDF scannés, images de texte (OCR classique) | imageAction: generateNormalizedImages + OCR skill + Text Merge (réinsère le texte des images dans le contenu) + Text Split |
| Structure (titres, tableaux) avec Document Intelligence | Document Layout skill (Markdown ou texte, découpage par sections ; 20 documents gratuits par indexer et par jour, puis Foundry resource payante) |
| Images à rendre cherchables | Document Extraction ou Content Understanding skill, puis GenAI Prompt (verbalisation) ou embeddings multimodaux |
Taille des chunks : la recommandation de départ (512 jetons, 25 % de chevauchement) est au chapitre 01.
5.3 Dépannage d'un pipeline RAG#
| Symptôme | Cause probable |
|---|---|
400 Skill validation failed |
modelName sans modelDeployment ; overlapLength > 0 en semantic ; couple method/unit invalide |
| 401 ou 403 vers la Foundry resource | mauvaise ressource dans cognitiveServices, ou rôle manquant pour l'identité du service de recherche |
text_sections vide |
format non supporté, région non supportée, PDF protégé par mot de passe |
| Timeout sur de gros PDF | le skill coupe au-delà de 5 minutes d'analyse (et facture quand même) : découper les fichiers, batchSize = 1 |
| Index qui ne suit pas les mises à jour | pas de schedule ou pas de change detection (SQL, Cosmos DB) |
Statut transientFailure |
succès partiel : relancer ou attendre la prochaine exécution planifiée |
6. Brancher la récupération sur les agents et les workflows#
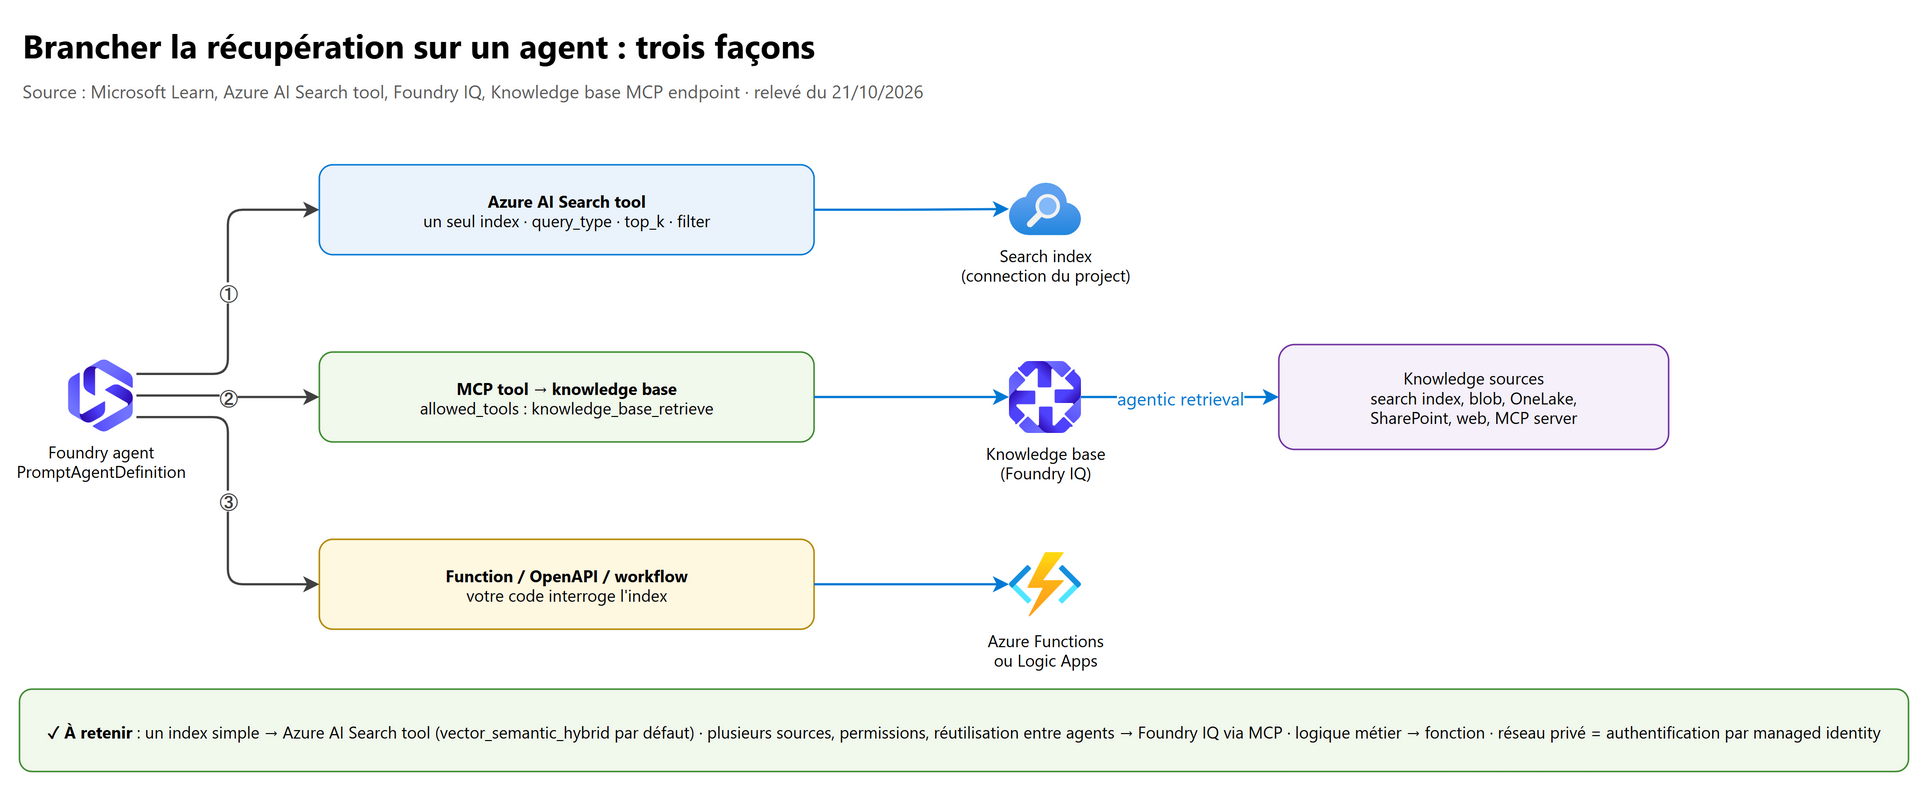
6.1 L'Azure AI Search tool (un index, simple)#
L'agent interroge un seul index d'une connection du project et cite ses sources.
| Paramètre | Obligatoire | À retenir |
|---|---|---|
project_connection_id |
oui | connection du project vers le service de recherche |
index_name |
oui | sensible à la casse |
top_k |
non | 5 par défaut |
query_type |
non | vector_semantic_hybrid par défaut ; aussi simple, vector, semantic, vector_simple_hybrid |
filter |
non | appliqué à toutes les requêtes de l'agent (gabarit {{variable}} possible avec les structured inputs) |
from azure.ai.projects.models import (AISearchIndexResource, AzureAISearchTool, AzureAISearchToolResource,
                                      PromptAgentDefinition)

conn_id = project.connections.get("my-search-connection").id     # project = AIProjectClient (chapitre 05)
agent = project.agents.create_version(
    agent_name="assistant-contrats",
    definition=PromptAgentDefinition(
        model="gpt-5-mini",
        instructions="Réponds uniquement à partir de l'index et cite chaque source.",
        tools=[AzureAISearchTool(azure_ai_search=AzureAISearchToolResource(indexes=[AISearchIndexResource(
            project_connection_id=conn_id, index_name="docs-index")]))]))   # query_type omis : vector_semantic_hybrid
Accès sans clé : sur le service de recherche, donner à la managed identity de la Foundry resource les rôles Search Index Data Contributor et Search Service Contributor (la doc de l'outil) ; avec un réseau privé, l'authentification par managed identity est obligatoire (pas de clé), et l'agent doit être en standard setup avec VNet injection. Le service de recherche et l'agent doivent être dans le même tenant.
6.2 Foundry IQ : une knowledge base exposée en MCP#
Une knowledge base (Azure AI Search, alias Foundry IQ dans le portail Foundry) regroupe des knowledge sources et applique
l'agentic retrieval (sous-requêtes en parallèle, reclassement unifié, citations). Chaque base est un serveur MCP qui expose
l'outil knowledge_base_retrieve :
https://<search-service>.search.windows.net/knowledgebases/<knowledge-base>/mcp?api-version=<version>
Avec 2026-04-01 (GA), la récupération est extractive (données d'ancrage seulement) ; avec 2026-08-01-preview, la base peut
renvoyer des réponses synthétisées si un LLM et un niveau de raisonnement compatible sont configurés.
from azure.ai.projects.models import MCPTool, PromptAgentDefinition

kb_tool = MCPTool(server_label="knowledge-base", server_url=mcp_endpoint, require_approval="never",
                  allowed_tools=["knowledge_base_retrieve"], project_connection_id=project_connection_name)
agent = project.agents.create_version(agent_name="assistant-rh", definition=PromptAgentDefinition(
    model="gpt-5-mini", tools=[kb_tool],
    instructions="Utilise toujours la knowledge base, cite les sources, sinon réponds « je ne sais pas »."))
| Knowledge source | Type | Remarque |
|---|---|---|
| Search index | indexé | enveloppe un index existant |
| Azure blob, OneLake | indexé | pipeline d'indexation généré automatiquement |
| File (preview), Azure SQL (preview), Indexed SharePoint (preview) | indexé | — |
| Remote SharePoint (preview), Web (Bing), MCP server (preview), Work IQ (preview), Fabric Data Agent / Ontology (preview) | distant | interrogé à la volée, rien n'est ingéré, pas d'URL de citation |
Réglages utiles : retrieval reasoning effort minimal (pas de LLM, le plus rapide), low, medium (passe itérative) ;
alwaysQuery pour forcer une source ; retrievalInstructions pour guider le choix des sources ; permissions au niveau
document et sensitivity labels Purview (preview, avec le jeton de l'utilisateur dans la requête).
6.3 Workflows et code#
Quand la récupération doit être mêlée à de la logique métier : une fonction (function calling), un outil OpenAPI, une Azure Function ou un Logic Apps workflow interroge l'index et renvoie le résultat à l'agent, ou un workflow Microsoft Agent Framework enchaîne récupération, décision et approbation (voir les chapitres 05 et 06).
| Besoin | Choix |
|---|---|
| Un index, mise en place rapide, citations | Azure AI Search tool |
| Plusieurs sources, SharePoint ou web, permissions, réutilisation entre agents et clients MCP | Foundry IQ (knowledge base via MCP tool) |
| Règles métier, appels combinés, transformation des résultats | Fonction / OpenAPI / workflow |
| Application sans agent | RAG dans le code (chapitre 05) |
7. Extraire avec des pipelines multimodaux (OCR, layout, champs)#
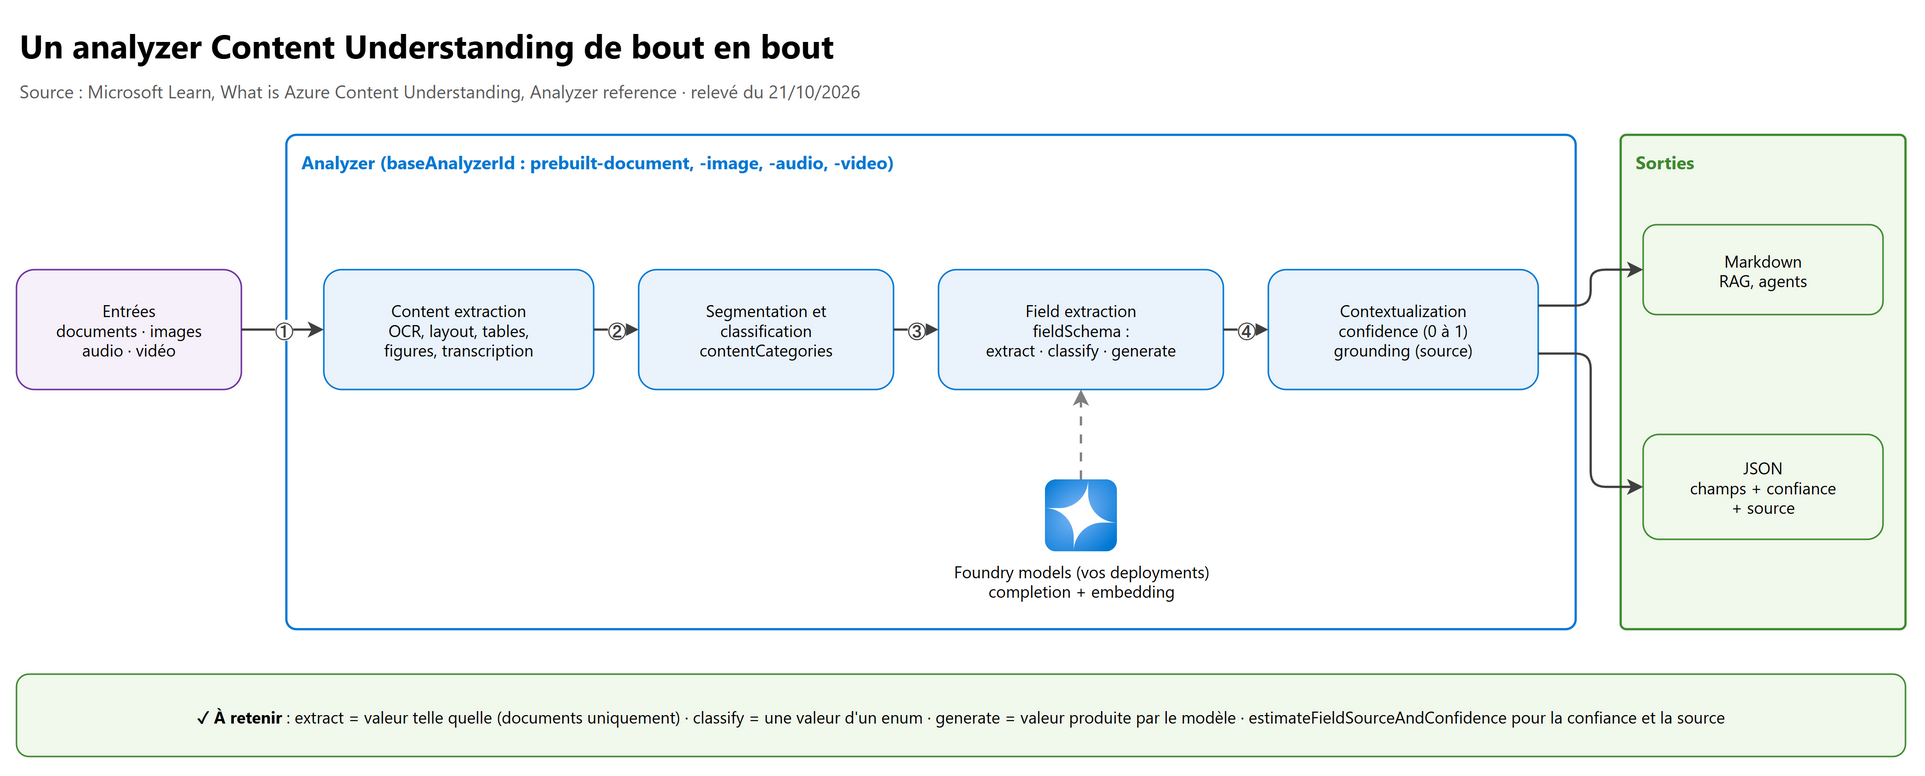
7.1 Azure Content Understanding in Foundry Tools#
Content Understanding est un Foundry Tool de la Foundry resource qui utilise l'IA générative pour transformer documents, images, audio et vidéo en Markdown ou en JSON conforme à un schéma. Ses étapes :
| Étape | Ce qu'elle fait |
|---|---|
| Content extraction | OCR, marques de sélection, codes-barres, formules, layout (paragraphes, sections, tableaux) ; transcription pour l'audio et la vidéo |
| Segmentation | découpe en sections logiques (enableSegment) : par type de document, par scène vidéo |
| Field extraction | champs du fieldSchema par extract, classify ou generate |
| Contextualization | normalisation, confidence (0 à 1), grounding (zone source de chaque valeur), préparation du contexte des modèles |
| Foundry models | vos deployments (un modèle de chat et un modèle d'embedding) : bring your own deployment |
| Structured output | Markdown (recherche, RAG) ou JSON (automatisation, analytique) |
Versions : 2025-11-01 (GA) pour la production ; 2026-06-01-preview pour les nouveautés (dont l'agentic mode).
Expériences : Content Understanding Studio (catalogue complet, analyzers personnalisés, étiquetage, API GA et preview) et le
playground Foundry (new) (preview seulement, pas de création d'analyzer personnalisé).
7.2 Azure Document Intelligence in Foundry Tools#
Document Intelligence (v4.0, API 2024-11-30 GA) fournit une extraction déterministe et à faible latence :
| Famille | Modèles | Quand |
|---|---|---|
| Analyse | Read (texte imprimé et manuscrit), Layout (texte, tableaux, structure, sortie Markdown) | OCR, préparation de documents pour le RAG |
| Prebuilt | factures, reçus, pièces d'identité, formulaires fiscaux, etc. (plus de 20) | documents standards à fort volume |
| Custom extraction | custom template (mise en page fixe, entraînement en minutes) ; custom neural (structuré et semi-structuré, recommandé) | formulaires propres à l'entreprise, 5 exemples étiquetés minimum |
| Custom classification | classifier (au moins deux types de documents) ; composed model | trier puis router |
Limites utiles : 2 000 pages par PDF ou TIFF (2 premières en F0), 500 Mo en S0 (4 Mo en F0), images de 50 × 50 à 10 000 × 10 000 pixels, texte d'au moins 12 pixels de haut.
7.3 Content Understanding ou Document Intelligence ?#
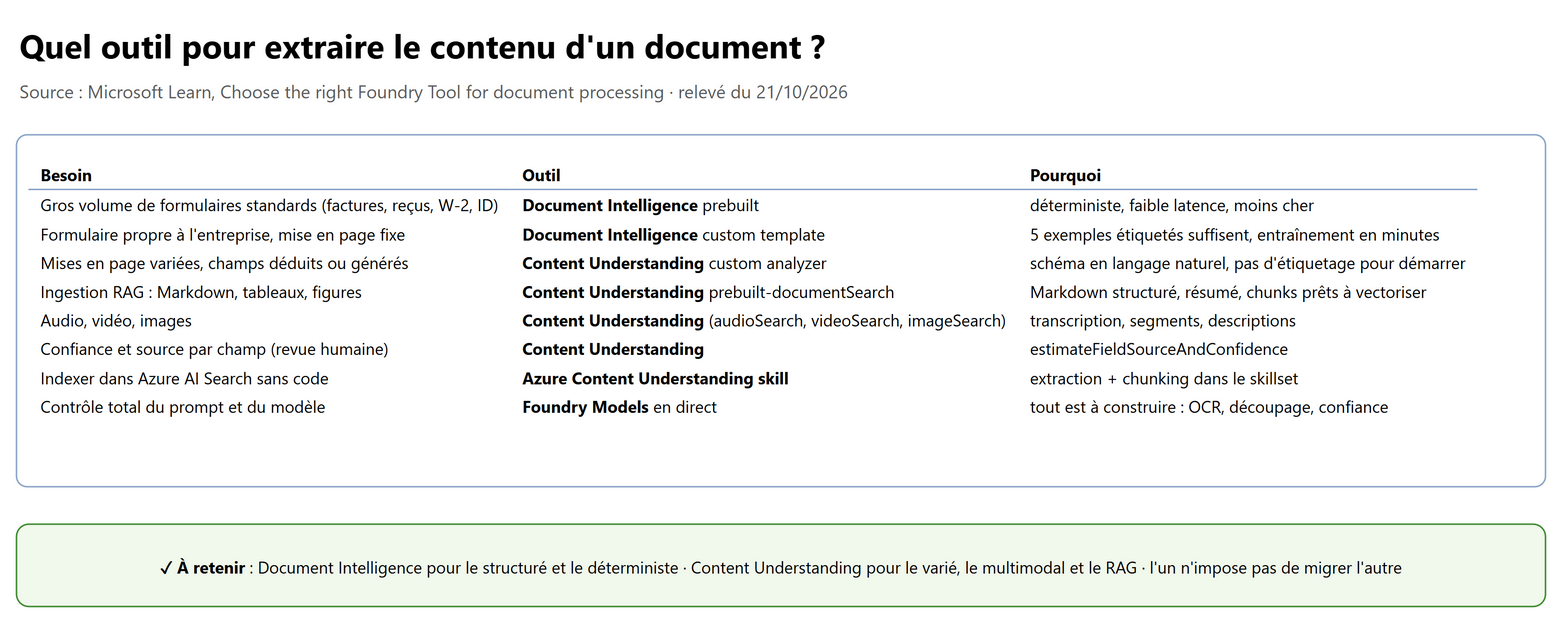
Microsoft présente Document Intelligence comme faisant partie des capacités de Content Understanding : DI pour l'extraction déterministe de documents structurés, les analyzers CU (LLM) pour le varié, le non structuré et le multimodal. Un client déjà en production sur Document Intelligence n'a rien à migrer (API, SDK et facturation inchangés).
| Document Intelligence | Content Understanding | |
|---|---|---|
| Idéal pour | gros volumes, formulaires standards | modèles variés, non structuré, multimodal |
| Étiquetage | requis pour les modèles personnalisés (5 exemples minimum) | aucun pour démarrer, étiqueter pour améliorer |
| IA générative | non | oui : champs déduits, raisonnement |
| Entrées | documents | documents, images, audio, vidéo |
| Latence | faible | moyenne |
| Confiance et source par champ | oui | oui |
flowchart TD
    A["Contenu à extraire"] --> B{"Audio, vidéo ou image ?"}
    B -- Oui --> CU1["Content Understanding : prebuilt audioSearch, videoSearch, imageSearch ou analyzer personnalisé"]
    B -- Non --> C{"Type de document standard avec un modèle prebuilt ?"}
    C -- Oui --> DI1["Document Intelligence prebuilt : déterministe, moins cher"]
    C -- Non --> D{"Mise en page fixe et exemples étiquetés ?"}
    D -- Oui --> DI2["Document Intelligence custom template ou neural"]
    D -- Non --> E{"But : RAG ou agent ?"}
    E -- Oui --> CU2["Content Understanding prebuilt-documentSearch : Markdown prêt à indexer"]
    E -- Non --> CU3["Content Understanding custom analyzer : fieldSchema, confiance, source"]
8. Des représentations propres et ancrées pour les agents et le RAG#
8.1 Les prebuilt analyzers utiles au RAG#
| Analyzer | Sortie |
|---|---|
prebuilt-documentSearch |
Markdown structuré (paragraphes, tableaux, figures), descriptions de figures, graphiques en syntaxe chart.js et diagrammes en mermaid.js (PDF et images), annotations manuscrites, résumé d'un paragraphe, sortie découpée prête pour l'embedding (fixe ou sémantique) |
prebuilt-imageSearch |
description d'un paragraphe d'une image (pour une image contenant du texte : prebuilt-documentSearch) |
prebuilt-audioSearch |
transcription avec diarisation et horodatage, résumé de la conversation |
prebuilt-videoSearch |
segments automatiques (changements de sujet ou de scène), transcription, descriptions, résumé par segment |
prebuilt-read, prebuilt-layout, prebuilt-digitalParse |
extraction de contenu seule (OCR, layout, ou lecture directe d'un fichier numérique), sans modèle de langage |
8.2 Obtenir le Markdown, sans clé#
# pip install azure-ai-contentunderstanding azure-identity
import os
from azure.ai.contentunderstanding import ContentUnderstandingClient
from azure.ai.contentunderstanding.models import AnalysisInput
from azure.identity import DefaultAzureCredential

# Prérequis : deployments par défaut (modèle de chat + embedding) définis au niveau de la ressource
# Rôle data plane : celui cité pour les appels directs aux Foundry Tools (Cognitive Services User) ; Owner ou Contributor ne suffisent pas
client = ContentUnderstandingClient(endpoint=os.environ["CONTENTUNDERSTANDING_ENDPOINT"],
                                    credential=DefaultAzureCredential())
poller = client.begin_analyze(analyzer_id="prebuilt-documentSearch",
                              inputs=[AnalysisInput(url="https://<compte>.blob.core.windows.net/docs/contrat.pdf")])
result = poller.result()                      # opération longue : poller
content = result.contents[0]
print(content.markdown)                       # Markdown propre, à découper et indexer
Pourquoi c'est « propre et ancré » :
- la structure (titres, tableaux, figures décrites) est conservée, ce qui donne de meilleurs chunks et un LLM qui comprend les tableaux ;
- chaque champ peut porter sa confidence et sa source (page, polygone) : l'agent peut citer, et un humain vérifier ;
- les sorties sont prévisibles (même schéma pour tous les fichiers), ce qui fiabilise les étapes suivantes d'un agent.
Intégrations documentées : LangChain (AzureAIContentUnderstandingLoader), MarkItDown (choisit l'analyzer selon le type de
fichier), et bien sûr l'Azure Content Understanding skill d'Azure AI Search. Côté données : les entrées sont supprimées à la fin
du traitement, les résultats gardés 24 heures pour la récupération asynchrone.
9. Les analyzers Content Understanding, sortie structurée ou Markdown#
9.1 L'anatomie d'un analyzer#
| Propriété | Rôle |
|---|---|
analyzerId, description |
identifiant ; la description sert de contexte au modèle : la soigner |
baseAnalyzerId |
l'un des quatre seuls parents possibles : prebuilt-document, prebuilt-image, prebuilt-audio, prebuilt-video |
models |
noms de modèles (pas de deployments) : completion (extraction, segmentation, figures) et embedding ; le service les relie aux deployments par défaut de la ressource (PATCH …/contentunderstanding/defaults) ou à ceux de la requête |
config |
options de traitement (tableau suivant) |
fieldSchema |
les champs à produire |
Option de config |
Défaut | Effet |
|---|---|---|
returnDetails |
false | confiance, boîtes, spans, métadonnées dans la réponse |
enableOcr, enableLayout |
true | OCR et structure (documents) |
enableFormula, enableBarcode |
true | formules en LaTeX, codes-barres et QR codes |
tableFormat |
html |
ou markdown |
enableFigureDescription, enableFigureAnalysis |
false | description des figures (texte alternatif), analyse des graphiques et diagrammes |
estimateFieldSourceAndConfidence |
false | source et confiance de chaque champ (documents) |
contentCategories + enableSegment |
— / false | classification et découpage d'un fichier mixte, routage de chaque catégorie vers un autre analyzer (analyzerId) ; prévoir une catégorie other |
segmentPerPage, omitContent |
false | un segment par page ; ne renvoyer que les résultats des sous-analyzers |
locales |
[] | langues de transcription (audio, vidéo) |
workflow (preview) |
default |
agentic : agentic mode, raisonnement sur les preuves du document (un fichier par requête) |
9.2 Le fieldSchema et les trois méthodes#
| Méthode | Principe | Exemple | Contrainte |
|---|---|---|---|
extract |
valeur telle qu'elle apparaît | numéro de facture, date | documents uniquement ; exige estimateSourceAndConfidence: true sur le champ |
classify |
une valeur parmi un enum |
type de document, sentiment d'un appel | — |
generate |
valeur produite par le modèle | résumé, description de scène, total déduit | — |
Types : string, number, boolean, date, object, array (normalisation automatique, par exemple des dates) ; éviter plus de
deux ou trois niveaux d'imbrication.
from azure.ai.contentunderstanding.models import (ContentAnalyzer, ContentAnalyzerConfig, ContentFieldDefinition,
                                                  ContentFieldSchema, ContentFieldType, GenerationMethod)

schema = ContentFieldSchema(name="contrat", description="Champs d'un contrat de maintenance", fields={
    "fournisseur": ContentFieldDefinition(type=ContentFieldType.STRING, method=GenerationMethod.EXTRACT,
                                          description="Raison sociale du prestataire", estimate_source_and_confidence=True),
    "montant_annuel": ContentFieldDefinition(type=ContentFieldType.NUMBER, method=GenerationMethod.EXTRACT,
                                             description="Montant annuel HT", estimate_source_and_confidence=True),
    "type_contrat": ContentFieldDefinition(type=ContentFieldType.STRING, method=GenerationMethod.CLASSIFY,
                                           description="Nature du contrat", enum=["maintenance", "licence", "autre"]),
    "resume": ContentFieldDefinition(type=ContentFieldType.STRING, method=GenerationMethod.GENERATE,
                                     description="Résumé en 3 phrases des obligations du prestataire"),
})
analyzer = ContentAnalyzer(base_analyzer_id="prebuilt-document", description="Analyse des contrats de maintenance",
                           config=ContentAnalyzerConfig(enable_ocr=True, enable_layout=True, return_details=True,
                                                        estimate_field_source_and_confidence=True),
                           field_schema=schema,
                           models={"completion": "gpt-5.2", "embedding": "text-embedding-3-large"})
client.begin_create_analyzer(analyzer_id="contrat_maintenance", resource=analyzer).result()

result = client.begin_analyze(analyzer_id="contrat_maintenance", inputs=[AnalysisInput(url=url_contrat)]).result()
champ = result.contents[0].fields["montant_annuel"]
print(champ.value, champ.confidence)          # router vers une revue humaine si la confiance est basse
Le même analyzer se crée en REST : PUT {endpoint}/contentunderstanding/analyzers/{analyzerId}?api-version=2025-11-01 (réponse
201 avec un Operation-Location à suivre). Pour partir d'un prebuilt : GET /analyzers/prebuilt-invoice, modifier la définition,
puis PUT sous un nouveau nom. Microsoft conseille de copier un prebuilt plutôt que de dépendre de sa définition en production
(elle peut changer d'une version d'API à l'autre).
9.3 Markdown ou JSON : que produire ?#
| Consommateur en aval | Sortie |
|---|---|
| Index de recherche, RAG, knowledge base | Markdown (prebuilt-documentSearch, ou content.markdown d'un analyzer) |
| Automatisation (ERP, workflow, RPA), analytique | JSON de champs avec confiance et source |
| Agent qui doit raisonner puis agir | les deux : Markdown comme contexte, champs pour décider (et seuils de confiance pour l'approbation humaine) |
9.4 Historique utile : standard, pro, agentic#
L'ancienne préversion 2025-05-01-preview proposait un mode standard (une tâche, un fichier) et un mode pro (raisonnement,
plusieurs fichiers, base de connaissances externe pour valider). Cette API est retirée ; le remplaçant est l'agentic mode
(config.workflow: "agentic", API 2026-06-01-preview), qui n'est pas un remplacement à l'identique (un seul fichier par requête au
départ). Les guardrails du deployment de modèle s'appliquent aussi : un analyze peut réussir avec des avertissements et des
champs non renvoyés.
10. Labs conseillés#
À faire dans un abonnement de test : Azure AI Search (Basic ou plus pour le semantic ranker), une Foundry resource dans une région où Content Understanding est disponible, un deployment de chat et un d'embedding ; quelques euros, supprimer le groupe de ressources à la fin (le semantic ranker et Content Understanding sont facturés à l'usage).
Lab 1 · Pipeline RAG sans code
- Déposer 3 PDF (dont un scanné) dans un conteneur Blob.
- Azure AI Search > Import data > RAG ; managed identity pour Blob et Azure OpenAI ; activer le semantic ranker.
- Ouvrir l'index, le skillset et l'indexer créés ; lire leur JSON.
- Résultat attendu : un document par chunk, un champ vector, une semantic configuration ; le PDF scanné est cherchable.
Lab 2 · Skillset moderne en REST
- Créer à la main l'index, le skillset de la section 5.1 (Content Understanding skill en
fixedSize, puis ensemanticavec l'API preview) et l'indexer avecallowSkillsetToReadFileData: true. GET …/indexers/{name}/statusjusqu'àsuccess.- Résultat attendu : chunks en Markdown avec
page_number_frometimage_path; un tableau multipage reste dans un seul chunk.
Lab 3 · Requête d'ancrage
- Lancer la requête de la section 3.3 avec et sans
query_type="semantic", puis sans la partie vectorielle. - Comparer l'ordre des résultats et
@search.reranker_score. - Résultat attendu : hybride + semantic remonte le bon passage en tête, même quand la question n'emploie pas les mots du texte.
Lab 4 · Agent branché sur l'index
- Créer une connection Azure AI Search dans le project (authentification Entra), rôles Search Index Data Contributor et Search Service Contributor pour l'identité de la Foundry resource.
- Créer l'agent de la section 6.1 ; poser une question couverte par un document.
- Résultat attendu : réponse avec annotations
url_citation; question hors corpus : « je ne sais pas ».
Lab 5 · Analyzer personnalisé
- Dans Content Understanding Studio, configurer les deployments par défaut de la ressource.
- Créer l'analyzer de la section 9.2 (ou partir de
prebuilt-invoice), l'exécuter sur deux documents différents. - Résultat attendu : JSON avec
confidenceet source par champextract, untype_contratpris dans l'enum, un résumé généré.
11. Les pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Rafraîchir l'index toutes les minutes avec un indexer | Impossible : 5 minutes minimum, sinon push API | Limite du schedule |
| Un indexer pour deux sources | Deux indexers vers le même index | Un indexer = un data source, un index |
| Nouvelles lignes Azure SQL non indexées | Activer la change detection (high water mark ou change tracking) | Pas intégrée pour SQL et Cosmos DB |
| Fichiers supprimés toujours présents dans l'index | Deletion detection (soft delete Blob ou métadonnée IsDeleted) |
Sinon documents orphelins |
| Un document par chunk dans l'index | Index projections (skipIndexingParentDocuments) |
Indexation one-to-many |
| Nouveau skillset : extraction + OCR + chunking en un seul skill | Azure Content Understanding skill | Recommandé à la place du Document Layout skill |
| Le Content Understanding skill ne reçoit rien | Indexer : allowSkillsetToReadFileData: true |
Fournit /document/file_data (Blob) |
semantic chunking avec chevauchement |
Erreur 400 : overlapLength doit être 0 |
Le chevauchement ne vaut qu'en fixedSize |
| Descriptions d'images dans les chunks | modelName et modelDeployment (preview) |
Les deux ou aucun |
| Vectoriser la question sans code | Vectorizer dans l'index, même modèle que l'embedding skill | Integrated vectorization |
| Modèle d'embedding changé | Revectoriser tout l'index | Espaces de vecteurs incompatibles |
| Indexation qui sature le TPM des requêtes | Deployments séparés (indexation, requêtes) | Le TPM est par modèle et par abonnement |
| Réduire la mémoire des vecteurs sans perte notable | Scalar ou binary quantization + rescoring | Recommandé avant les autres options |
| GenAI Prompt skill vers la Responses API | Non : chat completions seulement | Limite documentée |
| Custom skill qui expire à 30 s | timeout jusqu'à 230 s |
Défaut 30 s |
| Custom skill sans secret | authResourceId + managed identity du service de recherche |
Jeton Entra vers la Function |
| Agent : plusieurs index et SharePoint | Foundry IQ (knowledge base) via MCP tool | L'Azure AI Search tool ne cible qu'un index |
| Azure AI Search tool en réseau privé | Managed identity (pas de clé) + standard setup avec VNet injection | Les clés ne passent pas en réseau privé |
| Mode de requête par défaut de l'Azure AI Search tool | vector_semantic_hybrid |
Défaut documenté |
| Factures standard, gros volume, coût minimal | Document Intelligence prebuilt | Déterministe et moins cher |
| Champs à déduire de documents aux mises en page variées | Content Understanding custom analyzer | Schéma en langage naturel, pas d'étiquetage |
Méthode extract sur une vidéo |
Impossible : documents uniquement ; generate ou classify |
Contrainte de la méthode |
Parent d'un analyzer personnalisé : prebuilt-invoice |
Non : baseAnalyzerId = prebuilt-document, -image, -audio ou -video ; pour partir d'un prebuilt, copier sa définition |
Seuls quatre parents |
models dans l'analyzer |
Noms de modèles, reliés aux deployments par défaut de la ressource | Pas des noms de deployments |
| Trier un PDF qui contient factures et reçus | contentCategories + enableSegment: true (+ catégorie other) |
Classification et découpage |
| Pro mode de Content Understanding | Retiré avec 2025-05-01-preview → agentic mode (preview) |
Historique |
12. Scénarios d'entraînement#
1. Un cabinet indexe 50 000 PDF, dont beaucoup sont scannés, pour un assistant juridique. Les tableaux s'étendent sur plusieurs pages et doivent rester lisibles par le LLM.
Indexer Blob avec
allowSkillsetToReadFileData, skillset Azure Content Understanding skill (OCR et chunking en un skill, tableaux multipages en Markdown,semanticchunking en preview si accepté), Azure OpenAI Embedding skill, index projections vers un index de chunks. Le Document Layout skill ne serait justifié que pour un pipeline existant.
2. Les fiches produits sont dans Azure SQL et changent toutes les heures ; les nouveautés n'apparaissent jamais dans l'index.
Le data source n'a pas de change detection : activer une politique (high water mark sur une colonne
rowversion, ou SQL change tracking) et mettre l'indexer sur un schedule (par exemplePT1H).
3. Une application doit voir un prix mis à jour dans la seconde dans l'index.
Un indexer ne descend pas sous 5 minutes : utiliser le push model (
merge_or_upload_documents) depuis le code qui modifie le prix, avec le rôle Search Index Data Contributor.
4. Après avoir remplacé text-embedding-ada-002 par text-embedding-3-small dans l'embedding skill, les requêtes renvoient des résultats aberrants.
Le vectorizer de l'index utilise encore l'ancien modèle, et les anciens vecteurs ne sont pas comparables : aligner le vectorizer sur le même modèle, adapter
dimensionssi besoin et réindexer tout le contenu.
5. Une équipe veut rendre cherchables les schémas d'architecture inclus dans des documents Word.
Extraire les images (Content Understanding skill avec
extractionOptionsimages, ou Document Extraction), puis soit les verbaliser avec le GenAI Prompt skill (texte cherchable et vectorisable), soit activer les descriptions d'images du Content Understanding skill (preview) ; stocker les images dans un knowledge store pour les afficher.
6. Un agent Foundry doit répondre à partir d'un index, d'un site SharePoint et du web, en respectant les droits de chaque utilisateur.
Foundry IQ : une knowledge base avec trois knowledge sources (search index, Remote SharePoint en preview, Web), exposée en MCP et branchée par un MCP tool (
knowledge_base_retrieve) ; permissions au niveau document avec le jeton de l'utilisateur. L'Azure AI Search tool ne cible qu'un index.
7. L'Azure AI Search tool échoue avec « Unable to connect to Azure AI Search Resource » depuis que le service de recherche est derrière un Private Endpoint.
En réseau privé, la connection doit utiliser la managed identity du project (authentification Entra) et non une clé ; l'agent doit être en standard setup avec VNet injection.
8. Un service achats reçoit des milliers de factures de fournisseurs connus et veut le coût le plus bas avec un résultat déterministe.
Document Intelligence, modèle prebuilt invoice : déterministe, faible latence, moins cher. Content Understanding se justifie pour des documents très variés ou des champs à déduire.
9. Une assurance traite des dossiers PDF qui mélangent formulaires de sinistre, factures et photos ; elle veut extraire des champs différents selon le type, avec une revue humaine quand la confiance est basse.
Un analyzer Content Understanding de classification (
contentCategories+enableSegment: true, catégorieother) qui route chaque segment vers un analyzer dédié (prebuilt-invoice, analyzer personnalisé « sinistre ») ;estimateFieldSourceAndConfidenceet un seuil de confidence pour envoyer les cas douteux en revue.
10. Un développeur crée un analyzer personnalisé avec "baseAnalyzerId": "prebuilt-invoice" et la méthode extract sur un champ
d'une vidéo de formation ; la création échoue.
Deux erreurs :
baseAnalyzerIdn'accepte queprebuilt-document,-image,-audioou-video(pour réutiliserprebuilt-invoice, copier sa définition) ; etextractne vaut que pour les documents : utilisergenerateouclassifysur une vidéo.
13. Pour aller plus loin#
- Agentic retrieval en détail :
retrievalInstructions, image serving (preview, images des documents injectées dans la synthèse), analyzers de langue automatiques, ingestion privée par shared private link : pages knowledge source d'Azure AI Search. - Sécurité des données indexées : ACL et sensitivity labels Purview synchronisés par l'indexer (preview), filtres de sécurité à la requête ; Network Security Perimeter et Private Endpoints (voir le chapitre 03).
- Azure API Management devant les skills et vectorizers : les skills Azure OpenAI acceptent un endpoint APIM (passerelle IA, quotas, journaux).
- Video Indexer pour les vidéos longues et les insights profonds (personnes, sujets, émotions), y compris à la périphérie avec Azure Arc.
- Évaluer la récupération : evaluators Document Retrieval, Retrieval et Groundedness (chapitres 04 et 05).
14. Fiche à retenir#
- Pipeline : data source → indexer → skillset → index (+ knowledge store) ; un indexer = une source, un index.
- Schedule de 5 min à 24 h ; change detection intégrée pour Storage et SharePoint, à activer pour SQL et Cosmos DB.
- Field mappings = contenu brut ; output field mappings = sorties de skills ; index projections = un document par chunk.
- Push API pour la fraîcheur immédiate ou les sources hors Azure (rôle Search Index Data Contributor).
- Nouveau pipeline RAG : Content Understanding skill (OCR + layout + chunking, Markdown, tableaux multipages) +
Azure OpenAI Embedding skill + index projections ;
allowSkillsetToReadFileData. - Chunking CU skill :
fixedSize(caractères) ousemantic(jetons, preview, pas d'overlap) ; descriptions d'images =modelName+modelDeployment(preview). - Integrated vectorization : embedding skill + vectorizer du même modèle ; deployments séparés indexation et requêtes.
- Index : champ vector (
dimensions, profile) → profile → algorithm (HNSW / eKNN), vectorizer, compression (scalar, binary + rescoring). - Ancrage : hybride (BM25 + vecteur, RRF) + semantic ranker (semantic configuration, k = 50).
- Skills : built-in (Foundry resource attachée), Azure-hosted (CU, embedding, GenAI Prompt), custom (Web API, AML), utility.
- GenAI Prompt : chat completions seulement, 30 s ; Web API :
values/recordId, timeout ≤ 230 s,authResourceId. - Agent : Azure AI Search tool (un index,
vector_semantic_hybridpar défaut) ou Foundry IQ via MCP (knowledge_base_retrieve). - Réseau privé : managed identity obligatoire, standard setup + VNet injection.
- Document Intelligence : déterministe, structuré (Read, Layout, prebuilt, custom template/neural, classifier).
- Content Understanding : analyzer =
baseAnalyzerId(4 parents) +models(noms) +config+fieldSchema. - Méthodes : extract (documents, source et confiance obligatoires), classify (enum), generate.
- Sorties : Markdown pour RAG et agents (
prebuilt-documentSearch), JSON avec confidence et grounding pour l'automatisation. - API Content Understanding : 2025-11-01 GA ; 2026-06-01-preview (agentic mode) ; pro mode retiré.
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Study guide for Exam AI-103 (en anglais)
- Indexers in Azure AI Search
- Schedule an indexer
- Field mappings and transformations
- Index data from Azure Blob Storage
- Index data from Azure SQL Database
- Import data wizard in the Azure portal
- Skillset concepts
- Skills for extra processing during indexing
- Azure Content Understanding skill
- Chunk and vectorize content with the Azure Content Understanding skill
- Document Layout skill
- GenAI Prompt skill
- Custom Web API skill
- Add a custom skill to an enrichment pipeline
- Efficiently scale out a custom skill
- Multimodal search in Azure AI Search
- Integrated vector embedding
- Create a vector index
- Compress vectors using scalar or binary quantization
- Eliminate optional vector instances from storage
- Define an index projection
- Connect an Azure AI Search index to Foundry agents
- What is a knowledge source?
- Query a knowledge base using the retrieve action or MCP endpoint
- Tutorial: Build an end-to-end agentic retrieval solution
- What is Azure Content Understanding in Foundry Tools?
- Prebuilt analyzers
- What is a Content Understanding analyzer? (analyzer reference)
- Create a custom analyzer
- Choose the right Foundry Tool for document processing
- Content Understanding Studio and Microsoft Foundry
- Agentic mode for document analysis (preview)
- What's new in Content Understanding
- Azure Content Understanding video solutions
- Data, privacy, and security for Content Understanding
- Azure AI Content Understanding client library for Python
- What is Azure Document Intelligence in Foundry Tools?
- Which Document Intelligence model should I choose?
- Document Intelligence custom models
- RAG with Azure Document Intelligence (Layout model, Markdown)
- Configure keyless authentication with Microsoft Entra ID (Foundry Models)