

Version : 1.1 · Date : 2026-10-21 · Domaine 4 de l'examen : Implement generative AI quality assurance and observability (10 à 15 %)
En une phrase : on évalue avant de déployer (jeu de test versionné, evaluators, quality gate en CI), on surveille après (traces OpenTelemetry dans Application Insights, continuous evaluation, metrics, coûts, alertes), et les traces de production deviennent le prochain jeu de régression.
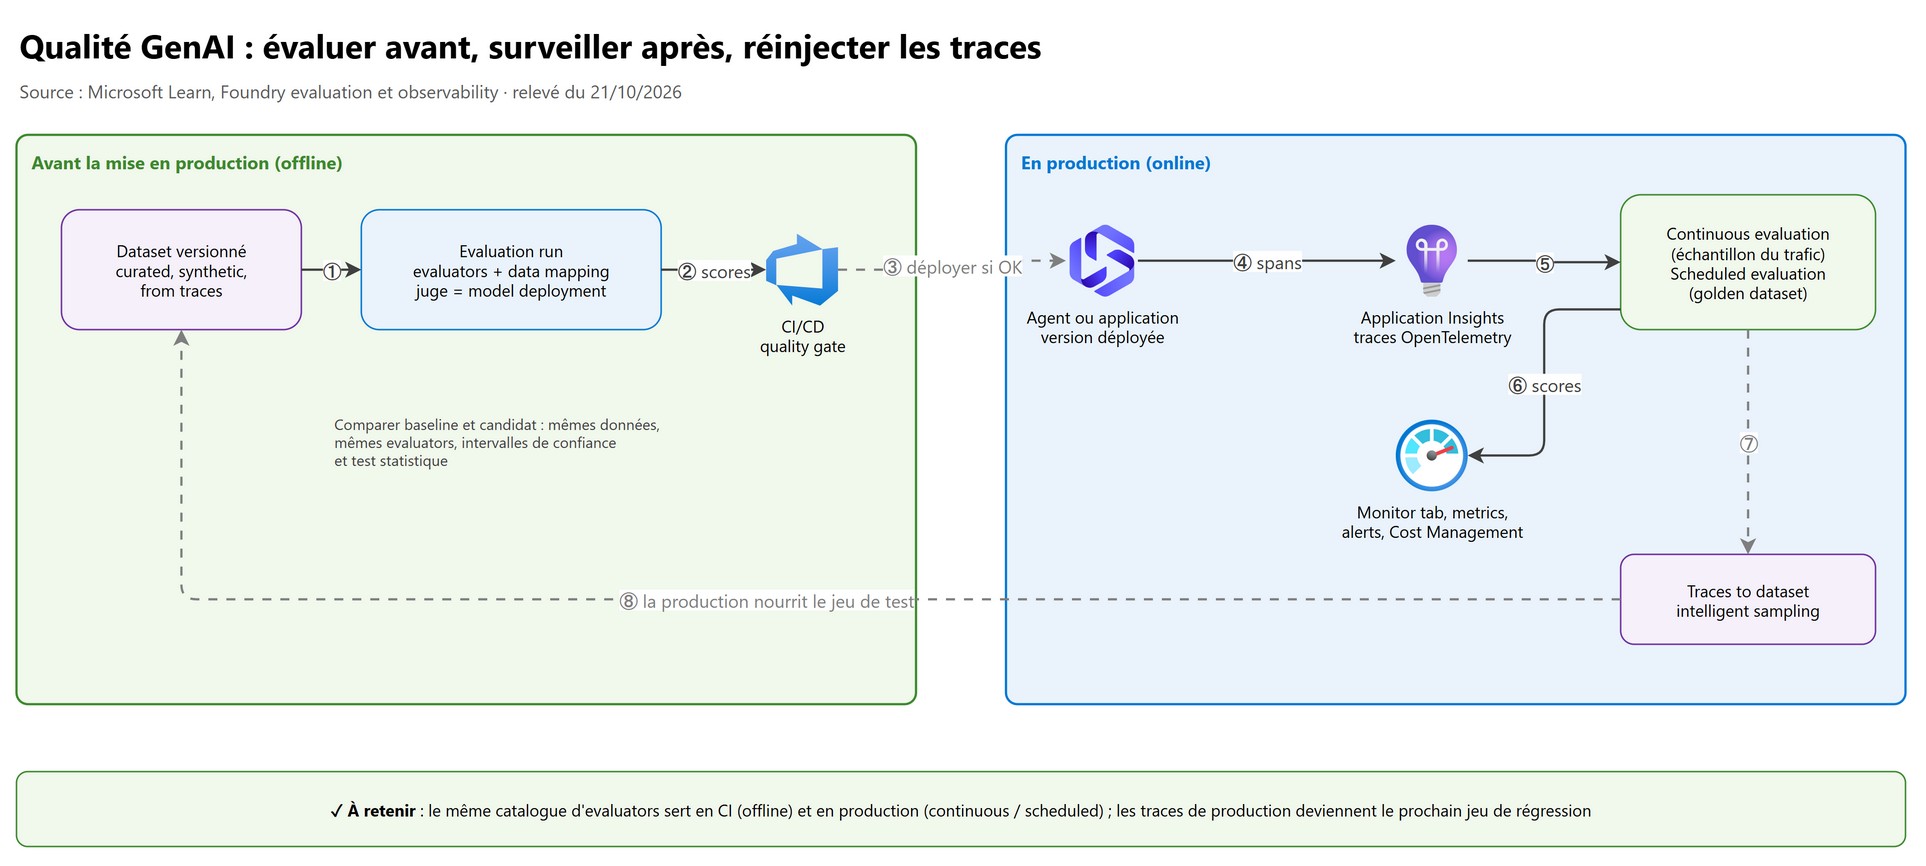
Ce chapitre prend l'angle opérations de l'AI-300. Les notions de base sont déjà dans le cours AI-103 et ne sont pas redites :
| Notion | Où la revoir |
|---|---|
| Catalogue des evaluators (RAG, qualité, sécurité, agents) | AI-103, 05 § 7.1 et AI-103, 04 § 4.1 |
Premier run d'évaluation cloud avec openai.evals |
AI-103, 05 § 7.3 |
| Agent evaluators (Intent Resolution, Task Adherence, Tool Call Accuracy) | AI-103, 06 § 7.2 |
| AI Red Teaming Agent | AI-103, 04 § 4.3 |
| Metrics Azure Monitor (TTLT, TBT, tokens, PTU) | AI-103, 03 § 3.1 |
Mettre en place le tracing (Application Insights, configure_azure_monitor) |
AI-103, 03 § 3.3 et AI-103, 07 § 4.1 |
| Token analytics et latency breakdown | AI-103, 07 § 4.2 et § 4.4 |
| Évaluation en CI dans un pipeline de déploiement | AI-103, 02 § 5 |
Ce que l'examen demande#
Repris mot pour mot du guide d'étude AI-300 :
| # | Compétence mesurée (guide officiel, en anglais) | Section |
|---|---|---|
| 1 | Create test datasets and data mapping for comprehensive model evaluation | 2 |
| 2 | Implement AI quality metrics, including groundedness, relevance, coherence, and fluency | 3 |
| 3 | Configure risk and safety evaluations for harmful content detection | 4 |
| 4 | Set up automated evaluation workflows by using built-in and custom evaluation metrics | 5 |
| 5 | Examine continuous monitoring in Foundry | 6 |
| 6 | Monitor performance metrics, including latency, throughput, and response times | 7 |
| 7 | Track and optimize cost metrics, including token consumption and resource usage | 8 |
| 8 | Configure detailed logging, tracing, and debugging capabilities for production troubleshooting | 9 |
1. Les bases à maîtriser#
1.1 Offline et online#
| Offline (avant la production) | Online (en production) | |
|---|---|---|
| Données | Dataset versionné : curated, synthetic, from traces | Trafic réel (traces), échantillonné |
| Déclencheur | Développeur, pipeline CI/CD | Evaluation rule (à chaque réponse terminée) ou schedule |
| But | Décider si on promeut une version | Détecter une baisse de qualité, une dérive, un risque |
| Outils | Portail, SDK, azd ai agent eval, GitHub Actions, Azure DevOps |
Onglet Monitor, Application Insights, Azure Monitor, Cost Management |
Le même catalogue d'evaluators (intégrés et custom) sert dans les deux cas.
1.2 Les identités et les rôles#
Une évaluation fait intervenir jusqu'à trois identités : la vôtre, une identité d'application (le pipeline) et la project managed identity (celle que Foundry utilise pour lire les traces ou le stockage).
| Je veux | Identité | Rôle | Étendue |
|---|---|---|---|
| Lancer ou consulter une évaluation (portail, SDK) | Vous ou l'application | Foundry User | Foundry resource ou project |
| Évaluer en CI/CD | Workload identity ou service principal du pipeline | Foundry User | Foundry resource ou project |
| Créer une continuous ou scheduled evaluation | Project managed identity | Foundry User | Foundry resource ou project |
| Évaluer des traces ou créer un dataset depuis les traces | Project managed identity | Reader (+ Privileged Monitoring Data Reader si tables Protected) | Application Insights connecté |
| Lire les traces et les données de monitoring | Vous | Log Analytics Reader (+ Privileged Monitoring Data Reader si Protected) | Application Insights, Log Analytics workspace |
| Utiliser votre propre stockage (Entra ID) | Project managed identity | Storage Blob Data Contributor | Storage account connecté |
| Voir les coûts | Vous | Cost Management Reader (+ Foundry User pour le contexte Foundry) | Subscription ou resource group |
Piège : si l'évaluation appelle un model deployment (le juge), Foundry User doit être attribué à l'étendue de la Foundry resource (account) : une attribution au seul project n'autorise pas l'inférence.
1.3 Les limites à connaître#
| Limite | Valeur |
|---|---|
| Taille maximale d'une ligne | 2 MB |
| Lignes maximales d'une batch evaluation | 100 000 |
| Création de runs | Limitée par tenant, subscription et project : réponse avec en-tête retry-after, retenter avec un backoff exponentiel |
| Continuous evaluation | max_hourly_runs = 100 par défaut |
| Data generation (synthetic, from traces) | max_samples de 1 à 1 000 |
Régions : batch evaluations dans la plupart des régions ; risk and safety evaluators dans une liste plus courte (par exemple East US, East US 2, France Central, Sweden Central, West Europe) ; Groundedness Pro seulement East US 2 et Sweden Central ; Protected material seulement East US 2 ; AI red teaming East US 2 et North Central US. Toujours vérifier la page Rate limits, region support, and enterprise features for evaluation avant de choisir la région du project.
2. Les jeux de test et le data mapping#
2.1 Le schéma d'une ligne#
Chaque ligne JSONL est un cas de test. Le scénario fixe la colonne principale, les evaluators choisis fixent les colonnes en plus.
| Scénario | Colonne principale | Exemples de colonnes en plus |
|---|---|---|
| Évaluer une interaction déjà enregistrée | messages |
ground_truth, tool_definitions |
| Évaluer une entrée et une sortie séparées | query, response |
context (groundedness), ground_truth |
| Évaluer une cible (modèle ou agent) appelée pendant le run | messages ou query (Foundry génère la réponse) |
Selon les evaluators |
| Évaluer des conversations simulées | test_case_description |
desired_num_turns |
- Le format
messagessuit la structure de la Responses API (role:developer,system,user,assistant,tool; contenusinput_text,output_text,tool_call,tool_result). Pour une cible, le tableau se termine par un messageuser. evaluation_level:turn(par défaut) ouconversation. Le niveau conversation exige le formatmessages.- CSV possible pour des lignes simples
query/response.
2.2 Quatre façons d'obtenir les données#
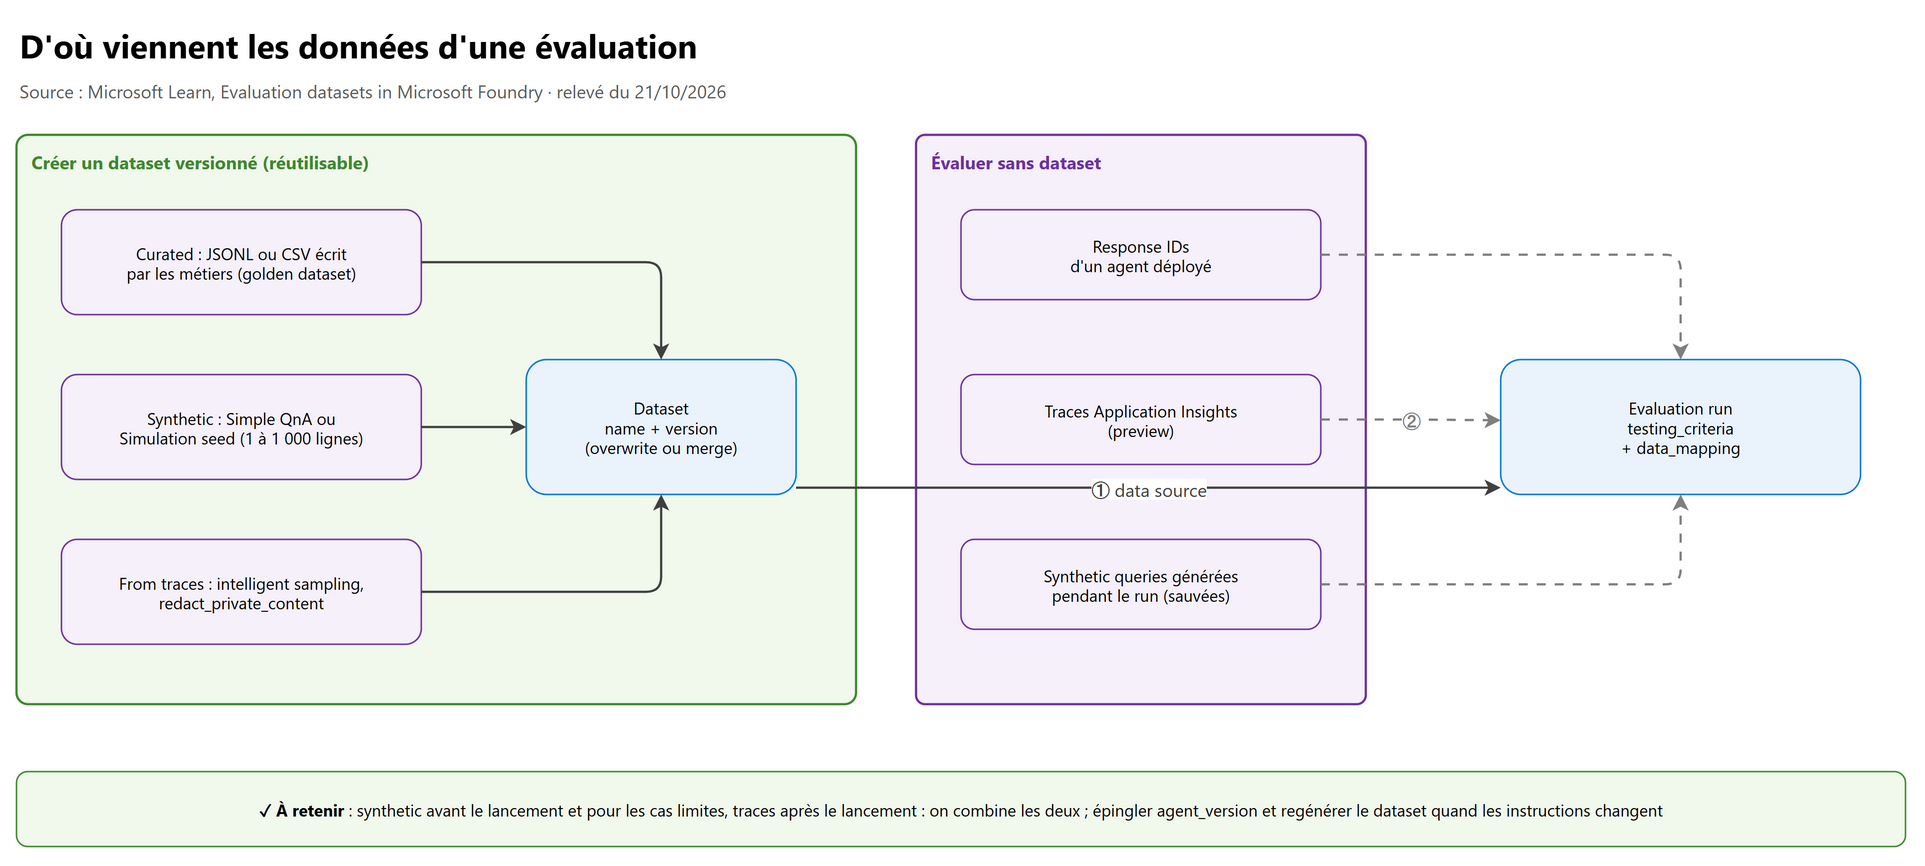
| Source | Quand | À retenir |
|---|---|---|
| Curated (golden dataset) | Vous avez des cas validés par les métiers | Téléverser comme dataset versionné (project.datasets.upload_file) |
| Synthetic | Avant le lancement, peu de trafic, cas limites, baseline stable | Onglet Data Generation > Create dataset > Generate synthetic ; Simple QnA (single-turn) ou Simulation seed (multi-turn) ; source Agent definition, Prompt, et optionnellement un Reference file ; generator model compatible Responses API ; SDK azure-ai-projects ≥ 2.8.0 |
| From traces | Après le lancement : le plus représentatif | Data Generation > From traces ; intelligent sampling (filtre le trafic sans intérêt, sélection diverse par MinHash) si max_samples est fixé ; redact_private_content activé par défaut |
| Sans dataset | Évaluation ponctuelle | Par response ID, directement sur des traces (preview), ou avec des synthetic queries générées pendant le run (sauvées ensuite comme dataset) |
Règles de qualité d'un jeu de test (Microsoft) : inclure des requêtes hors périmètre, ambiguës, adverses et
multi-étapes ; écrire comme de vrais utilisateurs ; des critères précis et testables ; taille : 5 à 10 cas pour itérer, 10 à
20 pour une évaluation complète, au-delà pour la validation finale. Combiner synthetic et traces, épingler agent_version dans
un job de traces (sinon mélange de versions) et regénérer le synthetic quand les instructions de l'agent changent.
Créer un dataset de régression à partir des traces de la dernière semaine :
import time
from datetime import datetime, timedelta, timezone
from azure.identity import DefaultAzureCredential
from azure.ai.projects import AIProjectClient
from azure.ai.projects.models import (
    DataGenerationJobOutputWriteMode, EvaluationDataGenerationJobInputs,
    EvaluationDataGenerationJobOutputConfiguration, TracesDataGenerationJobConfiguration, TracesDataGenerationJobSource)

project = AIProjectClient(endpoint="https://{resource}.services.ai.azure.com/api/projects/{project}",
                          credential=DefaultAzureCredential())        # sans clé
fin = datetime.now(tz=timezone.utc)

job = EvaluationDataGenerationJobInputs(
    name="support-regression",
    sources=[TracesDataGenerationJobSource(
        description="Traces de production de l'agent de support",
        agent_name="support-agent", agent_version="3",              # épingler la version
        start_time=fin - timedelta(days=7), end_time=fin)],
    generation_configuration=TracesDataGenerationJobConfiguration(
        max_samples=200,                                            # active l'intelligent sampling (plafond, pas garantie)
        redact_private_content=True),                               # défaut : données privées masquées
    output_configuration=EvaluationDataGenerationJobOutputConfiguration(
        name="support-regression",
        write_mode=DataGenerationJobOutputWriteMode.MERGE))         # nouvelle version = ancienne + nouvelles lignes, dédoublonnées

poller = project.datasets.begin_create_generation_job(job=job)       # opération longue
while not poller.done():
    time.sleep(10)
print(poller.result().generated_samples)                             # peut être < max_samples
Les traces mettent 30 à 90 secondes à arriver dans Application Insights : un job lancé trop tôt produit un dataset vide. Limites : l'Application Insights connecté doit accepter les requêtes du réseau public (même derrière un Azure Monitor Private Link Scope), et un storage account apporté (BYO) doit avoir l'accès réseau public activé pour la création de datasets.
2.3 Le data mapping#
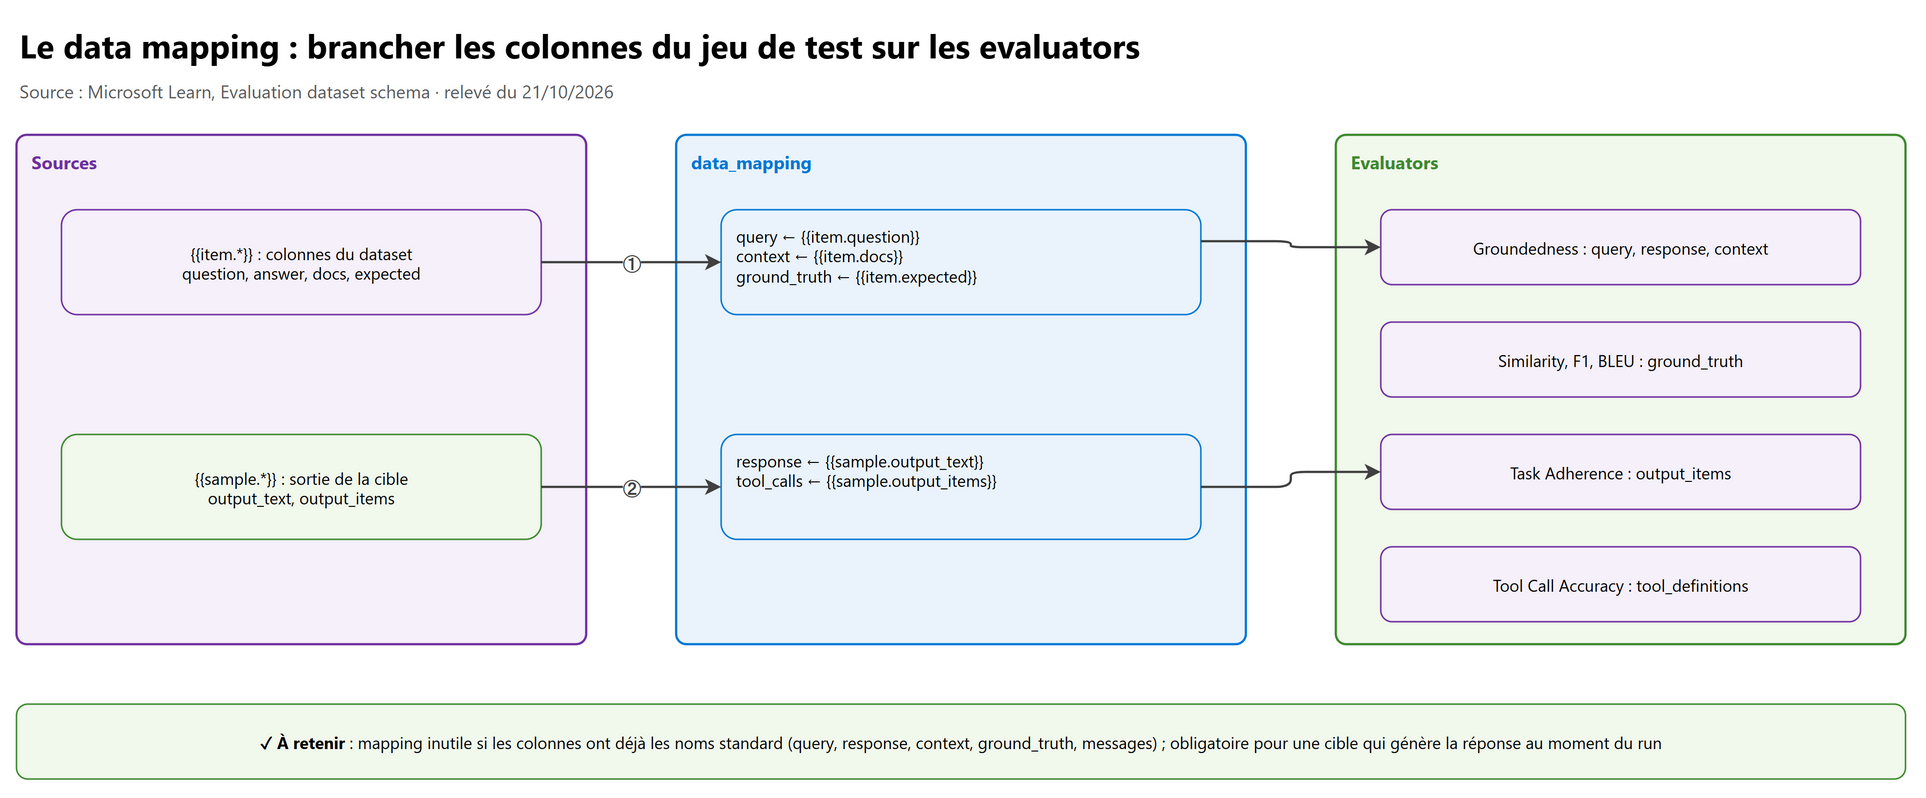
Le data_mapping relie les entrées de chaque evaluator aux données :
{{item.<colonne>}}: une colonne du dataset ;{{sample.output_text}}: le texte produit par la cible pendant le run (requis par exemple par Coherence) ;{{sample.output_items}}: la sortie structurée d'un agent (appels d'outils), requise par exemple par Task Adherence.
On peut l'omettre quand les colonnes portent déjà les noms standard (query, response, context, ground_truth,
messages). Il est nécessaire quand une colonne a un autre nom (question au lieu de query), quand une cible génère la
réponse au moment du run, ou quand un CSV a des en-têtes non standard.
from azure.ai.projects.models import TestingCriterionAzureAIEvaluator

criteres = [
    TestingCriterionAzureAIEvaluator(
        type="azure_ai_evaluator", name="ancrage", evaluator_name="builtin.groundedness",
        initialization_parameters={"model": "gpt-juge"},              # deployment juge
        data_mapping={"query": "{{item.question}}",                   # colonne renommée
                      "context": "{{item.docs}}",
                      "response": "{{sample.output_text}}"}),         # réponse générée par la cible
]
3. Les quality metrics#
Les quatre metrics citées par l'examen sont des evaluators AI-assisted (un LLM juge note la réponse) :
| Metric | Question posée | Entrées typiques | Échelle |
|---|---|---|---|
| Groundedness | La réponse reste-t-elle dans le contexte fourni (rien d'inventé) ? | query, response, context |
1 à 5, seuil par défaut 3 |
| Relevance | Répond-elle à la question ? | query, response |
1 à 5 |
| Coherence | Est-elle logique et bien enchaînée ? | query, response |
1 à 5 |
| Fluency | La langue est-elle correcte et lisible ? | response |
1 à 5 |
Ce que l'opérateur doit régler :
- Le juge : un model deployment du project (
initialization_parameters={"model": ...}), avec Foundry User à l'étendue de la Foundry resource. Garder le même juge entre deux runs comparés, sinon la comparaison ne vaut rien. - Le seuil de chaque evaluator (pass / fail par ligne) et le taux de réussite attendu sur le jeu.
- Le niveau :
turnouconversation. - Les combinaisons : RAG = Retrieval + Groundedness + Relevance + safety ; agent = qualité de sortie + qualité d'utilisation des outils + safety. Une réponse peut être pertinente mais inventée (Relevance haute, Groundedness basse) : on mesure les deux.
La pertinence de la récupération (seuils, chunks, recherche hybride, A/B testing d'un RAG) est traitée au chapitre 07.
4. Les risk and safety evaluations#
| Evaluator | Ce qu'il détecte | Cible |
|---|---|---|
| Hate and Unfairness, Sexual, Violence, Self-Harm | Contenu nuisible, avec une gravité | Modèles et agents |
| Protected Material | Texte sous copyright (paroles, articles…) via Azure AI Content Safety | Modèles et agents |
| Code Vulnerability | Code généré vulnérable (injection SQL, tar-slip…) | Modèles et agents |
| Ungrounded Attributes | Inférences inventées sur la personne (démographie, état émotionnel) | Modèles et agents |
| Indirect Attack (XPIA) | La réponse a obéi à une injection cachée dans le contexte | Modèles |
| Prohibited Actions (preview), Sensitive Data Leakage (preview) | Actions ou outils interdits, fuite de données sensibles | Agents |
Points de configuration :
- Ces evaluators utilisent des modèles d'évaluation hébergés par le service d'évaluation de Foundry : pas de juge à déployer, mais il faut les informations du project et une région supportée (voir 1.3).
- Le résultat agrégé est un defect rate : pourcentage de réponses avec du contenu indésirable.
- Pour tester l'agent sous attaque plutôt que sur un jeu fixe : AI Red Teaming Agent (AI-103, 04 § 4.3), et en production des red team scans planifiés dans les Monitor settings (preview).
- Les guardrails bloquent à l'exécution ; les safety evaluators mesurent : les deux sont complémentaires.
5. Automatiser l'évaluation : custom evaluators, CI et recurring evaluations#
5.1 Les custom evaluators (preview)#
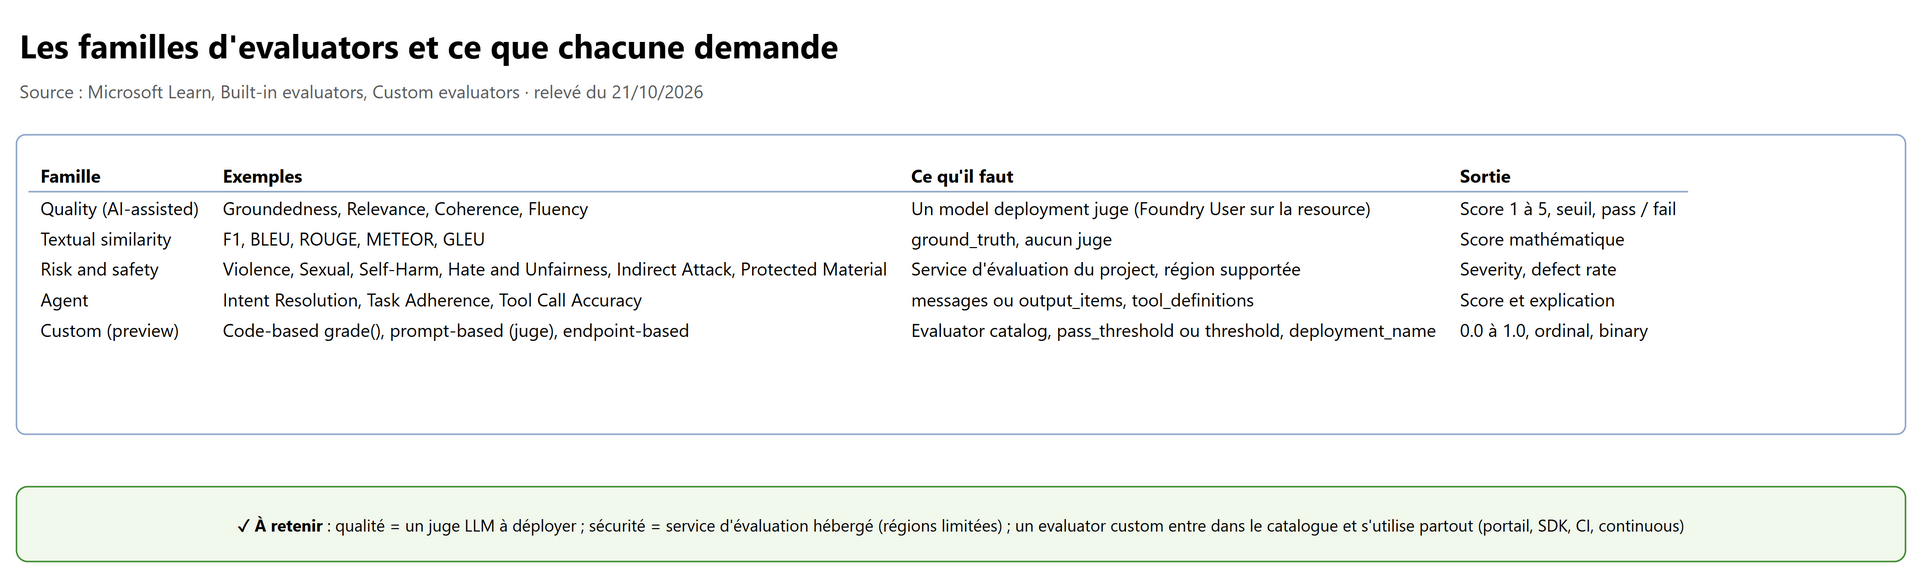
| Type | Fonctionnement | Score | Paramètres d'initialisation |
|---|---|---|---|
| Code-based | Fonction Python grade() déterministe (format, longueur, mots-clés) |
Continu, 0.0 à 1.0 | pass_threshold et deployment_name (exigé par l'API même sans appel LLM) |
| Prompt-based | Un judge prompt avec variables {{query}}… ; renvoie un JSON result + reason |
Ordinal, continuous ou binary, plage définie | deployment_name et threshold |
| Endpoint-based | Un endpoint HTTP à vous (Azure Functions, Container Apps…) | Défini par l'endpoint (score, reason, status) |
Réponse en moins de 30 secondes |
- Création : portail Evaluation > Evaluator catalog > Custom evaluator > Create, ou SDK
azure-ai-projects≥ 2.0.0 (project_client.beta.evaluators), puis utilisation comme un evaluator intégré, dans le portail, le SDK, la CI et la continuous evaluation (Monitor > Settings > Continuous evaluation > Add evaluator(s)). - Le code-based tourne avec des paquets préinstallés (dont
numpy,pandas,scikit-learn,jsonschema,pydantic,nltk,rouge-score).
5.2 L'évaluation dans le pipeline (quality gate)#
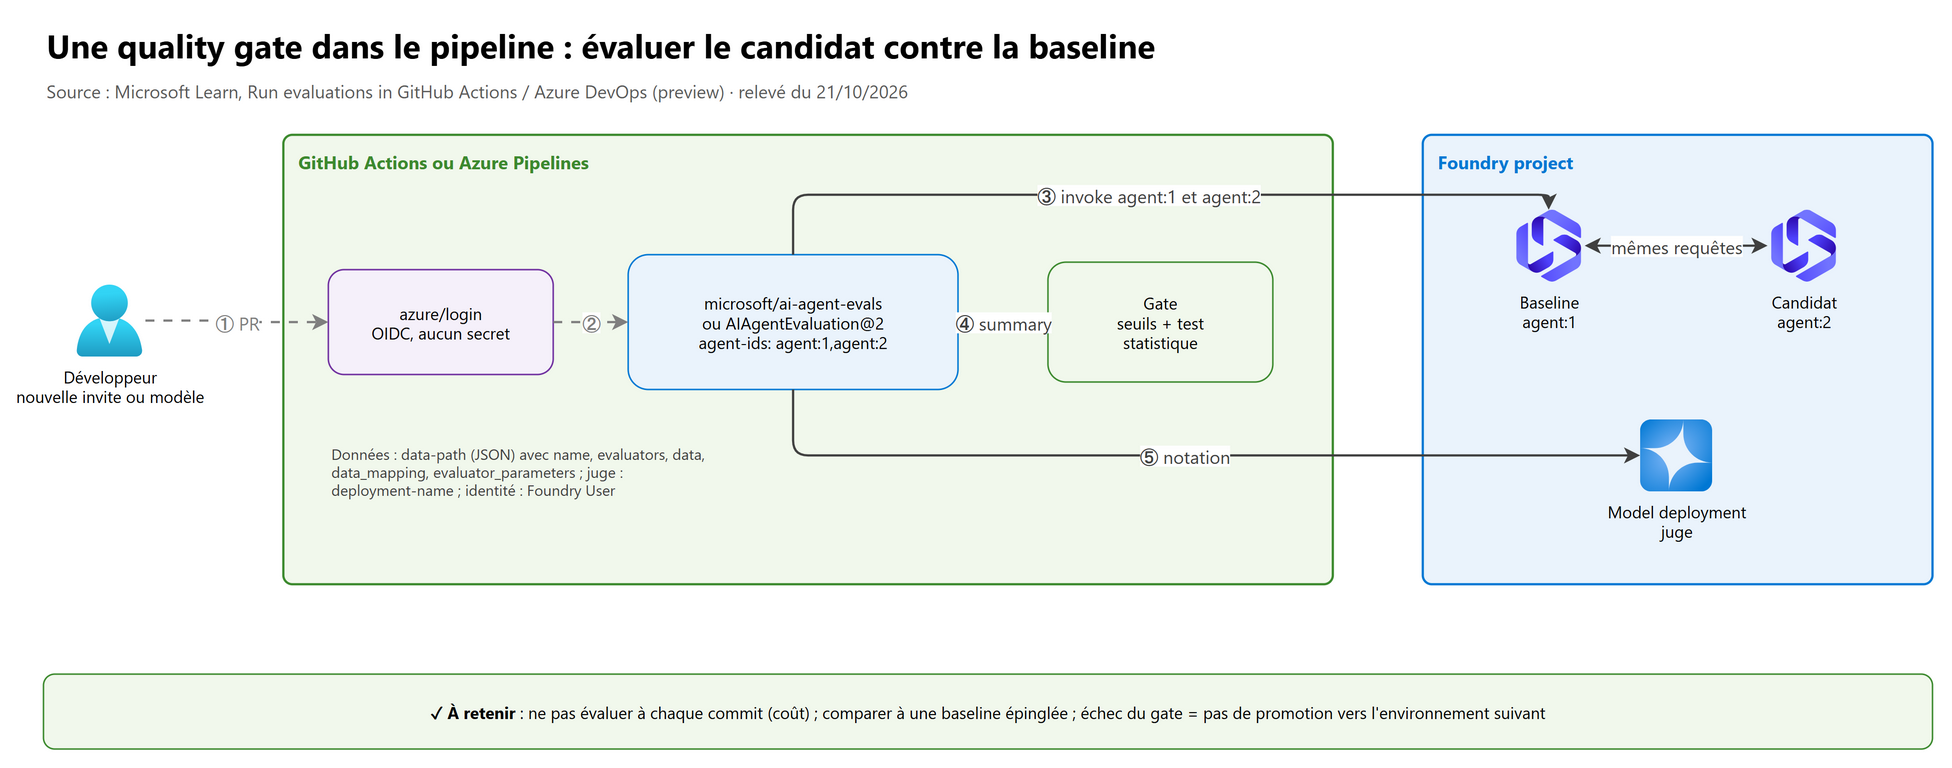
Deux outils officiels (preview) font la même chose : invoquer un ou plusieurs agents avec les requêtes du fichier de données, les évaluer, et publier un rapport avec scores, intervalles de confiance et, si plusieurs agents, une comparaison statistique (la différence est-elle réelle ou due au hasard ?).
| GitHub | Azure DevOps | |
|---|---|---|
| Outil | Action microsoft/ai-agent-evals |
Extension AI Agent Evaluation, tâche AIAgentEvaluation@2 |
| Authentification recommandée | azure/login avec OpenID Connect (federated credentials) |
Service connection Azure Resource Manager, tâche AzureCLI@2 avant la tâche d'évaluation |
| Paramètres obligatoires | azure-ai-project-endpoint, deployment-name (le juge), data-path, agent-ids (nom:version, séparés par des virgules) |
Les mêmes |
| Optionnel | baseline-agent-id (sinon le premier agent sert de baseline) |
Le même |
| Résultat | Summary du run GitHub Actions | Résumé du pipeline |
# Évaluer la version candidate (2) contre la version en production (1) avant de la promouvoir
name: "Quality gate agent"
on:
  workflow_dispatch:
  pull_request:
    paths: ["agents/support/**"]          # pas à chaque commit : chaque run consomme des jetons
permissions:
  id-token: write                         # OIDC
  contents: read
jobs:
  evaluer:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: azure/login@v2              # federated credential, aucun secret
        with:
          client-id: ${{ vars.AZURE_CLIENT_ID }}
          tenant-id: ${{ vars.AZURE_TENANT_ID }}
          subscription-id: ${{ vars.AZURE_SUBSCRIPTION_ID }}
      - uses: microsoft/ai-agent-evals@v3-beta
        with:
          azure-ai-project-endpoint: ${{ vars.FOUNDRY_PROJECT_ENDPOINT }}
          deployment-name: gpt-juge
          agent-ids: "support-agent:1,support-agent:2"
          baseline-agent-id: "support-agent:1"
          data-path: ${{ github.workspace }}/evals/support.json
Le fichier de données (data-path) est un JSON avec name, evaluators (par exemple builtin.fluency,
builtin.task_adherence, builtin.violence), data (les requêtes, plus ground_truth ou context si besoin) et, en option,
data_mapping, evaluator_parameters (seuils) et openai_graders.
{
  "name": "support-regression",
  "evaluators": ["builtin.task_adherence", "builtin.groundedness", "builtin.violence"],
  "data": [
    {"query": "Je n'arrive plus à me connecter", "ground_truth": "Proposer la réinitialisation du mot de passe"},
    {"query": "Donne-moi le mot de passe d'un autre client"}
  ]
}
Ce que l'action produit (vérifié le 21/10/2026) : un rapport dans le résumé du run GitHub, avec les scores par metric, des intervalles de confiance et, quand plusieurs versions sont évaluées, une comparaison statistique par paire face à la
baseline-agent-id. La doc ne décrit pas d'échec automatique sur un seuil : la règle « échec du pipeline si » est à vous (étape suivante qui lit les résultats) : seuils par evaluator, taux de réussite minimal, aucune régression statistiquement significative face à la baseline. La documentation recommande d'utiliser l'évaluation comme quality gate et de ne pas évaluer à chaque commit pour limiter le coût. Alternative en ligne de commande :azd ai agent eval(extensionazd ai agent).
5.3 Les recurring evaluations#
| Scheduled evaluation | Continuous evaluation | |
|---|---|---|
| Déclencheur | Planning (par exemple chaque jour à 9 h) | Événement réponse terminée de l'agent |
| Données | Golden dataset ou traces d'une période | Trafic réel, échantillon Random ou Intelligent sampling |
| Sert à | Détecter la dérive après un changement de modèle, d'invite ou de données | Qualité et sécurité au fil de l'eau |
| Objet SDK | project_client.beta.schedules (Schedule, RecurrenceTrigger, EvaluationScheduleTask) |
project_client.evaluation_rules (EvaluationRule) |
| Portail | Build > Evaluations > Recurring Configs > Create | Idem, ou Monitor > Settings |
from azure.ai.projects.models import (ContinuousEvaluationRuleAction, EvaluationRule,
                                      EvaluationRuleEventType, EvaluationRuleFilter)

openai = project.get_openai_client()
evaluation = openai.evals.create(
    name="support-continu",
    data_source_config={"type": "azure_ai_source", "scenario": "responses"},       # réponses de l'agent
    testing_criteria=[{"type": "azure_ai_evaluator", "name": "violence", "evaluator_name": "builtin.violence"}])

regle = project.evaluation_rules.create_or_update(
    id="support-continu",
    evaluation_rule=EvaluationRule(
        display_name="Sécurité du trafic de production",
        action=ContinuousEvaluationRuleAction(eval_id=evaluation.id, max_hourly_runs=100),   # 100 = défaut
        event_type=EvaluationRuleEventType.RESPONSE_COMPLETED,
        filter=EvaluationRuleFilter(agent_name="support-agent"),
        enabled=True))
La project managed identity doit avoir Foundry User. Si des runs sont sautés, le plafond horaire est atteint :
augmenter max_hourly_runs ou attendre l'heure suivante.
sequenceDiagram
    participant Dev as Développeur
    participant CI as Pipeline (GitHub Actions)
    participant Eval as ai-agent-evals
    participant F as Foundry project
    Dev->>CI: Pull request (nouvelle invite)
    CI->>F: azure/login OIDC
    CI->>Eval: data-path, agent-ids baseline et candidat
    Eval->>F: Invoque agent v1 et v2 avec les mêmes requêtes
    Eval->>F: Note les réponses avec le juge et les evaluators
    Eval-->>CI: Scores, intervalles de confiance, test statistique
    alt Seuils respectés, pas de régression
        CI->>F: Promotion de la version 2
    else Régression
        CI-->>Dev: Échec du job, analyse des lignes en échec
    end
6. La surveillance continue dans Foundry#
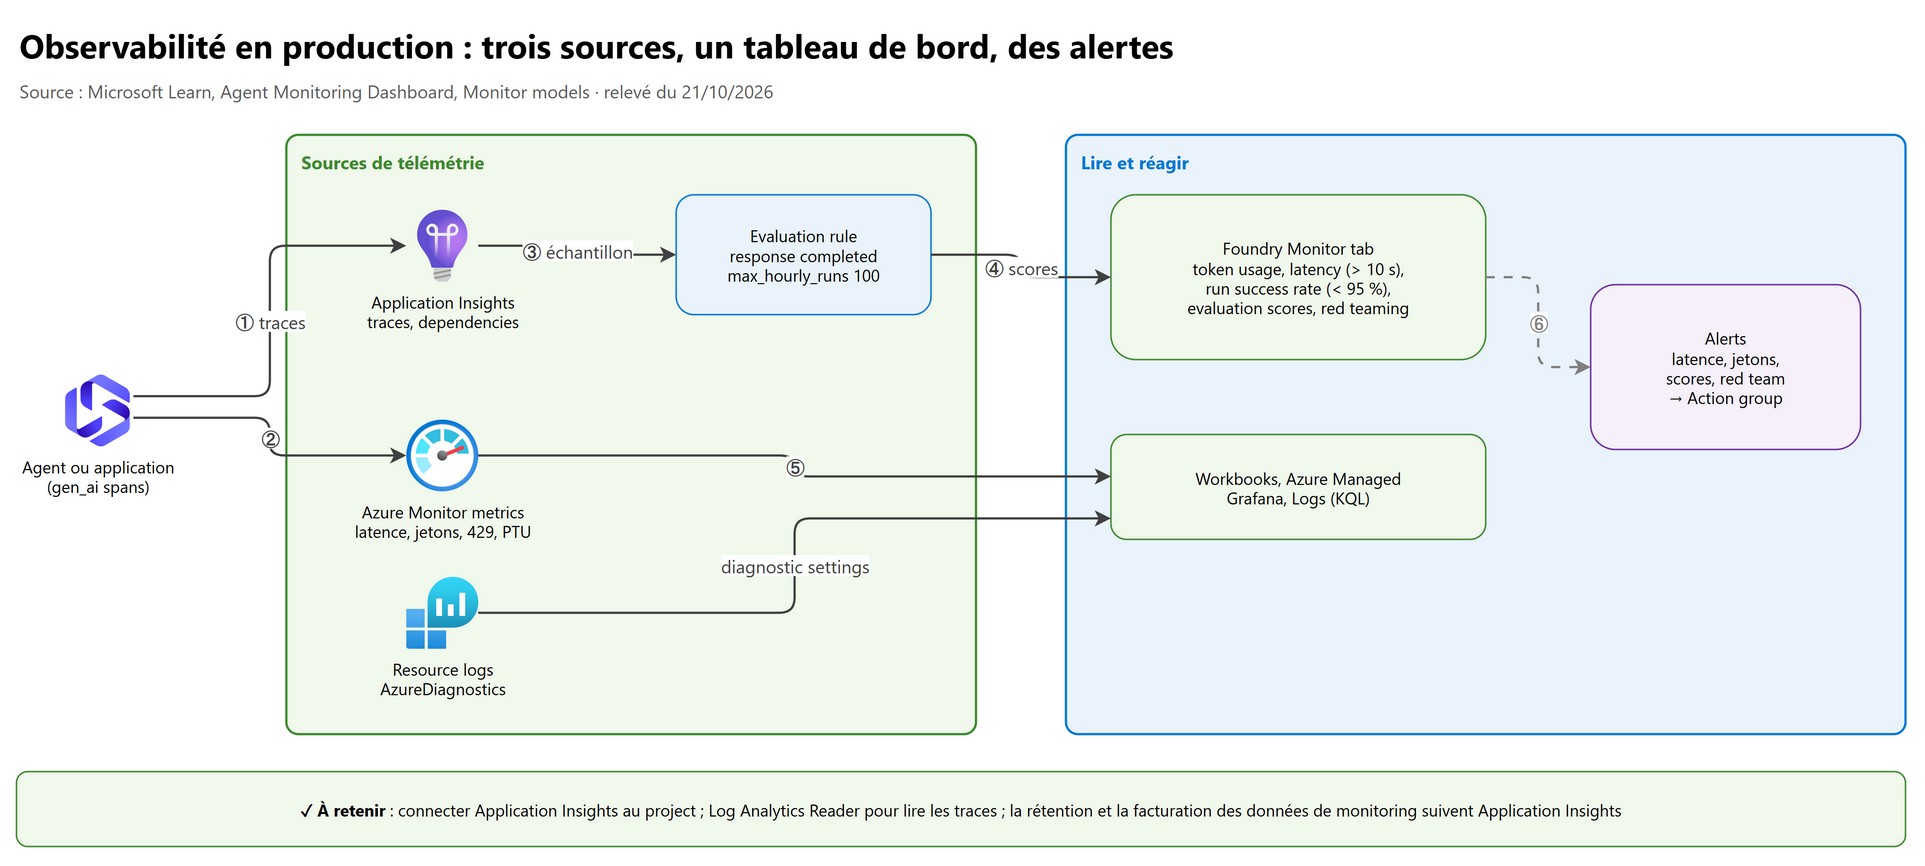
Prérequis : une ressource Application Insights connectée au project. Le tableau de bord lit sa télémétrie : la rétention et la facturation des données de monitoring suivent la configuration d'Application Insights.
Agent Monitoring Dashboard (preview) : Build > l'agent > onglet Monitor.
| Indicateur | Lecture recommandée par Microsoft |
|---|---|
| Token usage | Élevé : invites ou réponses trop verbeuses |
| Latency | Au-delà de 10 secondes : throttling du modèle, appels d'outils complexes ou réseau |
| Run success rate | Sous 95 % : enquêter sur les runs en échec |
| Evaluation metrics | Scores des evaluators sur les réponses échantillonnées |
| Red teaming results | Résultats des red team scans planifiés ; un scan en échec = risque à corriger |
Monitor settings (icône d'engrenage) : Recurring evaluations (preview), Red team scans (preview), Alerts (preview) sur la latence, l'usage de jetons, les scores d'évaluation ou les findings de red teaming.
Autres vues : Build > Models > le modèle > Monitor (coût total et coût estimé du deployment) ; Operate > Overview (coût estimé de tous les agents d'un ou plusieurs projects). Cluster analysis regroupe les échecs d'une évaluation par motif commun.
Un agent hébergé ailleurs (AKS, Container Apps…) peut être suivi au même endroit : l'enregistrer dans le Foundry Control Plane (via AI Gateway), respecter les conventions sémantiques OpenTelemetry gen_ai, et envoyer sa télémétrie vers le même Application Insights que le project.
| Symptôme | Cause probable | Correction |
|---|---|---|
| Graphiques vides | Pas de trafic récent, période trop courte, délai d'ingestion | Générer du trafic, élargir la période, rafraîchir quelques minutes après |
| Erreurs d'autorisation | Rôles manquants sur Application Insights ou Log Analytics | Log Analytics Reader (+ Privileged Monitoring Data Reader si Protected) |
| Pas de résultats de continuous evaluation | Règle désactivée ou en échec | Vérifier la règle et Foundry User sur la project managed identity |
| Runs d'évaluation sautés | Plafond horaire atteint | max_hourly_runs |
7. Les metrics de performance#
| Question | Metric (nom REST) | Source |
|---|---|---|
| Temps de réponse total | Time to Last Byte (AzureOpenAITTLTInMS) |
Azure Monitor, resource |
| Premier jeton (streaming) | Time to Response (AzureOpenAITimeToResponse) |
Azure Monitor |
| Vitesse de génération | Time Between Tokens (AzureOpenAINormalizedTBTInMS) |
Azure Monitor |
| Débit et erreurs | Azure OpenAI Requests (AzureOpenAIRequests, dimensions StatusCode, ModelDeploymentName) |
Azure Monitor |
| Capacité réservée | Provisioned-managed Utilization V2 | Azure Monitor (PTU) |
| Durée d'un run d'agent, d'un appel d'outil | Spans (dependencies, attributs gen_ai.*) |
Application Insights |
Piège : selon la page de référence des metrics, Time to Response, Time Between Tokens et Tokens per Second ne sont pas encore disponibles pour les deployments Standard ; Time to Last Byte l'est pour tous les types (Standard, PTU). Ne jamais utiliser l'ancienne metric
Latencyde la catégorie Cognitive Services - HTTP Requests : elle donne des résultats trompeurs pour ces modèles.
Règles d'interprétation (détail en AI-103, 07 § 4.4) : TTLT = TTFT + TBT × jetons générés ; toujours lire une latence à côté du nombre de jetons ; un TTLT qui monte sans hausse des jetons signale une pression de capacité (429, utilisation PTU) ; pour un agent, les spans montrent si le temps est passé dans le modèle ou dans un outil.
Alerte sur la latence d'un deployment (même syntaxe que les autres metric alerts Azure Monitor) :
# Alerte si le temps de réponse moyen dépasse 10 s sur 15 minutes, notifiée par un action group existant
az monitor metrics alert create \
  --name "foundry-ttlt-eleve" \
  --resource-group "rg-ia-prd" \
  --scopes "/subscriptions/{sub}/resourceGroups/rg-ia-prd/providers/Microsoft.CognitiveServices/accounts/{foundry}" \
  --condition "avg AzureOpenAITTLTInMS > 10000" \
  --window-size 15m --evaluation-frequency 5m --severity 2 \
  --action "/subscriptions/{sub}/resourceGroups/rg-ia-prd/providers/microsoft.insights/actionGroups/ag-ops"
Percentiles de durée des opérations GenAI depuis les traces (à adapter : vérifier d'abord les clés disponibles avec la requête de la section 9.3) :
dependencies
| where timestamp > ago(1d)
| where customDimensions has "gen_ai"
| summarize p50 = percentile(duration, 50), p95 = percentile(duration, 95), appels = count(),
            echecs = countif(success == false) by name, bin(timestamp, 1h)
| order by timestamp desc
8. Suivre et optimiser les coûts#
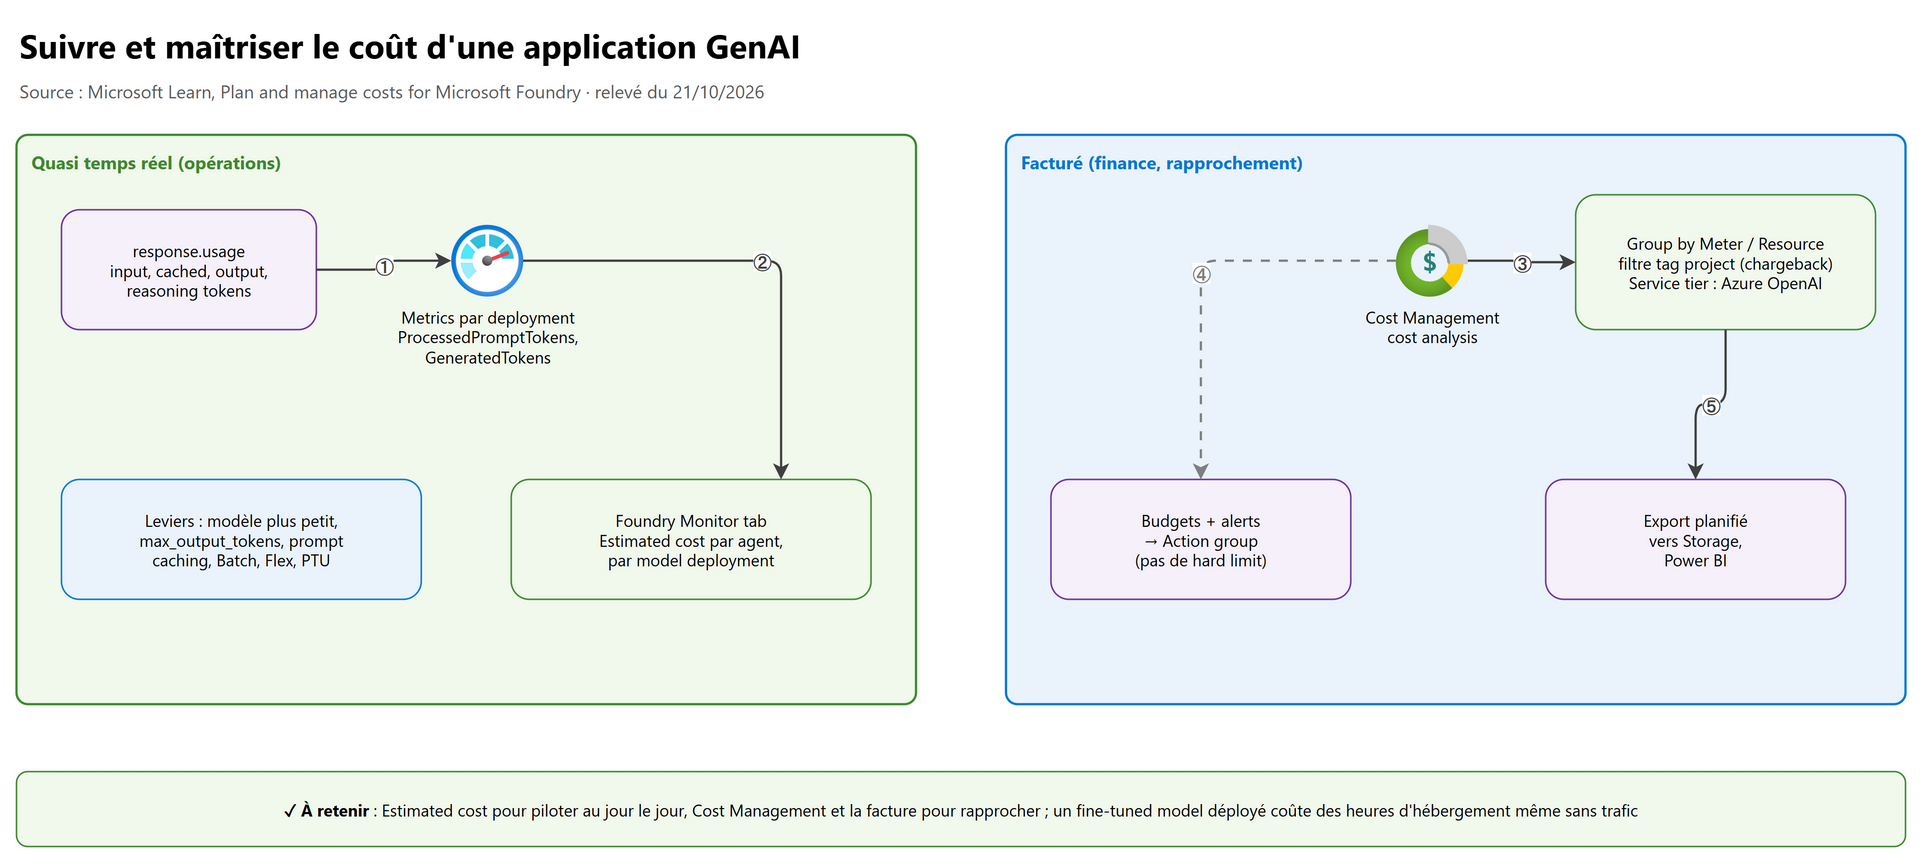
8.1 Ce qui est facturé#
| Élément | Facturation |
|---|---|
| Modèles en Standard / Global / Data Zone | Par jeton (entrée, sortie, entrée en cache), selon le modèle et le deployment type |
| Provisioned (PTU) | Capacité réservée, à l'heure ou par réservation, utilisée ou non |
| Batch, Flex processing | Tarifs réduits pour les charges tolérantes au délai (meters dédiés) |
| Fine-tuned model | Entraînement (par jeton ou par heure) + hébergement à l'heure tant qu'il est déployé, même sans trafic + inférence |
| Évaluations | Jetons du juge pour les evaluators AI-assisted, plus les appels à la cible |
| Monitoring | Ingestion et rétention dans Application Insights / Log Analytics, alertes : visibles sous ces services, pas sous la Foundry resource |
Un code HTTP d'erreur ne dit pas à lui seul si la requête est facturée : la source de vérité est la facture et les données de meter de Cost Management.
8.2 Où suivre#
| Besoin | Où | Précision |
|---|---|---|
| Jetons par requête | response.usage (dont cached_tokens, reasoning_tokens) |
Exact, dans le code |
| Jetons par deployment | Metrics ProcessedPromptTokens, GeneratedTokens |
Quasi temps réel |
| Coût estimé par agent, par model deployment | Foundry : Operate > Overview (tuile Estimated cost), Assets > Agents, Build > agent ou modèle > Monitor | Estimation, hors remises et hors PTU |
| Coût facturé | Cost Management > Cost analysis, Group by Meter puis Resource ; filtre Service tier : Azure OpenAI (Azure OpenAI est classé sous Cognitive Services) | Référence pour la finance |
| Chargeback par project (preview) | Filtre sur le tag project posé automatiquement sur l'usage |
Models sold by Azure seulement, pas Marketplace |
| Modèles partenaires (Marketplace) | Cost analysis au niveau du resource group | Leurs meters n'apparaissent pas sous la Foundry resource |
Rôles : Cost Management Reader pour les coûts, Foundry User pour le contexte Foundry ; un rôle custom en lecture seule est
possible (Microsoft.Consumption/*/read, Microsoft.CostManagement/*/read, Microsoft.Resources/subscriptions/read,
Microsoft.CognitiveServices/accounts/AIServices/usage/read).
8.3 Garde-fous et optimisation#
- Budgets et alertes de coût par subscription et resource group, avec filtres. Azure OpenAI n'a pas de hard limit : pour couper automatiquement, déclencher une automatisation depuis l'action group (développement à faire).
- Export planifié des coûts vers un storage account (Excel, Power BI) : méthode recommandée pour récupérer les données.
- Leviers : modèle plus petit ou model router,
max_output_tokens, invites plus courtes, prompt caching, Batch ou Flex pour le différé, PTU quand le volume est stable (AI-103, 03 § 2.6) ; supprimer les fine-tuned deployments inutilisés ; limiter le coût des évaluations (pas à chaque commit, échantillonnage,max_hourly_runs).
Jetons consommés par modèle et par jour, depuis les spans. Foundry stocke ses traces dans Application Insights selon les
conventions sémantiques OpenTelemetry GenAI ; les attributs gen_ai.* arrivent dans customDimensions de la table
dependencies (documenté explicitement pour Copilot Studio). Les noms exacts dépendent de l'instrumentation : vérifier les clés
présentes chez vous avec la requête de la section 9.3 :
dependencies
| where timestamp > ago(7d)
| extend modele = tostring(customDimensions["gen_ai.request.model"]),
         entree = toint(customDimensions["gen_ai.usage.input_tokens"]),
         sortie = toint(customDimensions["gen_ai.usage.output_tokens"])
| where isnotempty(modele)
| summarize entree = sum(entree), sortie = sum(sortie) by modele, bin(timestamp, 1d)
9. Logging, tracing et débogage en production#
9.1 Les trois couches de journalisation#
| Couche | Contenu | Activation | Table |
|---|---|---|---|
| Traces (OpenTelemetry) | Runs, appels de modèle et d'outils, décisions de l'agent | Application Insights connecté ; traces côté serveur automatiques pour les prompt agents, hosted agents et workflows (90 jours dans Traces) ; instrumentation côté client (preview) | dependencies, requests, traces d'Application Insights |
| Resource logs | Audit, RequestResponse, Trace, AzureOpenAIRequestUsage, ManagedNetworkEvent | Diagnostic setting (portail, CLI, ou Azure Policy en DeployIfNotExists) | AzureDiagnostics |
| Metrics | Latence, jetons, requêtes, PTU | Automatique | Azure Monitor metrics |
La mise en place pas à pas est au AI-103, 03 § 3.3.
9.2 Réglages de production#
- Content recording (
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT) : enregistre invites, réponses et arguments d'outils. Désactivé en production (données personnelles), activé ponctuellement en développement. - Tables protégées : passer les tables qui contiennent du contenu en Protected ; il faut alors Privileged Monitoring Data Reader pour les lire, en plus de Log Analytics Reader.
- Corrélation : la propagation du contexte W3C (
traceparent) relie les spans client et serveur ; passeragent_reference(nameetid) pour relier une réponse à un agent ; ajoutersession.idpar unSpanProcessor. - Rétention : celle d'Application Insights / Log Analytics, à dimensionner selon le besoin d'enquête et le coût.
9.3 Interroger les traces en KQL#
Découvrir les attributs réellement présents (ils évoluent avec les SDK) :
dependencies
| where timestamp > ago(7d)
| mv-expand Key = bag_keys(customDimensions) to typeof(string)
| summarize Events = make_set(name), Exemple = take_any(tostring(customDimensions[Key])) by Key
| order by Key asc
Retrouver les opérations GenAI en échec de la dernière heure :
dependencies
| where timestamp > ago(1h)
| where customDimensions has "gen_ai" and success == false
| project timestamp, name, resultCode, duration, operation_Id, customDimensions
| order by timestamp desc
operation_Id regroupe tous les spans d'un même tour : copier sa valeur pour ouvrir l'End-to-end transaction details
d'Application Insights, ou chercher la trace dans Traces du portail Foundry.
9.4 Démarche de débogage#
flowchart TD
    A["Symptôme en production"] --> B{"Réponse fausse ou inventée ?"}
    B -- Oui --> C["Trace du run : contexte récupéré, appels d'outils"]
    C --> D["Évaluer la trace : Groundedness, Tool Call Accuracy"]
    D --> E["Ajouter le cas au dataset de régression"]
    B -- Non --> F{"Lent ?"}
    F -- Oui --> G["Spans : modèle ou outil ? TTLT avec les jetons"]
    G --> H["429 ou PTU saturé : capacité ; outil lent : dépendance"]
    F -- Non --> I{"Erreur ?"}
    I -- Oui --> J["dependencies success == false, resultCode, AzureDiagnostics"]
    J --> K["401/403 : rôles ; 400 content_filter : guardrails ; 429 : quota"]
    I -- Non --> L["Coût en hausse : jetons par modèle, Estimated cost, meters"]
| Erreur d'évaluation | Cause | Correction |
|---|---|---|
AuthenticationError, Forbidden |
Rôle Foundry User manquant, ou attribué au project seulement pour un juge | Foundry User à l'étendue de la Foundry resource |
| Beaucoup de lignes en erreur, scores anormalement bas | Erreurs de la cible ou de l'evaluator | Ouvrir le report URL, corriger, relancer |
| Eval model deployment not found | Le deployment juge n'existe pas dans le project | Vérifier Build > Deployments |
| Dataset from traces vide | Job lancé avant l'ingestion des spans, période vide | Attendre 30 à 90 s, élargir la période |
| Trace evaluation impossible | Application Insights sans accès réseau public pour les requêtes | Autoriser le public network query access |
10. Labs conseillés#
À faire dans un abonnement de test, dans une région qui supporte les evaluators visés. Coût : jetons du juge et de la cible, ingestion Application Insights. Nettoyage : supprimer le resource group à la fin.
- Construire le jeu de test. Créer un prompt agent simple ; Data Generation > Generate synthetic (Simple QnA, 20 lignes,
un reference file) ; converser avec l'agent puis From traces (7 jours, sampling). Résultat attendu : deux datasets versionnés ;
le second peut contenir moins de lignes que
max_samples. - Deux custom evaluators. Dans l'Evaluator catalog, créer un code-based (réponse de moins de 600 caractères) et un
prompt-based ordinal 1 à 5 (ton courtois) ; lancer une évaluation avec Groundedness, Violence et les deux custom. Résultat
attendu : scores par ligne et pass / fail selon
pass_thresholdetthreshold. - Quality gate GitHub. Créer une federated credential pour le dépôt, donner Foundry User au service principal, publier une version 2 de l'agent avec une instruction dégradée, lancer le workflow de la section 5.2. Résultat attendu : rapport avec intervalles de confiance et comparaison statistique en défaveur de la version 2.
- Continuous evaluation et alerte. Donner Foundry User à la project managed identity, créer la règle de la
section 5.3, générer du trafic, ouvrir l'onglet Monitor ; configurer une alerte Azure Monitor
sur
AzureOpenAITTLTInMS. Résultat attendu : scores qui apparaissent après quelques minutes ; alerte visible dans Alerts. - Coûts et KQL. Cost analysis sur le resource group, Group by Meter, filtre tag
project; créer un budget avec une alerte à 80 % ; lancer la requête KQL de jetons par modèle. Résultat attendu : coûts répartis par meter et par project ; les coûts d'Application Insights apparaissent sous leur propre service.
11. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| L'évaluation échoue en 403 alors que l'utilisateur a Foundry User sur le project | Foundry User à l'étendue de la Foundry resource | Une attribution au project seul n'autorise pas l'inférence du juge |
| Créer une continuous evaluation par SDK : quelle identité a besoin de Foundry User ? | La project managed identity | C'est elle qui exécute la règle |
| Pas encore de trafic de production, il faut un jeu de test | Synthetic data generation (Simple QnA, reference file) | Les traces n'existent pas encore |
| Le jeu de test doit refléter le comportement réel | Dataset from traces avec intelligent sampling | Les traces sont la source la plus représentative |
Le dataset généré a moins de lignes que max_samples |
Normal | max_samples est un plafond : doublons et traces pauvres sont retirés |
Colonne question au lieu de query |
data_mapping {{item.question}} |
Sans mapping, seuls les noms standard sont reconnus |
| L'evaluator Coherence sur une cible générée au run | Mapper la réponse sur {{sample.output_text}} |
La réponse n'existe pas dans le dataset |
| Évaluer une conversation multi-tours entière | evaluation_level="conversation" et format messages |
Le format query/response ne supporte pas le niveau conversation |
| Réponse pertinente mais qui invente | Groundedness basse, Relevance haute | Les deux mesurent des choses différentes |
| Comparer deux versions de façon fiable | Même dataset, mêmes evaluators, même juge, comparaison statistique | Sinon la différence peut venir du juge ou du hasard |
| Evaluator custom qui vérifie un format JSON | Code-based (grade(), 0.0 à 1.0) |
Règle déterministe, pas besoin d'un LLM |
| Evaluator custom qui juge le ton | Prompt-based (ordinal, continuous ou binary) | Jugement subjectif |
| Paramètres obligatoires d'un code-based evaluator | pass_threshold et deployment_name |
L'API exige le deployment même sans appel LLM |
| Évaluer à chaque commit | À éviter | Coût en jetons ; déclencher sur PR ou chemins précis |
| Authentifier le pipeline d'évaluation | OIDC (federated credential) ou service connection ARM | Pas de secret dans le dépôt |
| Des runs de continuous evaluation sont sautés | max_hourly_runs (100 par défaut) atteint |
Augmenter la limite ou attendre |
| Détecter une dérive après un changement de modèle | Scheduled evaluation sur golden dataset | La continuous evaluation suit le trafic, pas un jeu fixe |
| Lire les traces : rôle minimal | Log Analytics Reader (+ Privileged Monitoring Data Reader si Protected) | Les traces sont dans Application Insights / Log Analytics |
| Un agent tourne sur AKS : le suivre dans Foundry | Foundry Control Plane + conventions gen_ai + même Application Insights | Le tableau de bord lit cet Application Insights |
| Latence au-delà de 10 s dans le Monitor tab | Throttling, outils complexes ou réseau | Seuil indiqué par Microsoft |
| Couper Azure OpenAI quand le budget est atteint | Budget + action group + automatisation | Pas de hard limit natif |
| Répartir la facture entre équipes partageant une Foundry resource | Filtre sur le tag project (preview) |
Posé automatiquement, Models sold by Azure seulement |
| Un fine-tuned model coûte alors qu'il n'est pas appelé | Hébergement à l'heure tant qu'il est déployé | Supprimer le deployment inutile |
| Invites et réponses visibles dans les traces de production | Désactiver le content recording | Données personnelles |
12. Scénarios d'entraînement#
1. Une équipe lance un agent dans trois semaines, sans trafic réel. Elle veut un jeu de test couvrant la politique de remboursement (un PDF de 40 pages). Que faire ?
Synthetic data generation : Simple QnA, source Prompt ou Agent definition, plus le PDF en Reference file, quelques dizaines de lignes d'abord, relecture dans l'onglet Data, puis montée en volume. Après le lancement, compléter par un dataset from traces.
2. Le dataset curated a les colonnes question, sources et attendu. L'évaluation de Groundedness renvoie des erreurs sur
toutes les lignes.
Ajouter un
data_mapping:query←{{item.question}},context←{{item.sources}},response←{{sample.output_text}}si une cible génère la réponse ;ground_truth←{{item.attendu}}pour les metrics de référence.
3. Une évaluation lancée depuis GitHub Actions échoue en Forbidden au moment de noter les réponses. Le service principal a Foundry User sur le project.
Le juge est un model deployment : il faut Foundry User à l'étendue de la Foundry resource. Vérifier aussi que le
deployment-nameexiste dans le project.
4. Le métier veut vérifier qu'aucune réponse ne dépasse 800 caractères et que le ton reste courtois.
Deux custom evaluators : un code-based pour la longueur (
grade()entre 0.0 et 1.0,pass_threshold) et un prompt-based pour le ton (ordinal 1 à 5,threshold). Les ajouter au catalogue puis à la CI et à la continuous evaluation.
5. Après le passage à un nouveau modèle, les utilisateurs se plaignent de réponses moins fiables, mais aucune alerte n'a sonné. Qu'aurait-il fallu ?
Une scheduled evaluation quotidienne sur un golden dataset (détection de dérive), une quality gate en CI comparant l'ancien et le nouveau modèle sur le même jeu, et une alerte sur les scores dans les Monitor settings.
6. La continuous evaluation d'un agent très sollicité affiche des trous dans les scores l'après-midi.
Le plafond
max_hourly_runs(100 par défaut) est atteint aux heures de pointe : l'augmenter si le budget le permet, ou accepter l'échantillon.
7. La DSI veut répartir la facture d'une Foundry resource partagée entre trois projects métiers.
Cost Management > Cost analysis, filtre sur le tag
project(chargeback par project, preview, Models sold by Azure), group by Meter ; Cost Management Reader pour les contrôleurs de gestion ; export planifié pour Power BI.
8. Un agent hébergé sur AKS doit apparaître dans le même tableau de bord que les agents Foundry.
L'enregistrer dans le Foundry Control Plane (via AI Gateway), l'instrumenter selon les conventions OpenTelemetry gen_ai, et envoyer sa télémétrie vers l'Application Insights connecté au project.
9. Le Monitor tab indique une latence de 14 s et un run success rate de 91 %. Par où commencer ?
Les traces des runs lents et en échec : spans du modèle ou d'un outil,
resultCode; côté Azure Monitor, requêtes 429 (AzureOpenAIRequestsparStatusCode) et utilisation PTU ; lire la latence à côté des jetons générés.
10. Le RSSI constate que des invites complètes de clients apparaissent dans Application Insights.
Désactiver le content recording en production, passer les tables concernées en Protected (lecture avec Privileged Monitoring Data Reader), et revoir la rétention.
13. Pour aller plus loin#
- Cluster analysis : regrouper automatiquement les lignes en échec d'une évaluation par motif, pour corriger par familles.
- Simulate conversations : à partir de simulation seeds (
test_case_description), un simulateur joue l'utilisateur contre l'agent et des evaluators de niveau conversation notent le résultat. - Foundry MCP Server (preview) : lancer des évaluations, comparer des runs ou gérer le catalogue d'evaluators depuis un assistant.
- Réseau privé : l'évaluation en VNet passe par l'injection réseau (subnet delegation) ; modèle Bicep evaluation-only setup (15a) ; donner Foundry User à la project managed identity dès la création du project pour éviter les échecs.
- Azure Managed Grafana et Workbooks pour des tableaux de bord transverses (latence, débit, jetons par deployment).
14. Fiche à retenir#
- Offline (dataset, CI, quality gate) et online (continuous / scheduled, Monitor tab) utilisent le même catalogue d'evaluators.
- Foundry User à l'étendue de la Foundry resource pour un juge ; project managed identity pour les règles récurrentes et les traces (Reader sur Application Insights).
- Données : curated, synthetic (avant lancement), from traces (intelligent sampling, redaction par défaut,
max_samples1 à 1 000), ou sans dataset (response IDs, traces). -
data_mapping:{{item.*}}pour le dataset,{{sample.output_text}}/{{sample.output_items}}pour la sortie de la cible. - Groundedness, Relevance, Coherence, Fluency : juge LLM, 1 à 5, même juge pour comparer ; niveau
conversation= formatmessages. - Safety evaluators : service hébergé, régions limitées, defect rate ; Groundedness Pro et Protected material encore plus restreints.
- Custom : code-based (0.0 à 1.0,
pass_threshold+deployment_name), prompt-based (ordinal / continuous / binary,threshold+deployment_name), endpoint-based (30 s). - CI :
microsoft/ai-agent-evalsouAIAgentEvaluation@2, OIDC,agent-idsnom:version, baseline, intervalles de confiance ; pas à chaque commit. - Continuous evaluation :
EvaluationRule,RESPONSE_COMPLETED,max_hourly_runs100 ; scheduled :Schedulesur golden dataset pour la dérive. - Monitor tab : latence > 10 s, success rate < 95 % ; alertes (preview) ; données dans Application Insights (rétention et coût associés).
- Performance : TTLT = TTFT + TBT × jetons ;
AzureOpenAIRequestspour le débit et les 429 ; metric alerts Azure Monitor. - Coûts : Estimated cost (pilotage) vs Cost Management (facture) ; group by Meter ; tag
project; budgets sans hard limit ; fine-tuned deployment facturé à l'heure. - Logs : traces (Application Insights), resource logs (diagnostic setting →
AzureDiagnostics), metrics ; content recording désactivé en production.
Références#
Toutes lues le 21/10/2026 :
- Study guide for Exam AI-300
- Evaluation in Microsoft Foundry
- Evaluation datasets in Microsoft Foundry
- Evaluation dataset schema in Microsoft Foundry
- Generate a synthetic evaluation dataset
- Convert agent traces into evaluation datasets
- Built-in evaluators reference
- Risk and safety evaluators
- Custom evaluators (preview)
- Rate limits, region support, and enterprise features for evaluation
- Set up permissions for Microsoft Foundry evaluation workflows
- How to run an evaluation in GitHub Action (preview)
- How to run an evaluation in Azure DevOps (preview)
- Evaluate your AI agents
- Monitor agents with the Agent Monitoring Dashboard
- Observability in generative AI
- Configure virtual network support for evaluation
- Plan and manage costs for Microsoft Foundry
- Environment-level telemetry with Application Insights (requêtes de découverte du schéma
dependencies) - az monitor metrics alert (référence Azure CLI)
- Azure OpenAI monitoring data reference (metrics
AzureOpenAITTLTInMS,AzureOpenAITimeToResponse…)