

Version : 1.1 · Date : 2026-10-21 · Domaine 2 de l'examen : Implement generative AI and agentic solutions (30 à 35 %)
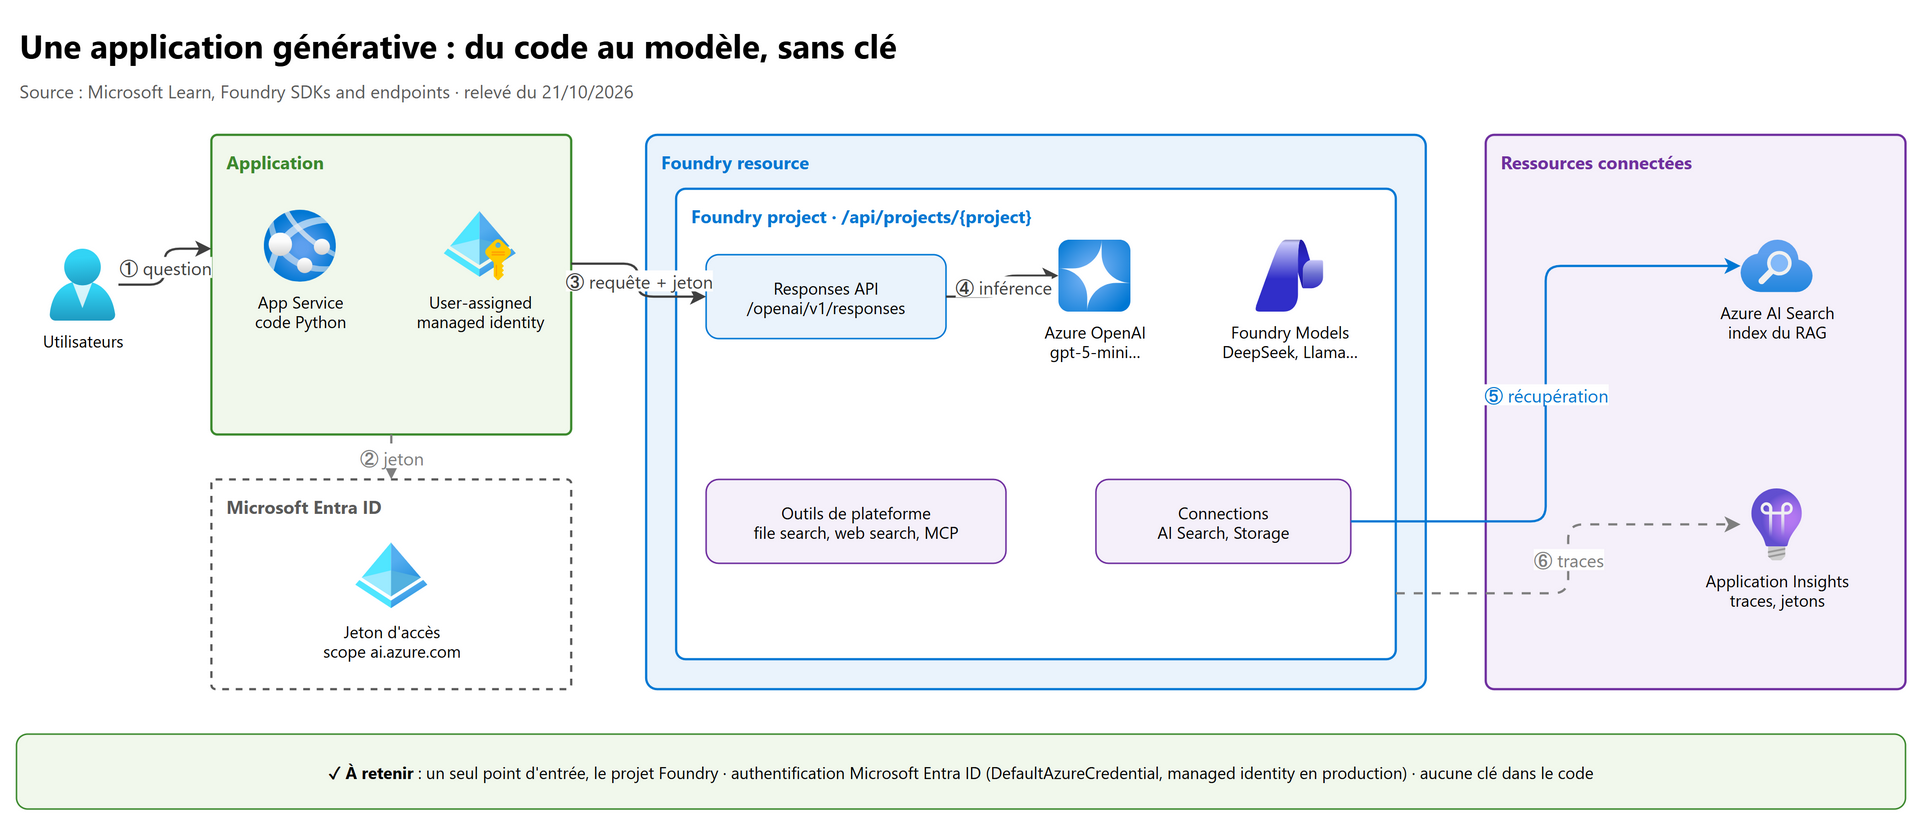
En une phrase : une application générative se connecte sans clé à un Foundry project (Microsoft Entra ID), appelle les modèles par la Responses API, ancre ses réponses dans vos données grâce au RAG (Azure AI Search), enchaîne les étapes avec le function calling et les workflows de Microsoft Agent Framework, et prouve sa qualité par des evaluators (groundedness, relevance, safety) avant et après la mise en production.
Ce que l'examen demande#
Bloc Build generative applications by using Foundry, repris mot pour mot du guide d'étude AI-103 (compétences au 16 avril 2026) :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| 1 | Deploy and consume LLMs, small models, code models, and multimodal models | 3 |
| 2 | Implement retrieval-augmented generation (RAG) in an application | 4 |
| 3 | Design workflows, tool-augmented flows, and multistep reasoning pipelines | 5 |
| 4 | Evaluate models and apps, including detecting fabrications, relevance, quality, and safety | 7 |
| 5 | Integrate generative workflows into applications by using Foundry SDKs and connectors | 6 |
| 6 | Configure an application to connect to a Foundry project | 2 |
Les autres blocs du domaine sont traités ailleurs : agents au chapitre 06, optimisation et observabilité au chapitre 07. L'indexation (ingestion, skills, chunking) est au chapitre 10 ; la sécurité et les filtres de contenu aux chapitres 03 et 04.
1. Les bases à maîtriser#
1.1 Le vocabulaire Foundry#
| Terme | Ce que c'est | Ce qu'il faut retenir |
|---|---|---|
| Foundry resource | La ressource Azure (type Foundry Tools / AI Services) qui porte les modèles, la facturation, le réseau | Elle expose tous les points de terminaison : projet, /openai/v1, /anthropic, outils |
| Foundry project | Espace de travail dans la ressource : agents, evaluations, connections, datasets, indexes | Point d'entrée recommandé : https://{resource}.services.ai.azure.com/api/projects/{project} |
| Deployment | Un modèle du catalogue rendu appelable, sous un nom que vous choisissez | Dans le code, model= reçoit le nom du deployment, pas l'ID du modèle |
| Foundry Models | Le catalogue : modèles Azure OpenAI et modèles « sold by Azure » (DeepSeek, Grok, Llama, MAI…) et partenaires | Beaucoup sont appelables par la même Responses API |
| Connection | Lien déclaré dans le projet vers une ressource (Azure AI Search, Storage…) | Lue par le code (project.connections.get(...)) ou utilisée par les outils d'agent |
1.2 Quel SDK pour quoi#
| SDK | Usage | Point de terminaison |
|---|---|---|
Foundry SDK (azure-ai-projects 2.x) |
Toutes les API du projet : agents, evaluations, connections, datasets, indexes, et un client OpenAI déjà authentifié | Project endpoint |
| Microsoft Agent Framework | Agents et systèmes multi-agents dans le code (FoundryChatClient en Python), workflows |
Responses API du projet |
OpenAI SDK (openai) |
Surface OpenAI complète, latence la plus basse, embeddings, Chat Completions | https://{resource}.openai.azure.com/openai/v1 |
| Anthropic SDK | Modèles Claude déployés dans Foundry | https://{resource}.services.ai.azure.com/anthropic |
| Foundry Tools SDKs | Services spécialisés : Vision, Speech, Language, Translator, Content Safety | Point de terminaison propre à l'outil |
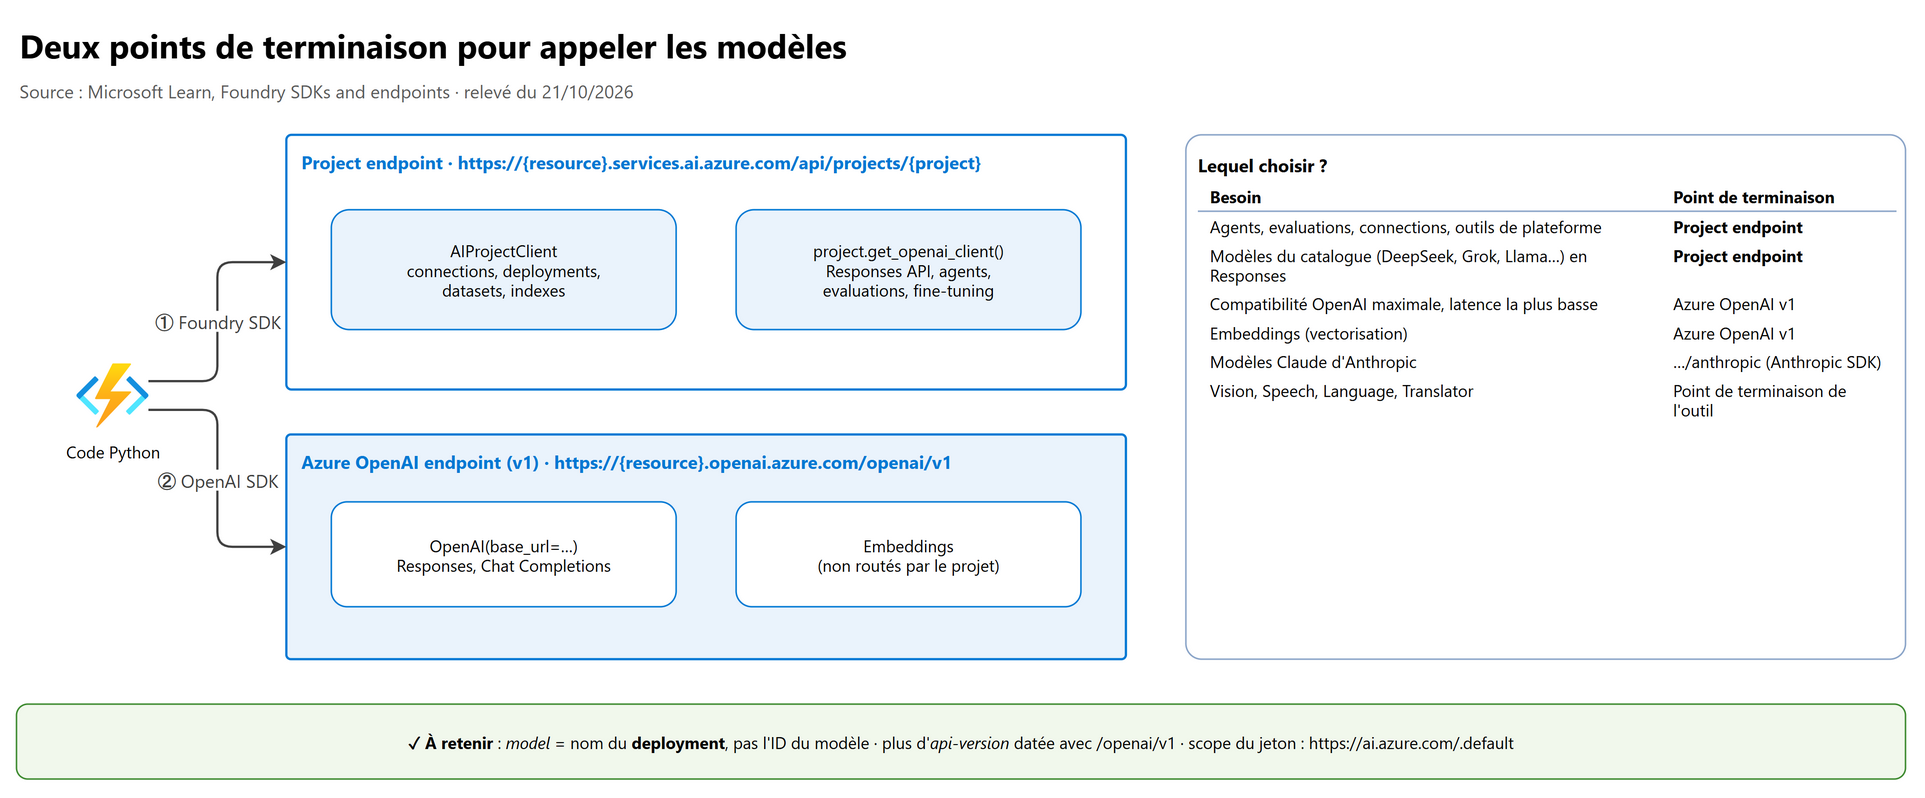
Piège : le project endpoint ne route pas les embeddings. Pour vectoriser (RAG, recherche vectorielle), utilisez le point de terminaison
/openai/v1de la ressource.
2. Connecter une application à un Foundry project#
2.1 Ce qu'il faut à l'application#
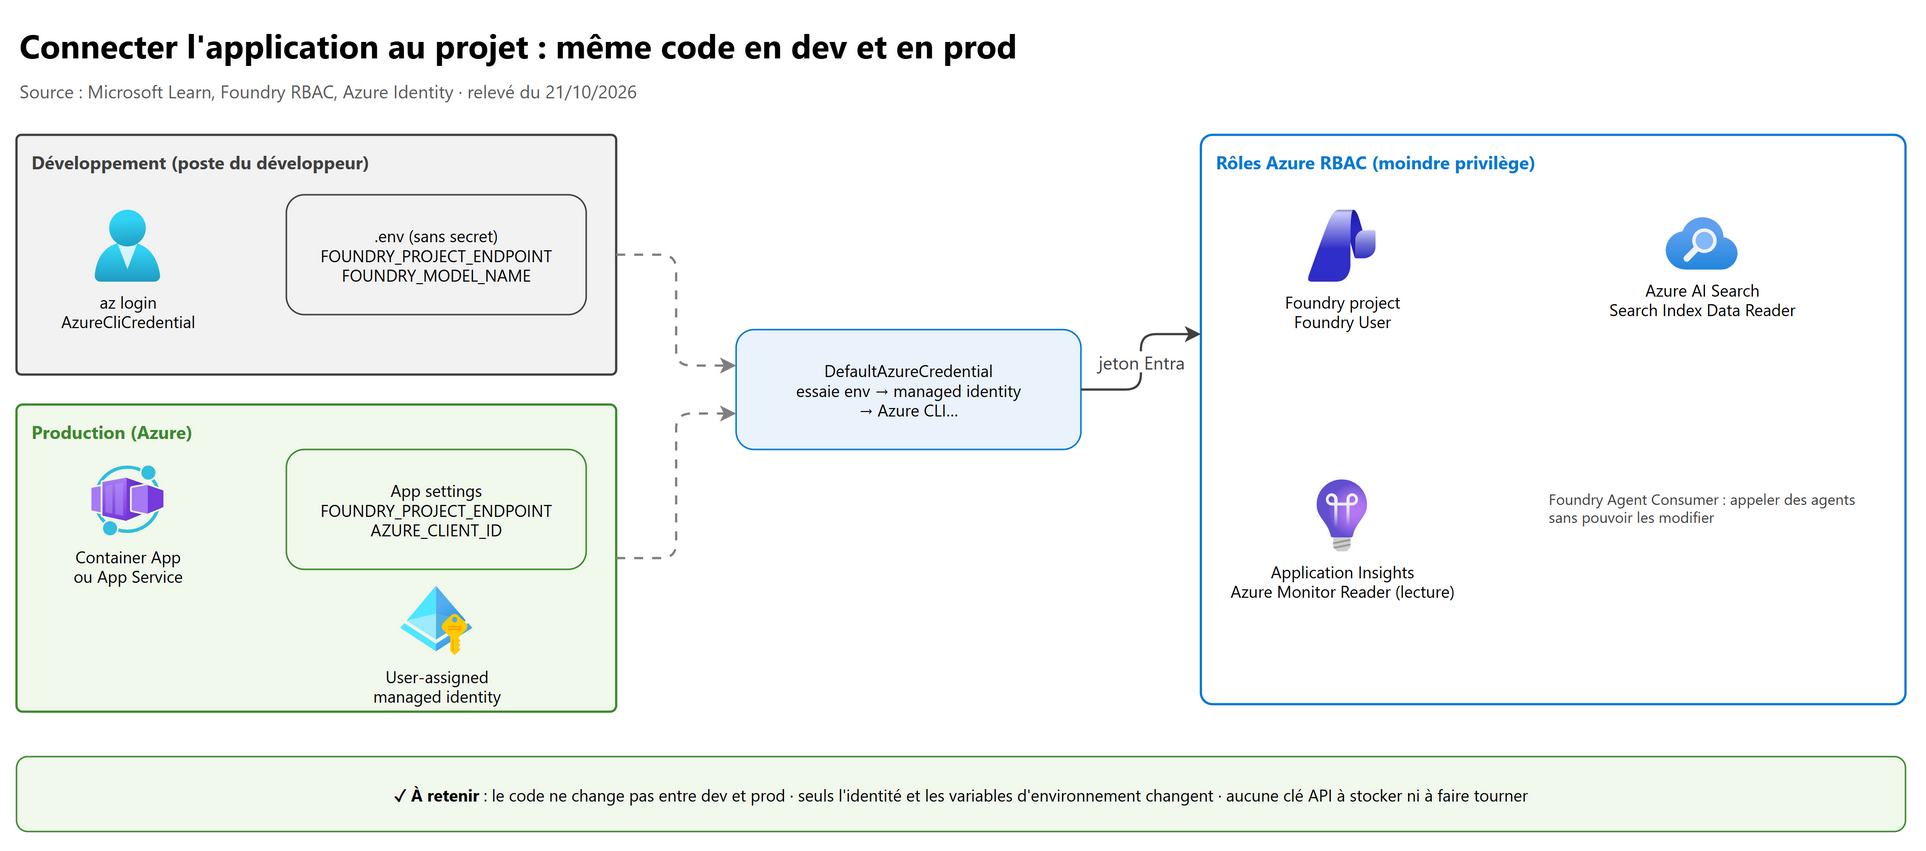
- L'adresse du projet, dans une variable d'environnement (jamais en dur) :
FOUNDRY_PROJECT_ENDPOINT, de la formehttps://{resource}.services.ai.azure.com/api/projects/{project}(avec un sous-domaine personnalisé, il remplace{resource}). - Le nom du deployment :
FOUNDRY_MODEL_NAME(par exemplegpt-5-mini). - Une identité reconnue par Microsoft Entra ID, résolue par
DefaultAzureCredential:- en développement : la session
az login(AzureCliCredential) ; - en production : une managed identity (de préférence user-assigned,
AZURE_CLIENT_IDdans les app settings).
- en développement : la session
- Un rôle Azure RBAC au plus juste (section 2.3).
Le client du Foundry SDK n'accepte que Microsoft Entra ID comme authentification. Les clés API restent possibles sur
/openai/v1, mais ne sont pas la bonne pratique.
2.2 Le code minimal#
# pip install "azure-ai-projects>=2.3.0" "openai>=3.0.0" azure-identity   (Python 3.10 ou plus)
import os
from azure.identity import DefaultAzureCredential
from azure.ai.projects import AIProjectClient

with (
    DefaultAzureCredential() as credential,          # az login en dev, managed identity en prod
    AIProjectClient(endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"], credential=credential) as project,
    project.get_openai_client() as openai,           # client OpenAI déjà authentifié sur le projet
):
    response = openai.responses.create(
        model=os.environ["FOUNDRY_MODEL_NAME"],      # nom du deployment
        input="Quelle est la superficie de la France en km² ?",
    )
    print(response.output_text)
Le project client (AIProjectClient) sert à ce qu'OpenAI n'a pas : connections, deployments, datasets, indexes, propriétés du
projet, traçage. Le client compatible OpenAI (get_openai_client()) sert à tout ce qui suit le modèle OpenAI : Responses,
agents, evaluations, fine-tuning. La plupart des applications utilisent les deux.
Variante sans le Foundry SDK, avec le seul OpenAI SDK et un jeton Entra :
from azure.identity import DefaultAzureCredential, get_bearer_token_provider
from openai import OpenAI

token_provider = get_bearer_token_provider(DefaultAzureCredential(), "https://ai.azure.com/.default")
client = OpenAI(
    base_url="https://{resource}.openai.azure.com/openai/v1/",   # ou {project_endpoint}/openai/v1
    api_key=token_provider,                                      # fournisseur de jeton, renouvelé automatiquement
)
Avec /openai/v1, il n'y a plus de paramètre api-version daté à gérer.
2.3 Les rôles#
Les rôles Foundry ont été renommés : Foundry User, Foundry Owner, Foundry Account Owner et Foundry Project Manager s'appelaient Azure AI User, Azure AI Owner, Azure AI Account Owner et Azure AI Project Manager (mêmes ID, mêmes droits). L'examen et le portail peuvent encore montrer les anciens noms.
| Besoin | Rôle | Étendue |
|---|---|---|
| Développer au quotidien, appeler les modèles, créer des agents avec des modèles déjà déployés | Foundry User | Foundry resource ou projet |
| Seulement appeler des agents (Responses API) sans les modifier | Foundry Agent Consumer | Projet |
| Créer et modifier des model deployments | Foundry Account Owner (Foundry Project Manager ne gère pas les modèles) | Ressource |
| Fine-tuning (plan de données + plan de contrôle) | Foundry Owner, ou Foundry User + Foundry Account Owner | Ressource |
| Créer des projets, gérer la ressource et ses clés | Foundry Account Owner (à réserver, idéalement en juste-à-temps avec PIM) | Ressource |
| Appeler un modèle avec Entra ID (endpoint du project ou endpoint OpenAI v1 de la ressource) | Foundry User ; ne pas attribuer de rôle Cognitive Services pour Foundry (seule exception : Cognitive Services Usages Reader pour lire le quota) | Ressource |
| L'application lit un index de recherche | Search Index Data Reader | Service Azure AI Search |
| Lire les traces | Azure Monitor Reader sur Application Insights, en plus de Foundry User | Application Insights |
Piège classique : avoir un rôle d'administration (Owner, Contributor) ne donne pas le droit d'appeler les modèles. Les opérations de données exigent un rôle « data » explicite (Foundry User).
2.4 Dépannage rapide#
| Symptôme | Cause probable | Correction |
|---|---|---|
DefaultAzureCredential failed to retrieve a token |
Pas de session (az login), ou managed identity absente |
Se connecter ; vérifier l'identité et AZURE_CLIENT_ID |
401 Unauthorized |
Identité sans rôle data | Donner Foundry User sur la Foundry resource ou le project |
404 Not Found |
Mauvais format d'URL, mauvais nom de projet ou de deployment | Vérifier /api/projects/{project} et le nom du deployment |
AttributeError, ModuleNotFoundError |
Version du SDK incompatible (1.x « classic » au lieu de 2.x) | pip show azure-ai-projects, réinstaller la bonne version |
Les anciens exemples (Foundry classic, SDK 1.x) construisaient le client avec une connection string du projet (
AIProjectClient.from_connection_string). Le SDK 2.x utilise le project endpoint.
3. Déployer et consommer des modèles#
3.1 Déployer#
Le déploiement (choix du type Global / Data Zone / Standard / Provisioned, quotas, versions) est détaillé au
chapitre 02. Pour ce chapitre, retenez : on déploie un modèle depuis le catalogue du portail
Foundry (ou par CLI / IaC), on lui donne un nom, et c'est ce nom que l'on passe dans model=.
Vérifier qu'un deployment est prêt (lecture seule) :
az cognitiveservices account deployment show --name <resource> --resource-group <rg> \
  --deployment-name gpt-5-mini --query properties.provisioningState --output tsv    # renvoie Succeeded
3.2 Choisir le type de modèle#
| Type | Quand | Exemples du catalogue (à vérifier dans la région) |
|---|---|---|
| LLM généraliste | Génération, synthèse, conversation, outils | Famille GPT d'Azure OpenAI, Llama-3.3-70B-Instruct, DeepSeek-V3.x |
| Modèle de raisonnement | Planification, problèmes à plusieurs étapes, agents | Série o (o3, o4-mini), GPT-5 avec reasoning, DeepSeek-R1, MAI-DS-R1 |
| Small language model (SLM) | Classification, extraction simple, latence et coût bas, volume élevé | Variantes « mini » et « nano », grok-3-mini |
| Modèle de code | Génération, revue et refactorisation de code | codex-mini, GPT-5 Codex |
| Multimodal | Image en entrée (et parfois audio) | GPT-4o, GPT-4.1, GPT-5, DeepSeek-V3-0324 |
Le choix détaillé (benchmarks, coût, région, model router) est au chapitre 01.
3.3 La Responses API, forme recommandée#
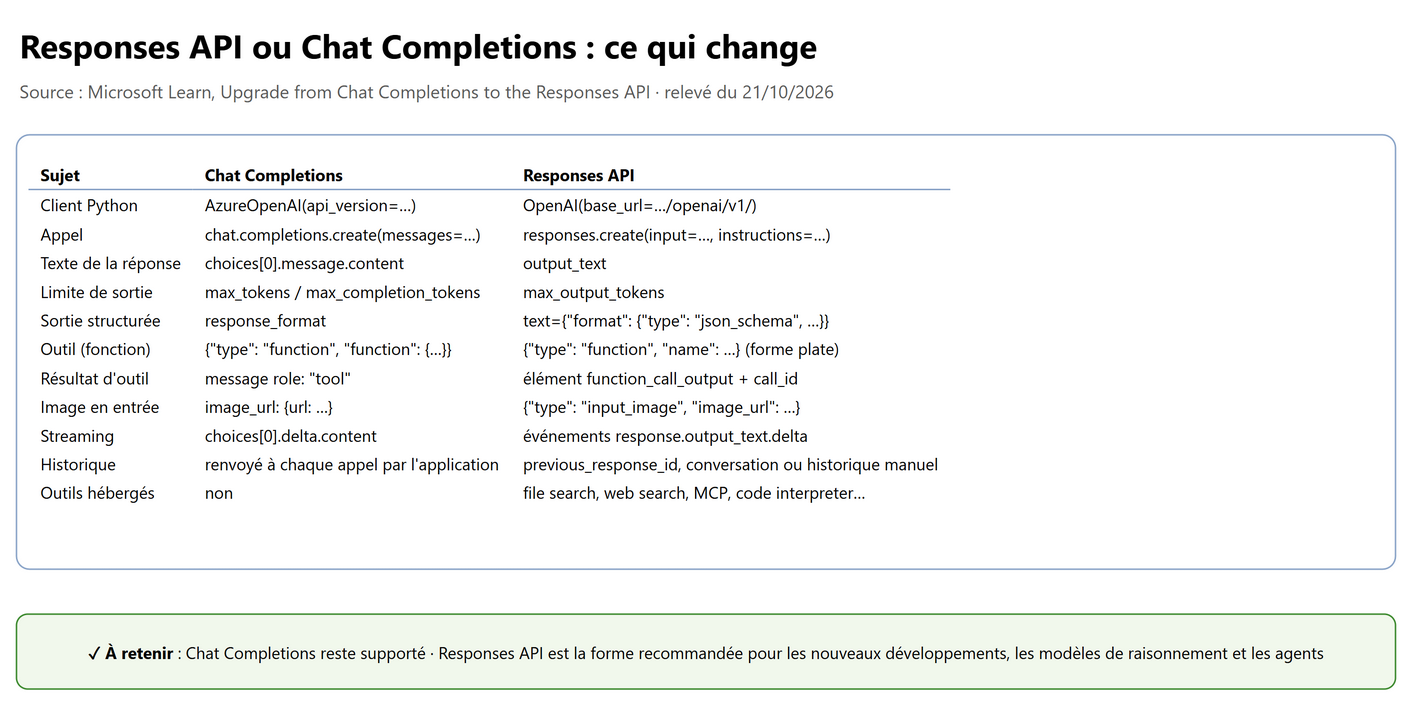
La Responses API est l'API de nouvelle génération : une seule forme pour du texte simple et pour des flux avancés (outils, raisonnement, état). Chat Completions reste supporté, mais les nouveaux développements, les modèles de raisonnement et les agents visent Responses. Sur le project endpoint, elle sert aussi des Foundry Models non-OpenAI (DeepSeek, Grok, Llama, MAI…).
Les éléments d'une requête :
response = openai.responses.create(
    model="gpt-5-mini",
    instructions="Tu es un assistant RH. Réponds en français, en trois phrases au plus.",   # consigne système
    input=[
        {"role": "user", "content": "Combien de jours de congés pour un temps partiel à 80 % ?"},
    ],
    max_output_tokens=800,          # remplace max_tokens / max_completion_tokens
)
print(response.output_text)          # texte final ; response.output contient les éléments typés
print(response.usage.output_tokens)  # consommation, utile pour les coûts
| Rôle | Usage |
|---|---|
system / developer |
Consignes de haut niveau (persona, règles, format). Avec les modèles de raisonnement, developer est équivalent à system : ne pas mettre les deux dans la même requête |
user |
La demande de l'utilisateur (non fiable : c'est là qu'arrivent les injections) |
assistant |
Réponses précédentes du modèle (historique géré par l'application) |
Conserver le contexte d'une conversation, trois façons :
| Méthode | Principe | À savoir |
|---|---|---|
previous_response_id |
Passer l'ID de la réponse précédente : le service retrouve le contexte | Les réponses sont stockées 30 jours par défaut (supprimables par ID) |
conversation |
Un ID conv_* stable pour toute la conversation |
Exclusif de previous_response_id |
| Historique manuel | L'application renvoie les éléments précédents dans input |
Obligatoire si store=False (exigence de conformité) |
Sécurité : un
previous_response_idou un ID de conversation reçu du client n'est pas une preuve d'autorisation. Vérifiez que l'utilisateur connecté en est bien propriétaire.
3.4 Sortie structurée (JSON schema)#
Pour obtenir du JSON conforme à un schéma (extraction, intégration à une autre application), utilisez les structured outputs :
text.format en Responses (au lieu de response_format en Chat Completions).
from pydantic import BaseModel

class Conge(BaseModel):          # le schéma attendu
    salarie: str
    date_debut: str
    nb_jours: int

response = openai.responses.parse(
    model="gpt-5-mini",
    input="Extrais la demande : Alice part en congés le 3 novembre pour 5 jours.",
    text_format=Conge,           # le SDK convertit le modèle Pydantic en JSON schema strict
)
print(response.output_parsed)    # objet Conge validé
Équivalent sans Pydantic : text={"format": {"type": "json_schema", "name": "Conge", "strict": True, "schema": {...}}}.
3.5 Streaming#
stream = openai.responses.create(model="gpt-5-mini", input="Résume la politique de télétravail.", stream=True)
for event in stream:
    if event.type == "response.output_text.delta":   # morceaux de texte au fil de l'eau
        print(event.delta, end="")
Si une erreur survient au milieu du flux, la réponse HTTP reste 200 : l'erreur arrive dans un événement d'erreur
(server_error, too_many_requests, forbidden, user_error). Prévoir un try/except et la gestion de ces événements. Les jetons
d'un streaming échoué ne sont pas facturés.
3.6 Image en entrée (multimodal)#
response = openai.responses.create(
    model="gpt-4.1",                                  # un deployment multimodal
    input=[{"role": "user", "content": [
        {"type": "input_text", "text": "Que montre ce schéma ?"},
        {"type": "input_image", "image_url": "https://exemple.com/schema.png"},   # URL ou data URL en base64
    ]}],
)
En Responses, les types de contenu sont input_text et input_image (et non text et image_url: {url: …} de Chat Completions).
La compréhension d'image détaillée est au chapitre 08.
3.7 Modèles de raisonnement#
| Paramètre | Comportement |
|---|---|
reasoning={"effort": "low"} (Responses) ou reasoning_effort (Chat Completions) |
Règle la réflexion : none, minimal, low, medium, high, xhigh, max selon le modèle (max : GPT-5.6 / GPT-6 et Responses API seulement ; minimal : premiers GPT-5 seulement) ; plus l'effort est élevé, plus il y a de jetons de raisonnement (facturés, invisibles) |
max_output_tokens |
Doit laisser de la place au raisonnement : trop bas, la réponse est vide ou tronquée |
| Non supportés (sauf exception documentée) | temperature, top_p, presence_penalty, frequency_penalty, logprobs, top_logprobs, logit_bias, max_tokens |
Mode background |
Recommandé pour les modèles très longs (o3-pro) afin d'éviter les timeouts |
Bonne pratique Microsoft : donner un objectif clair, des contraintes et un format de sortie, sans prescrire chaque étape ; traiter l'effort comme un réglage, pas comme le premier réflexe quand la qualité baisse.
3.8 Modèles non-OpenAI et embeddings#
# Un Foundry Model (DeepSeek) par le project endpoint, même client OpenAI, même Responses API
response = openai.responses.create(model="DeepSeek-R1-0528", input="Trois avantages du cloud ?", max_output_tokens=2000)

# Les embeddings passent par /openai/v1 de la ressource (pas par le projet)
emb = client.embeddings.create(model="text-embedding-3-large", input="politique de télétravail")
vecteur = emb.data[0].embedding
La liste des Foundry Models compatibles Responses se voit dans le portail : Discover > Models > Capabilities > Agent supported.
Erreur 400 Model not supported : le modèle déployé n'accepte pas la Responses API.
4. Le RAG dans une application#
4.1 Le principe#
La retrieval-augmented generation (RAG) ancre les réponses d'un LLM dans vos contenus : on récupère les extraits utiles, on les ajoute au prompt, le modèle répond à partir de ces extraits et cite ses sources. Elle évite de réentraîner un modèle et réduit les fabrications (hallucinations).
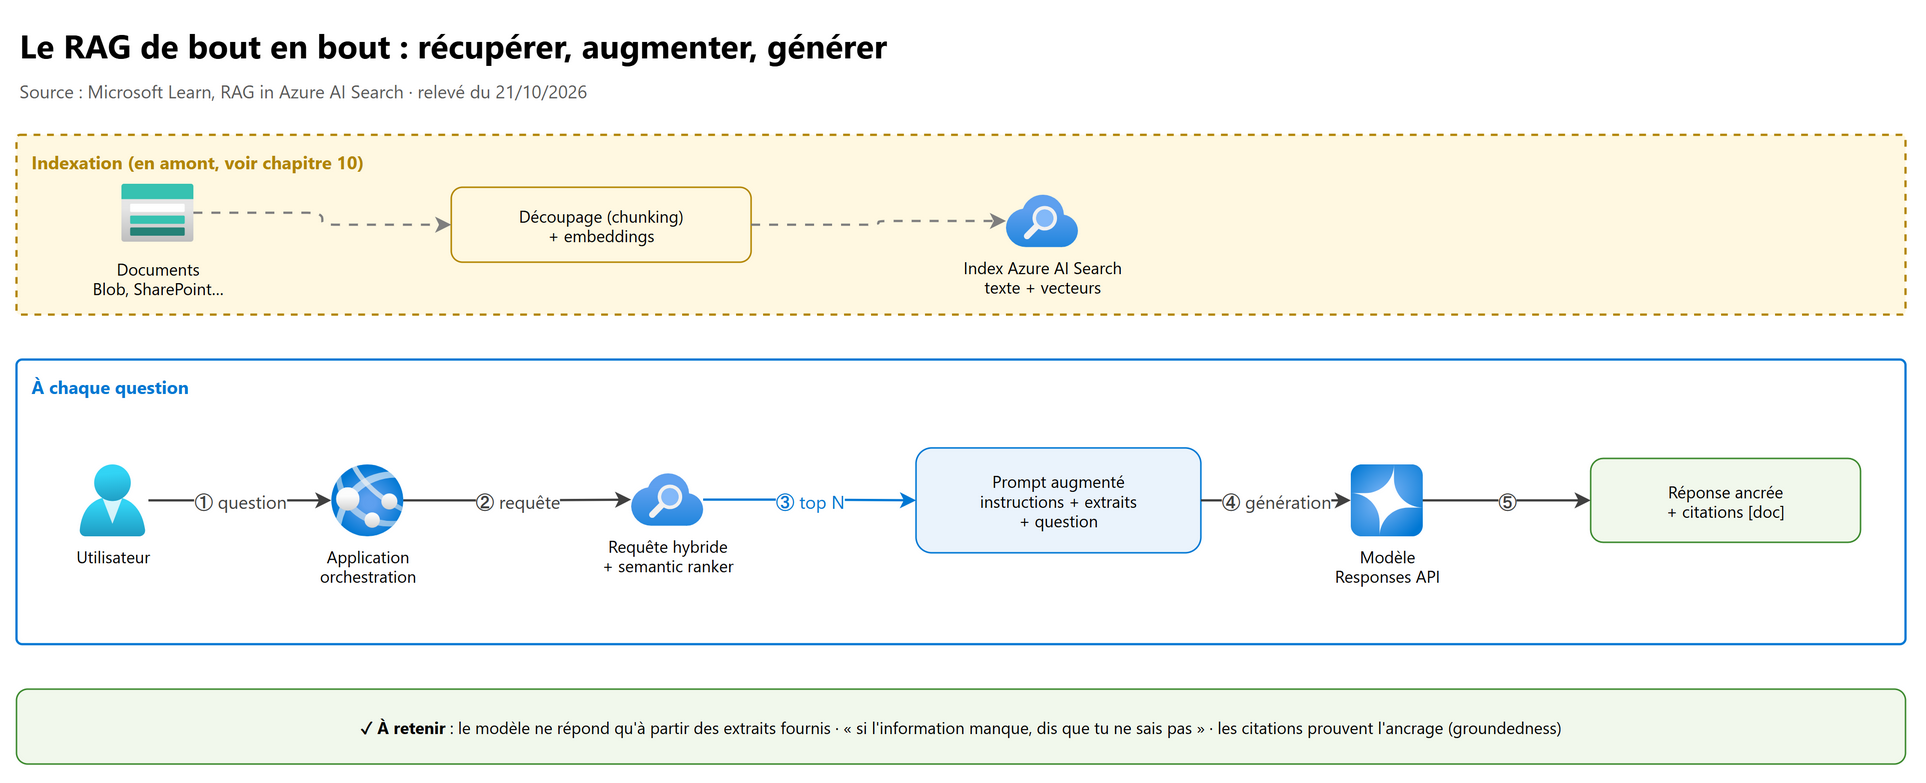
sequenceDiagram
    actor U as Utilisateur
    participant A as Application
    participant S as Azure AI Search
    participant M as Modèle (Responses API)
    U->>A: Question
    A->>S: Requête hybride + semantic ranker (identité managée)
    S-->>A: Top N extraits (titre, contenu, source)
    A->>M: instructions + extraits + question
    M-->>A: Réponse ancrée avec citations
    A-->>U: Réponse + liens vers les sources
4.2 Deux façons de faire le RAG avec Azure AI Search#
| RAG classique | Agentic retrieval (knowledge base, Foundry IQ) | |
|---|---|---|
| Principe | L'application envoie une requête à Azure AI Search puis orchestre l'appel au LLM | Un LLM planifie la requête : sous-requêtes parallèles, plusieurs knowledge sources, réponse structurée avec citations |
| Objets | Index (+ indexer et skillset) | Knowledge sources + knowledge base + action de récupération |
| Points forts | Simple, rapide (millisecondes), fonctionnalités GA, contrôle fin du pipeline | Pertinence maximale sur des questions complexes ou conversationnelles, multi-sources (dont SharePoint distant, Bing) |
| Recommandé pour | GA uniquement, code d'orchestration existant, simplicité | Nouvelles implémentations, clients de type agent ou chatbot |
| Statut | GA | Certaines capacités en preview (planification de requêtes, synthèse de réponse) |
Foundry IQ est la couche de connaissances gérée de Foundry, bâtie sur l'agentic retrieval : un agent s'y connecte comme à un point de terminaison unique. Le détail est aux chapitres 06 et 10.
Azure OpenAI On Your Data est retiré depuis le 14 octobre 2026 (plus supporté). Migration recommandée : Foundry IQ (ou Foundry Agent Service avec Foundry IQ). Alternatives GA : récupération minimale extractive d'une knowledge base, ou RAG classique avec génération gérée par l'application. La migration n'est pas automatique.
4.3 Récupérer : recherche hybride puis semantic ranker#
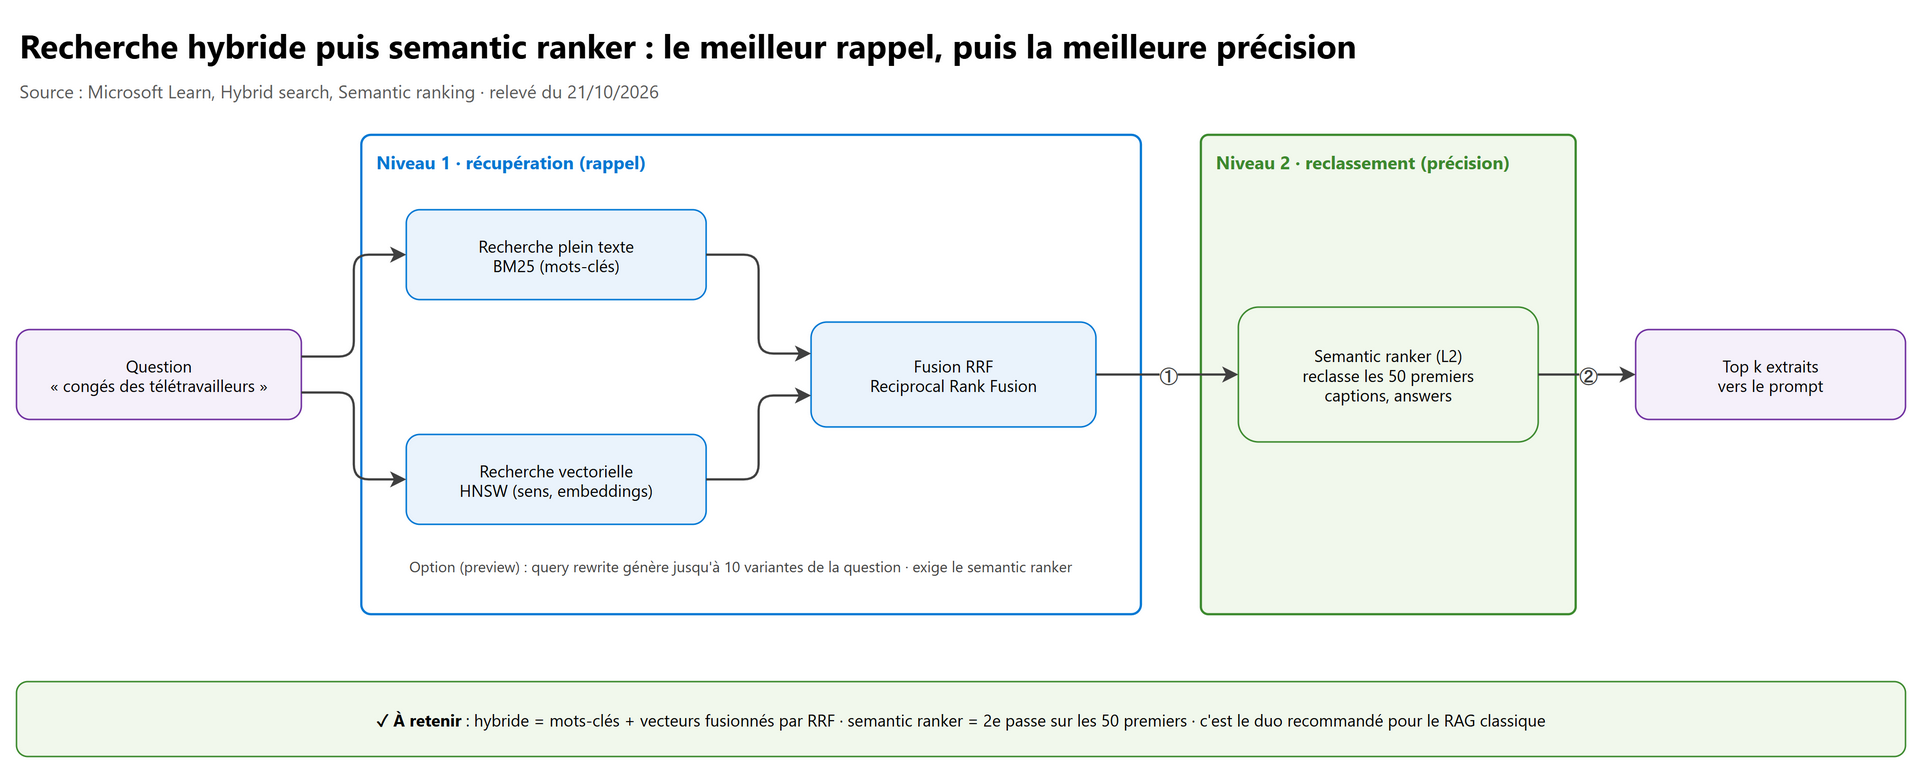
| Brique | Rôle | À savoir |
|---|---|---|
| Full-text search (BM25) | Correspondance de mots-clés exacts | Indispensable pour les codes, références, noms propres |
| Vector search (embeddings) | Correspondance de sens (« congés » ≈ « PTO ») | Exige des vecteurs dans l'index et le même modèle d'embeddings à l'indexation et à la requête |
| Hybrid search | Les deux en parallèle, fusionnés par Reciprocal Rank Fusion (RRF) | Meilleur rappel ; c'est la base recommandée |
| Semantic ranker | 2e passe (L2) sur les 50 premiers résultats, modèles de langage dérivés de Bing ; ajoute captions et answers | Fonctionnalité premium (coût), exige une semantic configuration dans l'index |
| Query rewrite (preview) | Génère jusqu'à 10 variantes de la question (fautes, synonymes) | Exige le semantic ranker et queryLanguage ; peut perdre des termes exacts |
| Filtres, scoring profiles, seuils | Restreindre (sécurité, métadonnées), pousser des champs, couper les résultats faibles | Les filtres de sécurité au niveau document se font à la requête |
4.4 Le code d'un RAG classique#
import os
from azure.identity import DefaultAzureCredential
from azure.search.documents import SearchClient
from azure.search.documents.models import VectorizedQuery
from azure.ai.projects import AIProjectClient
from openai import OpenAI
from azure.identity import get_bearer_token_provider

credential = DefaultAzureCredential()   # la même identité pour Search et Foundry (Search Index Data Reader + Foundry User)
search = SearchClient(os.environ["AZURE_SEARCH_ENDPOINT"], "rh-politiques", credential=credential)
project = AIProjectClient(endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"], credential=credential)
llm = project.get_openai_client()
emb_client = OpenAI(base_url=os.environ["AZURE_OPENAI_V1_ENDPOINT"],          # embeddings : /openai/v1 de la ressource
                    api_key=get_bearer_token_provider(credential, "https://ai.azure.com/.default"))

question = "Quelle est la politique de congés pour les télétravailleurs embauchés après 2023 ?"

# 1. Récupération : hybride (texte + vecteur) puis semantic ranker
vecteur = emb_client.embeddings.create(model="text-embedding-3-large", input=question).data[0].embedding
resultats = search.search(
    search_text=question,                                                       # partie mots-clés (BM25)
    vector_queries=[VectorizedQuery(vector=vecteur, k_nearest_neighbors=50, fields="contenu_vecteur")],
    query_type="semantic", semantic_configuration_name="config-semantique",     # reclassement L2
    select=["titre", "contenu", "url"], top=5,
)
sources = "\n".join(f"[{i}] {r['titre']} ({r['url']}) : {r['contenu']}" for i, r in enumerate(resultats, 1))

# 2. Augmentation + 3. Génération
response = llm.responses.create(
    model=os.environ["FOUNDRY_MODEL_NAME"],
    instructions=("Réponds UNIQUEMENT à partir des sources ci-dessous et cite-les sous la forme [n]. "
                  "Si l'information n'y est pas, réponds que tu ne sais pas."),
    input=f"Question : {question}\n\nSources :\n{sources}",
)
print(response.output_text)
Avec la vectorisation intégrée de l'index (vectorizer déclaré dans l'index), la requête peut envoyer du texte à vectoriser côté service au lieu d'un vecteur calculé par l'application.
4.5 Les bonnes pratiques d'un RAG#
- Prompt d'ancrage : « uniquement à partir des sources », « dis que tu ne sais pas », « cite [n] ».
- Citations : renvoyer titre et URL de chaque extrait ; elles rendent la réponse vérifiable et servent à l'évaluation.
- Peu d'extraits, mais pertinents : les jetons sont limités et coûtent ; top 3 à 5 extraits reclassés valent mieux que 20 bruts.
- Découpage (chunking) adapté aux documents, avec métadonnées (titre, section) : voir le chapitre 10.
- Sécurité : l'utilisateur ne doit récupérer que ce qu'il a le droit de voir (filtres de sécurité, permissions Entra héritées du stockage, SharePoint). Un document injecté peut contenir une injection d'invite indirecte : voir le chapitre 04 (Prompt Shields).
- Évaluer la récupération et la réponse séparément (section 7).
5. Flux outillés et pipelines à plusieurs étapes#
5.1 Function calling#
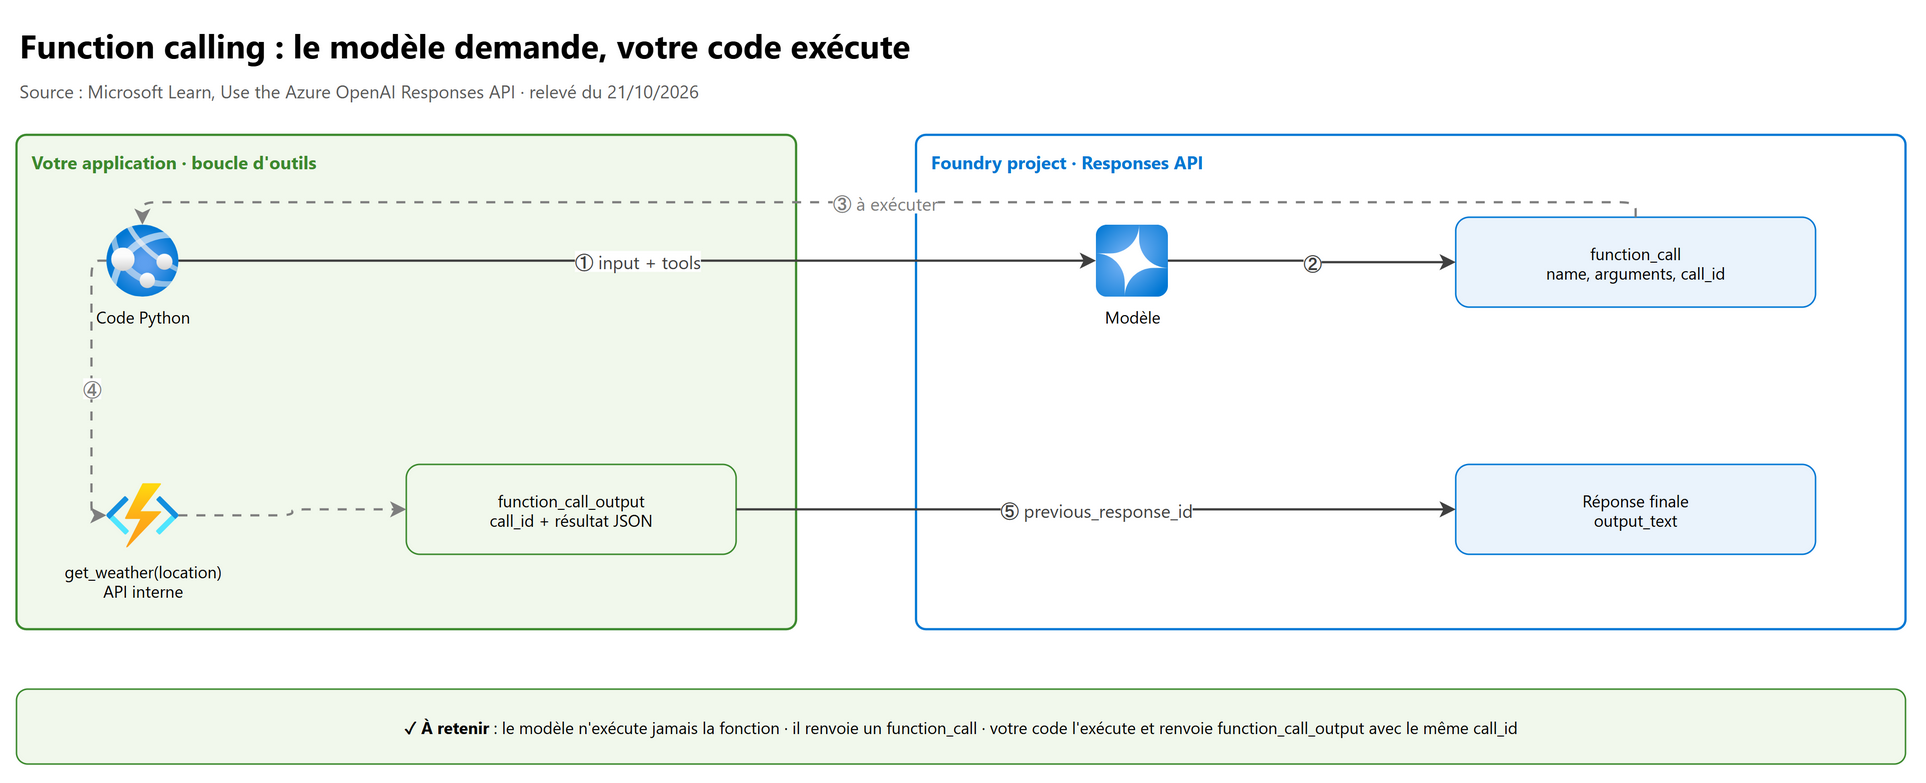
Le modèle ne fait que proposer un appel de fonction (nom + arguments JSON) ; votre code l'exécute et renvoie le résultat. C'est la base des flux « augmentés par des outils » et des agents.
import json

tools = [{
    "type": "function",                         # forme « plate » en Responses (pas de clé "function": {...})
    "name": "get_weather",
    "description": "Donne la météo d'une ville",
    "parameters": {"type": "object", "properties": {"location": {"type": "string"}}, "required": ["location"]},
}]

response = openai.responses.create(model="gpt-5-mini", tools=tools, input="Quel temps fait-il à Lyon ?")

sorties = []
for item in response.output:                    # le modèle peut demander plusieurs appels
    if item.type == "function_call" and item.name == "get_weather":
        args = json.loads(item.arguments)       # arguments à valider avant usage
        meteo = {"location": args["location"], "temperature": "14 °C"}   # ici, votre vraie API
        sorties.append({"type": "function_call_output", "call_id": item.call_id, "output": json.dumps(meteo)})

final = openai.responses.create(model="gpt-5-mini", previous_response_id=response.id, input=sorties)
print(final.output_text)
sequenceDiagram
    participant A as Application
    participant M as Modèle (Responses API)
    participant F as Votre fonction / API
    A->>M: input + définition des tools
    M-->>A: function_call (name, arguments, call_id)
    A->>F: exécute get_weather(location)
    F-->>A: résultat JSON
    A->>M: function_call_output (même call_id) + previous_response_id
    M-->>A: réponse finale (output_text)
Règles à retenir :
- valider les arguments (ils viennent du modèle, donc indirectement de l'utilisateur) et appliquer le moindre privilège à la fonction ;
- toujours renvoyer
function_call_outputavec le mêmecall_id; ne jamais renvoyer un messagerole: "tool"(forme Chat Completions) ; - avec les structured outputs, les arguments respectent strictement le schéma (
strict: True) ; - pour une action sensible, prévoir une approbation humaine (section 5.3 et chapitre 04).
5.2 Outils hébergés et outils de plateforme#
Sur le project endpoint, la Responses API expose des outils exécutés côté service, sans code à écrire : file search, code interpreter, web search, memory, serveurs MCP, SharePoint, Work IQ, Fabric IQ… Le Foundry SDK liste aussi des outils d'agent comme Azure AI Search, Azure Functions, OpenAPI et Agent-to-Agent (A2A), certains en preview. Leur usage dans les agents est au chapitre 06.
5.3 Pipelines à plusieurs étapes et workflows#
Quand une seule requête ne suffit pas, on enchaîne des étapes : classifier, récupérer, générer, contrôler, faire approuver.
| Approche | Principe | Quand |
|---|---|---|
| Enchaînement de prompts dans le code | La sortie (souvent structurée) d'un appel alimente le suivant | Pipeline court et linéaire |
| Modèle de raisonnement + outils | Le modèle planifie lui-même les appels d'outils successifs | Tâches ouvertes, peu prévisibles |
| Workflow Microsoft Agent Framework | Graphe d'executors (étapes ou agents) reliés par des edges : direct, conditionnel, switch-case, fan-out, fan-in ; points de pause human-in-the-loop | Processus métier déterministe, branches, parallélisme, approbations |
| Orchestrations d'agents (sequential, concurrent, group chat, handoff) | Plusieurs agents coordonnés | Multi-agents, voir chapitre 06 |
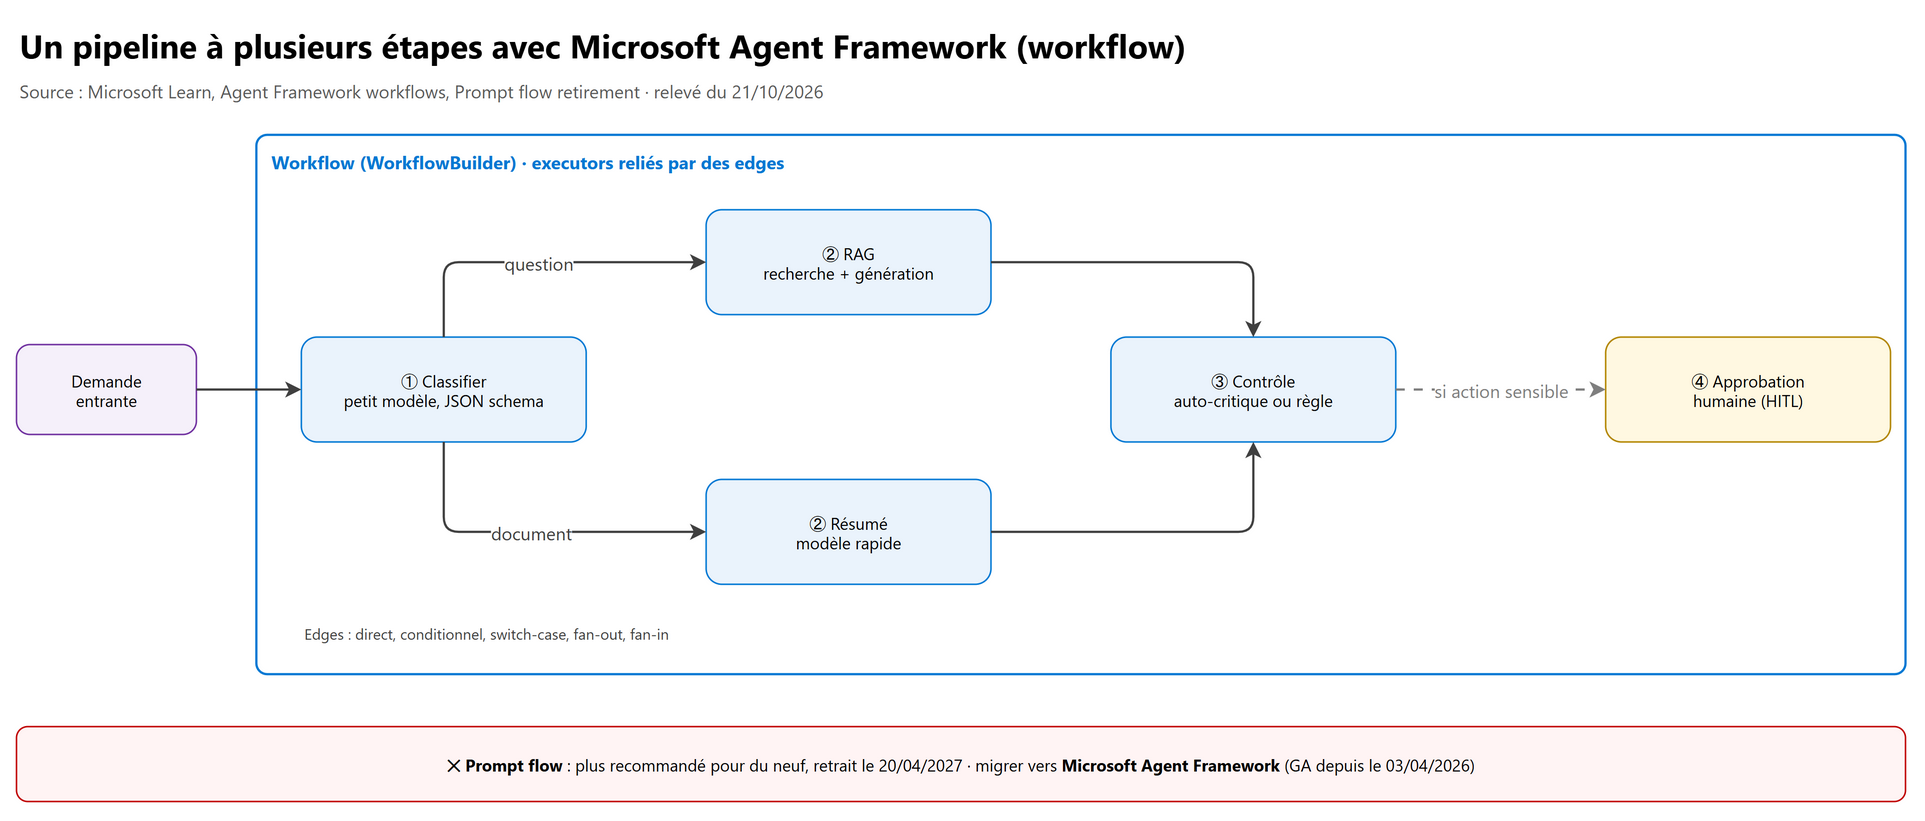
Dans un workflow, une approbation humaine se déclare par exemple sur un outil : @tool(approval_mode="always_require") met le
workflow en pause et émet une demande d'approbation avant l'exécution. Le Durable Task extension (Azure Functions) peut ajouter des
points de reprise à chaque étape.
Prompt flow est en fin de vie : plus recommandé pour de nouveaux développements, retrait le 20 avril 2027 (Foundry et Azure Machine Learning, extension VS Code, images de runtime qui ne reçoivent déjà plus de mises à jour). Migrer vers Microsoft Agent Framework (version 1.0 GA depuis le 3 avril 2026), guide de migration fourni par Microsoft.
6. Intégrer avec les Foundry SDKs et les connexions#
6.1 Les briques d'intégration#
| Besoin d'intégration | Moyen | Exemple |
|---|---|---|
| Appeler modèles, agents, evaluations depuis une appli | Foundry SDK (Python, C#, JavaScript/TypeScript, Java) | AIProjectClient(...).get_openai_client() |
| Réutiliser du code OpenAI existant | OpenAI SDK pointé sur /openai/v1 ou sur {project_endpoint}/openai/v1 |
OpenAI(base_url=..., api_key=token_provider) |
| Agents et workflows dans le code | Microsoft Agent Framework (FoundryChatClient en Python, AIProjectClient.AsAIAgent(...) en .NET) |
Agent « éphémère » défini dans le code, appels via la Responses API du projet |
| Retrouver une ressource connectée | Connections du projet | project.connections.get("ma-connexion-search") |
| Lister les modèles déployés | project.deployments |
Choix dynamique du deployment |
| Données de test, index | project.datasets, project.indexes |
Jeu d'évaluation téléversé (section 7) |
| Services spécialisés | Foundry Tools SDKs | Translator, Speech, Language, Vision (chapitres 08 et 09) |
| Outils d'agent vers vos systèmes | OpenAPI, Azure Functions, MCP, A2A | Voir chapitre 06 |
# Retrouver une connection du projet (sans connaître ni stocker l'adresse ou un secret dans l'application)
connexion = project.connections.get("my-search-connection")
print(connexion.id)
for d in project.deployments.list():        # modèles déployés dans le projet
    print(d.name)
Un agent ou un appel par le project endpoint hérite de la configuration du projet : traçage, content filters, politiques d'IA responsable, identité. L'« agent éphémère » (défini dans le code et appelé par la Responses API) a les mêmes capacités qu'un agent persistant : la différence porte sur l'endroit où vit sa définition, pas sur les fonctionnalités.
7. Évaluer les modèles et les applications#
7.1 Les evaluators intégrés#
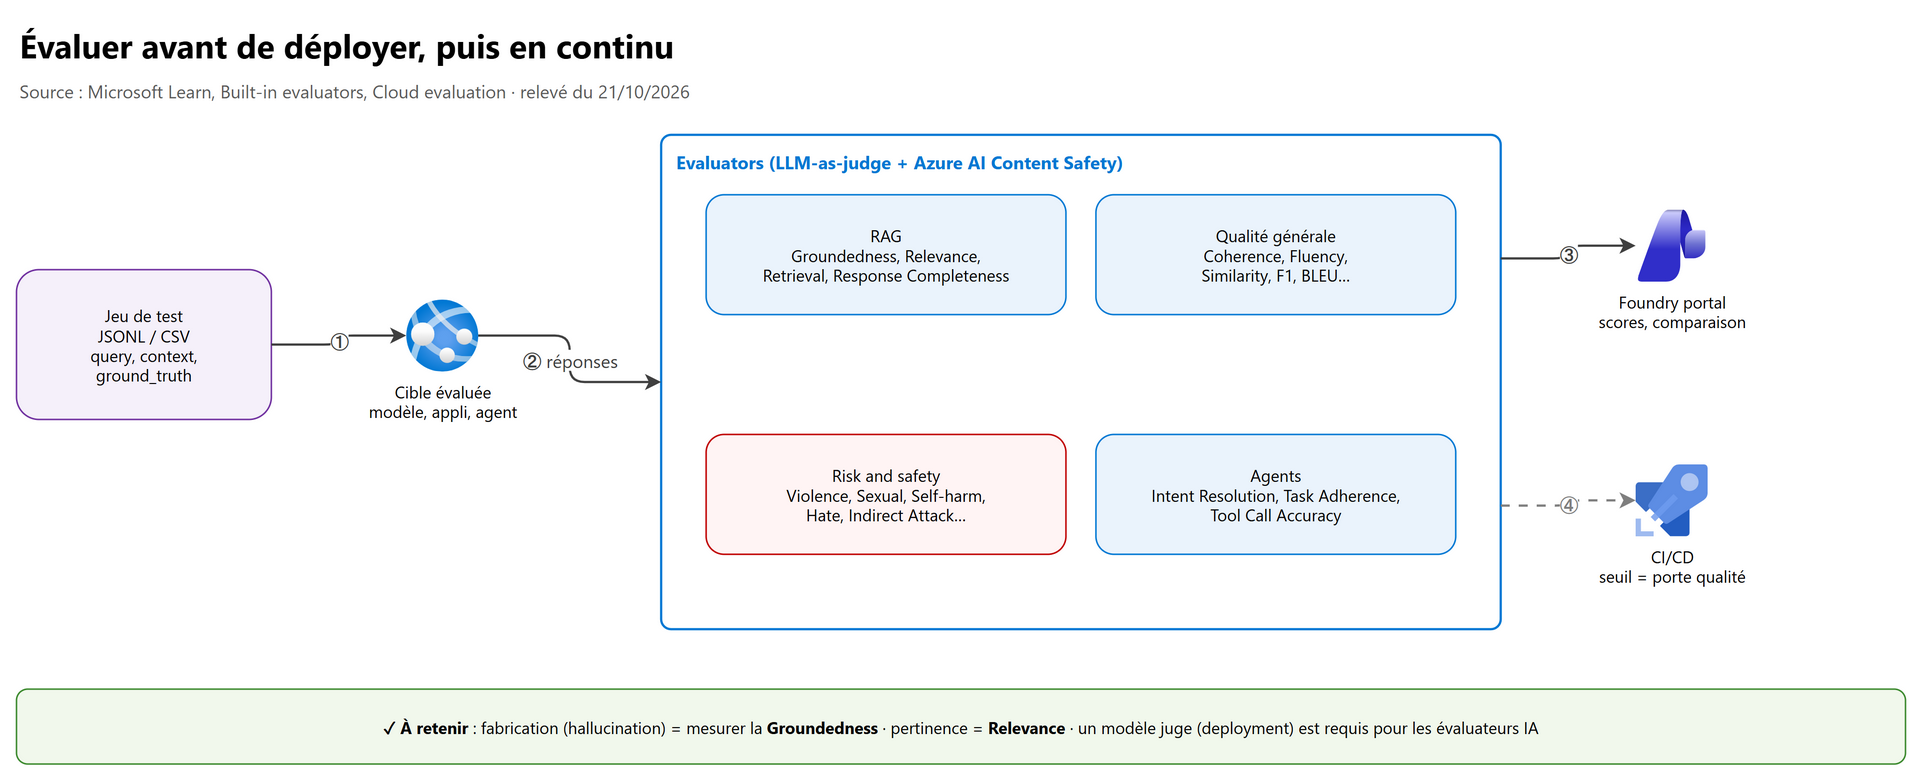
| Catégorie | Evaluators | Ce qu'ils mesurent |
|---|---|---|
| RAG | Groundedness (1 à 5, LLM judge), Groundedness Pro (preview, vrai/faux via Azure AI Content Safety, sans deployment), Relevance, Retrieval, Document Retrieval (avec vérité terrain : NDCG, XDCG, Fidelity…), Response Completeness (preview, avec vérité terrain) | Ancrage dans le contexte (fabrications), pertinence de la réponse, qualité de la récupération, complétude |
| Qualité générale | Coherence, Fluency, QA | Logique, qualité de langue |
| Similarité textuelle | Similarity, F1 Score, BLEU, GLEU, ROUGE, METEOR | Écart à une réponse de référence (traduction, résumé) |
| Risk and safety | Violence, Sexual, Self-Harm, Hate and Unfairness, Protected Material, Indirect Attack (XPIA), Code Vulnerability, Ungrounded Attributes, Prohibited Actions, Sensitive Data Leakage | Contenu dangereux, attaques indirectes réussies, fuites |
| Agents | Intent Resolution, Task Adherence, Tool Call Accuracy (et Task Completion, Tool Selection…) | Comportement des agents (détail au chapitre 06) |
| Graders Azure OpenAI | Label, String Check, Text Similarity, Grader personnalisé | Règles et notations personnalisées |
Combinaisons recommandées par Microsoft :
- application RAG : Retrieval + Groundedness + Relevance + Content Safety ;
- agent : Output Quality + Tool Use Quality + Rubric + Content Safety ;
- traduction : BLEU + METEOR + Fluency + Coherence ;
- toutes les applications : ajouter les evaluators risk and safety.
Fabrication = Groundedness. Une réponse peut être pertinente (Relevance élevée) tout en étant inventée (Groundedness faible) : on mesure les deux. Groundedness mesure la précision (rien d'inventé) ; Response Completeness mesure le rappel (rien d'oublié par rapport à la vérité terrain).
7.2 Ce qu'il faut fournir#
- Un jeu de test (JSONL ou CSV) :
query,response(ou une cible à appeler qui la produit),context(pour la groundedness),ground_truth(pour les metrics de référence) ; ou des conversations et des traces d'un agent déployé. - Un modèle juge (un deployment) pour les evaluators « IA » ; pas pour les metrics mathématiques (F1, BLEU) ni pour Groundedness Pro.
- Le résultat s'affiche dans le portail Foundry (scores par ligne, moyennes, comparaison entre runs et entre modèles).
7.3 Lancer une évaluation dans le cloud (Foundry SDK)#
from openai.types.eval_create_params import DataSourceConfigCustom
from azure.ai.projects.models import TestingCriterionAzureAIEvaluator

juge = os.environ["FOUNDRY_MODEL_NAME"]   # deployment utilisé comme LLM judge

# 1. Téléverser le jeu de test dans le projet
data_id = project.datasets.upload_file(name="eval-rh", version="1", file_path="./eval_rh.csv").id

# 2. Décrire les colonnes et choisir les evaluators intégrés
config = DataSourceConfigCustom(type="custom", include_sample_schema=True, item_schema={
    "type": "object",
    "properties": {"query": {"type": "string"}, "response": {"type": "string"},
                   "context": {"type": "string"}, "ground_truth": {"type": "string"}},
    "required": []})
criteres = [
    TestingCriterionAzureAIEvaluator(type="azure_ai_evaluator", name="coherence", evaluator_name="builtin.coherence",
                                     initialization_parameters={"model": juge},
                                     data_mapping={"query": "{{item.query}}", "response": "{{item.response}}"}),
    TestingCriterionAzureAIEvaluator(type="azure_ai_evaluator", name="violence", evaluator_name="builtin.violence",
                                     data_mapping={"query": "{{item.query}}", "response": "{{item.response}}"}),
]

# 3. Créer l'évaluation puis un run sur le CSV
evaluation = openai.evals.create(name="rag-rh", data_source_config=config, testing_criteria=criteres)
run = openai.evals.runs.create(eval_id=evaluation.id, name="run-1",
                               data_source={"type": "csv", "source": {"type": "file_id", "id": data_id}})
D'autres sources de données sont possibles : une cible (modèle ou agent appelé pendant l'évaluation), des traces d'Application Insights, des conversations simulées. Les versions récentes du SDK renvoient pour certaines opérations un poller (opération longue) au lieu d'un résultat direct.
Le SDK local azure-ai-evaluation (GroundednessEvaluator, evaluate(...)) existe aussi ; il est documenté côté Foundry
(classic) et en preview. Il reste utile pour des tests rapides sur le poste.
7.4 Évaluer en continu#
- Evaluation rules : évaluer automatiquement une partie des réponses d'un agent en production (événement « réponse terminée », plafond de runs par heure).
- Évaluations planifiées sur les traces (tous les jours, par exemple).
- Porte qualité en CI/CD : faire échouer le pipeline si un score passe sous un seuil (chapitres 02 et 07).
- Comparer des modèles : même jeu de test, même evaluators, deux deployments ; on choisit sur les scores, le coût et la latence.
8. Labs conseillés#
À faire dans un abonnement de test (coût : quelques euros de jetons ; Azure AI Search niveau Basic ou supérieur pour le semantic ranker ; supprimer le groupe de ressources à la fin).
Lab 1 · Connexion sans clé
- Créer un Foundry project et déployer
gpt-5-mini(ou un autre modèle disponible dans la région). - Vérifier son rôle Foundry User (Access control (IAM) de la ressource).
az login, définirFOUNDRY_PROJECT_ENDPOINTetFOUNDRY_MODEL_NAME, lancer le code de la section 2.2.- Résultat attendu : une réponse. Retirer temporairement le rôle : on obtient
401, preuve que la clé n'intervient pas.
Lab 2 · Responses API complète
- Envoyer une requête avec
instructions, puis une seconde avecprevious_response_id: le modèle se souvient du contexte. - Extraire un objet avec
responses.parseet un modèle Pydantic. - Activer le streaming et afficher
response.output_text.delta. - Résultat attendu : JSON validé ; affichage progressif ;
usage.output_tokensvisible.
Lab 3 · RAG classique
- Créer un index avec quelques documents (assistant Import data du portail Azure AI Search, avec vectorisation).
- Ajouter une semantic configuration.
- Donner Search Index Data Reader à votre identité ; exécuter le code de la section 4.4.
- Résultat attendu : réponse avec citations [n] ; une question hors corpus renvoie « je ne sais pas ».
Lab 4 · Function calling
- Déclarer
get_weathercomme dans la section 5.1 et exécuter la boucle. - Inspecter
response.output: un élémentfunction_callaveccall_id. - Résultat attendu : réponse finale qui reprend la température renvoyée par votre fonction.
Lab 5 · Évaluation
- Préparer un CSV de 10 lignes (
query,response,context,ground_truth), dont 2 réponses volontairement inventées. - Lancer une évaluation avec Groundedness, Relevance et Violence (portail Foundry ou code de la section 7.3).
- Résultat attendu : les 2 réponses inventées ont une groundedness basse, même si leur relevance reste correcte.
9. Les pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
Que mettre dans model= ? |
Le nom du deployment | Il peut différer du nom du modèle |
| Appeler les modèles sans stocker de clé | Microsoft Entra ID : DefaultAzureCredential + managed identity + rôle Foundry User |
Le Foundry SDK n'accepte que Entra ID |
| Quel scope pour le jeton ? | https://ai.azure.com/.default |
Scope des exemples v1 actuels |
L'appli a le rôle Contributor mais reçoit 401 |
Ajouter le rôle data Foundry User | L'administration ne donne pas l'accès aux données |
| Générer des embeddings par le project endpoint | Impossible : utiliser /openai/v1 de la ressource |
Le projet ne route pas les embeddings |
| Migrer du code Chat Completions | messages → input, max_tokens → max_output_tokens, response_format → text.format, choices[0].message.content → output_text, role: "tool" → function_call_output |
Table de migration officielle |
Modèle de raisonnement : erreur sur temperature |
Retirer le paramètre | Non supporté par ces modèles |
| Réponse vide d'un modèle de raisonnement | Augmenter max_output_tokens |
Les jetons de raisonnement consomment le budget |
| JSON garanti conforme | Structured outputs (text.format json_schema, strict) |
Le simple « réponds en JSON » ne garantit pas le schéma |
| Le modèle exécute-t-il la fonction ? | Non : il renvoie function_call, votre code exécute |
Function calling |
| Mots-clés exacts + sens | Hybrid search (BM25 + vecteur, fusion RRF) | Meilleur rappel |
| Améliorer l'ordre des résultats | Semantic ranker (semantic configuration, coût premium) | Reclasse les 50 premiers |
| Nouvelle application RAG pour un agent | Agentic retrieval / Foundry IQ | Recommandé pour les nouvelles implémentations |
| Exigence « GA uniquement » | RAG classique (hybride + semantic ranker) | Une partie de l'agentic retrieval est en preview |
| Application sur Azure OpenAI On Your Data | Migrer vers Foundry IQ (retrait le 14/10/2026) | Fonctionnalité retirée |
| Nouveau pipeline sous prompt flow | Microsoft Agent Framework (prompt flow retiré le 20/04/2027) | Prompt flow n'est plus recommandé |
| Détecter les hallucinations | Groundedness (ou Groundedness Pro) | Mesure l'ancrage dans le contexte |
| Réponse pertinente mais inventée | Relevance haute, Groundedness basse | Deux metrics différentes |
| Evaluator sans deployment de modèle juge | Groundedness Pro (Content Safety), metrics F1/BLEU | Les autres evaluators IA exigent un juge |
| Mesurer si la récupération ramène les bons documents avec des labels | Document Retrieval | Utilise la vérité terrain |
10. Scénarios d'entraînement#
1. Une application App Service doit appeler un modèle du Foundry project. La sécurité interdit toute clé. Que configurer ?
Une user-assigned managed identity sur l'App Service,
AZURE_CLIENT_IDetFOUNDRY_PROJECT_ENDPOINTen app settings, le rôle Foundry User sur la ressource (ou le projet), etDefaultAzureCredentialdans le code. Aucun secret à stocker ni à faire tourner.
2. Un développeur reçoit 404 Not Found avec model="gpt-4.1" alors que le modèle est bien déployé.
Le deployment porte un autre nom (par exemple
chat-prod) :model=attend le nom du deployment. Vérifier aussi le format/api/projects/{project}de l'URL.
3. Une équipe migre de Chat Completions vers la Responses API ; les outils renvoient missing_required_parameter: tools[0].name.
Les définitions d'outils sont encore imbriquées (
"function": {...}) : en Responses, la forme est plate ({"type": "function", "name": ..., "parameters": ...}). Les résultats d'outil passent enfunction_call_output.
4. Un chatbot RH doit répondre uniquement à partir des politiques internes et citer ses sources ; les documents emploient « congés » quand les salariés écrivent « PTO ».
RAG sur Azure AI Search : recherche hybride (le vecteur capte le sens, BM25 les termes exacts) + semantic ranker, prompt « uniquement à partir des sources, cite [n], sinon je ne sais pas ». Pour une nouvelle solution orientée agent, préférer l'agentic retrieval (Foundry IQ).
5. Une solution existante utilise Azure OpenAI On Your Data avec un index Azure AI Search.
La fonctionnalité est retirée depuis le 14/10/2026. Migrer vers Foundry IQ (knowledge base qui peut réutiliser l'index existant) ou vers un RAG classique piloté par l'application ; la migration demande des changements de code.
6. Une application doit extraire de chaque courriel un objet JSON (client, produit, urgence) consommé par un ERP.
Structured outputs :
responses.parseavec un modèle Pydantic, outext.formatenjson_schemaavecstrict: True. Un petit modèle (SLM, variante « mini ») suffit souvent pour ce type de tâche.
7. Un assistant doit consulter le stock en temps réel dans une API interne avant de répondre.
Function calling : déclarer l'outil, exécuter l'appel dans l'application quand le modèle renvoie
function_call, renvoyerfunction_call_outputavec le mêmecall_idetprevious_response_id. Valider les arguments et limiter les droits de l'API.
8. Un processus doit classer une demande, puis soit faire un RAG, soit résumer un document, puis attendre la validation d'un manager avant d'envoyer la réponse. L'équipe pense à prompt flow.
Workflow Microsoft Agent Framework : executors reliés par des edges conditionnels, point de pause human-in-the-loop avant l'envoi. Prompt flow est en fin de vie (retrait le 20/04/2027).
9. Avant la mise en production, on veut prouver que les réponses du RAG n'inventent rien et ne contiennent pas de contenu violent.
Évaluation dans Foundry avec Groundedness (fabrications), Relevance, Retrieval et l'evaluator Violence (risk and safety), sur un jeu de test avec
query,context,response; un deployment sert de juge. Puis evaluation rules en continu et un seuil en CI/CD.
10. L'application doit vectoriser des documents ; le développeur appelle embeddings.create sur le client obtenu par
project.get_openai_client() et échoue.
Le project endpoint ne route pas les embeddings : créer un client
OpenAIsurhttps://{resource}.openai.azure.com/openai/v1/(même jeton Entra) pour les embeddings.
11. Pour aller plus loin#
- Model router : un deployment qui choisit lui-même le modèle sous-jacent selon la requête (coût et qualité) ; voir le chapitre 07.
- Compaction de contexte (Responses) : réduire l'historique d'une longue conversation, à la demande (
/responses/compact) ou automatiquement côté serveur (context_managementavec un seuil). - Background mode et WebSocket mode de la Responses API pour les tâches longues et les échanges à faible latence.
- Tool search et namespaces : charger dynamiquement des outils parmi un grand catalogue (
defer_loading). - Migration assistée : le dépôt Azure-Samples azure-openai-to-responses fournit un scanner et une compétence d'agent pour migrer une application Python de Chat Completions vers Responses.
- Fine-tuning (SFT, DPO, RFT) quand le prompt et le RAG ne suffisent pas : voir le chapitre 02.
12. Fiche à retenir#
- Point d'entrée : Foundry project endpoint
https://{resource}.services.ai.azure.com/api/projects/{project}. -
AIProjectClientpour le projet (connections, deployments, datasets) ;get_openai_client()pour Responses, agents, evaluations. - Auth : Microsoft Entra ID seulement avec le Foundry SDK ;
DefaultAzureCredential; scopehttps://ai.azure.com/.default. - Rôles : Foundry User (dev, appels), Foundry Agent Consumer (appeler des agents), Foundry Project Manager (projects, publication ; pas de modèles), Foundry Account Owner (ressource, model deployments) ; anciens noms « Azure AI … ».
-
model== nom du deployment ; plus d'api-versionavec/openai/v1. - Embeddings : par
/openai/v1de la ressource, pas par le projet. - Responses :
instructions,input,output_text,max_output_tokens,text.format,previous_response_id(stockage 30 jours). - Raisonnement :
reasoning effort, pas detemperature/top_p,max_output_tokensassez grand,developer=system. - Function calling :
function_call→ votre code →function_call_output+ mêmecall_id. - RAG : récupérer → augmenter → générer ; hybrid (RRF) + semantic ranker (50 premiers, premium) ; query rewrite en preview.
- Nouvelles solutions : agentic retrieval / Foundry IQ ; GA uniquement : RAG classique.
- On Your Data retiré (14/10/2026) ; prompt flow retiré le 20/04/2027 → Microsoft Agent Framework (GA 03/04/2026).
- Workflows : executors + edges (direct, conditionnel, switch-case, fan-out, fan-in) + human-in-the-loop.
- Évaluer un RAG : Retrieval + Groundedness + Relevance + Content Safety ; fabrication = Groundedness.
- Groundedness Pro et F1/BLEU : sans modèle juge ; les autres evaluators IA : un deployment juge.
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Study guide for Exam AI-103 (en anglais)
- Guide d'étude de l'examen AI-103
- Kits de développement logiciel (SDK) et points de terminaison de Microsoft Foundry
- Azure AI Projects client library for Python
- Role-based access control for Microsoft Foundry
- Authentication and authorization in Microsoft Foundry
- Configure keyless authentication with Microsoft Entra ID
- Use the Azure OpenAI Responses API
- Upgrade your Azure OpenAI app from Chat Completions to the Responses API
- How to generate text responses with Microsoft Foundry Models
- Structured outputs
- Azure OpenAI reasoning models
- Quickstart: Build agents using the Responses API
- Génération augmentée par récupération (RAG) dans Recherche Azure AI
- Hybrid search
- Semantic ranking in Azure AI Search
- Rewrite queries with semantic ranker (preview)
- Azure OpenAI On Your Data (classic) : avis de retrait
- What is Foundry IQ
- Microsoft Agent Framework workflows : edges
- Microsoft Agent Framework workflows : human-in-the-loop
- What is Azure Machine Learning prompt flow (avis de retrait)
- Migrate from Prompt Flow to Microsoft Agent Framework
- Built-in evaluators reference
- Retrieval-Augmented Generation (RAG) evaluators
- Run evaluations on datasets (cloud evaluation)
- Monitor agents : continuous evaluation
- Evaluate locally with the Azure AI Evaluation SDK (classic)