

Version : 1.1 · Date : 2026-10-21 · Domaine 2 de l'examen : Implement machine learning model lifecycle and operations (25 à 30 %)
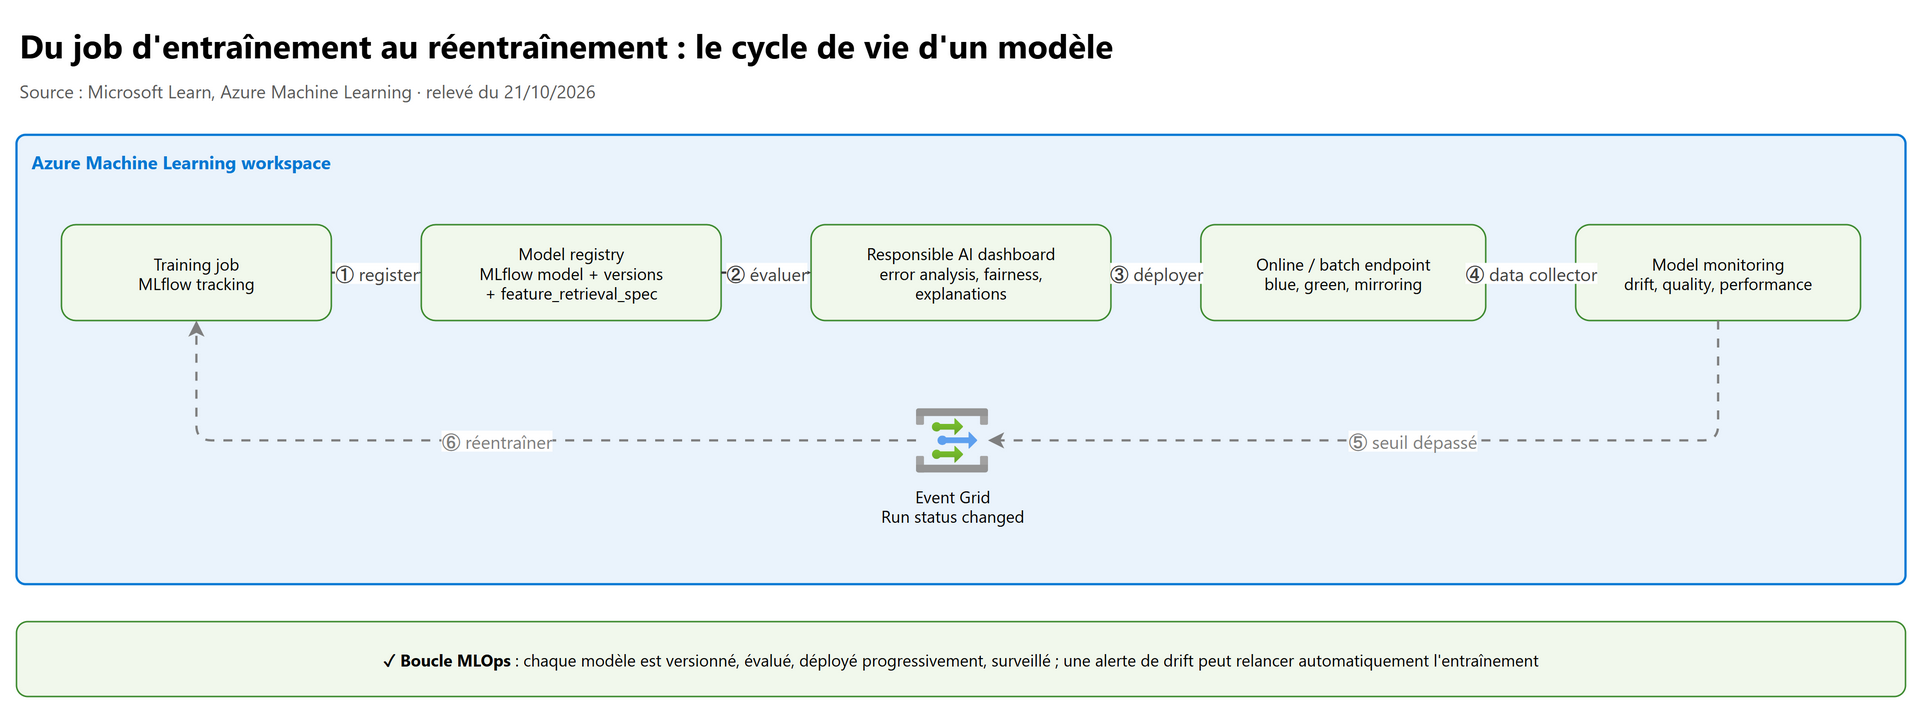
En une phrase : un modèle entraîné devient un model asset versionné dans le registry, il est évalué avec le Responsible AI dashboard, déployé derrière un online ou batch endpoint par étapes (blue/green, mirroring), puis surveillé (drift, qualité, performance) jusqu'à déclencher une alerte ou un réentraînement.
Ce que l'examen demande#
Texte officiel du guide d'étude AI-300 (blocs 2.2 à 2.4 ; le bloc 2.1, l'entraînement, est traité au chapitre 03) :
| # | Compétence mesurée (guide officiel, en anglais) | Section |
|---|---|---|
| 1 | Package a feature retrieval specification with the model artifact | 2.4 |
| 2 | Register an MLflow model | 2 |
| 3 | Evaluate a model by using responsible AI principles | 3 |
| 4 | Manage model lifecycle, including archiving models | 4 |
| 5 | Deploy models as real-time or batch endpoints with managed inference options | 5 |
| 6 | Test and troubleshoot model endpoints | 6 |
| 7 | Implement progressive rollout and safe rollback strategies | 7 |
| 8 | Detect and analyze data drift | 8 |
| 9 | Monitor performance metrics of models deployed to production | 8.4 |
| 10 | Configure retraining or alert triggers when thresholds are exceeded | 9 |
1. Les bases à maîtriser#
1.1 Le vocabulaire#
| Terme | Ce que c'est |
|---|---|
| Model (model asset) | Un artefact enregistré dans le workspace (ou un registry partagé), identifié par nom:version, type mlflow_model, custom_model ou triton_model |
| MLflow model | Un dossier au format MLflow : fichier MLmodel (flavors, signature), dépendances (conda.yaml), poids |
| Endpoint | Une URL stable et un mode d'authentification ; n'exécute rien lui-même |
| Deployment | Ce qui tourne derrière l'endpoint : modèle, environment, code, compute. Un endpoint peut en porter plusieurs (blue, green) |
| Control plane / data plane | Créer, lire, modifier un endpoint (control plane, jeton management.azure.com) ; envoyer une requête de scoring (data plane, jeton ml.azure.com) |
| Data collector | Collecte des entrées et sorties de production d'un online deployment, vers le Blob Storage du workspace |
| Model monitoring | Job planifié (serverless Spark) qui compare la production à une référence et alerte au-delà d'un seuil |
1.2 Les outils qui font quoi#
| Opération | MLflow SDK | CLI az ml / SDK azure-ai-ml v2 |
Studio |
|---|---|---|---|
| Logger métriques, paramètres, modèles | ✅ | ||
| Gérer des MLflow models | ✅ (quelques opérations non supportées) | ✅ | ✅ |
| Gérer des modèles non-MLflow | ✅ | ✅ | |
| Déployer un MLflow model (online, batch) | Online seulement | ✅ | ✅ |
Source : MLflow and Azure Machine Learning. Retenir : MLflow pour suivre et enregistrer, az ml / azure-ai-ml pour gérer
et déployer.
2. Enregistrer un MLflow model#
2.1 Trois façons d'arriver au même model asset#
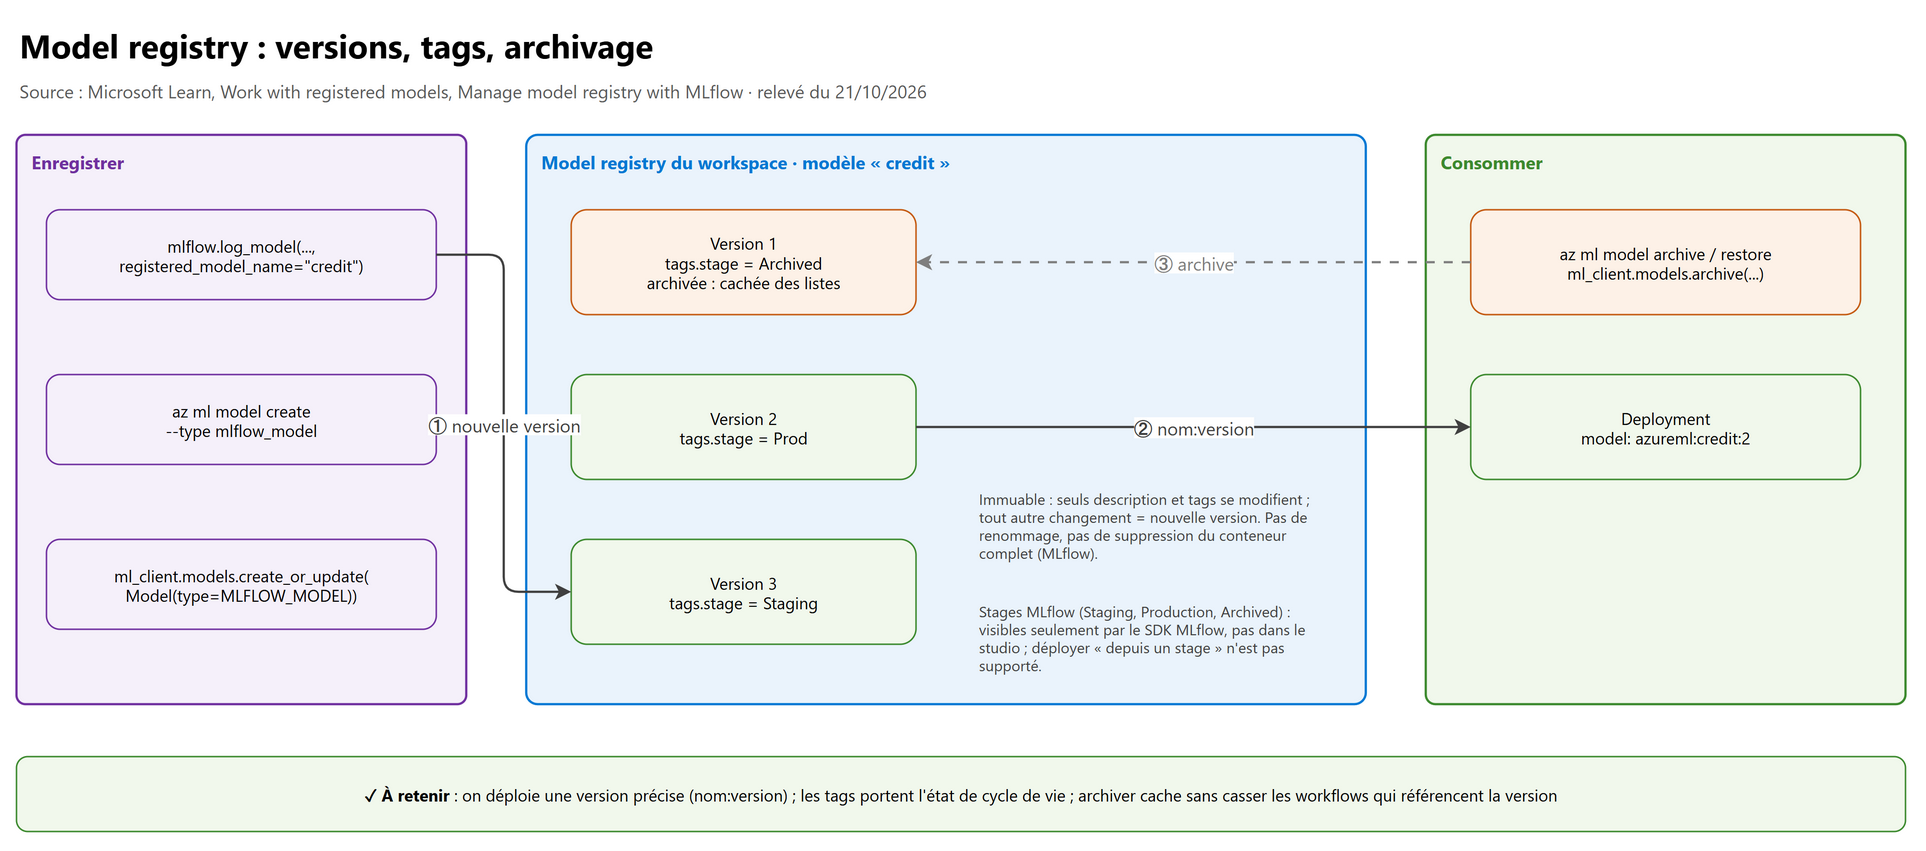
① Depuis le code d'entraînement, avec MLflow : si le nom n'existe pas, la version 1 est créée ; sinon une nouvelle version.
import mlflow

mlflow.set_experiment("credit-default")
with mlflow.start_run():
    # ... entraînement de "model" (scikit-learn)
    mlflow.sklearn.log_model(model, artifact_path="model", registered_model_name="credit")
② Depuis la sortie d'un job, avec la CLI : on pointe vers le dossier MLflow produit par le job.
az ml model create --name credit --type mlflow_model \
  --path azureml://jobs/$JOB_NAME/outputs/artifacts/paths/model/
③ Avec le SDK azure-ai-ml v2 :
from azure.ai.ml import MLClient
from azure.ai.ml.entities import Model
from azure.ai.ml.constants import AssetTypes
from azure.identity import DefaultAzureCredential

ml_client = MLClient(DefaultAzureCredential(), "<subscription-id>", "<resource-group>", "<workspace>")
model = Model(
    path=f"azureml://jobs/{job_name}/outputs/artifacts/paths/model/",
    type=AssetTypes.MLFLOW_MODEL,          # CUSTOM_MODEL pour un modèle non-MLflow
    name="credit",
    description="Classification du risque de défaut",
    tags={"stage": "Staging"},
)
ml_client.models.create_or_update(model)
À retenir : enregistrer le modèle et l'environment avant de déployer en production : le déploiement référence alors
azureml:credit:2etazureml:my-env:1, ce qui le rend reproductible et traçable.
2.2 MLflow model ou custom model#
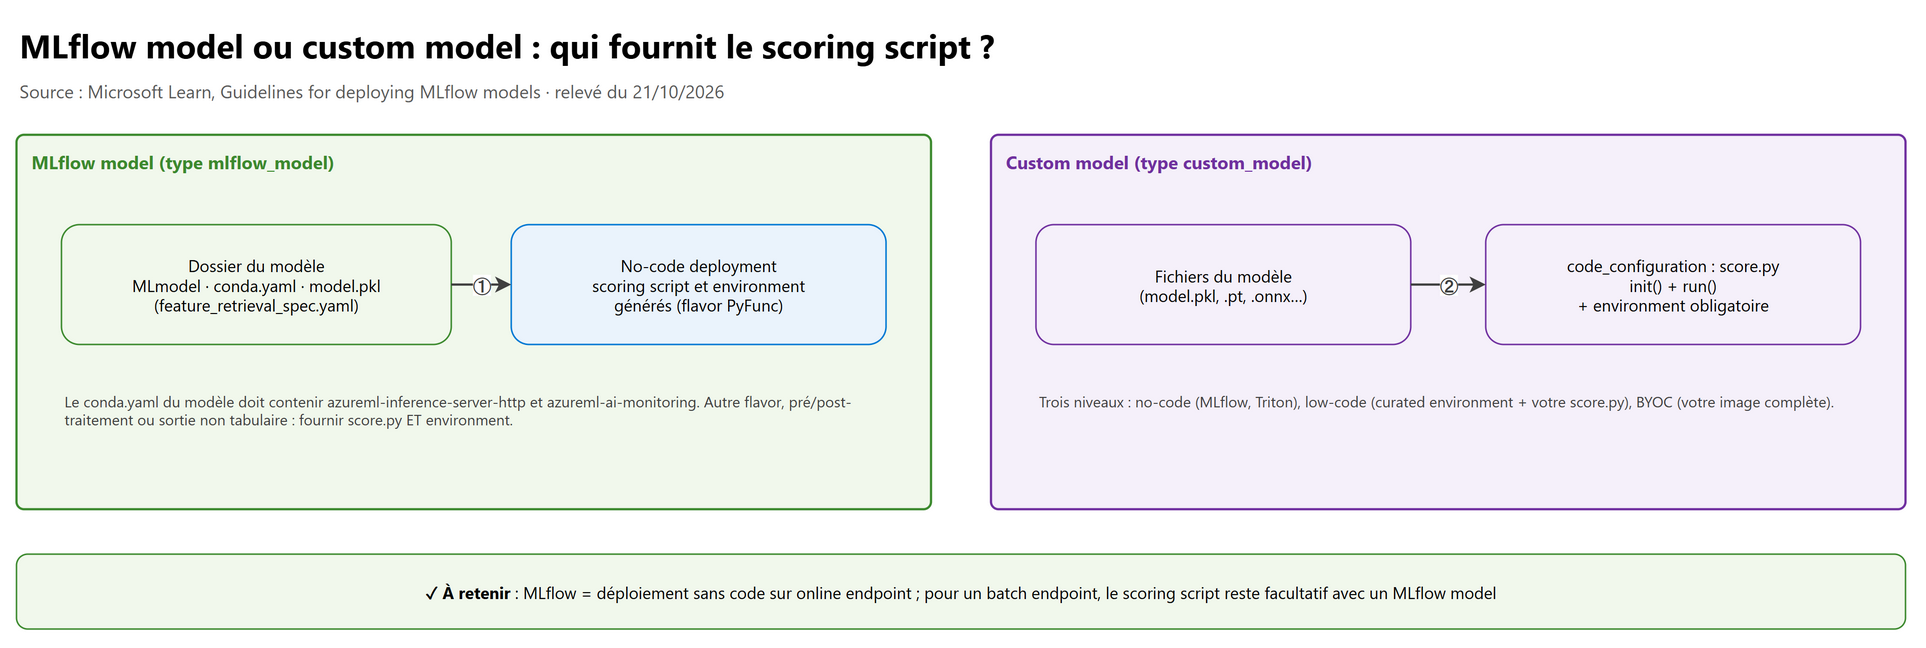
MLflow model (mlflow_model) |
Custom model (custom_model) |
|
|---|---|---|
| Scoring script | Généré (no-code deployment), pour le flavor PyFunc |
Obligatoire : score.py avec init() et run() |
| Environment | Généré à partir des dépendances du modèle | Obligatoire (curated ou custom) |
| Quand personnaliser | Autre flavor, pré ou post-traitement, sortie non tabulaire (tenseur, image) : fournir score.py et environment |
Toujours |
| Batch endpoint | Scoring script facultatif | Scoring script obligatoire |
| Responsible AI dashboard | Supporté si flavor sklearn |
Non supporté |
Trois niveaux de déploiement : no-code (MLflow et Triton), low-code (curated environment + votre score.py), BYOC
(votre image complète). Piège : si le conda.yaml du MLflow model liste ses dépendances, il doit contenir
azureml-inference-server-http et azureml-ai-monitoring.
2.3 La signature#
La signature MLflow (schéma des entrées et sorties, enregistré dans MLmodel) permet au serveur d'inférence de valider la
requête. Elle se déduit à l'entraînement (infer_signature) ou se fournit au log_model. Sans signature, le format d'entrée
n'est pas contrôlé.
2.4 Packager la feature retrieval specification#
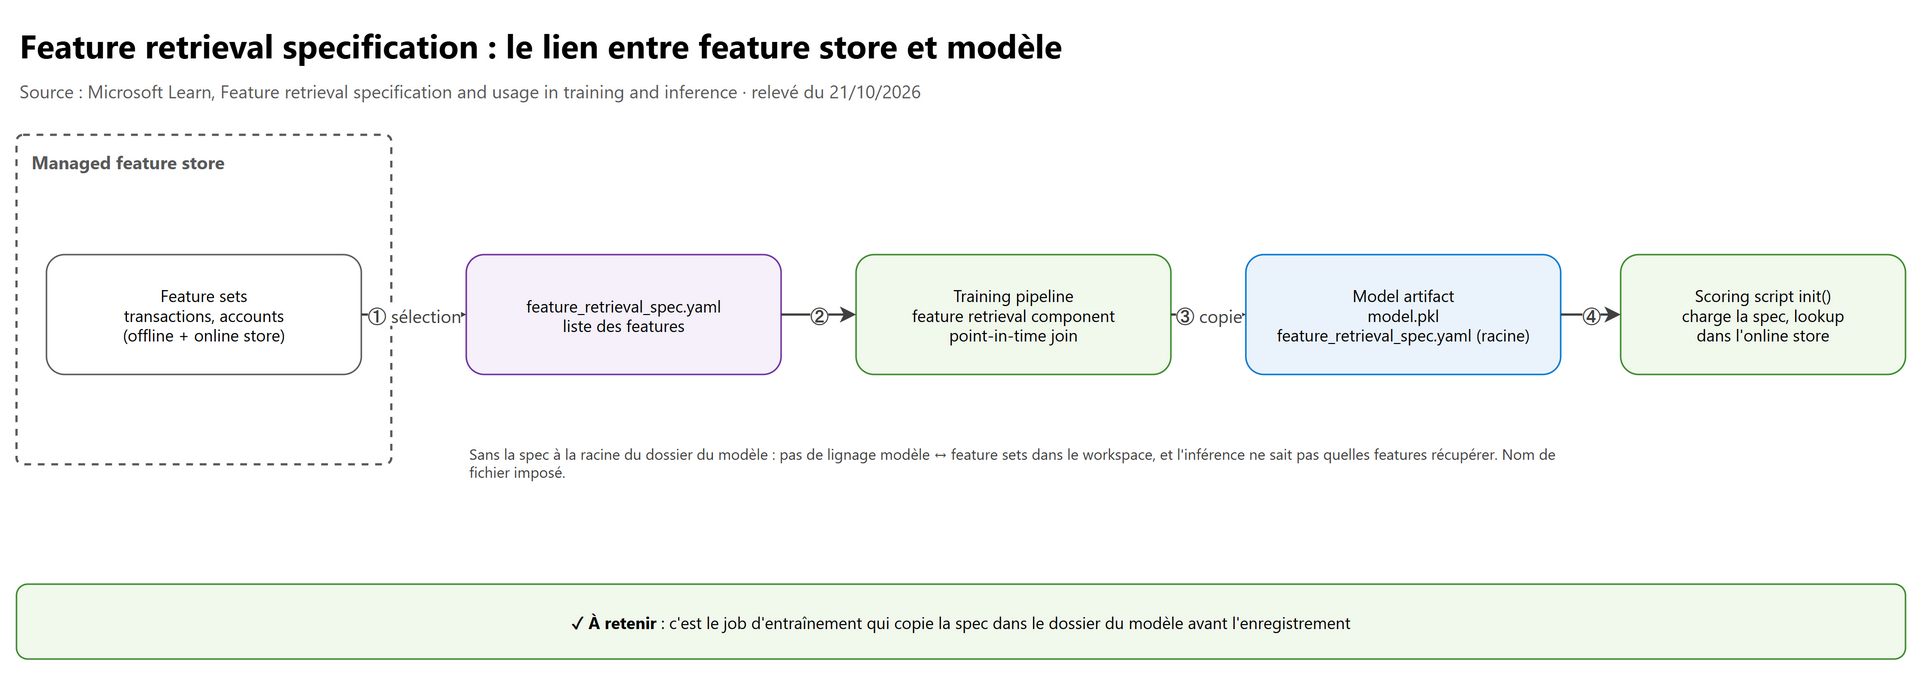
Quand le modèle est entraîné sur des features d'un managed feature store, la feature retrieval specification (liste des
features utilisées, sur un ou plusieurs feature sets) doit être copiée à la racine du dossier du modèle, sous le nom imposé
feature_retrieval_spec.yaml :
<model folder>/
├── model.pkl
├── other_folder/
└── feature_retrieval_spec.yaml
Pourquoi : (1) lignage : le workspace relie le modèle aux feature sets seulement si la spec est dans l'artefact (onglet
Feature sets du modèle, onglet Models du feature set) ; (2) inférence : init() du scoring script charge la spec pour
savoir quelles features récupérer dans l'online store. C'est le job d'entraînement qui fait la copie :
import os, shutil
# training_data a été produit par le feature retrieval component, qui y a placé la spec
shutil.copy(os.path.join(args.training_data, "feature_retrieval_spec.yaml"), args.model_output)
Le feature retrieval component intégré (registry azureml) fait le point-in-time join et place la spec avec les données ;
en batch, le modèle lui-même peut servir d'entrée à ce composant si la spec est packagée. Erreur classique : un job de
feature retrieval échoue quand on lui donne un modèle sans la spec à la racine.
3. Évaluer le modèle avec le Responsible AI dashboard#
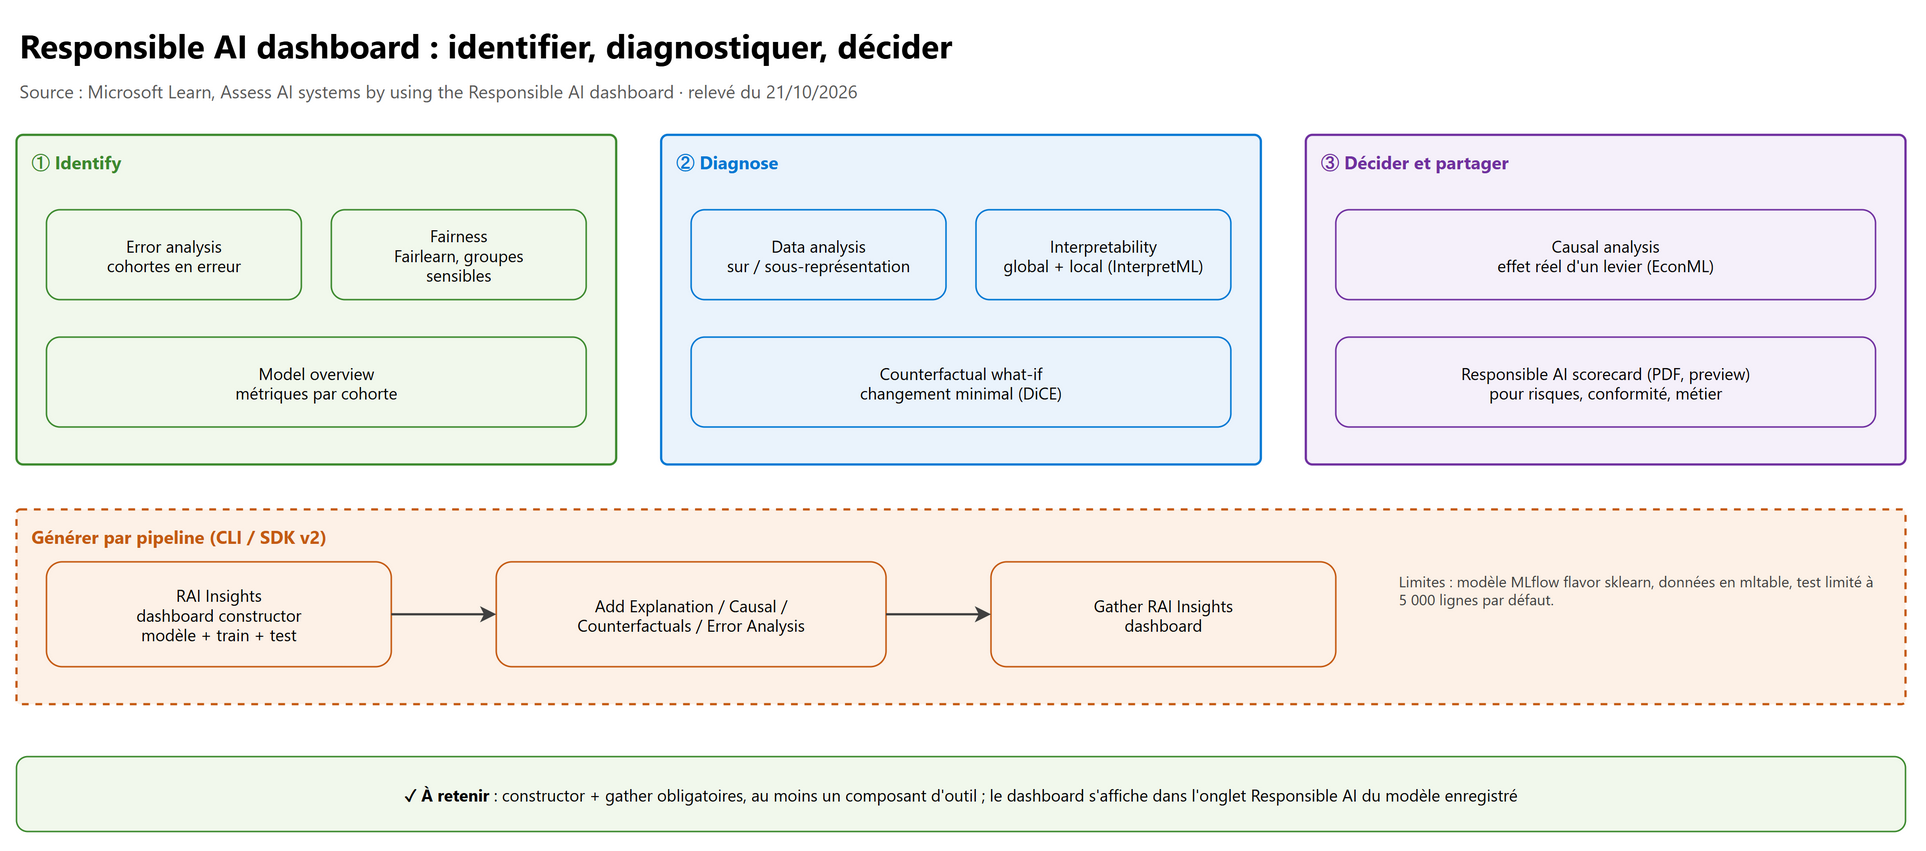
Les six principes Microsoft (fairness, reliability and safety, privacy and security, inclusiveness, transparency, accountability) sont rappelés dans le cours AI-103, chapitre 04. Pour un modèle ML classique, l'outil de l'examen est le Responsible AI dashboard d'Azure Machine Learning.
| Étape | Composant | Question | Bibliothèque |
|---|---|---|---|
| Identify | Error analysis | Où le modèle se trompe-t-il (cohortes) ? | Error Analysis |
| Identify | Fairness (model overview) | Les groupes sensibles sont-ils traités différemment ? | Fairlearn |
| Diagnose | Data analysis | Sur ou sous-représentation dans les données ? | — |
| Diagnose | Model interpretability | Quelles features pèsent, globalement et pour une prédiction ? | InterpretML |
| Diagnose | Counterfactual what-if | Plus petit changement qui inverse la prédiction ? | DiCE |
| Décider | Causal analysis | Effet réel d'un levier sur un résultat ? | EconML |
Le Responsible AI scorecard (preview) exporte les conclusions en PDF pour les métiers, les risques et la conformité.
Générer le dashboard : studio (sans code, onglet Responsible AI du modèle enregistré) ou pipeline CLI / SDK v2 :
RAI Insights dashboard constructor(obligatoire) : modèle + jeu d'entraînement + jeu de test ;- au moins un composant d'outil :
Add Explanation,Add Causal,Add Counterfactuals,Add Error Analysis; Gather RAI Insights dashboard(obligatoire) ; optionnellement le composantrai_score_card.
# Charger les composants depuis le registry azureml (extrait)
rai_erroranalysis = ml_client_registry.components.get(name="microsoft_azureml_rai_tabular_erroranalysis", label="latest")
erroranalysis_job = rai_erroranalysis(
    rai_insights_dashboard=create_rai_job.outputs.rai_insights_dashboard,
    filter_features='["style", "Employer"]',   # listes passées en chaîne JSON
)
Limites à connaître : modèle enregistré au format MLflow, flavor sklearn, chargeable et picklable, fourni par le composant
Fetch Registered Model ; données en mltable ; jeu de test limité à 5 000 lignes par défaut ; un modèle est requis même
pour une analyse causale seule (DummyClassifier). Pour un AutoML, le dashboard n'est créé que si l'option Explain best model
est cochée au lancement.
4. Gérer le cycle de vie d'un modèle#
| Action | CLI | SDK azure-ai-ml |
Remarque |
|---|---|---|---|
| Lister les versions | az ml model list --name credit |
ml_client.models.list(name="credit") |
|
| Voir une version | az ml model show -n credit -v 2 |
ml_client.models.get("credit", "2") |
|
| Mettre à jour | az ml model update -n credit -v 2 --set tags.stage="Prod" |
create_or_update après modification |
Seuls description et tags sont modifiables ; tout le reste = nouvelle version |
| Archiver | az ml model archive -n credit -v 1 |
ml_client.models.archive("credit", "1") |
Caché des listes, toujours utilisable ; sans version = tout le conteneur |
| Restaurer | az ml model restore -n credit -v 1 |
ml_client.models.restore(...) |
Conteneur archivé : restaurer le conteneur, pas une version |
| Partager | --registry-name |
registry MLClient |
Registries partagés entre workspaces : chapitre 01 |
Stages MLflow (Staging, Production, Archived, sensibles à la casse) : on les manipule uniquement avec le SDK MLflow
(client.transition_model_version_stage(...)) ; ils ne sont pas visibles dans le studio ni par la CLI ou le SDK Azure ML, et
on ne peut pas déployer « depuis un stage ». Dans Azure ML, l'état de cycle de vie se porte donc par des tags (ex.
stage=Prod) et l'on déploie une version précise. Autres limites MLflow : pas de renommage, pas de suppression du conteneur
complet, pas d'opération inter-workspaces.
Événement utile : l'enregistrement d'une version publie
Microsoft.MachineLearningServices.ModelRegistereddans Event Grid, ce qui peut déclencher un pipeline de validation ou de déploiement (voir section 9).
5. Déployer sur un online ou un batch endpoint#
5.1 Choisir le type d'endpoint#
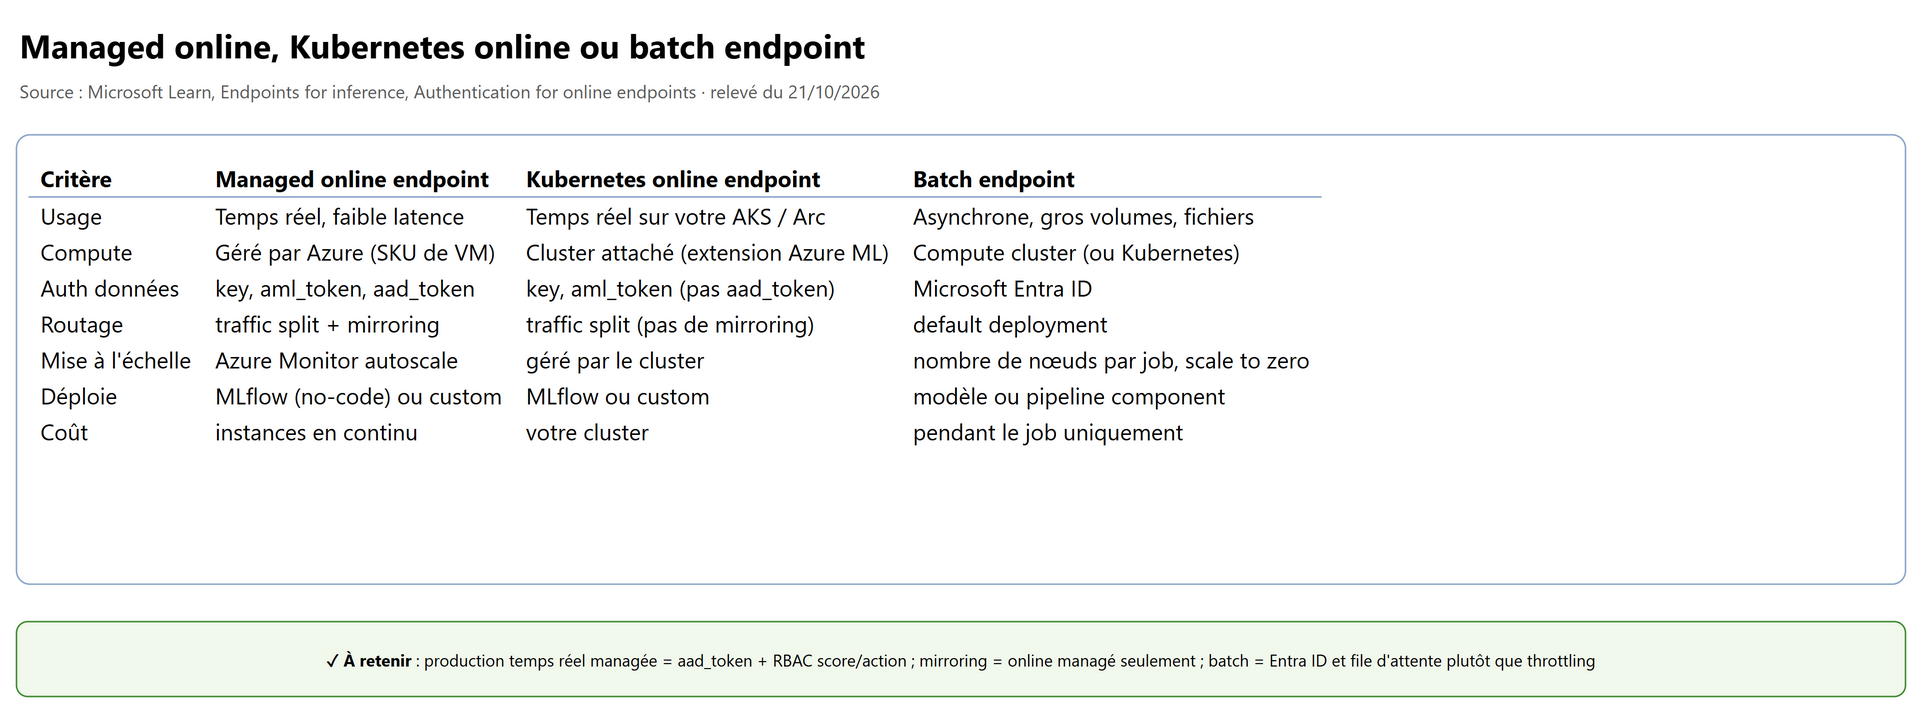
| Managed online endpoint | Kubernetes online endpoint | Batch endpoint | |
|---|---|---|---|
| Usage | Temps réel, faible latence | Temps réel sur votre cluster (AKS, Arc) | Gros volumes, fichiers, asynchrone |
| Compute | Géré (SKU de VM) | Cluster attaché via l'extension Azure ML | Compute cluster ou Kubernetes, low-priority possible |
| Auth du data plane | key, aml_token, aad_token |
key, aml_token (pas aad_token) |
Microsoft Entra ID |
| Plusieurs deployments | Oui, traffic split + mirroring | Oui, traffic split (pas de mirroring) | Oui, default deployment |
| Mise à l'échelle | Azure Monitor autoscale (métriques, planning) | Côté cluster | Par nombre de jobs, scale to zero |
| Surcharge | Throttling | Throttling | File d'attente |
| Coût | Instances provisionnées en continu | Votre cluster | Uniquement pendant les jobs |
| Test local (Docker) | Oui | Oui | Non |
Pour les foundation models (modèles du catalogue), les standard deployments (serverless, facturés au jeton) sont un autre choix : voir chapitre 05.
5.2 Un managed online endpoint pas à pas#
# endpoint.yml : l'URL stable et l'authentification
$schema: https://azuremlschemas.azureedge.net/latest/managedOnlineEndpoint.schema.json
name: credit-endpoint
auth_mode: aad_token          # key (dev), aml_token (pipelines), aad_token (production, managed seulement)
# blue-deployment.yml : un custom model avec son code et son environment enregistrés
$schema: https://azuremlschemas.azureedge.net/latest/managedOnlineDeployment.schema.json
name: blue
endpoint_name: credit-endpoint
model: azureml:credit:2
code_configuration:
  code: ./onlinescoring/
  scoring_script: score.py
environment: azureml:my-env:1
instance_type: Standard_DS3_v2
instance_count: 1
data_collector:               # collecte de production pour le model monitoring (section 8)
  collections:
    model_inputs:
      enabled: 'True'
    model_outputs:
      enabled: 'True'
az ml online-endpoint create -f endpoint.yml
az ml online-deployment create -f blue-deployment.yml --all-traffic
az ml online-endpoint invoke --name credit-endpoint --request-file sample-request.json
Pour un MLflow model, le deployment ne contient ni code_configuration ni environment (no-code deployment).
Authentification du data plane :
| Mode | Sécurité | Rôle pour scorer | Remarque |
|---|---|---|---|
key |
La plus faible (n'expire pas) | Aucun | Rotation manuelle (regenerateKeys) |
aml_token |
Moyenne (courte durée, renouvelée) | Aucun | Pipelines automatisés |
aad_token |
La plus forte | Rôle avec onlineEndpoints/score/action (AzureML Data Scientist, Owner, Contributor ou custom) |
Managed online endpoints uniquement ; jeton pour https://ml.azure.com |
Qui peut récupérer les clés ou jetons : un rôle avec onlineEndpoints/listKeys/action et onlineEndpoints/token/action. L'RBAC
est additif : un Contributor au niveau du groupe de ressources peut scorer, même s'il n'est pas dans le groupe Entra visé ; pour
une autorisation par groupe, mettre une couche devant (Azure API Management avec validate-jwt). L'endpoint identity
(system-assigned par défaut) est l'identité du conteneur : elle tire l'image de l'ACR et lit le stockage.
Mise à l'échelle : l'autoscale s'appuie sur Azure Monitor (règles sur CpuUtilizationPercentage, RequestLatency,
planning) :
az monitor autoscale create --name $AUTOSCALE_NAME --resource $DEPLOYMENT_RESOURCE_ID --min-count 2 --max-count 5 --count 2
az monitor autoscale rule create --autoscale-name $AUTOSCALE_NAME \
  --condition "CpuUtilizationPercentage > 70 avg 5m" --scale out 2
Règle Azure Monitor : scale out si une seule règle est vraie (OU), scale in si toutes le sont (ET) ; 10 règles max par profil. Le réseau privé des endpoints (managed network, private endpoint du workspace) est traité au chapitre 02.
5.3 Un batch endpoint#
Deux types de batch deployment :
| Type | Quand |
|---|---|
| Model deployment | Inférence longue sur beaucoup de fichiers, parallélisée sur un compute cluster ; scoring script facultatif pour un MLflow model |
| Pipeline component deployment | Graphe complet (prétraitement réutilisé de l'entraînement + scoring + post-traitement) |
az ml batch-endpoint create -f batch-endpoint.yml
az ml batch-deployment create --endpoint $BATCH_ENDPOINT -f deployment.yml --set-default
az ml batch-endpoint invoke --name $BATCH_ENDPOINT --input <dossier de données ou data asset> --input-type uri_folder
L'endpoint envoie chaque appel au default deployment ; on change de version en changeant le default. Pas de mirroring en batch.
6. Tester et dépanner un endpoint#
Méthode recommandée par Microsoft : (1) tester en local, (2) lire les logs des conteneurs, (3) reconnaître les erreurs courantes.
# 1. Déploiement local dans Docker (CLI ou SDK seulement, pas le studio)
az ml online-endpoint create --local -n credit-endpoint -f endpoint.yml
az ml online-deployment create --local -n blue --endpoint credit-endpoint -f blue-deployment.yml
az ml online-endpoint invoke --local -n credit-endpoint --request-file sample-request.json

# 2. Logs du serveur d'inférence (print et logging de score.py), puis du storage initializer
az ml online-deployment get-logs -e credit-endpoint -n blue -l 100
az ml online-deployment get-logs -e credit-endpoint -n blue --container storage-initializer

# 3. Tester un deployment précis, même à 0 % de trafic
az ml online-endpoint invoke -n credit-endpoint --deployment-name green --request-file sample-request.json
Sans Docker, le paquet azureml-inference-server-http permet de déboguer score.py localement. Le local ne supporte pas les
assets enregistrés : il utilise les fichiers locaux.
| Erreur | Cause typique | Réponse |
|---|---|---|
ImageBuildFailure |
Dépendance qui ne s'installe pas, ACR inaccessible, timeout de build | Lire le build log (stockage du workspace) ; épingler les versions ; workspace privé : autoriser le build d'image dans le réseau |
OutOfQuota |
CPU, disque, mémoire, endpoints, capacité régionale | Autre SKU ou région, demande de quota |
ResourceNotReady |
Le conteneur plante : erreur dans score.py (init()), paquet manquant, sondes trop courtes |
get-logs ; déploiement local ; allonger les probes ou prendre un SKU plus gros |
ResourceNotFound |
ACR privé ou ressource introuvable | Réseau, droits de l'endpoint identity (AcrPull) |
BadArgument |
Rôle manquant pour l'endpoint identity, modèle introuvable | Attributions de rôles, chemin du modèle |
| 401 | Jeton absent, expiré ou mauvaise audience | ml.azure.com pour le data plane, management.azure.com pour le control plane |
| 403 | Identité sans score/action |
Attribuer le rôle à l'échelle de l'endpoint |
En-têtes de traçage : x-request-id (serveur, à joindre à un ticket) et x-ms-client-request-id (client, 40 caractères max). Les
métriques (requêtes, latence, CPU, GPU) passent par Azure Monitor. Trois resource logs s'activent par diagnostic settings :
AmlOnlineEndpointTrafficLog (requêtes, codes et raisons, latence décomposée), AmlOnlineEndpointConsoleLog (sortie console du
conteneur : un conteneur qui ne démarre pas) et AmlOnlineEndpointEventLog (cycle de vie : BackOff, échec de liveness probe).
Activer Application Insights sur le deployment pour la télémétrie applicative.
7. Safe rollout et rollback#
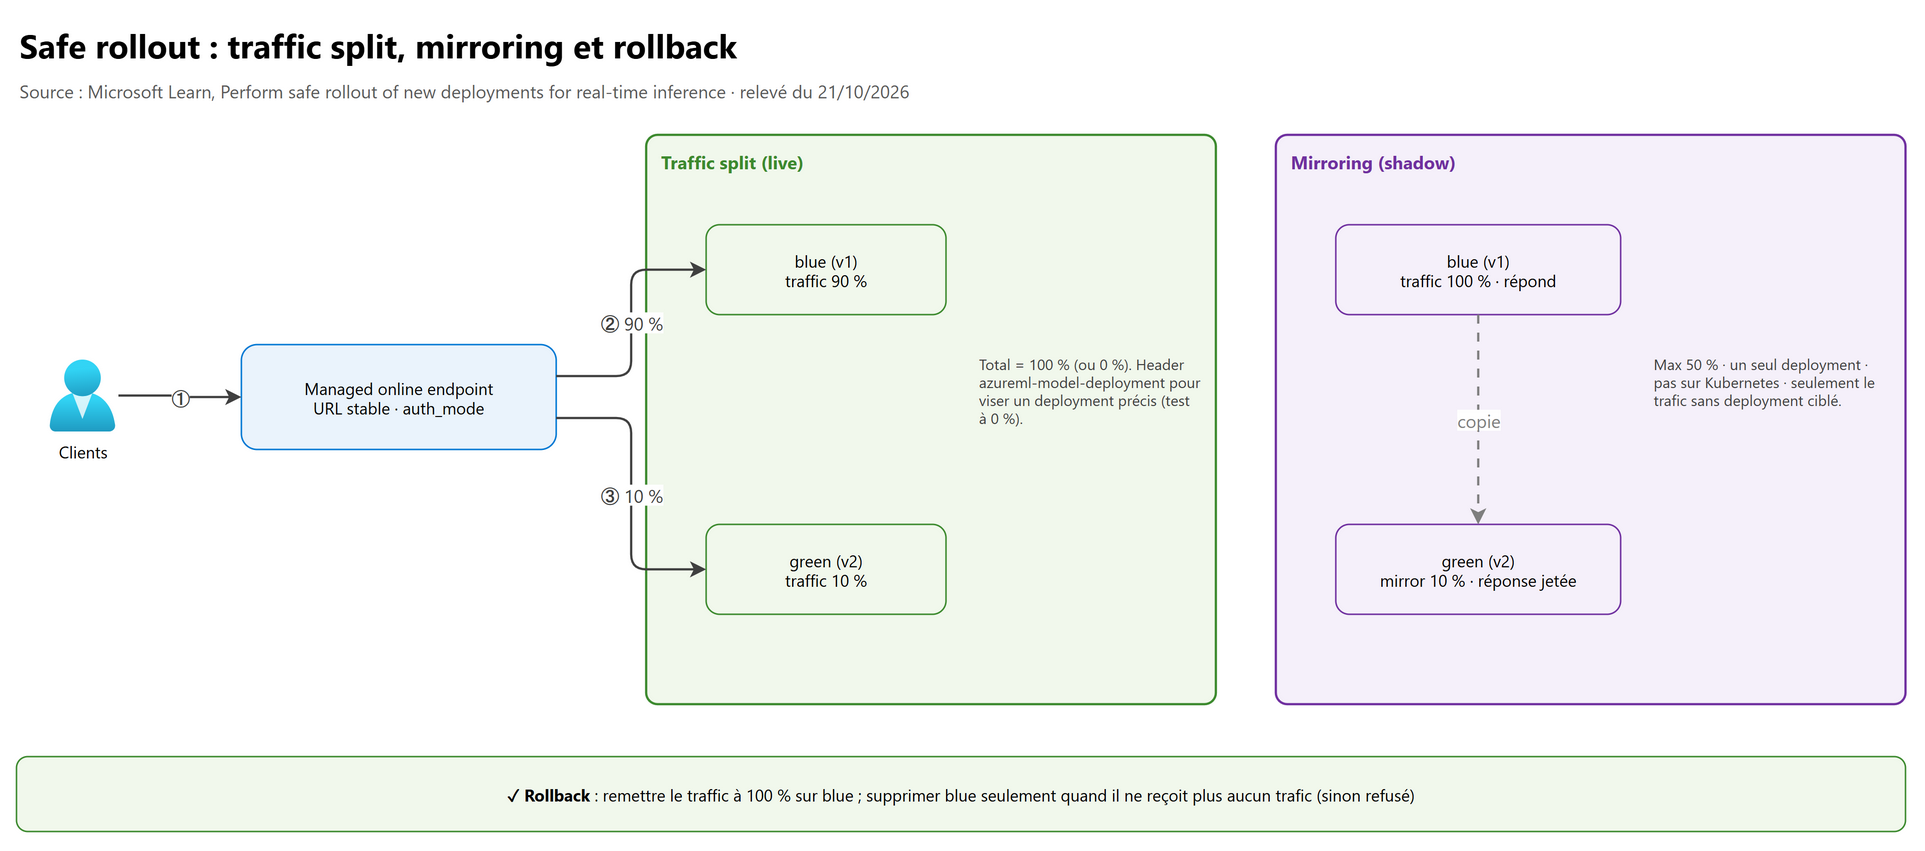
sequenceDiagram
    participant Ops as Pipeline ou opérateur
    participant EP as credit-endpoint
    participant B as blue (v1)
    participant G as green (v2)
    Ops->>EP: créer green, trafic 0 %
    Ops->>G: tester en direct (--deployment-name green)
    Ops->>EP: mirror-traffic green=10
    EP-->>G: copie de 10 % (réponses ignorées)
    Ops->>EP: traffic blue=90 green=10
    Ops->>EP: traffic blue=0 green=100
    Note over Ops,EP: rollback = traffic blue=100 green=0
    Ops->>B: supprimer blue (0 % de trafic seulement)
az ml online-deployment create --name green --endpoint credit-endpoint -f green-deployment.yml   # sans --all-traffic : 0 %
az ml online-endpoint update --name credit-endpoint --mirror-traffic "green=10"
az ml online-endpoint update --name credit-endpoint --mirror-traffic "green=0"
az ml online-endpoint update --name credit-endpoint --traffic "blue=90 green=10"
az ml online-endpoint update --name credit-endpoint --traffic "blue=0 green=100"
az ml online-deployment delete --name blue --endpoint credit-endpoint --yes --no-wait
| Règle | Détail |
|---|---|
| Total du trafic live | 100 % (ou 0 % pour couper) |
| Viser un deployment | En-tête HTTP azureml-model-deployment (contourne la répartition) |
| Mirroring | Un seul deployment, 50 % max, pas sur Kubernetes ; CLI ≥ 2.4.0, SDK ≥ 1.0.0 (sinon le réglage est perdu) |
| Mirroring et live | Un deployment reçoit soit du live, soit du miroir |
| Trafic mirroré | Seules les requêtes sans deployment ciblé sont copiées ; les réponses du shadow ne reviennent pas au client |
| Quota | Bande passante d'endpoint par défaut 5 Mo/s : le mirroring la consomme |
| Suppression | Impossible tant qu'un deployment reçoit du trafic live |
Rollback = remettre 100 % sur l'ancien deployment, qui doit donc rester en place pendant la période de validation. Avec un batch endpoint, le rollback consiste à rechanger le default deployment.
8. Model monitoring : drift, qualité, performance#
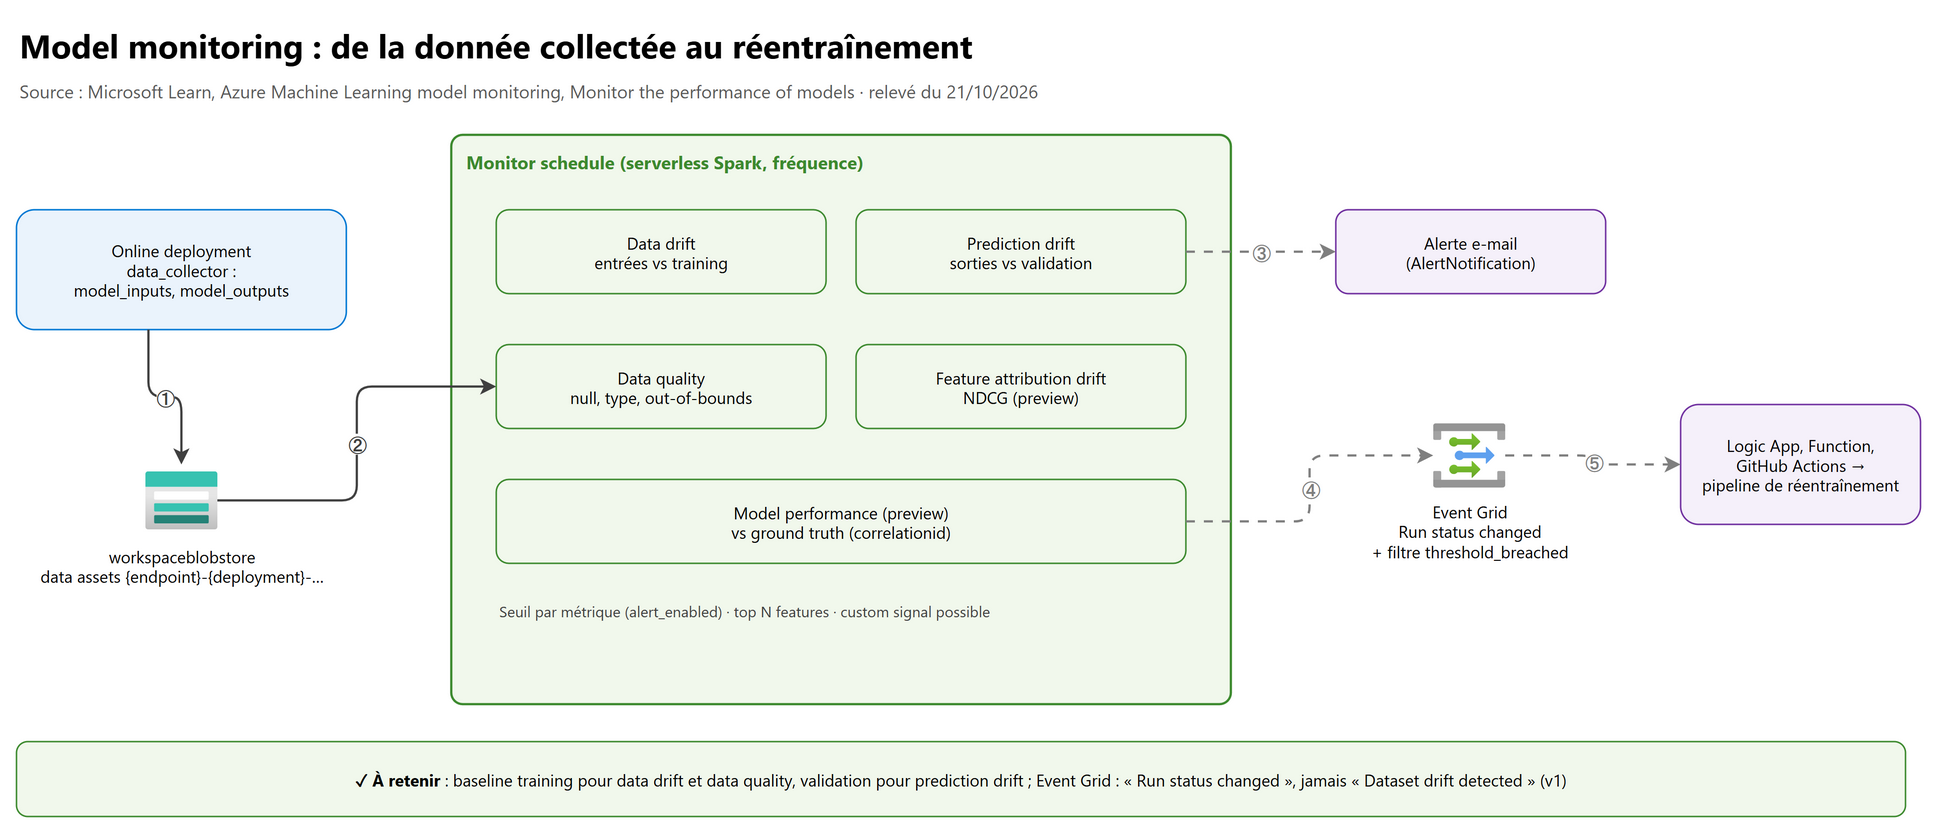
8.1 Le principe#
Azure ML calcule la distribution d'une feature dans la référence (baseline), puis dans la production récente, et compare par un test statistique ou une distance ; au-delà du seuil, il alerte. Trois étapes :
- Collecter les données de production : data collector sur un online endpoint (auto-instrumenté pour un MLflow model via
le studio ;
Collector(name="model_inputs")etCollector(name="model_outputs")dansscore.pypour un custom model). Les données arrivent dansworkspaceblobstoreet deviennent les data assets{endpoint}-{deployment}-model_inputs/-model_outputs. Batch endpoint ou modèle hors Azure ML : vous collectez vous-même. - Configurer le monitor (studio, CLI
az ml schedule create -f monitor.yaml, SDK) : signaux, métriques, seuils, fréquence. - Analyser dans le studio (Monitoring) : notifications, signal par signal, feature par feature.
Réseau : le model monitoring n'est pas pris en charge quand le managed VNet du workspace est en mode Allow only approved outbound (chapitre 02, § 3.2).
8.2 Les signaux#
| Signal | Compare | Métriques | Référence conseillée |
|---|---|---|---|
| Data drift | Distribution des entrées | Jensen-Shannon, PSI, Wasserstein normalisée, Kolmogorov-Smirnov, khi-deux | Training data |
| Prediction drift | Distribution des sorties | Mêmes familles (+ Chebyshev) | Validation data |
| Data quality | Intégrité des entrées | Null value rate, data type error rate, out-of-bounds rate | Training data |
| Feature attribution drift (preview) | Importance des features | NDCG | Training data (obligatoire) |
| Model performance (preview) | Sorties vs ground truth | Accuracy, precision, recall ; MAE, MSE, RMSE | Ground truth (jointure par ID) |
| Custom signal | Votre métrique | Composant Azure ML qui renvoie signal_metrics |
— |
Pour la performance, chaque ligne doit porter un ID unique (le correlationid généré, indexé _0, _1 en cas de batch de
lignes, ou mieux votre propre colonne d'ID) pour joindre la ground truth quand elle arrive.
Bonnes pratiques Microsoft : démarrer le monitoring dès la mise en production ; plusieurs signaux ; fréquence selon le volume
(quotidien si le trafic suffit) ; surveiller les top N features (top_n_feature_importance, 10 par défaut avec une référence
training) pour réduire coût et bruit.
8.3 Le monitor en code (out-of-box)#
from azure.ai.ml.entities import (AlertNotification, MonitoringTarget, MonitorDefinition, MonitorSchedule,
                                  RecurrencePattern, RecurrenceTrigger, ServerlessSparkCompute)

monitor = MonitorSchedule(
    name="credit_monitor",
    trigger=RecurrenceTrigger(frequency="day", interval=1, schedule=RecurrencePattern(hours=3, minutes=15)),
    create_monitor=MonitorDefinition(
        compute=ServerlessSparkCompute(instance_type="standard_e4s_v3", runtime_version="3.4"),
        monitoring_target=MonitoringTarget(ml_task="classification",
                                           endpoint_deployment_id="azureml:credit-endpoint:blue"),
        alert_notification=AlertNotification(emails=["[email protected]"]),
    ),
)
ml_client.schedules.begin_create_or_update(monitor).result()
Avec un online deployment ciblé et sans signal précisé, Azure ML active data drift, prediction drift et data quality avec des
valeurs par défaut (référence = production récente). Pour une référence training, des seuils précis ou d'autres signaux, on
déclare des DataDriftSignal, DataQualitySignal, FeatureAttributionDriftSignal, ModelPerformanceSignal (monitor avancé).
Limites : pas de support du mode de managed network AllowOnlyApprovedOutbound ; calcul sur Spark (éviter les MLTable
complexes). Accès sans secret au datastore : user-assigned managed identity attachée au workspace et
systemDatastoresAuthMode = identity.
8.4 Performance du modèle et métriques de l'endpoint#
Deux familles à ne pas confondre :
| Qualité du modèle | Santé de l'endpoint | |
|---|---|---|
| Quoi | Drift, qualité des données, accuracy vs ground truth | Requêtes par minute, latence, erreurs, CPU / GPU / mémoire, débit réseau |
| Outil | Model monitoring | Azure Monitor (metrics, logs, alertes), Application Insights |
| Action typique | Réentraîner | Scaler, corriger, ouvrir un incident |
Le Well-Architected Framework demande les deux : surveiller la performance du modèle et l'infrastructure (y compris le throttling de bande passante).
9. Alertes et déclenchement du réentraînement#
flowchart LR
    A["Monitor run<br/>seuil dépassé"] --> B["Alerte e-mail<br/>AlertNotification"]
    A --> C["Event Grid<br/>Run status changed"]
    C --> D{"Filtre<br/>threshold_breached"}
    D -- oui --> E["Logic App ou Function"]
    E --> F["Pipeline job de réentraînement<br/>ou workflow GitHub Actions"]
    F --> G["Nouvelle version enregistrée<br/>ModelRegistered"]
    G --> H["Validation puis safe rollout"]
| Déclencheur | Configuration |
|---|---|
alert_enabled: true sur chaque signal + AlertNotification(emails=[...]) |
|
| Event Grid (automatisation) | Abonnement sur le workspace, type d'événement Run status changed uniquement, filtre avancé : clé data.RunTags.azureml_modelmonitor_threshold_breached, opérateur String contains, valeur has failed due to one or more features violating metric thresholds ; filtre supplémentaire possible sur le nom du signal (<monitor>_<signal>) |
| Gestionnaires | Event Hubs, Azure Functions, Logic Apps, webhook… |
| Alertes d'infrastructure | Règles Azure Monitor sur les métriques de l'endpoint |
Piège : ne pas choisir l'événement Dataset drift detected : il concerne le data drift v1, pas le model monitoring actuel. Créer un abonnement Event Grid demande Contributor ou Owner sur le workspace et le fournisseur
Microsoft.EventGridenregistré.
Événements Azure ML utiles : RunCompleted, RunStatusChanged, ModelRegistered, ModelDeployed. Microsoft documente le
principe (« si la précision passe sous un seuil, Event Grid peut lancer un job de réentraînement sur la ground truth collectée ») ;
la chaîne suivante est un exemple d'assemblage de ces briques, pas un tutoriel officiel. Exemple de chaîne : drift
détecté → Event Grid → Logic App qui lance le pipeline d'entraînement (ou un workflow_dispatch GitHub Actions, voir
chapitre 02) → nouvelle version enregistrée → ModelRegistered → tests et déploiement green à 0 % →
mirroring → bascule.
10. Labs conseillés#
Dans un abonnement de test. Coût principal : les instances d'un managed online endpoint sont facturées tant qu'elles existent, et les jobs de monitoring consomment du serverless Spark. Supprimer les endpoints à la fin de chaque lab, puis le groupe de ressources.
- Registry et cycle de vie (30 min) : entraîner un petit modèle scikit-learn avec
mlflow.sklearn.log_model(..., registered_model_name=...); le réenregistrer pour obtenir la version 2 ; ajoutertags.stage=Prod; archiver la version 1. Résultat attendu : la v1 disparaît deaz ml model listmaisaz ml model show -n … -v 1fonctionne toujours. - Online endpoint et dépannage (45 min) : déployer d'abord en
--local(Docker), provoquer une erreur dansinit(), la lire avecget-logs --local; corriger, déployer dans Azure avecauth_mode: aad_token, scorer avecaz ml online-endpoint invoke. Résultat attendu : 403 tant que l'identité n'a passcore/action, puis succès. - Safe rollout (30 min) : ajouter
greensans trafic, le tester avec--deployment-name green, activer--mirror-traffic "green=10", comparer les logs, passer à 90/10 puis 0/100, revenir en arrière. Résultat attendu : les clients ne voient jamais de réponse de green pendant le mirroring ; la suppression de blue est refusée tant qu'il a du trafic. - Batch endpoint (30 min) : déployer le MLflow model sur un batch endpoint avec un compute cluster à 0 nœud minimum, invoquer sur un dossier de CSV. Résultat attendu : le cluster monte pour le job puis redescend ; un fichier de prédictions en sortie.
- Monitoring et alerte (45 min) : activer la collecte, envoyer des requêtes dont une feature est volontairement décalée, créer un monitor avec data drift (référence training) et un abonnement Event Grid filtré vers une Logic App qui envoie un e-mail. Résultat attendu : signal en échec dans Monitoring, événement reçu par la Logic App.
11. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Déployer un MLflow model sans écrire de code | No-code deployment (pas de score.py ni d'environment) |
Générés pour le flavor PyFunc |
| MLflow model avec pré-traitement spécifique | Fournir score.py et environment |
L'un ne va pas sans l'autre |
| Promouvoir avec les stages MLflow et déployer « Production » | Impossible : déployer une version ; utiliser des tags | Stages non visibles dans Azure ML, déploiement depuis un stage non supporté |
| Modifier le chemin d'un modèle enregistré | Créer une nouvelle version | Seuls description et tags sont modifiables |
| Retirer un vieux modèle sans casser un pipeline qui l'utilise | Archiver | L'archivage cache sans supprimer |
| Lignage modèle ↔ feature sets absent | Spec feature_retrieval_spec.yaml à la racine de l'artefact |
Le lignage en dépend |
Endpoint Kubernetes en aad_token |
Impossible : key ou aml_token |
aad_token = managed seulement |
| Tester v2 sur du vrai trafic sans impact client | Mirroring (shadow) | Les réponses de v2 ne sont pas renvoyées |
| Mirroring à 70 % | Impossible : 50 % max | Limite de bande passante |
| Mirroring sur endpoint Kubernetes | Non supporté | Limite documentée |
| Viser un deployment précis à 0 % de trafic | En-tête azureml-model-deployment ou --deployment-name |
Contourne la répartition |
| Supprimer l'ancien deployment encore à 10 % | Refusé : passer d'abord à 0 % | Règle de suppression |
| Scoring de millions de fichiers chaque nuit, pas de latence | Batch endpoint (model deployment) | Parallélisé, payé pendant le job |
| Réutiliser le prétraitement de l'entraînement en batch | Pipeline component deployment | Graphe complet |
Conteneur qui redémarre, ResourceNotReady |
get-logs, erreur dans init() ou probes |
Le conteneur crashe |
| Build de l'environnement qui échoue | ImageBuildFailure : build log, épingler les dépendances |
— |
401 en aad_token |
Audience https://ml.azure.com |
Data plane ≠ control plane |
| Data drift : quelle référence ? | Training data | Recommandation Microsoft |
| Prediction drift : quelle référence ? | Validation data | Idem |
| Mesurer l'accuracy en production | Model performance + ground truth + ID de jointure | Seul signal objectif |
| Automatiser un réentraînement sur drift | Event Grid, Run status changed + filtre threshold_breached |
Pas Dataset drift detected (v1) |
Monitoring sur un workspace en AllowOnlyApprovedOutbound |
Non supporté | Limite documentée |
| Autoscale : quand scale in ? | Quand toutes les règles de scale in sont vraies | OU pour scale out, ET pour scale in |
| Responsible AI dashboard sur un modèle PyTorch custom | Non : MLflow flavor sklearn requis | Limite des composants |
12. Scénarios corrigés#
1. Contoso entraîne un modèle de fraude avec des features du managed feature store. En production, le scoring script ne trouve pas la liste des features et le studio n'affiche aucun lien entre modèle et feature sets. Cause ?
La feature retrieval specification n'a pas été copiée à la racine du dossier du modèle avant l'enregistrement. Le job d'entraînement doit faire la copie (
feature_retrieval_spec.yaml, nom imposé), puis réenregistrer une nouvelle version.
2. L'équipe veut marquer « la version en production » et ses outils de déploiement lisent l'état dans Azure ML. Elle utilise
transition_model_version_stage(..., "Production"). Ça ne marche pas. Pourquoi, et que faire ?
Les stages MLflow ne sont visibles que par le SDK MLflow et on ne peut pas déployer depuis un stage. Utiliser un tag (
az ml model update --set tags.stage=Prod) et référencer la version (azureml:fraud:7) dans le deployment.
3. Un modèle de scoring doit répondre en moins de 200 ms à une application web, avec l'authentification la plus forte possible. Quel endpoint et quel mode ?
Managed online endpoint en
aad_token; l'identité appelante reçoit un rôle avecscore/actionà l'échelle de l'endpoint.
4. Une nouvelle version doit être validée sur le trafic réel sans qu'aucun client n'en reçoive les réponses, puis exposée à 5 % des utilisateurs. Étapes ?
Créer
greenà 0 %, le tester directement, activer le mirroring (≤ 50 %), observer métriques et logs, couper le miroir, puis trafficblue=95 green=5, augmenter progressivement. Rollback :blue=100.
5. Chaque nuit, 40 000 fichiers d'images doivent être notés ; la latence n'importe pas et le budget est serré. Solution ?
Batch endpoint (model deployment) sur un compute cluster avec minimum 0 nœud (low-priority possible) : on ne paie que pendant le job.
6. Après un az ml online-deployment create, l'état passe à ResourceNotReady. Démarche ?
az ml online-deployment get-logs(serveur d'inférence) : souvent une erreur dansinit()ou un paquet manquant. Reproduire en déploiement local (--local). Si l'initialisation est longue : allonger les probes ou prendre un SKU plus gros.
7. Le monitor de data drift alerte en permanence, avec des faux positifs sur des dizaines de features secondaires. Quoi ajuster ?
Référence = training data, surveiller les top N features par importance, revoir les seuils avec les data scientists, adapter la fréquence au volume de production.
8. Une banque veut relancer automatiquement l'entraînement quand le drift dépasse le seuil, puis valider avant déploiement. Comment ?
Abonnement Event Grid sur le workspace, type Run status changed, filtre
data.RunTags.azureml_modelmonitor_threshold_breached→ Logic App ou Function qui lance le pipeline d'entraînement ; la nouvelle version (ModelRegistered) déclenche validation puis safe rollout. Pas d'événement Dataset drift detected.
9. Les métiers veulent un document montrant que le modèle de crédit ne pénalise pas un groupe et expliquant ses décisions. Outil ?
Responsible AI dashboard (fairness, interpretability, error analysis) puis Responsible AI scorecard en PDF. Prérequis : modèle MLflow sklearn, données en mltable.
10. Le modèle doit tourner dans un AKS existant, déjà gouverné par l'équipe plateforme, avec du blue/green. Limites ?
Kubernetes online endpoint : traffic split oui, mirroring non, authentification
keyouaml_token(pasaad_token) ; prévoir une couche devant (APIM) si une authentification Entra est exigée.
13. Pour aller plus loin#
- Secret injection (preview) dans les online deployments : récupérer des secrets d'un store et les exposer en variables d'environnement au conteneur.
- Triton et BYOC pour des modèles de deep learning ou une pile d'inférence maison ; GPU sur online endpoints.
- Autoscale planifié (profil de week-end) en plus des règles de métriques.
- Shared quota pour tester des modèles du catalogue (Llama, Phi, Mistral…) sur managed online endpoints, avec un abonnement Enterprise Agreement.
- Monitoring des applications génératives (qualité, sécurité, jetons) : chapitre 06.
- Héberger soi-même un modèle sur AKS (KAITO, vLLM) : parcours AKS, fichier 06.
14. Fiche à retenir#
- Model =
nom:version; seuls description et tags se modifient ; archiver cache sans casser. - Stages MLflow : SDK MLflow seulement, invisibles dans le studio, pas de déploiement depuis un stage → tags.
- MLflow model = no-code deployment (PyFunc) ; personnalisation =
score.pyet environment. -
feature_retrieval_spec.yamlà la racine du modèle, copié par le job d'entraînement (lignage + inférence). - Responsible AI dashboard : constructor + gather + ≥ 1 outil ; MLflow sklearn, mltable, 5 000 lignes ; scorecard PDF.
- Managed online (temps réel, autoscale Azure Monitor, mirroring) · Kubernetes online (pas d'
aad_token, pas de mirroring) · batch (Entra ID, default deployment, payé au job, file d'attente). -
aad_token= le plus sûr, managed seulement, rôlescore/action, audienceml.azure.com. - Dépannage : local (Docker) →
get-logs(+storage-initializer) → erreurs (ImageBuildFailure,OutOfQuota,ResourceNotReady). - Safe rollout : green à 0 % → test direct → mirroring ≤ 50 %, un seul → split → 100 % ; rollback = remettre le trafic.
- Signaux : data drift (ref. training), prediction drift (ref. validation), data quality, feature attribution drift, model performance (ground truth + ID).
- Automatiser : Event Grid Run status changed + filtre
threshold_breached→ Logic App / Function → pipeline.
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Study guide for Exam AI-300
- MLflow and Azure Machine Learning
- Work with registered models in Azure Machine Learning
- Manage models registry in Azure Machine Learning with MLflow
- az ml model (CLI reference)
- Guidelines for deploying MLflow models
- Deploy MLflow models to online endpoints
- Feature retrieval specification and usage in training and inference
- Assess AI systems by using the Responsible AI dashboard
- Generate Responsible AI insights with YAML and Python
- Use Responsible AI scorecard (preview)
- Endpoints for inference in production
- Online endpoint deployment for real-time inferencing
- Deploy and score a machine learning model by using an online endpoint
- Authenticate clients for online endpoints
- Authentication and authorization for online endpoints
- Autoscale online endpoints in Azure Machine Learning
- Batch endpoints
- Deploy models for scoring in batch endpoints
- How to deploy a pipeline to perform batch scoring with preprocessing
- Troubleshoot online endpoint deployment and scoring
- Perform safe rollout of new deployments for real-time inference
- Azure Machine Learning model monitoring
- Monitor the performance of models deployed to production
- Collect production data from models for real-time inferencing
- Trigger applications, processes, or CI/CD workflows based on Azure Machine Learning events
- Azure Machine Learning as an Event Grid source
- Overview of autoscale in Azure Monitor
- Architecture best practices for Azure Machine Learning