

Version : 1.1 · Date : 2026-10-21 · Domaine 4 : Prompt Engineering & Structured Output (20 %)
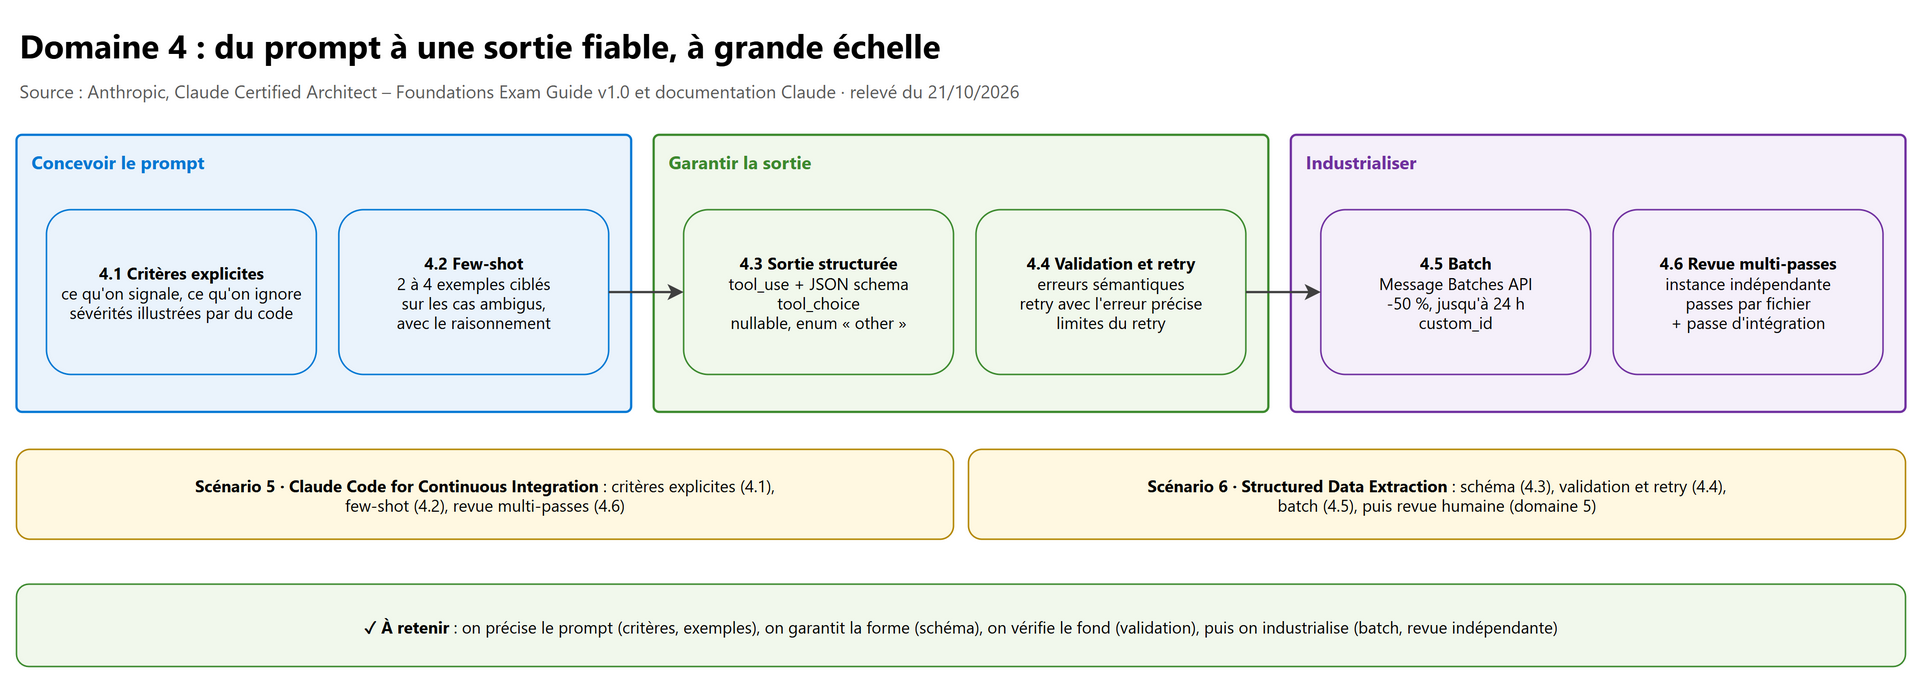
En une phrase : on rend un prompt précis avec des critères explicites et des exemples few-shot, on garantit la forme de la sortie avec tool use + JSON schema (ou les structured outputs), on vérifie le fond avec une boucle de validation et retry, puis on passe à l'échelle avec la Message Batches API et une revue par une instance indépendante.
Ce que l'examen demande#
Repris mot pour mot du guide d'examen officiel (Claude Certified Architect – Foundations, CCAR-F, v1.0 de juillet 2026) :
| # | Task statement (guide officiel, en anglais) | Section |
|---|---|---|
| 4.1 | Design prompts with explicit criteria to improve precision and reduce false positives | 2 |
| 4.2 | Apply few-shot prompting to improve output consistency and quality | 3 |
| 4.3 | Enforce structured output using tool use and JSON schemas | 4 |
| 4.4 | Implement validation, retry, and feedback loops for extraction quality | 5 |
| 4.5 | Design efficient batch processing strategies | 6 |
| 4.6 | Design multi-instance and multi-pass review architectures | 7 |
Deux des six scénarios d'examen reposent surtout sur ce domaine : Scénario 5, Claude Code for Continuous Integration (revues automatiques avec peu de faux positifs) et Scénario 6, Structured Data Extraction (extraction depuis des documents non structurés, validée par JSON schema). Le détail des scénarios est dans 06-scenarios-examen.md.
Convention du cours : quand le produit a changé depuis le guide v1.0, l'encadré Réponse d'examen donne ce qu'il faut répondre à l'examen (on répond selon le guide), puis État actuel ce que fait la plateforme au 21/10/2026.
1. Les bases à maîtriser#
1.1 Le vocabulaire#
| Terme | Définition courte |
|---|---|
System prompt (system) |
Les consignes permanentes, appliquées à chaque entrée : rôle, critères, format, exemples |
| Few-shot (ou multishot) | Quelques exemples entrée → sortie attendue, placés dans le prompt |
| XML tags | Balises (<instructions>, <examples>, <document>…) qui séparent les parties d'un prompt |
| Tool use | Claude répond par un bloc tool_use dont input respecte l'input_schema (JSON schema) d'un outil |
tool_choice |
Contrôle si Claude doit appeler un outil : auto, any, outil nommé (tool), none |
| Structured outputs | Décodage contraint par un schéma : output_config.format (réponse JSON) et strict: true (entrées d'outil) |
| Erreur de syntaxe / erreur sémantique | JSON invalide ou champ manquant / JSON valide mais valeur fausse (total, champ, invention) |
| Message Batches API | Traitement asynchrone d'un lot de requêtes Messages, à moitié prix, en 24 h au plus |
custom_id |
Identifiant que l'on donne à chaque requête d'un lot pour retrouver son résultat |
| Instance indépendante | Un appel séparé à Claude, sans l'historique ni le raisonnement de la génération |
1.2 Ce qui a changé depuis le guide v1.0#
| Sujet | Réponse d'examen (guide v1.0) | État actuel (doc Anthropic, 21/10/2026) |
|---|---|---|
| Sortie structurée la plus fiable | tool_use + JSON schema |
Les structured outputs sont en disponibilité générale : output_config.format et strict: true (doc) |
tool_choice |
trois modes : auto, any, outil forcé |
un quatrième, {"type": "none"}, interdit les outils ; Claude Opus 5.5, Claude Sonnet 5.5, Claude Fable 5.1 (et Mythos 5.1) refusent any et l'outil forcé (erreur 400) : on passe en auto + strict: true, ou à output_config.format. Claude Haiku 5.5, Claude Opus 5 et Claude Fable 5 les acceptent encore |
| Nombre d'exemples few-shot | 2 à 4 exemples ciblés | la doc de prompting conseille « 3–5 examples for best results » |
| Outils dans un lot | « the batch API does not support multi-turn tool calling within a single request » | les server tools (web search, code execution, MCP connector…) fonctionnent dans un lot ; un client tool (exécuté par votre code) arrête la requête sur tool_use : il faut une requête de suite |
| Extended thinking | cité : une instance indépendante vaut mieux qu'un extended thinking | sur les modèles actuels, adaptive thinking piloté par effort ; budget_tokens est refusé (400) sur Opus 5.5, Sonnet 5.5, Fable 5.1, Haiku 5.5 |
| Prompt caching | « beyond knowing it exists » : hors programme | existe toujours (cache_control) : voir § 11 |
1.3 Ce qui est hors programme pour ce domaine#
D'après la liste Out-of-Scope du guide : fine-tuning, embeddings et bases vectorielles, streaming, rate limiting et prix, vision, tokenisation, et le prompt caching au-delà de savoir qu'il existe. Ne pas y passer de temps pour l'examen.
2. Des critères explicites (4.1)#
2.1 Ce que l'examen teste#
Une consigne vague (« be conservative », « only report high-confidence findings », « check that comments are accurate ») ne donne aucune frontière de décision : le modèle classe au hasard d'un appel à l'autre. Ce qui marche, ce sont des critères catégoriels : quoi signaler, quoi ignorer, et quand.
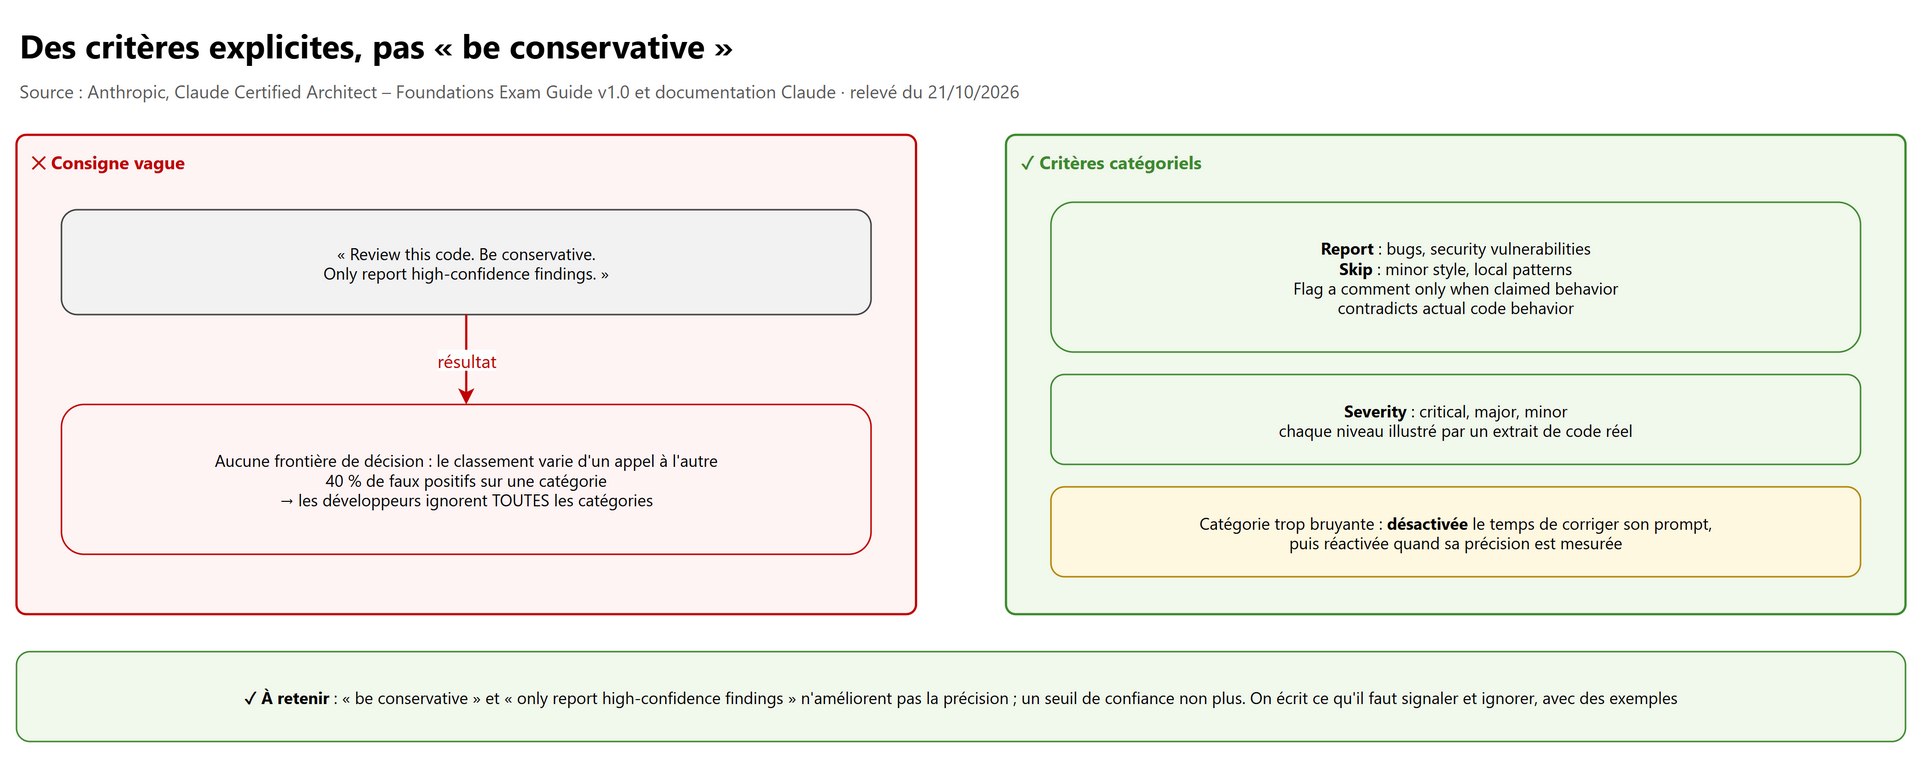
| Consigne vague (distracteur classique) | Critère explicite (bonne réponse) |
|---|---|
| « Check that comments are accurate » | « Flag comments only when claimed behavior contradicts actual code behavior » |
| « Be conservative » | « Report bugs and security vulnerabilities. Skip minor style preferences and local patterns. » |
| « Only report high-confidence findings » | Des niveaux de sévérité définis chacun par un extrait de code |
2.2 La confiance des développeurs#
Une seule catégorie trop bruyante (40 % de faux positifs, par exemple) fait ignorer toutes les catégories, y compris celles qui sont justes. La réponse attendue :
- désactiver temporairement la catégorie défaillante (on retire les faux positifs qui détruisent la confiance) ;
- réécrire son prompt avec des critères explicites et des exemples de code ;
- mesurer son taux de faux positifs sur un jeu de test, puis la réactiver quand il est acceptable.
Ajouter « only report high-confidence findings » ou un seuil de confiance ne corrige pas la cause : la confiance auto-déclarée est mal calibrée (elle sert au routage, après les critères : voir § 7.4).
2.3 Exemple de prompt système de revue#
You are a senior code reviewer for a payments service.

<instructions>
Report only:
- bugs: code that produces a wrong result or crashes for a realistic input;
- security vulnerabilities: injection, secrets in code, missing authorization checks.
Skip: naming and formatting preferences, patterns that are consistent with the rest of the file.
Flag a comment only when its claimed behavior contradicts what the code actually does.
These findings block a merge, so a false positive costs a developer's time.
</instructions>

<severity>
critical: exploitable or data-corrupting, e.g. `query = "SELECT * FROM users WHERE id=" + user_id`
major: wrong result in a common path, e.g. `if amount > limit:` where the rule is "at or above the limit"
minor: wrong result in a rare edge case, e.g. an empty list returns 0 instead of raising
</severity>
Trois points notés par le guide : des critères de signalement et d'exclusion, une raison (« a false positive costs a developer's time » : la doc recommande d'expliquer le pourquoi), et des sévérités illustrées par du code plutôt que par de la prose.
3. Le few-shot prompting (4.2)#
3.1 Quand l'utiliser#
Le guide en fait la technique la plus efficace pour obtenir une sortie cohérente quand des instructions détaillées ne suffisent pas. Trois symptômes typiques :
- format incohérent malgré des instructions précises ;
- jugements ambigus traités différemment (choix d'outil pour une demande ambiguë, gravité d'un constat, trou de couverture de tests au niveau des branches) ;
- champs vides en extraction alors que l'information existe sous une autre forme (texte narratif, mesures informelles, citations dans le texte plutôt qu'en bibliographie).
3.2 Construire de bons exemples#
| Règle | Détail |
|---|---|
| Combien | Réponse d'examen : 2 à 4 exemples ciblés. État actuel : la doc conseille 3 à 5. Plus n'est pas mieux : des exemples en trop coûtent des jetons |
| Lesquels | Les cas ambigus ou ratés, pas les cas faciles ; variés pour ne pas apprendre un motif involontaire |
| Avec le raisonnement | Montrer pourquoi cette action plutôt que l'alternative plausible : le modèle généralise le jugement à des cas nouveaux |
| Le format | Chaque exemple montre exactement la sortie voulue (location, issue, severity, suggested_fix) |
| Les faux positifs | Inclure un exemple de code acceptable à ne pas signaler, à côté d'un vrai problème |
| Balisés | Dans <example> (plusieurs dans <examples>), séparés des instructions |
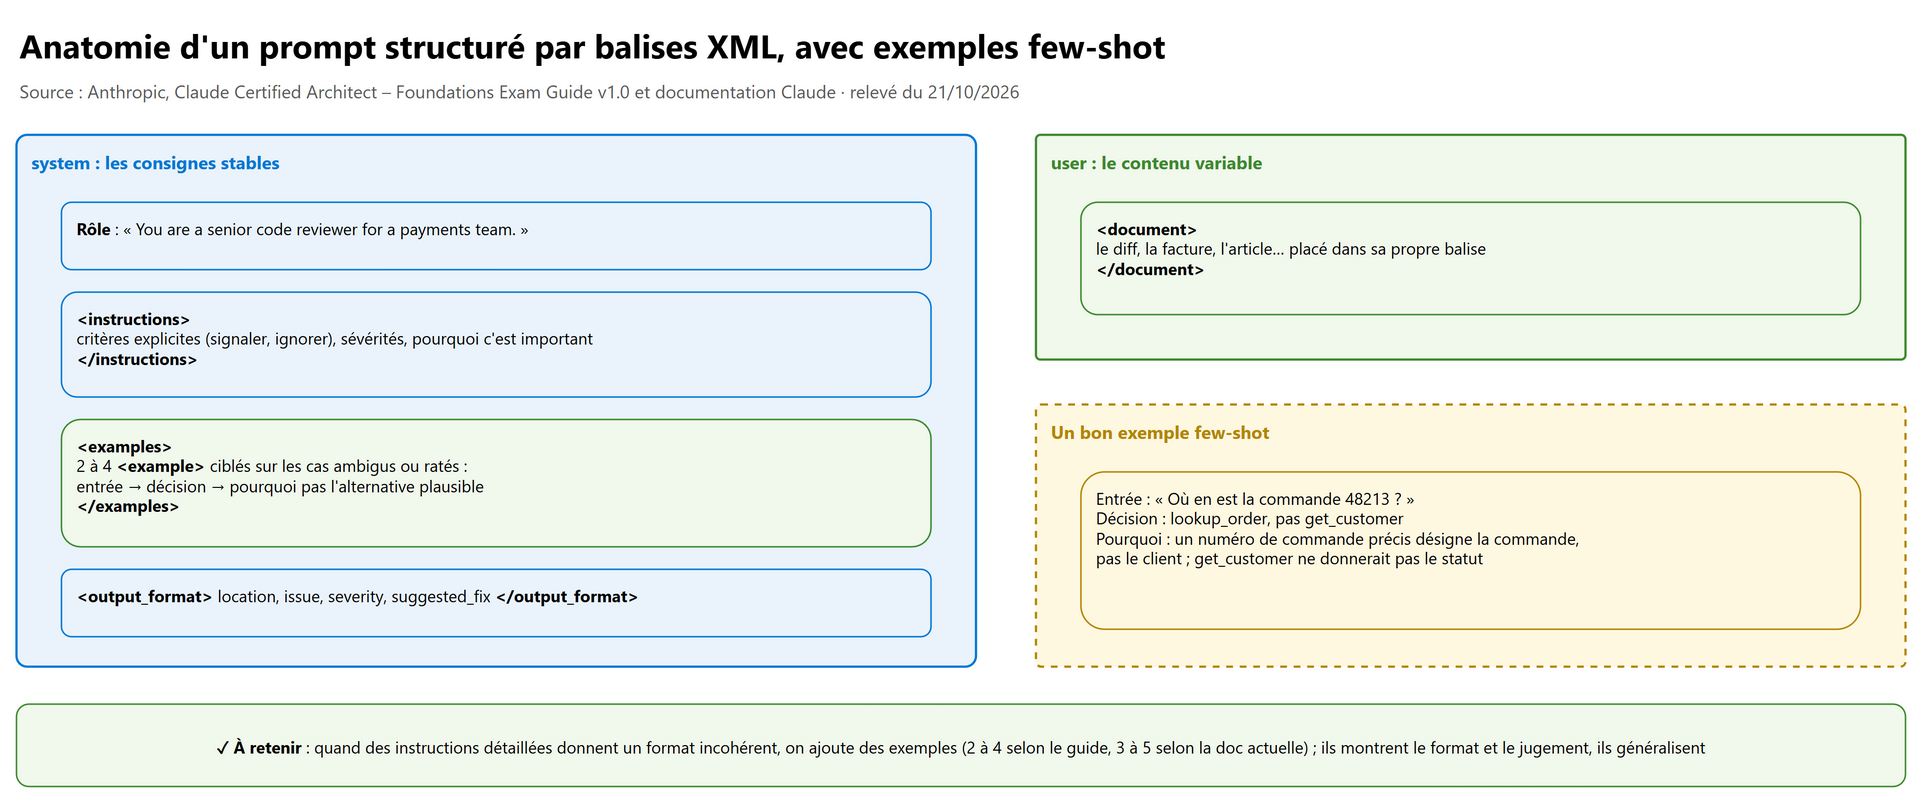
<examples>
<example>
Input: "Where is order 48213?"
Decision: lookup_order
Why: a specific order number identifies the order, not the customer; get_customer would not return the order status.
</example>
<example>
Document excerpt: "The pump draws roughly two and a half amps when idle."
Extraction: {"idle_current_amps": 2.5}
Why: informal measurements in prose are still measurements; do not leave the field empty.
</example>
</examples>
3.3 Quelle technique pour quel problème#
C'est le tableau de décision qui revient le plus dans les questions du domaine :
flowchart TD
    P["Quel est le problème ?"] --> A["Format de sortie incohérent"]
    P --> B["JSON mal formé"]
    P --> C["Valeurs inventées pour des champs absents"]
    P --> D["Mauvais outil choisi"]
    P --> E["Information ratée dans du texte narratif"]
    P --> F["Somme des lignes différente du total"]
    P --> G["Trop de faux positifs dans une catégorie"]
    A --> A1["Exemples few-shot"]
    B --> B1["tool_use + JSON schema"]
    C --> C1["Champs nullable dans le schéma"]
    D --> D1["Meilleure description d'outil, puis few-shot"]
    E --> E1["Few-shot d'extraction narrative"]
    F --> F1["Boucle de validation et retry"]
    G --> G1["Critères explicites, catégorie désactivée le temps de corriger"]
4. La sortie structurée par tool use et JSON schema (4.3)#
4.1 Trois niveaux de fiabilité#
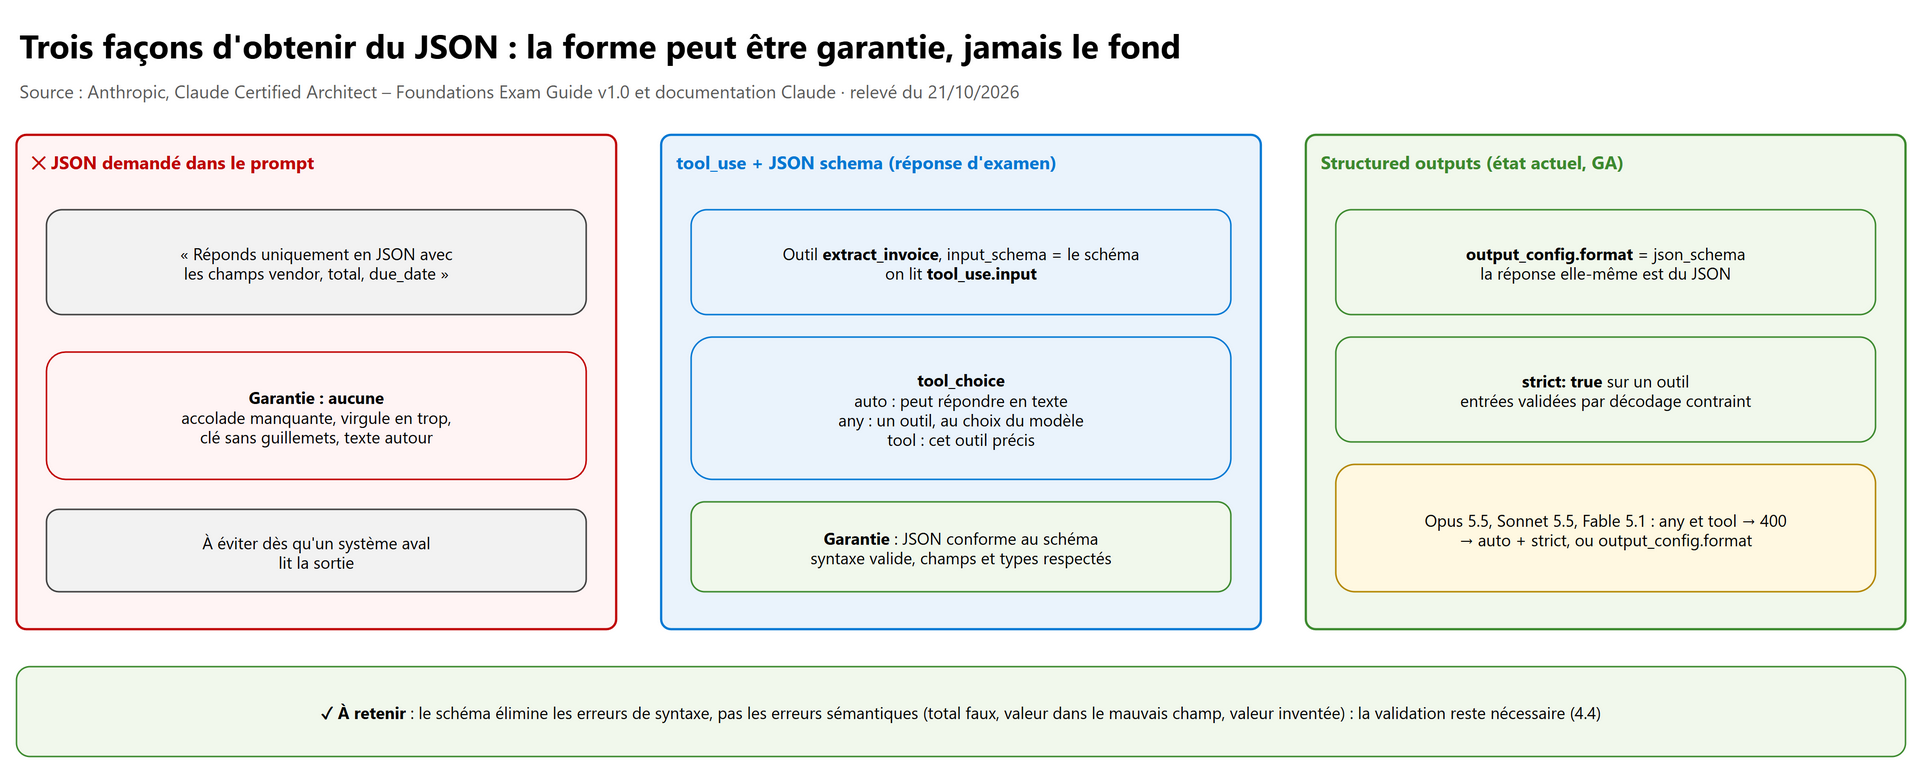
Le guide présente tool use + JSON schema comme la méthode la plus fiable : elle élimine les erreurs de syntaxe JSON. Demander du JSON en texte libre n'offre aucune garantie. Mais aucun schéma n'empêche les erreurs sémantiques : lignes qui ne font pas le total, valeur dans le mauvais champ, valeur inventée pour remplir un champ obligatoire. Celles-là se traitent par la validation (§ 5).
4.2 Un outil d'extraction#
On définit un outil dont l'input_schema est le schéma d'extraction, puis on lit tool_use.input dans la réponse.
import anthropic

client = anthropic.Anthropic()  # lit ANTHROPIC_API_KEY dans l'environnement

extract_invoice = {
    "name": "extract_invoice",
    "description": "Extract the fields of a supplier invoice. Use null when a field is not in the document.",
    "input_schema": {
        "type": "object",
        "properties": {
            "invoice_number": {"type": "string"},
            "due_date": {"type": ["string", "null"], "description": "ISO 8601 date, null if absent"},
            "category": {"type": "string", "enum": ["software", "hardware", "services", "other"]},
            "category_detail": {"type": ["string", "null"], "description": "Free text when category is other"},
            "line_items": {"type": "array", "items": {"type": "object", "properties": {
                "label": {"type": "string"}, "amount": {"type": "number"}}, "required": ["label", "amount"]}},
            "stated_total": {"type": "number"},
            "calculated_total": {"type": "number", "description": "Sum of line_items amounts"},
            "conflict_detected": {"type": "boolean", "description": "True if the document contains contradictory values"},
        },
        "required": ["invoice_number", "category", "line_items", "stated_total", "calculated_total", "conflict_detected"],
    },
}

response = client.messages.create(
    model="claude-haiku-5-5",            # accepte encore un outil forcé (voir 4.3)
    max_tokens=4096,
    system="Normalize dates to ISO 8601 and amounts to numbers without currency symbols.",
    tools=[extract_invoice],
    tool_choice={"type": "tool", "name": "extract_invoice"},   # cette extraction doit tourner
    messages=[{"role": "user", "content": f"<document>\n{invoice_text}\n</document>"}],
)
data = next(block.input for block in response.content if block.type == "tool_use")
4.3 Les modes de tool_choice#
| Valeur | Comportement | Quand (réponse d'examen) |
|---|---|---|
{"type": "auto"} (défaut) |
Claude peut répondre en texte au lieu d'appeler un outil | Agent qui choisit librement |
{"type": "any"} |
Claude doit appeler un outil, mais choisit lequel | Plusieurs schémas d'extraction et type de document inconnu : garantit une sortie structurée |
{"type": "tool", "name": "extract_metadata"} |
Claude doit appeler cet outil | Une extraction doit tourner avant les étapes d'enrichissement |
{"type": "none"} |
Aucun outil (état actuel, hors guide) | — |
tool_choice vaut pour une requête, pas pour toute la conversation : après un appel forcé, on repasse en auto (ou on retire le
paramètre) si l'on ne veut pas que le modèle rappelle le même outil.
Réponse d'examen :
anypour garantir un appel quand plusieurs outils d'extraction existent ; l'outil nommé pour imposer une étape. État actuel : Claude Opus 5.5, Claude Sonnet 5.5 et Claude Fable 5.1 renvoient une erreur 400 suranyet sur un outil forcé (aussi dans un lot). On utiliseauto+ une consigne qui nomme l'outil +strict: truesur l'outil (arguments conformes au schéma), on vérifie qu'untool_useest bien présent (sinon on relance), ou on passe àoutput_config.formatsi l'outil ne servait qu'à obtenir du JSON.
4.4 Concevoir le schéma#
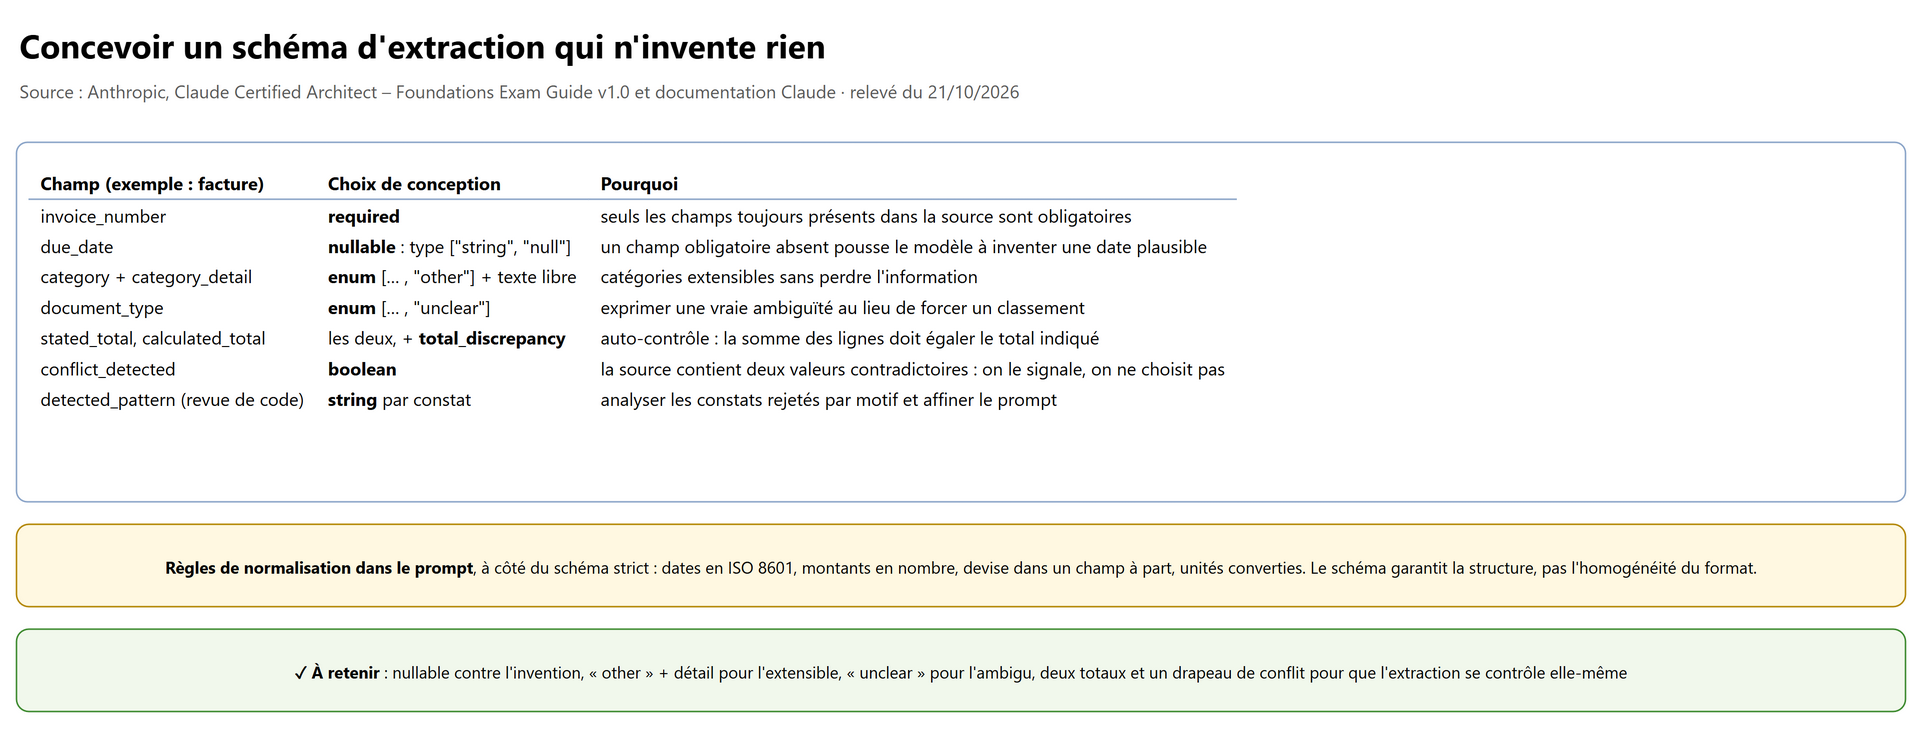
| Règle du guide | Pourquoi |
|---|---|
| Required seulement pour les champs toujours présents | un champ obligatoire absent pousse le modèle à inventer une valeur plausible |
Nullable (["string", "null"]) pour ce qui peut manquer |
le modèle peut honnêtement renvoyer null : c'est la vraie protection contre l'invention |
Enum + "other" + champ de détail |
catégories extensibles sans perdre l'information |
Enum "unclear" |
exprimer une ambiguïté réelle au lieu de forcer un classement |
| Règles de normalisation dans le prompt | le schéma garantit la structure, pas l'homogénéité (formats de date, devises, unités) |
4.5 L'état actuel : les structured outputs#
Deux fonctionnalités, utilisables ensemble (doc) :
| Fonctionnalité | Paramètre | Ce qu'elle garantit |
|---|---|---|
| JSON outputs | output_config: {"format": {"type": "json_schema", "schema": {...}}} |
La réponse est du JSON conforme au schéma (décodage contraint) |
| Strict tool use | "strict": true sur la définition de l'outil |
Les entrées d'outil (tool_use.input) valident le schéma |
Avec le SDK Python, la méthode recommandée est client.messages.parse() avec un modèle Pydantic :
from typing import Literal, Optional
from pydantic import BaseModel

class Invoice(BaseModel):
    invoice_number: str
    due_date: Optional[str] = None        # devient un champ optionnel dans le schéma envoyé
    category: Literal["software", "hardware", "services", "other"]
    category_detail: Optional[str] = None
    stated_total: float
    calculated_total: float
    conflict_detected: bool

response = client.messages.parse(
    model="claude-opus-5-5",
    max_tokens=16000,
    output_format=Invoice,               # envoyé comme output_config.format
    messages=[{"role": "user", "content": f"<document>\n{invoice_text}\n</document>"}],
)
if response.stop_reason in ("refusal", "max_tokens"):
    raise RuntimeError(f"sortie incomplète : {response.stop_reason}")  # le schéma n'est alors pas garanti
invoice = response.parsed_output         # instance Invoice validée
Limites à connaître (doc officielle) :
- chaque objet doit avoir
additionalProperties: false; pas de schéma récursif ; pas deminimum/maximum, ni deminLength/maxLength(les SDK Python et TypeScript les retirent du schéma et les vérifient côté client) ; - au plus 20 outils stricts par requête, 24 paramètres optionnels et 16 paramètres à type union en tout ;
- la première utilisation d'un schéma compile une grammaire (latence en plus), mise en cache 24 h après la dernière utilisation ;
stop_reason: "refusal"ou"max_tokens": la sortie peut ne pas respecter le schéma ; une valeur d'enum peut ne différer que par la casse (comparer sans tenir compte de la casse) ;- incompatible avec les citations (400) et avec le préremplissage ; compatible avec les lots.
5. Validation, retry et boucles de feedback (4.4)#
5.1 Erreurs de schéma et erreurs sémantiques#
| Type | Exemples | Qui le règle |
|---|---|---|
| Syntaxe de schéma | JSON mal formé, champ obligatoire absent, mauvais type | tool use + schéma (ou strict / output_config.format) |
| Sémantique | lignes qui ne font pas le total, dates dans le désordre, valeur dans le mauvais champ | votre validation (Pydantic, règles métier), puis retry |
5.2 Le retry avec feedback d'erreur#
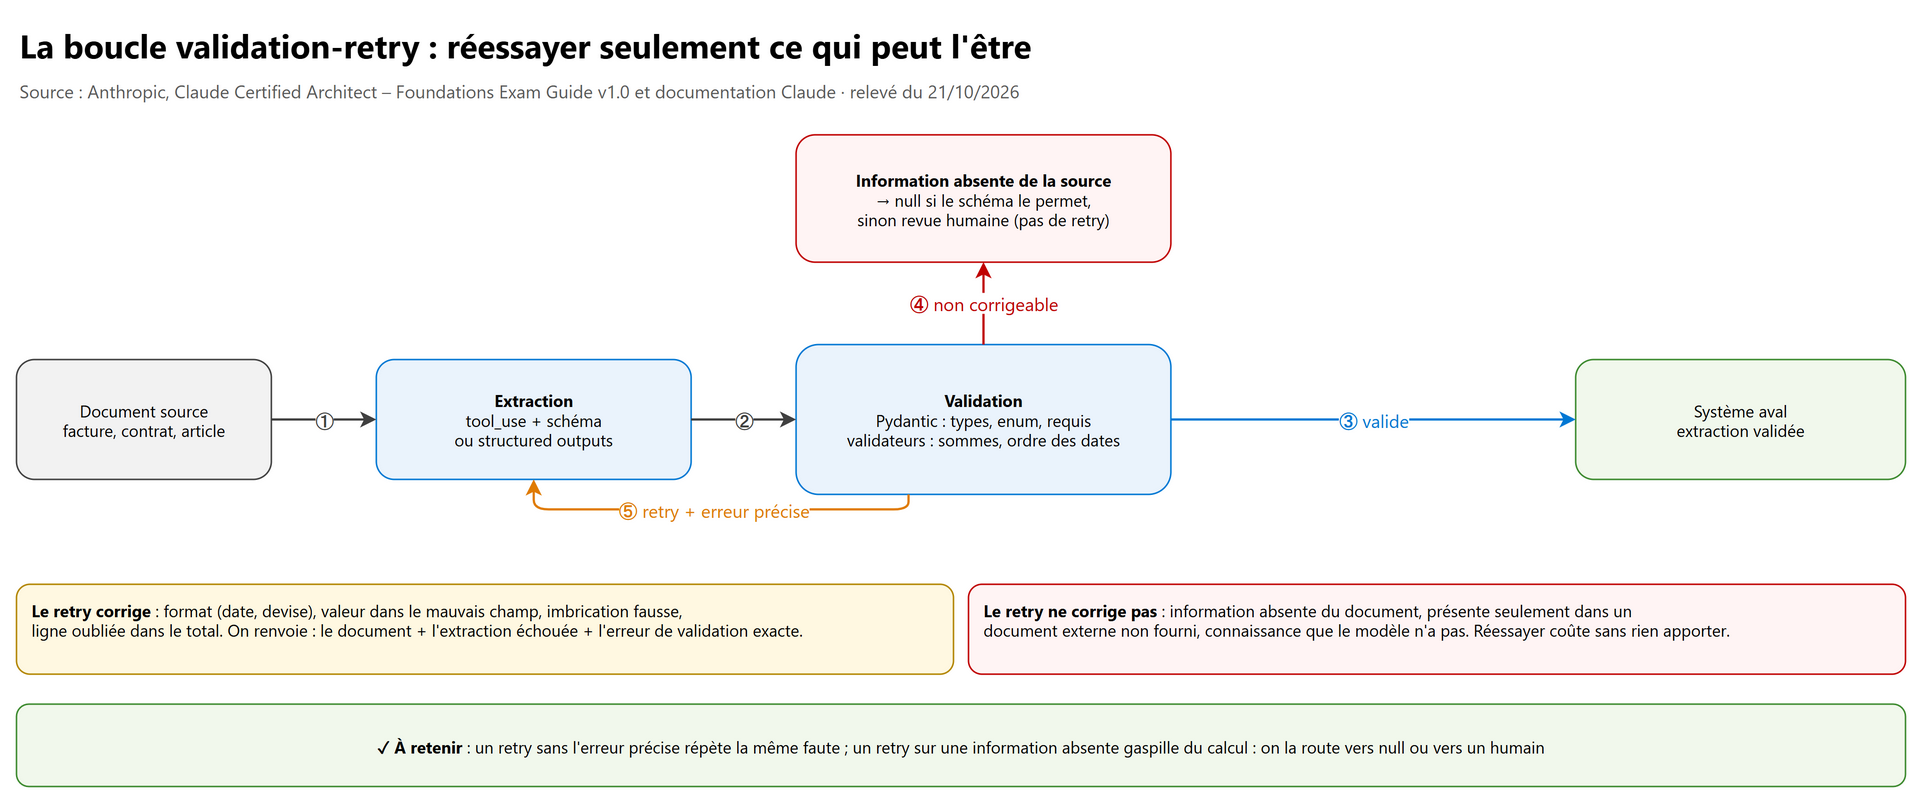
Un bon retry renvoie trois choses : le document original, l'extraction échouée et l'erreur de validation précise. Sans l'erreur précise, le modèle refait généralement la même faute.
| Le retry fonctionne | Le retry ne fonctionne pas |
|---|---|
| format (date, devise, notation) | information absente du document |
| valeur rangée dans le mauvais champ | information présente seulement dans un document externe non fourni |
| imbrication ou structure fausse | connaissance que le modèle n'a pas |
| ligne oubliée qui fausse le total | — dans ces cas : null si le schéma le permet, sinon revue humaine |
from pydantic import BaseModel, ValidationError, model_validator

class LineItem(BaseModel):
    label: str
    amount: float

class InvoiceCheck(BaseModel):
    invoice_number: str
    due_date: str | None = None
    category: str
    category_detail: str | None = None
    line_items: list[LineItem]
    stated_total: float
    calculated_total: float
    conflict_detected: bool

    @model_validator(mode="after")
    def check_totals(self):
        # règle sémantique qu'aucun JSON schema ne peut exprimer
        total = round(sum(item.amount for item in self.line_items), 2)
        if abs(total - self.stated_total) > 0.01:
            raise ValueError(f"sum(line_items) = {total} but stated_total = {self.stated_total}: re-check the line items")
        return self

def extract(invoice_text: str, max_retries: int = 2) -> InvoiceCheck | None:
    messages = [{"role": "user", "content": f"<document>\n{invoice_text}\n</document>"}]
    for attempt in range(max_retries + 1):
        response = client.messages.create(
            model="claude-haiku-5-5", max_tokens=4096, tools=[extract_invoice],
            tool_choice={"type": "tool", "name": "extract_invoice"}, messages=messages,
        )
        call = next(block for block in response.content if block.type == "tool_use")
        try:
            return InvoiceCheck.model_validate(call.input)
        except ValidationError as error:
            # le document reste dans l'historique ; on ajoute l'extraction échouée et l'erreur exacte
            messages += [
                {"role": "assistant", "content": response.content},
                {"role": "user", "content": [{"type": "tool_result", "tool_use_id": call.id, "is_error": True,
                                              "content": f"Validation failed: {error}. Fix the extraction from the document."}]},
            ]
    return None   # toujours invalide après les retries : revue humaine
sequenceDiagram
    participant App as Application
    participant C as Claude
    participant V as Validation (Pydantic)
    participant H as Revue humaine
    App->>C: document + outil extract_invoice
    C-->>App: tool_use.input
    App->>V: model_validate
    V-->>App: erreur précise (totaux incohérents)
    App->>C: document + extraction échouée + erreur exacte
    C-->>App: extraction corrigée
    App->>V: model_validate
    alt valide
        V-->>App: OK, envoi au système aval
    else toujours invalide ou information absente
        App->>H: dossier signalé, sans nouveau retry
    end
État actuel :
client.messages.parse()renvoie une instance Pydantic validée (parsed_output) etstrict: truegarantit la conformité au schéma côté serveur. Ni l'un ni l'autre ne remplace les règles métier : la plateforme applique le schéma, vos validateurs appliquent le fond.
5.3 Concevoir l'auto-correction dans le schéma#
calculated_totalà côté destated_total(et un indicateur d'écart) : l'extraction se contrôle elle-même.conflict_detected: la source contient deux valeurs contradictoires (deux délais de paiement) ; on le signale au lieu d'en choisir une. Retenter ou choisir une valeur est un piège : on extrait les deux, on route en revue.detected_patternpour la revue de code : chaque constat dit quel motif de code l'a déclenché. En analysant les constats rejetés par les développeurs par motif, on sait quel critère affiner. C'est la boucle de feedback attendue par le guide.
6. Le traitement par lots avec la Message Batches API (4.5)#
6.1 Les faits#
| Élément | Valeur (doc) |
|---|---|
| Coût | -50 % sur tous les jetons |
| Délai | la plupart des lots finissent en moins d'1 h ; au plus 24 h ; aucun SLA de latence |
| Taille | 100 000 requêtes ou 256 MB par lot, la première limite atteinte |
| Résultats | fichier JSONL, dans un ordre quelconque : on les relie par custom_id |
custom_id |
unique, 1 à 64 caractères alphanumériques, - ou _ |
| Types de résultat | succeeded, errored, canceled, expired (les trois derniers ne sont pas facturés) |
| Conservation | résultats téléchargeables 29 jours après la création |
| Non supporté | stream: true, fast mode (speed), max_tokens: 0 |
6.2 Synchrone ou lot#
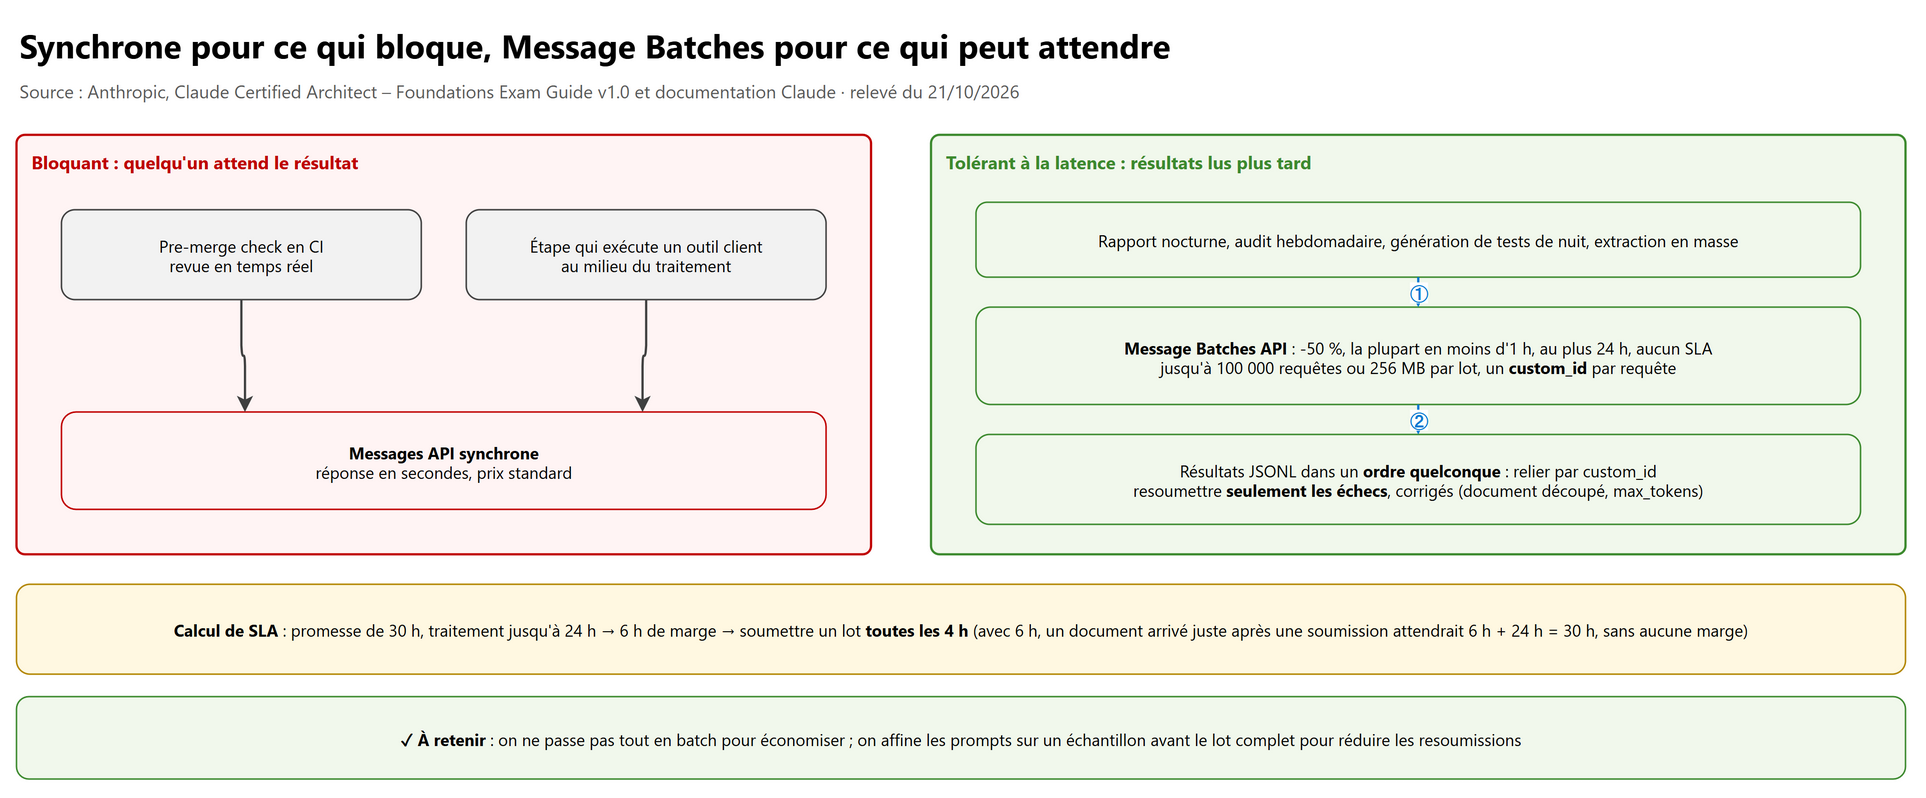
| Charge | API |
|---|---|
| Pre-merge check, revue en direct, tout ce qui fait attendre quelqu'un | synchrone |
| Rapport nocturne de dette technique, audit hebdomadaire, génération de tests de nuit, extraction en masse | Message Batches |
| Étape qui exécute un outil client au milieu du traitement | synchrone (ou outil exécuté avant / entre deux lots) |
Réponse d'examen : le lot ne supporte pas le tool calling multi-tours dans une requête (on ne peut pas exécuter un outil en cours de requête et renvoyer son résultat). État actuel : les server tools (web search, web fetch, code execution, MCP connector…) fonctionnent dans un lot ; pour un client tool, la requête s'arrête sur
tool_useet il faut une requête de suite.
6.3 Calculer la fréquence de soumission#
Le délai de traitement à prévoir est 24 h (c'est un maximum, pas une promesse). Pour une promesse de 30 h : 30 - 24 = 6 h de marge ; un document qui arrive juste après une soumission attend la suivante. Avec une soumission toutes les 4 h, il attend au plus 4 h + 24 h = 28 h ; toutes les 6 h ne laisse aucune marge (6 + 24 = 30). Règle : intervalle + 24 h < SLA, avec de la marge.
6.4 Gérer les échecs et réduire les resoumissions#
- Affiner les prompts sur un échantillon (5 à 10 documents représentatifs) avant le lot complet : sur 1 000 documents, un taux de réussite de 90 % fait 100 resoumissions, 60 % en fait 400.
- Identifier les échecs par
custom_id(errored,expired…). - Resoumettre seulement les échecs, modifiés : document découpé s'il dépassait le contexte,
max_tokensplus grand, exemple ajouté. Resoumettre tout le lot fait repayer ce qui avait réussi.
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request

batch = client.messages.batches.create(requests=[
    Request(custom_id=f"invoice-{doc_id}", params=MessageCreateParamsNonStreaming(
        model="claude-haiku-5-5", max_tokens=4096, tools=[extract_invoice],
        tool_choice={"type": "tool", "name": "extract_invoice"},
        messages=[{"role": "user", "content": f"<document>\n{text}\n</document>"}]))
    for doc_id, text in documents.items()
])

# plus tard (au plus 24 h) : on relit le lot, puis ses résultats par custom_id
batch = client.messages.batches.retrieve(batch.id)
if batch.processing_status == "ended":
    failed = []
    for item in client.messages.batches.results(batch.id):
        if item.result.type == "succeeded":
            save(item.custom_id, item.result.message)
        else:                                   # errored, canceled, expired
            failed.append(item.custom_id)       # à resoumettre après correction, et elles seules
stateDiagram-v2
    [*] --> in_progress: batches.create
    in_progress --> ended: toutes les requêtes traitées ou 24 h écoulées
    in_progress --> canceling: batches.cancel
    canceling --> ended
    ended --> [*]: résultats lus par custom_id (29 jours)
7. Revue multi-instance et multi-passes (4.6)#
7.1 Les limites de l'auto-revue#
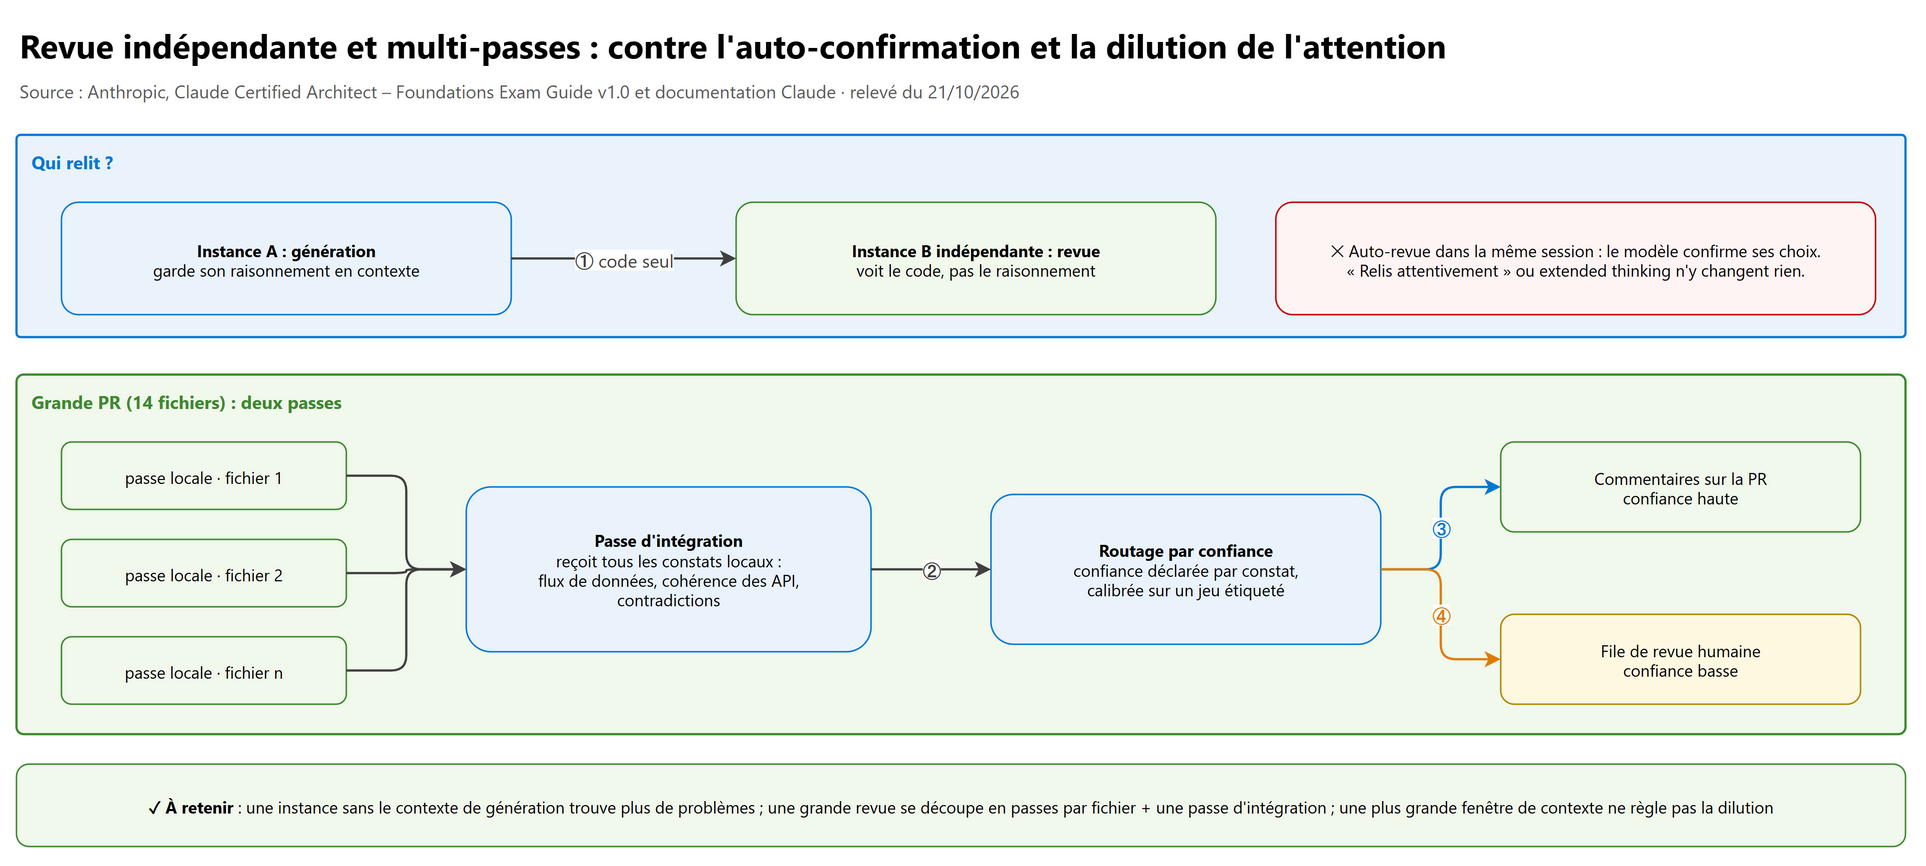
Un modèle qui relit sa propre production dans la même session garde son raisonnement de génération : il a tendance à confirmer ses choix. D'après le guide, une instance indépendante (sans ce contexte) trouve plus de problèmes subtils que des consignes d'auto-revue (« relis attentivement ») ou que l'extended thinking.
7.2 La revue multi-passes#
Une seule passe sur une grande PR dilue l'attention : commentaires détaillés sur certains fichiers et superficiels sur d'autres, bugs évidents manqués, conclusions contradictoires pour un même motif. Solution du guide :
- passes locales par fichier, avec un prompt ciblé (lancées en parallèle) ;
- passe d'intégration séparée, qui reçoit tous les constats locaux et vérifie les flux de données entre fichiers, la cohérence des API et les contradictions.
Une plus grande fenêtre de contexte ne règle pas le problème (c'est une question d'attention, pas de taille), et découper les PR n'est pas une réponse d'architecture.
7.3 Une instance indépendante en pratique#
def review_file(path: str, diff: str) -> str:
    # nouvelle requête, sans l'historique de génération : c'est l'instance indépendante
    response = client.messages.create(
        model="claude-opus-5-5", max_tokens=16000, system=REVIEW_SYSTEM_PROMPT,
        messages=[{"role": "user", "content": f"<file path=\"{path}\">\n{diff}\n</file>"}],
    )
    return next(block.text for block in response.content if block.type == "text")

def review_integration(local_findings: dict[str, str]) -> str:
    findings = "\n".join(f"<findings file=\"{p}\">\n{f}\n</findings>" for p, f in local_findings.items())
    response = client.messages.create(
        model="claude-opus-5-5", max_tokens=16000, system=INTEGRATION_SYSTEM_PROMPT,
        messages=[{"role": "user", "content": findings}],
    )
    return next(block.text for block in response.content if block.type == "text")
Dans Claude Code en CI (claude -p), c'est le même principe : la revue est faite par une autre instance que celle qui a généré
le code (03-claude-code.md).
7.4 Router par une confiance calibrée#
Une passe de vérification peut faire déclarer à Claude une confiance par constat : forte confiance → commentaire sur la PR, faible confiance → file de revue humaine. Une confiance brute est mal calibrée : on la calibre d'abord sur un jeu étiqueté avant de s'en servir pour router automatiquement (détail au domaine 5, 05-context-reliability.md).
8. Labs conseillés#
Prérequis : une clé API Anthropic de test dans ANTHROPIC_API_KEY (jamais dans le code), Python 3.10+, pip install anthropic pydantic. Coût : Claude Haiku 5.5 coûte 0,10 $ / 0,50 $ par million de jetons en entrée / sortie (prompts jusqu'à 100 000 jetons),
la moitié dans un lot ; ces labs restent à quelques centimes. Nettoyage : rien à supprimer côté API (les résultats de lot expirent après
29 jours) ; révoquer la clé de test dans la Console à la fin.
Lab 1 · Critères explicites contre consigne vague (30 min)
- Préparer 8 extraits de code : 3 bugs, 2 failles, 3 détails de style ou motifs locaux.
- Les relire avec le prompt « Be conservative. Only report high-confidence findings. », deux fois chacun.
- Refaire avec le prompt du § 2.3.
- Résultat attendu : avec le prompt vague, des classements qui changent d'un appel à l'autre et des détails de style signalés ; avec les critères, les 5 vrais problèmes et pas de style.
Lab 2 · Extraction avec schéma, nullable et retry (45 min)
- Écrire l'outil
extract_invoicedu § 4.2 et la boucle du § 5.2. - Tester 5 factures : 3 complètes, 1 sans date d'échéance, 1 dont une ligne est noyée dans un paragraphe.
- Passer
due_dateen champ obligatoire non nullable et relancer la facture sans date. - Résultat attendu :
nullpour la date absente avec le schéma nullable, une date inventée avec le champ obligatoire ; la ligne noyée est rattrapée au premier retry grâce à l'erreur « sum(line_items) ≠ stated_total ». - Variante état actuel : même extraction avec
client.messages.parse()etclaude-opus-5-5; essayertool_choiceanysurclaude-opus-5-5et constater l'erreur 400.
Lab 3 · Un lot avec reprise par custom_id (30 min, résultat dans l'heure en général)
- Soumettre 20 documents avec le code du § 6.4, dont un volontairement trop long
pour
max_tokens: 256. - Relire les résultats, lister les
custom_iden échec, resoumettre seulement ceux-là avec unmax_tokensplus grand. - Résultat attendu : les résultats arrivent dans le désordre (on ne peut s'appuyer que sur
custom_id), un seul document à resoumettre, coût affiché moitié moindre qu'en synchrone.
Lab 4 · Revue en deux passes par une instance indépendante (45 min)
- Générer avec Claude une petite fonctionnalité sur 3 fichiers, puis lui demander dans la même conversation de relire son code.
- Relire le même code avec
review_file(une requête par fichier) puisreview_integration. - Résultat attendu : la revue indépendante trouve davantage de problèmes, et la passe d'intégration repère l'incohérence inter-fichiers (une signature changée dans un fichier, pas dans l'appelant) que les passes locales ne voient pas.
9. Les pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Ajouter « be conservative » ou « only report high-confidence findings » | Non : des critères catégoriels explicites | Une consigne vague ne crée pas de frontière de décision |
| Un seuil de confiance pour réduire les faux positifs | Non : critères + exemples de code | La confiance auto-déclarée est mal calibrée |
| Une catégorie bruyante fait ignorer toutes les autres | Désactiver la catégorie, la corriger, la réactiver | Restaurer la confiance des développeurs |
| Format incohérent malgré des instructions détaillées | Exemples few-shot | Montrer le format plutôt que le redécrire |
| Ajouter 15 exemples pour couvrir chaque variante | Non : 2 à 4 exemples ciblés, avec raisonnement | Généralisation, coût en jetons |
| Champs vides quand l'info est dans un paragraphe | Few-shot couvrant tableaux et texte narratif | Variété structurelle ; on ne transforme pas les documents |
| JSON mal formé | tool_use + JSON schema | Élimine les erreurs de syntaxe |
| « Le schéma strict garantit une extraction juste » | Faux : syntaxe oui, sémantique non | Totaux faux, valeurs mal placées : validation |
| Le modèle invente des dates absentes, tous les champs sont obligatoires | Rendre ces champs nullable | Un champ obligatoire absent force l'invention |
| Plusieurs schémas d'extraction, type de document inconnu | tool_choice: "any" |
auto peut répondre en texte |
| Une extraction de métadonnées doit tourner avant l'enrichissement | Outil forcé {"type": "tool", "name": ...} |
Impose l'étape |
| Retry sans l'erreur de validation | Non : document + extraction échouée + erreur précise | Sinon il répète la même faute |
| Retry pour une information absente du document | Non : null ou revue humaine |
Le retry ne crée pas d'information |
| Deux valeurs contradictoires dans la source | Extraire les deux / conflict_detected, router en revue |
Ne pas choisir silencieusement |
| Passer tous les flux en batch pour économiser 50 % | Non : batch seulement pour ce qui peut attendre | Pas de SLA, jusqu'à 24 h |
| Associer les résultats d'un lot par leur position | Non : par custom_id |
Ordre quelconque |
| Resoumettre tout le lot après quelques échecs | Non : seulement les échecs, corrigés | On repaierait ce qui a réussi |
| Le générateur relit son propre code dans la même session | Instance indépendante | Il garde son raisonnement et confirme ses choix |
| Revue incohérente d'une PR de 14 fichiers | Passes par fichier + passe d'intégration | Dilution de l'attention |
| Un modèle à plus grande fenêtre de contexte pour la revue | Non | Problème d'attention, pas de taille |
10. Scénarios d'entraînement#
1. Votre revue de code en CI signale 35 % de faux positifs dans la catégorie « performance ». Les développeurs ignorent désormais tous les commentaires, y compris les failles de sécurité justes. Le budget ne permet pas de deuxième appel par revue. Que faites-vous ? A. Ajouter « only report high-confidence performance issues » · B. Désactiver temporairement la catégorie « performance » et réécrire son prompt avec des critères explicites et des exemples de code · C. Afficher ces commentaires repliés · D. Ajouter une passe de vérification par un second modèle
B. On restaure la confiance en retirant la source des faux positifs, et des critères explicites corrigent la précision. A est la consigne vague que le guide juge inefficace, C garde les faux positifs visibles, D dépasse le budget.
2. Un extracteur de contrats renvoie des dates de résiliation plausibles alors que beaucoup de contrats n'en ont pas. Le schéma
tool_use rend tous les champs obligatoires. Quelle correction en premier ?
A. Ajouter « n'invente jamais de date » au prompt · B. Revenir à du JSON demandé en texte · C. Rendre termination_date nullable ·
D. Valider après coup et rejeter les dates suspectes
C. Un champ obligatoire absent force l'invention ; nullable permet un
nullhonnête tout en gardant le schéma. A ne traite pas la cause, B perd la garantie de syntaxe, D détecte sans empêcher.
3. Un pipeline reçoit des factures, des bons de commande et des avoirs, sans savoir lequel. Trois outils d'extraction existent, un
par type. Vous devez garantir une sortie structurée. Selon le guide, quel tool_choice ?
A. auto · B. any · C. {"type": "tool", "name": "extract_invoice"} · D. aucun outil, du JSON en texte
B.
anyoblige à appeler un outil tout en laissant le modèle choisir le bon. A peut répondre en texte, C force le mauvais schéma pour deux types sur trois. État actuel : sur Claude Opus 5.5 ou Sonnet 5.5,anyrenvoie 400 ; on utiliseraitauto+strict: true+ vérification de la présence dutool_use.
4. Deux échecs de validation : sur le document A, la somme des lignes (1 180 €) diffère du total indiqué (1 250 €) ; sur le
document B, le numéro de commande n'apparaît nulle part dans le texte. Le temps humain est limité. Quelle stratégie ?
A. Réessayer A et B avec le même prompt · B. Envoyer A et B en revue humaine · C. Réessayer A avec l'erreur d'écart, et envoyer B en
revue (ou null) · D. Réessayer B en demandant de mieux chercher le numéro
C. L'écart de A est probablement une ligne oubliée, présente dans le document : corrigeable. L'information de B est absente : un retry ne la créera pas. A et D gaspillent du calcul, B gaspille du temps humain.
5. Votre manager veut passer à la Message Batches API la revue pré-merge des PR et l'audit hebdomadaire de sécurité du dépôt, pour l'économie de 50 %. Votre avis ? A. Les deux, avec un repli synchrone si le lot tarde · B. L'audit hebdomadaire seulement · C. Les deux, en interrogeant le statut toutes les minutes · D. Aucun, à cause de l'ordre des résultats
B. La revue pré-merge bloque un développeur et le lot n'a aucune garantie de délai (jusqu'à 24 h). L'audit hebdomadaire peut attendre. A et C ne règlent pas la latence, D renonce à une économie légitime (l'ordre se gère avec
custom_id).
6. Vous promettez les résultats d'extraction sous 36 h et traitez avec la Message Batches API. À quelle fréquence soumettre un lot, au minimum ? A. Toutes les 24 h · B. Toutes les 12 h · C. Toutes les 8 h · D. Une seule fois par jour, la nuit
C. Pire cas : intervalle + 24 h. Avec 12 h, 12 + 24 = 36 h sans aucune marge ; avec 8 h, 32 h et 4 h de marge. A et D dépassent la promesse.
7. Sur un lot de 1 000 documents, 40 reviennent en errored : ils dépassaient la fenêtre de contexte. Que faites-vous ?
A. Resoumettre le lot entier · B. Resoumettre ces 40 documents, identifiés par custom_id, découpés en morceaux · C. Les traiter en
synchrone sans modification · D. Augmenter max_tokens et resoumettre le lot entier
B. On ne repaie pas les 960 réussis, et on corrige la cause (le document trop long) au lieu de renvoyer à l'identique.
8. Votre agent de génération de code relit son propre code dans la même conversation avant de l'ouvrir en PR, puis la PR est fusionnée avec des bugs. Quelle est la meilleure amélioration ? A. Ajouter « relis très attentivement et sois critique » · B. Activer davantage de réflexion pendant la génération · C. Confier la revue à une seconde instance de Claude, sans le contexte de génération · D. Demander au générateur une note de confiance
C. Une instance indépendante n'est pas biaisée par le raisonnement de génération. A et B gardent ce raisonnement en contexte, D donne une confiance mal calibrée.
9. Une PR de 22 fichiers reçoit une revue inégale : très détaillée sur les premiers fichiers, superficielle ensuite, avec deux conclusions contradictoires sur le même motif. Quelle architecture ? A. Un modèle avec une plus grande fenêtre de contexte · B. Trois passes complètes et garder les constats vus deux fois · C. Une passe locale par fichier, puis une passe d'intégration inter-fichiers · D. Limiter les PR à 5 fichiers
C. Profondeur constante par fichier, et une passe dédiée aux interactions entre fichiers. A ne règle pas l'attention, B garde la dilution, D contourne le problème sans l'architecturer.
10. Un extracteur trouve les dimensions d'un produit dans les tableaux, mais laisse le champ vide quand le fabricant écrit « environ quarante centimètres de large » dans un paragraphe. Les documents doivent rester intacts. Première chose à faire ? A. Ajouter 2 ou 3 exemples few-shot montrant une extraction depuis un tableau et depuis un texte narratif · B. Convertir les paragraphes en tableaux avant l'appel · C. Retenter quand le champ est vide · D. Passer à un modèle plus grand
A. La variété structurelle et les mesures informelles se traitent par des exemples ciblés. B modifie les documents (interdit), C ne traite pas la cause, D n'est pas la première action.
11. Pour aller plus loin (hors examen)#
- Prompt caching : à l'examen, il suffit de savoir qu'il existe. En pratique,
cache_controlmet en cache un préfixe stable (system prompt, exemples, schémas) ; les lectures en cache coûtent environ un dixième du prix d'entrée. Dans un lot, la doc conseille la durée de cache d'1 heure et des blocscache_controlidentiques dans toutes les requêtes (doc). - Plus de préremplissage : sur les modèles récents (Opus 5.5, Sonnet 5.5, Fable 5.1, Haiku 5.5…), préremplir la réponse de l'assistant renvoie une erreur 400 ; pour imposer un format, on utilise les structured outputs ou des consignes.
- Adaptive thinking et
effort: sur les modèles actuels, la profondeur de réflexion se règle paroutput_config: {"effort": ...};budget_tokensest refusé. Un exemple few-shot présenté comme « problème, méthode, réponse » guide aussi la réflexion du modèle. - Chaînage de prompts pour l'auto-correction : la doc décrit le motif « brouillon → revue selon des critères → correction », chaque étape étant un appel séparé que l'on peut journaliser et évaluer.
12. Fiche à retenir#
- Critères catégoriels (signaler / ignorer) et sévérités illustrées par du code, pas « be conservative » ni un seuil de confiance.
- Catégorie bruyante : désactiver, corriger, mesurer, réactiver (confiance des développeurs).
- Few-shot = la technique pour la cohérence : 2 à 4 exemples ciblés sur les cas ambigus, avec le raisonnement (doc actuelle : 3 à 5).
- Balises XML :
<instructions>,<examples>/<example>,<document>. - Tool use + JSON schema : plus d'erreur de syntaxe, mais pas de garantie sémantique.
-
tool_choice:auto(peut répondre en texte),any(un outil au choix), outil nommé (cette étape),none; par requête. - État actuel : Opus 5.5, Sonnet 5.5, Fable 5.1 refusent
any/ outil forcé →auto+strict: true, ououtput_config.format. - Schéma : required seulement si toujours présent ; nullable contre l'invention ; enum
"other"+ détail,"unclear"; normalisation dans le prompt. - Retry = document + extraction échouée + erreur précise ; inutile si l'information est absente →
nullou humain. -
calculated_total/stated_total,conflict_detected,detected_patternpour l'auto-contrôle et l'analyse des rejets. - Message Batches API : -50 %, ≤ 24 h, aucun SLA, ordre quelconque →
custom_id; 100 000 requêtes / 256 MB ; 29 jours. - Synchrone pour ce qui bloque, lot pour ce qui attend ; intervalle de soumission + 24 h < SLA.
- Échecs d'un lot : resoumettre seulement ceux-là, corrigés ; affiner le prompt sur un échantillon d'abord.
- Revue par une instance indépendante ; grande PR = passes par fichier + passe d'intégration ; confiance calibrée avant de router.
Références#
Lues le 21/10/2026 :
- Claude Certified Architect – Foundations Exam Guide v1.0 (juillet 2026), Anthropic (domaine 4, scénarios 5 et 6, exercice 3, listes In-Scope / Out-of-Scope)
- Partner certifications, Anthropic Partner Academy
- Prompt engineering overview
- Prompting best practices (clarté, contexte, exemples, balises XML, rôle, chaînage)
- Structured outputs
- Define tools, forcing tool use
- Tool use overview
- Batch processing (Message Batches API)
- Messages API reference
- Models overview
- Prompt caching (existence seulement, hors examen)
- Pydantic documentation
- claudecertificationguide.com, domaine 4 (leçons 4.1 à 4.6, base du chapitre, site tiers)