

Version : 1.1 · Date : 2026-10-21 · Parcours AKS, niveau architecte (entretiens)
En une phrase : Kubernetes est un moteur de réconciliation (on lui décrit l'état voulu, il le fait exister et le maintient), et AKS est ce moteur avec son control plane opéré par Microsoft : toi, tu gardes les nodes, le réseau, l'identité et tes charges de travail.
| Chapitre du parcours | Sujet |
|---|---|
| 01-architecture (ce fichier) | Kubernetes pour un architecte, ce qu'AKS gère, anatomie d'un cluster, topologies de référence |
| 02-reseau | CNI (Overlay, Cilium), Services, entrée, sortie, Private cluster, DNS |
| 03-identite-securite | Microsoft Entra ID, RBAC, Workload Identity, secrets, policies, Defender for Containers |
| 04-stockage-scalabilite-fiabilite | Volumes, autoscaling, availability zones, upgrades |
| 05-exploitation-gitops | Monitoring, GitOps, Fleet Manager, coûts |
| 06-ia-llm | GPU, KAITO, inférence de LLM, intégration Foundry |
| 07-conteneurs-azure-et-entretiens | AKS ou Container Apps, App Service, ACI ; questions d'entretien |
La sécurité d'AKS vue « examen » est aussi traitée dans le cours SC-500 : 09-services-applicatifs.
1. Pourquoi des conteneurs, et pourquoi un orchestrateur#
Un conteneur embarque une application et ses dépendances dans une image immuable ; il partage le noyau de l'hôte (pas d'OS invité comme une VM), démarre en secondes et se comporte pareil partout. Le problème arrive avec le nombre : 200 conteneurs sur 20 machines, qui doivent redémarrer quand ils tombent, se répartir la charge, se trouver entre eux, monter en version sans coupure. C'est le rôle de l'orchestrateur.
| Ce que fait Kubernetes | Comment |
|---|---|
| Placer les conteneurs sur les machines | Le scheduler choisit un node selon les ressources demandées et les contraintes |
| Réparer | Les controllers recréent un pod disparu, le kubelet redémarre un conteneur qui échoue sa probe |
| Mettre à l'échelle | Nombre de replicas manuel ou automatique (HPA, KEDA), nodes ajoutés par le cluster autoscaler |
| Déployer sans coupure | Rolling update et rollback d'un Deployment |
| Se trouver entre services | Service : IP et nom DNS stables devant des pods éphémères |
| Injecter configuration et secrets | ConfigMap, Secret, volumes |
Phrase d'entretien : « Kubernetes n'exécute pas des commandes, il converge vers un état déclaré. Tout le reste (auto-réparation, scaling, déploiements) découle de cette boucle de réconciliation. »
2. Kubernetes en 15 minutes pour un architecte#
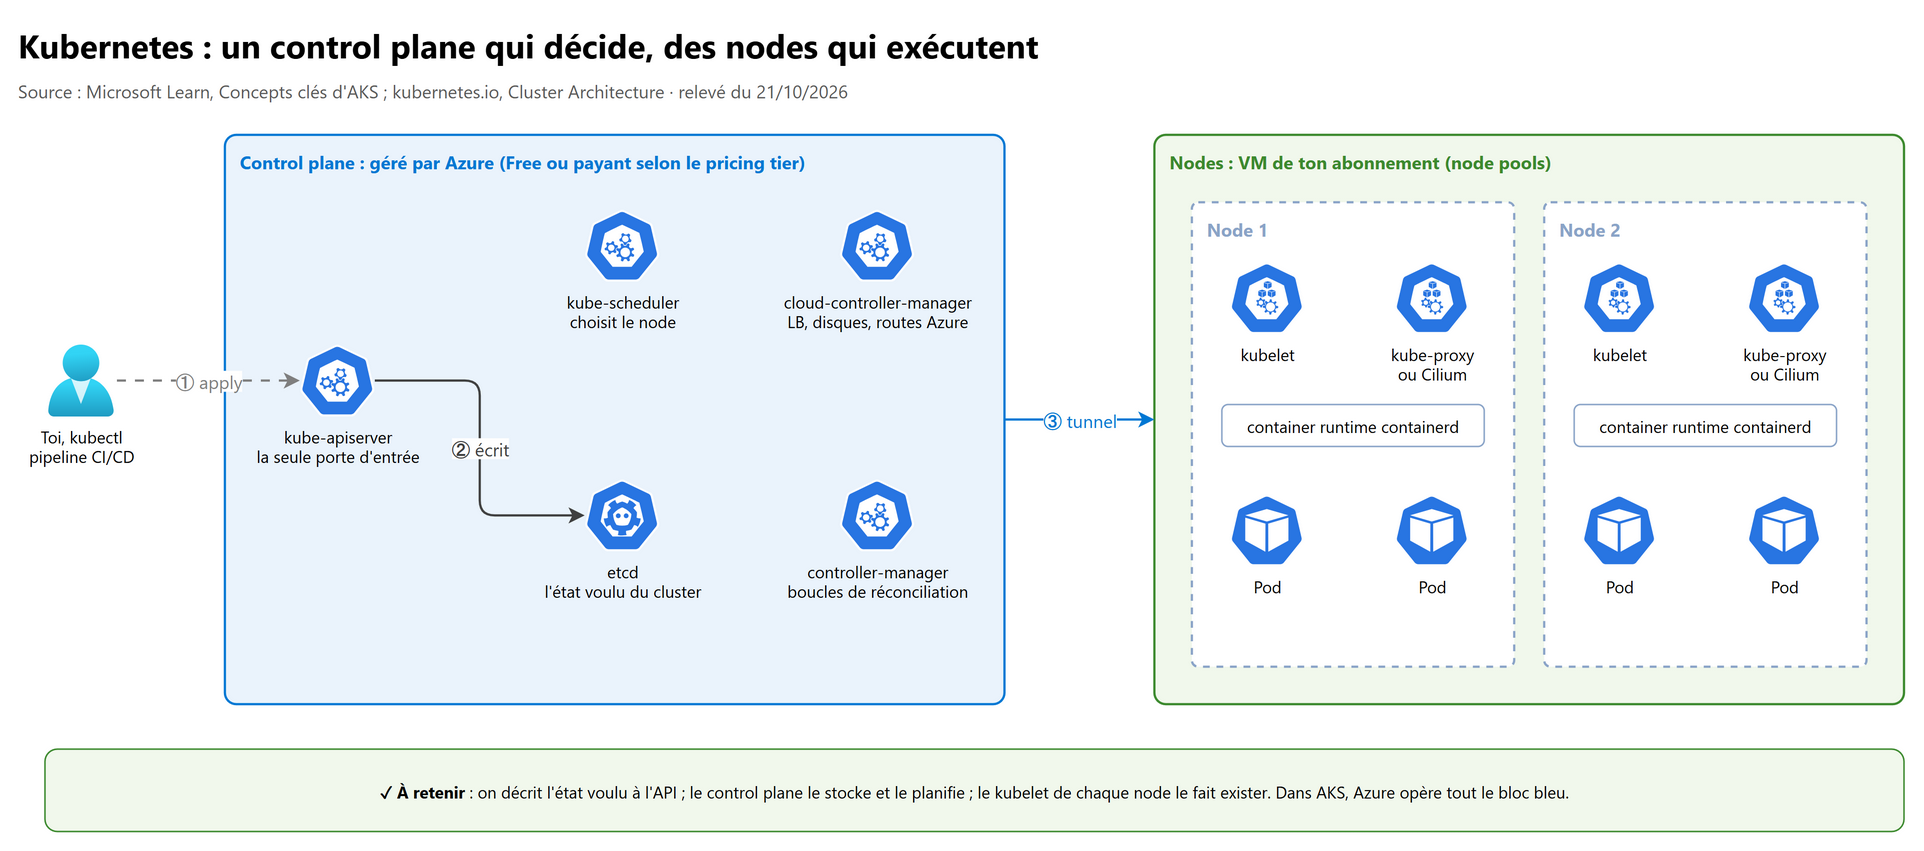
2.1 Le control plane#
| Composant | Rôle | Point d'architecture |
|---|---|---|
kube-apiserver |
Expose l'API Kubernetes : tout passe par lui (kubectl, controllers, kubelet) | Sa disponibilité = celle du pilotage du cluster ; c'est lui que couvre le SLA AKS |
etcd |
Magasin clé-valeur qui garde l'état et la configuration du cluster | Dans AKS, géré et sauvegardé par Microsoft (toutes les 30 minutes) |
kube-scheduler |
Surveille les pods sans node et leur choisit un node | Décide selon requests, affinités, taints, zones |
kube-controller-manager |
Exécute les boucles de contrôle (node en panne, replicas, etc.) | Le cœur de l'auto-réparation |
cloud-controller-manager |
Logique propre au cloud : Azure Load Balancer, disques, routes | C'est lui qui configure un Azure Load Balancer quand tu déclares un Service LoadBalancer |
2.2 Les nodes#
| Composant | Rôle |
|---|---|
kubelet |
Agent du node : garantit que les conteneurs décrits tournent dans leurs pods, exécute les probes |
kube-proxy ou Cilium |
Règles réseau des Services sur le node ; avec Azure CNI Powered by Cilium, Cilium remplace kube-proxy |
| Container runtime | containerd sur AKS (Linux depuis Kubernetes 1.19 ; seul runtime Windows depuis 1.23) |
2.3 Le modèle déclaratif et la boucle de réconciliation#
flowchart LR
    A["Manifeste YAML<br/>état voulu : 3 replicas"] -->|kubectl apply| B["API server"]
    B --> C[("etcd<br/>état voulu stocké")]
    D["Controller"] -->|observe| B
    D --> E{"État réel =<br/>état voulu ?"}
    E -- Oui --> D
    E -- "Non : 2 pods seulement" --> F["Crée le pod manquant<br/>via l'API"]
    F --> D
Ce que donne kubectl apply -f deploy.yaml, de bout en bout :
sequenceDiagram
    actor U as Toi
    participant API as API server
    participant E as etcd
    participant C as Controllers
    participant S as Scheduler
    participant K as kubelet du node
    U->>API: apply Deployment (3 replicas)
    API->>E: enregistre l'objet
    C->>API: crée le ReplicaSet puis 3 Pods (sans node)
    S->>API: affecte chaque Pod à un node
    K->>API: voit un Pod qui lui est affecté
    K->>K: containerd tire l'image, démarre le conteneur
    K->>API: Pod Running, readiness probe OK
    Note over API: le Service ajoute le Pod à ses endpoints
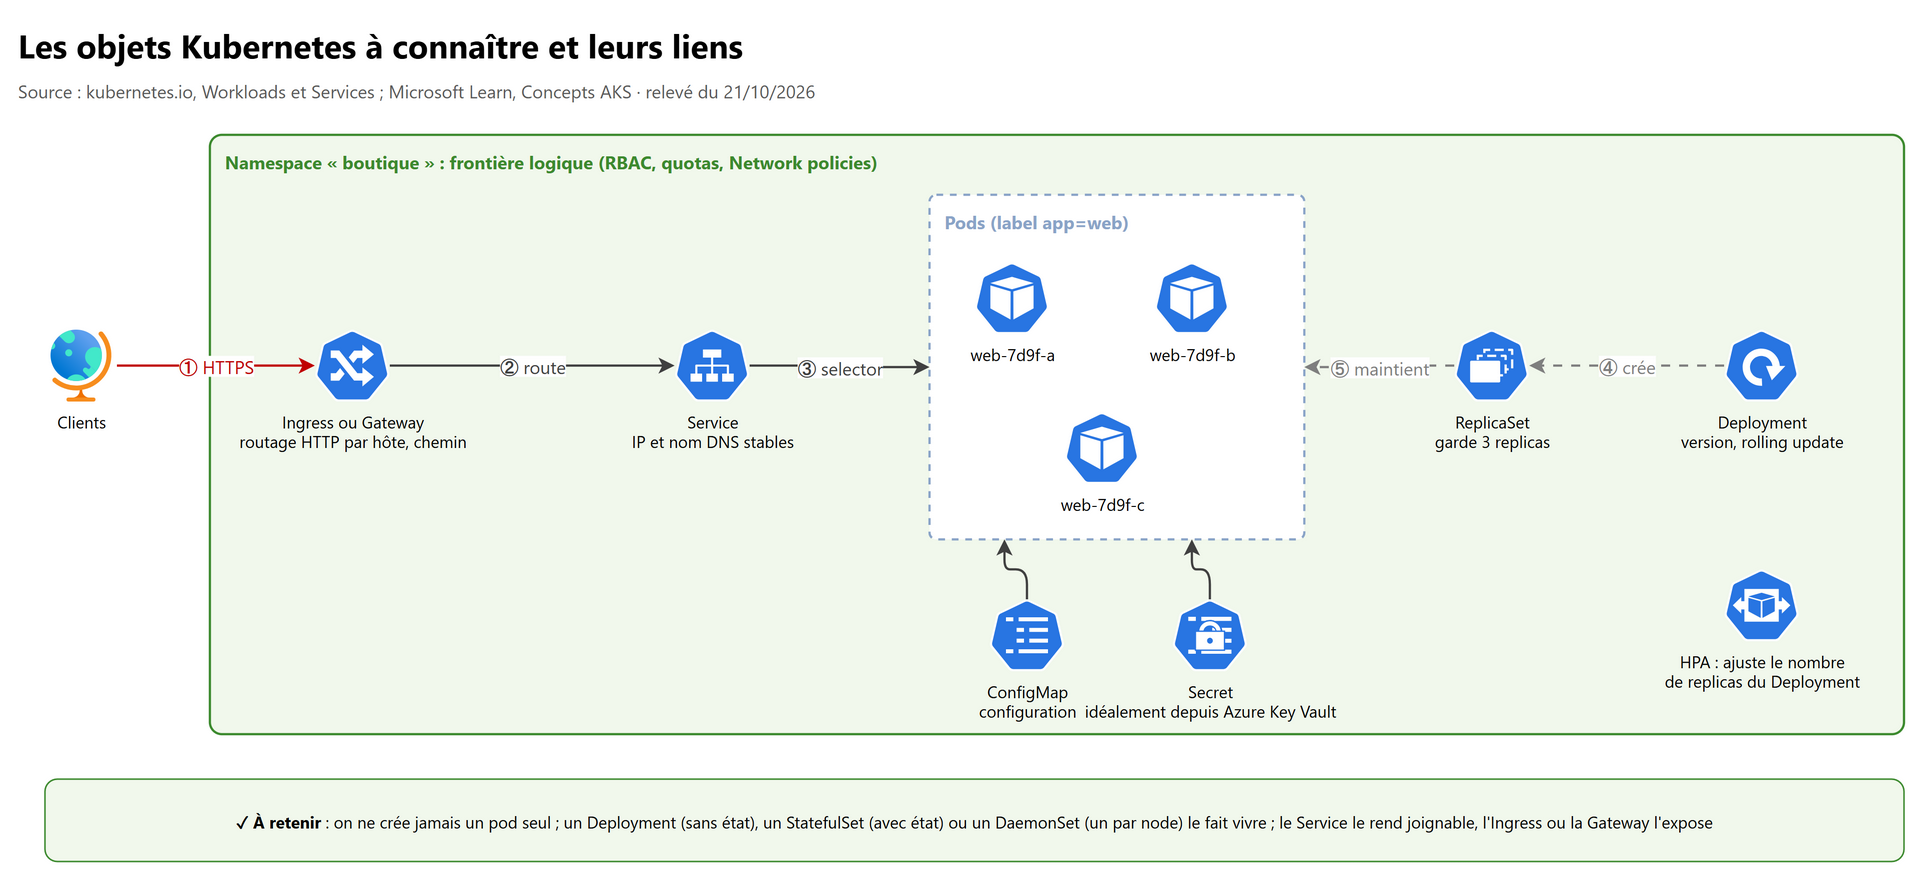
2.4 Les objets à connaître#
| Objet | À quoi il sert | Quand le choisir |
|---|---|---|
| Pod | Un ou plusieurs conteneurs qui partagent réseau et stockage | Jamais seul : toujours via un controller |
| ReplicaSet | Maintient N pods identiques | Créé par le Deployment, on n'y touche pas |
| Deployment | Versionne les pods sans état, rolling update, rollback | Web, API, workers sans état |
| StatefulSet | Pods ordonnés avec nom réseau et stockage stables | Bases de données, files, tout ce qui a une identité |
| DaemonSet | Un pod par node (ou par node sélectionné) | Agents de logs, de monitoring, de sécurité |
| Job / CronJob | Tâche qui se termine / tâche planifiée | Batch, migrations, purges |
| Service | IP virtuelle et DNS stables devant des pods choisis par label selector | Toujours, dès qu'un pod doit être joint |
| Ingress / Gateway API | Routage HTTP(S) par hôte et chemin vers des Services | Exposition web ; la Gateway API est le successeur moderne d'Ingress |
| ConfigMap / Secret | Configuration et données sensibles injectées en variables ou fichiers | Un Secret Kubernetes n'est qu'encodé en base64 : en production, Azure Key Vault (chapitre 03) |
| Namespace | Frontière logique : RBAC, quotas, Network policies | Par équipe, application ou environnement |
Trois mécanismes reviennent partout :
- Labels et selectors : le Service ne connaît pas les pods par leur nom mais par
app=web; c'est ce couplage faible qui permet de remplacer les pods à volonté. - Requests et limits : la request sert au scheduler (place réservée), la limit plafonne la consommation. Sans requests, le scheduler place à l'aveugle et le cluster autoscaler ne peut pas raisonner.
- Probes : readiness (prêt à recevoir du trafic, sinon retiré du Service), liveness (vivant, sinon redémarré), startup (laisse le temps de démarrer avant les deux autres).
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
  namespace: boutique
spec:
  replicas: 3
  selector:
    matchLabels: { app: web }          # doit correspondre aux labels du modèle
  template:
    metadata:
      labels: { app: web }
    spec:
      containers:
        - name: web
          image: monacr.azurecr.io/web:1.4.2   # une version précise, jamais « latest »
          ports: [{ containerPort: 8080 }]
          resources:
            requests: { cpu: 250m, memory: 256Mi }   # sert au placement
            limits:   { memory: 512Mi }              # plafond (OOMKill au-delà)
          readinessProbe: { httpGet: { path: /ready, port: 8080 } }
          livenessProbe:  { httpGet: { path: /health, port: 8080 } }
---
apiVersion: v1
kind: Service
metadata:
  name: web
  namespace: boutique
spec:
  selector: { app: web }
  ports: [{ port: 80, targetPort: 8080 }]   # type ClusterIP par défaut : interne au cluster
3. Ce qu'AKS gère, et ce qui reste à toi#
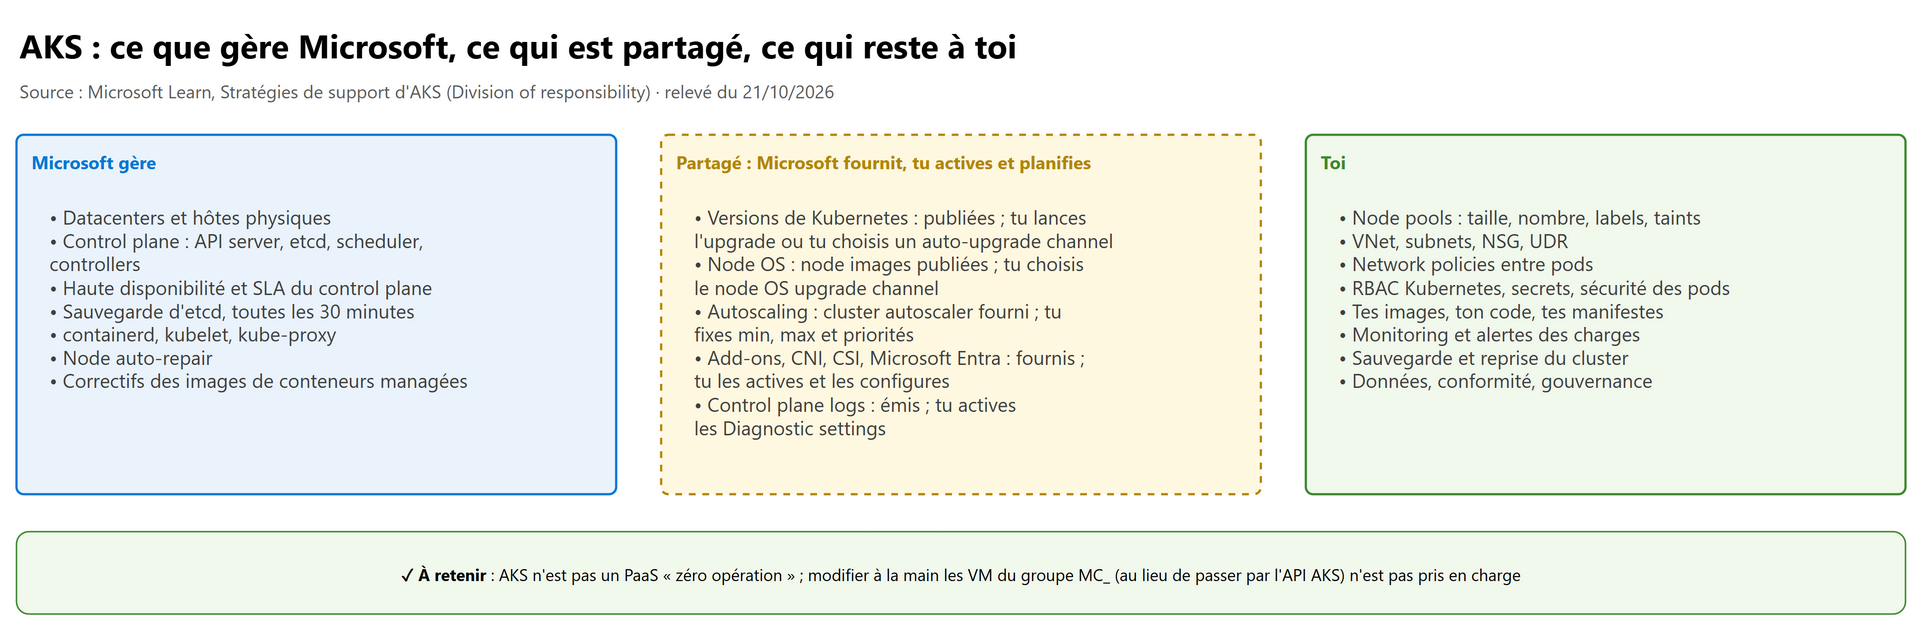
AKS est un mélange d'IaaS et de PaaS : le control plane est entièrement opéré par Microsoft (tu ne le vois pas, il vit dans un abonnement Microsoft), mais les nodes sont des VM de ton abonnement dont tu partages la responsabilité.
- Microsoft : control plane (API server, etcd, scheduler, controllers), sa haute disponibilité et son SLA, la sauvegarde d'etcd, containerd, kubelet, kube-proxy, la node auto-repair.
- Partagé : Microsoft publie les versions et les node images, toi tu déclenches les upgrades ou tu choisis un auto-upgrade channel ; idem pour le cluster autoscaler, les add-ons, le CNI, la Microsoft Entra integration, les control plane logs.
- Toi : node pools, VNet, NSG, UDR, Network policies, RBAC Kubernetes, secrets, sécurité des pods, images, manifestes, monitoring des applications, sauvegarde et reprise du cluster, données et conformité.
Piège classique : les VM des nodes apparaissent dans le portail comme des VM ordinaires, dans un groupe
MC_…. Les modifier directement (extensions, réseau, scale set) n'est pas pris en charge et ne survit pas à un upgrade. Pour personnaliser un node : un DaemonSet, ou l'API AKS.
4. Anatomie d'un cluster AKS dans Azure#
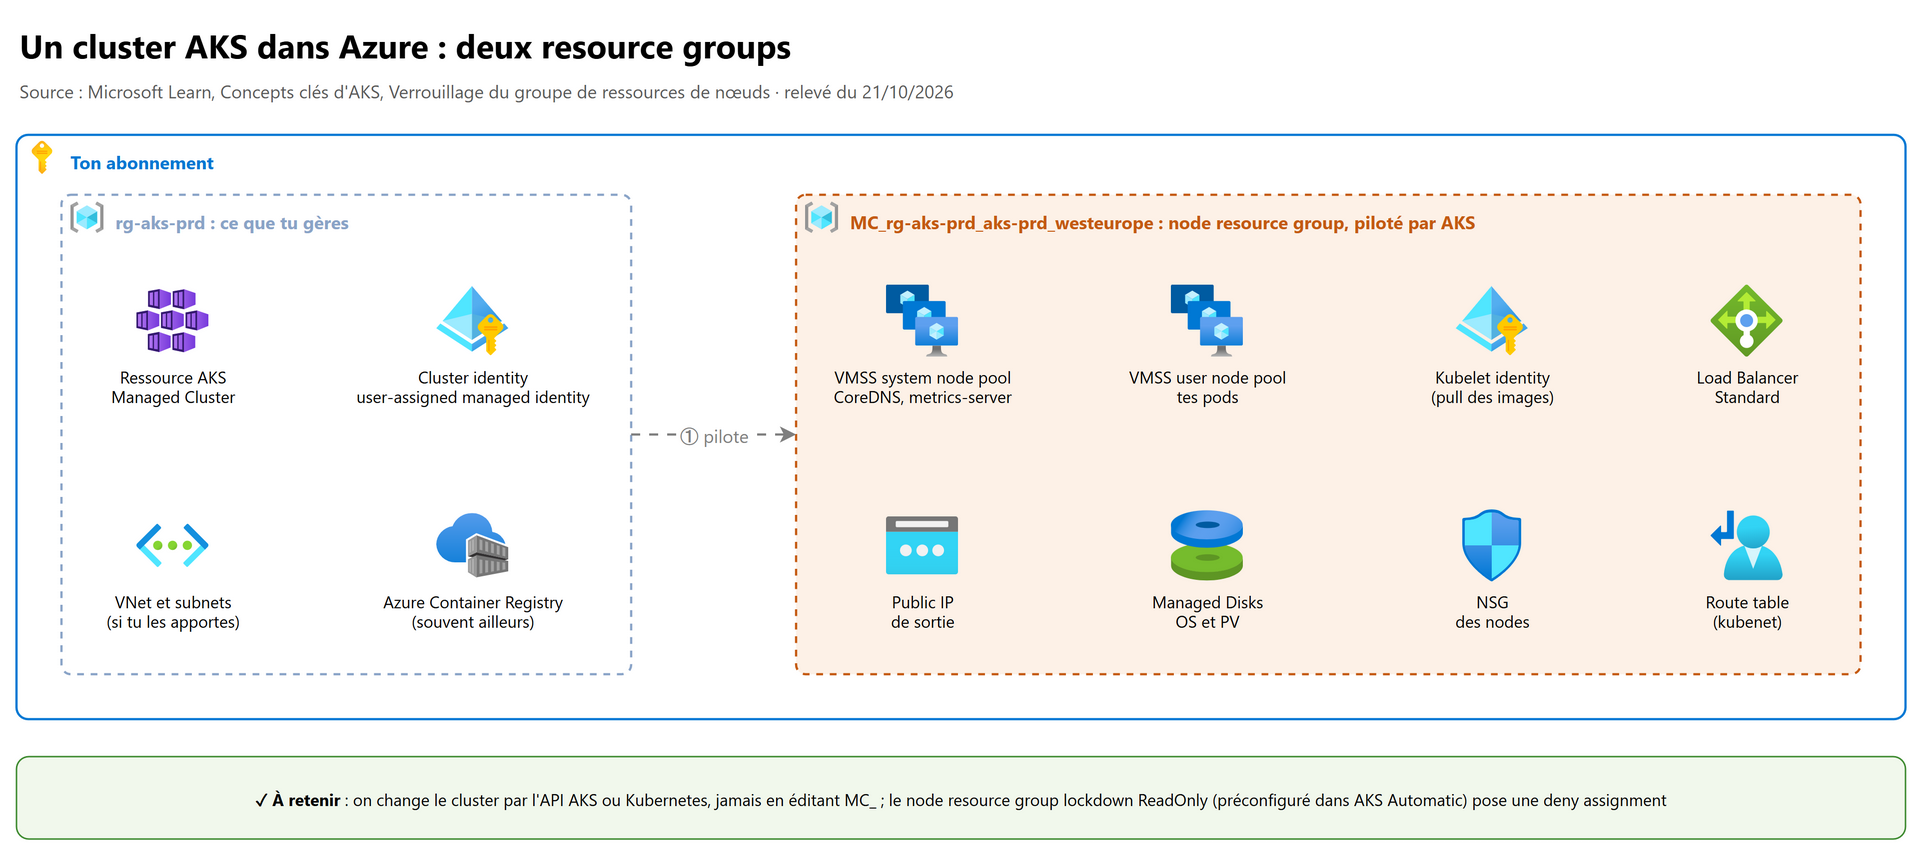
Créer un cluster crée deux resource groups : le tien, qui contient la ressource Managed Cluster, et le node resource
group (MC_<rg>_<cluster>_<région>, renommable à la création) où AKS dépose VMSS, Load Balancer, Public IP, disques, NSG,
kubelet identity. Le node resource group lockdown (--nrg-lockdown-restriction-level ReadOnly) y pose une deny
assignment : lecture seule pour tout le monde sauf AKS. Il est préconfiguré dans AKS Automatic, optionnel dans AKS Standard
(défaut : Unrestricted).
4.1 Les pricing tiers (gestion du cluster)#
| Tier | Pour quoi | SLA de l'API server | Nodes max | Particularité |
|---|---|---|---|---|
| Free | Dev, test, apprentissage | Aucun SLA financier (« au mieux ») | 1 000 (10 recommandés) | Control plane aux ressources limitées |
| Standard | Production | 99,95 % avec availability zones, 99,9 % sans | 5 000 | Control plane qui monte en charge automatiquement |
| Premium | Production réglementée, cycles d'upgrade lents | Comme Standard | 5 000 | Long-Term Support (LTS) : environ 24 mois par version |
Le pricing tier « Standard » n'a rien à voir avec le mode de cluster « AKS Standard ». Dans une région à zones, le control plane est réparti sur plusieurs zones automatiquement, même si tes node pools ne le sont pas.
4.2 AKS Automatic ou AKS Standard#
| AKS Automatic | AKS Standard | |
|---|---|---|
| Philosophie | Valeurs par défaut prêtes pour la production, Microsoft opère davantage | Tout se configure, tu opères davantage |
| Tier et SLA | Standard préconfiguré + pod readiness SLA (99,9 % des opérations prêtes en moins de 5 min) | Free par défaut ; Standard ou Premium en option |
| Node pools | Managed system node pools (hébergés côté AKS), Node Auto Provisioning (NAP) | Tu crées et dimensionnes les node pools ; NAP optionnel |
| Autoscaling | HPA, KEDA, VPA activés | Manuel par défaut ; cluster autoscaler, NAP, KEDA, VPA en option |
| Upgrades | Auto-upgrade channel stable (N-1) et node OS channel NodeImage automatiques |
Manuels par défaut, channel au choix |
| Identité et accès | Azure RBAC for Kubernetes authorization, Workload Identity, OIDC issuer | Local accounts par défaut ; Microsoft Entra en option |
| Réseau | Azure CNI Overlay avec Cilium, API Server VNet Integration, managed NAT Gateway, entrée par l'Application routing add-on (Gateway API à partir de 1.36) | Azure CNI Overlay si --network-plugin n'est pas précisé ; Azure CNI Pod Subnet, Cilium, BYO CNI en option |
| Garde-fous | Deployment Safeguards et Pod Security Standards (Baseline) appliqués, Image Cleaner, node resource group verrouillé | Tout en option |
Réseau par défaut : la page Azure CNI Overlay (la plus à jour) indique qu'un cluster créé sans
--network-pluginutilise Azure CNI Overlay ; avec--network-plugin azuresans--network-plugin-mode, AKS garde le mode « node subnet » par compatibilité. La page de comparaison Automatic/Standard cite encore kubenet, qui est retiré le 31 mars 2028.
Réponse d'entretien : « Microsoft recommande AKS Automatic par défaut pour la plupart des charges de production. Je prends AKS Standard quand j'ai besoin d'un contrôle fin : GPU node pools particuliers, réseau très contraint, CNI spécifique, modèle d'exploitation maison. »
4.3 Les node pools#
Un node pool est un groupe de VM de même configuration, porté par défaut par un Virtual Machine Scale Set (AKS sait aussi gérer des pools de VM individuelles).
| Règle du system node pool | Valeur |
|---|---|
| Rôle | Héberger CoreDNS, metrics-server, konnectivity ; label kubernetes.azure.com/mode: system |
| Isoler des applications | Taint CriticalAddonsOnly=true:NoSchedule (en Terraform : only_critical_addons_enabled) |
| Nodes | Au moins 2, 3 recommandés (zones) ; cluster autoscaler activé |
| OS | Linux uniquement ; VM d'au moins 4 vCPU et 4 Go ; pas de série B ; au moins 30 pods par node |
| Choix | Ce qu'il faut savoir |
|---|---|
| User node pools | Tes applications ; 0 node possible ; Linux ou Windows ; un pool par profil (GPU, mémoire, Spot) |
| OS | Ubuntu (défaut de Standard), Azure Linux (défaut du system node pool d'Automatic), Azure Container Linux, Windows Server 2022 / 2025. Azure Linux 2.0 n'a plus de correctifs depuis le 30/11/2025, ses images sont retirées le 31/10/2026 : migrer vers AzureLinux3 |
| Spot node pool | VM à prix réduit, sans SLA, évincées avec un préavis jusqu'à 30 s ; jamais en system node pool ; taint kubernetes.azure.com/scalesetpriority=spot:NoSchedule posée d'office ; eviction policy Delete (défaut) ou Deallocate |
| Ephemeral OS disk | Sur le stockage local de l'hôte : latence plus faible, scaling et upgrades plus rapides ; choisi par défaut quand la taille de VM le permet |
| Taille de VM | Non modifiable après création du pool : on crée un nouveau pool et on migre |
| Pods par node | Jusqu'à 250 ; défaut 250 en Azure CNI Overlay, 30 en Azure CNI node subnet, 110 en kubenet par la CLI ; se fixe à la création du pool |
4.4 Versions et cycle de vie#
| Règle | Détail |
|---|---|
| Fenêtre supportée | N-2 : les trois dernières versions mineures GA ; chacune environ 12 mois |
| Après la fenêtre | N-3 = platform support (Azure seulement, pas Kubernetes), 60 jours de grâce, puis upgrade imposé par la plateforme (à partir du 1er juin 2027), qui ne respecte ni la maintenance window ni les PDB bloquants |
| Upgrades | On ne saute pas de version mineure (1.32 → 1.34 interdit) ; pas de retour arrière |
| LTS | Tier Premium + --k8s-support-plan AKSLongTermSupport : un an de plus, environ 24 mois au total |
kubectl |
Une version mineure d'écart maximum avec l'API server |
Channels automatiques (détail au chapitre 04) :
Kubernetes (--auto-upgrade-channel) |
Node OS (--node-os-upgrade-channel) |
|---|---|
none (défaut Standard), patch, stable (N-1, défaut Automatic, recommandé en production), rapid (canari), node-image (hérité) |
SecurityPatch, NodeImage (hebdomadaire), Unmanaged, None |
4.5 Limites utiles#
| Ressource | Limite |
|---|---|
| Nodes par cluster (VMSS + Standard Load Balancer) | 5 000, tous node pools confondus |
| Nodes par node pool | 1 000 |
| Node pools par cluster | 100 |
| Pods par node | 250 maximum |
Services LoadBalancer par cluster |
300 |
| Clusters par abonnement | 5 000 au total ; par région, 100 par défaut en EA (10 en paiement à l'utilisation) |
5. Topologies de référence#
5.1 Combien de clusters ?#
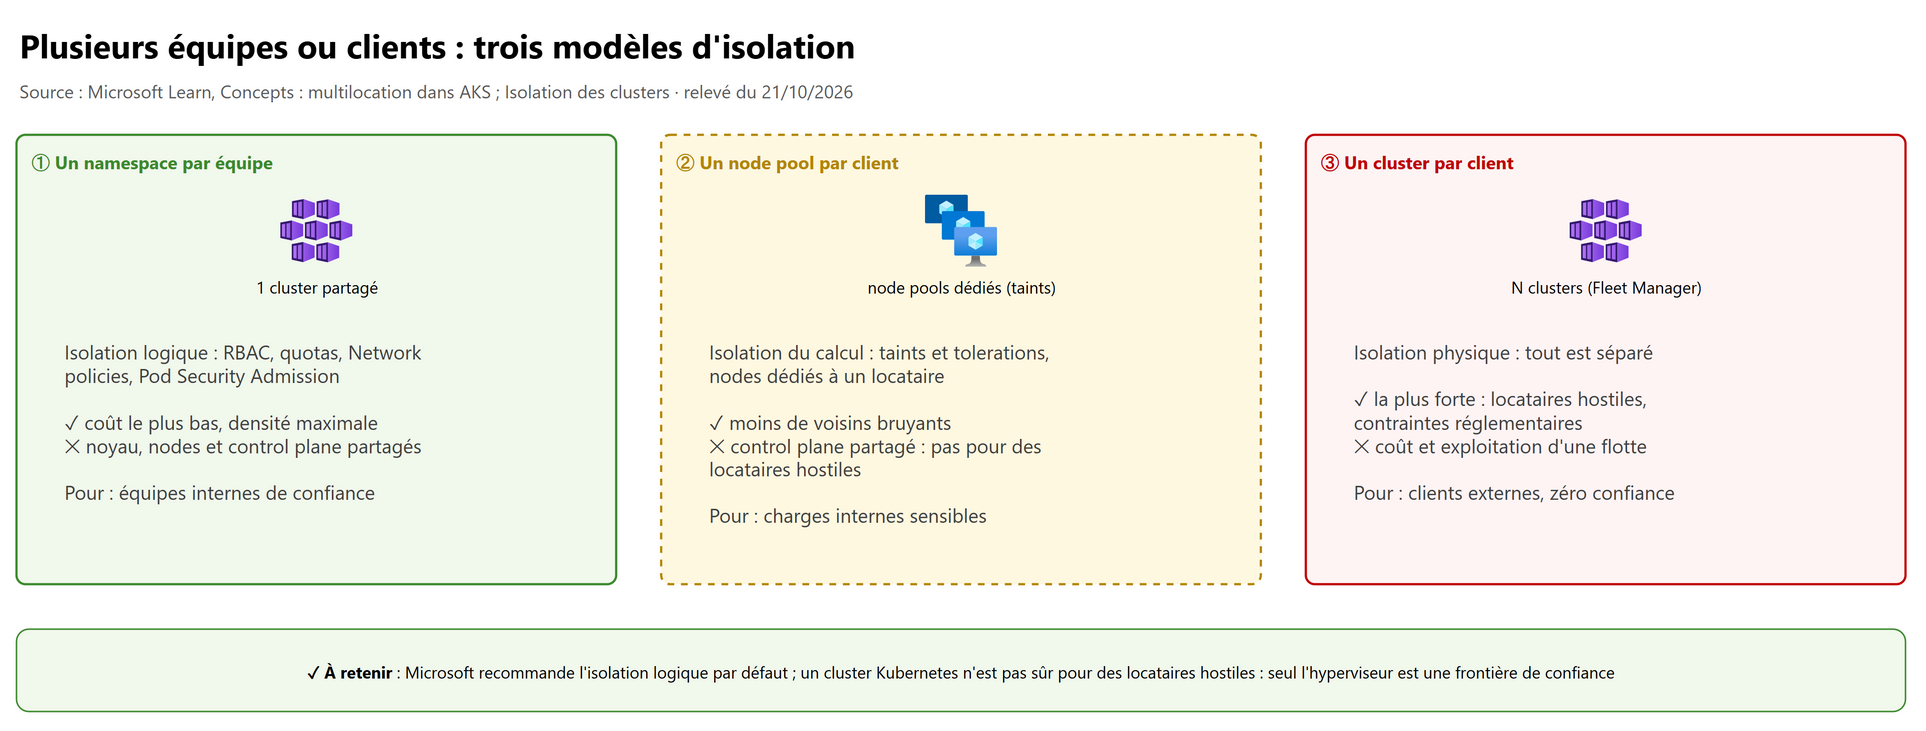
| Modèle | Isolation | Coût | Exploitation | Quand |
|---|---|---|---|---|
| Un namespace par équipe | Logique | Le plus faible | Un seul cluster | Équipes internes de confiance, dev/test |
| Un node pool par locataire | Calcul (taints, nodes dédiés) | Moyen | Taints et tolerations à gérer | Charges sensibles, voisins bruyants |
| Un cluster par locataire | Physique | Le plus élevé | Une flotte (Azure Kubernetes Fleet Manager) | Locataires hostiles, réglementaire, clients externes |
Microsoft recommande l'isolation logique par défaut et de limiter le nombre de clusters ; mais un cluster n'est pas une frontière sûre pour des locataires hostiles (seul l'hyperviseur l'est). En pratique on retrouve souvent : un cluster par environnement (dev, recette, production), des namespaces par application, et des node pools dédiés pour le GPU ou les données sensibles. Le Pod Sandboxing (Kata Containers) ajoute une frontière de calcul par pod, sans isoler le control plane ni le stockage.
5.2 L'architecture AKS baseline#
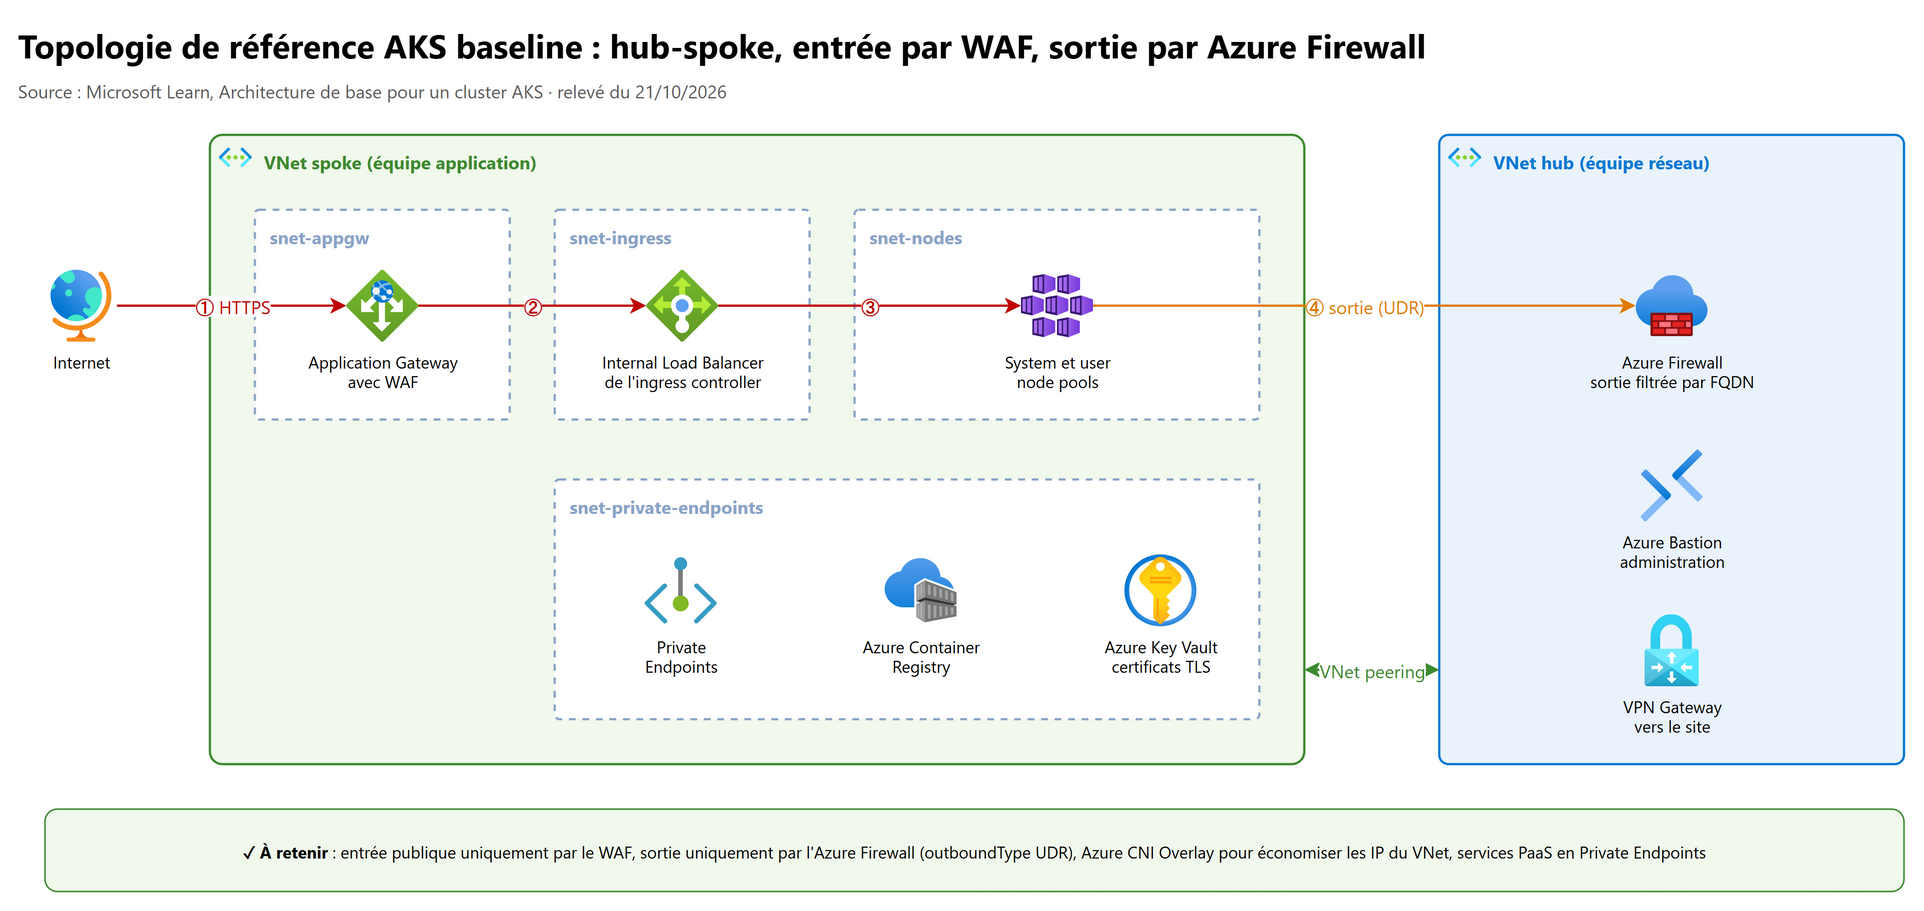
C'est le point de départ recommandé par Microsoft pour une infrastructure AKS de production :
- Hub-spoke : le hub (équipe réseau) porte l'Azure Firewall, Azure Bastion et la VPN Gateway ; le spoke (équipe application) porte le cluster. Aligné sur les Azure landing zones (séparation des responsabilités, moindre privilège).
- Entrée : Internet → Application Gateway avec WAF (subnet dédié) → internal Load Balancer de l'ingress controller
(subnet
ingress) → pods. Le certificat TLS vient d'Azure Key Vault. - Sortie : tout le trafic des nodes part vers l'Azure Firewall par UDR (
outboundType: userDefinedRouting), avec uniquement les FQDN requis par AKS autorisés. - Adressage : Azure CNI Overlay (les pods prennent leurs IP dans un espace séparé du VNet) ; prévoir quand même de la marge dans le subnet des nodes pour les nodes supplémentaires créés pendant les upgrades (surge).
- PaaS en privé : Azure Container Registry et Azure Key Vault derrière des Private Endpoints.
- Administration : API server privé (Private cluster), joint par Azure Bastion.
- Multirégion : la variante multirégion ajoute Azure Front Door devant des clusters actif/actif et Azure Kubernetes Fleet Manager pour orchestrer la flotte.
6. Déployer un premier cluster#
Azure CLI, AKS Automatic (l'option recommandée par Microsoft) :
az group create --name rg-aks-demo --location francecentral
az aks create --resource-group rg-aks-demo --name aks-demo --sku automatic
# le démarrage rapide Microsoft ajoute --enable-hosted-system : system node pools hébergés côté AKS
az aks get-credentials --resource-group rg-aks-demo --name aks-demo
kubectl get nodes        # demande une connexion Microsoft Entra (Azure RBAC for Kubernetes authorization)
Azure CLI, AKS Standard proche de la production :
az aks create \
  --resource-group rg-aks-demo --name aks-std-demo \
  --tier standard \
  --network-plugin azure --network-plugin-mode overlay --network-dataplane cilium \
  --enable-aad --enable-azure-rbac --disable-local-accounts \
  --enable-oidc-issuer --enable-workload-identity \
  --auto-upgrade-channel stable --node-os-upgrade-channel NodeImage \
  --nodepool-name system --node-count 3 --zones 1 2 3 \
  --nrg-lockdown-restriction-level ReadOnly \
  --generate-ssh-keys
Terraform (azurerm 5.10, arguments vérifiés dans la documentation du registre) :
resource "azurerm_kubernetes_cluster" "aks" {
  name                      = "aks-demo-dev"
  location                  = azurerm_resource_group.aks.location
  resource_group_name       = azurerm_resource_group.aks.name
  dns_prefix                = "aks-demo-dev"
  sku_tier                  = "Standard"   # Free, Standard (SLA), Premium (LTS)
  automatic_upgrade_channel = "stable"
  node_os_upgrade_channel   = "NodeImage"
  oidc_issuer_enabled       = true
  workload_identity_enabled = true
  local_account_disabled    = true         # exige la Microsoft Entra integration ci-dessous

  default_node_pool {                      # le system node pool
    name                         = "system"
    vm_size                      = "Standard_D4ds_v5"
    os_sku                       = "AzureLinux"
    zones                        = ["1", "2", "3"]
    auto_scaling_enabled         = true
    min_count                    = 3
    max_count                    = 5
    only_critical_addons_enabled = true    # taint CriticalAddonsOnly
    temporary_name_for_rotation  = "systemtmp"
    upgrade_settings {
      max_surge = "10%"
    }
  }

  node_provisioning_profile {              # bloc marqué Required dans la doc azurerm 5.10
    mode = "Manual"                        # Auto = Node Auto Provisioning (NAP)
  }

  identity {
    type = "SystemAssigned"
  }

  azure_active_directory_role_based_access_control {
    azure_rbac_enabled = true
  }

  network_profile {
    network_plugin      = "azure"
    network_plugin_mode = "overlay"
    network_data_plane  = "cilium"
    network_policy      = "cilium"
    outbound_type       = "loadBalancer"   # userDefinedRouting derrière un Azure Firewall
  }
}
7. Lab (environ 30 minutes, abonnement de test)#
Toutes les commandes sont à lancer par toi, dans un abonnement de test (le cluster coûte tant qu'il tourne).
# 1. Un petit cluster de test (tier Free, 2 nodes)
az group create -n rg-aks-lab -l francecentral
az aks create -g rg-aks-lab -n aks-lab --tier free --node-count 2 --generate-ssh-keys
az aks get-credentials -g rg-aks-lab -n aks-lab

# 2. Observer ce qu'AKS a créé
kubectl get nodes -o wide
kubectl get pods -n kube-system              # CoreDNS, konnectivity, metrics-server…
az aks show -g rg-aks-lab -n aks-lab --query nodeResourceGroup -o tsv
az resource list -g "$(az aks show -g rg-aks-lab -n aks-lab --query nodeResourceGroup -o tsv)" -o table

# 3. Déployer et exposer une application
kubectl create deployment web --image=nginx --replicas=3
kubectl expose deployment web --port=80 --type=LoadBalancer
kubectl get svc web -w                       # attendre l'EXTERNAL-IP : l'Azure Load Balancer vient d'être configuré

# 4. Voir la réconciliation à l'œuvre
kubectl delete pod -l app=web --wait=false
kubectl get pods -l app=web -w               # les pods reviennent seuls
kubectl scale deployment web --replicas=5
kubectl rollout status deployment web

# 5. Nettoyer
az group delete -n rg-aks-lab --yes --no-wait
À observer : la règle et l'IP ajoutées au Load Balancer du groupe MC_ après le expose (c'est le cloud-controller-manager), et
le nom des pods recréés (nouveau suffixe, même ReplicaSet).
8. Erreurs d'architecture fréquentes#
| Erreur | Conséquence | Bonne pratique |
|---|---|---|
| Applications sur le system node pool | Un pod gourmand affame CoreDNS, cluster instable | System node pool dédié avec CriticalAddonsOnly, user node pools séparés |
| System node pool à 1 node | Panne ou upgrade = cluster aveugle | 2 nodes minimum, 3 en zones |
| Tier Free en production | Pas de SLA, control plane limité | Standard (ou Premium pour LTS) |
| Pas de requests sur les pods | Placement aléatoire, cluster autoscaler inefficace, nodes saturés | Requests sur chaque conteneur, ResourceQuota par namespace |
Modifier les VM du groupe MC_ |
Non supporté, perdu à l'upgrade | Passer par l'API AKS, lockdown ReadOnly |
| Subnet trop petit | Upgrades ou scaling bloqués faute d'IP | Azure CNI Overlay, marge pour les nodes de surge |
| Aucun auto-upgrade channel | Cluster qui sort de la fenêtre N-2, puis upgrade imposé | Channel stable + NodeImage + maintenance window d'au moins 4 h |
| Un cluster par application | Coût, flotte ingérable | Isolation logique par défaut, clusters par environnement ou par frontière de confiance |
| Spot pour des charges critiques | Évictions sans préavis utile | Spot seulement pour ce qui tolère l'interruption (batch, test) |
Image latest |
Déploiements non reproductibles | Tag de version précis ou digest |
9. Questions d'entretien#
1. Explique l'architecture de Kubernetes en deux minutes.
Un control plane (API server, etcd, scheduler, controllers) qui garde l'état voulu et décide, et des nodes (kubelet, kube-proxy ou Cilium, containerd) qui exécutent les pods. Tout passe par l'API ; les controllers comparent en boucle l'état réel à l'état voulu et corrigent. C'est cette réconciliation qui donne l'auto-réparation et le scaling.
2. Que gère Microsoft dans AKS, et que dois-tu gérer ?
Microsoft opère le control plane, son SLA et la sauvegarde d'etcd, ainsi que kubelet et containerd. C'est partagé pour les upgrades (Microsoft publie, je déclenche ou je choisis un channel), les correctifs d'OS des nodes et l'autoscaling. Je garde le réseau, l'identité, les node pools, la sécurité des charges, le monitoring applicatif et la sauvegarde.
3. Pourquoi deux resource groups ?
Le mien contient la ressource AKS ; le node resource group
MC_contient l'infrastructure pilotée par AKS (VMSS, Load Balancer, disques, IP). On ne le modifie jamais à la main ; on peut le verrouiller en lecture seule (node resource group lockdown), ce que fait AKS Automatic par défaut.
4. Free, Standard, Premium : lequel en production ?
Standard au minimum : SLA de 99,95 % de l'API server avec zones, control plane qui monte en charge, jusqu'à 5 000 nodes. Premium si l'organisation ne peut pas suivre le rythme annuel des versions : il apporte le LTS, environ 24 mois par version.
5. AKS Automatic ou Standard ?
Automatic par défaut : managed system node pools, NAP, upgrades automatiques, garde-fous, Microsoft Entra et Workload Identity préconfigurés, pod readiness SLA. Standard quand j'ai besoin de contrôler finement les node pools, le CNI ou les opérations.
6. System node pool et user node pool ?
Le system node pool héberge les composants critiques (CoreDNS, metrics-server) : Linux, 2 nodes minimum (3 recommandés), taint
CriticalAddonsOnly. Les applications vont sur des user node pools, un par profil (général, GPU, Spot, Windows).
7. Deployment, StatefulSet ou DaemonSet ?
Deployment pour le sans état, avec rolling updates. StatefulSet quand chaque replica a une identité et un stockage stables (base de données). DaemonSet pour un agent sur chaque node (logs, sécurité).
8. Comment AKS gère-t-il les versions ? Que se passe-t-il si on ne met pas à niveau ?
Trois mineures supportées (N-2), environ un an chacune ; on ne saute pas de mineure. En N-3 on passe en platform support, et après 60 jours de grâce AKS fait l'upgrade d'office, sans respecter la maintenance window. D'où un channel
stableavec une maintenance window, et des tests sur un cluster canari enrapid.
9. Un ou plusieurs clusters pour 10 équipes ?
Par défaut un cluster partagé par environnement, une isolation par namespace (RBAC Microsoft Entra, quotas, Network policies), et des node pools dédiés pour les besoins particuliers. Un cluster séparé seulement pour une vraie frontière de confiance (client externe, données réglementées), car un cluster n'isole pas des locataires hostiles.
10. Décris une architecture AKS de production.
L'AKS baseline : hub-spoke ; entrée par Application Gateway WAF puis internal Load Balancer ; sortie forcée par l'Azure Firewall (UDR, FQDN autorisés) ; Azure CNI Overlay ; API server privé joint par Azure Bastion ; Azure Container Registry et Azure Key Vault en Private Endpoints ; Microsoft Entra, Azure RBAC et Workload Identity ; node pools en zones ; channel
stable; Azure Monitor avec managed Prometheus.
10. Fiche à retenir#
- Kubernetes = état voulu + boucle de réconciliation ; tout passe par l'API server.
- Control plane : apiserver, etcd, scheduler, controller-manager, cloud-controller-manager ; node : kubelet, kube-proxy ou Cilium, containerd.
- Deployment (sans état), StatefulSet (identité stable), DaemonSet (un par node), Job/CronJob ; Service par label selector ; Ingress ou Gateway API pour HTTP.
- Requests pour placer, limits pour plafonner ; readiness, liveness, startup probes.
- Microsoft opère le control plane ; upgrades et correctifs de nodes sont partagés ; réseau, identité, charges, sauvegarde sont à toi.
- Deux resource groups ; ne jamais modifier
MC_; node resource group lockdownReadOnly(d'office en Automatic). - Free (sans SLA, 1 000 nodes) · Standard (99,95 % avec zones, 5 000 nodes) · Premium (+ LTS, environ 24 mois).
- AKS Automatic recommandé par défaut ; Standard pour le contrôle fin ; réseau par défaut sans
--network-plugin: Azure CNI Overlay. - System node pool : Linux, 2 nodes minimum (3 recommandés),
CriticalAddonsOnly; taille de VM non modifiable après création. - Spot : sans SLA, jamais en system node pool ; Ephemeral OS disk par défaut quand c'est possible.
- Versions : N-2, environ 12 mois, pas de saut de mineure, N-3 puis upgrade imposé ; channel
stable+NodeImage. - Isolation logique par défaut ; cluster dédié pour les locataires hostiles.
- AKS baseline : hub-spoke, WAF en entrée, Azure Firewall en sortie, CNI Overlay, PaaS en Private Endpoints.
Références#
Toutes lues le 21/10/2026 :
- Concepts clés d'AKS
- Qu'est-ce qu'AKS Automatic ? (comparaison Automatic et Standard)
- Configurer Azure CNI Overlay (plugin réseau par défaut)
- Niveaux tarifaires de gestion des clusters AKS
- Stratégies de support d'AKS (répartition des responsabilités)
- Versions de Kubernetes prises en charge dans AKS
- Support à long terme (LTS) d'AKS
- Mise à niveau automatique d'un cluster AKS
- Mise à niveau automatique des images OS des nœuds
- Gérer les pools de nœuds système
- Ajouter un pool de nœuds Spot
- Options de stockage dans AKS (disques OS éphémères)
- Verrouillage du groupe de ressources de nœuds
- Quotas, restrictions de taille de VM et disponibilité régionale d'AKS
- Bonnes pratiques d'isolation des clusters
- Concepts : multilocation dans AKS
- Bonnes pratiques de fiabilité des déploiements et des clusters
- Architecture de base pour un cluster AKS
- AKS baseline multirégion
- Démarrage rapide : créer un cluster AKS Automatic
- Terraform azurerm_kubernetes_cluster (registre, azurerm 5.10)
- Kubernetes : composants du cluster · Workloads · Services