

Version : 1.0 · Date : 2026-10-21 · Parcours AKS, niveau architecte (entretiens)
En une phrase : AKS n'est qu'une des cibles de conteneurs d'Azure ; un architecte doit savoir dire pourquoi AKS (API Kubernetes, écosystème CNCF, contrôle du réseau et des GPU) et pourquoi pas (Container Apps fait le même travail avec bien moins d'exploitation), puis défendre son design au tableau.
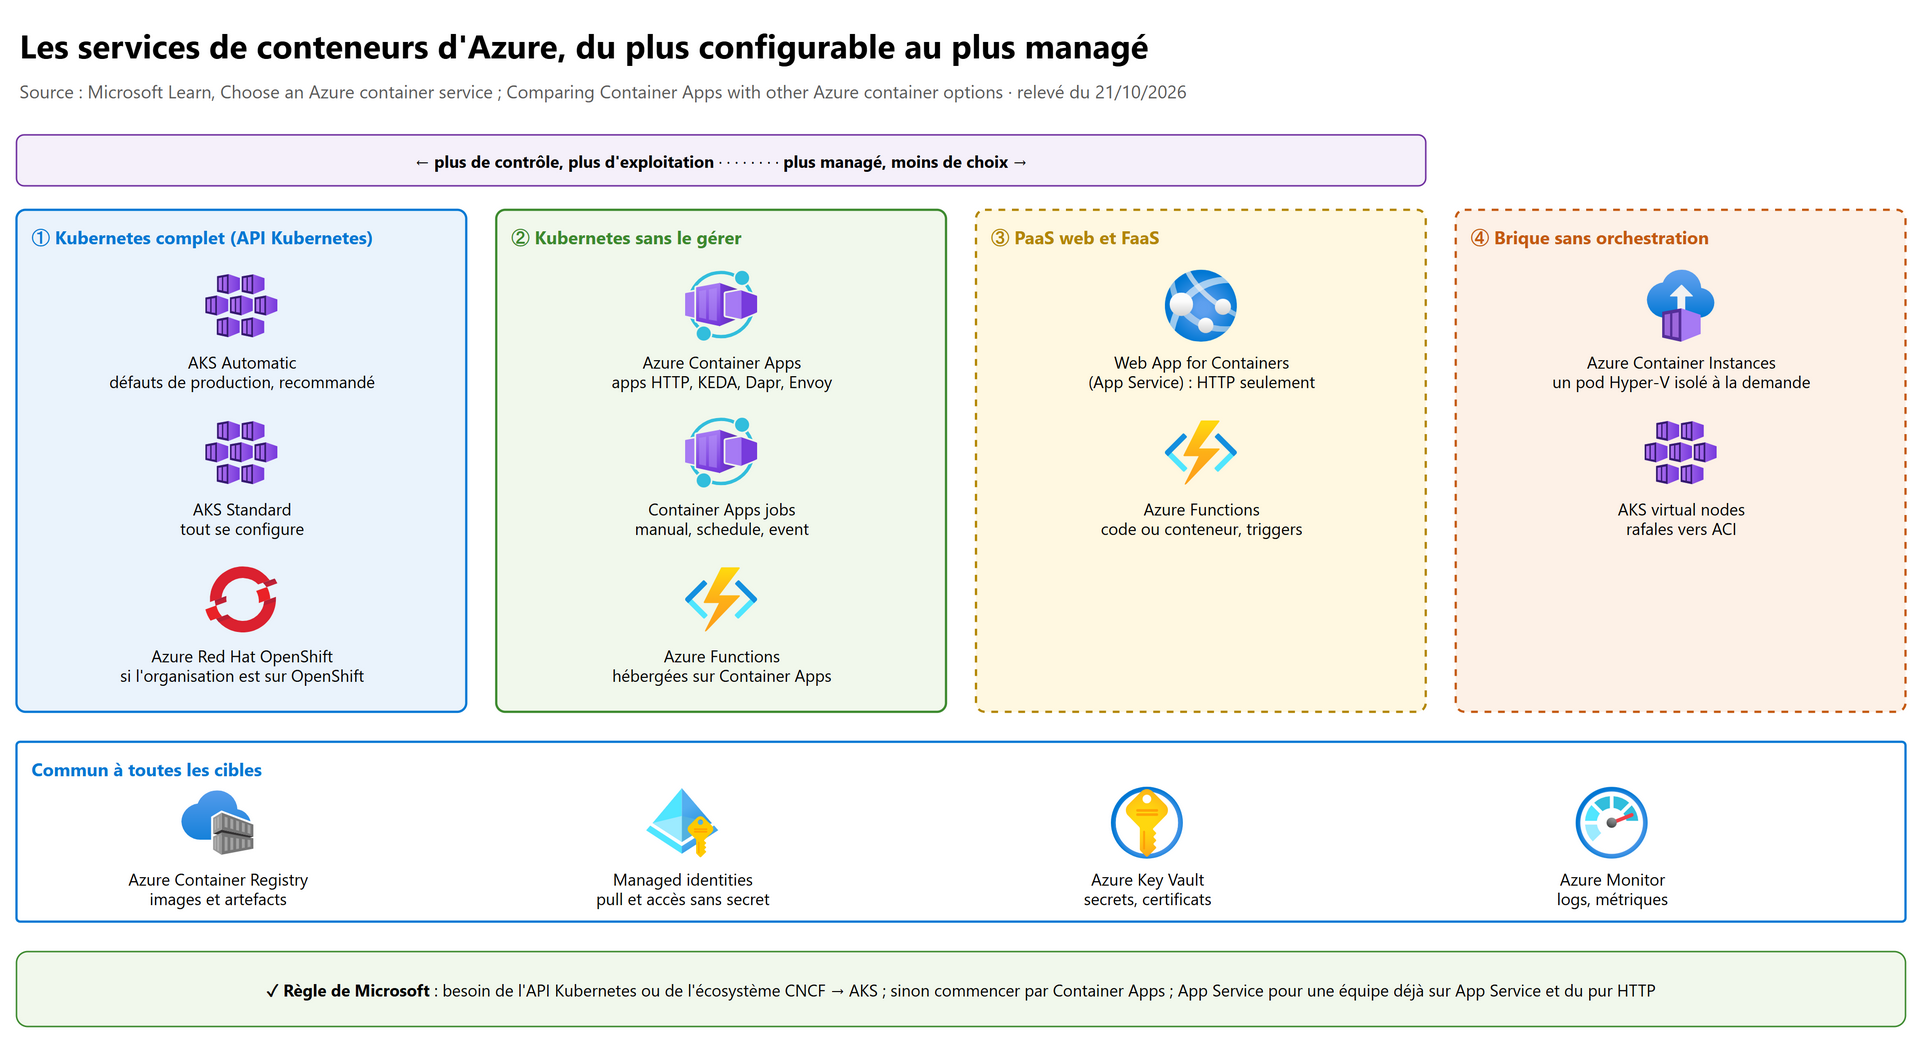
Ce fichier a deux parties : A. choisir le bon service de conteneurs (sections 1 à 5) et B. préparer l'entretien (sections 6 à 9 : questions express, études de cas, pièges, ce qu'il faut savoir dessiner).
Partie A · Choisir le bon service de conteneurs#
1. Le panorama#
| Service | Ce que c'est | Ce qu'on ne gère pas | Quand le choisir |
|---|---|---|---|
| AKS Automatic | Kubernetes managé avec défauts de production (node pools, scaling, sécurité, upgrades gérés) | Node pools système, NAP, upgrades, garde-fous | Besoin de l'API Kubernetes sans vouloir tout opérer ; recommandé par défaut pour AKS |
| AKS Standard | Kubernetes managé, tout se configure | Le control plane | Contrôle fin : CNI, GPU précis, opérateurs CNCF, réseau très contraint |
| Azure Container Apps | Serverless « à la Kubernetes » (Kubernetes, KEDA, Dapr, Envoy sous le capot) : apps, jobs, Functions | Tout le cluster : pas d'accès à l'API Kubernetes | Microservices, API, apps événementielles, scale to zero ; premier choix sans besoin de l'API Kubernetes |
| Web App for Containers (App Service) | PaaS web : conteneur sur un App Service plan | Orchestration, OS | Équipe déjà sur App Service, pur HTTP/HTTPS |
| Azure Functions | FaaS : triggers, bindings, code ou conteneur | Tout | Fonctions courtes déclenchées par des événements ; hébergeables sur Container Apps |
| Azure Container Instances (ACI) | Un pod de conteneurs isolés par Hyper-V, à la demande | Tout, mais aussi aucun scaling, LB ni certificat | Brique de bas niveau : tâche ponctuelle, rafales via les AKS virtual nodes |
| Azure Red Hat OpenShift | OpenShift opéré et supporté conjointement par Red Hat et Microsoft | Le cluster OpenShift | L'organisation utilise déjà OpenShift |
| Azure Container Registry (ACR) | Registre privé d'images et d'artefacts, commun à toutes ces cibles | Le stockage | Toujours ; Premium en production |
Phrase d'entretien : « Microsoft le dit lui-même : si je n'ai pas besoin de l'API Kubernetes et de l'écosystème CNCF, je commence par Container Apps. Je passe à AKS quand un besoin concret l'exige, par exemple des network policies deny-by-default entre composants colocalisés, ou des GPU que Container Apps ne propose pas. »
2. Azure Container Apps en 5 minutes (l'alternative n° 1 à AKS)#
| Notion | À retenir |
|---|---|
| Environment | La frontière : un réseau, un Log Analytics workspace partagé, une seule IP d'entrée (publique ou privée). La communication entre apps d'un même environment n'est pas restreinte : un environment = une charge de travail |
| Environment type | Workload profiles (v2), le défaut : UDR, sortie par NAT Gateway, Private Endpoints, subnet /27 minimum. Consumption-only (v1), hérité : subnet /23, ni UDR ni NAT Gateway |
| Workload profiles | Consumption (serverless, scale to zero, serverless GPUs T4 ou A100 dans certaines régions) ; Dedicated (D, E, GPU A100 : VM réservées, facturées par instance) ; Flexible (préversion, subnet /25, pas de scale to zero) |
| Apps | Tournent en continu ; revisions et traffic splitting (blue/green, canari) ; scaling par HTTP, TCP ou scalers KEDA |
| Jobs | Tâches qui se terminent : Manual, Schedule (cron), Event (KEDA, par exemple une file Service Bus ou un runner GitHub Actions) |
| Entrée | HTTP/HTTPS et TCP ; pas d'UDP |
| Réseau | Le type de réseau (managé ou VNet existant) ne change plus après création ; Private Endpoints facturés en plus (Dedicated Plan Management) |
| Identité | Managed identities, références Azure Key Vault, comme partout |
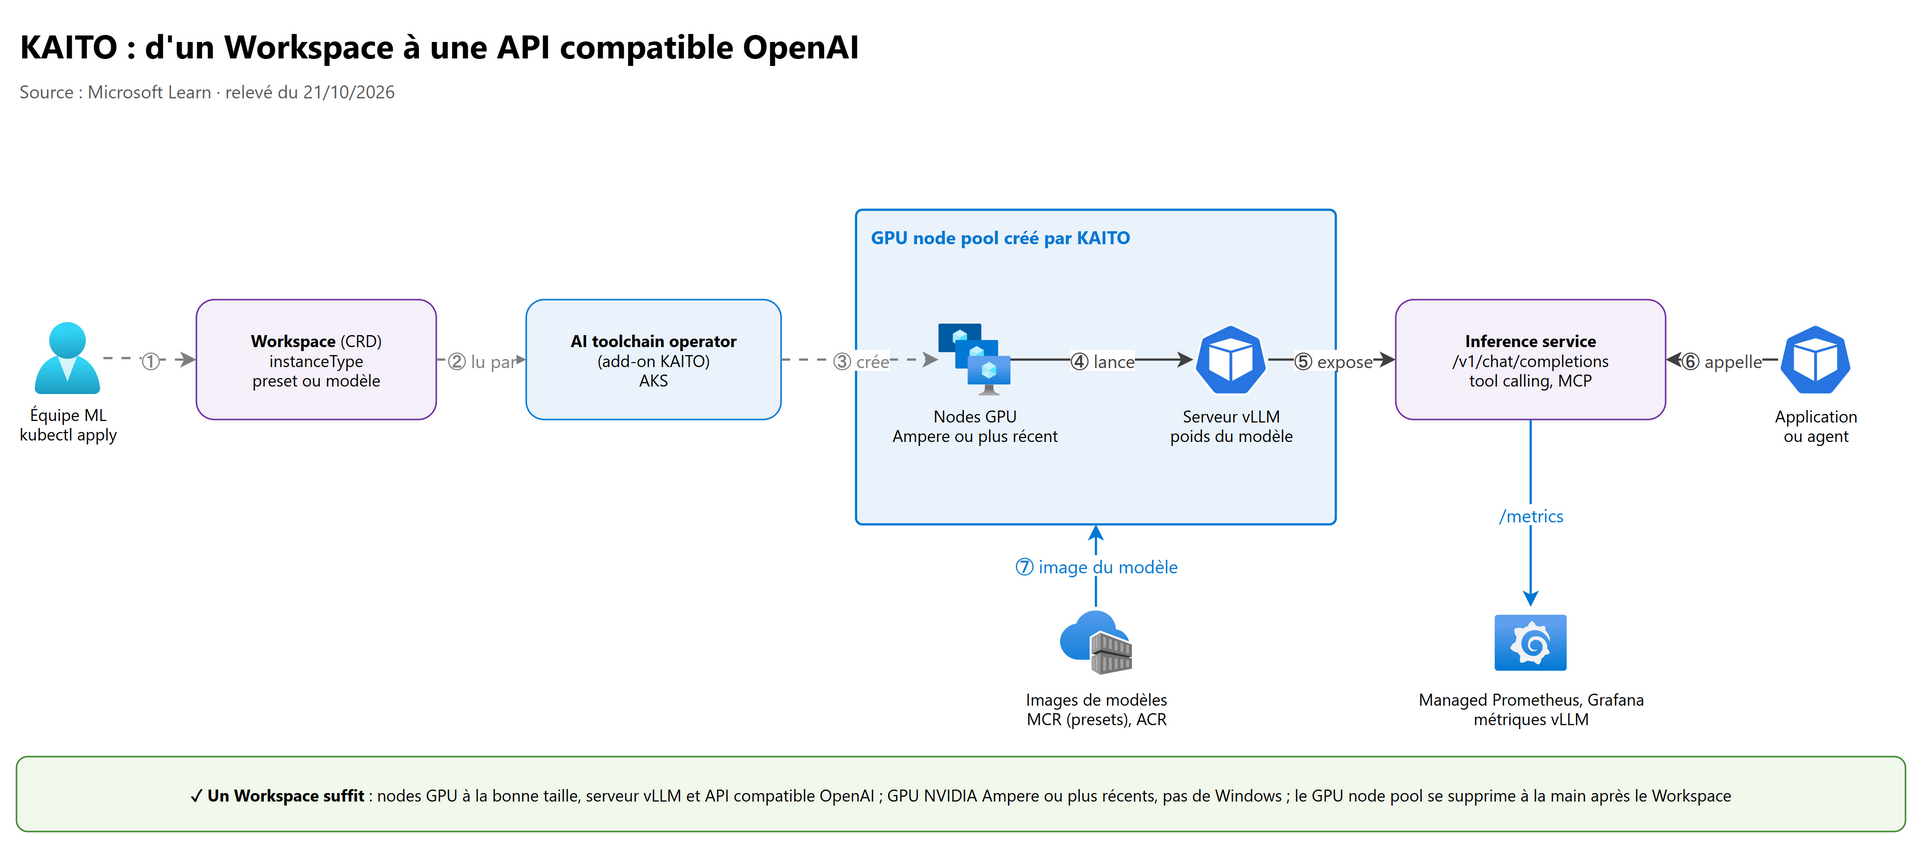
Ce que Container Apps ne sait pas faire et qui fait choisir AKS : l'API Kubernetes (opérateurs, CRD, Helm de l'écosystème), les network policies entre apps d'un même environment, l'UDP, le choix fin des tailles de VM et des GPU (H100, L4…), plusieurs IP d'entrée, un moteur d'inférence orchestré par KAITO.
# Un environment, une app avec scale to zero, un job planifié (abonnement de test)
az containerapp env create -g rg-aca-lab -n env-lab -l francecentral
az containerapp create -g rg-aca-lab -n api --environment env-lab \
  --image mcr.microsoft.com/k8se/quickstart:latest --ingress external --target-port 80 \
  --min-replicas 0 --max-replicas 5
az containerapp job create -g rg-aca-lab -n nightly --environment env-lab \
  --trigger-type Schedule --cron-expression "0 2 * * *" \
  --image mcr.microsoft.com/k8se/quickstart-jobs:latest --replica-timeout 1800
3. Les autres cibles, en bref#
- Azure Container Instances : un pod isolé par Hyper-V, créé et facturé à la demande. Pour cinq instances, on crée cinq ressources : pas de scaling ni de load balancing. Intérêt architecte : les AKS virtual nodes posent l'orchestration d'AKS sur ACI pour absorber des rafales sans ajouter de nodes.
- Web App for Containers : HTTP/HTTPS uniquement, une IP publique par App Service plan, entrée privée par Private Endpoint et sortie par VNet integration ; endpoint public totalement supprimé seulement dans un App Service Environment. Un App Service plan partage CPU et mémoire entre ses apps : une charge par plan pour éviter le voisin bruyant.
- Azure Functions : le modèle de programmation existe en image de base, donc portable vers Container Apps ou AKS ; sur Container Apps, les Functions peuvent utiliser un GPU (Dedicated plan avec workload profiles).
- Azure Red Hat OpenShift : choisi pour l'outillage OpenShift (builds, déploiements, registre intégrés), pas pour Kubernetes en soi.
- Azure Container Registry :
| Basic | Standard | Premium | |
|---|---|---|---|
| Usage | Apprentissage, dev | La plupart des productions | Grands volumes, production critique |
| Commun aux trois | Mêmes API, authentification Microsoft Entra, webhooks, chiffrement au repos, zone redundancy par défaut dans les régions qui la proposent | ||
| En plus | Plus de stockage et de débit | Geo-replication, Private Endpoints, débit et concurrence maximaux |
Pièges ACR : les ACR Tasks tournent uniquement dans la région d'origine ; le soft delete (préversion) ne fonctionne pas avec
la geo-replication ; un Private Endpoint consomme une IP pour le registre plus une par réplica (endpoints de données) ; Microsoft recommande au
moins un /27 pour le subnet des Private Endpoints d'un registre geo-répliqué.
Côté AKS, l'attache ACR donne le rôle AcrPull à la kubelet identity (chapitre 03).
4. Le tableau de décision#
| Critère | AKS (Standard / Automatic) | Container Apps | Web App for Containers | ACI |
|---|---|---|---|---|
| Contrôle | Maximal : API Kubernetes, CNI, add-ons, CNCF | Moyen : apps, revisions, scaling, réseau de l'environment | Faible : app web | Faible : un pod |
| Effort d'exploitation | Élevé (Standard), réduit (Automatic) | Faible | Faible | Très faible |
| Coût | Nodes payés même au repos ; rentable à gros volume et forte densité | À l'usage, scale to zero (Consumption) ; Dedicated pour une charge stable | Par App Service plan | À la seconde, par conteneur |
| Mise à l'échelle | HPA, KEDA, VPA, cluster autoscaler, NAP : tout est possible, tout est à toi | HTTP, TCP, KEDA, scale to zero intégré | Règles d'autoscale du plan | Aucune (une ressource par instance) |
| Réseau | TCP et UDP sur tout port, plusieurs IP d'entrée, network policies, ingress au choix | HTTP/HTTPS et TCP, une IP d'entrée par environment, UDR et NAT Gateway en workload profiles | HTTP/HTTPS, Private Endpoint et VNet integration | VNet possible, pas de LB intégré |
| GPU / IA | Toutes les tailles GPU d'AKS, KAITO, vLLM, inference gateway | Serverless GPUs T4 et A100, Dedicated A100 | Non | Non pertinent ici |
| Conformité, isolation | Segmentation fine dans un cluster, Defender for Containers, policies ; SLA à composer (control plane + node pools) | Un environment = une frontière ; SLA simple à calculer | ASE pour l'isolation complète | Hyper-V par pod |
L'arbre de décision#
flowchart TD
    A["Nouvelle charge conteneurisée"] --> B{"Besoin de l'API Kubernetes,<br/>d'opérateurs ou de l'écosystème CNCF ?"}
    B -- Oui --> C{"L'organisation est<br/>sur OpenShift ?"}
    C -- Oui --> ARO["Azure Red Hat OpenShift"]
    C -- Non --> D{"Contrôle fin requis :<br/>CNI, GPU précis, réseau ?"}
    D -- Oui --> STD["AKS Standard"]
    D -- Non --> AUTO["AKS Automatic"]
    B -- Non --> E{"Uniquement une app web HTTP,<br/>équipe déjà sur App Service ?"}
    E -- Oui --> WEB["Web App for Containers"]
    E -- Non --> F{"Tâche ponctuelle isolée,<br/>sans scaling ni LB ?"}
    F -- Oui --> ACI["Azure Container Instances"]
    F -- Non --> G{"Besoin de segmentation réseau<br/>entre composants colocalisés ?"}
    G -- Oui --> AUTO
    G -- Non --> ACA["Azure Container Apps"]
5. Une architecture type qui combine les deux#
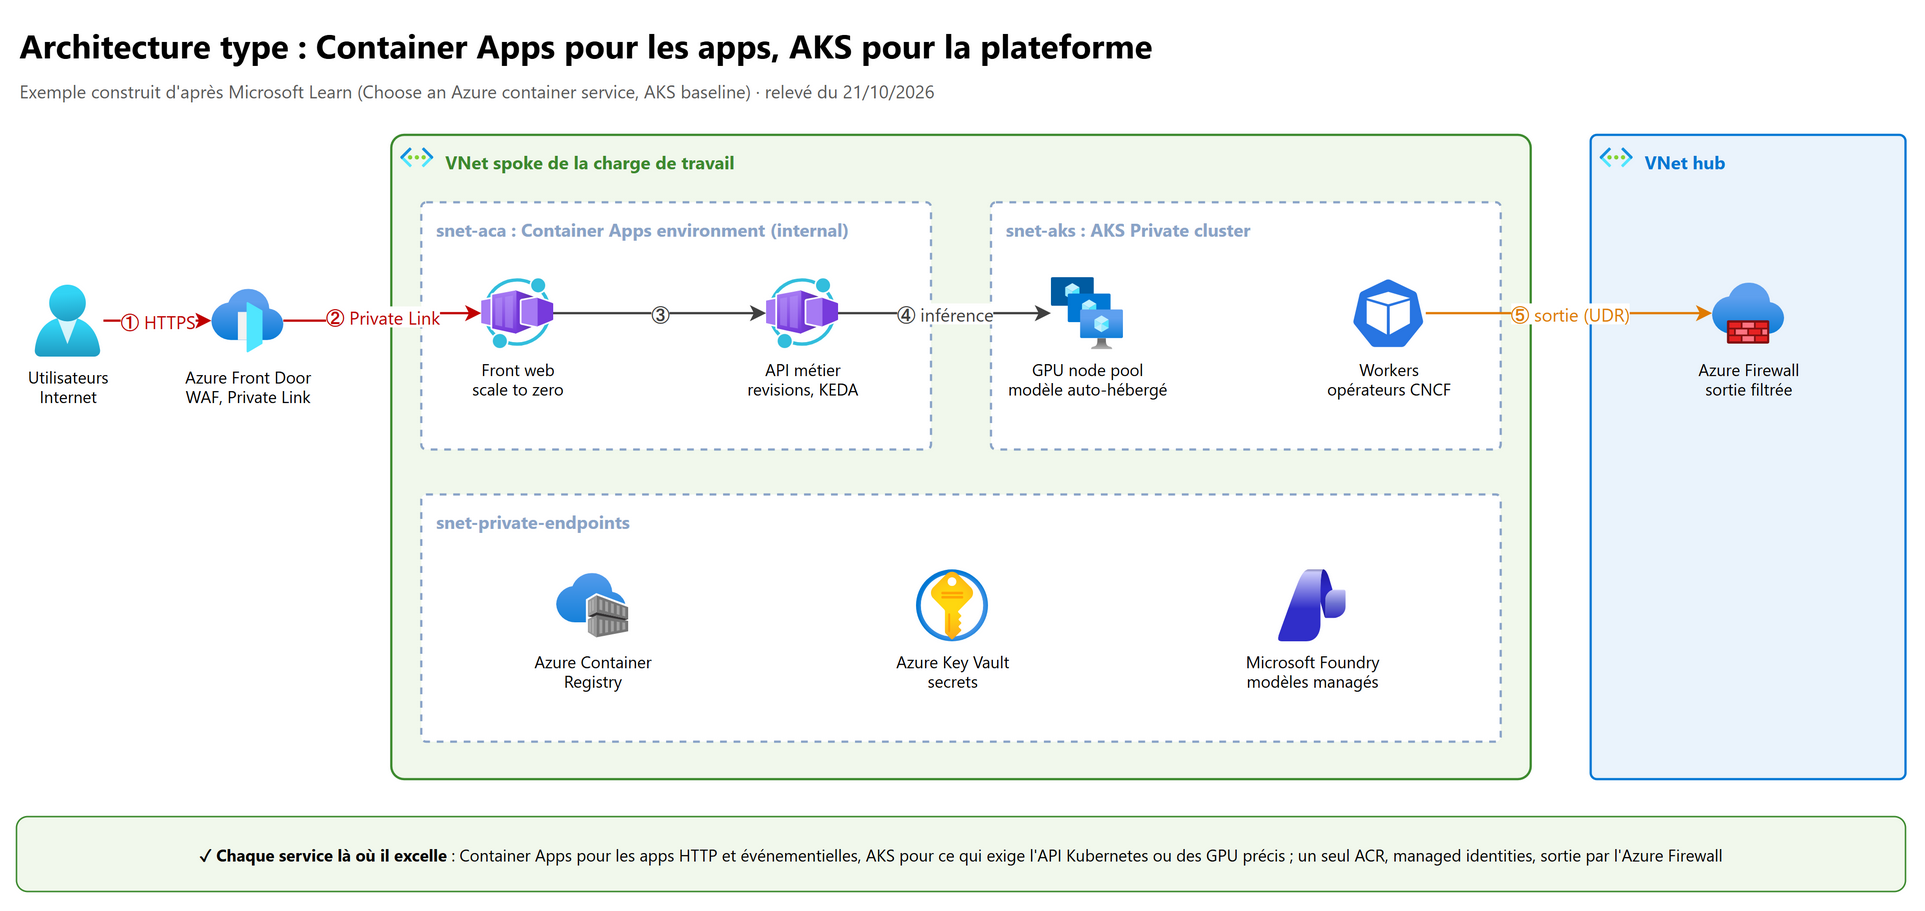
Rien n'oblige à tout mettre dans AKS. Un schéma fréquent en entretien : Container Apps pour le front et les API (scale to zero, revisions, peu d'exploitation), AKS pour ce qui a vraiment besoin de Kubernetes (GPU node pools, opérateurs, workers spécialisés), et un socle commun : Azure Front Door avec WAF devant (Private Link vers l'environment interne), un seul Azure Container Registry Premium en Private Endpoint, managed identities et Azure Key Vault, sortie par l'Azure Firewall du hub. C'est un exemple construit d'après les guides de choix de Microsoft, pas une architecture de référence publiée.
Partie B · Préparer l'entretien#
6. Questions express (réponse courte, détail en lien)#
Chaque fichier du parcours se termine par 10 à 12 questions avec des réponses argumentées. Ici, la version « révision de la veille » : une ou deux phrases, puis où creuser.
Fondamentaux Kubernetes#
- Pod ou conteneur ? Le pod est l'unité de déploiement : un ou plusieurs conteneurs qui partagent IP, réseau et volumes ; on ne le crée jamais seul, un controller le fait vivre. → 01, 2.4
- Readiness, liveness, startup ? Readiness retire le pod du Service, liveness le redémarre, startup protège un démarrage lent des deux autres. → 01, 2.4
- Requests et limits ? La request sert au scheduler et à l'autoscaling, la limit plafonne ; dépasser la limit mémoire = OOMKill. Sans requests, aucun autoscaling fiable. → 04, 2.1
- Les types de Service ? ClusterIP (interne), NodePort (port sur chaque node), LoadBalancer (Azure Load Balancer), headless (DNS direct vers les pods, pour les StatefulSets). → 02, 1.2
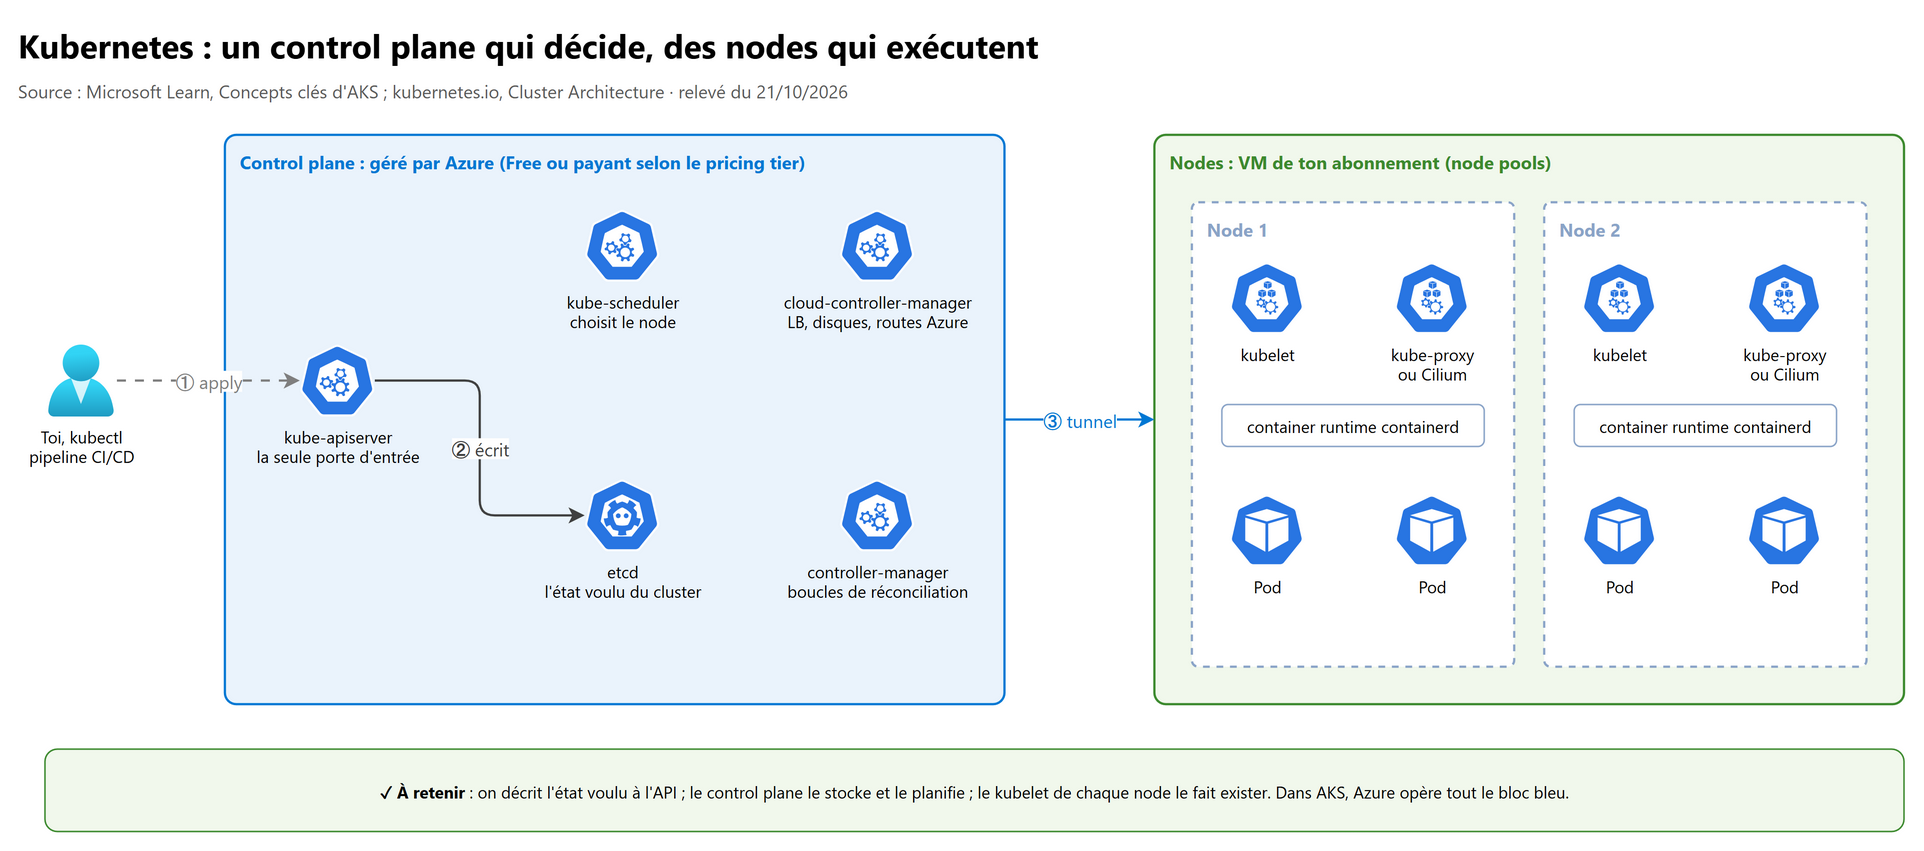
- Que fait un controller ? Il compare en boucle l'état réel à l'état voulu stocké dans etcd et corrige l'écart : c'est la réconciliation. → 01, 2.3
Architecture AKS#
- Que gère Microsoft ? Le control plane, son SLA, la sauvegarde d'etcd, kubelet et containerd ; upgrades et correctifs de nodes sont partagés ; réseau, identité, charges et sauvegarde sont à moi. → 01, 3
- AKS Automatic ou Standard ? Automatic par défaut (défauts de production, NAP, upgrades, garde-fous) ; Standard pour le contrôle fin. → 01, 4.2
- System et user node pools ? Le system node pool (Linux, 3 nodes recommandés,
CriticalAddonsOnly) porte CoreDNS et metrics-server ; les applis vont sur des user node pools par profil. → 01, 4.3 - Le groupe
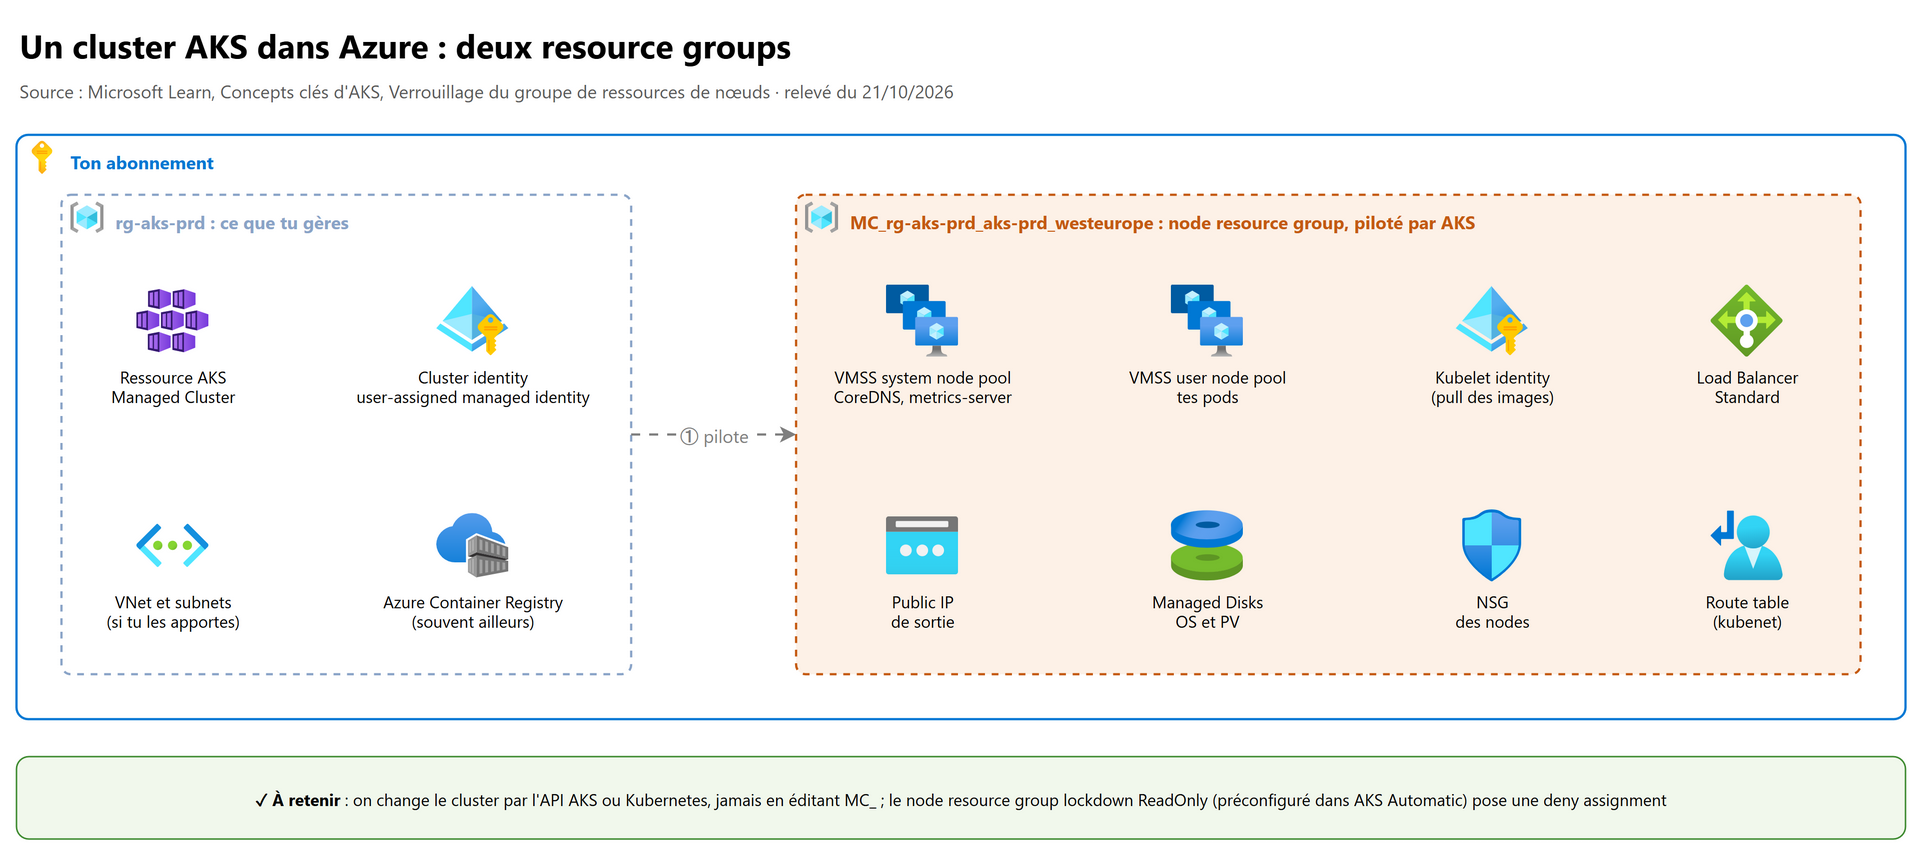
MC_? Le node resource group, piloté par AKS ; on n'y touche jamais, on le verrouille enReadOnly. → 01, 4 - Cycle de vie des versions ? N-2, environ 12 mois par mineure, pas de saut de mineure, upgrade imposé après N-3 ; Premium pour le LTS. → 01, 4.4
Réseau#
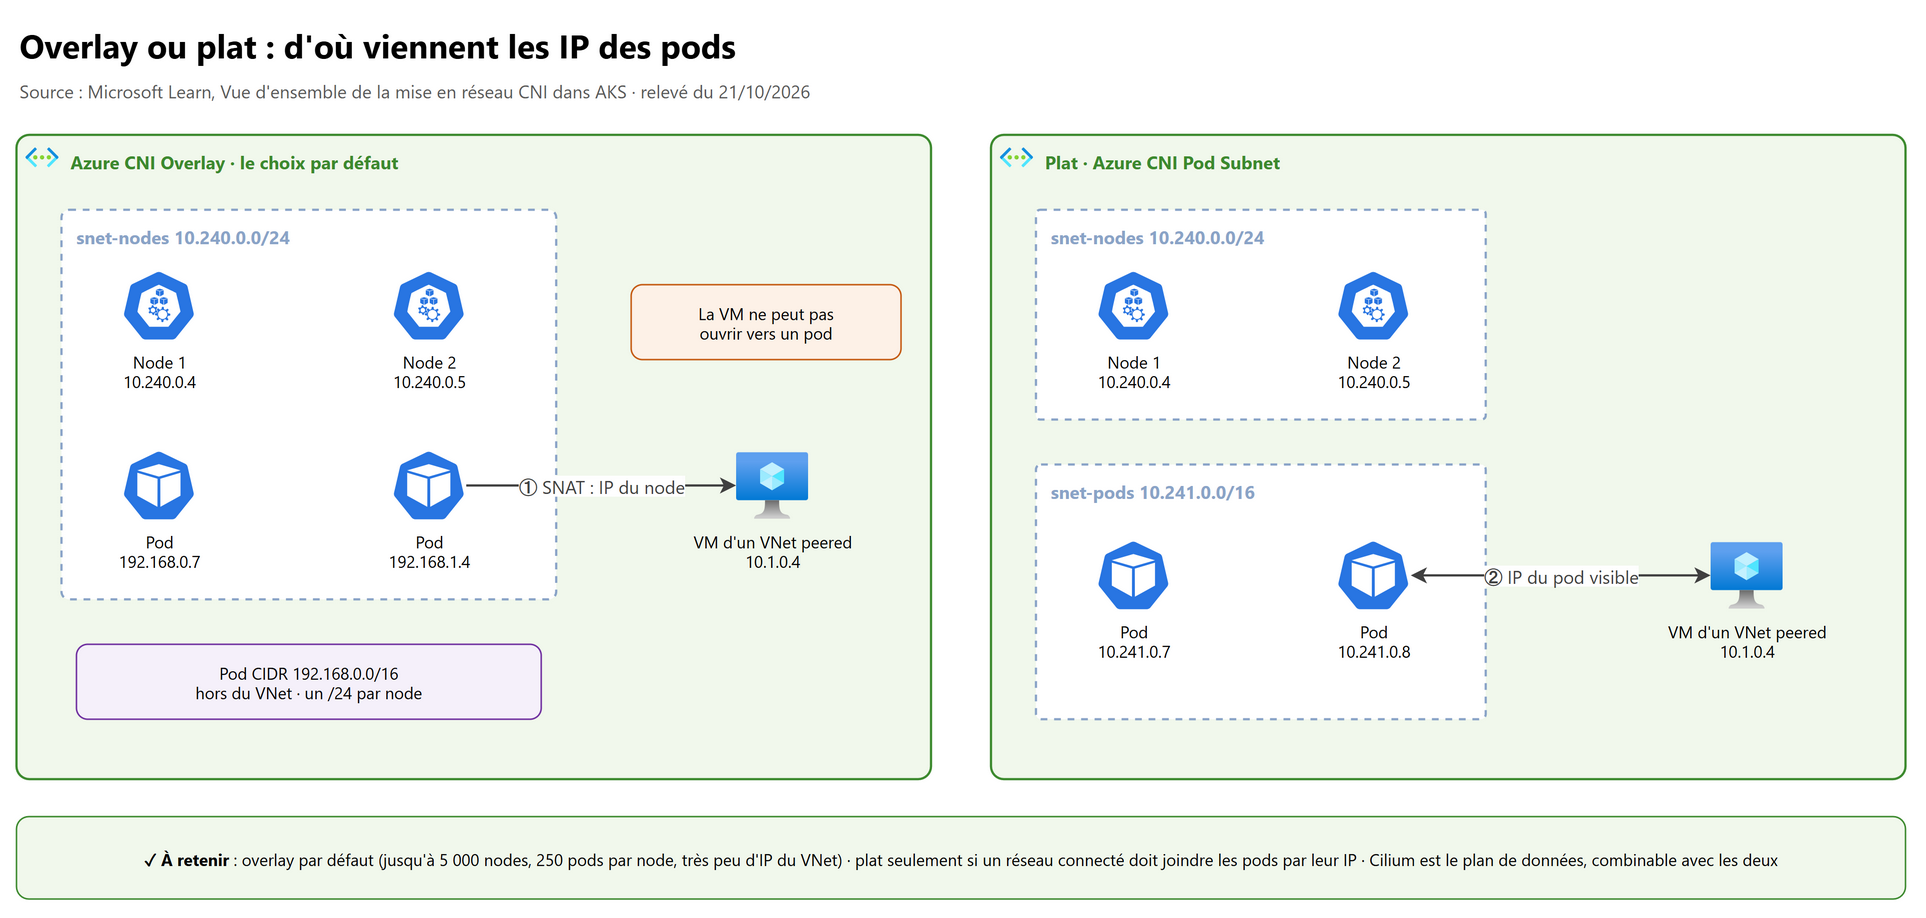
- Overlay ou Pod Subnet ? Overlay par défaut (économise le VNet, 250 pods par node, 5 000 nodes, SNAT vers le node) ; Pod Subnet quand les pods doivent être joignables directement depuis le VNet. → 02, 2.4
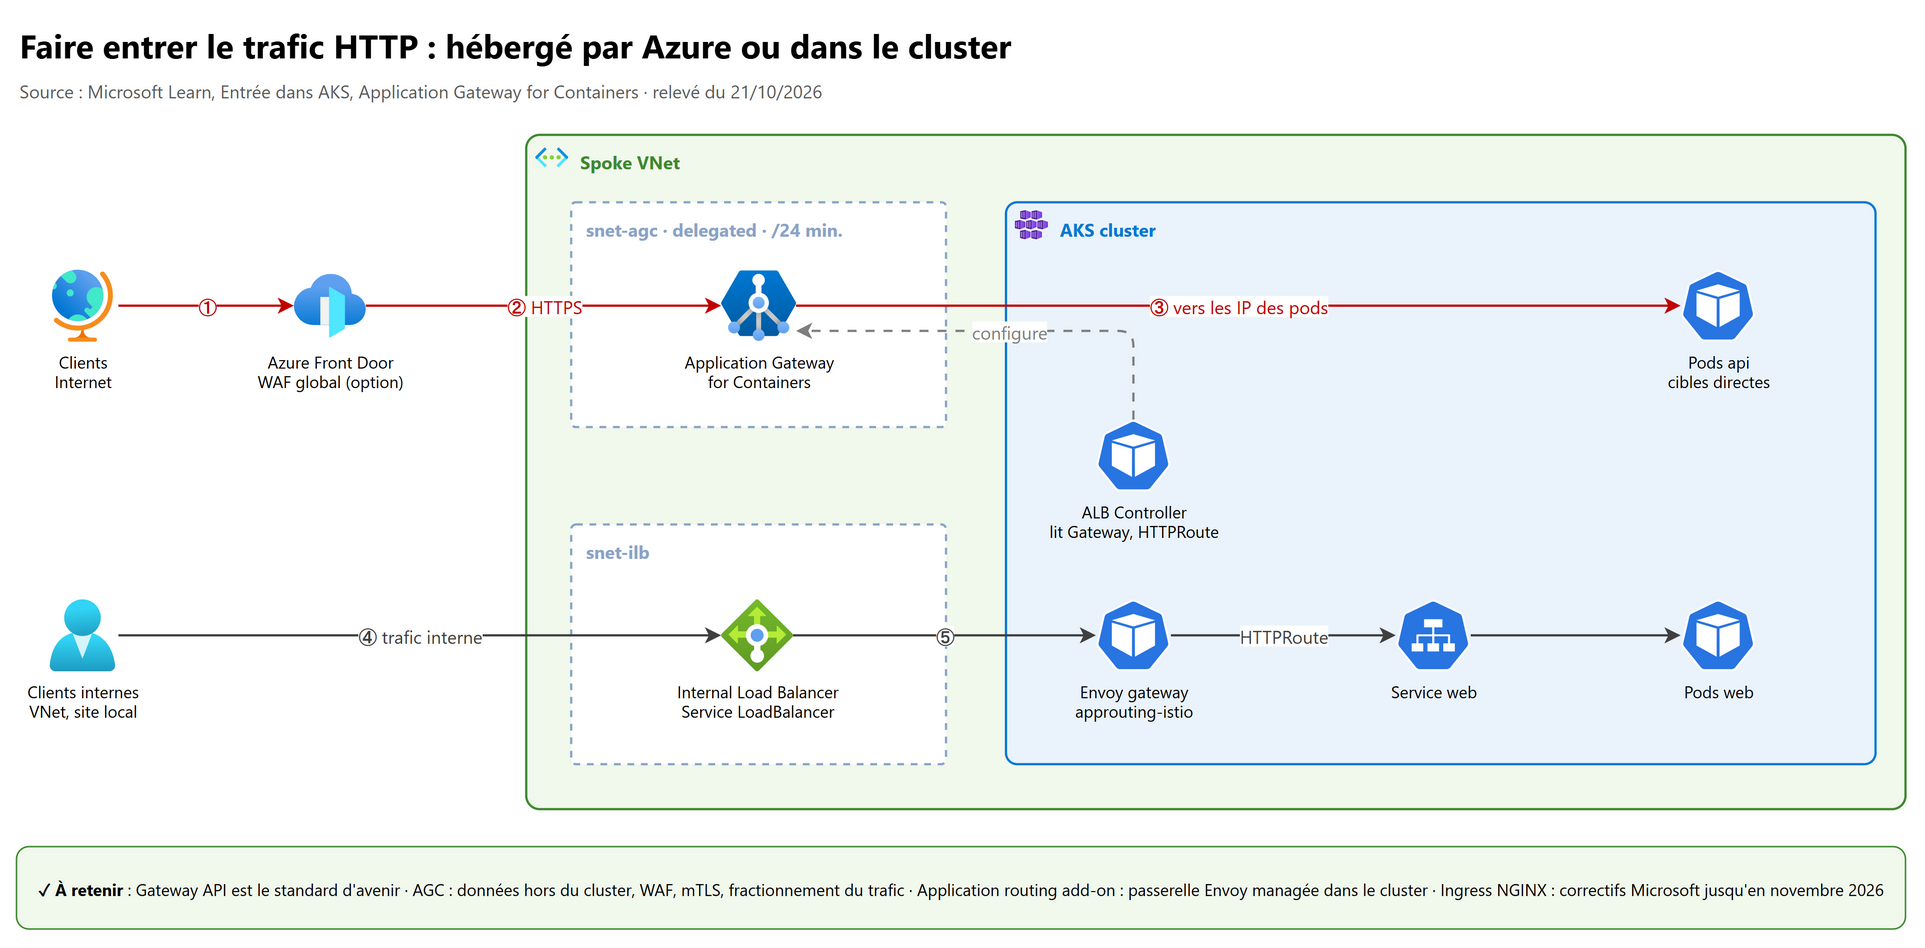
- Ingress ou Gateway API ? La Gateway API est le successeur, orientée rôles ; l'Ingress NGINX communautaire est arrêté et les correctifs du NGINX de l'Application routing add-on s'arrêtent en novembre 2026. → 02, 4.2
- Verrouiller la sortie ?
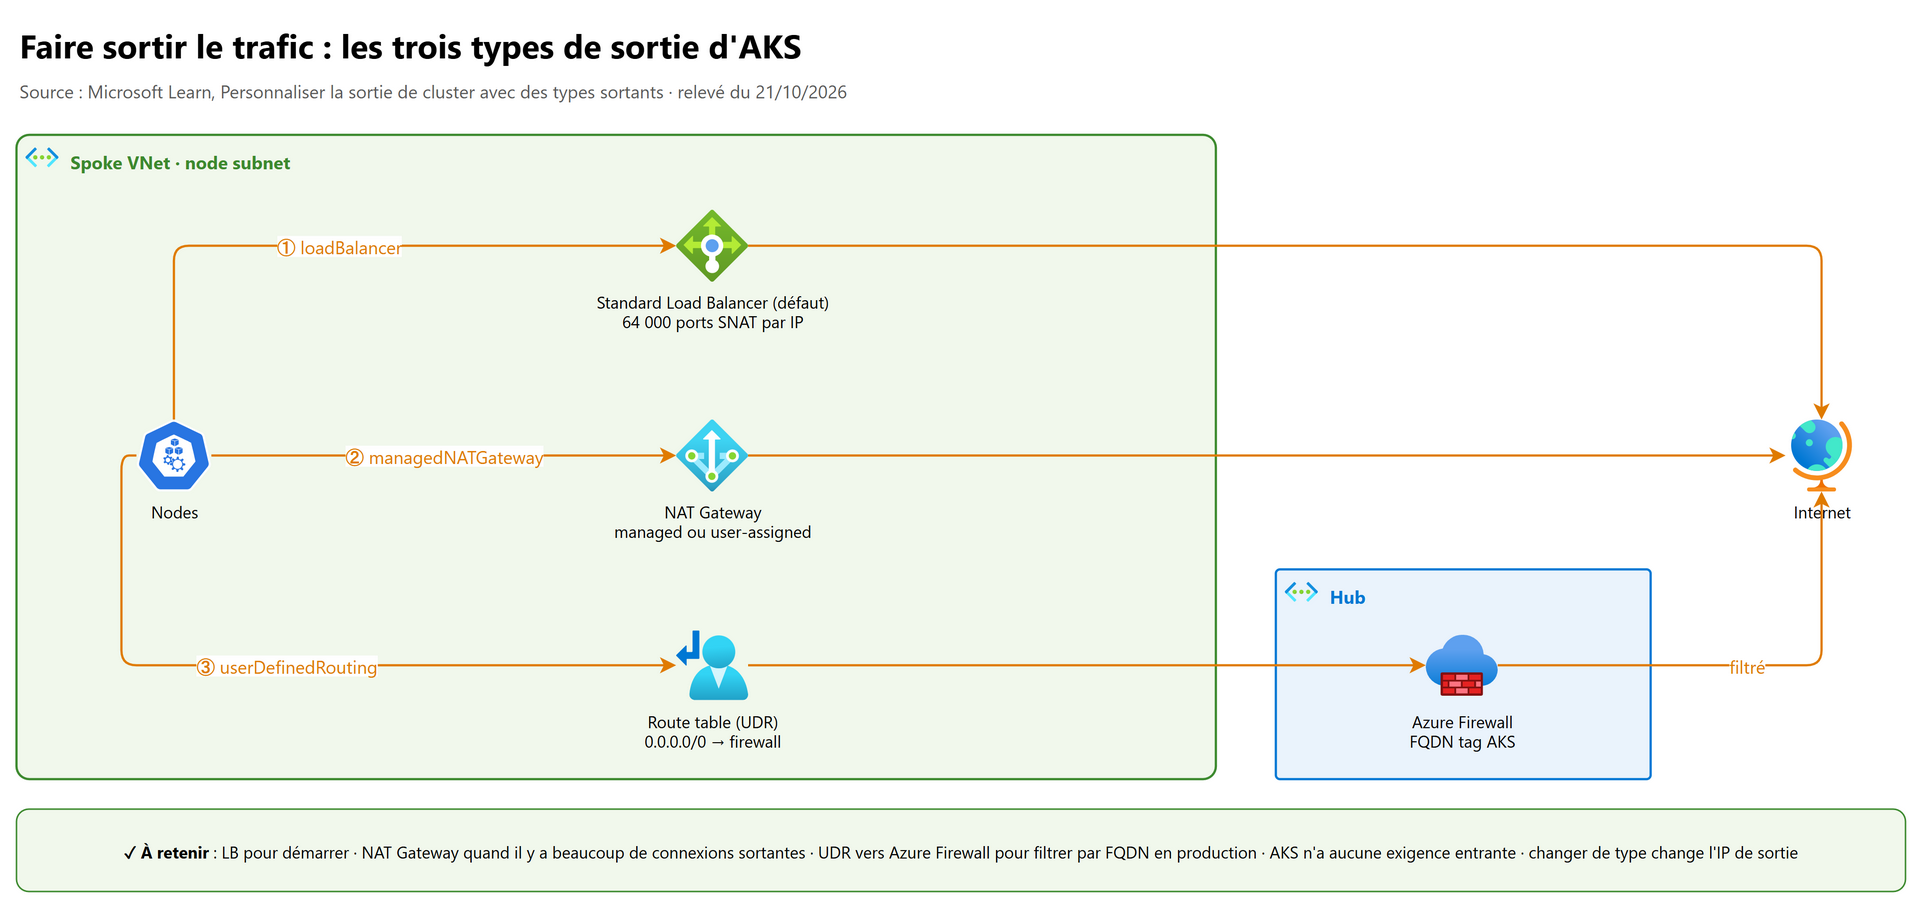
outboundType: userDefinedRoutingvers l'Azure Firewall avec les FQDN requis par AKS, plus FQDN filtering Cilium dans le cluster. → 02, 5.2 - Épuisement SNAT ? Les ports SNAT de l'IP de sortie sont partagés entre les nodes ; parade : plus d'IP, ports explicites, NAT Gateway, réutilisation des connexions. → 02, 5.1
- Private cluster ou API Server VNet Integration ? Les deux rendent l'API server privé ; VNet Integration le projette dans un subnet délégué, sans tunnel, et permet de basculer public/privé sans redéployer. → 02, 6
- Pourquoi default-deny casse tout ? Il bloque aussi le DNS : toujours autoriser CoreDNS (UDP/TCP 53) en premier. → 02, 7
Sécurité et identité#
- Les identités d'un cluster ? Utilisateur vers l'API server (Entra), cluster identity, kubelet identity (pull ACR), Workload ID pour les pods. → 03, 1
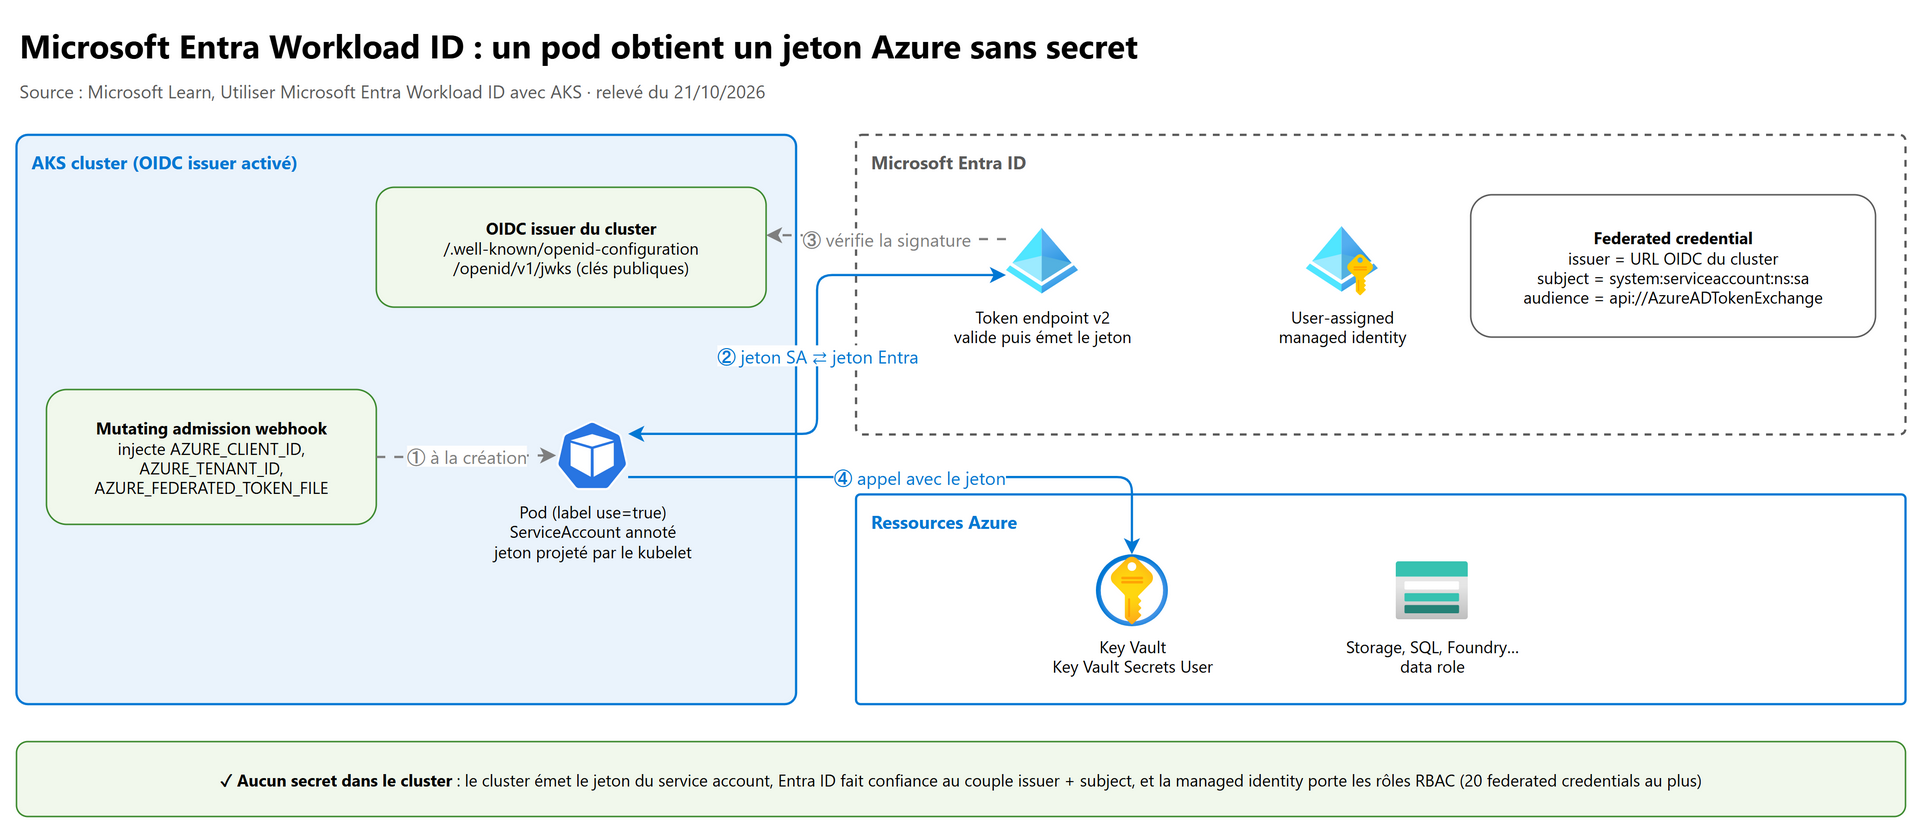
- Un pod lit Key Vault sans secret ? Workload ID : ServiceAccount annoté, federated credential sur une managed identity, jeton projeté échangé contre un jeton Entra. → 03, 3
- Les Secrets Kubernetes sont chiffrés ? Seulement encodés en base64 ; chiffrer etcd avec KMS et préférer le Secrets Store CSI Driver avec Azure Key Vault. → 03, 4
- Seules des images de confiance ? ACR privé, scan Defender, signature et vérification, admission par Azure Policy et Deployment Safeguards. → 03, 5
- Un namespace par client suffit-il ? Pour des équipes de confiance, oui avec quotas, RBAC et network policies ; pour des locataires hostiles, non : clusters séparés. → 03, 9
Stockage, scalabilité, fiabilité#
- Azure Disks ou Azure Files ? Disks : un seul node à la fois (RWO), pour une base ; Files : partagé (RWX), pour plusieurs replicas. → 04, 1.3
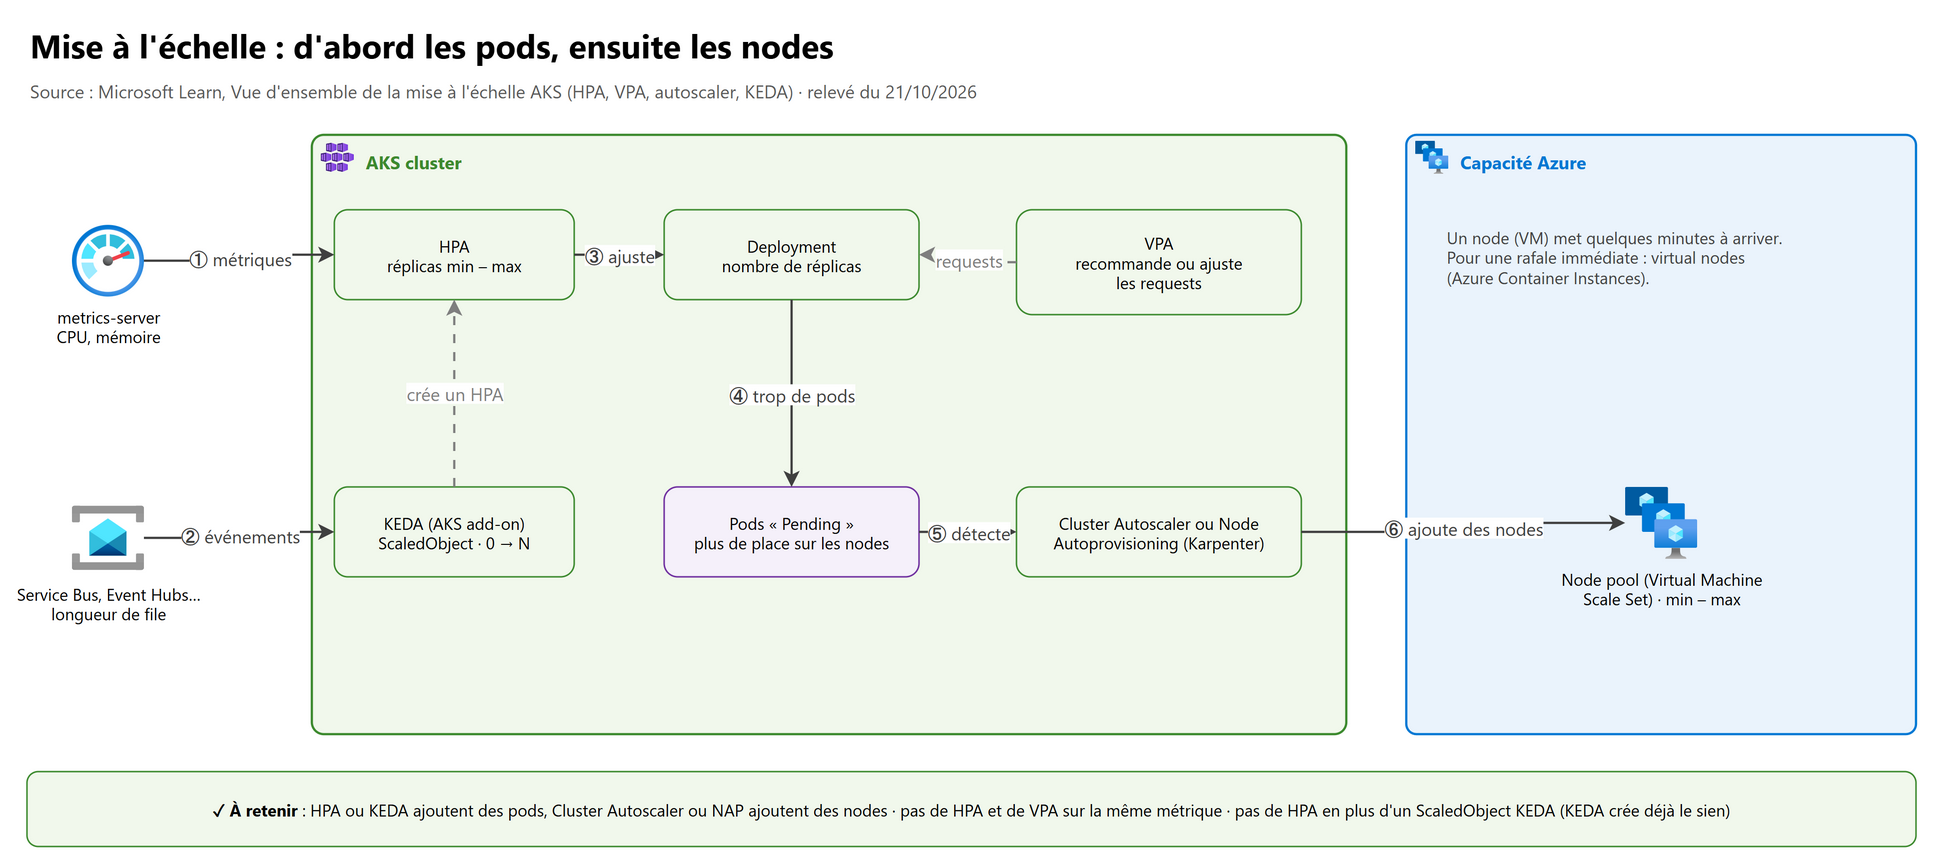
- HPA, KEDA, VPA, cluster autoscaler, NAP ? HPA et KEDA ajoutent des pods, VPA ajuste leurs requests, cluster autoscaler et NAP ajoutent des nodes. → 04, 2.2
- Résister à la perte d'une zone ? Node pools sur 3 zones,
topologySpreadConstraints, disques ZRS ou réplication applicative, PDB. → 04, 3.2 - Upgrade sans coupure ? Canal
stable, maintenance window,maxSurgeadapté, PDB réalistes, cluster canari enrapid. → 04, 3.4 - Un PDB bloque l'upgrade ? Un PDB trop strict empêche le drain ; corriger le PDB ou ajouter des replicas, et savoir que l'upgrade imposé par la plateforme ne l'attend pas. → 04, 3.3
Exploitation#
- Superviser sans facture énorme ? Managed Prometheus pour les métriques, Container Insights en preset Logs and Events,
kube-audit-adminplutôt quekube-audit. → 05, 1 - Qui a supprimé ce déploiement ? Table
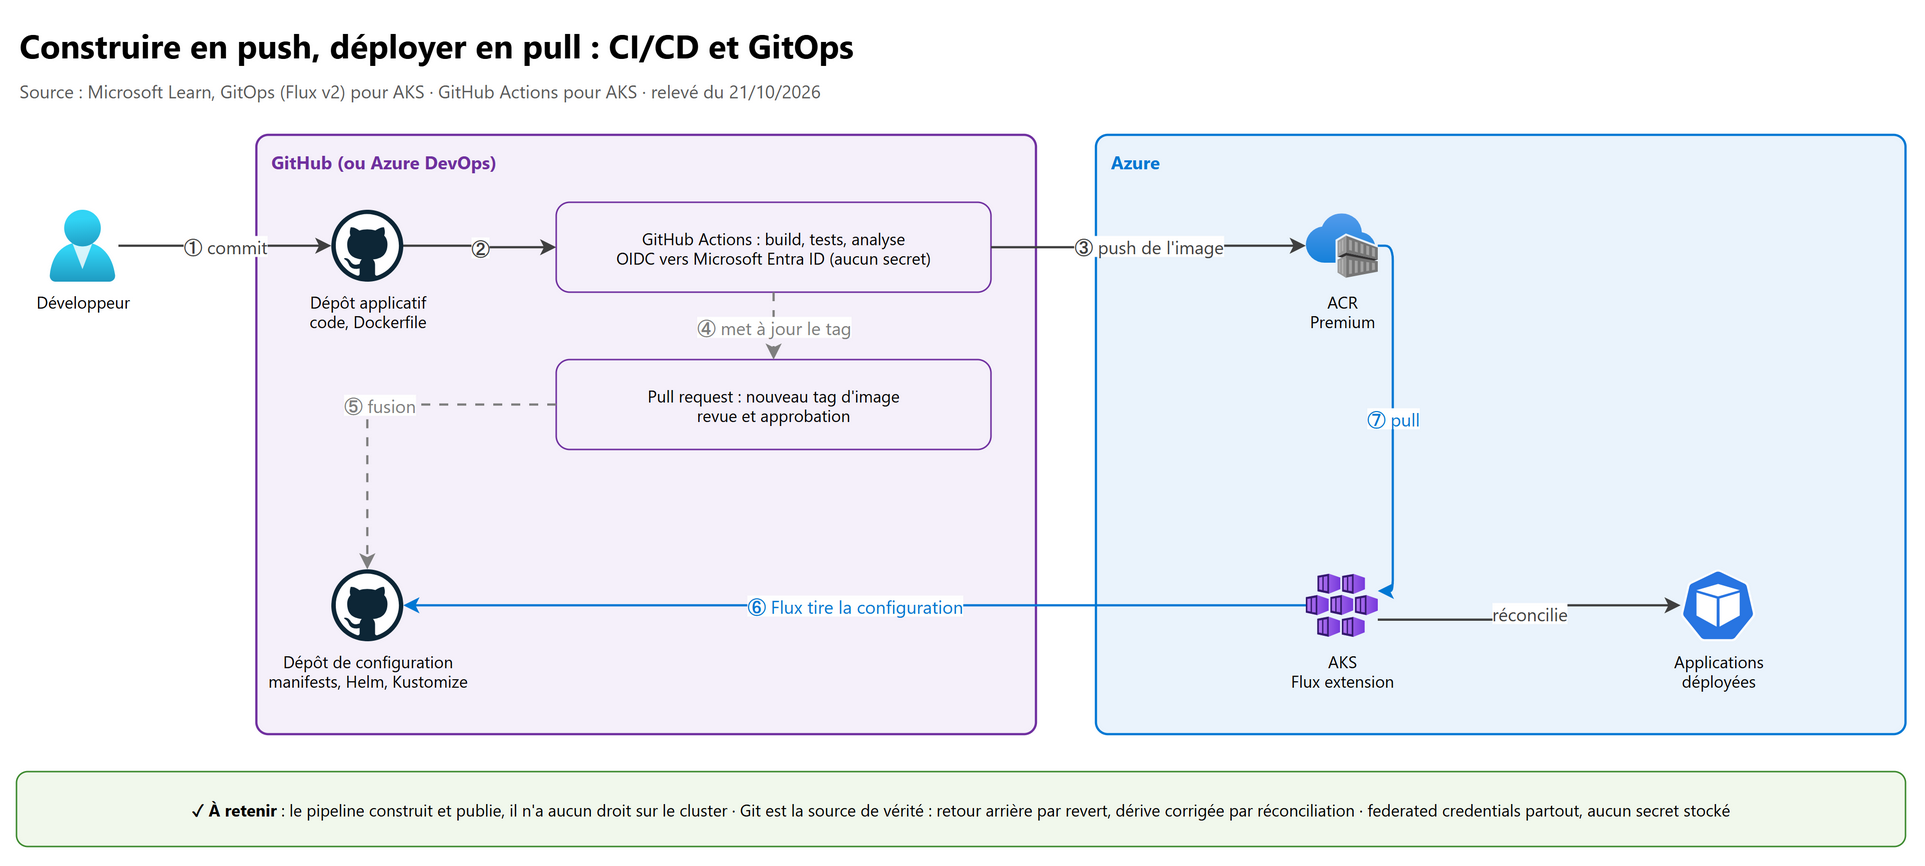
AKSAuditAdmin(resource-specific mode) si le Diagnostic setting était actif. → 05, 1.3 - Push ou pull (GitOps) ? Pull avec Flux : le cluster tire l'état de Git, aucun accès sortant du pipeline vers le cluster, dérive corrigée. → 05, 2
- 30 clusters à mettre à jour ? Azure Kubernetes Fleet Manager : stages et groups, du canari à la production. → 05, 4
IA et LLM#
- Où servir un modèle open source ? Foundry si un modèle managé suffit, Container Apps serverless GPUs pour l'intermittent, AKS + KAITO pour le volume, les GPU précis et le contrôle. → 06, 2
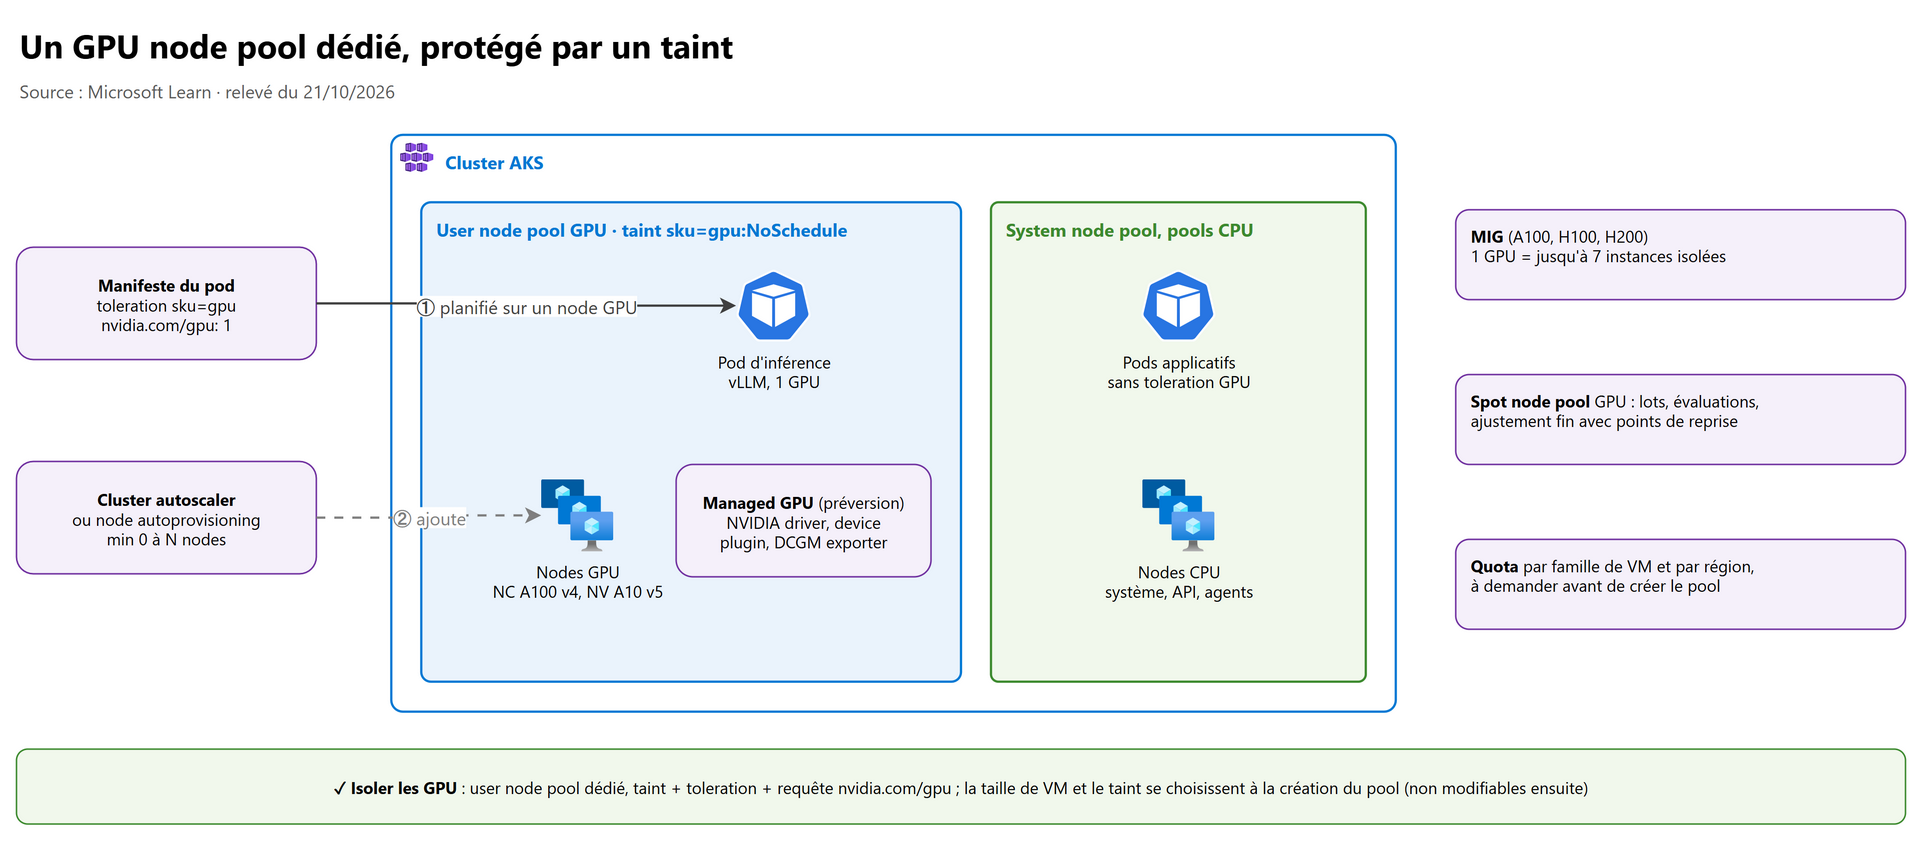
- Isoler les GPU ? GPU node pool dédié avec taint, toleration et requête
nvidia.com/gpusur les pods d'inférence. → 06, 3.3 - Scaler un LLM ? Sur la file d'attente ou le cache KV (KEDA via Prometheus), pas sur le CPU ; garder un replica chaud contre le démarrage à froid. → 06, 6
- Pourquoi une AI gateway ? Un point d'entrée unique : authentification Entra, quotas de jetons, routage et débordement entre modèles managés et auto-hébergés. → 06, 8
Choix de service#
- AKS ou Container Apps ? Container Apps tant que l'API Kubernetes, les network policies, l'UDP ou des GPU précis ne sont pas nécessaires. → section 4
- Quand ACI ? Une tâche ponctuelle isolée, ou des rafales via les AKS virtual nodes. → section 3
- Quand Web App for Containers ? Pur HTTP, équipe déjà sur App Service. → section 1
- Pourquoi ARO plutôt qu'AKS ? Uniquement si l'organisation est sur OpenShift et veut son outillage, avec un support commun Red Hat et Microsoft. → section 1
7. Trois études de cas#
7.1 Une plateforme multi-équipes dans un secteur régulé#
« Une banque veut héberger 15 équipes applicatives sur Kubernetes, avec des audits réguliers. Proposez une architecture. »
Réponse attendue :
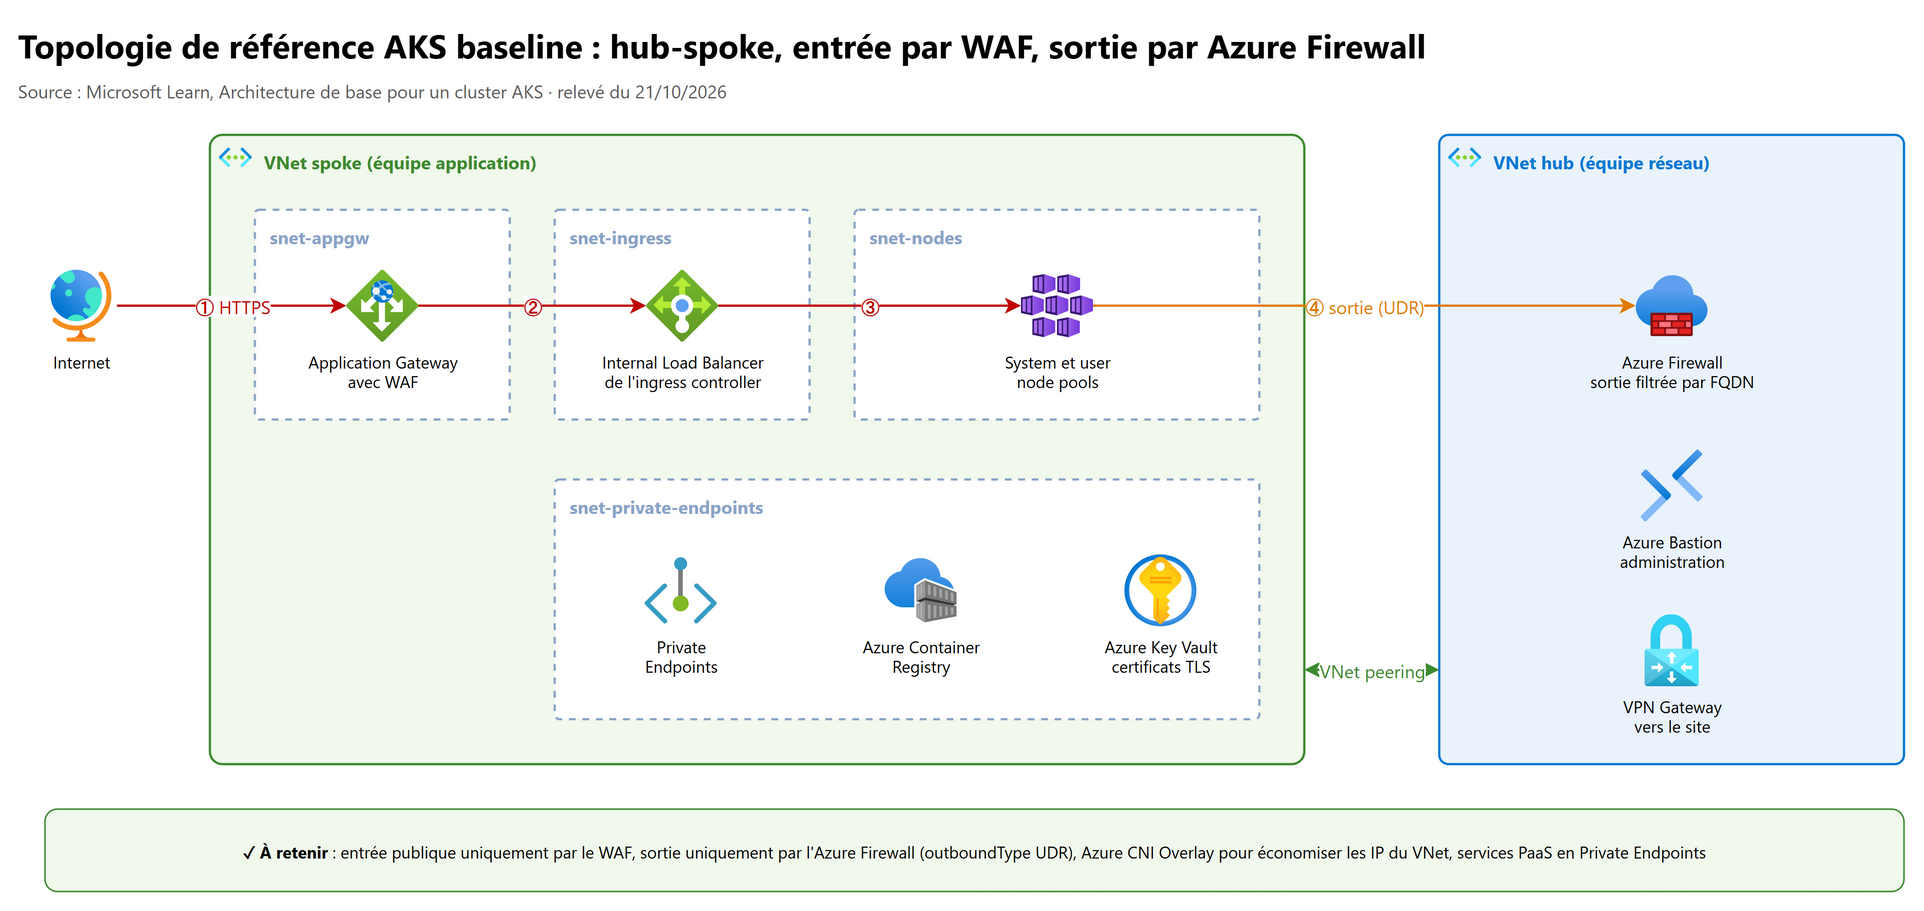
- Topologie : un cluster par environnement (dev, recette, production), sur le modèle AKS baseline en hub-spoke ; un cluster dédié seulement pour une vraie frontière de confiance (données de cartes, filiale). → 01, 5
- Accès : Microsoft Entra ID, local accounts désactivés, Azure RBAC for Kubernetes authorization par namespace et par groupe, PIM pour l'élévation. → 03, 2
- Isolation : un namespace par équipe,
ResourceQuota, network policies default-deny (Cilium), Deployment Safeguards enEnforceavec PSSRestricted. → 03, 6 - Réseau : API server privé (API Server VNet Integration), entrée par Application Gateway WAF ou Application Gateway for Containers, sortie UDR vers l'Azure Firewall, Azure Container Registry Premium et Azure Key Vault en Private Endpoints. → 02, 9
- Preuves pour l'audit : Defender for Containers,
kube-audit-adminetguardvers Log Analytics et Microsoft Sentinel, Azure Policy pour la conformité. → 05, 1.3 - Cycle de vie : tier Premium + LTS si l'organisation ne suit pas le rythme annuel, Fleet Manager au-delà de quelques clusters.
7.2 Une API à très forte variabilité de charge#
« Une API de billetterie passe de 50 à 20 000 requêtes par seconde à l'ouverture des ventes. Comment l'hébergez-vous ? »
Réponse attendue :
- D'abord la question du service : sans besoin de l'API Kubernetes, Container Apps (scale to zero, scaling HTTP ou KEDA, revisions pour déployer en canari) répond avec très peu d'exploitation. → section 4
- Si AKS est imposé : requests justes, HPA (ou KEDA sur la file d'attente des commandes), cluster autoscaler ou NAP, surprovisionnement par pods de faible priorité pour absorber le pic pendant que les nodes arrivent. → 04, 2
- Fiabilité : 3 zones,
topologySpreadConstraints, PDB ; Azure Front Door devant, éventuellement deux régions. → 04, 3 - Réseau : anticiper l'épuisement SNAT (NAT Gateway) et dimensionner le subnet pour le surge. → 02, 5.1
- Le piège : l'autoscaling des nodes prend des minutes ; pour un pic annoncé, pré-scaler avant l'ouverture.
7.3 Une plateforme d'inférence LLM privée#
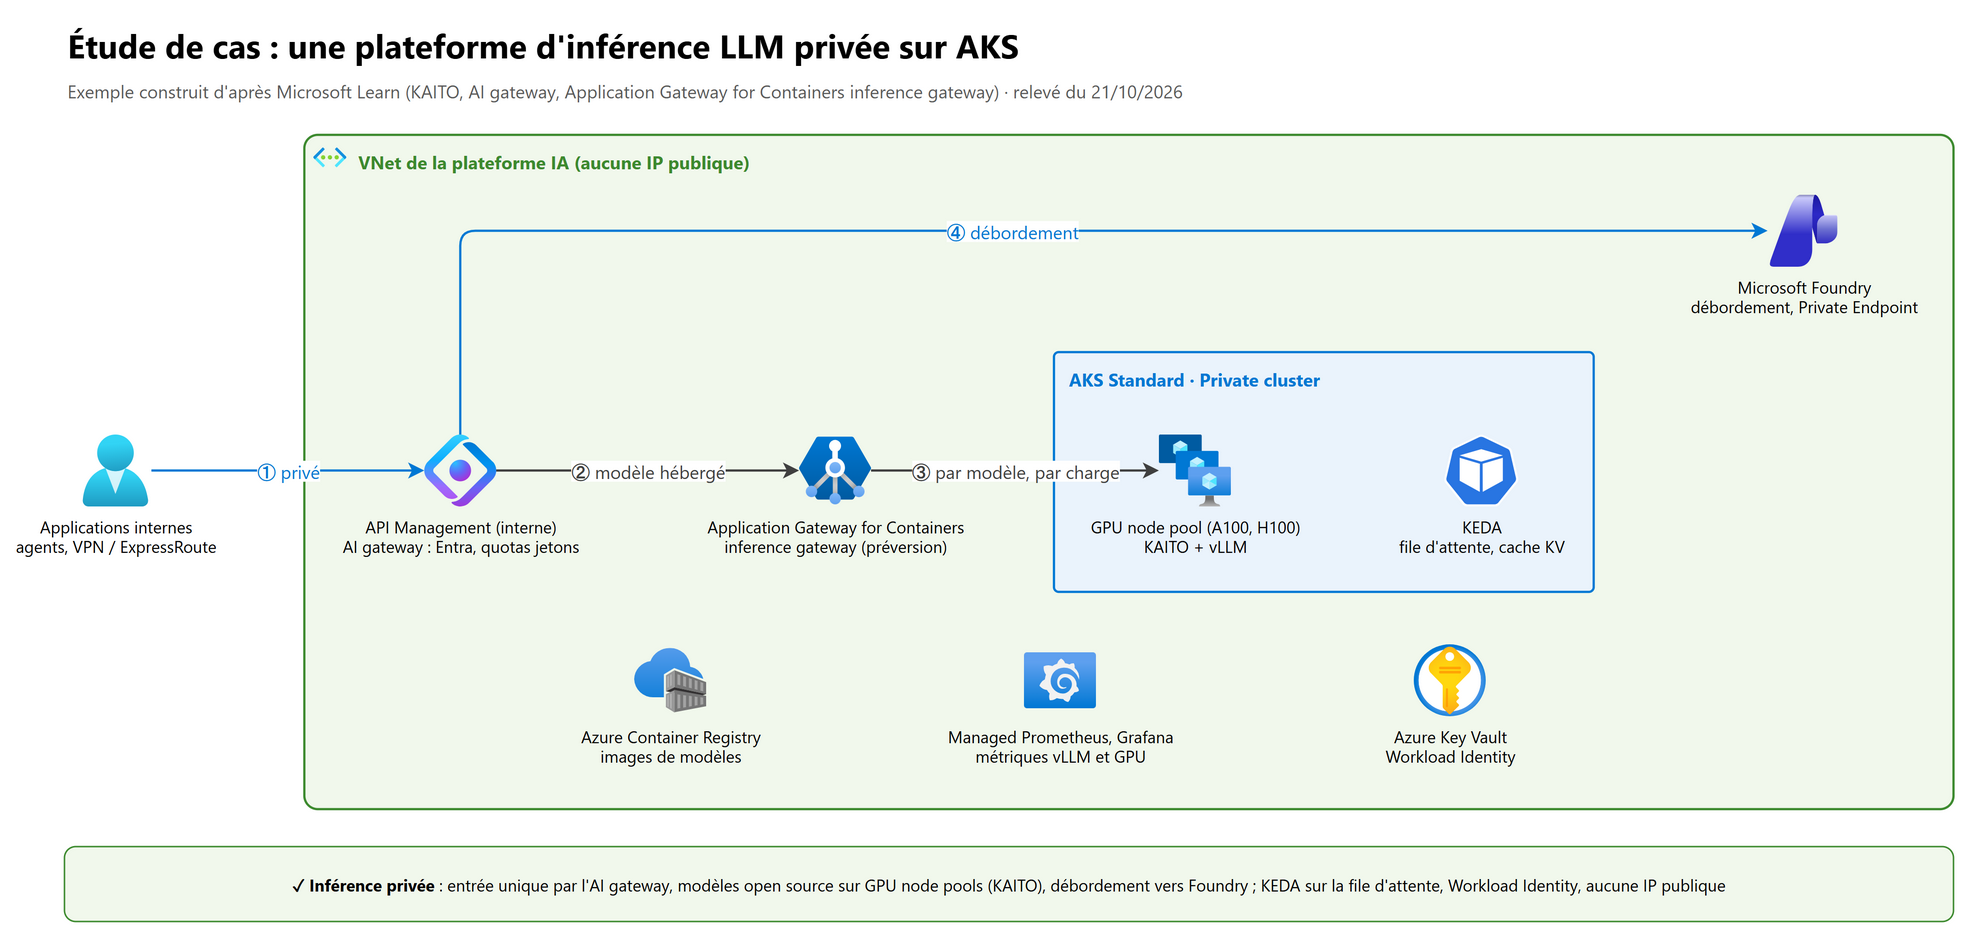
« Un industriel veut servir des modèles open source sur ses données, sans rien exposer sur Internet. »
Réponse attendue :
- Pourquoi AKS : volume soutenu, GPU précis (A100, H100), données qui ne sortent pas, besoin d'ajuster finement les modèles. → 06, 2
- Plateforme : AKS Standard en Private cluster, GPU node pools dédiés (taint), KAITO avec vLLM, quota GPU demandé à l'avance. → 06, 4
- Entrée : API Management interne en AI gateway (authentification Entra, quotas de jetons, débordement vers Microsoft Foundry), puis l'inference gateway d'Application Gateway for Containers (préversion) pour router par modèle et par charge. → 06, 8
- Scaling : KEDA sur la file d'attente vLLM, un replica chaud, images de modèles en cache. → 06, 6
- Sécurité et exploitation : Workload Identity, aucune IP publique, sortie par l'Azure Firewall, métriques vLLM et GPU dans Managed Prometheus et Grafana. → 06, 10
8. Les pièges d'entretien#
| Piège | Ce qu'il faut dire à la place |
|---|---|
| Proposer AKS par réflexe | « Pourquoi Kubernetes ? » : partir du besoin, citer Container Apps comme premier candidat |
| Confondre le pricing tier Standard et le mode AKS Standard | Tier = SLA et capacité du control plane ; mode = Automatic ou Standard |
| Dire que les Secrets Kubernetes sont chiffrés | Base64 seulement ; KMS pour etcd, Key Vault avec le CSI Driver |
| Un cluster pour isoler des clients hostiles « grâce aux namespaces » | Un cluster n'est pas une frontière contre des locataires hostiles |
| Oublier le DNS dans une politique default-deny | Autoriser CoreDNS d'abord |
| Kubenet pour un nouveau cluster | Retiré le 31/03/2028 ; Azure CNI Overlay par défaut |
| Ingress NGINX pour un nouveau projet | Gateway API (Application routing add-on ou Application Gateway for Containers) |
Modifier les VM du groupe MC_ |
Passer par l'API AKS, verrouiller ReadOnly |
| Scaler un LLM sur le CPU | File d'attente ou cache KV |
| Promettre un SLA AKS unique | SLA du control plane et des node pools à composer, plus celui de l'application |
9. Ce que je dois savoir dessiner au tableau#
- Le control plane et les nodes, avec la boucle de réconciliation (01-1).
- Les deux resource groups d'un cluster et le groupe
MC_(01-3). - L'AKS baseline en hub-spoke : WAF en entrée, Azure Firewall en sortie (01-5).
- Azure CNI Overlay et Pod Subnet avec leurs plages d'adresses (02-2).
- Le chemin d'une requête : Load Balancer ou passerelle L7, Service, pods (02-4).
- Les trois
outboundType(02-5). - Workload ID : OIDC issuer, federated credential, échange de jeton (03-3).
- Les trois niveaux d'autoscaling (04-2).
- La chaîne CI puis GitOps (05-2).
- Un GPU node pool avec taint et KAITO (06-2, 06-3).
- La carte des services de conteneurs d'Azure (07-1).
Références#
Toutes lues le 21/10/2026 :
- Choose an Azure container service
- Architectural considerations for choosing an Azure container service
- Comparing Container Apps with other Azure container options
- Comparing AKS with other Azure container options
- Compute and billing structures in Azure Container Apps
- Workload profiles in Azure Container Apps
- Networking in an Azure Container Apps environment
- Using serverless GPUs in Azure Container Apps
- Jobs in Azure Container Apps
- Azure Container Apps hosting of Azure Functions
- Private endpoints and DNS in Azure Container Apps
- Azure Container Registry SKU features and limits
- Reliability in Azure Container Registry
- Connect privately to an Azure container registry
- Secure your Azure Container Registry deployment
- Application Gateway for Containers : inference gateway