

Version : 1.1 · Date : 2026-10-21 · Domaine 3 de l'examen : Design and implement a GenAIOps infrastructure (20 à 25 %)
En une phrase : la GenAIOps applique au LLM ce que la MLOps applique au modèle ML : des environnements Foundry isolés et déployés par IaC, des identités sans clé, un réseau privé, des foundation models choisis sur preuves et déployés sans casser la production (versions, canary, PTU), et des prompts traités comme du code (Git, pull request, version d'agent).
Ce que l'examen demande#
Domaine Design and implement a GenAIOps infrastructure du guide d'étude AI-300 :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| Implement Foundry environments and platform configuration | ||
| 1 | Create and configure Foundry resources and project environments | 2 |
| 2 | Configure identity and access management with managed identities and role-based access control (RBAC) | 3 |
| 3 | Implement network security and private networking configurations | 4 |
| 4 | Deploy infrastructure using Bicep templates and Azure CLI | 5 |
| Deploy and manage foundation models for production workloads | ||
| 5 | Deploy foundation models by using serverless API endpoints and managed compute options | 6 |
| 6 | Select appropriate models for specific use cases | 7 |
| 7 | Implement model versioning and production deployment strategies | 8 |
| 8 | Configure provisioned throughput units for high-volume workloads | 9 |
| Implement prompt versioning and management with source control | ||
| 9 | Design and develop prompts | 10 |
| 10 | Create prompt variants and compare performance across different prompts | 11 |
| 11 | Implement version control for prompts by using Git repositories | 12 |
Ce chapitre prend l'angle opérations (environnements, promotion, migration, capacité, prompts en tant que code). Les notions de développeur sont dans le cours AI-103 et ne sont pas répétées : elles sont signalées par un lien à chaque fois.
1. Les bases : GenAIOps et ce que vous savez déjà#
1.1 Le cycle GenAIOps#
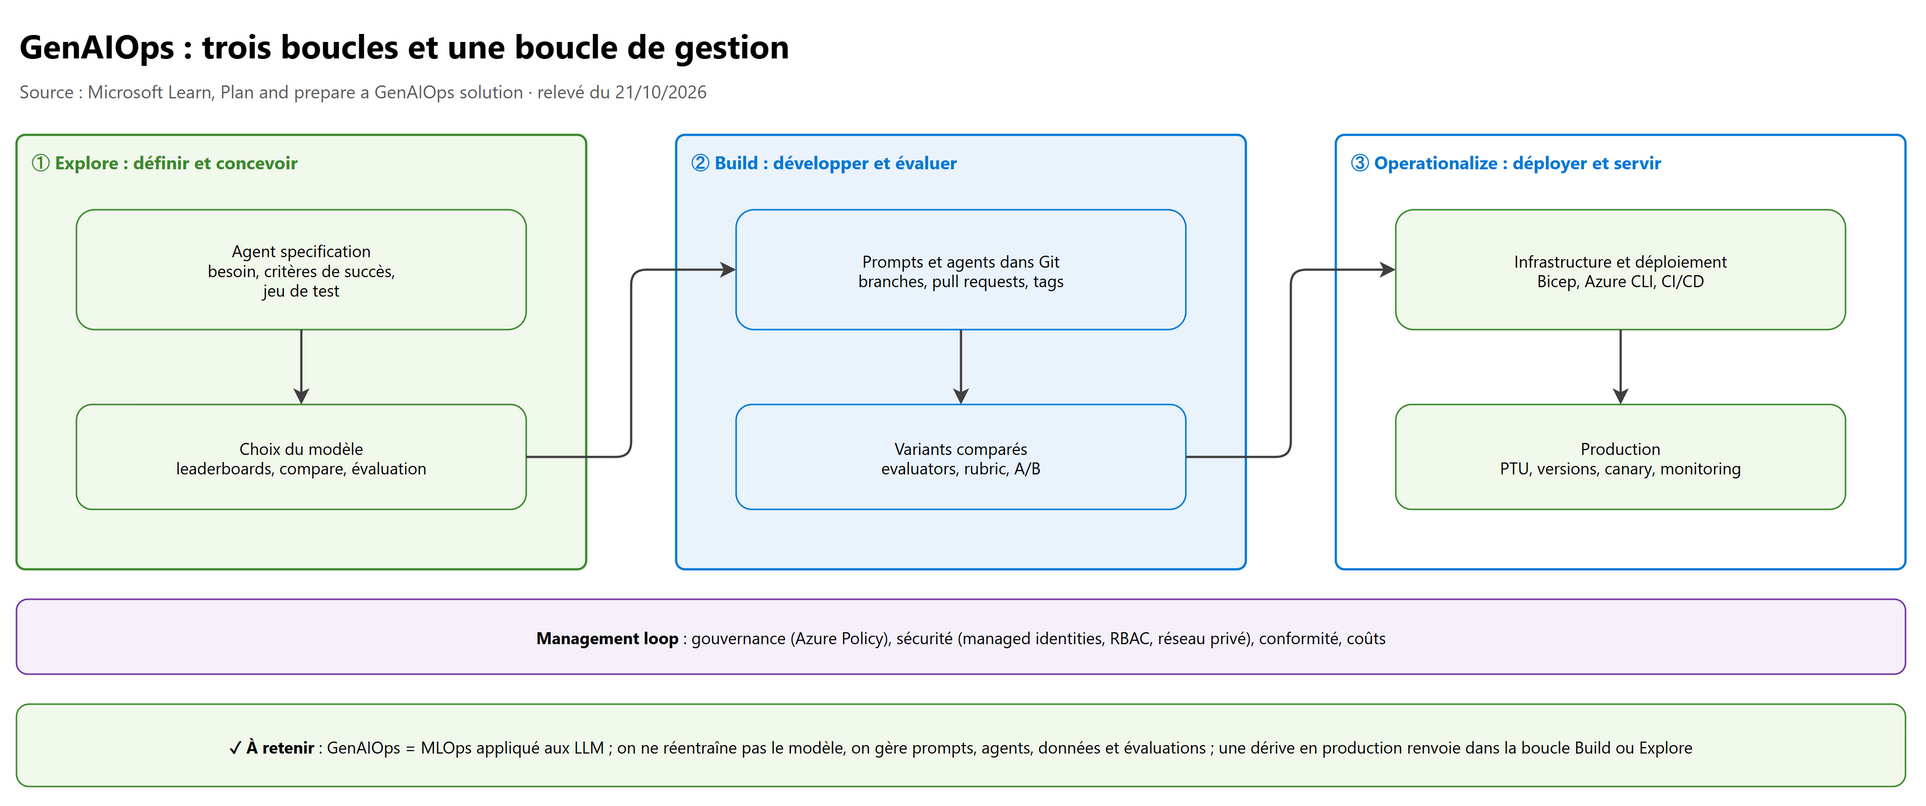
La GenAIOps (parfois appelée LLMOps) est une spécialisation de la MLOps pour les applications qui intègrent des modèles de langage. La différence tient à ce qu'on gère : on ne construit pas le modèle, on gère des modèles pré-entraînés, des prompts, des agents et des connecteurs de données, et on les évalue avec des mesures nouvelles (cohérence, groundedness, coût par requête) plutôt que la seule précision.
| Boucle | Ce qu'on y fait | Dans ce cours |
|---|---|---|
| Explore | Définir le besoin (agent specification : objectif, critères de succès, jeu de test) et concevoir : modèle, ancrage, prompts | Sections 7 et 10 |
| Build | Développer, puis évaluer de façon itérative jusqu'aux cibles de qualité et de sécurité | Sections 11 et 12, chapitre 06 |
| Operationalize | Déployer et servir de façon fiable et responsable | Sections 2 à 6, 8 et 9 |
| Management loop (autour des trois) | Gouvernance, sécurité, conformité | Sections 3, 4 et 7.4 |
Le cycle n'est pas linéaire : une dérive en production (réponses fausses, coût qui explose) renvoie dans la boucle Build (prompt, données) ou Explore (changer de modèle).
1.2 Ce qui est déjà traité ailleurs#
| Sujet | Où le relire |
|---|---|
| Foundry resource, projects, connections, architecture de référence baseline Foundry chat | AI-103 · 02, section 1 |
| Les deployment types (Global, Data Zone, Standard × Standard, Provisioned, Batch, Developer) | AI-103 · 02, section 3.2 |
| Spillover PTU → Standard | AI-103 · 02, section 3.3 |
| Version upgrade policy d'un model deployment | AI-103 · 02, section 4.1 |
| Agent versions, agent endpoint | AI-103 · 02, section 4.2 |
CI/CD Foundry avec microsoft/ai-agent-evals |
AI-103 · 02, section 5 |
| Quotas, 429, PTU (leaky bucket, réservations), coûts | AI-103 · 03, section 2 |
| Rôles Foundry, réseau privé, CMK, Azure Policy | AI-103 · 03, section 5 |
| Critères de choix d'un modèle, model router | AI-103 · 01, section 2 |
| Techniques de prompt engineering, paramètres | AI-103 · 07, section 2 |
| Private Endpoint, DNS privé, Azure Firewall, workload identity federation | SC-500 · 06, SC-500 · 01 |
2. Foundry resources et project environments#
2.1 Resource ou project : où mettre la frontière#
Foundry resource (Microsoft.CognitiveServices/accounts, kind AIServices) |
Foundry project (accounts/projects) |
|
|---|---|---|
| Rôle | Frontière de gouvernance : réseau, sécurité, CMK, model deployments, quota | Frontière de développement d'une équipe ou d'un cas d'usage |
| Contient | Model deployments partagés, connections partagées, guardrails | Agents, evaluations, datasets, indexes, files, sa propre managed identity |
| Isolation RBAC | Oui | Oui pour les capacités agents (agents, responses, evaluations…) |
Attention, toutes les capacités ne s'isolent pas par project (page Foundry rollout) :
| Capacité | Isolable par project ? | Conséquence |
|---|---|---|
| Agents, responses, evaluations, datasets, indexes, files | Oui | Project par cas d'usage dans un environnement partagé |
| Fine-tune training | Non (default project seulement) ; les fine-tuned deployments sont partagés entre projects | Une équipe qui doit fine-tuner seule → Foundry resource séparée |
| OpenAI image, video, batch | Non | Workload isolé |
| Content Understanding | Organisation par project, mais pas d'isolation RBAC | Resource séparée si l'isolation est exigée |
| Speech, Language | Par project pour le fine-tuning seulement | BYO Storage pour une couverture CMK complète |
| Translator | Non (API au niveau resource) | Resource séparée si isolation |
2.2 Topologie par environnement#
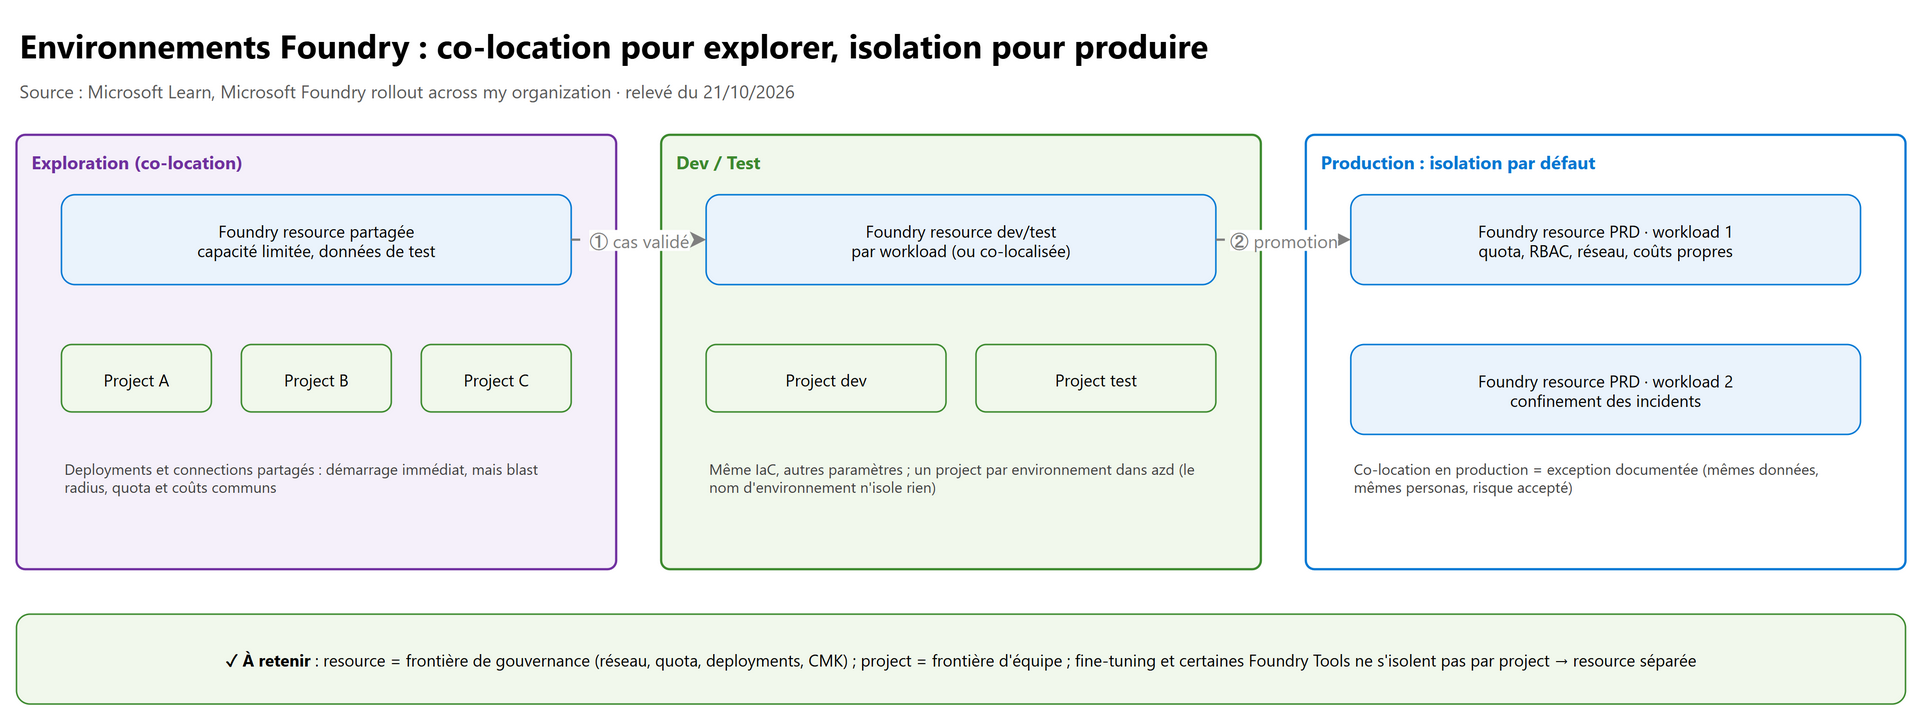
| Topologie | Mise en place | Pour | Contrepartie |
|---|---|---|---|
| Co-located | Une Foundry resource, plusieurs projects (souvent un par cas d'usage) | Exploration, prototypes, équipes qui profitent des deployments et connections partagés | Blast radius, épuisement du quota et erreurs de configuration partagés |
| Fully isolated | Une Foundry resource par frontière de workload de production (souvent un project principal) | Production : confinement, RBAC, quota et coûts indépendants | Plus de ressources à gérer, self-service plus difficile |
Recommandation Microsoft : en production, l'isolation est le défaut ; la co-location y est une exception documentée (mêmes données, mêmes personas, risque accepté). En exploration, la co-location est le défaut. L'exemple de référence (Contoso) : une Foundry resource d'exploration partagée et limitée en capacité, puis des environnements dev/test, puis une production isolée pour le petit nombre de cas financés.
Règles d'exploitation :
- Même IaC, autres paramètres pour chaque environnement ; avec
azd, un project par environnement (azd env new development | test | production) : le nom d'environnementazdn'isole aucune ressource Azure. - Promouvoir la même révision de code d'un environnement à l'autre (pas un artefact partagé pour un hosted agent : on reconstruit à partir de la révision testée).
- Les connections créées au niveau resource sont visibles de tous les projects ; au niveau project, seulement de ce project.
2.3 Créer une Foundry resource et un project#
Prérequis CLI de la doc : Azure CLI 2.80 ou plus, rôle Contributor ou Owner sur le groupe de ressources.
# 1. Foundry resource : managed identity et project management obligatoires pour créer des projects
az cognitiveservices account create \
  --name aif-support-dev --resource-group rg-ai-dev --location swedencentral \
  --kind AIServices --sku S0 \
  --custom-domain aif-support-dev \
  --assign-identity \
  --allow-project-management true

# 2. Project
az cognitiveservices account project create \
  --name aif-support-dev --resource-group rg-ai-dev \
  --project-name support --location swedencentral

# 3. Endpoint du project, à donner à l'application (avec le nom du deployment)
az cognitiveservices account project show --name aif-support-dev --resource-group rg-ai-dev \
  --project-name support --query 'properties.endpoints."AI Foundry API"' --output tsv
| Paramètre | Pourquoi |
|---|---|
--assign-identity |
Sans managed identity sur la resource, la création du project échoue |
--allow-project-management |
Active les projects ; non modifiable après création |
--custom-domain |
Sous-domaine globalement unique (erreur CustomDomainInUse sinon) ; requis pour Entra ID et Private Endpoint |
3. Identité et RBAC#
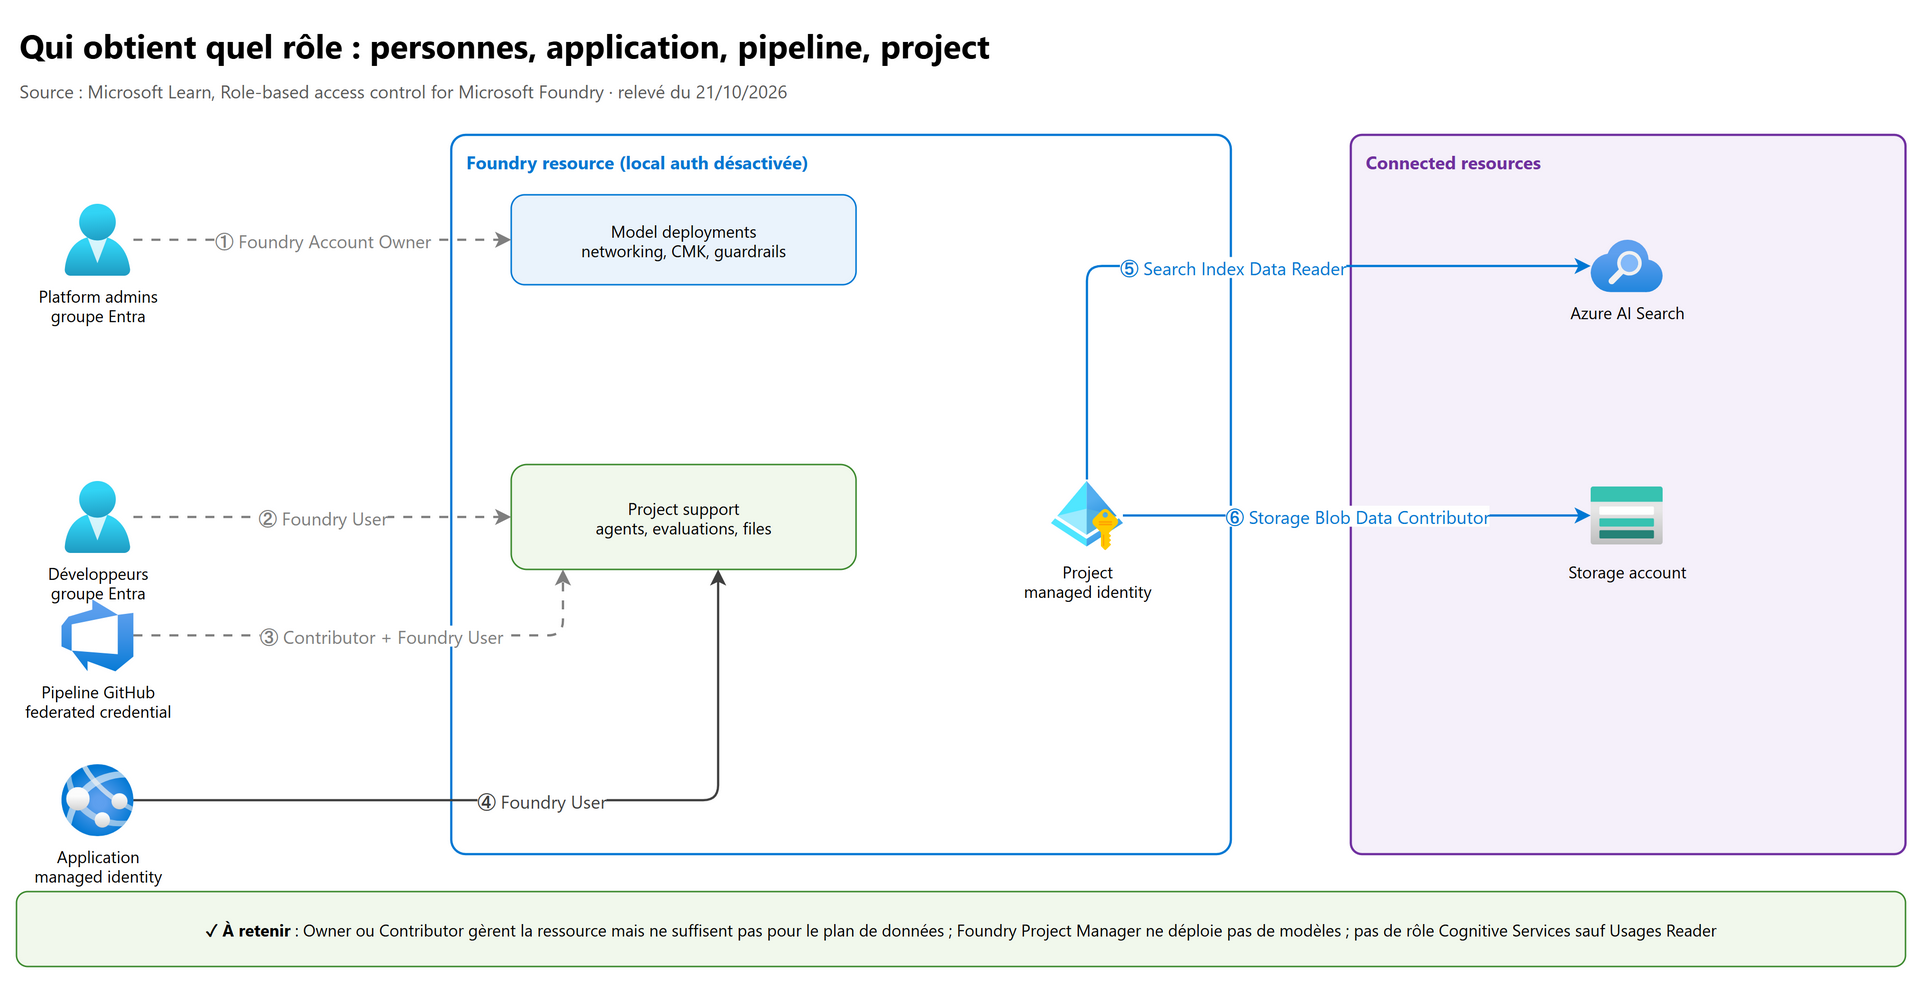
Le détail des rôles est au AI-103 · 03, section 5.3. Le schéma d'exploitation à retenir :
| Identité | Rôle | Étendue | Pour |
|---|---|---|---|
| Groupe Entra des platform admins | Foundry Account Owner (ou Foundry Owner) | Foundry resource | Créer projects et model deployments, connections, réseau |
| Groupe Entra des chefs de projet | Foundry Project Manager | Project (ou resource) | Gérer le project, publier un agent ; ne déploie pas de modèles |
| Groupe Entra des développeurs | Foundry User | Project | Construire agents et evaluations (plan de données) |
| Pipeline CI/CD (workload identity federation, aucun secret) | Contributor + Foundry User (+ ACR pour un hosted agent) | Project cible | Déployer infrastructure et agents |
| Managed identity de l'application | Foundry User | Project (ou agent) | Appeler modèles et agents sans clé |
| Project managed identity (standard setup) | Cosmos DB Built-in Data Contributor (base enterprise_memory, rôle de plan de données Cosmos DB attribué par CLI ou Bicep), Search Index Data Contributor + Search Service Contributor, Storage Blob Data Contributor (conteneur …-azureml-blobstore) et Storage Blob Data Owner (conteneur …-azureml-agent) ; en plus, pour l'identité system-assigned : Cosmos DB Operator et Storage Account Contributor au niveau du compte |
Ressources connectées | Lire et écrire l'état des agents au runtime (distinct des rôles du principal qui déploie : Storage Blob Data Contributor + Cosmos DB Operator) |
Trois principes que l'examen teste :
- Plan de contrôle ≠ plan de données : Owner ou Contributor gèrent la ressource mais ne suffisent pas pour discuter avec un agent dans le portail ; il faut aussi un rôle de plan de données (Foundry User).
- Keyless : désactiver les clés locales (
disableLocalAuth: trueen Bicep,local_auth_enabled = falseen Terraform) et authentifier tout le monde par Entra ID ; les clés ne gardent un sens que lorsque la granularité des rôles n'est pas requise. - Pas de rôle Cognitive Services pour Foundry, sauf Cognitive Services Usages Reader ; exception documentée : la doc du managed compute cite aussi Cognitive Services Contributor pour créer ou supprimer ses deployments.
Mapper des groupes Entra existants aux rôles Foundry à la bonne étendue, puis vérifier les deux chemins d'accès (gestion et développement) avant d'ouvrir l'environnement aux équipes.
4. Réseau privé#
Rappel détaillé : AI-103 · 02, section 2.3 et AI-103 · 03, section 5.4. Ce qu'il faut décider par environnement :
| Sens | Option | Choisir quand |
|---|---|---|
| Entrant | Private Endpoint sur la Foundry resource (zones privatelink.cognitiveservices.azure.com, privatelink.openai.azure.com, privatelink.services.ai.azure.com), accès public désactivé |
Toujours en production ; valider DNS privé et approbation des endpoints avant la mise en production |
| Sortant (agents) | Managed virtual network (dans le tenant Microsoft) | Configuration plus simple et plus sûre, peu de routage personnalisé |
| Sortant (agents) | BYO virtual network (subnet délégué Microsoft.App/environments, UDR vers Azure Firewall) |
Contrôle réseau avancé, routage personnalisé, inspection centralisée |
Le managed virtual network a trois modes sortants :
| Mode | Effet | Réversibilité |
|---|---|---|
| Allow internet outbound | Toute sortie Internet autorisée | Ne peut plus revenir à Disabled |
| Allow only approved outbound | Sortie limitée aux service tags, private endpoints et règles FQDN (ports 80 et 443) appliquées par Azure Firewall (coût) ; réduit le risque d'exfiltration | Ne peut plus revenir à Allow internet outbound |
| Disabled | Pas d'isolation gérée (sauf BYO VNet) | — |
# Managed network « Allow only approved outbound » sur une Foundry resource existante
az cognitiveservices account managed-network create \
  --resource-group rg-ai-prd --name aif-support-prd \
  --managed-network allow_only_approved_outbound --firewall-sku Standard

# Vérifier le mode et les règles sortantes
az cognitiveservices account managed-network show --resource-group rg-ai-prd --name aif-support-prd
az cognitiveservices account managed-network outbound-rule list --resource-group rg-ai-prd --name aif-support-prd
Points d'examen :
- Avec le managed network, la managed identity de la Foundry resource doit avoir le rôle Azure AI Enterprise Network Connection Approver (approbation automatique des managed private endpoints).
customSubDomainName,allowProjectManagementetnetworkInjectionsse définissent à la création de la resource ; la doc indique que la CLI ne sait pas encore créer une resource avec network injection (utiliseraz rest, Bicep ou Terraform).- Les managed private endpoints ne créent aucune carte réseau visible dans votre abonnement.
- Avec l'accès public désactivé, le plan de données n'est joignable que depuis le VNet : runners CI/CD auto-hébergés dans le VNet, jump box via Azure Bastion.
- Les ressources connectées (Storage, AI Search, Key Vault, Cosmos DB) ont leur propre réseau : les fermer une par une.
5. Bicep et Azure CLI#
Microsoft publie des modèles prêts à l'emploi (Bicep et Terraform) dans microsoft-foundry/foundry-samples
(infrastructure/infrastructure-setup-bicep : 00-basic, standard agent setup, réseau privé, 18-managed-virtual-network…).
On peut aussi partir de l'Export template d'une resource configurée dans le portail (Automation > Export template > Bicep),
puis remplacer les valeurs en dur par des paramètres.
Un environnement minimal en Bicep (resource keyless, project, model deployment) :
param location string = resourceGroup().location
param foundryName string            // globalement unique : sert aussi de sous-domaine
param projectName string = 'support'
param modelName string              // pris dans « az cognitiveservices account list-models »
param modelVersion string

resource foundry 'Microsoft.CognitiveServices/accounts@2025-06-01' = {
  name: foundryName
  location: location
  kind: 'AIServices'
  sku: { name: 'S0' }
  identity: { type: 'SystemAssigned' }   // requis pour créer des projects
  properties: {
    allowProjectManagement: true         // non modifiable ensuite
    customSubDomainName: foundryName     // requis pour Entra ID et Private Endpoint
    disableLocalAuth: true               // keyless
    publicNetworkAccess: 'Disabled'      // accès par Private Endpoint uniquement
  }
}

resource project 'Microsoft.CognitiveServices/accounts/projects@2025-06-01' = {
  parent: foundry
  name: projectName
  location: location
  identity: { type: 'SystemAssigned' }
  properties: {}
}

resource chat 'Microsoft.CognitiveServices/accounts/deployments@2025-06-01' = {
  parent: foundry
  name: 'chat'                           // nom passé par le code dans « model »
  sku: {
    name: 'GlobalStandard'
    capacity: 50                         // en milliers de TPM
  }
  properties: {
    model: { format: 'OpenAI', name: modelName, version: modelVersion }
    versionUpgradeOption: 'OnceCurrentVersionExpired'
    raiPolicyName: 'Microsoft.DefaultV2'
  }
}
# Déploiement, puis vérification
az deployment group create --resource-group rg-ai-dev --template-file main.bicep \
  --parameters foundryName=aif-support-dev modelName=<modele> modelVersion=<version>
az resource list --resource-group rg-ai-dev --output table

# Modèles disponibles en GA dans la région (utile quand un modèle est retiré : erreur ServiceModelDeprecating)
az cognitiveservices model list --location swedencentral \
  --query "[?model.lifecycleStatus=='GenerallyAvailable']"
L'exemple utilise 2025-06-01, une version GA encore valide ; la page de référence Microsoft.CognitiveServices/accounts/projects
liste au 21/10/2026 des versions GA plus récentes jusqu'à 2026-09-01 (et des préversions) : prendre la dernière GA pour un
nouveau modèle et vérifier son change log.
Les équivalents Terraform (azurerm_cognitive_account, azurerm_cognitive_account_project, azurerm_cognitive_deployment) sont
au AI-103 · 02, section 2.4.
Pièges de déploiement relevés par la doc :
| Symptôme | Cause | Solution |
|---|---|---|
ServiceModelDeprecating |
Le modèle cité dans le Bicep est retiré ou en cours de retrait | Mettre à jour name et version, lister les modèles GA |
AccountNameInvalid |
Nom non unique ou caractères interdits (2 à 64, minuscules, chiffres, tirets) | Changer le nom |
| Le standard setup échoue en cours de route | Le principal du déploiement n'a pas Storage Blob Data Contributor et Cosmos DB Operator sur les ressources BYO | Attribuer avant de déployer ; puis donner à la project managed identity ses rôles de runtime (ce sont deux jeux de rôles distincts) |
| Ressources dans une autre région que le groupe | Paramètre location par défaut du modèle |
Passer location explicitement |
6. Serverless API ou managed compute#
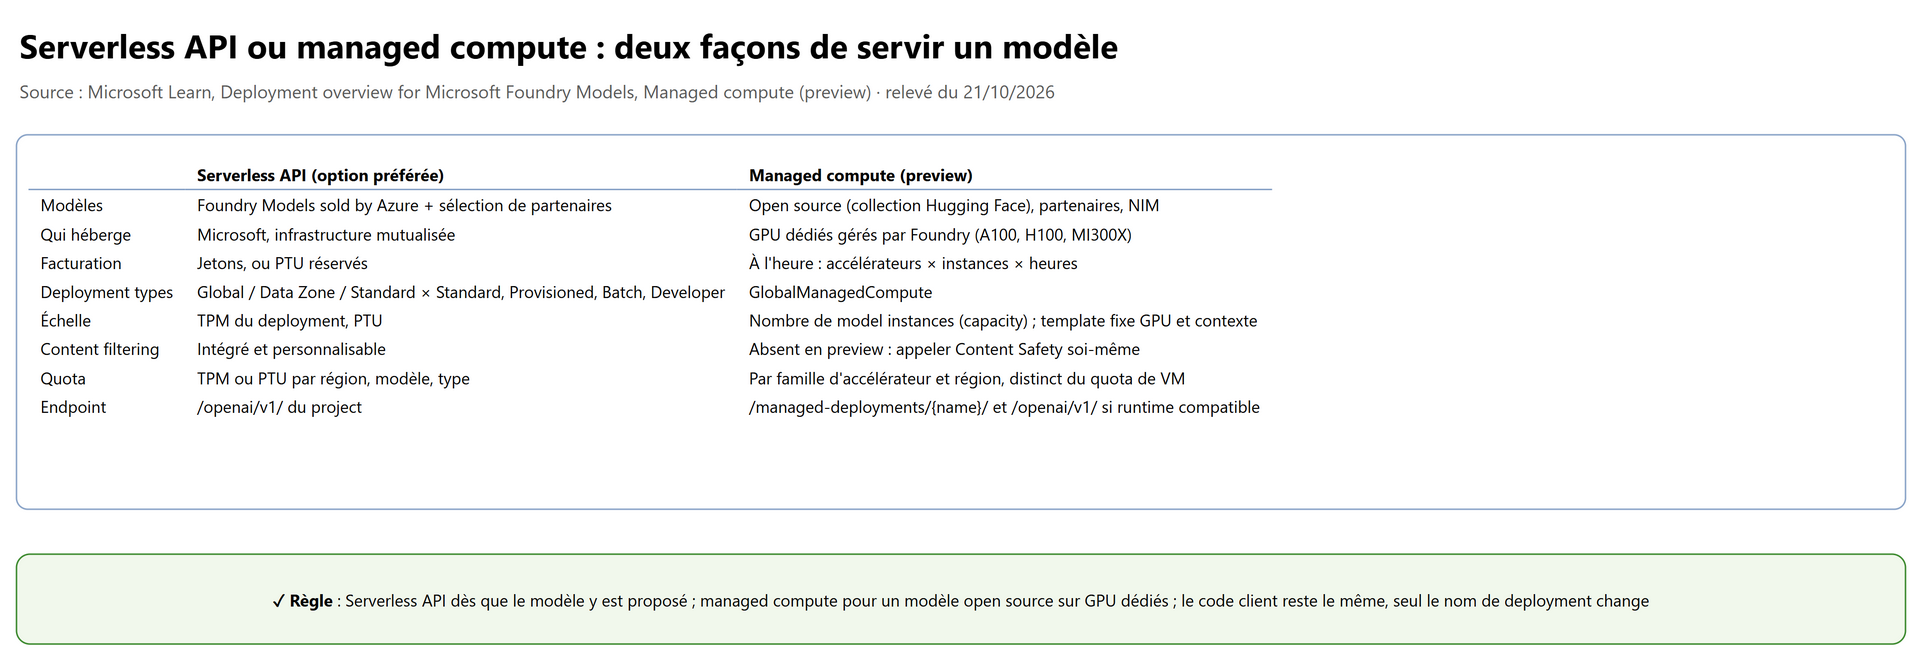
Microsoft recommande la Serverless API dès que possible ; elle porte tous les deployment types (Standard, Provisioned, Batch,
Developer). Le managed compute (preview) sert les modèles open source (collection Hugging Face du catalog, registre
azure-huggingface), partenaires ou personnalisés sur des GPU dédiés gérés par Foundry. L'instant access (preview) n'est pas
un deployment : on appelle un modèle pris en charge par son nom, pour essayer vite.
Le managed compute en détail :
| Concept | Ce qu'il faut savoir |
|---|---|
| Model instance | Unité de déploiement : on ne choisit ni VM ni nœud ; on augmente le nombre d'instances (capacity) |
| Deployment template | Asset versionné qui fixe le runtime (vLLM, SGLang, TensorRT-LLM, NIM, TEI, llama.cpp, hf-serve), l'accélérateur et leur nombre par instance, la longueur de contexte, la quantization ; c'est le seul réglage du « comment » (exemple : qwen3-32b en 1 × A100 40K, 1 × H100 40K, 2 × A100 128K, 2 × H100 128K) |
| Accelerator families | A100_80GB, H100_80GB, MI300_192GB ; quota par famille et par région, distinct du quota de VM |
| Deployment scope | Global uniquement aujourd'hui : SKU GlobalManagedCompute |
| Coût | Accélérateurs par instance × instances × heures × tarif horaire |
| Endpoint | Le même endpoint Foundry : route …/managed-deployments/{deployment}/ pour tous, …/openai/v1/ si le runtime est compatible OpenAI (sinon HTTP 404) |
| Sécurité | Entra ID (Foundry User pour l'inférence) ou clé ; poids pré-copiés dans un stockage Microsoft : pas de sortie vers Hugging Face Hub, déployable en réseau entièrement privé |
| Limites preview | Pas de content filtering intégré : appeler Azure AI Content Safety depuis l'application ; Data Zone et autres régions en cours |
| Fine-tuning | Un deployment de base avec un template compatible LoRA peut servir un ou plusieurs adapters (preview) |
| Patching | Runtime et CVE patchés automatiquement sur les deployments vivants, sans redéploiement |
flowchart TD
    A["Le modèle voulu est-il proposé<br/>en Serverless API ?"] -- Oui --> B{"Simple essai,<br/>sans deployment ?"}
    B -- Oui --> IA["Instant access (preview)"]
    B -- Non --> S["Serverless API<br/>puis choisir le deployment type"]
    A -- Non --> C{"Modèle open source<br/>de la collection Hugging Face ?"}
    C -- Oui --> MC["Managed compute (preview)<br/>template + accelerator + capacity"]
    C -- Non --> D["Hors Foundry managé :<br/>Azure Machine Learning ou AKS (KAITO)<br/>voir chapitre 08"]
Les modèles de partenaires vendus via Azure Marketplace demandent des droits Microsoft.MarketplaceOrdering/* et
Microsoft.SaaS/* (inclus dans Owner et Contributor). Le code client ne change pas d'une option à l'autre : seul le nom du
deployment change.
7. Choisir un modèle pour un cas d'usage#
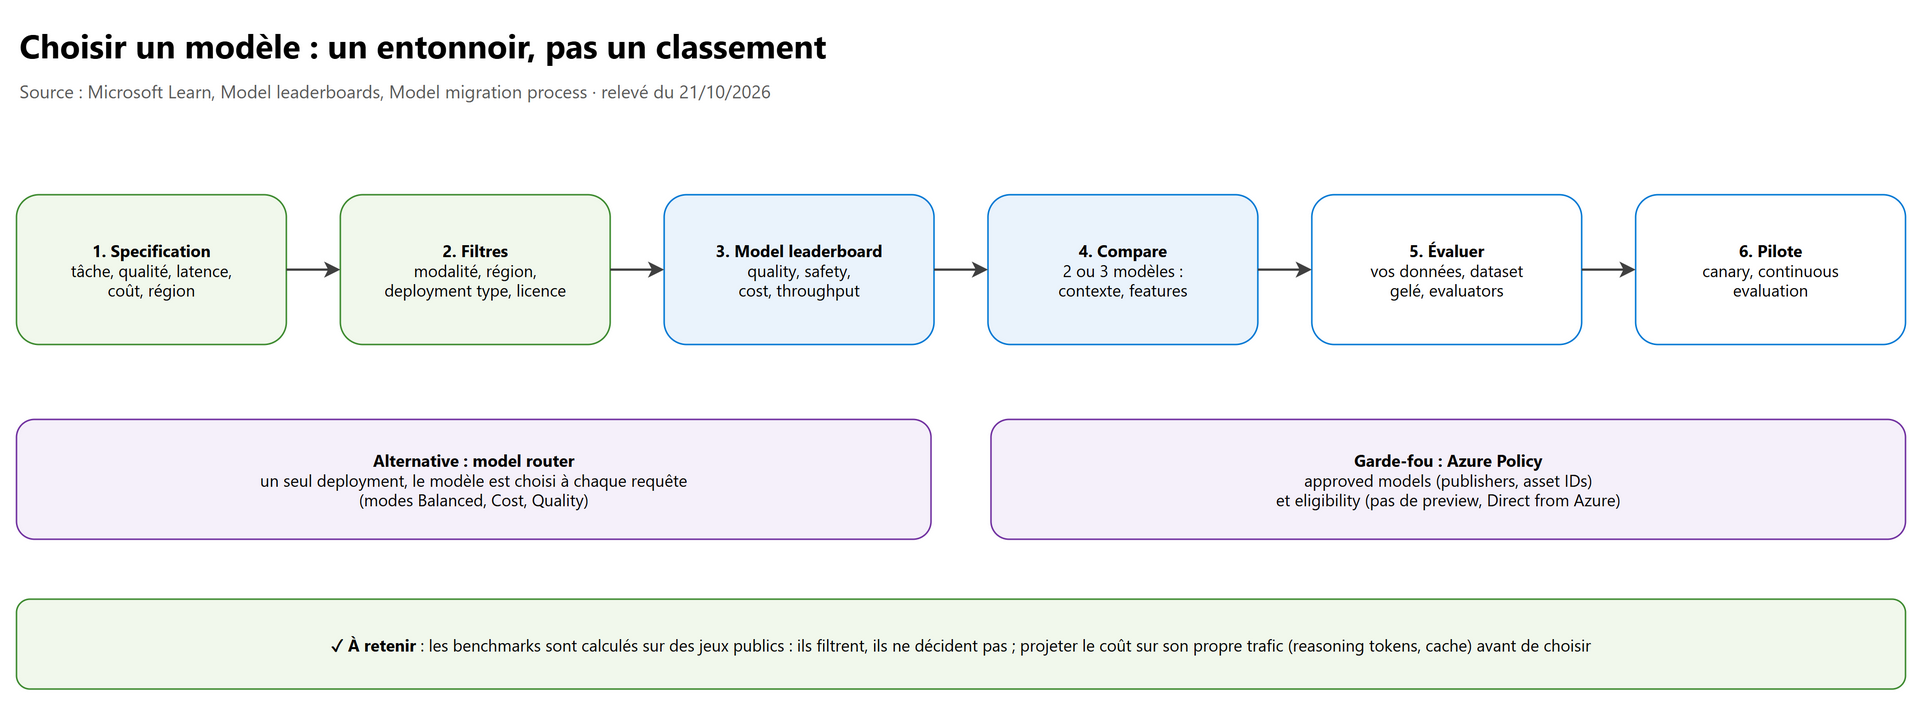
Les critères (qualité, latence, coût, contexte, modalités, raisonnement, région, licence) et les familles de modèles sont au AI-103 · 01, section 2. Ici, la méthode.
7.1 Partir de la specification#
Un modèle se choisit contre l'agent specification (objectif, comportement, critères de succès, jeu de test). Exemple du module Microsoft : un agent de recommandation d'équipement au ton amical → un chat completion model plutôt qu'un reasoning model, et un SLM envisagé parce que le trafic attendu est élevé. Choisir le modèle qui tient la rubric, pas le plus puissant.
7.2 Model leaderboards (preview)#
Dans le model catalog (Discover), le Model leaderboard classe des modèles texte (LLM, SLM) et d'embeddings selon :
| Axe | Lecture |
|---|---|
| Quality index | Plus haut = meilleur (raisonnement, connaissances, QA, maths, code) |
| Safety | Attack success rate (HarmBench…) : plus bas = plus robuste |
| Estimated cost | Coût réel d'exécution des benchmarks de qualité (jetons d'entrée, de raisonnement, de sortie) |
| Throughput, latency | Réactivité réelle |
| Leaderboards by scenario | Reasoning, Coding, Question answering… : commencer par là si le cas d'usage s'y rattache |
Outils : trade-off charts (qualité contre coût, débit ou sécurité), Compare de 2 ou 3 modèles côte à côte (performance, détails : contexte et langues, supported endpoints serverless ou managed compute, feature support : function calling, structured output, vision). Rôle requis : au moins Reader sur le project.
7.3 Les benchmarks filtrent, vos données décident#
- Les benchmarks sont calculés sur des jeux publics : un filtre, pas une conclusion. Évaluer la shortlist sur votre jeu de test (le Try with your own data de l'onglet Benchmarks n'existe que dans Foundry (classic) ; dans le nouveau portail, passer par les evaluations, voir chapitre 06).
- Projeter le coût sur votre trafic : jetons de raisonnement, jetons en cache et surcoût des sorties structurées peuvent changer l'économie d'un facteur 2 ou plus d'une génération à l'autre.
- Vérifier la disponibilité opérationnelle : région, deployment type, quota, et possibilité de faire tourner le candidat à côté de l'actuel (rollback).
- Pour une charge réglementée, la conformité (certification, région) filtre avant la qualité.
- Alternative : model router, qui choisit un modèle à chaque requête dans un seul deployment (AI-103 · 01, section 2.3).
7.4 Gouverner les modèles autorisés#
Deux définitions Azure Policy intégrées, évaluées au moment du déploiement (le catalog ne cache pas les modèles : le bouton Deploy est désactivé avec la raison) :
| Policy | Paramètres | Usage |
|---|---|---|
| Foundry model deployments should only use approved models | allowedPublishers, allowedAssetIds (préfixes : …/models/gpt-5/ avec la barre finale ne vise que ce modèle ; ID complet avec /versions/1 pour une seule version) |
Liste blanche explicite |
| Foundry model deployments should meet eligibility requirements | onlyAllowDirectFromAzure, denyPreviewModels (défaut false) |
Règles générales : « pas de preview en production » |
Effets Deny ou Audit ; rôle Owner ou Resource Policy Contributor pour assigner ; compter au moins 15 minutes avant
que l'assignation s'applique. Ces policies s'appliquent aussi aux modèles que model router peut choisir. Une policy custom peut
aussi interdire un deployment type (Microsoft.CognitiveServices/accounts/deployments/sku.name).
8. Versions de modèles et stratégies de déploiement#
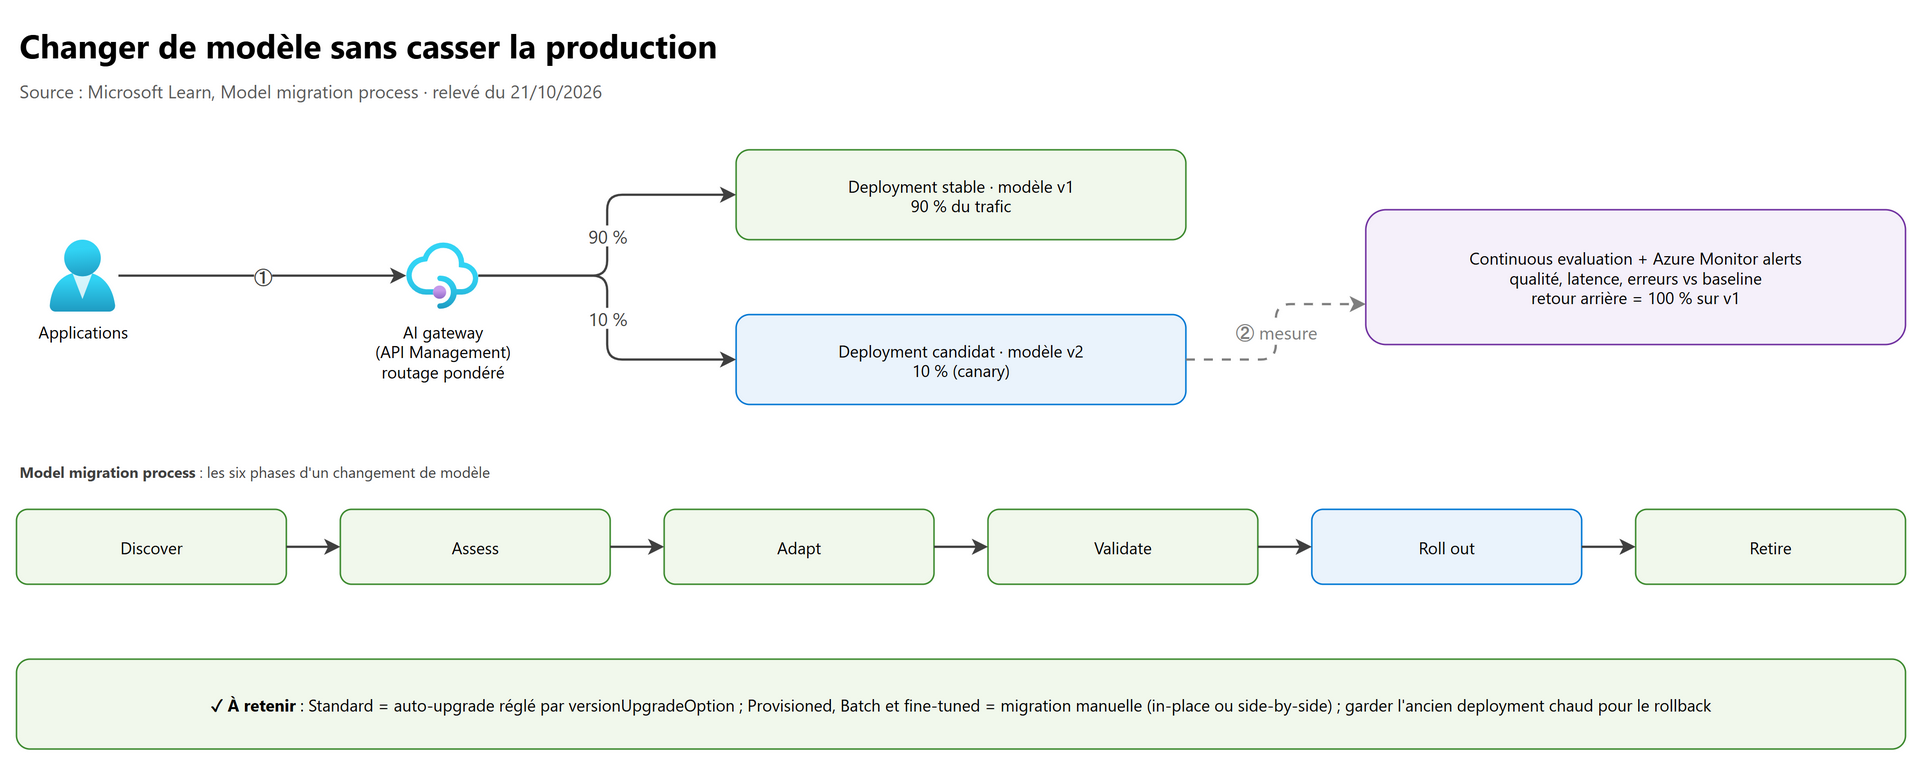
8.1 Ce qui se passe à la date de retrait#
| Deployment type | Comportement | Quota |
|---|---|---|
| Standard, Global Standard, Data Zone Standard (et Priority Processing) | Auto-upgrade progressif, réglé par versionUpgradeOption : OnceNewDefaultVersionAvailable, OnceCurrentVersionExpired, NoAutoUpgrade (le deployment cesse de répondre au retrait) |
Reporté automatiquement |
| Provisioned | Jamais mis à niveau automatiquement : migration in-place (le trafic bascule en 20 à 30 minutes, sans interruption) ou side-by-side (nouveau deployment, test, bascule, suppression de l'ancien) | S'assurer du quota du modèle cible avant |
| Batch | Side-by-side : nouveau deployment, resoumettre les jobs | Idem |
| Fine-tuned | Pas d'auto-upgrade, horloge de retrait propre : re-tuner ou distiller sur le nouveau modèle de base | Idem |
Délais garantis : le modèle de remplacement arrive environ 90 jours avant le retrait en Global Standard et 30 jours en
provisioned ; les dates de retrait ne sont pas prolongeables. L'auto-upgrade est un filet de sécurité, pas un plan de migration.
Sources du signal : Model retirement schedule, e-mails, Azure Service Health, API Models (lifecycleStatus, deprecationDate).
8.2 Le Model migration process en six phases#
| Phase | But | Outils Foundry |
|---|---|---|
| Discover | Savoir qu'un changement arrive (ou vaut le coup), décider go / no-go | Retirement schedule, lifecycle policy, Service Health, API Models |
| Assess | Choisir le modèle cible et vérifier qu'il est opérationnellement disponible (région, SKU, quota) | Leaderboards, Compare, trade-off charts |
| Adapt | Rejouer la charge sans rien changer d'abord, puis adapter prompts, paramètres, définitions d'outils, schémas de sortie et code d'appel | Prompt Optimizer (bouton Optimize dans l'Agent playground), Agent optimization, Simulator (données synthétiques) |
| Validate | Noter source et cible avec les mêmes evaluators sur un jeu gelé : qualité, latence, coût | Azure AI Evaluation SDK (plus de 30 evaluators), portal evaluation |
| Roll out | Exposition progressive (non-prod, canary ou pondéré, puis large), surveillance, commit ou rollback | versionUpgradeOption, migration provisioned, continuous evaluation, alertes Azure Monitor |
| Retire | Supprimer l'ancien deployment, libérer la capacité, archiver les évaluations, mettre à jour la doc | API Models, Observability dashboard |
Avant tout : préparer et geler le jeu de test (entrées réelles ou synthétiques, réponses attendues, critères). La capture de contenu en production est opt-in et jamais rétroactive : sans traces enregistrées, pas de rejeu possible.
8.3 Stratégies de déploiement en production#
| Stratégie | Mise en œuvre | Quand |
|---|---|---|
| Canary / weighted | Deux deployments (stable, candidat) et un routage pondéré dans votre passerelle (API Management) ou votre application : 10 %, puis 50 %, puis 100 % | Cas général |
| Shadow / mirror | Le candidat traite les entrées de production hors ligne, on compare sans exposer les utilisateurs | Flux réglementés (santé, finance) où le canary est impossible |
| Rollback corridor | Garder l'ancien deployment chaud pendant une période (environ 30 jours pour les équipes produit selon la doc) | Toujours |
| Split-state | Une partie du trafic (chemin sensible à la latence ou plus risqué) reste sur l'ancien modèle des semaines | Migration progressive réelle |
Pour un agent : chaque modification crée une agent version immuable ; l'agent endpoint sert par défaut Always use latest.
Épingler la production sur une version (version_selector avec une règle FixedRatio à 100 %) avant de créer une version
candidate, puis tester le candidat dans une session qui le cible.
Écart dans la doc (vérifié le 21/10/2026) : les pages What are hosted agents? et Manage hosted agents disent explicitement que le partage de trafic entre versions d'agent n'est pas pris en charge (une seule règle
FixedRatioà 100 %, même siversion_selection_rulesest un tableau). La page Promote hosted agents to production with the Azure Developer CLI, marquée preview, montre pourtant un canary 90 / 10 avecazd ai agent endpoint update. Réponse d'examen : épingler, tester une session sur la version candidate (--versionouversion_ref), promouvoir à 100 %, revenir ; le canary pondéré se fait de façon sûre dans la passerelle (API Management) ou entre deux deployments de modèle.
9. Provisioned throughput units#
Le fonctionnement des PTU (leaky bucket, 429 immédiat à 100 %, réservations non interchangeables) est au AI-103 · 03, section 2.4 et le spillover au AI-103 · 02, section 3.3. L'AI-300 attend surtout le dimensionnement.
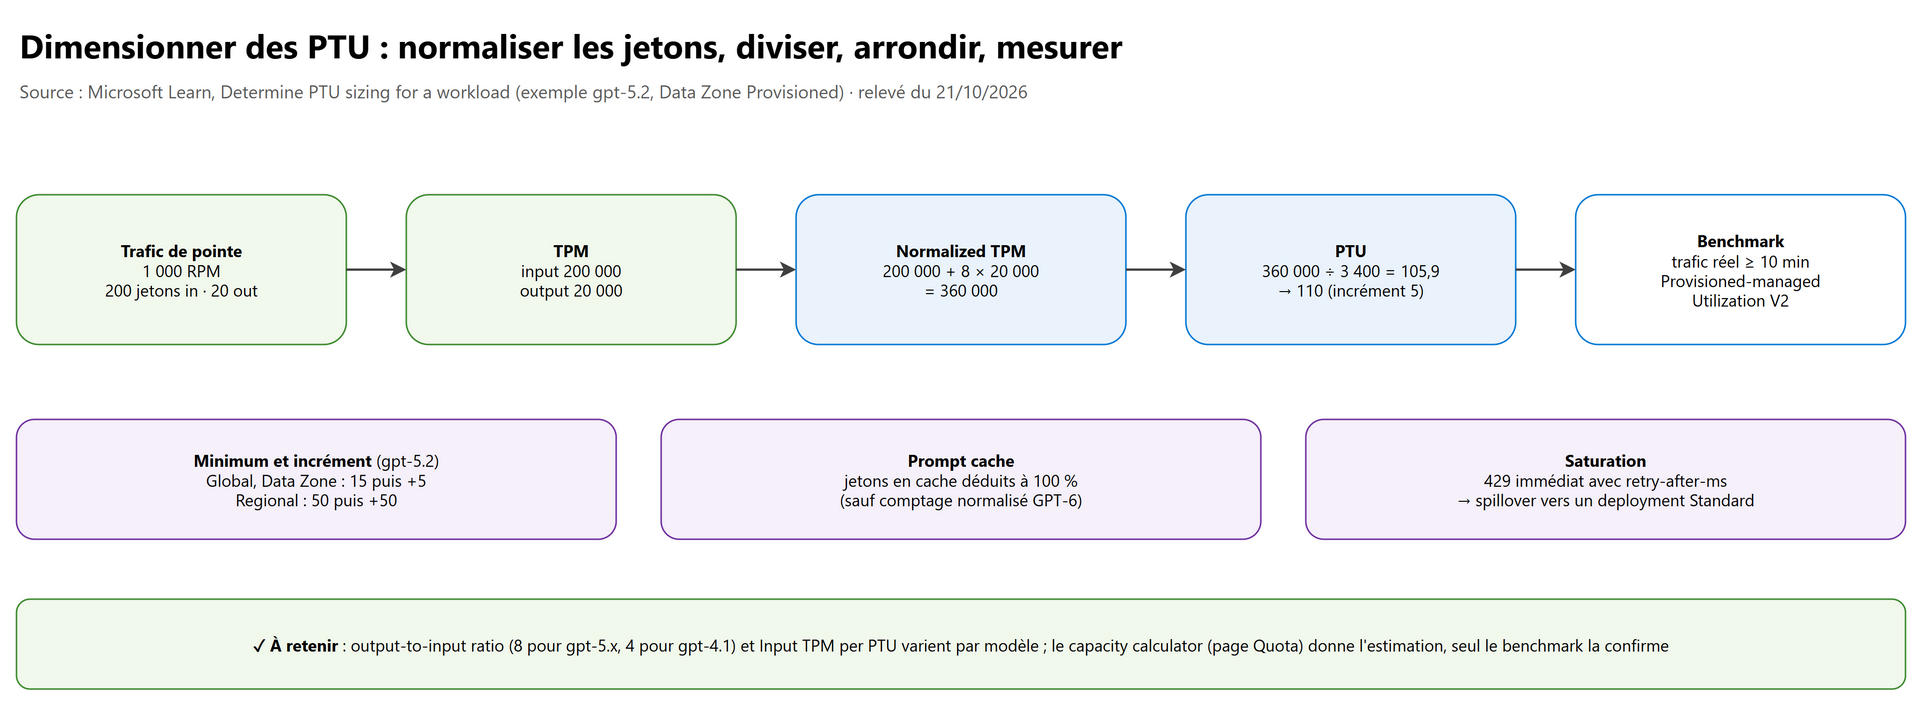
9.1 La méthode de calcul#
- Input TPM = RPM de pointe × taille moyenne de l'invite
- Output TPM = RPM de pointe × taille moyenne de la réponse
- Normalized TPM = input TPM × (1 − taux de cache) + output-to-input ratio × output TPM
- PTU = normalized TPM ÷ Input TPM per PTU, arrondi au minimum ou à l'incrément du deployment type (le plus grand)
Exemple de la doc (gpt-5.2, Data Zone Provisioned, Input TPM per PTU 3 400, ratio 8) :
| RPM | Invite | Réponse | Cache | Normalized TPM | PTU estimés | PTU déployés |
|---|---|---|---|---|---|---|
| 1 000 | 200 | 20 | 0 % | 360 000 | 105,88 | 110 |
| 1 000 | 200 | 20 | 50 % | 260 000 | 76,47 | 80 |
Valeurs par modèle (extrait de la page Determine PTU sizing, à revérifier pour le modèle choisi) :
| Modèle | Min. Global / Data Zone | Incrément Global / Data Zone | Min. / incrément Regional | Input TPM per PTU | Ratio sortie / entrée |
|---|---|---|---|---|---|
| gpt-5.2 | 15 | 5 | 50 / 50 | 3 400 | 8 |
| gpt-5 | 15 | 5 | 50 / 50 | 4 750 | 8 |
| gpt-5-mini | 15 | 5 | 25 / 25 | 23 750 | 8 |
| gpt-4.1 | 15 | 5 | 50 / 50 | 3 000 | 4 |
| gpt-4.1-mini | 15 | 5 | 25 / 25 | 14 900 | 4 |
Règles à connaître :
- Le ratio reflète l'écart de prix entre jetons de sortie et d'entrée (par exemple 8 pour gpt-5, 4 pour gpt-4.1) : générer coûte plus de capacité que lire.
- Jetons en cache : déduits à 100 % de l'utilisation, sauf pour les modèles à comptage normalisé (GPT-6 Astra, GPT-6 Sol, GPT-6.1 Sol), où entrée en cache et écritures de cache consomment de la capacité selon leur poids de prix.
- Pour les modèles antérieurs à GPT-4o, la forme des appels compte : quelques gros appels consomment plus que beaucoup de petits de même moyenne.
- Les requêtes de plus de 128K jetons d'invite ne sont pas prises en charge en PTU pour certains modèles (gpt-5.4, gpt-4.1…) : elles partent vers le spillover s'il existe, sinon en erreur.
9.2 La démarche d'exploitation#
- Estimer avec le capacity calculator (page Quota du portail Foundry).
- Demander le quota PTU (par région et par forme Global, Data Zone, Regional).
- Créer le deployment avant d'acheter une reservation (elle ne garantit pas la capacité).
- Lancer un benchmark sur la forme de trafic estimée pendant au moins 10 minutes (outil
azure-openai-benchmark), puis avec votre propre client et sa logique de retry. - Surveiller Provisioned-managed Utilization V2 (découpé par deployment) et activer le spillover vers un deployment Standard.
# Un deployment Data Zone Provisioned de 110 PTU, avec spillover vers le deployment standard « chat »
az cognitiveservices account deployment create -n aif-support-prd -g rg-ai-prd \
  --deployment-name chat-ptu --model-name <modele> --model-version <version> --model-format OpenAI \
  --sku-name DataZoneProvisionedManaged --sku-capacity 110
L'activation du spillover (spilloverDeploymentName ou en-tête x-ms-spillover-deployment) est détaillée au
AI-103 · 02, section 3.3.
10. Concevoir et développer des prompts#
Les techniques (system message, few-shot, délimiteurs, sortie structurée, décomposition, paramètres d'échantillonnage, reasoning models) sont au AI-103 · 07, section 2. Côté GenAIOps, un prompt se conçoit comme un composant d'agent :
| Composant d'un agent Foundry | Rôle | Fréquence de changement |
|---|---|---|
| Agent definition | Nom, métadonnées, numéro de version | Rare |
| System instructions (le prompt) | Définit le comportement et les capacités | Le plus souvent |
| Model selection | Le modèle qui répond | Rare |
| Tool integrations | APIs, données | Occasionnel |
Démarche recommandée (module Plan and prepare a GenAIOps solution) : écrire une agent specification avec ses critères de succès et un jeu de test, puis optimiser par petites itérations : après chaque retouche du prompt, des smoke tests rapides ; avant un changement important, une évaluation automatisée sur tout le jeu, toujours contre la même rubric.
Un prompt de production est structuré et testable. Exemple de progression du module Microsoft (agent « trail guide ») :
v1 : You are a trail guide assistant. Help users find hiking trails and provide basic safety advice.

v3 : You are an expert trail guide assistant with deep knowledge of hiking safety and trail conditions. When helping users plan hikes:
1. Assess their experience level and fitness
2. Consider weather and seasonal factors
3. Recommend appropriate trails with difficulty ratings
4. Provide comprehensive gear lists
5. Include safety protocols and emergency contacts
6. Suggest alternative options for different conditions
Always prioritize user safety and provide actionable, specific guidance.
Le Prompt Optimizer (bouton Optimize sous les instructions dans l'Agent playground, Foundry seulement) restructure les instructions selon les bonnes pratiques et explique chaque changement. Copier le prompt d'origine avant : il n'y a pas d'historique de versions dans l'outil, et le résultat se réévalue contre le jeu gelé.
11. Prompt variants : comparer les performances#
Comparer des variants, c'est changer une seule chose à la fois (prompt, modèle ou configuration) et mesurer contre la même rubric. Le workflow Git du module Evaluate and optimize AI agents through structured experiments :
- Une branche par variant :
experiment/prompt-v2-concise,experiment/prompt-v2-detailed,experiment/gpt4o-mini-model,experiment/token-optimization(main= baseline de production). - Prompts de test (5 à 10 scénarios, dont des cas limites : demande vague, informations manquantes) dans
test-prompts/. - Déployer la version de l'agent (
python agent.py), exécuter les prompts de test (python run-agent.py), garder les réponses (experiments/<variant>/agent-responses.json). - Noter sur 3 à 5 critères (intent resolution, relevance, groundedness…, échelle de 1 à 5) dans un
evaluation.csvau même format que l'export d'évaluation du portail, pour pouvoir consolider manuel et automatique. - Comparer et décider : fusionner le gagnant dans
mainet taguer ; documenter les échecs (par exemple « gpt4o-mini : qualité sous le seuil de 4,2 sur les demandes complexes »).
git checkout main
git merge experiment/prompt-v2-concise
git tag promoted-to-prod-2026-02-17
git push origin main --tags
À l'échelle, la comparaison s'automatise : l'action GitHub microsoft/ai-agent-evals évalue plusieurs versions d'un agent
(agent-ids: "support-agent:3,support-agent:4", la première sert de référence) et publie un rapport avec intervalles de confiance
et comparaison statistique (AI-103 · 02, section 5).
Les evaluators eux-mêmes sont au chapitre 06.
Prompt flow (variants dans un flow visuel) est retiré le 20 avril 2027 dans Foundry et Azure Machine Learning : plus recommandé pour un nouveau développement, migrer vers Microsoft Agent Framework. Ses images de runtime ne reçoivent plus de mises à jour de sécurité.
12. Versionner les prompts dans Git#
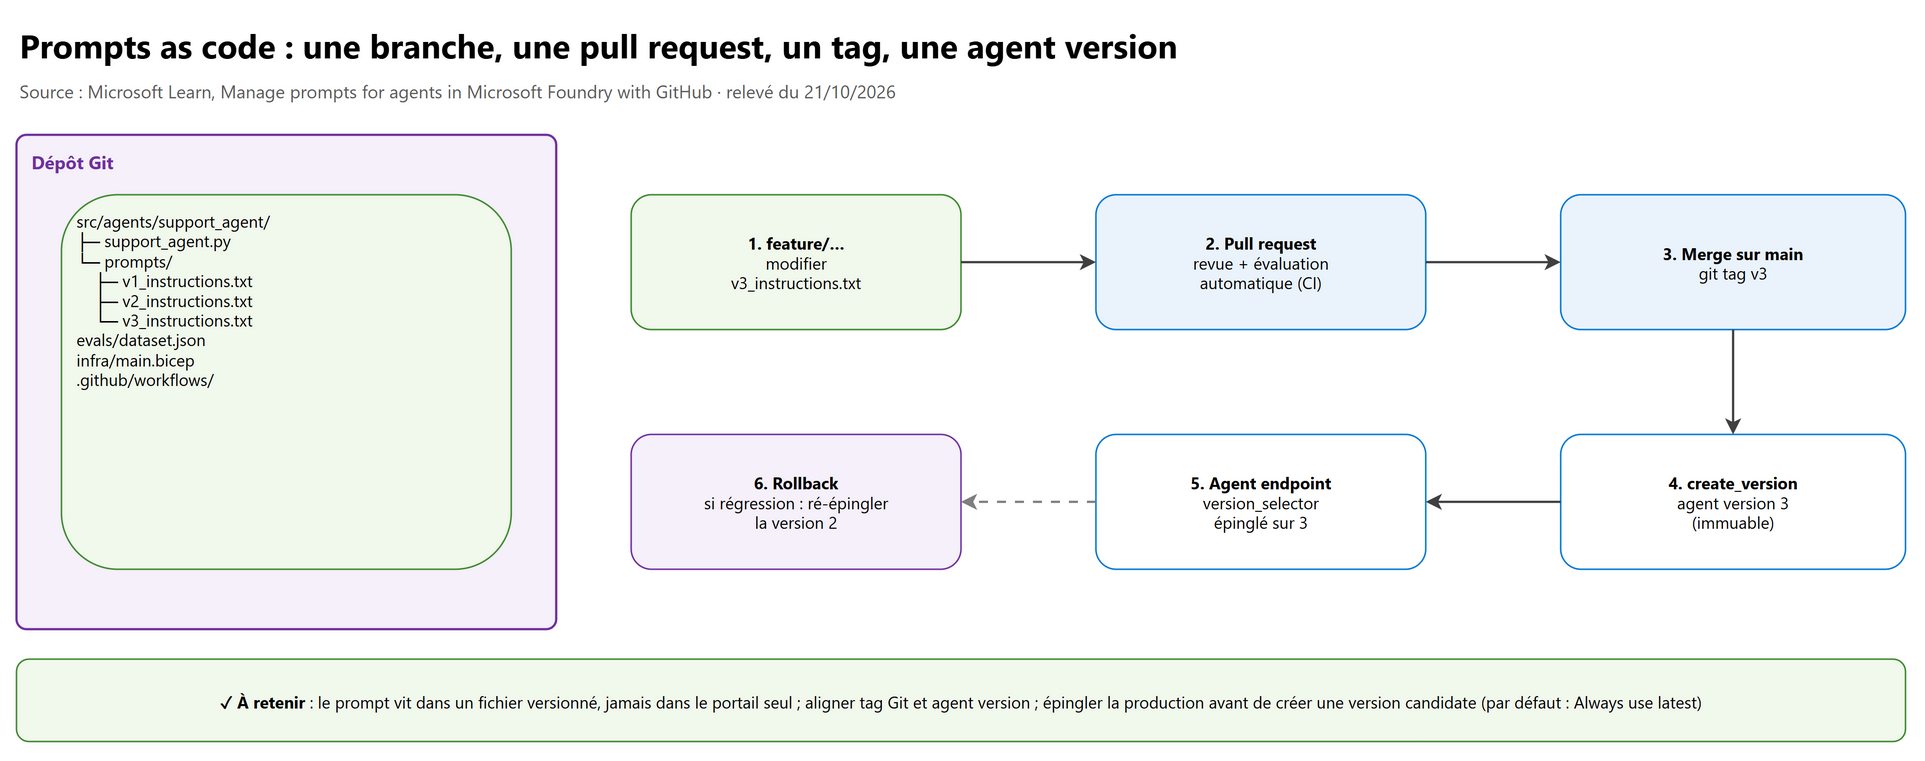
12.1 Où et sous quelle forme#
| Approche | Avantage | Limite |
|---|---|---|
| Prompt dans le script Python | Simple pour une petite équipe | Difficile de relire un changement de prompt seul |
Fichier séparé .txt ou .md |
Diff lisible, relecture par des non-développeurs ; c'est le choix des exemples Microsoft | Un fichier de plus à charger |
| YAML ou JSON avec métadonnées | Plusieurs environnements, métadonnées | Plus complexe |
.py ou Jinja2 |
Variables, contenu dynamique | Templating à maintenir |
Structure de dépôt recommandée :
project-root/
├── src/agents/support_agent/
│   ├── support_agent.py        # script de déploiement de l'agent
│   └── prompts/
│       ├── v1_instructions.txt
│       ├── v2_instructions.txt
│       └── v3_instructions.txt
├── tests/                      # tests automatisés de l'agent
├── evals/dataset.json          # jeu d'évaluation
├── infra/main.bicep            # infrastructure
├── .github/workflows/          # test-agents.yml, deploy-agents.yml
└── .env                        # configuration locale, jamais committée
Conventions : noms en minuscules, versions dans les noms de fichiers (v1_, v2_), au plus trois niveaux de dossiers, src/,
tests/ et infra/ séparés. Aligner la numérotation des fichiers sur les agent versions que Foundry attribue (1, 2, 3…) et
poser un tag Git par déploiement : on retrouve immédiatement quel état du dépôt a produit quelle version.
12.2 Déployer une version depuis le fichier#
import os
from azure.identity import DefaultAzureCredential
from azure.ai.projects import AIProjectClient
from azure.ai.projects.models import PromptAgentDefinition

project = AIProjectClient(endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"], credential=DefaultAzureCredential())

with open("src/agents/support_agent/prompts/v3_instructions.txt", encoding="utf-8") as f:
    instructions = f.read().strip()           # le prompt vient du fichier versionné, pas du portail

agent = project.agents.create_version(
    agent_name="support-agent",
    definition=PromptAgentDefinition(model=os.environ["MODEL_DEPLOYMENT_NAME"], instructions=instructions),
)
print(agent.name, agent.version)

for v in project.agents.list_versions(agent_name="support-agent"):   # historique côté Foundry
    print(v.version)
Le module Microsoft montre encore l'ancienne syntaxe (AIProjectClient.from_connection_string(...), agents.create_agent(...)) ;
le SDK actuel utilise l'endpoint du project et agents.create_version.
12.3 Promouvoir et revenir en arrière#
Épingler la version servie par l'agent endpoint (API REST, application/merge-patch+json) :
PATCH {project-endpoint}/agents/support-agent?api-version=v1
Content-Type: application/merge-patch+json

{ "agent_endpoint": { "version_selector": { "version_selection_rules": [
    { "type": "FixedRatio", "agent_version": "3", "traffic_percentage": 100 } ] } } }
Le rollback consiste à ré-épingler la version précédente : aucune reconstruction, aucune nouvelle version.
sequenceDiagram
    actor D as Développeur
    participant G as GitHub
    participant CI as Pipeline (OIDC)
    participant F as Foundry project
    D->>G: branche feature/…, modifie v3_instructions.txt
    D->>G: pull request
    G->>CI: déclenche la CI
    CI->>F: create_version (version candidate)
    CI->>F: évaluation de la candidate contre la production épinglée
    F-->>CI: rapport avec intervalles de confiance
    CI-->>G: résultat dans la pull request
    D->>G: merge sur main et tag v3
    CI->>F: version_selector sur la version 3 (100 %)
    Note over F: si régression, ré-épingler la version 2
Cycle de vie d'un prompt selon le module Microsoft : Development → Validation → Review → Production → Monitoring, avec des
branches feature/…, hotfix/… et experiment/…. Ne sauter aucune étape : chacune évite un incident de production.
13. Labs conseillés#
Dans un abonnement de test, région où les modèles visés existent. Supprimer le groupe de ressources à la fin ; ne pas créer de deployment PTU pour s'entraîner (facturation horaire dès la création, minimum 15 PTU en Global ou Data Zone).
| Lab | Étapes | Résultat attendu |
|---|---|---|
| 1. Environnement par IaC | Déployer le Bicep de la section 5 (sans publicNetworkAccess: 'Disabled' pour tester depuis votre poste) ; attribuer Foundry User à votre compte sur le project ; appeler le deployment depuis Python avec DefaultAzureCredential |
L'appel passe sans clé ; un appel avec la clé échoue (disableLocalAuth) |
| 2. Choisir un modèle | Model leaderboard : trade-off chart qualité contre coût ; Compare sur 3 modèles ; déployer les 2 meilleurs et lancer une évaluation sur 10 questions de votre domaine (chapitre 06) | Le classement sur vos données diffère du classement public ; un tableau qualité / latence / coût justifie le choix |
| 3. Dimensionner des PTU (sans déployer) | Mesurer RPM, taille d'invite et de réponse d'une appli de test ; appliquer la formule ; comparer avec le capacity calculator (page Quota) | Les deux estimations sont proches ; vous savez dire minimum et incrément du modèle |
| 4. Prompts as code | Créer le dépôt de la section 12 ; déployer v1 puis v2 avec create_version ; épingler la v1 ; comparer v1 et v2 avec microsoft/ai-agent-evals dans GitHub Actions (OIDC) ; tag et promotion de la gagnante |
Deux agent versions, un rapport de comparaison, un tag Git par version |
| 5. Gouverner les modèles | Assigner Foundry model deployments should meet eligibility requirements en Audit avec denyPreviewModels = true sur le groupe de ressources, attendre 15 minutes, tenter un modèle preview |
Le déploiement est signalé non conforme (en Deny, le bouton Deploy est désactivé avec la raison) |
Coût : quelques euros de jetons Global Standard pour les labs 1, 2 et 4 (plus les jetons du modèle juge des évaluations).
14. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Une équipe doit fine-tuner sans que les autres projects voient ses jobs | Foundry resource séparée | Le fine-tune training ne s'isole pas par project (default project seulement) |
| Production de plusieurs workloads, incidents et quotas à confiner | Une Foundry resource par workload de production | L'isolation est le défaut en production |
| Créer un project échoue : « managed identity must be enabled » | Créer la resource avec --assign-identity |
Requise par le project management |
| Activer les projects sur une resource existante créée sans | Impossible : --allow-project-management n'est pas modifiable après création |
Recréer la resource |
| Un développeur Owner de l'abonnement ne peut pas tester l'agent dans le portail | Lui attribuer Foundry User | Owner = plan de contrôle seulement |
| Le chef de projet doit déployer un nouveau modèle | Foundry Account Owner (ou Foundry Owner), pas Project Manager | Project Manager ne déploie pas de modèles |
| Un pipeline sans secret doit déployer dans le project | Workload identity federation + Contributor + Foundry User | Aucun secret, moindre privilège |
| Sortie des agents limitée à une liste de destinations, sans gérer de VNet | Managed virtual network en Allow only approved outbound | Règles FQDN via Azure Firewall (coût) |
| Repasser un managed network de Allow only approved outbound à Allow internet outbound | Impossible | Mode non réversible |
| Modèle open source de Hugging Face sur GPU dédiés, réseau sans sortie Internet | Managed compute | Poids pré-copiés par Microsoft, pas d'accès à Hugging Face Hub |
| Filtrage de contenu sur un deployment managed compute | Appeler Content Safety depuis l'application | Pas de content filtering intégré en preview |
| Le quota VM GPU de l'abonnement est disponible, le managed compute échoue | Demander du quota managed compute par famille d'accélérateur | Distinct du quota de VM |
| Choisir le modèle d'après le seul quality index | Faux : évaluer la shortlist sur ses données et projeter le coût sur son trafic | Benchmarks sur jeux publics |
| Score de sécurité du leaderboard | Plus bas = meilleur (attack success rate) | — |
| Interdire les modèles preview en production | Policy eligibility requirements avec denyPreviewModels |
GA, effet Deny ou Audit |
| Deployment PTU arrivé à la date de retrait du modèle | Il n'est pas mis à niveau : migrer in-place ou side-by-side | Pas d'auto-upgrade en provisioned |
NoAutoUpgrade sur un Standard à la date de retrait |
Le deployment cesse de répondre | — |
| Demander une prolongation de la date de retrait | Impossible | Dates non prolongeables |
| Canary impossible (données de santé) | Shadow / mirror hors ligne | Pas d'exposition des utilisateurs |
| Valider une migration : quel jeu de test ? | Un jeu gelé, mêmes evaluators sur source et cible | Sinon résultats incomparables |
| Calculer des PTU : 1 000 RPM, 200 in, 20 out, gpt-5.2 Data Zone | 360 000 ÷ 3 400 = 105,9 → 110 PTU | Incrément de 5 |
| Les jetons en cache consomment-ils des PTU ? | Non, déduits à 100 % (sauf comptage normalisé des GPT-6) | — |
| Créer une nouvelle version d'agent a changé la production | L'endpoint suivait Always use latest : épingler avant | Version selector |
| Revenir en arrière après une mauvaise version d'agent | Ré-épingler la version précédente | Versions immuables, pas de rebuild |
| Variants de prompt dans un nouveau projet : prompt flow ? | Non : retiré le 20 avril 2027, utiliser Agent Framework et Git | — |
15. Scénarios d'entraînement#
1. Contoso a cinq équipes qui explorent des idées d'agents et deux cas d'usage financés pour la production, l'un sur des données RH sensibles. Quelle topologie Foundry ?
Une Foundry resource d'exploration partagée (un project par équipe, capacité limitée, données de test) ; pour la production, une Foundry resource par workload (RH isolée), avec leur propre réseau, quota, RBAC et coûts, et des environnements dev/test déployés par la même IaC.
2. L'équipe plateforme veut que les développeurs construisent des agents mais qu'ils ne puissent ni créer de model deployments ni modifier le réseau. Quels rôles ?
Foundry User pour les développeurs sur leur project ; Foundry Account Owner réservé au groupe des platform admins sur la Foundry resource. Désactiver les clés locales pour que tout passe par Entra ID.
3. Un modèle Qwen open source doit tourner sur GPU dédiés dans un réseau totalement privé, avec filtrage des contenus dangereux. Que faire ?
Managed compute (
GlobalManagedCompute), avec un deployment template adapté (accélérateur, contexte) et du quota managed compute pour la famille d'accélérateur ; le réseau privé fonctionne sans sortie vers Hugging Face ; le filtrage se fait en appelant Azure AI Content Safety depuis l'application, faute de content filtering intégré en preview.
4. Le modèle d'un assistant de support (deployment Global Provisioned de 200 PTU) sera retiré dans quatre mois. Plan ?
Suivre le Model migration process : Assess (leaderboard, Compare, quota du modèle cible, disponibilité en Global Provisioned), Adapt (rejouer d'abord sans changement, puis adapter prompts, outils, schémas), Validate (jeu gelé, mêmes evaluators sur source et cible), Roll out (migration side-by-side ou in-place, canary dans la passerelle, continuous evaluation), Retire. Ne pas compter sur l'auto-upgrade : il n'existe pas en provisioned.
5. Une banque ne peut pas exposer un nouveau modèle à de vrais clients avant validation. Comment le tester sur le trafic réel ?
Shadow / mirror : le candidat traite des entrées de production hors ligne, on compare ses réponses à celles du modèle actuel sans affecter les clients ; l'ancien deployment reste le seul servi.
6. Un chatbot reçoit 2 000 RPM de pointe, 500 jetons d'invite et 50 de réponse, sur gpt-4.1 en Data Zone Provisioned (Input TPM per PTU 3 000, ratio 4). Combien de PTU ?
Input TPM 1 000 000, output TPM 100 000, normalized TPM = 1 000 000 + 4 × 100 000 = 1 400 000 ; 1 400 000 ÷ 3 000 = 466,7 → 470 PTU (incrément de 5) ; puis benchmark sur le trafic réel et spillover vers un Standard.
7. Une modification du prompt de l'agent a dégradé les réponses en production, et personne ne sait quelle version était avant. Quelles pratiques auraient évité cela ?
Prompts dans des fichiers versionnés (
v2_instructions.txt), changements par branche et pull request avec évaluation automatique, tag Git aligné sur l'agent version, production épinglée parversion_selector; le rollback se résume alors à ré-épingler la version précédente.
8. Deux variants de prompt et un modèle plus petit sont candidats. Comment les comparer proprement ?
Une branche par variant, une seule modification par branche, les mêmes 5 à 10 prompts de test, la même rubric (3 à 5 critères, échelle 1 à 5) ; automatiser avec
microsoft/ai-agent-evalssur les versions d'agent et lire les intervalles de confiance ; fusionner le gagnant et documenter les perdants.
9. La sécurité exige qu'aucun modèle en preview ni hors liste approuvée ne soit déployé en production. Comment l'imposer ?
Assigner les policies intégrées Foundry model deployments should only use approved models (publishers ou asset IDs) et … should meet eligibility requirements (
denyPreviewModels = true) en Deny sur le groupe d'administration de production ; elles s'appliquent aussi aux modèles choisis par model router.
10. Le déploiement Bicep d'un environnement échoue avec ServiceModelDeprecating. Cause et correction ?
Le modèle ou la version déclarés sont retirés ou en cours de retrait ; mettre à jour
nameetversiondu deployment après avoir listé les modèles GA (az cognitiveservices model list --location … --query "[?model.lifecycleStatus=='GenerallyAvailable']").
16. Pour aller plus loin#
- AI Gateway au niveau de la Foundry resource : une passerelle API Management partagée par tous les projects de la resource, avec des token limits par project ; pour des passerelles séparées, des Foundry resources séparées (voir SC-500 · 07 pour l'AI gateway).
- Foundry control plane : surveillance d'une flotte de ressources, enregistrement d'agents personnalisés, gouvernance des outils MCP par une passerelle.
- Agent 365 : remontée des traces des agents Foundry, Copilot Studio et Microsoft 365 dans une observabilité centrale.
- Model router et policies : des définitions Azure Policy dédiées au model router existent en preview (régions, règles de routage, journalisation).
- Fine-tuning et entraînement de LLM : chapitre 07 et chapitre 08 (hors examen : KAITO sur AKS, voir AKS · 06).
17. Fiche à retenir#
- GenAIOps : Explore, Build, Operationalize + management loop ; on gère prompts, agents, données et évaluations.
- Resource = gouvernance (réseau, quota, deployments, CMK), project = équipe ; fine-tuning, image, vidéo, batch et Translator ne s'isolent pas par project.
- Exploration co-localisée, production isolée (une resource par workload) ; même IaC, autres paramètres.
- Création :
--assign-identity,--allow-project-management(définitif),--custom-domainunique ; CLI 2.80+. - Rôles : Foundry Account Owner (deployments), Project Manager (publie, ne déploie pas), Foundry User (plan de données) ; Owner/Contributor ne suffisent pas pour le plan de données.
- Keyless (
disableLocalAuth), pipeline par workload identity federation, project managed identity vers les ressources connectées. - Réseau : Private Endpoint en entrée ; managed VNet (Allow internet outbound / Allow only approved outbound, non réversibles) ou BYO VNet en sortie.
- Bicep :
accounts(kindAIServices),accounts/projects,accounts/deployments; foundry-samples ; Export template. - Serverless API d'abord ; managed compute = open source sur GPU dédiés, template,
GlobalManagedCompute, pas de content filtering, quota distinct des VM ; instant access = essai sans deployment. - Choix du modèle : specification → filtres → leaderboard (safety : plus bas = mieux) → Compare → vos données → pilote.
- Policies approved models et eligibility requirements (Deny / Audit, 15 minutes).
- Retrait : Standard = auto-upgrade (
versionUpgradeOption) ; Provisioned, Batch, fine-tuned = manuel ; remplaçant ~90 jours avant (30 en provisioned) ; dates non prolongeables. - Migration : Discover, Assess, Adapt, Validate, Roll out, Retire ; jeu gelé ; canary, shadow, rollback corridor.
- PTU = normalized TPM ÷ Input TPM per PTU ; normalized = input × (1 − cache) + ratio × output ; arrondi au minimum ou à l'incrément ; calculator puis benchmark ≥ 10 minutes.
- Prompts : fichiers versionnés, branches, pull request + évaluation, tag = agent version, épingler la production, rollback = ré-épingler ; prompt flow retiré le 20/04/2027.
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Study guide for Exam AI-300
- Operationalize generative AI applications (GenAIOps) — learning path
- Plan and prepare a GenAIOps solution
- Manage prompts for agents in Microsoft Foundry with GitHub
- Evaluate and optimize AI agents through structured experiments
- Microsoft Foundry rollout across my organization
- Microsoft Foundry architecture
- Create a project for Microsoft Foundry
- Quickstart: Deploy a Microsoft Foundry resource by using a Bicep file
- Role-based access control for Microsoft Foundry
- Configure managed virtual network for Microsoft Foundry projects
- Configure private link for Microsoft Foundry
- Deployment overview for Microsoft Foundry Models
- Deployment types for Microsoft Foundry Models
- Managed compute in Microsoft Foundry (preview)
- Deploy open-source models with managed compute (preview)
- Model leaderboards in Microsoft Foundry portal (preview)
- Compare models using the model leaderboard (preview)
- Built-in policies for model deployment in Microsoft Foundry portal
- Model migration process
- Determine PTU sizing for a workload
- Get started using provisioned deployments
- Manage hosted agents
- Configure and share your agent
- Promote hosted agents to production with the Azure Developer CLI
- Get started with prompt flow (avis de retrait)