

Version : 1.1 · Date : 2026-10-21 · Domaine 4 de l'examen : Implement text analysis solutions (10 à 15 %)
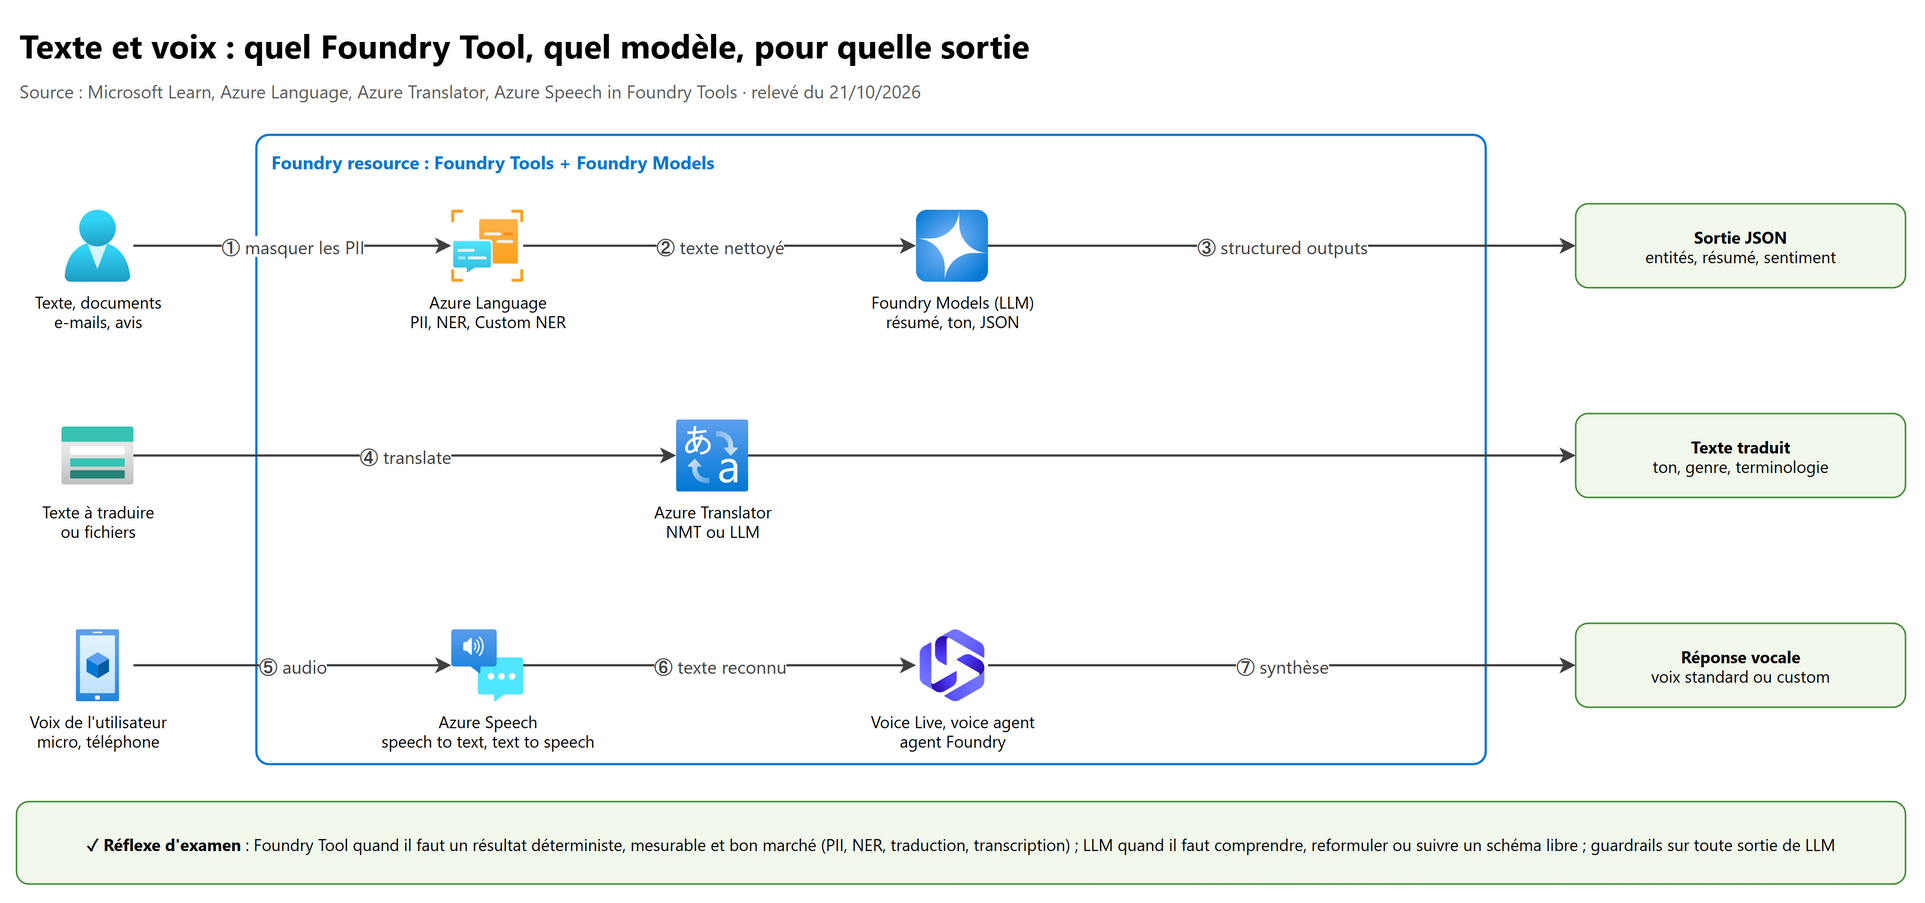
En une phrase : pour le texte, on combine des Foundry Tools spécialisés (Azure Language pour les PII et les entités, Azure Translator pour la traduction) et des LLM pilotés par prompt et structured outputs ; pour la voix, Azure Speech transcrit et synthétise, et Voice Live ou les Foundry voice agents font du temps réel une modalité d'agent à part entière.
Ce que l'examen demande#
Deux blocs du domaine Implement text analysis solutions, repris mot pour mot du guide d'étude AI-103 (compétences mesurées au 16 avril 2026) :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| Apply language model text analysis | ||
| 1 | Implement solutions to extract entities, topics, summaries, and structured JSON outputs by using generative prompting and Foundry Tools | 2 |
| 2 | Configure detection of sentiment, tone, safety issues, and sensitive content | 3 |
| 3 | Build solutions that translate text by using Azure Translator in Foundry Tools or LLM‑powered translation flows | 4 |
| 4 | Customize language model outputs for domain tasks, such as compliance summarization and domain extraction | 5 |
| Implement speech solutions | ||
| 5 | Implement workflows to convert speech to text and text to speech for agentic interactions | 6 |
| 6 | Integrate speech as an agent modality, including custom speech models | 7 |
| 7 | Enable multimodal reasoning from audio inputs | 8 |
| 8 | Translate speech into other languages by using language models and Foundry Tools | 9 |
Le choix général entre un modèle et un Foundry Tool est posé au chapitre 01, les structured outputs et la Responses API au chapitre 05, les guardrails et Content Safety au chapitre 04, le prompt engineering au chapitre 07. Ce chapitre les applique au texte et à la parole.
1. Les bases à maîtriser#
1.1 Foundry Tool ou LLM : la règle de choix#
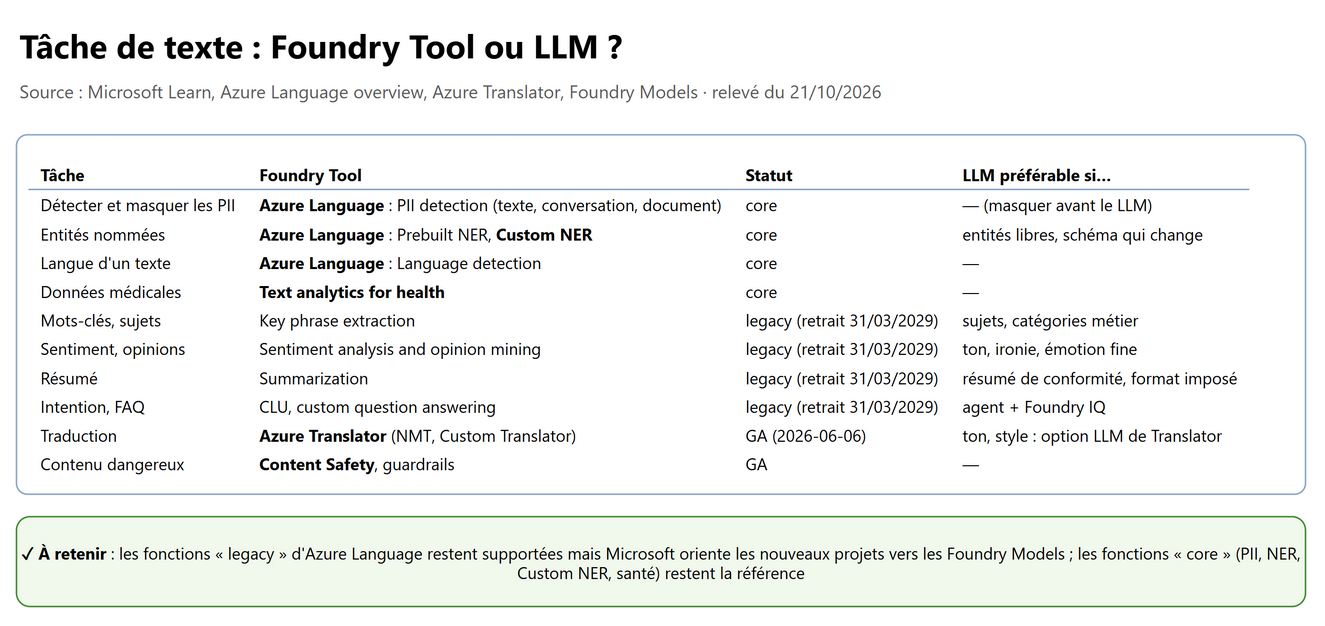
Un LLM sait extraire des entités, résumer, classer un sentiment ou traduire. Un Foundry Tool spécialisé reste souvent meilleur quand le résultat doit être déterministe, mesurable, bon marché et conforme. À l'examen, la bonne réponse combine souvent les deux : le Foundry Tool pour la partie normée, le LLM pour la partie qui demande de comprendre ou de reformuler.
flowchart TD
    A["Tâche de texte ou de parole"] --> B{"Résultat normé et mesurable ?<br/>PII, entités, langue, transcription"}
    B -- Oui --> T["Foundry Tool<br/>Azure Language, Azure Speech, Azure Translator"]
    B -- Non --> C{"Il faut comprendre, reformuler,<br/>suivre un schéma ou un ton ?"}
    C -- Oui --> L["LLM + prompt + structured outputs"]
    C -- Non --> T
    T --> G["Sortie exploitée par l'application ou l'agent"]
    L --> S["Guardrails sur la sortie du LLM"] --> G
1.2 Ce qui a changé, et que les questions récentes supposent#
| Service | État au 21/10/2026 |
|---|---|
| Azure Language in Foundry Tools | Fonctions core recommandées pour les nouveaux projets : PII detection, Language detection, Prebuilt NER, Custom NER, Text analytics for health. Fonctions legacy (supportées pour l'existant) : Key phrase extraction, Sentiment analysis and opinion mining, Summarization, Entity linking, Custom question answering, CLU, Custom text classification, Orchestration workflow |
| Fonctions legacy datées | Retrait le 31 mars 2029 pour Sentiment analysis and opinion mining, Key phrase extraction, Summarization, Entity linking, CQA, CLU et Custom text classification ; Microsoft oriente les nouveaux projets vers les Foundry Models |
| Azure Language MCP server (preview) | Les capacités d'Azure Language exposées comme outils d'agent, en serveur distant dans le Foundry Tool Catalog ou en serveur local |
| Azure Translator in Foundry Tools | Text translation 2026-06-06 (GA) : choix entre NMT et LLM par requête, adaptive custom translation, tone et gender ; changements incompatibles avec la v3.0 (inputs en requête, value en réponse) |
| Azure Speech in Foundry Tools | Speech to text (real-time, fast, batch), Azure LLM Speech, custom speech, text to speech, custom voice, speech translation, Live Interpreter, Voice Live |
| Foundry voice agents (preview) | Agent kind: voice géré dans Foundry, avec téléphonie intégrée et traçage du pipeline vocal |
1.3 Authentification sans clé#
Comme partout dans Foundry, on préfère Microsoft Entra ID aux clés (chapitre 03). Ce qui est propre aux Foundry Tools de ce chapitre :
| Service | Ce qu'il faut pour Entra ID |
|---|---|
| Azure Language | Custom subdomain obligatoire (les endpoints régionaux ne prennent pas Entra ID) ; rôle Cognitive Services Language Reader (ou Cognitive Services User) ; TextAnalyticsClient(endpoint, credential=DefaultAzureCredential()) |
| Azure Translator | Rôle Cognitive Services User ; endpoint personnalisé https://{ressource}.cognitiveservices.azure.com/translator/... ou endpoint global avec l'en-tête Ocp-Apim-ResourceId ; si les réseaux sont restreints (VNet), l'endpoint personnalisé est obligatoire |
| Azure Speech | Custom domain obligatoire (irréversible) et rôle Cognitive Services Speech User ou Cognitive Services Speech Contributor ; SpeechConfig(token_credential=..., endpoint=...) ; le ConversationTranslator ne prend pas en charge Entra ID |
| Voice Live en mode agent | Entra ID uniquement (pas de clé) ; vers un agent d'une autre resource, l'identité managée de Voice Live doit avoir le rôle Foundry User sur la resource cible |
2. Extraire entités, sujets, résumés et JSON#
2.1 Avec Azure Language#
| Besoin | Fonction Azure Language | Remarque |
|---|---|---|
| Personnes, lieux, organisations, dates… | Prebuilt NER | Catégories prédéfinies, aucun entraînement |
| Vos propres catégories (n° de contrat, clause…) | Custom NER | Modèle entraîné sur vos textes annotés ; fonction core |
| Données personnelles | PII detection | Texte, conversations (chat, transcriptions), documents natifs (.pdf, .docx, .txt) ; texte masqué (redacted_text) |
| Données cliniques | Text analytics for health | Extraction et étiquetage d'informations médicales |
| Mots-clés, résumé | Key phrase extraction, Summarization (extractive ou abstractive) | Legacy, retrait le 31/03/2029 : préférer un LLM pour un nouveau projet |
from azure.ai.textanalytics import TextAnalyticsClient
from azure.identity import DefaultAzureCredential

# Endpoint de la resource (custom domain), authentification sans clé
client = TextAnalyticsClient(endpoint="https://{ressource}.cognitiveservices.azure.com/",
                             credential=DefaultAzureCredential())

documents = ["Le client Jean Martin ([email protected], 06 12 34 56 78) conteste la facture F-2026-118."]

for doc in client.recognize_pii_entities(documents, language="fr"):
    if not doc.is_error:
        print(doc.redacted_text)                      # texte avec les PII masquées
        for e in doc.entities:
            print(e.text, e.category, round(e.confidence_score, 2))

for doc in client.recognize_entities(documents, language="fr"):   # Prebuilt NER
    if not doc.is_error:
        print([(e.text, e.category) for e in doc.entities])
2.2 Avec un LLM et les structured outputs#
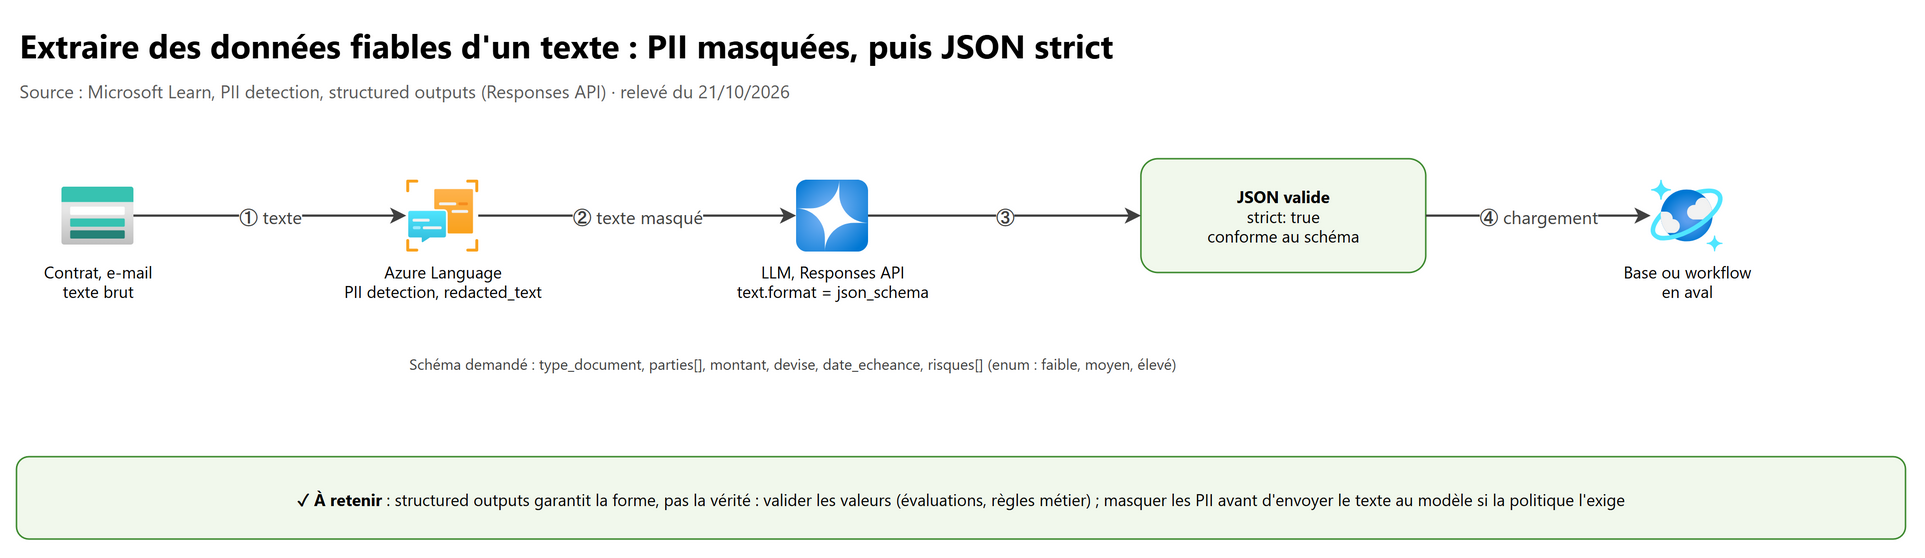
Pour les sujets, les résumés au format imposé ou une extraction dont le schéma change souvent, on utilise un LLM avec la Responses API et un JSON schema strict : la réponse respecte toujours la forme demandée.
import json
from azure.identity import DefaultAzureCredential
from azure.ai.projects import AIProjectClient

project = AIProjectClient(endpoint="https://{ressource}.services.ai.azure.com/api/projects/{project}",
                          credential=DefaultAzureCredential())
openai = project.get_openai_client()

schema = {
    "type": "object",
    "properties": {
        "sujets":     {"type": "array", "items": {"type": "string"}},
        "entites":    {"type": "array", "items": {"type": "object",
                       "properties": {"texte": {"type": "string"}, "type": {"type": "string"}},
                       "required": ["texte", "type"], "additionalProperties": False}},
        "resume":     {"type": "string"},
        "sentiment":  {"type": "string", "enum": ["positif", "neutre", "négatif"]},
    },
    "required": ["sujets", "entites", "resume", "sentiment"],
    "additionalProperties": False,          # obligatoire en mode strict
}

response = openai.responses.create(
    model="gpt-5-mini",                     # nom du model deployment
    instructions="Tu analyses des réclamations clients. Résumé en deux phrases maximum, en français.",
    input=texte_masque,                     # texte déjà passé par la PII detection
    text={"format": {"type": "json_schema", "name": "analyse_reclamation", "strict": True, "schema": schema}},
)
analyse = json.loads(response.output_text)
Structured outputs garantit la forme, pas la vérité : une valeur peut être conforme au schéma et fausse. On valide par des règles métier et des evaluators (chapitre 04).
2.3 Combiner les deux#
| Motif | Quand |
|---|---|
| PII detection puis LLM | Politique de confidentialité : le modèle ne doit pas voir les données personnelles |
| NER puis LLM | Les entités doivent être normées (catégories stables), le LLM rédige le résumé autour |
| LLM puis contrôle | Extraction libre par LLM, puis guardrail PII filter sur la sortie et règles de validation |
| Agent + Azure Language MCP server | Un agent appelle PII, NER ou la détection de langue comme des outils, à la demande |
3. Détecter le sentiment, le ton, les risques et le contenu sensible#
| À détecter | Solution | À savoir |
|---|---|---|
| Sentiment (positif, neutre, négatif) | Sentiment analysis d'Azure Language : étiquette par document et par phrase, scores de confiance de 0 à 1 ; opinion mining lie le sentiment à un aspect (« le personnel » → positif) | Legacy, retrait le 31/03/2029 |
| Sentiment, ton, émotion, ironie | LLM avec un champ enum dans le JSON schema (section 2.2) |
Évaluer sur un jeu annoté avant de remplacer l'ancien service |
| Problèmes de sécurité (haine, violence, sexuel, automutilation, jailbreak) | Guardrails des déploiements et Azure AI Content Safety (chapitre 04) | Les catégories et niveaux de gravité sont détaillés au chapitre 04 |
| Contenu sensible en entrée | PII detection d'Azure Language (texte, conversation, document), avec masquage | Anonymisation par remplacement synthétique : preview |
| Contenu sensible dans la réponse du modèle | Guardrail PII filter (personal data filter) | Modes Annotate ou Annotate and Block, réglables par catégorie de PII ; annotations à partir de l'API 2025-01-01-preview |
Le PII filter couvre notamment les données personnelles (e-mail, téléphone, adresse), financières (carte, IBAN, SWIFT), les
identifiants nationaux et des secrets Azure (connection strings, clés de compte de stockage). En mode Annotate, la réponse
contient detected, filtered et redacted.
4. Traduire du texte avec Azure Translator ou un LLM#
4.1 Les fonctions d'Azure Translator#
| Fonction | Ce qu'elle fait |
|---|---|
| Text translation 2026-06-06 (GA) | Traduction temps réel, choix NMT ou LLM, tone, gender, adaptive custom translation, transliteration |
| Text translation v3 (GA) | Version précédente : dynamic dictionary, prévention de traduction ; SDK et conteneur |
| Document translation, synchronous | Un fichier (seul ou avec un glossaire), structure et format préservés, sans compte de stockage, réponse directe |
| Document translation, asynchronous | Lots de fichiers complexes, conteneurs Blob source et cible, structure et format préservés ; fichiers image en preview (2025-12-01-preview) |
| Custom Translator | Modèle NMT entraîné sur un corpus parallèle et des dictionnaires (phrase ou sentence) ; appelé par son category ID ; réentraînement jusqu'à ~48 h |
| Adaptive custom translation | 5 à 10 000 paires de segments alignés (500 caractères max) : un index bilingue construit en quelques minutes oriente un LLM (terminologie, style) sans entraîner de modèle |
4.2 Un appel, trois moteurs#
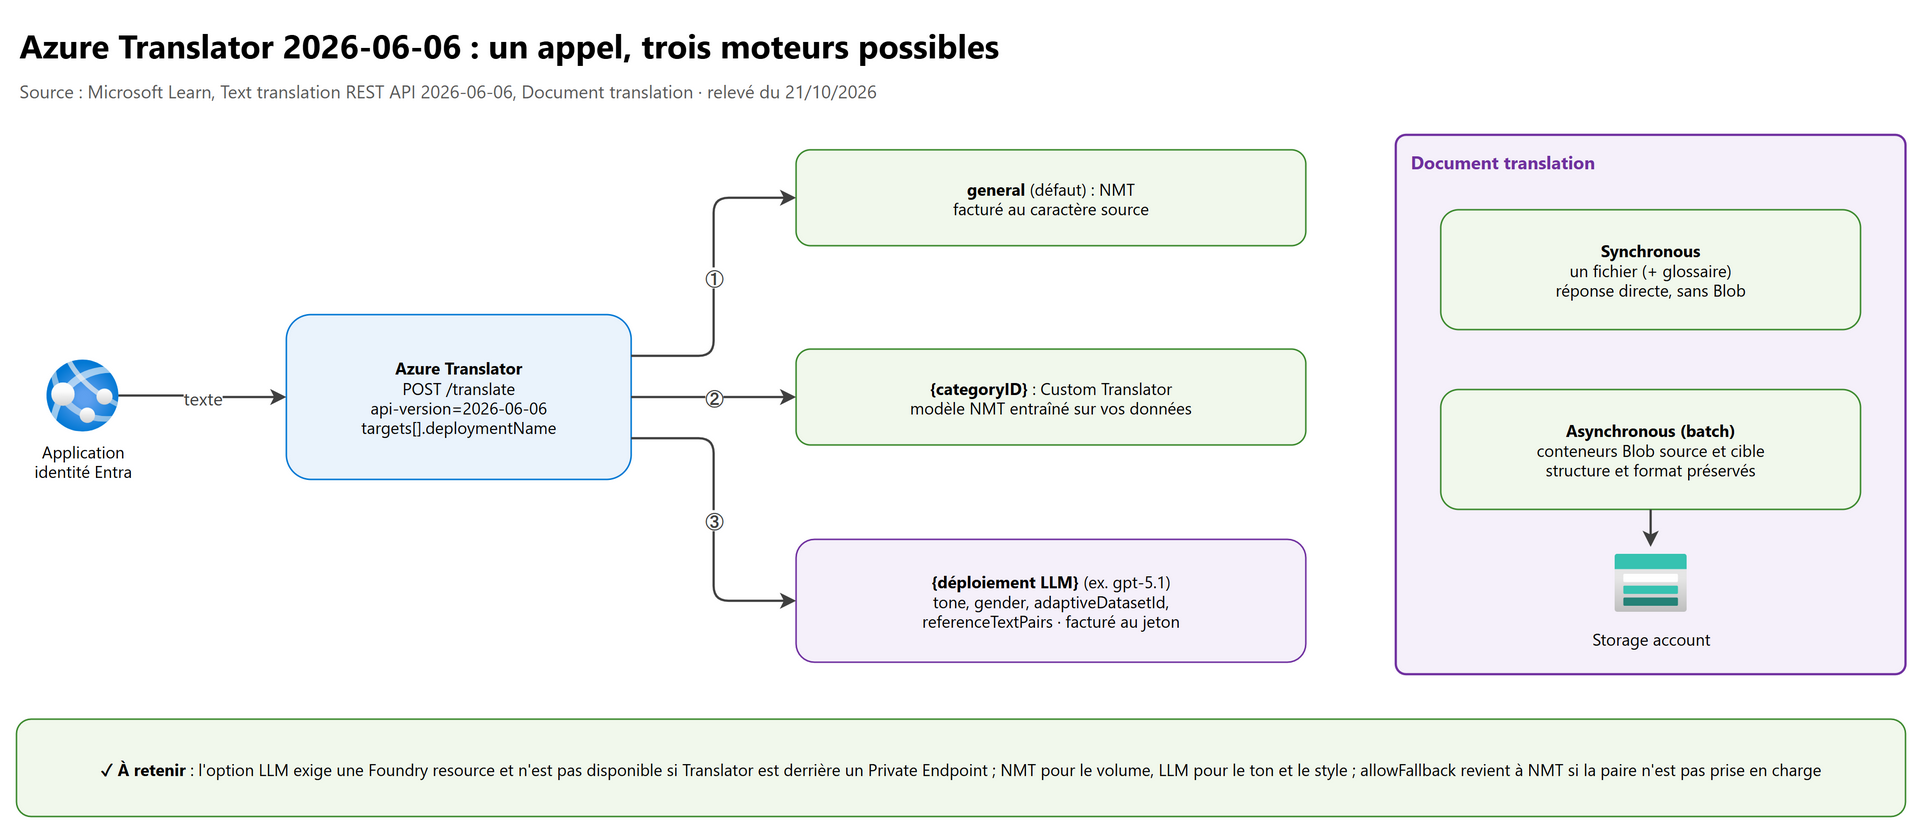
Dans la version 2026-06-06, chaque élément de targets choisit son moteur avec deploymentName :
deploymentName |
Moteur | Facturation | Options |
|---|---|---|---|
general (défaut) |
NMT standard | Au caractère source | profanityAction, textType (plain ou html) |
{categoryID} |
Modèle Custom Translator | Au caractère source | — |
| Nom d'un déploiement LLM (ex. GPT-5.1) | LLM | Au jeton (entrée et sortie) | tone (formal, informal, neutral), gender (female, male, neutral), adaptiveDatasetId, referenceTextPairs (5 paires max) |
Règles d'examen :
- l'option LLM exige une Foundry resource et n'est pas disponible quand Translator est configuré avec un Private Endpoint ;
allowFallback(vrai par défaut) bascule sur le système général si le modèle choisi ne prend pas en charge la paire de langues ; àfalse, le service renvoie une erreur ;- limites par requête : 1 000 éléments de 50 000 caractères en NMT, 50 éléments de 5 000 caractères en LLM ;
- sans
language, la langue source est détectée (detectedLanguagedans la réponse).
import requests
from azure.identity import DefaultAzureCredential

url = "https://{ressource}.cognitiveservices.azure.com/translator/text/translate?api-version=2026-06-06"
token = DefaultAzureCredential().get_token("https://cognitiveservices.azure.com/.default").token

body = {"inputs": [{
    "text": "Le médecin est disponible lundi prochain. Voulez-vous prendre rendez-vous ?",
    "language": "fr",
    "targets": [
        {"language": "en"},                                            # NMT (general)
        {"language": "es", "deploymentName": "gpt-51-traduction",      # LLM : ton et genre
         "tone": "formal", "gender": "female"},
    ],
}]}

r = requests.post(url, json=body, headers={"Authorization": f"Bearer {token}"})
for t in r.json()["value"][0]["translations"]:
    print(t["language"], t["text"])
4.3 Un flux de traduction entièrement piloté par LLM#
On peut aussi traduire avec un simple prompt sur un Foundry Model, par exemple pour réécrire dans un registre précis ou traduire et résumer en une étape. C'est le choix pertinent quand la traduction n'est qu'une étape d'un traitement génératif. Pour le volume, la prévisibilité du coût (au caractère) et la constance terminologique (Custom Translator, glossaires), Azure Translator reste la référence. Microsoft conseille de réserver le LLM aux cas qui demandent du ton, du style ou du contexte, et de laisser le trafic de masse sur NMT.
5. Personnaliser les sorties pour un domaine métier#
Exemples typiques : synthèse de conformité (résumer un contrat en signalant les clauses à risque selon une grille interne) et extraction métier (codes produits, numéros de police, clauses de résiliation).
| Levier | Effet | Quand |
|---|---|---|
| Instructions (system / developer) | Rôle, règles, vocabulaire, format, « réponds “non trouvé” plutôt que d'inventer » | Toujours en premier (chapitre 07) |
| Few-shot | 2 à 5 exemples entrée → sortie attendue | Format ou style difficile à décrire |
| Structured outputs | Schéma JSON strict, enum pour les valeurs autorisées |
Sortie consommée par un programme |
| Grounding / RAG | La grille de conformité ou le référentiel est fourni au modèle | Règles qui changent, besoin de citations (chapitre 05) |
| Custom NER (Azure Language) | Entités métier extraites de façon stable et mesurée | Gros volumes, catégories fixes |
| Fine-tuning (SFT) | Le modèle apprend le format et le ton à partir d'exemples | L'invite devient trop longue ou le format n'est pas tenu (chapitre 01) |
| Evaluations | Mesurer la qualité avant et après chaque changement | Toujours (chapitre 04) |
Remplacer un service legacy (CLU, custom text classification, summarization) par un LLM : construire un jeu de test à partir des données existantes, comparer les deux, puis basculer ; les fonctions legacy restent supportées jusqu'au 31/03/2029.
Instructions (extrait) d'une synthèse de conformité
Tu es analyste conformité. À partir du contrat fourni :
1. Résume l'objet du contrat en 3 phrases maximum.
2. Liste chaque clause de la grille ci-dessous avec : présente / absente / non conforme, et la citation exacte.
3. Si une information manque, écris "non trouvé". N'invente jamais de clause.
Grille : durée, résiliation anticipée, pénalités, protection des données (RGPD), juridiction.
6. Speech to text et text to speech pour les agents#
6.1 Les modes de speech to text#
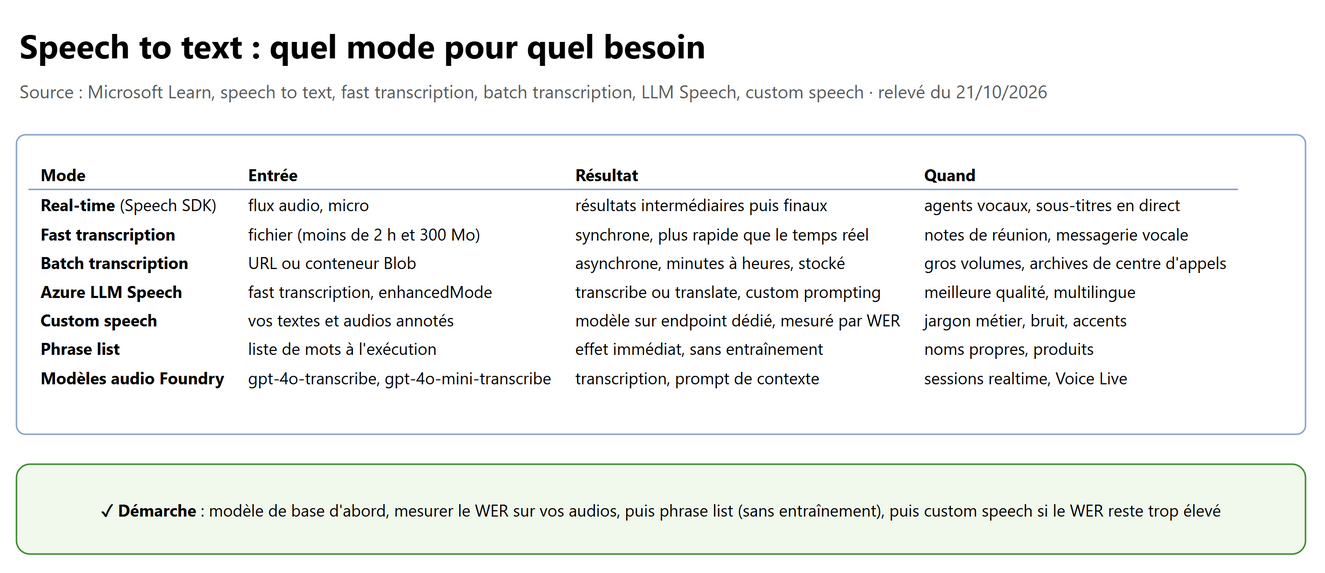
| Mode | Points clés |
|---|---|
| Real-time | Speech SDK, Speech CLI ou REST pour audio court ; résultats intermédiaires ; jusqu'à deux canaux transcrits séparément (preview) |
| Fast transcription | Synchrone, plus rapide que le temps réel, latence prévisible ; fichiers de moins de 2 h et 300 Mo ; forme display uniquement (ponctuation, majuscules) ; modèles : Azure Transcribe (défaut), Azure LLM Speech, MAI-Transcribe-2 |
| Batch transcription | Asynchrone depuis des URL ou un conteneur Azure, résultats stockés ; de quelques minutes à quelques heures ; un custom speech model y est utilisable sans endpoint hébergé |
| Azure LLM Speech | Mode enhanced de la fast transcription (enhancedMode.enabled) : tâches transcribe ou translate, custom prompting, multilingue par défaut ; audio de moins de 5 h et 500 Mo |
| Custom speech | Modèle de base + vos données (texte du domaine, audio annoté) ; qualité mesurée par le WER ; déployé sur un endpoint personnalisé |
| Phrase list | Personnalisation légère à l'exécution (noms propres, produits), sans entraînement |
Démarche recommandée par Microsoft : mesurer le word error rate du modèle de base sur des enregistrements réels, puis ajouter une phrase list, et n'entraîner un custom speech model que si le WER reste trop élevé. Un modèle déployé reste figé jusqu'à ce que vous le mettiez à jour, même quand un nouveau modèle de base sort.
6.2 Le text to speech#
- Standard voices : voix neuronales prêtes à l'emploi, dont des voix multilingues et HD ; Voice Live annonce plus de 600 voix sur plus de 150 locales.
- SSML (Speech Synthesis Markup Language) : régler le débit, la hauteur, les pauses, la prononciation, le style.
- Custom voice et text-to-speech avatar : voir la section 7.5.
import azure.cognitiveservices.speech as speechsdk
from azure.identity import DefaultAzureCredential

# Entra ID : custom domain obligatoire, rôle Cognitive Services Speech User
config = speechsdk.SpeechConfig(token_credential=DefaultAzureCredential(),
                                endpoint="https://{custom-domain}.cognitiveservices.azure.com/")
config.speech_recognition_language = "fr-FR"

# Speech to text depuis le micro, avec une phrase list
recognizer = speechsdk.SpeechRecognizer(speech_config=config)
phrases = speechsdk.PhraseListGrammar.from_recognizer(recognizer)
phrases.addPhrase("Contoso")
phrases.addPhrase("Foundry IQ")
result = recognizer.recognize_once_async().get()
print(result.text)

# Text to speech avec SSML
ssml = """<speak version='1.0' xml:lang='fr-FR' xmlns='http://www.w3.org/2001/10/synthesis'>
  <voice name='en-US-AvaMultilingualNeural'>
    Votre dossier est validé. <break time='300ms'/> <prosody rate='-10%'>Avez-vous une autre question ?</prosody>
  </voice>
</speak>"""
synthesizer = speechsdk.SpeechSynthesizer(speech_config=config)
synthesizer.speak_ssml_async(ssml).get()
7. La voix comme modalité d'agent#
7.1 Cascade ou temps réel#
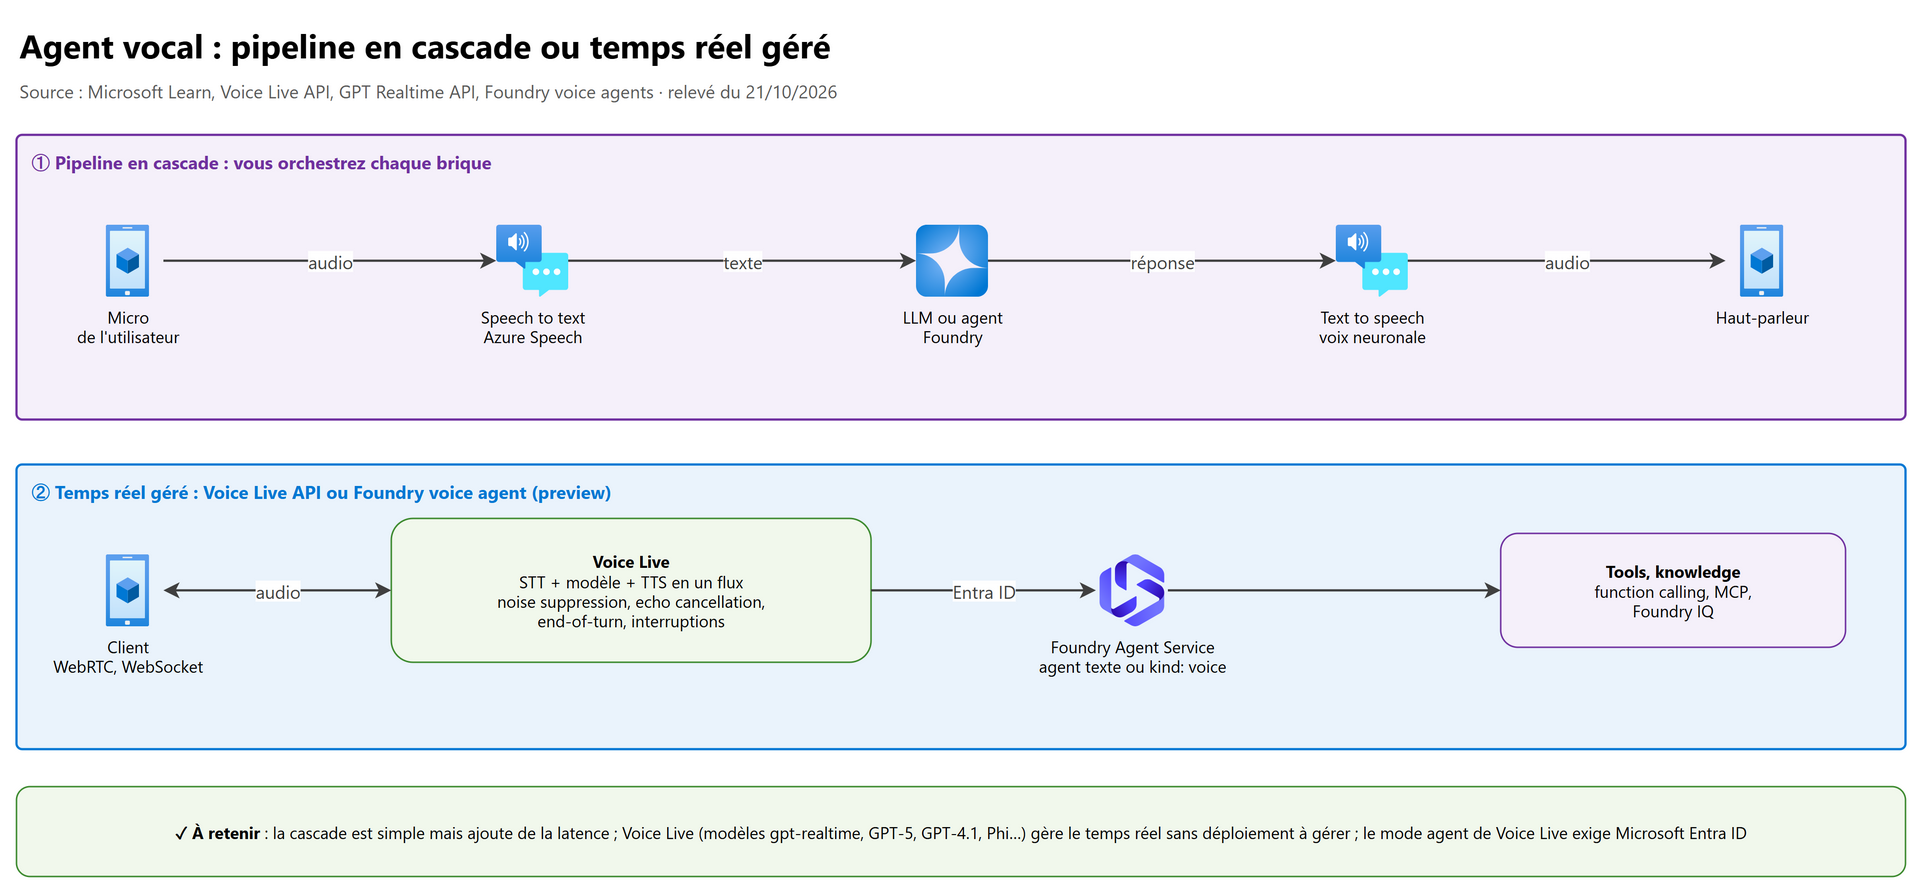
| Cascade (STT → LLM → TTS) | Voice Live API | Foundry voice agent (preview) | |
|---|---|---|---|
| Qui orchestre | Vous | Le service (STT, modèle, TTS en un flux) | Le service, configuré comme un agent kind: voice |
| Latence perçue | La plus élevée | Faible | Faible |
| Modèles | Tout modèle de texte | gpt-realtime, GPT-5, GPT-4.1, GPT-4o, Phi… gérés par le service | Speech-to-speech (gpt-realtime) ou modèles de texte, managed ou self_deployed |
| Extras | À coder | Noise suppression, echo cancellation, détection d'interruption et de fin de tour, avatar, function calling | Idem + téléphonie intégrée (Teams Phone, Twilio), traçage du pipeline vocal, enregistrements optionnels |
| Connexion | Vos API | WebSocket (serveur à serveur), API compatible avec la Realtime API | Endpoint du project : /api/projects/{project}/agents/{agent}/endpoint/protocols/voice?api-version=v1 |
7.2 Voice Live API#
- Entièrement géré : pas de modèle audio à déployer, pas de capacité à planifier.
- Personnalisation : phrase list ou custom speech en entrée, custom voice en sortie.
- Tarification par niveau Pro, Standard ou Lite, déterminé par le modèle choisi (vous ne choisissez pas le niveau) ; repères : environ 10 jetons par seconde d'audio en entrée et 20 en sortie pour les modèles Azure OpenAI.
- Mode agent : Voice Live se connecte à un agent Foundry existant (
agent_name,project_name, version etconversation_idoptionnels) ; les instructions et les outils restent dans l'agent. Entra ID obligatoire pour ce mode. - Variantes de données :
gpt-realtime-datazoneet-regionalgardent invites et réponses dans la zone de données ou la région de la resource.
sequenceDiagram
    actor U as Utilisateur
    participant C as Client (navigateur, téléphone)
    participant V as Voice Live
    participant A as Agent Foundry
    participant T as Outil (fonction, MCP)
    C->>V: Ouvre la session (jeton Entra ID)
    V-->>C: session.updated
    U->>C: Parle
    C->>V: Audio en continu
    V->>V: Réduction de bruit, fin de tour
    V->>A: Tour utilisateur
    A->>T: Appel d'outil
    T-->>A: Résultat
    A-->>V: Réponse
    V-->>C: Audio de synthèse en continu
    U->>C: Interrompt
    C->>V: Nouvel audio
    V-->>C: Réponse coupée, nouveau tour
7.3 GPT Realtime API (Azure OpenAI)#
| Connexion | Usage | Latence indicative |
|---|---|---|
| WebRTC | Applications clientes (web, mobile) : le choix par défaut | ~100 ms |
| WebSocket | Serveur à serveur, middleware | ~200 ms |
| SIP | Téléphonie : centres d'appels, SVI | Variable |
- Endpoint GA
/openai/v1/realtime, sans paramètreapi-versiondaté. - Types de session :
realtime(agent vocal),transcription(transcription en flux), et une translation session sur/openai/v1/realtime/translations. - Modèles de transcription utilisables dans la session :
gpt-4o-transcribe,gpt-4o-mini-transcribe,whisper-1(etgpt-4o-transcribe-diarizedans Voice Live), avec unpromptde contexte (« termes attendus : Azure, Foundry »). Le Model retirement schedule annonce le retrait des modèles Azure OpenAIwhisper,ttsettts-hd(version 001) le 15/12/2026 : préférer les modèlesgpt-4o-*pour un nouveau projet. - L'API n'est pas faite pour se connecter directement aux appareils : un client (WebRTC, téléphonie) termine le flux audio. Pas de clé longue durée dans le code du navigateur.
7.4 Foundry voice agents (preview)#
- On crée un nouvel agent avec Voice comme interaction mode (
VoiceAgentDefinitionen SDK) : un agent texte existant ne peut pas changer de mode ; on peut le réutiliser comme subagent (même project, pas dans un project isolé par VNet). model_type:managed(le service héberge le modèle) ouself_deployed(votre déploiement).- Le definition regroupe instructions, voix (
audio.output.voice), transcription, turn detection, réduction de bruit, greeting. storevaut false par défaut : àtrue, transcript, événements et audio brut sont conservés ensemble (consentement, rétention à prévoir).- REST : en-tête
Foundry-Features: VoiceAgents=V1Preview; jeton Entra pourhttps://ai.azure.com/.default.
import os
from azure.ai.projects import AIProjectClient
from azure.ai.projects.models import RealtimeServerEventError, RealtimeServerEventSessionUpdated
from azure.identity import DefaultAzureCredential

# pip install "azure-ai-projects[voice]>=2.7.0" azure-identity
with DefaultAzureCredential() as cred, AIProjectClient(endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"],
                                                       credential=cred, allow_preview=True) as project:
    with project.beta.voice_agents.realtime.connect(agent_name="agent-accueil-vocal", api_version="v1") as conn:
        while True:                                   # attendre que la session soit prête avant d'envoyer l'audio
            event = conn.recv(timeout=45)
            if isinstance(event, RealtimeServerEventError):
                raise RuntimeError(event.error.message)
            if isinstance(event, RealtimeServerEventSessionUpdated):
                print("Session vocale prête")
                break
7.5 Custom speech et custom voice#
L'examen cite explicitement les custom speech models (reconnaissance) ; la custom voice (synthèse) en est le pendant.
| Custom speech (entrée) | Custom voice (sortie) | |
|---|---|---|
| But | Mieux reconnaître le jargon, les accents, le bruit | Une voix unique pour la marque ou un personnage |
| Données | Textes du domaine, audio + transcriptions de référence, prononciations | Enregistrements du voice talent + scripts |
| Mesure | WER avant et après | Écoute, tests dans le playground |
| Accès | Ouvert | Limited Access (formulaire aka.ms/customneural) |
| Coût | Entraînement (modèles de base depuis octobre 2023), hébergement de l'endpoint, usage | Entraînement, hébergement, usage |
| Dans Voice Live | Phrase list ou custom speech model en entrée | Custom voice en sortie, facturée en plus |
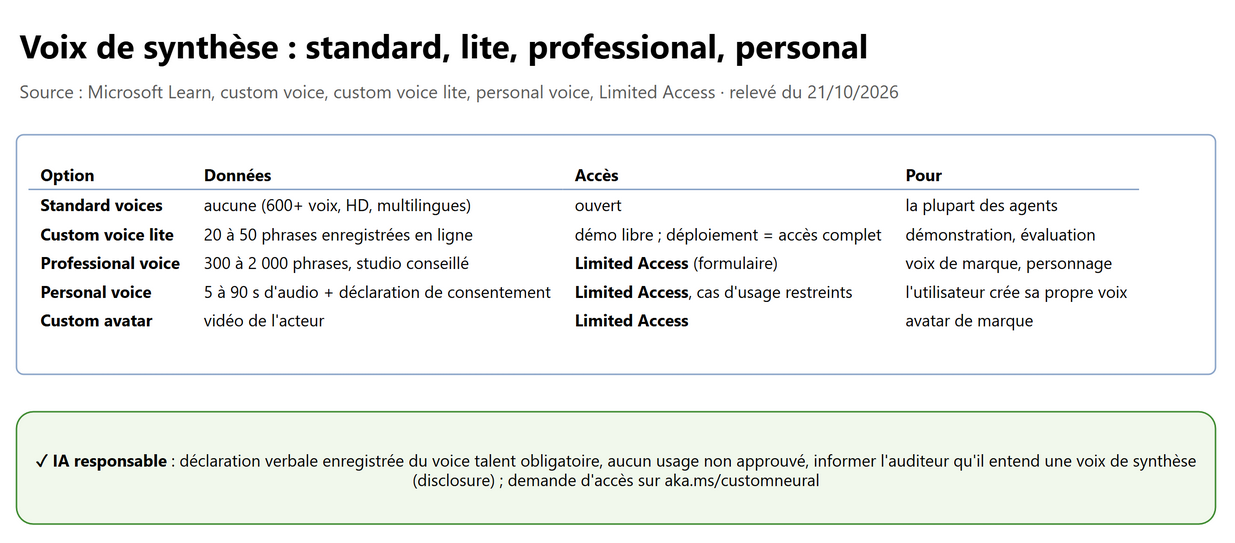
Pour une professional voice, le voice talent enregistre d'abord une déclaration de consentement ; pour une personal
voice, le service génère un speakerProfileId à partir de ce consentement et de 5 à 90 secondes d'audio, et la voix parle environ
une centaine de langues avec détection automatique. Le disclosure (dire à l'auditeur qu'il entend une voix de synthèse) fait
partie des obligations d'IA responsable.
8. Raisonner sur des entrées audio#
| Approche | Ce que fait le modèle | Exemple |
|---|---|---|
Audio completions (gpt-4o-audio-preview, gpt-4o-mini-audio-preview) |
Reçoit de l'audio dans /chat/completions et répond en texte, en audio ou les deux |
« Décris l'appel et résume la satisfaction du client » |
| Realtime API, Voice Live | Écoute et répond en continu, appelle des outils | Agent vocal |
| Azure LLM Speech | Transcription ou traduction guidée par un prompt | Transcrire une réunion avec le vocabulaire du projet |
| Transcription puis LLM | Le LLM raisonne sur le texte transcrit | Analyse de sentiment d'appels archivés (batch) |
import base64
from openai import AzureOpenAI
from azure.identity import DefaultAzureCredential, get_bearer_token_provider

token_provider = get_bearer_token_provider(DefaultAzureCredential(), "https://ai.azure.com/.default")
client = AzureOpenAI(azure_endpoint="https://{ressource}.openai.azure.com/", api_version="2025-01-01-preview",
                     azure_ad_token_provider=token_provider)

with open("appel-client.wav", "rb") as f:
    audio_b64 = base64.b64encode(f.read()).decode("utf-8")

completion = client.chat.completions.create(
    model="gpt-4o-mini-audio-preview",           # nom du déploiement audio
    modalities=["text"],                         # réponse texte seulement
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Résume cet appel et indique si le client est satisfait."},
        {"type": "input_audio", "input_audio": {"data": audio_b64, "format": "wav"}},
    ]}],
)
print(completion.choices[0].message.content)
Piège : Microsoft indique que le système de content filtering ne s'applique pas aux invites et réponses traitées par les modèles audio comme Whisper. Si le contenu doit être filtré, transcrire puis appliquer Content Safety ou les guardrails au texte. En streaming avec l'audio en sortie, seul le format
pcm16est accepté.
9. Traduire la parole#
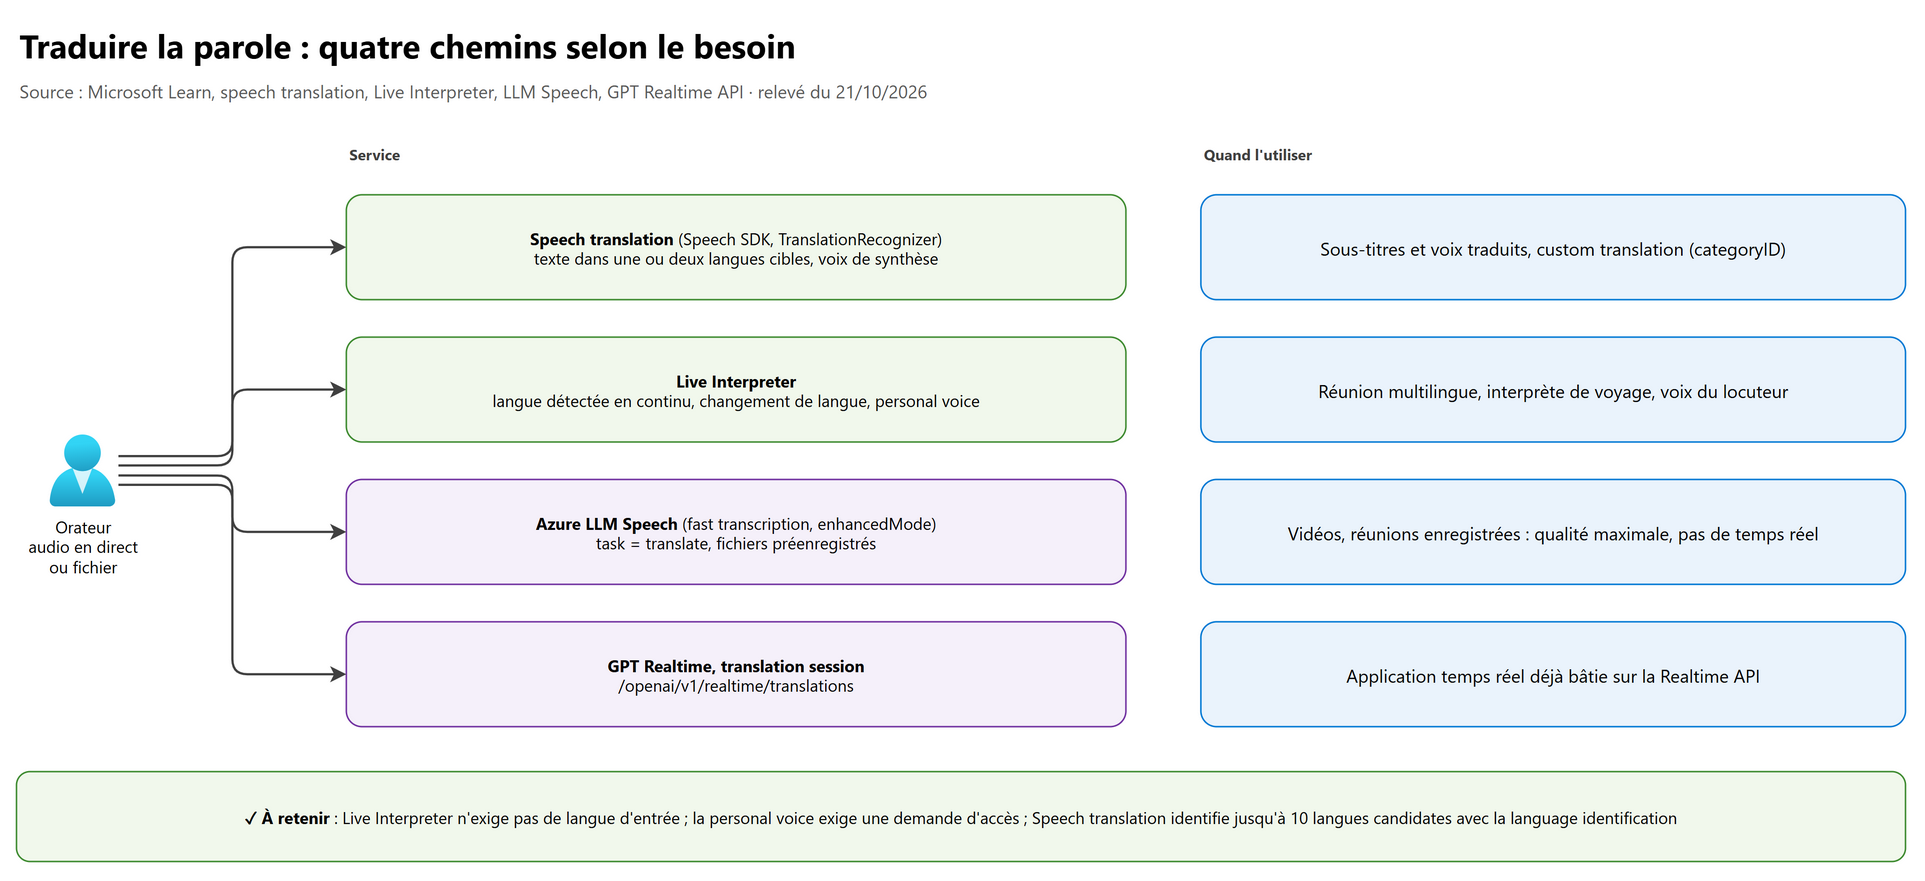
| Chemin | Points clés |
|---|---|
Speech translation (Speech SDK, TranslationRecognizer) |
Parole → texte traduit et parole de synthèse ; deux langues cibles directement dans un appel ; language identification jusqu'à 10 langues candidates ; custom translation (category ID de Custom Translator) avec une resource multiservice |
| Live Interpreter | Langue d'entrée détectée en continu, changement de langue dans la même session, voix naturelle qui garde le style de l'orateur, personal voice possible (accès à demander) |
Azure LLM Speech, task: translate |
Fichiers préenregistrés, une langue cible (targetLanguage) parmi une liste fermée |
| GPT Realtime, translation session | Traduction continue sur /openai/v1/realtime/translations |
| Transcription puis LLM | Traduire et reformuler (registre, résumé) en une étape générative |
import azure.cognitiveservices.speech as speechsdk
from azure.identity import DefaultAzureCredential

cfg = speechsdk.translation.SpeechTranslationConfig(token_credential=DefaultAzureCredential(),
                                                    endpoint="https://{custom-domain}.cognitiveservices.azure.com/")
cfg.speech_recognition_language = "fr-FR"
cfg.add_target_language("en")
cfg.add_target_language("de")                       # deux langues cibles dans le même appel

recognizer = speechsdk.translation.TranslationRecognizer(translation_config=cfg)
result = recognizer.recognize_once_async().get()
print(result.text, result.translations["en"], result.translations["de"])
Au-delà de deux langues cibles, il faut une Foundry resource (multiservice) ou un service de traduction séparé, et chaque
langue au-delà de la deuxième est facturée au caractère (tarif Translator). Piège : la synthèse vocale de la traduction
(voice_name + événement synthesizing) ne fonctionne qu'avec une seule langue cible.
10. Labs conseillés#
Dans un abonnement de test, avec une Foundry resource et un project dédiés. Coût : jetons des modèles, caractères traduits, heures d'audio transcrites ou synthétisées, minutes de Voice Live ; un custom speech model facture aussi l'entraînement et l'endpoint hébergé. Supprimer le groupe de ressources à la fin.
- PII puis JSON
- Dans Foundry, ouvrir le playground PII detection (texte), tester une réclamation contenant e-mail et téléphone.
- Exécuter le code de la section 2.1, puis celui de la section 2.2 sur le texte masqué.
- Attendu :
redacted_textsans données personnelles, JSON toujours conforme au schéma, même avec un texte inhabituel.
- Sentiment : service legacy contre LLM
- Analyser 10 avis clients avec Sentiment analysis (playground) puis avec le schéma de la section 2.2.
- Attendu : accord sur les cas simples, le LLM capte mieux l'ironie et le ton ; noter les écarts dans un tableau.
- Translator : NMT, LLM et tonalité
- Déployer un modèle de type GPT dans la Foundry resource.
- Envoyer la requête de la section 4.2 avec une cible
generalet une cible LLMtone: formal. - Attendu : en-têtes de facturation au caractère pour NMT, au jeton pour le LLM ; formulation plus soutenue avec le LLM.
- Transcription : fast, LLM Speech, phrase list
- Transcrire le même enregistrement avec la fast transcription par défaut, puis avec LLM speech dans le playground Speech to text, en ajoutant des instructions.
- En temps réel, ajouter une phrase list avec des noms propres mal reconnus.
- Attendu : les noms propres sont mieux reconnus ; la sortie LLM speech suit les consignes.
- Agent vocal
- Créer un agent avec l'interaction mode Voice (preview), une voix standard, un greeting.
- Lui parler depuis le portail, l'interrompre en cours de réponse.
- Attendu : la réponse s'arrête à l'interruption ; le traçage montre turn detection, appel du modèle et audio de sortie.
11. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Masquer les données personnelles avant de les envoyer à un LLM | PII detection d'Azure Language (redacted_text) |
Fonction core, déterministe ; le guardrail PII filter agit sur la sortie du modèle |
| Empêcher le modèle de répondre avec des données personnelles | Guardrail PII filter en Annotate and Block | Il analyse la sortie du LLM |
| Extraire des catégories métier fixes à très gros volume | Custom NER | Core, entraîné sur vos annotations, mesurable |
| Un nouveau projet de sentiment analysis ou de summarization | LLM (Foundry Models) de préférence | Fonctions legacy, retrait le 31/03/2029 |
| Garantir une sortie JSON exploitable par le code | Structured outputs (json_schema, strict: true, additionalProperties: false) |
Le JSON mode simple ne garantit pas le schéma |
| Traduire en formel et au féminin | Translator 2026-06-06 avec un déploiement LLM (tone, gender) |
Options réservées au moteur LLM |
| Terminologie maison sans entraîner de modèle | Adaptive custom translation (adaptiveDatasetId ou referenceTextPairs) |
Index construit en minutes, pas de réentraînement |
| Modèle de traduction dédié entraîné sur un gros corpus parallèle | Custom Translator, appelé par category ID | Entraînement et déploiement complets |
| Translator derrière un Private Endpoint, option LLM en échec | LLM non disponible avec un Private Endpoint | Limite documentée |
| Translator en réseau restreint : l'endpoint global échoue | Utiliser l'endpoint personnalisé | Obligatoire avec les VNet |
| Traduire un PDF en gardant la mise en page, un seul fichier, sans stockage | Document translation synchronous | Le mode batch exige des conteneurs Blob |
| Entra ID refusé par le Speech SDK | Activer le custom domain et donner Cognitive Services Speech User | Prérequis d'Entra pour Speech |
| Transcrire 10 000 enregistrements d'appels archivés | Batch transcription | Asynchrone, depuis le stockage |
| Transcrire au plus vite un fichier de 40 minutes | Fast transcription | Synchrone, moins de 2 h et 300 Mo |
| Jargon médical mal reconnu malgré une phrase list | Custom speech model, mesuré par le WER | Adaptation du modèle de base |
| Agent vocal à faible latence sans orchestrer STT, LLM et TTS | Voice Live ou Foundry voice agent | Pipeline géré, interruptions, fin de tour |
| Brancher Voice Live sur un agent Foundry avec une clé API | Impossible : Entra ID obligatoire en mode agent | Clés non prises en charge |
| Application web de voix en temps réel avec la Realtime API | WebRTC | Latence la plus faible côté client |
| Raccorder des appels téléphoniques à la Realtime API | SIP | Intégration téléphonie |
| Une voix de marque unique | Professional voice (Limited Access, consentement du voice talent) | Accès sur formulaire |
| Laisser chaque utilisateur cloner sa propre voix dans l'application | Personal voice (5 à 90 s + consentement, Limited Access) | Cas d'usage restreints |
| Résumer un appel directement depuis le fichier audio | Audio completions (input_audio) ou transcription puis LLM |
Raisonnement multimodal |
| Filtrer le contenu nuisible d'un flux traité par Whisper | Transcrire puis filtrer le texte | Le content filtering ne s'applique pas aux modèles audio comme Whisper |
| Interprète de réunion qui suit les changements de langue | Live Interpreter | Langue détectée en continu |
| Sous-titres traduits en deux langues en un seul appel | Speech translation (deux langues cibles) | Au-delà, plusieurs ressources ou services |
12. Scénarios d'entraînement#
1. Un assureur reçoit 50 000 e-mails de réclamation par jour. Il veut un JSON avec le type de sinistre, le n° de police, un résumé et le sentiment, sans exposer les données personnelles au modèle.
PII detection d'Azure Language sur chaque e-mail, puis un LLM avec structured outputs (schéma strict,
enumpour le sentiment). Le n° de police, catégorie métier stable, peut venir d'un Custom NER. Evaluations sur un échantillon annoté.
2. Une équipe utilise Key phrase extraction et Summarization d'Azure Language. Doit-elle tout réécrire demain ?
Non : ces fonctions legacy restent supportées jusqu'au 31 mars 2029. Planifier la migration vers des Foundry Models : jeu de test, comparaison, bascule. Les nouveaux projets partent directement sur un LLM.
3. Un site de e-commerce traduit ses fiches produits en 12 langues ; le service marketing veut un ton informel en espagnol et la terminologie maison partout.
Translator 2026-06-06 : NMT (
general) pour le volume, cible LLM avectone: informalpour l'espagnol, et adaptive custom translation (adaptiveDatasetId) pour la terminologie. Vérifier que la resource n'est pas derrière un Private Endpoint, sinon l'option LLM est indisponible.
4. Un cabinet juridique veut traduire des contrats Word en gardant la mise en page, un document à la fois, avec son glossaire.
Document translation synchronous avec un fichier de glossaire : pas de stockage Blob, structure préservée.
5. Un centre d'appels veut des transcriptions et une analyse de satisfaction de tous les appels de la veille.
Batch transcription depuis le conteneur d'enregistrements, puis un LLM avec un schéma JSON (sentiment, motif, résolution). Masquer les PII des transcriptions (PII detection en mode conversation).
6. Un hôpital constate que les noms de médicaments sont mal transcrits par la dictée vocale.
Mesurer le WER sur de vrais enregistrements ; ajouter une phrase list ; si insuffisant, entraîner un custom speech model avec le vocabulaire médical et des audios annotés, puis le déployer sur un endpoint personnalisé.
7. Une banque veut un agent vocal de support : faible latence, interruptions naturelles, accès aux outils de son agent texte existant, appels téléphoniques entrants.
Un Foundry voice agent (preview) avec téléphonie intégrée (Teams Phone ou Twilio), l'agent texte existant réutilisé comme subagent dans le même project ; ou, pour une solution GA, Voice Live connecté à l'agent texte (Entra ID obligatoire).
8. Une application mobile de voyage doit traduire en direct une conversation entre deux personnes qui changent de langue.
Live Interpreter : pas de langue d'entrée à fixer, changement de langue géré, voix naturelle ; la personal voice demande un accès sur formulaire.
9. Un éditeur veut que sa mascotte ait une voix unique dans son assistant.
Professional voice (custom voice) : demande d'accès Limited Access, déclaration de consentement du voice talent, 300 à 2 000 phrases enregistrées, déploiement sur un endpoint ; informer les utilisateurs qu'il s'agit d'une voix de synthèse.
10. Un développeur web veut connecter son navigateur à gpt-realtime pour une démo vocale.
WebRTC (latence la plus faible côté client), endpoint GA
/openai/v1; ne pas mettre de clé longue durée dans le code du navigateur.
13. Pour aller plus loin#
- Azure Language agents (preview) : Intent Routing agent et Exact Question Answering agent pour des réponses mot pour mot aux questions critiques, avec supervision humaine.
- Conteneurs : Sentiment analysis, Language detection, Key phrase extraction, Custom NER, Text analytics for health, Summarization et PII existent en conteneurs Docker pour garder les données sur site ; Speech et Translator aussi.
- Text-to-speech avatar : vidéo d'un avatar photoréaliste synchronisée avec la voix, en temps réel ou en lot ; l'avatar personnalisé est en Limited Access.
- Pronunciation assessment : retour sur la précision et la fluidité de prononciation, pour l'apprentissage des langues.
- Video translation et captioning : sous-titres synchronisés, filtres d'injures, résultats partiels.
- Microsoft Translator Pro : application mobile de traduction parole à parole, avec des langues utilisables hors ligne.
14. Fiche à retenir#
- Foundry Tool pour le normé (PII, NER, langue, traduction de masse, transcription) ; LLM pour comprendre et reformuler ; souvent les deux.
- Azure Language core : PII, Language detection, Prebuilt NER, Custom NER, Text analytics for health.
- Legacy, retrait 31/03/2029 : Sentiment/opinion mining, Key phrases, Summarization, Entity linking, CQA, CLU, Custom text classification.
- Structured outputs :
text.formatjson_schema,strict: true,additionalProperties: false; la forme, pas la vérité. - PII : PII detection (entrée,
redacted_text) vs guardrail PII filter (sortie, Annotate / Annotate and Block). - Translator 2026-06-06 :
deploymentName=general(NMT, au caractère),{categoryID}(Custom Translator), LLM (au jeton,tone,gender, adaptive). - LLM dans Translator : Foundry resource requise, pas avec un Private Endpoint, 50 éléments de 5 000 caractères.
- Document translation : sync (un fichier + glossaire, sans Blob) ou async (Blob source et cible).
- STT : real-time (flux), fast (synchrone, < 2 h et 300 Mo), batch (asynchrone, stockage), LLM Speech (enhanced, prompt, translate).
- Custom speech : WER, endpoint personnalisé ; d'abord une phrase list.
- Speech + Entra : custom domain et Cognitive Services Speech User ;
SpeechConfig(token_credential=…, endpoint=…). - Voice Live : STT + modèle + TTS gérés, bruit, écho, fin de tour ; mode agent = Entra ID ; niveaux Pro, Standard, Lite selon le modèle.
- Foundry voice agent (preview) :
kind: voice, managed ou self_deployed, téléphonie,storefalse par défaut. - Realtime API : WebRTC (client), WebSocket (serveur), SIP (téléphonie) ; endpoint
/openai/v1. - Custom voice : Limited Access, consentement ; professional (300 à 2 000 phrases), personal (5 à 90 s), lite (démo).
- Audio en entrée :
input_audio(audio completions) ; pas de content filtering sur les modèles audio comme Whisper. - Traduction de la parole : Speech translation (2 cibles, 10 langues candidates), Live Interpreter, LLM Speech translate, Realtime translation session.
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Guide d'étude de l'examen AI-103 (en anglais)
- What is Azure Language in Foundry Tools?
- Microsoft Foundry SDKs and endpoints (Foundry Tools SDKs, retraits du 31/03/2029)
- What is custom text classification?
- What are sentiment analysis and opinion mining?
- What is summarization?
- What is PII detection in Azure Language?
- Quickstart: Detect personally identifiable information (PII)
- Azure Text Analytics client library for Python
- Personally identifiable information (PII) filter
- How to configure guardrails and controls in Microsoft Foundry
- Migrate from Azure OpenAI to the Responses API (structured outputs)
- What is Azure Translator in Foundry Tools?
- What is Azure text translation in Microsoft Foundry?
- Text translation REST API 2026-06-06
- Translate (2026-06-06)
- Azure Translator adaptive custom translation
- Translator authentication and authorization
- What's new in Azure Translator?
- What is Azure Speech?
- What is speech to text?
- Use the fast transcription API
- Create a batch transcription
- Azure LLM Speech for transcription and translation
- What is custom speech?
- Improve recognition accuracy with phrase list
- Microsoft Entra authentication with the Speech SDK
- How to synthesize speech from text (SSML)
- Voice Live API for real-time voice agents
- Quickstart: Voice Live with Foundry Agent Service
- How to use the Voice Live API
- Migrate from Voice Live with Foundry Agent Service to Microsoft Foundry voice agents
- Use the GPT Realtime API for speech and audio
- Use the GPT Realtime API via WebRTC
- Use the GPT Realtime API via SIP
- Audio capabilities in Azure OpenAI
- Quickstart: Get started with Azure OpenAI audio generation
- What is custom voice?
- Custom voice lite
- What is personal voice for text to speech?
- Limited Access to custom neural voice
- What is speech translation? (Live Interpreter)
- How to recognize and translate speech