
Version : 1.1 · Date : 2026-10-22 · Domaine 2 de l'examen : Develop multi-agent solutions in Azure (30 à 35 %)
En une phrase : orchestrer, c'est choisir une topologie (hub-and-spoke, peer-to-peer, sequential, parallel), placer les humains aux bons points de décision, réutiliser ce qui a déjà été calculé (prompt, semantic et response caching), borner ce que les agents ont le droit de lancer, brancher les agents existants par A2A ou MCP, et factoriser logging, autorisation et gestion des erreurs dans du middleware ; Microsoft Agent Framework fournit tout cela, LangGraph et Hugging Face Transformers s'y ajoutent.
Ce que l'examen demande#
Bloc Implement multi-agent orchestration, repris mot pour mot du guide d'étude AI-500 (examen en bêta, guide vérifié inchangé le 22/10/2026) :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| 1 | Implement multi-agent orchestration patterns, including hub-and-spoke, sequential, parallel, peer-to-peer, and orchestrator-subagent | 1 |
| 2 | Implement human-in-the-loop processes, including approval workflows, overrides, and edge case handling | 2 |
| 3 | Design and implement a caching strategy, including prompt caching, semantic caching, and response caching | 3 |
| 4 | Implement scaling and control of multi-agent spawning, batching, and concurrent execution | 4 |
| 5 | Integrate existing agents into a multi-agent solution securely by using Agent2Agent (A2A) and/or MCP | 5 |
| 6 | Implement multi-agent orchestration frameworks, including Agent Framework, LangChain, and LangGraph | 6 |
| 7 | Implement advanced multi-agent capabilities by using Hugging Face Transformers | 7 |
| 8 | Design middleware for reusable capabilities across the solution, including logging, authorization, and exception handling | 8 |
Déjà vu ailleurs, à relire plutôt qu'à répéter ici :
- les cinq orchestrations d'Agent Framework (sequential, concurrent, handoff, group chat, magentic), le schéma de décision et
l'exemple
SequentialBuilder: AI-103, chapitre 06, section 5.2 ; les trois façons de faire travailler des agents ensemble (A2A tool, workflows, Agent Framework) : section 5.1 ; - l'approbation MCP (
require_approval,McpApprovalResponse),approval_mode, request info et checkpoints au niveau AI-103 : sections 6.1 à 6.3 ; le MCP tool : section 4.3 ; l'A2A tool : section 4.4 ; - le prompt caching (préfixe d'au moins 1 024 jetons,
cached_tokens, rétention) : AI-103, chapitre 07, section 2.5 ; les workflows Agent Framework (executors,WorkflowBuilder, types d'edges) : section 5.5 ; le routage de modèles : sections 5.2 et 5.3 ; - la logique coordinator-subagent, le passage de contexte, l'enforcement par hooks et la décomposition : Claude Architecte, chapitre 01 (sections 2 à 6).
Dans ce cours : architecture logique et choix des protocoles au chapitre 01, persistance d'état et Zero Trust par agent au chapitre 02, contexte et mémoire au chapitre 03, serveurs MCP et fallbacks d'outils au chapitre 04, coûts, limites de jetons et tracing au chapitre 06, identité, OBO, Key Vault et guardrails au chapitre 07.
1. Les motifs d'orchestration#
1.1 Le bon niveau de complexité#
Le Centre des architectures Azure pose une règle avant tout motif : prendre le niveau le plus simple qui répond de façon fiable. Chaque niveau ajoute de la coordination, de la latence et du coût.
| Niveau | Principe | À utiliser quand | Attention |
|---|---|---|---|
| Direct model call | Un appel de modèle avec un bon prompt, sans agent ni outil | Classer, résumer, traduire en une passe | Si le prompt suffit, pas besoin d'agent |
| Single agent with tools | Un agent qui raisonne et choisit parmi ses outils, en boucle | Requêtes variées d'un même domaine (statut de commande, requête en base) | Souvent le bon défaut en entreprise ; poser une limite d'itérations |
| Multiagent orchestration | Plusieurs agents spécialisés coordonnés par un orchestrateur ou un protocole entre pairs | Problème transverse, frontières de sécurité distinctes par agent, spécialisation parallèle | Justifié seulement si un agent seul échoue (prompt trop complexe, trop d'outils, exigences de sécurité) |
Arguments recevables pour passer en multi-agents : la sélection d'outils se dégrade quand un agent en a trop, un prompt qui couvre trois métiers perd en précision, deux agents n'ont pas le droit d'accéder aux mêmes données, ou une partie du travail doit tourner en parallèle. « C'est plus moderne » n'en est pas un.
1.2 Le vocabulaire de l'examen et Agent Framework#
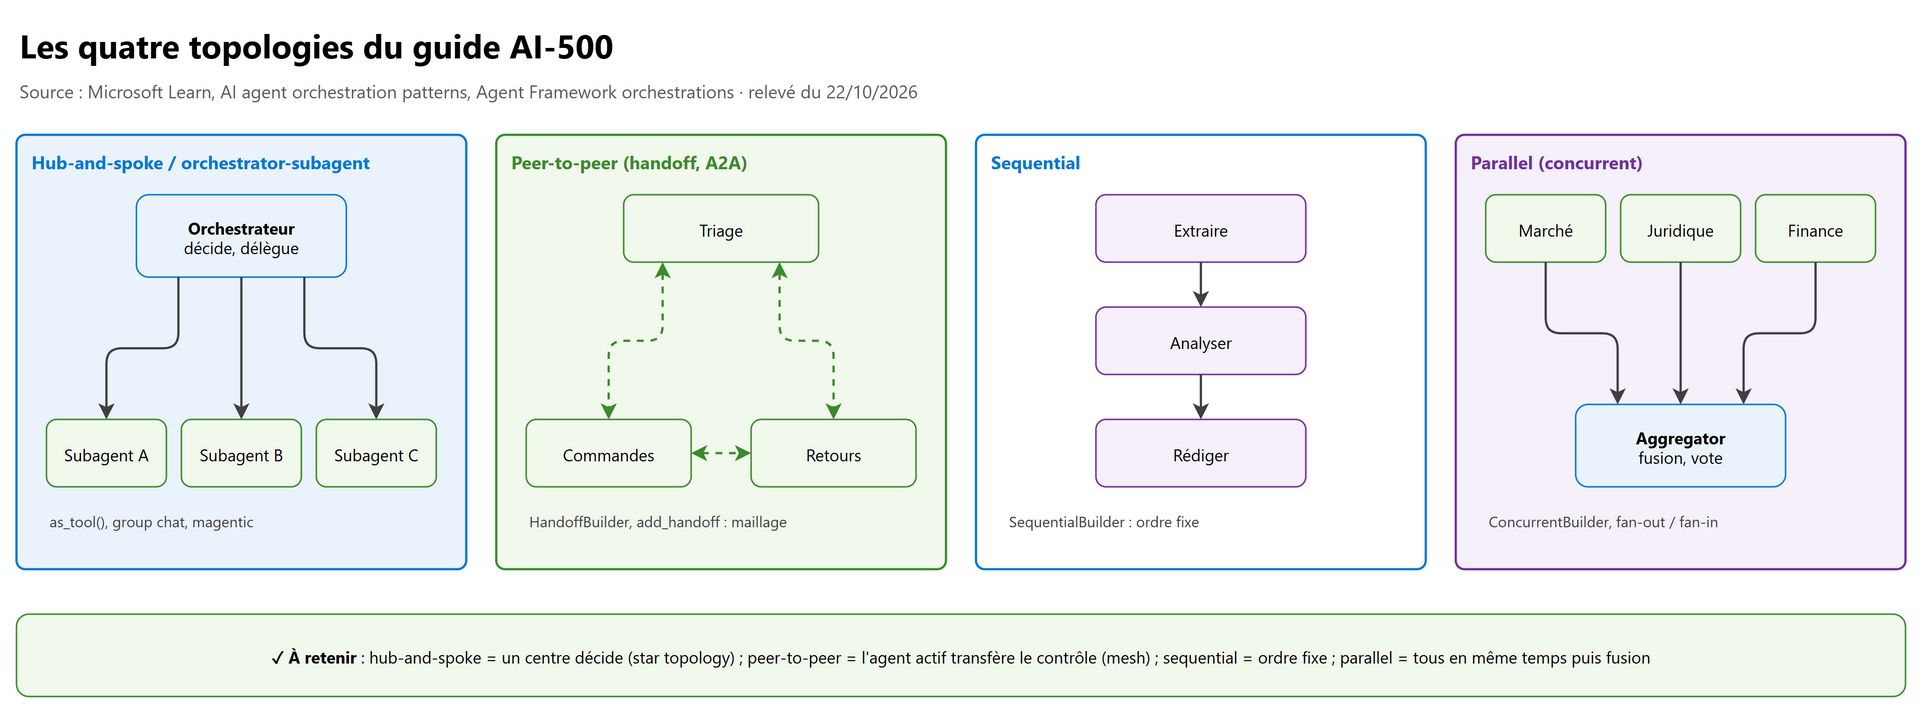
Le guide parle de topologies (hub-and-spoke, peer-to-peer, orchestrator-subagent, sequential, parallel). Agent Framework parle d'orchestrations intégrées. La correspondance est donnée par la documentation elle-même : le group chat et le magentic « assemblent les agents en star topology avec un orchestrateur au milieu », le handoff est « une mesh topology où les agents sont reliés directement, sans orchestrateur ».
| Vocabulaire de l'examen | Ce qui le réalise dans Agent Framework (Python) | Qui décide de la suite |
|---|---|---|
| Hub-and-spoke | GroupChatBuilder (orchestrateur au centre), MagenticBuilder (manager qui planifie), ou un graphe WorkflowBuilder dont un executor central route |
Le hub |
| Orchestrator-subagent | Agents utilisés comme outils (agent.as_tool()) par un agent principal ; ou MagenticBuilder |
Le modèle de l'orchestrateur, par function calling |
| Sequential | SequentialBuilder(participants=[...]) |
L'ordre fixé dans le code |
| Parallel | ConcurrentBuilder(participants=[...]), ou add_fan_out_edges / add_fan_in_edges dans un graphe |
Personne : tout le monde travaille, un aggregator fusionne |
| Peer-to-peer | HandoffBuilder (maillage, transfert du contrôle par un handoff tool) ; entre organisations, agents pairs reliés par A2A |
L'agent actif |
Hub-and-spoke et orchestrator-subagent se ressemblent : dans les deux cas un centre délègue. La nuance utile à l'examen : dans orchestrator-subagent, les subagents sont des outils de l'orchestrateur, ils ne voient que la sous-tâche qu'on leur passe et rendent un résultat ; dans un hub-and-spoke de type group chat, tous les participants voient l'historique complet et le hub choisit qui parle.
1.3 Hub-and-spoke et orchestrator-subagent#
Orchestrator-subagent, agents comme outils. La documentation Agent Framework recommande ce motif quand l'agent principal doit décider quand et s'il délègue, qu'on n'a pas besoin de contrôler l'ordre d'exécution, et que chaque sous-agent a un périmètre étroit (ses instructions, ses outils, éventuellement un modèle plus petit). Le Centre des architectures le conseille quand deux ou trois agents suffisent et que leurs responsabilités ne se chevauchent pas.
import os
from agent_framework import Agent
from agent_framework.foundry import FoundryChatClient
from azure.identity import AzureCliCredential

# Un seul client partagé par tous les agents (la doc déconseille un client par agent)
client = FoundryChatClient(project_endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"],
                           model=os.environ["FOUNDRY_MODEL"], credential=AzureCliCredential())

recherche = Agent(client=client, name="recherche", instructions="Trouve les faits et cite tes sources.")
juridique = Agent(client=client, name="juridique", instructions="Analyse les risques contractuels.")

orchestrateur = Agent(
    client=client, name="orchestrateur",
    instructions="Décompose la demande, délègue aux spécialistes, puis rédige la synthèse.",
    tools=[recherche.as_tool(), juridique.as_tool()],   # chaque subagent devient un function tool
)
reponse = await orchestrateur.run("Peut-on résilier le contrat X avant terme ?")
Hub-and-spoke piloté par le hub. Le group chat est le hub-and-spoke « conversationnel » : l'orchestrateur choisit le prochain intervenant (round-robin, sélection par prompt ou logique maison) et, après chaque tour, diffuse la réponse à tous les autres pour synchroniser leurs sessions (les agents n'ont pas la même instance de session, chacun la sienne, tenue à jour).
from agent_framework.orchestrations import GroupChatBuilder, GroupChatState

def round_robin(state: GroupChatState) -> str:
    noms = list(state.participants.keys())
    return noms[state.current_round % len(noms)]

workflow = GroupChatBuilder(
    participants=[redacteur, verificateur],
    termination_condition=lambda conversation: len(conversation) >= 6,   # toujours une fin explicite
    selection_func=round_robin,
).build()
Le magentic est un hub-and-spoke avec un manager qui planifie (task ledger, progress ledger) : même architecture que le group chat, manager beaucoup plus puissant. La doc prévient que ses performances ne sont pas testées en dehors du design original de Magentic-One : à évaluer sur vos tâches avant la production.
from agent_framework.orchestrations import MagenticBuilder

workflow = MagenticBuilder(
    participants=[researcher_agent, coder_agent],
    manager_agent=manager_agent,
    max_round_count=10,   # tours de coordination au maximum
    max_stall_count=3,    # tours sans progrès avant de replanifier
    max_reset_count=2,    # replanifications complètes au maximum
).build()
1.4 Peer-to-peer : handoff et agents pairs#
Dans le handoff, il n'y a pas de chef : l'agent actif répond lui-même ou transfère tout le contrôle à un pair en appelant un
handoff tool (Agent Framework injecte ces outils automatiquement). Par défaut tous les agents peuvent se transférer la main ; on
restreint les routes avec add_handoff. Les agents restent reliés en maillage même avec des règles, car ils doivent partager
l'historique ; les règles disent seulement qui peut prendre la suite.
from agent_framework.orchestrations import HandoffBuilder

workflow = (
    HandoffBuilder(name="support", participants=[triage, commandes, retours, remboursements],
                   termination_condition=lambda conv: len(conv) > 0 and conv[-1].text.strip().endswith("Dossier clos."))
    .with_start_agent(triage)
    .add_handoff(triage, [commandes, retours])        # le triage ne rembourse pas directement
    .add_handoff(retours, [remboursements])           # remboursement seulement après un retour
    .add_handoff(commandes, [triage])
    .add_handoff(remboursements, [triage])
    .build()
)
Points d'expert sur le handoff :
- Il est interactif par nature : si l'agent actif ne transfère pas, le workflow émet un événement
request_info(chargeHandoffAgentUserRequest) et attend l'utilisateur. Le mode autonome (with_autonomous_mode, fonctionnalité expérimentale) renvoie une réponse par défaut à la place, avec une limite de 50 tours autonomes par agent par défaut (turn_limits,0= rendre la main tout de suite). enable_return_to_previous(False)fait repasser chaque réponse de l'utilisateur par l'agent de départ au lieu de l'agent qui a posé la question.- Le
HandoffAgentExecutorfiltre les appels et résultats de handoff tools de l'historique transmis, pour ne pas embrouiller le modèle suivant. - Seuls les
Agentcapables d'exécuter des outils locaux peuvent participer.
Peer-to-peer entre équipes ou organisations : chaque agent reste chez son propriétaire, publie une agent card et échange par A2A (section 5). C'est le motif quand les agents sont construits avec des frameworks différents ou derrière des frontières de sécurité distinctes.
| Hub-and-spoke / orchestrator-subagent | Peer-to-peer (handoff, A2A) | |
|---|---|---|
| Contrôle | Centralisé, prévisible, facile à auditer | Distribué, chaque agent décide |
| Contexte | Le hub filtre ce que voit chaque subagent | Historique partagé (handoff) ou contrat de messages (A2A) |
| Risque principal | Le hub devient un goulot et un point de défaillance unique | Boucles de handoff, chemins imprévisibles |
| Garde-fous | Limites d'itérations du hub, budget | termination_condition, turn_limits, règles add_handoff |
| Monte en charge | Le hub sature quand le nombre de spokes grandit | Ajouter un pair ne touche pas les autres |
1.5 Sequential, parallel et group chat#
- Sequential : pipeline à étapes dépendantes ; une erreur d'une étape se propage aux suivantes, pas de parallélisme (exemple dans AI-103).
- Parallel (concurrent) : tous les participants reçoivent la même entrée, un aggregator fusionne. Par défaut, l'aggregator
garde le dernier message de chaque participant ; un aggregator personnalisé (
with_aggregator) résume, vote ou résout les contradictions. Gourmand en quota : c'est le motif qui crée les pics de jetons.
from agent_framework.orchestrations import ConcurrentBuilder

workflow = (
    ConcurrentBuilder(participants=[analyste_marche, analyste_juridique, analyste_finance],
                      intermediate_output_from=[analyste_marche, analyste_juridique, analyste_finance])
    .with_aggregator(synthetiser)   # votre fonction de fusion
    .build()
)
async for event in workflow.run("Lancement d'un vélo électrique d'entrée de gamme", stream=True):
    if event.type == "output":
        print(event.data)
- Group chat et maker-checker : le maker propose, le checker évalue selon des critères explicites et renvoie un retour ; la boucle s'arrête à l'acceptation ou au plafond d'itérations, avec un comportement de repli défini (escalade humaine ou meilleur résultat accompagné d'un avertissement). Le Centre des architectures conseille trois agents au plus dans un group chat, et de l'éviter si le manager n'a aucun moyen objectif de savoir que la tâche est finie.
1.6 Choisir, combiner, éviter les antipatterns#
flowchart TD
    A["Un seul agent avec tools suffit-il ?"] -- Oui --> S["Single agent"]
    A -- Non --> B{"Ordre des étapes connu ?"}
    B -- "Oui, fixe" --> SEQ["Sequential"]
    B -- Non --> C{"Sous-tâches indépendantes<br/>sur la même entrée ?"}
    C -- Oui --> PAR["Parallel (concurrent)"]
    C -- Non --> D{"Un centre doit-il garder<br/>le contrôle et l'audit ?"}
    D -- "Oui, délégation simple" --> OS["Orchestrator-subagent<br/>(agents as tools)"]
    D -- "Oui, plan à construire" --> MAG["Magentic"]
    D -- "Oui, débat ou revue" --> GC["Group chat / maker-checker"]
    D -- "Non, le spécialiste émerge en route" --> HO["Peer-to-peer : handoff"]
    HO --> X{"Agents d'autres équipes<br/>ou frameworks ?"}
    X -- Oui --> A2A["Pairs reliés par A2A"]
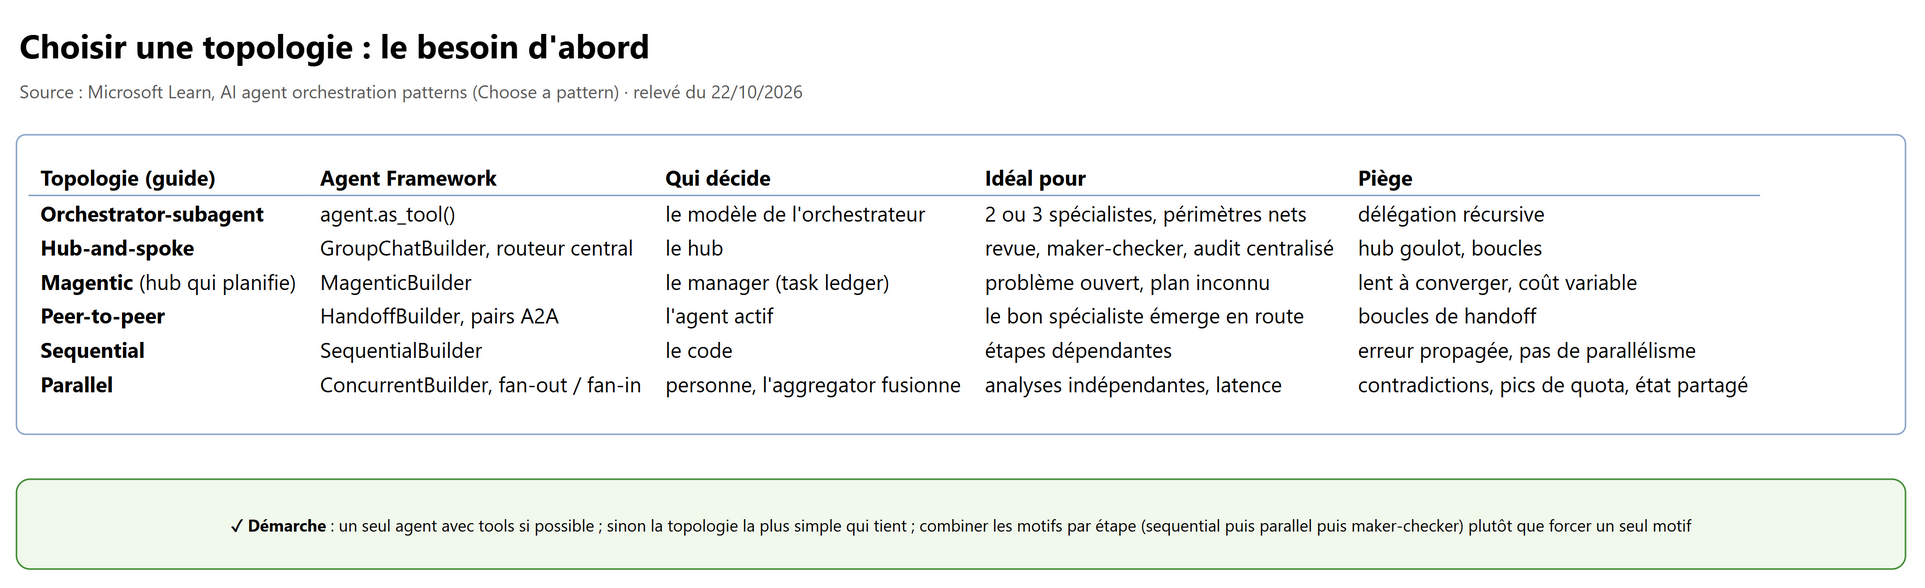
Combiner est normal : sequential pour la préparation des données, puis concurrent pour l'analyse, puis maker-checker pour la
validation. Un workflow Agent Framework peut imbriquer un autre workflow comme executor (sub-workflow) ou être exposé comme
agent (.as_agent()) pour devenir le subagent d'un orchestrateur.
Antipatterns cités par Microsoft : coordination complexe là où sequential ou concurrent suffit ; agents sans vraie spécialisation ; latence des sauts multiples ignorée ; état mutable partagé entre agents concurrents (données incohérentes) ; motif déterministe pour un processus qui ne l'est pas, et l'inverse ; concurrent sans regarder les quotas ; contexte qui gonfle d'agent en agent sans compaction (résumer ou élaguer entre agents, voir chapitre 03).
2. Human-in-the-loop#
2.1 Trois besoins : approval, override, edge case#
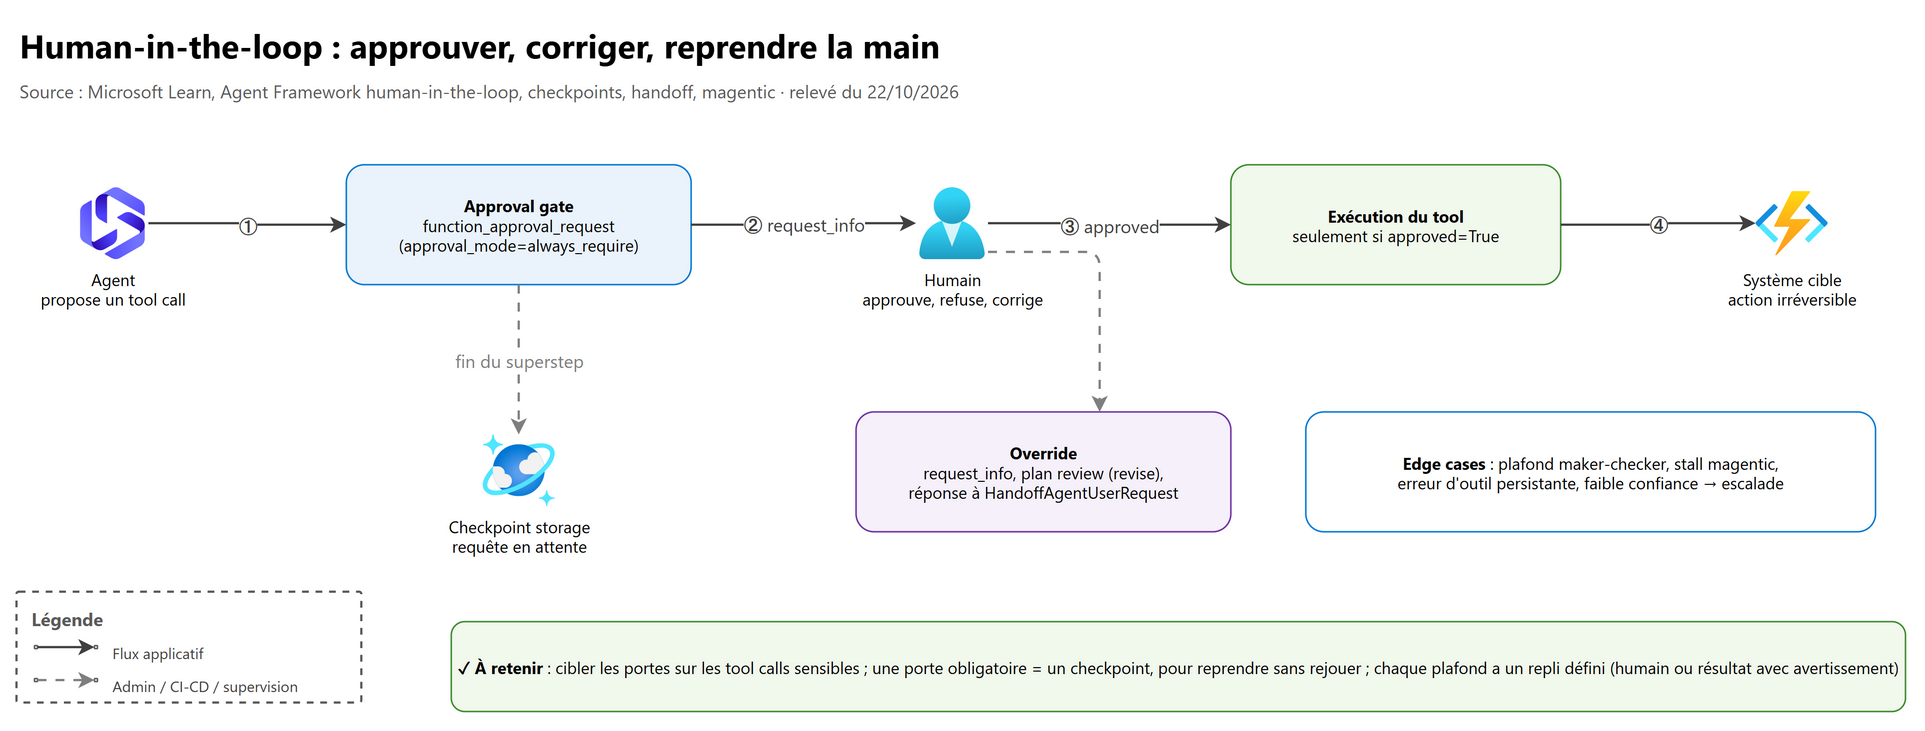
| Besoin (guide) | Ce que fait l'humain | Mécanisme Agent Framework | Effet sur le workflow |
|---|---|---|---|
| Approval workflow | Accepte ou refuse une action précise avant exécution | @tool(approval_mode="always_require") → contenu function_approval_request ; MCP require_approval |
L'outil ne s'exécute qu'après approved=True |
| Override | Corrige le plan, la réponse ou la route choisie par l'agent | ctx.request_info() + @response_handler ; plan review magentic (revise) ; réponse à HandoffAgentUserRequest |
Le retour revient dans la boucle de l'agent |
| Edge case handling | Reprend la main quand l'automatisation ne sait pas faire | Plafond atteint, stall, faible confiance, erreur d'outil → requête vers un humain | Escalade, avec l'état conservé |
Le Centre des architectures donne la règle de conception : identifier les points où un humain intervient, décider si son avis est optionnel ou obligatoire, et s'il s'agit d'une approbation qui fait avancer ou d'un retour qui fait reboucler. Une porte obligatoire rend le workflow synchrone à cet endroit : persister l'état à ce point pour reprendre sans rejouer le travail déjà fait. Et cibler les portes sur les tool calls sensibles plutôt que sur toute la sortie d'un agent, pour garder l'autonomie sur le reste.
2.2 Approval workflows : approuver un tool call#
from typing import Annotated
from agent_framework import tool

@tool(approval_mode="always_require")      # jamais exécuté sans accord humain
def emettre_remboursement(numero_commande: Annotated[str, "Commande à rembourser"]) -> str:
    """Rembourse une commande (action irréversible)."""
    return f"Remboursement émis pour {numero_commande}."
Quand l'agent appelle cet outil, le workflow émet un événement request_info dont la donnée est un Content de type
"function_approval_request" ; on répond avec to_function_approval_response(approved=True) (ou False). Si plusieurs outils
d'un même lot attendent une décision, aucun ne s'exécute et le modèle ne reprend pas tant que chaque approbation du lot n'a
pas reçu sa réponse ; les outils approuvés s'exécutent ensuite dans l'ordre demandé par le modèle. Côté Foundry, le MCP tool et
l'A2A tool portent leur propre approbation (AI-103, 6.2).
2.3 Overrides : request info, plan review, retour à l'humain#
Tout executor peut sortir du workflow pour demander une information : ctx.request_info() émet la requête, une méthode décorée
@response_handler reçoit la réponse (le framework fait correspondre les types de la requête et de la réponse). Pendant
l'attente, le workflow est dans l'état IDLE_WITH_PENDING_REQUESTS.
L'override le plus utile en multi-agents est la revue du plan magentic : l'humain voit le plan proposé (et le progress ledger s'il s'agit d'une replanification) avant toute exécution, puis l'approuve ou le réécrit.
from agent_framework.orchestrations import MagenticBuilder, MagenticPlanReviewRequest

workflow = MagenticBuilder(participants=[researcher_agent, coder_agent], manager_agent=manager_agent,
                           enable_plan_review=True, max_round_count=10, max_stall_count=1, max_reset_count=2).build()

# Dans la boucle d'événements :
#   event.type == "request_info" and event.request_type is MagenticPlanReviewRequest
#   demande = event.data
#   reponses = {event.request_id: demande.approve()}              # plan accepté tel quel
#   reponses = {event.request_id: demande.revise("Commence par ...")}  # override humain
#   puis : workflow.run(stream=True, responses=reponses)
Dans un handoff, l'humain peut aussi corriger la route : il répond à la HandoffAgentUserRequest par un texte, que l'agent
traite au tour suivant (ou l'agent de départ, si enable_return_to_previous(False)).
2.4 Checkpoints : une pause qui survit au redémarrage#
Un workflow s'exécute en supersteps ; un checkpoint est écrit à la fin de chaque superstep et contient l'état de chaque executor, les messages en attente pour le superstep suivant, les requêtes et réponses en attente et l'état partagé. Depuis la version Python 1.13.0, un checkpoint d'entrée enregistre aussi l'entrée du workflow et un autre les réponses livrées : un run complet devient rejouable.
from agent_framework import FileCheckpointStorage
from agent_framework.orchestrations import HandoffBuilder

stockage = FileCheckpointStorage(storage_path="./checkpoints")   # pas de dossier par défaut, chemin obligatoire

workflow = (HandoffBuilder(name="support_durable", participants=[triage, remboursements], checkpoint_storage=stockage)
            .with_start_agent(triage).build())

# Le processus peut s'arrêter pendant l'attente d'une approbation. Plus tard :
points = await stockage.list_checkpoints(workflow_name="support_durable")
dernier = sorted(points, key=lambda c: c.timestamp, reverse=True)[0]
async for event in workflow.run(checkpoint_id=dernier.checkpoint_id, stream=True):
    ...   # les requêtes en attente sont réémises : on les collecte, puis workflow.run(responses=..., stream=True)
sequenceDiagram
    participant U as Approbateur
    participant W as Workflow (Agent Framework)
    participant C as Checkpoint storage
    W->>W: superstep n : l'agent demande emettre_remboursement
    W->>C: checkpoint (état + requête en attente)
    W-->>U: request_info (function_approval_request)
    Note over W: le processus peut s'arrêter (heures, jours)
    U->>W: run(checkpoint_id=...)
    W-->>U: requête réémise
    U->>W: run(responses={id: approved=True})
    W->>W: exécution de l'outil, superstep n+1
Sécurité des checkpoints (point fort de la doc) : le stockage des checkpoints est une frontière de confiance. Ne jamais
charger un checkpoint venu d'une source non fiable ou altérable ; restreindre l'accès au dossier (FileCheckpointStorage) ou au
conteneur (CosmosCheckpointStorage, avec managed identity et RBAC de préférence aux clés). Une reprise doit garder la même
topologie et les mêmes identités d'executors que le workflow qui a écrit le checkpoint.
2.5 Edge cases : quand l'automatisation doit rendre la main#
| Cas limite | Signal | Réponse conçue |
|---|---|---|
| Boucle maker-checker sans accord | Plafond d'itérations atteint | Escalade humaine ou meilleur résultat + avertissement de qualité |
| Magentic qui tourne en rond | max_stall_count dépassé, puis max_reset_count |
Replanification, puis plan review humaine |
| Agent de handoff qui ne transfère pas | request_info avec HandoffAgentUserRequest |
L'humain répond, ou mode autonome borné par turn_limits |
| Outil en échec, réponse invalide | Exception dans le function middleware | Repli (section 8.4), puis escalade si l'erreur persiste |
| Approbation jamais donnée | Requête en attente trop longue | Expiration côté application, checkpoint conservé, notification |
| Demande hors périmètre ou ambiguë | Classification à faible confiance | Question de clarification avant d'engager des agents coûteux |
Le même motif existe dans LangGraph : un nœud d'approbation interrompt le graphe (Interrupt), le checkpointer conserve
l'état par thread_id, et on reprend avec Command(resume={"approve": True}) (section 6.2).
3. Stratégie de caching#
3.1 Trois caches, trois niveaux#
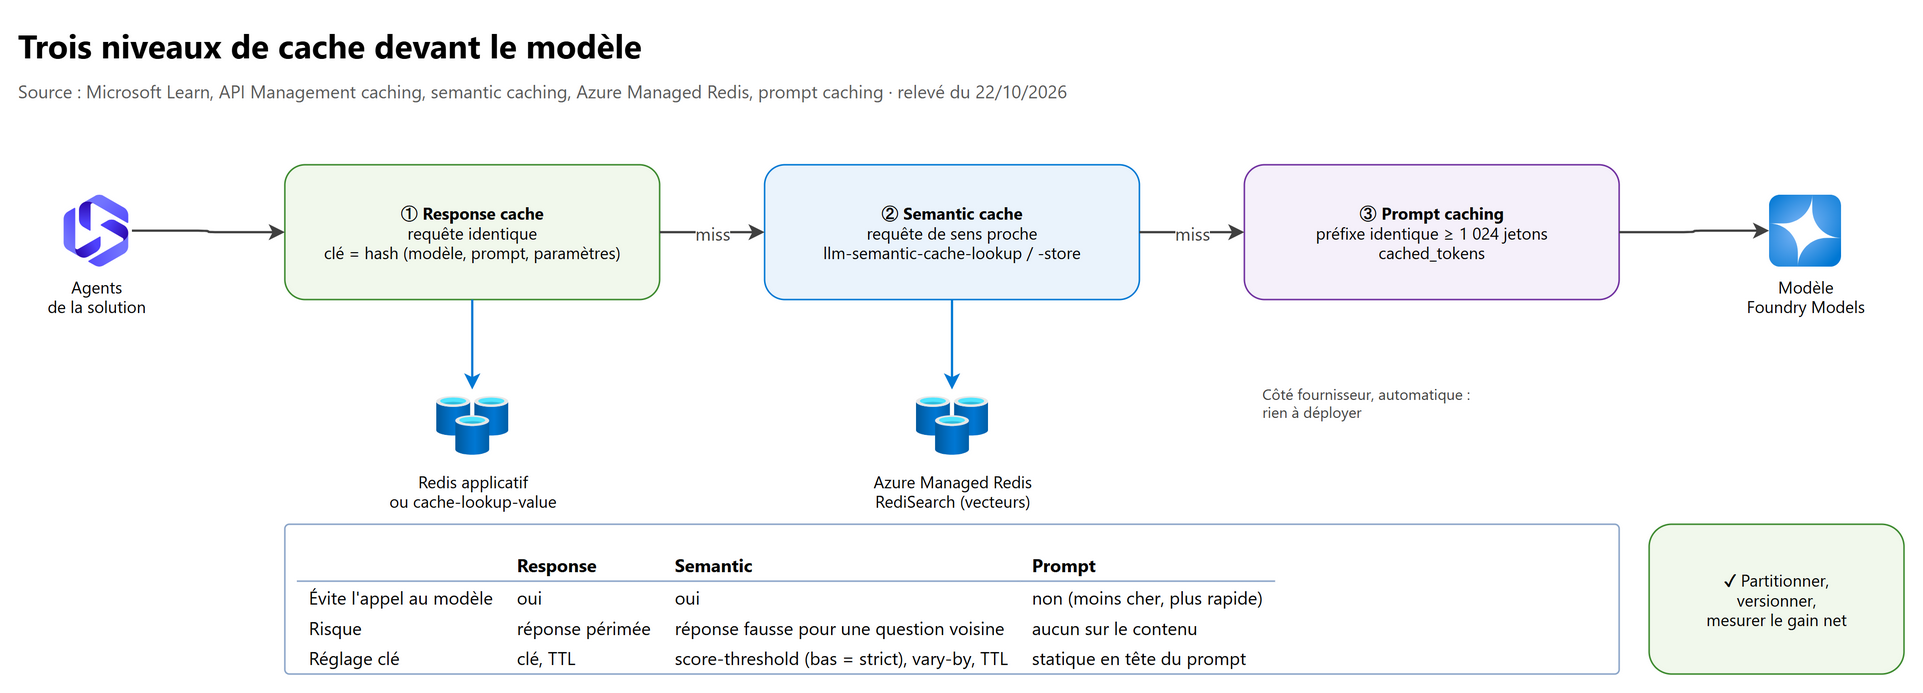
| Response caching | Semantic caching | Prompt caching | |
|---|---|---|---|
| Ce qui est réutilisé | La réponse complète d'une requête identique | La réponse d'une requête de sens proche | Le calcul du préfixe du prompt, côté modèle |
| Où | Application (clé = hash de la requête) ou API Management | API Management (llm-semantic-cache-*) ou application (RedisVL) |
Fournisseur du modèle, automatique |
| Stockage | Redis, cache interne d'API Management | Azure Managed Redis (recherche vectorielle RediSearch) | Aucun à gérer |
| Appel au modèle évité | Oui | Oui | Non : appel moins cher et plus rapide |
| Risque | Réponse périmée | Réponse fausse pour une question voisine mais différente | Aucun sur le contenu |
| Réglage clé | Clé, TTL | score-threshold, partition vary-by, TTL |
Ordre du prompt : partie stable d'abord |
Prompt caching (rappel, détail dans AI-103 07, 2.5) : activé par
défaut sur les modèles compatibles, à partir de 1 024 jetons avec un début identique, visible dans cached_tokens. Conséquence de
conception en multi-agents : mettre en tête de chaque prompt ce qui ne change pas (instructions de l'agent, définitions d'outils,
documents de référence) et en fin ce qui varie (question, état du tour). Des agents qui partagent le même long préambule en
profitent aussi.
3.2 Semantic caching dans API Management#
Quand tout le trafic LLM des agents passe par la passerelle IA d'API Management, le semantic caching est une politique centrale : un seul réglage pour tous les agents. Il faut un backend d'embeddings et un cache externe (Azure Managed Redis).
<inbound>
    <base />
    <llm-semantic-cache-lookup
        score-threshold="0.05"
        embeddings-backend-id="embeddings-backend"
        embeddings-backend-auth="system-assigned"
        ignore-system-messages="true"
        max-message-count="10">
        <vary-by>@(context.Subscription.Id)</vary-by>
    </llm-semantic-cache-lookup>
    <rate-limit calls="10" renewal-period="60" />
</inbound>
<outbound>
    <llm-semantic-cache-store duration="60" />
    <base />
</outbound>
| Attribut | Rôle | À retenir |
|---|---|---|
score-threshold |
Proximité exigée, de 0.0 à 1.0 | Plus bas = plus strict ; commencer vers 0.05 ; au-delà de 0.2, risque de réponses non pertinentes |
embeddings-backend-id |
Backend qui calcule les embeddings | Obligatoire ; l'accès lié n'est pas vérifié : qui écrit la politique peut viser n'importe quel backend |
embeddings-backend-auth |
Authentification vers ce backend | Obligatoire, valeur system-assigned (managed identity d'API Management) |
ignore-system-messages |
Retire les messages système du calcul de similarité | true recommandé |
max-message-count |
Nombre de messages restants au-delà duquel on ne cache plus | Évite de cacher des conversations longues |
vary-by |
Partition du cache | Par abonnement, locataire, groupe d'utilisateurs : empêche une fuite entre utilisateurs |
duration (store) |
TTL en secondes | Court pour le volatil, long pour une FAQ |
Recommandations de la doc : un rate-limit (ou rate-limit-by-key) juste après la recherche, pour protéger le backend si le
cache est indisponible ; une politique llm-content-safety avec prompt shield contre les attaques par prompt ; un modèle
d'embeddings avec assez de capacité et de contexte. Le cache sémantique peut renvoyer une réponse incorrecte, périmée ou
inadaptée : prévoir des garde-fous. Politiques disponibles sur les gateways classic, v2, consumption et self-hosted, pas sur les
workspace gateways ; API compatibles : OpenAI Chat Completions ou Responses, Anthropic Messages (v2), Google Vertex AI.
Liaison API Management vers Azure Managed Redis : par chaîne de connexion stockée en named value secrète (l'authentification Microsoft Entra n'est pas prise en charge pour ce lien aujourd'hui, et l'external cache n'est pas disponible dans les workspaces). Seule exception au « sans clé » : la clé reste dans API Management, jamais dans le code.
3.3 Semantic caching applicatif et response caching#
Semantic cache dans l'application (RedisVL SemanticCache sur Azure Managed Redis) : à choisir quand on possède le code et
qu'on veut ses propres seuils, partitions, métadonnées ou une logique par agent (par exemple cacher le résultat d'un subagent de
recherche et pas celui d'un agent qui agit). Attention : le distance_threshold de RedisVL est une distance cosinus de 0 à 2,
le score-threshold d'API Management une valeur de 0 à 1 ; ne pas recopier une valeur de l'un à l'autre.
Response caching : correspondance exacte.
- Dans API Management,
cache-lookup/cache-storene cachent que des réponses à des GET identiques : utile pour les outils en lecture qu'appellent les agents (catalogue, référentiel), pas pour les appels LLM, qui sont des POST. - Pour un appel LLM ou un résultat de subagent, construire sa clé :
cache-lookup-value/cache-store-valuedans API Management, ou Redis dans l'application, avec une clé = hash du modèle, du prompt complet et des paramètres. Utile pour un pipeline déterministe rejoué (même document, même consigne,temperaturebasse).
3.4 Règles de conception#
- Partitionner par locataire, utilisateur ou groupe avant toute réutilisation (
vary-by, préfixe de clé). - Versionner la clé ou l'index avec l'identifiant du modèle, du modèle d'embeddings, la version du prompt template, de la configuration d'outils et de la politique de sécurité : une réponse produite sous un autre contrat ne doit pas ressortir.
- TTL selon l'usage (exemples de la doc) : secondes à minutes pour prix, stocks, état opérationnel ; minutes à heures avec revue pour le juridique et la conformité ; heures à jours pour une FAQ produit.
- Ne pas cacher : réponses personnalisées sans partition, décisions qui déclenchent une action, données sensibles, contenu très volatil.
- Mesurer le gain net : chaque requête paie un embedding et une recherche ; en cas d'échec du cache, ce coût s'ajoute à l'appel normal. Juger sur la télémétrie de production, pas sur le seul taux de hit.
- En multi-agents, cacher au plus près de la source réutilisable : le préambule commun (prompt caching), les questions fréquentes à l'entrée (semantic cache à la passerelle), les sous-résultats déterministes (response cache applicatif).
4. Scaling et contrôle du spawning#
4.1 Les limites à poser#
Un système multi-agents mal borné se multiplie tout seul : un orchestrateur qui délègue en boucle, un subagent qui rappelle un outil quarante fois, un group chat sans fin. Les limites existent à chaque niveau ; l'examen attend qu'on sache lequel poser.
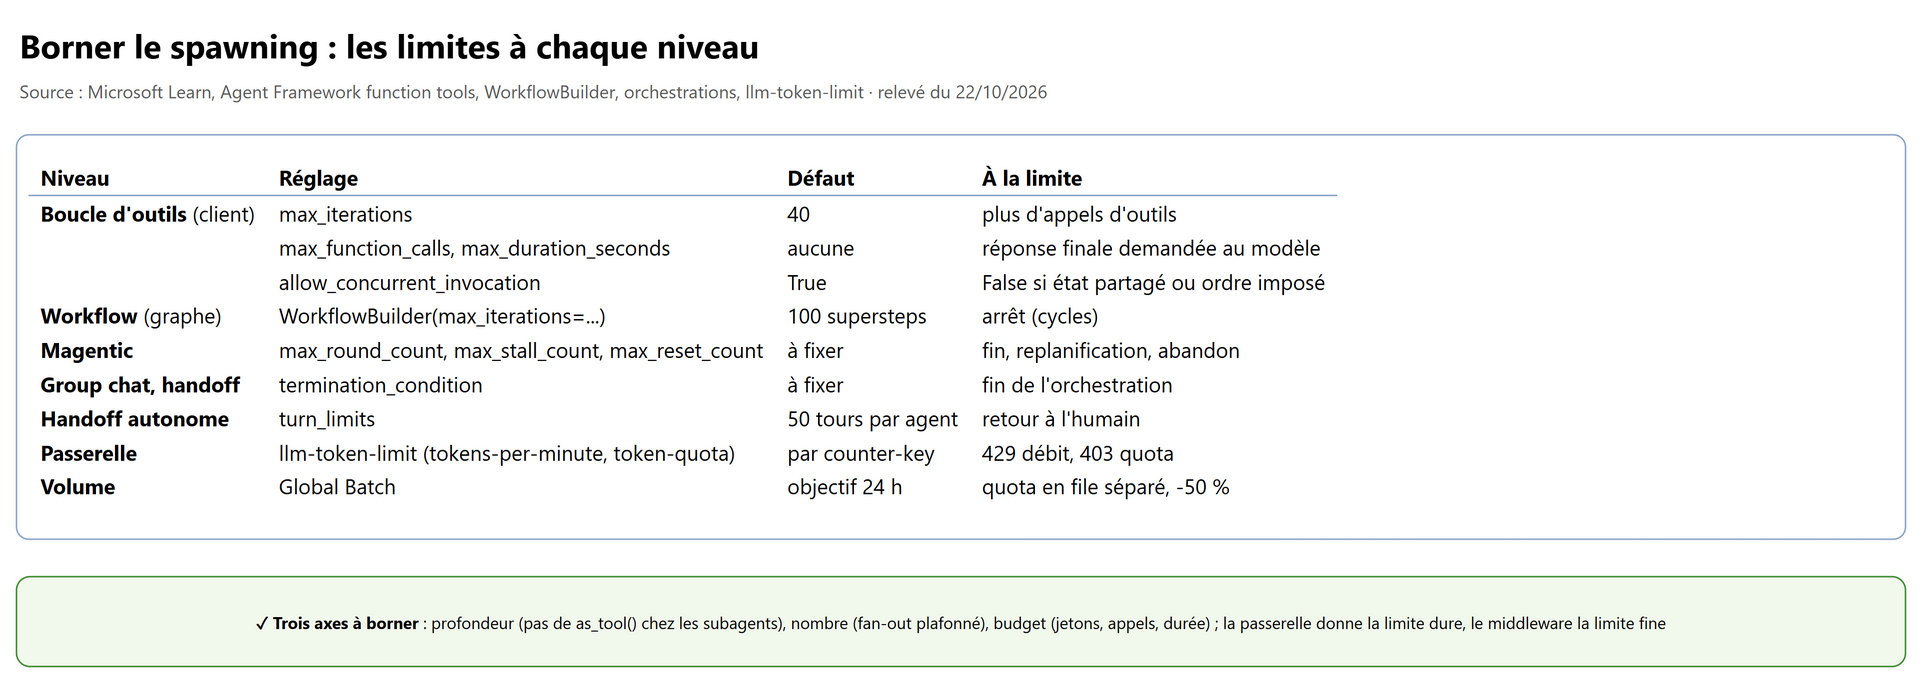
| Niveau | Réglage | Valeur par défaut | Ce qui se passe à la limite |
|---|---|---|---|
| Boucle d'outils d'un agent | function_invocation_configuration["max_iterations"] |
40 allers-retours modèle | Arrêt des appels d'outils |
max_function_calls, max_duration_seconds |
Aucune limite (None) |
Le client cesse d'appeler des outils et demande une réponse finale au modèle (contrôle après chaque lot : un lot peut dépasser) | |
allow_concurrent_invocation |
True : les appels d'un même message s'exécutent en parallèle |
False si les outils partagent un état mutable ou doivent suivre l'ordre |
|
| Workflow (graphe) | WorkflowBuilder(max_iterations=...) |
100 supersteps | Arrêt du workflow (protège des cycles) |
| Magentic | max_round_count, max_stall_count, max_reset_count |
À fixer | Fin, replanification, abandon |
| Group chat, handoff | termination_condition |
À fixer | Fin de l'orchestration |
| Handoff autonome | turn_limits |
50 tours par agent | Retour à l'humain |
| Passerelle | llm-token-limit (tokens-per-minute, token-quota) |
Par counter-key |
429 (débit) ou 403 (quota) |
| Modèle | Quota TPM du deployment | Par deployment | 429 |
client.function_invocation_configuration.update({
    "max_iterations": 5,           # allers-retours modèle par requête
    "max_function_calls": 20,      # appels d'outils au total
    "max_duration_seconds": 30.0,  # temps écoulé, attente d'approbation comprise
})
client.function_invocation_configuration["allow_concurrent_invocation"] = False   # outils à état partagé
4.2 Exécution concurrente : le modèle des supersteps#
Agent Framework exécute un graphe selon un modèle Pregel / Bulk Synchronous Parallel : à chaque superstep, il collecte les messages, les route, lance en parallèle tous les executors visés, puis attend qu'ils aient tous fini (barrière) avant le superstep suivant. Avantages : exécution déterministe, checkpoints fiables, pas de course entre supersteps.
Conséquences pratiques :
- Dans un fan-out vers une branche longue et une chaîne de trois petites étapes, la chaîne attend la branche longue à chaque superstep. Pour des chemins vraiment indépendants, regrouper la chaîne dans un seul executor.
- Fan-out et fan-in : chaque executor du
add_fan_out_edgesdoit figurer dans leadd_fan_in_edges, sinon l'aggregator se déclenche avec un résultat partiel ; le handler de fan-in reçoit une liste (list[str],list[T]), dans l'ordre déclaré. - Ne pas partager d'état mutable entre branches concurrentes : passer par les messages ou l'état d'executor
(
ctx.set_executor_state) et l'état partagé (ctx.set_state).
from agent_framework import WorkflowBuilder

workflow = (
    WorkflowBuilder(start_executor=decoupage, max_iterations=20)
    .add_fan_out_edges(decoupage, [analyse_a, analyse_b, analyse_c])
    .add_fan_in_edges([analyse_a, analyse_b, analyse_c], consolidation)   # consolidation reçoit list[...]
    .build()
)
4.3 Profondeur, nombre et budget#
Le guide parle de « control of multi-agent spawning ». Trois axes à borner explicitement :
| Axe | Risque | Comment le borner |
|---|---|---|
| Profondeur | Un subagent qui a lui-même des subagents (agents as tools imbriqués), délégation récursive | Ne donner as_tool() qu'au niveau orchestrateur ; un subagent n'a que des outils métier ; profondeur max documentée (1 ou 2) |
| Nombre | Fan-out non borné (un agent par document, par client…) | Nombre de participants fixé dans le code ; pour un fan-out dynamique, plafond et file d'attente dans l'executor de découpage (sémaphore asyncio côté application) ; allow_concurrent_invocation |
| Budget | Jetons et temps qui explosent | max_iterations, max_function_calls, max_duration_seconds par agent ; max_iterations du workflow ; llm-token-limit par agent ou par application à la passerelle (counter-key) ; compteur de jetons dans un agent middleware |
Pour le budget, la passerelle donne la limite dure et partagée ; le middleware la limite fine (par run, par utilisateur).
Les compteurs de llm-token-limit sont par gateway (chaque région, chaque workspace gateway a les siens) ; en v2, garder la
même valeur tokens-per-minute à toutes les portées qui partagent une counter-key.
4.4 Batching#
| Besoin | Outil | À retenir |
|---|---|---|
| Gros volume non interactif (classer 100 000 tickets) | Global Batch d'Azure OpenAI | Fichier de requêtes, objectif 24 h, 50 % moins cher que global standard, quota de jetons en file séparé (n'affecte pas le trafic en ligne), pas de modèles fine-tunés |
| Modèle Transformers sur GPU | pipeline(..., batch_size=N) |
Les pipelines regroupent les éléments envoyés au GPU pour le débit |
| Modèle Hugging Face sur Azure Machine Learning | Batch endpoint | Traitement par lots planifiable, hors temps réel |
| Plusieurs outils demandés dans le même message | Exécution concurrente par défaut du client | Désactiver si ordre ou état partagé |
Un agent n'a pas à traiter le volume lui-même : il prépare le lot (découpage, prompt), le batch traite, un agent consolide.
4.5 Héberger à l'échelle#
- Hosted agents Foundry : conteneur géré, mise à l'échelle jusqu'à zéro avec reprise d'état (AI-103 06, 1.1).
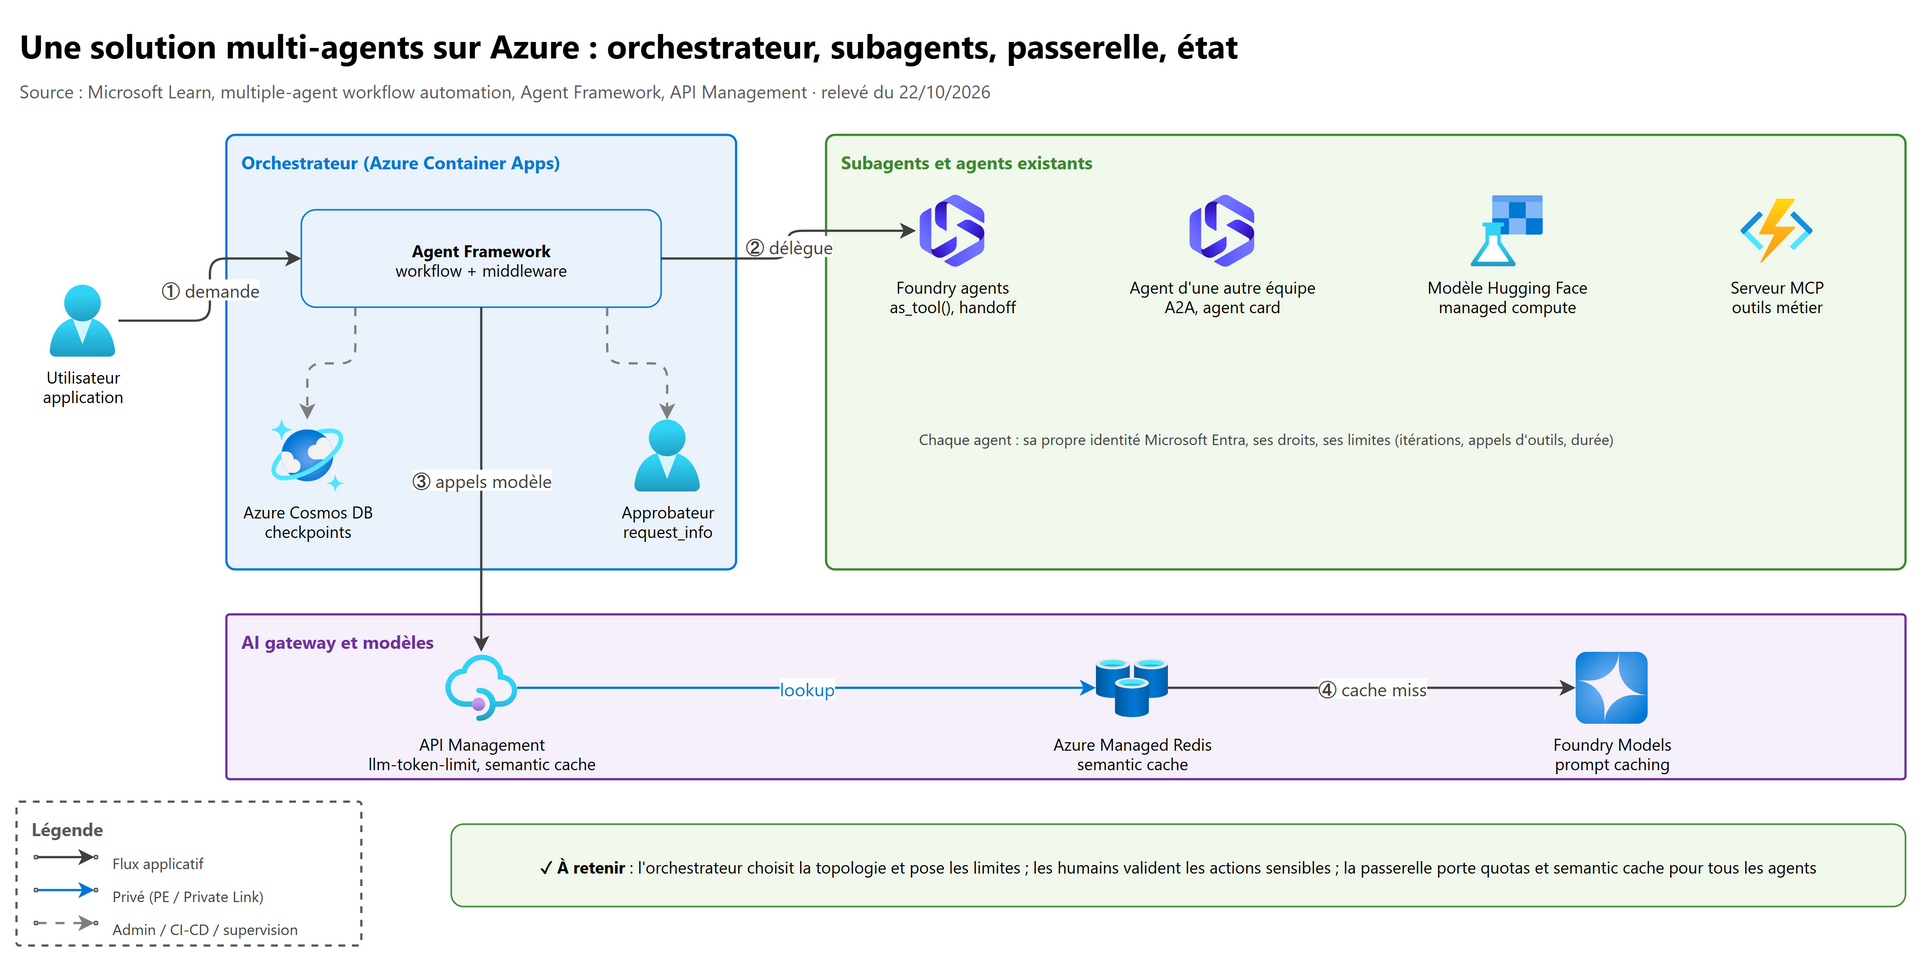
- Azure Container Apps : l'architecture de référence citée par le guide (multiple-agent workflow automation) héberge l'orchestrateur Agent Framework dans Container Apps, les modèles dans Foundry, plans et historique dans Azure Cosmos DB, images dans Container Registry ; alternative sans code : Foundry Agent Service seul, quand l'orchestration n'a pas besoin d'être déterministe.
- Des centaines d'agents : le motif Dynamic AI agents at scale sélectionne les agents candidats par recherche vectorielle (Azure AI Search utilisé comme cache sémantique d'agents), puis laisse un LLM choisir dans la liste réduite ; historique de conversation dans Azure Managed Redis avec TTL glissant.
5. Intégrer des agents existants : A2A et MCP#
5.1 A2A en bref#
Le protocole Agent2Agent (A2A) standardise : la découverte par agent card (description, skills, interfaces), la communication par messages, les tasks pour le travail long, l'interopérabilité entre frameworks. Un agent A2A reste chez son propriétaire, avec son modèle, ses outils et ses données ; on ne voit que son contrat.
5.2 Consommer un agent A2A#
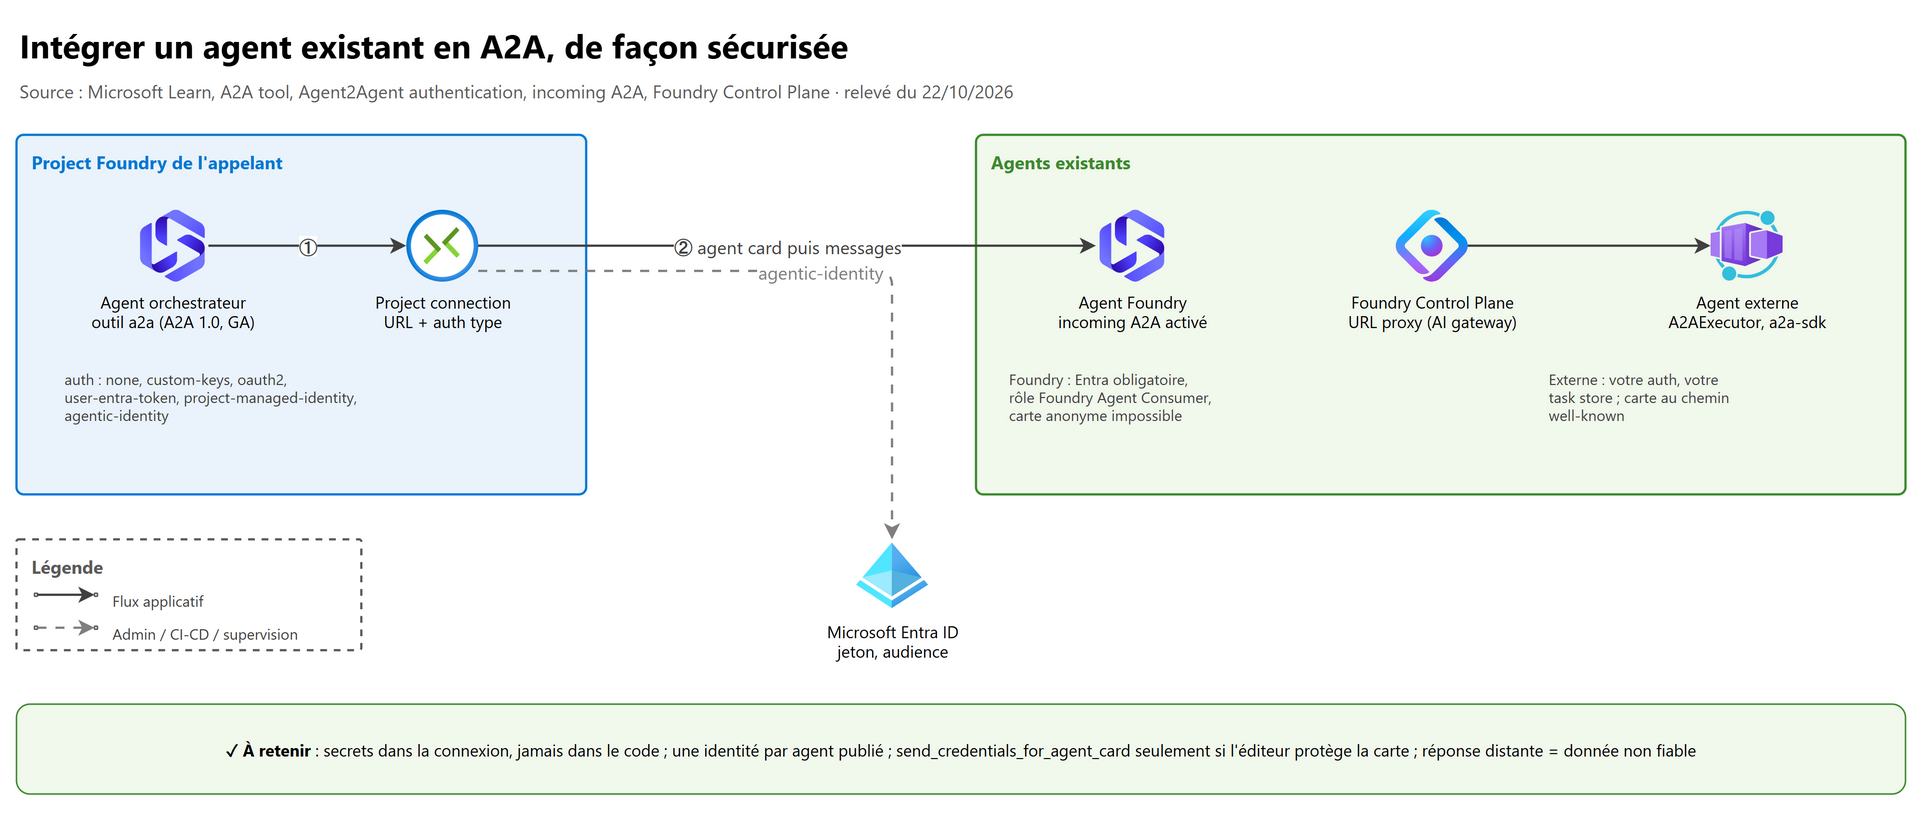
Depuis Foundry Agent Service : l'outil a2a (A2A 1.0, GA) pour toute nouvelle intégration ; a2a_preview
(A2A 0.3, preview) reste pour l'existant (c'est celui que crée aujourd'hui le flux azd ai toolbox). On crée une project
connection qui porte l'URL et l'authentification, puis on attache l'outil à l'agent, directement ou par une toolbox (outil
réutilisable par plusieurs agents, exposé comme endpoint MCP).
--auth-type de la connexion |
Quand |
|---|---|
none |
Agent public, démonstration |
custom-keys |
Clé d'API de l'éditeur (stockée dans la connexion, jamais dans le code) |
oauth2 |
OAuth géré ou application OAuth personnalisée |
user-entra-token |
L'identité de l'utilisateur est transmise (droits de l'utilisateur) |
project-managed-identity |
Une identité commune à tous les agents du project |
agentic-identity |
L'agent identity de l'agent appelant ; obligatoire avec l'audience https://ai.azure.com pour une cible Foundry |
{
  "type": "a2a",
  "a2a_version": "1.0",
  "base_url": "https://<a2a-endpoint>",
  "project_connection_id": "<connection-id>",
  "send_credentials_for_agent_card": true
}
Par défaut, la carte est lue anonymement et les identifiants ne servent qu'aux appels d'outils. send_credentials_for_agent_card
(défaut false) envoie aussi les identifiants pour lire la carte, seulement en HTTPS et vers l'hôte de base_url ; à activer
uniquement si l'éditeur protège le chemin de la carte, car cela expose davantage le secret.
Cible = agent Foundry : connexion vers https://{account}.services.ai.azure.com/api/projects/{project}/agents/{agent}/endpoint/protocols/a2a,
audience https://ai.azure.com, pas de chemin de carte à fournir ; l'agent cible doit avoir l'incoming A2A activé ; tasks et
contexts conservés 60 jours après la dernière écriture.
Depuis Agent Framework (pip install agent-framework-a2a --pre, en préversion) : A2AAgent enveloppe n'importe quel
endpoint A2A comme un agent ordinaire, utilisable dans une orchestration (participant d'un concurrent, subagent as_tool()…).
from agent_framework.a2a import A2AAgent

async with A2AAgent(agent_card=carte) as facturation:       # carte venue d'un registre ou d'A2ACardResolver
    reponse = await facturation.run("Statut de la facture F-2026-118 ?")
Trois façons d'initialiser : URL directe (carte minimale construite, JSON-RPC), agent card fournie (nom et description repris,
transport négocié par supported_interfaces), ou découverte au chemin well-known par A2ACardResolver du a2a-sdk.
5.3 Exposer un agent en A2A#
| Situation | Méthode | Sécurité |
|---|---|---|
| Agent Foundry | Enable incoming A2A : PATCH de l'agent avec son agent_card ; cartes v1.0 et v0.3 servies à partir du même contenu |
Microsoft Entra obligatoire, carte anonyme impossible ; l'appelant a le rôle Foundry Agent Consumer (ou un rôle Foundry qui donne accès à l'endpoint) |
| Agent A2A hébergé ailleurs | Register dans Foundry Control Plane (protocole A2A) : Foundry découvre la carte (/.well-known/agent-card.json) et génère une URL proxy |
Contrôle d'accès et supervision par l'AI gateway (API Management) |
| Agent Agent Framework auto-hébergé | A2AExecutor (agent-framework-a2a) dans un serveur a2a-sdk |
À votre charge : carte, DefaultRequestHandler, task store, routes, authentification ; tester avec un AuthInterceptor |
Deux noms dans la doc (22/10/2026) : la page Python d'Agent Framework cite
/.well-known/agent.jsonpourA2ACardResolver; Foundry (agent_card_pathpar défaut), la page .NET et la spécification A2A actuelle écrivent/.well-known/agent-card.json. À l'examen, reteniragent-card.json.
5.4 A2A ou MCP#
| A2A | MCP | |
|---|---|---|
| Ce qu'on intègre | Un agent autonome, traité comme un pair | Un outil ou une source de données (ou un agent présenté comme outil) |
| Contrat | Agent card : skills, interfaces ; tasks pour le long cours, context_id de conversation |
Liste d'outils typés (tools/list, tools/call) |
| L'appelant voit | Le résultat, pas le raisonnement ni les outils internes | Chaque appel d'outil et son résultat |
| Typique | Agent d'une autre équipe, d'un éditeur, d'un autre framework | Base de connaissances, API métier, toolbox Foundry |
| Contrôle humain | Approbation de l'outil A2A | require_approval, allowed_tools |
Les deux se combinent : une toolbox Foundry peut contenir un outil A2A et l'exposer en MCP. Serveurs MCP et fallbacks : voir le chapitre 04.
5.5 Sécuriser l'intégration#
- Identité par agent : un agent Foundry reçoit une agent identity ; avant publication, tous les agents d'un project partagent la même, après publication chacun a la sienne. Les rôles sur le service cible se donnent à cette identité, au plus juste (Zero Trust par agent : chapitre 02, Agent ID : SC-500 chapitre 07).
- Choisir l'identité qui porte le droit :
user-entra-tokenquand l'action doit respecter les droits de l'utilisateur,agentic-identityquand l'agent agit pour son propre compte (OBO et flux OAuth : chapitre 07). - Clés : uniquement dans la project connection, jamais dans le code ni l'agent card.
- Passer par la passerelle : l'enregistrement dans Foundry Control Plane met l'agent externe derrière l'AI gateway (contrôle d'accès, quotas, traces).
- Traiter la réponse d'un agent externe comme une donnée non fiable : guardrails sur les tool responses (chapitre 07), approbation sur l'outil A2A quand l'agent distant peut agir.
sequenceDiagram
    participant O as Agent orchestrateur (Foundry)
    participant E as Microsoft Entra ID
    participant R as Agent distant (A2A)
    O->>R: GET agent card (anonyme par défaut)
    R-->>O: skills, interfaces, versions
    O->>E: demande de jeton (agentic-identity, audience Foundry)
    E-->>O: access token
    O->>R: message A2A + Bearer token
    R-->>O: task (en cours) puis artefacts
    Note over O: réponse traitée comme donnée non fiable (guardrails)
6. Frameworks : Agent Framework, LangChain, LangGraph#
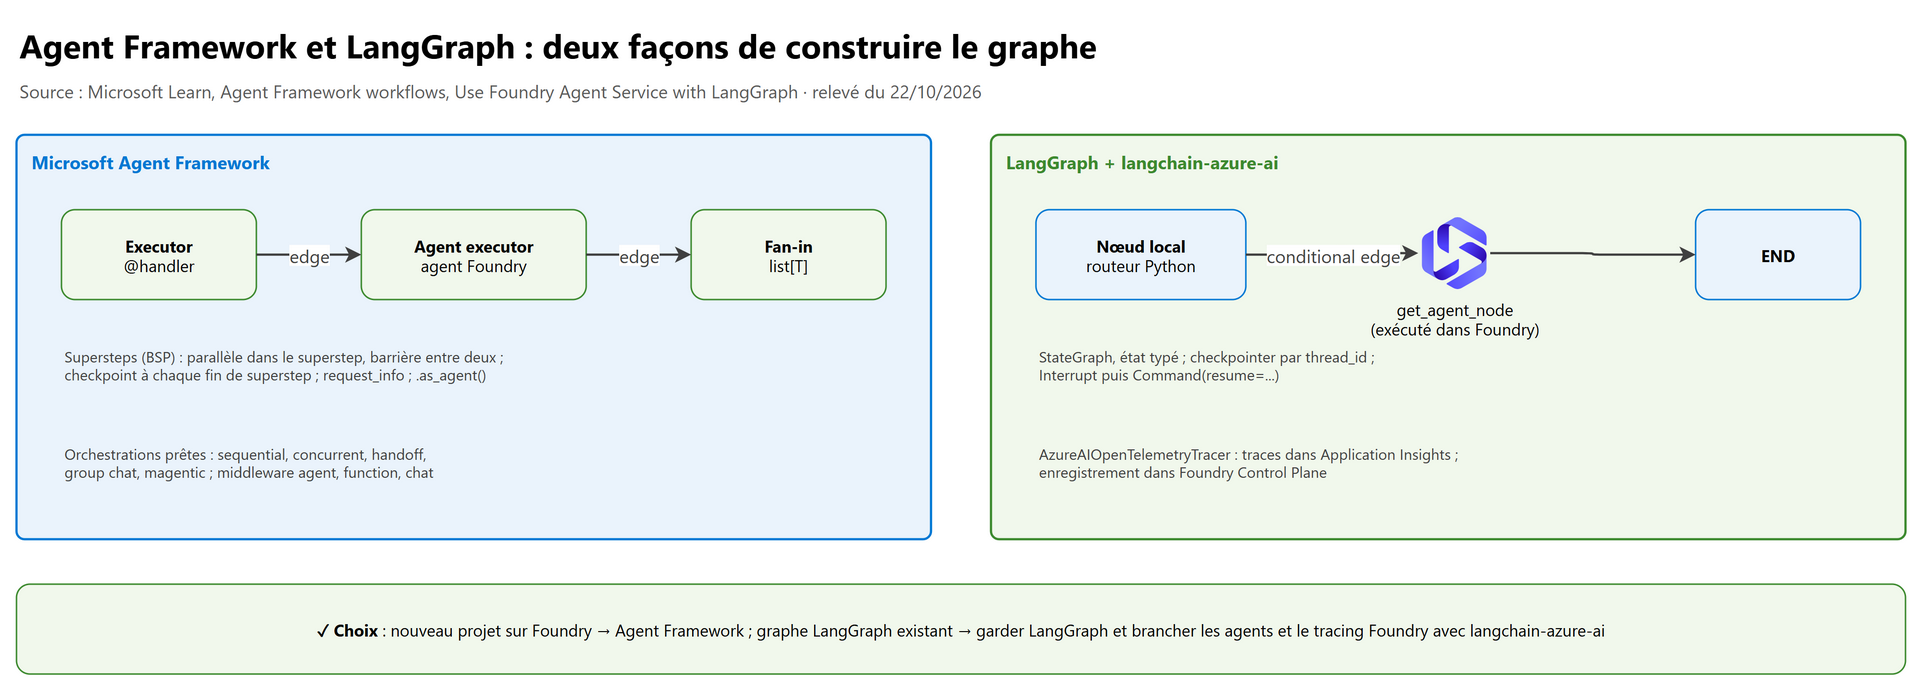
6.1 Agent Framework : workflows, executors, edges#
Rappel du modèle (AI-103 07, 5.5) : des
executors (classe avec @handler, WorkflowContext, ctx.send_message, ctx.yield_output), reliés par des edges (direct,
conditional, switch-case, fan-out, fan-in), construits par WorkflowBuilder, exécutés en supersteps, avec events, state,
checkpoints, request info. Ce qu'il faut savoir en plus au niveau expert :
| Sujet | À retenir |
|---|---|
| Deux API en Python | Graph (WorkflowBuilder, typé, fan-out / fan-in, checkpoints aux supersteps) et Functional (@workflow, @step, contrôle de flux Python natif, asyncio.gather, expérimental) ; mêmes résultats observables |
| Composition | Un workflow devient un executor d'un autre (sub-workflow, WorkflowExecutor) ou un agent (.as_agent()) |
| Agents dans un graphe | Un agent est enveloppé dans un Agent Executor ; les orchestrations intégrées sont des graphes préconstruits |
| Instances | Une instance de Workflow garde son état entre deux run : une instance par run indépendant |
| Tracing | OpenTelemetry natif, traces dans Foundry et Application Insights (chapitre 06) |
| Migration | Semantic Kernel et AutoGen convergent vers Agent Framework (guides de migration) ; prompt flow retiré le 20/04/2027 ; Foundry workflows (preview) retirés le 01/12/2026 |
6.2 LangGraph et LangChain avec Foundry#
Le paquet langchain-azure-ai relie LangChain et LangGraph à Foundry (pip install langchain-azure-ai[tools,opentelemetry] azure-identity). AgentServiceFactory crée des nœuds LangGraph qui s'exécutent dans Foundry Agent Service ; la doc recommande
de configurer les agents dans Foundry et de les référencer par nom, pour que le code ne fasse que l'orchestration.
import os
from typing import Literal
from azure.identity import DefaultAzureCredential
from langchain_azure_ai.agents import AgentServiceFactory
from langgraph.graph import StateGraph, MessagesState, START, END

factory = AgentServiceFactory(project_endpoint=os.environ["AZURE_AI_PROJECT_ENDPOINT"],
                              credential=DefaultAzureCredential())
expert = factory.get_agent_node(name="expert-contrats", version="latest")   # agent existant dans Foundry

class Etat(MessagesState):
    aller_vers: str | None

def routeur(state: Etat):
    besoin_expert = "contrat" in state["messages"][-1].content.lower()
    return {"aller_vers": "expert" if besoin_expert else None}

def decider(state: Etat) -> Literal["expert", END]:
    return "expert" if state.get("aller_vers") == "expert" else END

graphe = StateGraph(Etat)
graphe.add_node("routeur", routeur)
graphe.add_node("expert", expert)                 # nœud exécuté par Foundry Agent Service
graphe.add_edge(START, "routeur")
graphe.add_conditional_edges("routeur", decider)
graphe.add_edge("expert", END)
app = graphe.compile()
| Besoin | Ce qu'apporte langchain-azure-ai |
|---|---|
| Réutiliser un agent Foundry | get_agent_node(name=..., version="latest" ou figée) ; l'identifiant de conversation est ajouté à l'état (azure_ai_agents_conversation_id) |
| Créer l'agent en code | create_prompt_agent(name, model, instructions, tools, checkpointer) ; renvoie un CompiledStateGraph |
| Outils | Locaux (fonctions Python, outils LangChain) → un nœud d'outils dans le graphe ; built-in Foundry (langchain_azure_ai.agents.prebuilt.tools, Code Interpreter, image, File search…) → exécutés côté service, seulement avec create_prompt_agent |
| Human-in-the-loop | MCPTool(..., require_approval="always") + checkpointer=MemorySaver() : le graphe s'interrompt, on reprend avec Command(resume={"approve": True}) et le même thread_id |
| Tracing | AzureAIOpenTelemetryTracer(agent_id=...) attaché par .with_config({"callbacks": [tracer]}) ; trace_all_langgraph_nodes=True ; deux agents visibles : le nœud Foundry et le graphe entier |
| Gouvernance | Enregistrer l'application dans Foundry Control Plane (exige une AI gateway configurée) pour voir ses traces dans le portail |
Autres façons d'exécuter du LangGraph sur Azure : en hosted agent Foundry (conteneur), ou dans Container Apps comme n'importe quelle application, en appelant les modèles Foundry.
6.3 Que choisir#
| Critère | Agent Framework | LangGraph (+ LangChain) |
|---|---|---|
| Orchestrations prêtes à l'emploi | Sequential, concurrent, handoff, group chat, magentic | À construire en graphe (nombreux exemples dans l'écosystème) |
| Graphe et état | Executors typés, supersteps BSP, checkpoints | StateGraph, état typé, checkpointer par thread_id |
| Human-in-the-loop | request_info, approbation d'outils, plan review |
Interrupt, Command(resume=...) |
| Middleware | Agent, function, chat middleware natifs (section 8) | Callbacks et nœuds dédiés |
| Intégration Foundry | Native (FoundryChatClient, hosted agents, tracing) |
Par langchain-azure-ai |
| Choisir quand | Nouveau projet sur Azure, .NET et Python, gouvernance Microsoft | Équipe et code LangGraph existants, écosystème LangChain |
À l'examen, une question « nouvelle solution multi-agents sur Foundry, déterministe, avec approbations et reprise » appelle
Agent Framework ; « l'équipe a déjà un graphe LangGraph et veut utiliser des agents Foundry et le tracing Foundry » appelle
langchain-azure-ai (AgentServiceFactory, AzureAIOpenTelemetryTracer), sans réécriture.
7. Hugging Face Transformers#
7.1 Le rôle des modèles Transformers dans un système multi-agents#
Les « capacités avancées » attendues sont des modèles spécialisés qui complètent les LLM : classifier une demande pour router vers le bon agent, extraire des entités, détecter la langue ou le sentiment, calculer des embeddings, résumer, ou un petit modèle génératif fine-tuné sur un métier. Avantages : coût et latence faibles, comportement stable, exécution possible sans Internet, données qui ne sortent pas. La bibliothèque Transformers fournit les modèles pré-entraînés, les tokenizers et des pipelines par tâche qui utilisent le GPU s'il existe et regroupent les éléments par lots.
Le guide ne précise pas le niveau attendu sur Hugging Face. Ce chapitre s'appuie sur ce que documente Microsoft Learn (catalogue Foundry, Azure Machine Learning, Transformers) ; les bibliothèques d'agents propres à Hugging Face (smolagents…) ne sont pas décrites sur Learn et restent hors de ce cours.
7.2 Où faire tourner le modèle#
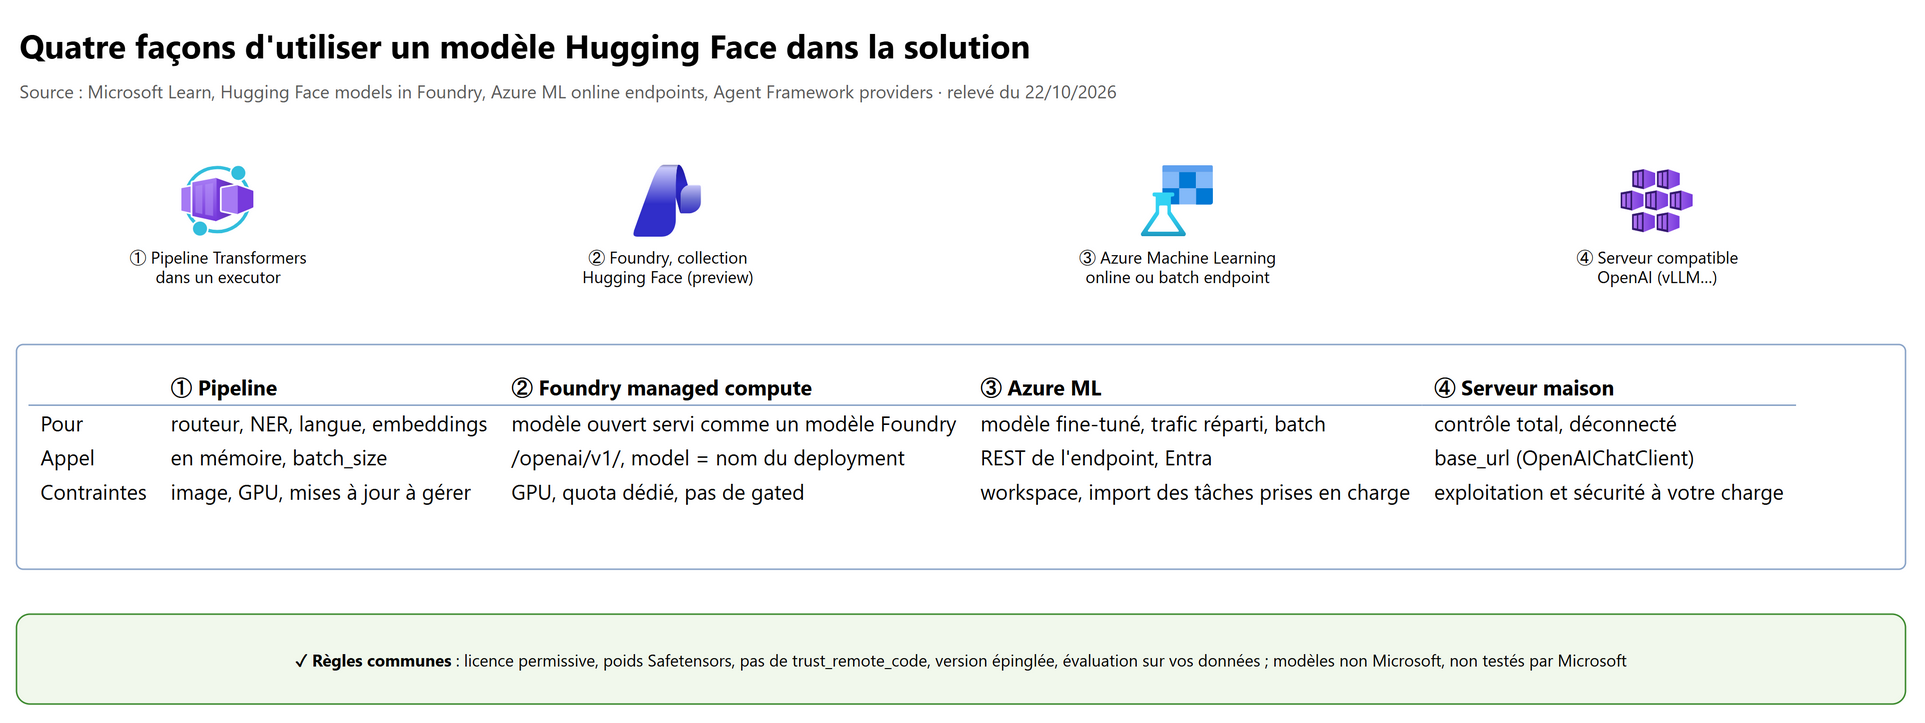
| Option | Où tourne le modèle | Quand | Contraintes |
|---|---|---|---|
| Pipeline dans un executor | Dans le conteneur de l'orchestrateur (Container Apps avec GPU, AKS) | Petit modèle appelé à chaque requête (routeur, NER) | Vous gérez image, mémoire, GPU, mises à jour |
| Foundry, collection Hugging Face (Managed compute, preview) | Instances GPU dédiées, endpoint Foundry | Modèle ouvert servi comme les autres modèles Foundry (/openai/v1/, champ model = nom du deployment) |
Quota GPU propre au managed compute ; modèles gated non disponibles ; GPU uniquement |
| Azure Machine Learning | Managed online endpoint (temps réel) ou batch endpoint | Modèle personnalisé, fine-tuné, trafic réparti ou miroir entre versions, autoscale | Workspace Azure ML ; import depuis le Hub pour les tâches prises en charge |
| Serveur compatible OpenAI (vLLM, Ollama…) | Votre infrastructure | Contrôle total, local ou déconnecté | Agent Framework s'y branche par base_url (OpenAIChatClient) ou OllamaChatClient ; vérifier que le modèle sait appeler des outils |
Critères des modèles Hugging Face déployables dans Foundry : tag Transformers, Diffusers ou Sentence-Transformers ; licence
permissive (Apache 2.0, MIT, OpenRAIL-M…) ; tâche prise en charge (chat-completion, image-to-text, embeddings…) ; poids au
format Safetensors et pas de trust_remote_code. Dans le nouveau Foundry, les poids sont stockés sur Azure (dans Foundry
classic et Azure ML, ils sont téléchargés depuis le Hub au déploiement).
7.3 Un routeur Transformers dans un workflow#
Un classifieur local décide quel agent traite la demande ; les LLM ne sont appelés que pour la suite.
from transformers import pipeline
from agent_framework import Executor, WorkflowBuilder, WorkflowContext, handler

class RouteurTransformers(Executor):
    def __init__(self, id: str):
        super().__init__(id=id)
        # Modèle de classification validé en interne (licence, évaluation) ; chargé une fois
        self.classifieur = pipeline("text-classification", model="<modele-de-classification>", batch_size=16)

    @handler
    async def router(self, demande: str, ctx: WorkflowContext[str]) -> None:
        etiquette = self.classifieur(demande)[0]["label"]
        await ctx.send_message(f"{etiquette}||{demande}")   # préfixe lu par les conditions des edges

def vers(categorie: str):
    return lambda msg: msg.startswith(categorie + "||")

routeur = RouteurTransformers(id="routeur")
workflow = (
    WorkflowBuilder(start_executor=routeur)
    .add_edge(routeur, agent_facturation, condition=vers("facturation"))
    .add_edge(routeur, agent_technique, condition=vers("technique"))
    .build()
)
Le préfixe catégorie||charge est le motif montré par la doc de migration de prompt flow pour router sur des conditions d'edges.
Pour un volume important, appeler le pipeline sur une liste de textes : batch_size regroupe les éléments sur le GPU. Un modèle
servi par un endpoint (Foundry ou Azure ML) s'appelle de la même façon depuis l'executor, par son SDK ou en REST, avec
l'authentification Microsoft Entra.
7.4 Sécurité et licences#
- Les modèles Hugging Face sont des produits non Microsoft, non testés par Microsoft : évaluer risques et sécurité sur votre cas d'usage avant le déploiement, respecter la licence affichée sur la fiche du modèle.
- Dans Foundry, chaque modèle de la collection passe un scan de malware, une inspection du code (pas de
trust_remote_code=Truesauf modèle vérifié), l'obligation Safetensors (pas de pickle) et des tests de conformité d'API. - Hors Foundry, appliquer les mêmes règles vous-même : Safetensors, pas de code distant, version épinglée, image scannée.
- Content Safety n'est pas automatique sur un modèle en managed compute d'Azure ML : l'appeler explicitement si nécessaire.
8. Middleware réutilisable#
8.1 Trois types de middleware et leur ordre#
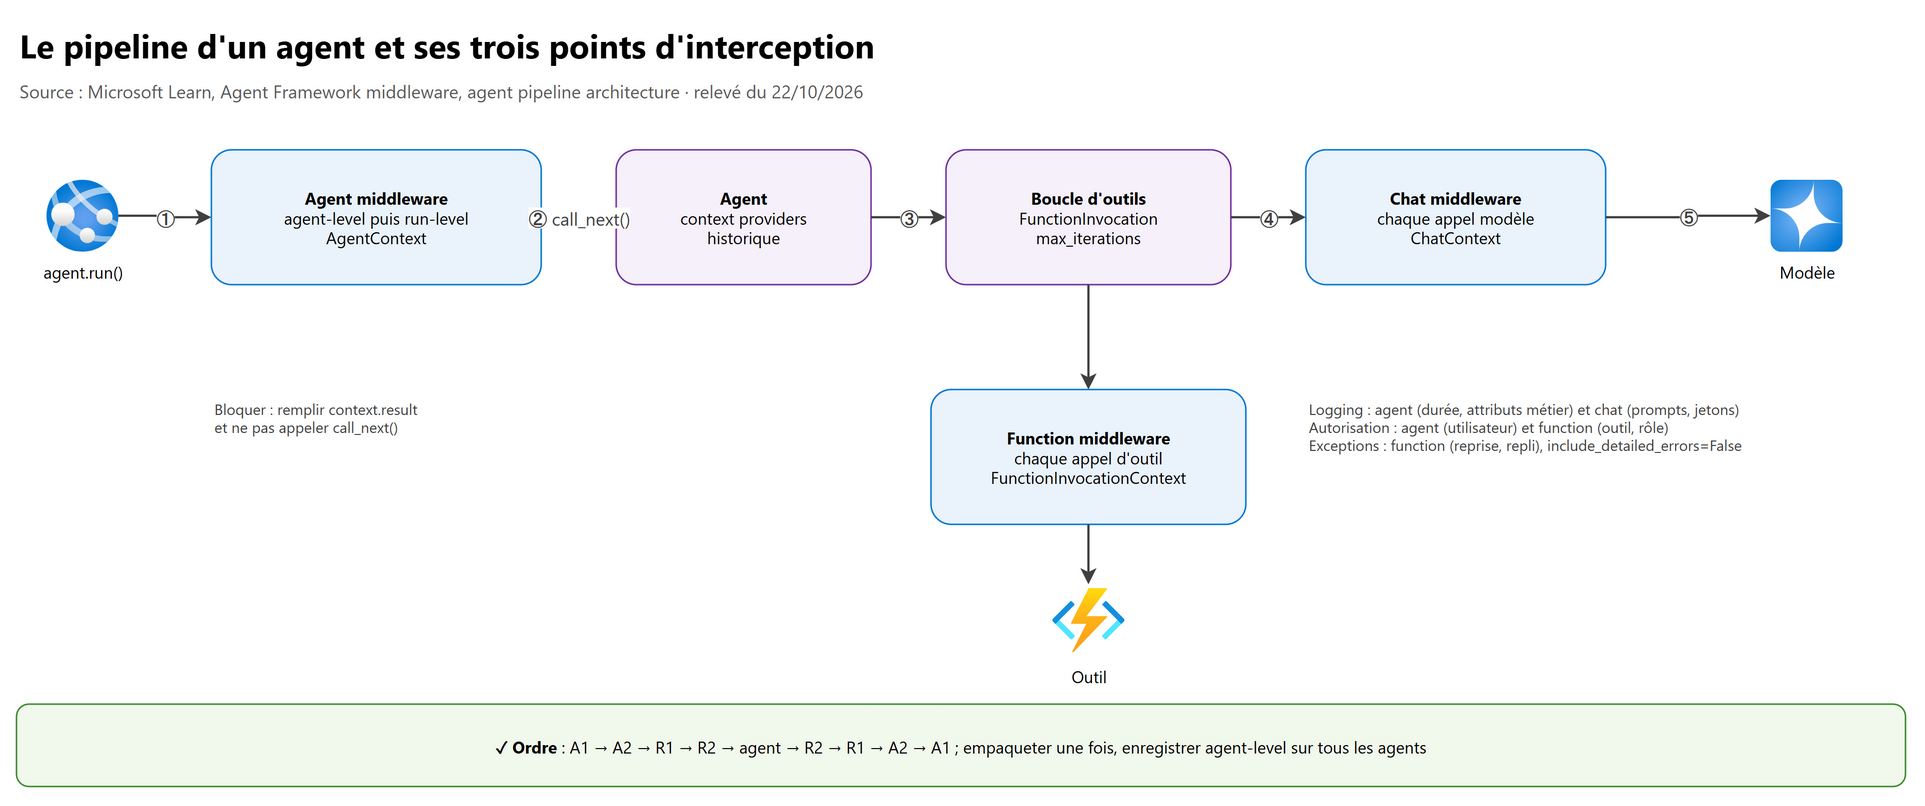
| Type | Intercepte | Contexte | Usages |
|---|---|---|---|
| Agent middleware | Chaque run() de l'agent |
AgentContext : agent, messages, session, options, stream, metadata, result, function_invocation_kwargs… |
Filtrage d'entrée, autorisation de l'utilisateur, budget, réécriture de la réponse |
| Function middleware | Chaque appel d'outil | FunctionInvocationContext : function, arguments, kwargs, result |
Autoriser un outil, valider les arguments, journaliser, retenter, masquer un résultat |
| Chat middleware | Chaque appel au modèle, y compris les appels qui renvoient les résultats d'outils | ChatContext : client, messages, options, stream, result |
Journaliser prompts et jetons, réécrire les messages, cache maison |
Règles de fonctionnement :
- Chaque middleware appelle
await call_next()pour passer au suivant ;call_nextne prend pas le contexte, on modifie le contexte partagé avant ou après. - Ne pas appeler
call_next()(après avoir remplicontext.result), ou leverMiddlewareTermination, arrête la chaîne et saute l'exécution normale. - Deux portées : agent-level (à la création, pour tous les runs) et run-level (
agent.run(..., middleware=[...])). L'agent enveloppe le run : pour[A1, A2]et[R1, R2], l'ordre estA1 → A2 → R1 → R2 → agent → R2 → R1 → A2 → A1. metadatatransporte des données entre middleware (identifiant de requête, horodatage).- Agent Hooks installe un même paquet de middleware sur les trois couches et ajoute des barrières de streaming et de persistance : une frontière de contrôle fail-closed (rien n'est diffusé ni stocké avant le verdict).
8.2 Logging#
import time
from collections.abc import Awaitable, Callable
from agent_framework import AgentMiddleware, AgentContext, FunctionMiddleware, FunctionInvocationContext

class JournalAgent(AgentMiddleware):
    async def process(self, context: AgentContext, call_next: Callable[[], Awaitable[None]]) -> None:
        context.metadata["debut"] = time.time()
        await call_next()
        print(f"[{context.agent.name}] run terminé en {time.time() - context.metadata['debut']:.2f}s")

class JournalOutils(FunctionMiddleware):
    async def process(self, context: FunctionInvocationContext, call_next: Callable[[], Awaitable[None]]) -> None:
        print(f"outil appelé : {context.function.name}")   # jamais les arguments sensibles en clair
        await call_next()
Pour une solution entière, préférer le tracing OpenTelemetry déjà intégré (couches de télémétrie de l'agent et du client) au
print : le middleware sert à ajouter des attributs métier (locataire, identifiant de dossier) et à corréler.
8.3 Autorisation#
L'agent middleware place les valeurs d'exécution destinées aux outils dans function_invocation_kwargs (cachées au modèle) ; le
function middleware les lit et bloque les outils non autorisés.
OUTILS_SENSIBLES = {"emettre_remboursement", "supprimer_compte"}

async def poser_contexte(context: AgentContext, call_next) -> None:
    # Rôles issus du jeton validé par l'application, pas du texte de l'utilisateur
    context.function_invocation_kwargs.setdefault("roles", context.metadata.get("roles", []))
    await call_next()

class AutorisationOutils(FunctionMiddleware):
    async def process(self, context: FunctionInvocationContext, call_next) -> None:
        if context.function.name in OUTILS_SENSIBLES and "Finance.Approver" not in context.kwargs.get("roles", []):
            context.result = "Action refusée : droits insuffisants."   # le modèle reçoit ce résultat
            return                                                     # call_next() non appelé : l'outil ne s'exécute pas
        await call_next()
Le middleware complète, sans les remplacer, les vraies barrières : RBAC sur la ressource cible, identité de l'agent, approbation humaine, guardrails (chapitre 07). Le modèle ne doit jamais être la seule défense.
8.4 Exception handling#
class ReprisesOutils(FunctionMiddleware):
    async def process(self, context: FunctionInvocationContext, call_next) -> None:
        for tentative in range(3):
            try:
                await call_next()
                return
            except TimeoutError:
                continue                                   # erreur transitoire : on retente
        context.result = "Service indisponible, réessayer plus tard."   # repli lisible par le modèle
À connaître côté framework :
include_detailed_errorsvautFalsepar défaut : l'échec d'un outil renvoie au modèle un résultat générique, le détail reste dansContent.exceptionpour le code de confiance. Ne le passer àTrueque si le canal est de confiance (le texte d'une exception peut contenir des données sensibles).- Arrêter la boucle d'outils de force (
Terminateen .NET) peut laisser un historique incohérent (appel sans résultat) et rendre la session inutilisable. - Les erreurs persistantes deviennent un cas limite : escalade humaine (section 2.5) et alerte (traces, chapitre 06).
8.5 Middleware applicatif ou politiques de passerelle#
| Capacité transverse | Dans le middleware Agent Framework | Dans API Management (AI gateway) |
|---|---|---|
| Journalisation | Attributs métier, corrélation par run | Jetons par consommateur (llm-emit-token-metric) |
| Autorisation | Par outil, par rôle, avec le contexte de l'agent | Par abonnement, JWT, produit |
| Limites | Itérations, appels d'outils, durée, budget par run | llm-token-limit, rate-limit, quota partagés |
| Cache | Response cache maison | Semantic cache central |
| Contenu | Validation et réécriture des sorties | llm-content-safety |
| Exceptions | Reprises, repli, escalade | Retry et bascule entre backends |
Règle : ce qui dépend de la logique de l'agent (quel outil, quel rôle, quelle étape) va dans le middleware, empaqueté une fois et enregistré sur tous les agents ; ce qui doit s'appliquer à tous les consommateurs quel que soit leur code va dans la passerelle.
9. Labs conseillés#
Abonnement de test, une Foundry resource, un project, un deployment gpt-5-mini (ou équivalent), Python 3.10 ou plus,
pip install agent-framework --pre, authentification az login (aucune clé dans le code). Coût : surtout les jetons ; API
Management Developer ou Basic v2 et Azure Managed Redis pour le lab 3 sont facturés à l'heure. Supprimer le groupe de ressources
à la fin.
- Trois topologies sur le même problème
- Écrire trois agents (recherche, juridique, synthèse) et les assembler en
SequentialBuilder, puisConcurrentBuilderavec aggregator, puis en orchestrator-subagent (as_tool()). - Comparer les jetons et la latence de chaque run dans les traces.
- Attendu : concurrent plus rapide mais plus de jetons en pic ; orchestrator-subagent appelle seulement les spécialistes utiles.
- Écrire trois agents (recherche, juridique, synthèse) et les assembler en
- Handoff avec approbation et reprise
- Construire le handoff de la section 1.4 avec un outil
approval_mode="always_require"etFileCheckpointStorage. - Arrêter le script à la demande d'approbation, le relancer depuis le dernier checkpoint, approuver.
- Attendu : la requête est réémise après reprise ; l'outil ne s'exécute qu'après
approved=True.
- Construire le handoff de la section 1.4 avec un outil
- Semantic cache à la passerelle
- Importer le deployment dans API Management comme LLM API, ajouter un backend d'embeddings, un external cache Azure Managed Redis, puis les politiques de la section 3.2.
- Envoyer deux questions reformulées, puis une question voisine mais différente ; tracer dans la console de test.
- Attendu : la reformulation sort du cache ; faire varier
score-threshold(0.05 puis 0.3) et constater la mauvaise réponse servie avec le seuil trop lâche.
- Agent distant en A2A
- Créer deux agents Foundry dans deux projects ; activer l'incoming A2A sur le second.
- Créer la connexion
agentic-identity(audiencehttps://ai.azure.com), attribuer Foundry Agent Consumer à l'identité de l'appelant, attacher l'outila2a. - Attendu : sans le rôle, échec d'autorisation ; avec, réponse de l'agent distant.
- Middleware et routeur Transformers
- Ajouter
JournalAgent,AutorisationOutilsetReprisesOutils(section 8) à un agent ; tester un appel refusé. - Brancher le
RouteurTransformers(section 7.3) avec un petit modèle de classification local. - Attendu : l'outil sensible est refusé sans le rôle ; le routage se fait sans appel LLM.
- Ajouter
10. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Un agent seul avec cinq outils répond bien, on propose cinq agents | Garder un seul agent | Plus simple niveau fiable ; le multi-agents ajoute coût, latence et pannes |
| Deux agents ne doivent pas accéder aux mêmes données | Multi-agents avec une identité par agent | Frontière de sécurité distincte = justification reconnue |
| L'orchestrateur doit décider seul s'il appelle un spécialiste | Orchestrator-subagent (agents as tools) | Délégation pilotée par le modèle, pas d'ordre imposé |
| Tous les agents doivent voir tout l'historique et se relire | Group chat (hub-and-spoke conversationnel) | L'orchestrateur diffuse chaque réponse à tous |
| Le bon spécialiste n'apparaît qu'en cours d'échange, sans chef | Handoff (peer-to-peer) | Maillage, transfert complet du contrôle |
| Handoff qui s'arrête et attend après chaque réponse | Comportement normal : request_info ; sinon mode autonome borné |
Pas de handoff = retour à l'utilisateur |
| Group chat qui tourne sans fin | termination_condition et 3 agents au plus |
Le manager doit avoir un critère objectif de fin |
| Maker-checker qui ne converge pas | Plafond d'itérations + repli (humain ou résultat avec avertissement) | Défini avant la mise en production |
| Valider une action irréversible sans bloquer le reste | Approbation ciblée sur le tool call (approval_mode="always_require") |
L'agent reste autonome sur le reste |
| L'humain doit corriger le plan avant toute exécution | Magentic enable_plan_review=True, revise() |
Override du plan |
| Approbation reçue trois jours plus tard, processus redémarré | Checkpoint + run(checkpoint_id=...) puis responses |
Les requêtes en attente sont dans le checkpoint |
| Charger un checkpoint fourni par un tiers | Refuser | Stockage des checkpoints = frontière de confiance |
| Réduire le coût d'un long préambule identique à chaque appel | Prompt caching (statique en tête) | Rien à déployer, appel moins cher |
| Questions reformulées en boucle sur une FAQ, plusieurs agents | Semantic cache dans API Management + Azure Managed Redis | Une politique pour tous les agents |
| Cache sémantique qui sert la réponse d'un autre client | vary-by par abonnement ou locataire |
Partition obligatoire |
| Réponses fausses servies par le cache | Baisser score-threshold |
Plus bas = plus strict ; au-delà de 0.2, mismatch |
cache-lookup sur les appels LLM sans effet |
Ne cache que des GET identiques : utiliser llm-semantic-cache-* ou cache-lookup-value |
Les appels LLM sont des POST |
| Cache indisponible, backend saturé | rate-limit juste après le lookup |
Recommandation de la doc |
| Un agent rappelle des outils sans fin | max_iterations (40 par défaut), max_function_calls, max_duration_seconds |
Limites du client de function calling |
| Workflow qui ne se termine jamais | Cycle d'edges ; max_iterations du workflow (100 par défaut) |
Supersteps jusqu'à la limite |
| Branche courte qui attend une branche longue en fan-out | Regrouper la chaîne en un executor | Barrière de synchronisation entre supersteps |
| Aggregator déclenché avec un résultat partiel | Tous les executors du fan-out dans le fan-in | Sinon le fan-in part trop tôt |
| Limiter les jetons de chaque agent sur un modèle partagé | llm-token-limit avec counter-key par agent ou application |
429 au débit, 403 au quota |
| Classer 200 000 documents sans gêner le trafic en ligne | Global Batch | Quota en file séparé, 24 h, -50 % |
| Intégrer l'agent d'un éditeur construit avec un autre framework | A2A (outil a2a 1.0 GA) |
Agent card, interopérabilité |
| Exposer une base de connaissances à plusieurs agents | MCP (ou toolbox) | C'est un outil, pas un pair |
| L'appel A2A doit respecter les droits de l'utilisateur | Connexion user-entra-token |
L'identité de l'utilisateur est transmise |
| Appeler un agent Foundry en A2A | agentic-identity, audience https://ai.azure.com, rôle Foundry Agent Consumer, incoming A2A activé |
Carte anonyme impossible côté Foundry |
| L'éditeur protège le chemin de son agent card | send_credentials_for_agent_card: true |
Défaut false, carte lue anonymement |
| Agent A2A hébergé hors Foundry à gouverner | Register dans Foundry Control Plane | URL proxy, AI gateway |
| Graphe LangGraph existant, veut des agents Foundry et le tracing | langchain-azure-ai : AgentServiceFactory, AzureAIOpenTelemetryTracer |
Pas de réécriture |
| Approbation dans LangGraph | require_approval="always" + checkpointer + Command(resume=...) |
Interrupt et reprise par thread_id |
| Modèle Hugging Face introuvable dans Foundry | Modèle gated, trust_remote_code, pas Safetensors, licence, quota GPU, région |
Critères de la collection |
| Router sans appel LLM, latence minimale | Pipeline Transformers dans un executor | Modèle spécialisé local |
| Journaliser chaque appel d'outil de tous les agents | Function middleware agent-level | Une fois, réutilisé partout |
| Chat middleware appelé plus de fois que prévu | Normal : une fois par appel de modèle, y compris après chaque résultat d'outil | Il tourne dans la boucle d'outils |
| Bloquer une requête dans un middleware | Remplir context.result et ne pas appeler call_next() (ou MiddlewareTermination) |
Arrête la chaîne |
| Le modèle voit le texte complet des exceptions | include_detailed_errors passé à True : le remettre à False |
Fuite possible de données sensibles |
11. Scénarios d'entraînement#
1. Une banque veut un assistant qui répond aux conseillers sur les produits, la conformité et les sinistres. Trois équipes possèdent chacune leurs données ; aucune ne doit voir celles des autres. L'ordre des étapes n'est pas connu à l'avance.
Orchestrator-subagent : un orchestrateur appelle trois subagents comme outils (
as_tool()), chacun avec sa propre identité et ses droits sur ses seules données ; l'orchestrateur ne voit que les résultats. La séparation des données justifie le multi-agents.
2. Un centre de support : le triage oriente vers commandes ou retours ; un remboursement n'est possible qu'après un retour ; l'utilisateur dialogue tout au long.
Handoff (peer-to-peer) avec
add_handoff(triage, [commandes, retours]),add_handoff(retours, [remboursements])et retours vers le triage ; outil de remboursement enapproval_mode="always_require";termination_conditionexplicite.
3. Une analyse de lancement produit doit combiner marché, juridique et finance, le plus vite possible, puis produire une synthèse unique.
Parallel :
ConcurrentBuilderavec un aggregator personnalisé (with_aggregator) qui résout les contradictions ; surveiller le quota (pic de jetons) et éviter tout état mutable partagé.
4. Une remédiation d'incident n'a pas de procédure connue ; l'équipe SRE veut valider le plan avant toute action et que le système replanifie s'il n'avance plus.
Magentic avec
enable_plan_review=True(approve ou revise),max_stall_countpour replanifier,max_reset_countetmax_round_countpour borner ; checkpoints pour la reprise.
5. Une demande de virement validée par un manager arrive parfois deux jours après ; le service redémarre chaque nuit.
Outil de virement en
approval_mode="always_require", checkpoint storage durable (CosmosCheckpointStorageavec managed identity et RBAC) ; à la réponse,run(checkpoint_id=...)puisrun(responses=...). Interdire le chargement de checkpoints d'une autre source.
6. Quarante agents interrogent le même modèle ; une FAQ interne représente 30 % des questions, souvent reformulées ; les locataires ne doivent jamais voir les réponses des autres.
Semantic cache dans API Management (
llm-semantic-cache-lookupen inbound,-storeen outbound, Azure Managed Redis),vary-bypar locataire,score-thresholdstrict (vers 0.05),ignore-system-messages="true",rate-limitaprès le lookup, TTL de quelques heures ; clé ou index versionné avec le modèle et le prompt.
7. Après le passage à un nouveau modèle, le cache sémantique renvoie des réponses dans l'ancien format.
Cache non versionné : inclure l'identifiant du modèle, du modèle d'embeddings et la version du prompt template dans l'index, la clé ou le
vary-by, puis purger.
8. Un orchestrateur crée un subagent par document reçu ; un lot de 3 000 documents fait exploser le quota et les coûts.
Borner le nombre (fan-out plafonné, file et sémaphore dans l'executor de découpage), la profondeur (pas de
as_tool()chez les subagents), le budget (max_function_calls,max_duration_seconds,llm-token-limitpar application) ; si le traitement n'est pas interactif, passer en Global Batch.
9. L'agent de facturation d'un prestataire, construit avec un autre framework, doit être appelé par l'agent Foundry de l'entreprise, avec les droits de l'utilisateur qui pose la question.
A2A : outil
a2a(1.0, GA) avec une connexionuser-entra-token; carte lue anonymement sauf si le prestataire la protège (send_credentials_for_agent_card) ; réponse filtrée par les guardrails de tool response ; approbation si l'agent distant peut agir.
10. Une équipe a un graphe LangGraph en production ; elle veut appeler un agent configuré dans Foundry à l'une des étapes et voir l'ensemble dans les traces Foundry.
langchain-azure-ai:AgentServiceFactory(...).get_agent_node(name=..., version=...)comme nœud du graphe,AzureAIOpenTelemetryTracer(agent_id=...)en callback, puis enregistrement dans Foundry Control Plane (AI gateway requise).
11. Le routage des demandes par un LLM coûte cher et ajoute 800 ms ; les catégories sont stables et un jeu de données étiqueté existe.
Classifieur Hugging Face Transformers fine-tuné, exécuté par un pipeline dans l'executor de routage (ou servi par un managed online endpoint Azure ML) ; edges conditionnels vers les agents ; vérifier licence, Safetensors, absence de
trust_remote_code.
12. Toute la solution doit journaliser chaque appel d'outil, refuser les outils financiers aux non-approbateurs et retenter les erreurs transitoires, sans modifier le code de chaque agent.
Trois middleware empaquetés une fois et enregistrés agent-level sur tous les agents : function middleware de journal, function middleware d'autorisation (rôles passés par
function_invocation_kwargs), function middleware de reprise avec repli ;include_detailed_errors=False; limites globales et semantic cache dans la passerelle.
12. Pour aller plus loin#
- Agent Hooks (Agent Framework) : une frontière de contrôle fail-closed sur les trois couches de middleware, avec barrières de streaming et de persistance.
- Functional workflows (
@workflow,@step, expérimental) : même modèle d'exécution, écriture en Python natif, cache des résultats par step. - Durable workflows et AG-UI : exposer un workflow à une interface (événements, requêtes humaines) ; voir la doc Agent Framework (intégrations UI).
- AI agent orchestration patterns et Dynamic AI agents at scale (Centre des architectures Azure) : variantes, sélection d'agents parmi des centaines, contexte multi-tours en cache.
- Multi-Agent Custom Automation Engine (accélérateur GitHub de l'architecture citée par le guide) : déploiement complet Container Apps, Foundry, Cosmos DB.
- Prompt flow vers Agent Framework : guide de migration (motifs fan-out, fan-in, handoff par edges conditionnels), avant le retrait du 20/04/2027.
13. Fiche à retenir#
- Niveau le plus simple d'abord : direct model call → single agent with tools → multiagent ; multi-agents justifié par la spécialisation, la sécurité ou le parallélisme.
- Hub-and-spoke = star topology (group chat, magentic, routeur central) ; orchestrator-subagent = agents comme outils (
as_tool()) ; peer-to-peer = handoff (mesh) ou pairs A2A ; sequential ; parallel =ConcurrentBuilderou fan-out / fan-in. - Handoff :
add_handoff,with_start_agent,request_infosi pas de transfert, mode autonome expérimental (50 tours par défaut),enable_return_to_previous. - Group chat :
selection_func,termination_condition, 3 agents au plus ; maker-checker = plafond + repli. - Magentic :
max_round_count,max_stall_count,max_reset_count,enable_plan_review(approve/revise). - HITL : approval (
approval_mode="always_require",function_approval_request), override (request_info+@response_handler, plan review), edge cases (plafonds, stall, erreurs → escalade). - Checkpoints à la fin de chaque superstep (état, messages, requêtes en attente) ;
FileCheckpointStorage(storage_path=...),CosmosCheckpointStorage; repriserun(checkpoint_id=...)puisresponses; stockage = frontière de confiance. - Caches : response (exact), semantic (proche), prompt (préfixe, côté modèle) ; statique en tête du prompt.
-
llm-semantic-cache-lookup(inbound) /-store(outbound,duration) ;score-threshold0 à 1, plus bas = plus strict, départ 0.05, > 0.2 risqué ;vary-by;rate-limitaprès le lookup ; Azure Managed Redis par chaîne de connexion. -
cache-lookup/cache-store= GET identiques seulement ; clé maison parcache-lookup-valueou Redis applicatif. - Partitionner, versionner (modèle, embeddings, prompt, outils, politique), TTL par usage, mesurer le gain net.
- Limites :
max_iterations40 (outils),max_function_calls,max_duration_seconds,allow_concurrent_invocation; workflowmax_iterations100 ;llm-token-limit(429 / 403, compteur par gateway). - Supersteps BSP : parallèle dans un superstep, barrière entre supersteps ; regrouper une chaîne dans un executor ; tout fan-out dans le fan-in.
- Spawning : borner profondeur, nombre, budget ; Global Batch (24 h, -50 %, quota séparé) pour le volume.
- A2A : agent card, tasks ; outil
a2a1.0 GA,a2a_preview0.3 ; auth : none, custom-keys, oauth2, user-entra-token, project-managed-identity, agentic-identity ;send_credentials_for_agent_card(défaut false). - Exposer : incoming A2A Foundry (Entra obligatoire, Foundry Agent Consumer), Foundry Control Plane (URL proxy, AI gateway),
A2AExecutorauto-hébergé. - A2A = un pair ; MCP = un outil ; toolbox = A2A exposé en MCP.
- LangGraph :
langchain-azure-ai,AgentServiceFactory,get_agent_node,create_prompt_agent,Command(resume=...),AzureAIOpenTelemetryTracer. - Hugging Face : pipeline dans un executor, Foundry managed compute (preview, GPU, pas de gated, Safetensors, pas de
trust_remote_code), Azure ML online / batch endpoint, serveur compatible OpenAI parbase_url. - Middleware : agent, function, chat (une fois par appel de modèle) ;
call_next(); bloquer =context.resultsanscall_next()ouMiddlewareTermination; agent-level enveloppe run-level ;include_detailed_errors=False.
Références#
Toutes lues le 22/10/2026 sur Microsoft Learn :
- Study guide for Exam AI-500 (en anglais)
- AI agent orchestration patterns
- Build a multiple-agent workflow automation solution by using Microsoft Agent Framework
- Dynamic AI agents at scale pattern
- Agent Framework : Workflow orchestrations (Concurrent, Handoff, Group Chat, Magentic)
- Agent Framework : Agents as tools
- Agent Framework : Human-in-the-loop et Checkpoints
- Agent Framework : Workflow Builder & Execution (supersteps) et Edges
- Agent Framework : Using function tools (limites d'invocation)
- Agent Framework : Agent Middleware et Agent pipeline architecture
- Agent Framework : A2A agent service et Host agents with A2A
- Connect to an A2A agent endpoint from Foundry Agent Service
- Agent2Agent (A2A) authentication
- Enable incoming A2A on a Foundry agent
- Enable semantic caching for LLM APIs in Azure API Management
- llm-semantic-cache-lookup policy et llm-semantic-cache-store policy
- Tutorial: Use Azure Managed Redis as a semantic cache
- Caching overview (API Management) et Use an external Redis-compatible cache
- llm-token-limit policy
- Getting started with Azure OpenAI batch deployments
- Use Foundry Agent Service with LangGraph et Trace LangChain and LangGraph apps
- Hugging Face models in Microsoft Foundry
- Deploy models from Hugging Face hub to Azure Machine Learning online endpoints
- What are Hugging Face Transformers? (Azure Databricks)
- Agent Framework : Ollama et OpenAI-compatible endpoints
- Audit, rebuild, and validate your Prompt Flow workflow in Microsoft Agent Framework