

Version : 1.1 · Date : 2026-10-21 · Domaine 5 : Context Management & Reliability (15 %)
En une phrase : un agent fiable ne garde dans son contexte que ce qui sert, protège les faits critiques du résumé, escalade sur des critères explicites, remonte ses erreurs sans les cacher ni tout arrêter, et conserve la source de chaque affirmation jusqu'au rapport final.
Ce que l'examen demande#
Texte officiel du guide d'examen CCAR-F v1.0 (juillet 2026, Domain 5) :
| # | Task statement (guide officiel, en anglais) | Section |
|---|---|---|
| 5.1 | Manage conversation context to preserve critical information across long interactions | 2 |
| 5.2 | Design effective escalation and ambiguity resolution patterns | 3 |
| 5.3 | Implement error propagation strategies across multi-agent systems | 4 |
| 5.4 | Manage context effectively in large codebase exploration | 5 |
| 5.5 | Design human review workflows and confidence calibration | 6 |
| 5.6 | Preserve information provenance and handle uncertainty in multi-source synthesis | 7 |
Le Domain 5 pèse 15 %, mais il revient dans quatre des six scénarios de l'examen : Customer Support Resolution Agent (5.1, 5.2), Code Generation with Claude Code (5.4), Multi-Agent Research System (5.3, 5.6) et Structured Data Extraction (5.5). Les questions officielles d'exemple qui le touchent (n° 3 sur l'escalade, n° 8 sur le timeout d'un subagent) sont commentées au chapitre 06.
1. Les bases à maîtriser avant tout#
1.1 La fenêtre de contexte#
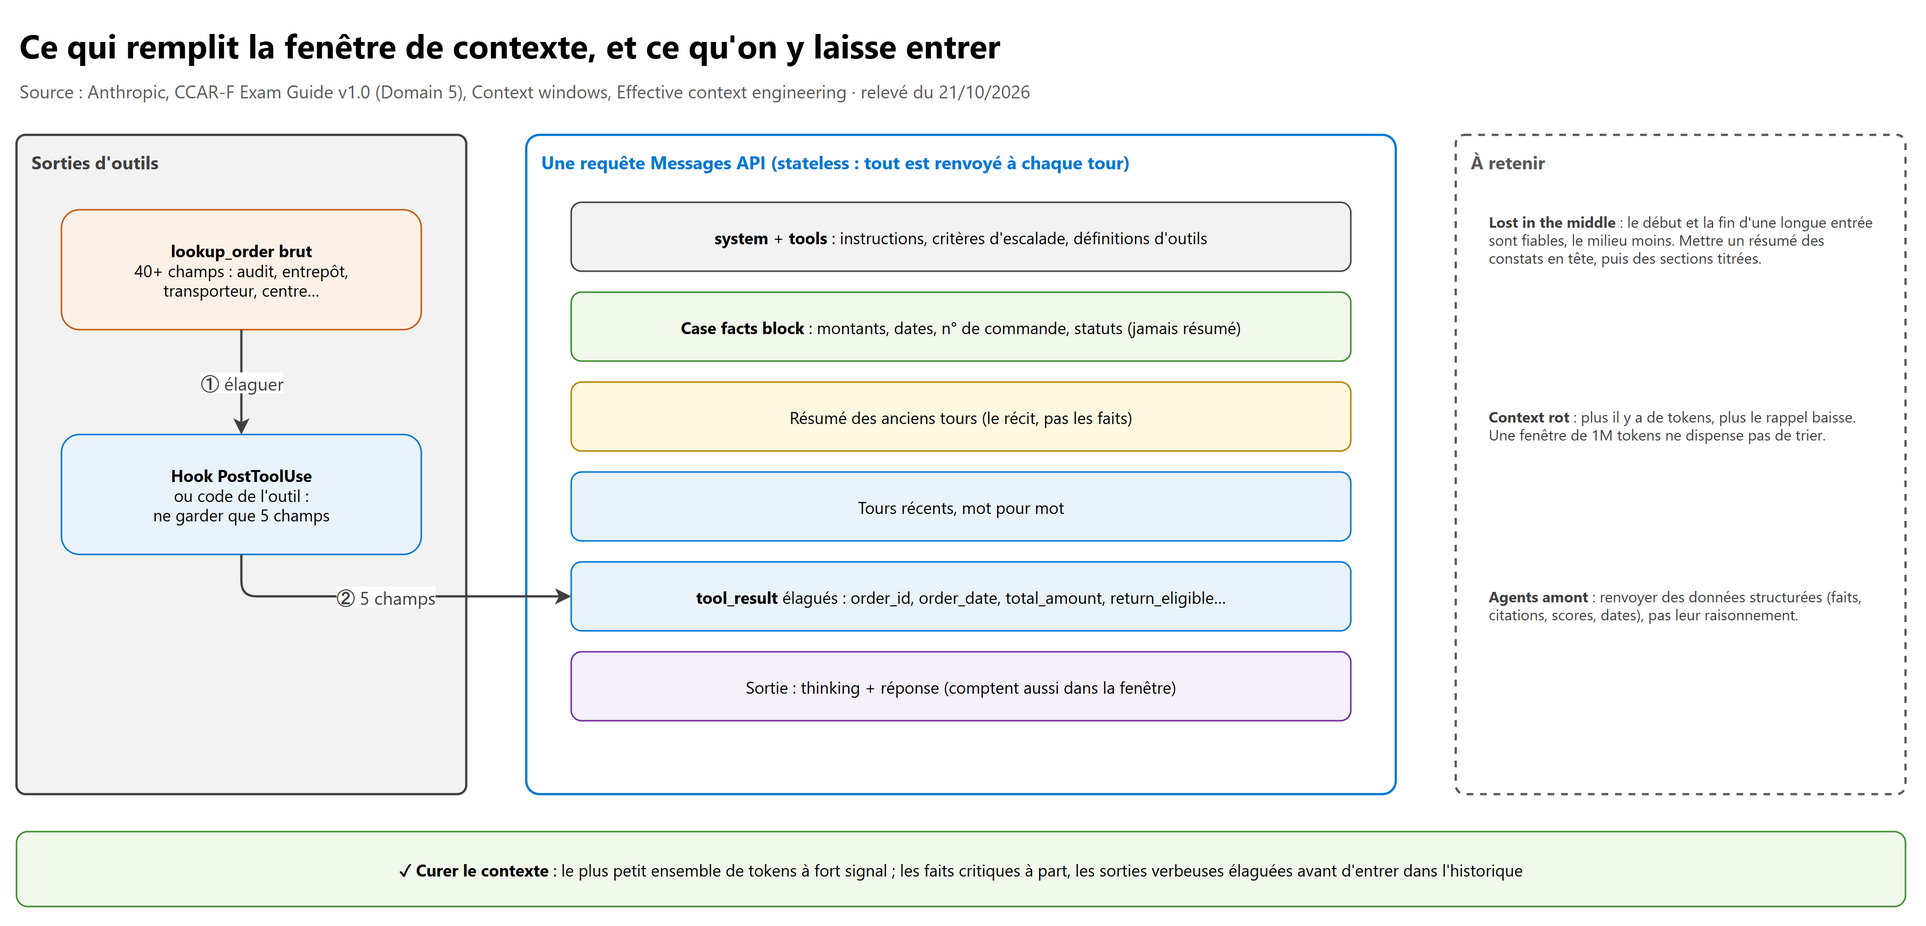
La context window est tout ce que Claude lit pour produire une réponse, réponse comprise : le system prompt, chaque
message de messages (avec les tool_result, images et documents), les définitions d'outils, puis la sortie du tour
(thinking compris). Chaque réponse indique ce qu'elle a consommé dans son champ usage.
| Fait | Ce qu'il implique pour l'architecte |
|---|---|
| La Messages API est stateless : aucun état de session côté serveur | chaque requête renvoie tout l'historique utile ; c'est l'application qui décide ce qu'il contient |
| Fenêtre de 1M tokens sur les modèles Claude 5 (Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5), 128k tokens de sortie | la place manque rarement ; c'est la qualité du contexte qui pose problème |
| Context rot : plus il y a de tokens, plus la précision et le rappel baissent (doc Context windows) | trier ce qui entre vaut autant que la taille de la fenêtre |
| Lost in the middle : début et fin d'une longue entrée sont fiables, le milieu moins (guide 5.1) | ce qui compte se place en tête, sous des titres explicites |
Entrée trop longue : erreur 400 invalid_request_error ; sortie qui atteint la limite : stop_reason: "model_context_window_exceeded" |
à traiter dans la boucle agentique (chapitre 01) |
1.2 Fiabilité : la règle qui traverse tout le domaine#
Le guide pose un principe constant : une décision fiable se prend sur des données structurées et des critères explicites, pas sur une impression du modèle. On le retrouve partout :
- faits critiques dans un bloc structuré, pas dans un résumé en prose (5.1) ;
- escalade sur des déclencheurs définis, pas sur le sentiment ou une note de confiance (5.2) ;
- erreurs remontées avec leur type, leur tentative et leurs résultats partiels, pas un statut générique (5.3) ;
- constats d'exploration écrits dans un fichier, pas laissés dans un historique qui s'enfouit (5.4) ;
- confiance calibrée sur des données étiquetées, pas des scores bruts (5.5) ;
- affirmations reliées à leur source et à leur date, pas paraphrasées (5.6).
2. TS 5.1 : Préserver les faits critiques dans les longues conversations#
Ce que l'examen teste : un agent qui « oublie » un montant ou une date après un résumé ; la bonne réponse est presque toujours le case facts block.
2.1 Le piège du résumé progressif#
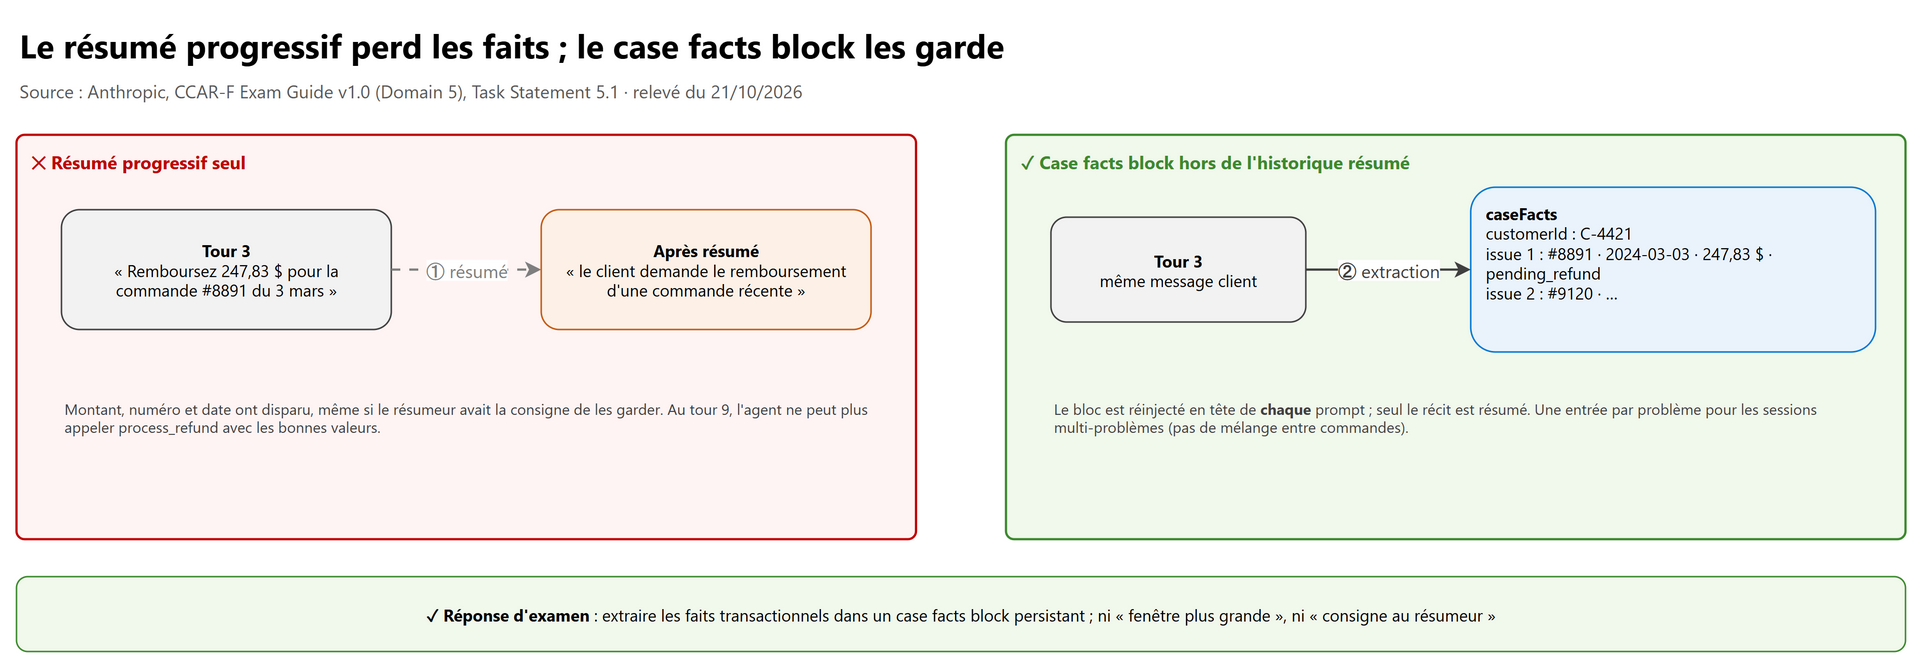
Le progressive summarization remplace les anciens tours par un résumé pour gagner de la place. Il écrase précisément ce qui compte : valeurs numériques, pourcentages, dates et attentes exprimées par le client. « Remboursez 247,83 $ pour la commande #8891 du 3 mars » devient « le client demande le remboursement d'une commande récente ». Demander au résumeur de « tout garder mot pour mot » ne suffit pas : c'est la compression elle-même qui perd l'information.
2.2 Le case facts block#
On extrait les faits transactionnels (montants, dates, numéros de commande, statuts) dans un bloc structuré, inclus dans chaque prompt, en dehors de l'historique résumé. Le récit peut être résumé, les faits jamais.
import json
import anthropic

client = anthropic.Anthropic()  # la clé est lue dans ANTHROPIC_API_KEY, jamais écrite dans le code

case_facts = {
    "customerId": "C-4421",
    "issues": [  # une entrée par problème : pas de mélange entre commandes dans une session multi-problèmes
        {"orderId": "#8891", "orderDate": "2024-03-03", "refundAmount": "247.83 USD", "status": "pending_refund"},
        {"orderId": "#9120", "orderDate": "2024-04-11", "issue": "colis endommagé", "status": "replacement_requested"},
    ],
}

def appeler_agent(historique_resume, tours_recents, message):
    systeme = [
        {"type": "text", "text": INSTRUCTIONS_SUPPORT},  # rôle, politique, critères d'escalade (section 3)
        {"type": "text", "text": "## Case facts (source de vérité, ne jamais résumer)\n"
                                 + json.dumps(case_facts, ensure_ascii=False, indent=2)},
        {"type": "text", "text": "## Résumé des échanges précédents\n" + historique_resume},
    ]
    return client.messages.create(
        model="claude-sonnet-5-5", max_tokens=2048, system=systeme,
        messages=tours_recents + [{"role": "user", "content": message}],
        tools=OUTILS_SUPPORT,
    )
Le bloc est mis à jour par le code de l'application (à partir des tool_result de lookup_order ou process_refund), pas par
le modèle qui reformule.
2.3 Lost in the middle : une correction de structure#
Quand un agent de synthèse reçoit de longs résultats agrégés, on place en tête un résumé des constats clés, puis les résultats détaillés sous des titres de section explicites. Ajouter « lis tout attentivement » au prompt ne corrige pas un effet de position.
## Résumé des constats clés
- Source A : marché en hausse de 12 % (données 2023)
- Source B : dépôts de brevets +34 % sur un an
## Constats détaillés
### Source A : rapport de marché
…
2.4 Élaguer les sorties d'outils avant qu'elles s'accumulent#
Un lookup_order peut renvoyer plus de 40 champs (horodatages d'audit, codes d'entrepôt, transporteur…) alors que 5 suffisent
pour un remboursement. Une fois dans l'historique, ces tokens sont renvoyés à chaque tour suivant. On réduit la sortie dans
l'implémentation de l'outil, ou par un hook PostToolUse (chapitre 01), avant qu'elle entre
dans le contexte :
CHAMPS_REMBOURSEMENT = ("order_id", "order_date", "total_amount", "return_eligible", "item_description")

def lookup_order(order_id: str) -> dict:
    brut = api_commandes.get(order_id)  # 40+ champs
    return {k: brut[k] for k in CHAMPS_REMBOURSEMENT if k in brut}
2.5 Historique complet et agents amont#
- Historique complet : l'API étant stateless, on renvoie l'historique à chaque requête pour garder la cohérence. Le conflit avec la taille se règle en séparant les faits (bloc persistant) du récit (résumable), pas en supprimant des tours au hasard.
- Agents amont : dans un système multi-agents, un subagent renvoie des données structurées (faits, citations, scores de pertinence) avec leurs métadonnées (date, emplacement de la source, méthode), pas son raisonnement complet. L'agent aval, au budget de contexte limité, n'a pas à reparser de la prose.
Réponse d'examen / état actuel
- Examen : case facts block, résumé des constats en tête, sorties d'outils élaguées, historique complet.
- Aujourd'hui : l'API propose la compaction côté serveur (le modèle résume les anciens tours ; beta : compaction par seuil avec l'en-tête
compact-2026-01-12et l'editcompact_20260112, déclenchée par défaut vers 150K tokens ; compaction à la demande avec le paramètrecompaction, en-têtecompact-2026-09-04; il faut renvoyerresponse.contenten entier pour garder le bloccompaction) et le context editing (clear_tool_uses_20250919,clear_thinking_20251015, betacontext-management-2025-06-27) qui efface les ancienstool_resultpassé un seuil (trigger), en gardant les derniers (keep) et certains outils (exclude_tools). Le memory tool (memory_20250818) persiste des fichiers hors contexte ; combiné au context editing, Claude est averti avant l'effacement pour sauvegarder l'essentiel. Ces fonctions automatisent les principes du guide : elles ne remplacent pas le case facts block pour les valeurs exactes.- Le prompt caching réduit le coût du préfixe stable, mais les tokens en cache comptent toujours dans la fenêtre. À l'examen, seule son existence est au programme.
3. TS 5.2 : Escalade et résolution des ambiguïtés#
Ce que l'examen teste : quand transférer à un humain, quand résoudre seul, et reconnaître les deux faux signaux. Une mauvaise calibration fait chuter la résolution au premier contact (objectif de 80 % dans le scénario officiel).
3.1 Les déclencheurs#
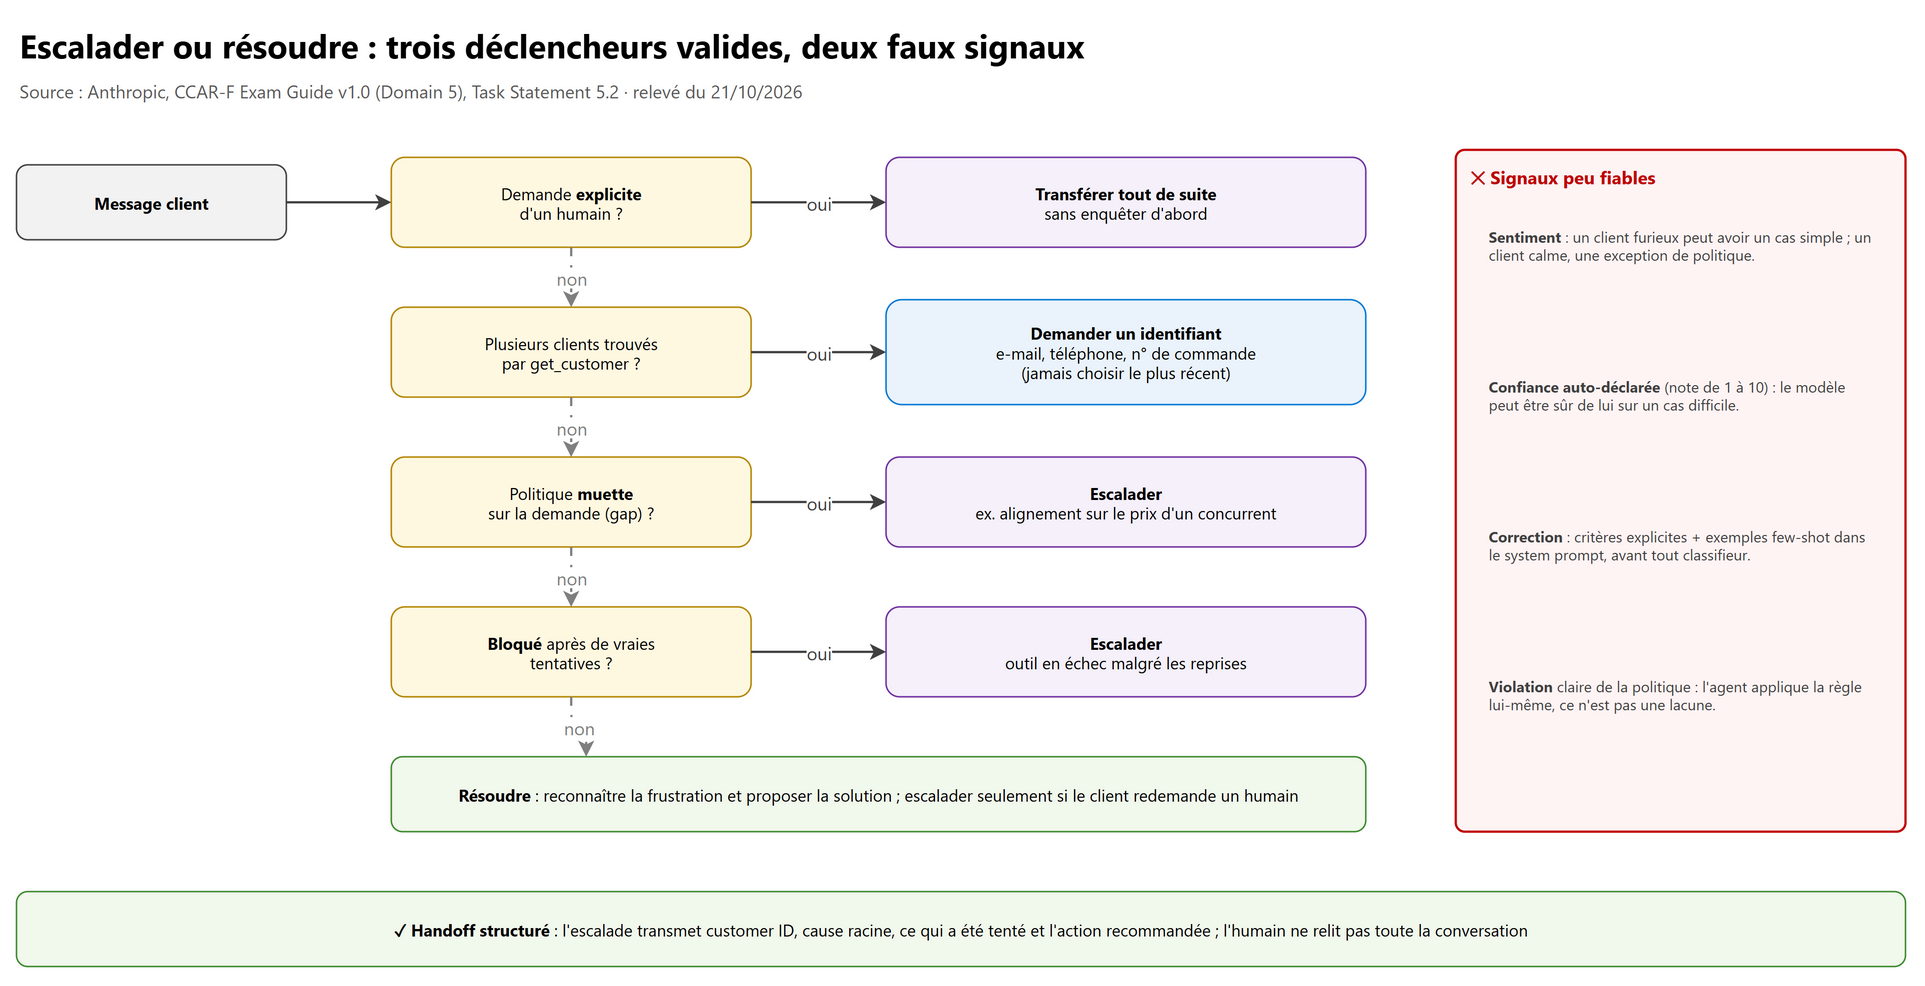
| Déclencheur | Valide ? | Comportement attendu |
|---|---|---|
| Le client demande explicitement un humain | oui | transférer immédiatement, sans enquêter d'abord |
| Policy gap : la politique ne dit rien du cas (ex. alignement sur le prix d'un concurrent alors que la politique ne couvre que les ajustements sur le site) | oui | escalader |
| Policy violation : la politique répond clairement (ex. retour hors délai) | non | l'agent applique la règle lui-même |
| L'agent est bloqué après de vraies tentatives (outil en échec malgré les reprises, accès manquant) | oui | escalader en disant ce qui a été tenté |
| Sentiment négatif, frustration | non | la frustration ne mesure pas la complexité : reconnaître l'émotion et proposer la solution ; escalader seulement si le client réitère sa demande d'humain |
| Note de confiance auto-déclarée (« de 1 à 10 ») | non | le modèle est mal calibré : il peut être sûr de lui sur un cas difficile |
3.2 Plusieurs correspondances : demander, ne pas deviner#
Si get_customer renvoie trois « John Smith », l'agent demande un identifiant supplémentaire (e-mail, téléphone, numéro
de commande). Choisir le plus récent ou le plus actif risque d'exposer les données d'un client à un autre ou d'agir sur le
mauvais compte.
3.3 La correction proportionnée : critères explicites et few-shot#
Avant tout classifieur ou analyse de sentiment, on écrit dans le system prompt des critères explicites avec des exemples
few-shot : quand escalader, quand résoudre, et le format exact du transfert.
## Escalade
Escalade vers un humain (outil escalate_to_human) seulement si :
1. le client demande un humain : transfère tout de suite, sans enquête ni proposition préalable ;
2. la politique ne couvre pas la demande (ex. prix d'un concurrent) ;
3. tu ne peux pas progresser malgré des tentatives réelles (outil en échec après reprises).
Ne jamais escalader sur la seule frustration du client, ni sur ta propre impression de confiance.
Si get_customer renvoie plusieurs clients, demande l'e-mail ou le numéro de commande ; ne choisis jamais toi-même.

Exemple A : « Votre colis est en retard, c'est inadmissible ! » → reconnaître la gêne, proposer réexpédition et geste
commercial. Pas d'escalade.
Exemple B : « Je veux parler à quelqu'un. » → escalate_to_human immédiatement.
Le transfert est un handoff structuré : l'humain ne relit pas toute la conversation.
{"customer_id": "C-4421", "root_cause": "demande d'alignement sur le prix d'un concurrent, hors politique",
 "attempted": ["vérification de la commande #9120", "politique de prix consultée"],
 "case_facts": {"orderId": "#9120", "amount": "189.00 USD"}, "recommended_action": "décision commerciale sur l'alignement"}
Réponse d'examen / état actuel : rien n'a changé. Côté outillage, l'Agent SDK sait demander une approbation ou une information à l'utilisateur pendant l'exécution (chapitre 01), mais la décision d'escalader reste pilotée par les critères du prompt et, pour les règles absolues, par un contrôle programmatique (hook).
4. TS 5.3 : Propager les erreurs dans un système multi-agents#
Ce que l'examen teste : le contexte d'erreur structuré, les deux anti-patterns et la différence entre échec d'accès et résultat vide valide (c'est là que la plupart des candidats se trompent, selon le site).
4.1 Le contexte d'erreur structuré#
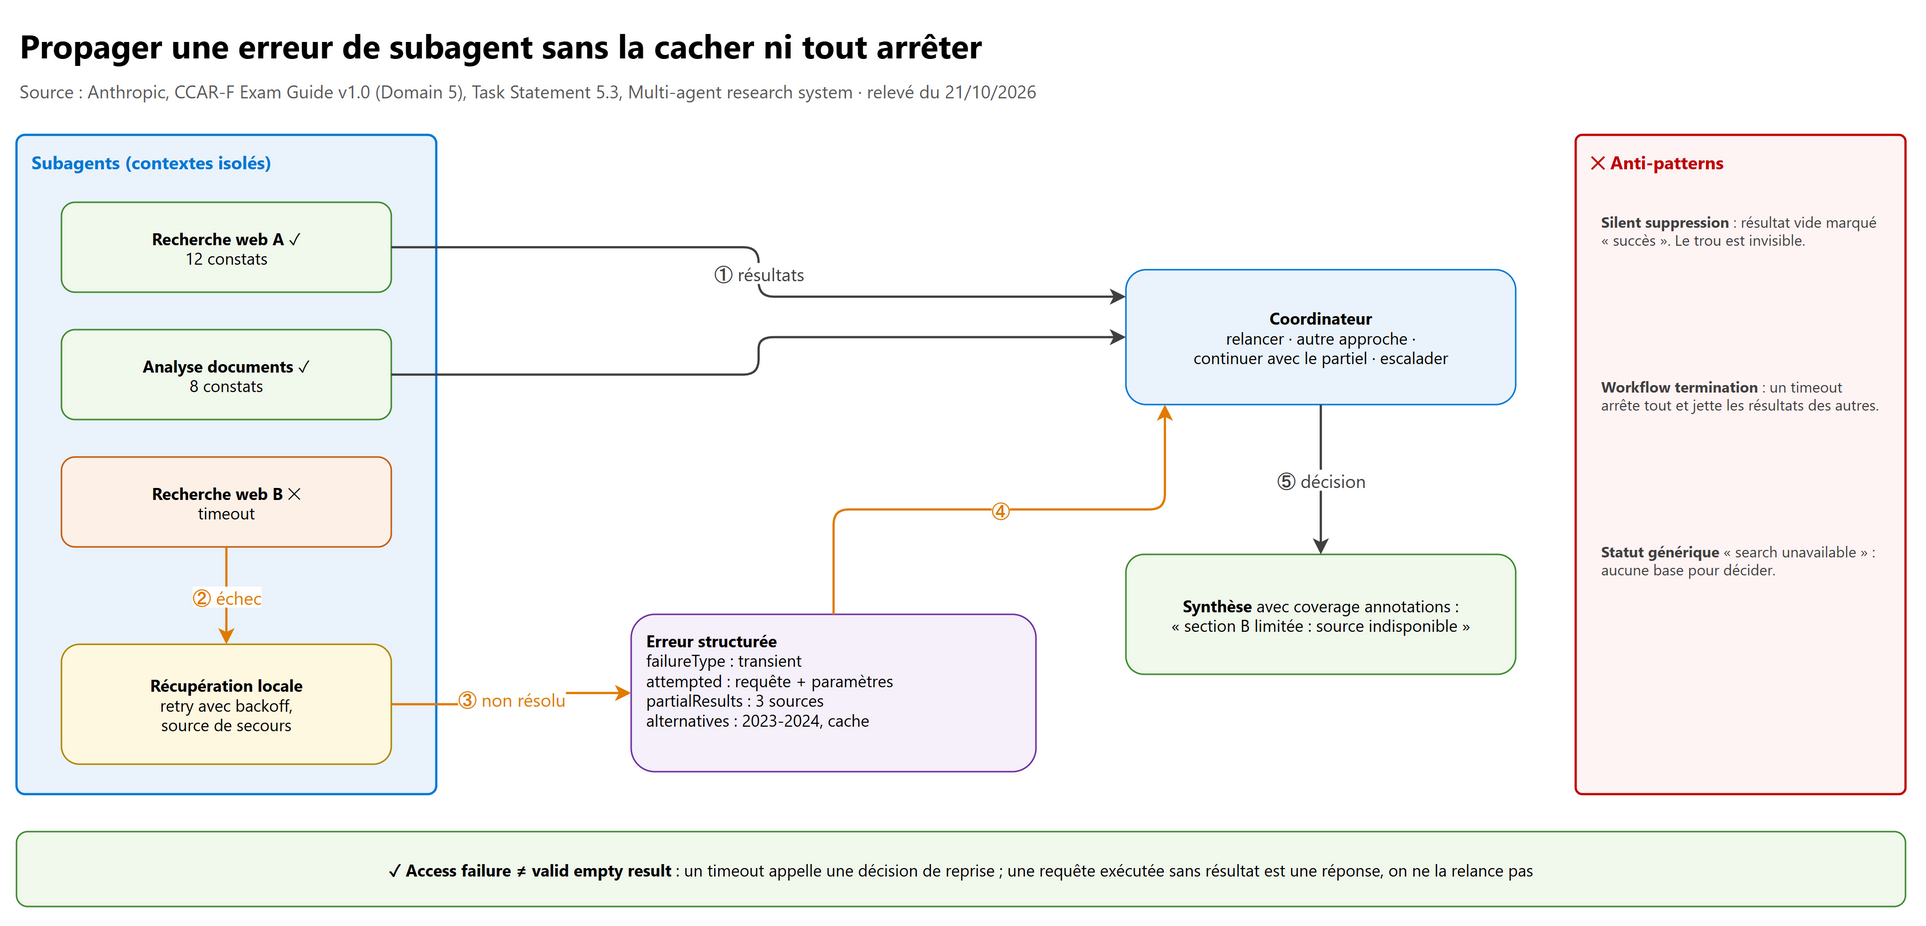
Un subagent en échec renvoie quatre informations, sans lesquelles le coordinateur ne peut pas décider :
| Élément | Contenu | Pourquoi |
|---|---|---|
| Failure type | transient (timeout, limite), validation (entrée invalide), business (règle métier), permission (accès refusé) |
chaque type appelle une réaction différente |
| Attempted | requête exacte, paramètres, système visé | on ne corrige pas une requête qu'on ne voit pas |
| Partial results | ce qui a été obtenu avant l'échec | 3 sources sur 5 restent utiles |
| Alternatives | autre source, plage élargie, cache | le subagent connaît son domaine |
{"status": "partial_failure", "failureType": "transient",
 "attempted": {"tool": "search_academic_db", "query": "politique énergies renouvelables", "dateRange": "2022-2024"},
 "partialResults": [{"claim": "Directive UE 2023 sur les renouvelables", "source": "EUR-Lex", "publicationDate": "2023-10-31"}],
 "alternatives": ["réduire la plage à 2023-2024", "interroger government_publications", "réutiliser le cache de la session"],
 "isRetryable": true}
Côté outil MCP, le même principe passe par isError et des catégories d'erreur (chapitre 02).
4.2 Échec d'accès ou résultat vide valide#
| Access failure | Valid empty result | |
|---|---|---|
| Ce qui s'est passé | la source n'a pas été atteinte (timeout, connexion, permission) | la requête a été exécutée, rien ne correspond |
| Signification | on ne sait pas | « il n'y en a pas » est la réponse |
| Décision | envisager une reprise ou une alternative | ne pas relancer |
| Erreur classique | le transformer en « 0 résultat » : le coordinateur conclut à tort | le relancer en boucle |
4.3 Deux anti-patterns, un juste milieu#
- Silent suppression : attraper le timeout et renvoyer une liste vide marquée « succès ». Le pire : le trou est invisible (« aucune commande trouvée » alors que le service était en panne).
- Workflow termination : un seul échec arrête tout le pipeline et jette le travail des autres subagents.
- Statut générique (« search unavailable ») après les reprises : mieux que rien, mais il cache la requête, les résultats partiels et les alternatives.
- Juste milieu : récupération locale dans le subagent (retry avec backoff, source de secours), puis propagation des seules erreurs non résolues, avec leur contexte ; la synthèse porte des coverage annotations (« section B limitée : source indisponible »).
sequenceDiagram
    participant C as Coordinateur
    participant S as Subagent recherche B
    participant W as Source web
    C->>S: Tâche avec requête et périmètre
    S->>W: Requête
    W--xS: Timeout
    S->>W: Retry avec backoff
    W--xS: Timeout
    S->>S: Essai de la source de secours, 3 sources obtenues
    S-->>C: Erreur structurée, transient, tentatives, résultats partiels, alternatives
    C->>C: Décide de continuer avec le partiel et de relancer sur 2023-2024
    C-->>C: Synthèse avec annotation de couverture
Réponse d'examen / état actuel : inchangé. Les subagents de Claude Code et de l'Agent SDK renvoient un résultat au parent ; c'est au prompt du subagent (et à ses outils) de produire ce contexte structuré.
5. TS 5.4 : Le contexte dans l'exploration d'une grosse base de code#
Ce que l'examen teste : le symptôme de la dégradation (l'agent parle de « patterns typiques » au lieu des classes qu'il a trouvées) et ses remèdes. Une fenêtre plus grande n'est pas la réponse : les détails sont enfouis, pas expulsés.
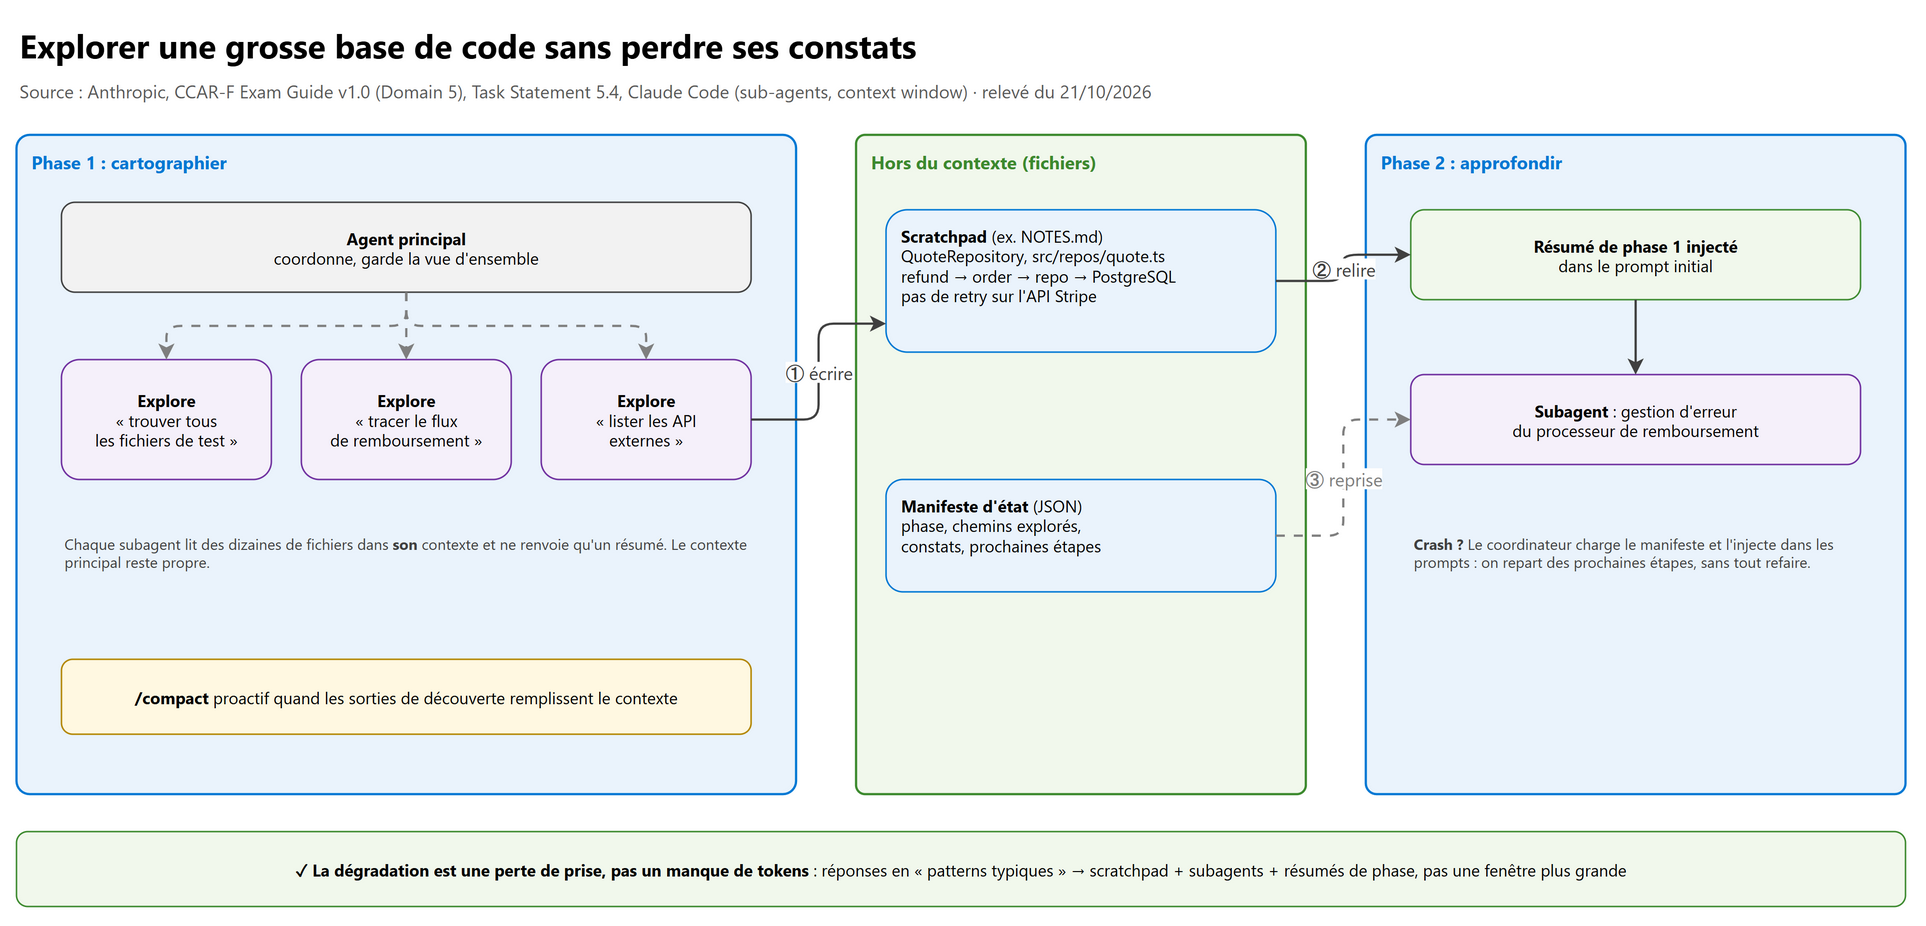
5.1 Les quatre outils du guide#
| Outil | Ce qu'il fait | Quand |
|---|---|---|
| Scratchpad file | l'agent écrit ses constats précis (classes, chemins, chaînes de dépendances) dans un fichier et le relit | dès le début de toute exploration longue, pas en urgence |
| Subagent delegation | une question ciblée (« trouver tous les fichiers de test », « tracer le flux de remboursement ») explorée dans un contexte isolé ; seul le résumé revient | pour isoler les sorties verbeuses ; l'intérêt est l'isolation, pas d'abord le parallélisme |
| Résumé de phase injecté | avant la phase 2, on résume les constats de la phase 1 et on les met dans le prompt initial des nouveaux subagents | sinon ils repartent à froid (un subagent n'hérite pas de l'historique) |
| State manifest | chaque agent exporte son état (phase, chemins explorés, constats, prochaines étapes) à un emplacement connu ; le coordinateur le charge à la reprise et l'injecte | reprise après crash ou épuisement du contexte |
Et /compact dans Claude Code, de façon proactive quand les sorties de découverte remplissent le contexte, pas
seulement à la limite.
{"sessionId": "explo-devis-01", "phase": 2,
 "exploredPaths": ["src/repos/quote.ts", "src/services/refund/*"],
 "findings": ["QuoteRepository implémente Repository<T>, cache dans findById", "pas de retry sur les échecs de l'API Stripe"],
 "nextSteps": ["examiner la gestion d'erreur de RefundProcessor"], "openQuestions": ["invalidation du cache ?"]}
sequenceDiagram
    participant U as Développeur
    participant C as Coordinateur
    participant F as Fichiers d'état
    participant S as Subagent phase 2
    C->>F: Écrit scratchpad et manifeste après chaque étape
    Note over C: Crash ou contexte épuisé
    U->>C: Relance l'exploration
    C->>F: Charge le manifeste
    C->>S: Prompt initial avec constats et prochaines étapes
    S-->>C: Résumé ciblé, sans refaire la phase 1
Réponse d'examen / état actuel
- Examen : scratchpad, subagents, résumés de phase, manifestes,
/compactproactif.- Aujourd'hui, dans Claude Code :
- l'auto-compaction se déclenche à l'approche de la limite.
/compact focus on …oriente le résumé./contextmontre la consommation par catégorie,/clearsert entre deux tâches sans rapport,/autocompactrègle le seuil ;- après compaction, le CLAUDE.md racine, la mémoire automatique et le plan sont réinjectés, ainsi que les 5 fichiers modifiés le plus récemment ;
- le subagent intégré Explore est en lecture seule et ne charge ni CLAUDE.md ni snapshot git ;
- un subagent repris (même session) garde tout son historique. Les subagents ont aussi leur propre auto-compaction.
- À l'examen, la réponse reste le manifeste pour la reprise après crash.
6. TS 5.5 : Revue humaine et calibration de la confiance#
Ce que l'examen teste : où mettre des relecteurs peu nombreux, et pourquoi une bonne moyenne ne justifie pas l'automatisation.
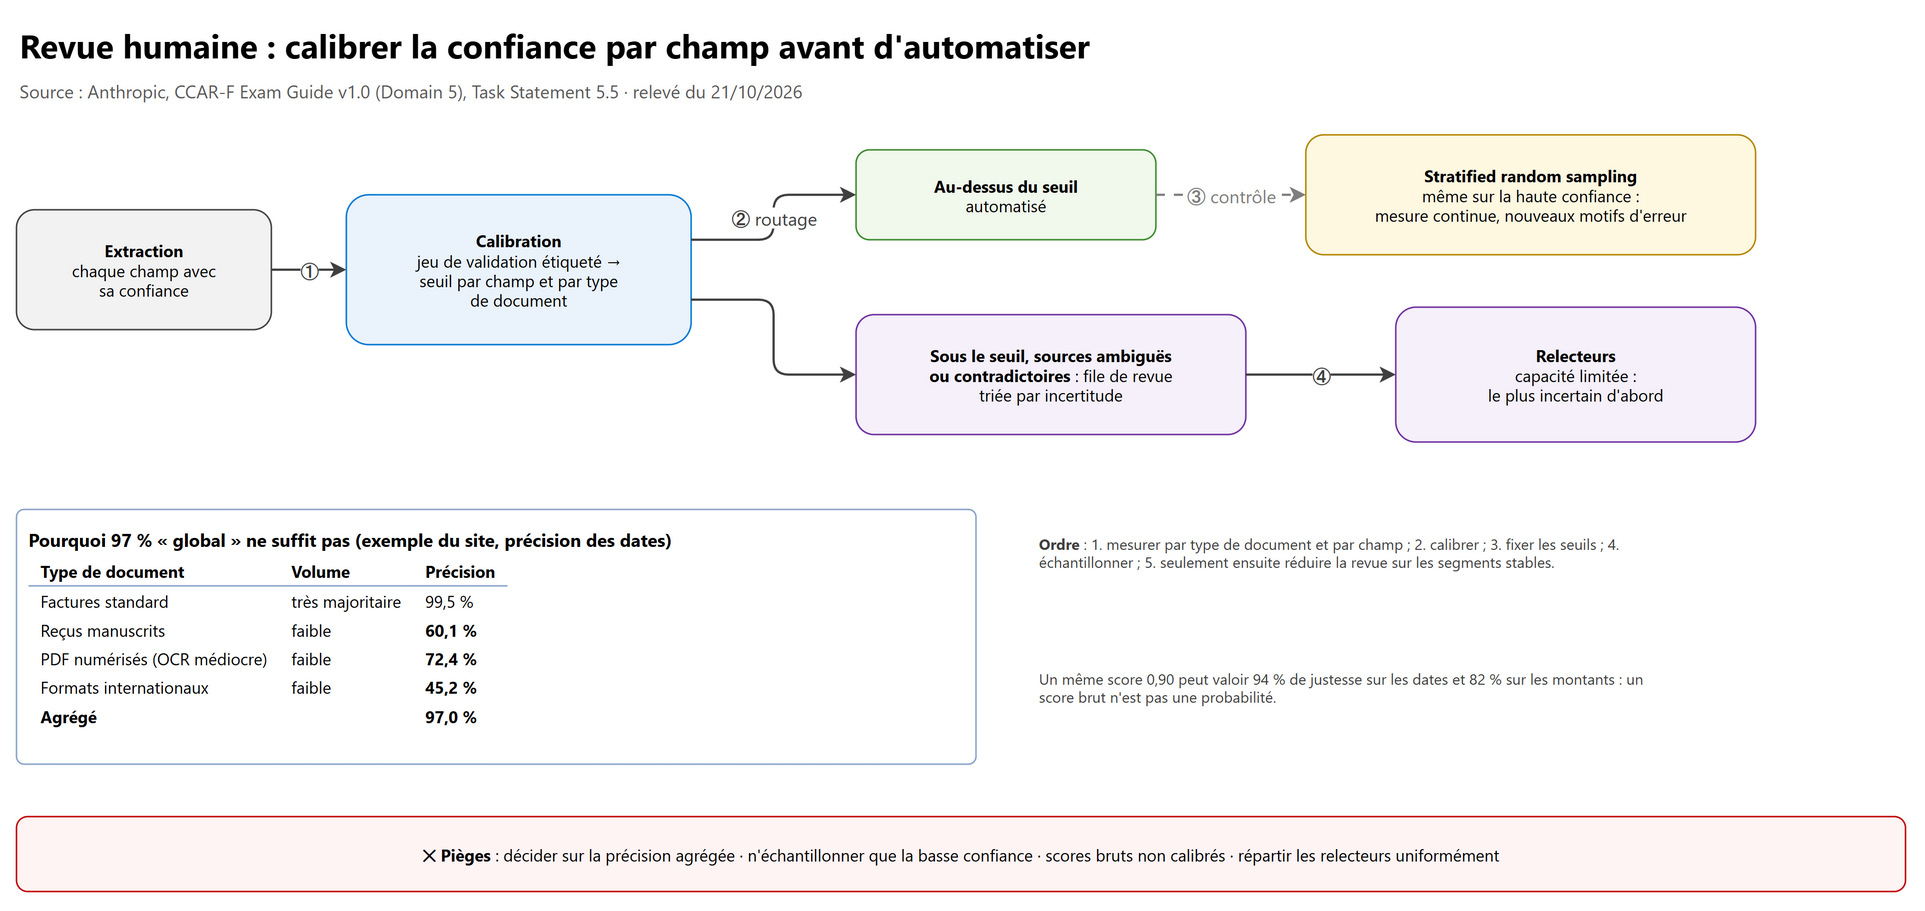
6.1 Le piège de la métrique agrégée#
97 % de précision globale peut cacher 45 % sur les formats internationaux, parce que les factures standard dominent le volume. On mesure par type de document et par champ avant toute décision.
6.2 La séquence à respecter#
- Mesurer la précision par segment (type de document × champ).
- Faire produire au modèle une confiance par champ, puis la calibrer sur un jeu de validation étiqueté (un 0,90 peut valoir 94 % de justesse sur les dates et 82 % sur les montants).
- Fixer des seuils calibrés par champ : au-dessus, automatisé ; en dessous, revue humaine.
- Mettre en place un stratified random sampling, y compris sur la haute confiance : c'est le seul moyen de détecter un nouveau motif d'erreur (nouvelle mise en page d'un fournisseur) dans ce que personne ne relit.
- Seulement ensuite, réduire la revue sur les segments qui restent stables.
{"vendorName": {"value": "Acme Corp", "confidence": 0.98},
 "invoiceDate": {"value": "2024-03-15", "confidence": 0.95},
 "totalAmount": {"value": "1247.83", "confidence": 0.72},
 "sourceConflict": {"value": true, "detail": "total imprimé ≠ somme des lignes"}}
6.3 Prioriser la capacité des relecteurs#
La file de revue est triée par incertitude et réordonnée en continu : confiance basse, documents sources ambigus ou contradictoires, types historiquement faibles. Répartir uniformément gaspille le temps sur ce que le modèle fait bien.
flowchart LR
    A["Extraction avec confiance par champ"] --> B{"Confiance au-dessus du seuil calibré du champ ?"}
    B -- "oui" --> C["Automatisé"]
    C --> D["Échantillon stratifié relu"]
    B -- "non" --> E["File de revue triée par incertitude"]
    F["Sources ambiguës ou contradictoires"] --> E
    E --> G["Relecteur suivant : l'élément le plus incertain"]
Réponse d'examen / état actuel : inchangé. Les structured outputs (GA) garantissent la forme du JSON, pas la justesse des valeurs (chapitre 04) : la calibration reste nécessaire.
7. TS 5.6 : Provenance de l'information et incertitude#
Ce que l'examen teste : garder l'attribution pendant la synthèse, gérer deux chiffres qui se contredisent, et ne pas prendre une différence de date pour une contradiction.
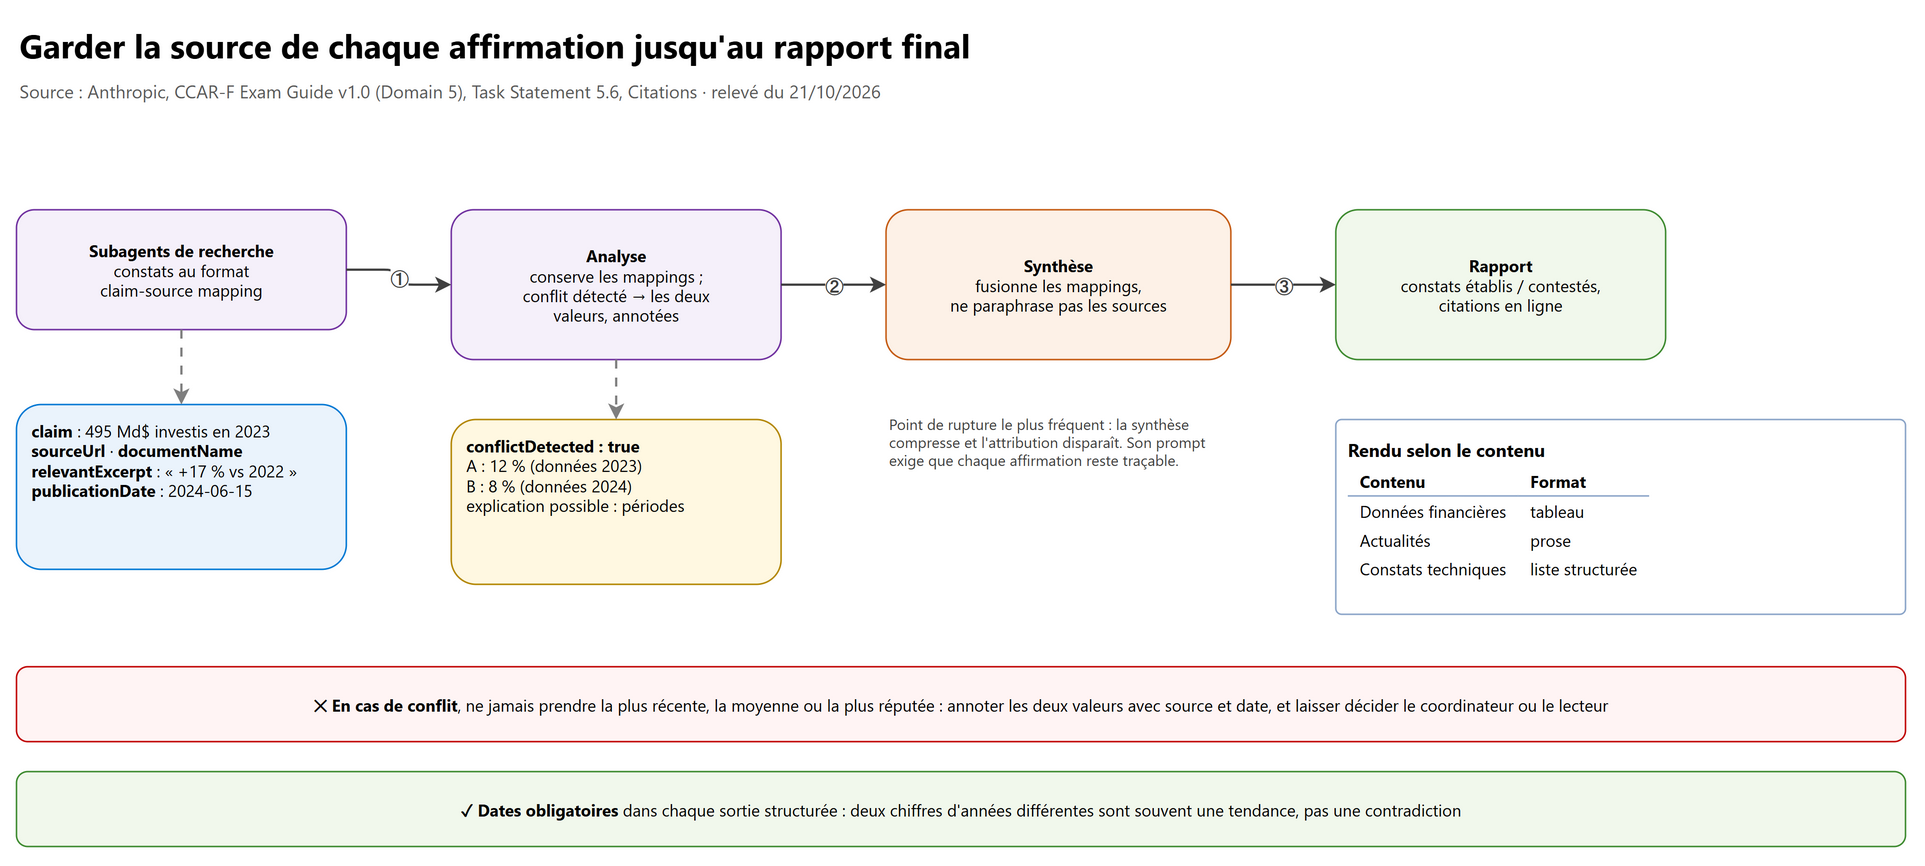
7.1 Le claim-source mapping#
Chaque constat est une donnée, pas une phrase : claim, sourceUrl, documentName, relevantExcerpt,
publicationDate. Les subagents le produisent, l'analyse et la synthèse le conservent et le fusionnent, le rapport le rend
en citations ou en section de références. Le point de rupture le plus fréquent est la synthèse, qui paraphrase : son prompt
exige que chaque affirmation reste traçable.
{"claim": "Les investissements mondiaux dans les renouvelables ont atteint 495 Md$ en 2023",
 "sourceUrl": "https://example.org/world-energy-investment-2024", "documentName": "World Energy Investment 2024",
 "relevantExcerpt": "… en hausse de 17 % par rapport à 2022 …", "publicationDate": "2024-06-15"}
7.2 Conflits et dates#
| Situation | ✕ À ne pas faire | ✓ À faire |
|---|---|---|
| Deux sources crédibles : 12 % et 8 % | garder la plus récente, faire la moyenne, garder la plus réputée | annoter le conflit avec les deux valeurs, leur source et leur date ; laisser décider le coordinateur ou le lecteur |
| 12 % (données 2023) et 8 % (données 2024) | conclure à une erreur de données | lire une évolution : d'où l'obligation des dates dans chaque sortie |
| Analyse qui trouve des valeurs incompatibles | trancher dans l'agent d'analyse | terminer l'analyse avec conflictDetected: true et les deux valeurs, puis transmettre |
| Rapport final | tout uniformiser (tout en tableau ou tout en prose) | données financières en tableau, actualités en prose, constats techniques en liste ; séparer constats établis et contestés |
Réponse d'examen / état actuel : la réponse attendue est le mapping structuré. Côté API, la fonction Citations (GA) renvoie, pour des blocs
documentaveccitations: {"enabled": true}, lecited_textexact et sa position (char_location,page_location,content_block_location), garantis valides et non comptés en tokens de sortie. Attention : Citations est incompatible avec les structured outputs (output_config.formatrenvoie une erreur 400).
8. Réponse d'examen et état actuel, en un coup d'œil#
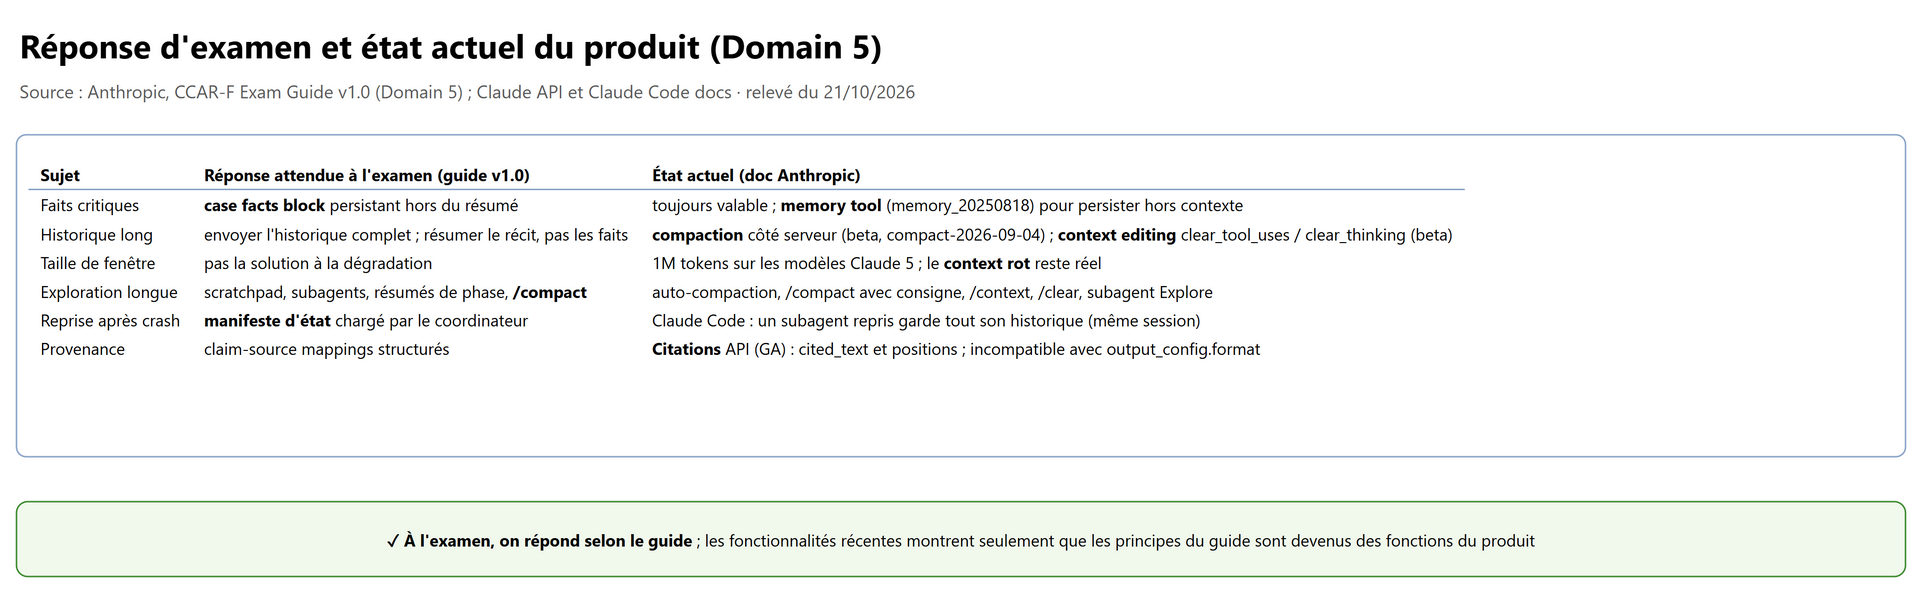
À l'examen, on répond selon le guide v1.0 (même si le produit a évolué). Les fonctions récentes (compaction, context editing, memory tool, reprise des subagents, Citations) sont surtout la preuve que les principes du guide sont les bons.
9. Labs conseillés#
Un compte API Anthropic de test (clé dans une variable d'environnement, jamais dans le code) et Claude Code suffisent.
Utilisez claude-haiku-5-5 pour les boucles répétitives : chaque lab coûte quelques centimes à quelques dollars. Nettoyage :
révoquer la clé de test à la fin, supprimer les fichiers de données factices.
Lab 1 · Agent support : case facts et escalade (1 h 30)
- Coder une boucle agentique avec trois outils simulés :
get_customer(renvoie parfois trois homonymes),lookup_order(40 champs bruts) etescalate_to_human. - Élaguer
lookup_orderà 5 champs dans l'outil ; tenir uncase_factsmis à jour par le code. - Résumer l'historique après le tour 4, sans toucher au bloc.
- Mettre les critères d'escalade et deux exemples few-shot dans le
systemprompt. - Tester quatre conversations : client furieux au cas simple, demande d'un humain, prix d'un concurrent, homonymes.
- Résultat attendu : au tour 8, l'agent cite encore 247,83 $ et #8891. Les quatre cas donnent dans l'ordre : résolution, transfert immédiat, escalade, demande d'un identifiant.
Lab 2 · Panne simulée d'un subagent (1 h)
- Coordinateur et trois « subagents » (fonctions qui appellent Claude) ; le troisième lève un timeout une fois sur deux.
- Implémenter le retry local, puis le retour d'erreur structuré (4 éléments).
- Comparer avec deux versions fautives : liste vide « succès », et exception qui arrête tout.
- Résultat attendu : seule la version structurée produit une synthèse complète avec une annotation de couverture sur le sujet manquant.
Lab 3 · Routage par confiance calibrée (1 h 30)
- Générer 60 documents factices de 4 types, avec les valeurs exactes connues (jeu étiqueté).
- Faire extraire chaque champ avec une confiance (sortie JSON) ; pour le volume, passer par la Message Batches API (chapitre 04).
- Calculer la précision par type × champ et la courbe confiance → justesse ; fixer un seuil par champ.
- Construire la file de revue triée par incertitude et un échantillon stratifié de la haute confiance.
- Résultat attendu : une précision globale flatteuse et au moins un segment nettement en dessous. Les seuils diffèrent d'un champ à l'autre.
Lab 4 · Explorer un gros dépôt avec Claude Code (1 h)
- Cloner un dépôt open source inconnu de taille moyenne ; lancer
claude. - Demander une cartographie en déléguant à des subagents ; regarder
/contextavant et après. - Faire tenir
NOTES.md(classes, chemins, dépendances) ; poser une question précise 30 minutes plus tard, avec et sans relecture du fichier. /compact focus on …, puis fermer et reprendre la session (claude --resume).
- Résultat attendu : avec le scratchpad, les réponses citent des classes et des chemins réels, sans retomber dans les « patterns typiques ».
Lab 5 · Synthèse multi-sources avec provenance (45 min)
- Fournir deux documents (blocs
document,citationsactivé) qui donnent deux chiffres différents à des dates différentes. - Demander une synthèse ; vérifier
cited_textet la position de chaque citation. - Refaire en pipeline maison avec des claim-source mappings JSON (sans Citations, puisque incompatible avec la sortie structurée).
- Résultat attendu : les deux valeurs apparaissent avec leur source et leur date, sans moyenne ni choix arbitraire.
10. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| L'agent perd un montant après résumé, le résumeur avait déjà la consigne de tout garder | case facts block hors de l'historique résumé | la compression perd les valeurs, quelle que soit la consigne |
| « Augmenter la fenêtre de contexte » | presque toujours faux | certaines sessions dépassent toute fenêtre ; et la dégradation n'est pas un manque de place |
| Constats manqués au milieu d'une longue entrée | résumé des constats en tête + sections titrées | effet de position, pas un problème de consigne |
| Garder les sorties d'outils complètes « au cas où » | élaguer aux champs utiles avant l'historique | elles reviennent à chaque tour |
| Supprimer des tours au hasard pour gagner de la place | non : faits à part, récit résumé de façon maîtrisée | l'API est stateless, la cohérence demande l'historique |
| Escalade sur seuil de sentiment négatif | non | le sentiment ne mesure pas la complexité |
| Escalade si la confiance auto-déclarée est < 7 | non | confiance mal calibrée |
| Le client demande un humain, l'agent veut d'abord vérifier la commande | transférer immédiatement | la demande explicite est absolue |
| Client frustré, cas simple | reconnaître, résoudre ; escalader seulement s'il redemande un humain | pas de déclencheur valide |
| Politique claire qui refuse la demande | l'agent applique la règle | violation ≠ lacune |
| Trois clients du même nom | demander un identifiant | jamais d'heuristique (plus récent, plus actif) |
| Timeout d'un subagent | erreur structurée : type, tentative, partiel, alternatives | permet une décision de reprise |
| Liste vide renvoyée comme succès | anti-pattern (silent suppression) | trou invisible |
| Tout arrêter sur un échec | anti-pattern (workflow termination) | perd les résultats des autres |
| « 0 résultat » relancé en boucle | non : résultat vide valide | la requête a fonctionné |
| Agent qui parle de « patterns typiques » | scratchpad + subagents + résumés de phase | perte de prise sur les constats |
| Subagents de phase 2 qui refont la phase 1 | injecter un résumé de phase dans leur prompt | ils n'héritent pas de l'historique |
| Redémarrer une exploration après crash | charger le manifeste et l'injecter | ne pas tout refaire |
/compact seulement quand c'est plein |
proactif | qualité du contexte |
| 97 % global → tout automatiser au-dessus de 95 % | valider par segment et calibrer d'abord | la moyenne cache les segments faibles |
| N'échantillonner que la basse confiance | échantillonner aussi la haute confiance | seul moyen de voir un nouveau motif d'erreur |
| Deux sources en conflit | annoter les deux avec source et date | ni récente, ni moyenne, ni « plus réputée » |
| Rapport tout en tableaux | format selon le contenu | lisibilité |
11. Scénarios d'entraînement#
Questions originales au format de l'examen (une seule bonne réponse). Les questions officielles n° 3 et n° 8 du guide sont commentées au chapitre 06.
1. (Customer Support) Dans une session à deux problèmes, l'agent confond le remboursement de la commande #8891 avec le remplacement de la commande #9120 après la compression de l'historique. Que changer ?
- A. Réduire le résumé à une seule phrase par tour.
- B. Tenir un case facts block avec une entrée distincte par problème, hors de l'historique résumé.
- C. Interdire tout résumé et tronquer les tours les plus anciens.
- D. Demander au modèle de relire toute la conversation avant chaque réponse.
B. Une entrée par problème évite le mélange entre commandes ; A et D gardent le défaut du résumé, C perd la cohérence.
2. (Customer Support) Un client écrit : « C'est la troisième fois que mon colis arrive abîmé, je suis furieux ! ». La politique prévoit un remplacement automatique. Que doit faire l'agent ?
- A. Escalader, car le sentiment est très négatif.
- B. Lui demander de noter sa satisfaction avant de décider.
- C. Reconnaître la frustration et lancer le remplacement prévu ; escalader seulement s'il demande un humain.
- D. Escalader si la confiance de l'agent est inférieure à 7 sur 10.
C. Cas simple couvert par la politique : la colère n'est pas un déclencheur, la confiance auto-déclarée non plus.
3. (Customer Support) get_customer("Martin Dubois") renvoie deux comptes actifs. Quelle action ?
- A. Prendre le compte avec la commande la plus récente.
- B. Demander l'e-mail ou le numéro de commande pour identifier le bon compte.
- C. Escalader immédiatement vers un humain.
- D. Fusionner les informations des deux comptes.
B. Une ambiguïté de correspondance se résout par un identifiant, jamais par une heuristique ; ce n'est pas un motif d'escalade.
4. (Multi-Agent Research) Le subagent « brevets » obtient 3 sources sur 5, puis la base expire. Que doit-il renvoyer ?
- A. Les 3 sources, marquées succès, sans mentionner l'échec.
- B. Une exception qui arrête le pipeline.
- C. Un statut « recherche indisponible » après trois tentatives.
- D. Le type d'échec, la requête tentée, les 3 sources partielles et des alternatives.
D. A est une suppression silencieuse partielle, B un arrêt total, C un statut générique qui cache le contexte.
5. (Multi-Agent Research) Le subagent « réglementation » interroge une base disponible et ne trouve aucun texte pour un pays donné. Le coordinateur relance trois fois la même requête. Quel est le problème ?
- A. Il fallait augmenter le timeout.
- B. Un résultat vide valide a été traité comme un échec d'accès.
- C. Il fallait arrêter le workflow.
- D. Il fallait masquer ce sujet dans la synthèse.
B. La requête a fonctionné : « rien » est la réponse, à signaler dans la synthèse, pas à relancer.
6. (Code Generation with Claude Code) Après deux heures d'exploration, Claude Code répond de façon générique sur des modules qu'il avait analysés en détail. Quelle mesure est la plus efficace pour la suite ?
- A. Passer à un modèle avec une fenêtre plus grande.
- B. Recommencer la session et redemander l'exploration.
- C. Faire tenir un scratchpad des constats précis et déléguer les nouvelles explorations à des subagents.
- D. Charger tout le dépôt dans le premier prompt.
C. La dégradation est une perte de prise ; B efface le savoir acquis, A et D ajoutent du bruit.
7. (Code Generation with Claude Code) Une exploration en trois phases s'interrompt pendant la phase 2. Que prévoir pour reprendre ?
- A. Relancer la phase 1 pour reconstituer le contexte.
- B. Un manifeste d'état par agent, chargé par le coordinateur et injecté dans les prompts à la reprise.
- C. Copier la transcription complète de la phase 1 dans chaque subagent de phase 2.
- D. Augmenter le nombre maximal de tours.
B. C'est la réponse du guide ; C peut dépasser le budget des subagents et noie l'essentiel.
8. (Structured Data Extraction) La précision moyenne est de 96 %. Les relecteurs ne relisent que les extractions sous 0,8 de confiance. Un nouveau fournisseur change sa mise en page et les totaux deviennent faux, avec une confiance de 0,95. Qu'est-ce qui aurait détecté le problème ?
- A. Relever le seuil à 0,99.
- B. Un échantillonnage aléatoire stratifié incluant les extractions à haute confiance.
- C. Répartir les relecteurs uniformément sur tous les documents.
- D. Demander au modèle de se relire.
B. Personne ne relisait la haute confiance ; seul l'échantillonnage stratifié mesure ce segment en continu.
9. (Multi-Agent Research) Deux rapports donnent 8 % (données 2023) et 12 % (données 2024) pour le même indicateur. Le rapport est publié automatiquement, sans relecture humaine. Quelle sortie ?
- A. 10 %, avec une note sur la variance.
- B. 12 %, la source la plus récente.
- C. Les deux valeurs avec leur source et leur date, présentées comme une évolution possible.
- D. Suspendre la publication jusqu'à la décision d'un analyste.
C. Aucun chiffre inventé, aucune valeur supprimée ; D suppose une étape humaine qui n'existe pas.
12. Pour aller plus loin#
- Effective context engineering (Anthropic, 29/09/2025) : attention budget, context rot, compaction, tool result clearing (la forme la plus légère de compaction), prise de notes structurée (NOTES.md), sous-agents à contexte propre et contexte just-in-time (garder des chemins et des requêtes plutôt que le contenu). Règle : « the smallest set of high-signal tokens ».
- Compaction en pratique : à la demande (l'application décide, peut garder les derniers tours mot pour mot et compacter en arrière-plan) ou au seuil (l'API compacte dans la requête). On peut fournir son propre prompt de résumé quand le résumé par défaut perd une information utile.
- Context awareness : certains modèles (Sonnet 5, Sonnet 4.6) reçoivent leur budget de tokens restant ; sur Opus 5.5, Sonnet 5.5, Haiku 5.5 et Fable 5.1, on peut fixer un budget explicite avec les task budgets (beta).
- Multisession pattern du memory tool : une session d'initialisation crée un journal de progression et une liste de fonctionnalités ; chaque session les relit au début et les met à jour à la fin ; une fonctionnalité n'est cochée qu'après vérification de bout en bout. C'est la version outillée du manifeste.
- Sécurité du memory tool : l'application exécute les opérations de fichiers ; valider chaque chemin (rester dans
/memories, refuser../) contre le path traversal. - Hors examen : détails du prompt caching (points d'arrêt
cache_control, durée de vie), comptage de tokens (count_tokens).
13. Fiche à retenir#
- API stateless : l'application renvoie l'historique ; 1M tokens sur Claude 5, mais context rot : trier ce qui entre.
- Faits transactionnels → case facts block dans chaque prompt, hors du résumé ; une entrée par problème.
- Lost in the middle → résumé des constats en tête + sections titrées.
- Sorties d'outils élaguées avant l'historique ; agents amont → données structurées avec métadonnées.
- Escalade : demande d'humain (immédiat), policy gap, blocage réel. Pas le sentiment, pas la confiance auto-déclarée. Violation claire = l'agent applique la règle.
- Homonymes → demander un identifiant, jamais d'heuristique.
- Correction de calibration : critères explicites + few-shot dans le system prompt, avant tout classifieur ; handoff structuré.
- Erreur de subagent : type, tentative, résultats partiels, alternatives ; récupération locale d'abord.
- Access failure ≠ valid empty result ; ni silent suppression, ni workflow termination ; coverage annotations.
- Exploration longue : scratchpad, subagents (isolation), résumé de phase injecté, manifeste pour la reprise,
/compactproactif ; pas une fenêtre plus grande. - Revue humaine : précision par type × champ, confiance par champ calibrée sur données étiquetées, échantillonnage stratifié y compris haute confiance, file triée par incertitude.
- Provenance : claim, sourceUrl, documentName, relevantExcerpt, publicationDate conservés jusqu'au rapport.
- Conflit → les deux valeurs annotées ; dates obligatoires ; format selon le contenu (tableau, prose, liste).
- État actuel (hors réponse d'examen) : compaction, context editing, memory tool, Citations API, reprise des subagents.
Références#
Toutes lues le 21/10/2026.
Officiel Anthropic
- Claude Certified Architect – Foundations, Exam Guide v1.0 (juillet 2026), Domain 5 (lien depuis Partner certifications)
- Context windows
- Compaction overview
- Context editing
- Memory tool
- Citations
- Prompting best practices
- Prompt caching (existence seulement à l'examen)
- Claude Code : Explore the context window
- Claude Code : Subagents
- Agent SDK : Subagents · Hooks · Sessions
- Effective context engineering for AI agents
- How we built our multi-agent research system
Base du cours (tiers) : leçons du Domain 5 de claudecertificationguide.com : 5.1, 5.2, 5.3, 5.4, 5.5, 5.6.