

Version : 1.0 · Date : 2026-10-21 · Chapitre transversal : les 5 domaines
En une phrase : l'examen ne demande pas de réciter la doc, il pose un problème de production dans l'un des 6 scénarios officiels et vérifie que vous choisissez la correction proportionnée qui traite la cause racine : ce chapitre entraîne exactement ce réflexe.
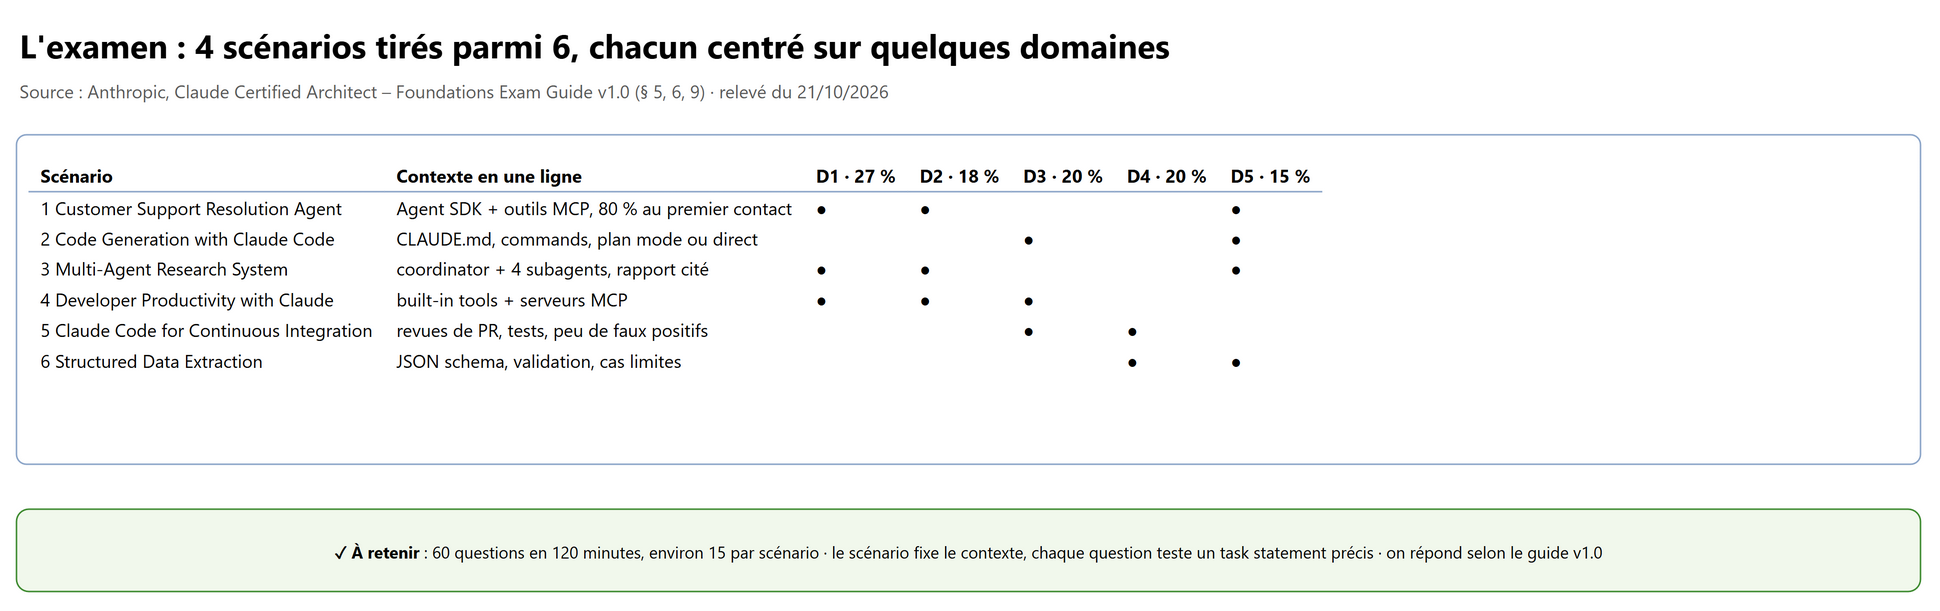
Ce que ce chapitre apporte#
| Section | Contenu | Pourquoi |
|---|---|---|
| 1 | Format, lecture d'un scénario, distracteurs typiques, gestion du temps | Les questions se ressemblent : la méthode fait gagner des points |
| 2 | Les 6 scénarios, chacun avec son architecture cible et ses pièges | 4 d'entre eux seront votre examen |
| 3 | Les 12 questions d'exemple du guide, commentées | Elles montrent le niveau et la logique des corrigés |
| 4 | 25 questions originales, pondérées comme l'examen | S'entraîner sans recopier les vraies questions |
| 5 | Les 4 exercices de préparation du guide, pas à pas | La pratique demandée par Anthropic |
| 6 · 7 | Fiche globale et corrigé | Révision de la veille |
1. La méthode de l'examen#
1.1 Le format#
| Élément | Valeur (guide v1.0, juillet 2026) |
|---|---|
| Questions | 60, à choix unique ou multiple ; chaque question indique combien de réponses choisir |
| Structure | 4 scénarios tirés au hasard parmi 6, environ 15 questions par scénario |
| Durée | 120 minutes, soit 2 minutes par question |
| Réussite | score mis à l'échelle de 720 sur 100 à 1 000 ; pourcentage par domaine sur le rapport |
| Surveillance | en ligne ou en centre Pearson VUE, sans notes ni second écran |
| Confidentialité | accord de non-divulgation : les vraies questions ne circulent pas ; ce chapitre n'utilise que les exemples publics du guide et des questions originales |
1.2 Lire un scénario en quatre temps#
- Le contexte (Agent SDK, Claude Code, CI, extraction) dit quels outils existent. Une réponse qui sort de ce cadre est rarement juste.
- Le symptôme : « dans 12 % des cas », « le rapport ne couvre que les arts visuels », « le job attend une saisie ». Le chiffre ou le détail des logs pointe la cause.
- La cause racine : demandez-vous où le problème naît (le coordinator ou le subagent ? la description de l'outil ou le prompt ?). Les corrigés officiels écartent toujours les options qui « réparent en aval ».
- La correction proportionnée : la plus petite intervention qui traite la cause. « First step », « most effective », « most maintainable » sont des indices : ils écartent l'infrastructure lourde.
1.3 Les distracteurs qui reviennent#
| Distracteur typique | Pourquoi il est faux | Exemple dans les questions officielles |
|---|---|---|
| « Renforcer le system prompt » quand une règle doit être respectée à 100 % | un prompt a un taux d'échec non nul : il faut une garantie programmatique (hook, gate) | Q1 |
| Ajouter une couche lourde (classifieur, routeur, modèle entraîné) en premier | sur-ingénierie : on essaie d'abord la correction simple (description, critères, few-shot) | Q2, Q3 |
| Se fier à la confiance auto-déclarée ou au sentiment | mal calibrés, sans lien avec la complexité réelle | Q3 |
| Accuser l'agent en aval qui a bien fait son travail | la cause est en amont (décomposition, passage de contexte) | Q7 |
| Masquer l'erreur (succès vide) ou tout arrêter | l'agent qui décide doit recevoir un contexte d'erreur structuré | Q8 |
| Donner tous les outils à un agent | viole le moindre privilège, dégrade le choix d'outil | Q9 |
Une fonctionnalité qui n'existe pas (CLAUDE_HEADLESS, --batch, .claude/config.json) |
lisez chaque option : une option inventée est éliminée d'office | Q4, Q10 |
| Un plus grand modèle ou une plus grande fenêtre de contexte | ne règle pas la dilution de l'attention ni un mauvais découpage | Q12 |
| Le batch pour un traitement bloquant | jusqu'à 24 h, sans SLA de latence | Q11 |
1.4 Le temps et l'écart guide / produit#
- 2 minutes par question : lisez d'abord la question, puis le scénario utile, puis les options. L'examen mesure chacun par rapport à un standard fixe, pas par rapport aux autres candidats (« criterion-referenced », guide § 10) : ne restez pas bloqué sur une question au détriment des suivantes.
- On répond selon le guide v1.0, même quand le produit a évolué (outil
TaskdevenuAgent,allowed-toolsqui pré-approuve,tool_choiceforcé refusé par les modèles les plus récents, slash commands fusionnées dans les skills). Chaque chapitre donne les deux, dans les encadrés « Réponse d'examen / État actuel » ; le récapitulatif est au chapitre 05, § 8.
2. Les 6 scénarios officiels#
Contextes reformulés d'après le guide (§ 5). Pour chacun : l'architecture attendue, les task statements mobilisés et les pièges.
2.1 Scénario 1 : Customer Support Resolution Agent#
Contexte : un agent de support construit avec le Claude Agent SDK traite des demandes ambiguës (retours, litiges de
facturation, comptes) via des outils MCP get_customer, lookup_order, process_refund, escalate_to_human. Objectif : 80 %
de résolution au premier contact, en sachant quand escalader. Domaines principaux : 1, 2, 5.
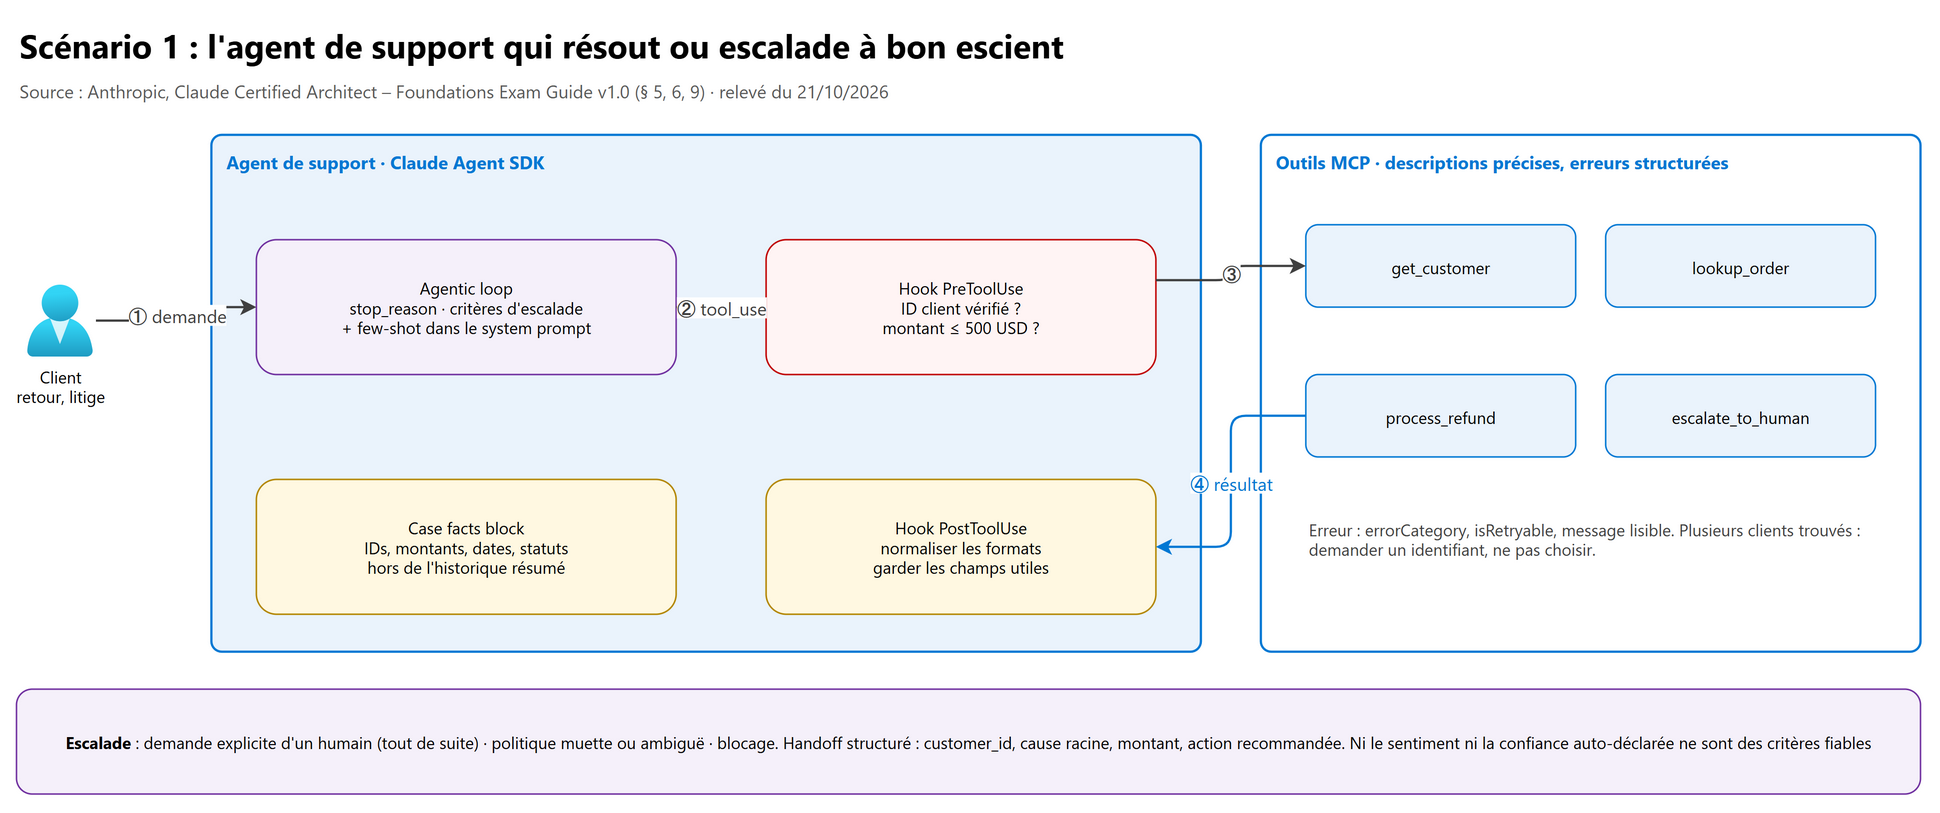
| Décision | Réponse attendue | Task statement |
|---|---|---|
| Vérifier l'identité avant tout remboursement | gate programmatique qui bloque lookup_order / process_refund tant que get_customer n'a pas renvoyé un ID vérifié |
1.4 |
| Remboursement au-dessus d'un seuil | hook PreToolUse qui refuse et redirige vers escalate_to_human |
1.5 |
| Formats hétérogènes des outils | hook PostToolUse de normalisation |
1.5 |
| Mauvais outil choisi | enrichir les descriptions (formats, exemples, limites) | 2.1 |
| Erreurs d'outils | isError, errorCategory, isRetryable, message lisible ; vide valide ≠ échec |
2.2 |
| Montants oubliés après un long échange | case facts block hors de l'historique résumé | 5.1 |
| Quand escalader | demande explicite d'un humain (tout de suite), politique muette ou ambiguë, blocage ; critères explicites + few-shot | 5.2 |
| Passer la main | handoff structuré : customer ID, cause racine, montant, action recommandée | 1.4 |
Pièges : « mettre la règle dans le prompt » pour une obligation financière ; escalader sur le sentiment ou sur un score de confiance auto-déclaré ; choisir un client par heuristique quand plusieurs correspondent (il faut demander un identifiant).
2.2 Scénario 2 : Code Generation with Claude Code#
Contexte : l'équipe utilise Claude Code pour générer, refactorer, déboguer et documenter, avec des slash commands, une configuration CLAUDE.md, et doit savoir quand choisir le plan mode ou la direct execution. Domaines principaux : 3, 5.
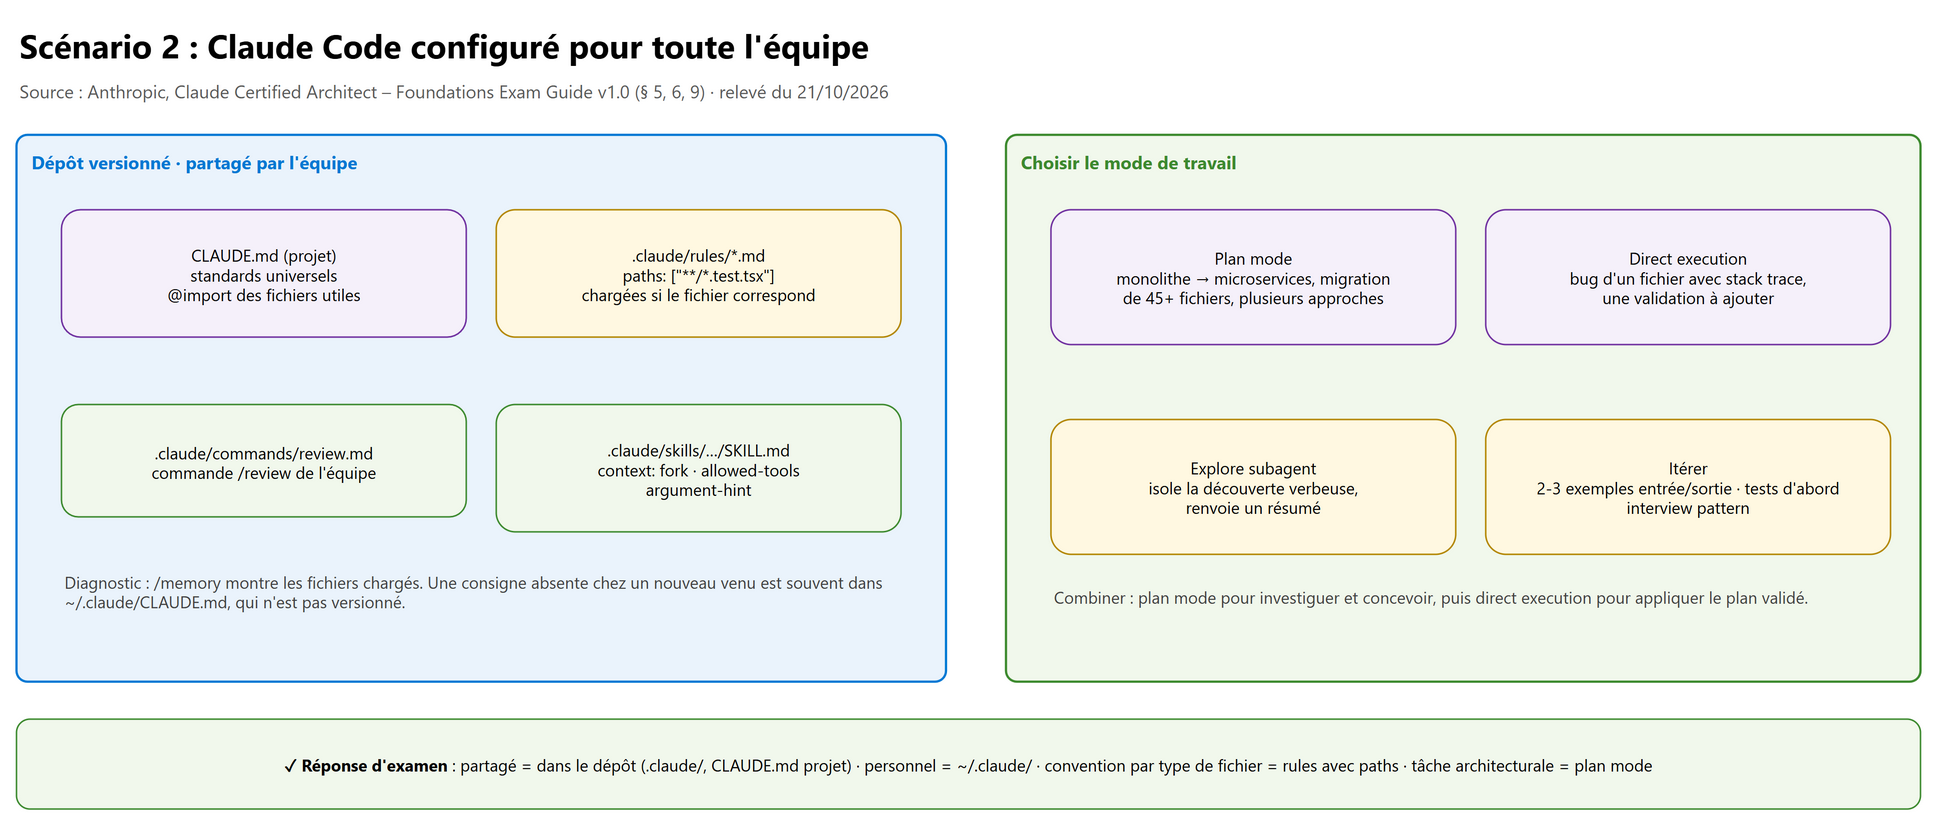
| Décision | Réponse attendue | Task statement |
|---|---|---|
| Une consigne que seul un développeur reçoit | elle est dans ~/.claude/CLAUDE.md (personnel, non versionné) : la déplacer dans le CLAUDE.md du projet ; diagnostiquer avec /memory |
3.1 |
| Une commande pour toute l'équipe | .claude/commands/ dans le dépôt (personnel : ~/.claude/commands/) |
3.2 |
| Un skill verbeux qui pollue la session | context: fork dans le frontmatter de SKILL.md |
3.2 |
| Des conventions par type de fichier dispersé | .claude/rules/ avec paths (globs) |
3.3 |
| Tâche architecturale, plusieurs approches | plan mode, puis exécution directe du plan | 3.4 |
| Résultats incohérents d'une description en prose | 2 à 3 exemples entrée / sortie, tests d'abord, interview pattern | 3.5 |
| Session longue qui devient vague | Explore subagent, scratchpad, /compact |
5.4 |
Pièges : un CLAUDE.md par sous-dossier pour des tests éparpillés partout (les rules avec paths sont la bonne réponse) ; un skill
quand il faut un chargement automatique (le skill est à la demande) ; commencer en direct execution « et voir » sur un chantier
dont la complexité est déjà connue.
2.3 Scénario 3 : Multi-Agent Research System#
Contexte : un coordinator (Agent SDK) délègue à des subagents spécialisés : recherche web, analyse de documents, synthèse, génération de rapport. Le système produit des rapports complets et cités. Domaines principaux : 1, 2, 5.
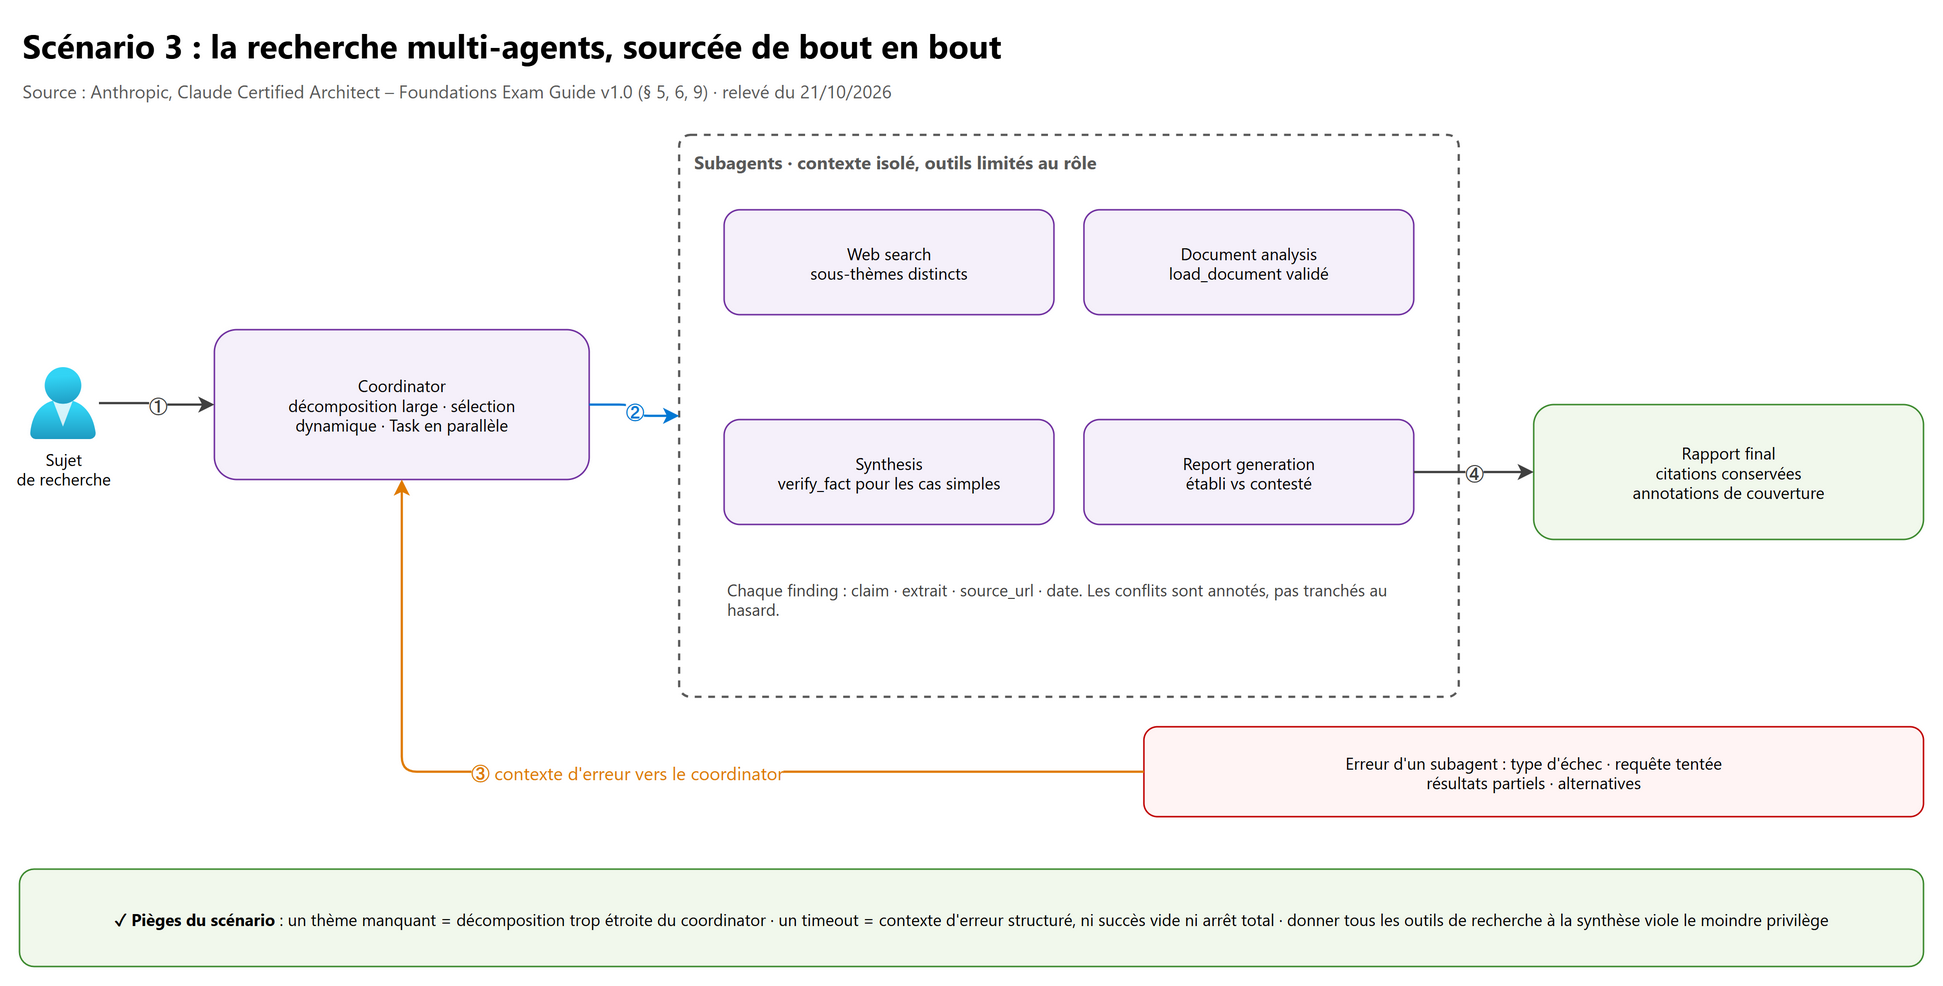
| Décision | Réponse attendue | Task statement |
|---|---|---|
| Un pan du sujet manque dans le rapport | la décomposition du coordinator est trop étroite | 1.2 |
| Lancer les recherches | plusieurs appels Task dans une seule réponse (parallélisme) ; allowedTools contient "Task" |
1.3 |
| Ce que reçoit un subagent | les findings complets dans son prompt, en données structurées (contenu + métadonnées) | 1.3 |
| Outils par rôle | jeu restreint par subagent ; verify_fact pour les vérifications simples de la synthèse |
2.3 |
| Un subagent en timeout | contexte d'erreur structuré (type, requête, résultats partiels, alternatives) ; reprise locale des erreurs transitoires | 5.3 |
| Sources contradictoires | garder les deux valeurs avec leur source et leur date ; sections « établi » / « contesté » | 5.6 |
Pièges : accuser la recherche ou la synthèse alors que les logs du coordinator montrent la cause ; laisser les subagents se parler directement (tout passe par le coordinator) ; un « search unavailable » générique.
2.4 Scénario 4 : Developer Productivity with Claude#
Contexte : un agent (Agent SDK) aide les ingénieurs à explorer des bases de code inconnues, comprendre du legacy, générer du boilerplate et automatiser des tâches, avec les built-in tools (Read, Write, Bash, Grep, Glob) et des serveurs MCP. Domaines principaux : 2, 3, 1.
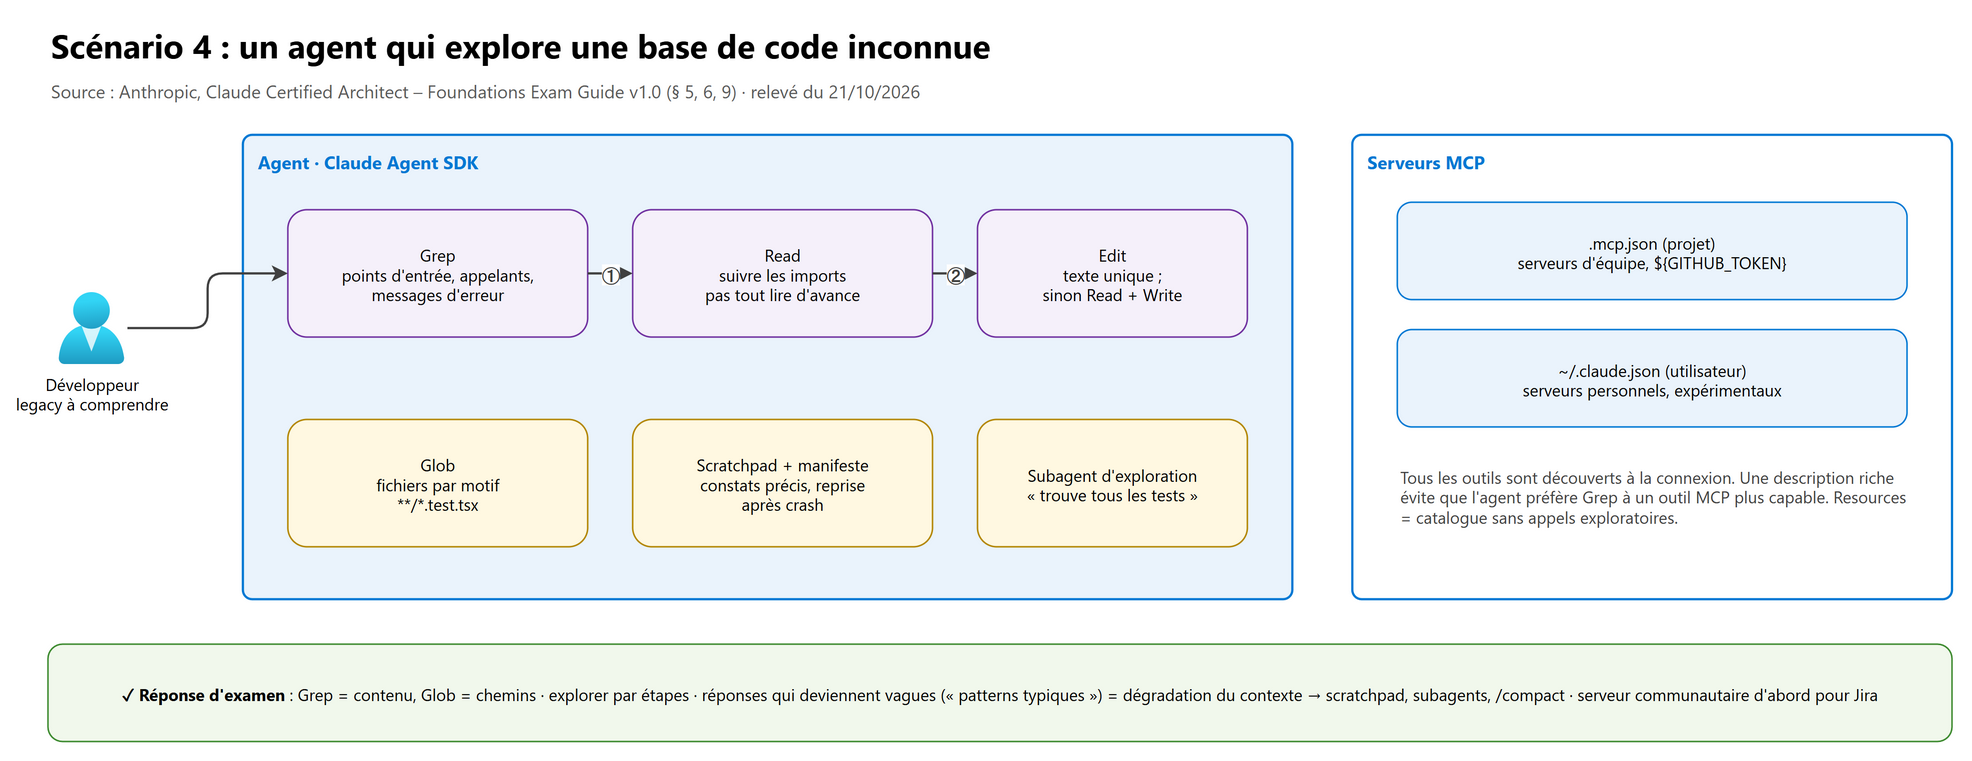
| Décision | Réponse attendue | Task statement |
|---|---|---|
| Trouver les appelants d'une fonction | Grep (contenu) ; trouver des fichiers par motif : Glob | 2.5 |
| Explorer | Grep pour les points d'entrée, puis Read en suivant les imports ; pas tout lire d'avance | 2.5 |
| Edit échoue (texte non unique) | Read + Write en repli | 2.5 |
| Serveur d'équipe avec un token | .mcp.json du projet avec ${VAR} ; serveur personnel : ~/.claude.json |
2.4 |
| L'agent préfère Grep à un outil MCP plus riche | enrichir la description de l'outil MCP | 2.4 |
| Réponses qui deviennent génériques | scratchpad, subagents d'exploration, résumés de phase, manifeste de reprise | 5.4 |
| Tâche ouverte (« ajoute des tests au legacy ») | décomposition dynamique : cartographier, prioriser, adapter | 1.6 |
Pièges : écrire un serveur MCP maison pour Jira alors qu'un serveur communautaire existe ; mettre un secret en clair dans
.mcp.json ; agrandir la fenêtre de contexte au lieu de structurer l'exploration.
2.5 Scénario 5 : Claude Code for Continuous Integration#
Contexte : Claude Code tourne dans la CI/CD : revues automatiques, génération de tests, retours sur les PR. Les prompts doivent donner un retour actionnable et peu de faux positifs. Domaines principaux : 3, 4.
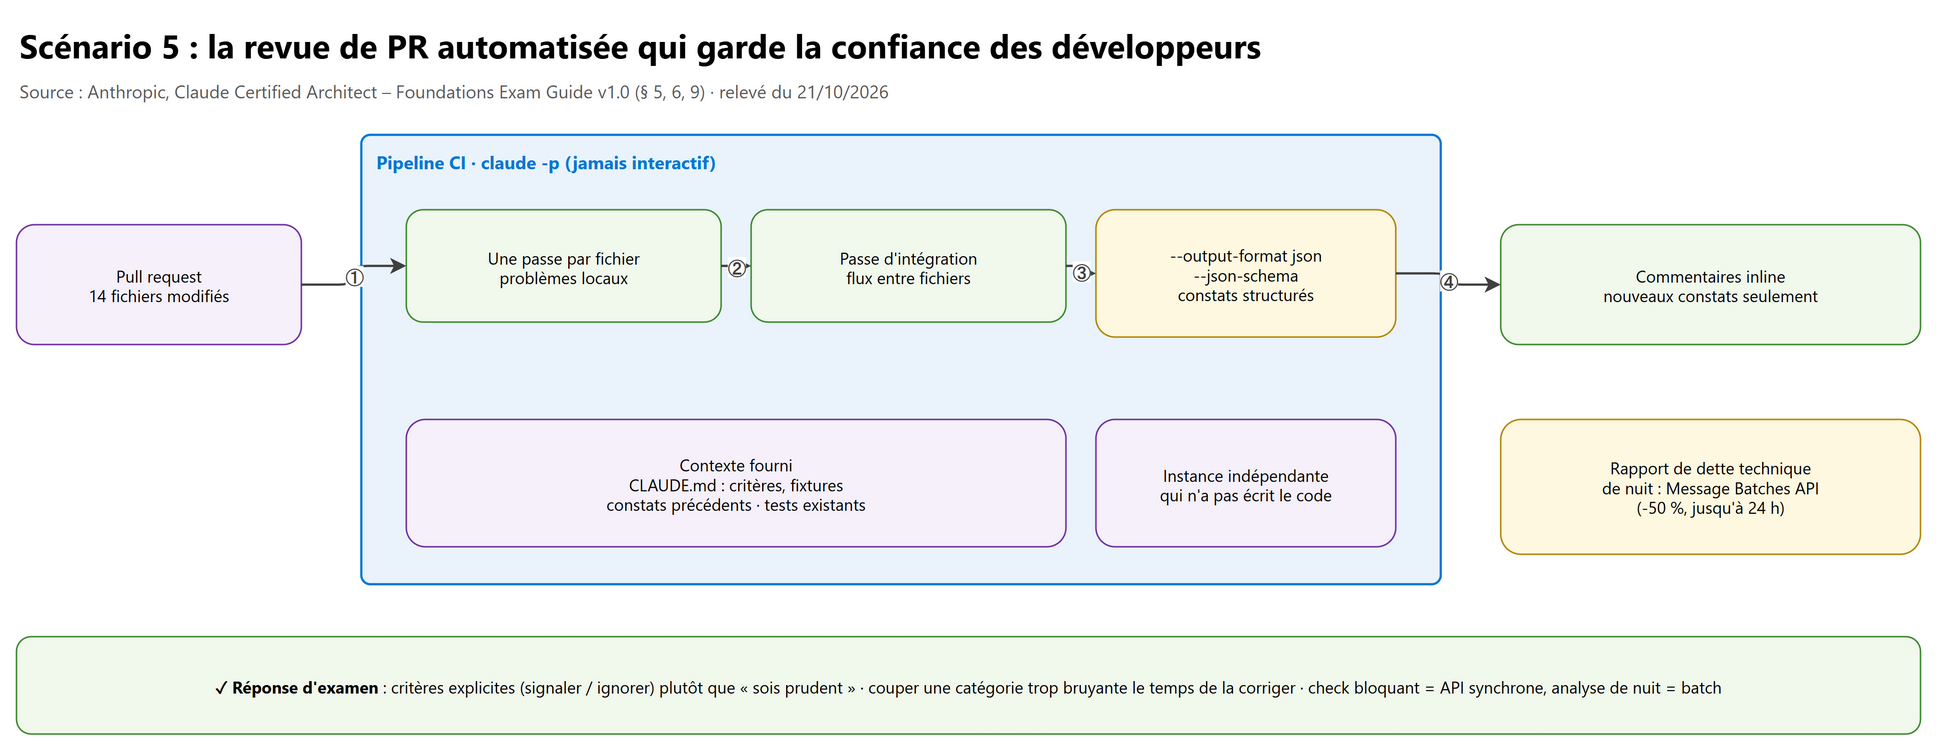
| Décision | Réponse attendue | Task statement |
|---|---|---|
| Le job attend une saisie | claude -p (ou --print) |
3.6 |
| Sortie exploitable par la CI | --output-format json + --json-schema |
3.6 |
| Commentaires en double après de nouveaux commits | fournir les constats précédents, ne signaler que le nouveau ou le non corrigé | 3.6 |
| Trop de faux positifs | critères explicites (signaler / ignorer), couper temporairement une catégorie bruyante, sévérités avec exemples | 4.1 |
| Revue incohérente sur 14 fichiers | une passe par fichier + une passe d'intégration | 4.6 |
| Qui relit le code généré | une instance indépendante, sans le raisonnement du générateur | 4.6 |
| Check bloquant ou rapport de nuit | synchrone pour le pré-merge ; Message Batches API pour la nuit | 4.5 |
Pièges : « sois prudent » ou « ne signale que ce dont tu es sûr » au lieu de critères ; exiger que les développeurs découpent leurs PR ; voter à deux sur trois exécutions (supprime des vrais bugs détectés par intermittence).
2.6 Scénario 6 : Structured Data Extraction#
Contexte : un système extrait des informations de documents non structurés, valide la sortie avec des JSON schemas, garde une précision élevée, gère les cas limites et alimente des systèmes aval. Domaines principaux : 4, 5.
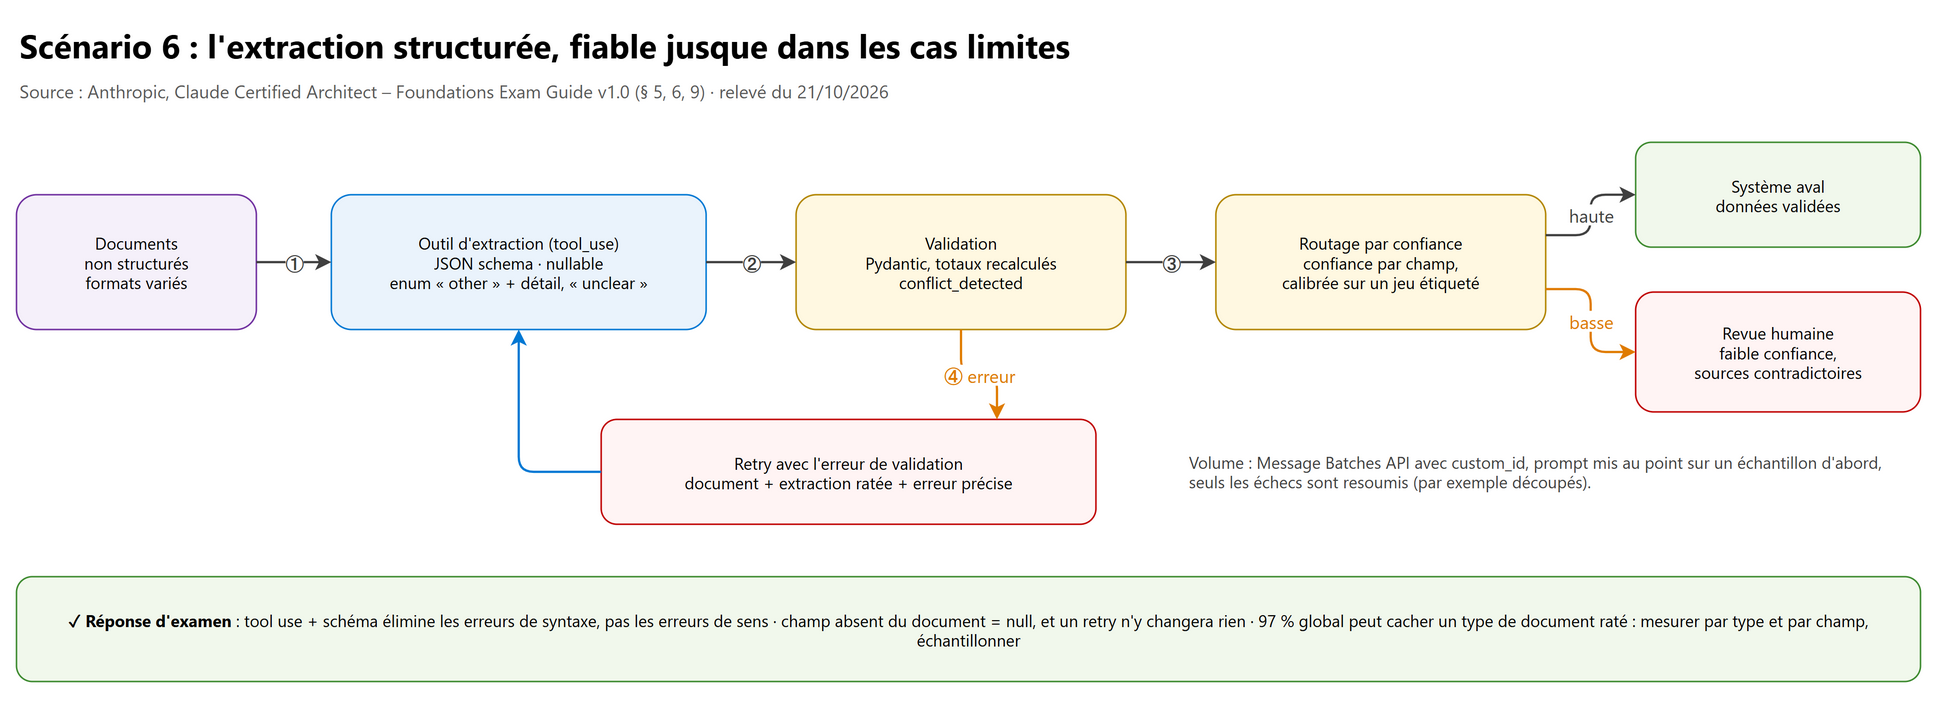
| Décision | Réponse attendue | Task statement |
|---|---|---|
| Garantir une sortie conforme au schéma | outil d'extraction + JSON schema (tool_use) ; tool_choice: "any" si plusieurs schémas, outil forcé pour imposer une étape |
4.3 |
| Le modèle invente des valeurs absentes | champs nullable ; enum "other" + détail, "unclear" |
4.3 |
| Erreurs de sens (totaux faux) | calculated_total vs stated_total, conflict_detected, retry avec l'erreur précise |
4.4 |
| Information absente du document | un retry ne sert à rien : null et revue |
4.4 |
| Formats variés | few-shot sur les structures différentes | 4.2 |
| Gros volume non urgent | Message Batches API, custom_id, prompt mis au point sur un échantillon |
4.5 |
| Réduire la revue humaine | précision par type de document et par champ, échantillonnage stratifié, confiance par champ calibrée | 5.5 |
Pièges : croire que le schéma garantit le sens ; rendre tous les champs obligatoires ; couper la revue sur la foi d'une précision globale.
3. Les 12 questions d'exemple officielles commentées#
Le guide (§ 9) publie 12 questions tirées de son test d'entraînement, avec leur corrigé. Elles sont résumées ici (lisez-les en entier dans le guide officiel), puis commentées.
| # | Scénario · situation résumée | Bonne réponse | Pourquoi les autres sont fausses | TS |
|---|---|---|---|---|
| Q1 | Support · dans 12 % des cas l'agent saute get_customer et rembourse le mauvais compte |
gate programmatique qui bloque lookup_order / process_refund tant qu'un ID vérifié n'est pas obtenu |
prompt renforcé ou few-shot = conformité probabiliste ; un routeur d'outils traite la disponibilité, pas l'ordre | 1.4 |
| Q2 | Support · get_customer appelé à la place de lookup_order, descriptions d'une ligne |
enrichir les descriptions (formats, exemples, limites, quand utiliser l'un ou l'autre) | few-shot : coût en jetons sans traiter la cause ; routeur : sur-ingénierie ; fusionner les outils : valable mais trop lourd pour un « premier pas » | 2.1 |
| Q3 | Support · 55 % au lieu de 80 % : escalade les cas simples, traite seul les exceptions | critères d'escalade explicites + few-shot dans le system prompt | confiance auto-déclarée mal calibrée ; classifieur entraîné : trop lourd avant d'avoir essayé le prompt ; sentiment sans lien avec la complexité | 5.2 |
| Q4 | Code generation · commande /review disponible pour tous au clone |
.claude/commands/ dans le dépôt |
~/.claude/commands/ = personnel ; CLAUDE.md = instructions, pas commandes ; .claude/config.json n'existe pas |
3.2 |
| Q5 | Code generation · monolithe vers microservices, des dizaines de fichiers | plan mode d'abord | direct « incrémental » : reprises coûteuses ; instructions détaillées sans exploration ; attendre la complexité alors qu'elle est déjà connue | 3.4 |
| Q6 | Code generation · conventions par zone, tests dispersés à côté du code | .claude/rules/ avec globs dans paths |
tout dans le CLAUDE.md racine = inférence ; skills = invocation, pas chargement automatique ; CLAUDE.md par dossier = lié au répertoire | 3.3 |
| Q7 | Recherche · rapport limité aux arts visuels, logs du coordinator explicites | décomposition trop étroite du coordinator | les subagents ont bien fait ce qu'on leur a confié : blâmer l'aval est faux | 1.2 |
| Q8 | Recherche · timeout du subagent de recherche | contexte d'erreur structuré (type, requête, partiels, alternatives) | statut générique après retries = contexte perdu ; succès vide = erreur masquée ; tout arrêter = inutile | 5.3 |
| Q9 | Recherche · la synthèse fait 2-3 allers-retours pour vérifier des faits simples (85 %) | un outil verify_fact limité pour les cas simples, le reste via le coordinator |
lot de vérifications en fin de passe : dépendances bloquantes ; tous les outils de recherche : moindre privilège violé ; cache spéculatif : imprévisible | 2.3 |
| Q10 | CI · le job attend une saisie | claude -p |
CLAUDE_HEADLESS et --batch n'existent pas ; rediriger stdin ne règle pas la syntaxe |
3.6 |
| Q11 | CI · passer pré-merge bloquant et rapport de nuit en batch | batch pour le rapport de nuit seulement | le pré-merge ne peut pas attendre jusqu'à 24 h ; l'ordre des résultats se gère avec custom_id ; le repli vers le temps réel ajoute de la complexité |
4.5 |
| Q12 | CI · revue de 14 fichiers incohérente et contradictoire | une passe par fichier + une passe d'intégration | exiger de petites PR reporte la charge ; une plus grande fenêtre ne règle pas l'attention ; le vote à 2 sur 3 supprime des vrais bugs | 4.6 |
État actuel : Q4, les commandes sont aujourd'hui fusionnées dans les skills (
.claude/skills/review/SKILL.md), mais.claude/commands/fonctionne toujours : la réponse d'examen reste A. Q9, l'outilTasks'appelleAgentdans le produit. Voir les encadrés des chapitres 03 et 01.
La leçon commune aux 12 corrigés : la bonne réponse traite la cause avec le mécanisme prévu pour cela (code pour une garantie, description pour le choix d'outil, critères pour la précision, découpage pour l'attention), au coût le plus faible.
4. Questions d'entraînement#
25 questions originales, réparties comme l'examen : domaine 1 (7), domaine 2 (4), domaine 3 (5), domaine 4 (5), domaine 5 (4). Répondez sans regarder le corrigé. Sauf mention, une seule réponse.
Domaine 1 · Agentic Architecture & Orchestration#
E1 (scénario 1) Votre boucle s'arrête dès que la réponse contient un bloc texte, alors que Claude voulait encore appeler un
outil. Que corriger ?
A. Augmenter le nombre maximal d'itérations.
B. Continuer tant que stop_reason vaut "tool_use" et s'arrêter sur "end_turn".
C. Chercher le mot « terminé » dans le texte de la réponse.
D. Demander au modèle d'écrire « DONE » à la fin.
E2 (scénario 3) Le coordinator lance la recherche web, attend, puis lance l'analyse de documents au tour suivant. Les deux sont
indépendantes. Comment réduire la latence ?
A. Fusionner les deux subagents en un seul.
B. Passer au modèle le plus rapide pour les subagents.
C. Émettre les deux appels Task dans une seule réponse du coordinator.
D. Lancer un second coordinator en parallèle.
E3 (scénario 3) Le rapport final n'a plus aucune citation, alors que le subagent de recherche avait trouvé des sources. Les logs montrent que le coordinator transmet à la synthèse un résumé en prose des findings. Cause la plus probable ? A. Les métadonnées (URL, document, date) ont été perdues au passage de contexte : il faut transmettre des findings structurés. B. Le prompt de la synthèse ne demande pas de citations. C. Le subagent de recherche n'a pas assez de résultats. D. La fenêtre de contexte de la synthèse est trop petite.
E4 (scénario 1) Aucun remboursement au-dessus de 500 USD ne doit partir sans un humain, sans exception. Quelle solution ?
A. Écrire la règle en majuscules dans le system prompt.
B. Ajouter trois exemples few-shot de refus.
C. Vérifier après coup les remboursements dans un rapport quotidien.
D. Un hook PreToolUse sur process_refund qui refuse au-delà de 500 USD et oriente vers escalate_to_human.
E5 (scénario 1) Trois outils MCP renvoient des dates en Unix, en ISO 8601 et en JJ/MM/AAAA ; Claude confond le jour et le mois.
Que faire ?
A. Expliquer les trois formats dans le system prompt.
B. Un hook PostToolUse qui normalise toutes les dates avant que Claude lise le résultat.
C. Demander à Claude de redemander la date au client.
D. Retirer deux des trois outils.
E6 (scénario 4) Hier, une session a analysé un module ; ce matin, trois fichiers de ce module ont changé. Que faire ?
A. Créer un fork de la session d'hier.
B. Relancer une exploration complète dans une nouvelle session, sans contexte.
C. Reprendre la session (--resume) en indiquant les trois fichiers modifiés pour une ré-analyse ciblée.
D. Reprendre la session sans rien dire : l'agent relira ce qu'il faut.
E7 (scénario 4) Tâche : « ajoute des tests complets à ce dépôt legacy ». Quelle décomposition ? A. Cartographier la structure, repérer les zones à fort impact, établir un plan priorisé qui s'adapte aux dépendances découvertes. B. Un pipeline fixe : un fichier après l'autre par ordre alphabétique. C. Une seule requête avec tout le dépôt en contexte. D. Un subagent par fichier lancé d'emblée, sans plan.
Domaine 2 · Tool Design & MCP Integration#
E8 (scénario 3) analyze_content et analyze_document ont des descriptions presque identiques ; les pages web partent vers
le mauvais outil. Correction la plus directe ?
A. Ajouter une règle de routage dans le coordinator.
B. Renommer analyze_content en extract_web_results avec une description propre au web.
C. Supprimer analyze_document.
D. Passer tool_choice en "any".
E9 (scénario 1) lookup_order renvoie « Operation failed » pour un timeout comme pour une commande inexistante ; l'agent
relance sans fin les commandes inexistantes. Que changer ?
A. Limiter l'agent à trois appels par outil.
B. Renvoyer un texte d'erreur plus long.
C. Faire échouer toute la conversation sur une erreur d'outil.
D. Des erreurs structurées (errorCategory, isRetryable) et un résultat vide valide pour « aucune commande trouvée ».
E10 (scénario 4) L'équipe veut un serveur MCP Jira partagé, authentifié par un token. Bonne configuration ?
A. Un serveur communautaire déclaré dans le .mcp.json du dépôt, token passé par ${JIRA_TOKEN}.
B. Le token en clair dans .mcp.json pour que tout marche au clone.
C. Le serveur dans ~/.claude.json de chaque développeur.
D. Un serveur maison écrit pour l'occasion.
E11 (scénario 4) Edit échoue : le texte à remplacer apparaît trois fois dans le fichier. Repli recommandé par le guide ?
A. Recommencer Edit jusqu'à ce qu'il passe.
B. Utiliser Bash avec sed sur tout le fichier.
C. Read du fichier complet, puis Write du contenu modifié.
D. Abandonner la modification.
Domaine 3 · Claude Code Configuration & Workflows#
E12 (scénario 2) Un nouvel arrivant ne reçoit pas les conventions que le lead obtient. Cause la plus probable ?
A. Le nouvel arrivant n'a pas la bonne version de Claude Code.
B. Les conventions sont dans le ~/.claude/CLAUDE.md du lead, non versionné.
C. Le CLAUDE.md du projet est trop long.
D. Le plan mode est désactivé chez le nouvel arrivant.
E13 (scénario 2) Les conventions Terraform doivent s'appliquer seulement quand on modifie des fichiers sous terraform/. Quoi
utiliser ?
A. Un fichier .claude/rules/terraform.md avec paths: ["terraform/**/*"].
B. Une section Terraform dans le CLAUDE.md racine.
C. Un skill /terraform à lancer à la main.
D. Un hook qui ajoute les conventions à chaque prompt.
E14 (scénario 2) Le skill /analyse produit une analyse très longue qui encombre ensuite la conversation. Que faire ?
A. Le transformer en CLAUDE.md.
B. Lancer /compact après chaque appel.
C. Le déplacer dans ~/.claude/skills/.
D. Ajouter context: fork dans son frontmatter.
E15 (scénario 5) Après chaque nouveau commit, la revue en CI recommente les mêmes problèmes. Correction ? A. Ne lancer la revue qu'une fois par PR. B. Supprimer les anciens commentaires avant chaque revue. C. Fournir les constats précédents et demander de ne signaler que les nouveaux ou ceux encore non corrigés. D. Baisser la sévérité de tous les constats.
E16 (scénario 2) Une transformation de données décrite en prose donne des résultats différents à chaque essai. Technique la plus efficace ? A. Réécrire la description plus longuement. B. Donner 2 ou 3 exemples concrets d'entrée et de sortie attendues. C. Passer en plan mode. D. Augmenter la température.
Domaine 4 · Prompt Engineering & Structured Output#
E17 (scénario 5) La revue signale tant de détails de style que les développeurs ignorent aussi les vrais bugs. Premier geste ? A. Des critères explicites (signaler bugs et sécurité, ignorer le style) et couper la catégorie style le temps de la corriger. B. Ajouter « sois prudent, ne signale que l'important ». C. Ne garder que les constats à confiance supérieure à 0,9. D. Passer à un modèle plus grand.
E18 (scénario 6) Le modèle remplit due_date alors que la facture n'en contient pas. Correction du schéma ?
A. Ajouter une valeur par défaut « 30 jours ».
B. Ajouter un exemple few-shot avec une date.
C. Rendre le champ nullable pour que le modèle puisse renvoyer null.
D. Rendre le champ obligatoire.
E19 (scénario 6) Trois outils d'extraction existent (facture, contrat, bon de commande) et le type de document est inconnu. Il
faut une sortie structurée à coup sûr. Réponse attendue à l'examen ?
A. tool_choice: "auto".
B. Forcer l'outil facture.
C. Demander du JSON dans le texte.
D. tool_choice: "any".
E20 (scénario 6) La sortie respecte le schéma, mais les lignes ne font pas le total indiqué. Que faire ?
A. Rendre le schéma plus strict.
B. Extraire calculated_total à côté de stated_total, signaler l'écart et relancer avec l'erreur précise.
C. Arrondir automatiquement les montants.
D. Rejeter tous les documents concernés.
E21 (scénario 6) 10 000 documents d'archive à traiter d'ici la semaine prochaine, budget serré. Stratégie ?
A. Message Batches API, prompt mis au point sur un échantillon, resoumission des seuls échecs par custom_id.
B. Appels synchrones en parallèle maximum.
C. Un seul appel avec tous les documents.
D. Message Batches API sans test préalable, puis tout relancer en cas d'erreur.
Domaine 5 · Context Management & Reliability#
E22 (scénario 1) Après un long échange résumé au fil de l'eau, l'agent ne sait plus le montant exact promis au client. Que faire ? A. Augmenter la taille du résumé. B. Repartir d'une nouvelle conversation. C. Garder un bloc « case facts » (montants, dates, IDs, statuts) inclus à chaque requête, hors de l'historique résumé. D. Demander au client de répéter.
E23 (scénario 1) Pour un problème simple, le client écrit : « je veux parler à un humain ». Que fait l'agent ? A. Il escalade tout de suite. B. Il résout d'abord, puis propose l'humain. C. Il mesure le sentiment pour décider. D. Il demande au client de noter sa confiance.
E24 (scénario 6) Précision globale de 97 % ; on veut supprimer la revue humaine. Préalable ? A. Aucun : 97 % suffit. B. Monter le seuil de confiance à 0,99. C. Passer à un modèle plus grand. D. Mesurer la précision par type de document et par champ, avec un échantillonnage stratifié des extractions à forte confiance.
E25 (scénario 3, 2 réponses) Deux sources fiables donnent des chiffres différents pour la même statistique. Que faire ? A. Garder la valeur de la source la plus citée. B. Conserver les deux valeurs, chacune avec sa source. C. Exiger la date de publication ou de collecte de chaque valeur. D. Publier la moyenne des deux.
5. Les 4 exercices officiels, guidés#
Le guide (§ 8) recommande quatre exercices. Voici comment les mener, avec les labs des chapitres qui en couvrent une partie. Clé
API de test via ANTHROPIC_API_KEY, jamais en dur ; un modèle économique (Claude Haiku 5.5) suffit pour la plupart des étapes ;
budget : quelques dollars par exercice.
5.1 Exercice 1 : un agent multi-outils avec escalade (domaines 1, 2, 5)#
- Définir 3 à 4 outils MCP (par exemple
get_customer,lookup_order,lookup_invoice,process_refund), dont deux proches (commande et facture), avec des descriptions qui donnent formats, exemples et limites (02, § 2). - Écrire la boucle pilotée par
stop_reason(tool_use→ exécuter,end_turn→ répondre) (01, lab 1). - Renvoyer des erreurs structurées :
errorCategory(transient,validation,permission),isRetryable, message lisible ; vérifier que l'agent relance un timeout et explique une erreur métier (02, lab 2). - Ajouter un hook qui bloque un remboursement au-dessus d'un seuil et redirige vers l'escalade (01, lab 3).
- Tester un message à plusieurs sujets (« ma commande est en retard et j'ai été facturé deux fois ») : l'agent doit traiter chaque point puis répondre de façon unifiée.
Résultat attendu : bon outil choisi entre commande et facture, aucun remboursement non conforme, erreurs traitées selon leur type.
5.2 Exercice 2 : Claude Code pour une équipe (domaines 3, 2)#
Couvert par le lab 1 du chapitre 03, qui en est une version guidée :
- CLAUDE.md du projet avec les standards et les conventions de test ; vérifier qu'ils s'appliquent à tous (
/memory). .claude/rules/avecpaths: ["src/api/**/*"]etpaths: ["**/*.test.*"]: vérifier qu'elles ne se chargent que sur les fichiers concernés.- Un skill de projet avec
context: forketallowed-tools: vérifier qu'il tourne isolé. - Un serveur MCP dans
.mcp.jsonavec${VAR}, plus un serveur personnel dans~/.claude.json: les deux visibles en même temps. - Comparer plan mode et direct execution sur un bug d'un fichier, une migration multi-fichiers, une fonctionnalité à plusieurs approches (03, lab 4).
Résultat attendu : configuration partagée par le dépôt, rules conditionnelles, plan mode utile seulement sur les deux derniers cas.
5.3 Exercice 3 : un pipeline d'extraction structurée (domaines 4, 5)#
- Outil d'extraction avec champs obligatoires et optionnels, enum
"other"+ détail, champs nullable ; vérifiernullsur les informations absentes (04, lab 2). - Boucle validation-retry (Pydantic) : renvoyer document, extraction ratée et erreur précise ; noter ce qu'un retry corrige (format) et ce qu'il ne corrige pas (information absente).
- Few-shot sur des structures variées (citations en ligne ou bibliographie, texte ou tableau).
- Lot de 100 documents en Message Batches API : reprise par
custom_id, découpe des documents trop longs, calcul du délai par rapport au SLA (04, lab 3). - Confiance par champ et routage vers la revue humaine ; analyser la précision par type de document et par champ (05, lab 3).
Résultat attendu : aucune valeur inventée, retries ciblés, revue humaine concentrée sur les cas incertains.
5.4 Exercice 4 : un pipeline de recherche multi-agents (domaines 1, 2, 5)#
- Coordinator avec deux subagents (recherche web, analyse de documents) ;
allowedToolscontient"Task"(état actuel :"Agent") et chaque subagent reçoit ses données dans son prompt (01, lab 2). - Appels parallèles dans une seule réponse ; mesurer le gain de latence par rapport au séquentiel.
- Findings structurés : affirmation, extrait, source, date ; vérifier que la synthèse garde l'attribution.
- Simuler un timeout : le coordinator reçoit type d'échec, requête, résultats partiels, et annote les trous de couverture (05, lab 2).
- Deux sources contradictoires : les deux valeurs conservées, sections « établi » et « contesté » (05, lab 5).
Résultat attendu : un rapport complet, sourcé, qui dit ce qu'il n'a pas pu couvrir.
6. Fiche à retenir globale#
- 60 questions, 4 scénarios sur 6, 120 minutes, 720 sur 1 000 ; on répond selon le guide v1.0.
- Règle à respecter à 100 % → code (hook, gate) ; préférence → prompt.
- Mauvais outil choisi → d'abord la description ; trop d'outils → jeu restreint par rôle.
- Erreurs :
isError, catégorie,isRetryable; vide valide ≠ échec d'accès ; jamais masquer, jamais tout arrêter. - Un pan du sujet manque → décomposition du coordinator ; citations perdues → métadonnées perdues au passage de relais.
- Subagents : contexte explicite dans le prompt, appels parallèles dans une réponse, tout passe par le coordinator.
- Partagé = dans le dépôt ; personnel =
~/.claude/; conventions par type de fichier = rules avecpaths. - Tâche architecturale = plan mode ; changement simple = direct ; découverte verbeuse = Explore subagent.
- CI :
-p,--output-format json,--json-schema, constats précédents fournis, instance indépendante. - Précision : critères explicites, pas « sois prudent » ; 14 fichiers = passes par fichier + intégration.
- Schéma : syntaxe garantie, sens non ; nullable contre l'invention ; retry inutile si l'info est absente.
- Batch : -50 %, jusqu'à 24 h, pas de SLA,
custom_id; jamais pour un check bloquant. - Longues conversations : case facts ; demande d'un humain = escalade immédiate ; ni sentiment ni confiance auto-déclarée.
- 97 % global ne suffit pas : mesurer par type et par champ, échantillonnage stratifié.
- Sources en conflit : garder les deux valeurs, sources et dates.
7. Corrigé des questions d'entraînement#
| # | Réponse | Explication | Section |
|---|---|---|---|
| E1 | B | seul stop_reason est fiable ; texte + tool_use peuvent coexister ; un plafond n'est qu'un garde-fou |
01 § 1 |
| E2 | C | plusieurs Task dans une seule réponse s'exécutent en parallèle |
01 § 3 |
| E3 | A | la prose a fait perdre URL, document et date : passer des findings structurés | 01 § 3 |
| E4 | D | conformité exigée à 100 % = interception déterministe avant l'exécution | 01 § 5 |
| E5 | B | PostToolUse normalise les données avant que le modèle les lise |
01 § 5 |
| E6 | C | le contexte reste valable ; signaler les fichiers changés évite une ré-exploration complète | 01 § 7 |
| E7 | A | tâche ouverte = décomposition dynamique et plan priorisé | 01 § 6 |
| E8 | B | supprimer le chevauchement par le nom et la description, exemple même du guide | 02 § 2 |
| E9 | D | l'agent doit savoir si l'erreur se relance ; « aucune commande » est un résultat valide | 02 § 3 |
| E10 | A | partagé = .mcp.json du projet, secret par variable d'environnement, communautaire d'abord |
02 § 5 |
| E11 | C | Read + Write est le repli fiable quand Edit ne trouve pas d'ancre unique | 02 § 6 |
| E12 | B | ~/.claude/CLAUDE.md n'est pas partagé ; diagnostiquer avec /memory |
03 § 2 |
| E13 | A | chargement conditionnel par globs, exactement l'exemple du guide | 03 § 4 |
| E14 | D | context: fork exécute le skill dans un contexte isolé |
03 § 3 |
| E15 | C | les constats précédents en contexte évitent les doublons | 03 § 7 |
| E16 | B | des exemples concrets lèvent l'ambiguïté de la prose | 03 § 6 |
| E17 | A | critères catégoriels et désactivation temporaire ; « sois prudent » et le seuil de confiance ne marchent pas | 04 § 2 |
| E18 | C | un champ obligatoire pousse à inventer ; nullable autorise null |
04 § 4 |
| E19 | D | any garantit un appel d'outil tout en laissant choisir le schéma (état actuel : refusé par Opus 5.5, Sonnet 5.5, Fable 5.1 → auto + strict) |
04 § 4 |
| E20 | B | erreur sémantique : un champ de contrôle et un retry avec l'erreur précise | 04 § 5 |
| E21 | A | non urgent et volumineux = batch ; mettre au point sur un échantillon réduit les resoumissions | 04 § 6 |
| E22 | C | le résumé progressif écrase les valeurs exactes ; le case facts block les garde | 05 § 2 |
| E23 | A | une demande explicite d'humain s'honore tout de suite | 05 § 3 |
| E24 | D | une moyenne peut cacher un type de document raté | 05 § 6 |
| E25 | B, C | garder les deux valeurs sourcées et datées (une différence de date n'est pas une contradiction) | 05 § 7 |
Références#
Lues le 21/10/2026 :
- Claude Certified Architect – Foundations Exam Guide v1.0 (juillet 2026), § 3 (format), § 5 (scénarios), § 8 (exercices), § 9 (questions d'exemple), § 14 (confidentialité)
- Anthropic Partner Academy, page de la certification
- claudecertificationguide.com, base des leçons du cours
- Sources techniques : voir les références des chapitres 01 à 05