

Version : 1.1 · Date : 2026-10-22 · Domaine 1 : Agents and Workflows (14,7 %)
En une phrase : on choisit la solution la plus simple qui marche (un appel, puis un workflow, puis un agent seulement si le chemin est imprévisible), on construit l'agent sur un harness qui plafonne tours et dépenses (Claude Agent SDK chez soi, Claude Managed Agents chez Anthropic), et on garantit les règles métier par du code (hooks), jamais par le seul prompt.
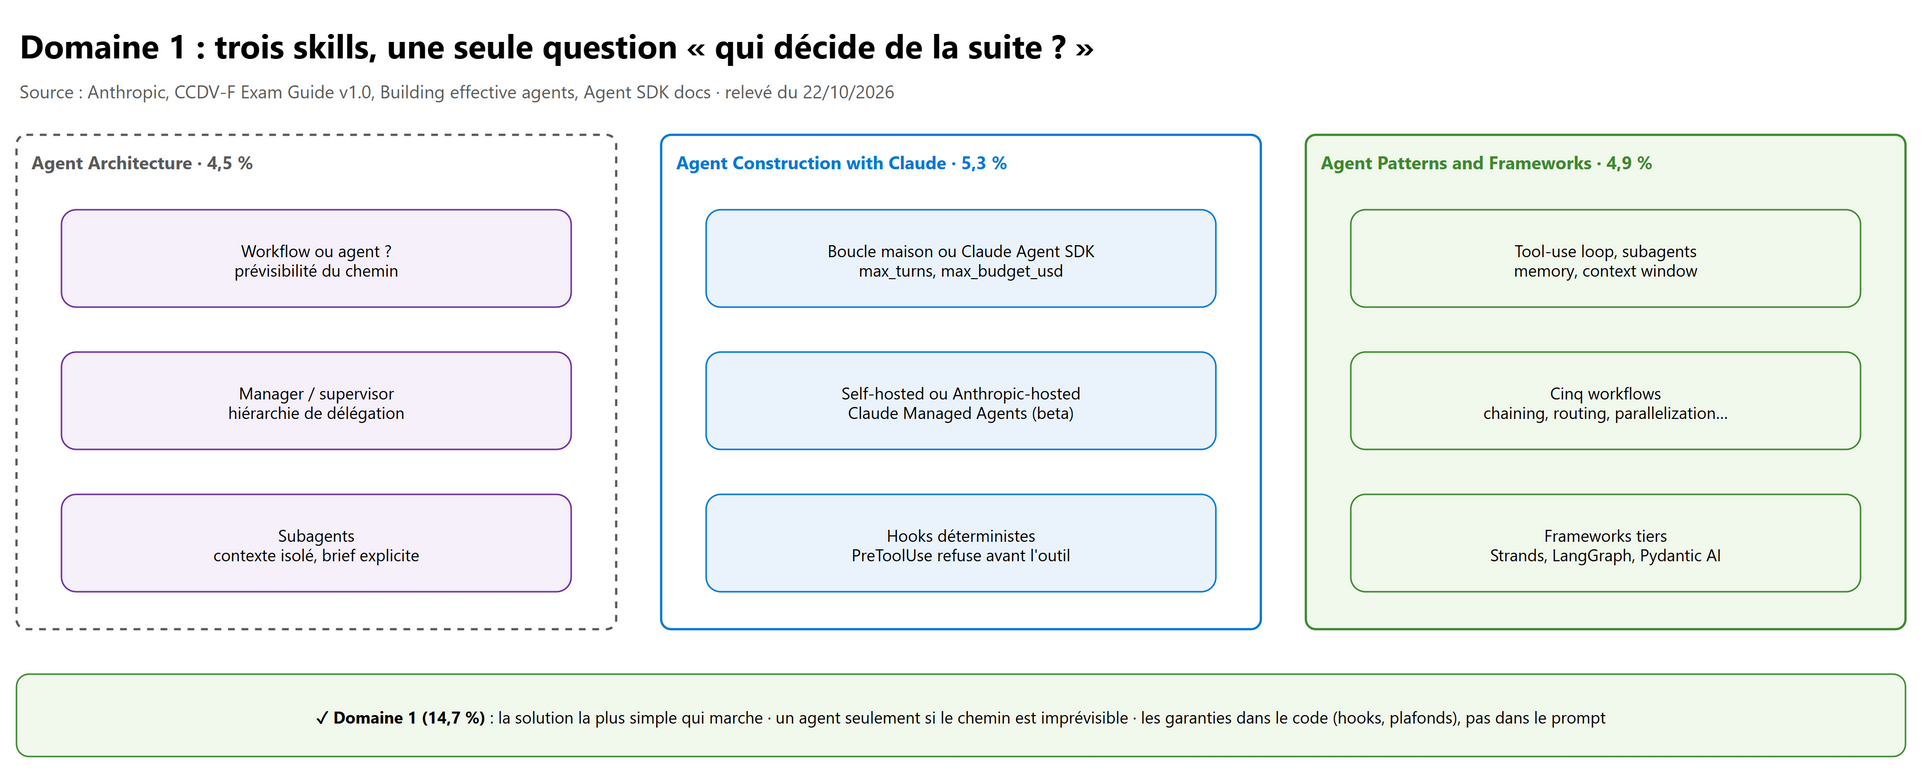
Ce chapitre ouvre le cours Claude Developer. Le cours voisin Claude Architect traite déjà en profondeur la boucle agentique, le coordinator, le passage de contexte, les hooks et les sessions : ici, on renvoie à ses sections et on ajoute ce qui est propre au CCDV-F (workflow ou agent, les cinq workflows, Claude Managed Agents, frameworks tiers).
Ce que l'examen demande#
Texte officiel du Claude Certified Developer – Foundations Exam Guide v1.0 (juillet 2026) :
| # | Skill (guide officiel, en anglais) | Poids | Section |
|---|---|---|---|
| 1.1 | Agent Architecture : Principles, patterns, and tradeoffs of agent and workflow architecture, including the decision criteria for using a workflow versus an agent, the structure of manager/supervisor hierarchies, and the role of subagents in improving task execution. | 4,5 % | 1 |
| 1.2 | Agent Construction with Claude : Methods, tools, and platforms for constructing Claude agents, including the Claude Agent SDK, custom agent loops and harnesses, managed agent deployment models (self-hosted vs. Anthropic-hosted), and hooks for deterministic actions. | 5,3 % | 2 |
| 1.3 | Agent Patterns and Frameworks : Common agent design patterns (tool-use loops, sub-agents, memory, context-window management) and agentic abstraction frameworks (e.g., Strands, LangGraph, PydanticAI) for building agents and workflows for multi-step tasks. | 4,9 % | 3 |
Convention du cours : le produit évolue plus vite que le guide v1.0. Quand c'est le cas, un encadré donne d'abord la réponse d'examen (celle du guide), puis l'état actuel du produit (relevé le 22/10/2026 sur la doc officielle).
0. L'examen CCDV-F en bref#
| Élément | Valeur (guide officiel v1.0) |
|---|---|
| Nom, code | Claude Certified Developer – Foundations, CCDV-F |
| Format | 53 questions à choix multiple ou à réponses multiples (le nombre de réponses attendues est indiqué) |
| Durée, surveillance | 120 minutes, surveillé, en ligne ou en centre Pearson VUE |
| Réussite | score mis à l'échelle de 720 sur 100-1 000, avec un pourcentage par domaine sur le rapport |
| Prix, validité | 125 USD par tentative ; valable 12 mois, renouvellement gratuit sur l'Anthropic Partner Academy |
| Reprises | après 14, puis 30, puis 90 jours ; 4 tentatives au plus sur 12 mois glissants |
| Technologies couvertes | Claude API et SDK clients, Claude Agent SDK, Claude Code, Skills, MCP |
| # | Domaine | Poids | Chapitre |
|---|---|---|---|
| 1 | Agents and Workflows | 14,7 % | 01 (ce chapitre) |
| 2 | Applications and Integration | 33,1 % | 02, 03 |
| 3 | Claude Code | 3,1 % | 03 |
| 4 | Eval, Testing, and Debugging | 2,6 % | 08 |
| 5 | Model Selection and Optimization | 16,8 % | 04 |
| 6 | Prompt and Context Engineering | 11,0 % | 05 |
| 7 | Security and Safety | 8,1 % | 06 |
| 8 | Tools and MCPs | 10,6 % | 07 |
Différence avec le CCAR-F (Architect) : l'Architect est bâti sur des scénarios d'architecture (4 tirés parmi 6) et pèse lourd sur l'orchestration (27 %). Le Developer est un examen de développeur : plus d'un tiers porte sur l'intégration applicative et les mécanismes de l'API (domaine 2, 33,1 %), et il ajoute le choix de modèle et les coûts (16,8 %) et la sécurité (8,1 %), presque absents de l'Architect. Environ 40 % des notions sont communes : ce cours y renvoie.
1. Agent Architecture (skill 1.1)#
1.1 La taxonomie : augmented LLM, workflow, agent#
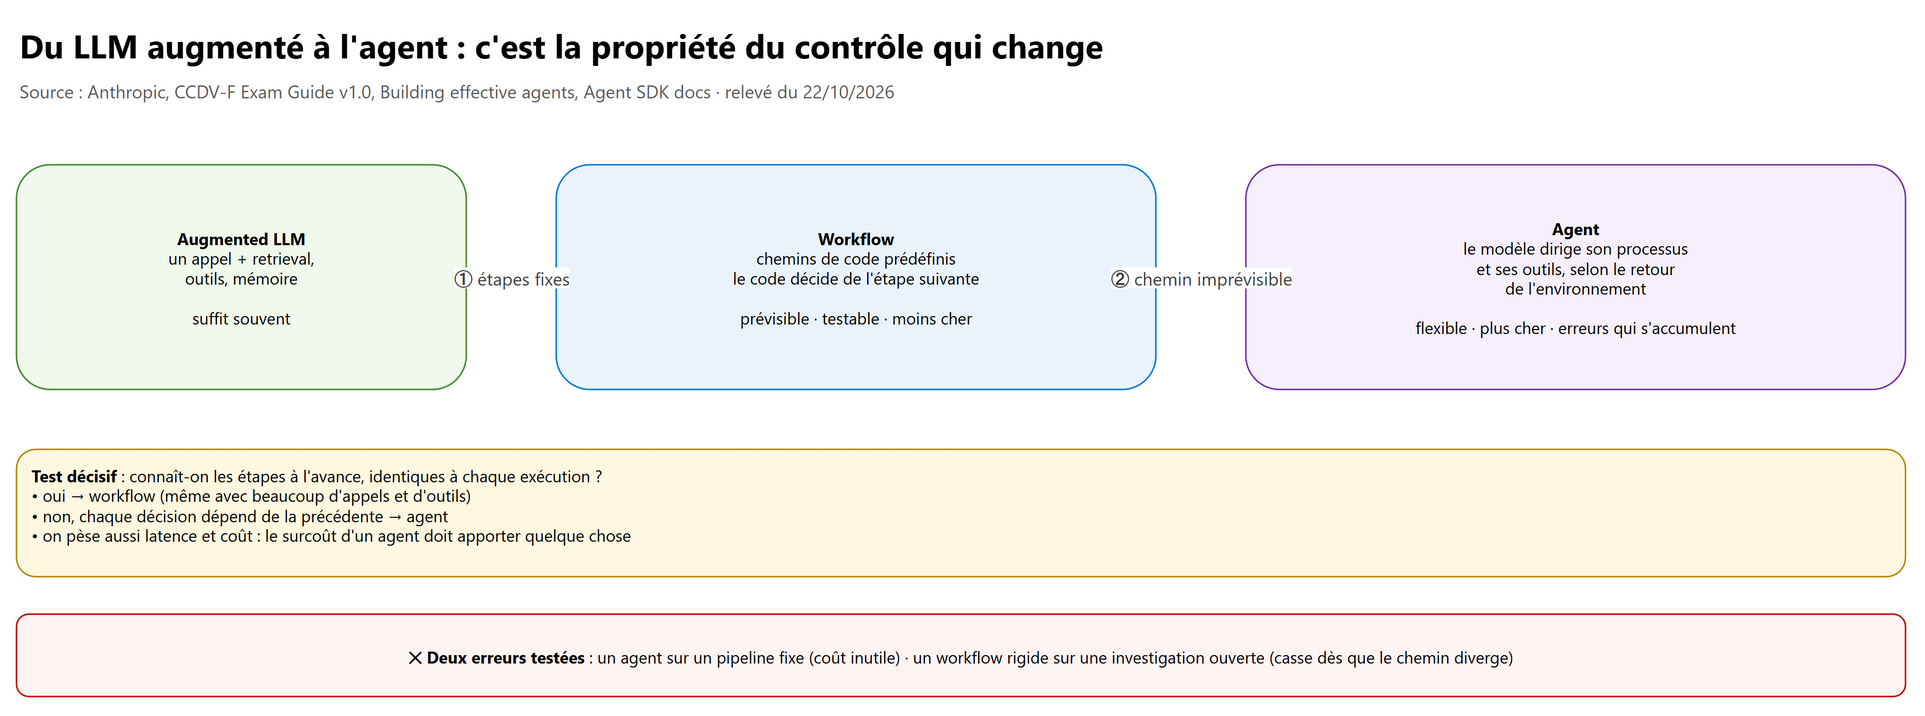
Le critère de classement d'Anthropic est simple : qui décide de l'étape suivante ?
| Niveau | Définition (Building effective agents) | Qui décide | Exemple |
|---|---|---|---|
| Augmented LLM | Un appel de modèle enrichi de retrieval, d'outils et de mémoire | Personne : un seul appel | Répondre à une question avec trois documents injectés |
| Workflow | « Systems where LLMs and tools are orchestrated through predefined code paths » | Le code | Résumer, puis traduire, puis vérifier le format d'un rapport |
| Agent | Le modèle dirige lui-même son processus et son usage des outils, selon le retour de l'environnement | Le modèle | Corriger un test qui échoue : lire, chercher, modifier, relancer, recommencer |
Piège classique : plusieurs appels et l'accès aux outils ne font pas un agent. Un pipeline codé en trois étapes reste un workflow, même avec un modèle très capable.
1.2 Workflow ou agent : les critères de décision#
La règle d'Anthropic : trouver la solution la plus simple possible, et n'ajouter de la complexité que si elle améliore nettement le résultat. Un système agentique échange de la latence et du coût contre de la performance sur les tâches ouvertes ; pour beaucoup d'applications, un seul appel bien optimisé (retrieval, exemples en contexte) suffit.
| Question | Workflow | Agent |
|---|---|---|
| Connaît-on les étapes à l'avance ? | Oui, identiques à chaque exécution | Non : chaque décision dépend de la précédente |
| Faut-il prédire et tester le comportement ? | Oui : chemin fixe, testable | Moins : comportement émergent, tests en sandbox |
| Coût et latence | Maîtrisés | Plus élevés, erreurs qui peuvent s'accumuler |
| Exemple de tâche | Classer puis traiter un ticket, extraire puis valider un document | Enquêter sur un incident, refactorer un module inconnu |
flowchart TD
    A["Nouvelle tâche"] --> B{"Un seul appel bien outillé<br/>(retrieval, exemples) suffit ?"}
    B -- oui --> C["Augmented LLM"]
    B -- non --> D{"Étapes connues d'avance<br/>et identiques à chaque fois ?"}
    D -- oui --> E{"Une décision de<br/>classification au départ ?"}
    E -- oui --> F["Routing"]
    E -- non --> G["Prompt chaining<br/>ou parallelization"]
    D -- non --> H{"Critères de qualité clairs<br/>et raffinement utile ?"}
    H -- oui --> I["Evaluator-optimizer"]
    H -- non --> J{"Sous-tâches découvertes<br/>en cours de route ?"}
    J -- oui --> K["Agent, ou orchestrator-workers<br/>(subagents)"]
    J -- non --> G
1.3 Manager / supervisor et subagents#
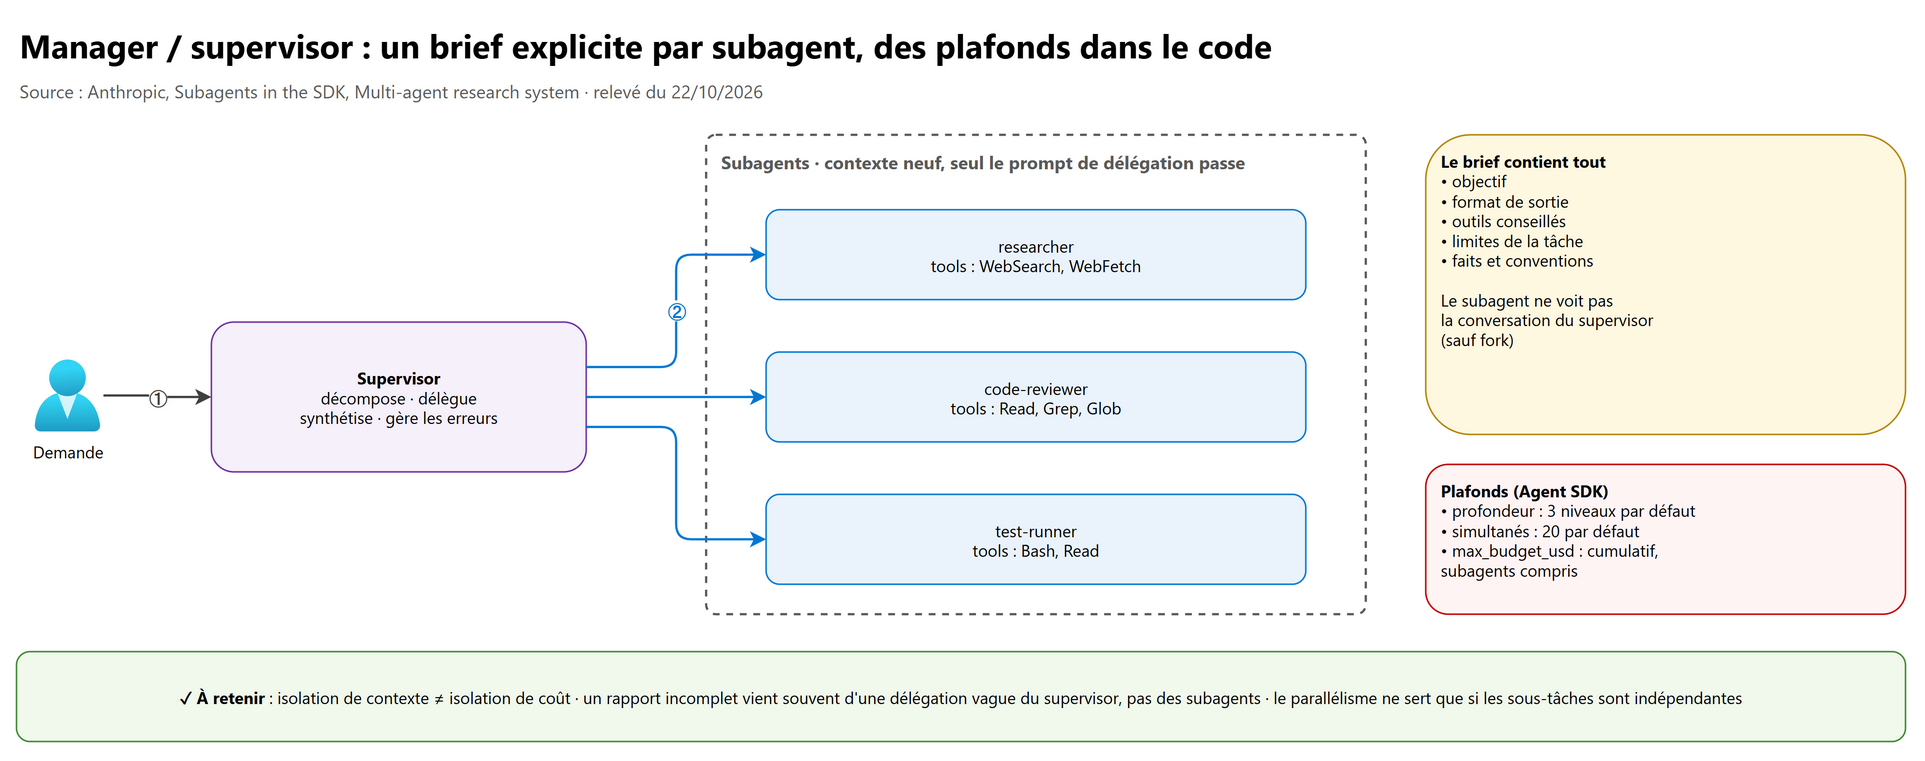
Dans une hiérarchie manager / supervisor (orchestrator-workers), un agent principal décompose la tâche, délègue à des subagents spécialisés et synthétise leurs résultats. Les règles détaillées (hub-and-spoke, quatre responsabilités du coordinator, piège de la décomposition trop étroite) sont dans Architect § 2. Ce qu'il faut retenir pour le CCDV-F :
| Point | Ce qui est documenté | Conséquence |
|---|---|---|
| Contexte isolé | Un subagent démarre avec un contexte neuf : seul le prompt de l'outil Agent lui parvient, plus son propre system prompt, le CLAUDE.md du projet et ses outils | Le brief doit contenir objectif, format de sortie, outils conseillés, limites, faits et conventions (Architect § 3) |
| Ce qui remonte | Les appels d'outils intermédiaires restent dans le subagent : seul son message final revient au parent | Le contexte du parent grossit d'un résumé, pas de toute l'exploration |
| Fork | Un fork copie la conversation au lieu de partir de zéro (subagent_type: "fork", refusable par la règle Agent(fork)) |
Exception à la règle du contexte isolé |
| Parallélisme | Plusieurs subagents peuvent tourner en même temps | Utile seulement si les sous-tâches sont indépendantes |
| Plafonds | Profondeur : 3 niveaux sous l'agent principal (CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH) ; 20 subagents simultanés (CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS) ; max_budget_usd cumulatif, subagents compris |
Isolation de contexte ≠ isolation de coût |
Diagnostic d'un mauvais résultat multi-agent : commencer par le supervisor (délégation vague, périmètres qui se chevauchent, trop de subagents lancés), pas par les subagents qui ont fait ce qu'on leur a demandé.
Réponse d'examen : hub-and-spoke strict, tout passe par le supervisor.
État actuel (doc Agent SDK, relevé du 22/10/2026) : par défaut, un subagent lancé par l'agent principal tourne en arrière-plan (
status: "async_launched") et son rapport arrive dans un tour suivant ; l'outilSendMessagepermet d'écrire à d'autres agents nommés de la session. À l'examen, on répond hub-and-spoke.
Côté Claude Managed Agents (voir § 2.3), la délégation est
encadrée par la plateforme : un seul niveau de délégation (un agent listé qui a lui-même une configuration multiagent fait
échouer la requête en 400), jusqu'à 20 agents dans la liste predefined_agents, et au plus 25 child threads actifs ou
inactifs par session. Tous partagent le sandbox, le système de fichiers et les credentials du vault, chacun dans son propre
session thread au contexte isolé.
1.4 Quand ne pas utiliser d'agent, ni plusieurs#
- Étapes fixes : un agent coûte plus cher pour un résultat moins prévisible qu'un workflow.
- Sous-tâches couplées : plusieurs agents en parallèle sur des sous-tâches qui dépendent l'une de l'autre se marchent dessus.
- Plus de subagents ≠ meilleur résultat : chaque subagent consomme des jetons et doit être briefé.
- Règle stricte : si une règle doit être garantie (jamais la base de prod, montant maximal de remboursement), ce n'est pas une question d'architecture d'agent mais de hook ou de gate dans l'outil (§ 2.4).
2. Agent Construction with Claude (skill 1.2)#
2.1 La boucle nue et le harness#
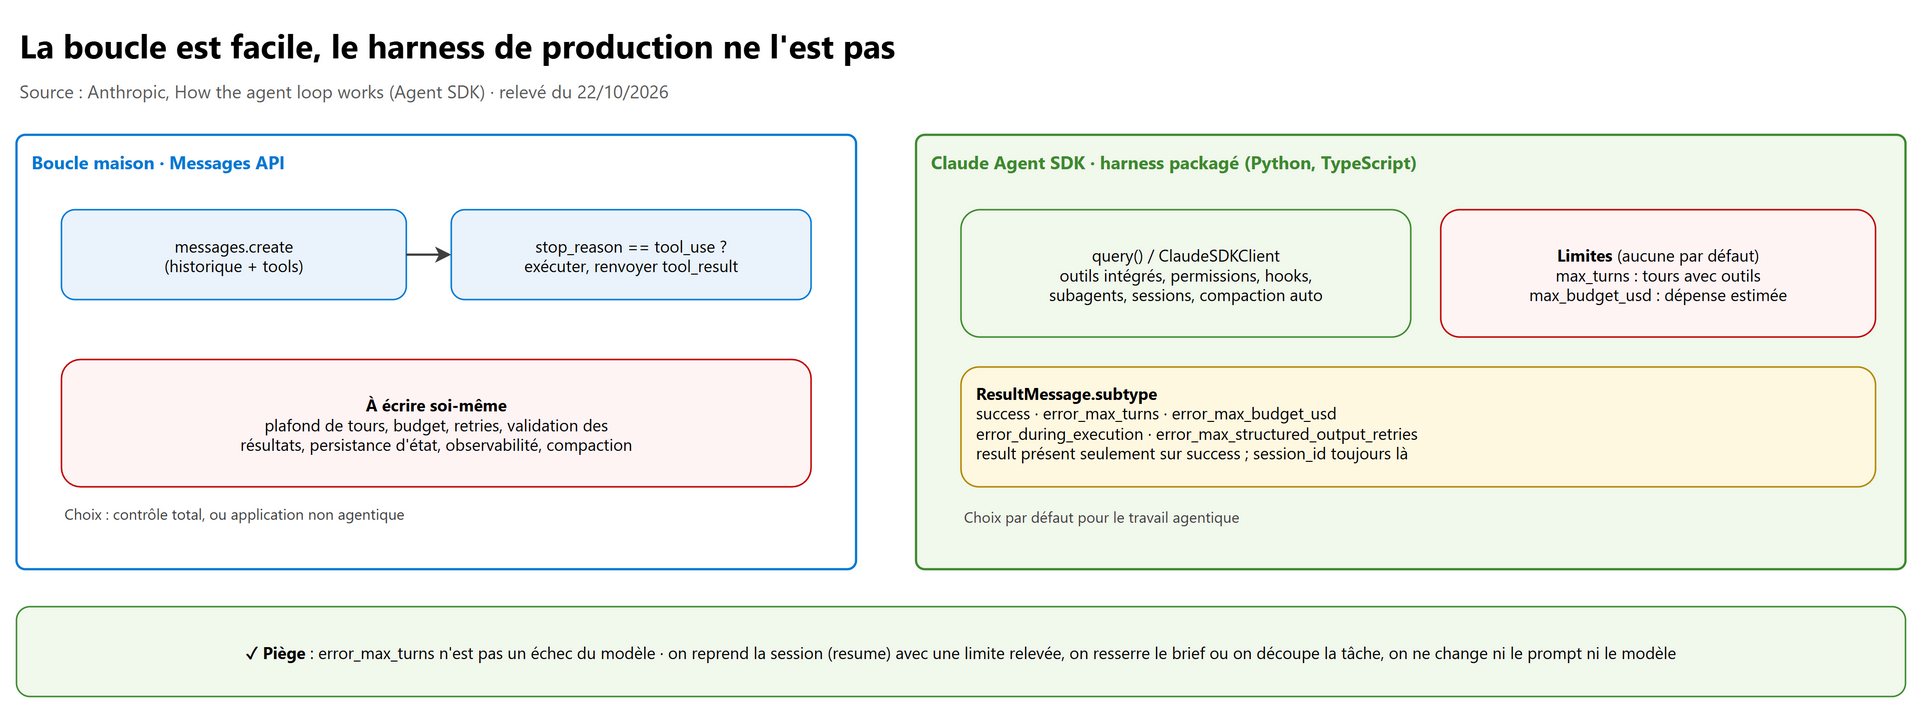
Toute boucle d'agent a la même forme : envoyer le prompt et les définitions d'outils, exécuter les outils demandés, renvoyer les
tool_result, recommencer jusqu'à une réponse sans appel d'outil. Le code complet sur la Messages API (pilotage par
stop_reason, anti-patterns) est dans Architect § 1.
Le harness, c'est tout ce qui entoure la boucle en production : plafond de tours, budget, nouvelles tentatives, validation des
résultats d'outils, persistance de l'état, observabilité, compaction. Ces mécanismes relèvent du code, jamais du prompt :
« arrête-toi après trente appels » dans un prompt est une demande ; max_turns met fin à l'exécution.
| Choix | Quand |
|---|---|
| Boucle maison (Messages API) | Contrôle total exigé, ou application non agentique (workflow fixe) |
| Claude Agent SDK | Choix par défaut pour un agent dans votre processus : le harness de Claude Code, déjà écrit |
| Claude Managed Agents | Le harness et le sandbox sont exécutés par Anthropic (§ 2.3) |
2.2 Le Claude Agent SDK#
Le SDK (Python claude_agent_sdk, TypeScript @anthropic-ai/claude-agent-sdk) embarque la boucle de Claude Code : outils
intégrés (Read, Edit, Write, Glob, Grep, Bash, WebSearch, WebFetch, Agent, Skill…), permissions, hooks,
subagents, sessions avec reprise et compaction automatique.
Deux modes d'entrée :
| Mode | Appel | Usage |
|---|---|---|
| Single message input | query(prompt="…") |
Réponse ponctuelle, environnement sans état (fonction serverless, job planifié) |
| Streaming input (mode recommandé) | ClaudeSDKClient (Python) ou générateur asynchrone de messages |
Processus longue durée : images en pièce jointe, messages en file d'attente, interruptions |
Limites et résultat (aucune limite par défaut ; un budget est un bon défaut en production) :
import asyncio
from claude_agent_sdk import query, ClaudeAgentOptions, ResultMessage


async def main():
    session_id = None
    try:
        async for message in query(
            prompt="Trouve et corrige le test qui échoue dans le module auth",
            options=ClaudeAgentOptions(
                allowed_tools=["Read", "Edit", "Bash", "Glob", "Grep"],  # pré-approuvés, sans demande
                max_turns=30,          # tours avec outils
                max_budget_usd=2.0,    # dépense estimée, subagents compris
            ),
        ):
            if isinstance(message, ResultMessage):
                session_id = message.session_id           # présent même en cas d'erreur
                if message.subtype == "success":
                    print(message.result)                 # result n'existe que sur success
                else:
                    print(f"Arrêt : {message.subtype}, reprendre la session {session_id}")
    except Exception as error:
        # un query() en un coup lève une exception APRÈS avoir livré le ResultMessage d'erreur
        print(f"Session terminée en erreur : {error}")


asyncio.run(main())
ResultMessage.subtype |
Signification | Bonne réaction |
|---|---|---|
success |
Terminé normalement, result présent |
Lire result |
error_max_turns |
Plafond de tours atteint | Reprendre la session (resume=session_id) avec une limite relevée, resserrer le brief ou découper la tâche |
error_max_budget_usd |
Plafond de dépense atteint | Revoir le budget ou le périmètre de la tâche |
error_during_execution |
Erreur pendant la boucle (requête annulée, plantage) | Diagnostiquer l'intégration (chapitre 08) |
error_max_structured_output_retries |
Aucune sortie structurée valide dans la limite de tentatives | Revoir le schéma ou le prompt |
Tous les sous-types portent total_cost_usd, usage (boucle principale seulement, sans les sous-agents : préférer model_usage pour
la comptabilité), num_turns et session_id. Le champ stop_reason du résultat indique
pourquoi le modèle s'est arrêté au dernier tour (end_turn, max_tokens, refusal).
Piège d'examen :
error_max_turnsn'est pas un échec du modèle. C'est une limite que vous avez configurée. Changer de modèle ou réécrire le prompt ne corrige pas un plafond mal dimensionné. Etmax_iterations,turn_capoubudget_limitn'existent pas dans l'Agent SDK : les noms sontmax_turns/maxTurnsetmax_budget_usd/maxBudgetUsd.
L'option effort (low, medium, high, xhigh, max) règle la profondeur de raisonnement par session, et
AgentDefinition.effort (niveau nommé ou entier) par sous-agent ; le choix des modèles et de l'effort est détaillé au chapitre 04.
2.3 Où l'agent s'exécute : self-hosted ou Anthropic-hosted#
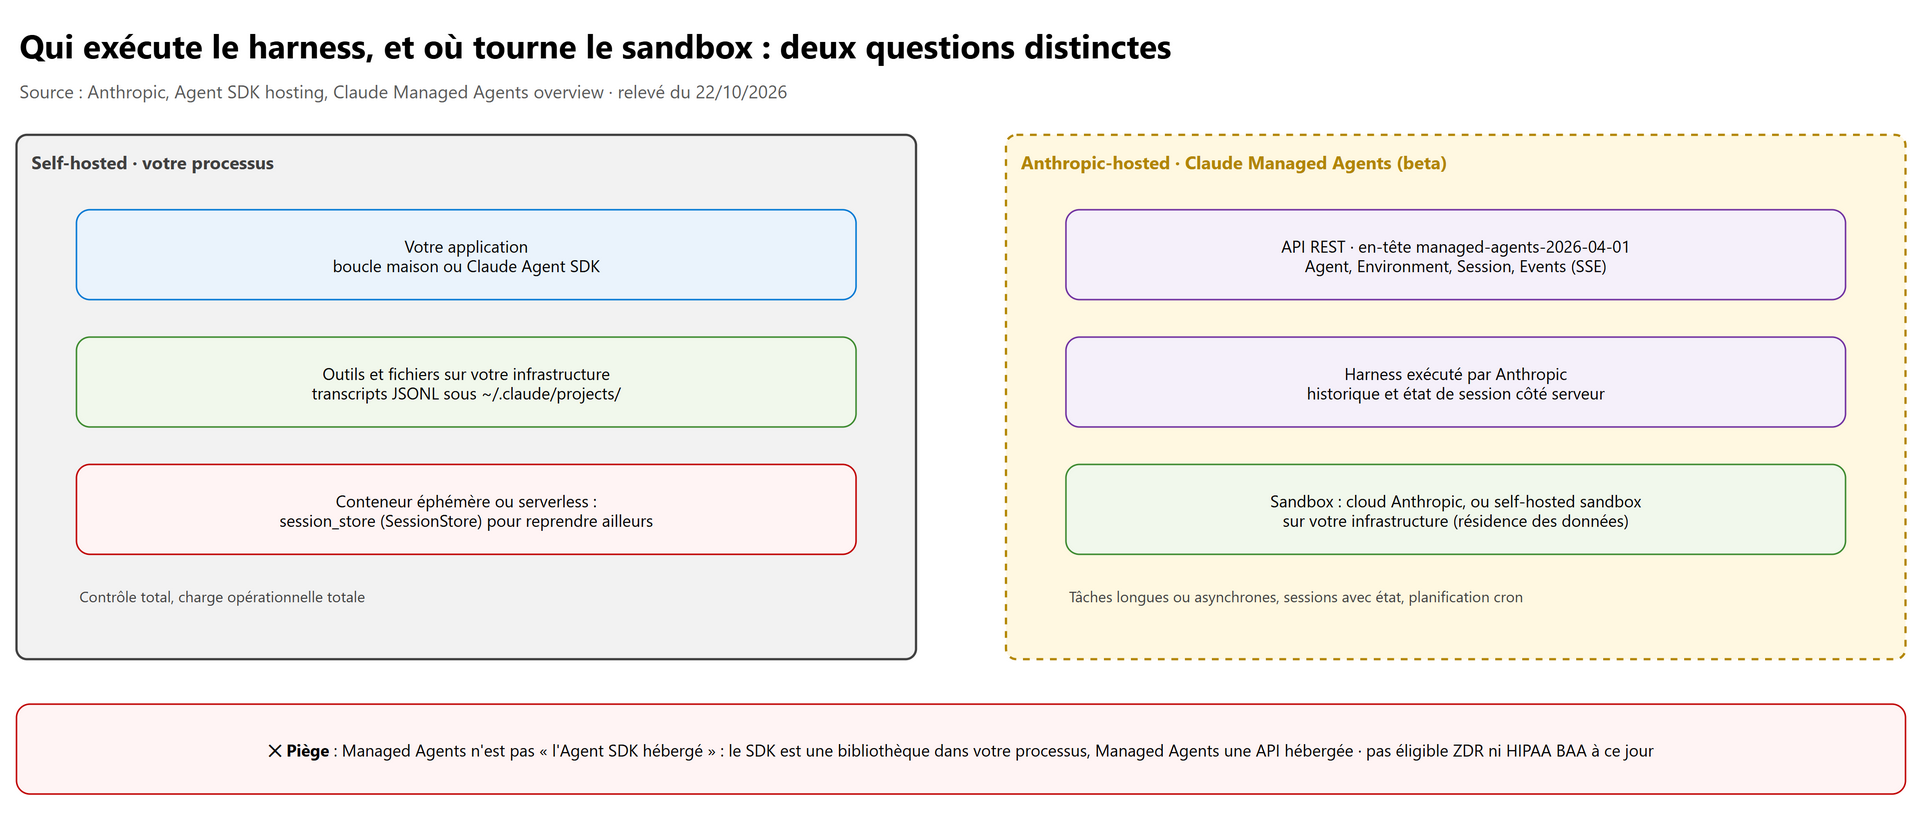
Le guide distingue deux modèles de déploiement. Il faut séparer deux questions : qui exécute le harness, et où tourne le sandbox (outils, fichiers, trafic sortant).
| Self-hosted (boucle maison ou Agent SDK) | Anthropic-hosted : Claude Managed Agents | |
|---|---|---|
| Nature | Bibliothèque ou code dans votre processus | API REST hébergée : un harness préconfiguré qui tourne sur une infrastructure gérée |
| Statut | Disponible | Beta : en-tête managed-agents-2026-04-01 sur tous les endpoints (le SDK l'ajoute) |
| Concepts | query(), options, sessions locales |
Agent (modèle, system prompt, outils, MCP servers, skills), Environment (où tournent les sessions), Session, Events (SSE) |
| Sandbox | Votre machine, conteneur ou serverless | Cloud sandbox géré par Anthropic, ou self-hosted sandbox sur votre infrastructure |
| État | Transcripts JSONL locaux ; session_store pour reprendre sur un autre hôte |
Historique, état du sandbox et sorties conservés côté serveur |
| Cas d'usage | Contrôle total, intégration dans votre application | Tâches longues (minutes, heures), asynchrones, sessions avec état, exécutions planifiées (cron), peu d'infrastructure |
| Limites à connaître | Charge opérationnelle complète | Pas éligible à Zero Data Retention ni à la HIPAA BAA à ce jour |
Piège d'examen : Claude Managed Agents n'est pas « l'Agent SDK hébergé ». Ce sont deux produits : le SDK exécute la boucle dans votre processus ; Managed Agents expose un harness hébergé par une API.
Self-hosted SDK en conteneur : par défaut, le SDK écrit les transcripts sur le disque local (
~/.claude/projects/). Un conteneur détruit perd donc la session. Pour reprendre ailleurs, passer un adaptateursession_store/sessionStore, qui réplique les transcripts vers votre stockage.
2.4 Hooks pour les actions déterministes#
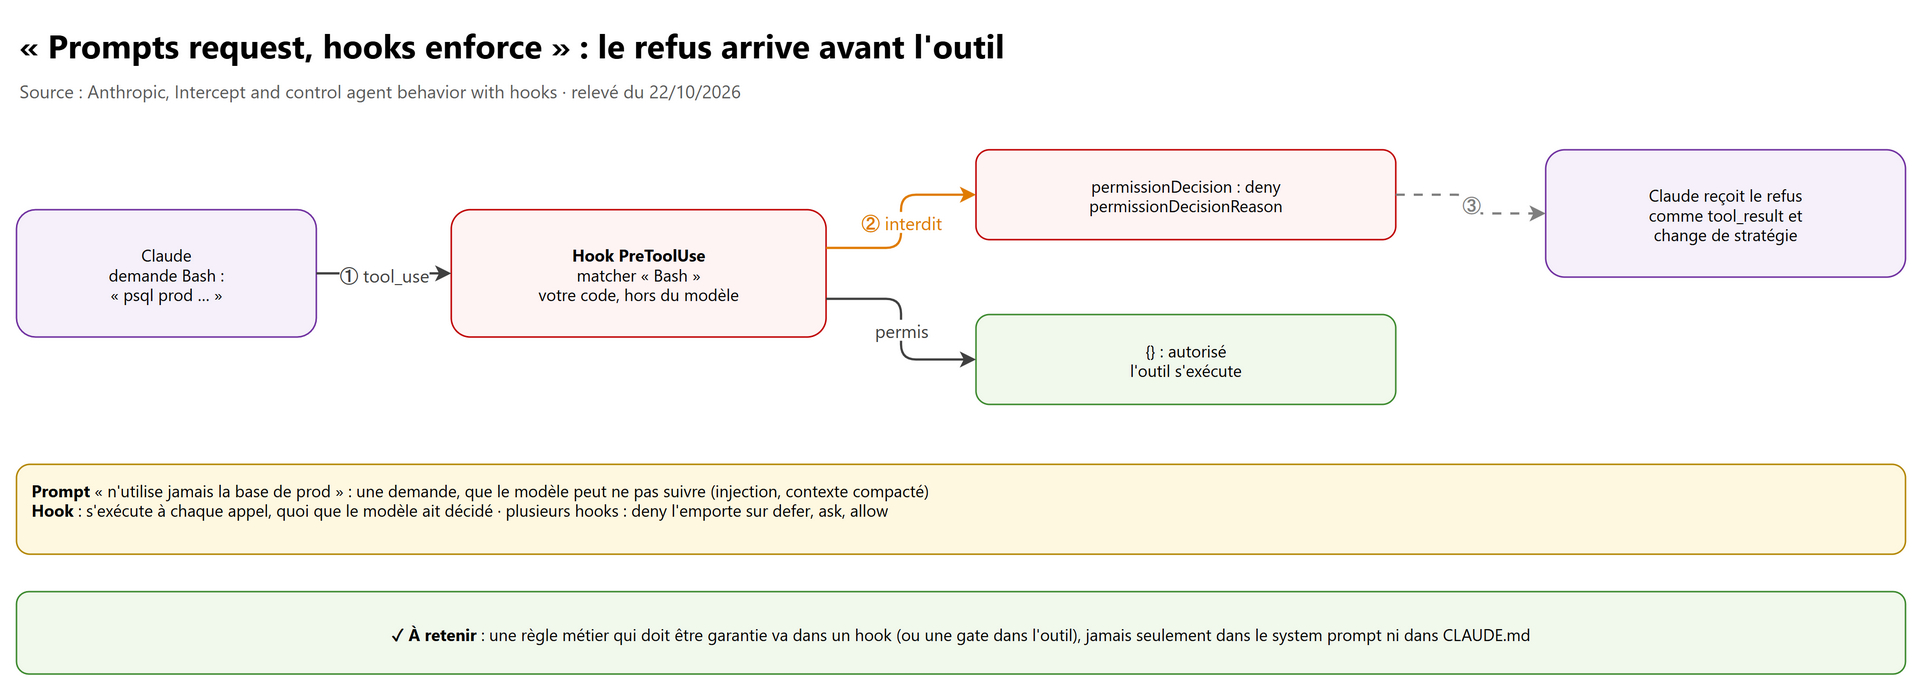
Un hook est du code de votre application exécuté à un point fixe de la boucle. Il ne consomme pas de contexte et ne dépend pas du bon vouloir du modèle. La formule à retenir : « Prompts request, hooks enforce ».
from claude_agent_sdk import ClaudeAgentOptions, HookMatcher

PROD_CLI = ("psql", "prod-db")  # motifs interdits, à adapter


async def bloquer_prod(input_data, tool_use_id, context):
    commande = input_data["tool_input"].get("command", "")
    if any(motif in commande for motif in PROD_CLI):
        return {
            "hookSpecificOutput": {
                "hookEventName": input_data["hook_event_name"],
                "permissionDecision": "deny",
                "permissionDecisionReason": "Accès à la base de production interdit",
            }
        }
    return {}  # objet vide : l'appel continue


options = ClaudeAgentOptions(hooks={"PreToolUse": [HookMatcher(matcher="Bash", hooks=[bloquer_prod])]})
| Hook | Quand | Usage typique |
|---|---|---|
PreToolUse |
Avant l'exécution d'un outil | Bloquer (deny), demander (ask), modifier l'entrée (updatedInput) |
PostToolUse |
Après le retour de l'outil | Auditer, ajouter du contexte, remplacer la sortie (updatedToolOutput) |
Stop |
Fin de l'agent | Valider le résultat, sauvegarder l'état |
SubagentStart / SubagentStop |
Lancement et fin d'un subagent | Suivre et agréger les tâches parallèles |
PreCompact |
Avant la compaction | Archiver le transcript complet |
Points d'examen :
- Le refus revient à Claude comme un résultat d'outil : il change de stratégie au lieu de planter.
- Plusieurs hooks
PreToolUseen désaccord :denyl'emporte, puisdefer, puisask, puisallow. - Un matcher porte sur le nom de l'outil (
Bash,Write|Edit,^mcp__), pas sur les arguments : filtrer le chemin ou la commande dans la fonction. - Le détail (deux directions, normalisation des données, règle de décision) est dans Architect § 5 ; les hooks comme garde-fous de sécurité sont repris au chapitre 06.
sequenceDiagram
    participant C as Claude
    participant H as Hook PreToolUse (votre code)
    participant T as Outil Bash
    C->>H: tool_use « psql prod … »
    H-->>C: deny + permissionDecisionReason
    Note over T: l'outil n'est jamais exécuté
    C->>H: tool_use « npm test »
    H->>T: {} (autorisé)
    T-->>C: tool_result
3. Agent Patterns and Frameworks (skill 1.3)#
3.1 Les cinq workflows#
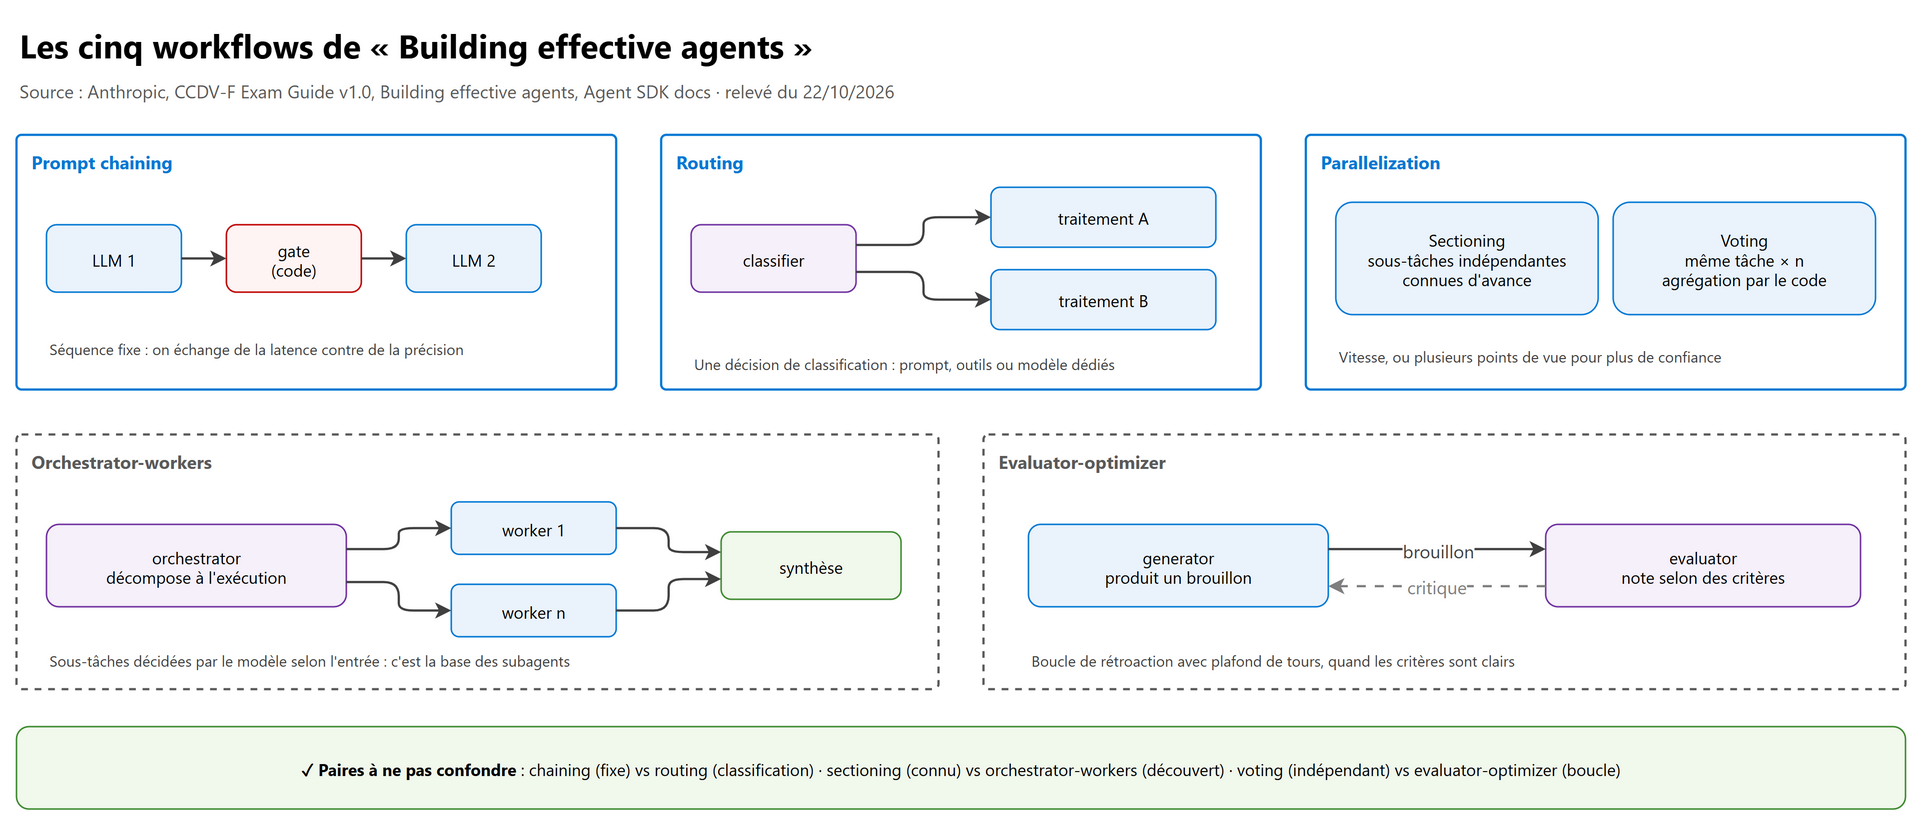
| Pattern | Principe | Quand l'utiliser (Anthropic) |
|---|---|---|
| Prompt chaining | Étapes séquentielles, chaque appel traite la sortie du précédent, avec des gates programmatiques possibles | Tâche décomposable en sous-tâches fixes ; on échange de la latence contre de la précision |
| Routing | Classer l'entrée, puis l'envoyer vers un traitement spécialisé (prompt, outils ou modèle dédiés) | Catégories distinctes, classification fiable ; par exemple, requêtes simples vers un petit modèle, difficiles vers un modèle plus capable |
| Parallelization | Sectioning : sous-tâches indépendantes en parallèle ; voting : même tâche répétée, puis agrégation | Gagner du temps, ou obtenir plusieurs points de vue pour plus de confiance |
| Orchestrator-workers | Un modèle central décompose à l'exécution, délègue, synthétise | Sous-tâches imprévisibles, décidées selon l'entrée : c'est la base des subagents |
| Evaluator-optimizer | Un modèle génère, un autre évalue selon des critères et renvoie une critique, en boucle | Critères d'évaluation clairs et raffinement itératif qui apporte une valeur mesurable |
Les quatre paires à ne pas confondre :
| Si la question dit… | C'est… | Pas… |
|---|---|---|
| Séquence fixe | Prompt chaining | Routing (qui est une décision de classification) |
| Sous-tâches énumérables d'avance | Sectioning | Orchestrator-workers (sous-tâches découvertes) |
| Tentatives indépendantes agrégées | Voting | Evaluator-optimizer (boucle de critique) |
| Point de contrôle à sens unique | Gate dans un chaining | Evaluator-optimizer (qui réinjecte une critique) |
3.2 Les patterns agentiques : boucle, subagents, mémoire, contexte#
| Pattern | Ce qu'il résout | Où approfondir |
|---|---|---|
| Tool-use loop | Le modèle enchaîne outils et décisions jusqu'au résultat | Architect § 1, chapitre 07 |
| Sub-agents | Isoler une exploration dans un contexte propre, paralléliser, spécialiser | § 1.3 |
| Memory | Conserver un état entre sessions : rien n'est gardé par défaut | Ci-dessous |
| Context-window management | Éviter la saturation et le context rot : compaction, élagage des sorties d'outils, subagents | Chapitre 05, Architect 05 |
Quatre façons de « se souvenir » :
| Mécanisme | Durée de vie | À savoir |
|---|---|---|
| Contexte de la conversation | La session | Gratuit jusqu'à saturation, perdu à la fin |
Reprise de session (resume, fork) |
Restaure une conversation précise | Voir Architect § 7 |
Memory tool ({"type": "memory_20250818", "name": "memory"}) |
Entre sessions, fichiers sous /memories |
Outil côté client : Claude demande view, create, str_replace, insert, delete, rename, votre application exécute ; pas d'en-tête beta |
| Mémoire externe (base, fichiers de progression) | Ce que vous décidez | Pattern multisession : un journal de progression lu au début de chaque session |
Sécurité du memory tool : votre gestionnaire doit valider chaque chemin (rester sous
/memories, résoudre la forme canonique, rejeter../et ses formes encodées%2e%2e%2f), plafonner la taille des fichiers et ce queviewrenvoie (pagination parview_range).
Frontière entre domaines : choisir l'architecture (subagent, fichier mémoire) relève du domaine 1 ; les techniques de gestion de la fenêtre (quoi élaguer, comment résumer, compaction) relèvent du domaine 6 (chapitre 05).
3.3 Frameworks tiers#
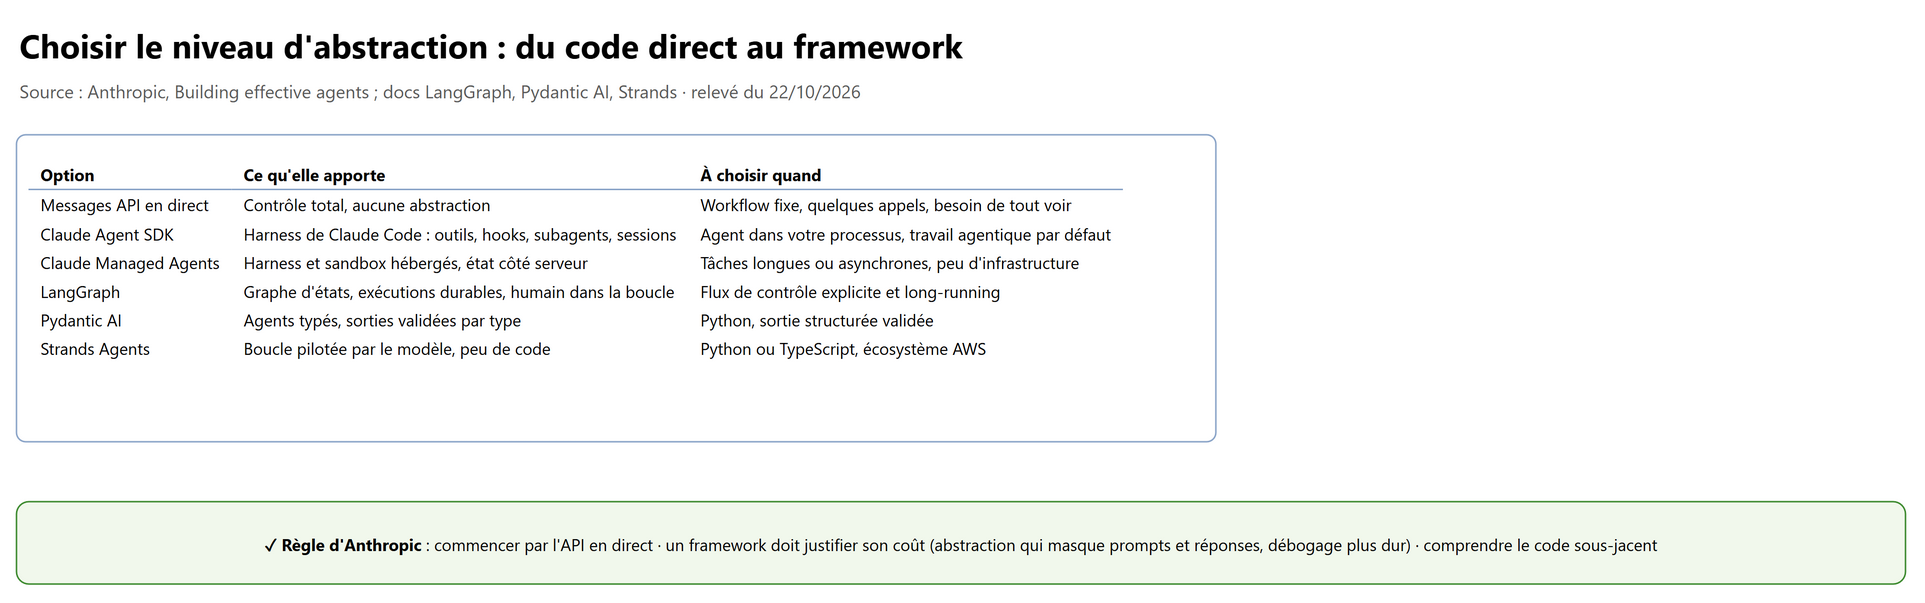
| Framework | Ce qu'il apporte | À choisir quand | À ne pas choisir pour |
|---|---|---|---|
| LangGraph | Orchestration bas niveau : le flux de contrôle est un graphe d'états, exécutions durables, humain dans la boucle | Flux explicite, long-running, reprise après incident | Valider une sortie typée (c'est Pydantic AI) |
| Pydantic AI | SDK Python typé : les sorties sont validées contre un type déclaré | Python, sorties structurées validées | Modéliser un flux en graphe (c'est LangGraph) |
| Strands Agents | SDK open source (Python, TypeScript) d'AWS, boucle pilotée par le modèle, peu de code d'orchestration | Agent simple, écosystème AWS | Contrôle fin d'un flux déterministe |
| Claude Agent SDK | Le harness de Claude Code | Agent dans votre processus sur Claude | — |
Le conseil d'Anthropic : commencer par appeler l'API directement ; beaucoup de patterns tiennent en quelques lignes. Un framework simplifie le bas niveau mais ajoute une abstraction qui masque prompts et réponses et complique le débogage ; s'il est utilisé, il faut comprendre le code qu'il exécute.
4. Labs conseillés#
Un compte Claude Console avec une clé API dans ANTHROPIC_API_KEY (jamais en dur dans le code). Les labs coûtent quelques
dizaines de centimes à quelques dollars avec un petit modèle ; fixer max_budget_usd partout.
- Workflow ou agent (30 min)
- Prendre deux automatisations réelles : une aux étapes fixes, une dont le chemin dépend des découvertes.
- Classer chacune (augmented LLM, workflow, agent) avec une phrase de justification.
- Implémenter la première en prompt chaining avec une gate en code entre deux appels Messages API.
- Attendu : le workflow donne la même séquence à chaque exécution ; noter le coût et la latence.
- Atteindre chaque limite volontairement (30 min, Agent SDK)
max_turns=2sur une tâche qui en demande plus : observererror_max_turns, sansresult.- Capturer
session_id, reprendre avecresume=session_idet une limite relevée. max_budget_usdtrès bas sur une tâche gourmande : observererror_max_budget_usd.- Attendu : un tableau sous-type ↔ cause tiré de vos propres exécutions.
- Hook de blocage (20 min)
- Ajouter le hook
PreToolUsede la § 2.4 surBashavec un motif inoffensif (par exemplerm -rf), puis demander à l'agent de l'exécuter. - Attendu : l'appel est refusé avant exécution, la raison apparaît dans le flux, l'agent change de stratégie.
- Ajouter le hook
- Supervisor et subagents (40 min)
- Définir deux subagents en lecture seule (
tools=["Read", "Grep", "Glob"]) avecAgentDefinition, et un brief complet. - Retirer un fait du brief et observer l'erreur qui en découle.
- Fixer
CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH=1etmax_budget_usd. - Attendu : le subagent sans le fait se trompe ; le coût total inclut les subagents.
- Définir deux subagents en lecture seule (
- Evaluator-optimizer (30 min, Messages API)
- Un appel rédige, un second note selon trois critères écrits, la critique repart au rédacteur, plafond de 3 tours.
- Attendu : la note monte puis se stabilise ; la boucle s'arrête au plafond même si les critères ne sont pas tous atteints.
Nettoyage : supprimer les clés API de test dans la Console, et les sessions Managed Agents si vous en avez créé.
5. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| « Plusieurs appels et des outils, donc c'est un agent » | Non : si le code fixe le chemin, c'est un workflow | Le critère est qui décide de l'étape suivante |
| Étapes fixes, l'équipe propose un agent « plus capable » | Workflow | Coût et imprévisibilité sans bénéfice |
| Investigation ouverte modélisée en pipeline rigide | Agent (ou orchestrator-workers) | Le chemin réel diverge du chemin codé |
| Un subagent ignore une règle donnée au supervisor | Mettre la règle dans le brief du subagent | Le subagent ne voit pas la conversation du parent (sauf fork) |
| « Plus de subagents pour un meilleur rapport » | Non : revoir la décomposition du supervisor | Les échecs viennent souvent d'une délégation vague |
| Les dépenses des subagents « échappent au plafond » | Faux : max_budget_usd est cumulatif |
Isolation de contexte ≠ isolation de coût |
error_max_turns : changer de modèle ? |
Non : reprendre la session avec une limite relevée, ou découper | C'est une limite de configuration |
Options max_iterations, turn_cap, budget_limit |
N'existent pas | Noms réels : max_turns, max_budget_usd |
Lire result sans tester le sous-type |
Erreur | result n'existe que sur success |
| Interdire la base de prod par le system prompt ou CLAUDE.md | Insuffisant : hook PreToolUse qui refuse |
Un prompt demande, un hook impose |
| Un hook journalise après coup | N'empêche rien | Seul PreToolUse agit avant l'outil |
Matcher Write|Edit pour bloquer l'écriture de .env |
Ne couvre pas une écriture via Bash |
Le matcher porte sur le nom de l'outil |
| « Managed Agents = Agent SDK hébergé » | Faux | Bibliothèque dans votre processus ≠ API hébergée |
| Données de santé sous BAA avec Managed Agents | Pas couvert à ce jour (ni ZDR) | Produit avec état côté serveur, en beta |
| Agent SDK dans un conteneur éphémère qui doit reprendre | session_store vers un stockage externe |
Transcripts locaux perdus avec le conteneur |
| Sous-tâches connues d'avance, exécutées en parallèle | Sectioning | Orchestrator-workers = sous-tâches découvertes |
| Brouillon, notation, critique réinjectée | Evaluator-optimizer | Voting = tentatives indépendantes sans retour |
| Requêtes simples vers un petit modèle, complexes vers un gros | Routing | Décision de classification |
| L'agent « se souvient » des décisions d'hier | Rien n'est gardé par défaut : memory tool, reprise de session ou fichier de progression | Sans mécanisme, chaque session repart de zéro |
| Le memory tool écrit lui-même sur disque | Non : il est côté client, votre code exécute | Validation des chemins à votre charge |
| LangGraph pour valider une sortie typée | Non : Pydantic AI | LangGraph = flux en graphe |
| « Un framework d'abord, c'est plus pro » | Commencer par l'API directe | Recommandation d'Anthropic |
6. Scénarios corrigés (QCM originaux)#
1. Une équipe traite des factures : extraction des champs, vérification d'un total, puis export comptable, toujours dans cet ordre. Le prototype est un agent avec trois outils. Que recommander ? A. Garder l'agent et ajouter un modèle plus capable B. Un workflow en prompt chaining, avec une gate en code qui vérifie le total C. Un orchestrator-workers avec trois subagents D. Un evaluator-optimizer pour fiabiliser l'export
B. Les étapes sont fixes et identiques à chaque exécution : c'est un workflow. La gate en code garantit la vérification. A et C ajoutent coût et imprévisibilité ; D sert quand il faut raffiner une sortie selon des critères.
2. Un supervisor délègue la rédaction de trois sections de rapport. Les subagents ignorent la charte de style décrite au début de la conversation avec l'utilisateur. Cause la plus probable ? A. Les subagents ont un modèle trop petit B. Le brief ne contient pas la charte : un subagent ne voit pas la conversation du parent C. La compaction a effacé la charte D. Il faut activer la mémoire partagée entre subagents
B. Seul le prompt de délégation passe. D n'existe pas comme tel ; A et C ne règlent pas un problème de transmission.
3. Un job Agent SDK nocturne s'arrête avec error_max_turns une fois sur trois. Que faire en premier ?
A. Passer à un modèle plus capable
B. Ajouter « termine en moins de 30 étapes » au prompt
C. Reprendre la session avec resume=session_id et une limite relevée, ou découper la tâche
D. Remplacer max_turns par max_iterations
C. C'est une limite de configuration, pas un échec du modèle. B est une demande non garantie ; D n'existe pas.
4. Un agent de maintenance a accès à Bash. Il ne doit jamais lancer terraform destroy, même si un fichier du dépôt le lui
demande. Quel contrôle garantit la règle ?
A. Une instruction dans CLAUDE.md
B. Un hook PreToolUse sur Bash qui renvoie permissionDecision: "deny" pour ce motif
C. Un hook PostToolUse qui journalise les commandes
D. Réduire max_turns
B. Seul un hook avant l'outil bloque de façon déterministe. A est une demande ; C agit après coup ; D ne bloque rien.
5. Une société veut un agent qui tourne plusieurs heures chaque nuit, avec un sandbox, l'historique conservé côté serveur et un minimum d'infrastructure à gérer. Les données doivent rester dans son réseau. Quelle option ? A. Claude Agent SDK sur un poste développeur B. Claude Managed Agents avec un self-hosted sandbox C. Une boucle maison sur la Messages API D. Claude Managed Agents avec le cloud sandbox d'Anthropic
B. Managed Agents fournit le harness hébergé, l'état côté serveur et la planification ; le self-hosted sandbox exécute les outils et garde les fichiers sur l'infrastructure du client. D ne répond pas à l'exigence de résidence.
6. Une application route les questions de support : facturation vers un prompt spécialisé avec un outil de lecture de factures, technique vers un autre prompt avec la documentation. Quel pattern ? A. Routing B. Prompt chaining C. Voting D. Orchestrator-workers
A. Une décision de classification envoie l'entrée vers un traitement spécialisé.
7. Une revue de code lance trois analyses indépendantes et connues d'avance (style, sécurité, couverture), puis agrège. A. Orchestrator-workers B. Sectioning C. Evaluator-optimizer D. Routing
B. Sous-tâches indépendantes et énumérables d'avance. Orchestrator-workers suppose des sous-tâches découvertes à l'exécution.
8. Une équipe Python veut un agent dont la réponse finale est toujours un objet validé contre un modèle de données. Quel framework tiers correspond le mieux à ce besoin ? A. LangGraph B. Pydantic AI C. Strands Agents D. Aucun : impossible
B. Pydantic AI valide les sorties contre un type déclaré. LangGraph sert à modéliser un flux en graphe.
9. Un agent Agent SDK tourne dans un conteneur détruit après chaque requête HTTP ; le lendemain, il doit reprendre la
conversation de la veille. Que faire ? (deux réponses)
A. Capturer session_id et le passer à resume à la requête suivante
B. Configurer un session_store qui réplique les transcripts vers un stockage externe
C. Relancer avec le même prompt initial
D. Augmenter max_turns
A et B. La reprise demande l'identifiant de session et un transcript qui survit au conteneur.
10. Le budget d'une requête est max_budget_usd=5. Le supervisor lance dix subagents. Que se passe-t-il quand la dépense
estimée atteint 5 USD ?
A. Les subagents continuent : leur budget est séparé
B. Les nouveaux lancements de subagents échouent et la requête se termine en error_max_budget_usd
C. Le supervisor passe automatiquement à un modèle moins cher
D. Rien : le budget est indicatif
B. Le plafond couvre les subagents : un nouveau lancement échoue (« Budget limit reached ») et la requête se termine avec ce sous-type.
7. Pour aller plus loin (hors examen ou état actuel)#
- Dynamic workflows : pour des dizaines ou des centaines d'agents, l'outil
Workflow(TypeScript Agent SDK) déplace l'orchestration dans un script exécuté hors du contexte de la conversation ; seul le résultat final y revient. - Advisor (Managed Agents) : le thread principal peut consulter un modèle conseiller en cours de tour pour planifier ou relire.
- Claude Code : les mêmes notions (subagents dans
.claude/agents/, hooks, sessions) sont traitées en configuration au chapitre 03 et dans Architect 03. - Lecture de fond : Building effective agents, How we built our multi-agent research system et Effective context engineering for AI agents (Anthropic Engineering).
8. Fiche à retenir#
- Qui décide de la suite ? Le code : workflow. Le modèle : agent. Un seul appel outillé suffit souvent.
- La solution la plus simple d'abord ; un agent seulement si le chemin est imprévisible.
- Supervisor : décompose, délègue avec un brief complet, synthétise ; le subagent ne voit que son prompt (sauf fork).
- Plafonds SDK : profondeur 3, 20 subagents simultanés,
max_budget_usdcumulatif. -
max_turnsetmax_budget_usd: aucune limite par défaut ; mettre un budget en production. -
ResultMessage.subtypeavantresult;error_max_turns= reprendre la session, pas changer de modèle. -
query()pour un appel ponctuel ;ClaudeSDKClient(streaming input) pour un agent longue durée. - Claude Managed Agents : API hébergée, beta (
managed-agents-2026-04-01), Agent / Environment / Session / Events, sandbox Anthropic ou self-hosted, pas de ZDR ni BAA. - Prompts request, hooks enforce :
PreToolUse+denybloque avant l'outil ;denyl'emporte sur tout. - Cinq workflows : chaining, routing, parallelization (sectioning, voting), orchestrator-workers, evaluator-optimizer.
- Memory tool
memory_20250818: côté client,/memories, valider les chemins. - LangGraph = graphe d'états ; Pydantic AI = sorties typées ; Strands = boucle pilotée par le modèle ; API directe d'abord.
Références#
Lues le 22/10/2026 :
- Claude Certified Developer – Foundations Exam Guide v1.0 (PDF officiel)
- Anthropic Partner certifications
- Building effective agents
- How we built our multi-agent research system
- Effective context engineering for AI agents
- How the agent loop works (Agent SDK)
- Agent SDK overview
- Subagents in the SDK
- Intercept and control agent behavior with hooks
- Streaming input vs single message mode
- Work with sessions
- Persist sessions to external storage
- Hosting the Agent SDK
- Claude Managed Agents overview
- Multiagent orchestration (Managed Agents)
- Self-hosted sandboxes
- Memory tool
- Compaction
- LangGraph overview
- Pydantic AI
- Strands Agents
- Cursus tiers utilisé comme base : claudecertificationguide.com, CCDV-F, domaine 1