

Version : 1.0 · Date : 2026-10-21 · Parcours AKS (niveau architecte, préparation d'entretiens)
En une phrase : sur Azure, on peut soit héberger soi-même un modèle (GPU node pools, KAITO, vLLM sur AKS), soit héberger l'application ou l'agent qui consomme un modèle managé (Microsoft Foundry, Azure OpenAI) ; l'architecte choisit le service le plus managé qui répond au besoin, puis sécurise, met à l'échelle et observe la chaîne avec des signaux propres à l'IA (jetons, file d'attente, mémoire GPU).
Ce chapitre suppose les bases d'AKS (01), le réseau (02) et l'identité (03). Les contrôles de sécurité propres à l'IA (AI gateway, guardrails de Foundry, Defender for AI Services) sont détaillés dans le cours SC-500, chapitre 07 : on y renvoie plutôt que de les répéter.
| # | Section | Ce qu'on y apprend |
|---|---|---|
| 1 | Les deux grands cas | Héberger le modèle ou héberger l'application |
| 2 | Où exécuter quoi | Foundry, Azure Container Apps, Azure Machine Learning ou AKS |
| 3 | Les GPU sur AKS | VM GPU, pile NVIDIA, taints, MIG, Spot, quotas |
| 4 | KAITO | Déployer un LLM open source en un manifeste |
| 5 | Moteurs d'inférence | vLLM, Triton, Transformers |
| 6 | Mise à l'échelle | KEDA, démarrage à froid, images lourdes |
| 7 | Applications et agents | RAG sur AKS sans clé, Workload Identity |
| 8 | AI gateway et routage | APIM devant tous les modèles, inference gateway |
| 9 | MCP et outils | Tool calling, héberger un serveur MCP |
| 10 | Sécurité | Défense en profondeur d'une plateforme IA |
| 11 | Observabilité | vLLM, DCGM, jetons |
| 12 | Entraînement et ajustement fin | PyTorchJob, NCCL, Kueue |
| 13–16 | Erreurs, lab, entretien, fiche |
1. Les deux grands cas#
| Cas 1 : héberger soi-même le modèle | Cas 2 : héberger l'application qui consomme un modèle managé | |
|---|---|---|
| Ce qui tourne sur AKS | Le serveur d'inférence (vLLM…), les poids du modèle, des GPU | Le front, l'API, l'orchestrateur ou l'agent (CPU) |
| Le modèle | Open source (Phi, Llama, Qwen, Falcon…) ou ajusté | Microsoft Foundry (Azure OpenAI et catalogue) |
| Pourquoi | Coût prévisible à gros volume (au lieu d'un prix au jeton), ajustement fin libre, données qui ne quittent pas votre environnement (secteurs réglementés) | Aller vite, aucun GPU à gérer, modèles les plus récents |
| Ce que vous gérez | GPU, quotas, pilotes, mise à l'échelle, version du modèle | Identité, réseau privé, quotas de jetons, coût à l'usage |
Ces raisons du cas 1 sont celles que Microsoft donne pour KAITO : prix au jeton qui « peut rapidement devenir incontrôlable », besoin d'ajuster ou de personnaliser le modèle, données sensibles dans la finance, la santé ou la défense.
En entretien : la plupart des projets d'entreprise sont des cas 2 (une application RAG ou un agent sur AKS qui appelle Foundry). Le cas 1 se justifie par le volume, la conformité ou la personnalisation, pas par goût de la technique.
2. Où exécuter quoi#
2.1 Les quatre options#
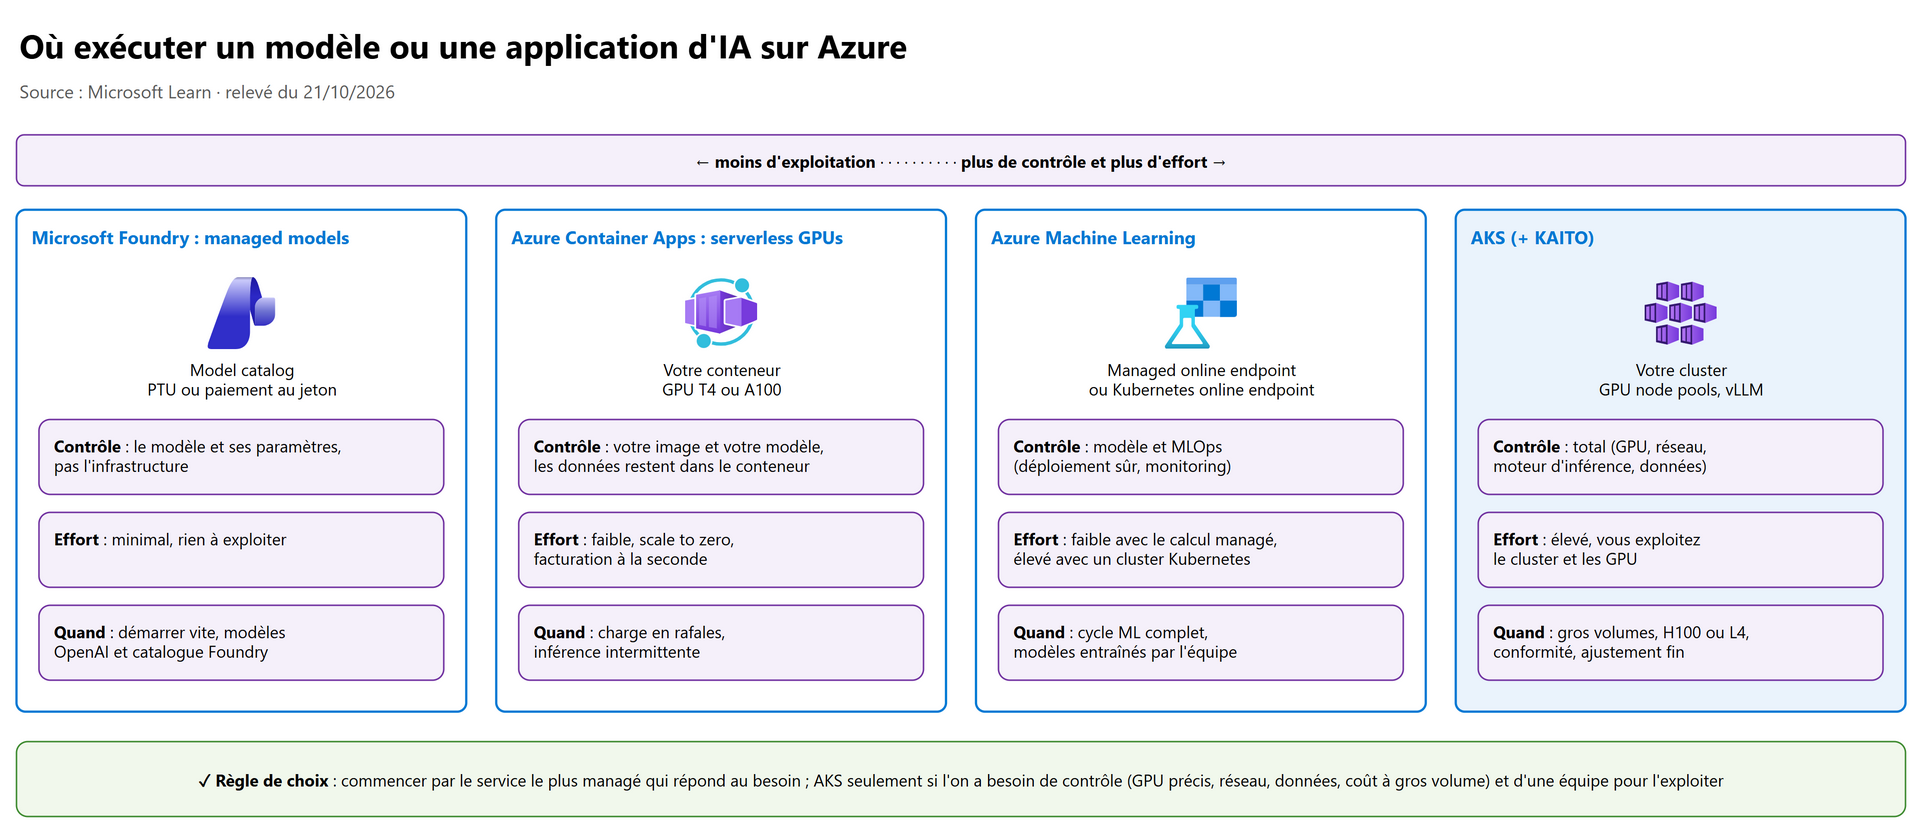
| Critère | Microsoft Foundry (managed models) | Azure Container Apps (serverless GPUs) | Azure Machine Learning (online endpoints) | AKS (+ KAITO) |
|---|---|---|---|---|
| Vous fournissez | Rien : un déploiement de modèle | Une image de conteneur avec le modèle | Le modèle et son code de scoring | Le cluster, les pools GPU, le moteur |
| GPU | Invisibles | NVIDIA T4 ou A100 | CPU et GPU, gérés (managed) ou dans votre cluster (Kubernetes) | Toutes les tailles prises en charge par AKS (H100, L4, A10…) |
| Mise à zéro | Sans objet (paiement au jeton ou PTU) | Oui, facturation à la seconde | Selon le type de point de terminaison | Possible (pool à 0 node), au prix du démarrage à froid |
| Effort d'exploitation | Minimal | Faible | Faible (managed) à élevé (Kubernetes) | Élevé |
| Contrôle | Le moins | Image et modèle | Modèle et MLOps (déploiement sûr, monitoring) | Total |
Points vérifiés à connaître :
- Container Apps serverless GPUs : seulement dans les profils de charge de travail Consumption d'un environnement workload profiles (pas dans un environnement Consumption-only) ; quota GPU à demander ; les conteneurs doivent tourner sans root ; un exemple Microsoft mesure 1 à 2 minutes de démarrage à froid pour un modèle d'environ 5 Go.
- Azure Machine Learning : le managed online endpoint est la voie recommandée (calcul, réseau, mises à jour de l'OS gérés,
déploiement sûr, coût par déploiement). Le Kubernetes online endpoint (extension Azure ML sur AKS ou Arc) laisse les nodes, le
réseau et le monitoring à votre charge ; les modèles du Model catalog n'y sont pas pris en charge et la création d'un
déploiement est limitée à 20 minutes. L'ancienne cible
AksCompute(SDK v1) est remplacée parKubernetesCompute. - Repère de dimensionnement donné par Microsoft (guide coût IA) : T4 ou L4 suffisent pour moins d'environ 13 milliards de paramètres ; A100 ou H100 ne se justifient qu'au-delà d'environ 34 milliards ou à fort débit ; L4 et H100 demandent AKS (Container Apps ne propose que T4 et A100).
2.2 L'arbre de décision#
flowchart TD
    A["Besoin : un modèle d'IA dans l'application"] --> B{"Un modèle du catalogue Foundry convient ?"}
    B -- Oui --> F["Microsoft Foundry<br/>+ application sur AKS ou Container Apps"]
    B -- Non --> C{"Modèle à vous (open source, ajusté) ?"}
    C -- Oui --> D{"Charge intermittente,<br/>T4 ou A100 suffisent ?"}
    D -- Oui --> ACA["Azure Container Apps<br/>serverless GPUs"]
    D -- Non --> E{"Cycle ML complet<br/>(entraînement, registre, monitoring) ?"}
    E -- Oui --> AML["Azure Machine Learning<br/>managed online endpoint"]
    E -- Non --> AKS["AKS + GPU node pools<br/>KAITO, vLLM"]
Règle d'architecte : commencer par le plus managé. AKS se justifie quand on a déjà une plateforme Kubernetes et une équipe, ou quand il faut un GPU précis, un réseau particulier, des données qui restent dans le cluster ou un coût maîtrisé à gros volume.
3. Les GPU sur AKS#
3.1 Les familles de VM GPU#
| Famille | Usage selon Microsoft | Exemples de séries |
|---|---|---|
| NC | Calcul intensif, graphisme | NCasT4_v3 (T4), NC_A100_v4 (1 à 4 A100 PCIe 80 Go), NCads_H100_v5 (seule série NC où Microsoft déploie de la nouvelle capacité) |
| ND | Gros entraînements, IA générative, HPC à grande échelle | ND_A100_v4 (8 × A100 40 Go), NDm_A100_v4 (8 × A100 80 Go), ND_H100_v5 (8 × H100), ND-H200-v5, ND GB200/GB300-v6 ; InfiniBand entre VM et GPUDirect RDMA |
| NV | VDI, rendu, calcul simple précision | NVadsA10_v5 (A10) |
Règles AKS :
- taille minimale conseillée pour un pool GPU :
Standard_NC4as_T4_v3; la série NVv4 (AMD) n'est pas prise en charge ; - une taille de VM et un taint se choisissent à la création du pool : impossible d'ajouter une taille GPU à un pool existant ;
- KAITO exige des GPU NVIDIA Ampere ou plus récents (capacité CUDA 8.0) : T4, V100, M60, K80 sont exclus de KAITO.
3.2 La pile logicielle NVIDIA#
Un node GPU a besoin de trois briques : le pilote NVIDIA, le device plugin Kubernetes (qui annonce la ressource
nvidia.com/gpu au kubelet) et un exportateur de métriques (DCGM exporter). AKS propose trois profils :
| Profil | Option de az aks nodepool add |
Ce qu'AKS installe |
|---|---|---|
| Managed GPU (préversion) | --enable-managed-gpu=true |
Pilote, device plugin, DCGM exporter (port 19400) et signaux de santé GPU dans le Node Problem Detector |
| Driver only (défaut) | --enable-managed-gpu=false ou rien |
Le pilote seulement ; vous déployez le device plugin (DaemonSet ou NVIDIA GPU Operator) |
| None (BYO) | --enable-managed-gpu=false --gpu-driver None |
Rien ; Microsoft ne prend pas en charge vos pilotes |
- Le profil est immuable : pour en changer, créer un nouveau pool. L'ancien drapeau
--skip-gpu-driver-installn'est plus accepté depuis le 14 août 2025 (remplacé par--gpu-driver None). - Le NVIDIA GPU Operator sert aux configurations avancées (version de pilote, time-slicing) ; garder alors au moins 1 node si le cluster autoscaler est actif.
- Pièges : pas de correctifs de sécurité automatiques sur un pool GPU Azure Linux (vérifier le canal de mise à niveau de l'image de node) ; Flatcar Container Linux et Azure Linux avec OS Guard ne prennent pas les GPU NVIDIA.
3.3 Placer les pods sur les GPU#
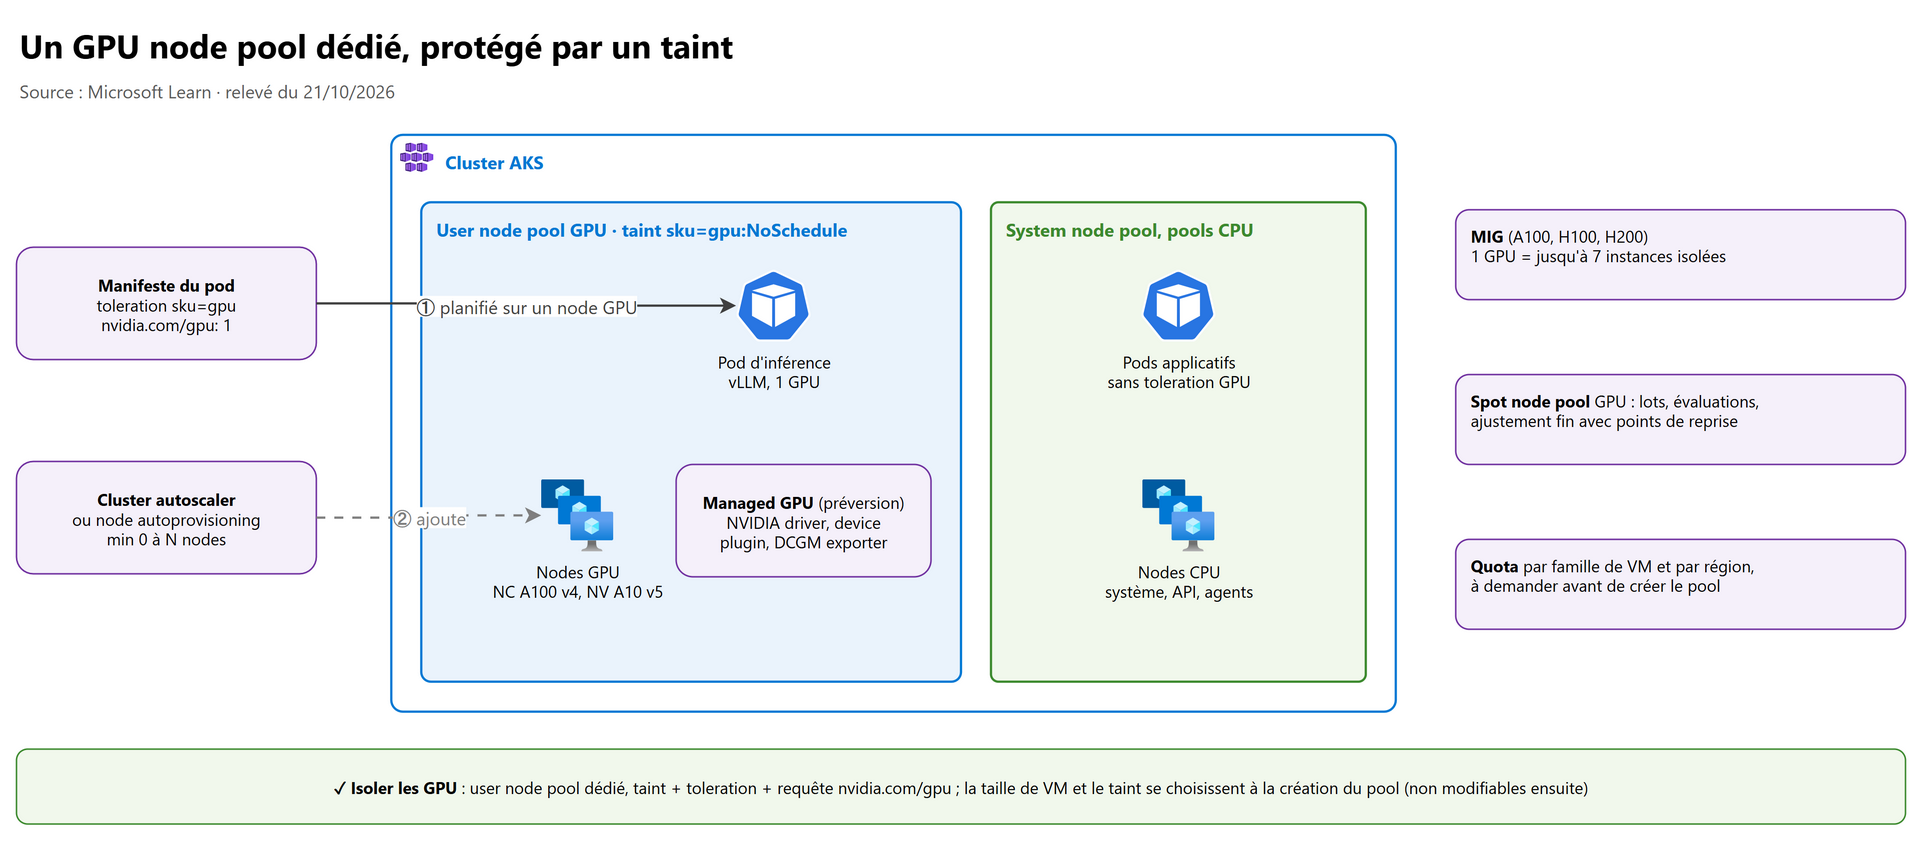
Kubernetes traite le GPU comme une ressource étendue, jamais surallouée : le pod demande nvidia.com/gpu, et le pool GPU
porte un taint que seuls les pods GPU tolèrent (pour ne pas gaspiller des nodes coûteux avec des pods ordinaires).
# Pool utilisateur GPU, pile gérée par AKS (préversion), à l'échelle de 0 à 4 nodes
az aks nodepool add --resource-group rg-ia --cluster-name aks-ia --name gpunp \
  --mode User --node-vm-size Standard_NC24ads_A100_v4 \
  --node-taints sku=gpu:NoSchedule --labels accelerator=nvidia \
  --enable-cluster-autoscaler --min-count 0 --max-count 4 \
  --enable-managed-gpu=true
# Extrait de Deployment : tolérer le taint, viser le pool GPU, demander 1 GPU
spec:
  template:
    spec:
      nodeSelector:
        accelerator: nvidia
      tolerations:
        - key: sku
          operator: Equal
          value: gpu
          effect: NoSchedule
      containers:
        - name: inference
          image: monacr.azurecr.io/llm/serveur:1.0
          resources:
            requests: { nvidia.com/gpu: 1 }
            limits:   { nvidia.com/gpu: 1 }
Vérifier : kubectl describe node <node> doit afficher nvidia.com/gpu dans Capacity et Allocatable.
3.4 Partager un GPU#
| Stratégie | Géré par AKS ? | Isolation | Usage conseillé par Microsoft |
|---|---|---|---|
| MIG (Multi-Instance GPU) | Oui (pool MIG) | Matérielle : calcul, mémoire, cache dédiés | Production |
| Time-slicing | Non (GPU Operator) | Aucune, partage dans le temps | Expérimentation, charges variables |
| MPS (Multi-Process Service) | Non (GPU Operator) | Faible | Faible latence, haut débit, utilisateurs avancés |
- MIG existe sur les A100, H100 et H200 : un GPU se découpe en jusqu'à 7 instances. Exemple
Standard_ND96asr_v4: profilsMIG1g(1g.5gb, 7 instances) àMIG7g(7g.40gb, 1 instance). Le profil (--gpu-instance-profile) est fixé à la création. - Stratégie d'exposition : Single (chaque instance vue comme
nvidia.com/gpu: 1) ou Mixed (ressource par profil, par exemplenvidia.com/mig-1g.10gb).
3.5 Autoscaling, Spot, quotas et coût#
- Cluster autoscaler : un pod GPU en attente ne déclenche l'ajout d'un node que si toutes ses contraintes collent au pool (requête GPU, labels, taints, affinités, nombre maximal, quota Azure). Un pool à 0 coûte zéro au repos mais ajoute création de VM, téléchargement de l'image, montage des données et chargement du modèle au premier appel : garder un minimum non nul quand la latence compte.
- AKS Automatic et le node autoprovisioning (NAP, basé sur Karpenter) peuvent créer la capacité GPU à partir des pods en attente. KAITO sur Automatic : la page de l'extension VS Code dit qu'il ne s'installe pas aujourd'hui sur un cluster Automatic ; la page de l'add-on ne le cite pas dans ses limites. Prévoir un cluster Standard pour KAITO tant que ce n'est pas clarifié.
- Spot node pool : pool secondaire seulement, sans SLA, éviction avec 30 secondes de préavis, taint
kubernetes.azure.com/scalesetpriority=spot:NoScheduleà tolérer. À réserver aux lots, évaluations et ajustements fins avec points de reprise ; jamais pour l'inférence face aux utilisateurs. - Quota : par famille de VM et par région, à demander avant ; c'est la première cause d'échec d'un Workspace KAITO.
- Coût : l'analyse des coûts AKS montre le coût par node et le coût d'inactivité ; les A100 sont chers, ne les prendre que si la charge l'exige.
4. KAITO (AI toolchain operator)#
4.1 Ce que c'est#
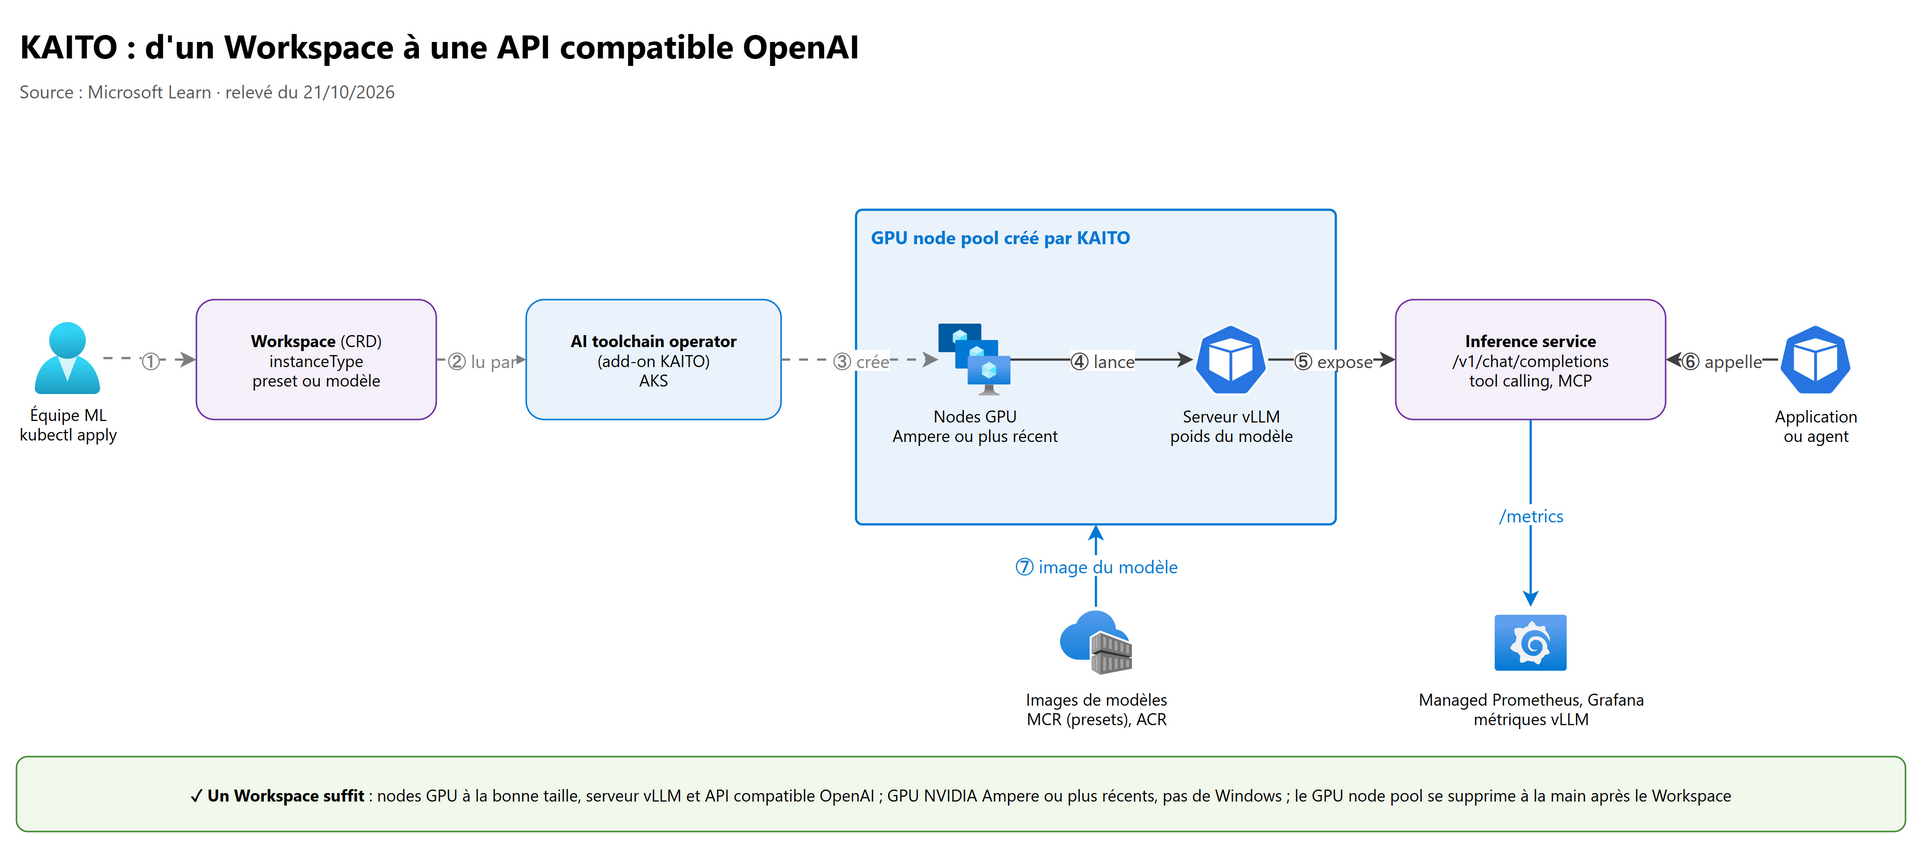
KAITO (Kubernetes AI Toolchain Operator) est un projet CNCF Sandbox ; AKS le propose en add-on managé (AI toolchain operator). Un seul objet, le Workspace (CRD), décrit le modèle et la taille de VM ; KAITO :
- crée les nodes GPU à la bonne taille (Karpenter) ;
- lance le serveur d'inférence, vLLM par défaut, avec une API compatible OpenAI, la mise en forme des invites et les réponses en flux ;
- propose des préréglages (presets) de modèles publiés comme images de conteneur, ou un modèle Hugging Face au choix (gabarit personnalisé, runtime Transformers uniquement) ;
- gère l'ajustement fin (LoRA, QLoRA) dont les adaptateurs sont stockés comme images dans ACR ;
- expose le tool calling et la connexion à des serveurs MCP ; publie les métriques vLLM pour Prometheus.
# Activer l'add-on (nouveau cluster ou cluster existant)
az aks update --resource-group rg-ia --name aks-ia --enable-ai-toolchain-operator --enable-oidc-issuer
# Workspace d'inférence (structure documentée ; prendre la taille de VM indiquée par le préréglage choisi)
apiVersion: kaito.sh/v1beta1
kind: Workspace
metadata:
  name: workspace-phi-4-mini
resource:
  instanceType: "Standard_NC24ads_A100_v4"
  labelSelector:
    matchLabels:
      apps: phi-4-mini
inference:
  preset:
    name: phi-4-mini-instruct
4.2 Le cycle d'un Workspace#
sequenceDiagram
    actor E as Équipe ML
    participant K as AI toolchain operator (KAITO)
    participant N as Node autoprovisioning
    participant P as Pod vLLM
    E->>K: kubectl apply Workspace (preset, instanceType)
    K->>N: Demande des nodes GPU de la taille indiquée
    N-->>K: Nodes prêts (jusqu'à 10 min)
    K->>P: Démarre vLLM avec l'image du modèle
    P-->>K: Modèle chargé (Workspace prêt : jusqu'à 20 min)
    E->>P: POST /v1/chat/completions via le Service
    Note over E,K: Supprimer le Workspace ne supprime pas le GPU node pool : à faire à la main
4.3 Limites à connaître#
| Limite | Conséquence |
|---|---|
| Pas de nodes Windows, pas de GPU AMD, pas de GPU antérieurs à Ampere | T4 et V100 exclus ; viser A10, A100, H100 |
| L'add-on a en général une version de retard sur KAITO open source | Vérifier qu'un préréglage existe dans la version installée |
| Régions Azure publiques seulement | Pas de cloud souverain |
az aks stop / start mal pris en charge avec des Workspaces actifs |
Risque de pools orphelins ou d'échecs de provisionnement |
| Le pool GPU n'est pas supprimé avec le Workspace | Le retrouver par le label kaito.sh/workspace et le supprimer, sinon il coûte |
| Tool calling et MCP : Kubernetes 1.33+, CLI 2.77+, runtime vLLM (pas Transformers) | Choisir un préréglage qui prend en charge le tool calling |
KAITO existe aussi en extension pour AKS sur Azure Local (préversion), pour l'inférence au plus près des données.
5. Les moteurs d'inférence#
| Moteur | Ce qu'en dit la documentation Microsoft | Où on le croise |
|---|---|---|
| vLLM | Moteur à haut débit pour servir des LLM, réduit les besoins en mémoire et en GPU ; API compatible OpenAI ; métriques Prometheus (vllm:num_requests_waiting, vllm:kv_cache_usage_perc…) |
Moteur par défaut de KAITO ; inference gateway ; Container Apps |
| Triton Inference Server | Cité parmi les frameworks qui profitent des GPU ; Azure Machine Learning sert des modèles hautes performances avec Triton sur un managed online endpoint | Azure ML, AKS |
| Hugging Face Transformers / TGI | Runtime Transformers : seul runtime du gabarit de modèle personnalisé KAITO, sans tool calling ; TGI cité comme API compatible OpenAI importable dans APIM | KAITO (modèles personnalisés), APIM |
Ollama n'apparaît pas dans la documentation AKS consultée : c'est surtout un outil de poste de développeur.
Pourquoi vLLM compte en entretien : le goulot d'un LLM est la mémoire GPU (poids + cache KV des conversations en cours). Un moteur comme vLLM gère ce cache pour servir plus de requêtes simultanées par GPU ; ses métriques de file d'attente et de cache KV sont les bons signaux de mise à l'échelle et de routage.
6. Mettre un LLM à l'échelle#
6.1 Les bons signaux#
| Niveau | Outil | Signal adapté à un LLM |
|---|---|---|
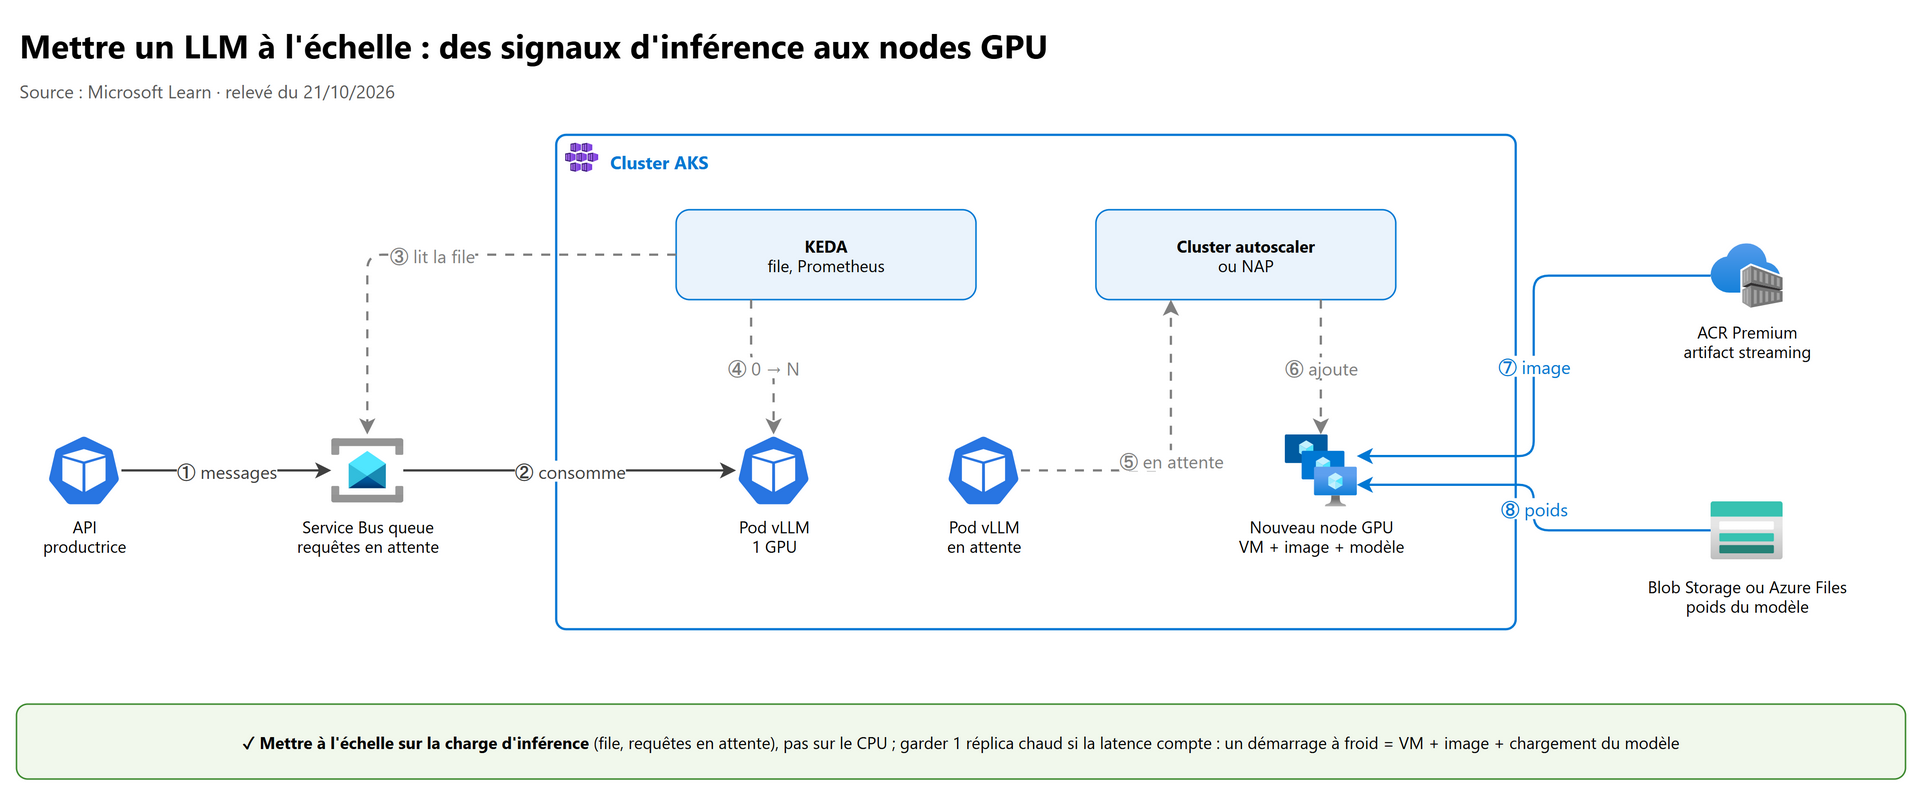
| Pods | KEDA (add-on AKS ; préconfiguré dans AKS Automatic), ou HPA | Longueur de file (Service Bus), requêtes en attente vLLM, cache KV (via Prometheus) |
| Nodes | Cluster autoscaler ou NAP | Pods GPU en attente |
| Ressources d'un pod | VPA | Requêtes et limites CPU / mémoire justes (réduit le surprovisionnement) |
Le CPU est un mauvais signal pour un LLM : le GPU peut être saturé alors que le CPU est bas. KEDA lit les métriques du Managed Prometheus (espace Azure Monitor) depuis KEDA 2.10, avec une Workload Identity qui a le rôle Monitoring Data Reader ; KEDA doit être le seul adaptateur de métriques externes du cluster.
# Mise à l'échelle d'un Deployment vLLM sur les requêtes en attente (Prometheus managé, Workload Identity)
apiVersion: keda.sh/v1alpha1
kind: TriggerAuthentication
metadata:
  name: azure-managed-prometheus-auth
spec:
  podIdentity:
    provider: azure-workload
---
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: vllm-scaler
spec:
  scaleTargetRef:
    name: vllm-phi
  minReplicaCount: 1            # un réplica chaud : pas de démarrage à froid en journée
  maxReplicaCount: 6
  triggers:
    - type: prometheus
      metadata:
        serverAddress: https://<espace>.<region>.prometheus.monitor.azure.com
        query: sum(vllm:num_requests_waiting)   # exemple construit : Microsoft recommande de scaler sur la file d'attente ou le cache KV
        threshold: "10"
      authenticationRef:
        name: azure-managed-prometheus-auth
6.2 Le démarrage à froid et les images lourdes#
Un nouveau réplica sur un nouveau node = création de la VM + téléchargement de l'image (souvent 5 à 15 Go pour une image GPU) + chargement du modèle en mémoire GPU. Leviers documentés :
| Levier | Effet | Statut |
|---|---|---|
| Artifact Streaming (ACR Premium → AKS) | Ne télécharge que les blocs utiles au démarrage ; plus de 15 % de gain sur le temps de disponibilité, surtout au-delà de 30 Go | Préversion ; tirage par tag uniquement, Linux AMD64, pas de registre CMK |
| Prepared Image Specification | Pré-charge images et dépendances (pilotes, CUDA, poids) dans l'image du node | Préversion |
| Tirage parallèle des images | Par défaut depuis Kubernetes 1.31 sur AKS | GA |
| Disque OS éphémère, VM plus récente | Moins d'étranglement disque | GA |
| Poids hors de l'image | Blob Storage (CSI Blob), Azure Files (partagé, POSIX), Azure Disk (un seul node) | GA |
| Garder 1 réplica chaud | Supprime la latence visible ; on peut descendre à 0 la nuit | Choix d'architecture |
7. Applications et agents qui consomment des modèles managés#
7.1 Le schéma de référence#
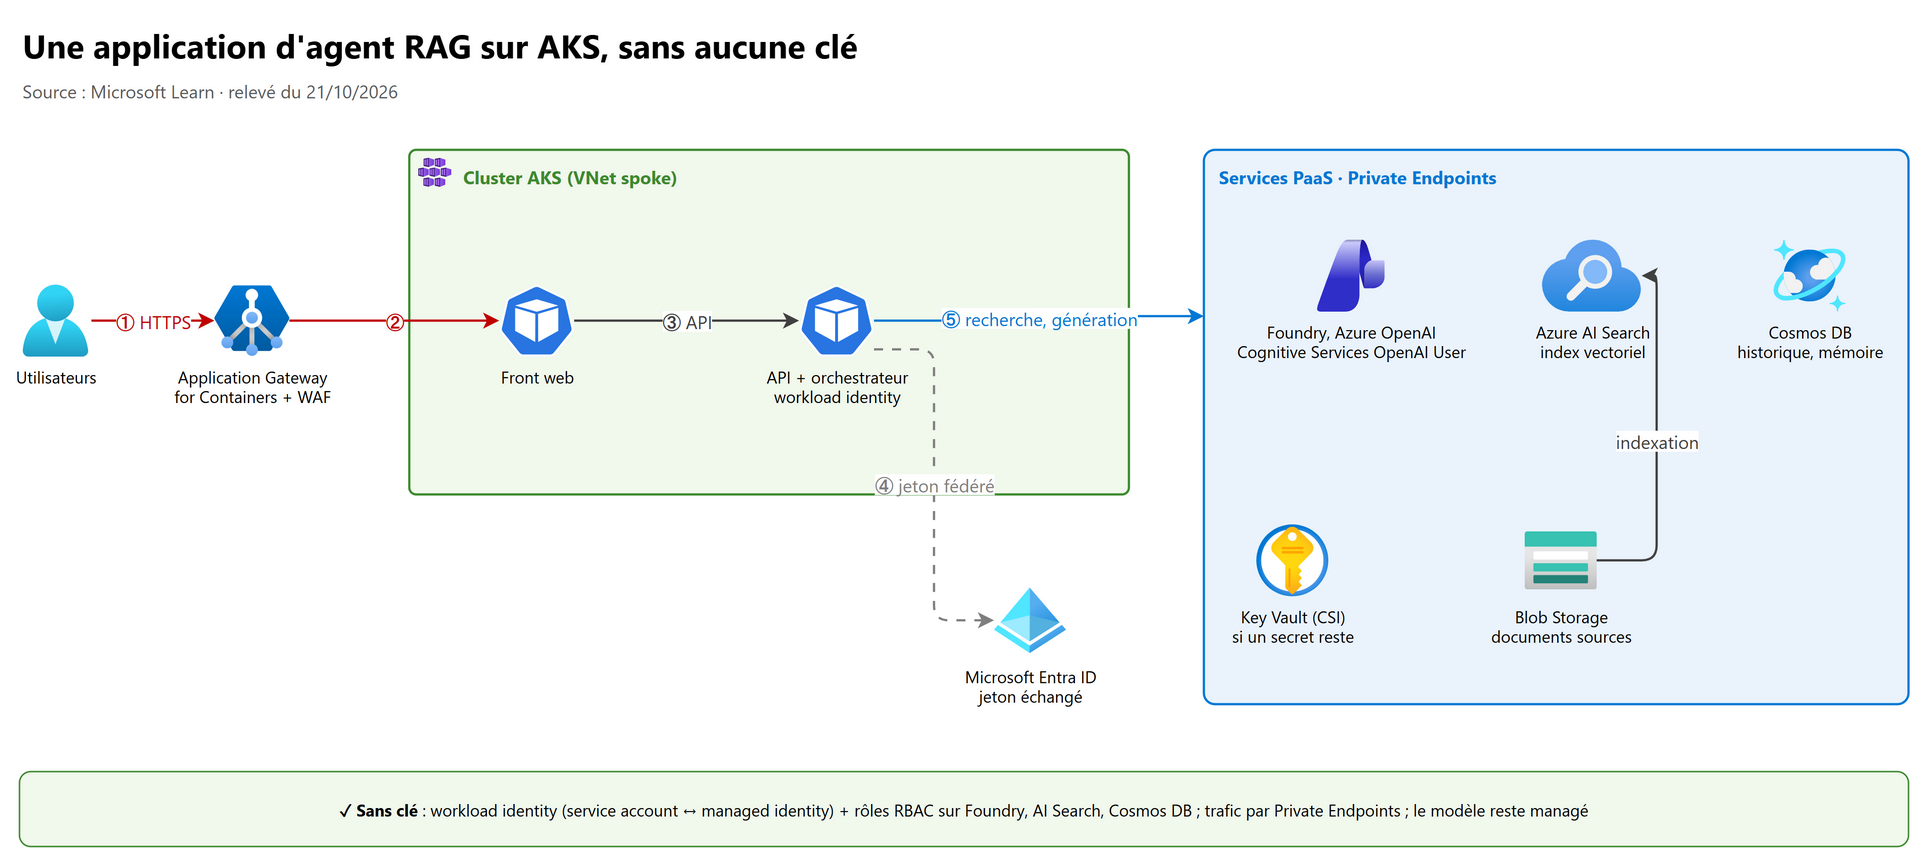
Le RAG (retrieval-augmented generation) : l'application récupère des passages dans un index (Azure AI Search, vectoriel et hybride), augmente l'invite avec ce contexte, puis le modèle génère une réponse fondée et citée. Sur AKS : front, API/orchestrateur (ou agent) et éventuellement l'ingestion en pods CPU ; le modèle reste dans Foundry.
sequenceDiagram
    actor U as Utilisateur
    participant O as Orchestrateur (pod AKS)
    participant E as Microsoft Entra ID
    participant S as Azure AI Search
    participant F as Foundry (Azure OpenAI)
    participant C as Cosmos DB
    U->>O: Question
    O->>E: Jeton du service account (Workload Identity)
    E-->>O: Jeton d'accès Entra (sans clé)
    O->>F: Embedding de la question
    O->>S: Recherche vectorielle / hybride
    S-->>O: Passages pertinents + métadonnées
    O->>F: Invite augmentée (question + passages)
    F-->>O: Réponse fondée
    O->>C: Historique de conversation
    O-->>U: Réponse avec citations
7.2 Sans clé : Workload Identity#
- Activer
--enable-oidc-issuer --enable-workload-identitysur le cluster. - Créer une user-assigned managed identity et lui donner le rôle Cognitive Services OpenAI User sur la ressource (Contributor seulement pour les Assistants). La ressource doit avoir un custom subdomain pour l'authentification Entra.
- Créer la federated credential : émetteur OIDC du cluster, sujet
system:serviceaccount:<namespace>:<service account>, audienceapi://AzureADTokenExchange. - Annoter le ServiceAccount
azure.workload.identity/client-idet mettre le labelazure.workload.identity/use: "true"sur le pod (obligatoire). Le code utiliseDefaultAzureCredential(bibliothèque Azure Identity).
az identity federated-credential create --name fic-agent --identity-name id-agent --resource-group rg-ia \
  --issuer "$(az aks show -g rg-ia -n aks-ia --query oidcIssuerProfile.issuerUrl -o tsv)" \
  --subject system:serviceaccount:agents:sa-agent --audience api://AzureADTokenExchange
# Variante guidée : Service Connector crée identité, rôle et ServiceAccount
az aks connection create cognitiveservices --workload-identity <id-de-l-identite>
Points d'architecte : une identité par charge de travail ; une user-assigned managed identity accepte au plus 20 federated credentials (les identity bindings AKS contournent cette limite pour de nombreux clusters) ; désactiver ensuite les clés locales de la ressource IA (recommandation Defender for Cloud) ; trafic par Private Endpoints.
8. AI gateway et routage d'inférence#
8.1 Azure API Management comme AI gateway#
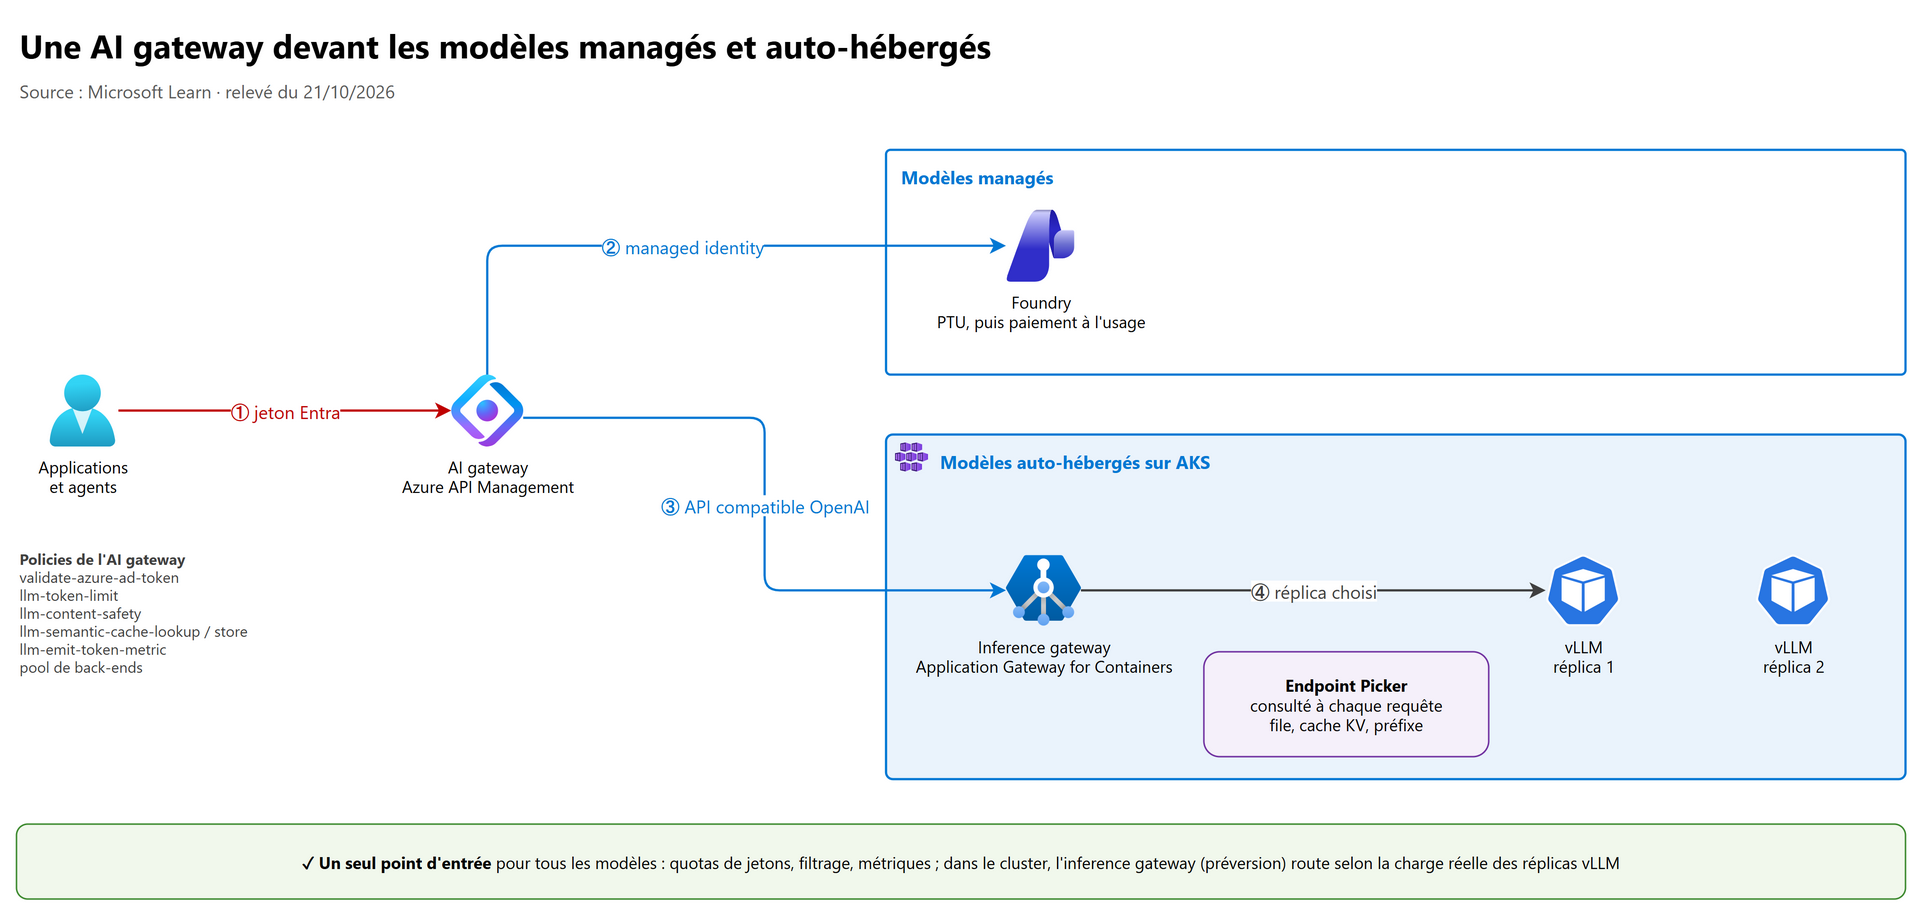
L'AI gateway d'APIM met un seul point d'entrée devant tous les modèles : Foundry (import direct, authentification au back-end
par managed identity), modèles auto-hébergés importés comme Language Model API OpenAI-compatible (vLLM, TGI…) ou en
passthrough, et autres fournisseurs. Policies clés : validate-azure-ad-token, llm-token-limit (429 au-delà du débit,
403 au-delà du quota), llm-content-safety, llm-semantic-cache-lookup / store, llm-emit-token-metric, pool de back-ends
avec disjoncteur. Détail et exemple XML : SC-500, chapitre 07, section 8.
Piège :
llm-token-limitcompte les jetons selon le schéma de l'API (OpenAI Chat Completions ou Responses, Anthropic Messages, Vertex AI) ; pour un modèle open source auto-hébergé, vérifier que le comptage correspond à son tokenizer.
8.2 Dans le cluster : l'inference gateway (préversion)#
Application Gateway for Containers propose une inference gateway fondée sur la Gateway API Inference Extension :
- InferencePool : le groupe de pods de modèle et l'Endpoint Picker (EPP) qui choisit le pod pour chaque requête ;
- l'EPP note les réplicas selon la file d'attente, l'occupation du cache KV et l'affinité de préfixe : moins de délai avant le premier jeton, moins de timeouts, meilleure utilisation des GPU ;
- routage par modèle (le champ
modeldu corps OpenAI-compatible), répartition pondérée pour les déploiements canary, InferenceObjective pour prioriser les requêtes critiques ; - associée au WAF d'Application Gateway for Containers pour filtrer avant de consommer du GPU.
Limite : elle vise les modèles auto-hébergés sur Kubernetes, pas les fournisseurs managés (c'est le rôle d'APIM).
9. MCP, tool calling et serveurs d'outils#
- Tool calling : le modèle décide d'appeler une fonction décrite en JSON (météo, base de données…) et renvoie un
tool_callsstructuré ; KAITO le prend en charge pour les préréglages vLLM listés. - MCP (Model Context Protocol) : un serveur d'outils autonome expose des tools, resources et prompts en JSON-RPC sur HTTP streamable ; on met à jour les outils indépendamment du modèle. Un espace de travail KAITO peut appeler un serveur MCP externe (exemple Microsoft avec AutoGen).
Où héberger un serveur MCP (guide Microsoft) :
| Besoin | Service conseillé |
|---|---|
| Point de départ le plus flexible, plusieurs serveurs MCP qui se parlent | Azure Container Apps (standalone) |
| Exécuter du code non fiable ou généré par un LLM | Container Apps dynamic sessions (isolation Hyper-V, MCP géré, préversion) |
| Exposer une API REST existante sans code | App Service built-in MCP (préversion) |
| Outils sans état, paiement à l'appel | Azure Functions (extension MCP) |
| Cluster existant, GPU à côté, réseau ou KEDA sur mesure | AKS : Deployment + Service + Ingress, Workload Identity |
Sur AKS, un exemple Microsoft Learn déploie un serveur MCP avec le contrôleur open source KMCP (ressource MCPServer).
APIM peut aussi exposer une API REST comme serveur MCP ou gouverner un serveur MCP existant.
10. Sécurité propre à une plateforme d'IA#
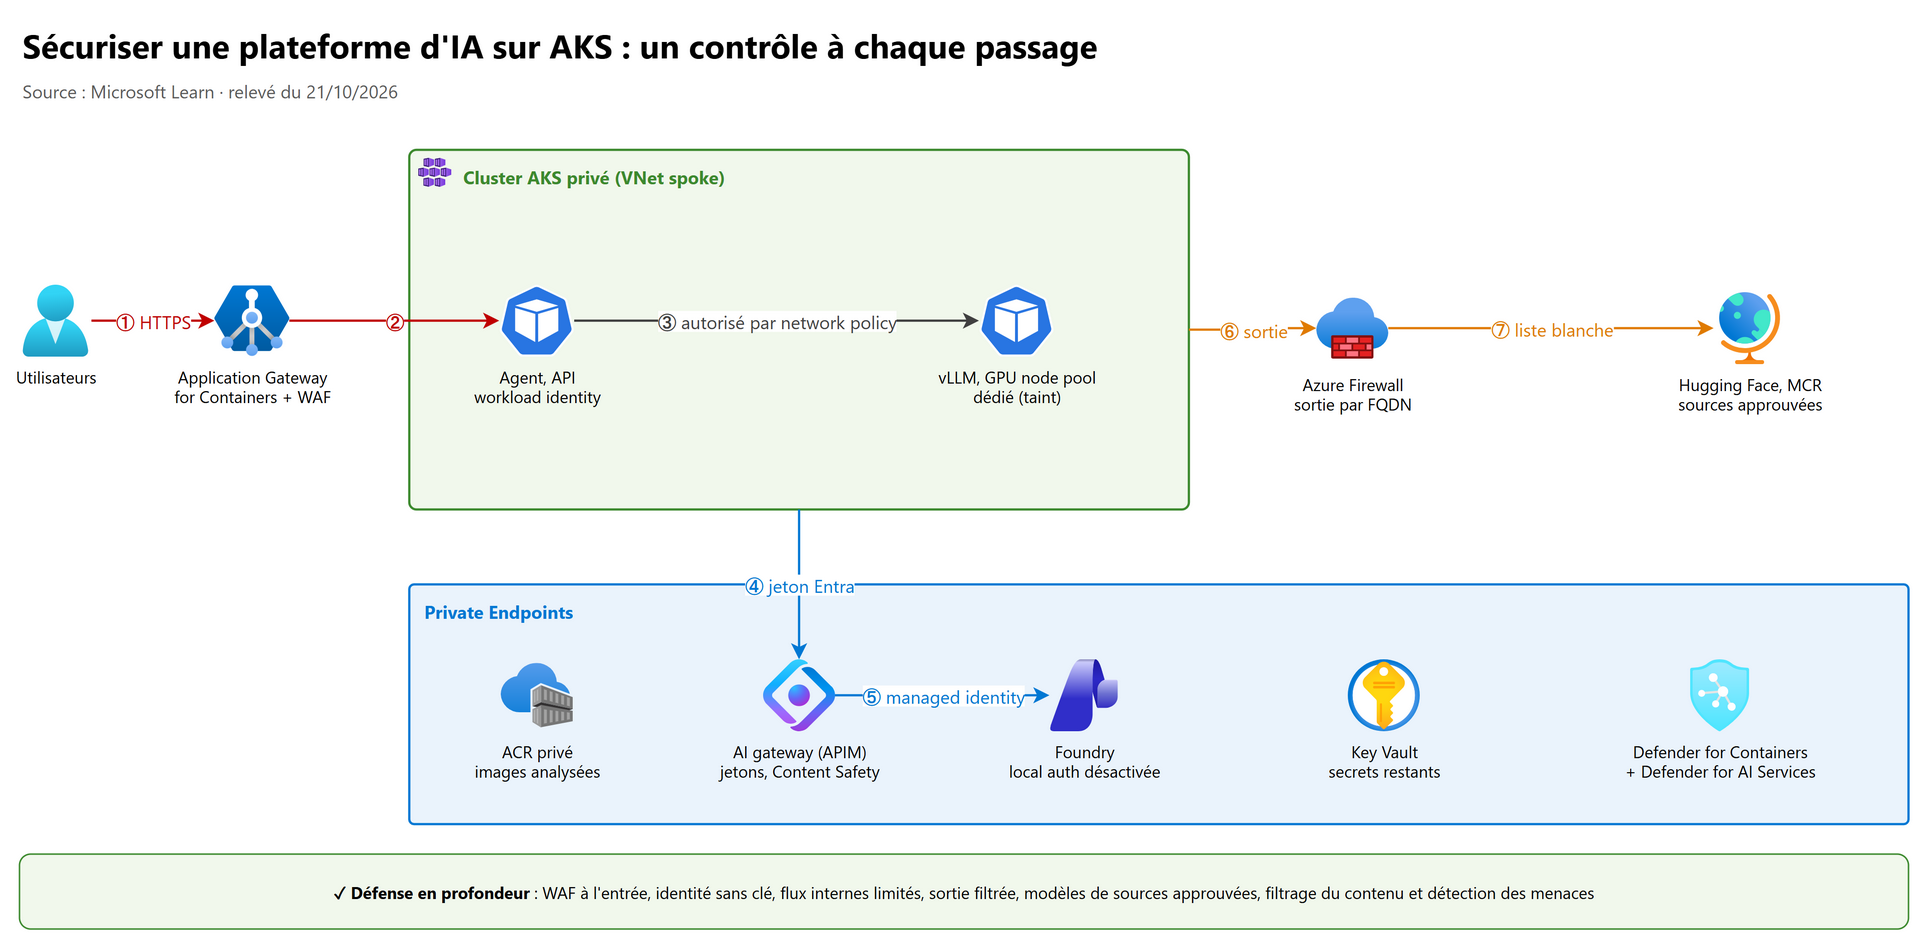
| Passage | Contrôle | Pourquoi |
|---|---|---|
| Entrée | Application Gateway for Containers + WAF, ou Front Door | Bloquer l'abusif avant qu'il ne consomme du GPU |
| Identité | Workload Identity, Entra ID Authentication sur Foundry, clés locales désactivées | Aucun secret dans les pods |
| Flux internes | Network Policy (seul l'agent parle à vLLM) ; cluster privé | Limiter les mouvements latéraux |
| Sortie | Azure Firewall en sortie (FQDN autorisés : registres de modèles, MCR) | Empêcher l'exfiltration et les téléchargements non approuvés |
| Modèles | Sources de confiance (gouvernance du choix des modèles), images dans ACR privé analysées par Defender for Containers | Un modèle ou une image peut être piégé (désérialisation, malware) |
| Contenu | Prompt Shields, Content Safety (policy APIM llm-content-safety ou guardrails Foundry) |
Injection d'invite, contenu nuisible |
| Détection | Defender for AI Services (applications construites avec Foundry), AI-SPM de Defender CSPM (découvre les bibliothèques d'IA dans les images et l'IaC) | Menaces à l'exécution, posture |
| Nodes GPU | Pool dédié, taint, mise à jour de l'image de node planifiée | Pas de patch automatique sur Azure Linux GPU |
Responsabilité : les logiciels open source que vous déployez (moteur d'inférence, opérateurs) sont hors SLA AKS et support Azure ; ceux que Microsoft déploie via un add-on (KAITO) sont construits, analysés et signés par Microsoft.
Pour l'entraînement distribué, attention : NCCL négocie des ports dynamiques ; une Network Policy trop étroite fait « pendre » les jobs. Autoriser tout le trafic entre les réplicas du job et le DNS, pas au-delà.
11. Observabilité d'une charge d'IA#
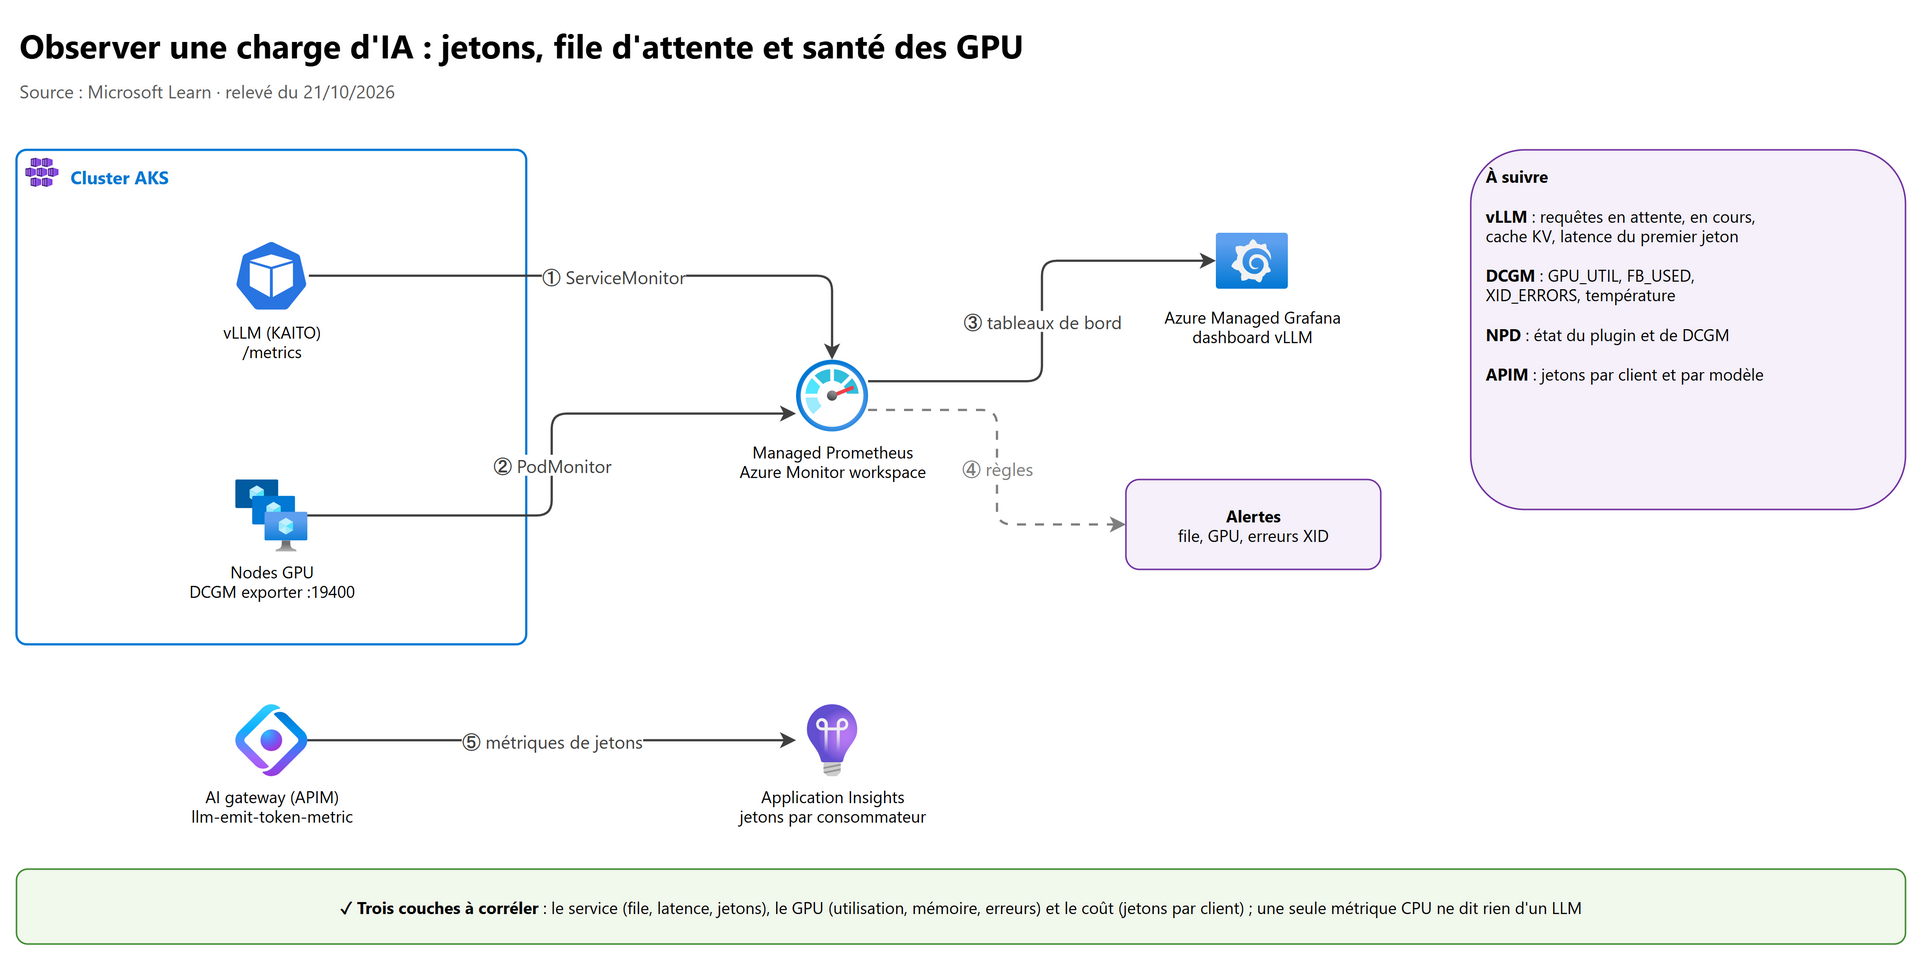
- Managed Prometheus + Container Insights + Azure Managed Grafana : la base.
- vLLM : KAITO publie
/metrics; unServiceMonitor(CRDazmonitoring.coreos.com/v1, danskube-system) les envoie au Managed Prometheus ; vLLM fournit un tableau de bord Grafana à importer. - GPU : DCGM exporter (port 19400 avec le Managed GPU), récupéré par un
PodMonitor; ne pas déployer deux exportateurs si le GPU Operator en a déjà un.
| Métrique DCGM | Sens |
|---|---|
DCGM_FI_DEV_GPU_UTIL |
Pourcentage de temps actif du GPU |
DCGM_FI_DEV_FB_USED / FB_FREE |
Mémoire GPU utilisée / libre |
DCGM_FI_DEV_POWER_USAGE, GPU_TEMP |
Consommation, température |
DCGM_FI_DEV_XID_ERRORS |
Erreurs matérielles NVIDIA (XID) |
- Santé GPU : le Node Problem Detector expose des conditions de node (
UnhealthyNvidiaDevicePlugin,UnhealthyNvidiaDCGMServices, nombre de GPU incorrect) : alerte, isolement du node, replanification. - Jetons et coût :
llm-emit-token-metricd'APIM vers Application Insights, par client et par modèle.
12. Entraînement et ajustement fin (en bref)#
| Sujet | À retenir |
|---|---|
| Ajustement fin | PEFT : LoRA (adaptateurs légers) et QLoRA (adaptateurs quantifiés) ; avec KAITO, Workspace tuning (A100 ou mieux conseillé) |
| Entraînement distribué | Kubeflow Training Operator (PyTorchJob, TFJob) ; NCCL sur l'interface eth0 du pod, NCCL_IB_DISABLE=1 sans RDMA |
| Partage entre équipes | Kueue (ClusterQueue, LocalQueue, quotas nvidia.com/gpu) ; Volcano pour l'admission tout ou rien |
| Priorités | PriorityClass : l'inférence peut préempter l'entraînement, qui reprend depuis un point de reprise |
| Robustesse | Job idempotent, gestion de SIGTERM, points de reprise hors du pod (Blob, Files, Disk), /dev/shm agrandi pour les chargeurs de données |
13. Erreurs fréquentes#
| Erreur | Conséquence | Correction |
|---|---|---|
| Pas de taint sur le pool GPU | Des pods ordinaires occupent des VM à plusieurs euros de l'heure | Taint + toleration + requête nvidia.com/gpu |
| Mise à l'échelle sur le CPU | Le LLM sature sans ajout de réplicas | KEDA sur la file ou les métriques vLLM |
| Pool GPU à 0 pour une interface de chat | Une à plusieurs minutes d'attente au premier message | 1 réplica chaud, mise à zéro la nuit |
| Workspace KAITO jamais prêt | Quota GPU absent ou taille indisponible dans la région | Demander le quota, vérifier la région |
| Workspace supprimé, pool GPU oublié | Facture qui continue | Supprimer le pool (label kaito.sh/workspace) |
| T4 choisi pour KAITO | Non pris en charge (pré-Ampere) | A10, A100, H100 |
| Clé Azure OpenAI dans un Secret ou une variable | Fuite possible, rotation manuelle | Workload Identity + RBAC, clés locales désactivées |
| Spot pour l'inférence utilisateur | Coupures à 30 s de préavis | Spot pour les lots seulement |
| Network Policy stricte sur un job d'entraînement | Job bloqué (ports NCCL dynamiques) | Autoriser le trafic entre réplicas du job |
| Image tirée par digest avec Artifact Streaming | Pas de streaming | Tirer par tag (ou renoncer au streaming) |
14. Lab#
Coût : un node A100 coûte cher à l'heure. Faire le lab dans un abonnement de test, supprimer tout à la fin. Rien n'est à lancer sur un environnement partagé.
Lab A : un LLM open source avec KAITO (environ 1 h)
- Vérifier le quota GPU de la famille visée dans la région.
- Créer un cluster avec
--enable-ai-toolchain-operator --enable-oidc-issuer. kubectl applydu Workspace Phi-4-mini de l'exemple officiel ; suivrekubectl get workspace -w(ResourceReady,InferenceReady,WorkspaceSucceeded).- Tester l'API compatible OpenAI depuis un pod
curlsur l'IP du Service. - Ajouter un
ServiceMonitor, importer le tableau de bord vLLM dans Grafana, envoyer quelques requêtes. - Nettoyer :
kubectl delete workspace …, puis supprimer le GPU node pool créé, puis le resource group.
Lab B : une application qui appelle Azure OpenAI sans clé (environ 45 min)
- Déployer l'application d'exemple « AKS Store » du démarrage rapide OpenAI sur AKS.
- Suivre « Secure access to Azure OpenAI from AKS » : managed identity, rôle Cognitive Services OpenAI User, federated credential, ServiceAccount annoté, label sur le pod.
- Vérifier avec
kubectl describe podque plus aucune clé n'apparaît dans les variables d'environnement.
15. Questions d'entretien#
1. Un client veut « mettre ChatGPT dans AKS ». Que lui proposez-vous ?
Clarifier d'abord : s'il veut une application qui utilise un modèle, l'application va sur AKS et le modèle reste dans Foundry (Azure OpenAI), appelé sans clé par Workload Identity et Private Endpoint. On n'héberge un modèle sur AKS que pour un modèle open source ou ajusté, un gros volume, ou des données qui ne doivent pas sortir.
2. AKS, Container Apps ou Azure ML pour servir un modèle open source ?
Container Apps serverless GPUs si la charge est intermittente et que T4 ou A100 suffisent (mise à zéro, à la seconde). Azure ML managed online endpoint si l'équipe fait du MLOps complet (déploiement sûr, monitoring de modèle). AKS si on a déjà la plateforme et l'équipe, ou besoin de H100/L4, d'un réseau particulier, d'un coût maîtrisé à gros volume.
3. Comment empêcher les pods ordinaires d'aller sur les nodes GPU ?
Pool GPU dédié avec un taint (
sku=gpu:NoSchedule), toleration et requêtenvidia.com/gpudans les seuls pods GPU, plus un label pour lenodeSelector. Le taint et la taille se fixent à la création du pool.
4. Comment partager un A100 entre plusieurs petits modèles ?
MIG en production : découpage matériel jusqu'à 7 instances isolées, profil fixé à la création du pool, exposé en Single ou Mixed. Time-slicing ou MPS (via le GPU Operator) en développement : plus souples mais sans isolation.
5. Sur quoi mettre à l'échelle un service LLM ?
Sur la charge d'inférence : file d'attente (Service Bus) ou métriques vLLM (requêtes en attente, cache KV) via KEDA et le Managed Prometheus ; le cluster autoscaler ou NAP ajoute les nodes GPU. Pas sur le CPU.
6. Le premier appel après une nuit prend trois minutes. Pourquoi, et que faire ?
Démarrage à froid : création du node GPU, téléchargement d'une image de plusieurs Go, chargement du modèle. Garder un réplica chaud en journée, Artifact Streaming (préversion), poids sur stockage monté, disque OS éphémère, Prepared Image Specification.
7. Qu'apporte KAITO par rapport à un Deployment vLLM écrit à la main ?
Un Workspace provisionne les nodes GPU à la bonne taille, applique une configuration testée pour le modèle (pas d'OOM à régler), expose une API compatible OpenAI, gère l'ajustement fin et les métriques. Limites : GPU Ampere+, pas de Windows, une version de retard, pool à supprimer à la main.
8. Comment l'application accède-t-elle à Azure OpenAI sans clé ?
Workload Identity : OIDC issuer du cluster, user-assigned managed identity avec le rôle Cognitive Services OpenAI User, federated credential sur le service account, annotation
client-idet labelazure.workload.identity/use;DefaultAzureCredentialdans le code. Puis clés locales désactivées et Private Endpoint.
9. Pourquoi une AI gateway, et pourquoi en plus une inference gateway ?
L'AI gateway (APIM) gouverne tous les modèles, managés ou non : authentification Entra, quotas de jetons par client, Content Safety, cache sémantique, métriques de coût, bascule PTU vers paiement à l'usage. L'inference gateway (Application Gateway for Containers, préversion) agit dans le cluster : elle choisit le réplica vLLM selon sa file et son cache KV.
10. Quels contrôles de sécurité propres à l'IA ajoutez-vous sur AKS ?
Sources de modèles approuvées et images analysées dans un ACR privé ; sortie filtrée par Azure Firewall ; Network Policies ; Prompt Shields et Content Safety à la passerelle ; Defender for Containers sur le cluster et Defender for AI Services sur Foundry ; aucune clé (Workload Identity) ; journalisation des jetons et des invites selon la politique de données.
16. Fiche à retenir#
- Deux cas : héberger le modèle (GPU, KAITO, vLLM) ou héberger l'application qui appelle Foundry (le plus fréquent).
- Choix : Foundry → Container Apps serverless GPUs (T4, A100, mise à zéro) → Azure ML (online endpoints) → AKS (contrôle total).
- L4 et H100 : AKS ; Container Apps ne propose que T4 et A100.
- GPU node pool dédié, taint + toleration +
nvidia.com/gpu; taille et taint fixés à la création. - Pile NVIDIA : pilote, device plugin, DCGM exporter ; profils Managed GPU (préversion), driver only (défaut), BYO.
- MIG (A100, H100, H200) : jusqu'à 7 instances isolées, pour la production ; time-slicing et MPS sans isolation.
- Spot : lots seulement (30 s de préavis, sans SLA) ; quota GPU par famille et région à demander avant.
- KAITO : Workspace → nodes GPU + vLLM + API compatible OpenAI ; Ampere+, pas de Windows ; pool à supprimer à la main.
- Mise à l'échelle sur la file ou les métriques vLLM (KEDA ≥ 2.10 + Managed Prometheus), pas sur le CPU.
- Démarrage à froid = VM + image + modèle : réplica chaud, Artifact Streaming (tag, ACR Premium), poids sur stockage.
- Sans clé : Workload Identity + Cognitive Services OpenAI User + Private Endpoint ; 20 federated credentials par identité.
- AI gateway (APIM) devant tous les modèles ; inference gateway (préversion) dans le cluster pour choisir le réplica.
- Observer le service (file, latence, jetons), le GPU (DCGM, XID) et le coût (jetons par client).
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Déployer un modèle IA sur AKS avec l'AI toolchain operator
- Ajuster et déployer un modèle avec l'AI toolchain operator
- Concepts : ajustement fin des modèles de langage
- Intégrer des modèles personnalisés avec KAITO
- Tool calling avec KAITO
- Connecter un serveur MCP à KAITO
- Surveiller les métriques d'inférence KAITO
- KAITO dans Visual Studio Code
- Utiliser des GPU sur AKS
- Pool de nœuds GPU entièrement managé (préversion)
- Pool de nœuds GPU multi-instance
- Stratégies de partitionnement GPU
- Bonnes pratiques MLOps sur AKS
- Utiliser AKS pour des charges GPU (Architecture Center)
- Tailles de VM GPU
- Spot node pool sur AKS
- Module complémentaire KEDA
- Intégrer KEDA à Managed Prometheus
- Artifact Streaming sur AKS
- Prepared Image Specification (préversion)
- Améliorer le tirage des images sur AKS
- Serverless GPUs dans Azure Container Apps
- Online endpoints d'Azure Machine Learning
- Kubernetes compute target dans Azure Machine Learning
- Optimiser le coût des charges d'IA
- Sécuriser l'accès à Azure OpenAI depuis AKS
- Déployer une application qui utilise OpenAI sur AKS
- Microsoft Entra Workload ID sur AKS
- Utiliser Azure OpenAI sans clé
- Connecter AKS à Azure OpenAI avec Service Connector
- RAG et index dans Foundry
- AI gateway dans Azure API Management
- Importer une Language Model API dans APIM
- Policy llm-token-limit
- Application Gateway for Containers : inference gateway
- Configurer l'inference gateway
- Choisir un service Azure pour un serveur MCP
- Héberger des serveurs MCP sur Container Apps
- Serveur MCP Open-WebSearch sur AKS
- Sécuriser les services PaaS pour l'IA (CAF)
- AI security posture management
- Activer la protection contre les menaces pour les services d'IA