

Version : 1.0 · Date : 2026-10-21
En une phrase : dans AKS, le VNet ne voit que des nodes et des services Azure ; les pods vivent dans un CIDR à part (overlay) ou dans un subnet du VNet (plat), les Services leur donnent un nom et une IP stables, le trafic entre par un Load Balancer ou une passerelle L7 (Gateway API), sort par un
outboundTypechoisi, et l'API server est public filtré, privé ou intégré au VNet.
Ce chapitre suppose acquis le réseau Azure (VNet, peering, NSG, UDR, Private Link, Private DNS zone, Azure Firewall : voir
../SC-500/06-reseau.md). Il ne traite que ce qui est propre à Kubernetes et à AKS. Les
composants du cluster sont dans 01-architecture.md, l'identité et la sécurité dans
03-identite-securite.md.
Sommaire#
- Le modèle réseau Kubernetes
- Les modèles CNI d'AKS : d'où viennent les IP des pods
- Planifier les adresses
- Faire entrer le trafic
- Faire sortir le trafic
- Atteindre l'API server
- Network policies
- Service mesh Istio
- L'architecture de référence
- Terraform : le bloc network_profile
- Dépanner et pièges de production
- Lab
- Questions d'entretien
- Fiche à retenir
1. Le modèle réseau Kubernetes#
1.1 Les règles du jeu#
Kubernetes impose un modèle simple, que tout plug-in réseau (CNI, Container Networking Interface) doit respecter :
| Règle | Conséquence pour l'architecte |
|---|---|
| Chaque Pod a sa propre IP | Pas de mappage de ports comme avec Docker ; un pod se comporte comme une petite VM |
| Tout pod joint tout autre pod sans NAT, quel que soit le node | Par défaut, le réseau est plat et tout est ouvert : il faut des Network policies pour segmenter |
| Les pods sont éphémères : leur IP change à chaque recréation | On ne s'adresse jamais à un pod par son IP, mais à un Service |
| Le plug-in CNI attribue les IP et route le trafic | Dans AKS, c'est Azure CNI (overlay ou plat) avec un plan de données iptables Azure ou Cilium |
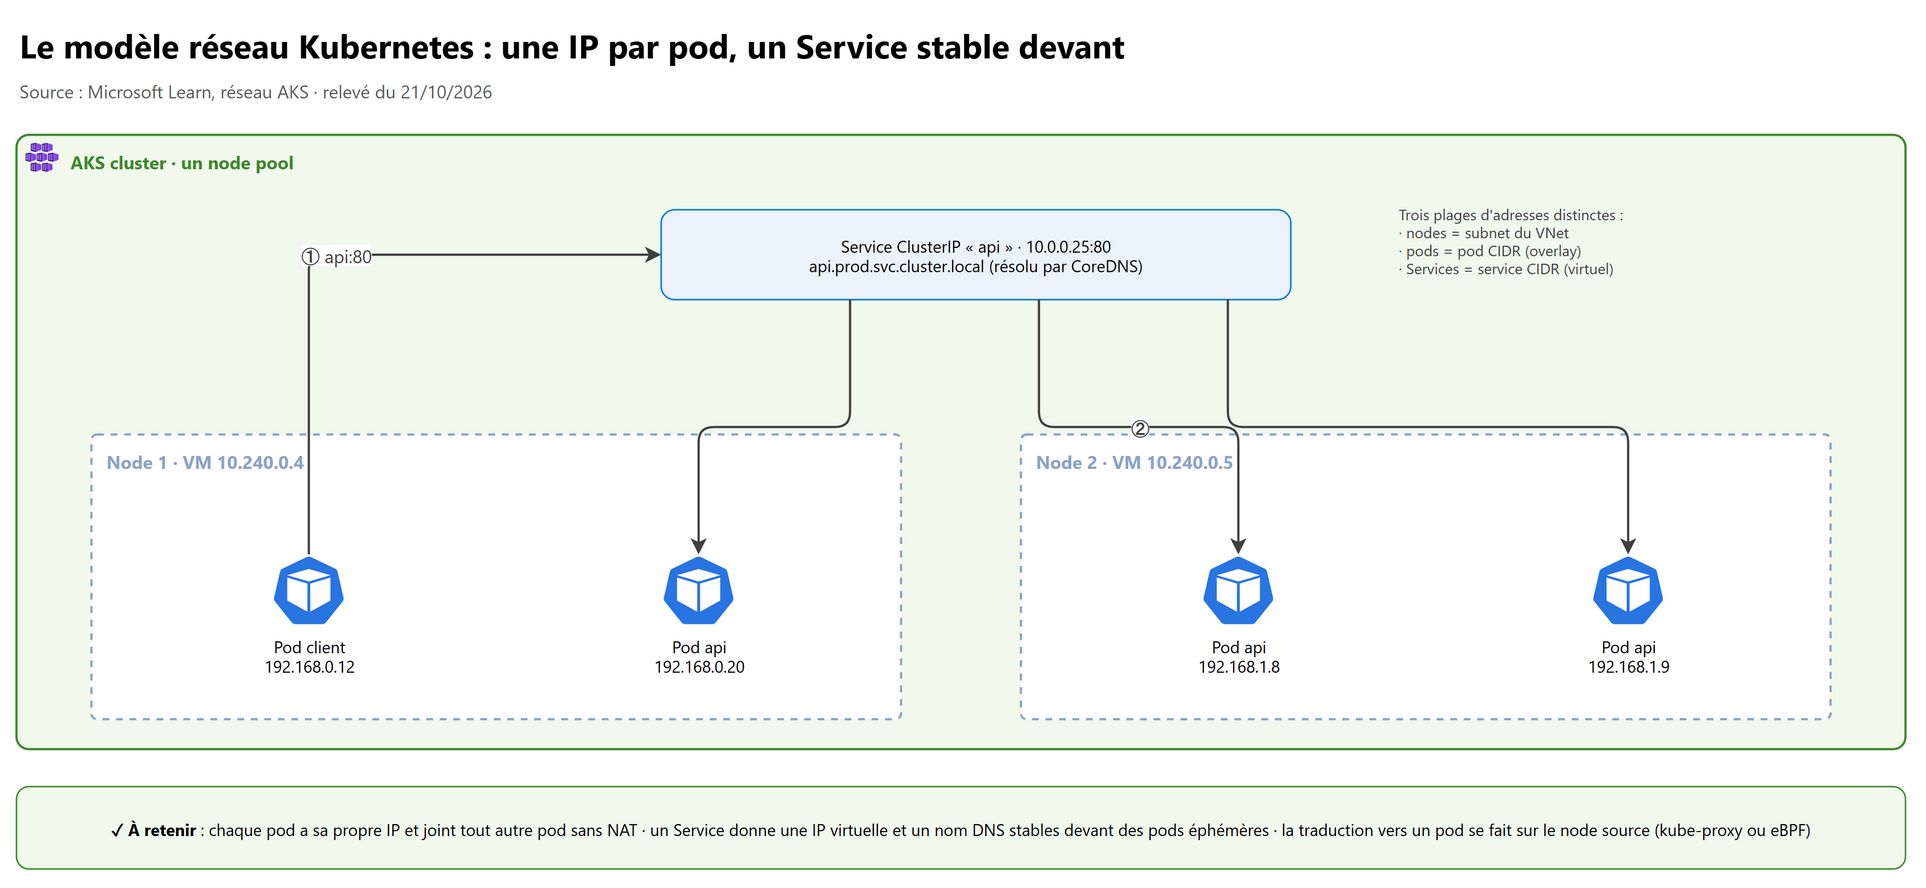
Un cluster AKS manipule donc trois plages d'adresses à ne jamais confondre :
| Plage | Qui la porte | Visible dans le VNet ? | Exemple |
|---|---|---|---|
| Node subnet | Les VM des node pools (VMSS) | Oui, ce sont des IP du VNet | 10.240.0.0/22 |
| Pod CIDR (overlay) ou pod subnet (plat) | Les pods | Overlay : non · plat : oui | 192.168.0.0/16 ou 10.241.0.0/16 |
| Service CIDR | Les IP virtuelles des Services (ClusterIP) |
Jamais : elles n'existent que dans les règles des nodes | 172.16.0.0/16 |
1.2 Les Services#
Un Service regroupe des pods par labels (sélecteur) et leur donne une IP et un nom DNS stables. Les types :
| Type | Ce qu'il crée | Usage |
|---|---|---|
ClusterIP (défaut) |
Une IP virtuelle interne au cluster | Communication entre microservices |
NodePort |
Un port (30000-32767 par défaut côté Kubernetes) ouvert sur chaque node, devant le ClusterIP |
Rarement en direct ; brique interne du LoadBalancer |
LoadBalancer |
Une règle sur l'Azure Load Balancer du cluster (public ou interne) + les règles NSG nécessaires, gérées par AKS | Exposer un service L4 (TCP/UDP) |
ExternalName |
Un enregistrement DNS (CNAME) vers un nom externe | Donner un nom interne à une ressource externe |
Headless (clusterIP: None) |
Pas d'IP virtuelle : le DNS renvoie directement les IP des pods | StatefulSets, bases distribuées, découverte côté client |
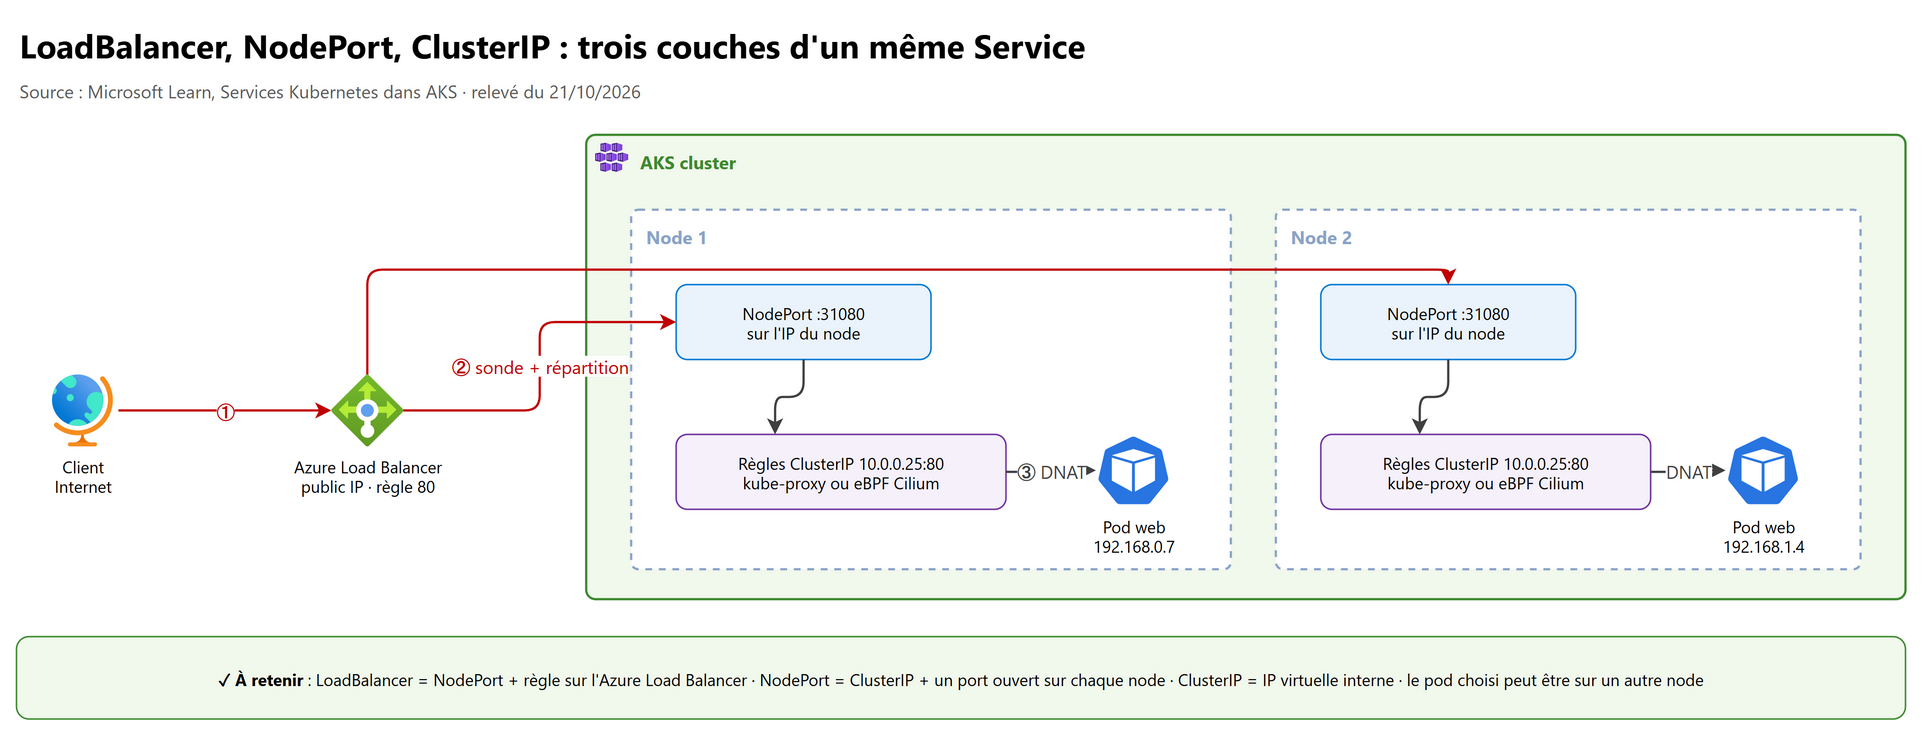
Qui traduit l'IP du Service en IP de pod ? Le node source, avant que le paquet ne parte :
- avec le plan de données Azure iptables :
kube-proxyprogramme des règles sur chaque node ; - avec Azure CNI powered by Cilium : des programmes eBPF remplacent
kube-proxy(les clusters Cilium n'utilisent paskube-proxy).
En entretien : « Un
ClusterIPne répond pas au ping » est normal : ce n'est pas une interface, juste une règle de traduction (DNAT) sur les nodes.
Exposer un service en interne au VNet (annotation officielle) ; Microsoft recommande les annotations plutôt que le champ
loadBalancerIP, déprécié en amont :
apiVersion: v1
kind: Service
metadata:
  name: api-interne
  annotations:
    service.beta.kubernetes.io/azure-load-balancer-internal: "true"
    service.beta.kubernetes.io/azure-load-balancer-internal-subnet: "snet-ilb"   # subnet du même VNet que le cluster
spec:
  type: LoadBalancer
  selector:
    app: api
  ports:
    - port: 80
      targetPort: 8080
Pour limiter les sources d'un Service LoadBalancer, utiliser spec.loadBalancerSourceRanges : il s'applique avant la
réécriture des adresses, alors qu'une Network policy peut ne pas voir l'IP d'origine.
1.3 Le DNS du cluster#
CoreDNS (Service kube-dns dans kube-system) résout les noms internes. Le nom complet d'un Service est
<service>.<namespace>.svc.cluster.local ; dans le même namespace, api suffit.
sequenceDiagram
    participant P as Pod client (namespace prod)
    participant L as LocalDNS (si activé, sur le node)
    participant C as CoreDNS (kube-system)
    participant A as Azure DNS 168.63.129.16
    P->>L: api ?
    L->>C: api.prod.svc.cluster.local
    C-->>P: 10.0.0.25 (IP du Service)
    P->>L: monkv.vault.azure.net ?
    L->>C: nom hors cluster
    C->>A: transfert (ou DNS personnalisé du VNet)
    A-->>P: IP privée si Private DNS zone liée, sinon publique
- LocalDNS : un proxy DNS sur chaque node qui résout localement, réduit la latence et soulage la table
conntrack. Préconfiguré dans AKS Automatic, optionnel par node pool dans AKS Standard ; l'activer réimage les nodes du pool. Avec Cilium, autoriser la sortie vers169.254.10.0/24sur UDP et TCP 53 dans les Network policies. - Toujours autoriser le DNS en UDP et en TCP 53 (NSG, pare-feu, DNS personnalisé) : un client repasse en TCP quand la réponse UDP est tronquée.
- La configuration de CoreDNS se personnalise par ConfigMap (domaines internes, redirecteurs) : voir Customize CoreDNS dans les références.
2. Les modèles CNI d'AKS : d'où viennent les IP des pods#
Choisir le réseau des pods, c'est faire deux choix indépendants :
- la gestion des adresses (IPAM) : overlay ou plat ;
- le plan de données (routage, application des politiques) : Azure iptables, Cilium ou BYO CNI.
2.1 Azure CNI Overlay : le choix par défaut#
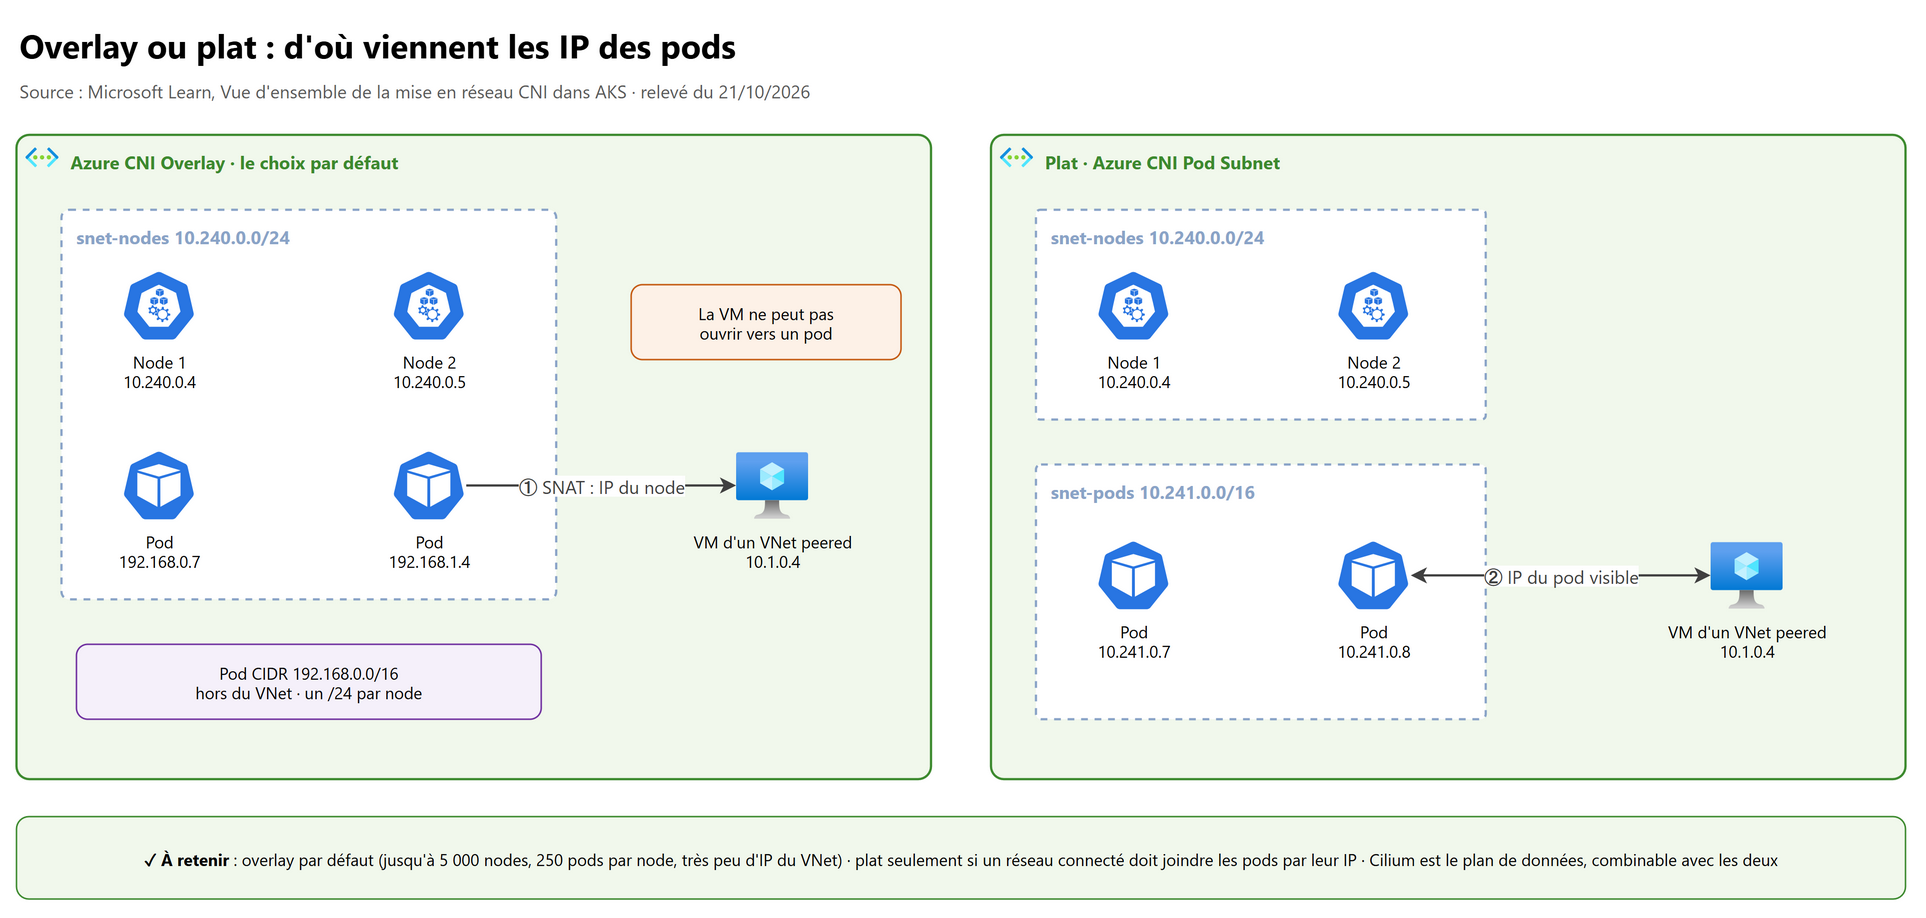
- Seuls les nodes prennent des IP du VNet. Les pods prennent leurs IP dans un pod CIDR privé fourni à la création.
- Chaque node reçoit un bloc
/24de ce CIDR (taille fixe) : jusqu'à 250 pods par node (défaut 250, minimum 10 ; 110 recommandés pour Windows Server). - Un domaine de routage distinct dans la pile réseau Azure porte le pod CIDR : pas d'encapsulation, pas d'UDR à gérer, performances équivalentes aux VM.
- Le trafic qui sort du pod CIDR (VNet appairé, local, Internet) est SNATé vers l'IP du node. En retour, personne hors du cluster ne peut ouvrir une connexion vers un pod : on passe par un Service ou une passerelle.
- Échelle : jusqu'à 5 000 nodes et 200 000 pods par cluster (limites indépendantes).
- Le même pod CIDR peut être réutilisé par plusieurs clusters indépendants, à condition de ne chevaucher aucun réseau connecté (sinon le trafic vers cet hôte part dans l'overlay et est perdu).
- Sur un cluster Linux uniquement, on peut étendre le pod CIDR vers un sur-ensemble contigu ; jamais le réduire ni le remplacer.
2.2 Le modèle plat : Azure CNI Pod Subnet#
Les pods prennent des IP du VNet, dans un subnet séparé de celui des nodes. Les réseaux connectés joignent les pods directement par leur IP, et l'IP du pod est préservée à travers les VNet connectés. Deux modes :
| Dynamic IP allocation | Static block allocation | |
|---|---|---|
| Principe | Le node demande des IP au pod subnet par lots de 16 (et un nouveau lot quand il lui en reste moins de 8) | Le node reçoit des blocs /28 à sa création et les garde toute sa vie |
| Échelle | Pod subnet jusqu'à /16, environ 65 000 pods |
Jusqu'à 1 million de pods, subnet jusqu'à /12 |
| Efficacité des IP | Bonne | Gaspillage si max-pods mal choisi : viser max_pods = 16 × N − 1 (31, 47, 63…) |
| Point d'attention | Forte rotation de pods (CronJobs, agents CI) : des pods attendent en ContainerCreating (not enough IPs available … waiting on Azure CNS) |
Pas de migration en place ; Kubernetes 1.28 minimum ; Private Link service via Service LoadBalancer non pris en charge |
Atout du pod subnet : on peut appliquer au subnet des pods des règles différentes de celui des nodes (NSG, NAT Gateway pour fixer l'IP source d'un pool, Internet pour les pods mais pas pour les nodes).
Azure CNI Node Subnet (nodes et pods dans le même subnet) est hérité : à garder seulement si l'on veut un VNet géré par AKS.
kubenet est retiré le 31 mars 2028 (400 nodes maximum, UDR à gérer) : migrer vers Azure CNI Overlay.
2.3 Le plan de données : Cilium#
Azure CNI powered by Cilium combine l'IPAM d'Azure CNI (overlay, pod subnet ou node subnet) et le plan de données eBPF de Cilium. C'est la configuration par défaut d'AKS Automatic (Azure CNI Overlay + Cilium, avec LocalDNS, managed NAT Gateway et Application routing add-on).
- Routage des Services en eBPF, sans
kube-proxy; application des Network policies intégrée (pas de moteur séparé). - Linux uniquement (Windows : Calico).
- Limites à connaître : une règle
ipBlockne peut pas sélectionner les IP des pods ni des nodes (utiliserpodSelector/namespaceSelector) ; les podshostNetwork: truene sont pas soumis aux politiques ; 65 535 identités Cilium au maximum.
Advanced Container Networking Services (ACNS), payant, s'ajoute à Cilium :
| Fonctionnalité | Sans ACNS | Avec ACNS |
|---|---|---|
Kubernetes NetworkPolicy, CiliumNetworkPolicy L3/L4, CiliumClusterwideNetworkPolicy |
✔️ | ✔️ |
FQDN filtering (toFQDNs, Kubernetes 1.29+) |
❌ | ✔️ (activé par défaut) |
| Politiques L7 (HTTP, gRPC, Kafka) | ❌ | ✔️ |
| Container network observability : métriques et flow logs (Hubble) | ❌ | ✔️ (fonctionne aussi hors Cilium, avec Retina) |
| Chiffrement WireGuard entre nodes (UDP 51871) | ❌ | ✔️ |
| mTLS Cilium | ❌ | Préversion |
BYO CNI : aucun CNI installé par AKS, on apporte le sien ; Microsoft ne prend pas en charge les problèmes liés au CNI.
2.4 Quoi choisir#
flowchart TD
    A[Nouveau cluster] --> B{"Un réseau connecté doit-il<br/>joindre les pods par leur IP ?"}
    B -- Non --> C["Azure CNI Overlay<br/>(recommandation générale)"]
    B -- Oui --> D{"Plus de ~65 000 pods<br/>ou forte rotation de pods ?"}
    D -- Non --> E[Pod Subnet · dynamic IP allocation]
    D -- Oui --> F[Pod Subnet · static block allocation]
    C --> G{Nodes Windows ?}
    E --> G
    F --> G
    G -- Non --> H["Plan de données Cilium<br/>+ ACNS si FQDN, L7, observabilité"]
    G -- Oui --> I["Plan de données Azure iptables<br/>+ Calico pour les Network policies"]
3. Planifier les adresses#
Les règles qui font échouer un déploiement :
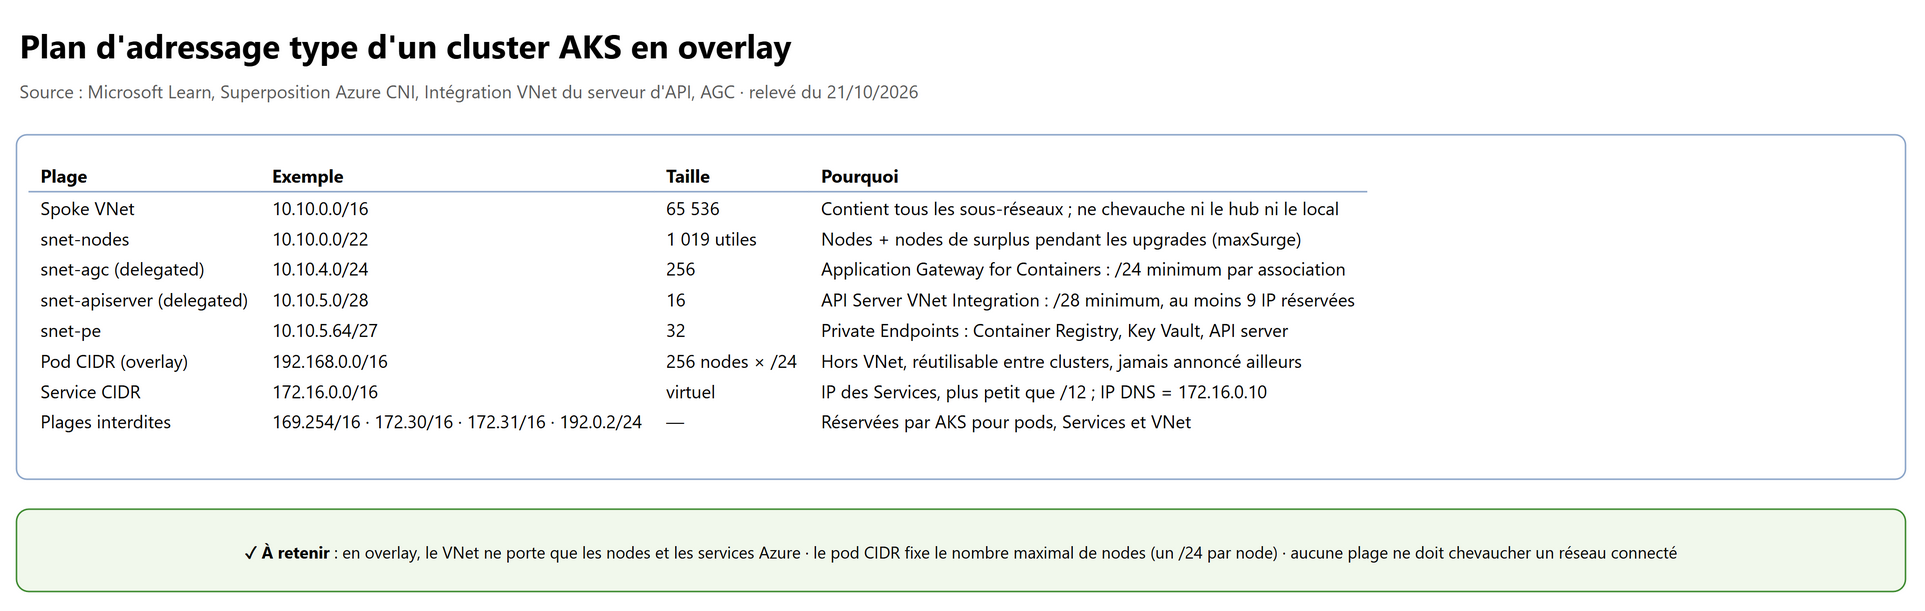
- Plages réservées par AKS (pods, Services, VNet du cluster) :
169.254.0.0/16,192.0.2.0/24,172.30.0.0/16,172.31.0.0/16. Un pod CIDR172.16.0.0/12est refusé (il contient172.30et172.31). - Service CIDR plus petit que
/12, sans chevauchement avec le pod CIDR, les subnets, les VNet appairés et le local. L'IP du DNS (--dns-service-ip) est dans le Service CIDR, jamais la première (réservée àkubernetes.default). Depuis Kubernetes 1.33, la ressourceServiceCIDRpermet d'étendre la plage après coup. - Pod CIDR en RFC 1918 ou RFC 6598 (100.64.0.0/10) : une plage publique n'est pas prise en charge.
- Node subnet dimensionné pour le maximum de nodes plus les nodes de surplus des mises à niveau (
maxSurge) et du cluster autoscaler ; il ne peut pas être délégué. - En overlay, le pod CIDR fixe le nombre maximal de nodes : un
/16donne 256 blocs/24, donc 256 nodes. - BYO VNet : l'identité du cluster a besoin de Network Contributor sur le subnet (ou d'un rôle personnalisé avec
Microsoft.Network/virtualNetworks/subnets/join/actionetMicrosoft.Authorization/roleAssignments/write, plussubnets/readsi l'on définit ses propres subnets). - NSG : AKS n'en pose pas sur un subnet fourni par le client et ne modifie pas ceux qui y sont. Si le NSG contient des refus, autoriser au minimum : node CIDR ↔ node CIDR, node CIDR → pod CIDR, pod CIDR ↔ pod CIDR (tous ports et protocoles ; le trafic overlay n'étant pas encapsulé, les règles du NSG s'y appliquent). Bloquer le trafic interne au subnet par NSG ou pare-feu n'est pas pris en charge : c'est le rôle des Network policies.
4. Faire entrer le trafic#
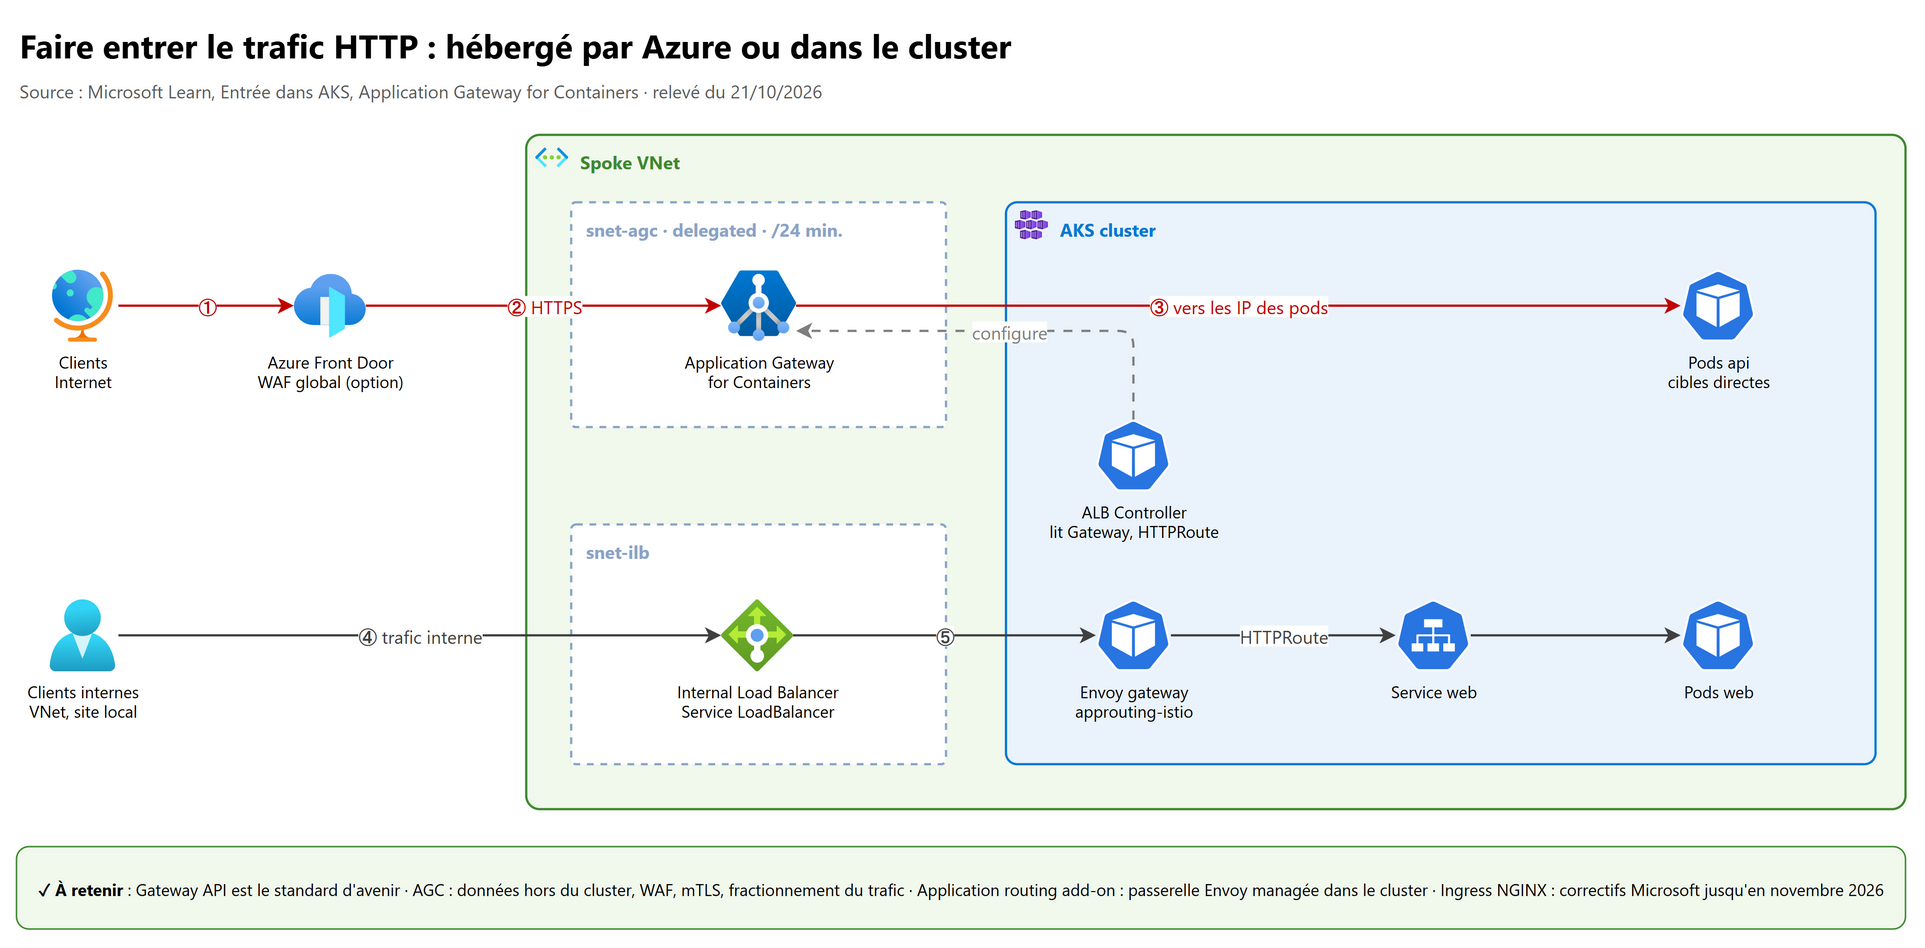
4.1 L4 ou L7#
- Service
LoadBalancer: L4, une règle sur l'Azure Load Balancer par port. Simple, mais aucun routage par URL, nom d'hôte ou en-tête. - Contrôleur d'entrée / passerelle : L7 (HTTP, HTTPS, gRPC), terminaison TLS, routage par chemin et par hôte, fractionnement du trafic. Configuré par l'API Ingress (historique) ou Gateway API (successeur).
Gateway API est le standard d'avenir retenu par AKS. Elle est orientée rôles : l'équipe plateforme possède la
GatewayClass et la Gateway (écoutes, certificats, IP) ; les équipes applicatives possèdent leurs HTTPRoute dans leur
namespace. Ingress mélangeait les deux dans un seul objet et dépendait d'annotations propres à chaque contrôleur.
4.2 Les options d'entrée dans AKS#
Changement majeur 2026 : le projet communautaire Ingress NGINX est retiré (maintenance arrêtée en mars 2026). Microsoft fournit les correctifs de sécurité critiques du NGINX de l'Application routing add-on jusqu'en novembre 2026. Migrer vers la Gateway API.
| Option | Données | API | Points forts | Quand l'utiliser |
|---|---|---|---|---|
| Application routing add-on · Gateway API implementation | Dans le cluster (Envoy, control plane Istio léger, GatewayClass approuting-istio, sans sidecar ni CRD Istio) |
Gateway API | Managé, mises à jour en place, autoscaling et disruption budgets sur les proxys ; défaut des nouveaux clusters AKS Automatic à partir de la version 1.36 | Entrée HTTP/HTTPS standard, défaut recommandé |
| Application routing add-on · NGINX managé | Dans le cluster | Ingress | Intégration Key Vault et Azure DNS, LB interne ou externe, IP statique | Existant à migrer avant fin 2026 |
| Application Gateway for Containers (AGC) | Hébergé par Azure, hors du cluster ; piloté par l'ALB Controller | Ingress et Gateway API | WAF (security policy), mTLS frontend et backend, fractionnement pondéré, retries, résilience de zone, mises à jour quasi temps réel des pods ; inference gateway pour les modèles auto-hébergés | Entrée partagée gérée par l'équipe plateforme, WAF, trafic hors du cluster |
| Istio ingress gateway (Istio-based service mesh add-on) | Dans le cluster (Envoy) | API Istio (et Gateway API, voir la note) | Limitation de débit, disjoncteur, mTLS | Quand on utilise déjà le service mesh |
| Application Gateway Ingress Controller (AGIC) | Application Gateway v2 | Ingress | WAF v2, joint les pods par IP | Hérité : AGC est son successeur, migration recommandée ; AGIC s'approprie toute la configuration de l'Application Gateway |
Points d'architecture d'AGC :
- ressources : l'Application Gateway for Containers (parent), ses frontends (point d'entrée, un FQDN unique à cibler par un CNAME ; pas d'IP statique ; les IP privées de frontend ne sont pas encore prises en charge) et son association (lien 1:1 avec un subnet) ;
- subnet d'association délégué à
Microsoft.ServiceNetworking/trafficControllers, au moins/24(256 adresses par déploiement), une association par AGC aujourd'hui ; - l'ALB Controller (deux pods) utilise une user-assigned managed identity avec le rôle AppGw for Containers Configuration
Manager et Network Contributor sur le subnet ; l'AKS add-on crée tout cela (et le subnet
aks-appgateway) à ta place ; - AGC envoie directement vers les IP des pods : ni NodePort ni saut supplémentaire.
Istio et Gateway API : l'entrée par la Gateway API est prise en charge par l'Istio-based service mesh add-on à partir de la révision
asm-1-26, avec la Managed Gateway API activée (page dédiée, la plus à jour ; la page de présentation d'Istio cite encore l'ancienne limite). Restent non pris en charge : la Gateway API pour le trafic est-ouest du mesh (GAMMA), la sortie autrement qu'en déploiement manuel, et la cohabitation avec l'implémentation Gateway API de l'Application routing add-on.
Exemple Gateway API avec l'Application routing add-on :
apiVersion: gateway.networking.k8s.io/v1
kind: Gateway
metadata:
  name: web
  namespace: infra
spec:
  gatewayClassName: approuting-istio      # GatewayClass installée par l'Application routing add-on
  listeners:
    - name: http
      protocol: HTTP
      port: 80
      allowedRoutes:
        namespaces:
          from: All                       # les équipes applicatives attachent leurs routes
---
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: api
  namespace: prod
spec:
  parentRefs:
    - name: web
      namespace: infra
  rules:
    - matches:
        - path: { type: PathPrefix, value: /api }
      backendRefs:
        - name: api                       # Service ClusterIP
          port: 80
sequenceDiagram
    actor U as Client
    participant D as Azure DNS / Front Door
    participant G as Gateway (AGC ou Envoy)
    participant S as Service api
    participant P as Pod api
    U->>D: GET shop.contoso.com/api
    D-->>U: FQDN du frontend AGC (ou IP du LB)
    U->>G: TLS (terminé ici, ou de bout en bout)
    G->>G: HTTPRoute /api vers le Service api, port 80
    G->>P: requête vers l'IP d'un pod prêt (AGC) ou via le Service
    P-->>U: réponse
Préserver l'IP du client : derrière un contrôleur d'entrée, l'IP source d'origine arrive dans l'en-tête X-Forwarded-For si la
préservation est activée ; elle est alors incompatible avec le TLS passthrough sur ce contrôleur.
5. Faire sortir le trafic#
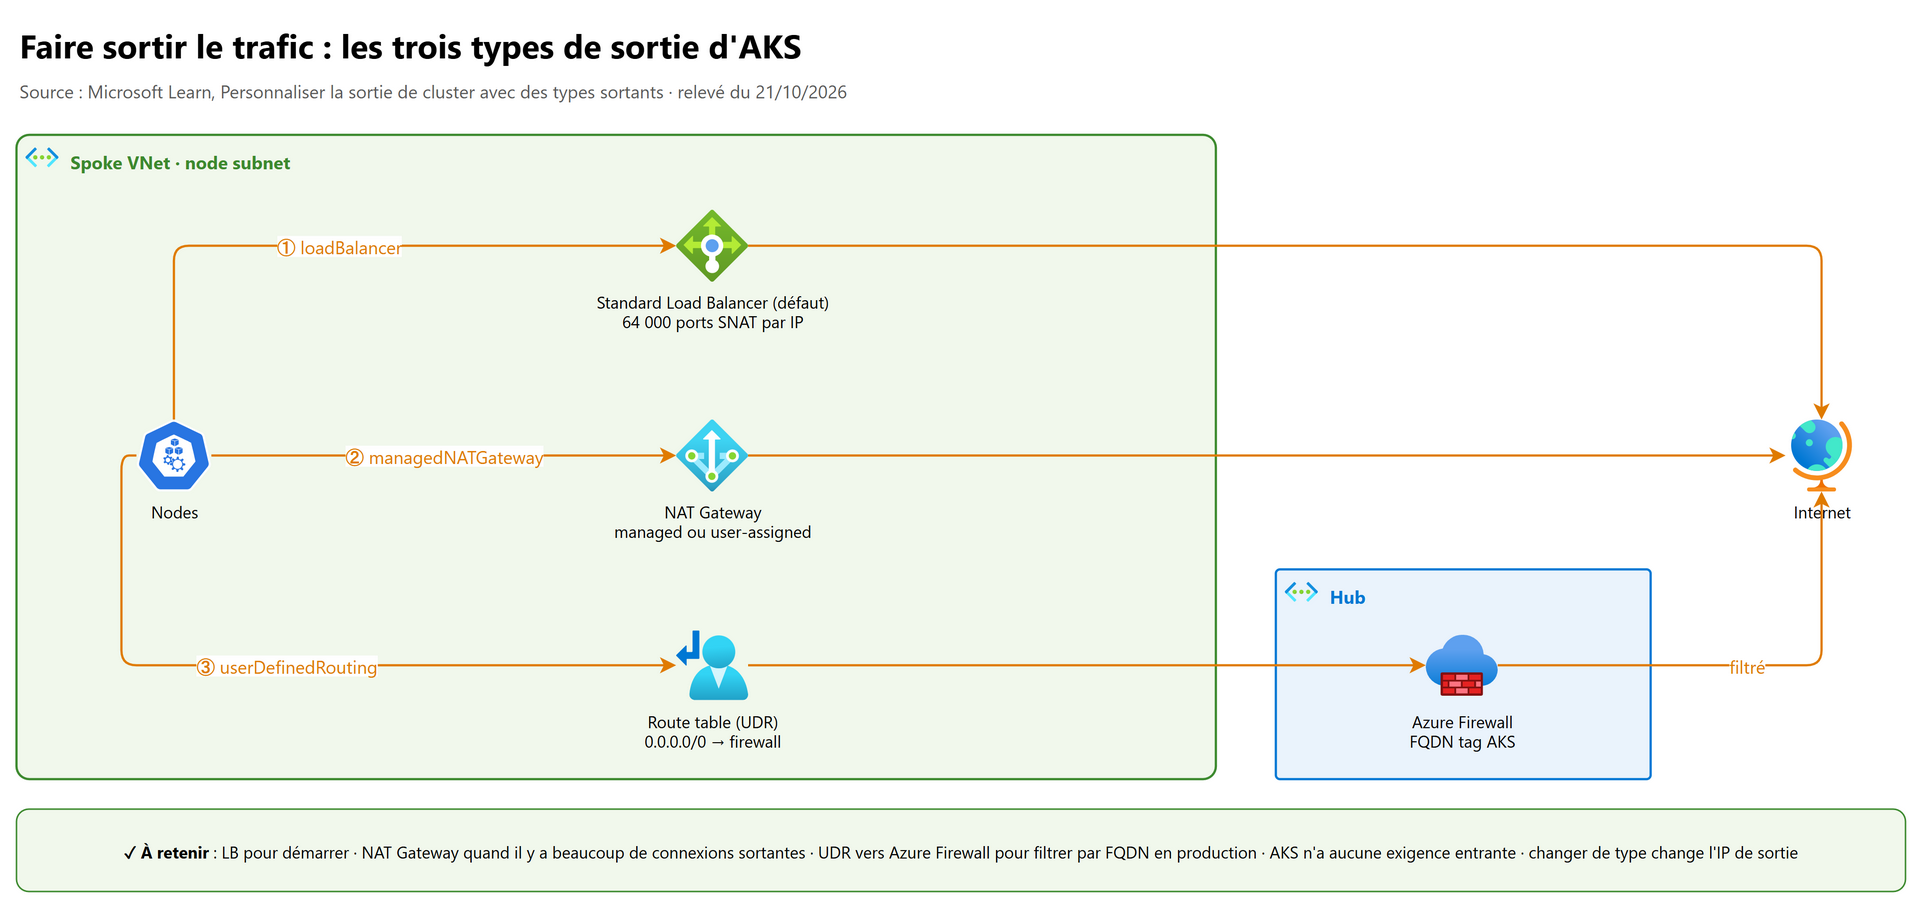
AKS a des dépendances sortantes (API server, Microsoft Container Registry, Entra ID, paquets) mais aucune exigence
entrante. Le chemin de sortie se choisit avec outboundType (prérequis : VMSS et Standard Load Balancer) :
outboundType |
VNet | Ce qu'AKS fait | Quand |
|---|---|---|---|
loadBalancer (défaut) |
Managé ou BYO | Crée une IP publique de sortie sur le Standard Load Balancer et le pool back-end des nodes | Démarrer, petits clusters |
managedNATGateway |
Géré par AKS | Crée une NAT Gateway ; à partir de l'API 2026-06-01, en StandardV2 (redondante interzone, plus de débit) quand la région le permet ; migration Standard → StandardV2 possible, pas l'inverse |
Beaucoup de connexions sortantes |
userAssignedNATGateway |
BYO | Utilise la NAT Gateway associée au subnet (Standard ou StandardV2) | Idem, VNet de l'entreprise |
userDefinedRouting |
BYO | Rien : une route table avec 0.0.0.0/0 vers un pare-feu ou une NVA doit être sur le subnet |
Production verrouillée (hub-spoke) |
none |
Managé ou BYO | Rien, sans exiger de route par défaut | Network isolated cluster uniquement |
block (préversion) |
Géré par AKS | Règles NSG qui bloquent toute sortie Internet | Network isolated cluster |
Points clés :
- Le type de sortie se modifie après création, mais cela change l'IP de sortie et coupe les connexions : mettre à jour les pare-feu distants et les authorized IP ranges de l'API server.
- Sur un cluster non privé, le trafic vers l'API server passe par ce chemin de sortie : un cluster privé ou l'API Server VNet Integration l'évite.
- Fin de l'accès sortant par défaut des VM (31 mars 2026) : les nouveaux clusters à VNet géré par AKS ont des subnets privés
(
defaultOutboundAccess = false) ; sans effet sur les chemins gérés par AKS ni sur les VNet BYO.
5.1 L'épuisement des ports SNAT#
Avec loadBalancer, toutes les connexions sortantes partagent les ports SNAT de l'IP publique : 64 000 ports par IP,
répartis entre les nodes (1 024 par node jusqu'à 50 nodes, moins au-delà : passer de 50 à 51 nodes réduit les ports de
tous les nodes et peut couper des connexions). Formule de dimensionnement :
64 000 / ports par node × nombre d'IP de sortie = nombre maximal de nodes (ports en multiple de 8, compter maxSurge et
le maxCount de l'autoscaler).
# 2 IP de sortie, 4 000 ports par node : 64 000 / 4 000 × 2 = 32 nodes au maximum
az aks update --resource-group rg-aks-prd --name aks-prd \
  --load-balancer-managed-outbound-ip-count 2 \
  --load-balancer-outbound-ports 4000
Fixer une valeur explicite plutôt que l'allocation automatique (AllocatedOutboundPorts = 0), réutiliser les connexions dans le
code, raccourcir le délai d'inactivité (30 minutes par défaut) si besoin, ou passer à une NAT Gateway. Derrière un Azure
Firewall, c'est le nombre d'IP publiques du pare-feu qui borne les connexions : prévoir plusieurs IP, ou une NAT Gateway sur
l'AzureFirewallSubnet.
5.2 Verrouiller la sortie#
Les dépendances d'AKS sont des FQDN sans IP fixes : un NSG ne suffit pas, il faut un pare-feu capable de filtrer par nom.
| FQDN (cloud public) | Port | Rôle |
|---|---|---|
*.hcp.<region>.azmk8s.io |
443 | Node ↔ API server (inutile sur un cluster privé) |
mcr.microsoft.com, *.data.mcr.microsoft.com, mcr-0001.mcr-msedge.net |
443 | Images système (CoreDNS…) |
management.azure.com |
443 | Opérations Kubernetes sur l'API Azure |
login.microsoftonline.com |
443 | Authentification Microsoft Entra |
packages.microsoft.com |
443 | Paquets |
acs-mirror.azureedge.net, packages.aks.azure.com |
443 | Binaires Kubernetes et Azure CNI |
| DNS | UDP et TCP 53 | Résolution |
- Sur Azure Firewall, la FQDN tag
AzureKubernetesServiceregroupe ces règles. Les applications horskube-systemqui parlent à l'API server ont besoin en plus d'une règle réseau TCP 443 vers l'IP de l'API server. - Les add-ons (Monitor, Defender, Key Vault CSI, Istio…) ont leurs propres FQDN : voir la page Outbound network and FQDN rules.
- Container Registry : activer les dedicated data endpoints (
<registry>.<region>.data.azurecr.io), sinon le téléchargement des couches passe par*.blob.core.windows.netet il faudrait autoriser tout le stockage Azure. - Le plus strict : le network isolated cluster, qui tire ses images système d'un Container Registry privé (cache de MAR) et démarre sans aucune sortie Internet.
6. Atteindre l'API server#
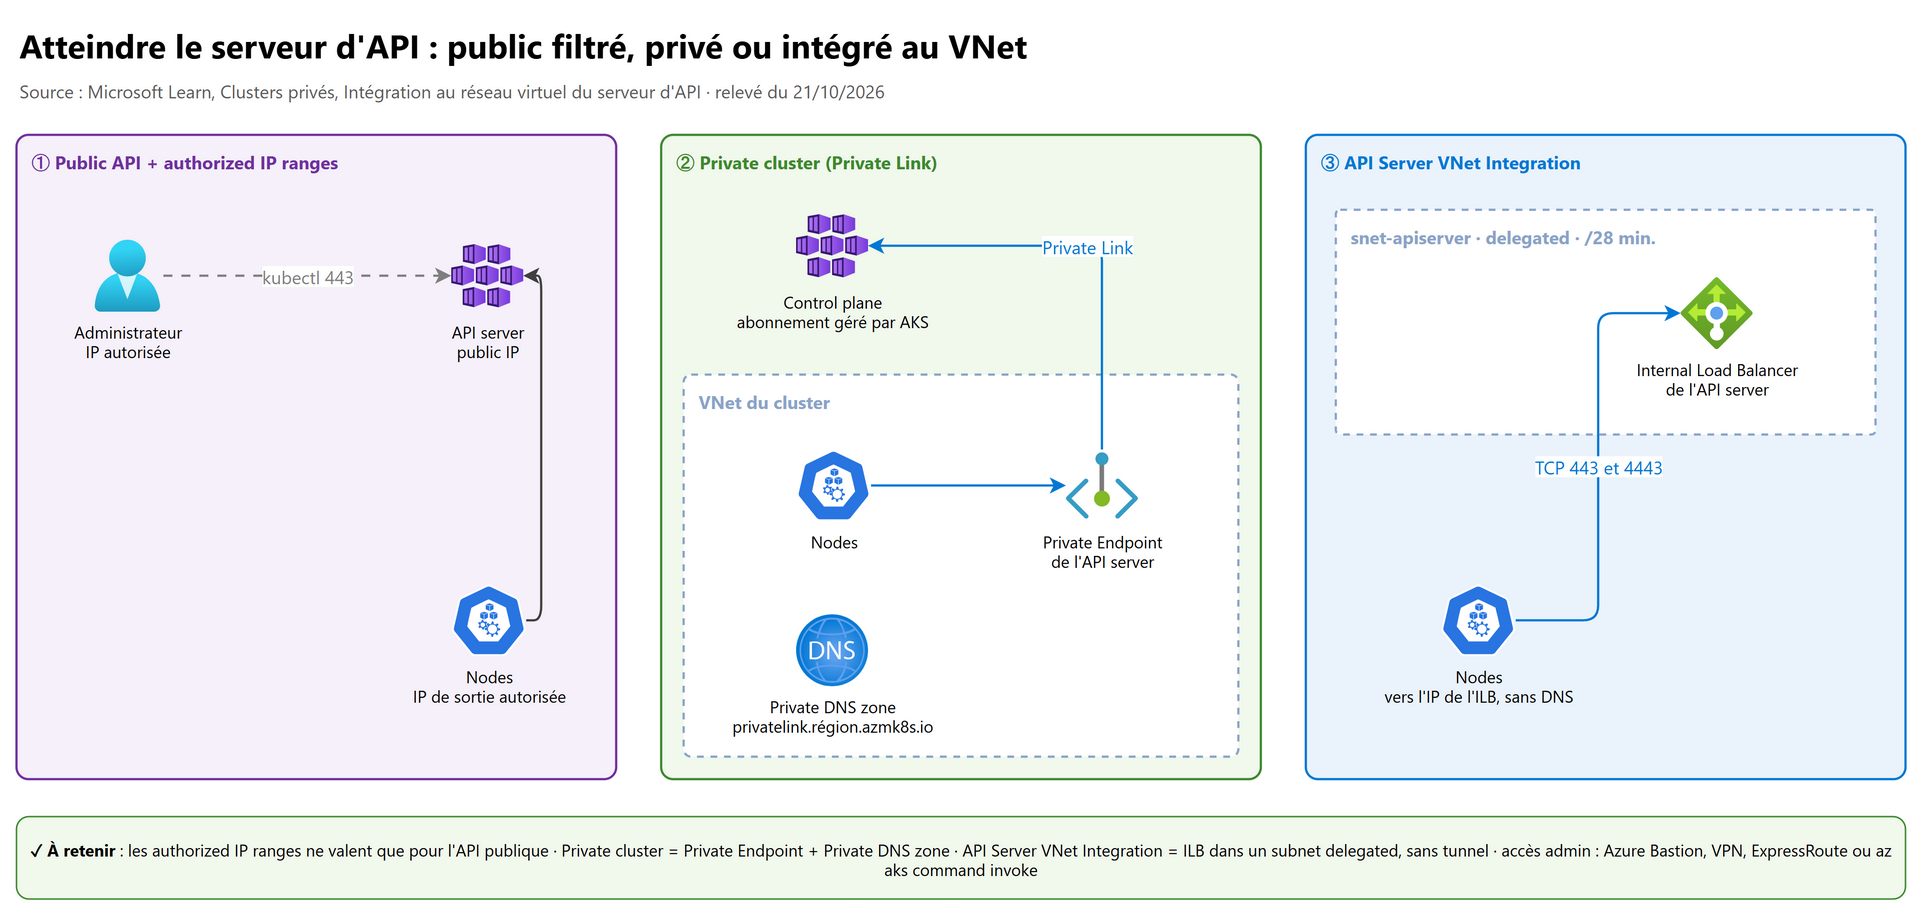
Le control plane (API server, etcd…) vit dans un abonnement géré par AKS. Trois façons de l'exposer :
| Public + authorized IP ranges | Private cluster | API Server VNet Integration | |
|---|---|---|---|
| Principe | IP publique filtrée par une liste de plages | Private Endpoint dans le subnet du premier node pool + Private DNS zone | Internal Load Balancer de l'API server dans un subnet délégué du VNet |
| Nodes → API | Par le chemin de sortie | Par le Private Endpoint (tunnel Konnectivity) | Directement vers l'IP de l'ILB, sans DNS ni tunnel |
| Exigences | Ajouter l'IP de sortie du cluster et les réseaux d'administration | Résolution DNS de la zone privée depuis les clients | Subnet délégué à Microsoft.ContainerService/managedClusters, /28 minimum, au moins 9 IP réservées |
| Particularités | AKS ajoute par défaut l'IP de l'API server et l'IP de sortie du LB ; 0.0.0.0/32 = seulement l'IP de sortie du cluster ; propagation jusqu'à 2 minutes |
Les authorized IP ranges ne s'appliquent pas au point privé ; pas d'agents Microsoft-hosted Azure DevOps ; supprimer le Private Endpoint arrête le cluster | Public ou privé, accès public activable après coup ; NSG : 443 et 4443 depuis le node subnet, 9988 depuis AzureLoadBalancer ; incompatible avec VNet encryption ; préconfiguré dans AKS Automatic |
Le DNS du private cluster (--private-dns-zone) :
| Valeur | Effet |
|---|---|
system (défaut) |
AKS crée la zone privatelink.<region>.azmk8s.io dans le node resource group et la lie au VNet du cluster |
none |
Pas de zone privée : résolution par le FQDN public (qui pointe vers l'IP privée) |
| ID d'une zone existante | Zone gérée par toi (souvent dans le hub) ; user-assigned managed identity avec Private DNS Zone Contributor et Network Contributor ; sous-zone possible (--fqdn-subdomain) |
- Par défaut, un private cluster garde un FQDN public (nom DNS seulement, pas d'accès public) ;
--disable-public-fqdnle supprime.nonecombiné à--disable-public-fqdnn'est pas pris en charge. - Hub-spoke avec DNS personnalisé : le DNS du hub doit transférer la zone vers
168.63.129.16(redirecteur conditionnel) ou passer par un Azure DNS Private Resolver dans un VNet lié à la zone. - Administrer un private cluster : jumpbox ou Azure Bastion dans un réseau connecté, VPN/ExpressRoute, Cloud Shell injecté
dans le VNet, ou
az aks command invoke(la commande passe par l'API Azure, sans accès réseau direct).
# Private cluster avec API Server VNet Integration, sans FQDN public
az aks create --resource-group rg-aks-prd --name aks-prd \
  --network-plugin azure --network-plugin-mode overlay --network-dataplane cilium \
  --vnet-subnet-id <id-snet-nodes> \
  --enable-apiserver-vnet-integration --apiserver-subnet-id <id-snet-apiserver> \
  --enable-private-cluster --disable-public-fqdn \
  --outbound-type userDefinedRouting \
  --assign-identity <id-identite-cluster>
7. Network policies#
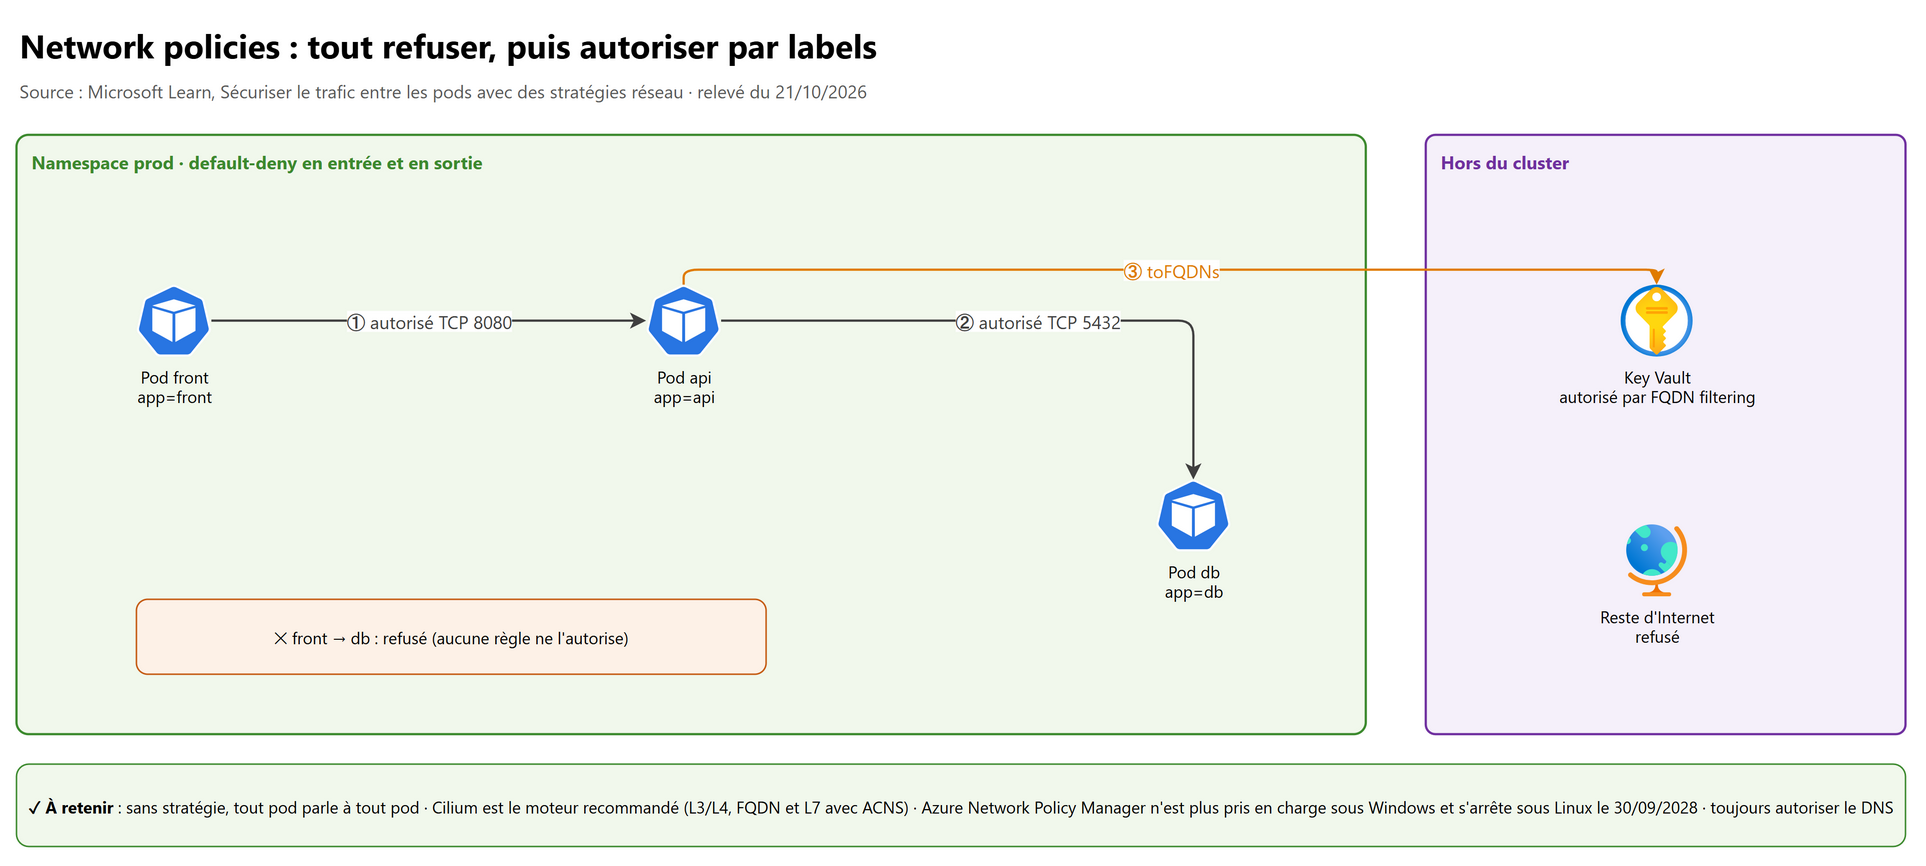
Par défaut, tout pod parle à tout pod. Une NetworkPolicy sélectionne des pods par labels et définit ce qu'ils acceptent
(ingress) et émettent (egress). Dès qu'un pod est sélectionné par une politique d'un type, tout ce qui n'est pas autorisé
pour ce type est refusé.
| Moteur | Plateformes | Particularités | Statut |
|---|---|---|---|
| Cilium | Linux | L3/L4, FQDN et L7 avec ACNS, eBPF, meilleure échelle | Recommandé |
| Calico (géré par AKS) | Linux, Windows | Seules les politiques networking.k8s.io sont prises en charge |
Choix pour Windows |
| Azure Network Policy Manager (NPM) | Linux | iptables, 250 nodes et 20 000 pods maximum, pas d'IPv6 | Plus pris en charge sous Windows depuis le 30/09/2026, fin sous Linux le 30/09/2028 ; non activable sur les nouveaux abonnements |
Le modèle à appliquer dans chaque namespace :
# 1. Tout refuser en entrée et en sortie
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata: { name: default-deny, namespace: prod }
spec:
  podSelector: {}
  policyTypes: [Ingress, Egress]
---
# 2. Autoriser le DNS (sinon plus rien ne fonctionne)
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata: { name: allow-dns, namespace: prod }
spec:
  podSelector: {}
  policyTypes: [Egress]
  egress:
    - to:
        - namespaceSelector: { matchLabels: { kubernetes.io/metadata.name: kube-system } }
          podSelector: { matchLabels: { k8s-app: kube-dns } }
      ports:
        - { protocol: UDP, port: 53 }
        - { protocol: TCP, port: 53 }
---
# 3. Autoriser front → api sur 8080
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata: { name: api-from-front, namespace: prod }
spec:
  podSelector: { matchLabels: { app: api } }
  policyTypes: [Ingress]
  ingress:
    - from:
        - podSelector: { matchLabels: { app: front } }
      ports:
        - { protocol: TCP, port: 8080 }
Avec Cilium et ACNS, filtrer la sortie par nom. La règle dns.matchPattern est obligatoire à côté de toFQDNs : sans
elle, Cilium laisse passer le DNS sans l'inspecter, n'apprend pas les IP du domaine et bloque la connexion. Un joker seul *
n'est pas accepté, écrire *.vault.azure.net :
apiVersion: cilium.io/v2
kind: CiliumNetworkPolicy
metadata: { name: api-to-keyvault, namespace: prod }
spec:
  endpointSelector: { matchLabels: { app: api } }
  egress:
    - toEndpoints:
        - matchLabels: { io.kubernetes.pod.namespace: kube-system, k8s-app: kube-dns }
      toPorts:
        - ports: [{ port: "53", protocol: ANY }]
          rules:
            dns: [{ matchPattern: "*.vault.azure.net" }]
    - toFQDNs:
        - matchPattern: "*.vault.azure.net"
      toPorts:
        - ports: [{ port: "443", protocol: TCP }]
Défense en profondeur : les Network policies segmentent dans le cluster ; l'Azure Firewall filtre la sortie du cluster ; les NSG protègent les subnets. Les trois se complètent.
8. Service mesh Istio#
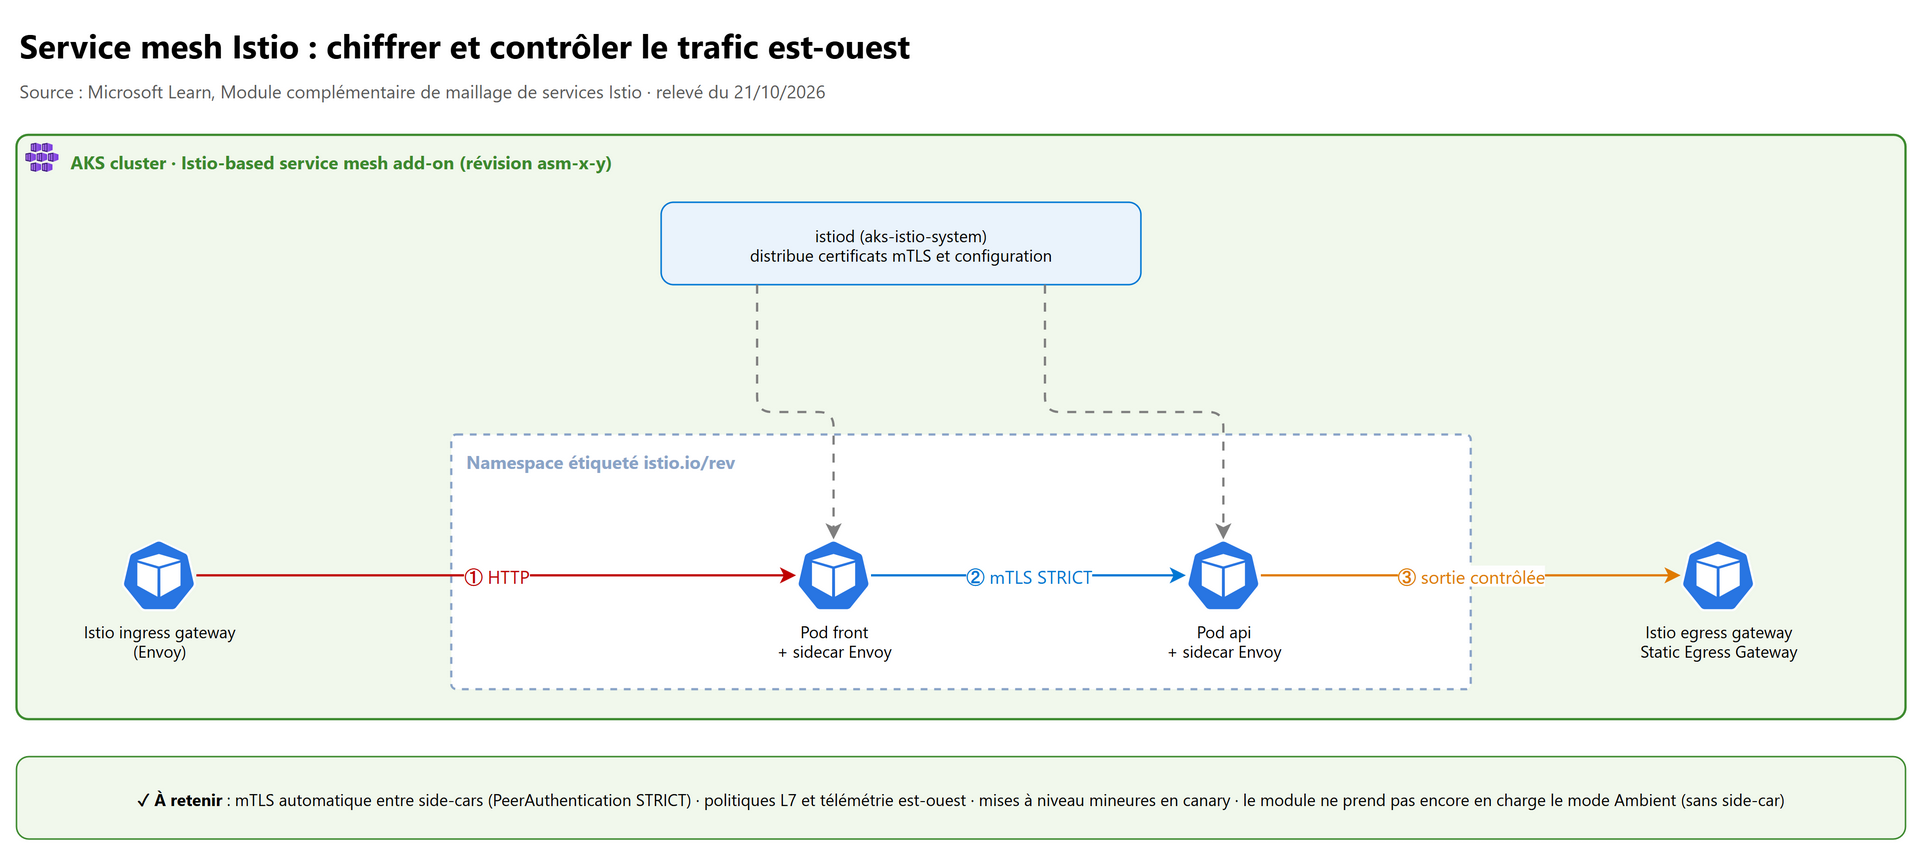
L'Istio-based service mesh add-on installe un control plane Istio managé (istiod dans aks-istio-system). Les pods des
namespaces étiquetés istio.io/rev: asm-x-y (et non istio-injection=enabled comme en open source) reçoivent un sidecar
Envoy.
- mTLS automatique entre sidecars ; une
PeerAuthenticationen modeSTRICTrefuse le trafic en clair. - Politiques L7, retries, disjoncteurs, télémétrie du trafic est-ouest (entre services).
- Ingress gateways internes ou externes, et egress gateways (qui s'appuient sur la Static Egress Gateway pour une plage d'IP source fixe, utile pour les règles de pare-feu).
- Limites : pas encore de mode Ambient (sans sidecar), pas de multicluster, pas de Windows, pas de mise à niveau automatique (les révisions mineures se font en canary ; une révision trop ancienne peut bloquer la mise à niveau automatique du cluster). Open Service Mesh est retiré le 30/09/2027 : migrer vers Istio.
Mesh ou pas ? Le mesh ajoute un proxy par pod (ressources, latence, exploitation). Pour du simple chiffrement entre nodes, WireGuard (ACNS) suffit ; pour de la segmentation, les Network policies. Le mesh se justifie avec des besoins mTLS par identité, de routage fin (canary par en-tête) ou d'observabilité L7 généralisée.
9. L'architecture de référence#
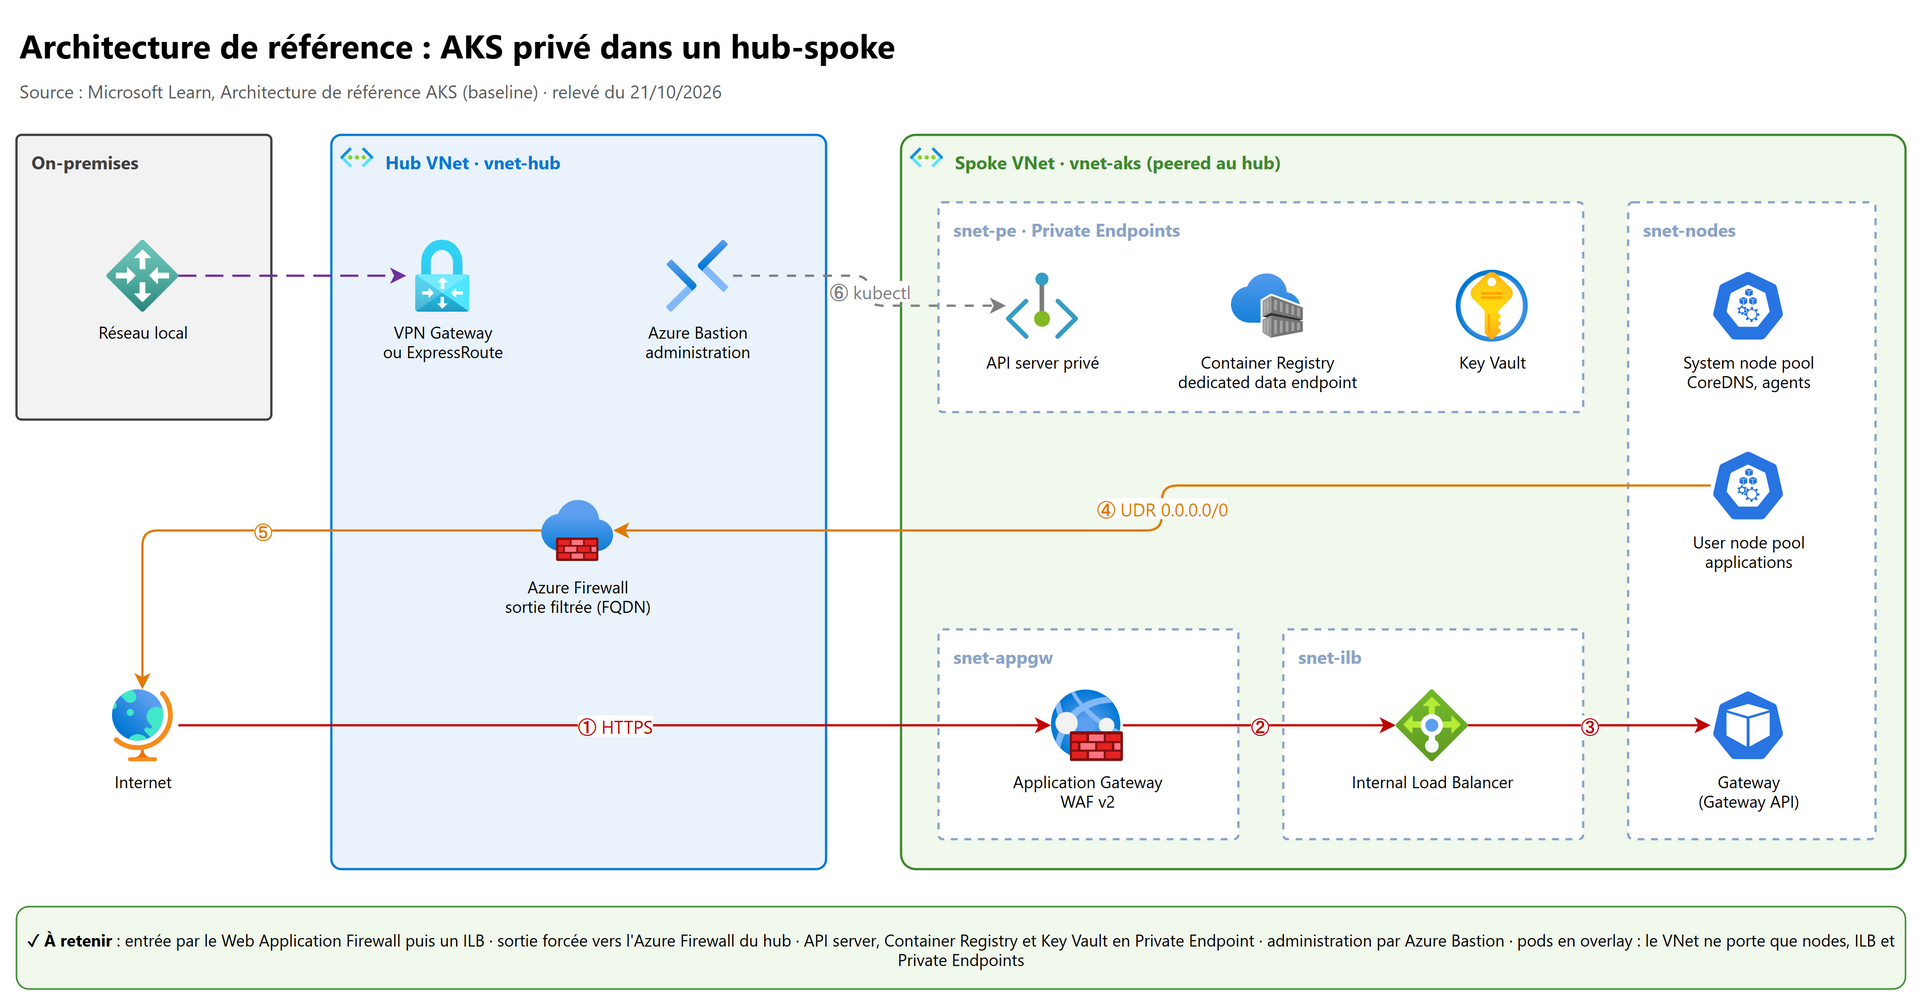
L'AKS baseline du Centre des architectures Azure :
- Hub : Azure Firewall (politiques globales de l'équipe centrale, via Firewall Manager), Azure Bastion (administration de l'API server privé), GatewaySubnet (VPN ou ExpressRoute), observabilité réseau.
- Spoke appairé : subnet de l'Application Gateway WAF v2 (entrée publique), subnet des IP d'ILB (l'Application Gateway envoie vers une IP privée d'ILB), subnet des nodes (pods en Azure CNI Overlay), subnet des Private Endpoints (Container Registry avec dedicated data endpoints, Key Vault, API server).
- Entrée : Internet → WAF → ILB → passerelle (Application routing add-on avec Gateway API, Istio managé comme contrôleur de passerelle sans fonctions de mesh) → pods.
- Sortie : UDR
0.0.0.0/0vers l'Azure Firewall du hub, FQDN autorisés au plus juste. - Est-ouest : Network policies.
- Administration : par Bastion vers l'API privée, jamais d'API publique ouverte.
- Mises à niveau : réserver des IP dans le node subnet pour les nodes temporaires ; en overlay, les pods n'en consomment pas.
10. Terraform : le bloc network_profile#
Arguments vérifiés dans le registre (hashicorp/azurerm 5.10.0, ressource azurerm_kubernetes_cluster) :
resource "azurerm_kubernetes_cluster" "aks" {
  name                                = local.aks_name
  location                            = var.location
  resource_group_name                 = var.resource_group_name
  dns_prefix                          = local.aks_name
  private_cluster_enabled             = true
  private_cluster_public_fqdn_enabled = false
  private_dns_zone_id                 = var.private_dns_zone_id # zone privatelink.<region>.azmk8s.io du hub

  default_node_pool {
    name           = "system"
    vm_size        = "Standard_D4ds_v5"
    node_count     = 3
    vnet_subnet_id = var.node_subnet_id
  }

  identity {
    type         = "UserAssigned"
    identity_ids = [var.cluster_identity_id] # Network Contributor sur les subnets, Private DNS Zone Contributor sur la zone
  }

  api_server_access_profile {
    virtual_network_integration_enabled = true
    subnet_id                           = var.apiserver_subnet_id # délégué, /28 minimum
  }

  network_profile {
    network_plugin      = "azure"
    network_plugin_mode = "overlay"
    network_data_plane  = "cilium"
    network_policy      = "cilium"
    pod_cidr            = "192.168.0.0/16"
    service_cidr        = "172.16.0.0/16"
    dns_service_ip      = "172.16.0.10"
    outbound_type       = "userDefinedRouting" # route table 0.0.0.0/0 → Azure Firewall déjà sur le subnet
    load_balancer_sku   = "standard"

    advanced_networking {
      observability_enabled = true
      security_enabled      = true # FQDN filtering et L7 : exige network_data_plane = cilium
    }
  }
}
Attention : dns_service_ip, service_cidr et private_cluster_enabled forcent la recréation du cluster s'ils changent.
11. Dépanner et pièges de production#
11.1 Les outils#
| Besoin | Outil |
|---|---|
| Vue d'ensemble, endpoints | kubectl get svc,endpointslices -A -o wide, kubectl describe svc api |
| Tester depuis un pod | kubectl run -it debug --image=<image de diagnostic> -- sh puis nslookup, curl |
| Événements d'un pod bloqué | kubectl describe pod (ex. FailedCreatePodSandBox) |
| Flux en direct (Cilium) | Hubble : hubble observe --namespace prod --port 53 --type l7 --follow ; Hubble UI |
| Métriques et flow logs | Container network observability (ACNS) vers Managed Prometheus, Managed Grafana, Log Analytics ; les logs exigent une CRD ContainerNetworkLog |
| Sans ACNS | Métriques de node de base avec Managed Prometheus ; Retina open source (captures de paquets distribuées) |
| Côté Azure | Network Watcher (IP flow verify, Next hop, Effective security rules sur les NIC des nodes), métriques SNAT du Load Balancer |
| Cluster privé sans réseau | az aks command invoke --command "kubectl get pods -A" |
11.2 Les pièges qui reviennent#
| Symptôme | Cause probable | Correction |
|---|---|---|
| Connexions sortantes qui échouent sous charge | Épuisement SNAT du Load Balancer | Ports explicites, plus d'IP de sortie, NAT Gateway, réutilisation des connexions |
Pods en ContainerCreating (waiting on Azure CNS) |
Pod Subnet dynamique saturé ou forte rotation | Agrandir le subnet, étaler les CronJobs, pool en static block, overlay |
| Une VM du local n'atteint pas un pod | Overlay : les pods ne sont pas routables | Exposer par Service ou passerelle, ou passer en Pod Subnet |
| Un hôte du réseau d'entreprise devient injoignable depuis les pods | Le pod CIDR chevauche un réseau connecté | Choisir un pod CIDR qui ne chevauche rien |
Tout casse après default-deny |
DNS non autorisé | Politique allow-dns en UDP et TCP 53 |
ipBlock 0.0.0.0/0 n'autorise pas les pods (Cilium) |
ipBlock ne sélectionne pas les IP de pods ni de nodes |
Ajouter namespaceSelector / podSelector |
Nodes NotReady après la pose d'un pare-feu |
FQDN obligatoires bloqués (MCR, management.azure.com, *.hcp…) |
FQDN tag AzureKubernetesService, DNS 53 UDP/TCP |
kubectl refusé après changement d'outboundType |
L'IP de sortie a changé, absente des authorized IP ranges | Ajouter la nouvelle plage |
| Private cluster injoignable depuis le hub | Zone privée non liée ou DNS personnalisé qui ne transfère pas | Lien de zone, redirecteur vers 168.63.129.16 ou DNS Private Resolver |
| Échec de création en BYO VNet | Identité du cluster sans Network Contributor sur le subnet | Attribuer le rôle avant la création |
| Règle de LB modifiée à la main qui disparaît | AKS réconcilie le Load Balancer | Toujours passer par az aks ou le manifeste du Service |
12. Lab#
À faire dans un abonnement de test (coût : un petit cluster quelques heures).
- Créer un cluster overlay + Cilium :
az group create --name rg-lab-aks --location francecentral az aks create --resource-group rg-lab-aks --name aks-lab --node-count 2 \ --network-plugin azure --network-plugin-mode overlay --pod-cidr 192.168.0.0/16 \ --network-dataplane cilium --generate-ssh-keys az aks get-credentials --resource-group rg-lab-aks --name aks-lab - Observer les trois plages :
kubectl get nodes -o wide(IP du VNet),kubectl get pods -A -o wide(IP en192.168.x.x),kubectl get svc -A(IP du Service CIDR). - Vérifier l'absence de
kube-proxy:kubectl get ds -n kube-system(Cilium présent, pas dekube-proxy). - Déployer un serveur et un client, puis appliquer la politique du MS Learn (namespace
demo,app=server,app=client) et constater leTIMEOUTpuis le succès après l'ajout du label. - Exposer le serveur en
LoadBalancerinterne (annotation du § 1.2) et retrouver la règle dans le Load Balancer interne du node resource group. - Afficher les ports SNAT :
az network lb outbound-rule list --resource-group <node-rg> --lb-name kubernetes -o table. - Supprimer :
az group delete --name rg-lab-aks --yes --no-wait.
13. Questions d'entretien#
1. Overlay ou plat, comment choisis-tu ?
Overlay par défaut : il économise l'espace du VNet (seuls les nodes en consomment), monte à 5 000 nodes et 250 pods par node, et se configure sans UDR. Je passe au Pod Subnet seulement si un réseau connecté doit joindre les pods par leur IP (ou voir l'IP du pod comme source), avec l'allocation dynamique pour l'efficacité ou par blocs statiques pour l'échelle et les fortes rotations.
2. Que se passe-t-il quand un pod en overlay appelle une base SQL dans un VNet appairé ?
Le paquet quitte le pod CIDR : Azure CNI le SNAT vers l'IP du node. La base voit l'IP du node, donc les règles de pare-feu se font sur le node subnet. La base ne peut pas initier vers le pod.
3. Comment se fait la traduction d'un ClusterIP vers un pod ?
Sur le node source : kube-proxy programme des règles (iptables) ou, avec Cilium, des programmes eBPF remplacent kube-proxy. Le ClusterIP n'est porté par aucune interface ; c'est un DNAT local vers un pod prêt, éventuellement sur un autre node.
4. Ingress ou Gateway API, et pourquoi c'est d'actualité ?
Ingress NGINX est retiré (maintenance arrêtée en mars 2026, correctifs Microsoft pour l'add-on jusqu'en novembre 2026). Gateway API est le successeur : orientée rôles (plateforme : GatewayClass/Gateway ; applications : HTTPRoute), portable, sans annotations propriétaires. Sur AKS : Application routing add-on en Gateway API, ou Application Gateway for Containers.
5. AGC ou passerelle dans le cluster ?
AGC si je veux le plan de données hors du cluster, géré par Azure, avec WAF, mTLS vers les pods et fractionnement de trafic, et une équipe plateforme qui fournit l'entrée. Passerelle dans le cluster (Envoy managé) pour une entrée standard sans dépendre d'un service Azure supplémentaire, ou si j'ai besoin d'un frontend privé (pas encore disponible sur AGC).
6. Comment verrouilles-tu la sortie d'un cluster de production ?
outboundType userDefinedRoutingavec une route0.0.0.0/0vers l'Azure Firewall du hub, FQDN tagAzureKubernetesServiceplus les FQDN des add-ons et des applications, DNS en UDP et TCP 53, Container Registry et Key Vault en Private Endpoint avec dedicated data endpoints. Encore plus strict : network isolated cluster. Dans le cluster : default-deny et FQDN filtering Cilium.
7. Qu'est-ce que l'épuisement SNAT et comment l'éviter ?
Avec le Load Balancer, 64 000 ports par IP sont partagés entre nodes (1 024 par node jusqu'à 50 nodes). Beaucoup de connexions vers la même destination les épuisent. Je fixe les ports par node, j'ajoute des IP de sortie selon la formule, je passe à une NAT Gateway, et je fais réutiliser les connexions par les applications.
8. Private cluster ou API Server VNet Integration ?
Les deux gardent le trafic nodes ↔ API privé. Le private cluster passe par un Private Endpoint et une Private DNS zone, avec la complexité DNS du hub-spoke. L'intégration VNet place l'ILB de l'API dans un subnet délégué /28 : les nodes parlent à l'IP directement, sans DNS ni tunnel, et l'accès public peut être coupé ou rétabli après coup. Attention : incompatible avec la VNet encryption.
9. Un développeur n'arrive pas à joindre un private cluster depuis son poste. Que vérifies-tu ?
La connectivité réseau (VPN, Bastion, peering), puis la résolution DNS : zone
privatelink.<region>.azmk8s.ioliée au bon VNet, ou redirecteur conditionnel vers 168.63.129.16 / DNS Private Resolver. En secours :az aks command invoke. Les authorized IP ranges ne servent à rien ici, elles ne valent que pour l'API publique.
10. Pourquoi une politique default-deny casse-t-elle tout ?
Parce qu'elle bloque aussi le DNS. On ajoute toujours une règle de sortie vers CoreDNS (et LocalDNS
169.254.10.0/24si activé) en UDP et TCP 53, puis les flux métier un par un.
11. Quand mettre un service mesh ?
Quand il faut du mTLS par identité de service, du routage L7 fin ou une observabilité est-ouest généralisée. Sinon, Network policies pour la segmentation et WireGuard pour le chiffrement suffisent, sans un proxy par pod. Sur AKS, l'add-on Istio se met à niveau en canary et n'a pas encore de mode Ambient.
12. Quelles plages d'adresses prévois-tu pour un nouveau cluster ?
Un node subnet dimensionné pour le maximum de nodes plus le surplus des mises à niveau ; un pod CIDR overlay qui ne chevauche aucun réseau connecté (un /16 = 256 nodes) ; un Service CIDR plus petit que /12, lui aussi isolé, avec l'IP DNS dedans (pas la première) ; un /28 délégué pour l'API ; un /24 pour AGC ; un subnet de Private Endpoints. Et j'évite 169.254/16, 172.30/16, 172.31/16 et 192.0.2/24.
14. Fiche à retenir#
- Trois plages : nodes (VNet), pods (pod CIDR ou pod subnet), Services (virtuelles). Aucune ne chevauche un réseau connecté.
- Azure CNI Overlay par défaut :
/24par node, 250 pods par node, 5 000 nodes, SNAT vers l'IP du node, pods non routables de l'extérieur. - Pod Subnet si l'IP des pods doit être joignable : dynamique (lots de 16) ou static block (
/28,max_pods = 16N − 1). - kubenet retiré le 31/03/2028 ; Azure NPM fini sous Windows, retiré sous Linux le 30/09/2028.
- Cilium : eBPF, pas de kube-proxy, Linux seulement ; ACNS pour FQDN, L7, observabilité, WireGuard.
- Service
LoadBalancerinterne par annotation ;loadBalancerSourceRangespour filtrer les sources. - Gateway API remplace Ingress ; Ingress NGINX : correctifs Microsoft jusqu'en novembre 2026.
- AGC : hébergé par Azure, subnet délégué
/24, frontend = FQDN, WAF, mTLS, vers les IP des pods. -
outboundType:loadBalancer, NAT Gateway (managed / user-assigned),userDefinedRouting,none/block(isolé). - SNAT : 64 000 ports par IP, 1 024 par node jusqu'à 50 nodes.
- Sortie verrouillée : FQDN tag
AzureKubernetesService, DNS UDP et TCP 53, dedicated data endpoints pour Container Registry. - API : authorized IP ranges (public seulement), Private cluster (Private Endpoint + Private DNS zone), API Server VNet Integration (
/28délégué, ILB). -
default-deny+allow-dnsdans chaque namespace. - Istio add-on :
istio.io/rev, mTLS STRICT, canary, pas d'Ambient.
Références#
Toutes lues le 21/10/2026 :
- Concepts de mise en réseau pour les applications dans AKS
- Vue d'ensemble de la mise en réseau CNI dans AKS
- Azure CNI Overlay
- Azure CNI Pod Subnet
- Planifier la mise en réseau des pods
- Azure CNI powered by Cilium
- Advanced Container Networking Services
- Diagnostiquer les problèmes réseau avec ACNS
- Services Kubernetes dans AKS
- Utiliser un équilibreur de charge interne
- Configurer un Standard Load Balancer public (ports SNAT)
- Entrée dans AKS
- Application routing add-on avec la Gateway API
- Migrer de l'Ingress NGINX vers la Gateway API
- Qu'est-ce qu'Application Gateway for Containers ?
- Composants d'Application Gateway for Containers
- Migrer d'AGIC vers Application Gateway for Containers
- Personnaliser la sortie avec les types sortants
- Règles réseau et FQDN sortants pour AKS
- Limiter le trafic avec Azure Firewall
- Créer un cluster AKS privé
- API Server VNet Integration
- Authorized IP ranges de l'API server
- Sécuriser le trafic entre les pods avec des stratégies réseau
- Istio-based service mesh add-on
- Istio ingress avec la Gateway API
- Istio egress gateways
- Architecture de référence AKS (baseline)
- Terraform azurerm_kubernetes_cluster
- Kubernetes : Services, DNS et Network Policies