

Version : 1.1 · Date : 2026-10-21 · Domaine 2 de l'examen : Implement generative AI and agentic solutions (30 à 35 %)
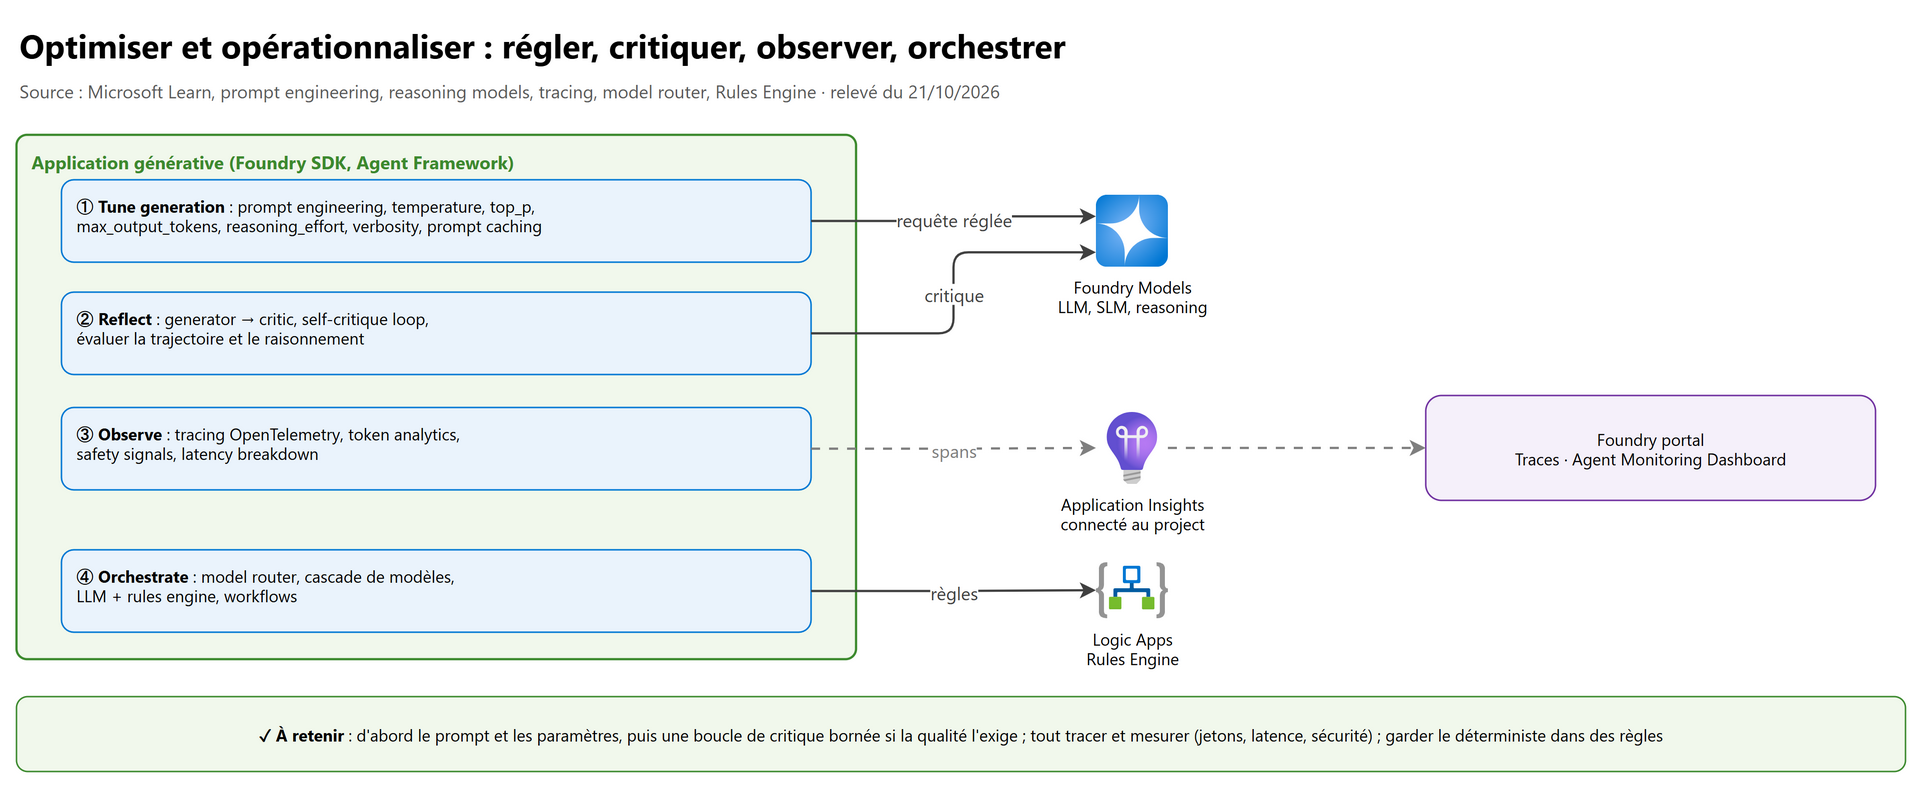
En une phrase : une application générative se règle (prompt et paramètres), se fiabilise (boucles de critique bornées), s'observe (traces, jetons, signaux de sécurité, latence décomposée) et s'orchestre (model router, cascade, règles métier déterministes) ; ce chapitre donne les leviers et la façon de prouver qu'ils marchent.
Ce que l'examen demande#
Bloc Optimize and operationalize generative AI systems, repris mot pour mot du guide d'étude AI-103 (compétences mesurées au 16 avril 2026) :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| 1 | Tune generation behavior, such as prompt engineering and adjusting model parameters | 2 |
| 2 | Implement model reflection, chain-of-thought evaluations, and self-critique loops | 3 |
| 3 | Set up observability by implementing tracing, token analytics, safety signals, and latency breakdowns | 4 |
| 4 | Orchestrate multiple models, flows, or hybrid LLM and rules engines | 5 |
Ce chapitre s'appuie sur les précédents sans les répéter : le choix du modèle et le model router sont présentés au chapitre 01, les quotas, les metrics Azure Monitor et la mise en place du tracing au chapitre 03, les evaluators et la sécurité du contenu au chapitre 04, la Responses API, les structured outputs et le function calling au chapitre 05, les orchestrations multi-agents au chapitre 06.
1. Les bases à maîtriser#
1.1 Les quatre leviers du chapitre#
| Levier | Question à laquelle il répond | Outils typiques |
|---|---|---|
| Tune | Comment obtenir la bonne réponse, au bon format, au meilleur coût ? | System message, few-shot, délimiteurs, temperature, top_p, max_output_tokens, reasoning_effort, verbosity, prompt caching |
| Reflect | Comment rattraper une réponse insuffisante avant de la rendre ? | Boucle generator-critic, judge, evaluators de trajectoire, reasoning summary |
| Observe | Que s'est-il passé, combien cela a coûté, où est le temps perdu ? | Tracing OpenTelemetry, Application Insights, Agent Monitoring Dashboard, metrics Azure Monitor |
| Orchestrate | Quel modèle, quel flux, quelle règle pour chaque requête ? | Model router, cascade, Logic Apps Rules Engine, workflows Microsoft Agent Framework |
1.2 Reasoning ou non-reasoning : la question qui change tout#
Presque toutes les questions de ce bloc dépendent du type de modèle :
| Non-reasoning model (gpt-4.1, gpt-4o…) | Reasoning model (GPT-5 series, o-series) | |
|---|---|---|
| Comment il travaille | Prédit directement la réponse | Produit d'abord des reasoning tokens invisibles, facturés comme des jetons de sortie |
| Réglages | temperature, top_p, pénalités, max_tokens / max_output_tokens |
reasoning_effort, verbosity (GPT-5), max_output_tokens ou max_completion_tokens |
| Prompt engineering | Few-shot, chain of thought demandée, décomposition : utiles | Ces techniques ne sont pas recommandées : donner un objectif, des contraintes et un contrat de sortie |
| Voir le raisonnement | Lui demander d'écrire ses étapes | Seulement par le paramètre reasoning summary (Responses API) |
Règle d'or Microsoft : tenter d'extraire le raisonnement brut d'un reasoning model par un autre moyen que le reasoning summary n'est pas pris en charge, peut violer l'Acceptable Use Policy et entraîner une limitation ou une suspension.
2. Régler le comportement de génération#
2.1 Le system message#
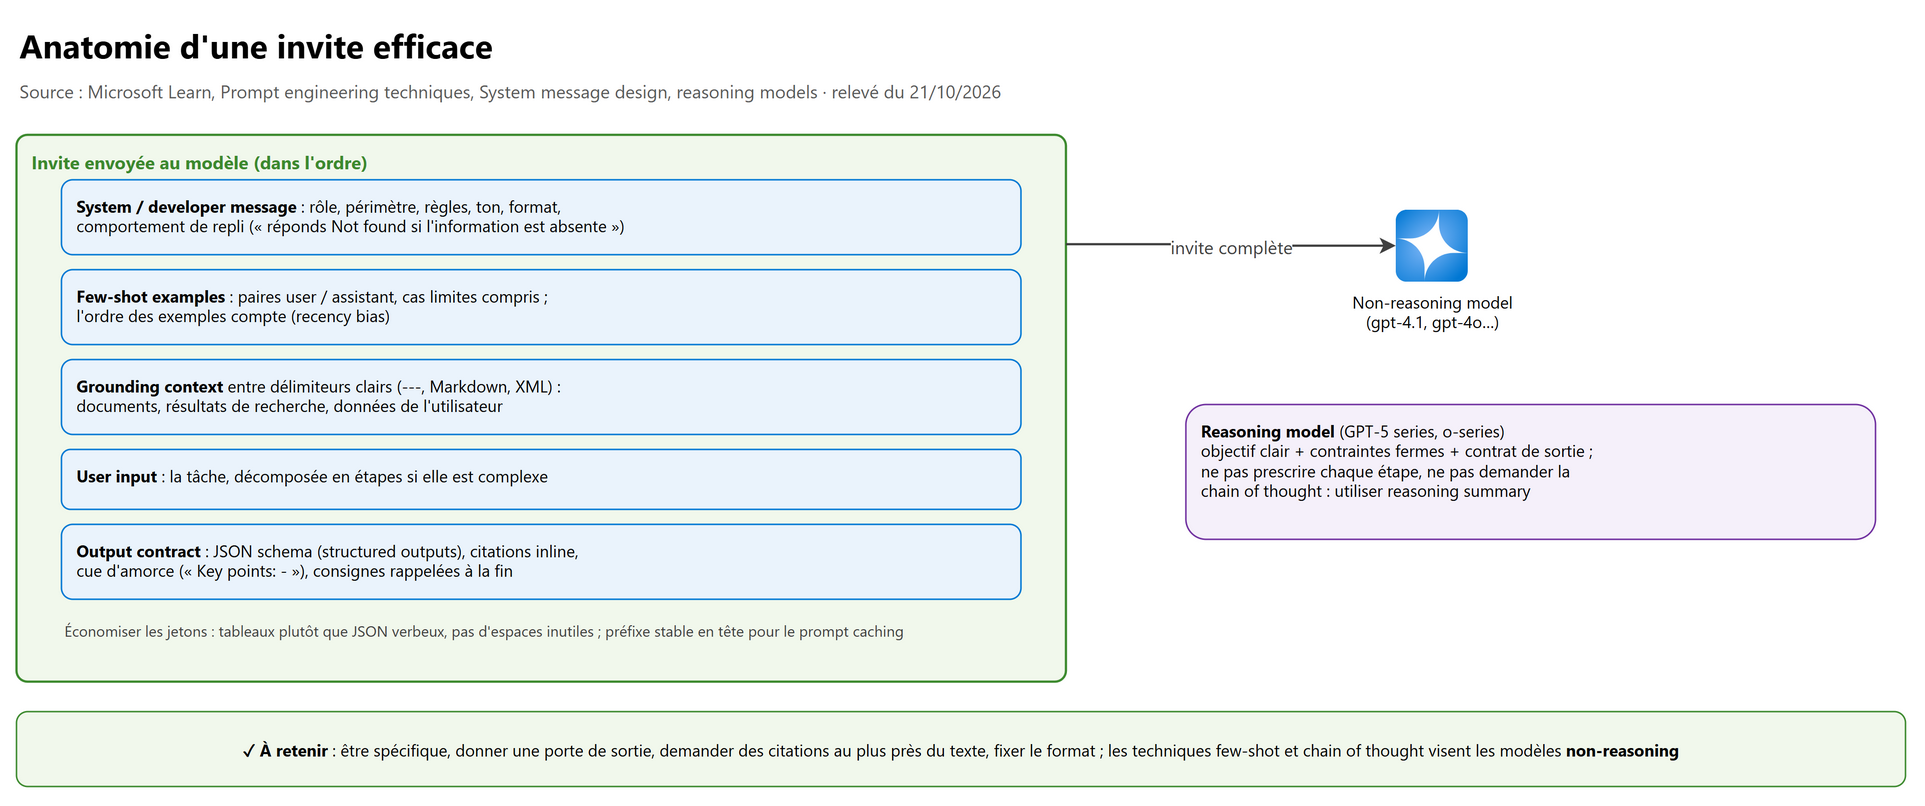
Le system message (ou system prompt, metaprompt ; developer est équivalent avec les modèles récents : ne pas envoyer les
deux dans la même requête) fixe le rôle, les limites, le ton, le format et les contraintes de sécurité. Il est le plus efficace
quand les consignes sont non ambiguës, sans contradiction, et que le comportement de repli est explicite (que faire
quand l'information manque ou que la demande sort du périmètre). Il influence le modèle mais ne garantit pas l'obéissance :
on le combine avec les content filters et l'évaluation (chapitre 04).
2.2 Les techniques de prompt engineering#
D'après la page Prompt engineering techniques de Microsoft (qui précise d'emblée qu'elles ne sont pas recommandées pour les reasoning models) :
| Technique | Principe | Exemple |
|---|---|---|
| Instructions claires d'abord | Annoncer la tâche avant le contexte et les exemples | « Ta tâche : vérifier si l'affirmation X est appuyée par les extraits suivants… » |
| Few-shot (zero-, one-, few-shot) | Des paires entrée / sortie conditionnent la réponse pour cette requête seulement (aucun apprentissage durable) | Exemples user / assistant après le system message |
| Ordre et recency bias | La fin de l'invite pèse plus : l'ordre des exemples compte, on peut répéter les consignes à la fin | Rappel du format en dernière ligne |
| Amorcer la sortie (cue, priming) | Quelques mots en fin d'invite orientent la forme | Key points:\n- |
| Syntaxe claire | Délimiteurs (---), titres en majuscules, Markdown ou XML ; un délimiteur peut servir de stop sequence |
---PARAGRAPH … ---QUERIES |
| Décomposer la tâche | Étape 1 extraire les faits, étape 2 générer les requêtes de vérification | Plus fiable qu'une seule consigne complexe |
| Affordances | Faire appeler un outil (recherche) plutôt que de compter sur la mémoire du modèle | Résultats de recherche réinjectés dans l'invite |
| Chain of thought (non-reasoning uniquement) | Demander de procéder pas à pas et de montrer les étapes avant la réponse | « Procède étape par étape, puis : ANSWER is: … » |
| Spécifier la structure de sortie | Demander des citations inline (plus efficaces qu'en fin de texte) ou une structure (entité, relation, entité) | BEHAVIOR("raison"), JSON |
| Grounding context | Fournir les données de référence : plus la source est proche de la réponse attendue, moins d'erreurs | Extraits entre balises <sources> |
| Donner une porte de sortie | Autoriser « Not found » si l'information est absente | Réduit les fabrications |
| Économiser l'espace | Tableaux plutôt que JSON répétitif, pas d'espaces superflus | Un mois en toutes lettres coûte parfois moins de jetons qu'une date numérique |
Exemple Python : invite structurée, ancrée, avec porte de sortie, sur un modèle non-reasoning.
import os
from azure.ai.projects import AIProjectClient
from azure.identity import DefaultAzureCredential

project = AIProjectClient(endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"], credential=DefaultAzureCredential())
openai = project.get_openai_client()             # client compatible OpenAI, authentifié par Entra ID (aucune clé)

INSTRUCTIONS = """Tu es l'assistant RH de Contoso.
- Réponds uniquement à partir des extraits placés entre <sources> et </sources>.
- Cite la source après chaque affirmation, au format [n].
- Si la réponse n'y figure pas, réponds exactement : Not found."""

response = openai.responses.create(
    model="gpt-4.1-mini",                        # nom du deployment (non-reasoning)
    instructions=INSTRUCTIONS,                   # system / developer message
    input=[
        # few-shot : une paire exemple montre le format attendu
        {"role": "user", "content": "<sources>[1] Le télétravail est limité à 2 jours par semaine.</sources>\nCombien de jours de télétravail ?"},
        {"role": "assistant", "content": "Deux jours par semaine au maximum [1]."},
        {"role": "user", "content": "<sources>[1] Les congés se posent 15 jours à l'avance.</sources>\nQuel délai pour poser un congé ?"},
    ],
    temperature=0.2,                             # réponse factuelle : peu de variation
    max_output_tokens=200,                       # borne la sortie : coût et latence
)
print(response.output_text)
2.3 Les paramètres d'échantillonnage#
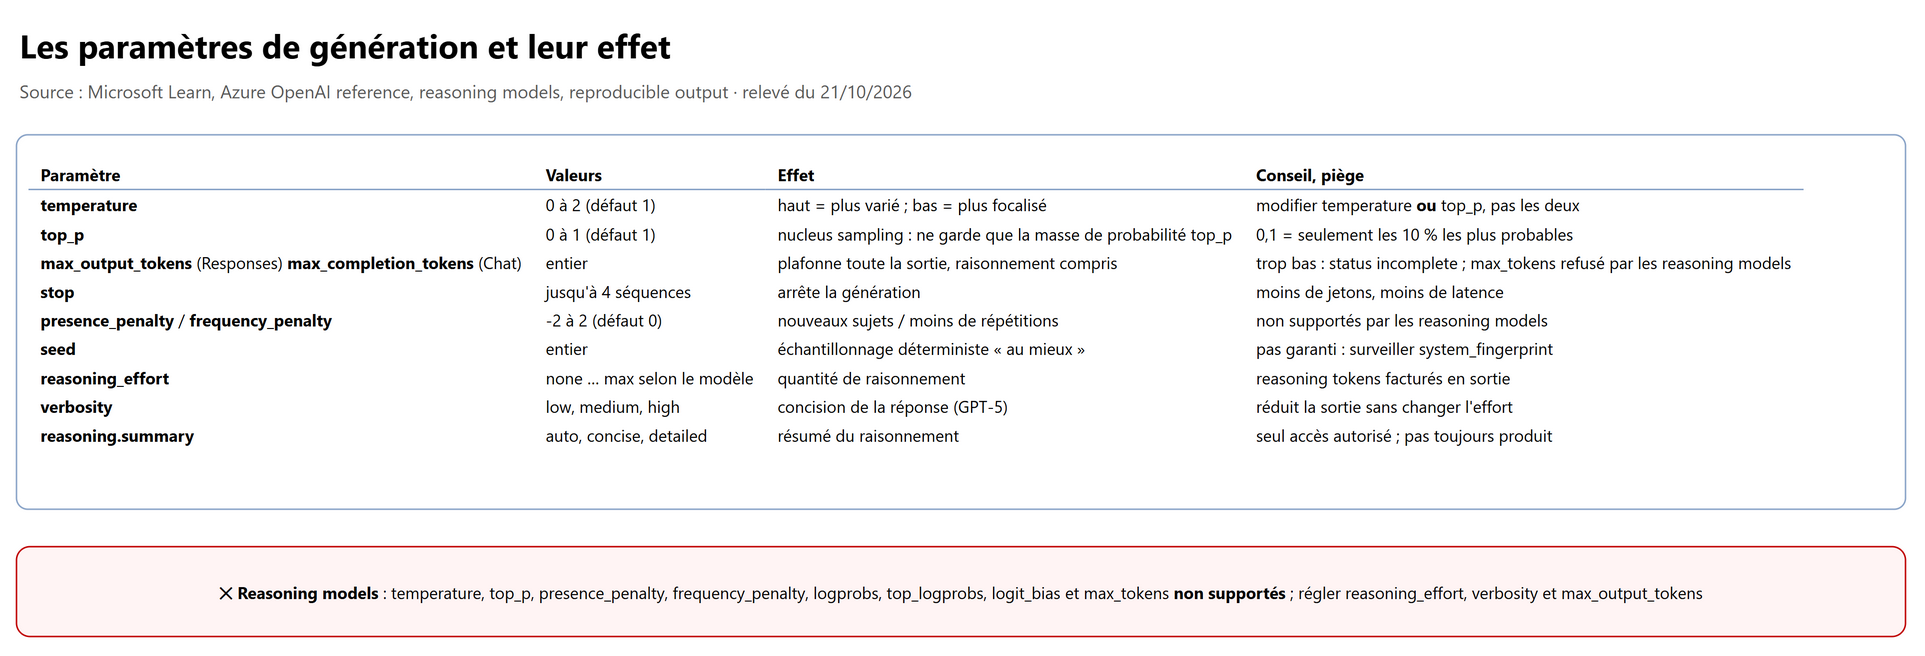
| Paramètre | Valeurs | Effet | À retenir |
|---|---|---|---|
temperature |
0 à 2, défaut 1 | Élevée (ex. 0,7) : plus aléatoire, plus divers ; basse (ex. 0,2) : plus focalisé | Créatif = plus haut ; document juridique = beaucoup plus bas |
top_p |
0 à 1, défaut 1 | Nucleus sampling : seuls les jetons dans la masse de probabilité top_p sont considérés (0,1 = les 10 % les plus probables) |
Microsoft recommande de modifier temperature ou top_p, pas les deux |
max_output_tokens (Responses) / max_completion_tokens (Chat Completions) |
Entier | Plafonne la génération ; pour un reasoning model, le plafond couvre raisonnement + réponse visible | max_tokens ne fonctionne pas avec les reasoning models ; ne change que la longueur, pas la qualité |
stop |
Jusqu'à 4 séquences | Arrête la génération quand la séquence apparaît (non incluse dans le texte) | Évite du contenu superflu, donc jetons et latence |
presence_penalty |
-2 à 2, défaut 0 | Positif : pénalise les jetons déjà apparus, pousse vers de nouveaux sujets | Non supporté par les reasoning models |
frequency_penalty |
-2 à 2, défaut 0 | Positif : pénalise selon la fréquence d'apparition, réduit les répétitions | Non supporté par les reasoning models |
seed (Chat Completions) |
Entier | Échantillonnage déterministe « au mieux » si tous les autres paramètres sont identiques | Déterminisme non garanti : surveiller system_fingerprint (configuration du back-end) ; un max_tokens élevé réduit la reproductibilité |
n |
Entier | Plusieurs réponses par requête | Augmente la latence : laisser à 1 |
stream |
Booléen | Renvoie les jetons dès qu'ils sont prêts | Réduit le temps jusqu'au premier jeton perçu, pas le temps total |
Attention à l'API : stop, les pénalités, seed et n sont des paramètres de Chat Completions. La référence de la
Responses API ne les documente pas, et le guide de migration de Microsoft dit explicitement de retirer seed en passant à
Responses (où l'on garde temperature, top_p, max_output_tokens, truncation, text.format, reasoning). Toujours vérifier
le modèle : un reasoning model refuse temperature, top_p et les pénalités.
2.4 Régler un reasoning model#
| Réglage | Valeurs | Effet |
|---|---|---|
reasoning_effort (Chat) / reasoning={"effort": …} (Responses) |
none, minimal, low, medium, high, xhigh, max selon le modèle (défaut variable) |
Plus d'effort = plus de reasoning tokens, plus de latence et de coût |
text={"verbosity": …} |
low, medium, high (modèles GPT-5) |
Concision de la réponse visible, indépendamment de l'effort |
reasoning={"summary": …} |
auto, concise, detailed (concise non supporté par la série GPT-5) |
Résumé du raisonnement ; pas garanti à chaque requête ; non supporté avec la multi-agent orchestration |
reasoning={"mode": "pro"} |
gpt-5.6 |
Mode qui fait plus de travail pour les tâches difficiles : plus de jetons, plus de coût |
reasoning={"context": …} |
current_turn, all_turns |
Réutiliser (ou non) le raisonnement des tours précédents ; all_turns augmente les jetons facturés |
max_output_tokens |
Entier | Si le plafond est atteint, la réponse revient status: incomplete (reason: max_output_tokens), parfois sans texte visible alors que le raisonnement est facturé |
Paramètres non supportés par les reasoning models (sauf exception documentée par modèle) : temperature, top_p,
presence_penalty, frequency_penalty, logprobs, top_logprobs, logit_bias, max_tokens.
Conseils officiels :
- Donner un objectif clair, des contraintes fermes et un contrat de sortie explicite, sans prescrire chaque étape.
- Traiter
reasoning_effortcomme un réglage fin, pas comme le premier réflexe quand la qualité baisse. - Pour les tâches agentiques, définir ce qui compte comme « terminé » et comment le modèle doit vérifier son propre travail.
- En exploration, réserver au moins 25 000 jetons pour le raisonnement et la sortie, puis ajuster ; vérifier
statusà chaque réponse. - Avec des appels de fonctions, renvoyer les reasoning items de la réponse précédente (le plus simple :
previous_response_id).
response = openai.responses.create(
    model="gpt-5",                                # deployment d'un reasoning model
    input="Analyse ce plan de migration et liste les modes de défaillance possibles : …",
    reasoning={"effort": "medium", "summary": "auto"},   # effort modéré + résumé du raisonnement
    text={"verbosity": "low"},                    # réponse visible concise
    max_output_tokens=25000,                      # place pour raisonnement + réponse
)
if response.status == "incomplete":               # plafond atteint : ne pas traiter comme une réponse vide
    print("Incomplet :", response.incomplete_details.reason)
print(response.output_text)
print(response.usage.output_tokens_details.reasoning_tokens)   # jetons de raisonnement facturés
2.5 Prompt caching#
Le prompt caching réutilise le calcul du début identique des invites longues : moins de latence et des jetons d'entrée facturés avec remise (jusqu'à 100 % de remise en Provisioned).
| Règle | Détail |
|---|---|
| Conditions | Invite d'au moins 1 024 jetons, dont les 1 024 premiers identiques ; un seul caractère différent = cache miss |
| Activation | Par défaut sur les modèles supportés, sans configuration |
| Mesure | cached_tokens (dans prompt_tokens_details en Chat Completions, input_tokens_details en Responses) |
| Ce qui est mis en cache | Messages (system, developer, user, assistant), images (même paramètre detail), définitions d'outils, schéma de sortie structurée |
| Durée en mémoire | Effacé en général après 5 à 10 minutes d'inactivité, toujours dans l'heure ; jamais partagé entre abonnements |
| Rétention étendue | Jusqu'à 24 heures sur les modèles qui la proposent |
| Modèles récents (GPT-5.6 et suivants) | Écritures en cache parfois facturées (cache_write_tokens), prompt_cache_key pour améliorer les correspondances, breakpoints explicites |
Conséquence de conception : mettre le contenu stable (system message, exemples, définitions d'outils, documents de référence) au début, et le contenu variable (question de l'utilisateur) à la fin.
2.6 Prompt engineering, RAG ou fine-tuning ?#
L'ordre recommandé reste prompt engineering → RAG → fine-tuning (détaillé au chapitre 01, section 1.2) : le RAG apporte des connaissances, le fine-tuning un comportement constant (format, ton, usage d'outils) et permet de raccourcir les invites.
flowchart TD
    A["La réponse ne convient pas"] --> B{"Manque de connaissances ?"}
    B -- Oui --> R["RAG : grounding, Foundry IQ, Azure AI Search"]
    B -- Non --> C{"Format, ton ou consignes non suivis ?"}
    C -- Oui --> P["Prompt engineering : system message, exemples, structured outputs"]
    P --> D{"Toujours insuffisant ou invite trop longue ?"}
    D -- Oui --> F["Fine-tuning : SFT puis DPO ou RFT"]
    D -- Non --> OK["Garder le prompt"]
    C -- Non --> E{"Erreurs de raisonnement ?"}
    E -- Oui --> G["Reasoning model, effort plus élevé, ou boucle de critique"]
    E -- Non --> H["Comparer d'autres modèles sur ses données"]
3. Réflexion, évaluation de la chaîne de pensée et boucles d'autocritique#
3.1 Ce que « chain of thought » veut dire selon le modèle#
| Non-reasoning model | Reasoning model | |
|---|---|---|
| Faire raisonner | Demander « procède étape par étape » (chain of thought prompting) | Le modèle raisonne de lui-même (reasoning tokens) |
| Voir le raisonnement | Les étapes sont dans la réponse | reasoning.summary uniquement |
| Évaluer le raisonnement | Lire et noter les étapes écrites | Évaluer la trajectoire (appels d'outils, étapes) et le résultat, pas le raisonnement brut |
Avec un modèle non-OpenAI qui renvoie un champ reasoning_content, Microsoft conseille de ne pas le remettre dans l'historique
d'une conversation (sauf exigence du modèle) et de le traiter comme une sortie du modèle, pas comme une explication vérifiée.
3.2 La boucle generator-critic#
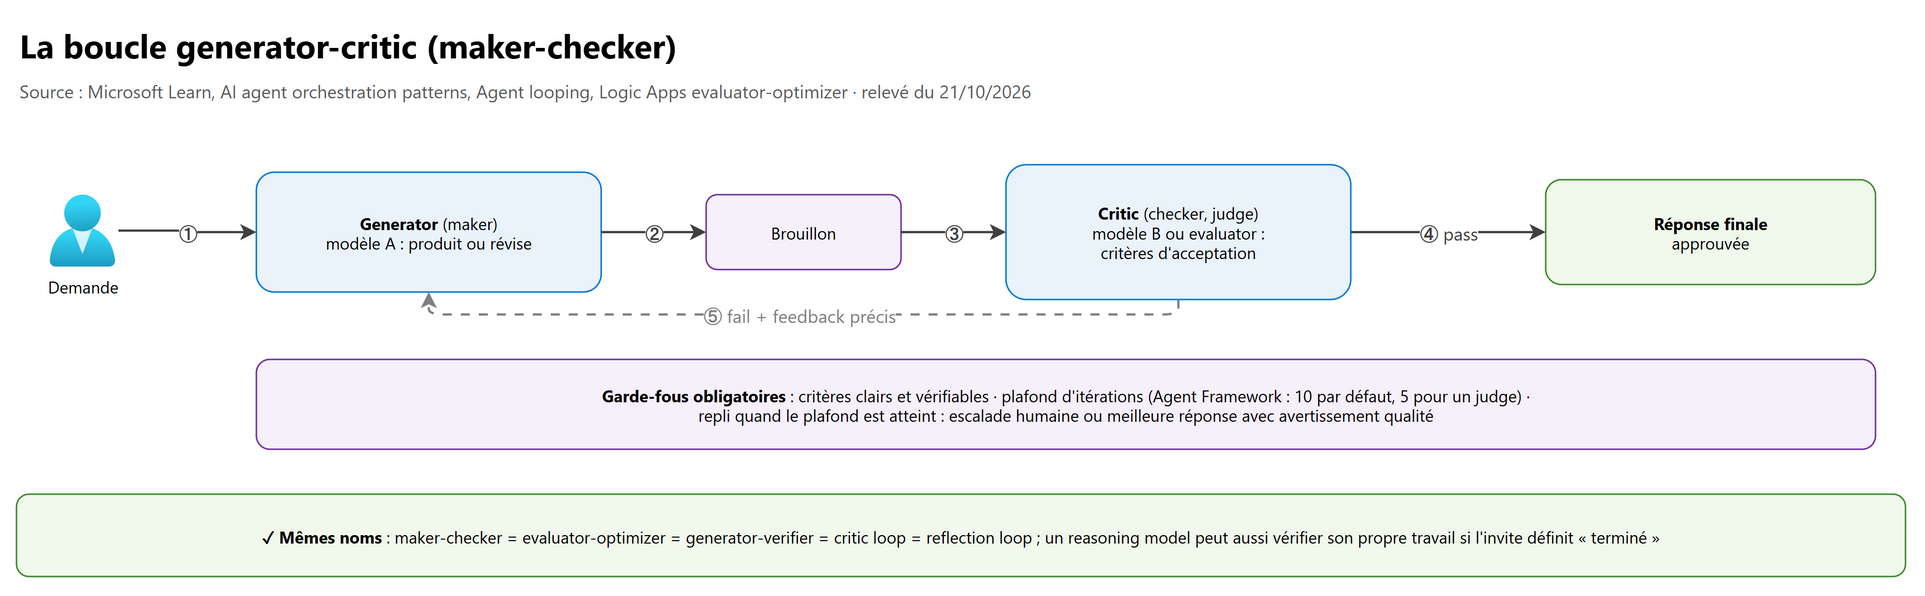
Le Microsoft Azure Architecture Center décrit la maker-checker loop : un agent maker produit, un agent checker évalue le résultat contre des critères définis ; en cas d'écart, il renvoie un retour précis, le maker révise et resoumet, jusqu'à l'approbation ou jusqu'à un nombre maximal d'itérations. Autres noms : evaluator-optimizer, generator-verifier, critic loop, reflection loop.
| Exigence | Pourquoi |
|---|---|
| Critères d'acceptation clairs pour le checker | Pour des décisions pass / fail cohérentes |
| Plafond d'itérations | Éviter la boucle infinie ; une condition peut échouer, un modèle stagner, un evaluator être probabiliste |
| Comportement de repli au plafond | Escalade vers un humain, ou meilleure réponse accompagnée d'un avertissement qualité |
| Valeur mesurable | Le motif ajoute latence et coût : le réserver aux cas où la révision améliore réellement le résultat |
Où le trouver dans l'écosystème Microsoft :
| Outil | Mise en œuvre | Statut |
|---|---|---|
| Microsoft Agent Framework | Agent looping : AgentLoopMiddleware (Python), LoopAgent (C#) ; AgentLoopMiddleware.with_judge pour un juge IA ; 10 itérations max par défaut, 5 pour un judge |
Expérimental |
| Agent Framework, group chat | Orchestration maker-checker pilotée par le chat manager (writer-reviewer) | Voir chapitre 06 |
| Azure Logic Apps (Standard) | Motif evaluator-optimizer entre agent loops, avec conditions de terminaison | Préversion |
| Code applicatif | Deux appels de modèle et une boucle for bornée |
— |
3.3 Implémenter la boucle#
Version Agent Framework (extrait de la documentation Agent looping, expérimental) :
from agent_framework import Agent, AgentLoopMiddleware

loop = AgentLoopMiddleware.with_judge(
    judge_client,                                   # client du modèle juge (de confiance : il voit la demande et la réponse)
    criteria=[
        "Answer every part of the request.",
        "Support conclusions with evidence.",
    ],
    max_iterations=4,                               # toujours borner
)
agent = Agent(client=client, middleware=[loop])     # le raisonnement du juge est renvoyé à l'agent s'il faut retravailler
Version « à la main » avec la Responses API (exemple pédagogique : le critic renvoie un verdict structuré) :
from pydantic import BaseModel

class Avis(BaseModel):                     # verdict structuré du critic
    verdict: str                           # "pass" ou "fail"
    feedback: str                          # corrections précises à apporter

CRITERES = """Tu es relecteur. Vérifie la réponse :
1. chaque affirmation est suivie d'une source [n] ;
2. toutes les parties de la question sont traitées ;
3. rien n'est ajouté hors des sources.
verdict = pass seulement si les trois critères sont remplis."""

def generer(question, sources, feedback=None):
    consigne = question if feedback is None else f"{question}\nCorrige ta réponse précédente : {feedback}"
    r = openai.responses.create(model="gpt-4.1-mini", instructions=INSTRUCTIONS,
                                input=f"<sources>{sources}</sources>\n{consigne}", temperature=0.2)
    return r.output_text

def critiquer(question, sources, brouillon):
    r = openai.responses.parse(model="gpt-4.1", instructions=CRITERES, text_format=Avis,
                               input=f"Question : {question}\nSources : {sources}\nRéponse : {brouillon}")
    return r.output_parsed

MAX_ITERATIONS = 3                          # plafond explicite
feedback = None
for _ in range(MAX_ITERATIONS):
    brouillon = generer(question, sources, feedback)
    avis = critiquer(question, sources, brouillon)
    if avis.verdict == "pass":
        break
    feedback = avis.feedback
else:                                       # plafond atteint sans approbation : repli
    brouillon = "[À relire par un conseiller] " + brouillon
sequenceDiagram
    participant App as Application
    participant G as Generator (modèle A)
    participant C as Critic (modèle B ou evaluator)
    participant H as Humain
    App->>G: Question + sources
    G-->>App: Brouillon 1
    App->>C: Brouillon 1 + critères
    C-->>App: fail + feedback précis
    App->>G: Révision avec le feedback
    G-->>App: Brouillon 2
    App->>C: Brouillon 2 + critères
    alt verdict pass
        C-->>App: pass, réponse rendue à l'utilisateur
    else plafond atteint
        App->>H: Escalade avec le meilleur brouillon
    end
3.4 Évaluer le raisonnement et la trajectoire#
Avec les reasoning models, on n'évalue pas le raisonnement brut (inaccessible) : on évalue le chemin suivi et le résultat. Les evaluators Foundry utiles (détail et code au chapitre 04) :
| Evaluator | Ce qu'il vérifie | Sortie |
|---|---|---|
| Task Navigation Efficiency | La séquence d'actions de l'agent correspond-elle au chemin attendu ? Demande une vérité terrain (expected_actions, matching_mode optionnel) |
Pass / Fail |
| Tool Call Accuracy | Bons outils, bons paramètres, efficacité | Pass / Fail sur une échelle 1-5 |
| Tool Selection, Tool Input Accuracy, Tool Output Utilization, Tool Call Success | Choix, paramètres, exploitation des résultats, réussite technique | Pass / Fail |
| Intent Resolution (préversion) | L'intention de l'utilisateur a-t-elle été comprise ? | Pass / Fail sur 1-5 |
| Task Adherence (préversion) | Les actions respectent-elles les règles du system message ? | Pass / Fail |
| Task Completion (préversion) | La tâche est-elle réalisée de bout en bout ? | Pass / Fail |
| Rubric (préversion) | Critères personnalisés pondérés, jugés par un LLM, avec un raisonnement par dimension | Score 0 à 1 |
| Groundedness, Relevance, Coherence | Qualité de la réponse finale | 1 à 5 |
Deux bonnes pratiques :
- Chaque evaluator renvoie un champ
reason: c'est l'explication du juge, utile pour l'analyse d'erreurs. - Dans le SDK classique, plusieurs evaluators acceptent un reasoning model comme juge avec
is_reasoning_model=True. - Le reasoning summary et les traces (section 4) servent de pièces à conviction pour comprendre un échec.
4. Observabilité, tracing, jetons, sécurité et latence#
4.1 Tracing : de la configuration aux spans#
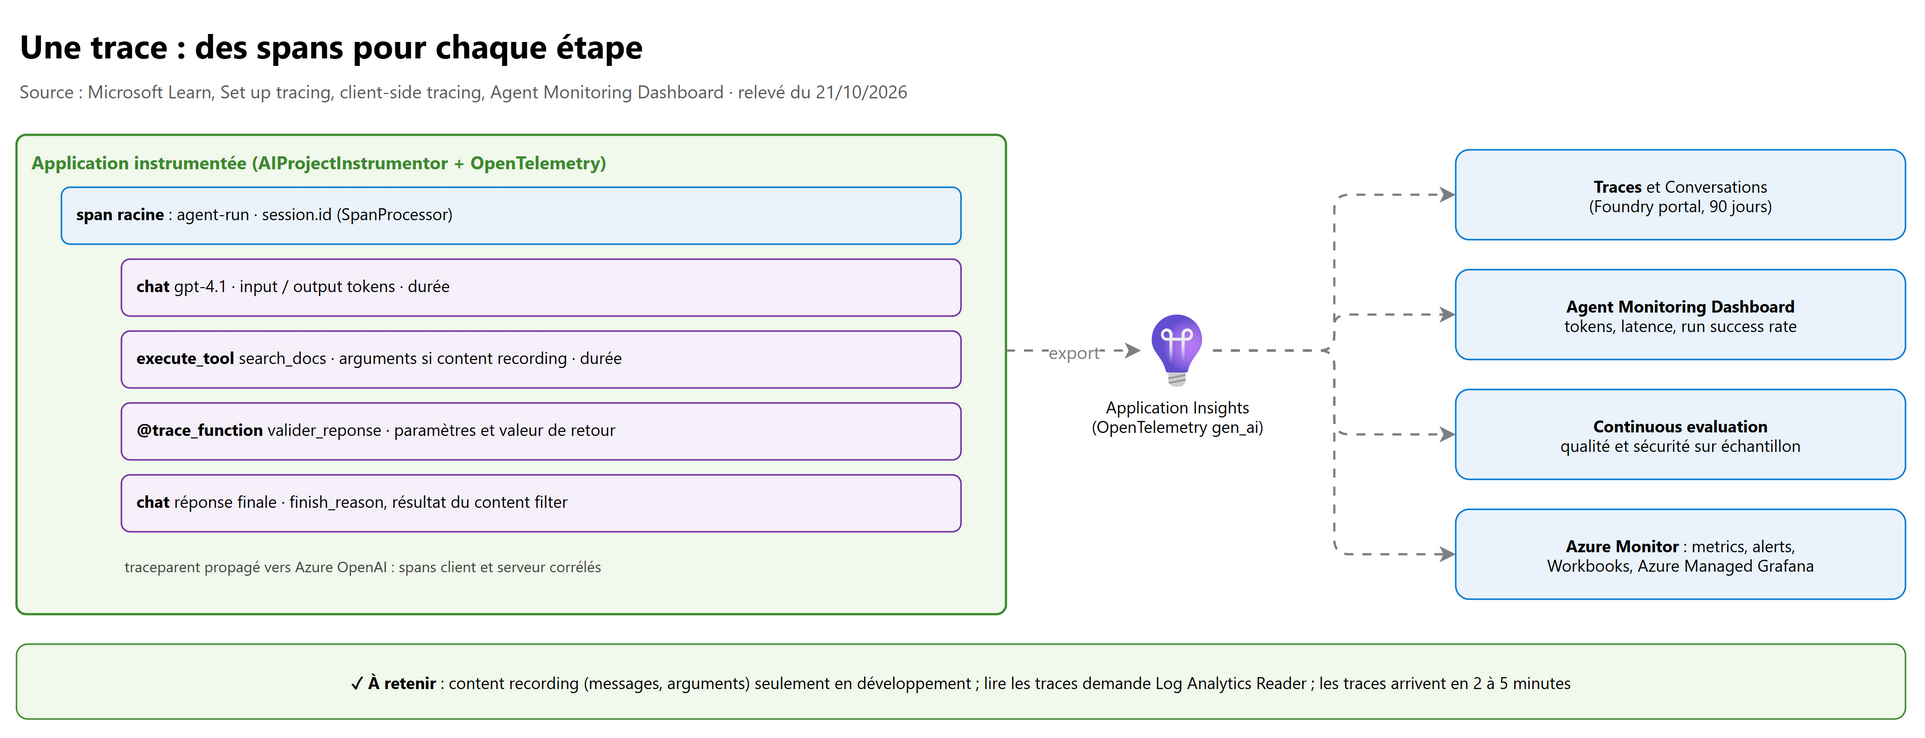
La mise en place (connexion d'Application Insights au project, AZURE_EXPERIMENTAL_ENABLE_GENAI_TRACING, configure_azure_monitor)
est au chapitre 03, section 3.3. Ce qu'il faut savoir en plus :
| Élément | Détail |
|---|---|
| Server-side traces | Foundry trace automatiquement les prompt agents, hosted agents et workflows, sans code ; 90 jours consultables dans Traces |
| Client-side traces (préversion) | AIProjectInstrumentor().instrument() crée des spans pour les appels de modèle, d'outils et votre logique ; export vers Azure Monitor, la console ou tout back-end OTLP (Aspire Dashboard, Grafana Tempo, Jaeger…) |
| Spans personnalisés | Décorateur @trace_function : paramètres (code.function.parameter.<nom>) et valeur de retour toujours tracés |
| Attributs métier | Un SpanProcessor ajoute par exemple session.id à chaque span |
| Corrélation | Trace context propagation (W3C traceparent) activée par défaut : spans client et serveur reliés ; baggage désactivé par défaut (données sensibles possibles) |
| Relier à un agent | Passer agent_reference avec name et id dans responses.create() |
| Content recording | OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true : messages et arguments d'outils ; développement seulement |
| Conversations | Dans Traces, une conversation montre l'historique, les jetons par run, les étapes et appels d'outils dans l'ordre |
import os
os.environ["AZURE_EXPERIMENTAL_ENABLE_GENAI_TRACING"] = "true"    # avant instrument()

from azure.ai.projects.telemetry import AIProjectInstrumentor, trace_function
from opentelemetry import trace
from opentelemetry.sdk.trace import SpanProcessor, TracerProvider

AIProjectInstrumentor().instrument()             # spans automatiques : Responses, Conversations, agents

class SessionSpanProcessor(SpanProcessor):       # ajoute un identifiant de session à chaque span
    def on_start(self, span, parent_context=None):
        span.set_attribute("session.id", "user-session-abc")

trace.get_tracer_provider().add_span_processor(SessionSpanProcessor())   # fournisseur configuré par configure_azure_monitor

@trace_function("valider-reponse")               # span dédié à une étape métier
def valider(reponse: str) -> bool:
    return "[1]" in reponse                      # paramètres et retour enregistrés dans le span
4.2 Token analytics#
| Où | Ce qu'on lit |
|---|---|
Chaque réponse (response.usage) |
input_tokens, input_tokens_details.cached_tokens, output_tokens, output_tokens_details.reasoning_tokens (Responses) ; prompt_tokens, completion_tokens, completion_tokens_details.reasoning_tokens (Chat) |
| Spans GenAI | Jetons d'entrée et de sortie par appel de modèle, donc par étape d'un agent |
| Azure Monitor (resource) | ProcessedPromptTokens, GeneratedTokens, TokenTransaction, taux de correspondance du cache ; split par ModelDeploymentName |
| Agent Monitoring Dashboard | Token usage sur la période : un volume élevé signale des invites ou réponses trop verbeuses |
| Model router | Champ model de chaque réponse et metrics splittées par modèle sous-jacent : où partent les jetons |
u = response.usage
print(f"entrée={u.input_tokens} (dont cache={u.input_tokens_details.cached_tokens}) "
      f"sortie={u.output_tokens} (dont raisonnement={u.output_tokens_details.reasoning_tokens})")
4.3 Safety signals#
| Signal | Où | Réaction attendue |
|---|---|---|
| Requête ou réponse bloquée par les content filters | finish_reason = content_filter, ou erreur HTTP 400 code content_filter ; annotations de filtrage dans la réponse |
Message utile à l'utilisateur ; ne pas renvoyer la même invite bloquée telle quelle |
| Volumes de sécurité | Metrics Content Safety de la ressource (Blocked Volume, Harmful Volume Detected, Potential Abusive User Count…), voir chapitre 03 | Alertes Azure Monitor |
| Qualité et sécurité du trafic réel | Continuous evaluation avec safety evaluators (violence, sexual, self_harm, hate_unfairness…) | Score sous le seuil : alerte, analyse des traces |
| Attaques | Red team scans planifiés (Agent Monitoring Dashboard, préversion) ; Defender for AI services (SC-500, 07) | Remédiation |
| Contenu des échanges | Content recording des traces (dev) | À désactiver en production |
4.4 Latency breakdown#
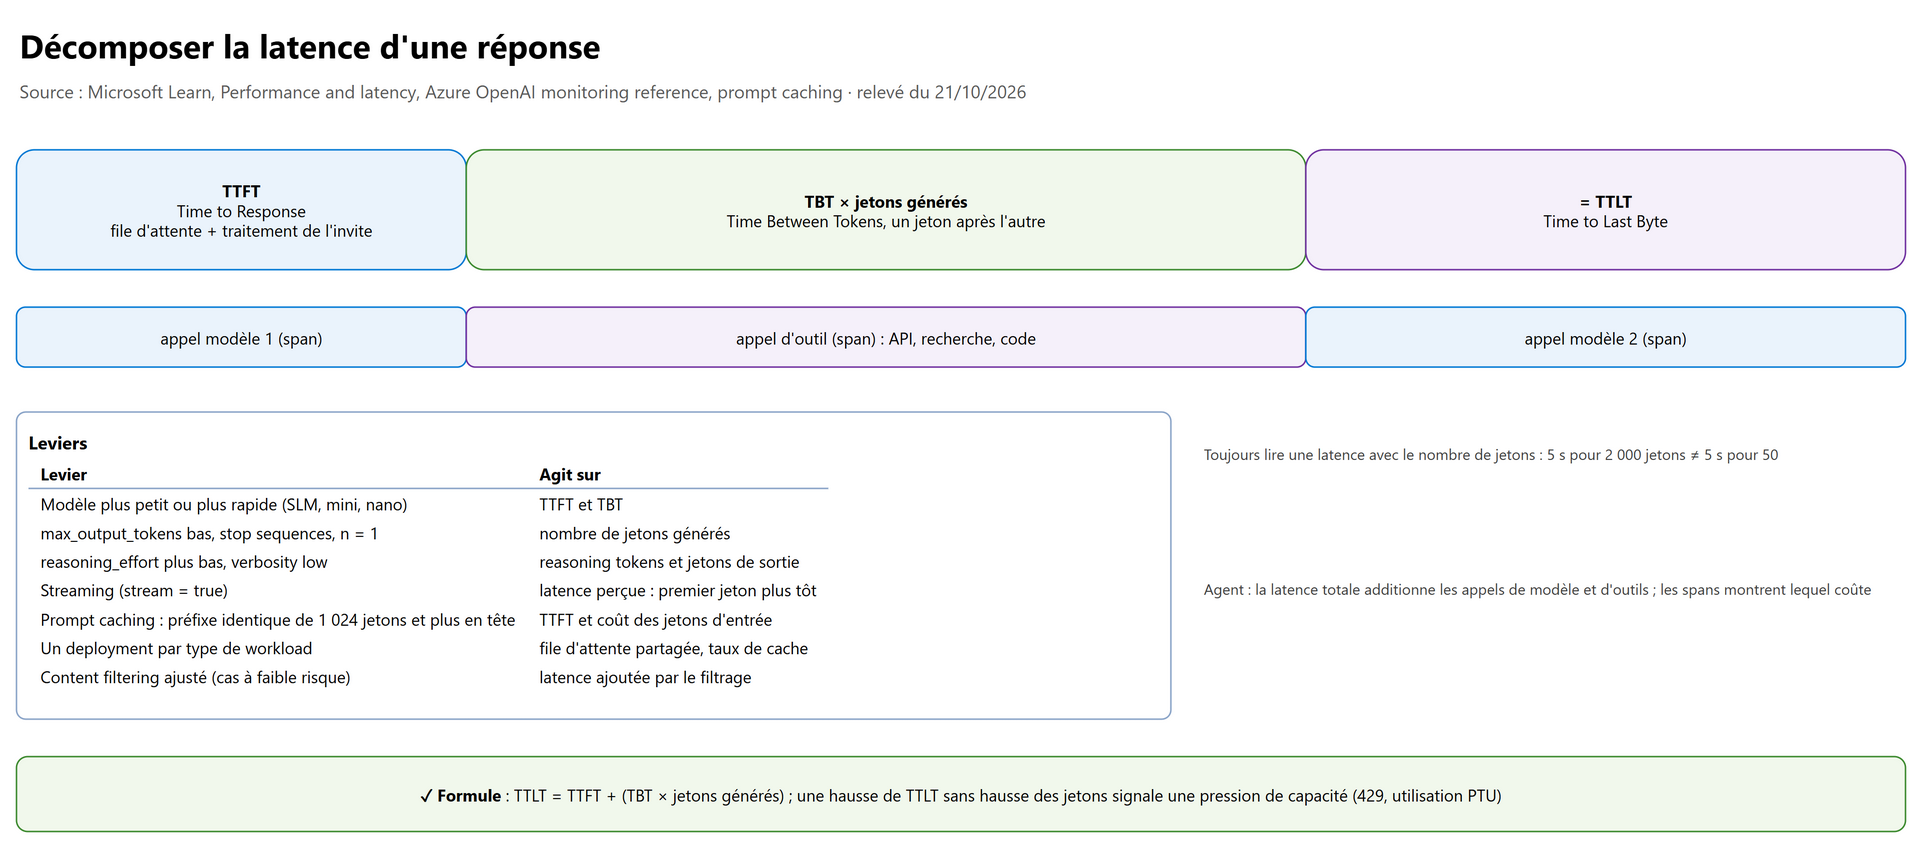
Formule officielle : TTLT = TTFT + (TBT × jetons générés).
| Metric | Nom REST | Mesure | Quand |
|---|---|---|---|
| Time to Response | AzureOpenAITimeToResponse |
Jusqu'au premier fragment (TTFT) | Streaming, réactivité |
| Time Between Tokens | AzureOpenAINormalizedTBTInMS |
Temps moyen entre deux jetons (TBT) | Débit de génération |
| Time to Last Byte | AzureOpenAITTLTInMS |
Temps total jusqu'au dernier jeton (TTLT) | Requêtes non streamées, temps de bout en bout |
| Generated Completion Tokens | GeneratedTokens |
Jetons de sortie | Toujours à côté d'une latence |
Lecture :
- Toujours associer une latence à un nombre de jetons : un TTLT qui monte avec les jetons de sortie n'est pas une régression.
- TTLT qui monte sans hausse des jetons : pression de capacité (429, utilisation PTU) (chapitre 03).
- Pour un agent, la latence additionne les appels de modèle et d'outils : les spans montrent lequel coûte.
- Pour un voice agent, le tableau de bord ajoute le time to first audio (TTFA), la mesure la plus visible pour l'appelant.
Leviers officiels : modèle plus rapide, max_output_tokens bas, stop sequences, n = 1, streaming (latence perçue), prompt
caching, un deployment par type de workload (les appels courts n'attendent plus les longs, meilleur taux de cache), invite plus
courte, regroupement des requêtes, content filtering modifié pour les cas à faible risque (le filtrage ajoute de la latence).
4.5 Où regarder#
| Besoin | Outil |
|---|---|
| Déboguer une requête précise | Foundry portal > agent > Traces (ou Application Insights, End-to-end transaction details) |
| Suivre un agent en production | Onglet Monitor : Agent Monitoring Dashboard (préversion) : token usage, latency (au-delà de 10 s : throttling, outils, réseau), run success rate (sous 95 % : enquêter), evaluation metrics, red teaming results ; alertes (préversion) |
| Tableaux de bord transverses | Azure Monitor metrics, Workbooks, Azure Managed Grafana (dashboard Foundry : latence, débit, jetons, succès par deployment) |
| Rôles nécessaires | Log Analytics Reader pour lire les traces ; Privileged Monitoring Data Reader si les tables sont Protected |
5. Orchestrer plusieurs modèles, flux et règles#
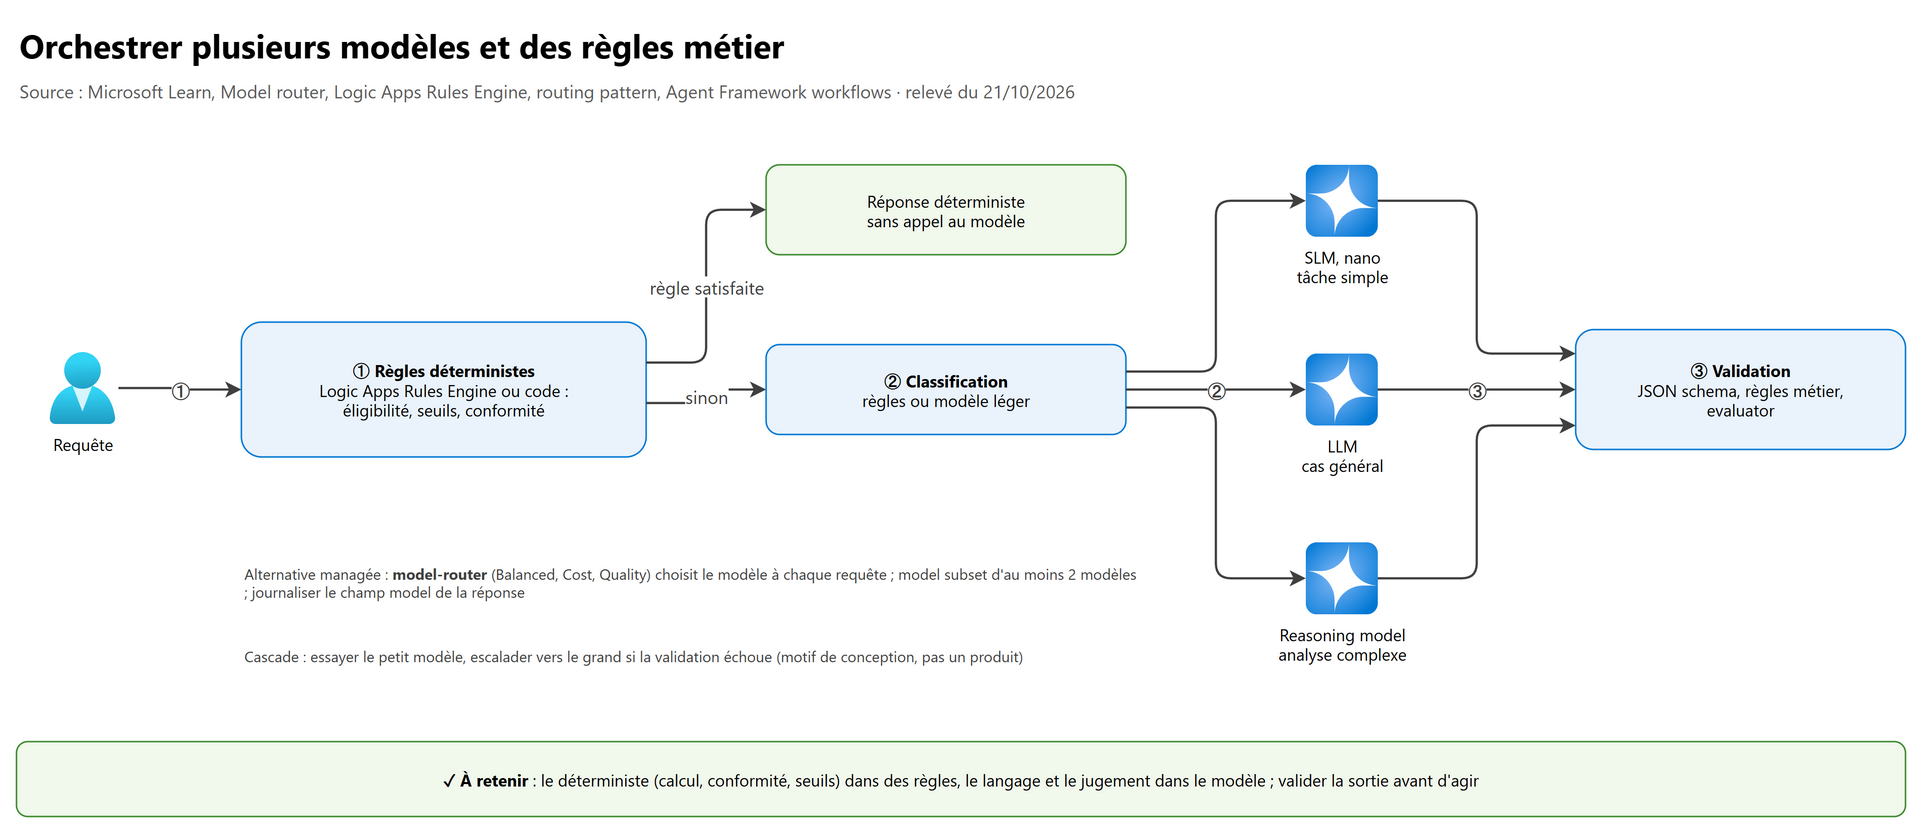
5.1 Le bon niveau de complexité#
L'Azure Architecture Center recommande d'utiliser le niveau de complexité le plus bas qui répond au besoin :
| Niveau | Quand | Attention |
|---|---|---|
| Direct model call (un appel bien écrit) | Classification, résumé, traduction, tâche en une passe | Si le prompt suffit, pas besoin d'agent |
| Single agent with tools | Requêtes variées dans un domaine, outils dynamiques | Souvent le bon défaut en entreprise ; limiter les itérations d'outils |
| Multiagent orchestration | Problèmes transverses, frontières de sécurité distinctes, spécialisation parallèle | Coordination, latence et modes de panne en plus (chapitre 06) |
Anti-patterns cités : complexité inutile, agents sans vraie spécialisation, oubli de la latence multi-sauts, motifs déterministes pour des flux non déterministes et inversement, fenêtres de contexte qui grossissent sans contrôle.
5.2 Model router : laisser Foundry choisir le modèle#
Présenté au chapitre 01 ; côté exploitation :
| Point | À savoir |
|---|---|
| Routing mode | Balanced (défaut : le moins cher dans une petite marge de qualité), Cost (marge plus large), Quality (le meilleur, quel que soit le coût) ; changement effectif en 5 minutes au plus |
| Model subset | Liste des modèles autorisés ; les nouveaux modèles ne sont pas ajoutés sans action ; c'est aussi le jeu de repli : en choisir au moins deux |
| Failover | Automatique : en cas de problème transitoire, la requête part vers le modèle suivant adapté |
| Contexte | Limité par le plus petit modèle du pool : filtrer le subset si les invites sont longues |
| Rate limit | Le TPM se règle sur le deployment model router, pas sur chaque modèle sous-jacent |
| Observabilité | Journaliser le champ model de chaque réponse ; metrics splittées par modèle sous-jacent |
| Gouvernance | Respecte la même Azure Policy de contrôle des modèles déployables que les deployments classiques |
| Bonne pratique | Démarrer en Balanced, observer quelques semaines, puis passer les traitements batch en Cost et le chemin critique en Quality ; changer un levier à la fois et réévaluer |
r = openai.chat.completions.create(
    model="model-router",                         # nom du deployment model router
    messages=[{"role": "user", "content": "Classe ce ticket : imprimante hors ligne au 3e étage."}],
)
print(r.model)                                    # modèle sous-jacent réellement utilisé : à journaliser
5.3 Cascade et routage maison#
Quand on veut garder la main sur la logique de choix :
| Motif | Principe | Source |
|---|---|---|
| Routing pattern | Une étape de classification (algorithme classique ou LLM) envoie chaque entrée vers un traitement spécialisé ; exemple officiel : questions basiques vers un agent de base, questions complexes vers un agent avancé | Logic Apps, Routing pattern |
| Prompt chaining | Étapes fixes en séquence, avec des portes de validation programmatiques entre elles | Logic Apps, Prompt chaining |
| Parallelization | Sectioning (sous-tâches parallèles) ou voting (même tâche plusieurs fois, consensus) | Logic Apps |
| Cascade | Essayer d'abord un petit modèle, escalader vers un plus grand si la validation échoue | Motif de conception (combinaison du routage et d'une validation), pas un produit |
5.4 LLM + rules engine : garder le déterministe déterministe#
Un modèle est probabiliste ; une éligibilité, un calcul de remise ou une règle de conformité doivent donner toujours le même résultat. L'Azure Logic Apps Rules Engine (Logic Apps Standard) apporte un moteur d'inférence de règles déclaratives (algorithme Rete) :
| Notion | Rôle |
|---|---|
| Facts | Données évaluées par les règles : documents XML et objets .NET |
| Rules | IF <condition> THEN <action> (prédicats combinés par AND, OR, NOT) |
| Rulesets | Blocs de logique métier combinables |
| Vocabularies | Noms métier lisibles pour les faits |
| Outils | Microsoft Rules Composer pour écrire et versionner les règles ; exécution par une local custom function (.NET facts) ou l'action Execute Rules Engine (XML facts, préversion) |
Pourquoi l'associer à l'IA, selon Microsoft : cohérence, clarté, conformité ; éviter les informations incorrectes de l'IA ; modifier les règles sans redéployer le workflow ; traiter instantanément les cas connus sans appeler de modèle (performance, coût) ; dépôt de règles centralisé et auditable.
Répartition type :
| Le modèle | Les règles (ou le code) |
|---|---|
| Comprendre la demande, extraire les champs (structured outputs) | Vérifier l'éligibilité, les seuils, les plafonds |
| Rédiger, résumer, reformuler | Calculer montants, dates, scores |
| Classer une demande ambiguë | Appliquer la politique de conformité et décider |
| Proposer une action | Valider (schéma JSON, limites) avant d'exécuter |
5.5 Workflows Microsoft Agent Framework#
Pour enchaîner modèles, règles et humains dans un flux explicite et inspectable, Microsoft Agent Framework propose des workflows : des executors (étapes, code ou agents) reliés par des edges :
| Type d'edge | Usage |
|---|---|
| Direct | Pipeline linéaire |
| Conditional | Routage if / else selon le contenu du message |
| Switch-case | Plusieurs branches évaluées dans l'ordre, avec une branche par défaut |
| Fan-out (multi-selection) | Traitement parallèle |
| Fan-in | Agrégation |
Exemple (syntaxe des pages Workflows d'Agent Framework 1.0 ; la référence d'API montre aussi l'ancienne forme register_executor / set_start_executor) : une règle déterministe décide, le
modèle ne rédige que si la demande est éligible.
from typing_extensions import Never
from agent_framework import Executor, WorkflowBuilder, WorkflowContext, handler

class Regles(Executor):                              # étape déterministe : aucune IA
    @handler
    async def appliquer(self, demande: dict, ctx: WorkflowContext[dict]) -> None:
        demande["eligible"] = demande["anciennete_mois"] >= 6       # règle métier
        await ctx.send_message(demande)

class Refus(Executor):
    @handler
    async def repondre(self, demande: dict, ctx: WorkflowContext[Never, str]) -> None:
        await ctx.yield_output("Non éligible : 6 mois d'ancienneté minimum.")

class Redaction(Executor):                           # étape générative : le modèle rédige
    @handler
    async def rediger(self, demande: dict, ctx: WorkflowContext[Never, str]) -> None:
        r = openai.responses.create(model="gpt-4.1-mini", input=f"Rédige l'accord de formation : {demande}")
        await ctx.yield_output(r.output_text)

regles, refus, redaction = Regles(id="regles"), Refus(id="refus"), Redaction(id="redaction")
workflow = (
    WorkflowBuilder(start_executor=regles)                          # point d'entrée du graphe
    .add_edge(regles, refus, condition=lambda d: not d["eligible"])  # edge conditionnel
    .add_edge(regles, redaction, condition=lambda d: d["eligible"])
    .build()
)
events = await workflow.run({"anciennete_mois": 8, "formation": "AI-103"})
print(events.get_outputs())
Les workflows prennent en charge le human-in-the-loop (pause sur un outil soumis à approbation), les checkpoints et l'exposition
d'un workflow comme un agent (.as_agent()). Les orchestrations prêtes à l'emploi (sequential, concurrent, handoff, group chat,
magentic) sont au chapitre 06. Prompt flow n'est plus recommandé (retrait le 20 avril 2027,
chapitre 05).
flowchart LR
    Q["Requête"] --> R{"Règles métier<br/>Rules Engine ou code"}
    R -->|"cas connu"| D["Réponse déterministe"]
    R -->|"à interpréter"| C["Classification"]
    C -- simple --> S["SLM"]
    C -- général --> L["LLM"]
    C -- complexe --> M["Reasoning model"]
    S --> V{"Validation<br/>schéma + règles"}
    L --> V
    M --> V
    V -- ok --> OUT["Réponse ou action"]
    V -->|"échec, petit modèle"| L
    V -->|"échec persistant"| H["Revue humaine"]
6. Labs conseillés#
Dans un abonnement de test, avec une Foundry resource et un project dédiés. Coût : surtout les jetons (les reasoning models consomment beaucoup de jetons de sortie), Application Insights (ingestion des traces) et Logic Apps Standard (plan d'hébergement) ; supprimer le groupe de ressources à la fin.
- Paramètres d'échantillonnage
- Déployer
gpt-4.1-mini; dans le playground, poser trois fois la même demande créative avectemperature0,2 puis 1,2. - Ajouter deux exemples few-shot et une stop sequence
---. - Appeler un reasoning model avec
temperaturedéfini. - Attendu : sorties stables à 0,2, variées à 1,2 ; le format suit les exemples ; le reasoning model refuse
temperature.
- Déployer
- Régler un reasoning model
- Exécuter le code de la section 2.4 avec
effortlowpuishigh,verbositylowpuishigh. - Recommencer avec
max_output_tokens=200. - Attendu :
reasoning_tokenset latence augmentent avec l'effort ; avec 200 jetons,status=incomplete.
- Exécuter le code de la section 2.4 avec
- Prompt caching
- Construire un system message stable de plus de 1 024 jetons ; envoyer deux requêtes à quelques secondes d'intervalle avec des questions différentes à la fin.
- Modifier un seul caractère au début et renvoyer.
- Attendu :
cached_tokens> 0 à la deuxième requête, 0 après la modification.
- Boucle de critique bornée et traces
- Connecter Application Insights au project, activer l'instrumentation (section 4.1).
- Exécuter la boucle de la section 3.3 avec des sources volontairement incomplètes.
- Ouvrir Traces puis l'onglet Monitor de l'agent.
- Attendu : des spans par appel de generator et de critic, les jetons par span, la boucle qui s'arrête au plafond avec le repli ; traces visibles après 2 à 5 minutes.
- Model router et latence
- Déployer model-router en Custom deployment, mode Cost, subset de deux modèles.
- Envoyer une question triviale puis une question d'analyse ; journaliser
r.model. - Dans Azure Monitor, afficher Time to Response, Time to Last Byte et Generated Completion Tokens splittés par modèle.
- Attendu : modèles différents selon la question ; TTLT qui suit le nombre de jetons générés.
7. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
Régler temperature sur un reasoning model |
Impossible : régler reasoning_effort (et verbosity) |
temperature, top_p, pénalités, logprobs, logit_bias, max_tokens non supportés |
Ajuster à la fois temperature et top_p |
En modifier un seul | Recommandation officielle |
| Demander au reasoning model d'écrire toute sa chaîne de pensée, ou l'extraire | Non : utiliser reasoning.summary |
Extraction brute non supportée, contraire à l'Acceptable Use Policy |
| Few-shot et « step by step » sur GPT-5 ou o-series | Pas recommandé : objectif + contraintes + contrat de sortie | Ces techniques visent les non-reasoning models |
| Réponse vide d'un reasoning model, mais jetons facturés | max_output_tokens trop bas : status = incomplete |
Le plafond couvre aussi le raisonnement |
max_tokens avec o-series en Chat Completions |
max_completion_tokens (Chat) ou max_output_tokens (Responses) |
max_tokens non supporté |
seed pour des réponses identiques garanties |
Non : déterminisme au mieux ; suivre system_fingerprint |
Variabilité possible même avec le même seed |
| Réduire la latence perçue d'un chatbot | Streaming | Le temps total ne change pas, le premier jeton arrive plus tôt |
| Réduire le coût d'un long system message répété | Prompt caching : contenu stable au début, au moins 1 024 jetons identiques | Un caractère différent dans le préfixe = cache miss |
| Le cache ne sert jamais entre deux applications d'abonnements différents | Normal | Caches non partagés entre abonnements |
| TTLT en hausse | Vérifier d'abord les jetons générés | TTLT = TTFT + TBT × jetons |
| Appels courts lents parce qu'ils partagent le deployment d'un batch | Un deployment par type de workload | File d'attente et cache partagés |
| Boucle d'autocritique qui tourne sans fin | Plafond d'itérations + repli (humain ou avertissement) | Exigence du motif maker-checker |
| Le checker ne tranche pas de façon cohérente | Lui donner des critères d'acceptation clairs | Décisions pass / fail stables |
| Évaluer si l'agent suit le chemin attendu | Task Navigation Efficiency (avec expected_actions) |
Évalue la trajectoire |
| Messages et arguments d'outils visibles dans les traces en production | Désactiver le content recording | Données personnelles |
| Aucune trace visible | Application Insights connecté ? variable d'activation avant instrument() ? Log Analytics Reader ? attendre 2 à 5 min |
Causes officielles |
| Relier des traces client à un agent précis | agent_reference avec name et id |
Sinon pas de corrélation dans le portail |
| Model router avec un seul modèle dans le subset | Au moins deux modèles | Sinon ni routage ni failover |
| Erreur de contexte dépassé avec model router | Restreindre le subset aux modèles à grand contexte | Contexte = plus petit modèle du pool |
| Fixer le TPM de chaque modèle derrière le router | Non : TPM sur le deployment model router | Règle officielle |
| Décision de conformité confiée au LLM | Rules Engine (ou code) pour la décision, LLM pour le langage | Résultat déterministe et auditable |
| Logic Apps Consumption pour le Rules Engine | Non : Logic Apps Standard | Le Rules Engine s'applique au Standard |
| Système multi-agents pour une simple classification | Direct model call | Niveau de complexité le plus bas |
| Nouveau pipeline en prompt flow | Microsoft Agent Framework | Prompt flow retiré le 20/04/2027 |
8. Scénarios d'entraînement#
1. Un assistant juridique produit des réponses de style variable et invente parfois des articles de loi. Il utilise gpt-4.1
avec temperature = 1. Que régler en premier ?
Baisser
temperature(ex. 0,2) sans toucher àtop_p; ancrer les réponses sur des extraits délimités avec citations inline ; donner une porte de sortie (« Not found ») ; fixer le format par structured outputs. Évaluer ensuite avec Groundedness.
2. Une équipe migre vers un reasoning model et garde son code : temperature=0.3, max_tokens=500, consigne « explique ton
raisonnement étape par étape ». Les appels échouent. Que corriger ?
Retirer
temperature; remplacermax_tokensparmax_completion_tokens(Chat) oumax_output_tokens(Responses) avec une marge pour le raisonnement ; supprimer la demande de chain of thought et activerreasoning.summarysi l'on veut voir le raisonnement ; réglerreasoning_effortselon la difficulté.
3. Un chatbot de support envoie à chaque requête un system message de 3 000 jetons, puis la question. Comment réduire coût et latence sans changer de modèle ?
Prompt caching : garder le system message identique et en tête, la question en fin ; vérifier
cached_tokens. Ajouter streaming pour la latence perçue, et unmax_output_tokensadapté.
4. Des fiches produit générées doivent respecter une charte en cinq points ; 20 % sont refusées par la relecture humaine. Quelle architecture ?
Une boucle generator-critic : le critic vérifie les cinq critères et renvoie un verdict structuré avec un feedback précis ; plafond de 3 itérations ; au plafond, envoi à la relecture humaine avec un avertissement. Mesurer le taux de refus avant / après.
5. Un agent répond correctement mais appelle quatre outils là où deux suffisent. Comment le mesurer en continu ?
Task Navigation Efficiency avec les séquences attendues (
expected_actions), complété par Tool Selection et Tool Call Accuracy ; analyser les spansexecute_tooldans les traces.
6. Les utilisateurs se plaignent de lenteur. Le TTLT moyen est passé de 4 à 9 secondes, les jetons générés de 300 à 900 après une modification de l'invite. Diagnostic ?
Pas une régression de la plateforme : TTLT = TTFT + TBT × jetons. Le nouveau prompt fait produire trois fois plus de texte : réduire la verbosité (consigne,
verbosity,max_output_tokens) et activer le streaming.
7. Une banque veut qu'un agent traite des demandes de prêt : l'éligibilité dépend de seuils réglementaires qui changent chaque trimestre, et la réponse au client doit être rédigée en langage naturel. Quelle conception ?
Éligibilité et seuils dans l'Azure Logic Apps Rules Engine (Logic Apps Standard, rulesets versionnés, modifiables sans redéploiement) ; le modèle extrait les champs de la demande (structured outputs) et rédige la réponse ; validation de la sortie avant envoi. Le LLM ne décide jamais de l'éligibilité.
8. Le trafic mélange questions simples et analyses complexes ; l'équipe sécurité n'a approuvé que trois modèles. Comment optimiser le coût ?
Model router, mode Balanced (ou Cost), model subset limité aux trois modèles approuvés (nouveaux modèles exclus par défaut, au moins deux pour le failover) ; journaliser le champ
model; ajuster après observation.
9. Les développeurs veulent voir dans Application Insights la durée de leur fonction de validation et l'identifiant de session, mais pas le contenu des messages en production. Que configurer ?
AIProjectInstrumentor().instrument(), décorateur@trace_functionsur la fonction de validation, unSpanProcessorqui ajoutesession.id; laisserOTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENTàfalseen production (attention :@trace_functionenregistre toujours ses paramètres, ne pas lui passer de données sensibles).
10. Sur le tableau de bord de l'agent, le run success rate est à 91 % et la latence moyenne à 14 secondes. Que faire ?
Les deux sont au-delà des seuils indicatifs (moins de 95 % de succès, plus de 10 s) : ouvrir les traces des runs en échec, regarder quels spans (modèle, outil) portent la latence, vérifier les 429 et l'utilisation de capacité ; configurer des alertes.
9. Pour aller plus loin#
- Prompt cache key et breakpoints (GPT-5.6 et suivants) :
prompt_cache_keyregroupe les requêtes qui partagent un préfixe (au-delà d'environ 15 requêtes par minute par clé, répartir sur plusieurs clés) ; breakpoints explicites pour délimiter le préfixe réutilisable. - Persisted reasoning :
reasoning.context=all_turnsréutilise le raisonnement des tours précédents (plus de jetons, plus de continuité) ;current_turnpour limiter le contexte d'un long workflow. - Background mode : pour les traitements longs (ex. o3-pro), éviter les timeouts côté client.
- Agentic behavior engineering (Azure Architecture Center) : gouverner le comportement d'un agent par des contrats versionnés, des exigences de preuves, des contrôles à l'exécution et des portes de publication.
- Dynamic AI agents at scale : sélection dynamique d'agents dans un grand pool via Azure AI Search comme cache sémantique, puis un LLM.
- Fine-tuning et distillation pour réduire la taille des invites et passer sur un modèle plus petit (chapitre 01).
10. Fiche à retenir#
- Reasoning ou non ? décide des réglages :
temperature/top_p/ pénalités d'un côté,reasoning_effort/verbosityde l'autre. - Modifier
temperatureoutop_p;temperature0 à 2 (défaut 1),top_p0 à 1. -
max_output_tokens(Responses) /max_completion_tokens(Chat) couvrent le raisonnement ;status: incompletesi trop bas. -
seed= déterminisme au mieux, suivresystem_fingerprint;stopjusqu'à 4 séquences ;n= 1. - Prompt engineering : instructions d'abord, few-shot, recency bias, délimiteurs, décomposition, citations inline, porte de sortie.
- Chain of thought demandée = non-reasoning ; raisonnement d'un reasoning model = reasoning summary uniquement.
- Prompt caching : 1 024 jetons identiques en tête,
cached_tokens, 5 à 10 min (≤ 1 h), étendu jusqu'à 24 h, pas entre abonnements. - Maker-checker = evaluator-optimizer = critic / reflection loop : critères clairs, plafond, repli.
- Agent Framework Agent looping (expérimental) : 10 itérations par défaut, 5 avec un judge.
- Trajectoire : Task Navigation Efficiency (expected_actions), Tool Call Accuracy, Intent Resolution, Task Adherence, Rubric.
- Tracing : server-side automatique (90 jours), client-side
AIProjectInstrumentor,@trace_function,agent_referencename + id. - Content recording dev uniquement ; lire les traces = Log Analytics Reader ; délai 2 à 5 min.
- Token analytics :
cached_tokens,reasoning_tokens, metricsProcessedPromptTokens/GeneratedTokens, champmodeldu router. - Safety signals :
content_filter, metrics Content Safety, safety evaluators en continu, red team scans. - TTLT = TTFT + TBT × jetons ; streaming = latence perçue ; un deployment par workload.
- Agent Monitoring Dashboard : latence > 10 s ou success rate < 95 % = enquêter.
- Niveau de complexité le plus bas : direct call → single agent → multi-agent.
- Model router : Balanced / Cost / Quality, subset ≥ 2, contexte du plus petit, TPM sur le router.
- Déterministe dans le Logic Apps Rules Engine (Standard, facts XML / .NET, rulesets, Rete) ; le LLM pour le langage.
- Workflows Agent Framework : executors + edges (conditional, switch-case, fan-out, fan-in) ; prompt flow retiré le 20/04/2027.
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Guide d'étude de l'examen AI-103 (en anglais)
- Prompt engineering techniques
- System message design
- Azure OpenAI reasoning models
- Use reasoning models with Microsoft Foundry Models
- Prompt caching
- Learn how to use reproducible output (preview)
- Azure OpenAI in Microsoft Foundry Models REST API reference
- Performance and latency
- Set up tracing in Microsoft Foundry
- Add client-side tracing to Foundry agents (preview)
- Monitor agents with the Agent Monitoring Dashboard
- Voice agent tracing, monitoring, and evaluation
- Create a Microsoft Foundry dashboard (Azure Managed Grafana)
- AI agent orchestration patterns
- Agent looping (Microsoft Agent Framework)
- Compare single agent loop versus multiple agent loops in Azure Logic Apps (preview)
- Built-in evaluators reference
- Agent evaluators
- Evaluate your AI agents (classic)
- Model router for Microsoft Foundry
- How model router works
- Use model router for Microsoft Foundry
- Decision management with the Azure Logic Apps Rules Engine
- Create an Azure Logic Apps Rules Engine project
- Create rules using the Microsoft Rules Composer
- Workflow edges (Microsoft Agent Framework)
- Workflow orchestrations (Microsoft Agent Framework)
- WorkflowBuilder class (Python)