

Version : 1.1 · Date : 2026-10-22 · Domaine 5 : Model Selection and Optimization (16,8 %)
En une phrase : un LLM produit un token après l'autre dans une fenêtre de contexte partagée par l'entrée et la sortie ; on choisit le modèle en réglant d'abord l'effort, on mesure les tokens au lieu de les estimer, et on paie moins grâce au prompt caching, au Batch API et à un préfixe stable, jamais en coupant
max_tokens.
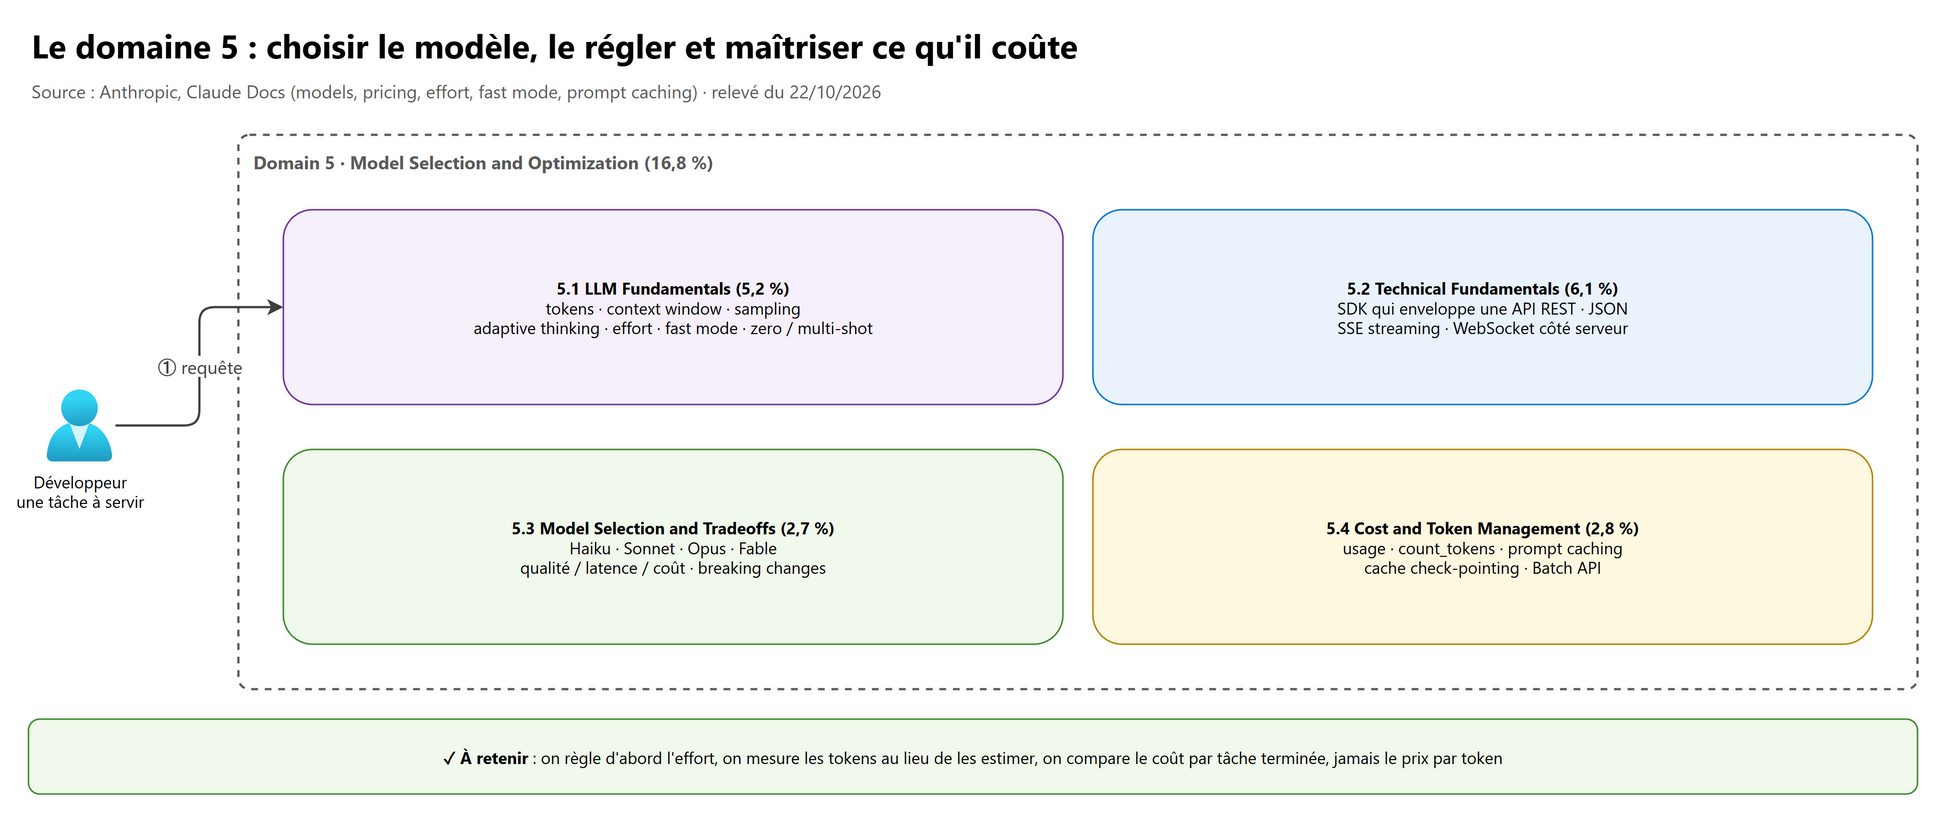
C'est le 2e domaine de l'examen (16,8 %), et le plus « chiffré » : prix, limites, valeurs par défaut. Les chiffres de ce chapitre ont été relevés le 22/10/2026 sur la doc officielle ; ils bougent à chaque sortie de modèle, relisez la page Pricing et la page Models overview avant l'examen.
Ce que l'examen demande#
Texte officiel du Claude Certified Developer – Foundations Exam Guide v1.0 (juillet 2026) :
| # | Skill (guide officiel, en anglais) | Poids | Section |
|---|---|---|---|
| 5.1 | LLM Fundamentals : Basic understanding of LLMs (tokens, context windows, sampling, non-determinism, next-token generation), model options (fast mode, extended thinking, adaptive thinking, effort levels), and fundamental prompting techniques (zero-shot, single-shot, multi-shot). | 5,2 % | 1 |
| 5.2 | Technical Fundamentals : Foundational technical concepts supporting AI application development, including basic engineering practices (integrating with SDKs that wrap REST APIs, websockets). | 6,1 % | 2 |
| 5.3 | Model Selection and Tradeoffs : Claude model capabilities (Opus vs. Sonnet vs. Haiku use cases, adaptive thinking support), tradeoffs across quality/latency/cost parameters, and breaking behavior changes across model releases when selecting models for tasks. | 2,7 % | 3 |
| 5.4 | Cost and Token Management : Token budgeting and cost management techniques for Claude applications, including token usage tracking, cost modeling, and caching techniques (prompt caching, cache check-pointing) for cost optimization. | 2,8 % | 4 |
Convention du cours : le produit évolue plus vite que le guide v1.0. Quand c'est le cas, un encadré donne d'abord la réponse d'examen (celle du guide), puis l'état actuel du produit (relevé le 22/10/2026 sur la doc officielle).
0. Les bases à maîtriser avant tout#
0.1 Le vocabulaire#
| Terme | Sens |
|---|---|
| Token | Unité de texte que lit et produit le modèle (un morceau de mot). Ordre de grandeur donné par la doc : 1M tokens ≈ 555 000 mots. Tout se compte et se facture en tokens. |
| Context window | Tout ce que le modèle voit en une requête : outils, system, messages, résultats d'outils, images, plus la sortie et le thinking du tour. |
max_tokens |
Plafond de sortie du tour (thinking compris). Une coupure dure, pas une consigne de longueur. |
| Input / output tokens | Facturés séparément ; la sortie coûte 5 fois plus cher que l'entrée sur tous les modèles actuels. |
| Adaptive thinking | Le modèle décide lui-même s'il réfléchit et combien (thinking: {type: "adaptive"}). |
| Effort | output_config.effort : low, medium, high, xhigh, max. Règle la quantité de travail sur tous les tokens de sortie. |
| Prompt caching | Réutiliser un préfixe identique d'une requête à l'autre, lu à une fraction du prix de l'entrée. |
| Batch API | Requêtes asynchrones, résultat en moins de 24 h, -50 % sur tous les tokens. |
| Snapshot | Un ID de modèle (claude-opus-5-5) désigne un modèle figé, qui ne change pas sous vos pieds. |
0.2 Les quatre questions du domaine#
| Question | Skill | Réponse courte |
|---|---|---|
| Comment le modèle produit-il une réponse, et qu'est-ce que je peux régler ? | 5.1 | Token par token ; thinking, effort, fast mode, exemples dans le prompt |
| Comment mon code parle-t-il à Claude ? | 5.2 | SDK officiel au-dessus d'une API REST JSON, streaming SSE |
| Quel modèle pour quelle tâche, et que casse une nouvelle version ? | 5.3 | Effort d'abord, puis modèle ; coût par tâche terminée ; breaking changes |
| Combien ça coûte, et comment payer moins ? | 5.4 | usage, count_tokens, prompt caching, Batch, Usage and Cost API |
1. LLM Fundamentals (skill 5.1)#
1.1 La génération, un token après l'autre#
Le modèle lit toute l'entrée, puis produit un token à la fois : chaque nouveau token est choisi à partir de tout ce qui précède (l'entrée et les tokens déjà produits). Trois conséquences pratiques :
| Fait | Conséquence pour le développeur |
|---|---|
| La sortie est séquentielle | Produire 2 000 tokens prend plus de temps que lire 20 000 tokens d'entrée : la latence dépend surtout de la longueur de la sortie |
| Le modèle ne « revient » pas sur ce qu'il a écrit | Demander de réfléchir avant de répondre (thinking) améliore les tâches difficiles |
| On peut afficher les tokens dès qu'ils sortent | Le streaming réduit la latence perçue, pas le temps total |
1.2 Mesurer les tokens, ne pas les deviner#
Le nombre de tokens d'un texte dépend du tokenizer du modèle. Les modèles récents n'utilisent pas le même : à partir d'Opus 4.7, le même texte produit environ 1 à 1,35 fois plus de tokens. Deux outils officiels :
import anthropic

client = anthropic.Anthropic()  # lit ANTHROPIC_API_KEY dans l'environnement

# Avant l'appel : estimer la taille exacte d'une requête (gratuit, soumis à des rate limits)
compte = client.messages.count_tokens(
    model="claude-opus-5-5",
    system="Tu es un assistant de support.",
    messages=[{"role": "user", "content": "Résume ce ticket : ..."}],
)
print(compte.input_tokens)

# Après l'appel : le compteur réel, à journaliser pour chaque requête
reponse = client.messages.create(model="claude-opus-5-5", max_tokens=1024,
                                 messages=[{"role": "user", "content": "Bonjour"}])
print(reponse.usage)  # input_tokens, output_tokens, cache_creation_input_tokens, cache_read_input_tokens
Piège : un tokenizer d'un autre fournisseur (tiktoken, par exemple) ou la règle « 4 caractères = 1 token » donnent un ordre de grandeur, jamais le chiffre. Pour un budget, une limite ou une facture :
count_tokensavant,usageaprès.
1.3 La fenêtre de contexte : un seul budget pour tout#
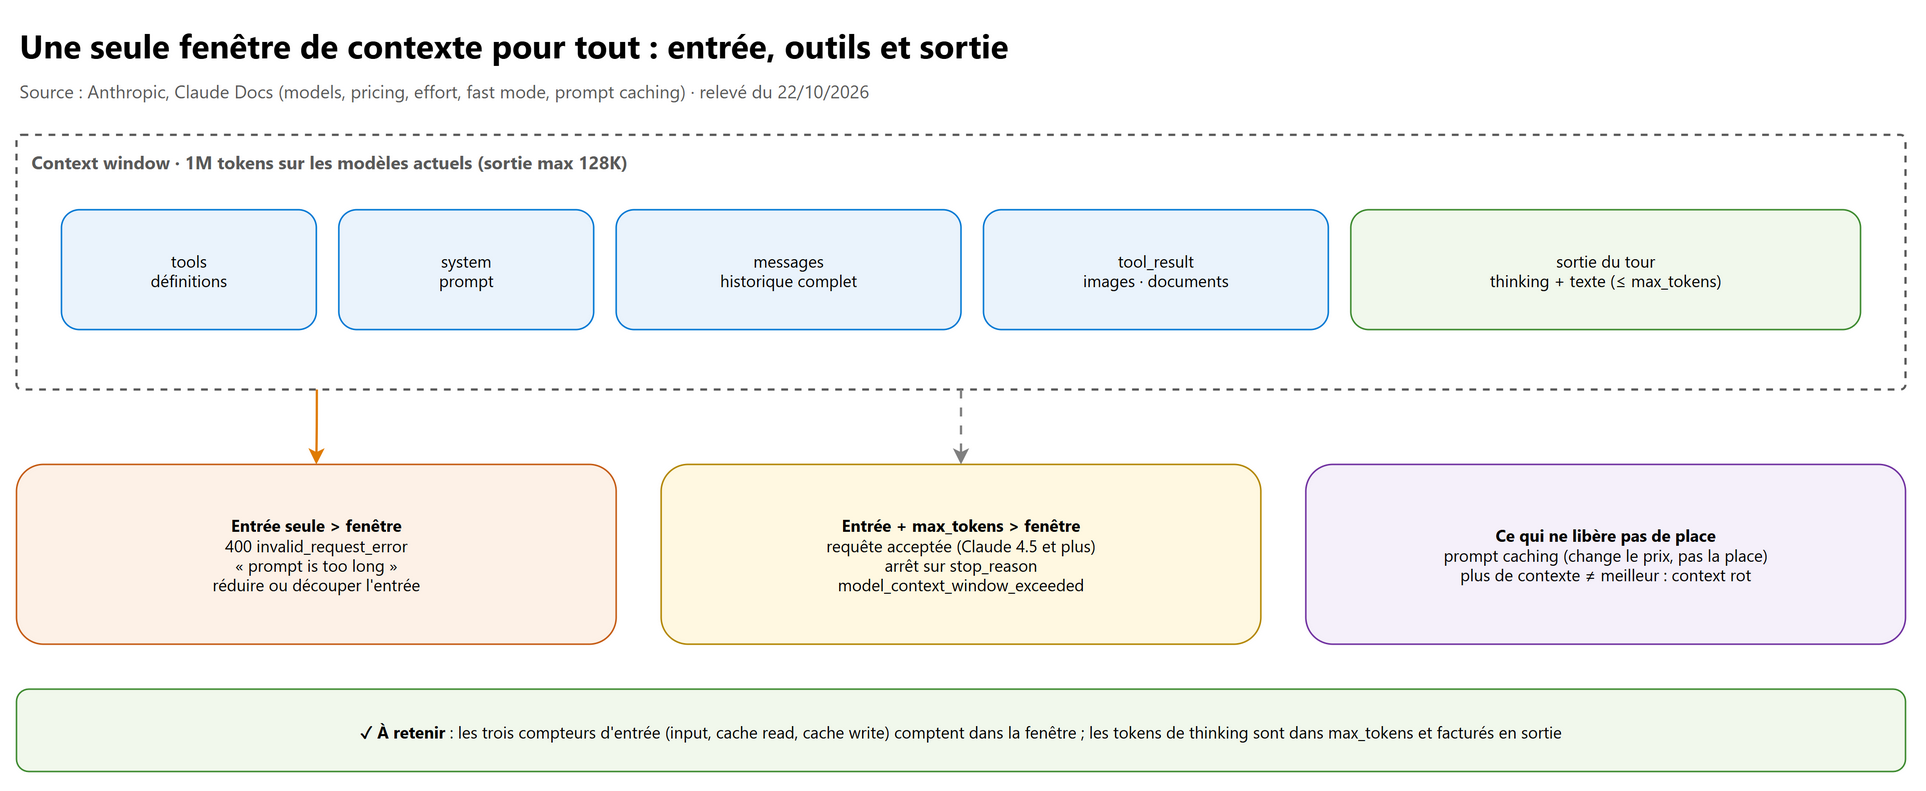
Tous les modèles actuels ont 1M tokens de fenêtre et jusqu'à 128K tokens de sortie (300K en Batch API avec le beta
output-300k-2026-03-24). Ce qui se passe quand ça déborde :
| Situation | Comportement (Claude 4.5 et plus récents) |
|---|---|
| L'entrée seule dépasse la fenêtre | Erreur 400 invalid_request_error (« prompt is too long ») : rien n'est généré |
Entrée + max_tokens dépassent la fenêtre |
La requête est acceptée ; la génération s'arrête quand la fenêtre est pleine, avec stop_reason: "model_context_window_exceeded" |
La sortie atteint max_tokens |
stop_reason: "max_tokens" : réponse tronquée |
Deux idées reçues à corriger :
- Le prompt caching n'agrandit pas la fenêtre : un token lu depuis le cache compte dans la fenêtre comme un autre. Il change le prix, pas la place.
- Plus de contexte n'est pas mieux : la doc parle de context rot, la précision baisse quand le contexte s'allonge. On garde le contexte pertinent, on élague les résultats d'outils inutiles (voir le chapitre 05).
Certains modèles savent combien de contexte il leur reste (context awareness : Sonnet 5, Sonnet 4.6, Sonnet 4.5,
Haiku 4.5). Pour les autres, les task budgets (beta, en-tête task-budgets-2026-03-13, champ
output_config.task_budget, 20 000 tokens au moins) donnent au modèle un budget de tokens pour toute une boucle agentique.
1.4 Sampling et non-déterminisme#
À chaque pas, le modèle calcule une probabilité pour chaque token possible, puis en tire un : c'est l'échantillonnage (sampling). Deux requêtes identiques peuvent donc produire deux réponses différentes.
Réponse d'examen :
temperaturerègle l'aléa (basse pour l'extraction, la classification ou le code ; plus haute pour la créativité) ;top_pettop_krestreignent les tokens candidats ; on règle l'un ou l'autre, pas les deux. Même àtemperature0, la sortie n'est pas garantie identique d'un appel à l'autre.État actuel : les modèles Claude 4.7 et suivants (Opus 4.7 à 5.5, Fable, Sonnet 5 / 5.5, Haiku 5.5) n'acceptent que les valeurs par défaut : toute autre valeur renvoie une 400. La version d'API
2026-10-21supprime ces paramètres (400 sur tous les modèles, même à la valeur par défaut). Le levier de qualité devient le prompt, l'effort et le thinking.
Ce qu'on fait du non-déterminisme, quel que soit le modèle :
| Besoin | Réponse |
|---|---|
| Une sortie exploitable par du code | Structured outputs ou un outil avec input_schema (chapitre 05), puis validation |
| Savoir si un changement améliore vraiment | Evals sur plusieurs exécutions, pas sur un seul essai (chapitre 03) |
| Une décision métier stable | La règle dans le code (hook, gate), pas dans le prompt |
1.5 Les options du modèle : thinking, effort, fast mode#
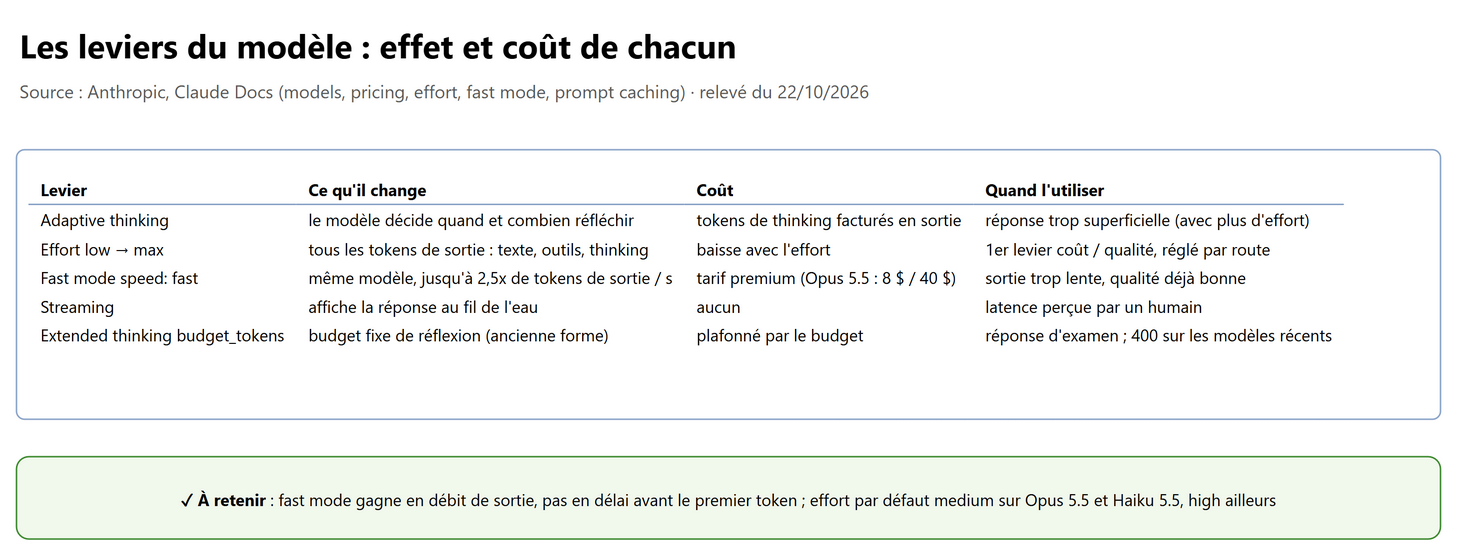
Adaptive thinking. Le modèle réfléchit avant de répondre, et décide quand et combien. Les tokens de thinking sont des
tokens de sortie (dans max_tokens, facturés au prix de la sortie).
reponse = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16000,
    thinking={"type": "adaptive"},          # toujours actif sur Opus 5.5 et Fable 5.1
    output_config={"effort": "high"},       # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": "Planifie la migration de ce schéma de base ..."}],
)
Réponse d'examen : extended thinking =
thinking: {type: "enabled", budget_tokens: N}, un budget fixe de réflexion ; adaptive thinking = le modèle choisit lui-même.État actuel :
budget_tokensest déprécié sur Opus 4.6 et Sonnet 4.6, et rejeté (400) sur Fable 5 / 5.1, Opus 5.5 / 5 / 4.8 / 4.7, Sonnet 5.5, Sonnet 5 et Haiku 5.5. On utiliseadaptive+effort. Sur Opus 5.5,thinking: {type: "disabled"}renvoie 400 ; sur Sonnet 5.5, le réglage le plus bas est{type: "between_tools"}(avec un efforthighau plus).
Effort. C'est le premier levier coût / qualité / latence. Il agit sur tous les tokens de sortie : texte, appels d'outils et thinking. Un effort bas = moins de tokens, plus vite, moins cher ; un effort haut = plus de travail sur les cas difficiles.
| Modèle | Effort par défaut |
|---|---|
| Fable 5.1, Sonnet 5.5 | high |
| Opus 5.5, Haiku 5.5 | medium |
Changer l'effort au niveau de la requête invalide le cache ; le changer en cours de conversation par un message
role: "system" (beta mid-conversation-output-config-2026-07-01) le préserve.
Fast mode. Le même modèle, servi plus vite : jusqu'à 2,5 fois plus de tokens de sortie par seconde, au prix d'un tarif premium.
| Opus 5.5 | Opus 5 et 4.8 | |
|---|---|---|
| Statut | GA, sans header beta | Research preview, header fast-mode-2026-02-01 |
| Activation | speed: "fast" |
speed: "fast" + header |
| Prix ($ / MTok, entrée / sortie) | 8 / 40 (contre 4 / 20 en standard) | 10 / 50 |
Ce qu'il faut savoir : pas de gain sur le délai avant le premier token (TTFT) ; usage.speed indique la vitesse servie ; rate
limit dédié (429 quand il est atteint) ; repasser en vitesse standard provoque un cache miss ; incompatible avec le Batch
API et le Priority Tier. Opus 5.5 en fast mode est aussi disponible sur Microsoft Foundry hébergé sur Azure.
1.6 Zero-shot, single-shot, multi-shot#
| Technique | Ce qu'on met dans le prompt | Quand |
|---|---|---|
| Zero-shot | La consigne seule | Tâche courante, format libre |
| Single-shot (one-shot) | La consigne + un exemple d'entrée et de sortie | Montrer un format précis |
| Multi-shot (few-shot) | La consigne + plusieurs exemples variés (la doc conseille 3 à 5), balisés <example> |
Format strict, cas limites, ton, classification ambiguë |
<examples>
  <example>
    <ticket>Ma facture de mars est en double.</ticket>
    <categorie>billing</categorie>
  </example>
  <example>
    <ticket>L'export CSV plante au-delà de 10 000 lignes.</ticket>
    <categorie>bug</categorie>
  </example>
</examples>
Piège : des exemples trop semblables apprennent au modèle un détail non voulu (toujours la même longueur, le même mot). On varie les exemples et on couvre les cas limites. Les exemples coûtent des tokens d'entrée à chaque requête : on les met dans le préfixe caché (section 4.2).
2. Technical Fundamentals (skill 5.2)#
2.1 Une API REST JSON sous le SDK#
La Claude API est une API REST : des requêtes HTTPS avec un corps JSON. L'appel principal :
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{"model": "claude-opus-5-5", "max_tokens": 1024,
       "messages": [{"role": "user", "content": "Bonjour"}]}'
| Élément | Rôle |
|---|---|
x-api-key |
La clé API (toujours côté serveur, jamais dans le navigateur ni dans le dépôt) |
anthropic-version |
La version d'API : fige le comportement de l'interface |
anthropic-beta |
Active une fonctionnalité beta (liste séparée par des virgules) |
request-id (réponse) |
L'identifiant à donner au support |
Les SDK officiels (Python, TypeScript, Java, Go, Ruby, C#, PHP) enveloppent cette API. Ils n'ajoutent ni modèle, ni tarif, ni limite : ils ajoutent l'ergonomie.
| Ce que fait le SDK | Détail |
|---|---|
| Authentification | Lit ANTHROPIC_API_KEY dans l'environnement |
| Retries automatiques | 2 par défaut, avec backoff, sur 408, 409, 429 et 5xx (réglable : max_retries) |
| Timeout | 10 minutes par défaut (réglable : timeout) |
| Exceptions typées | RateLimitError (429), BadRequestError (400), AuthenticationError (401), APIConnectionError… |
| Identifiant de requête | reponse._request_id |
| Helpers | Streaming (messages.stream, get_final_message()), pagination, Batch, count_tokens, tool runner |
import anthropic

client = anthropic.Anthropic(max_retries=4, timeout=60.0)  # un seul client, réutilisé par toute l'application

try:
    reponse = client.messages.create(model="claude-sonnet-5-5", max_tokens=512,
                                     messages=[{"role": "user", "content": "Classe ce ticket ..."}])
except anthropic.RateLimitError:
    ...  # 429 après les retries : file d'attente, ou réduire le débit
except anthropic.APIStatusError as e:
    print(e.status_code, e.response.headers.get("request-id"))
Bonne pratique : créer un client et le réutiliser (connexions HTTP gardées ouvertes). Créer un client par requête coûte des connexions et fait perdre le bénéfice du pool.
Les erreurs à reconnaître : 400 requête invalide (paramètre retiré, prompt trop long), 401 clé invalide, 403
permission, 413 requête trop grosse, 429 rate limit (en-tête retry-after), 500 erreur interne, 529
overloaded_error (API surchargée, réessayer plus tard).
2.2 Streaming : SSE côté API, WebSocket côté client#
Avec stream: true, l'API renvoie des server-sent events (SSE) sur la même connexion HTTPS :
sequenceDiagram
    participant S as Votre serveur (SDK)
    participant A as Claude API
    S->>A: POST /v1/messages (stream: true)
    A-->>S: message_start (usage initial)
    A-->>S: content_block_start
    loop pour chaque morceau
        A-->>S: content_block_delta (text_delta, thinking_delta ou input_json_delta)
    end
    A-->>S: content_block_stop
    A-->>S: message_delta (stop_reason, usage final)
    A-->>S: message_stop
with client.messages.stream(model="claude-opus-5-5", max_tokens=4096,
                            messages=[{"role": "user", "content": "Explique ..."}]) as flux:
    for texte in flux.text_stream:
        print(texte, end="", flush=True)  # relayer vers le client au fil de l'eau
    message = flux.get_final_message()    # le message complet, usage compris
Le streaming est conseillé dès que la sortie est longue ou max_tokens élevé : il évite les timeouts sur les requêtes
longues.
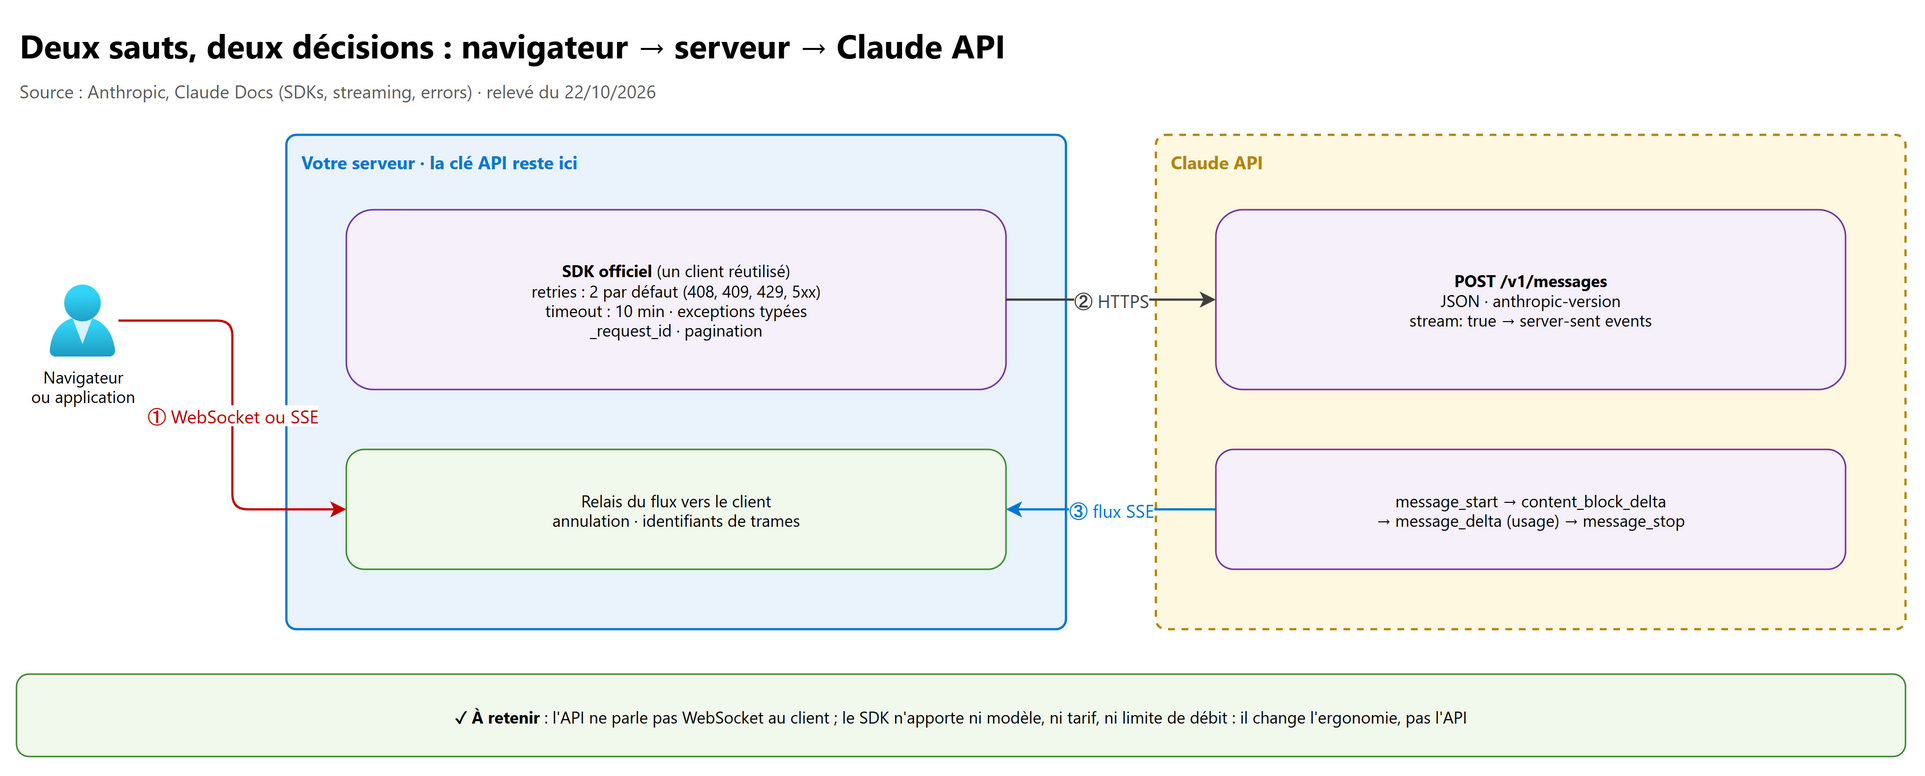
Le guide cite les websockets : ils se placent sur le premier saut, entre le navigateur et votre serveur. La clé API reste sur le serveur, qui appelle Claude en HTTPS et relaie le flux SSE.
| Saut | Protocole | Pourquoi |
|---|---|---|
| ① Navigateur ↔ votre serveur | WebSocket (bidirectionnel : annuler, envoyer un nouveau message pendant le flux) ou SSE (sens unique, plus simple) | Votre choix d'architecture |
| ② Votre serveur → Claude API | HTTPS + JSON, réponse en SSE si stream: true |
Imposé par l'API |
Piège : appeler la Claude API directement depuis le navigateur expose la clé. Le serveur intermédiaire porte la clé, les quotas par utilisateur, la journalisation de
usageet l'annulation.
2.3 Versions, betas et modèles#
anthropic-versionfige l'interface ; une nouvelle version peut retirer des paramètres (exemple :2026-10-21supprimetemperature,top_p,top_k).anthropic-betaactive une fonctionnalité en preview ; elle peut changer ou disparaître. On isole son usage derrière un drapeau de configuration.- L'ID du modèle est un snapshot : changer d'ID, c'est changer de modèle, donc refaire les evals (section 3.4).
- La Models API (
client.models.list()/retrieve) renvoie pour chaque modèlemax_input_tokens,max_tokensetcapabilities: utile pour vérifier une limite par code plutôt qu'en dur.
3. Model Selection and Tradeoffs (skill 5.3)#
3.1 La gamme actuelle#
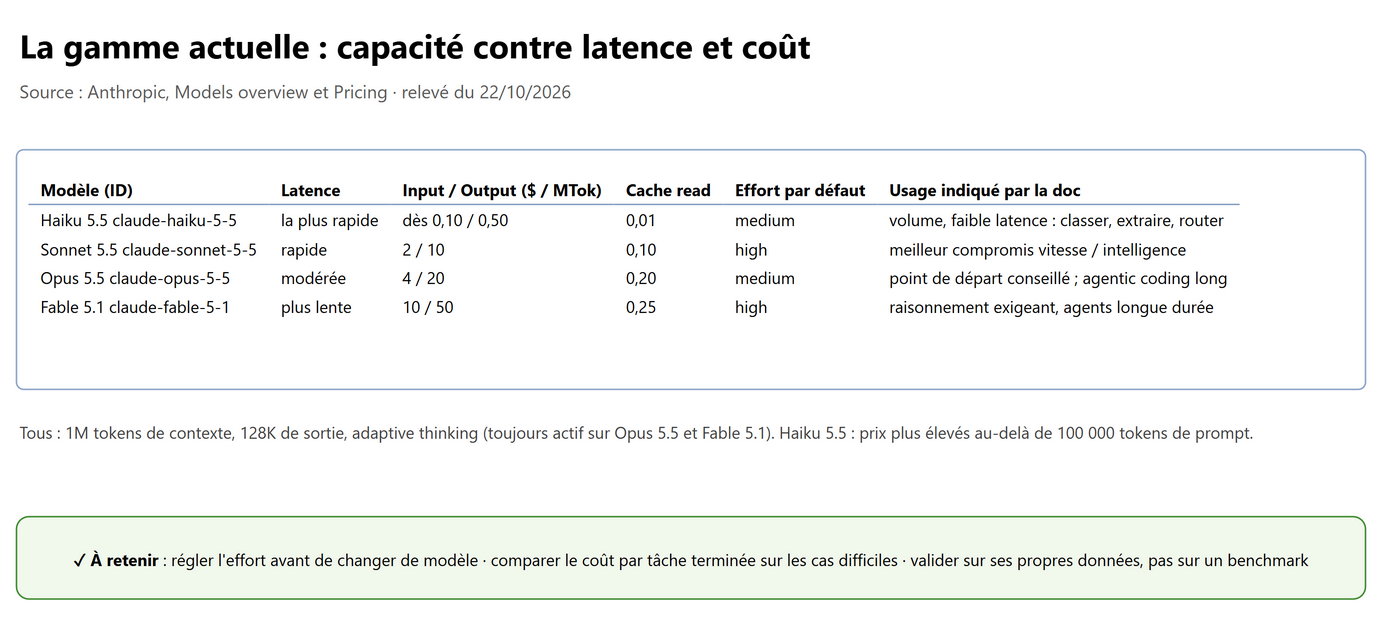
| Modèle | ID | Latence | Prix $ / MTok (entrée / sortie) | Effort par défaut | Pour quoi (doc officielle) |
|---|---|---|---|---|---|
| Haiku 5.5 | claude-haiku-5-5 |
la plus rapide | 0,10 / 0,50 (prompt ≤ 100K) ; 0,50 / 2,50 au-delà | medium |
Volume, temps réel, sous-tâches (classer, extraire, router) |
| Sonnet 5.5 | claude-sonnet-5-5 |
rapide | 2 / 10 | high |
Meilleur compromis vitesse / intelligence |
| Opus 5.5 | claude-opus-5-5 |
modérée | 4 / 20 | medium |
Point de départ recommandé ; agentic coding, tâches longues |
| Fable 5.1 | claude-fable-5-1 |
plus lente | 10 / 50 | high |
Raisonnement le plus exigeant, agents de longue durée |
Points communs : 1M de contexte, 128K de sortie, adaptive thinking, cutoff de connaissances à juin 2026. Le thinking est toujours actif sur Opus 5.5 et Fable 5.1. Les modèles legacy encore servis : Fable 5, Opus 5, Opus 4.8 / 4.7 / 4.6 / 4.5, Sonnet 5, Sonnet 4.6, Haiku 4.5.
Réponse d'examen : le guide oppose Opus (capacité maximale), Sonnet (équilibre) et Haiku (vitesse et volume).
État actuel : Fable 5.1 se place au-dessus d'Opus pour le raisonnement le plus exigeant, et la doc recommande Opus 5.5 comme point de départ. Le raisonnement « capacité / équilibre / vitesse » reste le bon.
3.2 Choisir : effort d'abord, modèle ensuite#
flowchart TD
    A[Tâche + eval sur vos cas réels] --> B[Commencer avec Opus 5.5, effort par défaut]
    B --> C{Qualité atteinte ?}
    C -- oui --> D[Baisser l'effort tant que la qualité tient]
    D --> E{Coût ou latence encore trop hauts ?}
    E -- oui --> F[Essayer Sonnet 5.5 puis Haiku 5.5 sur la même eval]
    E -- non --> G[Garder ce réglage]
    C -- non --> H[Monter l'effort : high, xhigh, max]
    H --> I{Qualité atteinte ?}
    I -- non --> J[Essayer Fable 5.1, revoir le prompt et le contexte]
    I -- oui --> G
    F --> G
Deux stratégies, toutes deux validées sur une eval :
| Stratégie | Démarche | Bon choix quand |
|---|---|---|
| Capacité d'abord | Partir du modèle le plus capable, valider la qualité, puis descendre (effort, puis modèle) | Tâche nouvelle ou difficile, qualité non négociable |
| Efficacité d'abord | Partir du modèle le plus rapide, monter seulement si l'eval échoue | Tâche simple à fort volume (classification, extraction) |
La bonne mesure n'est pas le prix par token mais le coût par tâche terminée : un modèle moins cher qui échoue une fois sur trois, ou qui fait trois tours d'agent de plus, peut coûter plus cher au final. On compare sur les cas difficiles de l'eval, pas sur la moyenne.
3.3 Combiner plusieurs modèles#
| Architecture | Exemple |
|---|---|
| Routage | Haiku 5.5 classe la demande, Sonnet 5.5 ou Opus 5.5 la traite |
| Orchestrator / subagents | Opus 5.5 planifie, des subagents Sonnet 5.5 ou Haiku 5.5 exécutent (chapitre 01) |
| Effort par route | Le même modèle, low pour les FAQ, high pour les cas complexes |
3.4 Cycle de vie et breaking changes#
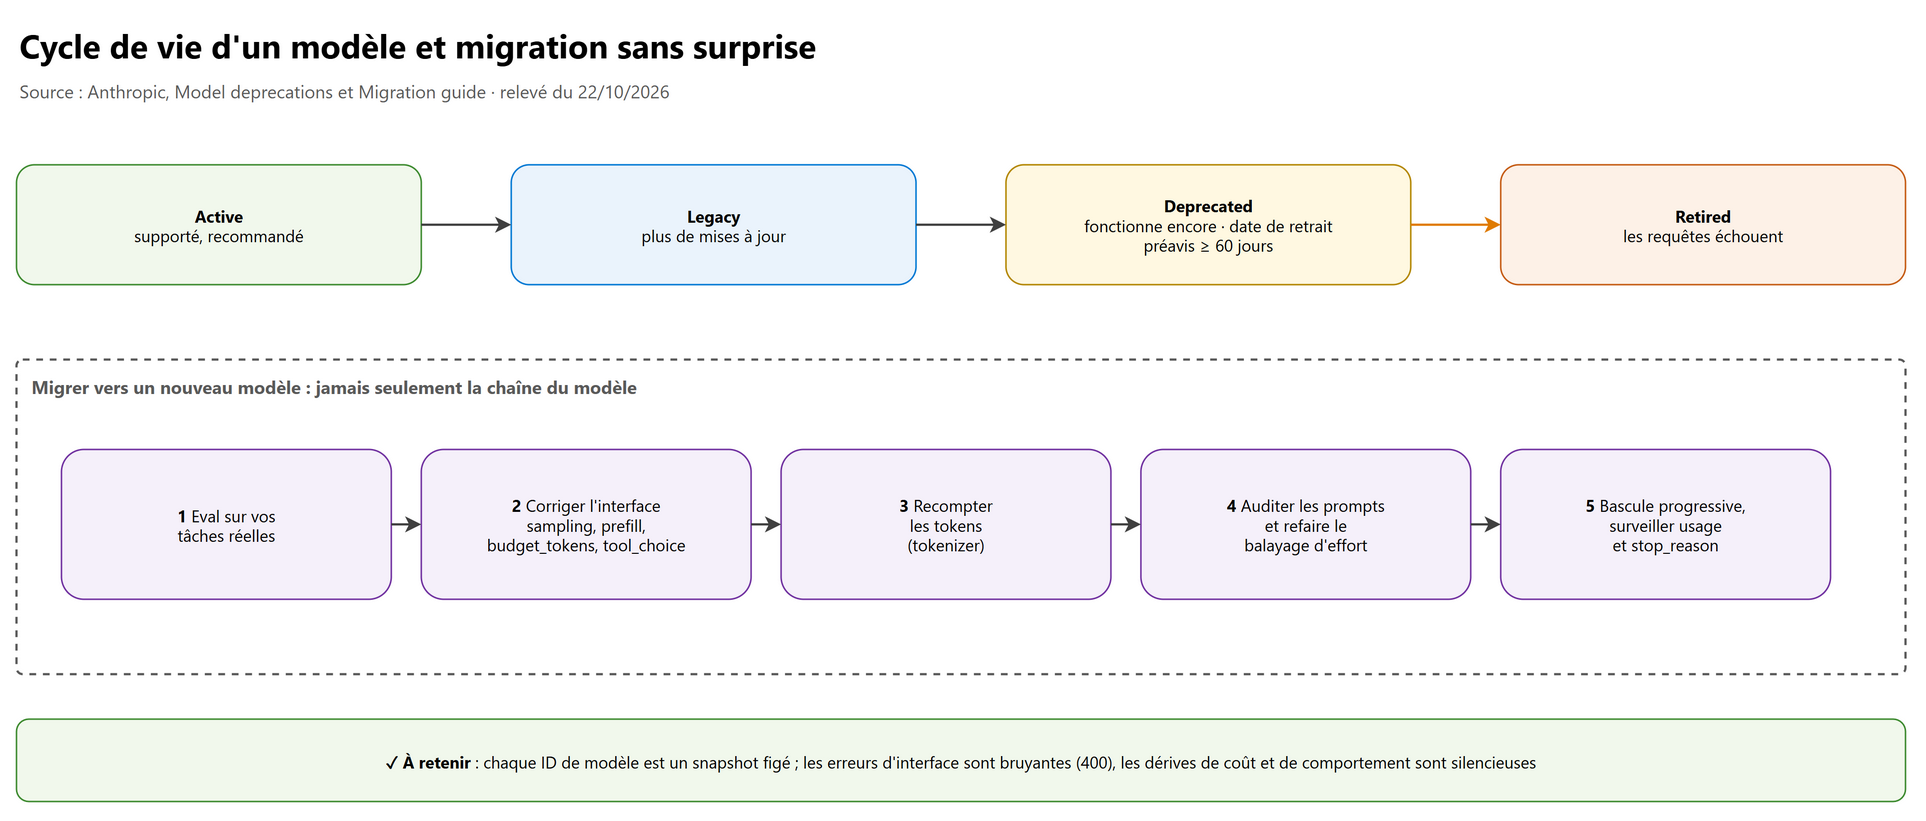
| État | Sens |
|---|---|
| Active | Supporté et recommandé |
| Legacy | Encore servi, plus de mises à jour ; à quitter à terme |
| Deprecated | Fonctionne encore, une date de retrait est annoncée (préavis d'au moins 60 jours) |
| Retired | Les requêtes échouent |
Exemple au 22/10/2026 : Sonnet 4.5 est retiré le 30/11/2026. La page Usage de la Console permet d'exporter un audit des modèles appelés, pour repérer ce qui utilise encore un modèle déprécié.
Les breaking changes récents, à connaître pour l'examen et pour toute migration :
| Changement | Modèles concernés | Correction |
|---|---|---|
budget_tokens rejeté (400) |
Fable 5 / 5.1, Opus 5.5 / 5 / 4.8 / 4.7, Sonnet 5.5, Sonnet 5, Haiku 5.5 | thinking: {type: "adaptive"} + output_config.effort |
| Prefill du message assistant rejeté (400) | Gamme récente | Structured outputs, ou consigne dans le prompt |
tool_choice forcé (any ou tool) rejeté (400) |
Fable 5.1, Mythos 5.1, Opus 5.5, Sonnet 5.5 | auto + consigne claire, ou structured outputs |
thinking: {type: "disabled"} rejeté (400) |
Opus 5.5 ; Sonnet 5.5 (utiliser between_tools) |
Garder le thinking, baisser l'effort |
temperature / top_p / top_k |
400 si non par défaut sur Claude 4.7 et suivants ; supprimés sur tous les modèles en 2026-10-21 |
Retirer les paramètres |
| Nouveau tokenizer | Opus 4.7 et plus récents (≈ 1 à 1,35x plus de tokens) | Recompter les budgets, les limites et les coûts |
| Effort par défaut changé | Opus 5.5 : medium |
Refaire le balayage d'effort, ne pas supposer high |
Les erreurs d'interface sont bruyantes (400 immédiat). Les vrais risques sont silencieux : un coût qui monte avec le
nouveau tokenizer, un comportement qui change avec le nouvel effort par défaut, un prompt écrit pour l'ancien modèle. La
méthode du schéma : eval sur les tâches réelles, correction de l'interface, recomptage des tokens, audit des prompts et
nouveau balayage d'effort, puis bascule progressive en surveillant usage et stop_reason.
4. Cost and Token Management (skill 5.4)#
4.1 Les quatre compteurs et la formule de coût#
Chaque réponse porte un objet usage :
| Compteur | Ce qu'il compte | Prix |
|---|---|---|
input_tokens |
L'entrée après le dernier breakpoint de cache (la partie non cachée) | Tarif d'entrée de base |
cache_creation_input_tokens |
L'entrée écrite dans le cache (détail : cache_creation.ephemeral_5m_input_tokens et ephemeral_1h_input_tokens) |
1,25x (5 min) ou 2x (1 h) |
cache_read_input_tokens |
L'entrée lue depuis le cache | 0,1x en général ; 0,05x sur Opus 5.5 et Sonnet 5.5 ; 0,025x sur Fable 5.1 |
output_tokens |
Toute la sortie, thinking compris | Tarif de sortie (5x l'entrée) |
Entrée totale = cache_read_input_tokens + cache_creation_input_tokens + input_tokens. Un input_tokens très petit ne veut
pas dire une requête bon marché : il faut lire les quatre compteurs.
Tarifs relevés le 22/10/2026 ($ / MTok) :
| Modèle | Entrée | Écriture cache 5 min | Écriture cache 1 h | Lecture cache | Sortie |
|---|---|---|---|---|---|
| Fable 5.1 | 10 | 12,50 | 20 | 0,25 | 50 |
| Opus 5.5 | 4 | 5 | 8 | 0,20 | 20 |
| Sonnet 5.5 | 2 | 2,50 | 4 | 0,10 | 10 |
| Haiku 5.5 (prompt ≤ 100K) | 0,10 | 0,125 | 0,20 | 0,01 | 0,50 |
| Haiku 5.5 (prompt > 100K) | 0,50 | 0,625 | 1 | 0,05 | 2,50 |
Lecture cache = 0,05x l'entrée sur Opus 5.5 et Sonnet 5.5, 0,025x sur Fable 5.1, 0,1x ailleurs : ne pas confondre Sonnet 5.5 (0,10) avec Sonnet 5 (0,20).
Multiplicateurs qui s'ajoutent : Batch API -50 % sur tous les tokens (cache compris, les remises se cumulent) ;
inference_geo: "us" (data residency) 1,1x ; fast mode (section 1.5).
Le contexte long est au prix standard, sauf sur Haiku 5.5.
Modéliser un coût : coût d'une requête = Σ (compteur × tarif) ; coût mensuel = coût moyen par requête × volume, par
fonctionnalité, à partir des usage réels journalisés (pas d'une estimation). Pour un agent, on compte la tâche entière :
tous les tours, tous les résultats d'outils renvoyés.
4.2 Prompt caching#
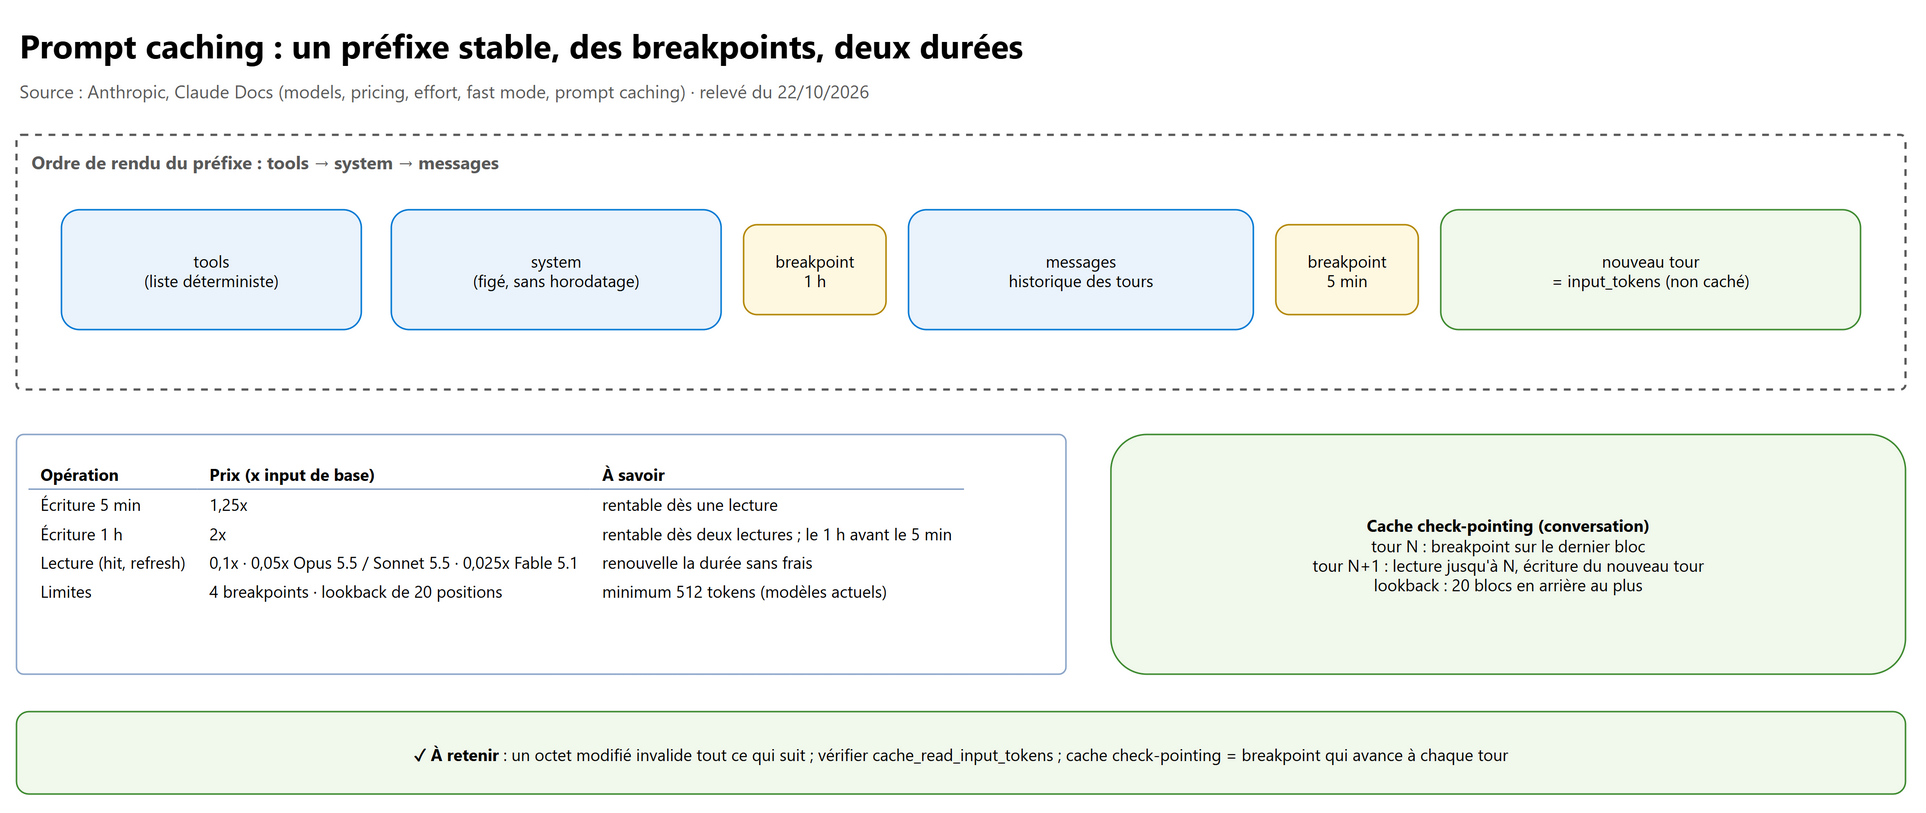
Le cache fonctionne sur le préfixe de la requête, rendu dans l'ordre tools → system → messages. On place un
cache_control sur le dernier bloc d'une partie stable ; tout ce qui précède ce point est mis en cache.
reponse = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    tools=OUTILS,  # liste stable, dans un ordre déterministe
    system=[{
        "type": "text",
        "text": CONSIGNES_ET_DOCUMENTATION,             # gros bloc stable : rien de variable dedans
        "cache_control": {"type": "ephemeral", "ttl": "1h"},
    }],
    messages=historique,                                # la partie qui change
)
u = reponse.usage
print(u.cache_creation_input_tokens, u.cache_read_input_tokens, u.input_tokens)
| Règle | Valeur |
|---|---|
| Breakpoints | 4 au plus par requête (le caching automatique, cache_control au niveau de la requête, en consomme un) |
| Lookback | Le système remonte jusqu'à 20 positions avant un breakpoint pour trouver un hit |
| Taille minimum | 512 tokens (Fable 5 / 5.1, Opus 5.5 / 5, Sonnet 5.5, Haiku 5.5) ; 1 024 (Opus 4.8, Sonnet 5, Sonnet 4.6) ; 2 048 (Opus 4.7) ; 4 096 (Opus 4.6 / 4.5, Haiku 4.5). En dessous : pas de cache, sans erreur |
| Durées | 5 min (défaut, écriture 1,25x) ou 1 h ("ttl": "1h", écriture 2x) ; chaque hit renouvelle la durée |
| Mélange de durées | Les breakpoints 1 h doivent précéder les breakpoints 5 min |
| Rentabilité | 5 min : rentable dès 1 lecture ; 1 h : dès 2 lectures |
| Isolation | Par workspace (Claude API, AWS, Foundry) ; par organisation (Bedrock, Google Cloud) |
Ce qui invalide le cache : tout octet modifié dans le préfixe invalide ce qui suit. Les causes classiques : un horodatage
ou un identifiant de requête dans le system prompt, des outils dans un ordre variable, un JSON sérialisé sans ordre de clés
stable, et les changements de réglages qui touchent le préfixe (outils, web search, citations, speed, tool_choice, images,
thinking, effort au niveau de la requête).
Cache check-pointing. Dans une conversation ou une boucle d'agent, on place le breakpoint sur le dernier bloc du tour courant. Au tour suivant, tout le préfixe jusqu'à ce point est lu depuis le cache et seul le nouveau tour est écrit : le breakpoint « avance » à chaque tour. Le lookback de 20 positions permet de retrouver le point précédent ; au-delà (un tour qui ajoute beaucoup de blocs, par exemple de nombreux résultats d'outils), on ajoute un breakpoint intermédiaire.
sequenceDiagram
    participant App as Application
    participant API as Claude API
    App->>API: tour 1 : tools + system (cache 1 h) + message 1 (breakpoint)
    API-->>App: cache_creation_input_tokens élevé
    App->>API: tour 2 : même préfixe + réponse 1 + message 2 (breakpoint déplacé)
    API-->>App: cache_read élevé, cache_creation = le tour 1 seulement
    App->>API: tour 3 : même préfixe + ... + message 3 (breakpoint déplacé)
    API-->>App: cache_read encore plus élevé, input_tokens faible
Exemple chiffré (Opus 5.5, system prompt de 50 000 tokens, 1 000 requêtes par jour, chacune moins de 5 min après la précédente) :
| Calcul | Coût du system prompt | |
|---|---|---|
| Sans cache | 1 000 × 50 000 × 4 $ / 1M | 200 $ par jour |
| Avec cache 5 min | 1 écriture (50 000 × 5 $ / 1M = 0,25 $) + 999 lectures (999 × 50 000 × 0,20 $ / 1M ≈ 9,99 $) | ≈ 10,24 $ par jour |
Vérification indispensable : cache_read_input_tokens doit être supérieur à 0 à partir de la deuxième requête. Sinon, le
préfixe change d'une requête à l'autre ou il est sous la taille minimum.
4.3 Batch API#
| Fait | Valeur |
|---|---|
| Remise | -50 % sur tous les tokens, cumulable avec le prompt caching |
| Taille d'un lot | 100 000 requêtes ou 256 MB |
| Délai | La plupart finissent en moins d'1 h ; expiration à 24 h |
| Résultats | Gardés 29 jours ; dans un ordre quelconque : on les rapproche par custom_id |
| Cache | TTL 1 h conseillé (les requêtes d'un lot peuvent s'étaler) |
| Incompatible | Fast mode |
Bon usage : tout ce qui n'attend pas une réponse immédiate (évaluations, enrichissement de données, traitements de nuit). Mauvais usage : un chat ou une API synchrone.
4.4 Suivre l'usage#
| Outil | Niveau | Pour quoi |
|---|---|---|
count_tokens |
Une requête, avant | Vérifier une limite, estimer un coût, découper un document |
response.usage |
Une requête, après | Journaliser le coût réel par fonctionnalité et par utilisateur |
| Console (page Usage) | Organisation | Suivi visuel, export d'audit des modèles utilisés |
| Usage and Cost API | Organisation, par code | Tableaux de bord, alertes, refacturation |
La Usage and Cost API demande une clé Admin (sk-ant-admin01-…), non disponible pour les comptes individuels :
| Endpoint | Contenu |
|---|---|
/v1/organizations/usage_report/messages |
Tokens par bucket de 1m, 1h ou 1d, groupés par modèle, workspace, clé API, service_tier, inference_geo, speed… |
/v1/organizations/cost_report |
Coût en USD (montants en cents), bucket 1d seulement |
Les données arrivent en environ 5 minutes ; une interrogation par minute suffit. Le Priority Tier n'apparaît pas dans le cost report ; l'exécution de code n'apparaît que dans le cost report.
4.5 Les leviers, dans l'ordre#
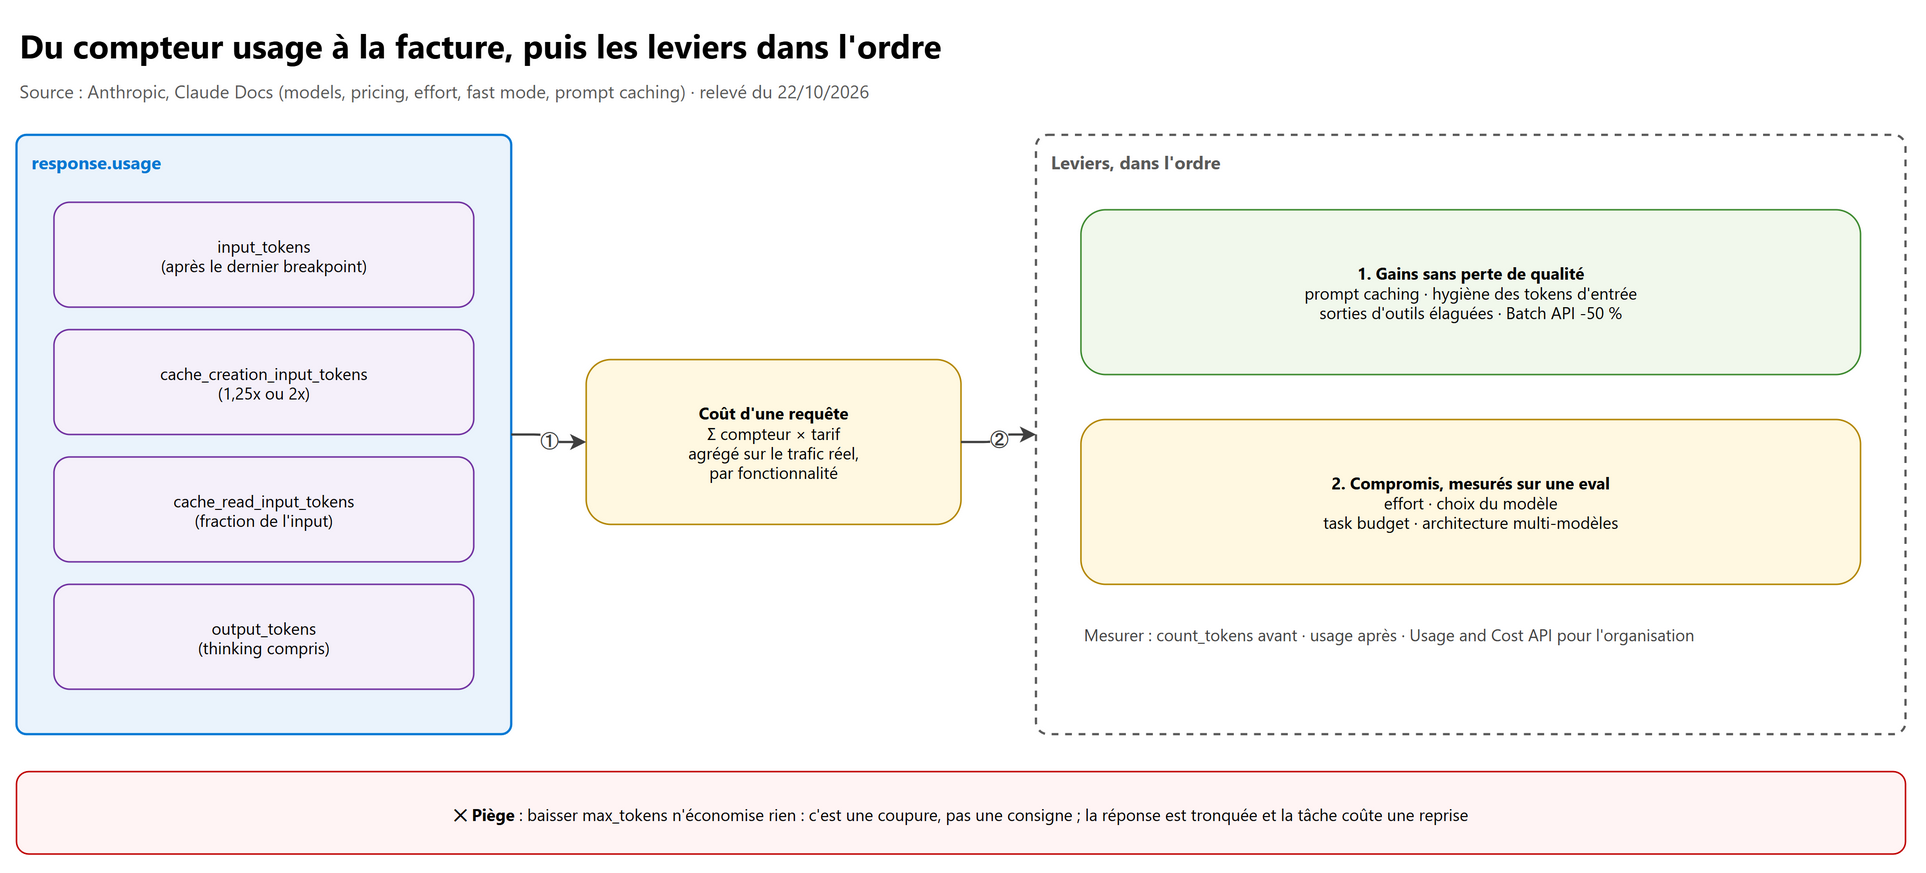
| Ordre | Levier | Effet sur la qualité |
|---|---|---|
| 1 | Prompt caching du préfixe stable | Aucun |
| 2 | Hygiène de l'entrée : contexte pertinent seulement, résultats d'outils élagués, pas de documents en double | Aucun, souvent meilleur (moins de context rot) |
| 3 | Batch API pour le non-urgent | Aucun (seul le délai change) |
| 4 | Effort réglé par route, mesuré sur une eval | À mesurer |
| 5 | Modèle moins cher, ou architecture multi-modèles | À mesurer |
| 6 | Task budget (beta) pour borner un agent | À mesurer |
Piège classique : baisser
max_tokenspour économiser. C'est une coupure, pas une consigne : le modèle ne produit pas une réponse plus courte, elle est tronquée (stop_reason: "max_tokens"), et la reprise coûte plus cher. Pour des réponses plus courtes : la consigne dans le prompt, un format structuré, ou un effort plus bas.
5. Labs conseillés#
Chaque lab coûte quelques centimes sur un workspace de test (count_tokens est gratuit). Clé dans une variable d'environnement,
jamais dans le code.
- Compter avant, mesurer après : même texte passé à
count_tokenssurclaude-haiku-4-5etclaude-opus-5-5; comparer (nouveau tokenizer). Puis unmessages.createet la lecture des quatre compteurs deusage. - Déborder exprès :
max_tokens=50sur une question longue, observerstop_reason: "max_tokens"et la réponse tronquée. - Balayage d'effort : 10 questions de difficulté variée,
low/medium/highsur Sonnet 5.5 ; noteroutput_tokens, la latence et la qualité ; calculer le coût par réponse correcte. - Prompt caching : un system prompt de plus de 512 tokens avec
cache_control, deux requêtes identiques à moins de 5 min ; vérifiercache_creation_input_tokenspuiscache_read_input_tokens. Ajouter un horodatage dans le system prompt et constater le cache miss. - Check-pointing : une conversation de 4 tours avec le breakpoint sur le dernier message ; suivre l'évolution des trois compteurs d'entrée.
- Streaming :
messages.streamavec affichage destext_delta, puisget_final_message().usage. - Batch : un lot de 5 requêtes avec
custom_id, suivreprocessing_status, rapprocher les résultats. - Breaking change : envoyer
thinking: {type: "enabled", budget_tokens: 2000}àclaude-opus-5-5, lire l'erreur 400, corriger enadaptive+effort.
6. Pièges d'examen#
| Piège | La bonne réponse |
|---|---|
| « Le prompt caching agrandit la fenêtre de contexte » | Non : il change le prix, pas la place |
| « On estime les tokens à 4 caractères par token pour la facture » | count_tokens avant, usage après ; tokenizer propre au modèle |
« temperature 0 rend la sortie déterministe » |
Non garanti ; et ces paramètres sont rejetés sur les modèles récents |
« Baisser max_tokens réduit le coût » |
Réponse tronquée et reprise ; raccourcir par la consigne ou l'effort |
| « Le fast mode réduit le délai avant le premier token » | Non : il augmente le débit de sortie (jusqu'à 2,5x), à prix premium |
| « Fast mode + Batch pour aller vite et payer moins » | Incompatibles |
| « Changer de modèle d'abord quand c'est trop cher » | Régler l'effort d'abord, sur une eval |
| « Comparer les modèles au prix par token » | Coût par tâche terminée, sur les cas difficiles |
« budget_tokens sur Opus 5.5 » |
400 : adaptive + effort |
| « Prefill de l'assistant pour forcer un JSON » | 400 sur la gamme récente : structured outputs |
« tool_choice: any pour forcer un outil sur Sonnet 5.5 » |
400 : auto + consigne, ou structured outputs |
« Thinking disabled sur Opus 5.5 pour économiser » |
400 : baisser l'effort |
« Un input_tokens faible = requête pas chère » |
Lire aussi cache_creation et cache_read |
| « Mettre la date du jour en tête du system prompt » | Invalide le cache à chaque requête : la mettre à la fin, hors préfixe caché |
« Un system prompt de 300 tokens avec cache_control » |
Sous le minimum (512) : pas de cache, sans erreur |
| « Le cache 1 h est toujours meilleur » | Écriture 2x : rentable seulement avec au moins 2 lectures |
| « Mélanger 5 min puis 1 h dans le préfixe » | Le 1 h doit précéder le 5 min |
| « Les résultats d'un batch arrivent dans l'ordre » | Ordre quelconque : custom_id |
| « Appeler l'API en WebSocket depuis le navigateur » | L'API diffuse en SSE ; la clé reste sur le serveur, le WebSocket est entre client et serveur |
| « Créer un client SDK par requête » | Un client réutilisé ; retries et timeout réglés une fois |
| « Un nouveau snapshot ne change que la qualité » | Tokenizer, effort par défaut, paramètres retirés : refaire les evals |
7. Scénarios corrigés#
Questions originales, au format de l'examen. Répondez avant de lire la correction.
Q1. Un assistant interne reçoit 20 000 requêtes par jour. Chaque requête envoie le même system prompt de 30 000 tokens
(procédures internes), puis une question courte. La facture est dominée par l'entrée. Que faire en premier ?
A. Passer à Haiku 5.5. B. Mettre le system prompt en cache avec cache_control et vérifier cache_read_input_tokens.
C. Réduire max_tokens. D. Passer en Batch API.
B. Préfixe identique et volume élevé : le prompt caching réduit le coût de ce bloc à 0,05x (Opus 5.5 / Sonnet 5.5) sans toucher à la qualité. A est un compromis à mesurer, C ne touche pas l'entrée, D est inadapté à un assistant interactif.
Q2. Après l'ajout du cache, cache_read_input_tokens reste à 0 à chaque requête. Le system prompt commence par
Nous sommes le {date et heure}. Cause la plus probable ?
A. Le TTL est trop court. B. Le préfixe change à chaque requête. C. Le modèle ne supporte pas le cache. D. Il faut 4 breakpoints.
B. L'heure en tête rend chaque préfixe unique. On la déplace après le breakpoint (dans le message utilisateur).
Q3. Une équipe migre de Sonnet 5 vers Sonnet 5.5. Son code envoie thinking: {type: "enabled", budget_tokens: 4000} et
tool_choice: {type: "any"}. Que se passe-t-il ?
A. Tout fonctionne, les paramètres sont ignorés. B. Erreur 400 ; il faut passer en adaptive + effort et en tool_choice
auto. C. Avertissement dans la réponse. D. Le modèle bascule seul en Sonnet 5.
B. Les deux paramètres sont rejetés sur Sonnet 5.5. Ensuite : recompter les tokens et refaire le balayage d'effort.
Q4. Une tâche d'extraction sur Opus 5.5 donne la qualité voulue mais coûte trop cher. Première action ?
A. Passer à Haiku 5.5 en production. B. Mesurer sur l'eval un effort low, puis seulement ensuite comparer Sonnet 5.5 et
Haiku 5.5 au coût par extraction correcte. C. Baisser max_tokens. D. Activer le fast mode.
B. L'effort d'abord, mesuré ; puis le modèle, au coût par tâche réussie. D augmente le coût.
Q5. Un chat produit des réponses longues ; les utilisateurs trouvent qu'il « met du temps à répondre », bien que la
qualité convienne. Le premier mot arrive vite mais la suite défile lentement. Quelle option ?
A. Fast mode sur Opus 5.5. B. Batch API. C. Baisser max_tokens. D. Thinking disabled.
A. Le TTFT n'est pas le problème, c'est le débit de sortie : le fast mode l'augmente jusqu'à 2,5x (prix premium). B est asynchrone, C tronque, D renvoie 400 sur Opus 5.5.
Q6. Une application monopage (navigateur) doit afficher la réponse de Claude au fil de l'eau et permettre à l'utilisateur
d'annuler. Quelle architecture ?
A. Le navigateur appelle api.anthropic.com avec la clé. B. Le navigateur ouvre un WebSocket vers votre serveur, qui appelle
la Messages API en stream: true et relaie les événements. C. Le serveur appelle l'API sans streaming et renvoie la réponse
entière. D. Le navigateur interroge le serveur toutes les secondes.
B. Clé côté serveur, WebSocket bidirectionnel pour l'annulation, SSE entre le serveur et l'API.
Q7. Une requête contient 990 000 tokens d'entrée avec max_tokens à 64 000 sur un modèle à 1M de contexte. Résultat ?
A. Erreur 400 immédiate. B. La requête est acceptée et la génération peut s'arrêter avec stop_reason: "model_context_window_exceeded". C. Le cache libère de la place. D. L'entrée est tronquée automatiquement.
B. L'entrée seule tient ; c'est la somme qui dépasse. 400 seulement si l'entrée seule dépasse la fenêtre.
Q8. Chaque nuit, 50 000 fiches produits doivent être résumées ; personne n'attend le résultat avant le matin. Le prompt
commun fait 2 000 tokens. Quelle combinaison ?
A. Fast mode + cache. B. Batch API + prompt caching (TTL 1 h), résultats rapprochés par custom_id. C. Appels synchrones en
parallèle. D. Batch API + fast mode.
B. -50 % du Batch, cumulable avec le cache ; TTL 1 h car les requêtes du lot s'étalent. A et D : le fast mode est incompatible avec le Batch et coûte plus.
Q9. Un agent fait 30 tours par tâche, chaque tour renvoyant tout l'historique. Le coût d'entrée croît à chaque tour.
Quelle technique ?
A. Un seul breakpoint figé sur le system prompt. B. Cache check-pointing : breakpoint sur le dernier bloc de chaque tour, et
un breakpoint intermédiaire si un tour ajoute plus de 20 blocs. C. Réduire max_tokens. D. Changer d'ID de modèle à chaque tour.
B. Le breakpoint qui avance fait lire tout l'historique depuis le cache ; A ne cache que le début.
Q10. Un directeur financier veut un tableau de bord quotidien des coûts Claude par workspace. Quelle source ?
A. Additionner usage à la main dans les logs. B. Le cost_report de la Usage and Cost API avec une clé Admin, bucket 1d.
C. count_tokens sur chaque requête. D. La page Pricing.
B. Coûts en USD par jour, groupables par workspace ; A sert au détail par fonctionnalité, C n'est qu'une estimation avant appel.
8. Pour aller plus loin (hors examen)#
- Priority Tier : capacité réservée pour les charges critiques (incompatible avec le fast mode).
- Data residency :
inference_geopour l'inférence aux États-Unis (1,1x). - Effort par message (beta) : changer l'effort en cours de conversation sans casser le cache.
- Migration guide officiel : la liste complète des changements par modèle, à relire à chaque nouvelle version.
- La commande
cost-optimizedu skillclaude-apide Claude Code applique la même méthode : profil de tokens, leviers sans perte d'abord, compromis mesurés ensuite.
9. Fiche à retenir#
- Génération : un token après l'autre ; la latence suit la longueur de sortie ; le streaming réduit la latence perçue.
- Tokens :
count_tokensavant,usageaprès ; tokenizer propre au modèle (Opus 4.7+ : jusqu'à 1,35x plus). - Fenêtre : 1M pour tout (entrée, outils, sortie, thinking) ; entrée seule trop grande = 400 ; entrée +
max_tokens=model_context_window_exceeded; le cache ne libère pas de place. - Sampling : non-déterminisme ;
temperature/top_p/top_kvaleur par défaut seulement sur Claude 4.7 et suivants, et supprimés sur tous les modèles dans l'API2026-10-21. - Thinking :
adaptive+effort;budget_tokens= 400 sur la gamme récente. - Effort :
low→max, agit sur tous les tokens ; défautmedium(Opus 5.5, Haiku 5.5),high(Fable 5.1, Sonnet 5.5). - Fast mode : jusqu'à 2,5x de débit, pas de gain TTFT, prix premium, pas de Batch.
- Shots : zero, single, multi (3 à 5 exemples variés, balisés).
- Technique : SDK = REST JSON + retries (2), timeout (10 min), exceptions typées ; un client réutilisé ; SSE côté API, WebSocket éventuel côté client ; clé sur le serveur.
- Choix : Opus 5.5 pour démarrer ; effort d'abord ; coût par tâche terminée ; Haiku pour le volume, Fable pour l'extrême.
- Breaking changes :
budget_tokens, prefill,tool_choiceforcé, thinkingdisabled, sampling, tokenizer, effort par défaut. - Cache : tools → system → messages ; 4 breakpoints ; lookback 20 ; minimum 512 ; 5 min (1,25x) ou 1 h (2x) ; lecture 0,1x (0,05x Opus 5.5 / Sonnet 5.5, 0,025x Fable 5.1) ; check-pointing = breakpoint qui avance.
- Batch : -50 %, cumulable avec le cache ; 24 h max ;
custom_id. - Suivi : Usage and Cost API, clé Admin,
usage_reportetcost_report. - Jamais : baisser
max_tokenspour économiser.
Références#
Toutes consultées le 22/10/2026.
- Claude Certified Developer – Foundations Exam Guide v1.0 (juillet 2026)
- Models overview
- Pricing
- Model deprecations
- Migration guide
- Context windows
- Adaptive thinking · Extended thinking
- Effort
- Fast mode
- Prompt caching
- Batch processing
- Token counting
- Streaming messages
- Errors · Rate limits · Beta headers
- Usage and Cost API
- Cursus tiers, leçons 5.1 à 5.4 : claudecertificationguide.com/ccdv-f/learn