

Version : 1.1 · Date : 2026-10-21 · Domaine 1 : Agentic Architecture & Orchestration (27 %)
En une phrase : un agent fiable est une boucle pilotée par
stop_reason, un coordinator qui délègue à des subagents en leur passant explicitement le contexte, des règles métier garanties par du code (hooks, prerequisite gates) plutôt que par le prompt, et des sessions qu'on reprend, qu'on bifurque ou qu'on recommence volontairement.
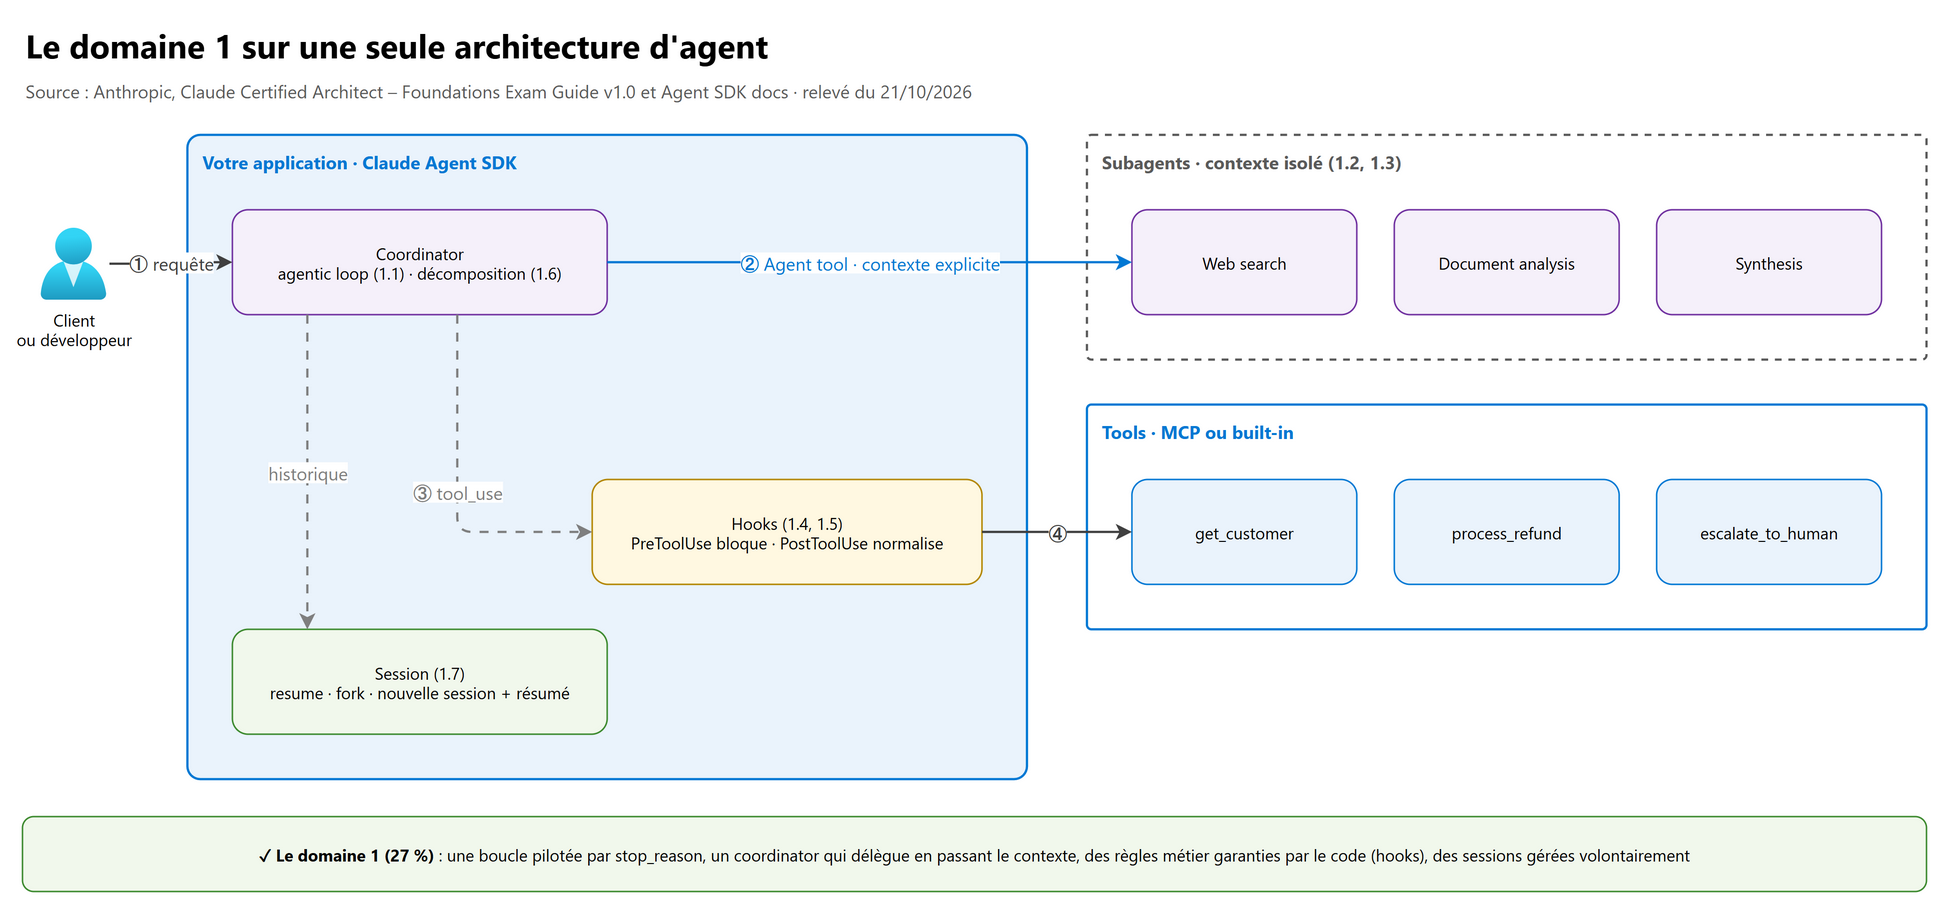
C'est le domaine le plus lourd de l'examen (27 %). Il domine trois des six scénarios officiels : 1 Customer Support Resolution Agent, 3 Multi-Agent Research System et 4 Developer Productivity with Claude (voir 06-scenarios-examen.md).
Ce que l'examen demande#
Texte officiel du guide Claude Certified Architect – Foundations Exam Guide v1.0 (juillet 2026), identique à la version de mars 2026 :
| # | Task statement (guide officiel, en anglais) | Section |
|---|---|---|
| 1.1 | Design and implement agentic loops for autonomous task execution | 1 |
| 1.2 | Orchestrate multi-agent systems with coordinator-subagent patterns | 2 |
| 1.3 | Configure subagent invocation, context passing, and spawning | 3 |
| 1.4 | Implement multi-step workflows with enforcement and handoff patterns | 4 |
| 1.5 | Apply Agent SDK hooks for tool call interception and data normalization | 5 |
| 1.6 | Design task decomposition strategies for complex workflows | 6 |
| 1.7 | Manage session state, resumption, and forking | 7 |
Convention du cours : le produit a évolué depuis le guide v1.0. Quand c'est le cas, un encadré donne d'abord la réponse d'examen (celle du guide, à cocher le jour J), puis l'état actuel du produit (à connaître pour le travail réel).
0. Les bases à maîtriser avant tout#
0.1 Trois façons de faire tourner un agent#
| Claude API (Messages API) | Claude Agent SDK | Claude Code | |
|---|---|---|---|
| Qui écrit la boucle | Vous : messages.create, lecture de stop_reason, exécution des outils |
Le SDK : la même boucle que Claude Code, en bibliothèque | Claude Code lui-même |
| Outils | Ceux que vous définissez (name, description, input_schema) |
Built-in tools (Read, Write, Edit, Bash, Grep, Glob, WebSearch, WebFetch, Agent…) + vos outils (MCP in-process ou serveurs MCP) | Built-in tools + serveurs MCP |
| Subagents, hooks, sessions | À coder vous-même | Fournis (agents, hooks, resume, fork_session) |
Fournis (.claude/agents/, hooks dans settings.json, --resume) |
| Paquets | anthropic (Python), @anthropic-ai/sdk |
claude-agent-sdk (Python), @anthropic-ai/claude-agent-sdk (TypeScript) |
CLI claude |
Retenez une chose : l'API est sans état. Elle ne garde aucune mémoire entre deux appels. Votre code renvoie à chaque fois tout l'historique, résultats d'outils compris. L'Agent SDK le fait pour vous et persiste la conversation sur disque (une session).
0.2 Le vocabulaire#
| Terme | Signification |
|---|---|
| Tool use | Claude ne lance jamais un outil lui-même : il demande un appel (tool_use), votre code l'exécute et renvoie un tool_result |
stop_reason |
Pourquoi Claude a arrêté de générer : tool_use (il attend des résultats d'outils), end_turn (il a fini), et d'autres valeurs (§ 1.4) |
| Turn (SDK) | Un aller-retour : Claude demande des outils, le SDK les exécute, les résultats repartent vers Claude |
| Coordinator | L'agent principal qui décompose, délègue, agrège et gère les erreurs |
| Subagent | Une instance d'agent séparée, avec son propre contexte, lancée par le coordinator via l'outil Agent (« Task » dans le guide) |
| Hook | Votre code, appelé à un point précis de la boucle (avant ou après un outil, à l'arrêt…), qui peut bloquer, réécrire ou compléter |
| Session | La conversation persistée (prompt, appels d'outils, résultats, réponses) qu'on peut reprendre ou bifurquer |
1. Agentic loops (TS 1.1)#
1.1 Le cycle#
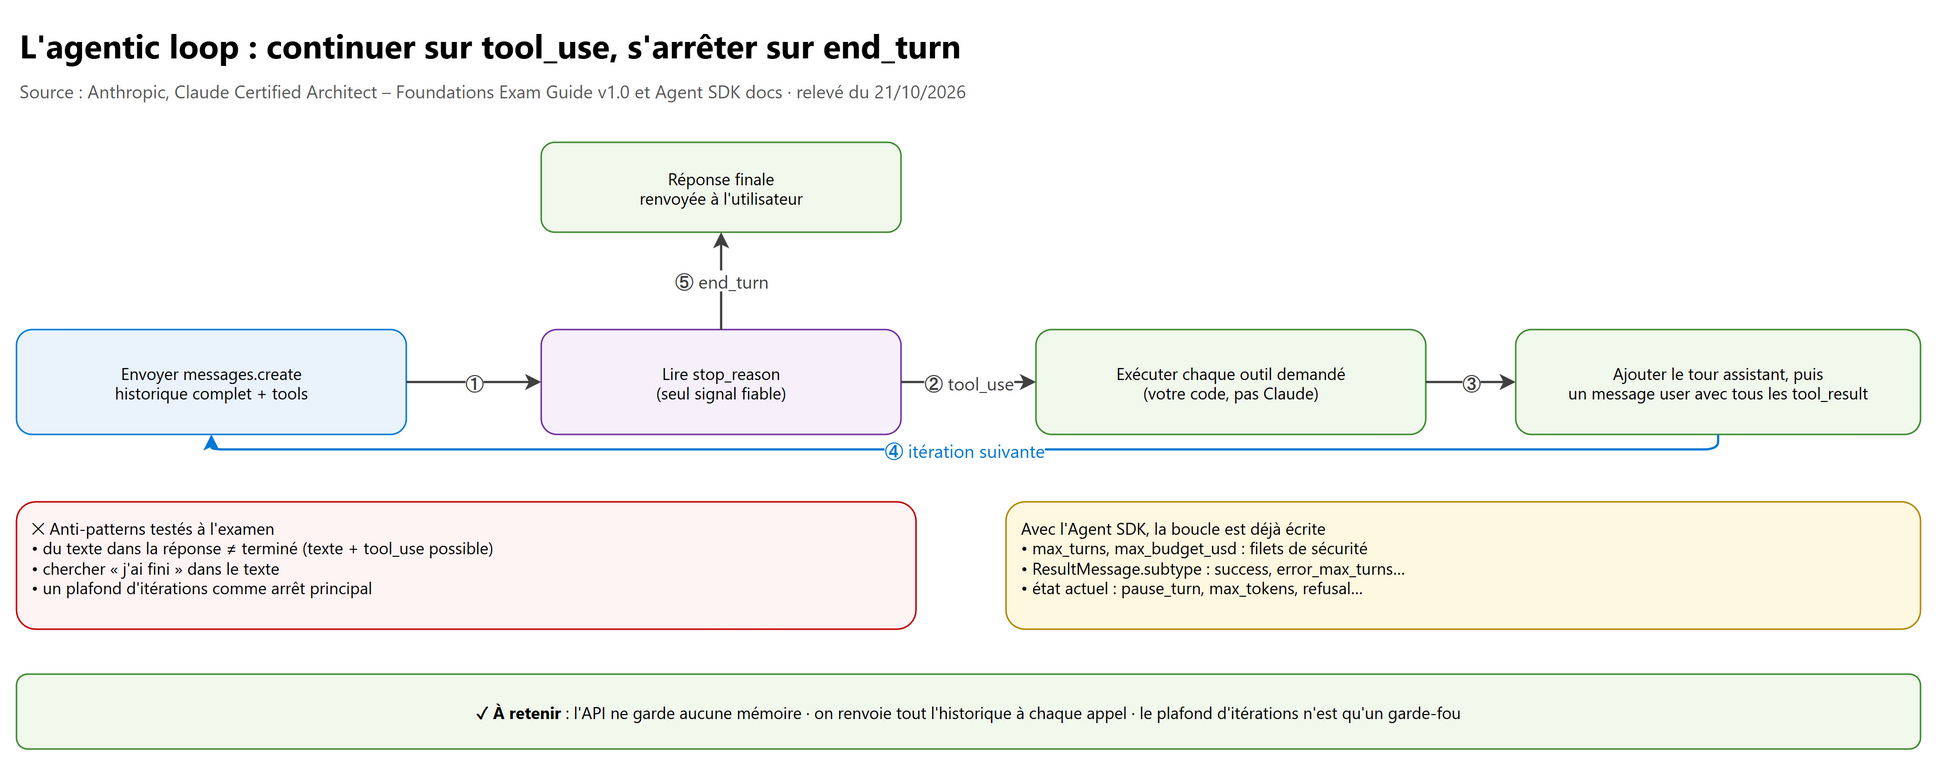
- Envoyer la requête : historique complet + définitions d'outils.
- Lire
stop_reason: c'est le seul signal fiable pour piloter la boucle. - Si
tool_use: exécuter chaque outil demandé (votre code). - Ajouter le tour assistant à l'historique, puis un message
userqui contient untool_resultpartool_use, et recommencer. - Si
end_turn: renvoyer la réponse finale.
sequenceDiagram
    participant App as Votre code
    participant API as Messages API
    participant Tool as Outil (lookup_order)
    App->>API: messages + tools
    API-->>App: stop_reason = tool_use, tool_use lookup_order
    App->>Tool: exécute lookup_order(ORD-1234)
    Tool-->>App: statut et montant
    App->>API: historique + tour assistant + tool_result
    API-->>App: stop_reason = end_turn, texte final
    App-->>App: fin de la boucle
1.2 Le code (Messages API, Python)#
import json
import anthropic

client = anthropic.Anthropic()  # lit la clé dans la variable d'environnement ANTHROPIC_API_KEY

TOOLS = [{
    "name": "lookup_order",
    "description": "Renvoie le statut et le montant d'une commande à partir de son numéro (format ORD-1234). "
                   "À utiliser dès que le client cite une commande.",
    "input_schema": {
        "type": "object",
        "properties": {"order_id": {"type": "string", "description": "Numéro au format ORD-1234"}},
        "required": ["order_id"],
    },
}]


def run_tool(name: str, tool_input: dict) -> dict:
    if name == "lookup_order":
        return {"order_id": tool_input["order_id"], "status": "shipped", "amount": 129.90}  # simulé pour le lab
    raise ValueError(f"outil inconnu : {name}")


def agent(question: str, safety_cap: int = 20):
    messages = [{"role": "user", "content": question}]
    for _ in range(safety_cap):                      # garde-fou contre une boucle folle, pas l'arrêt normal
        response = client.messages.create(model="claude-sonnet-5-5", max_tokens=2048,
                                          tools=TOOLS, messages=messages)
        if response.stop_reason == "end_turn":
            return response                          # arrêt normal
        if response.stop_reason != "tool_use":
            raise RuntimeError(f"arrêt à traiter : {response.stop_reason}")  # max_tokens, refusal… (voir 1.4)
        messages.append({"role": "assistant", "content": response.content})
        results = []
        for block in response.content:               # plusieurs tool_use possibles dans une même réponse
            if block.type != "tool_use":
                continue                             # Claude peut écrire du texte AVANT ses tool_use
            try:
                output = run_tool(block.name, block.input)
                results.append({"type": "tool_result", "tool_use_id": block.id, "content": json.dumps(output)})
            except Exception as exc:                 # l'erreur repart vers Claude au lieu de casser la boucle
                results.append({"type": "tool_result", "tool_use_id": block.id, "content": str(exc), "is_error": True})
        messages.append({"role": "user", "content": results})   # tous les résultats dans UN message user
    raise RuntimeError("garde-fou atteint : boucle anormalement longue")
Règles de format à connaître (doc Handling stop reasons) : un tool_result par tool_use, avec le même tool_use_id ; tous
les résultats d'appels parallèles dans le même message user, juste après le tour assistant ; pas de texte après les
tool_result dans ce message.
1.3 Décision pilotée par le modèle#
Dans une boucle agentique, Claude choisit l'outil suivant selon le contexte (model-driven decision-making), au lieu d'un arbre de décision ou d'une séquence d'outils figée dans le code. C'est ce qui permet de traiter des cas imprévus. Exception : quand une règle doit être respectée à 100 % (argent, sécurité, conformité), on la garantit par du code (§ 4 et 5).
1.4 Les anti-patterns (très testés)#
| Anti-pattern | Pourquoi c'est faux | Bonne pratique |
|---|---|---|
| Tester si la réponse contient du texte pour savoir si c'est fini | Claude écrit souvent « Je regarde votre commande » avant un tool_use : la boucle s'arrête trop tôt |
Lire stop_reason |
| Chercher une phrase (« j'ai terminé ») dans le texte | Formulation ambiguë et variable | Lire stop_reason |
| Un plafond d'itérations comme arrêt principal | Coupe un travail légitime ou boucle pour rien | Arrêt sur end_turn ; le plafond reste un garde-fou |
| Ne pas renvoyer les résultats, ou les remplacer par un résumé pour gagner des jetons | L'API n'a pas de mémoire : Claude ne voit jamais le résultat | Ajouter chaque tool_result ; réduire plutôt ce que l'outil renvoie |
Réponse d'examen : le guide ne cite que
tool_use(continuer) etend_turn(s'arrêter).État actuel : la Messages API renvoie aussi
max_tokens(réponse tronquée : augmenter la limite ou reprendre),stop_sequence,pause_turn(une boucle de server tools a atteint sa limite : renvoyer le contenu pour continuer),refusal(Claude décline, en HTTP 200, détail dansstop_details) etmodel_context_window_exceeded(à traiter comme une troncature). En production : tout ce qui n'est pasend_turnveut dire « pas fini, regarder pourquoi ».
1.5 La même boucle dans l'Agent SDK#
L'Agent SDK exécute la boucle pour vous et émet un flux de messages : SystemMessage (sous-type init), AssistantMessage
(un par bloc de contenu), UserMessage (résultats d'outils), puis un ResultMessage final dont le subtype dit comment la
boucle s'est terminée : success, error_max_turns, error_max_budget_usd, error_during_execution,
error_max_structured_output_retries. Les options max_turns et max_budget_usd sont des filets de sécurité ; une
session arrêtée sur une limite peut être reprise (§ 7).
2. Coordinator-subagent (TS 1.2)#
2.1 Hub-and-spoke#
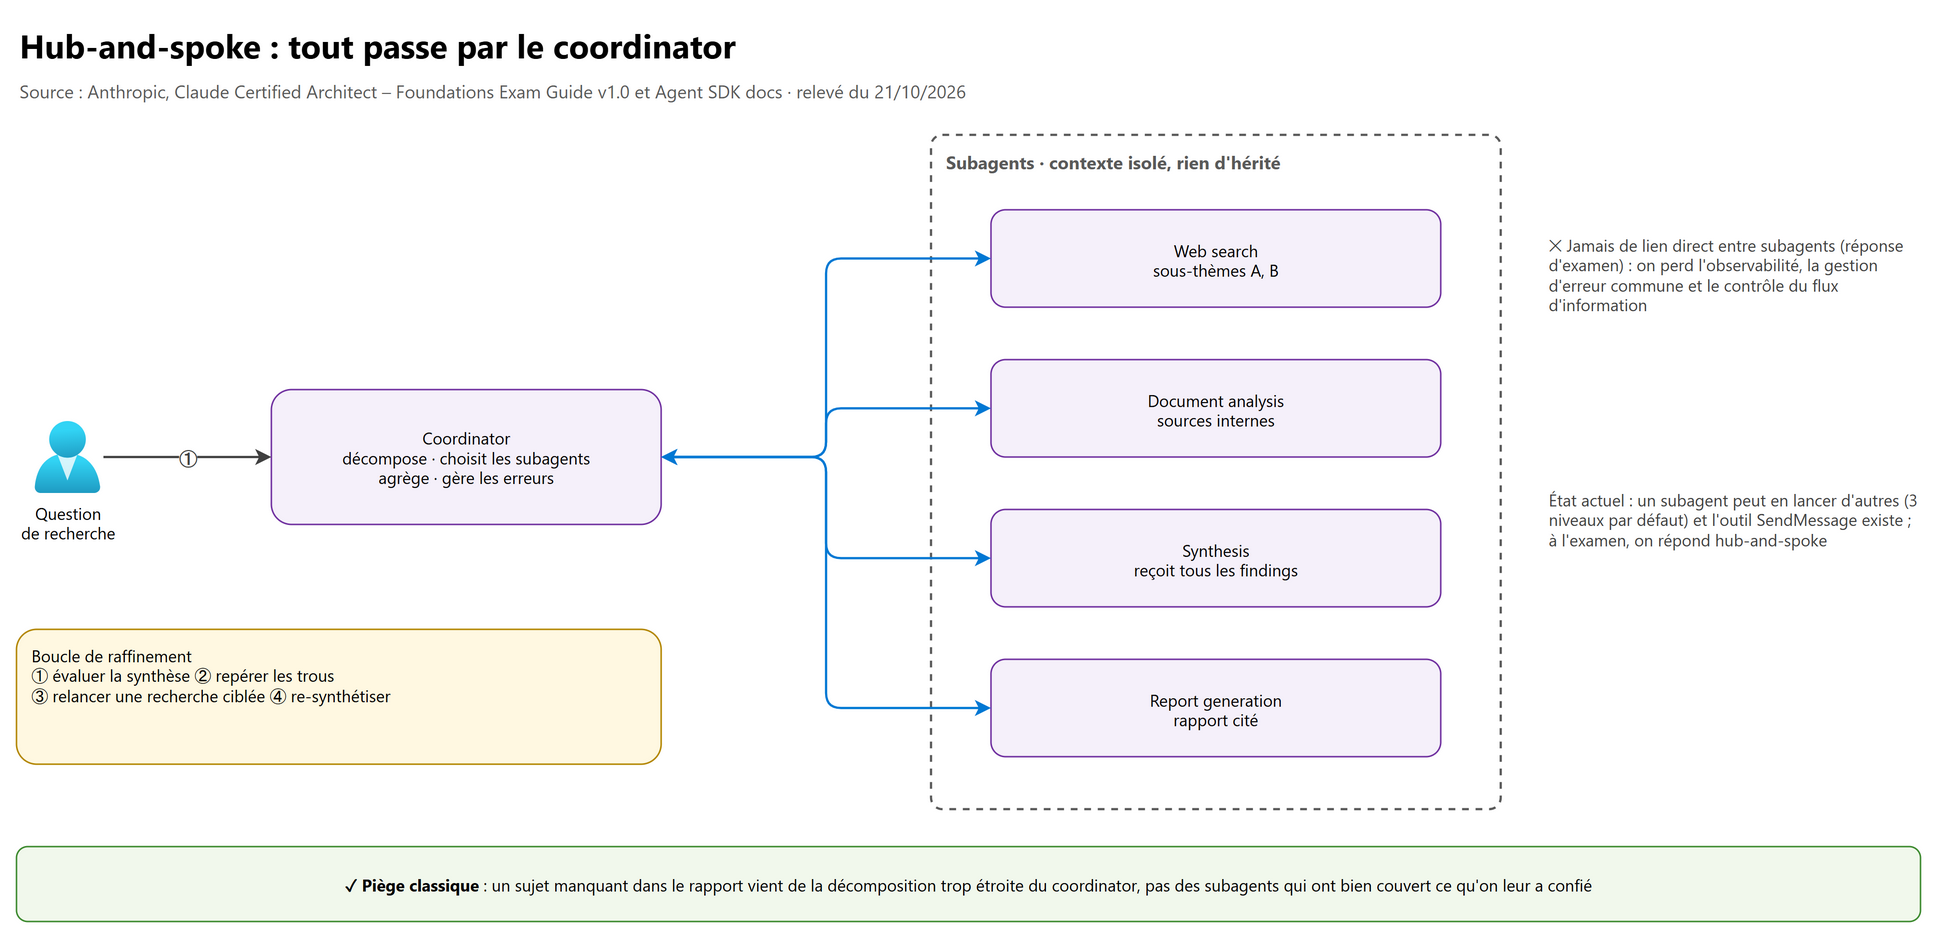
Le coordinator (le hub) reçoit la tâche, la décompose, choisit les subagents, leur passe le contexte, agrège les résultats, gère les erreurs et route l'information. Les subagents (les spokes) reçoivent leurs instructions du coordinator et lui rendent leur résultat. Ils ne se parlent jamais directement : passer par le hub garantit l'observabilité (tout est visible au même endroit), une gestion d'erreur cohérente et un flux d'information contrôlé.
2.2 Le contexte des subagents est isolé#
Un subagent n'hérite pas de l'historique du coordinator, ni de son system prompt, ni des résultats des autres subagents, et deux appels successifs ne partagent aucune mémoire. Il ne voit que ce que le coordinator écrit dans son prompt (§ 3). Avantage : un subagent peut lire des dizaines de fichiers sans encombrer le contexte du coordinator, qui ne reçoit que son rapport final.
2.3 Les quatre responsabilités du coordinator#
| Responsabilité | En pratique |
|---|---|
| Sélection dynamique | Analyser la demande et n'appeler que les subagents utiles : une question factuelle simple n'a pas besoin de toute la chaîne |
| Partition du périmètre | Donner à chaque subagent des sous-thèmes ou des types de sources distincts, pour éviter les doublons |
| Boucle de raffinement | Évaluer la synthèse, repérer les trous, relancer une recherche ciblée, re-synthétiser jusqu'à une couverture suffisante |
| Routage centralisé | Toute communication entre subagents passe par lui |
2.4 Le piège de la décomposition trop étroite#
Un rapport sur « les technologies d'énergie renouvelable » qui ne parle que du solaire et de l'éolien, alors que chaque subagent a parfaitement couvert ce qu'on lui a confié : la cause est la décomposition du coordinator, pas un subagent. Ni un meilleur moteur de recherche, ni un subagent de synthèse plus fort ne rattrapent un sous-thème que personne n'a reçu.
flowchart TD
    Q["Nouvelle demande"] --> A{"Une seule compétence<br/>et peu de contexte ?"}
    A -- Oui --> S["Un seul agent avec ses outils"]
    A -- Non --> B{"Sous-tâches indépendantes<br/>ou contexte volumineux ?"}
    B -- Oui --> M["Coordinator + subagents spécialisés<br/>lancés en parallèle"]
    B -- Non --> C["Un agent, tâche découpée en étapes<br/>(prompt chaining, § 6)"]
    M --> R{"La synthèse couvre<br/>tout le sujet ?"}
    R -- Non --> M
    R -- Oui --> F["Rapport final"]
Réponse d'examen : hub-and-spoke strict, pas de communication directe entre subagents.
État actuel : un subagent peut lancer ses propres subagents (3 niveaux par défaut,
CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH), et un outilSendMessagepermet d'écrire à d'autres agents nommés de la session. Pour des orchestrations de dizaines d'agents, la doc oriente vers les dynamic workflows (outilWorkflow, SDK TypeScript). À l'examen, on répond hub-and-spoke.
3. Invoquer les subagents et leur passer le contexte (TS 1.3)#
3.1 Le mécanisme#
Le coordinator lance un subagent avec l'outil Task (nom du guide), qui doit figurer dans ses allowedTools. Chaque type de
subagent est décrit par un AgentDefinition :
| Champ | Obligatoire | Rôle |
|---|---|---|
description |
Oui | Quand l'utiliser : c'est ce que lit le coordinator pour choisir (comme la description d'un outil) |
prompt |
Oui | Son system prompt : rôle, expertise, contraintes, format de sortie |
tools |
Non | Liste des outils autorisés ; omis = hérite des outils disponibles. Ex. relecteur en lecture seule : Read, Grep, Glob |
disallowedTools, model, skills, mcpServers, maxTurns, background, effort, permissionMode |
Non | Réglages fins (état actuel) |
import asyncio
from claude_agent_sdk import query, ClaudeAgentOptions, AgentDefinition, ResultMessage

AGENTS = {
    "web-researcher": AgentDefinition(
        description="Recherche web sur UN sous-thème précis. À utiliser pour des sources publiques récentes.",
        prompt="Tu cherches des sources fiables sur le sous-thème fourni. Rends une liste JSON de findings : "
               "claim, source_url, published_at, confidence. N'invente aucune source.",
        tools=["WebSearch", "WebFetch"],
    ),
    "doc-analyst": AgentDefinition(
        description="Analyse les documents internes du dossier ./corpus. À utiliser pour les sources internes.",
        prompt="Tu extrais les constats utiles des documents. Rends des findings : claim, document_name, page_number, confidence.",
        tools=["Read", "Grep", "Glob"],                           # lecture seule
    ),
    "synthesizer": AgentDefinition(
        description="Rédige la synthèse à partir des findings fournis dans le prompt. Ne cherche rien lui-même.",
        prompt="Rédige une synthèse où chaque affirmation garde sa source. Signale les contradictions entre sources.",
        tools=["Read"],
    ),
}

COORDINATOR = ("Tu coordonnes une recherche. Objectif : un rapport complet et sourcé. Couvre TOUS les sous-thèmes du sujet. "
               "Lance web-researcher et doc-analyst en parallèle, puis passe-leur résultats COMPLETS, métadonnées comprises, "
               "à synthesizer. Si la synthèse laisse un trou, relance une recherche ciblée.")


async def main():
    options = ClaudeAgentOptions(
        system_prompt=COORDINATOR,
        allowed_tools=["Agent", "WebSearch", "WebFetch", "Read", "Grep", "Glob"],   # "Agent" : lancer des subagents
        agents=AGENTS,
        max_budget_usd=2.0,                                      # garde-fou de coût, subagents compris
    )
    try:
        async for message in query(prompt="Les technologies d'énergie renouvelable en 2026", options=options):
            if isinstance(message, ResultMessage):
                print(message.subtype, message.total_cost_usd)
                if message.subtype == "success":
                    print(message.result)
    except Exception as error:                                   # query() lève après un résultat en erreur
        print(f"Session terminée en erreur : {error}")


asyncio.run(main())
3.2 Les quatre règles du passage de contexte#
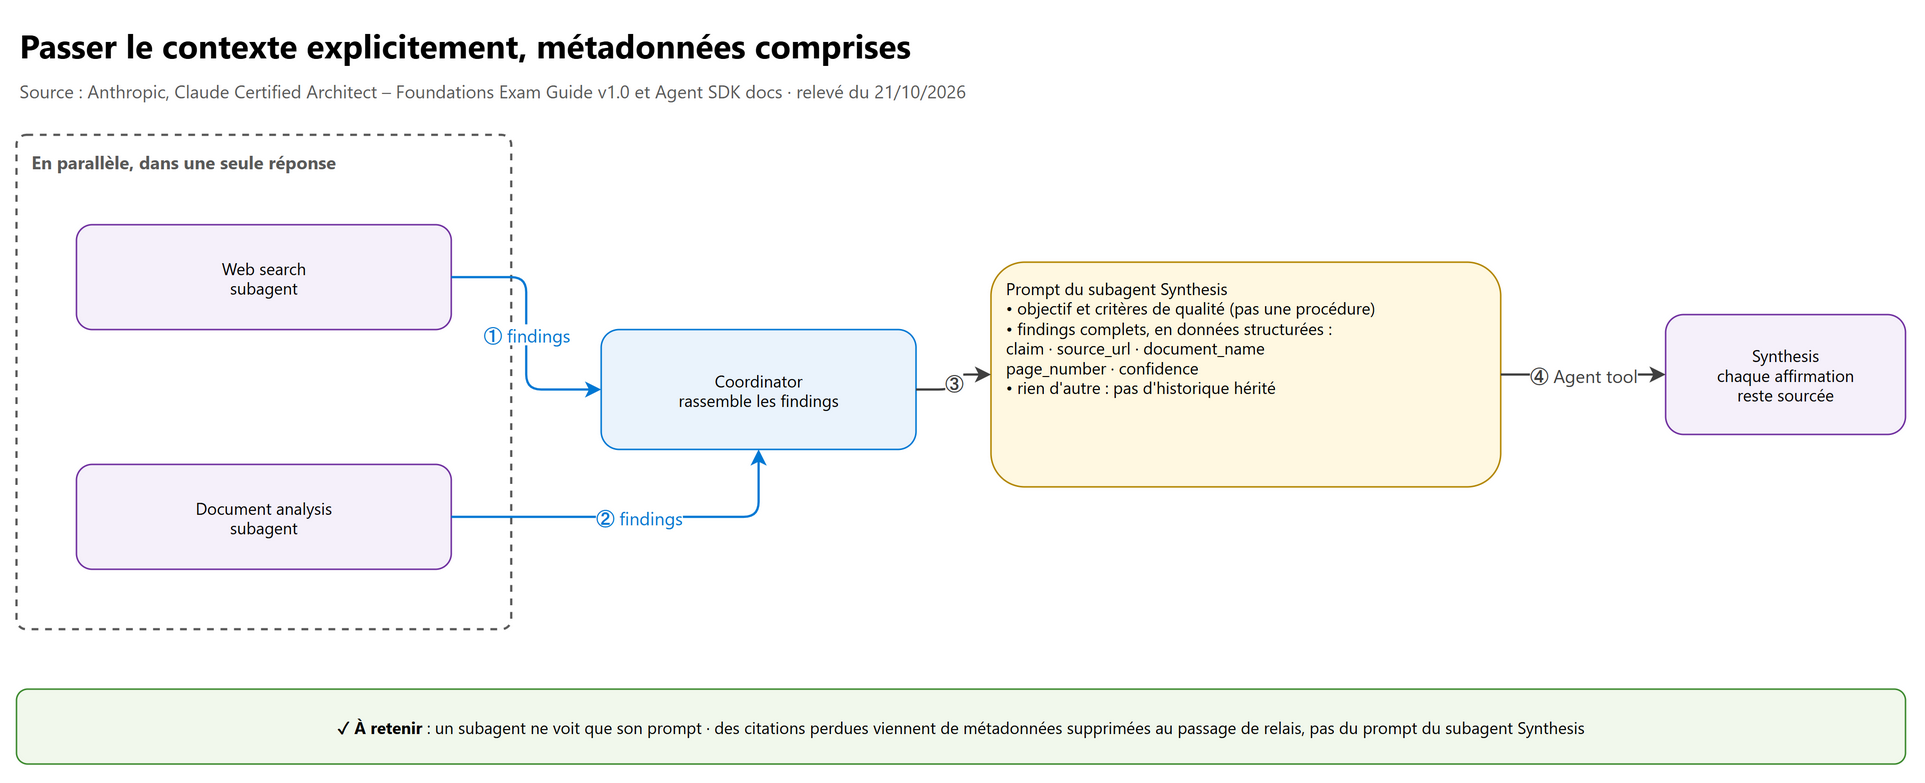
Passer les résultats complets des agents précédents dans le prompt du suivant : le prompt est sa seule entrée.
Séparer contenu et métadonnées dans un format structuré, pour garder l'attribution :
{"findings": [
  {"claim": "La capacité géothermique installée a progressé en 2025.",
   "source_url": "https://exemple.org/rapport-2026", "document_name": null, "page_number": null,
   "confidence": "medium", "retrieved_by": "web-researcher"}
]}
Lancer en parallèle les subagents indépendants : plusieurs appels Task dans une seule réponse du coordinator, pas un par tour (latence inutile).
Donner au subagent des objectifs et des critères de qualité, pas une procédure pas à pas : il doit pouvoir s'adapter.
Diagnostic type : la synthèse a perdu ses citations alors que les subagents amont renvoient des sources correctes → les métadonnées ont été supprimées au passage de relais par le coordinator. Le prompt du subagent de synthèse n'y est pour rien.
3.3 Le fork#
Un fork part d'une base d'analyse commune pour explorer des approches divergentes (par exemple deux stratégies de
refactoring), sans que l'une influence l'autre. Voir § 7 pour fork_session.
Réponse d'examen : outil Task,
allowedToolsdoit contenir"Task", contexte isolé, fork pour explorer.État actuel (doc Agent SDK Subagents) :
- l'outil s'appelle
Agent:tool_use.namevaut"Agent"depuis Claude Code v2.1.63 (il apparaît encore sous"Task"dans la listesystem:init) ; on met"Agent"dansallowed_tools. Pour détecter un subagent, tester les deux noms et lireparent_tool_use_idsur les messages émis depuis le subagent ;allowed_toolspré-approuve les outils listés ; un outil absent reste disponible mais passe par le flux de permissions (refusé dans une exécution sans surveillance) ;- un subagent tourne en arrière-plan par défaut (
status: "async_launched") ; Claude attend quand il a besoin du rapport ;- un fork subagent (
subagent_type: "fork") copie la conversation au lieu de repartir de zéro ;- limites : profondeur 3, 20 subagents simultanés par défaut,
max_budget_usdcompte les subagents ;- les agents peuvent aussi être définis en fichiers Markdown dans
.claude/agents/(chapitre 03).
4. Enforcement et handoff (TS 1.4)#
4.1 Prompt ou code#
| Guidance par prompt | Enforcement programmatique | |
|---|---|---|
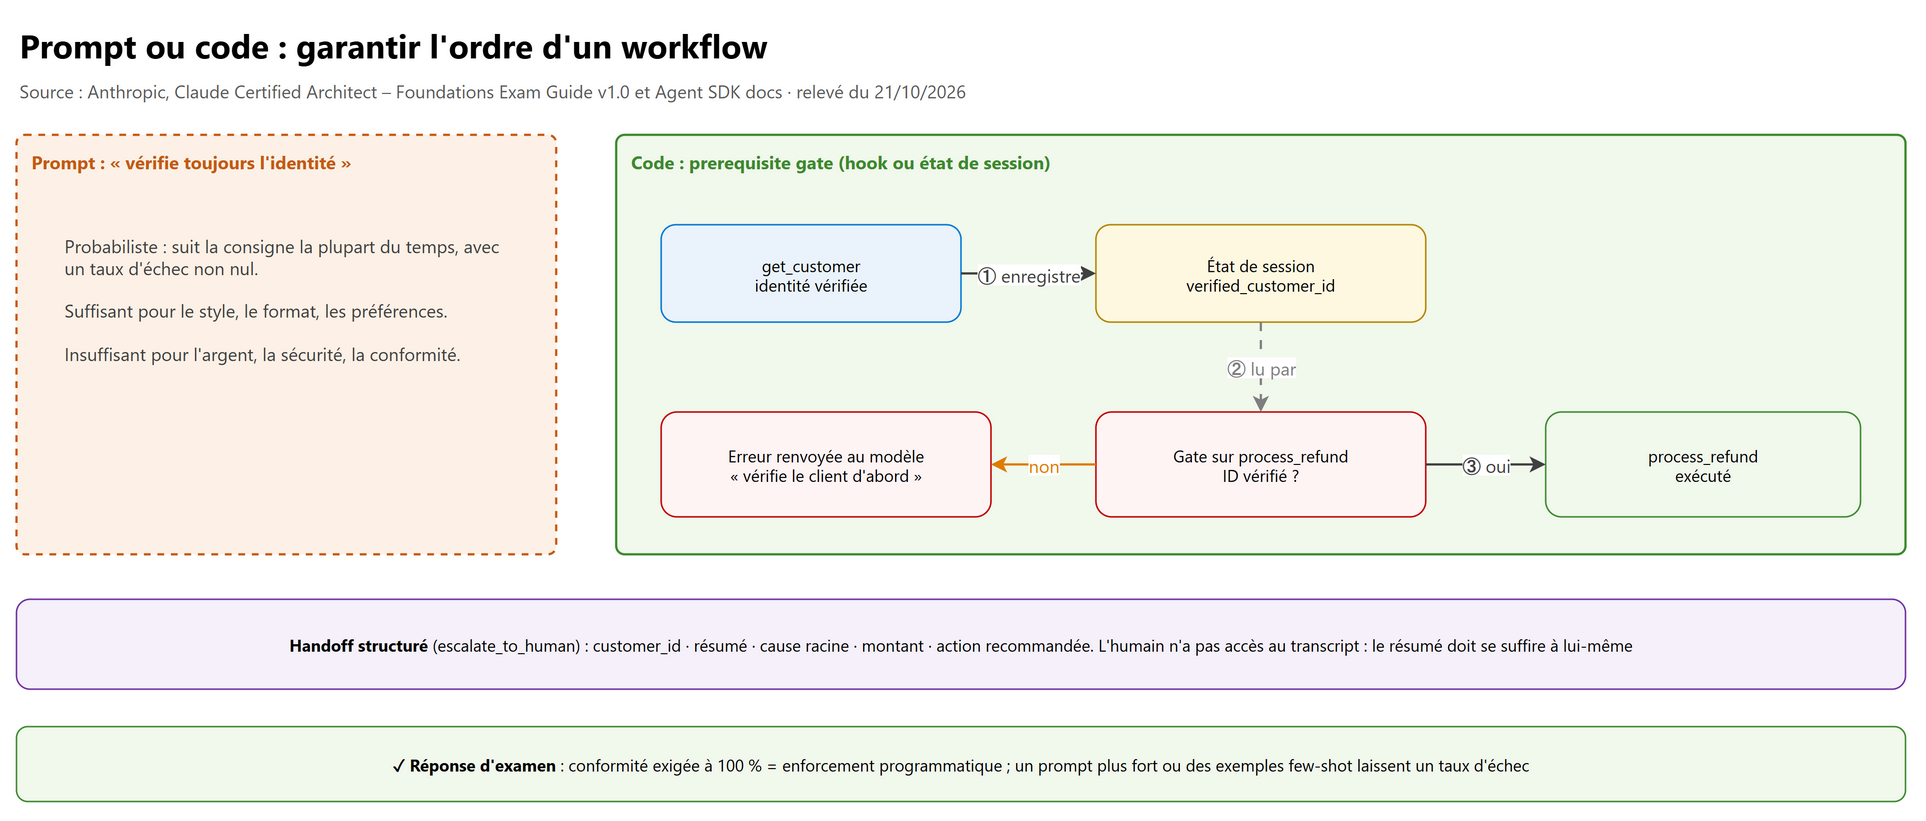
| Mécanisme | Une consigne dans le system prompt (« vérifie toujours l'identité avant un remboursement ») | Un hook ou une prerequisite gate qui bloque l'outil aval tant que l'étape amont n'a pas réussi |
| Garantie | Probabiliste : suivi la plupart du temps, avec un taux d'échec non nul | Déterministe : le mauvais ordre est physiquement impossible |
| Pour | Style, format, préférences | Argent, sécurité, conformité, identité |
Exemple d'examen : malgré la consigne « vérifie le client avant tout remboursement », l'agent rembourse sans vérification dans
une petite part des cas. La correction n'est ni un prompt plus fort, ni des exemples few-shot, ni un classifieur de routage :
c'est une gate qui bloque process_refund tant que get_customer n'a pas renvoyé un ID vérifié.
4.2 Une prerequisite gate dans l'outil lui-même#
from typing import Any
from claude_agent_sdk import tool, create_sdk_mcp_server

SESSION_STATE = {"verified_customer_id": None}   # état de la conversation en cours (une instance par session en production)


@tool("get_customer", "Vérifie l'identité du client (e-mail + code reçu) et renvoie son customer_id.",
      {"email": str, "verification_code": str})
async def get_customer(args: dict[str, Any]) -> dict[str, Any]:
    customer_id = "C-1042"                       # simulé : appel au CRM en production
    SESSION_STATE["verified_customer_id"] = customer_id
    return {"content": [{"type": "text", "text": f'{{"customer_id": "{customer_id}", "verified": true}}'}]}


@tool("process_refund", "Rembourse une commande d'un client déjà vérifié par get_customer.",
      {"customer_id": str, "order_id": str, "amount": float})
async def process_refund(args: dict[str, Any]) -> dict[str, Any]:
    if SESSION_STATE["verified_customer_id"] != args["customer_id"]:      # la gate : déterministe
        return {"content": [{"type": "text", "text": "Refusé : appelle d'abord get_customer pour vérifier ce client."}],
                "is_error": True}
    return {"content": [{"type": "text", "text": f"Remboursement de {args['amount']} USD effectué."}]}


support_server = create_sdk_mcp_server(name="support", version="1.0.0", tools=[get_customer, process_refund])
# options : mcp_servers={"support": support_server}, allowed_tools=["mcp__support__get_customer", "mcp__support__process_refund"]
La même règle peut vivre dans un hook PreToolUse (§ 5) : c'est l'option à privilégier quand l'outil vient d'un serveur MCP
que vous ne modifiez pas.
4.3 Demandes à plusieurs sujets#
« Je veux retourner ce canapé, contester une facture et changer mon adresse » : décomposer en trois items, enquêter sur chacun en parallèle avec un contexte partagé (le compte client), puis répondre une seule fois avec une résolution unifiée. Traiter les sujets un par un, en plusieurs réponses, est la mauvaise réponse.
4.4 Le handoff structuré#
Quand l'agent escalade (escalate_to_human), l'humain n'a pas accès au transcript. Le résumé doit donc se suffire à
lui-même :
{"customer_id": "C-1042",
 "summary": "Demande de remboursement d'une table livrée abîmée, commande ORD-1234.",
 "root_cause": "Montant (900 USD) au-dessus du plafond automatique de 500 USD.",
 "refund_amount": 900.00,
 "recommended_action": "Valider le remboursement intégral après photo du dommage, déjà fournie par le client."}
5. Agent SDK hooks (TS 1.5)#
5.1 Deux directions, deux usages#
| Hook | Quand | Ce qu'il peut faire | Usage d'examen |
|---|---|---|---|
PreToolUse |
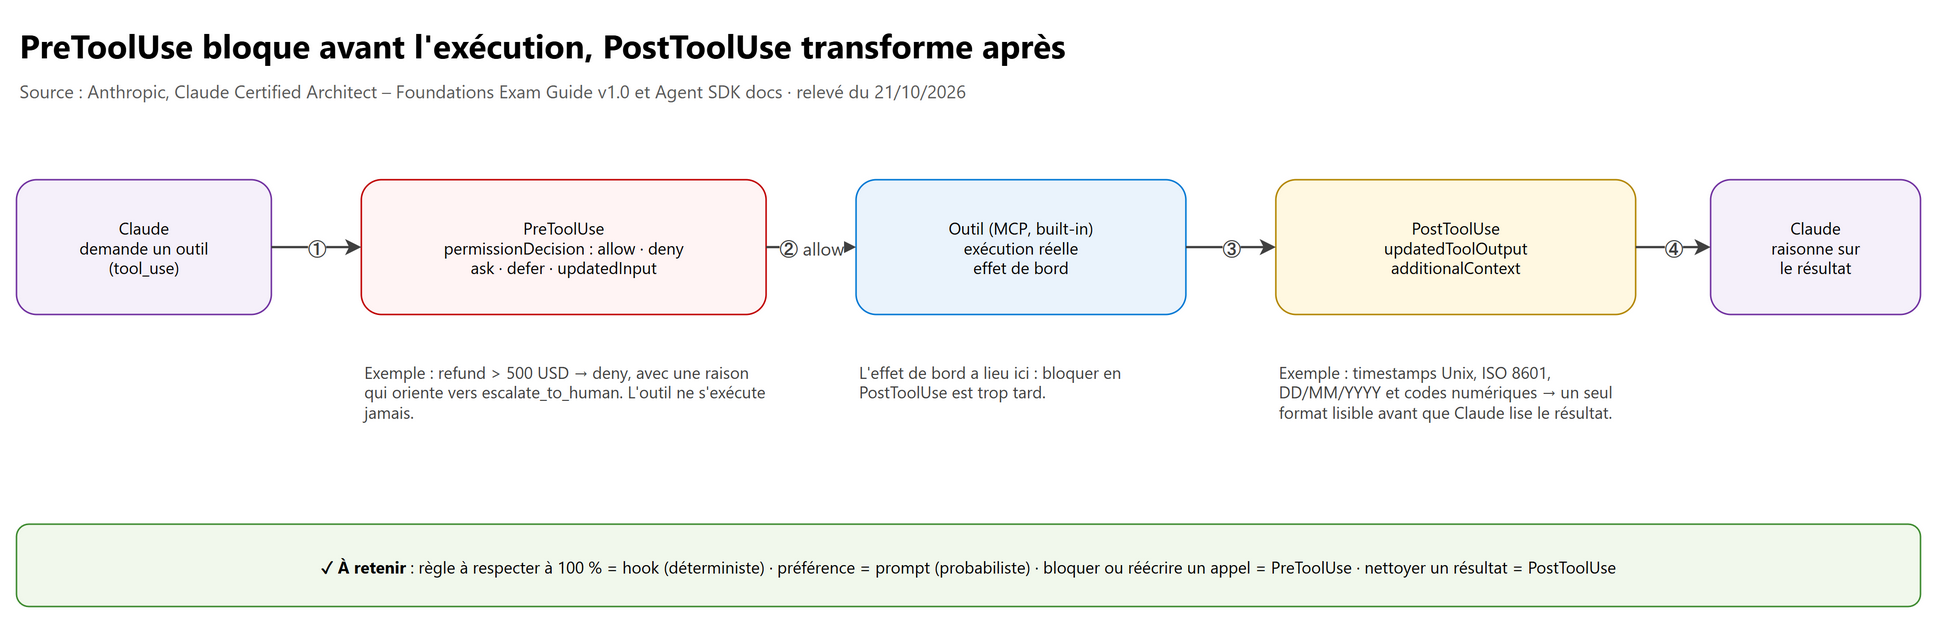
Avant l'exécution de l'outil | permissionDecision : allow, deny, ask, defer ; permissionDecisionReason (ce que lit Claude) ; updatedInput (réécrire les arguments) |
Bloquer une action contraire à la politique (remboursement > 500 USD) et rediriger vers l'escalade |
PostToolUse |
Après l'exécution, avant que Claude lise le résultat | updatedToolOutput (remplacer le résultat), additionalContext (ajouter une note) |
Normaliser des formats hétérogènes (timestamps Unix, ISO 8601, DD/MM/YYYY, codes numériques) |
Bloquer en PostToolUse est trop tard : l'effet de bord a déjà eu lieu. Nettoyer un résultat en PreToolUse est
impossible : le hook ne voit que l'appel sortant.
5.2 Le code (Python)#
from datetime import datetime, timezone
from claude_agent_sdk import ClaudeAgentOptions, ClaudeSDKClient, HookMatcher

REFUND_LIMIT = 500


async def block_large_refunds(input_data, tool_use_id, context):
    amount = float(input_data["tool_input"].get("amount", 0))
    if amount > REFUND_LIMIT:
        return {"hookSpecificOutput": {
            "hookEventName": input_data["hook_event_name"],
            "permissionDecision": "deny",
            "permissionDecisionReason": f"Remboursement de {amount} USD au-dessus de {REFUND_LIMIT} USD : "
                                        "appelle escalate_to_human avec un résumé structuré.",
        }}
    return {}                                     # {} = laisser passer


def to_iso(value):
    """Convertit un timestamp Unix (int) en ISO 8601 ; laisse le reste tel quel."""
    return datetime.fromtimestamp(value, tz=timezone.utc).isoformat() if isinstance(value, int) else value


async def normalize_customer(input_data, tool_use_id, context):
    raw = input_data["tool_response"]             # la forme exacte dépend de l'outil : renvoyer la même forme
    # … parser raw, convertir created_at avec to_iso() et le code statut en libellé, reconstruire normalized …
    normalized = raw
    return {"hookSpecificOutput": {"hookEventName": "PostToolUse", "updatedToolOutput": normalized}}


options = ClaudeAgentOptions(hooks={
    "PreToolUse": [HookMatcher(matcher="mcp__support__process_refund", hooks=[block_large_refunds])],
    "PostToolUse": [HookMatcher(matcher="mcp__support__get_customer", hooks=[normalize_customer])],
})
# async with ClaudeSDKClient(options=options) as client: await client.query(...)
Points de syntaxe : le matcher filtre sur le nom de l'outil (Write|Edit, ^mcp__, mcp__<server>__<tool>), jamais sur
ses arguments (on teste tool_input dans le callback) ; le callback reçoit (input_data, tool_use_id, context) ; quand
plusieurs hooks répondent, deny l'emporte sur defer, puis ask, puis allow.
5.3 La règle de décision#
| Exigence | Mécanisme |
|---|---|
| Doit être respectée à 100 % (une seule erreur coûte de l'argent ou crée un risque légal) | Hook (déterministe) |
| Préférée, une déviation occasionnelle est acceptable | Prompt (probabiliste) |
Réponse d'examen :
PostToolUsepour transformer, interception des appels (PreToolUse) pour bloquer, hooks pour les garanties déterministes.État actuel : l'Agent SDK expose bien d'autres événements (
PostToolUseFailure,Stop,SubagentStart,SubagentStop,PreCompact,UserPromptSubmit,PermissionRequest,Notification… ; plusieurs sont propres au SDK TypeScript).updatedToolOutputfonctionne pour tous les outils ; l'ancienupdatedMCPToolOutputne vise que les outils MCP. Un hookPreToolUsequi dépasse son délai bloque l'appel. Les hooks tournent dans votre processus : ils ne consomment pas de contexte.
6. Décomposer une tâche complexe (TS 1.6)#
| Prompt chaining (pipeline fixe) | Décomposition dynamique | |
|---|---|---|
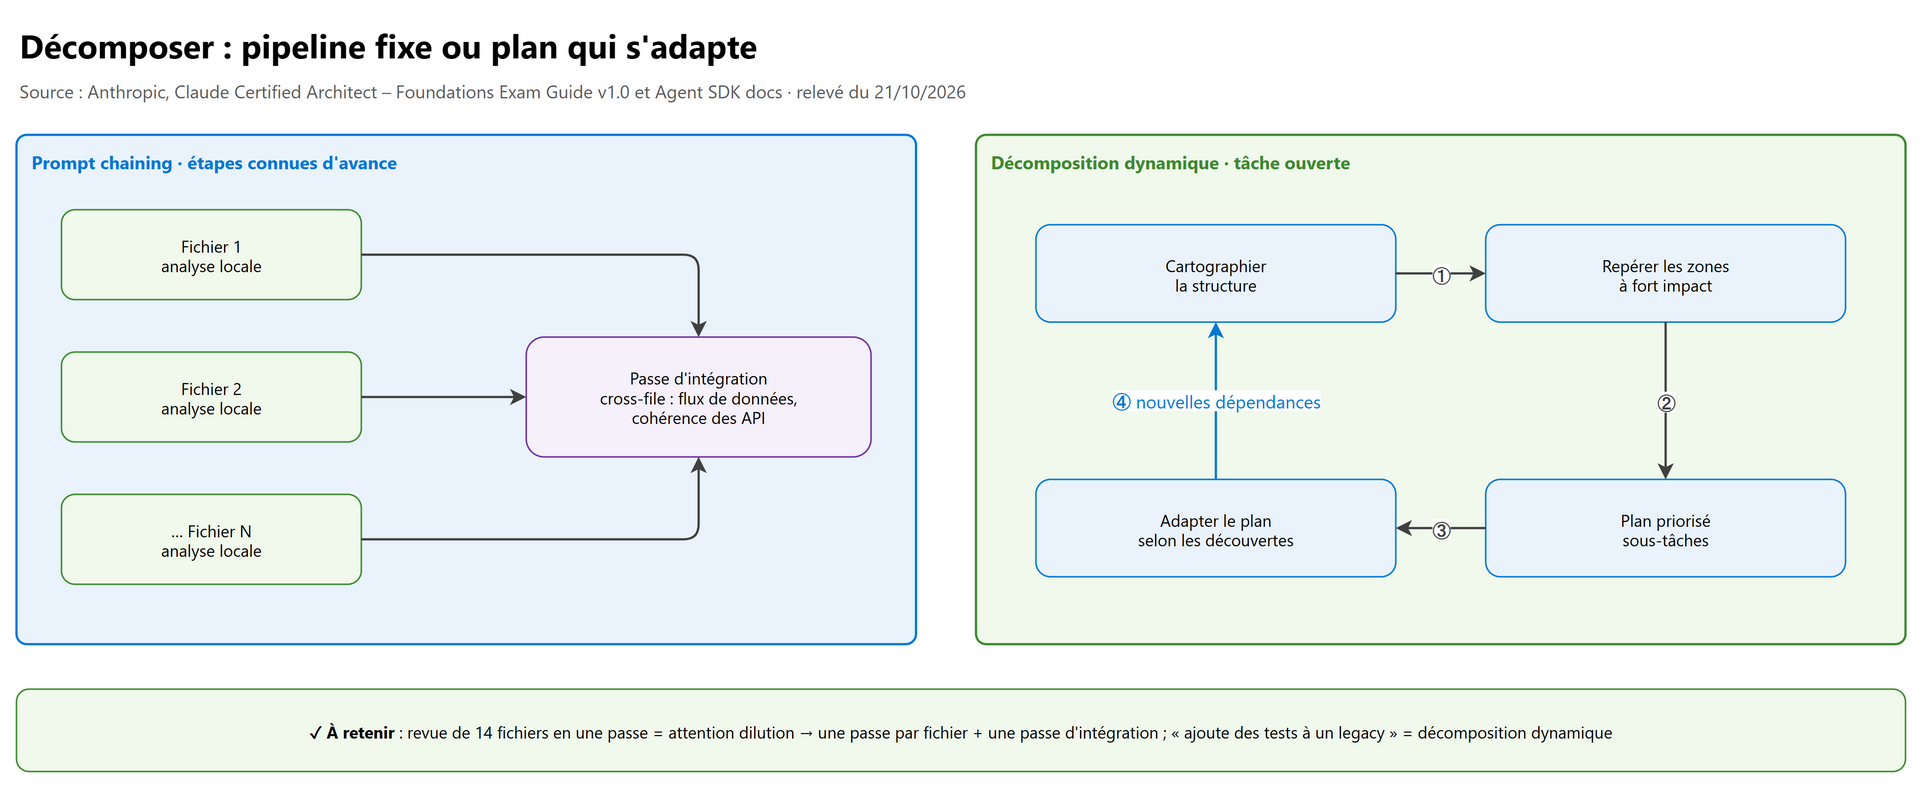
| Principe | Étapes connues d'avance, chacune utilise la sortie de la précédente | Le plan se construit et se révise selon ce que l'agent découvre |
| Pour | Tâches prévisibles et structurées : revue de code multi-aspects, extraction de documents, contrôle de conformité | Tâches ouvertes : explorer un legacy, enquête de sécurité, recherche, débogage d'un système inconnu |
| Avantages | Résultats constants, débogage et supervision faciles | S'adapte à l'imprévu, plus complet sur les tâches ouvertes |
| Limite | Ne s'adapte pas | Durée et coût moins prévisibles, débogage plus dur |
Attention dilution : traiter trop d'éléments en une seule passe donne une analyse inégale (détaillée au début, superficielle à la fin, et parfois contradictoire : le même motif est signalé dans un fichier et accepté dans un autre). La correction est structurelle : une passe locale par fichier puis une passe d'intégration cross-file (flux de données, cohérence des API). Un meilleur modèle, une fenêtre de contexte plus grande, un prompt plus insistant ou des lots sans passe d'intégration ne règlent pas le problème.
Pour une tâche ouverte comme « ajoute des tests complets à ce legacy » : cartographier la structure, repérer les zones à fort impact, construire un plan priorisé, puis l'adapter à mesure que les dépendances apparaissent.
Le chapitre 04 (TS 4.6) prolonge ce point avec les revues multi-passes et l'instance de revue indépendante.
7. Sessions : resume, fork ou nouvelle session (TS 1.7)#
7.1 Trois options#
| Situation | Option | Pourquoi |
|---|---|---|
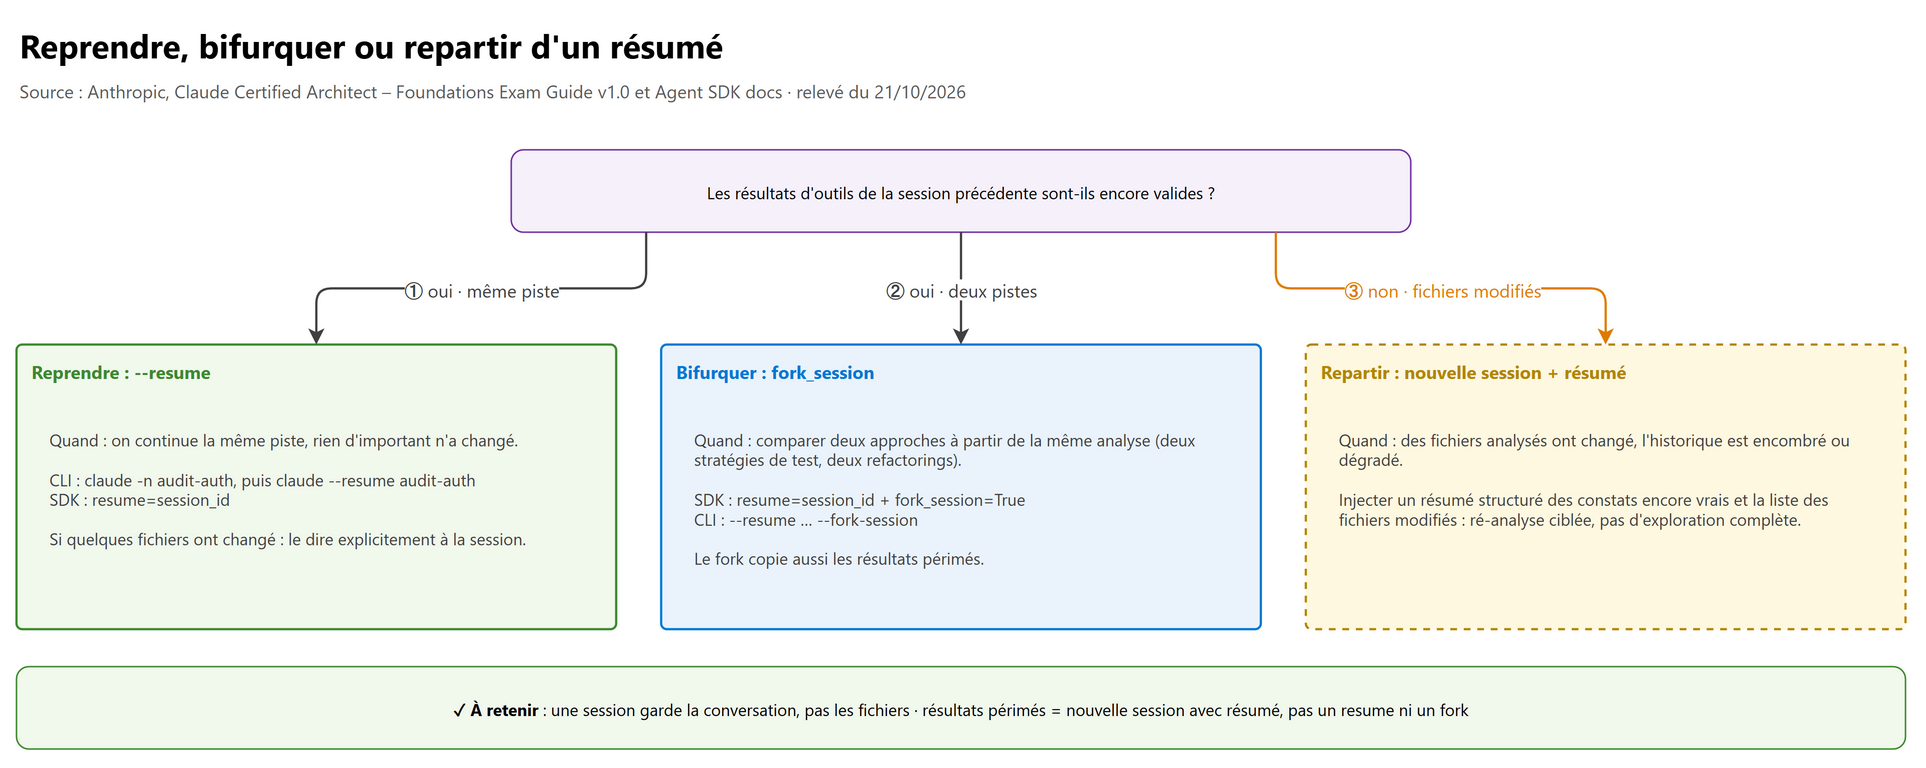
| On continue le travail d'hier, rien d'important n'a changé | Reprendre : claude --resume <session-name> ; SDK resume=session_id |
Le contexte est valide et utile |
| Comparer deux stratégies de test ou de refactoring à partir de la même analyse | Bifurquer : fork_session |
Deux branches indépendantes depuis une base commune |
| Les fichiers analysés ont changé, ou l'historique est encombré | Nouvelle session + résumé structuré | Les anciens tool_result sont périmés et provoquent des conseils contradictoires |
| Reprise après la modification de quelques fichiers sur beaucoup | Reprendre en signalant précisément les fichiers modifiés, ou nouvelle session + résumé si le raisonnement reposait sur eux | Ré-analyse ciblée plutôt qu'exploration complète |
Le piège : reprendre une session puis « relire les fichiers modifiés » laisse les anciens résultats dans l'historique, et ils continuent d'influencer le raisonnement. Un fork n'aide pas non plus : il copie les résultats périmés.
7.2 La syntaxe#
claude -n audit-auth                      # nommer la session au lancement (ou /rename en cours de session)
claude --resume audit-auth                # reprendre cette session (par nom ou par ID)
claude -c                                 # reprendre la plus récente du dossier courant
claude --resume audit-auth --fork-session # bifurquer : nouvelle session, l'originale reste intacte
from claude_agent_sdk import query, ClaudeAgentOptions, ResultMessage

# session_id capturé sur le ResultMessage d'une première exécution
async def explorer_oauth2(session_id: str):
    async for message in query(
        prompt="Au lieu de JWT, esquisse une version OAuth2 du module d'authentification",
        options=ClaudeAgentOptions(resume=session_id, fork_session=True, max_turns=5),
    ):
        if isinstance(message, ResultMessage):
            print("fork :", message.session_id)   # nouvel ID, l'original n'est pas modifié
Réponse d'examen :
--resume <session-name>,fork_session, informer la session des fichiers modifiés, nouvelle session avec résumé quand les résultats d'outils sont périmés.État actuel :
--resumeaccepte un nom ou un ID et ne crée jamais de session ;fork_session(Python) /forkSession(TypeScript) s'ajoute àresume, il ne le remplace pas. Une session persiste la conversation, pas le système de fichiers : pour annuler des modifications de fichiers, il faut le file checkpointing. Les sessions sont stockées sous~/.claude/projects/<dossier-encodé>/*.jsonl; pour reprendre sur une autre machine, il faut unSessionStoreou injecter un résumé dans une session neuve. En Python,ClaudeSDKClientenchaîne plusieurs requêtes dans la même session sans gérer d'ID.
8. Labs conseillés#
Prérequis : un compte Claude API de test, la clé dans ANTHROPIC_API_KEY (jamais dans le code), Python 3.10+,
pip install anthropic claude-agent-sdk. Coût : quelques centimes à quelques dizaines de centimes par lab avec Sonnet ; mettez
max_budget_usd sur tout ce qui utilise l'Agent SDK.
- Boucle agentique à la main (30 min) : reprenez le code du § 1.2 avec deux outils (une calculatrice et une recherche
simulée). Posez une question qui exige les deux. Résultat attendu : au moins deux itérations
tool_useavantend_turn. Puis remplacez le test surstop_reasonpar « la réponse contient du texte » et observez l'arrêt prématuré. - Coordinator et subagents (45 min) : le code du § 3.1 sur un sujet large. Résultat attendu : deux
tool_useAgentdans le mêmeAssistantMessage, des messages avecparent_tool_use_id, un rapport dont chaque affirmation garde sa source. Retirez les métadonnées dans le prompt du coordinator et constatez la perte des citations. - Gate et hook (45 min) : le serveur MCP in-process du § 4.2 et le hook du § 5.2. Demandez un remboursement sans
vérification, puis un remboursement de 900 USD. Résultat attendu : le premier est refusé par la gate puis réussi après
get_customer; le second n'exécute jamaisprocess_refundet finit enescalate_to_human. - Normalisation PostToolUse (30 min) : trois outils qui renvoient des dates en Unix, ISO 8601 et DD/MM/YYYY ; un hook
PostToolUsequi convertit tout en ISO 8601. Résultat attendu : Claude ne confond plus le jour et le mois. - Resume, fork, nouvelle session (30 min) : dans Claude Code, analysez un petit dépôt dans une session nommée, modifiez
trois fichiers, faites
--resumeet notez les contradictions ; recommencez avec une session neuve et un résumé qui liste les fichiers modifiés. Testez aussi--fork-sessionpour comparer deux refactorings.
Nettoyage : rien à supprimer côté cloud ; effacez les sessions de test sous ~/.claude/projects/ si besoin.
9. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| La boucle s'arrête quand le premier bloc est du texte | Piloter sur stop_reason |
Du texte peut précéder un tool_use |
| « Plafonner à 15 itérations » proposé comme correction | Non : garde-fou seulement | L'arrêt normal est end_turn |
| Remplacer l'historique par un résumé pour économiser | Non | L'API n'a pas de mémoire ; réduire plutôt la sortie des outils |
| Rapport incomplet alors que chaque subagent a bien travaillé | Décomposition trop étroite du coordinator | Un sous-thème non attribué n'est jamais traité |
| « Faire parler les subagents entre eux pour gagner du temps » | Non : tout passe par le coordinator | Observabilité, erreurs, contrôle du flux |
| Le subagent « devrait savoir » ce que le coordinator a lu | Non : tout passer dans son prompt | Contexte isolé, rien d'hérité |
| Citations perdues dans la synthèse | Métadonnées supprimées au passage de relais | Le subagent de synthèse ne cite que ce qu'il reçoit |
| Subagents indépendants lancés un par tour | Plusieurs appels Task dans une seule réponse | Parallélisme, moins de latence |
| Prompt de subagent en procédure pas à pas | Objectifs et critères de qualité | Le subagent doit pouvoir s'adapter |
| Le coordinator ne peut lancer aucun subagent | Ajouter Task (aujourd'hui Agent) à allowedTools |
Prérequis de l'invocation |
| Remboursement sans vérification dans quelques % des cas | Prerequisite gate ou hook | Le prompt garde un taux d'échec |
| Prompt plus fort ou few-shot pour une règle de conformité | Non | Probabiliste |
| Classifieur de routage pour une erreur d'ordre dans un workflow | Non : gate dans la séquence d'exécution | Le routage choisit l'agent, pas l'ordre des outils |
Bloquer un virement non conforme en PostToolUse |
Non : PreToolUse |
Le virement a déjà eu lieu |
| Laisser le modèle interpréter des formats de date mélangés | Hook PostToolUse de normalisation |
Lecture stable à chaque itération |
| Handoff sans customer ID ni action recommandée | Résumé structuré complet | L'humain n'a pas le transcript |
| Revue de 14 fichiers, les derniers bâclés | Une passe par fichier + une passe d'intégration | Attention dilution |
| Fixed pipeline pour une enquête ouverte, ou l'inverse | Adapter le motif à la tâche | Prévisible = chaining ; ouvert = dynamique |
| Reprise après modification des fichiers centraux | Nouvelle session + résumé, ré-analyse ciblée | Résultats d'outils périmés |
fork_session pour continuer une seule piste ou pour purger le périmé |
Non : --resume pour continuer ; nouvelle session pour le périmé |
Le fork copie l'historique |
10. Scénarios corrigés#
1. (Scénario 1, support client) Votre agent appelle lookup_order, puis répond « Je vérifie aussi le remboursement… » et
votre boucle s'arrête. Le client n'a jamais sa réponse. Que corriger ?
A. Ajouter « Ne réponds qu'une fois tout terminé » au system prompt. B. Arrêter la boucle sur stop_reason == "end_turn" et
continuer sur "tool_use". C. Forcer tool_choice pour que chaque réponse appelle un outil. D. Limiter la boucle à 10 tours.
B. Le texte accompagnait un
tool_use: seulestop_reasondit si Claude a fini. A est probabiliste, C empêche Claude de conclure, D est un garde-fou, pas un critère d'arrêt.
2. (Scénario 3, recherche) Le rapport sur « l'impact de l'IA sur les industries créatives » ne traite que des arts visuels. Les logs montrent que chaque subagent a couvert son sujet en profondeur. Cause la plus probable ? A. Le subagent web search formule des requêtes trop étroites. B. Le subagent de synthèse n'audite pas ses entrées. C. La décomposition du coordinator n'a créé que des sous-thèmes « arts visuels ». D. Le modèle de synthèse est trop petit.
C. Les subagents ont fait ce qu'on leur a demandé ; la musique, l'écriture et le cinéma n'ont été confiés à personne.
3. Votre coordinator lance la recherche web, attend le résultat, puis lance l'analyse de documents, pourtant indépendante.
Comment réduire la latence ?
A. Fusionner les deux subagents. B. Émettre les deux appels Task dans la même réponse du coordinator. C. Passer les deux en
background puis attendre 30 secondes. D. Lancer deux processus query() sans coordinator.
B. Plusieurs appels Task dans une seule réponse s'exécutent en parallèle. A perd la spécialisation, D perd l'agrégation et la gestion d'erreur du hub.
4. Le subagent de synthèse produit un texte fluide mais sans aucune source, alors que les subagents amont renvoient des
source_url. Que faire ?
A. Ajouter « cite toujours tes sources » au prompt du subagent de synthèse. B. Faire passer par le coordinator des findings
structurés qui gardent source_url, document_name et page_number. C. Donner au subagent de synthèse l'outil WebSearch pour
retrouver les sources. D. Passer au modèle le plus puissant.
B. On ne peut pas citer une source qu'on n'a pas reçue. A et D ne changent rien à l'entrée, C refait le travail.
5. (Scénario 1) Malgré la consigne « vérifie toujours l'identité », 6 % des remboursements partent vers le mauvais compte.
La direction exige 0 %. Quelle solution ?
A. Ajouter des exemples few-shot du bon workflow. B. Un classifieur qui envoie les demandes de remboursement vers un agent
spécialisé. C. Une prerequisite gate qui bloque process_refund tant que get_customer n'a pas renvoyé un ID vérifié. D. Un
system prompt en majuscules.
C. Seul le code garantit l'ordre. A et D restent probabilistes ; B choisit l'agent mais ne contrôle pas l'ordre des outils.
6. Une politique interdit tout remboursement au-dessus de 500 USD sans validation humaine. Où mettre la règle ?
A. Hook PostToolUse sur process_refund qui annule le remboursement. B. Hook PreToolUse sur process_refund qui renvoie
deny avec une raison orientant vers escalate_to_human. C. Consigne dans le system prompt. D. Vérification par un subagent
dédié après chaque remboursement.
B. Le blocage doit intervenir avant l'exécution. A et D arrivent après l'effet de bord ; C est probabiliste.
7. Trois outils MCP renvoient des dates en timestamps Unix, en ISO 8601 et en DD/MM/YYYY ; l'agent se trompe parfois de
mois. Meilleure correction ?
A. Expliquer les trois formats dans le system prompt. B. Un hook PostToolUse qui normalise toutes les dates en ISO 8601 avant
que Claude lise le résultat. C. Un hook PreToolUse qui demande des dates ISO. D. Un modèle plus récent.
B. La normalisation déterministe se fait sur le résultat. C ne voit que l'appel sortant, pas la réponse.
8. (Scénario 5, CI) La revue automatique d'une PR de 22 fichiers est détaillée sur les premiers fichiers et rate des bugs évidents à la fin. Que faire ? A. Couper la PR en lots de 5 fichiers. B. Une passe d'analyse par fichier puis une passe d'intégration cross-file. C. Un prompt « accorde la même attention à chaque fichier ». D. Un modèle avec une plus grande fenêtre de contexte.
B. C'est de l'attention dilution : il faut changer la structure. A rate les problèmes entre lots, C et D ne changent pas la passe unique.
9. (Scénario 4, productivité) Hier, une session nommée legacy-billing a analysé 50 fichiers. Ce matin, un collègue a
réécrit les 3 modules centraux sur lesquels reposait l'analyse. Comment repartir ?
A. claude --resume legacy-billing, puis demander de relire les 3 modules. B. --fork-session depuis legacy-billing.
C. Une nouvelle session avec un résumé structuré des constats encore valides et la liste des 3 fichiers modifiés à ré-analyser.
D. Une nouvelle session qui ré-analyse les 50 fichiers.
C. Les anciens résultats d'outils sont périmés : A les garde dans l'historique, B les copie, D gaspille du temps et des jetons.
10. Vous voulez comparer deux stratégies de tests (unitaires vs contrats d'API) à partir de la même analyse du code, sans
qu'elles s'influencent. Quelle option ?
A. Deux --resume successifs de la même session. B. fork_session depuis la session d'analyse, une branche par stratégie.
C. Deux sessions neuves sans contexte. D. Un seul agent qui alterne les deux stratégies.
B. Le fork part d'une base commune et crée des branches indépendantes ; A mélange les deux pistes dans un seul historique.
11. Pour aller plus loin (hors examen)#
- Building effective agents (Anthropic) : la différence entre workflows (chemins codés à l'avance) et agents (le modèle choisit), et les motifs prompt chaining, routing, parallelization, orchestrator-workers et evaluator-optimizer. Principe central : commencer par la solution la plus simple et n'ajouter de l'autonomie que si elle apporte quelque chose.
- How we built our multi-agent research system (Anthropic) : retour d'expérience sur un système coordinator + subagents en parallèle, avec ses coûts en jetons et ses difficultés d'évaluation.
- Tool runner du SDK
anthropic: exécute la boucle d'outils et formate les messages pour vous, quand l'Agent SDK est trop lourd. - File checkpointing de l'Agent SDK : annuler les modifications de fichiers d'une session, ce qu'une session seule ne fait pas.
- Dynamic workflows (outil
Workflow, SDK TypeScript) : orchestrer des dizaines d'agents depuis un script, hors du contexte de la conversation. - Limites de coût : avec les modèles récents qui délèguent plus facilement (la doc le signale pour Opus 5), fixez toujours
max_budget_usdet les limites de profondeur et de concurrence des subagents.
12. Fiche à retenir#
- La boucle continue sur
tool_use, s'arrête surend_turn; texte présent, phrase « j'ai fini » ou plafond d'itérations ne sont pas des critères d'arrêt. - Un
tool_resultpartool_use, mêmetool_use_id, tous dans un messageuser;is_errorpour une erreur d'outil. - L'API est sans état : on renvoie tout l'historique ; on réduit les sorties d'outils plutôt que l'historique.
- Hub-and-spoke : le coordinator décompose, sélectionne, partitionne, raffine et route tout ; aucun lien direct entre subagents.
- Rapport incomplet malgré de bons subagents = décomposition trop étroite.
- Subagent = contexte isolé : tout passer dans son prompt, findings complets, contenu et métadonnées séparés.
- Subagents indépendants = plusieurs appels Task dans une seule réponse ; objectifs et critères plutôt que procédure.
- Task dans
allowedTools(examen) ; aujourd'hui l'outil s'appelleAgentetallowed_toolspré-approuve. - Règle à 100 % (argent, sécurité, conformité) = code (gate, hook) ; préférence = prompt.
-
PreToolUsebloque ou réécrit l'appel ;PostToolUsetransforme le résultat ; bloquer après coup est trop tard. - Handoff : customer_id, résumé, cause racine, montant, action recommandée ; l'humain n'a pas le transcript.
- Prompt chaining pour le prévisible, décomposition dynamique pour l'ouvert ; une passe par fichier + une passe d'intégration.
-
--resumesi le contexte est valide,fork_sessionpour deux pistes, nouvelle session + résumé si les résultats sont périmés.
Références#
Lues le 21/10/2026 :
- Claude Certified Architect – Foundations Exam Guide v1.0 (juillet 2026), domaine 1
- Handling stop reasons
- Tool use overview
- Agent SDK overview
- How the agent loop works
- Subagents in the SDK
- Intercept and control agent behavior with hooks et Hooks reference
- Give Claude custom tools
- Work with sessions et CLI reference
- Permissions (Agent SDK)
- Building effective agents
- How we built our multi-agent research system
- claudecertificationguide.com, domaine 1 (leçons 1.1 à 1.7, base du chapitre)
- Building with the Claude API (Skilljar)