

Version : 1.1 · Date : 2026-10-21 · Domaine 5 de l'examen : Optimize generative AI systems and model performance (10 à 15 %)
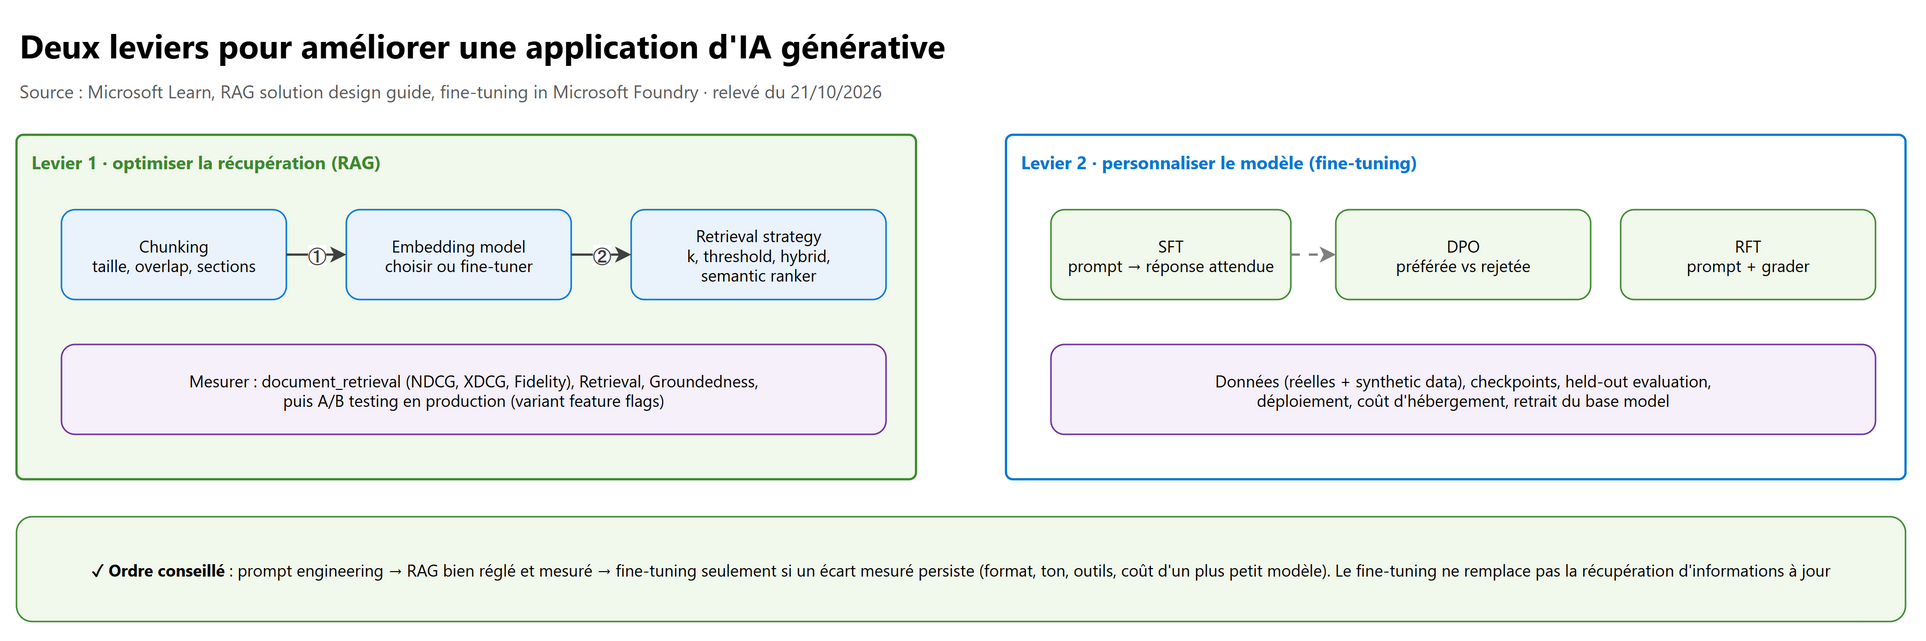
En une phrase : on améliore une application d'IA générative avec deux leviers mesurés : d'abord la récupération (chunking, embedding model, k, threshold, hybrid search, semantic ranker, évalués par
document_retrievalpuis A/B testés), puis, si un écart persiste, la personnalisation du modèle (SFT, DPO ou RFT dans Microsoft Foundry, avec des données réelles ou synthétiques, des checkpoints comparés sur un test tenu à l'écart, et un déploiement dont on maîtrise le coût).
Ce que l'examen demande#
Texte officiel du guide d'étude AI-300, domaine Optimize generative AI systems and model performance :
| # | Compétence mesurée (guide officiel, en anglais) | Section |
|---|---|---|
| 1 | Optimize retrieval performance by tuning similarity thresholds, chunk sizes, and retrieval strategies | 2 |
| 2 | Select and fine-tune embedding models for domain-specific use cases and accuracy improvements | 3 |
| 3 | Implement and optimize hybrid search approaches combining semantic and keyword-based retrieval | 4 |
| 4 | Evaluate and improve RAG system performance by using relevance metrics and A/B testing frameworks | 5 |
| 5 | Design and implement advanced fine-tuning methods | 6 |
| 6 | Create and manage synthetic data for fine-tuning | 7 |
| 7 | Monitor and optimize fine-tuned model performance | 8 |
| 8 | Manage a fine-tuned model from development through production deployment | 9 |
Le RAG côté application (Responses API, citations, agentic retrieval) est dans AI-103 · 05, l'indexation (indexers, skillsets, integrated vectorization) dans AI-103 · 10, et l'arbre de décision prompt / RAG / fine-tuning dans AI-103 · 01. Ce chapitre va plus loin sur le réglage, la mesure et le fine-tuning. L'entraînement complet d'un LLM, le dimensionnement GPU et KAITO sont dans 08.
1. Les bases#
1.1 Le vocabulaire#
| Terme | Définition courte |
|---|---|
| Chunk | Morceau de document indexé séparément ; l'unité que la récupération renvoie au modèle |
| Embedding model | Modèle qui transforme un texte en vecteur ; le même modèle sert à l'indexation et à la requête |
k |
Nombre de plus proches voisins demandés à une vector query (50 par défaut si ni k ni top ne sont fixés) |
threshold (preview) |
Score minimal sous lequel un résultat vectoriel est écarté, même si on en obtient moins que k |
| RRF (Reciprocal Rank Fusion) | Algorithme qui fusionne les classements full-text et vectoriel d'une requête hybride |
| Semantic ranker | Reranking L2 des 50 premiers résultats, score @search.rerankerScore de 0 à 4 |
| qrels | Labels de pertinence humains (document, question, note) qui servent de vérité terrain à la récupération |
| SFT / DPO / RFT | Supervised fine-tuning, Direct Preference Optimization, Reinforcement fine-tuning |
| LoRA | Low-rank adaptation : on n'entraîne qu'un petit sous-ensemble de paramètres (adaptateur), plus rapide et moins cher |
| Epoch | Un passage complet sur le jeu d'entraînement |
| Checkpoint | Version intermédiaire du modèle produite pendant l'entraînement, déployable |
| Grader | Fonction de récompense de RFT : note de 0 à 1 chaque réponse générée |
1.2 Quel levier pour quel symptôme#
| Symptôme mesuré | Levier probable | Section |
|---|---|---|
| Les bons passages existent mais ne remontent pas | chunking, k, hybrid search, semantic ranker |
2, 4 |
| Le vocabulaire métier (acronymes, termes rares) est mal compris | embedding model de domaine ou fine-tuné ; hybrid search pour les mots exacts | 3 |
| Des résultats hors sujet polluent le contexte | threshold sur la vector query, filtre, semantic ranker |
2 |
| La récupération est bonne mais la réponse ne suit pas le format, le ton, l'usage des outils | fine-tuning (SFT, puis DPO) | 6 |
| Un grand modèle coûte trop cher pour une tâche étroite | distillation : SFT d'un petit modèle sur des réponses d'un grand | 6.8 |
| Le raisonnement sur un domaine objectif (calcul, classification experte) est faible | RFT sur un reasoning model | 6.4 |
| L'information doit être à jour | RAG, jamais le fine-tuning seul | — |
À retenir : selon Microsoft, le fine-tuning ne remplace pas la récupération pour l'information à jour ni les contrôles de sécurité de l'application ; ses bénéfices ne sont pas garantis et se prouvent par une évaluation sur données tenues à l'écart.
2. Régler la récupération : chunks, k, threshold, stratégies#
2.1 La taille et la forme des chunks#
Le chunking est un choix semi-permanent : le changer oblige à réindexer et à réévaluer toute la chaîne. Microsoft recommande de comparer plusieurs approches sur vos propres documents et requêtes avant de choisir.
| Approche | Quand | Brique Azure AI Search |
|---|---|---|
| Taille fixe avec overlap | Contenu peu structuré, beaucoup de types de documents | Text Split skill (pages par nombre de caractères) |
| Taille variable (phrases, titres Markdown ou HTML) | Documents structurés par sections | Text Split skill (phrases), Content Understanding skill |
| Semantic chunking | Garder des unités de sens qui peuvent traverser les pages | Content Understanding skill (sortie Markdown) |
| Combinaison | Grands documents : sections + titre du document ajouté à chaque chunk | custom skill |
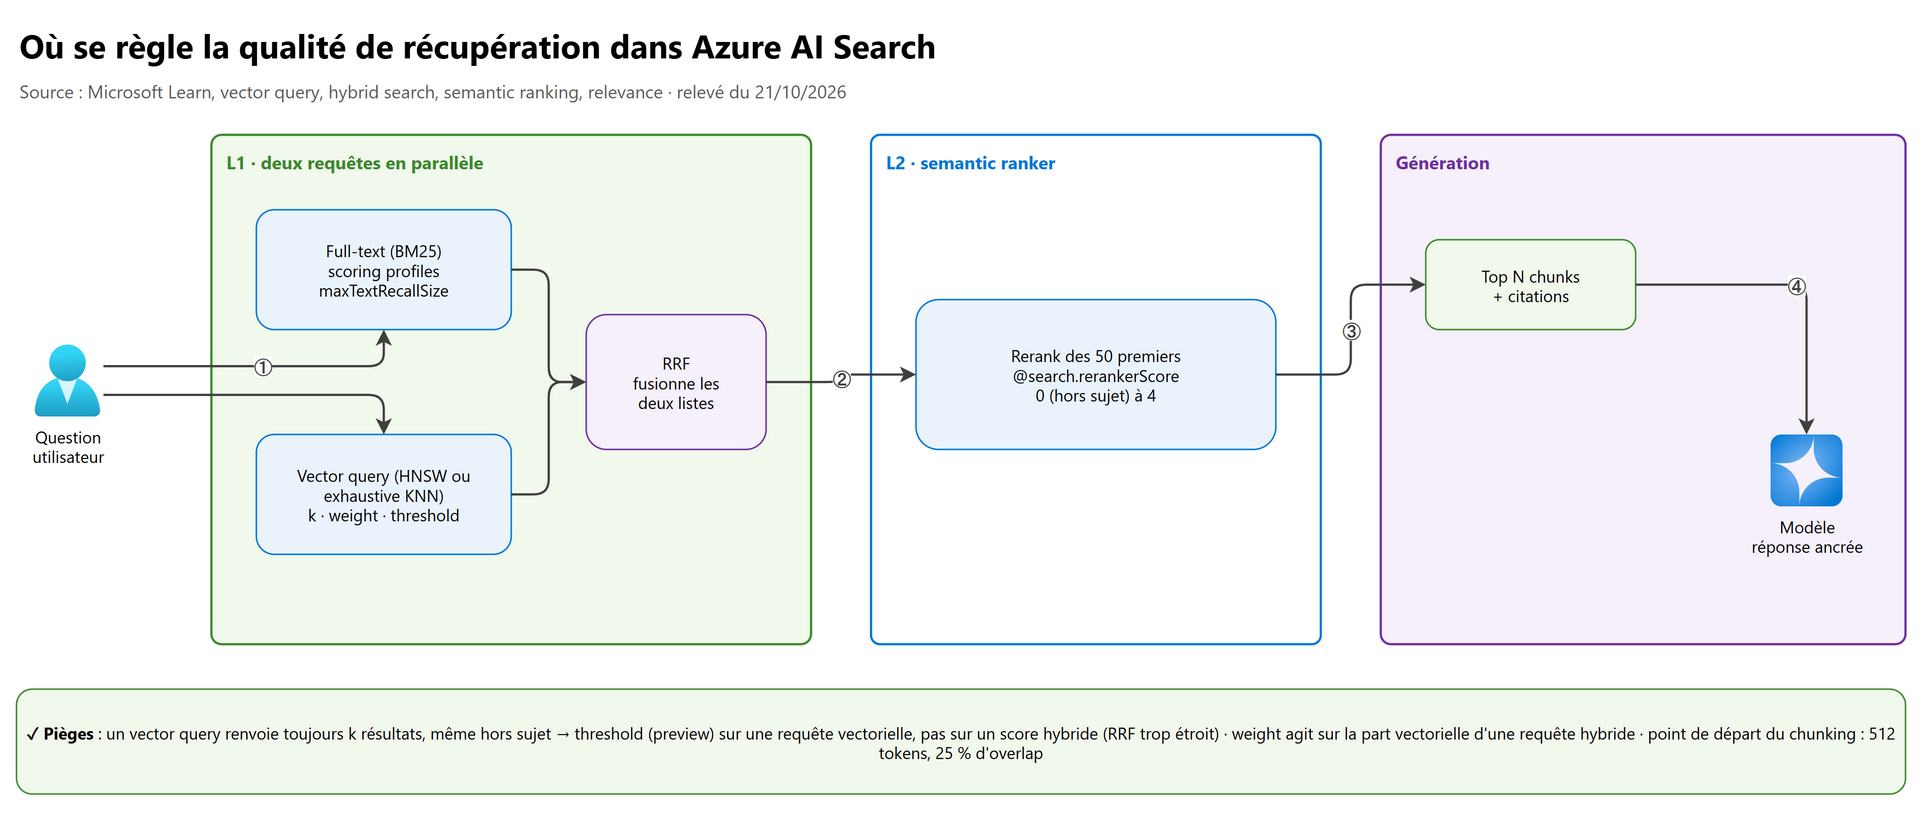
Point de départ documenté : 512 tokens (environ 2 000 caractères) et 25 % d'overlap (128 tokens). Un chunk trop petit perd le
contexte, un chunk trop gros dilue la pertinence et coûte des tokens. Les limites d'entrée de l'embedding model s'appliquent :
text-embedding-3-small accepte 8 191 tokens au maximum ; au-delà, le texte est tronqué et l'information perdue.
2.2 Le nombre de résultats et le seuil#
- Une vector query renvoie toujours
krésultats, même si les voisins sont peu similaires : une question hors sujet obtient quand même des chunks, avec des scores bas. kvaut pour une requête vectorielle seule,toppour une requête hybride ; sans l'un ni l'autre, 50 résultats.threshold(preview, API2026-08-01-preview) écarte les résultats sous un score minimal avant la fusion. Microsoft le déconseille sur un score hybride : les scores RRF sont trop étroits et trop volatils.- HNSW (approximatif, rapide) ou exhaustive KNN (exact, coûteux) : on peut forcer
exhaustive: trueà la requête pour comparer la qualité des deux sur un échantillon. - Les distributions de
@search.rerankerScorevarient légèrement (infrastructure, mises à jour du modèle) : ne fixez pas de seuil trop fin.
POST https://{service}.search.windows.net/indexes/{index}/docs/search?api-version=2026-08-01-preview
{
  "search": "délai de résiliation contrat cadre",
  "hybridSearch": { "maxTextRecallSize": 100, "countAndFacetMode": "countAllResults" },
  "vectorQueries": [{
    "kind": "text", "text": "délai de résiliation contrat cadre",
    "fields": "contentVector", "k": 50, "weight": 2,
    "threshold": { "kind": "vectorSimilarity", "value": 0.8 }
  }],
  "queryType": "semantic", "semanticConfiguration": "default", "top": 5
}
kind: "text" suppose un vectorizer sur le champ (integrated vectorization) ; sinon on envoie kind: "vector" avec le vecteur
déjà calculé. threshold n'a de sens que sur la part vectorielle (voir 4).
2.3 Les stratégies de récupération#
| Stratégie | Force | Faiblesse | Réglages |
|---|---|---|---|
| Full-text (BM25) | mots exacts, codes, identifiants, noms propres | synonymes, paraphrases | analyzers, scoring profiles |
| Vector | sens, paraphrases, multilingue | termes rares, codes exacts ; renvoie toujours k |
embedding model, k, threshold, HNSW / KNN, filtres |
| Hybrid (RRF) | le meilleur des deux | scores RRF peu lisibles | weight, maxTextRecallSize |
| Hybrid + semantic ranker | meilleure qualité selon Microsoft | coût (premium), latence | semantic configuration, query rewrite (preview) |
| Agentic retrieval (Foundry IQ) | requêtes complexes, sous-questions en parallèle | plus de latence et de coût | voir AI-103 · 01 |
Leviers complémentaires : filtres sur des métadonnées (pré ou post-filtrage du vecteur), scoring profiles (fraîcheur, champs pondérés), query rewrite du semantic ranker (jusqu'à 10 variantes de la requête, preview).
3. Choisir et fine-tuner l'embedding model#
3.1 La démarche Microsoft#
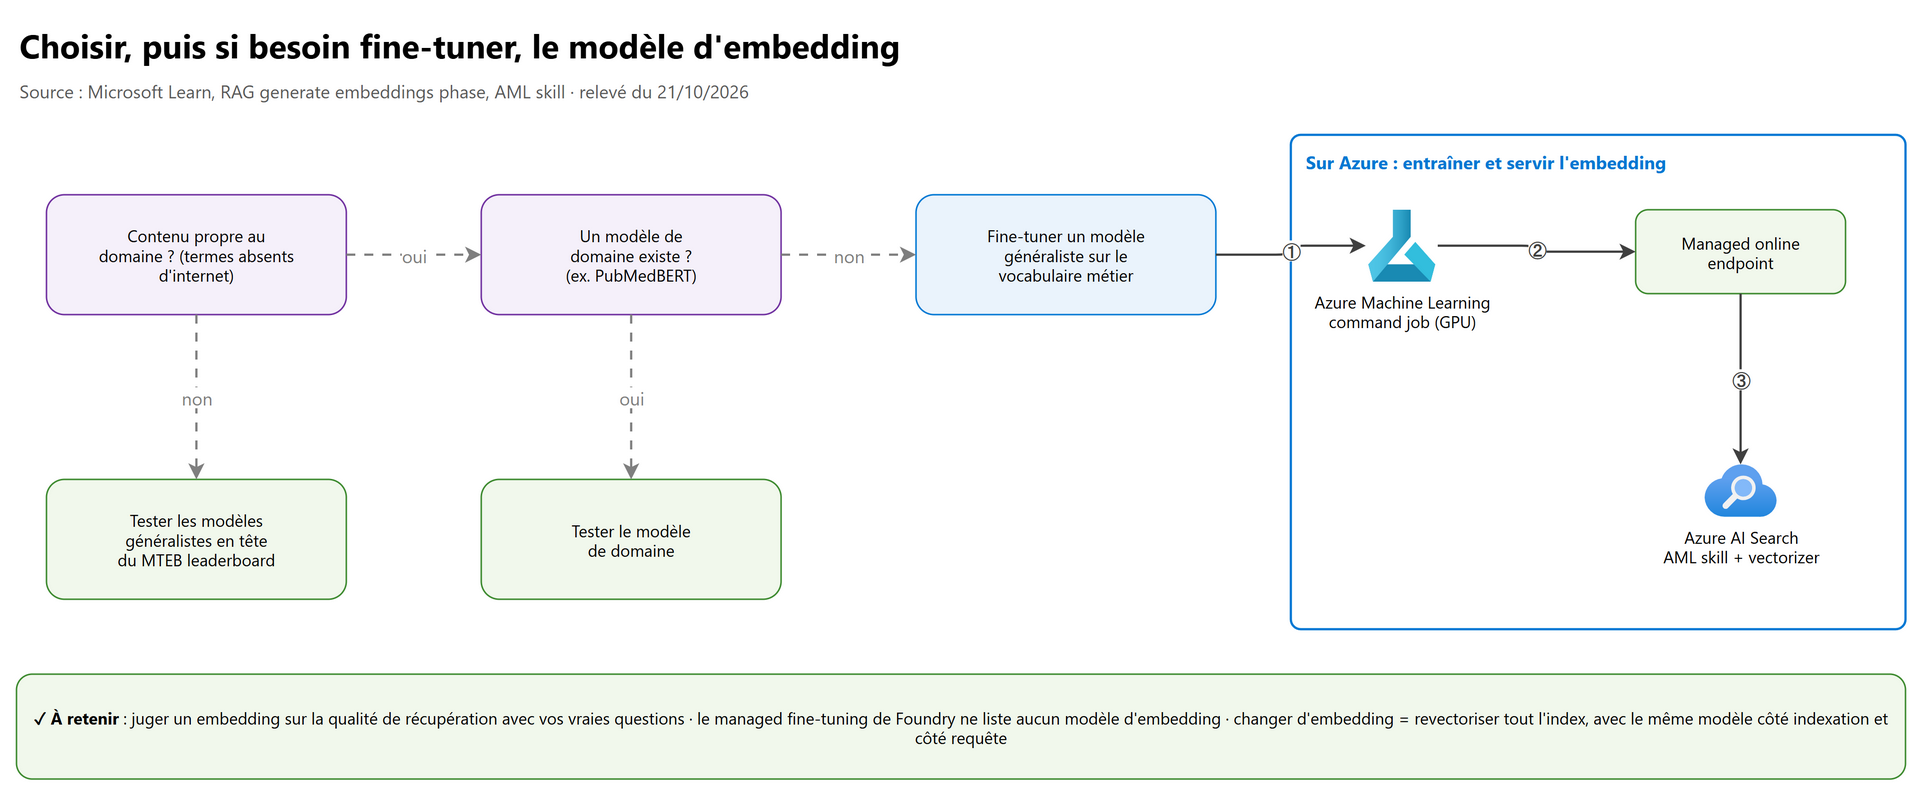
- Le contenu est-il propre au domaine ? Test simple : si les entités et mots-clés se trouvent sur internet, un modèle généraliste les connaît probablement.
- Non → tester les modèles généralistes en tête du MTEB leaderboard de Hugging Face, sur vos données.
- Oui → existe-t-il un modèle de domaine (exemple documenté : PubMedBERT pour la littérature biomédicale) ? Le tester.
- Sinon, ou s'il déçoit → fine-tuner un modèle généraliste sur votre vocabulaire.
Pourquoi le vocabulaire compte : un mot absent du vocabulaire du modèle est découpé en sous-mots (exemple Microsoft : histamine → his, ta, mine) dont le sens est très éloigné, ce qui dégrade le vecteur.
3.2 Évaluer un embedding#
- La méthode la plus pratique est la qualité de récupération : indexer, interroger avec de vraies questions, mesurer si les bons documents remontent (5).
- En complément : visualiser les vecteurs (t-SNE), mesurer les distances question ↔ chunks.
- Vérifier la licence et la langue du modèle.
- Les dimensions et la compression (scalar ou binary quantization, stockage réduit) jouent sur le coût de l'index.
3.3 Fine-tuner un embedding : où et comment sur Azure#
- Le fine-tuning peut dégrader la récupération si les données sont mauvaises ; l'Azure Architecture Center (RAG generate embeddings phase) conseille d'évaluer d'abord si le prompt engineering ou le constrained decoding suffisent, de tester d'abord les modèles généralistes les mieux classés puis un modèle de domaine, et de guider la décision par les métriques de récupération.
- Le managed fine-tuning de Foundry ne liste aucun modèle d'embedding dans son tableau des modèles pris en charge (relevé du 21/10/2026) : il vise les modèles de génération.
- La voie Azure est donc Azure Machine Learning (déduction d'architecture : Microsoft Learn n'a pas de tutoriel dédié au fine-tuning d'embedding) : un command job (GPU) entraîne le modèle, on le publie sur un managed online endpoint, puis Azure AI Search l'appelle par l'AML skill (indexation) et le vectorizer correspondant (requête), qui se connectent aussi aux endpoints du Foundry model catalog.
- Changer d'embedding = revectoriser tout l'index, et utiliser le même modèle à l'indexation et à la requête.
4. Hybrid search et semantic ranker#
4.1 Comment les scores se combinent#
| Niveau | Score | Plage | Rôle |
|---|---|---|---|
| L1 texte | @search.score (BM25) |
0 à illimité | correspondance de termes |
| L1 vecteur | @search.score (HNSW / KNN) |
0,333 à 1,00 | similarité |
| L1 fusionné | @search.score (RRF) |
0 à une borne qui dépend du nombre de requêtes | hybride ou plusieurs vector queries |
| L2 | @search.rerankerScore |
0,00 à 4,00 | semantic ranker sur les 50 premiers |
| L2 + profil | @search.rerankerBoostedScore |
0 à illimité | scoring profile réappliqué après le reranking |
weightmultiplie le rang d'une vector query dans le calcul RRF (défaut 1,0, valeur positive) : 2 la rend deux fois plus importante que le texte. La part texte se règle parmaxTextRecallSize(preview).- Le semantic ranker est une fonctionnalité premium facturée à l'usage (gratuite dans les limites du niveau Free), obligatoire pour l'agentic retrieval. Il renvoie aussi des captions et answers extraites mot pour mot de l'index (aucune génération).
- Pour qu'un scoring profile (fraîcheur, par exemple) ait le dernier mot après le reranking :
"rankingOrder": "boostedRerankerScore"dans la semantic configuration (sans reconstruire l'index ; ne s'applique qu'aux fonctions du profil).
4.2 Exemple Python : requête hybride + semantic ranker, sans clé#
import os
from azure.identity import DefaultAzureCredential
from azure.search.documents import SearchClient
from azure.search.documents.models import VectorizableTextQuery

search = SearchClient(endpoint=os.environ["SEARCH_ENDPOINT"], index_name="contrats",
                      credential=DefaultAzureCredential())          # rôle Search Index Data Reader

question = "délai de résiliation du contrat cadre"
results = search.search(
    search_text=question,                                             # partie BM25
    vector_queries=[VectorizableTextQuery(text=question, k_nearest_neighbors=50,
                                          fields="contentVector", weight=2)],   # partie vectorielle, vectorizer de l'index
    query_type="semantic", semantic_configuration_name="default",     # reranking L2
    top=5, select=["id", "title", "content"])

for r in results:
    print(r["id"], r["@search.score"], r.get("@search.reranker_score"))
Quelle stratégie retenir ? Celle qui gagne sur vos métriques (5). Selon Microsoft, l'hybride avec semantic ranking donne en général les meilleurs résultats qualitatifs, au prix d'un coût et d'une latence plus élevés.
5. Évaluer le RAG et l'A/B tester#
5.1 Les évaluateurs RAG de Foundry#
| Évaluateur | Mesure | Entrées | Juge |
|---|---|---|---|
| Document Retrieval | Fidelity, NDCG, XDCG, Max Relevance N, Holes (composite) | retrieval_ground_truth, retrieved_documents |
calcul, qrels requis |
| Retrieval | pertinence des chunks récupérés pour la question | query, context |
LLM (1 à 5) |
| Groundedness | la réponse n'invente rien hors du contexte (précision) | response, context (+ query) |
LLM |
| Groundedness Pro (preview) | cohérence stricte avec le contexte | query, response, context |
Azure AI Content Safety |
| Relevance | la réponse traite la question | query, response |
LLM |
| Response Completeness (preview) | la réponse n'oublie rien de la vérité terrain (rappel) | ground_truth, response |
LLM |
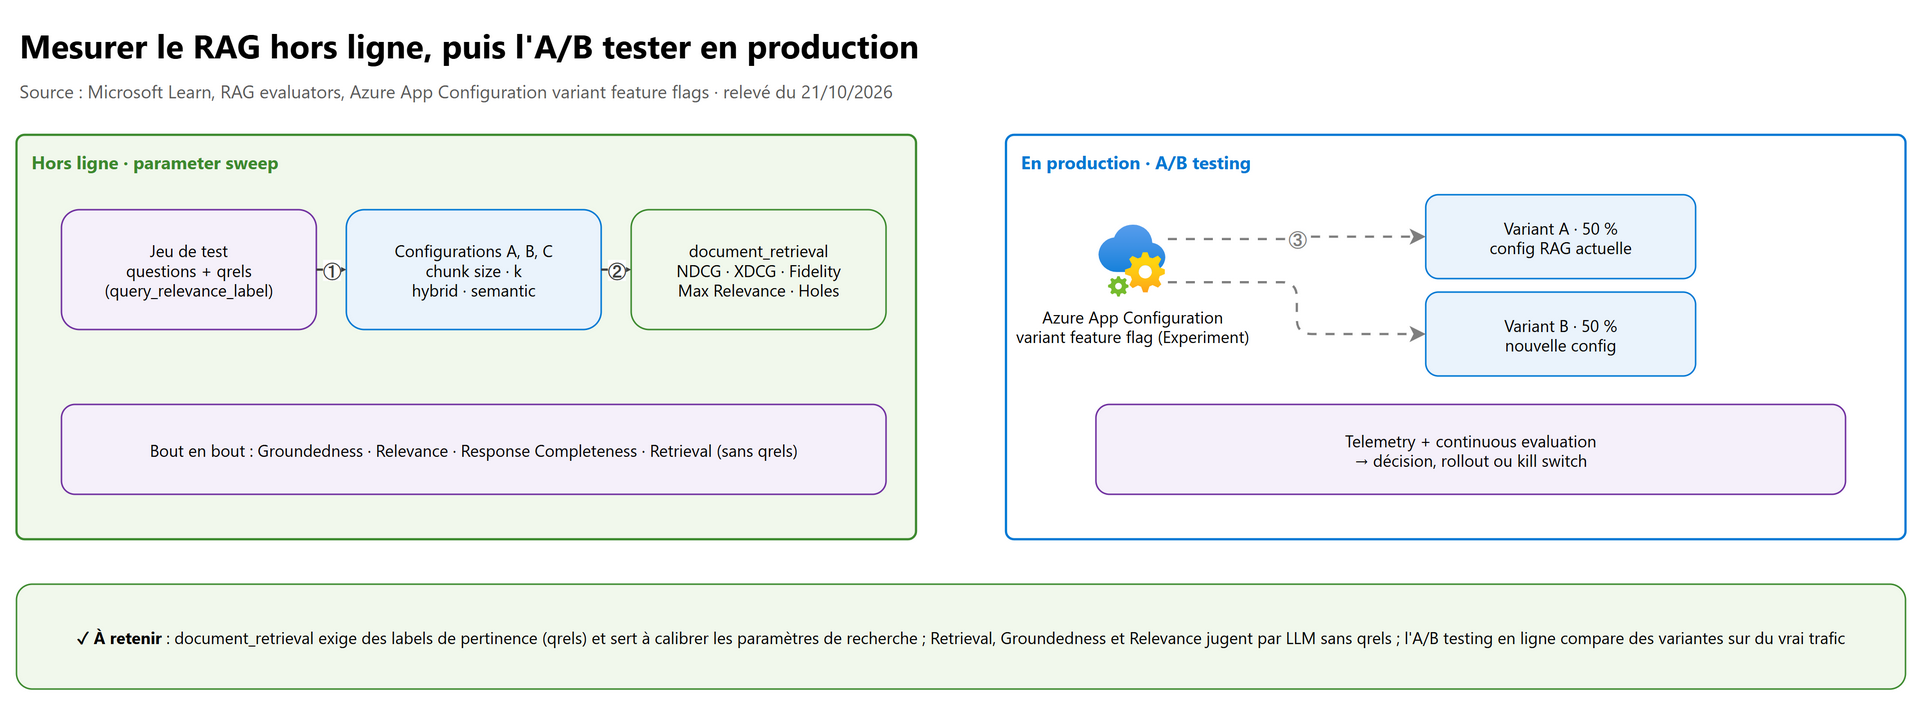
Les évaluateurs à juge LLM renvoient un score de 1 à 5, seuil de réussite par défaut 3. Document Retrieval est le plus précis pour
régler les paramètres de recherche : Microsoft le décrit pour un parameter sweep (algorithmes, top_k, tailles de chunk).
| Métrique de Document Retrieval | Question à laquelle elle répond |
|---|---|
| Fidelity | combien des bons documents connus sont dans le top n ? |
| NDCG | le classement est-il proche de l'ordre idéal ? |
| XDCG | les résultats du top k sont-ils bons, indépendamment du reste de l'index ? |
| Max Relevance N | meilleure pertinence dans le top k |
| Holes | documents sans label de pertinence (jeu de vérité incomplet) |
5.2 Le parameter sweep hors ligne#
# Produit, pour chaque configuration, les données attendues par l'évaluateur document_retrieval
import json

configs = {
    "A_vector_k10": dict(hybride=False, k=10),
    "B_hybride":    dict(hybride=True,  k=50),
}
qrels = {  # vérité terrain : document -> note de pertinence (0 à 4), par question
    "Quel est le délai de résiliation ?": [{"document_id": "c-12", "query_relevance_label": 4},
                                           {"document_id": "c-07", "query_relevance_label": 2}],
}

for nom, cfg in configs.items():
    with open(f"eval_{nom}.jsonl", "w", encoding="utf-8") as f:
        for question, verite in qrels.items():
            docs = rechercher(question, **cfg)            # votre fonction d'appel à Azure AI Search
            ligne = {"retrieval_ground_truth": verite,
                     "retrieved_documents": [{"document_id": d["id"], "relevance_score": d["@search.score"]}
                                             for d in docs]}
            f.write(json.dumps(ligne, ensure_ascii=False) + "\n")
# Puis : une évaluation par fichier avec document_retrieval, et comparaison des runs dans le portail Foundry
Pour industrialiser ces expériences, Microsoft publie le RAG Experiment Accelerator (dépôt GitHub, CLI) qui fait varier embedding models, chunking et stratégies de recherche.
5.3 L'A/B testing en production#
Hors ligne, on compare sur un jeu figé ; en ligne, on compare sur du vrai trafic.
- Azure App Configuration : un feature flag de type Experiment (variant feature flag) répartit les utilisateurs entre
variantes (exemple : 50 % Control, 50 % NewConfig), avec des overrides par utilisateur ou groupe, un kill switch
(
Enabled = false→ tout le monde reçoitDefaultWhenDisabled) et une télémétrie pour mesurer l'impact. - L'AI configuration d'App Configuration externalise prompts, température, modèle : on change la configuration RAG ou le prompt sans redéployer, puis on la diffuse progressivement par feature flag.
- On mesure chaque variante par la télémétrie applicative et la continuous evaluation de Foundry (échantillon du trafic noté par les évaluateurs), puis on décide : rollout complet, retour arrière, ou nouvelle itération.
6. Les méthodes de fine-tuning avancées#
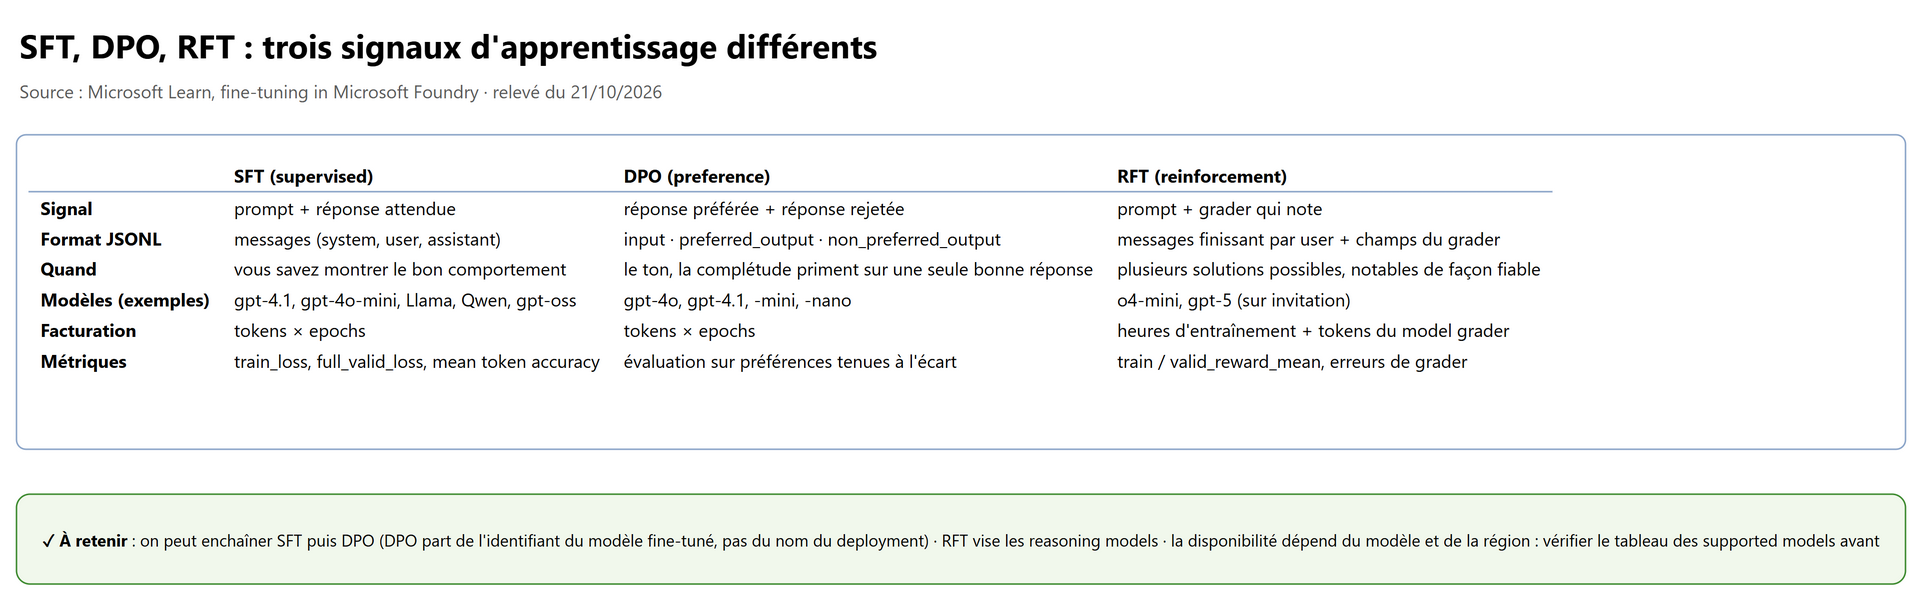
6.1 Managed fine-tuning ou interactive training#
| Managed fine-tuning | Interactive training (preview, sur approbation) | |
|---|---|---|
| Principe | vous fournissez données et réglages, Foundry exécute le job | vous écrivez une boucle Python, Foundry exécute entraînement et échantillonnage |
| Pour qui | ingénieurs IA, workflows prédéfinis | praticiens ML expérimentés |
| Vous contrôlez | données, hyperparameters supportés, graders RFT | losses, rewards, rollouts, gradient accumulation, checkpoints |
| Méthodes | SFT, DPO, RFT selon le modèle ; distillation par données SFT d'un modèle enseignant | recettes SFT, RL, préférence, distillation, losses personnalisées |
| GPU | aucun à provisionner dans les deux cas | idem |
Microsoft conseille de commencer par le managed fine-tuning. Un modèle pris en charge pour une approche, une méthode ou une modalité ne l'est pas automatiquement pour une autre : toujours vérifier le tableau Supported models.
6.2 SFT : montrer le comportement attendu#
Fichiers séparés training.jsonl et validation.jsonl, une conversation par ligne au format Chat Completions :
{"messages": [{"role": "system", "content": "Tu extrais les clauses de résiliation au format JSON."}, {"role": "user", "content": "Article 12 : chacune des parties peut résilier avec un préavis de trois mois…"}, {"role": "assistant", "content": "{\"preavis_mois\": 3, \"partie\": \"chacune\"}"}]}
Création du job avec le SDK Foundry, sans clé (la page officielle montre aussi la variante OpenAI SDK avec clé) :
import os
from azure.ai.projects import AIProjectClient
from azure.identity import DefaultAzureCredential

project = AIProjectClient(endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"], credential=DefaultAzureCredential())
client = project.get_openai_client()      # rôle Foundry User pour entraîner, Foundry Owner pour déployer

with open("training.jsonl", "rb") as f:
    training_file = client.files.create(file=f, purpose="fine-tune")
with open("validation.jsonl", "rb") as f:
    validation_file = client.files.create(file=f, purpose="fine-tune")
client.files.wait_for_processing(training_file.id)
client.files.wait_for_processing(validation_file.id)

job = client.fine_tuning.jobs.create(
    model=os.environ["FINE_TUNING_MODEL"],                 # ex. un gpt-4.1-mini pris en charge
    training_file=training_file.id, validation_file=validation_file.id,
    suffix="clauses-v1",                                   # identifie le modèle produit
    method={"type": "supervised", "supervised": {"hyperparameters": {
        "batch_size": "auto", "learning_rate_multiplier": "auto", "n_epochs": "auto"}}},
    extra_body={"trainingType": os.environ["FINE_TUNING_TRAINING_TYPE"]},   # ex. GlobalStandard
)
print(job.id, job.status)
Le même workflow existe dans le portail (Build > Fine-tune > Fine-tune), en REST et avec l'Azure Developer CLI (extension
azure.ai.finetune : azd ai finetuning jobs submit -f job.yaml, puis pause, resume, cancel quand le modèle le permet).
6.3 DPO : apprendre une préférence#
Chaque ligne contient une entrée et exactement deux sorties pour le même prompt :
{"input": {"messages": [{"role": "system", "content": "Tu réponds aux clients de façon concise."}, {"role": "user", "content": "Puis-je changer ma date de livraison ?"}]}, "preferred_output": [{"role": "assistant", "content": "Oui, depuis Mon compte > Commandes, jusqu'à 24 h avant l'expédition."}], "non_preferred_output": [{"role": "assistant", "content": "Peut-être, il faudrait voir avec le service concerné."}]}
- Le job se crée avec
method={"type": "dpo"}; les hyperparameters facultatifs vont sousmethod.dpo.hyperparameters. - DPO après SFT : on passe l'identifiant du modèle fine-tuné, pas le nom de son deployment.
- Une métrique de token accuracy ne dit pas si les réponses suivent la préférence : on évalue sur des paires tenues à l'écart, avec la même grille que les labels.
6.4 RFT et les graders#
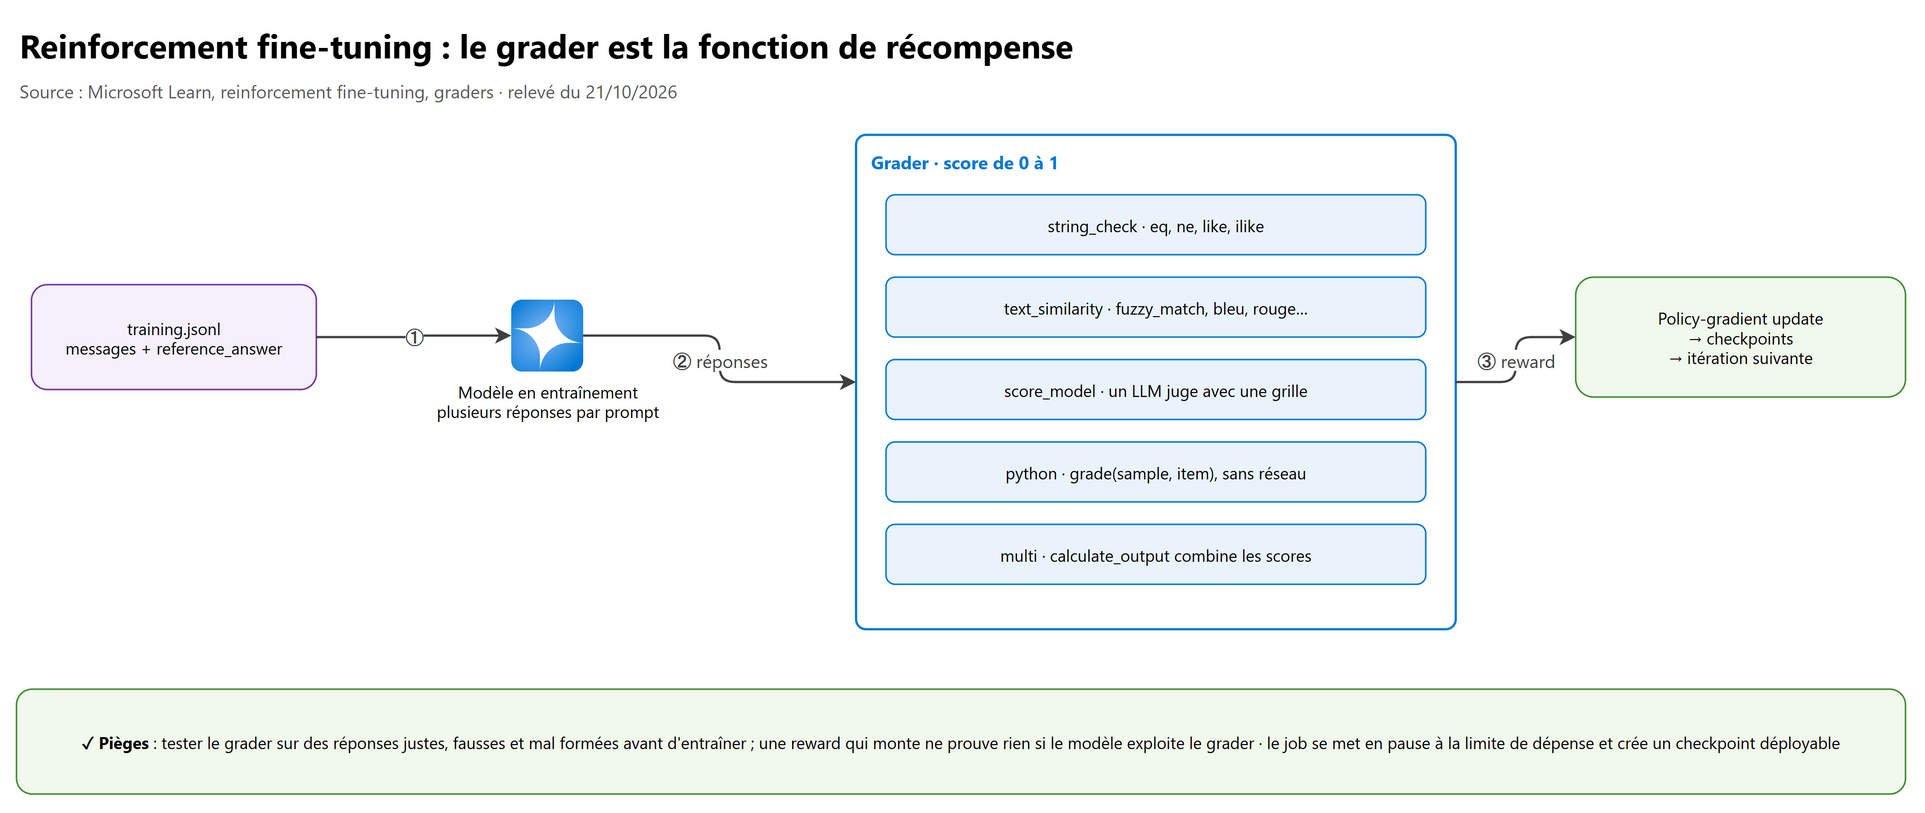
RFT améliore un reasoning model par récompense : le modèle produit plusieurs réponses par prompt, le grader les note, et des
mises à jour de type policy-gradient renforcent ce qui est bien noté. Les données : un tableau messages terminé par un message
user, plus les champs de référence dont le grader a besoin (reference_answer dans l'exemple Microsoft MedMCQ).
| Grader | Usage | Exemple |
|---|---|---|
string_check |
réponse exacte, label, sous-chaîne | operation: eq, ne, like, ilike (seul ilike ignore la casse) |
text_similarity |
proche d'une référence | evaluation_metric: fuzzy_match, bleu, gleu, meteor, rouge_1… rouge_l (cosine pour les évaluations, pas pour RFT) |
score_model |
jugement selon une grille | un modèle de notation différent du modèle entraîné, range, sampling_params |
python |
calcul spécifique | fonction grade(sample, item) qui renvoie un nombre ; runtime sans réseau |
multi |
plusieurs critères | calculate_output : expression (+ - * / ^, min, max, sqrt…) sur les sous-graders |
{
  "name": "clause_match_grader", "type": "multi",
  "graders": {
    "texte": {"name": "texte", "type": "text_similarity", "input": "{{sample.output_json.extracted_text}}",
              "reference": "{{item.extracted_text}}", "evaluation_metric": "fuzzy_match"},
    "type":  {"name": "type", "type": "string_check", "input": "{{sample.output_json.clause_type}}",
              "reference": "{{item.clause_type}}", "operation": "eq"}
  },
  "calculate_output": "(texte + type) / 2"
}
- Références de gabarit :
{{sample.output_text}}(réponse texte),{{sample.output_json}}(réponse structurée, avec unresponse_formatJSON schema dansmethod.reinforcement.response_format),{{item.<champ>}}(ligne du dataset). - Valider et tester le grader avant l'entraînement :
client.fine_tuning.alpha.graders.validate(grader=grader)puisclient.fine_tuning.alpha.graders.run(...)sur des réponses justes, fausses et mal formées. Une réponse superficielle ne doit pas obtenir un bon score. - Le job :
extra_body={"method": {"type": "reinforcement", "reinforcement": {"grader": grader}}}. Paramètres propres à RFT documentés :eval_samples,eval_interval,reasoning_effort,compute_multiplier. - Coût : RFT est facturé au temps d'entraînement (plus les tokens du model grader, facturés à part). Le job se met en
pause à la limite de dépense par job et crée un checkpoint déployable ; si on reprend, plus de limite. Pas de facturation du
travail perdu sur erreur du service ; une annulation facture le travail déjà fait. Conseils :
reasoning_effortbas pour commencer, peu d'eval_samples, le plus petit grader suffisant. - Danger : une reward qui monte ne prouve rien si le modèle exploite le grader (reward hacking) : vérifier sur un test tenu à l'écart et lire les réponses.
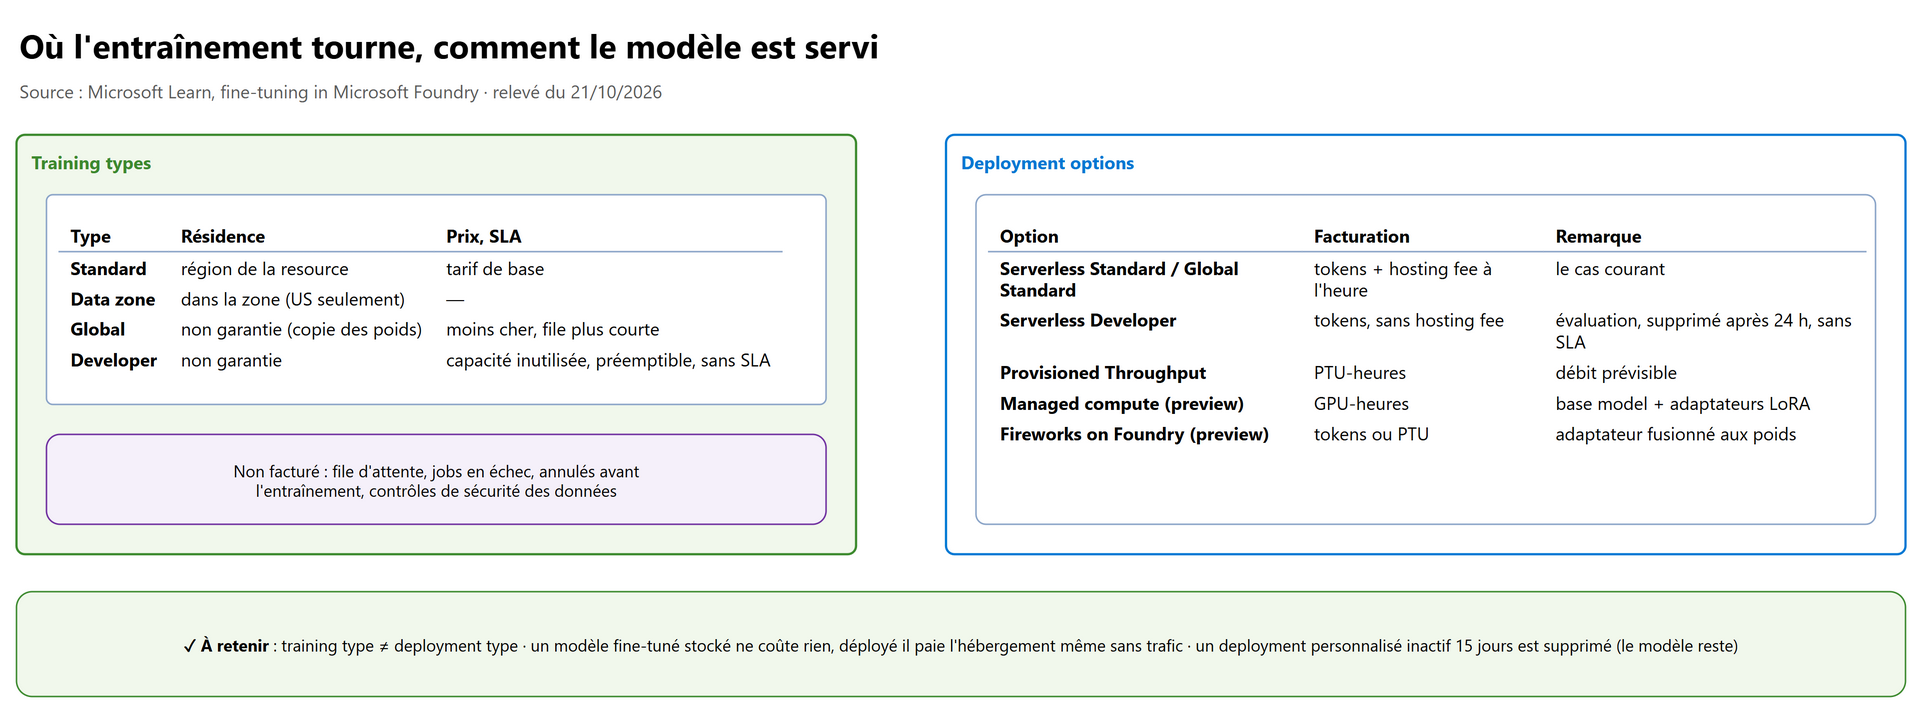
6.5 Les training types#
| Training type | Où tourne l'entraînement | Pour |
|---|---|---|
| Standard | région de la Foundry resource, résidence garantie | données qui ne doivent pas quitter la région |
| Data zone | dans la zone (US uniquement au 21/10/2026) | résidence au niveau de la zone |
| Global | capacité hors région, données et poids copiés | moins cher, files plus courtes, sans contrainte de résidence |
| Developer | capacité inutilisée, préemptible, sans SLA ni résidence | expérimentation, budget serré ; un job en pause reprend seul et n'est pas facturé pendant la pause |
L'API utilise par exemple GlobalStandard pour Global. Training type ≠ deployment type : le premier dit où le modèle est
entraîné, le second comment il est servi (9).
6.6 Les hyperparameters#
| Hyperparameter (API v1) | Effet | Si overfitting |
|---|---|---|
n_epochs (CLI : epochs) |
nombre de passages complets sur les données | diminuer |
learning_rate_multiplier |
multiplie le learning rate d'entraînement | diminuer |
batch_size |
exemples par passe ; plus grand = mises à jour moins fréquentes et moins variables | — |
Commencer par les valeurs par défaut (auto) et ne changer qu'après comparaison des résultats de validation. Les valeurs admises
dépendent du modèle.
6.7 Vision fine-tuning et tool calling#
- Vision : images dans les messages
user(URL publique ou data URI base64), modèlesgpt-4o(2024-08-06) etgpt-4.1(2025-04-14) uniquement. Limites : 50 000 exemples avec images, 64 images par exemple, 10 MB par image, JPEG / PNG / WEBP en RGB ou RGBA, au moins 10 exemples, pas d'image en sortie de l'assistant. Les images avec personnes, visages, enfants ou CAPTCHA sont exclues automatiquement.detail: "low"(512 × 512) réduit le coût d'entraînement. Non pris en charge en Japan East. - Tool calling : on fine-tune avec des exemples d'appels d'outils pour améliorer le choix d'outil et les arguments, même sans toutes les définitions d'outils dans le prompt (page dédiée « fine-tuning functions »).
6.8 Distillation vers un plus petit modèle#
Principe : utiliser les sorties d'un grand modèle enseignant pour faire un SFT d'un petit modèle, qui atteint une
qualité proche sur la tâche, à coût et latence moindres. Dans le Foundry actuel, la distillation passe par des données SFT
générées par le modèle enseignant (ou les recettes de distillation de l'interactive training, en preview). L'ancienne
fonctionnalité stored completions & distillation (store=True, puis Distill) est retirée depuis le 15/10/2026 (UI et
API arrêtées) ; la doc de migration renvoie vers la Responses API et les Agent Traces, qui servent désormais de source pour
les jeux d'évaluation et de fine-tuning. Si une question d'examen la cite, retenir le principe (réponses d'un grand modèle →
dataset SFT d'un petit), pas le bouton.
6.9 Les modèles et la disponibilité (relevé du 21/10/2026)#
Extrait du tableau Supported models : gpt-4.1, gpt-4.1-mini, gpt-4.1-nano et gpt-4o (SFT, DPO) ; gpt-4o-mini,
Llama-3.3-70B-Instruct, Qwen3-32B, gpt-oss-20b, Ministral-3B (SFT) ; o4-mini (RFT) ; gpt-5 (RFT sur invitation) ;
plusieurs modèles en preview avec interactive training et déploiement managed compute ou Fireworks. Le tableau change souvent : à
l'examen, retenez le principe (méthode, training type et deployment option dépendent du modèle et de la région).
7. Les données synthétiques pour le fine-tuning#
7.1 Pourquoi#
Microsoft cite quatre raisons : créer de grands jeux variés quand les données réelles manquent, préserver la confidentialité tout en gardant une structure utile, produire des données propres à l'entreprise depuis ses documents ou son code, et réduire le coût de la collecte manuelle.
7.2 Dans Foundry (preview)#
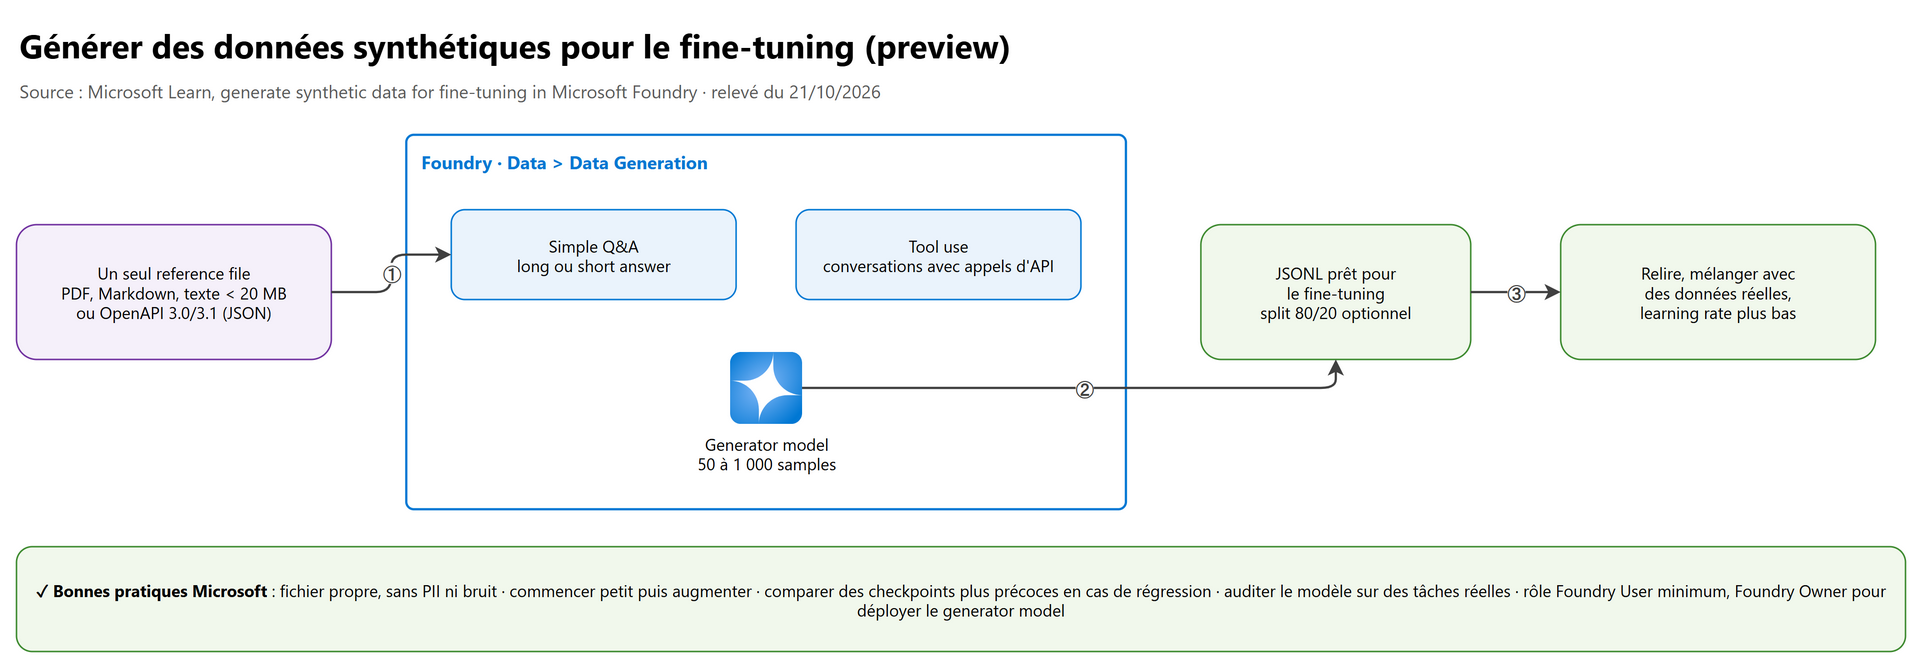
Data > Data Generation (preview) > Create dataset > Generate synthetic data :
| Générateur | Fichier de référence | Produit |
|---|---|---|
| Simple Q&A | un PDF, Markdown ou texte de moins de 20 MB | paires question-réponse ; paramètre Long answer (raisonnement analytique) ou Short answer (brièveté factuelle) |
| Tool use | une spécification OpenAPI 3.0.x ou 3.1.x en JSON de moins de 20 MB | conversations multi-tours avec appels d'outils sur votre API |
Réglages : 50 à 1 000 samples, generator model (déployé automatiquement s'il ne l'est pas), split 80/20 train/validation optionnel, suffixe du job. Sortie : JSONL compatible avec le fine-tuning, utilisable directement par Use this dataset. Un seul fichier de référence par génération (combiner les documents avant). Prérequis : rôle Foundry User au minimum (ou Foundry Project Manager), Foundry Owner pour déployer le generator model, et une région prise en charge.
Ne pas confondre avec la génération de données synthétiques d'évaluation (Dataset usage = Evaluation, Simple QnA ou Simulation seed multi-tours, 1 à 1 000 samples, ou
azure_ai_synthetic_data_gen_previewdans le SDK, 15 à 1 000) qui sert à tester un agent avant d'avoir du trafic (06).
7.3 Bonnes pratiques et risques#
- Fichier de référence propre : pas de bruit (menus de navigation), pas de PII ni de données sensibles. Pour Tool use, des descriptions claires de chaque chemin et paramètre, politiques métier comprises.
- Commencer petit, relire les sorties, ajuster, puis augmenter : on évite des coûts inutiles.
- Fine-tuner sur du synthétique avec un learning rate plus bas pour limiter l'overfitting, et essayer des checkpoints plus précoces en cas de régression.
- Mélanger avec une part de données réelles pour mieux généraliser.
- Auditer le modèle sur des tâches réelles : un jeu synthétique peut porter des biais ou des erreurs du generator model.
8. Surveiller et optimiser un modèle fine-tuné#
8.1 Les métriques d'entraînement#
| Méthode | Métriques (API) | Lecture |
|---|---|---|
| SFT | train_loss, full_valid_loss, train_mean_token_accuracy, full_valid_mean_token_accuracy |
la loss baisse et l'accuracy monte ; si la loss d'entraînement baisse mais que la loss de validation remonte, c'est de l'overfitting : moins d'epochs ou un learning rate multiplier plus petit |
| DPO | métriques du job + évaluation sur préférences tenues à l'écart | la token accuracy ne mesure pas la préférence |
| RFT | train_reward_mean, valid_reward_mean, scores par grader, erreurs de grader (data.errors.graders), train/valid_reasoning_tokens_mean |
la reward de validation est le signal le plus stable ; plus de reasoning tokens ≠ meilleur modèle |
job = client.fine_tuning.jobs.retrieve("<JOB_ID>")
print(job.status, job.fine_tuned_model, job.result_files)
for event in client.fine_tuning.jobs.list_events(job.id).data:      # journal et métriques
    print(event.created_at, event.message)
checkpoints = client.fine_tuning.jobs.checkpoints.list(job.id)      # versions intermédiaires déployables
Le fichier de résultats CSV (result_files) se télécharge avec client.files.content(...).
8.2 Choisir le bon checkpoint#
- Ne pas supposer que le dernier checkpoint est le meilleur ; comparer les candidats sur un test tenu à l'écart (jamais vu à l'entraînement ni à la validation).
- Ne pas décider sur la training loss seule.
- Évaluer avant / après avec les mêmes évaluateurs que le baseline (qualité, sécurité, tâche) : Run evaluations dans le portail ou la cloud evaluation du SDK.
8.3 Les défis documentés#
| Défi | Réponse Microsoft |
|---|---|
| Qualité et couverture des données | exemples exacts, cohérents, représentatifs ; chercher trous, doublons, biais, données sensibles |
| Overfitting, fuite d'évaluation | séparer train, validation et test final ; comparer les checkpoints sur des tâches tenues à l'écart |
| Récompenses trompeuses (RFT) | tester le grader sur des réponses justes, fausses et adverses |
| Coût des essais | budgéter runs, grading, évaluation, hébergement ; arrêter les essais qui n'améliorent pas la métrique cible |
| Compatibilité | vérifier méthode, tier, version et déploiement ; un adaptateur ne se transpose pas à un base model au nom proche |
| Maintenance | réévaluer quand les données changent ou que le base model approche de son retrait |
| Sécurité et gouvernance | garder les contrôles de sécurité applicatifs et évaluer le runtime final |
9. Du développement à la production#
9.1 Les options de déploiement#
| Option | Facturation | Points clés |
|---|---|---|
| Serverless · Standard | tokens + hosting fee à l'heure | région du deployment |
| Serverless · Global Standard | tokens + hosting fee | poids pouvant être stockés temporairement hors de la géographie |
| Serverless · Data Zone Standard | tokens | US uniquement |
| Serverless · Developer | tokens au tarif Global Standard, pas de hosting fee | pour l'évaluation : supprimé après 24 h, sans SLA ni résidence |
| Provisioned Throughput / Global Provisioned | PTU-heures | débit prévisible (Global Provisioned pour les custom models importés) |
| Managed compute (preview) | GPU-heures, même sans requêtes | base deployment avec un deployment template LoRA + adaptateurs compatibles |
| Fireworks on Foundry (preview) | tokens (modèles du catalogue) ou PTU (custom models importés) | à activer par un Owner ou Contributor de l'abonnement |
Déployer demande le rôle Foundry Owner (ou Microsoft.CognitiveServices/accounts/deployments/write) ; on déploie depuis le
job terminé : Deploy > Serverless | Managed Compute | Fireworks.
9.2 Les règles qui coûtent cher si on les oublie#
- Un modèle fine-tuné stocké ne coûte rien ; déployé, il paie l'hébergement à l'heure même sans aucun appel.
- Un deployment de modèle personnalisé inactif pendant 15 jours (aucun appel sur une période continue de 15 jours) est supprimé automatiquement ; le modèle reste et se redéploie. Règle documentée pour les modèles Azure OpenAI fine-tunés (pages Customize a model with fine-tuning et Plan to manage costs) ; la nouvelle page Foundry Deploy fine-tuned models (Serverless, Managed Compute, Fireworks) ne la reprend pas : la vérifier pour un modèle non-OpenAI.
- Annuler un job ne supprime pas les deployments et n'arrête pas leurs frais.
- Le system message utilisé en production doit être le même qu'à l'entraînement, sinon le modèle peut mal se comporter.
- On ne peut pas supprimer un modèle fine-tuné qui a encore un deployment.
9.3 Le cycle de vie complet#
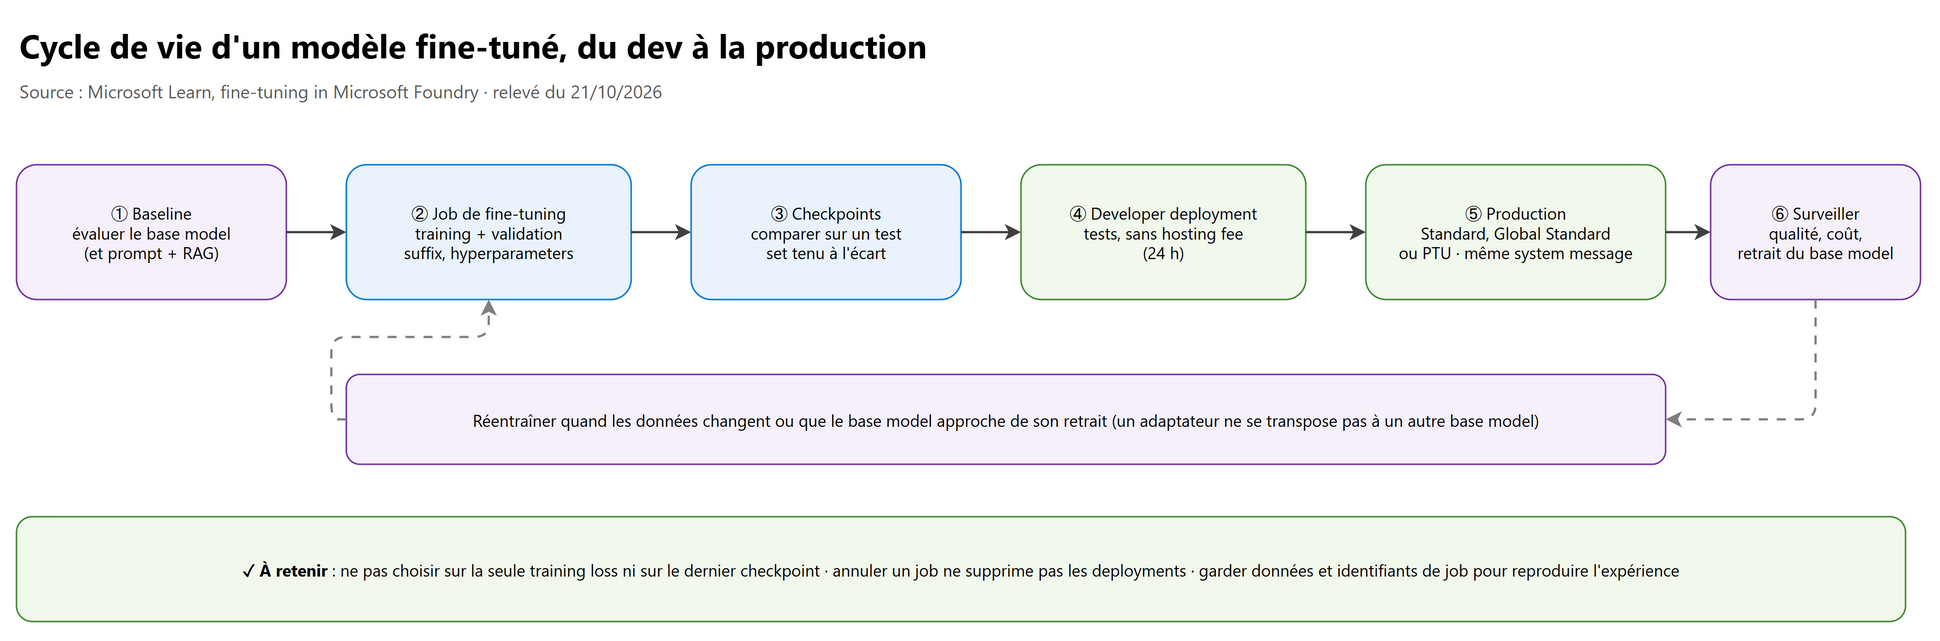
flowchart LR
    A["Baseline : base model + prompt + RAG évalués"] --> B["Données : réelles + synthétiques, train / validation / test"]
    B --> C["Job : SFT, DPO ou RFT, training type"]
    C --> D["Checkpoints comparés sur le test tenu à l'écart"]
    D -->|"meilleur que le baseline"| E["Developer deployment : tests 24 h"]
    D -->|"pas mieux"| B
    E --> F["Production : Standard, Global Standard ou PTU"]
    F --> G["Surveiller qualité, coût, retrait du base model"]
    G -->|"dérive ou retrait annoncé"| B
Coût mensuel type documenté (o4-mini fine-tuné, 30 jours, 10 000 conversations) : 720 × H (hébergement) + 20 × I (20 M tokens
en entrée) + 40 × O (40 M tokens en sortie), avec les tarifs H, I, O de la page de prix. Pour un SFT : tokens du fichier
× epochs × prix par token (exemple Microsoft : 1 M tokens, 2 epochs → 2T). On ne paie ni la file d'attente, ni les jobs en
échec, ni ceux annulés avant le début de l'entraînement, ni les contrôles de sécurité des données.
10. Labs conseillés#
À faire dans un abonnement de test, avec une Foundry resource dans une région qui propose le modèle et le training type voulus. Supprimez les deployments à la fin : l'hébergement d'un modèle fine-tuné est facturé à l'heure.
- Régler la récupération (≈ 1 h, coût faible : Azure AI Search Basic, semantic ranker en quota gratuit si disponible).
- Indexer un corpus de 50 documents avec deux tailles de chunks (256 et 512 tokens, 25 % d'overlap).
- Préparer 20 questions avec qrels (note 0 à 4).
- Comparer vector seul, hybride, hybride + semantic avec
document_retrieval. - Résultat attendu : NDCG et Fidelity meilleurs en hybride + semantic sur les questions à mots exacts.
- Seuil et hors sujet (30 min). Envoyer une question hors domaine en vector query : constater que
krésultats reviennent quand même, puis ajouterthreshold(API preview). Résultat attendu : moins de résultats, ou aucun, pour la question hors sujet. - SFT puis DPO (2 h, coût : tokens × epochs + hébergement si déployé).
- SFT de
gpt-4.1-minien Developer training sur 50 à 100 exemples. - Puis DPO à partir du modèle fine-tuné.
- Comparer les checkpoints, puis déployer en Developer deployment.
- Résultat attendu : format respecté mieux que le baseline sur le test tenu à l'écart ; deployment supprimé seul après 24 h.
- SFT de
- Données synthétiques (45 min). Générer 50 samples Simple Q&A depuis un PDF interne non sensible, split 80/20, relire 10 exemples, corriger le fichier de référence, régénérer. Résultat attendu : un JSONL directement utilisable par Use this dataset.
- Grader RFT à blanc (30 min, sans entraîner). Écrire un grader
multi(text_similarity+string_check), le valider avecgraders.validateet le tester avecgraders.runsur une réponse juste, une fausse et une mal formée. Résultat attendu : les scores trient correctement les trois réponses ; sinon, corriger avant tout job.
Nettoyage : client.fine_tuning.jobs.cancel(...), client.files.delete(...), suppression des deployments sur la page Models,
puis du groupe de ressources de test.
11. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Une vector query renvoie des chunks pour une question absurde | Normal : elle renvoie toujours k voisins ; threshold ou hybride |
Pas de résultat vide en vectoriel |
| Mettre un seuil minimal sur un score hybride | Déconseillé : seuil sur la part vectorielle | Les scores RRF sont étroits et volatils |
| Donner plus de poids au vecteur qu'au texte dans une requête hybride | weight sur la vector query (le texte : maxTextRecallSize) |
weight agit dans le calcul RRF |
| Le classement final doit suivre la fraîcheur malgré le semantic ranker | Scoring profile + rankingOrder: boostedRerankerScore |
Sinon le reranking efface le boost |
| Termes métier rares mal retrouvés | Hybrid search (mots exacts) et embedding de domaine ou fine-tuné | Problème de vocabulaire de l'embedding |
| Changer d'embedding model en production | Revectoriser tout l'index ; même modèle à l'indexation et à la requête | Espaces vectoriels incompatibles |
| Fine-tuner un embedding dans le managed fine-tuning de Foundry | Pas proposé : Azure Machine Learning + AML skill / vectorizer | Le tableau des supported models ne contient pas d'embedding |
Calibrer top_k et la taille des chunks avec des qrels |
Évaluateur Document Retrieval (parameter sweep) | Métriques de recherche précises (NDCG, XDCG, Fidelity) |
| Évaluer la pertinence des chunks sans vérité terrain | Évaluateur Retrieval (LLM juge) | Document Retrieval exige des qrels |
| Comparer deux configurations RAG sur du vrai trafic | Variant feature flag Experiment d'Azure App Configuration + télémétrie | A/B testing en ligne, kill switch |
| Le modèle doit adopter un ton préféré, pas une seule bonne réponse | DPO | Paires préférée / rejetée |
| Améliorer le raisonnement d'un o4-mini sur un domaine objectif | RFT avec grader | Récompense notée |
| Démontrer exactement le format attendu | SFT | Prompt + réponse cible |
| DPO après un SFT | Utiliser l'identifiant du modèle fine-tuné | Pas le nom du deployment |
| Données qui ne doivent pas quitter la région | Training type Standard | Global et Developer ne garantissent pas la résidence |
| Expérimenter au moindre coût sans contrainte de délai | Training type Developer | Capacité préemptible, pas de SLA |
| Training loss en baisse, validation loss en hausse | Overfitting : moins d'epochs, learning rate multiplier plus petit, checkpoint antérieur | Le modèle apprend par cœur |
| La reward RFT monte mais les réponses sont mauvaises | Le modèle exploite le grader : retester le grader, évaluer sur test tenu à l'écart | Reward hacking |
| Tester un modèle fine-tuné sans payer d'hébergement | Developer deployment | Pas de hosting fee, supprimé après 24 h |
| Un deployment fine-tuné a disparu | Inactif 15 jours → supprimé ; redéployer, le modèle existe toujours | Règle des deployments personnalisés |
| Le job est annulé, la facture continue | Les deployments restent : les supprimer | Annuler ne supprime pas les deployments |
| Réponses étranges après déploiement | Utiliser le même system message qu'à l'entraînement | Écart d'instructions |
| Images de visages ignorées en vision fine-tuning | Exclusion automatique (personnes, visages, enfants, CAPTCHA) | Politique de modération |
| Générer des données d'entraînement depuis une spec d'API | Générateur Tool use (OpenAPI 3.0/3.1 en JSON) | Simple Q&A part d'un document |
| Rôle minimal pour lancer un SFT | Foundry User ; Foundry Owner pour aussi déployer | RBAC Foundry renommé |
12. Scénarios corrigés#
1. Une assistance juridique utilise une recherche vectorielle seule. Les questions citant un numéro d'article exact (« article L1234-5 ») échouent souvent. Que faire en premier ?
- A. Fine-tuner
gpt-4.1sur les articles - B. Passer en hybrid search (BM25 + vecteur), puis semantic ranker
- C. Augmenter
kà 500 - D. Changer de région
B. Les identifiants exacts sont le point faible du vecteur et le point fort de BM25. Le fine-tuning ne règle pas un problème de récupération ; augmenter
knoie le contexte.
2. Vous avez 300 questions avec des documents notés de 0 à 4 et vous voulez choisir entre 256 et 512 tokens par chunk et entre
top_k 5 et 10. Quel évaluateur ?
- A. Relevance
- B. Groundedness
- C. Document Retrieval
- D. Fluency
C. Il exige des qrels et sert précisément au parameter sweep des réglages de recherche.
3. Un modèle doit répondre aux réclamations avec un ton apaisant et complet ; plusieurs réponses correctes existent et les experts savent dire laquelle est meilleure. Méthode ?
DPO (préférée / rejetée). Si le format de base n'est pas maîtrisé, d'abord un SFT, puis DPO en partant de l'identifiant du modèle fine-tuné.
4. Une banque veut améliorer o4-mini sur la classification de risques ; chaque cas a une réponse vérifiable. Quoi configurer et quel risque surveiller ?
RFT avec un grader (
string_checksur le label, oumultisi plusieurs critères), testé avant l'entraînement. Surveiller que la reward ne monte pas parce que le modèle exploite le grader, et comparer sur un test tenu à l'écart.
5. Les données de santé ne doivent pas quitter la région France Central. Quel training type, et qu'en est-il du déploiement ?
Training type Standard (résidence de la région) si le modèle le propose dans cette région ; Global et Developer ne garantissent pas la résidence. Pour le serving, éviter Global Standard (poids possiblement stockés hors géographie) au profit d'un deployment Standard régional disponible. Vérifier le tableau des régions.
6. Après fine-tuning, train_loss baisse jusqu'à la fin, full_valid_loss remonte dès la 3e epoch. Que faire ?
Overfitting : choisir un checkpoint antérieur ou relancer avec moins d'epochs et un learning rate multiplier plus petit ; comparer sur le test tenu à l'écart.
7. L'équipe teste trois modèles fine-tunés pendant une journée et veut éviter les frais d'hébergement. Comment déployer ?
Developer deployment : tokens au tarif Global Standard, pas de hosting fee, supprimé après 24 h, sans SLA : réservé à l'évaluation.
8. Un deployment fine-tuné de production a disparu après des congés de trois semaines sans trafic. Pourquoi, et que faire ?
Un deployment personnalisé inactif 15 jours est supprimé automatiquement. Le modèle existe toujours : le redéployer. Pour l'éviter, un trafic minimal ou un redéploiement automatisé ; à l'inverse, en dev, cette règle protège des frais oubliés.
9. Pas de données réelles pour fine-tuner un agent qui appelle l'API de réservation de l'entreprise. Que proposez-vous ?
Synthetic data generation de Foundry, générateur Tool use, à partir de la spécification OpenAPI 3.0/3.1 (JSON, < 20 MB) avec des descriptions de chemins et de paramètres incluant les règles métier ; commencer par 50 samples, relire, puis augmenter et mélanger ensuite avec des conversations réelles anonymisées.
10. Une nouvelle configuration RAG gagne hors ligne. Le métier veut la valider sur 20 % des utilisateurs avec un retour arrière immédiat possible. Quelle solution ?
Un variant feature flag de type Experiment dans Azure App Configuration (allocation 80 / 20), la configuration RAG externalisée (AI configuration), la télémétrie et la continuous evaluation pour comparer, et le kill switch pour revenir en arrière.
13. Pour aller plus loin#
- Entraîner ou héberger soi-même (pré-entraînement, GPU ND / NC, KAITO sur AKS, quantization, coût total) : 08 · Entraîner et choisir un LLM et AKS · 06.
- Interactive training (preview) : boucle Python personnalisée (rollouts, rewards, losses) sur l'infrastructure de Foundry, sur approbation ; facturé par catégories de tokens (prefill, cached prefill, sampling, training).
- Managed compute et LoRA : servir plusieurs adaptateurs LoRA sur un même base deployment GPU (preview).
- RAG Experiment Accelerator : cadre open source de Microsoft pour automatiser les expériences de chunking, d'embedding et de recherche.
- Guide Architecture Center « Design and develop a RAG solution » : préparation, chunking, enrichissement, embeddings, récupération, évaluation bout en bout, agentic RAG.
14. Fiche à retenir#
- Ordre : prompt → RAG réglé et mesuré → fine-tuning si un écart mesuré persiste ; le fine-tuning ne remplace pas le RAG.
- Chunking : départ 512 tokens, 25 % d'overlap ; choix semi-permanent ; respecter la limite de tokens de l'embedding model.
- Vector query : renvoie toujours k résultats ; 50 par défaut ;
threshold(preview) sur le vecteur, pas sur l'hybride. - Hybride = BM25 + vecteur fusionnés par RRF ;
weightpour le vecteur,maxTextRecallSizepour le texte. - Semantic ranker : rerank des 50 premiers,
@search.rerankerScore0 à 4, premium ;boostedRerankerScorepour garder un scoring profile. - Embedding : démarche domaine ? → modèle de domaine ? → fine-tuner ; juger sur la récupération ; changer = revectoriser ; fine-tuning d'embedding via Azure ML.
- Document Retrieval (qrels : NDCG, XDCG, Fidelity, Max Relevance, Holes) pour régler ; Retrieval, Groundedness, Relevance sans qrels.
- A/B testing en ligne : variant feature flag Experiment d'Azure App Configuration, kill switch.
- SFT = réponse attendue ; DPO = préférée / rejetée (après SFT : identifiant du modèle) ; RFT = grader, reasoning models.
- Graders :
string_check,text_similarity,score_model,python(sans réseau),multi; les tester avant. - Training types : Standard (résidence), Data zone (US), Global (moins cher), Developer (préemptible, sans SLA).
- Coûts : SFT/DPO = tokens × epochs ; RFT = heures + tokens du grader, pause à la limite de dépense ; rien pour file d'attente et échecs.
- Overfitting : validation loss qui remonte → moins d'epochs, learning rate multiplier plus petit, checkpoint antérieur.
- Synthetic data (preview) : Simple Q&A (document < 20 MB) ou Tool use (OpenAPI 3.0/3.1), 50 à 1 000 samples, split 80/20.
- Déploiement : hosting fee à l'heure même sans trafic ; Developer = 24 h sans hosting fee ; inactif 15 jours → supprimé.
- Même system message qu'à l'entraînement ; annuler un job ne supprime pas les deployments ; Foundry User entraîne, Foundry Owner déploie.
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Study guide for Exam AI-300
- Fine-tuning in Microsoft Foundry (overview, training types, deployment options, supported models)
- Fine-tune a model with supervised fine-tuning
- Fine-tune a model with direct preference optimization
- Fine-tune a model with reinforcement fine-tuning
- Vision fine-tuning
- Manage fine-tuning costs in Microsoft Foundry
- Deploy fine-tuned models in Microsoft Foundry
- Generate synthetic data for fine-tuning (preview)
- Generate a synthetic evaluation dataset
- Azure OpenAI fine-tuning considerations
- Azure OpenAI FAQ : why was my fine-tuned model deployment deleted?
- Azure OpenAI stored completions and distillation (retiré le 15/10/2026, classic)
- Migrate from stored completions to Responses API and Agent Traces
- RAG generate embeddings phase (Azure Architecture Center)
- Deploy fine-tuned models in Microsoft Foundry
- Retrieval-Augmented Generation (RAG) evaluators
- Create a vector query in Azure AI Search (k, weight, threshold)
- Hybrid search using vectors and full-text search
- Relevance in Azure AI Search
- Semantic ranking in Azure AI Search
- Use scoring profiles with semantic ranker
- Chunk large documents for RAG and vector search
- RAG chunking phase (Architecture Center)
- RAG generate embeddings phase (Architecture Center)
- Large language model end-to-end evaluation (RAG Experiment Accelerator)
- Generate embeddings for search queries and documents
- Use variant feature flags (Azure App Configuration)
- AI configuration in Azure App Configuration