
Version : 1.0 · Date : 2026-10-23 · Parcours SUPPORT-IA (support N2/N3 de chatbots sur Azure)
En une phrase : sur AKS, une panne de chatbot se trouve presque toujours en lisant dans l'ordre le chemin d'une requête (Ingress → Service → endpoints → pod), l'état du pod (
describe,logs --previous), puis ses dépendances Azure (image dans ACR, jeton Workload ID, secrets Key Vault montés par le Secrets Store CSI Driver).
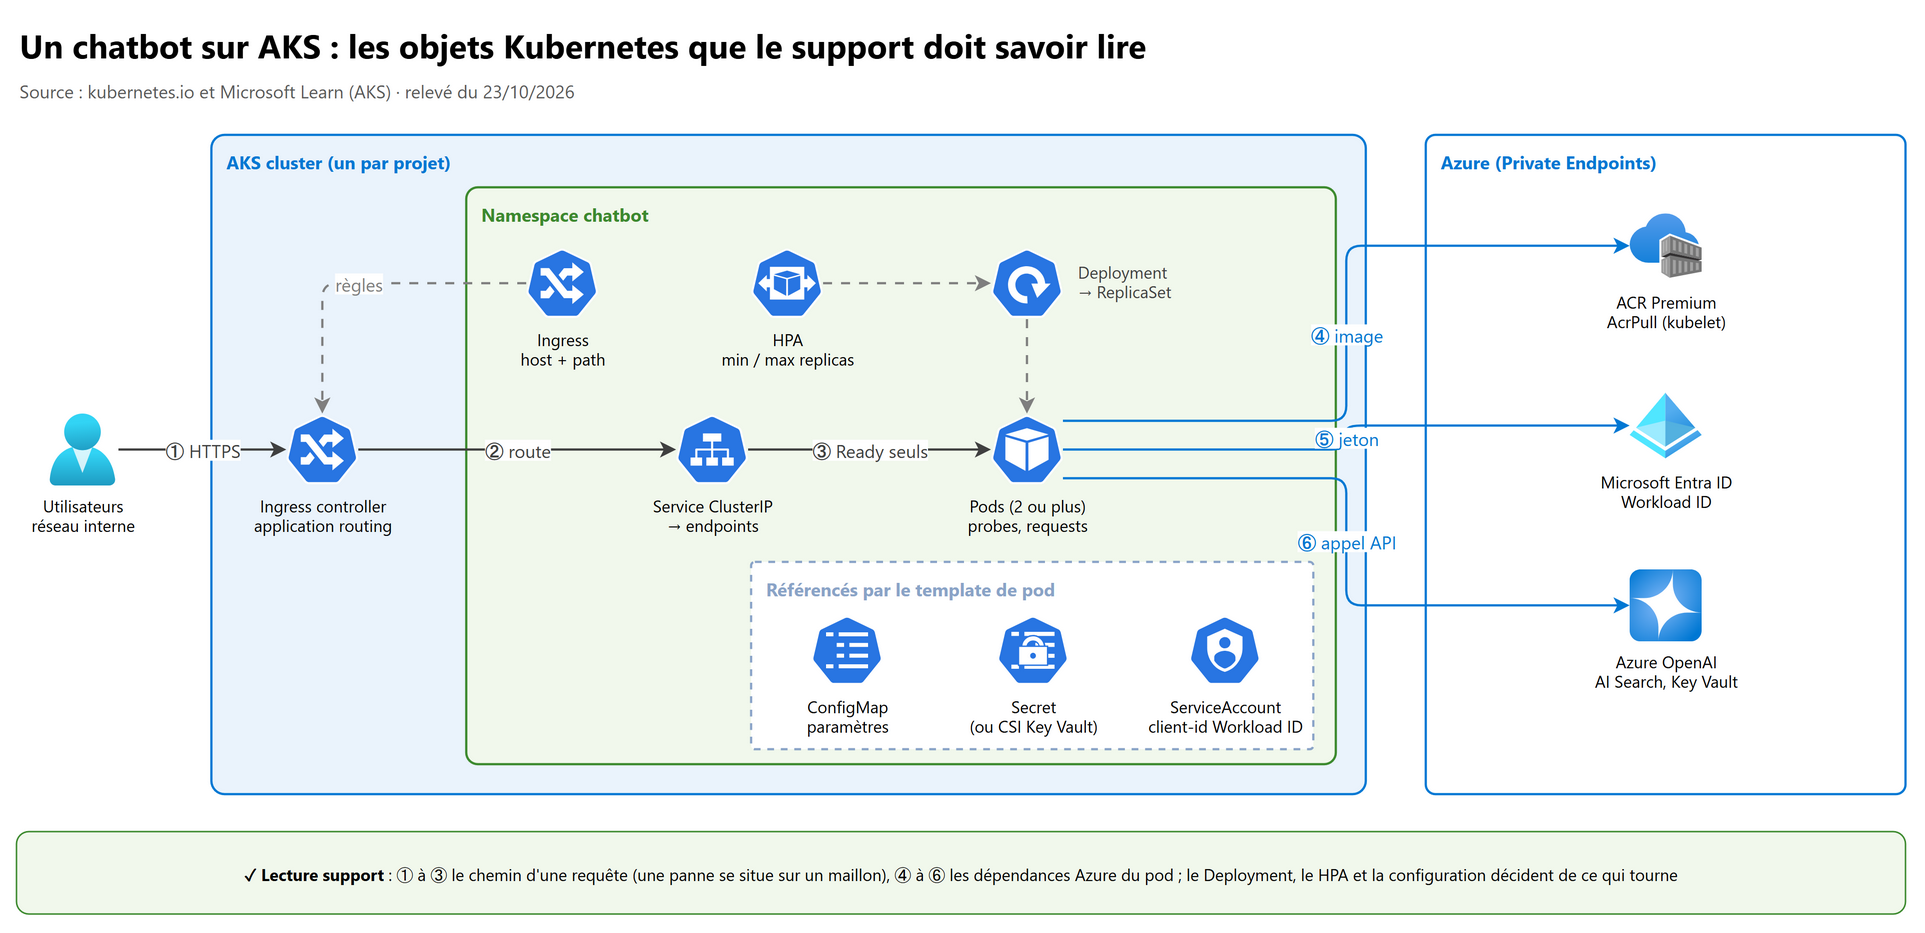
Ce chapitre prend l'angle support : reconnaître un symptôme, savoir où regarder, prouver la cause, proposer la correction. Les choix d'architecture sont traités dans le parcours AKS : identités et secrets dans AKS/03-identite-securite, observabilité et runbooks dans AKS/05-exploitation-gitops, réseau et Ingress dans AKS/02-reseau. La chaîne de déploiement (Azure DevOps, ACR, Argo CD) est dans 05-gitops-argocd-azure-devops-acr, la Web App for Containers dans 06-web-app-for-containers-privee.
Les noms d'objets, de fonctionnalités et de rôles restent en anglais, comme dans kubectl et le portail.
Ce que tu dois savoir expliquer en entretien#
| Question type | Section |
|---|---|
| « Pod, Deployment, Service, Ingress, ConfigMap, Secret : à quoi sert chacun et comment ils se relient ? » | 1 |
| « Un pod est en CrashLoopBackOff, ImagePullBackOff, Pending, OOMKilled : que fais-tu ? » | 2, 6 |
« Comment lis-tu un kubectl describe ? » |
3 |
| « Comment un pod accède-t-il à Azure OpenAI ou Key Vault sans secret ? Qu'est-ce que l'OIDC issuer ? » | 4 |
| « Comment les secrets Key Vault arrivent-ils dans le pod ? Et la rotation ? » | 5 |
1. Les objets à savoir lire#
1.1 La carte des objets#
| Objet | Rôle | Ce que le support regarde |
|---|---|---|
| Namespace | Périmètre logique (droits, quotas, noms) ; un chatbot = un namespace, souvent un cluster par projet | -n <ns> sur chaque commande ; ResourceQuota et LimitRange du namespace |
| Pod | Unité exécutée : un ou plusieurs conteneurs qui partagent réseau et volumes ; planifié une seule fois sur un node | Phase, état de chaque conteneur, Restart Count, Conditions, Events |
| ReplicaSet | Maintient N pods identiques ; créé et géré par le Deployment (label pod-template-hash) |
kubectl get rs : quel ReplicaSet porte les pods, l'ancien est-il encore là ? |
| Deployment | Déclare l'état voulu (image, replicas, probes) et gère les rollouts | rollout status, rollout history, conditions Available et Progressing |
| Service | Adresse stable devant des pods sélectionnés par labels | Les endpoints (EndpointSlices) : vides = aucun pod sélectionné ou aucun pod Ready |
| Ingress | Règles HTTP (host, path) appliquées par un Ingress controller | ingressClassName, adresse publiée, logs du controller |
| ConfigMap / Secret | Configuration et données sensibles injectées en variables ou en fichiers | Clé présente ? Montée comment (variable, volume, subPath) ? |
| ServiceAccount | Identité Kubernetes du pod ; porte l'annotation Workload ID | azure.workload.identity/client-id, serviceAccountName du pod |
| HorizontalPodAutoscaler | Ajuste replicas selon une métrique |
kubectl get hpa : cible, valeur actuelle, min/max |
1.2 Deployment, ReplicaSet et rollout#
- Un rollout n'est déclenché que si le template de pod (
.spec.template) change (image, variable, label…). Changerreplicasne crée pas de révision. Corollaire support : pousser une nouvelle image sous le même tag ne change rien au template, donc ne déclenche rien. - Stratégie par défaut
RollingUpdate:maxUnavailable25 % etmaxSurge25 %. progressDeadlineSeconds(600 s par défaut) : passé ce délai sans progrès, la conditionProgressingdevientFalseavec la raisonProgressDeadlineExceeded. Le controller continue d'essayer, mais l'état est signalé (et Argo CD passe enDegraded).revisionHistoryLimit(10 par défaut) : nombre d'anciens ReplicaSets gardés, donc de retours arrière possibles.- Causes de rollout bloqué listées par Kubernetes : quota insuffisant, readiness en échec, erreur de pull d'image, droits insuffisants, LimitRange, mauvaise configuration applicative.
kubectl rollout status deployment/chat-api -n chatbot          # attend la fin, code retour ≠ 0 si échec
kubectl rollout history deployment/chat-api -n chatbot         # révisions
kubectl rollout undo deployment/chat-api -n chatbot            # revient à la révision précédente
kubectl rollout restart deployment/chat-api -n chatbot         # recrée les pods (annotation restartedAt dans le template)
kubectl get rs -n chatbot -l app=chat-api                      # ancien et nouveau ReplicaSet, replicas de chacun
Piège GitOps :
rollout undoourollout restartmodifient le cluster sans passer par Git. Avec Argo CD etselfHeal, la modification est annulée ; sansselfHeal, l'application passeOutOfSync. Le vrai retour arrière se fait dans Git (chapitre 05). En incident,undoreste un geste d'urgence à signaler et à reporter dans Git.
1.3 Service et endpoints#
| Type | Exposition | Usage dans un chatbot |
|---|---|---|
ClusterIP (défaut) |
IP interne au cluster | API derrière l'Ingress, Redis, services internes |
NodePort |
Port sur chaque node | Rare sur AKS |
LoadBalancer |
Azure Load Balancer (public ou interne avec annotation) | Ingress controller, service exposé directement |
ExternalName |
Alias DNS (CNAME) | Pointer vers un nom externe |
Le Service sélectionne des pods par labels ; Kubernetes publie leurs adresses dans des EndpointSlices, et seuls les pods Ready reçoivent le trafic.
kubectl get svc chat-api -n chatbot -o wide                                  # selector et ports
kubectl get endpointslices -n chatbot -l kubernetes.io/service-name=chat-api  # adresses réellement servies
kubectl get pods -n chatbot -l app=chat-api --show-labels                    # les labels collent-ils au selector ?
Endpoints vides : selector qui ne correspond à aucun label (faute de frappe après un refactoring Helm), ou pods existants mais
pas Ready (readiness probe). targetPort différent du port d'écoute du conteneur : endpoints présents, mais connexion refusée.
1.4 Ingress, Ingress controller et application routing#
L'Ingress est une règle ; c'est l'Ingress controller qui reçoit le trafic et l'applique. Sur AKS, le controller géré est
l'application routing add-on (NGINX managé) : son IngressClass s'appelle webapprouting.kubernetes.azure.com, ses pods
tournent dans app-routing-system.
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata: { name: chat-api, namespace: chatbot }
spec:
  ingressClassName: webapprouting.kubernetes.azure.com    # sans classe valide, aucun controller ne prend la règle
  rules:
  - host: chat.interne.contoso.com
    http:
      paths:
      - { path: /, pathType: Prefix, backend: { service: { name: chat-api, port: { number: 80 } } } }
À savoir en 2026 : le projet Ingress NGINX est retiré (maintenance arrêtée en mars 2026). Microsoft fournit les correctifs de sécurité critiques de l'application routing add-on NGINX jusqu'en novembre 2026 et oriente vers l'application routing Gateway API implementation (GatewayClass
approuting-istio) ou Application Gateway for Containers. Kubernetes a gelé l'API Ingress (toujours prise en charge, plus d'évolution) et recommande Gateway. Bonne question à poser au client : « quel est votre plan de migration ? ».
Diagnostic d'un 502/503/504 vu par l'utilisateur : kubectl get ingress -n chatbot (classe, adresse), endpoints du Service, puis
logs du controller (kubectl logs -n app-routing-system deploy/nginx, nom à vérifier avec kubectl get deploy -n app-routing-system).
Pour un chatbot, une réponse LLM longue peut aussi dépasser un timeout du proxy : c'est un réglage du controller, pas une panne du pod.
1.5 ConfigMap et Secret#
| Consommation | Mise à jour à chaud ? | Conséquence support |
|---|---|---|
Variable d'environnement (env, envFrom) |
Non, il faut redémarrer le pod | « J'ai changé la ConfigMap et rien ne bouge » → rollout restart (ou changement du template via Git) |
| Volume monté | Oui, après un délai | L'application doit relire le fichier |
Volume monté en subPath |
Non | Piège classique, identique pour le CSI Key Vault |
- Un
SecretKubernetes est encodé en base64, pas chiffré ; ne jamais en committer un en clair dans le dépôt GitOps. - Référencer une ConfigMap ou un Secret absent (ou une clé absente) bloque le démarrage du conteneur : état
Waiting, raisonCreateContainerConfigError, message explicite dans les Events. Unoptional: trueévite le blocage. immutable: trueempêche toute modification (il faut recréer l'objet).
1.6 Requests, limits, quotas#
| Notion | Effet | Symptôme si mal réglé |
|---|---|---|
| requests CPU / mémoire | Réservation utilisée par le scheduler | Pending avec FailedScheduling … Insufficient cpu si aucun node n'a assez d'allocatable |
| limit mémoire | Dépassement = conteneur tué par le noyau (OOM) | Last State: Terminated, Reason: OOMKilled, Exit Code: 137, redémarrages |
| limit CPU | Dépassement = throttling (pas de kill) | Latence, timeouts, probes qui échouent sans erreur applicative |
| ResourceQuota (namespace) | Plafonne la somme des requests/limits ou le nombre d'objets | Le ReplicaSet ne crée pas de pod : condition ReplicaFailure, message exceeded quota |
| LimitRange (namespace) | Valeurs par défaut et bornes par conteneur | Pod refusé à la création si hors bornes |
1.7 Les trois probes#
| Probe | Question posée | En cas d'échec | Erreur classique |
|---|---|---|---|
| startupProbe | « Le démarrage est-il fini ? » | Les autres probes attendent ; au-delà de failureThreshold × periodSeconds, le conteneur est tué |
Absente sur une application lente (chargement de modèle, d'index) → la liveness la tue en boucle |
| livenessProbe | « Le processus est-il bloqué ? » | Le kubelet redémarre le conteneur | Liveness qui appelle Azure OpenAI ou la base : une dépendance lente redémarre tous les pods |
| readinessProbe | « Peut-il recevoir du trafic ? » | Pod retiré des endpoints, pas redémarré | Readiness trop stricte → 0 pod Ready → 503 côté Ingress |
Valeurs par défaut (référence API Kubernetes) : periodSeconds 10, timeoutSeconds 1, failureThreshold 3, successThreshold 1
(obligatoirement 1 pour liveness et startup). Mécanismes : httpGet, tcpSocket, exec, grpc.
# Extrait du template de pod d'une API de chat (Python, port 8000)
containers:
- name: chat-api
  image: acrchatprd.azurecr.io/chat-api:4812        # tag unique, jamais latest
  ports: [{ containerPort: 8000 }]
  resources:
    requests: { cpu: 250m, memory: 512Mi }
    limits:   { memory: 1Gi }
  startupProbe:   { httpGet: { path: /healthz, port: 8000 }, periodSeconds: 10, failureThreshold: 30 }   # 300 s pour démarrer
  livenessProbe:  { httpGet: { path: /healthz, port: 8000 } }                                          # processus vivant, sans dépendance
  readinessProbe: { httpGet: { path: /ready,   port: 8000 } }                                          # dépendances critiques prêtes
1.8 HorizontalPodAutoscaler#
- Boucle de contrôle toutes les 15 s ; calcul
desiredReplicas = ceil(currentReplicas × valeur actuelle / valeur cible). - Pour une métrique CPU ou mémoire en utilisation, les conteneurs doivent avoir des requests : sans elles, la métrique n'est pas
définie et le HPA n'agit pas (
<unknown>danskubectl get hpa). - Comportement par défaut : montée immédiate, descente stabilisée sur 300 s.
- Le HPA modifie
replicasdans le cluster : si le manifeste Git fixe aussireplicas, Argo CD voit une différence (voirignoreDifferencesau chapitre 05).
kubectl get hpa -n chatbot                    # TARGETS (actuel/cible), MINPODS, MAXPODS, REPLICAS
kubectl describe hpa chat-api -n chatbot      # conditions AbleToScale, ScalingActive, ScalingLimited et événements
2. Cycle de vie d'un pod et états des conteneurs#
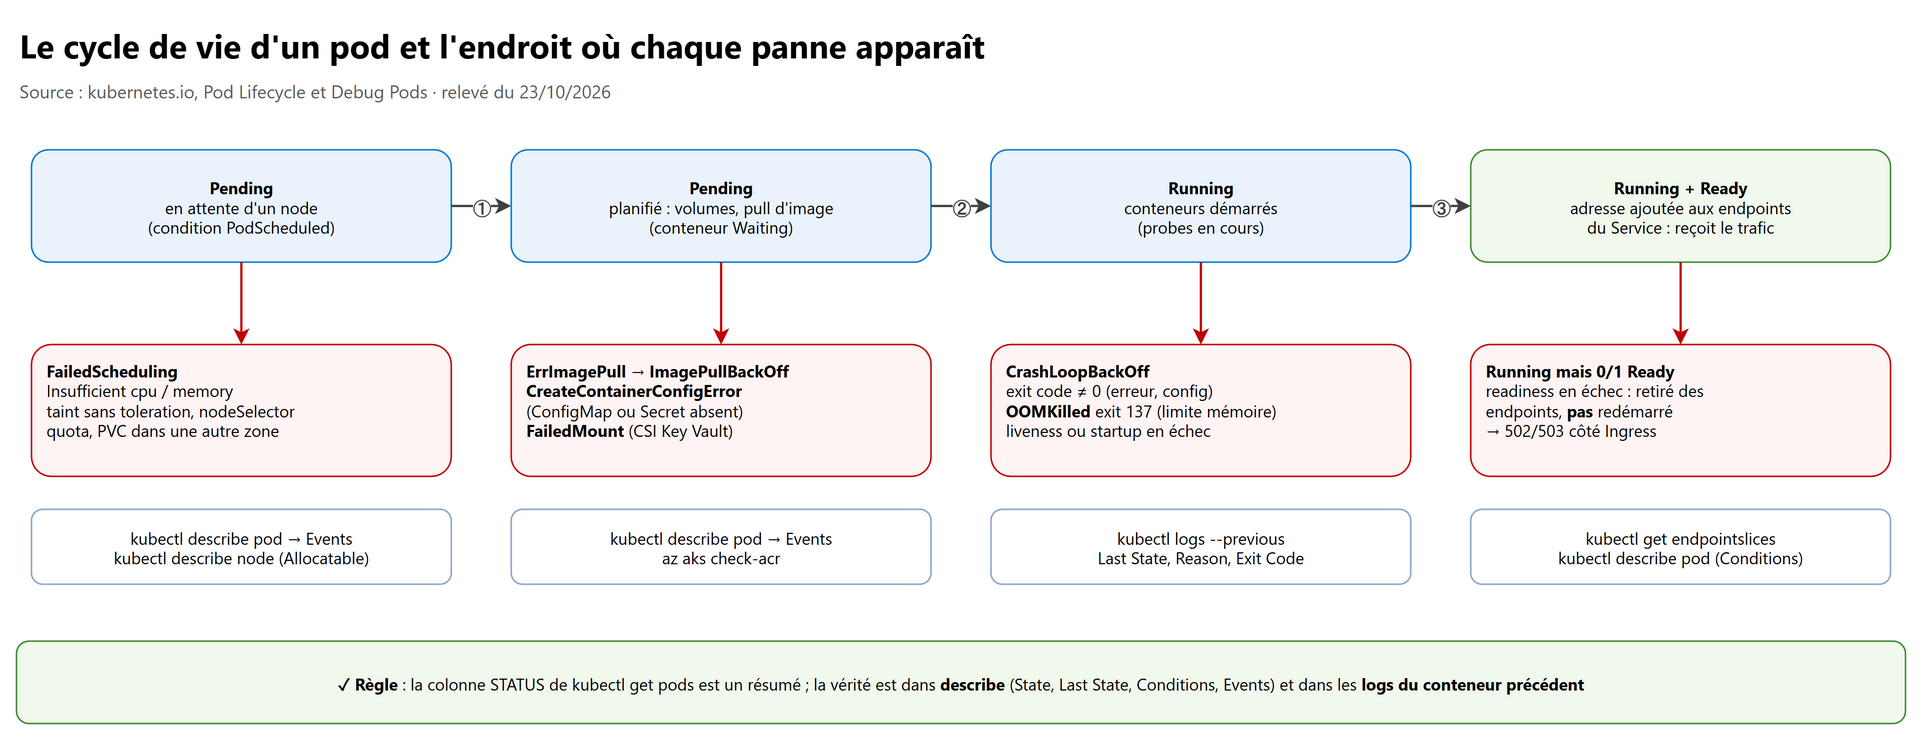
2.1 Phase du pod, état du conteneur, colonne STATUS#
| Niveau | Valeurs | Où le lire |
|---|---|---|
Phase du pod (status.phase) |
Pending, Running, Succeeded, Failed, Unknown (node injoignable) |
kubectl get pod -o jsonpath='{.status.phase}' |
| État de chaque conteneur | Waiting (avec Reason), Running, Terminated (avec Reason, Exit Code) |
kubectl describe pod : State, Last State |
| Conditions du pod | PodScheduled, PodReadyToStartContainers, Initialized, ContainersReady, Ready |
kubectl describe pod : bloc Conditions |
STATUS de kubectl get pods |
Résumé pour humains : CrashLoopBackOff, ImagePullBackOff, Terminating… |
Ce n'est pas la phase : Kubernetes le précise lui-même |
2.2 Les états qu'on voit en incident#
| STATUS affiché | Ce qui se passe vraiment | Premier réflexe |
|---|---|---|
Pending |
Pas encore planifié, ou planifié mais en attente (volumes, image) | describe pod → Events FailedScheduling ? |
ContainerCreating long |
Montage de volume (CSI Key Vault), pull d'image lourd | Events FailedMount, Pulling |
ErrImagePull puis ImagePullBackOff |
Pull en échec, puis nouvelles tentatives espacées (jusqu'à 300 s) | Message exact dans Events, az aks check-acr |
CreateContainerConfigError |
ConfigMap, Secret ou clé référencés absents | Events : nom de l'objet manquant |
CrashLoopBackOff |
Le conteneur démarre puis s'arrête, Kubernetes espace les redémarrages : 10 s, 20 s, 40 s… plafonné à 300 s, remis à zéro après 10 min sans incident | kubectl logs --previous, Last State |
OOMKilled (dans Last State) |
Limite mémoire dépassée | Augmenter la limit ou corriger la fuite ; regarder kubectl top pod |
Running mais 0/1 dans READY |
Readiness en échec : vivant, mais sans trafic | describe pod : Readiness probe failed, endpoints vides |
Terminating qui dure |
Arrêt gracieux (30 s par défaut), finalizer, node perdu | describe pod, état du node |
Evicted / Failed |
Node sous pression (mémoire, disque) | describe node, Conditions du node |
Codes de sortie fréquents (convention Unix : 128 + numéro du signal) : 0 fin normale, 1 erreur applicative, 137 = SIGKILL (OOM
ou kill après le délai de grâce), 143 = SIGTERM (arrêt demandé).
Kubernetes récent : la durée du backoff
CrashLoopBackOffdevient configurable par node (maxContainerRestartPeriod, fonction bêta depuis 1.35) ; les valeurs 10 s / 300 s restent celles par défaut. Ne pas s'étonner d'un rythme différent sur un cluster réglé.
3. Boîte à outils kubectl#
3.1 Se connecter (lecture seule par défaut)#
az account show                                                   # bon tenant, bonne subscription (PRD ?)
az aks get-credentials -g rg-chat-prd -n aks-chat-prd             # kubeconfig utilisateur (Cluster User Role)
kubelogin convert-kubeconfig -l azurecli                          # réutilise la session az (exigé dans certains contextes)
kubectl config current-context                                    # vérifier AVANT toute commande
kubectl auth can-i --list -n chatbot                              # ce que mes droits permettent
# Cluster privé sans accès réseau : passer par l'API Azure (audité, droit runcommand requis)
az aks command invoke -g rg-chat-prd -n aks-chat-prd --command "kubectl get pods -n chatbot"
Depuis Kubernetes 1.24, AKS utilise d'office le format exec de kubelogin ; la conversion sert aux méthodes non interactives (pipeline, managed identity) ou pour forcer l'Azure CLI. Le détail des rôles (Cluster User Role, AKS RBAC Reader…) est dans AKS/03-identite-securite.
3.2 Les commandes, dans l'ordre d'un diagnostic#
| Besoin | Commande |
|---|---|
| Vue d'ensemble du namespace | kubectl get deploy,rs,pods,svc,ingress,hpa -n chatbot -o wide |
| Pods en échec dans tout le cluster | kubectl get pods -A --field-selector=status.phase!=Running |
| Détail d'un pod | kubectl describe pod <pod> -n chatbot |
| Événements récents, triés | kubectl get events -n chatbot --sort-by=.lastTimestamp |
| Seulement les avertissements | kubectl get events -n chatbot --field-selector type=Warning |
| Journaux du conteneur actuel / précédent | kubectl logs <pod> -n chatbot [-c <conteneur>] puis --previous |
| Journaux de tous les pods d'une appli | kubectl logs -n chatbot -l app=chat-api --tail=100 --prefix |
| Suivre un rollout | kubectl rollout status deploy/chat-api -n chatbot |
| Consommation réelle | kubectl top pods -n chatbot --containers, kubectl top nodes |
| Tester depuis le pod | kubectl exec -it <pod> -n chatbot -- sh (si l'image a un shell) |
| Tester depuis un conteneur de debug | kubectl debug -it <pod> -n chatbot --image=busybox:1.36 --target=chat-api |
| Joindre l'API sans passer par l'Ingress | kubectl port-forward svc/chat-api 8080:80 -n chatbot puis curl localhost:8080/healthz |
| YAML réel (valeurs effectives) | kubectl get pod <pod> -n chatbot -o yaml |
| Accès ACR depuis le cluster | az aks check-acr -g rg-chat-prd -n aks-chat-prd --acr acrchatprd.azurecr.io |
Règle de prudence :
exec,port-forward,debug,rollout restart,delete podmodifient ou touchent la production. En support, annoncer l'action, l'impact et le retour arrière avant de la lancer, et la tracer dans le ticket.
3.3 Lire un kubectl describe pod#
Extrait type (simplifié) d'un pod en échec, annoté :
Name:             chat-api-7d9f8c6b5-x2kqp
Namespace:        chatbot
Node:             aks-user-12345678-vmss000002/10.240.0.35     ← planifié : ce n'est pas un problème de scheduling
Labels:           app=chat-api  pod-template-hash=7d9f8c6b5   ← doit correspondre au selector du Service
Service Account:  sa-chat-api                                  ← celui qui porte l'annotation Workload ID
Containers:
  chat-api:
    Image:          acrchatprd.azurecr.io/chat-api:4812        ← le tag attendu ? (sinon problème de déploiement)
    State:          Waiting
      Reason:       CrashLoopBackOff                           ← symptôme
    Last State:     Terminated
      Reason:       OOMKilled                                  ← cause : limite mémoire
      Exit Code:    137
    Ready:          False
    Restart Count:  6
    Limits:         memory: 1Gi
    Requests:       cpu: 250m, memory: 512Mi
    Environment:
      AZURE_CLIENT_ID:             <client-id>                 ← injecté par le webhook Workload ID
      AZURE_FEDERATED_TOKEN_FILE:  /var/run/secrets/azure/tokens/azure-identity-token
Conditions:
  Type              Status
  PodScheduled      True
  Initialized       True
  ContainersReady   False
  Ready             False                                      ← hors des endpoints du Service
Events:
  Type     Reason   Age                 From     Message
  Warning  BackOff  2m (x25 over 12m)   kubelet  Back-off restarting failed container chat-api
Méthode de lecture, de haut en bas : Node (planifié ou non), Image (la bonne version ?), State / Last State (raison,
code de sortie, nombre de redémarrages), Conditions (où le pod s'est arrêté dans son cycle), Events (le message exact, avec
x25 over 12m = répété). Un événement n'est conservé que temporairement par l'API : pour un incident passé, aller dans Container
Insights (KubeEvents, ContainerLogV2), voir AKS/05-exploitation-gitops.
flowchart TD
    A["Le chatbot ne répond pas"] --> B{"kubectl get pods : tous Running et READY 1/1 ?"}
    B -- Non --> C{"STATUS ?"}
    C -- Pending --> C1["describe pod : FailedScheduling<br/>requests, quota, taints, nodes"]
    C -- "ContainerCreating" --> C2["describe pod : FailedMount<br/>CSI Key Vault, section 5"]
    C -- "ImagePullBackOff" --> C3["Events : 401, 403, not found, timeout<br/>az aks check-acr"]
    C -- "CreateContainerConfigError" --> C4["ConfigMap ou Secret absent"]
    C -- "CrashLoopBackOff" --> C5["logs --previous + Last State<br/>OOMKilled ? exception ? jeton Entra ?"]
    C -- "Running 0/1" --> C6["Readiness probe failed<br/>dépendance, port, chemin"]
    B -- Oui --> D{"Endpoints du Service remplis ?"}
    D -- Non --> D1["selector ≠ labels, targetPort"]
    D -- Oui --> E{"Ingress : classe, adresse, logs du controller ?"}
    E -- "KO" --> E1["ingressClassName, DNS, controller"]
    E -- "OK" --> F["Problème applicatif ou dépendance Azure<br/>logs applicatifs, Application Insights"]
4. Workload Identity de bout en bout#
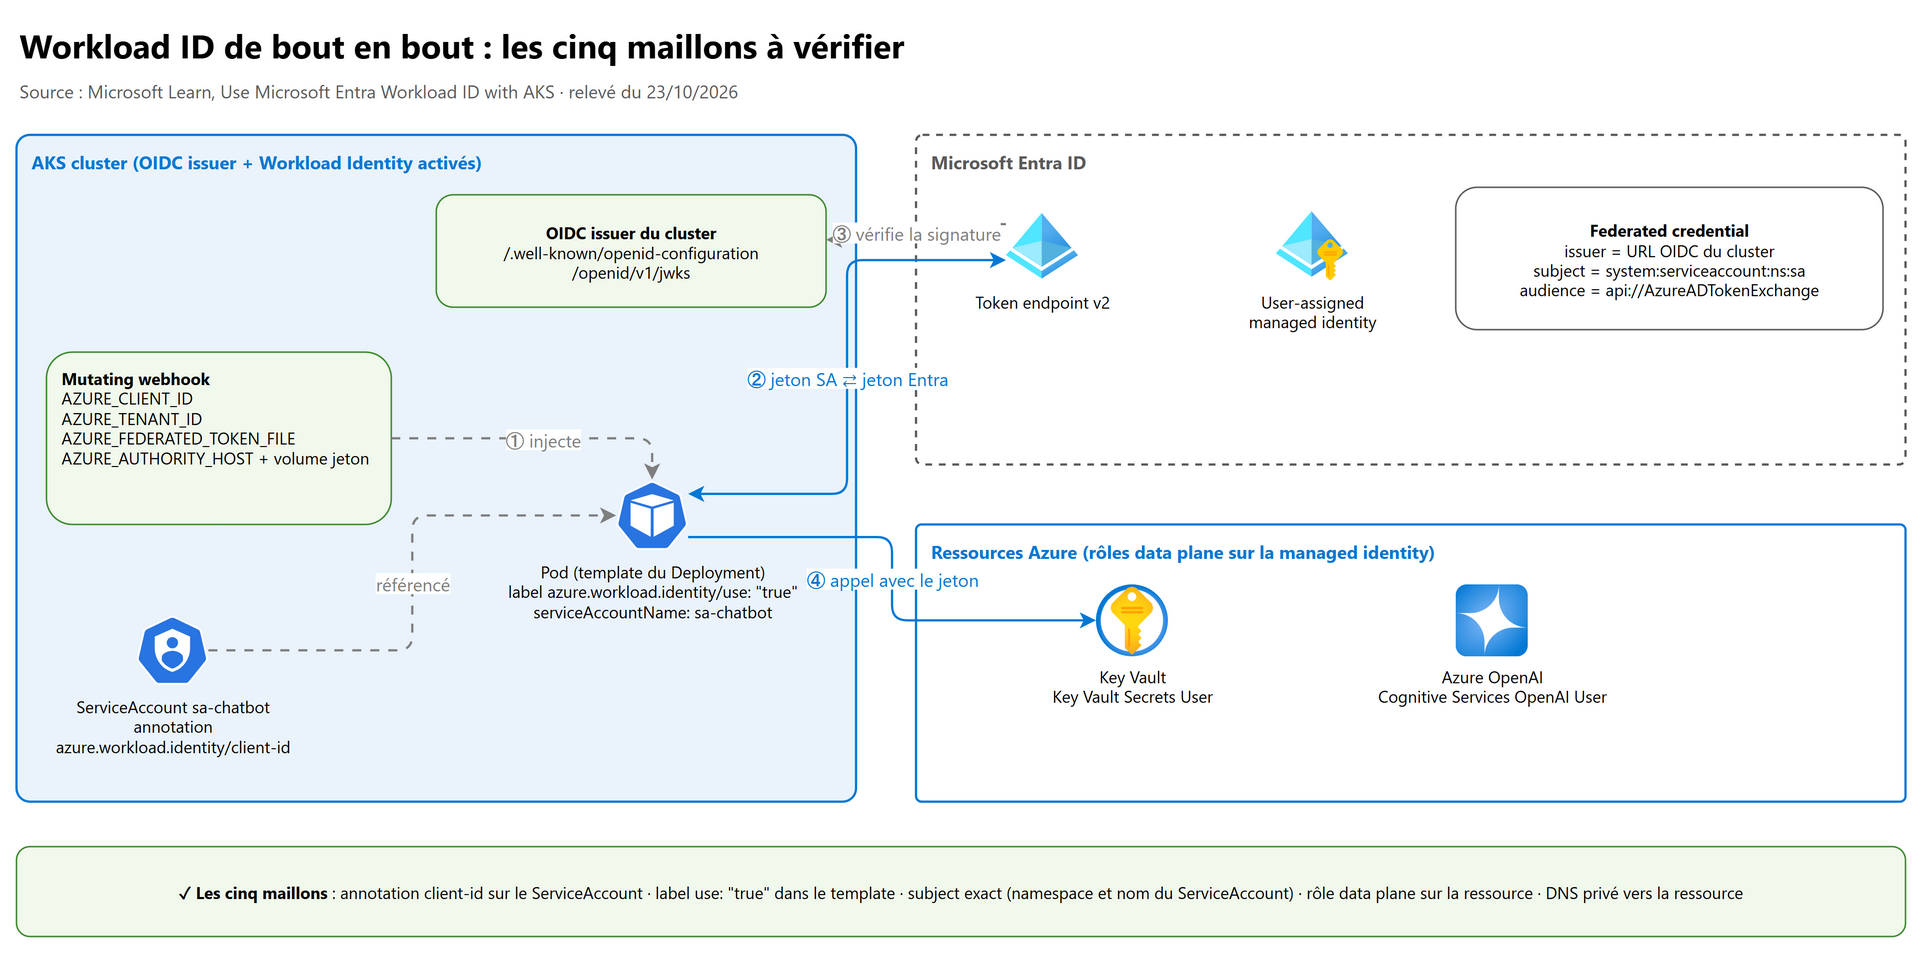
4.1 Le mécanisme en cinq maillons#
Le détail architecture est dans AKS/03-identite-securite. Pour le support, il faut savoir vérifier chaque maillon :
| # | Maillon | Où il vit | Valeur attendue |
|---|---|---|---|
| 1 | OIDC issuer du cluster | Ressource AKS | oidcIssuerProfile.enabled = true, URL publiée ; Workload Identity activé (securityProfile.workloadIdentity.enabled) |
| 2 | User-assigned managed identity et son federated credential | Entra ID (ressource Microsoft.ManagedIdentity) |
issuer = URL OIDC exacte du cluster, subject = system:serviceaccount:<namespace>:<serviceaccount>, audience api://AzureADTokenExchange |
| 3 | ServiceAccount annoté | Namespace de l'appli | azure.workload.identity/client-id: <client ID de l'identité> |
| 4 | Label du pod | Template du Deployment | azure.workload.identity/use: "true" (obligatoire : sans lui, le webhook n'injecte rien) |
| 5 | Rôle data plane | Ressource cible | Key Vault Secrets User, Cognitive Services OpenAI User, Search Index Data Reader… sur la ressource, attribué à l'identité |
Quand les maillons 3 et 4 sont en place, le mutating webhook injecte dans chaque conteneur AZURE_CLIENT_ID, AZURE_TENANT_ID,
AZURE_FEDERATED_TOKEN_FILE, AZURE_AUTHORITY_HOST et le volume du jeton projeté. Le SDK (DefaultAzureCredential ou
WorkloadIdentityCredential) échange ce jeton contre un jeton Entra, avec une portée au format v2 <ressource>/.default.
apiVersion: v1
kind: ServiceAccount
metadata:
  name: sa-chat-api
  namespace: chatbot
  annotations:
    azure.workload.identity/client-id: "00000000-0000-0000-0000-000000000000"   # client ID de la managed identity (exemple)
---
apiVersion: apps/v1
kind: Deployment
metadata: { name: chat-api, namespace: chatbot }
spec:
  selector: { matchLabels: { app: chat-api } }
  template:
    metadata:
      labels:
        app: chat-api
        azure.workload.identity/use: "true"      # dans le TEMPLATE, pas sur le Deployment
    spec:
      serviceAccountName: sa-chat-api
      containers:
      - name: chat-api
        image: acrchatprd.azurecr.io/chat-api:4812
4.2 Vérifier, maillon par maillon (lecture seule)#
# 1. Cluster : OIDC issuer et Workload Identity
az aks show -g rg-chat-prd -n aks-chat-prd \
  --query "{oidc:oidcIssuerProfile.issuerUrl, wi:securityProfile.workloadIdentity.enabled}" -o table
# 2. Identité et federated credential : issuer et subject exacts ?
az identity federated-credential list --identity-name id-chat-api -g rg-chat-prd -o table
# 3. ServiceAccount annoté ?
kubectl get sa sa-chat-api -n chatbot -o jsonpath='{.metadata.annotations}'
# 4. Le pod a-t-il été muté ? (label, variables, volume)
kubectl get pod <pod> -n chatbot -o jsonpath='{.metadata.labels}'
kubectl exec <pod> -n chatbot -- env | grep AZURE_
# 5. Rôles de l'identité sur la ressource cible
az role assignment list --assignee <principalId-ou-clientId> --all -o table
4.3 Erreurs et causes#
| Symptôme (logs de l'appli) | Cause | Correction |
|---|---|---|
Aucune variable AZURE_* dans le pod, le SDK cherche une autre méthode |
Label azure.workload.identity/use absent du template, ou pod créé avant l'annotation |
Ajouter le label au template (Git), recréer les pods ; un changement d'annotation exige un redémarrage du pod |
AADSTS70021: No matching federated identity record found |
Federated credential absent, issuer ou subject faux ; ou credential créé il y a quelques instants (propagation) | Comparer subject avec system:serviceaccount:<ns>:<sa> réel, l'issuer avec l'URL OIDC ; attendre et réessayer |
AADSTS700211 / AADSTS700213 |
Issuer (700211) ou subject (700213) sans correspondance | Idem, corriger la valeur fautive |
AADSTS700212 |
Audience du jeton ≠ audience du federated credential (cas des identity bindings) | Audience api://AzureADTokenExchange pour la fédération directe |
AADSTS70025: Client application has no configured federated identity credentials |
Aucune fédération sur cette identité | Créer le federated credential |
403 de Key Vault, OpenAI ou Search après obtention du jeton |
Rôle data plane manquant (ou propagation, jusqu'à quelques minutes) | Attribuer le rôle sur la ressource, à l'identité du client-id |
403 … public network access is disabled / ForbiddenByConnection |
Réseau : le FQDN résout vers l'IP publique | DNS privé (zone privatelink.* liée au VNet du cluster), voir section 5 |
| Le namespace ou le ServiceAccount a été renommé | Le subject ne correspond plus |
Nouveau federated credential (20 au plus par managed identity) |
Phrase d'entretien : « Je vérifie dans l'ordre : le pod a-t-il été muté (variables
AZURE_*) ? l'échange de jeton réussit-il (erreurAADSTSou pas) ? la ressource accepte-t-elle le jeton (403 RBAC ou 403 réseau) ? Trois questions, trois endroits différents : le cluster, Entra ID, la ressource. »
5. Secrets Store CSI Driver et Azure Key Vault provider#
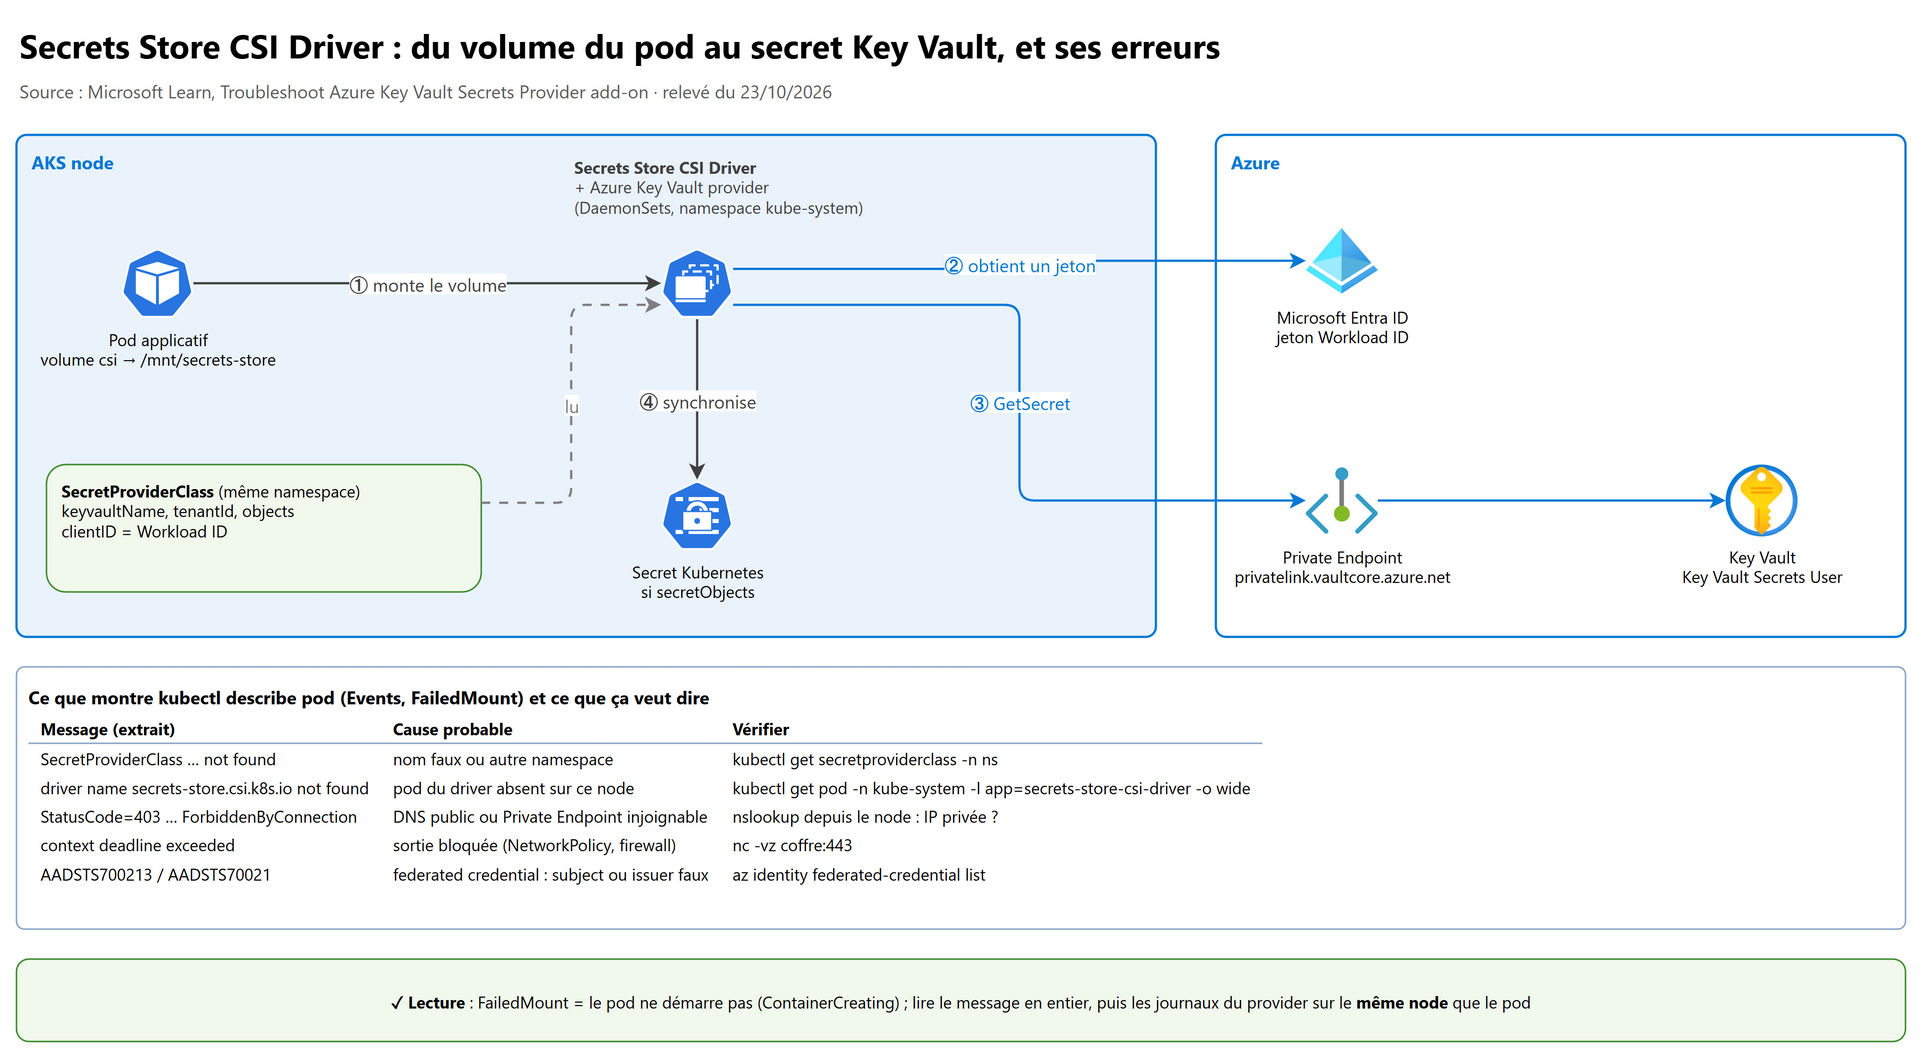
5.1 Fonctionnement#
L'add-on azure-keyvault-secrets-provider installe deux DaemonSets dans kube-system : le Secrets Store CSI Driver et
l'Azure Key Vault provider. Au démarrage du pod, le kubelet demande le montage du volume CSI ; le provider lit la
SecretProviderClass (même namespace que le pod), obtient un jeton (Workload ID recommandé) et écrit les secrets en
fichiers dans le volume. Tant que le montage échoue, le pod reste en ContainerCreating.
apiVersion: secrets-store.csi.x-k8s.io/v1
kind: SecretProviderClass
metadata: { name: kv-chat-api, namespace: chatbot }
spec:
  provider: azure
  parameters:
    usePodIdentity: "false"
    clientID: "00000000-0000-0000-0000-000000000000"     # identité Workload ID (même client ID que le ServiceAccount)
    keyvaultName: kv-chat-prd
    tenantId: "11111111-1111-1111-1111-111111111111"
    objects: |
      array:
        - |
          objectName: search-admin-key
          objectType: secret
  secretObjects:                                        # optionnel : copie en Secret Kubernetes (pour une variable d'env)
  - secretName: chat-api-secrets
    type: Opaque
    data: [{ objectName: search-admin-key, key: SEARCH_KEY }]
# Dans le template de pod
volumes:
- name: secrets
  csi:
    driver: secrets-store.csi.k8s.io
    readOnly: true
    volumeAttributes: { secretProviderClass: kv-chat-api }
containers:
- name: chat-api
  volumeMounts: [{ name: secrets, mountPath: /mnt/secrets-store, readOnly: true }]
5.2 Ce qu'il faut savoir pour le support#
| Point | Comportement | Conséquence |
|---|---|---|
| Rôle | Key Vault Secrets User (secrets) ou Key Vault Certificate User (certificats) sur le coffre |
Un 403 après jeton = rôle manquant |
| Autorotation | Désactivée par défaut ; --enable-secret-rotation, sondage toutes les 2 minutes par défaut (--rotation-poll-interval) |
Le fichier change, l'application doit le relire |
subPath |
Ne reçoit pas la rotation | Monter le répertoire, pas un fichier |
Variable d'environnement (via secretObjects) |
Pas de mise à jour sans redémarrage du pod | Après rotation : rollout restart |
| Secret Kubernetes synchronisé | N'existe que tant qu'un pod monte le volume | « Le Secret a disparu » après un scale à zéro : normal |
| Désactiver l'add-on | Impossible tant qu'une SecretProviderClass existe ; les nouveaux pods ne démarrent plus ensuite |
Ne jamais le faire « pour tester » en production |
| Métriques | Port 8095 (total_node_publish_error, total_rotation_reconcile_error…) |
Visibles avec port-forward sur le DaemonSet |
5.3 Diagnostic#
az aks show -g rg-chat-prd -n aks-chat-prd --query addonProfiles.azureKeyvaultSecretsProvider     # add-on actif ?
kubectl get secretproviderclass -n chatbot                                                          # bon nom, bon namespace
kubectl describe pod <pod> -n chatbot | sed -n '/Events/,$p'                                         # FailedMount : message complet
kubectl get pod -n kube-system -l 'app in (secrets-store-provider-azure, secrets-store-csi-driver)' -o wide   # sur le même node ?
kubectl logs -n kube-system <provider-pod-du-meme-node> --since=1h | grep ^E
kubectl logs -n kube-system <csi-driver-pod-du-meme-node> -c secrets-store --since=1h | grep ^E
| Message dans les Events ou les journaux | Cause | Correction |
|---|---|---|
SecretProviderClass … not found |
Nom faux ou SecretProviderClass dans un autre namespace |
Corriger le nom ou la créer dans le namespace du pod |
driver name secrets-store.csi.k8s.io not found in the list of registered CSI drivers |
Pod du driver absent ou en échec sur ce node | État du DaemonSet sur le node |
StatusCode=403 … Public network access is disabled … ForbiddenByConnection |
Le FQDN du coffre résout vers l'IP publique (zone privatelink.vaultcore.azure.net non liée au VNet des nodes) ou Private Endpoint injoignable |
Lien de zone DNS, peering ; vérifier avec nslookup depuis un node |
context deadline exceeded |
Sortie bloquée (NetworkPolicy, firewall, NSG) | Autoriser le provider vers Entra ID et le coffre |
400 … Identity not found |
userAssignedIdentityID faux (mode managed identity) |
Bon client ID, ou passer en Workload ID |
401 / 429 |
Non authentifié / trop de requêtes au coffre | Voir les codes REST de Key Vault ; espacer la rotation |
AADSTS7002xx |
Fédération Workload ID (section 4) | Corriger le federated credential |
6. Pannes fréquentes : symptôme → cause → vérification → correction#
| Symptôme | Cause probable | Vérifier | Corriger |
|---|---|---|---|
Pending, Insufficient cpu/memory |
Requests trop hautes ou cluster plein | describe node (Allocatable), cluster autoscaler |
Ajuster les requests, capacité du node pool |
Pending, didn't tolerate taint / node affinity |
Node pool dédié (GPU, système) | Taints des nodes, tolerations du pod | Toleration ou nodeSelector corrects |
Aucun pod créé, ReplicaFailure, exceeded quota |
ResourceQuota du namespace | kubectl describe resourcequota -n ns |
Revoir quota ou requests |
ImagePullBackOff, 401 Unauthorized |
Kubelet identity sans AcrPull (ou ABAC : Container Registry Repository Reader) |
az aks check-acr |
Attribuer le rôle |
ImagePullBackOff, not found |
Tag inexistant (pipeline en échec, faute de frappe) | az acr repository show-tags -n acr --repository chat-api |
Corriger le tag dans Git |
ImagePullBackOff, 403 ou i/o timeout |
DNS ou réseau vers le Private Endpoint ACR (registre et data endpoint) | nslookup <acr>.azurecr.io depuis un pod |
Zone privatelink.azurecr.io liée, routes, firewall |
CrashLoopBackOff, exception au démarrage |
Variable manquante, erreur de config, dépendance absente | logs --previous |
Corriger la config (Git) |
CrashLoopBackOff, OOMKilled |
Limite mémoire trop basse, fuite | Last State, kubectl top |
Augmenter la limit, analyser |
CrashLoopBackOff sans erreur applicative |
Liveness trop stricte, pas de startupProbe | describe pod : Liveness probe failed |
startupProbe, liveness sans dépendance |
Running 0/1, 503 côté utilisateur |
Readiness en échec (dépendance, port, chemin) | Events Readiness probe failed, endpoints vides |
Corriger la probe ou la dépendance |
| 502/503 alors que les pods sont Ready | Selector ou targetPort faux, mauvaise ingressClassName |
Endpoints, kubectl get ingress |
Corriger Service ou Ingress |
Le chatbot répond 401/403 vers Azure OpenAI |
Workload ID : rôle, fédération, ou DNS public | Section 4.2 | Maillon fautif |
ContainerCreating sans fin |
FailedMount CSI Key Vault |
Section 5.3 | Selon le message |
| Nouvelle version poussée, pods inchangés | Même tag réutilisé, ou Git non appliqué | Image dans describe pod |
Tag unique, chapitre 05 |
HPA bloqué à <unknown> |
Pas de requests, metrics-server KO | describe hpa |
Requests sur les conteneurs |
| Latence et timeouts sans erreur | Throttling CPU (limit CPU basse), SNAT, dépendance lente | kubectl top, métriques, Application Insights |
Limit CPU, pooling de connexions |
7. Lab : provoquer et diagnostiquer quatre pannes (45 minutes)#
À faire sur un cluster de test (jamais sur l'environnement du client), par exemple celui du lab de
AKS/03-identite-securite. Pour chaque étape : appliquer, observer get pods, describe,
logs --previous, puis revenir à l'état sain.
kubectl create namespace lab-support
kubectl create deployment web --image=nginx:1.27 -n lab-support --replicas=2
kubectl expose deployment web --port=80 -n lab-support
# 1. ImagePullBackOff : tag inexistant
kubectl set image deployment/web nginx=nginx:9.99-inexistant -n lab-support
kubectl get pods -n lab-support -w                     # ErrImagePull puis ImagePullBackOff ; describe → "not found"
kubectl rollout undo deployment/web -n lab-support
# 2. OOMKilled : limite mémoire ridicule
kubectl set resources deployment/web -n lab-support --limits=memory=4Mi
kubectl describe pod -n lab-support -l app=web | grep -A3 "Last State"
kubectl set resources deployment/web -n lab-support --limits=memory=128Mi
# 3. Endpoints vides : selector du Service cassé
kubectl patch svc web -n lab-support -p '{"spec":{"selector":{"app":"web-faux"}}}'
kubectl get endpointslices -n lab-support -l kubernetes.io/service-name=web
kubectl patch svc web -n lab-support -p '{"spec":{"selector":{"app":"web"}}}'
# 4. CreateContainerConfigError : ConfigMap absente
kubectl set env deployment/web -n lab-support --from=configmap/absente
kubectl get pods -n lab-support                        # CreateContainerConfigError
kubectl delete namespace lab-support                   # nettoyage
Résultat attendu : savoir dire, pour chaque cas, quelle ligne de describe ou de get donnait la cause.
8. Questions d'entretien#
1. Différence entre un pod, un ReplicaSet et un Deployment ?
Le pod est l'unité qui tourne. Le ReplicaSet garantit N pods identiques. Le Deployment pilote les ReplicaSets : à chaque changement du template de pod, il crée un nouveau ReplicaSet et fait le rollout, en gardant les anciens pour le retour arrière.
2. Un pod est en CrashLoopBackOff. Ta démarche ?
kubectl describe podpourLast State(raison et code de sortie : 137 + OOMKilled = mémoire), puiskubectl logs --previouspour l'erreur du conteneur précédent, et les Events pour une probe en échec. Ensuite je remonte à la cause : configuration, dépendance (jeton Entra, Key Vault, OpenAI), ressources, ou liveness trop agressive sans startupProbe.
3. ImagePullBackOff sur un ACR privé ?
Le message exact des Events oriente :
401= identité (AcrPull sur la kubelet identity,az aks check-acr),not found= tag,403ou timeout = réseau (Private Endpoint, zoneprivatelink.azurecr.ioavec registre et data endpoint, firewall).
4. Liveness, readiness, startup : différence et piège ?
Liveness redémarre, readiness retire du Service sans redémarrer, startup protège un démarrage lent. Le piège : une liveness qui dépend d'Azure OpenAI ; une lenteur de la dépendance redémarre tous les pods et transforme une latence en panne.
5. Les pods sont Running mais l'utilisateur a des 503. Où regardes-tu ?
READY 0/1 ? Puis les endpoints du Service (selector, readiness,
targetPort), puis l'Ingress (classe, adresse) et les logs du controller. Si tout est sain, c'est l'application ou une dépendance.
6. J'ai modifié une ConfigMap, l'appli ne voit rien. Pourquoi ?
Consommée en variable d'environnement : lue au démarrage seulement, il faut redémarrer les pods. En volume, la mise à jour arrive avec un délai, sauf en
subPath. Et avec GitOps, la modification doit passer par Git, sinon Argo CD la défait.
7. Explique Workload ID de bout en bout.
Le cluster est OIDC issuer et signe des jetons de ServiceAccount. Une user-assigned managed identity porte un federated credential qui fait confiance à cet issuer pour
system:serviceaccount:<ns>:<sa>. Le ServiceAccount porte l'annotationclient-id, le pod le labeluse: "true"; le webhook injecte les variables et le jeton, le SDK l'échange contre un jeton Entra, et la ressource applique les rôles de l'identité.
8. AADSTS70021 dans les logs : que fais-tu ?
Comparer le
subjectdu federated credential avec le namespace et le ServiceAccount réels du pod, et l'issueravec l'URL OIDC du cluster (un cluster recréé change d'URL). Si le credential vient d'être créé, attendre la propagation et réessayer.
9. Comment un secret Key Vault arrive-t-il dans le pod, et que se passe-t-il à la rotation ?
Le Secrets Store CSI Driver monte un volume, l'Azure provider lit les objets décrits dans la
SecretProviderClassavec l'identité Workload ID. Avec l'autorotation (sondage 2 min par défaut), le fichier est mis à jour ; une variable d'environnement ou unsubPathne le sont pas, il faut redémarrer.
10. Le pod reste en ContainerCreating avec FailedMount 403 ForbiddenByConnection.
Le coffre refuse une connexion qui arrive par le réseau public : le FQDN résout vers l'IP publique depuis les nodes. Je vérifie la zone
privatelink.vaultcore.azure.net, son lien avec le VNet du cluster et le peering avec le VNet du Private Endpoint.
11. Pourquoi des requests sont-elles indispensables ?
Le scheduler place les pods avec elles, et le HPA calcule l'utilisation CPU ou mémoire par rapport à elles : sans requests, le HPA n'agit pas et le placement devient imprévisible.
12. Que fais-tu avant de lancer une commande en production ?
Je vérifie le contexte (
az account show,kubectl config current-context), je reste en lecture, et pour toute action (redémarrage, rollback) j'annonce l'environnement, la commande, l'impact et le retour arrière, et je la reporte dans Git si le cluster est piloté par GitOps.
9. Fiche à retenir#
- Pod (exécute) → ReplicaSet (N copies) → Deployment (rollouts) ; rollout seulement si le template change.
-
maxSurge/maxUnavailable25 %,progressDeadlineSeconds600 (ProgressDeadlineExceeded), 10 révisions gardées. - Service → selector → EndpointSlices ; seuls les pods Ready reçoivent le trafic.
- Ingress = règle, Ingress controller = proxy ; app routing NGINX : classe
webapprouting.kubernetes.azure.com, support jusqu'en novembre 2026, cible Gateway API. - ConfigMap en variable = redémarrage nécessaire ;
subPath= pas de mise à jour ; référence absente =CreateContainerConfigError. - Requests = scheduling et HPA ; limit mémoire = OOMKilled (137) ; limit CPU = throttling.
- Probes : startup (démarrage), liveness (redémarre), readiness (retire du trafic) ; défauts 10 s / 1 s / 3 échecs.
- HPA : boucle 15 s, descente stabilisée 300 s, requests obligatoires.
- CrashLoopBackOff : backoff 10 s → 300 s, remis à zéro après 10 min ;
logs --previous. - Lire
describe: Node, Image, State / Last State, Conditions, Events. - Workload ID : OIDC issuer, managed identity + federated credential (
system:serviceaccount:ns:sa), annotationclient-id, labeluse: "true", rôle data plane, variablesAZURE_*. -
AADSTS70021/700211/700213= fédération ; 403 après jeton = RBAC ou réseau. - CSI Key Vault :
SecretProviderClassdans le namespace du pod,FailedMount=ContainerCreating, rotation 2 min si activée,secretObjectsvit avec les pods. - Toujours vérifier le contexte avant une commande ; GitOps : toute correction finit dans Git.
Références#
Relevé du 23/10/2026.
Kubernetes (kubernetes.io) :
- Pod Lifecycle et Debug Pods
- Deployments
- Configure Liveness, Readiness and Startup Probes et Pod API (Probe)
- Service et Ingress
- ConfigMaps et Secrets
- Resource Management for Pods and Containers
- Horizontal Pod Autoscaling
Microsoft Learn :
- Use Microsoft Entra Workload ID with AKS
- Federated identity credentials : considérations (propagation, AADSTS70021)
- Azure Key Vault provider for Secrets Store CSI Driver, identité d'accès et options de configuration
- Troubleshoot Azure Key Vault Secrets Provider add-on in AKS
- Troubleshoot AKS image pull errors from ACR
- Pod stuck in CrashLoopBackOff
- Managed NGINX ingress with the application routing add-on et migration vers la Gateway API
- Use kubelogin to authenticate users in AKS
- Role-based access control for Azure OpenAI
- Verify the connection to the container registry (Architecture Center)