

Version : 1.1 · Date : 2026-10-21 · Domaine 1 de l'examen : Plan and manage an Azure AI solution (25 à 30 %)
En une phrase : une application Foundry en production se pilote avec trois leviers : gérer la capacité (quota TPM/RPM, PTU, Batch, coûts), surveiller ce qui se passe (metrics, logs, traces OpenTelemetry, evaluations continues, santé d'Azure AI Search) et sécuriser l'accès (Entra ID sans clé, managed identities, rôles Foundry, Private Endpoint, CMK, Azure Policy).
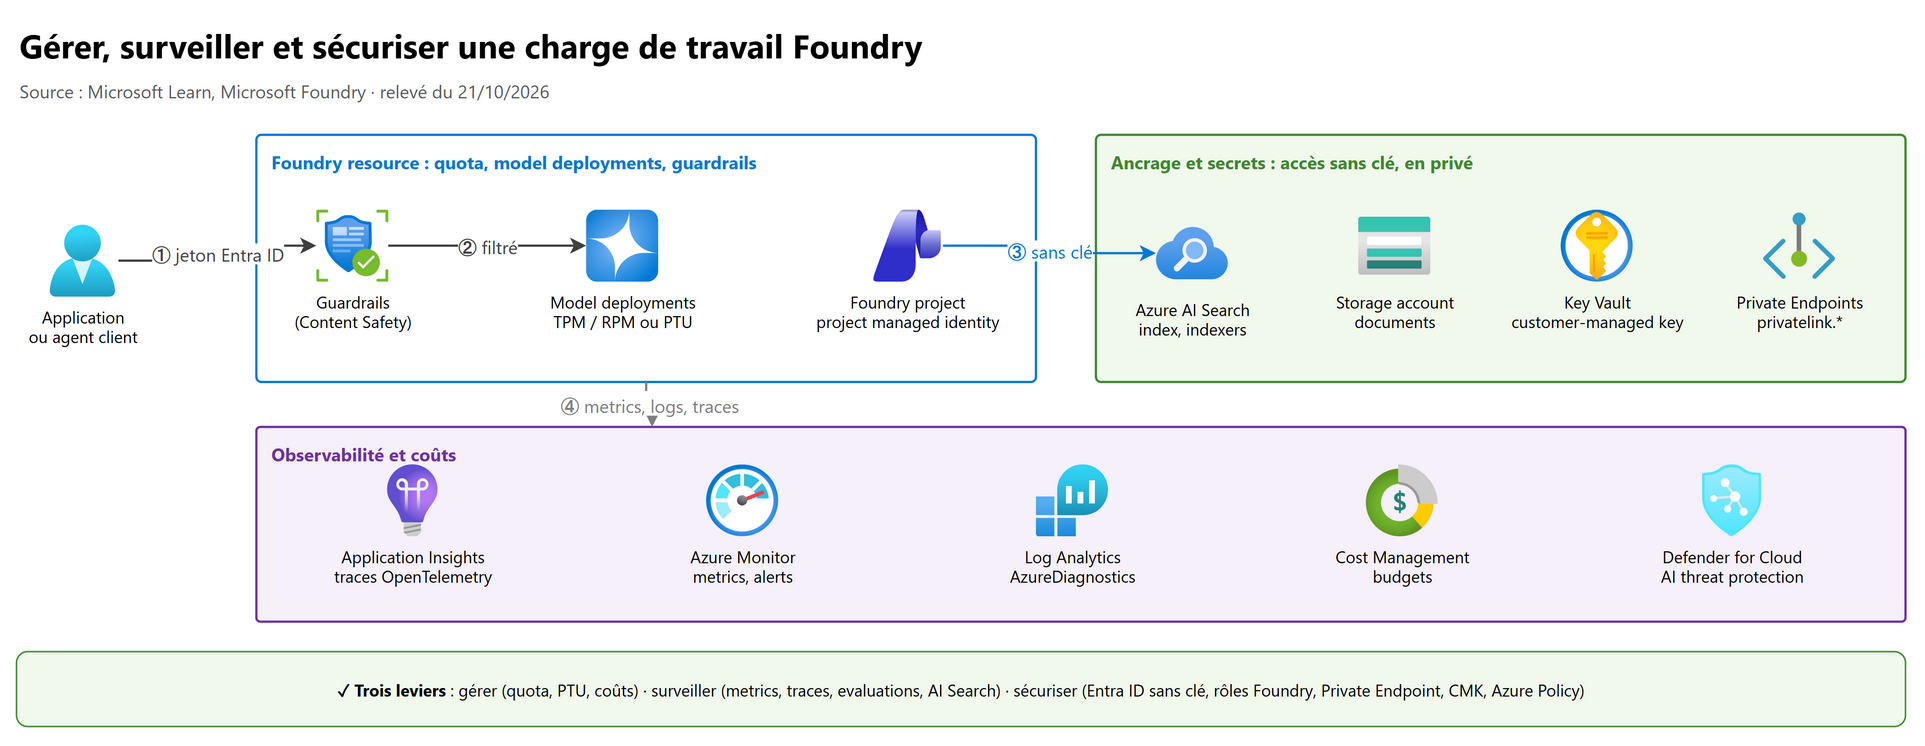
Ce que l'examen demande#
Bloc Manage, monitor, and secure AI systems, repris mot pour mot du guide d'étude AI-103 (compétences mesurées au 16 avril 2026) :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| 1 | Manage quotas, scaling, rate limits, and cost footprints for model and agent workloads | 2 |
| 2 | Monitor model performance, drift, safety events, and grounding quality | 3 |
| 3 | Monitor data ingestion quality, search index health, and relevance performance | 4 |
| 4 | Configure security, including managed identity, private networking, keyless credentials, and role policies | 5 |
Les types de déploiement (Global Standard, Provisioned, Batch…) sont présentés au chapitre 02 ; les guardrails et evaluators sous l'angle de l'IA responsable au chapitre 04. Pour la sécurité générique (Conditional Access, Private Endpoint, DNS privé, AI gateway), voir le cours SC-500 : 01 Entra ID, 06 Réseau et 07 IA.
1. Les bases à maîtriser#
1.1 Plan de contrôle et plan de données#
Foundry sépare deux surfaces, chacune avec ses autorisations RBAC :
| Plan | Ce qu'on y fait | Outils | Autorisation RBAC |
|---|---|---|---|
| Control plane | Créer la Foundry resource et les projects, déployer un modèle, configurer réseau, chiffrement, connexions, faire tourner les clés | Portail Azure, Azure CLI, Bicep, Terraform | Actions |
| Data plane | Inférence, création et exécution d'agents, evaluations, tracing, fine-tuning | SDK, API REST, playground | DataActions |
Conséquence très testée : un rôle comme Contributor permet de déployer un modèle (plan de contrôle) mais pas de créer un agent (plan de données) ; à l'inverse Foundry User construit dans un project mais ne déploie pas de modèle (section 5.3).
1.2 Les trois questions de ce chapitre#
| Question | Outil principal | Section |
|---|---|---|
| Ai-je assez de capacité, et combien ça coûte ? | Quota (TPM/RPM), PTU, Batch, prompt caching, Cost Management | 2 |
| Mon application répond-elle bien, vite et sans danger ? | Azure Monitor metrics, diagnostic settings, Application Insights, continuous evaluation | 3 |
| Mes données d'ancrage sont-elles fraîches et pertinentes ? | Indexer status, metrics Azure AI Search, evaluators Retrieval | 4 |
| Qui peut accéder à quoi, par quel chemin ? | Entra ID sans clé, rôles Foundry, managed identities, Private Endpoint, CMK, Azure Policy | 5 |
2. Quotas, limites de débit, mise à l'échelle et coûts#
2.1 Le quota#
Le quota est attribué à la subscription, par région, par modèle et par type de déploiement, en TPM (tokens per minute). Chaque deployment reçoit une part de ce quota ; la somme des parts ne peut pas dépasser le quota.
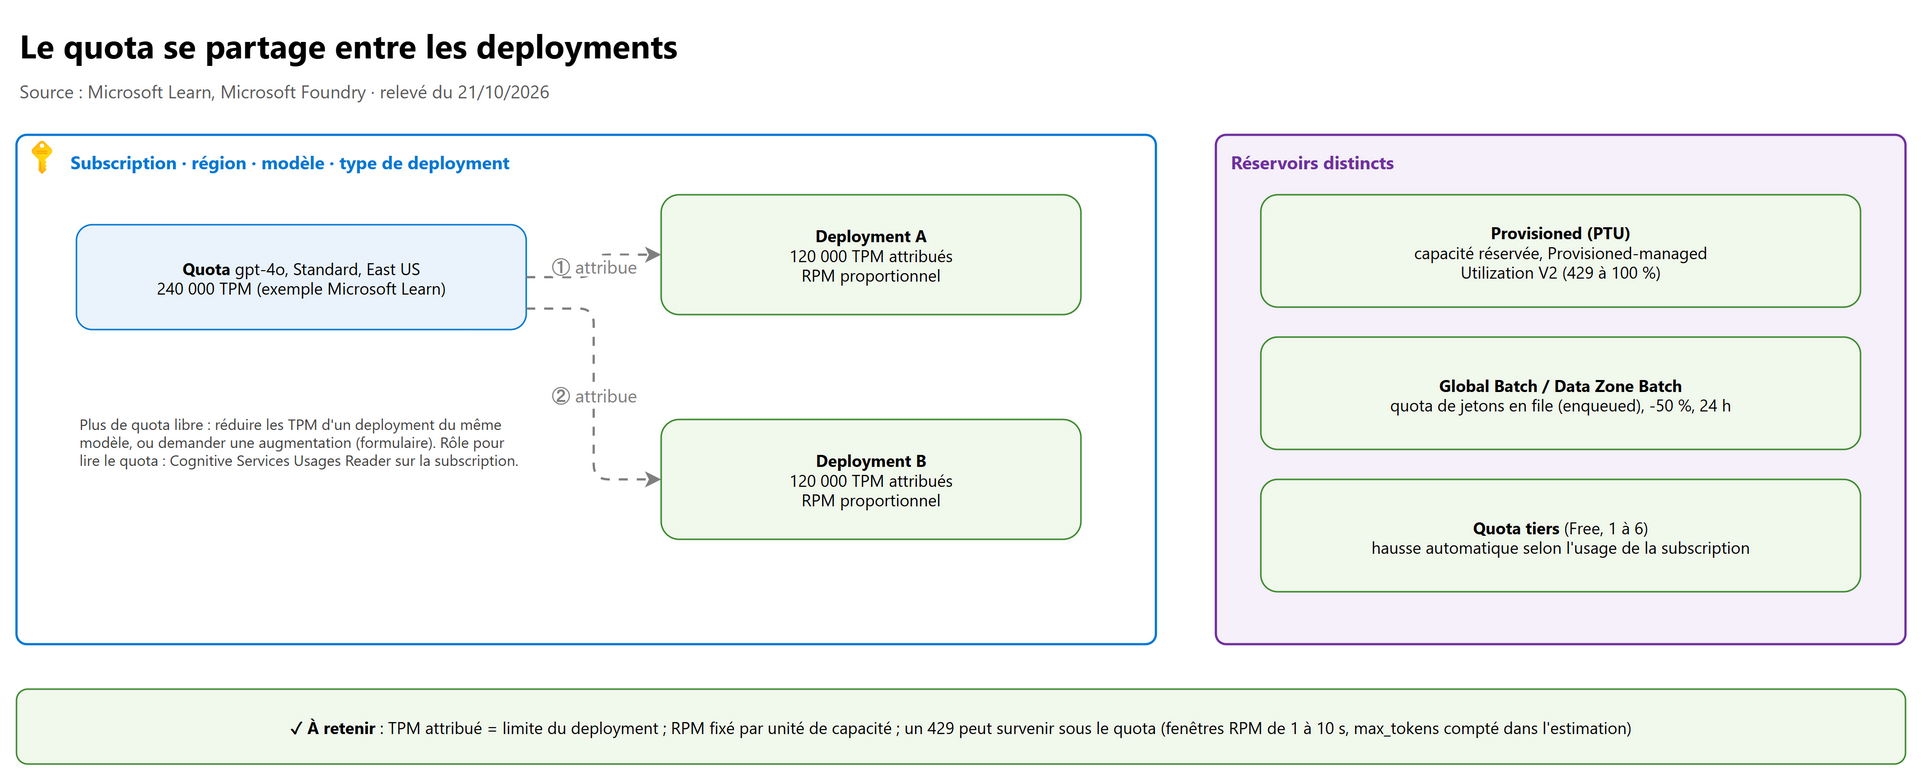
- Exemple officiel : avec 240 000 TPM de GPT-4o en East US, on peut créer un seul deployment de 240 000 TPM, deux de 120 000, etc.
- Le RPM (requests per minute) n'est pas réglable séparément : le quota est alloué en unités de capacité, chacune correspondant à un couple RPM/TPM fixé par modèle (par exemple 6 RPM pour 1 000 TPM pour les anciens modèles de chat, 1 RPM pour 1 000 TPM pour o3 et o4-mini).
- Le quota TPM n'a rien à voir avec la taille maximale d'une invite (limite d'entrée du modèle).
- Limites utiles : 30 ressources Azure OpenAI par région et par subscription ; 32 deployments standard par ressource.
- Quota tiers : sept niveaux (Free, puis 1 à 6) ; le niveau est évalué par subscription et monte automatiquement avec
l'usage. On peut refuser la montée automatique (
tierUpgradePolicy: NoAutoUpgrade, en préversion) et toujours demander plus de quota par le formulaire de demande (traité en priorité pour les clients qui utilisent déjà leur quota). - Gestion au niveau de la subscription : depuis le 7 mai 2026, Foundry commence à suivre le quota par subscription plutôt que par ressource ou région (d'abord Realtime Translate et Realtime Whisper, puis tous les modèles) : pool commun Global Standard pour toutes les régions, pool par data zone pour Data Zone Standard.
Lire le quota demande le rôle Cognitive Services Usages Reader assigné à l'étendue de la subscription (une attribution au niveau du resource group ou de la ressource ne suffit pas). Deux API Resource Manager :
| API | Question | Exemple |
|---|---|---|
Usages (…/locations/{location}/usages) |
Combien de quota ai-je consommé dans cette région ? | currentValue / limit par ligne OpenAI.Standard.gpt-4o |
Model capacities (…/modelCapacities) |
Où puis-je déployer ce modèle, avec quelle capacité libre ? | availableCapacity par région et SKU |
az rest --method get \
  --url "https://management.azure.com/subscriptions/$SUB/providers/Microsoft.CognitiveServices/locations/eastus/usages?api-version=2024-10-01"
Deux détails d'exploitation : une modification de quota met jusqu'à 15 minutes à se propager ; une ressource supprimée par l'API (sans supprimer ses deployments d'abord) bloque son quota 48 heures, sauf si on la purge.
2.2 Comment la limite de débit est calculée#
- TPM : à la réception de chaque requête, le service estime le nombre maximal de jetons : texte de l'invite +
max_tokens+best_of. Cette estimation (pas les jetons facturés) s'ajoute au compteur de la minute ; à la limite, tout nouvel appel reçoit un 429. - RPM : évalué sur de courtes fenêtres de 1 ou 10 secondes. Un deployment de 600 RPM limite dès qu'il reçoit plus de 10 requêtes dans une seconde, même si la minute reste sous 600.
- Les requêtes rejetées comptent quand même dans la limite : renvoyer en boucle sans attendre aggrave la limitation.
D'où le piège classique : 429 alors que la métrique de jetons est sous le quota. Les metrics montrent les jetons facturés des requêtes réussies, la limitation porte sur l'estimation de toutes les requêtes reçues.
| Type de 429 | Indice | Bonne réaction |
|---|---|---|
| Limite du deployment dépassée | « rate limit is exceeded » | Augmenter le TPM du deployment, rééquilibrer, demander du quota |
| Capacité système saturée | « temporarily unable to process », « high demand » | Retry après retry-after-ms ; si persistant, PTU |
| Ajustement temporaire de la limite (pool partagé) | x-ratelimit-limit-tokens inférieur au TPM configuré |
Retry avec backoff ; se résout en quelques heures ; PTU si besoin de constance |
| Budget de jetons gonflé par la requête | métriques de jetons faibles | Réduire max_tokens à la taille de réponse attendue |
Piège : demander une augmentation de quota pour une saturation temporaire de capacité ne sert à rien. Toujours lire le message d'erreur et les en-têtes avant d'agir.
2.3 Absorber les 429 dans le code#
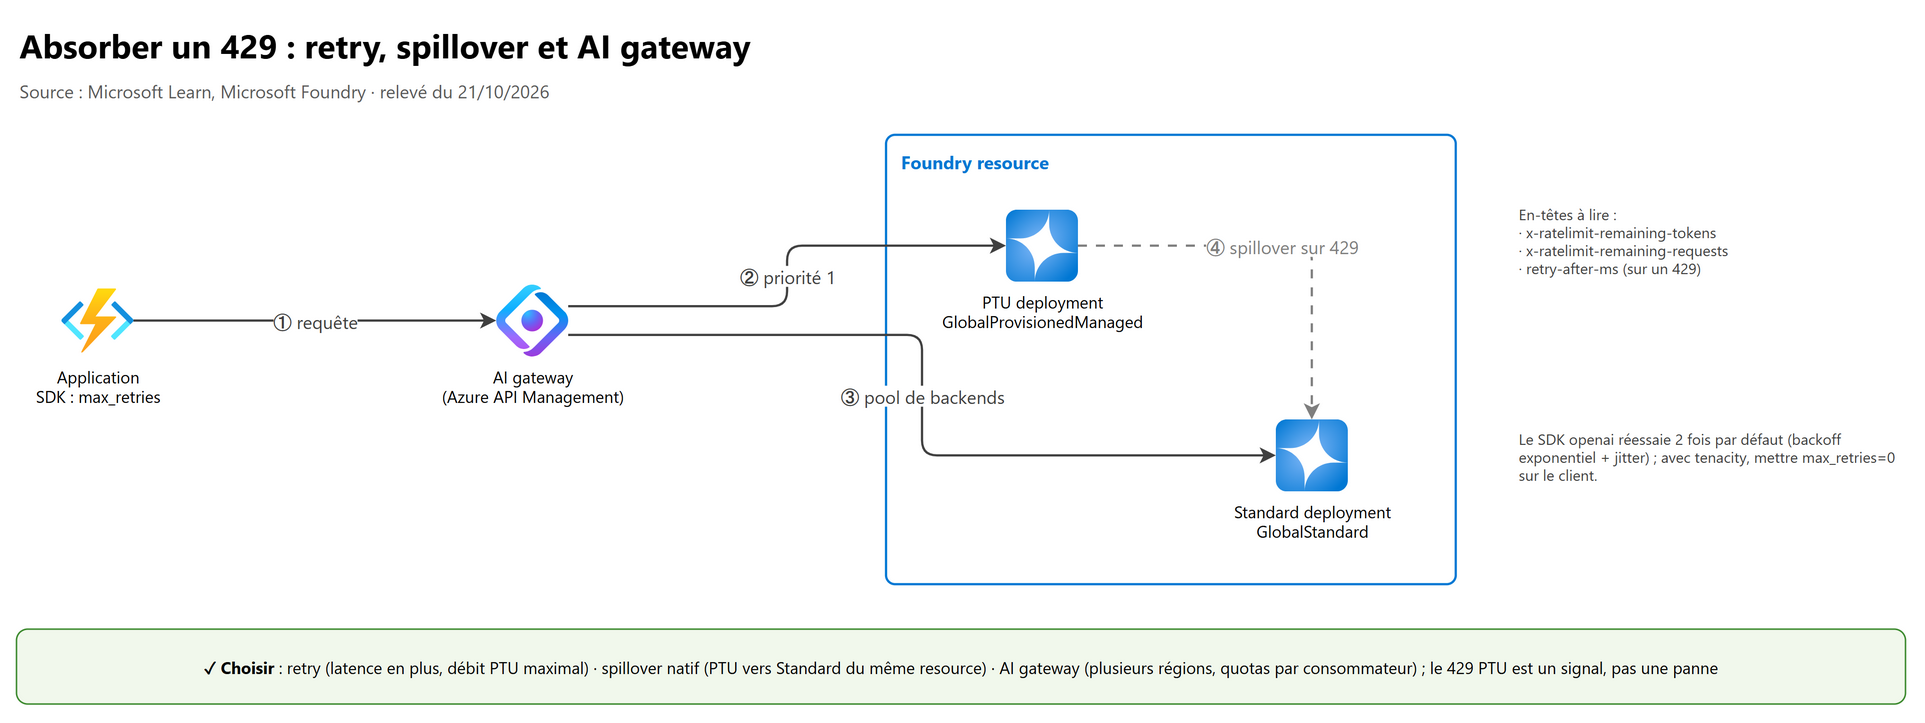
| En-tête de réponse | Rôle |
|---|---|
x-ratelimit-limit-requests / x-ratelimit-limit-tokens |
Limites effectives du deployment |
x-ratelimit-remaining-requests / x-ratelimit-remaining-tokens |
Ce qui reste avant le 429 : à surveiller pour ralentir avant |
x-ratelimit-reset-requests / x-ratelimit-reset-tokens |
Délai avant réinitialisation |
retry-after-ms (et retry-after) |
Présent sur un 429 : temps d'attente conseillé |
Le SDK Python openai (v1+) réessaie automatiquement les 429 et erreurs transitoires avec backoff exponentiel et jitter, en
respectant retry-after : 2 nouvelles tentatives par défaut, réglables avec max_retries.
from openai import OpenAI
from azure.identity import DefaultAzureCredential, get_bearer_token_provider

token_provider = get_bearer_token_provider(DefaultAzureCredential(), "https://ai.azure.com/.default")
client = OpenAI(
    base_url="https://<resource>.openai.azure.com/openai/v1/",
    api_key=token_provider,       # jeton Entra ID, pas de clé (section 5.1)
    max_retries=5,                # au lieu de 2 par défaut
)
response = client.with_options(max_retries=8).responses.create(model="<deployment>", input="Bonjour")
Piège : avec une bibliothèque de retry personnalisée (
tenacity, Polly…), mettremax_retries=0sur le client ; sinon chaque tentative externe déclenche aussi les tentatives du SDK.
sequenceDiagram
    participant App as Application (SDK)
    participant Dep as Deployment Foundry
    App->>Dep: Requête (invite + max_tokens)
    Dep-->>App: 429 + retry-after-ms: 2000
    Note over App: Attendre 2 s (ou backoff exponentiel + jitter)
    App->>Dep: Nouvelle tentative
    Dep-->>App: 200 + x-ratelimit-remaining-tokens
    Note over App: Ralentir si remaining-tokens devient faible
Autres bonnes pratiques officielles : réduire max_tokens et best_of (1), raccourcir les invites, monter la charge
progressivement, répartir sur plusieurs deployments ou régions, passer en traitement asynchrone (file d'attente, Batch)
quand la réponse immédiate n'est pas requise.
2.4 Provisioned throughput (PTU)#
Les deployments Provisioned réservent une capacité exprimée en PTU : débit prévisible, faible variance de latence.
| Type | sku-name |
Traitement des données |
|---|---|---|
| Global Provisioned | GlobalProvisionedManaged |
Toute région Azure |
| Data Zone Provisioned | DataZoneProvisionedManaged |
Dans la data zone (US, EU) |
| Regional Provisioned | ProvisionedManaged |
Dans la région du deployment |
- Surveillance : metric Provisioned-managed Utilization V2 (fenêtres d'une minute ; l'ancienne version est dépréciée), à découper par deployment (Apply splitting).
- Calcul : variante du leaky bucket. Chaque requête ajoute une estimation (jetons d'invite moins les jetons en cache +
max_tokens), corrigée à la fin avec le réel ; l'utilisation se vide à un rythme proportionnel aux PTU déployés. À 100 %, le service répond immédiatement 429 avecretry-after-ms: les requêtes acceptées gardent une latence prévisible. - Un 429 en PTU n'est pas une erreur : c'est un signal de gestion du trafic. Deux réponses : rediriger (latence minimale) ou réessayer (débit maximal par PTU).
- Spillover (débordement) : option qui renvoie automatiquement le trafic d'un deployment provisioned saturé (réponse non 200,
comme un 429) vers un deployment standard de la même Foundry resource ; activable pour tout le deployment ou requête par
requête avec l'en-tête
x-ms-spillover-deployment. Pris en charge par les modèles Azure OpenAI éligibles au provisioned, pas par les modèles d'autres fournisseurs (DeepSeek, Llama). DimensionIsSpilloverdans la metric Azure OpenAI Requests. - Dimensionnement : capacity calculator de la page Quota, puis benchmark avec un trafic réel. Fixer
max_tokensau plus près de la taille réelle des réponses augmente la concurrence. - Reservations (1 mois ou 1 an) : remise sur le tarif horaire des PTU. Une reservation Global, Data Zone ou Regional n'est pas interchangeable ; elle ne garantit pas la capacité (créer le deployment avant d'acheter) ; supprimer un deployment n'annule pas la reservation (l'annuler ou l'échanger dans Azure Reservations).
2.5 Mettre à l'échelle#
| Besoin | Solution |
|---|---|
| Plus de débit pour un deployment | Augmenter ses TPM (rééquilibrer le quota), demander une augmentation |
| Débit constant et latence stable | Provisioned (PTU), éventuellement avec spillover vers Standard |
| Gros volumes non urgents | Global Batch / Data Zone Batch : quota séparé (jetons en file), objectif 24 h, -50 % par rapport à Global Standard, sans perturber le trafic en ligne |
| Plusieurs deployments ou régions, quotas par consommateur | AI gateway dans Azure API Management : load balancing, circuit breaker, llm-token-limit (voir SC-500, 07) |
| Rester sous la latence attendue en Standard | Respecter les usage tiers : au-delà du volume mensuel du modèle (par exemple 30 milliards de jetons pour gpt-4.1), la latence peut plus que doubler ; solution : PTU |
2.6 Maîtriser les coûts#
| Levier | Effet |
|---|---|
| Choix du type de déploiement | Global Standard = prix le plus bas pour le paiement au jeton ; Batch = -50 % ; PTU = coût fixe horaire, réservable |
| Prompt caching | Invite d'au moins 1 024 jetons dont les 1 024 premiers sont identiques : jetons en cache facturés avec une remise (Standard) et jusqu'à 100 % de remise sur l'utilisation PTU. Activé par défaut sur les modèles pris en charge ; cache vidé après 5 à 10 minutes d'inactivité, toujours sous une heure, jamais partagé entre subscriptions. Mettre le contenu stable (system prompt, définitions d'outils) au début |
max_tokens / max_output_tokens |
Plafonne les jetons générés, y compris les jetons de raisonnement (facturés comme sortie) |
| Routage vers un plus petit modèle | Modèles mini ou nano pour les tâches simples, model router |
| Cost Management | Cost analysis (grouper par Resource puis Meter ; Azure OpenAI apparaît sous Cognitive Services, filtrer Service tier : Azure OpenAI), budgets et alertes, export des coûts |
| Foundry portal | Monitor d'un modèle : coût total et estimé ; Operate > Overview : coût estimé des agents |
Piège : contrairement à OpenAI, Azure OpenAI n'a pas de limite dure de dépense. Un budget alerte ; pour couper, il faut automatiser via un action group (développement spécifique). Le quota n'est pas un outil de facturation (Microsoft le déconseille).
Rôles : Cost Management Reader pour voir les coûts, Foundry User pour relier coûts et ressources. Les outils d'agent ont leurs propres frais : par exemple File search est facturé en plus des jetons du modèle. Les données envoyées à Azure Monitor (logs, traces) sont aussi facturées, hors de la Foundry resource.
3. Surveiller les modèles et les agents#
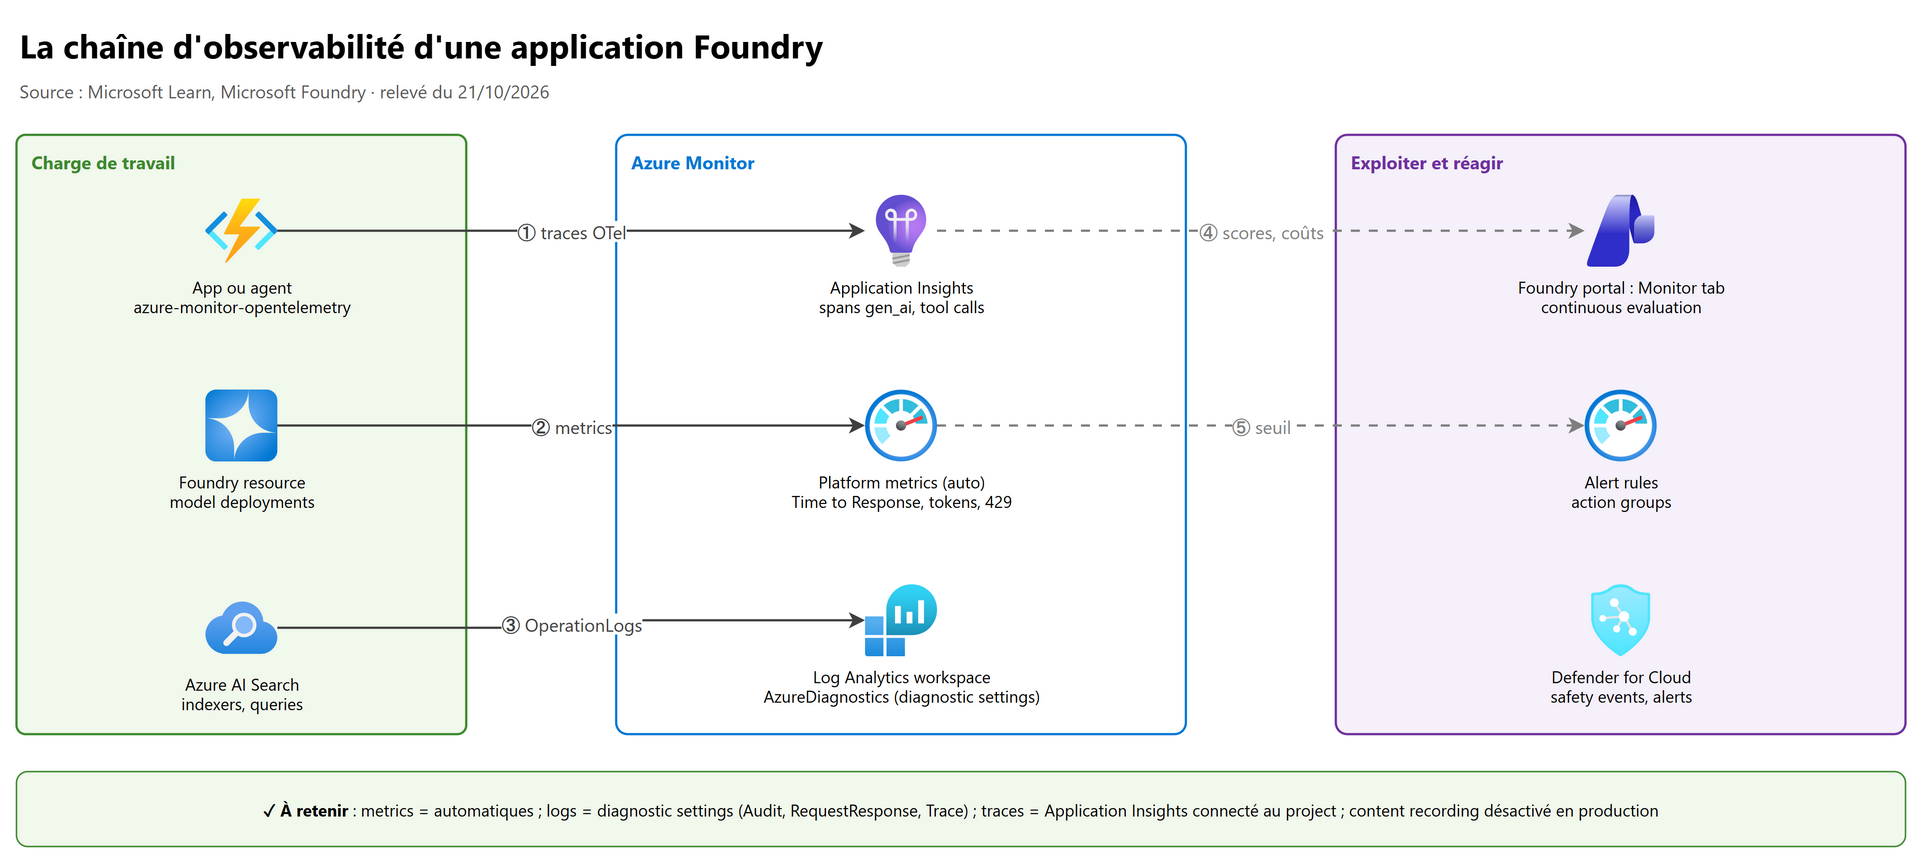
| Signal | Collecte | Où le lire |
|---|---|---|
| Platform metrics | Automatique | Azure Monitor > Metrics, dashboards de la ressource, alertes |
| Resource logs | Seulement après création d'un diagnostic setting | Log Analytics (AzureDiagnostics), Storage, Event Hubs |
| Traces (OpenTelemetry) | Application Insights connecté au project + instrumentation | Foundry portal (Traces, onglet Monitor), Application Insights |
| Evaluations | Evaluations planifiées ou continues | Foundry portal (Evaluations, Monitor) |
3.1 Les metrics Azure Monitor#
| Je veux surveiller… | Metric | Nom REST |
|---|---|---|
| Temps de réponse total | Time to Last Byte | AzureOpenAITTLTInMS |
| Premier jeton (streaming) | Time to Response | AzureOpenAITimeToResponse |
| Vitesse de génération | Time Between Tokens | AzureOpenAINormalizedTBTInMS |
| Premier jeton normalisé par la taille de l'invite | Normalized Time to First Byte | AzureOpenAINormalizedTTFTInMS |
| Jetons en sortie / en entrée | Generated Completion Tokens / Processed Prompt Tokens | GeneratedTokens / ProcessedPromptTokens |
| Utilisation PTU | Provisioned-managed Utilization V2 | AzureOpenAIProvisionedManagedUtilizationV2 |
| Volume et erreurs (429…) | Azure OpenAI Requests (dimensions StatusCode, IsSpillover, ModelDeploymentName) |
AzureOpenAIRequests |
| Taux de cache | Prompt Token Cache Match Rate | — |
Règles d'interprétation officielles :
- Toujours associer une latence à un nombre de jetons : 5 secondes pour 2 000 jetons n'a rien à voir avec 5 secondes pour 50.
- La metric héritée Latency (catégorie Cognitive Services - HTTP Requests) n'est pas faite pour Azure OpenAI : résultats trompeurs.
- Selon la page de référence, Tokens per Second, Time to Response et Time Between Tokens ne sont pas encore disponibles pour les deployments Standard.
- Si TTLT monte sans hausse des jetons : pression de capacité (utilisation PTU, ou 429 et concurrence en Standard).
Safety events : metrics de Content Safety disponibles sur la ressource : Blocked Volume, Harmful Volume Detected, Potential Abusive User Count, Safety System Event, Total Volume Sent for Safety Check. Les attaques (jailbreak, injection d'invite indirecte, fuite de données) sont détectées par le plan Defender for AI services de Defender for Cloud (SC-500, 07).
3.2 Les resource logs#
Catégories de Microsoft.CognitiveServices/accounts, toutes dans la table AzureDiagnostics : Audit, RequestResponse,
Trace, AzureOpenAIRequestUsage, et ManagedNetworkEvent (réseau managé). Elles ne sont collectées qu'après un
diagnostic setting (portail, CLI, ou Azure Policy Enable logging by category group for Cognitive Services… en
DeployIfNotExists).
// Premier aperçu des journaux de la ressource
AzureDiagnostics
| where ResourceProvider == "MICROSOFT.COGNITIVESERVICES"
| summarize count() by Category, OperationName, bin(TimeGenerated, 1h)
| order by TimeGenerated desc
3.3 Le tracing OpenTelemetry#
Le tracing capture le déroulé d'une requête : appels au modèle, appels d'outils, décisions de l'agent, dépendances. Il repose sur OpenTelemetry (conventions sémantiques gen_ai) et Application Insights, et fonctionne avec Microsoft Agent Framework, Semantic Kernel (natif), LangChain, LangGraph et OpenAI Agents SDK.
- Connecter une ressource Application Insights au project Foundry.
- Instrumenter le code (préversion pour le tracing côté client) :
import os
os.environ["AZURE_EXPERIMENTAL_ENABLE_GENAI_TRACING"] = "true"     # avant l'instrumentation

from azure.ai.projects import AIProjectClient
from azure.identity import DefaultAzureCredential
from azure.monitor.opentelemetry import configure_azure_monitor

project = AIProjectClient(endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"], credential=DefaultAzureCredential())
configure_azure_monitor(connection_string=project.telemetry.get_application_insights_connection_string())
- Les traces apparaissent en 2 à 5 minutes dans Traces et dans Azure Monitor.
| Variable d'environnement | Défaut | Effet |
|---|---|---|
AZURE_EXPERIMENTAL_ENABLE_GENAI_TRACING |
false |
Active l'instrumentation GenAI |
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT |
false |
Content recording : contenu des messages et arguments d'outils |
AZURE_TRACING_GEN_AI_INCLUDE_BINARY_DATA |
false |
Inclut images et fichiers dans les spans |
Piège : le content recording enregistre les entrées, sorties et arguments d'outils (données personnelles possibles) : à activer en développement seulement. Pour lire les traces il faut Log Analytics Reader sur les données (plus Privileged Monitoring Data Reader si les tables sont Protected).
Un agent hébergé ailleurs que dans Foundry peut être suivi au même endroit : l'enregistrer dans le Foundry Control Plane (via AI Gateway), respecter les conventions OpenTelemetry gen_ai et envoyer sa télémétrie au même Application Insights.
3.4 Évaluer en production : qualité, dérive, ancrage#
Après le déploiement, Microsoft recommande quatre pratiques : operational metrics, continuous evaluation (qualité et sécurité du trafic réel, sur un échantillon), scheduled evaluation (sur un jeu de test fixe, pour détecter la dérive du système) et scheduled red teaming (attaques simulées régulières).
| Type de recurring evaluation | Source | Sert à |
|---|---|---|
| Continuous evaluation | Live traffic (traces), échantillonnage aléatoire ou intelligent sampling | Qualité et sécurité au fil de l'eau |
| Scheduled evaluation | Dataset (golden dataset) | Comparer dans le temps : dérive après changement de modèle, d'invite ou de données |
Configuration : Build > Evaluations > Recurring Configs > Create (ou SDK azure-ai-projects), puis lecture dans l'onglet
Monitor de l'agent (Agent Monitoring Dashboard, préversion : tokens, latence, taux de succès, scores). Limite par défaut :
100 exécutions par heure (max_hourly_runs) ; en SDK, la project managed identity doit avoir Foundry User.
flowchart LR
    A["Trafic réel de l'agent"] --> B["Traces dans Application Insights"]
    B --> C["Continuous evaluation (échantillon)"]
    D["Golden dataset"] --> E["Scheduled evaluation"]
    C --> F["Scores : groundedness, relevance, sécurité"]
    E --> F
    F --> G{"Sous le seuil ?"}
    G -- Oui --> H["Alerte et analyse des traces"]
    H --> I["Corriger l'invite, les données ou le modèle"]
    I --> A
    G -- Non --> A
Qualité d'ancrage (grounding quality) : evaluator Groundedness (score 1 à 5, seuil par défaut 3 : la réponse ne contient rien qui sorte du contexte, c'est l'aspect précision) ; Groundedness Pro (préversion, s'appuie sur Azure AI Content Safety, résultat vrai/faux, sans deployment de juge) ; Response Completeness (préversion, aspect rappel face à une vérité terrain). Le détail des evaluators est au chapitre 04.
4. Surveiller l'ingestion, l'index et la pertinence#
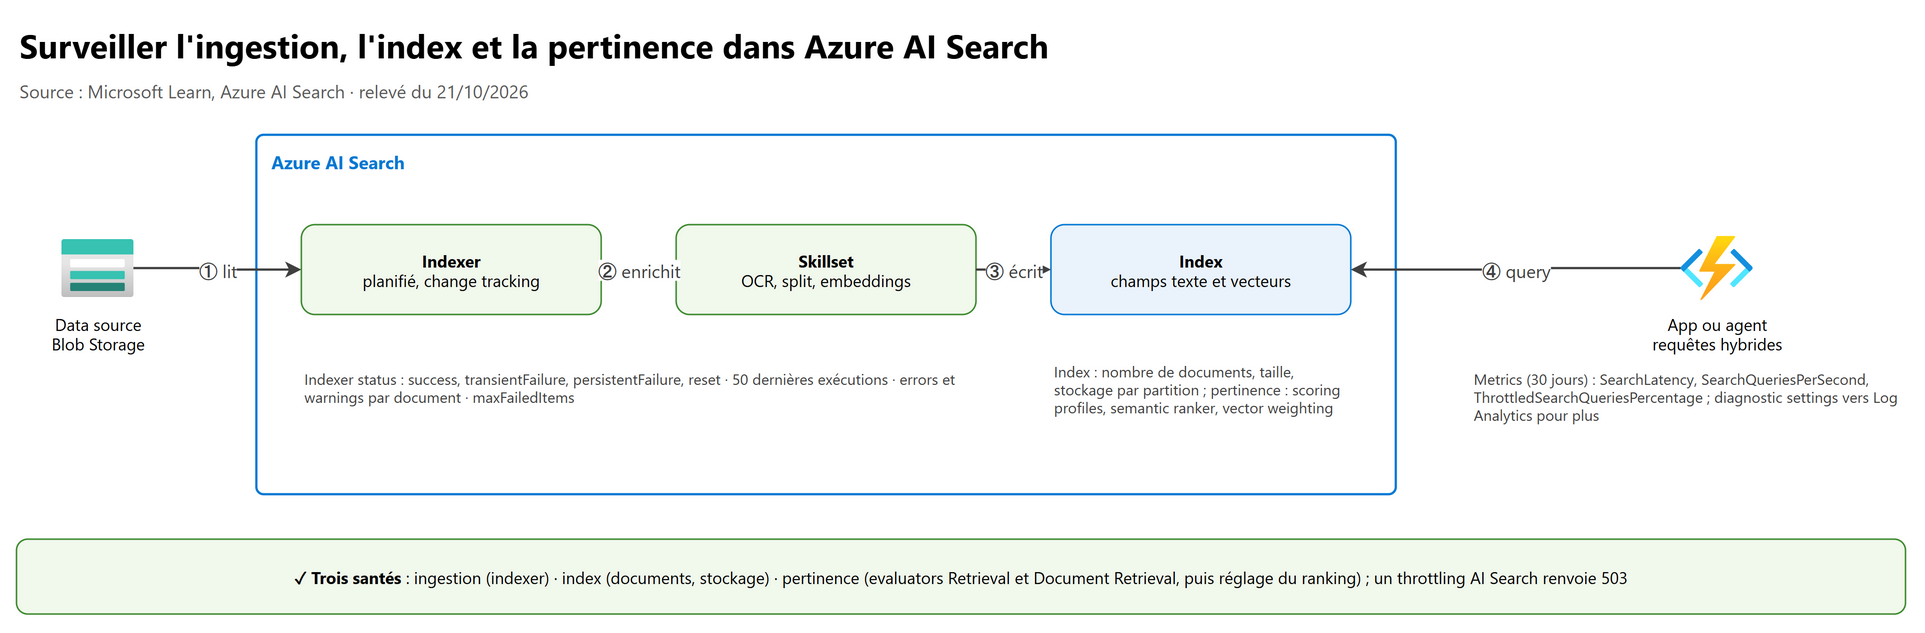
4.1 Qualité de l'ingestion : l'indexer#
| Où | Ce qu'on voit |
|---|---|
| Portail, page Indexers | Statut In Progress, Success, Failed (erreurs au-delà de Max failed items), Reset (change tracking réinitialisé, réindexation complète) ; Docs Succeeded ; détail d'une exécution téléchargeable en CSV |
| API Get Indexer Status | Statut de l'indexer (running = disponible, pas forcément en cours) et historique des 50 dernières exécutions : success, transientFailure, persistentFailure, reset |
| Errors / warnings | Problèmes par document (contenu illisible, skill en échec…) |
Piège : une exécution Success peut contenir des erreurs de documents, tant qu'elles restent sous Max failed items. Il faut lire les errors et warnings, pas seulement le statut.
GET https://<service>.search.windows.net/indexers/<indexer>/status?api-version=2026-04-01
Authorization: Bearer <jeton Entra ID>
L'en-tête api-key (clé admin) devient facultatif quand le service accepte les rôles et qu'un jeton Bearer est fourni. Les objets
comme les indexers relèvent du rôle Search Service Contributor ; les rôles Search Index Data ne portent que sur les documents
(chargement, requêtes).
4.2 Santé du service et de l'index#
| Metric | Signification |
|---|---|
| SearchLatency | Durée des requêtes (moyenne, max, total sur la minute) |
| SearchQueriesPerSecond | Charge (QPS), fenêtre fixe d'une minute |
| ThrottledSearchQueriesPercentage | Pourcentage de requêtes abandonnées : mémoire, CPU, E/S au-dessus d'un seuil ; requêtes et indexation partagent les mêmes ressources |
- Les metrics sont gardées 30 jours ; au-delà, et pour avoir les chaînes de requête, activer un diagnostic setting vers Log Analytics (recommandé).
- Une requête limitée renvoie « You are sending too many requests » ou un 503. Hausse fréquente pendant l'indexation ou quand un replica sort de la rotation : décaler l'indexation, ajouter des replicas (requêtes) ou partitions (stockage).
- Alertes usuelles : latence, throttling, seuil de QPS.
// Durée moyenne par opération d'Azure AI Search
AzureDiagnostics
| where ResourceProvider == "MICROSOFT.SEARCH"
| summarize avg(DurationMs), count() by OperationName, bin(TimeGenerated, 1h)
4.3 Pertinence : mesurer puis régler#
Mesurer avec les evaluators RAG de Foundry :
| Evaluator | Il faut | Mesure |
|---|---|---|
| Retrieval | query, context (+ deployment juge) |
Pertinence des extraits récupérés, sans vérité terrain |
| Document Retrieval | retrieval_ground_truth (labels de pertinence), retrieved_documents |
Fidelity, NDCG, XDCG, Max Relevance, Holes : métriques de moteur de recherche, pour comparer des réglages (parameter sweep : top_k, taille des chunks, vecteur ou sémantique) |
| Groundedness, Relevance | réponse + contexte / requête | Qualité de la réponse finale |
Régler avec les leviers d'Azure AI Search :
| Levier | Effet |
|---|---|
| Scoring profiles | Booste des champs ou des fonctions (fraîcheur, distance, magnitude) ; champs non vectoriels ; jusqu'à 100 par index, un seul par requête |
| Hybrid search | Texte (BM25) + vecteurs (HNSW ou KNN exhaustif) fusionnés par RRF |
| Vector weighting | Poids d'une requête vectorielle dans le RRF (défaut 1.0) |
| Semantic ranker | Reclassement L2 (@search.rerankerScore de 0 à 4) des meilleurs résultats ; fonctionnalité premium ; obligatoire pour l'agentic retrieval |
debug dans la requête |
Décompose le score en sous-scores pour régler le poids des vecteurs |
5. Sécuriser identités, rôles, réseau et chiffrement#
5.1 Entra ID plutôt que les clés#
| Microsoft Entra ID (keyless) | API keys | |
|---|---|---|
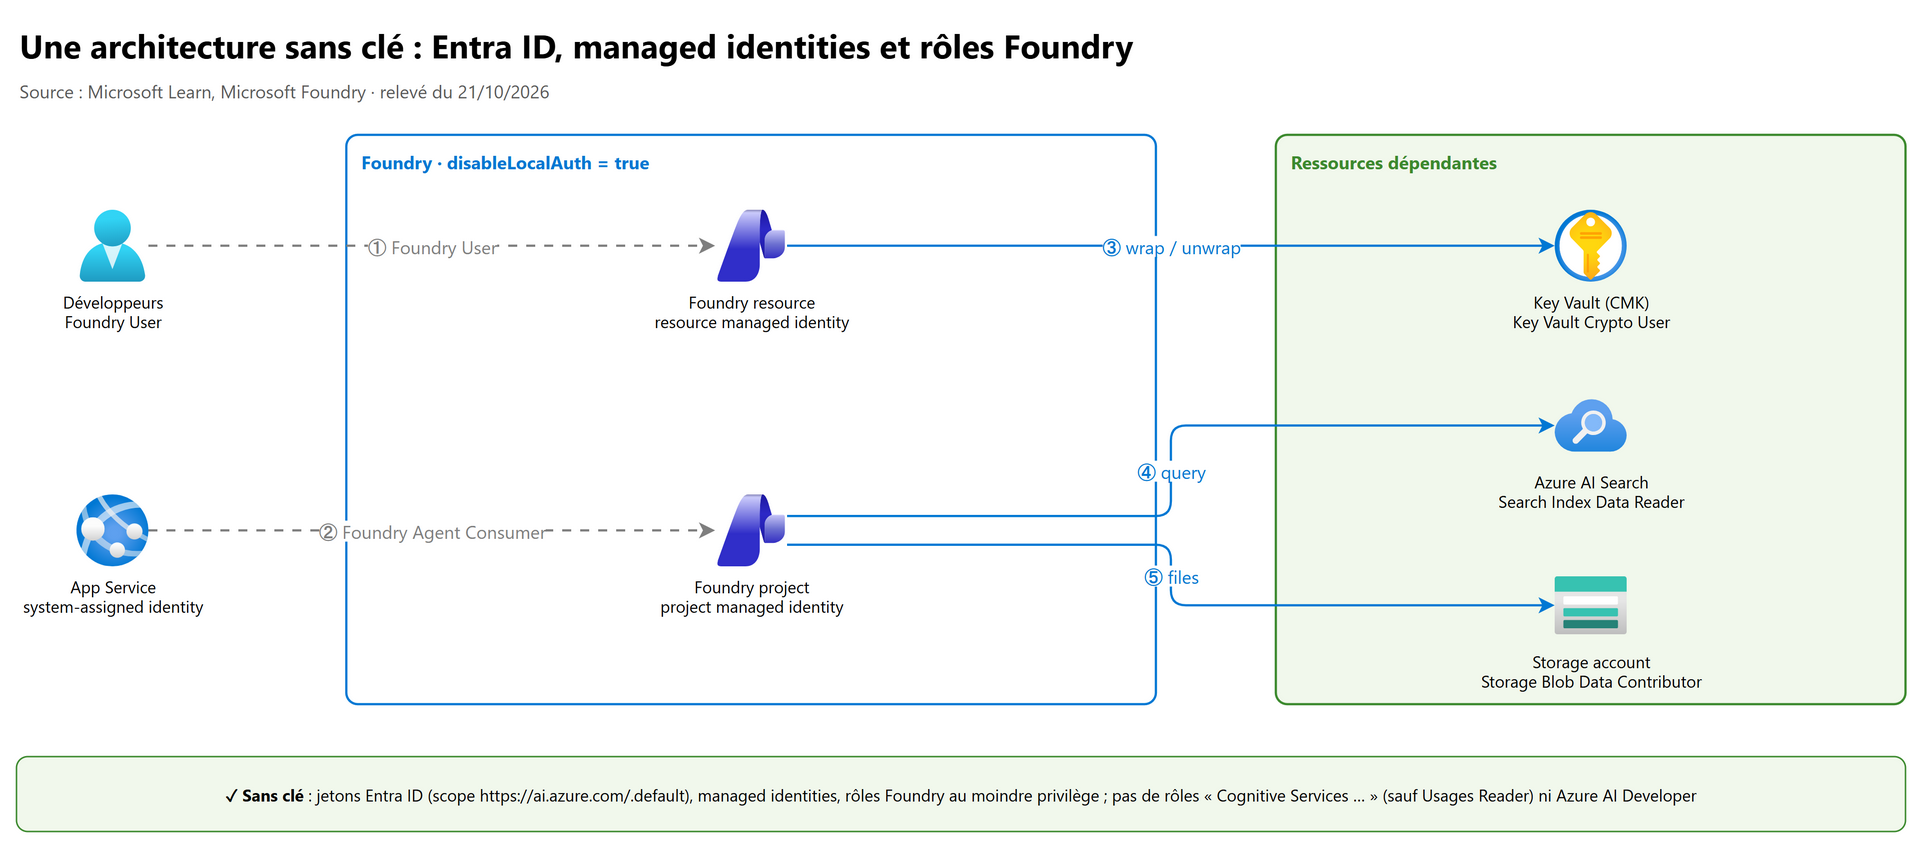
| Nature | Jeton OAuth 2.0, scope https://ai.azure.com/.default |
Secret statique de la ressource |
| Granularité | RBAC au moindre privilège, par principal | Tout ou rien sur la ressource |
| Traçabilité | Par utilisateur (tenant ID et object ID dans le jeton) | Aucune |
| Révocation | Retirer le rôle ou désactiver le principal | Régénérer la clé |
| Conditional Access, MFA, managed identities | Oui | Non |
| Foundry Agent Service, evaluations, toolbox | Oui (seule méthode) | Non |
| Usage conseillé | Production | Prototype rapide, test isolé |
Prérequis : la ressource doit avoir un custom subdomain (sinon l'authentification par jeton échoue). En production, Microsoft
conseille de remplacer DefaultAzureCredential par une credential déterministe (ManagedIdentityCredential, ou un
ChainedTokenCredential réduit). Erreurs fréquentes : 401 (jeton absent ou mauvais scope), 403 (rôle manquant).
Désactiver les clés une fois tous les appelants passés à Entra ID :
| Méthode | Comment |
|---|---|
| Azure Policy | Azure AI Services resources should have key access disabled (disable local authentication) à la subscription ou au resource group |
| Bicep / ARM | Propriété disableLocalAuth: true |
| PowerShell | Set-AzCognitiveServicesAccount -ResourceGroupName rg -Name res -DisableLocalAuth $true (vérifier avec Get-AzCognitiveServicesAccount) |
Piège : l'effet n'est pas immédiat : la passerelle peut accepter les anciennes clés quelques minutes à plusieurs heures. Vérifier par un appel avec l'ancienne clé (attendu : 401) et régénérer Key1 et Key2.
5.2 Managed identities et ressources liées#
Deux identités côté Foundry : celle de la Foundry resource et celle de chaque Foundry project (project managed identity). Les rôles sur les ressources dépendantes s'attribuent à ces identités :
| Ressource | Rôle à donner (identité) | Pourquoi |
|---|---|---|
| Foundry resource | Foundry User (project managed identity) | Accès du project aux fonctionnalités (attribué automatiquement à la création par le portail si on peut attribuer des rôles) |
| Azure AI Search | Search Index Data Reader (lecture) ; Search Index Data Contributor + Search Service Contributor (Standard agent setup, création d'index) | Requêter ou alimenter l'index sans clé |
| Storage account | Storage Blob Data Reader / Contributor ; Storage Blob Data Owner sur le conteneur des agents (Standard setup) | Lire les documents, déposer des fichiers |
| Azure Cosmos DB (Standard setup) | Cosmos DB Built-in Data Contributor | Fils de conversation des agents |
| Key Vault (CMK) | Key Vault Crypto User (RBAC) | Chiffrement par clé client (5.5) |
| Foundry resource ← Azure AI Search | Cognitive Services User / Cognitive Services Data User (identité du service de recherche) | Vectorisation intégrée, knowledge base |
Piège : dans le nouveau Foundry, les permissions ne sont pas héritées de l'utilisateur : si un agent n'arrive pas à lire l'index alors que l'index fonctionne, vérifier d'abord les rôles de la project managed identity (puis le réseau).
5.3 Les rôles Foundry (role policies)#
Les rôles ont été renommés récemment ; les anciens noms apparaissent encore. Dans le code, utiliser le GUID.
| Rôle (ancien nom) | GUID | Peut |
|---|---|---|
| Foundry Agent Consumer | eed3b665-ab3a-47b6-8f48-c9382fb1dad6 |
Seulement appeler les endpoints d'agents (moindre privilège pour les applications et utilisateurs finaux) |
| Foundry User (Azure AI User) | 53ca6127-db72-4b80-b1b0-d745d6d5456d |
Construire et développer dans un project (data actions), lecture ; pas de déploiement de modèle |
| Foundry Project Manager (Azure AI Project Manager) | eadc314b-1a2d-4efa-be10-5d325db5065e |
Gérer les projects, construire, publier des agents, attribuer Foundry User (sous condition) ; pas de gestion des modèles (ni déploiement, ni fine-tuning) |
| Foundry Account Owner (Azure AI Account Owner) | e47c6f54-e4a2-4754-9501-8e0985b135e1 |
Créer comptes et projects, gérer les modèles, attribuer Foundry User, ACR, monitoring ; pas de data actions |
| Foundry Owner (Azure AI Owner) | c883944f-8b7b-4483-af10-35834be79c4a |
Tout (contrôle + données) : rôle libre-service très privilégié |
| Rôle Azure générique | Créer projects / comptes | Data actions | Gérer les modèles |
|---|---|---|---|
| Owner | Oui | Non | Oui |
| Contributor | Oui | Non | Oui (peut déployer des modèles) |
| Reader | Non | Non | Non |
Règles à connaître :
- Ne pas utiliser les rôles commençant par Cognitive Services pour Foundry (prévus pour l'accès direct aux AI Services), sauf Cognitive Services Usages Reader pour le quota.
- Ne pas utiliser Azure AI Developer : il vise les workspaces Azure Machine Learning et les hubs, pas les Foundry projects.
- Étendues : Foundry resource > Foundry project > agent (évaluée seulement pour l'accès à l'endpoint de cet agent). Le portail n'attribue Foundry Agent Consumer qu'au niveau du compte : pour le project ou l'agent, passer par la CLI.
- Fine-tuning : il faut plan de données + plan de contrôle : Foundry Owner, ou Foundry User + Foundry Account Owner.
- Publier un agent : Foundry Project Manager au minimum. Observabilité : Foundry User + Monitoring Reader sur Application Insights.
- Les rôles mettent jusqu'à 5 minutes à se propager.
# Foundry Agent Consumer sur un seul agent (moindre privilège)
az role assignment create --assignee-object-id "<principalId>" --assignee-principal-type ServicePrincipal \
  --role "eed3b665-ab3a-47b6-8f48-c9382fb1dad6" \
  --scope "/subscriptions/<sub>/resourceGroups/<rg>/providers/Microsoft.CognitiveServices/accounts/<compte>/projects/<project>/agents/<agent>"
Un rôle personnalisé se construit avec Actions (plan de contrôle) et DataActions (plan de données, par exemple
Microsoft.CognitiveServices/accounts/AIServices/agents/*) ; il faut Owner sur l'étendue pour le créer.
5.4 Le réseau privé#
| Sens | Options | À retenir |
|---|---|---|
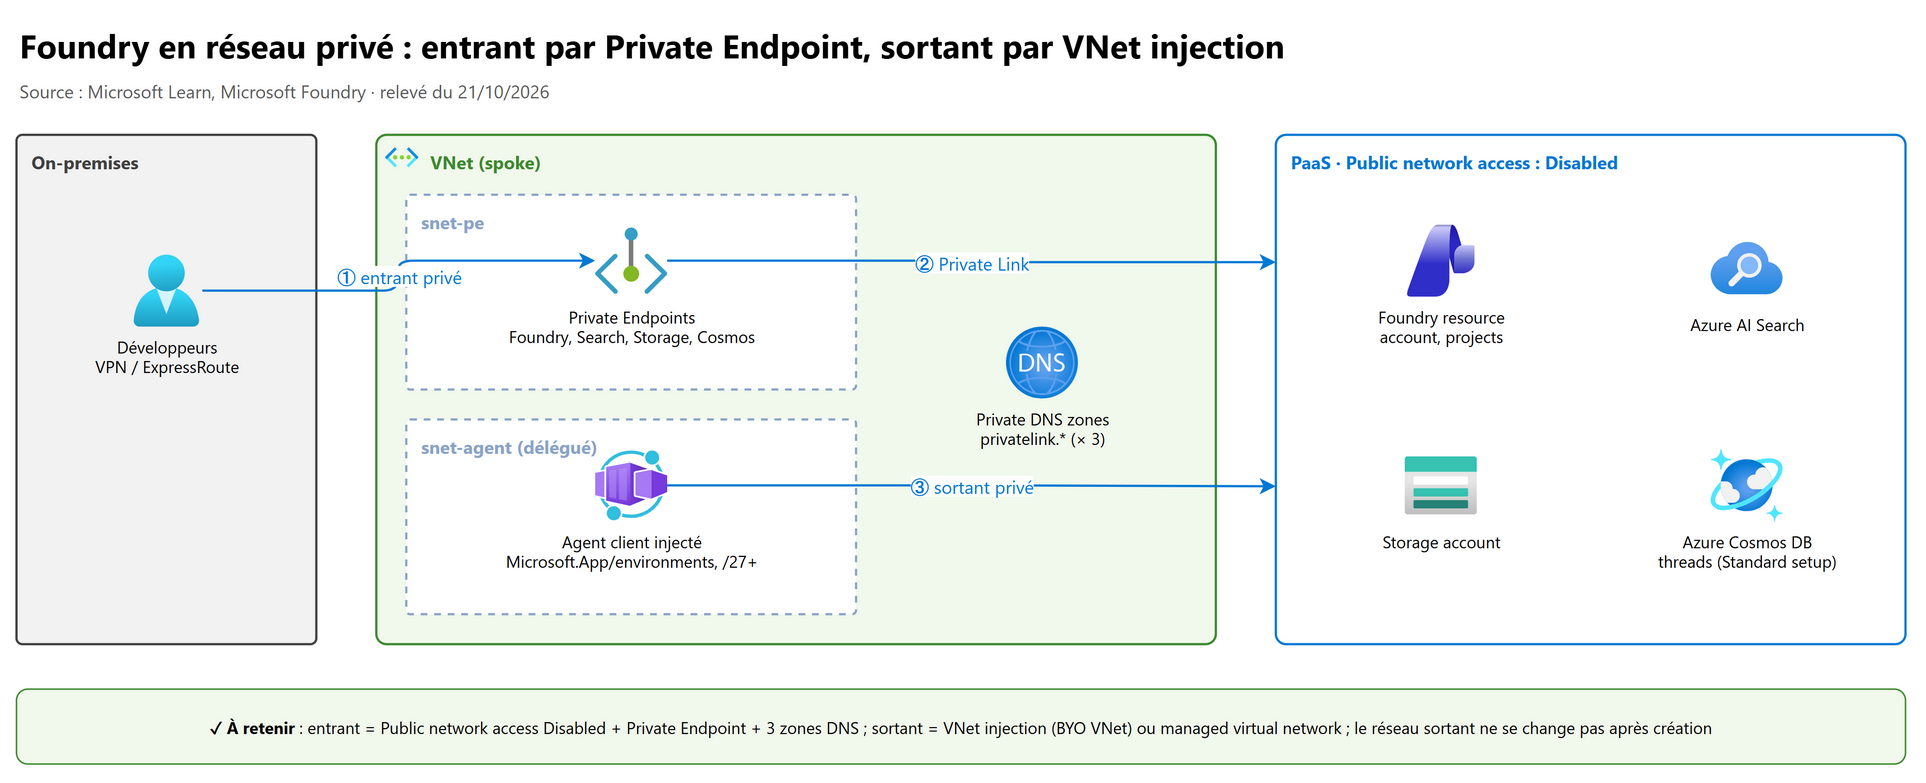
| Entrant (qui atteint l'endpoint Foundry) | Public network access : Enabled, Selected IP addresses, ou Disabled + Private Endpoint | Sous-ressource account ; trois zones DNS : privatelink.cognitiveservices.azure.com, privatelink.openai.azure.com, privatelink.services.ai.azure.com |
| Sortant (comment les agents et evaluations atteignent les données) | Public egress, BYO VNet (VNet injection), Managed virtual network | VNet injection : subnet délégué à Microsoft.App/environments, taille /27 ou plus ; managed VNet : Microsoft gère le réseau (utile si les plages IP se chevauchent), régions limitées |
- Avec la sortie isolée, l'entrée passe aussi par un Private Endpoint.
- Les Private Endpoints vers Azure AI Search, Storage et Cosmos DB ne sont pas créés automatiquement : les ajouter sur chaque
ressource (zones
privatelink.search.windows.net,privatelink.blob.core.windows.net,privatelink.documents.azure.com). - Le réseau sortant ne peut pas être modifié après création (pas d'ajout de VNet injection, pas de changement de subnet) : il faut redéployer la Foundry resource.
- Avec un pare-feu en sortie, autoriser notamment
login.microsoftonline.com,*.identity.azure.net(agents) et les FQDN d'Application Insights (evaluations et traces). - Limites : Workflow Agents (sortie isolée non prise en charge), AI Gateway créé depuis le portail public par défaut (à isoler dans le portail Azure), certains outils d'agent partiellement pris en charge.
5.5 Customer-managed keys (CMK)#
Les données sont chiffrées au repos avec des clés Microsoft ; une CMK apporte le contrôle (rotation, révocation, audit).
| Exigence | Détail |
|---|---|
| Key store | Key Vault ou Managed HSM, même région que la Foundry resource |
| Protection | Soft delete et purge protection obligatoires |
| Identité | Managed identity de la ressource (system-assigned ou user-assigned) |
| Droits | RBAC : Key Vault Crypto User ; access policies : Encrypt, Decrypt, Wrap Key, Unwrap Key, Sign, Verify ; Managed HSM : Managed HSM Crypto User |
| Pare-feu du Key Vault | Autoriser les trusted Microsoft services |
Piège : supprimer ou rendre inaccessible la clé rend les données chiffrées inutilisables. Les pages classic d'Azure OpenAI citent d'autres exigences (clés RSA 2048, rôle Key Vault Crypto Service Encryption User) : à l'examen, retenir le principe identité + Key Vault protégé + droits wrap/unwrap.
5.6 Azure Policy pour Foundry#
| Définition intégrée | Effets | Usage |
|---|---|---|
| Foundry model deployments should only use approved models | Audit, Deny, Disabled | Liste blanche d'éditeurs (allowedPublishers) ou d'asset IDs (préfixe : terminer par / pour ne viser qu'un modèle) |
| Foundry model deployments should meet eligibility requirements (marquée préversion dans la liste des définitions) | Audit, Deny | denyPreviewModels, onlyAllowDirectFromAzure |
| Azure AI Services resources should have key access disabled | Audit, Deny | Imposer Entra ID |
| Azure AI Services resources should encrypt data at rest with a customer-managed key (CMK) | Audit, Deny | Imposer la CMK |
| Enable logging by category group for Cognitive Services… | DeployIfNotExists | Créer les diagnostic settings |
Stratégie personnalisée sur Microsoft.CognitiveServices/accounts/deployments/sku.name |
Deny | Interdire un type de déploiement (par exemple GlobalStandard pour la résidence des données) |
Les politiques de modèles s'évaluent au déploiement : le modèle reste visible dans le catalogue, mais Deploy est désactivé avec le nom de la policy. Il faut Owner ou Resource Policy Contributor pour assigner, et jusqu'à 15 minutes de propagation.
6. Labs conseillés#
Dans une subscription de test. Coût : quelques centimes de jetons, plus Log Analytics et Application Insights (petits volumes) ; supprimer le resource group à la fin. Éviter tout PTU (facturé à l'heure).
- Provoquer et lire un 429 : déployer un modèle mini en Global Standard avec un très petit TPM ; envoyer 30 requêtes en
rafale avec
max_tokensélevé puis faible. Attendu : des 429 avecretry-after-ms, moins de 429 quandmax_tokensbaisse ; comparer avec la metric Azure OpenAI Requests découpée parStatusCode. - Sans clé de bout en bout : attribuer Foundry User à son compte, appeler le modèle avec
get_bearer_token_provider, puisdisableLocalAuthet un appel avec la clé. Attendu : l'appel Entra ID réussit ; l'appel par clé finit en 401. - Tracing et evaluation continue : connecter Application Insights au project, activer le tracing d'un agent, générer du trafic, créer une Continuous evaluation (Groundedness, Relevance). Attendu : traces visibles en 2 à 5 minutes, scores dans l'onglet Monitor.
- Santé d'Azure AI Search : indexer quelques PDF depuis Blob Storage (avec un fichier corrompu), activer un diagnostic setting.
Attendu : exécution Success avec un warning/error de document, requête KQL sur
MICROSOFT.SEARCHdans Log Analytics. - Policy de modèles : assigner Foundry model deployments should only use approved models en Deny avec un seul modèle autorisé. Attendu : le bouton Deploy est désactivé pour les autres modèles, avec le nom de la policy.
7. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| 429 alors que les metrics de jetons sont sous le quota | Estimation max_tokens, rafales sur 1 à 10 s, requêtes rejetées |
La limite porte sur l'estimation à la réception, pas sur les jetons facturés |
| Un 429 sur un deployment PTU | Rediriger (spillover) ou réessayer après retry-after-ms |
Signal de gestion du trafic, pas une panne |
| Débordement automatique d'un PTU saturé | Spillover vers un deployment Standard de la même ressource | Fonction native (x-ms-spillover-deployment) |
| Traiter des millions de documents la nuit au moindre coût | Global Batch (-50 %, 24 h, quota séparé) | N'affecte pas le quota en ligne |
| Lire le quota disponible, moindre privilège | Cognitive Services Usages Reader sur la subscription | Pas au resource group |
| Bloquer toute dépense au-delà d'un montant | Budget + action group automatisé | Azure OpenAI n'a pas de limite dure |
| Réduire le coût d'un long system prompt répété | Prompt caching (≥ 1 024 jetons identiques en tête) | Remise sur les jetons en cache |
| Surveiller la latence Azure OpenAI | Time to Response / Time to Last Byte, avec un nombre de jetons (en Standard, Time to Last Byte : Time to Response et Time Between Tokens n'y sont pas encore disponibles) | Jamais la metric héritée Latency |
| Les journaux RequestResponse sont vides | Créer un diagnostic setting | Les resource logs ne sont pas collectés par défaut |
| Détecter une dérive de qualité dans le temps | Scheduled evaluation sur un golden dataset | La continuous evaluation échantillonne le trafic réel |
| Voir le contenu des messages dans les traces | OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true, en dev seulement |
Données sensibles |
| Indexer « Success » mais documents manquants | Lire errors/warnings, Max failed items | Le statut global masque les erreurs par document |
| Requêtes Azure AI Search abandonnées pendant l'indexation | ThrottledSearchQueriesPercentage ; décaler l'indexation, ajouter des replicas | Mêmes ressources pour requêtes et indexation |
| Comparer des réglages de recherche avec des labels de pertinence | Evaluator Document Retrieval (NDCG, XDCG, Fidelity) | Retrieval sert sans vérité terrain |
| Une application ne doit qu'appeler un agent | Foundry Agent Consumer (au project ou à l'agent, par CLI) | Moindre privilège |
| Un développeur crée des agents mais ne déploie pas de modèles | Foundry User | Data actions sans gestion des modèles |
| Contributor ne peut pas créer d'agent | Normal : pas de data actions | Ajouter Foundry User |
| Rôle à attribuer pour le fine-tuning | Foundry Owner, ou Foundry User + Foundry Account Owner | Il faut les deux plans |
| Rôle « Azure AI Developer » ou « Cognitive Services OpenAI User » pour un Foundry project | À éviter | Hubs / accès direct AI Services ; sauf Usages Reader |
| Agent Service avec une API key | Impossible | Agents et evaluations exigent Entra ID |
| Authentification par jeton qui échoue « custom subdomain required » | Configurer un custom subdomain | Prérequis du jeton |
Les clés marchent encore après disableLocalAuth |
Propagation jusqu'à plusieurs heures ; régénérer les clés | Pas de coupure immédiate |
| Ajouter une VNet injection à une Foundry existante | Impossible : redéployer | Le réseau sortant n'est pas modifiable |
| Private Endpoint créé mais résolution publique | Les trois zones DNS (cognitiveservices, openai, services.ai) | Trois FQDN par ressource |
| Subnet pour l'Agent Service | Délégué à Microsoft.App/environments, /27 minimum | Exigence de la VNet injection |
| CMK refusée | Key Vault même région, soft delete + purge protection, rôle Key Vault Crypto User | Prérequis obligatoires |
| N'autoriser que GPT-5 et pas GPT-5.2 | Asset ID terminé par / dans la policy d'approved models |
Correspondance par préfixe |
8. Scénarios d'entraînement#
1. Une application reçoit des 429 aux heures de pointe sur un deployment Global Standard de 300 000 TPM, alors que la metric
de jetons plafonne à 180 000 par minute. Les requêtes fixent max_tokens: 4000 pour des réponses d'environ 300 jetons.
La limite TPM compte l'estimation (invite +
max_tokens) : chaque requête « réserve » 4 000 jetons. Réduiremax_tokensvers 400, lisser les rafales (fenêtres RPM de 1 à 10 s), garder les retries du SDK avecretry-after-ms. Demander du quota ne s'impose qu'ensuite.
2. Un service client critique exige une latence stable, mais les pics dépassent parfois la capacité réservée. Que configurer ?
Un deployment Provisioned (PTU) dimensionné avec le capacity calculator, le spillover vers un deployment Standard de la même ressource pour les pics, la metric Provisioned-managed Utilization V2 découpée par deployment avec une alerte, et une reservation PTU (après création du deployment).
3. Chaque nuit, 2 millions de fiches produit doivent être résumées ; le budget est serré et le trafic en ligne ne doit pas être perturbé.
Global Batch (ou Data Zone Batch pour la résidence) : -50 %, quota de jetons en file séparé, objectif 24 h.
4. La direction veut être prévenue dès 80 % du budget mensuel IA et couper les appels au-delà de 100 %.
Budget Cost Management avec alertes à 80 % et 100 % ; Azure OpenAI n'a pas de plafond dur : déclencher un action group (runbook ou Function) qui, par exemple, réduit les TPM ou désactive l'application. Rôle de lecture : Cost Management Reader.
5. Après une mise à jour du system prompt, les utilisateurs signalent des réponses inventées. Comment le détecter automatiquement la prochaine fois ?
Scheduled evaluation sur un golden dataset avant et après chaque changement (dérive), continuous evaluation du trafic réel avec Groundedness et Relevance, alerte sous le seuil, puis analyse des traces de l'agent.
6. Un agent Foundry n'arrive pas à interroger un index Azure AI Search qui répond pourtant dans Search explorer.
Donner à la project managed identity le rôle Search Index Data Reader (ou Data Contributor + Search Service Contributor en Standard setup) ; vérifier ensuite le réseau (Private Endpoint de Search et zone
privatelink.search.windows.netsi l'accès public est coupé).
7. La sécurité impose : aucune clé, accès uniquement depuis le réseau d'entreprise, agents qui n'accèdent aux données qu'en privé.
disableLocalAuth(et la policy key access disabled), applications en managed identity avec les rôles Foundry ; Public network access : Disabled + Private Endpoint + les trois zones DNS ; VNet injection (subnet déléguéMicrosoft.App/environments, /27+) ou managed virtual network, décidé à la création ; Private Endpoints vers Search, Storage et Cosmos DB.
8. Une application web doit seulement converser avec un agent précis, rien d'autre.
Managed identity de l'App Service avec Foundry Agent Consumer à l'étendue de cet agent (attribution par CLI, le portail ne propose que le niveau compte).
9. L'équipe conformité veut interdire les modèles en préversion et n'autoriser que les modèles OpenAI.
Policies Foundry model deployments should meet eligibility requirements (
denyPreviewModels: true) et …should only use approved models (allowedPublishers: ["OpenAI"]) en Deny, à la subscription ; le bouton Deploy est désactivé pour le reste.
10. Des requêtes Azure AI Search échouent en 503 chaque matin à 8 h, pendant la réindexation complète.
Throttling (ThrottledSearchQueriesPercentage) : requêtes et indexation partagent les ressources. Décaler l'indexation, passer en change tracking (incrémental), ajouter des replicas ; alerte sur le throttling.
9. Pour aller plus loin#
- Priority processing (Data Zone Standard) : réponses plus rapides en paiement à l'usage, pour les charges sensibles à la latence sans PTU.
- Instant access (préversion) : appeler certains modèles par leur nom sans créer de deployment, pour prototyper.
- Chargeback par project (préversion) dans Cost Management, et tags de deployment pour répartir les coûts.
- Azure Monitor Private Link Scope : faire passer la télémétrie d'Application Insights en privé dans une architecture isolée.
- Microsoft Defender for Cloud : AI-SPM (posture des ressources IA) et Defender for AI services (SC-500, 07).
- Foundry Control Plane : inventaire et supervision centralisés des agents, y compris ceux hébergés hors de Foundry.
10. Fiche à retenir#
- Quota = subscription + région + modèle + type de déploiement, en TPM ; RPM fixé par unité de capacité.
- Limite TPM = estimation (invite +
max_tokens+best_of) ; RPM sur des fenêtres de 1 à 10 s ; les rejets comptent. - En-têtes :
x-ratelimit-remaining-*,retry-after-ms; SDK : 2 retries par défaut,max_retries=0avec tenacity. - PTU : Provisioned-managed Utilization V2 ; 429 immédiat à 100 % ; spillover vers Standard de la même ressource.
- Reservations PTU : 1 mois / 1 an, non interchangeables, pas de garantie de capacité.
- Batch : -50 %, 24 h, quota séparé. Prompt caching : 1 024 jetons identiques en tête.
- Pas de limite dure de dépense : budget + action group ; rôle Cost Management Reader.
- Quota lisible avec Cognitive Services Usages Reader à la subscription.
- Metrics auto ; logs (Audit, RequestResponse, Trace) via diagnostic setting ; traces via Application Insights du project.
- Latence : Time to Response / Time to Last Byte, toujours avec un nombre de jetons ; jamais Latency héritée.
- Continuous evaluation (trafic réel) vs scheduled evaluation (golden dataset, dérive) ; Groundedness 1 à 5, seuil 3.
- Content recording : dev uniquement.
- Indexer : 50 dernières exécutions, Success possible avec erreurs ; Search : SearchLatency, QPS, Throttled %, 503.
- Pertinence : Document Retrieval (NDCG, XDCG, Fidelity) avec labels ; scoring profiles, semantic ranker, vector weighting.
- Entra ID : scope
https://ai.azure.com/.default, custom subdomain ; Agent Service et evaluations sans clé uniquement. -
disableLocalAuth: true/ policy key access disabled ; propagation jusqu'à plusieurs heures. - Rôles : Agent Consumer < Foundry User < Project Manager ; Account Owner (contrôle) ; Foundry Owner (tout).
- Pas de rôles Cognitive Services (sauf Usages Reader) ni Azure AI Developer pour Foundry.
- Réseau : PE + 3 zones DNS ; sortie par VNet injection (Microsoft.App/environments, /27) ou managed VNet ; non modifiable.
- CMK : Key Vault même région, soft delete + purge protection, Key Vault Crypto User.
- Policies : approved models, eligibility, key access disabled, CMK, diagnostic logs (DINE).
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Guide d'étude de l'examen AI-103 (en anglais)
- Azure OpenAI dans Microsoft Foundry : quotas et limites
- Gérer le quota d'Azure OpenAI
- Deployment types for Microsoft Foundry Models
- What is provisioned throughput for Foundry Models?
- Operate provisioned deployments in production
- Manage traffic with spillover for provisioned deployments
- Save costs with Microsoft Foundry Provisioned Throughput Reservations
- Prompt caching
- Plan and manage costs for Microsoft Foundry
- Performance and latency
- Azure OpenAI monitoring data reference
- Observability in generative AI
- Add client-side tracing to Foundry agents (preview)
- Monitor agents with the Agent Monitoring Dashboard
- Retrieval-Augmented Generation (RAG) evaluators
- Monitor indexer status and results in Azure AI Search
- Monitor query requests in Azure AI Search
- Azure AI Search monitoring data reference
- Configure diagnostic logging for Azure AI Search
- Relevance in Azure AI Search
- Authentification et autorisation dans Microsoft Foundry
- Contrôle d'accès en fonction du rôle pour Microsoft Foundry
- Configure keyless authentication with Microsoft Entra ID
- Disable local authentication in Foundry Tools
- Elevated-role tasks in Microsoft Foundry
- Connect an Azure AI Search index to Foundry agents
- How to configure network isolation for Microsoft Foundry
- Networking options for Foundry Agent Service
- Set up private networking for Foundry Agent Service
- Configure managed virtual network for Microsoft Foundry projects
- Azure Private Endpoint private DNS zone values
- Configure customer-managed keys for Microsoft Foundry
- Built-in policies for model deployment in Microsoft Foundry portal
- Azure Policy built-in policy definitions (Cognitive Services)