

Version : 1.1 · Date : 2026-10-21
En une phrase : dans AKS, les données vivent hors des pods (PVC → StorageClass → CSI driver → Managed Disk, Azure Files ou Blob Storage), la capacité suit la charge en deux temps (des pods avec HPA ou KEDA, puis des nodes avec Cluster Autoscaler ou Node Autoprovisioning), et la résilience se construit par couches : réplicas étalés sur les availability zones (zones de disponibilité), PDB, mises à niveau maîtrisées, puis une deuxième région.
Ce que tu dois savoir expliquer en entretien#
| Question type | Section |
|---|---|
| « Comment un pod obtient-il un disque persistant ? Que se passe-t-il si le pod change de node ou de zone ? » | 1 |
| « Managed Disks, Azure Files, Blob Storage, Azure NetApp Files, Azure Container Storage : lequel et pourquoi ? » | 1.3 |
| « Comment sauvegardez-vous un cluster ? » | 1.6 |
| « HPA, VPA, KEDA, Cluster Autoscaler, Node Autoprovisioning : qui fait quoi ? » | 2 |
| « Comment rendez-vous un cluster résistant à la perte d'une zone, puis d'une région ? » | 3 |
| « Comment mettez-vous à niveau sans coupure ? » | 3.4 |
1. Le stockage#
1.1 Les objets à connaître#
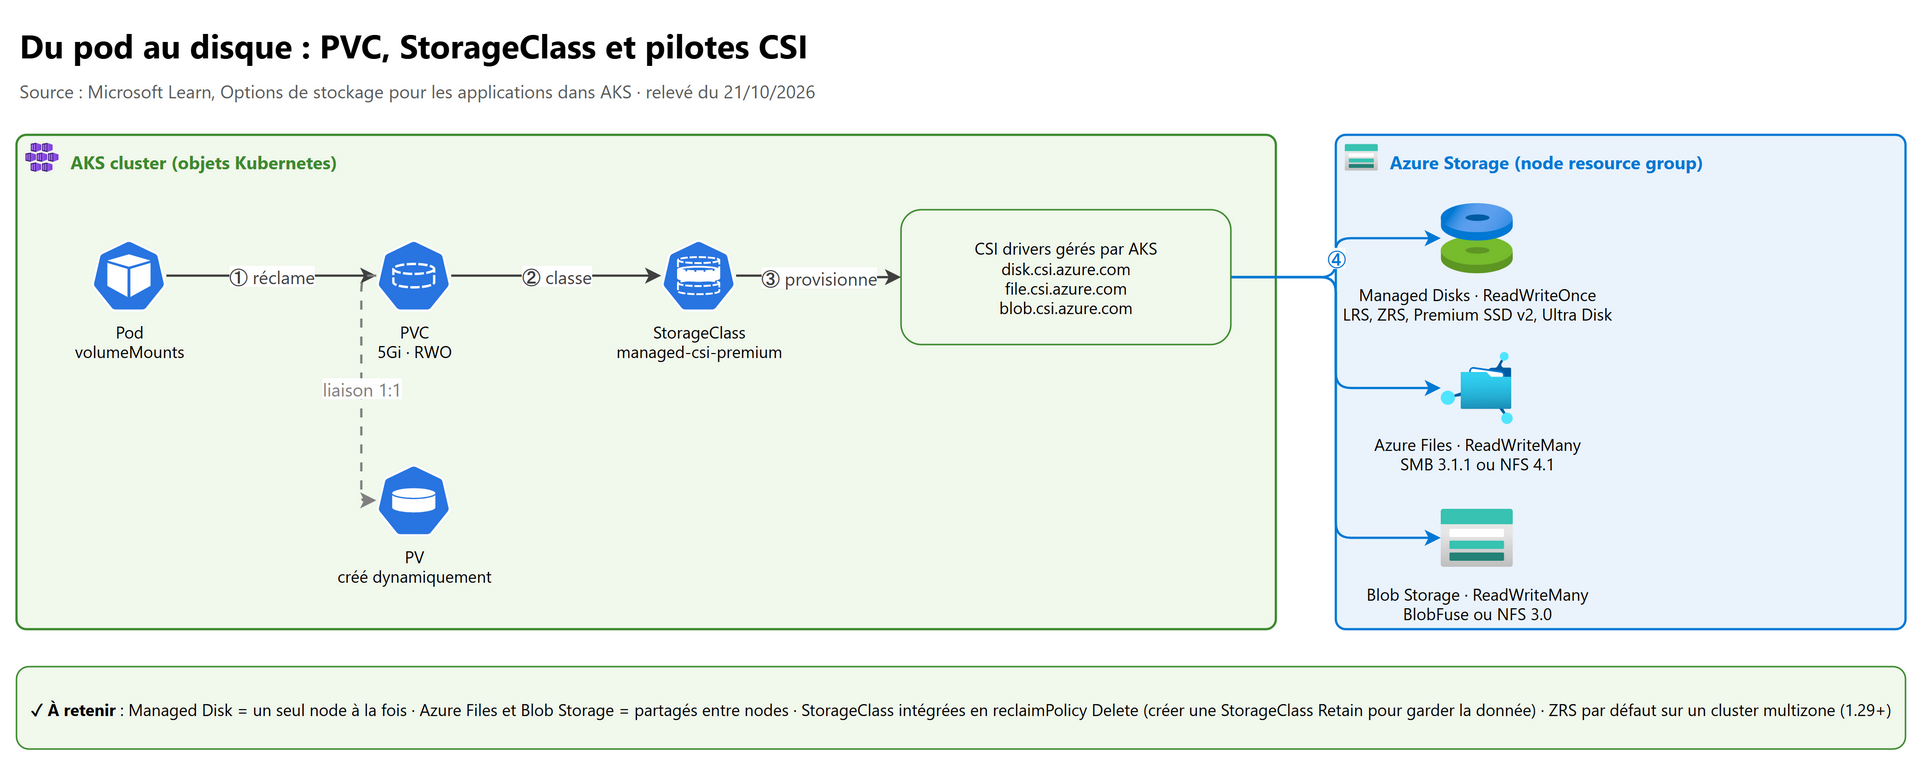
Un pod est jetable : tout ce qu'il écrit sur son propre système de fichiers disparaît avec lui. Kubernetes sépare donc le besoin (la demande) de la ressource (le volume) :
| Objet | Rôle | Qui le crée |
|---|---|---|
| Volume (emptyDir, secret, configMap…) | Stockage lié à la vie du pod (emptyDir disparaît avec le pod ; secret et configMap injectent de la configuration, le secret en mémoire tmpfs) | Le développeur, dans le pod |
| PersistentVolumeClaim (PVC) | La demande : taille, access mode, StorageClass | Le développeur |
| StorageClass | Le « type » de stockage : provisioner, SKU, reclaimPolicy, volumeBindingMode |
L'équipe plateforme (AKS en fournit) |
| PersistentVolume (PV) | La ressource réelle, liée 1 pour 1 à une PVC | Créé dynamiquement par le CSI driver (ou à la main en statique) |
| CSI driver (Container Storage Interface) | Le plug-in qui crée, attache, monte et supprime la ressource Azure | Géré par AKS : disk.csi.azure.com, file.csi.azure.com, blob.csi.azure.com |
Depuis Kubernetes 1.21, AKS utilise les CSI drivers par défaut ; depuis 1.26, on ne peut plus créer de volume avec les anciens
drivers « in-tree ». Les ressources Azure créées dynamiquement atterrissent dans le node resource group (MC_…).
Les modes d'accès expliquent la plupart des choix :
| Mode | Sens | Exemple |
|---|---|---|
ReadWriteOnce (RWO) |
Monté en lecture-écriture par un seul node à la fois | Azure Disks |
ReadWriteMany (RWX) |
Monté par plusieurs nodes en même temps | Azure Files, Blob Storage |
1.2 Les StorageClass fournies par AKS#
| StorageClass | Stockage | Remarque |
|---|---|---|
managed-csi (= default) |
Managed Disk Standard SSD | LRS, ou ZRS sur un cluster multizone depuis Kubernetes 1.29 |
managed-csi-premium |
Managed Disk Premium SSD | Idem : ZRS sur un cluster multizone (1.29+) |
managed-csi-premium-v2 |
Managed Disk Premium SSD v2 (LRS) | Depuis Kubernetes 1.35 |
azurefile-csi / azurefile-csi-premium |
Azure Files (file share) Standard / Premium | RWX |
azureblob-nfs-premium / azureblob-fuse-premium |
Blob Storage (container) en NFS 3.0 / BlobFuse | RWX, données non structurées |
Toutes ces StorageClass sont en reclaimPolicy: Delete : supprimer la PVC supprime le disque. AKS réconcilie les
StorageClass par défaut et écrase toute modification : pour un autre comportement, on crée sa propre StorageClass.
# StorageClass Premium ZRS qui conserve le disque après suppression de la PVC (exemple Microsoft Learn)
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: managed-premium-retain
provisioner: disk.csi.azure.com
parameters:
  skuName: Premium_ZRS
reclaimPolicy: Retain
volumeBindingMode: WaitForFirstConsumer   # le disque est créé là où le pod est planifié (zone comprise)
allowVolumeExpansion: true
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: data-postgres
spec:
  accessModes: [ReadWriteOnce]
  storageClassName: managed-premium-retain
  resources:
    requests:
      storage: 64Gi
1.3 Quel stockage choisir#
| Besoin | Choix | Pourquoi |
|---|---|---|
| Base de données, file de messages, un pod = un volume | Azure Disks (Premium SSD, Premium SSD v2, Ultra Disk) | Performances bloc ; RWO ; ZRS pour survivre à une zone |
| Fichiers partagés entre pods (CMS, uploads, partage applicatif) | Azure Files (SMB 3.1.1 ou NFS 4.1) | RWX ; Premium pour la latence |
| Gros volumes non structurés (journaux, images, jeux de données d'IA) | Blob Storage via BlobFuse ou NFS 3.0 | Coût, échelle ; Data Lake Storage montable directement |
| NFS ou SMB très performant | Azure NetApp Files | Cinq niveaux de service, débit élevé |
| Latence inférieure à la milliseconde, données reconstructibles (cache, points de contrôle d'IA, base répliquée) | Azure Container Storage sur NVMe local | Disques de la VM, agrégés ; données perdues si la VM est libérée |
| Volumes bloc gérés à grande échelle, snapshots, ZRS | Azure Container Storage sur Elastic SAN | Orchestration native Kubernetes |
| Données métier critiques | Un service géré hors du cluster (Azure SQL, Cosmos DB, PostgreSQL flexible…) | Sauvegarde, réplication, mises à jour gérées : le cluster reste jetable |
flowchart TD
    A["Le pod a besoin de stockage"] --> B{"Donnée à garder<br/>après le pod ?"}
    B -- Non --> C["emptyDir, ou NVMe local<br/>via Azure Container Storage"]
    B -- Oui --> D{"Donnée métier critique ?"}
    D -- Oui --> E["Service géré hors du cluster<br/>(SQL, Cosmos DB, PostgreSQL…)"]
    D -- Non --> F{"Partagée entre<br/>plusieurs nodes ?"}
    F -- Non --> G["Azure Disks (RWO)<br/>ZRS si multizone"]
    F -- Oui --> H{"Fichiers ou objets ?"}
    H -- Fichiers --> I["Azure Files ou<br/>Azure NetApp Files"]
    H -- Objets --> J["Blob Storage (BlobFuse, NFS 3.0)"]
1.4 StatefulSet, disques et availability zones#
- Un StatefulSet donne à chaque réplica une identité stable (
postgres-0,postgres-1) et sa propre PVC (volumeClaimTemplates). - Un disque LRS est rattaché à une zone : un pod qui bascule dans une autre zone ne peut pas le rattacher, il reste
en
Pending. Un disque ZRS est répliqué de façon synchrone sur les zones de la région et suit le pod. WaitForFirstConsumerévite de créer le disque dans une zone où le pod ne sera jamais planifié.- Le nombre de disques par node est limité par la taille de VM (colonne « nombre maximal de disques de données » ; par exemple 64 pour certaines VM de 16 cœurs).
1.5 Le disque système des nodes#
AKS utilise par défaut un ephemeral OS disk quand la taille de VM le permet : stocké sur l'hôte, plus rapide, mise à l'échelle et mises à niveau plus rapides, sans coût de stockage. Microsoft le recommande vivement. Sinon, le managed OS disk est dimensionné selon le nombre de vCPU (P10 de 128 Go pour 1 à 7 vCPU, jusqu'à P30 de 1 To pour 64 vCPU et plus). La taille du disque OS ne se change pas après la création du node pool.
1.6 Sauvegarder un cluster#
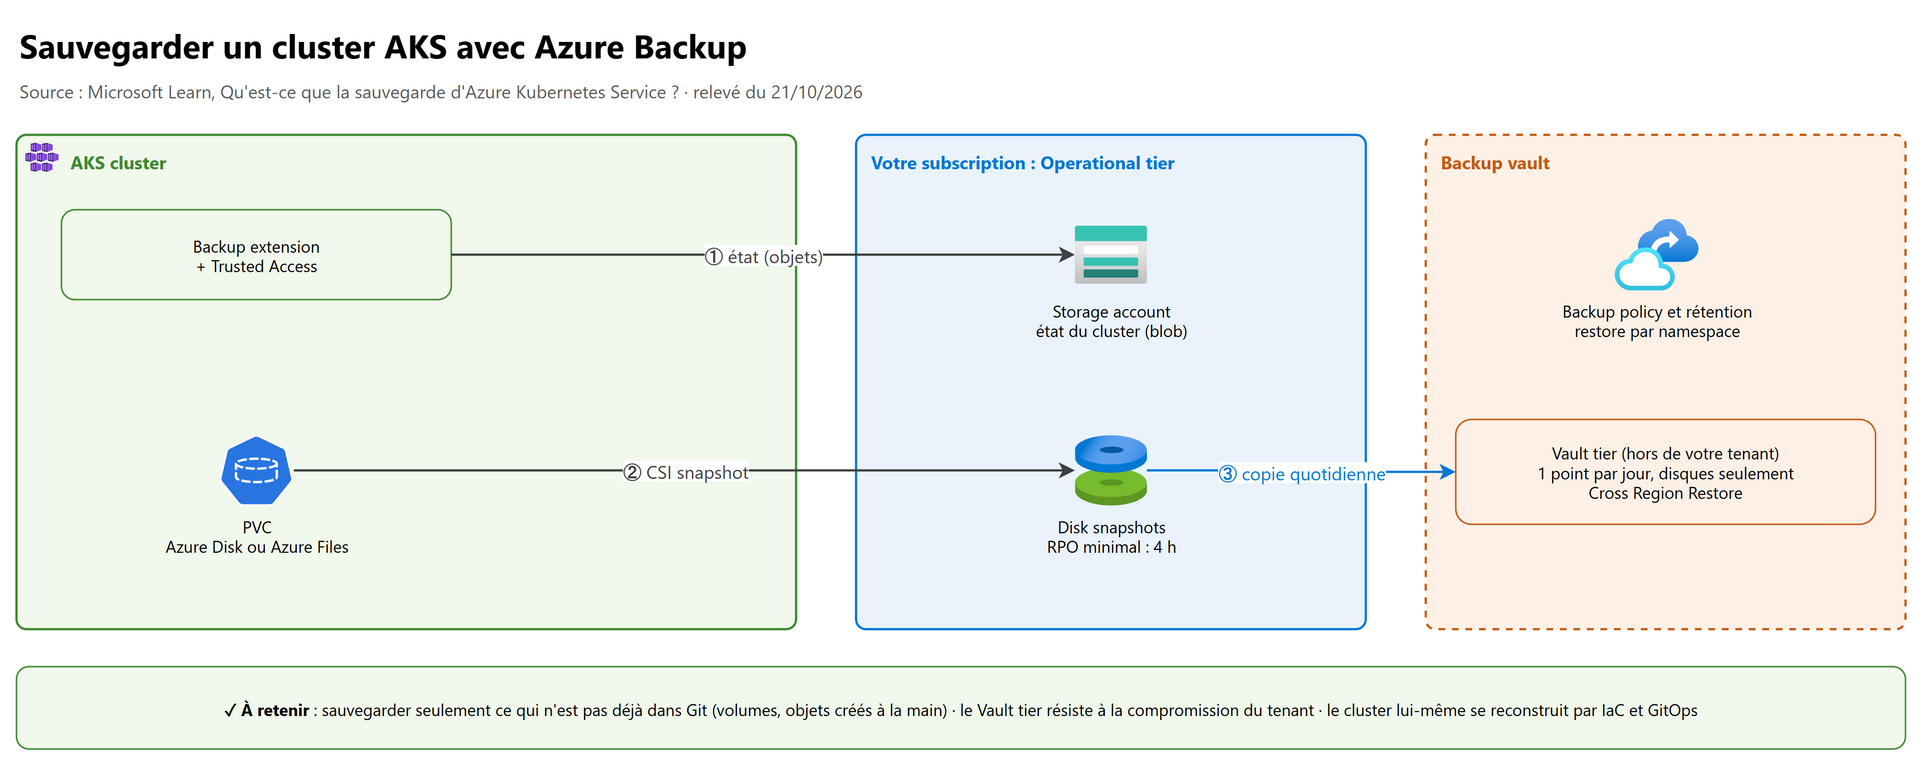
Azure Backup for AKS sauvegarde les objets du cluster et les volumes persistants :
| Élément | Détail |
|---|---|
| Backup extension | Installée dans le cluster (obligatoire) ; une extension identity reçoit le rôle Storage Account Contributor sur le Storage account |
| Trusted Access | Obligatoire entre le Backup vault et le cluster ; fonctionne avec les clusters privés, sans compte local, avec plages IP autorisées |
| Operational tier | CSI snapshots des disques + état du cluster en blob, dans votre tenant ; RPO minimal de 4 heures ; disques et Azure Files (SMB, rétention 30 jours max avec Files) |
| Vault tier (Vault-standard) | Un point par jour copié hors de votre tenant ; rétention longue, protection contre les rançongiciels ; disques uniquement |
| Restauration | Cluster d'origine ou autre cluster ; restauration complète ou par namespace ; conflit de nom : Skip (défaut) ou Patch |
| Cross Region Restore | Seulement depuis le Vault tier, avec un Backup vault géoredondant (RPO effectif jusqu'à 36 h) |
Discours d'architecte : le cluster se reconstruit par IaC et GitOps ; on sauvegarde ce qui n'est pas dans Git (volumes, objets créés à la main) et on sort les données critiques vers des services gérés. Velero, outil open source, reste une alternative courante à Azure Backup for AKS.
2. La mise à l'échelle#
2.1 Tout commence par les requests#
Le planificateur place un pod selon ses requests (ce qu'il réserve), pas selon sa consommation réelle. Les limits
plafonnent : au-delà de la limite mémoire, le conteneur est tué (OOMKilled) ; au-delà de la limite CPU, il est ralenti.
| Classe QoS (Kubernetes) | Condition | Comportement sous pression |
|---|---|---|
| Guaranteed | requests = limits pour CPU et mémoire de tous les conteneurs | Évincé en dernier |
| Burstable | Au moins une request, différente des limits | Entre les deux |
| BestEffort | Aucune request ni limit | Évincé en premier |
Sans requests, ni HPA (en pourcentage), ni Cluster Autoscaler, ni Node Autoprovisioning ne peuvent décider correctement : c'est la première
question à poser en revue d'architecture. Les quotas de namespace (ResourceQuota, LimitRange) imposent des valeurs.
2.2 Qui fait quoi#
| Méthode | Agit sur | Déclencheur | À utiliser quand |
|---|---|---|---|
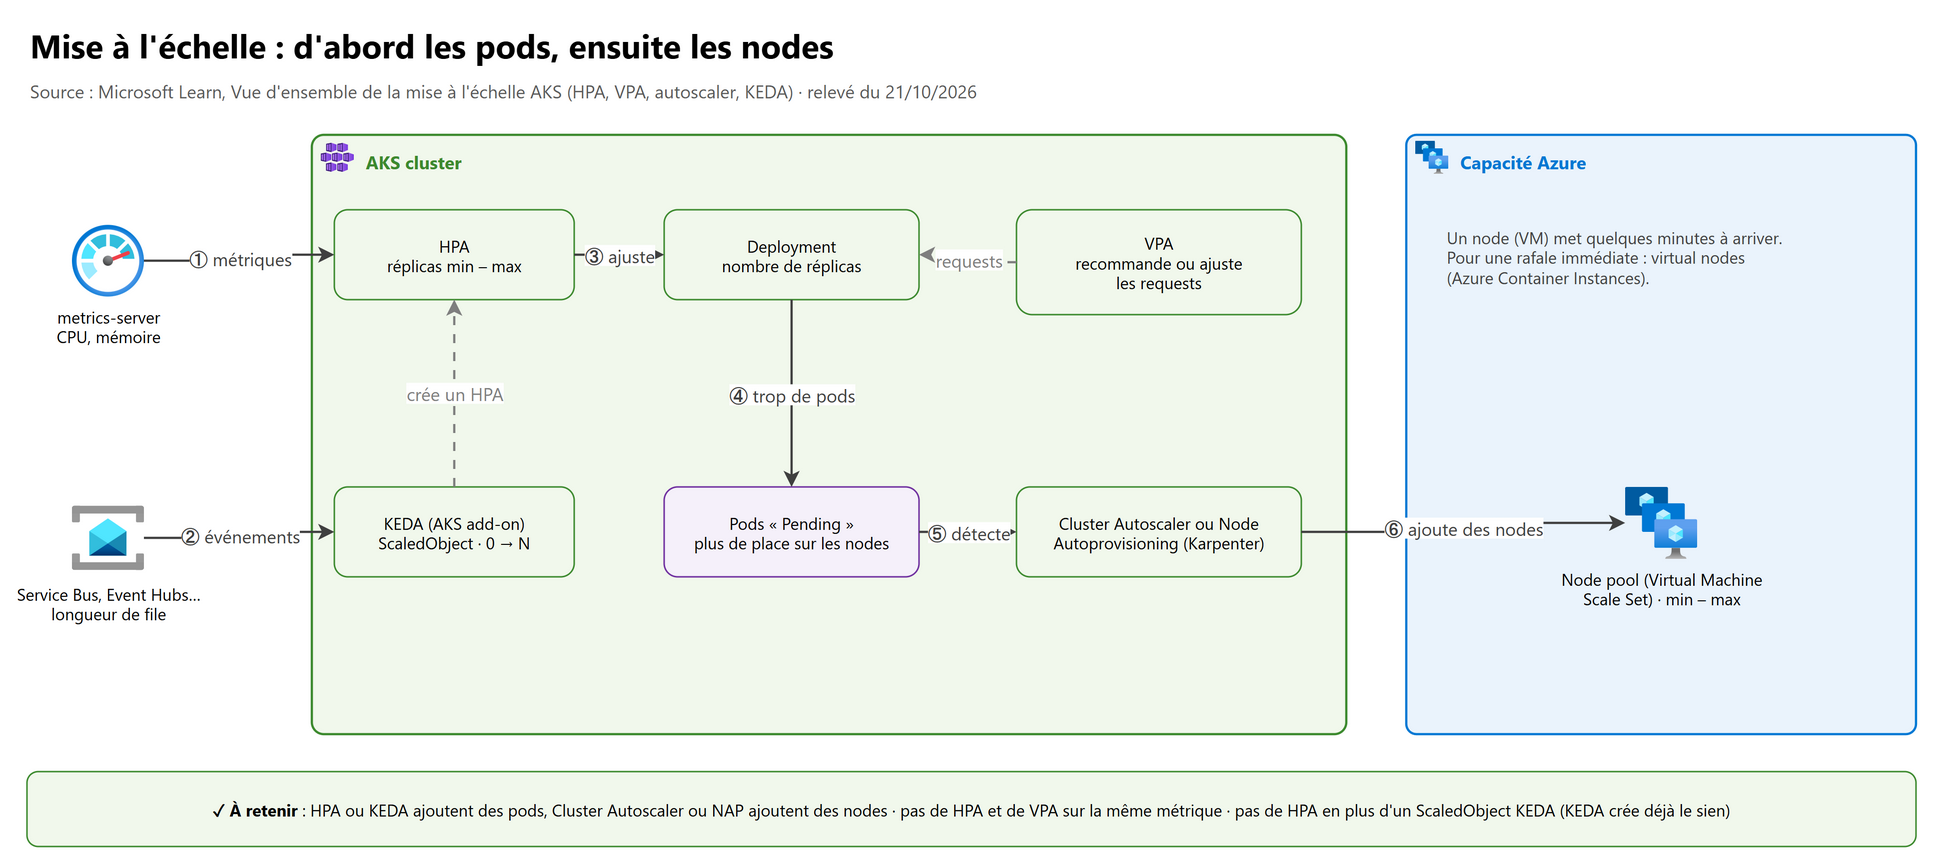
| HPA (Horizontal Pod Autoscaler) | Nombre de réplicas | CPU, mémoire, métriques applicatives ou externes | Charge variable, réplicas identiques |
| VPA (Vertical Pod Autoscaler) | Requests des pods | Consommation observée | Charge non parallélisable, ou pour dimensionner les requests |
| KEDA (AKS add-on) | Réplicas, de 0 à N | Événements : files, flux, messages | Traitement asynchrone, besoin de descendre à zéro |
| Cluster Autoscaler | Nombre de nodes d'un node pool existant | Pods Pending faute de place |
Node pools prédéfinis |
| Node Autoprovisioning (NAP, Karpenter) | Nodes et taille de VM | Exigences des pods en attente | Choix automatique des SKU, meilleur remplissage |
| Virtual nodes (Azure Container Instances) | Capacité en rafale | Pic immédiat | Linux, sans attendre 2 à 5 minutes de démarrage de VM |
Deux règles reviennent en entretien :
- Pas de HPA et de VPA sur la même métrique CPU ou mémoire : VPA en mode recommandation, ou HPA sur une autre métrique.
- Pas de HPA en plus d'un ScaledObject KEDA pour la même charge : KEDA crée et pilote déjà son propre HPA.
En AKS Automatic, Node Autoprovisioning, VPA et KEDA sont préconfigurés ; en AKS Standard, on les active un par un.
2.3 HPA et KEDA en pratique#
# HPA : entre 3 et 20 réplicas, cible 60 % du CPU demandé
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: api
spec:
  scaleTargetRef: { apiVersion: apps/v1, kind: Deployment, name: api }
  minReplicas: 3
  maxReplicas: 20
  metrics:
  - type: Resource
    resource: { name: cpu, target: { type: Utilization, averageUtilization: 60 } }
# KEDA : un consommateur Service Bus qui descend à zéro, authentifié par Workload Identity
apiVersion: keda.sh/v1alpha1
kind: TriggerAuthentication
metadata:
  name: azure-servicebus-auth
spec:
  podIdentity:
    provider: azure-workload
    identityId: <client-id-de-l-identite-managee>
---
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: commandes-worker
spec:
  scaleTargetRef: { name: commandes-worker }
  minReplicaCount: 0
  maxReplicaCount: 30
  triggers:
  - type: azure-servicebus
    metadata: { namespace: sb-prod, queueName: commandes, messageCount: "10" }
    authenticationRef: { name: azure-servicebus-auth }
Activer les add-ons : az aks update -g <rg> -n <cluster> --enable-keda (activer Workload Identity avant KEDA si on veut
l'utiliser) et --enable-vpa pour le VPA.
2.4 VPA : les modes#
| Mode | Effet |
|---|---|
Off |
Recommandations seulement : le bon point de départ en production |
Initial |
Requests posées à la création des pods, jamais ensuite |
Recreate |
Évince les pods (en respectant les PDB) pour appliquer les nouvelles valeurs |
InPlaceOrRecreate |
Redimensionne sans redémarrer quand c'est possible, sinon évince (AKS 1.34+) |
Auto est déprécié depuis VPA 1.4.0 (AKS 1.34+) : c'est un alias de Recreate.
2.5 Cluster Autoscaler et Node Autoprovisioning#
Le Cluster Autoscaler s'active par node pool (--enable-cluster-autoscaler --min-count 3 --max-count 10) et se règle pour tout
le cluster avec le cluster autoscaler profile (--cluster-autoscaler-profile clé=valeur) :
| Paramètre | Défaut | À quoi il sert |
|---|---|---|
scale-down-unneeded-time |
10 min | Délai avant de retirer un node inutile |
max-empty-bulk-delete |
10 | Nodes vides retirés d'un coup |
expander |
random |
Choix du node pool à agrandir : least-waste, priority, most-pods, random |
balance-similar-node-groups |
false |
Équilibrer des node pools similaires (recommandé avec des node pools alignés sur une zone) |
skip-nodes-with-local-storage, skip-nodes-with-system-pods |
— | Ne pas retirer certains nodes |
Node Autoprovisioning (NAP) s'appuie sur Karpenter : il lit les besoins des pods en attente et crée des nodes de la
bonne taille à partir d'une liste de SKU autorisés (objets NodePool et AKSNodeClass). Activation :
az aks create … --node-provisioning-mode Auto --network-plugin azure --network-plugin-mode overlay --network-dataplane cilium.
Limites : pas de node pools Windows, pas d'IPv6, pas de service principal (managed identity obligatoire), pas de stop du
cluster, outbound type non modifiable après création, Standard Load Balancer obligatoire en VNet personnalisé.
2.6 Spot node pools et surprovisionnement#
Les Spot node pools utilisent la capacité inutilisée d'Azure à prix réduit, sans SLA :
- jamais node pool par défaut ;
priorityeteviction-policy(Deletepar défaut, ouDeallocatequi consomme encore du quota) fixées à la création ; - étiquette et taint
kubernetes.azure.com/scalesetpriority=spot:NoSchedule: seuls les pods avec la tolérance y vont ; - préavis d'éviction de 30 secondes au plus ; avec le Cluster Autoscaler, le node pool remonte après éviction ;
- mise à niveau sans surge node ; réservé aux traitements par lots, aux tests, aux charges interruptibles.
Surprovisionnement (pratique Kubernetes courante) : des pods « tampons » de basse priorité réservent de la place ; un pod réel les évince immédiatement, et l'autoscaler recrée la marge en arrière-plan. On paie un peu de capacité inutilisée contre un démarrage sans attente.
3. La fiabilité#
3.1 Pricing tiers et Uptime SLA#
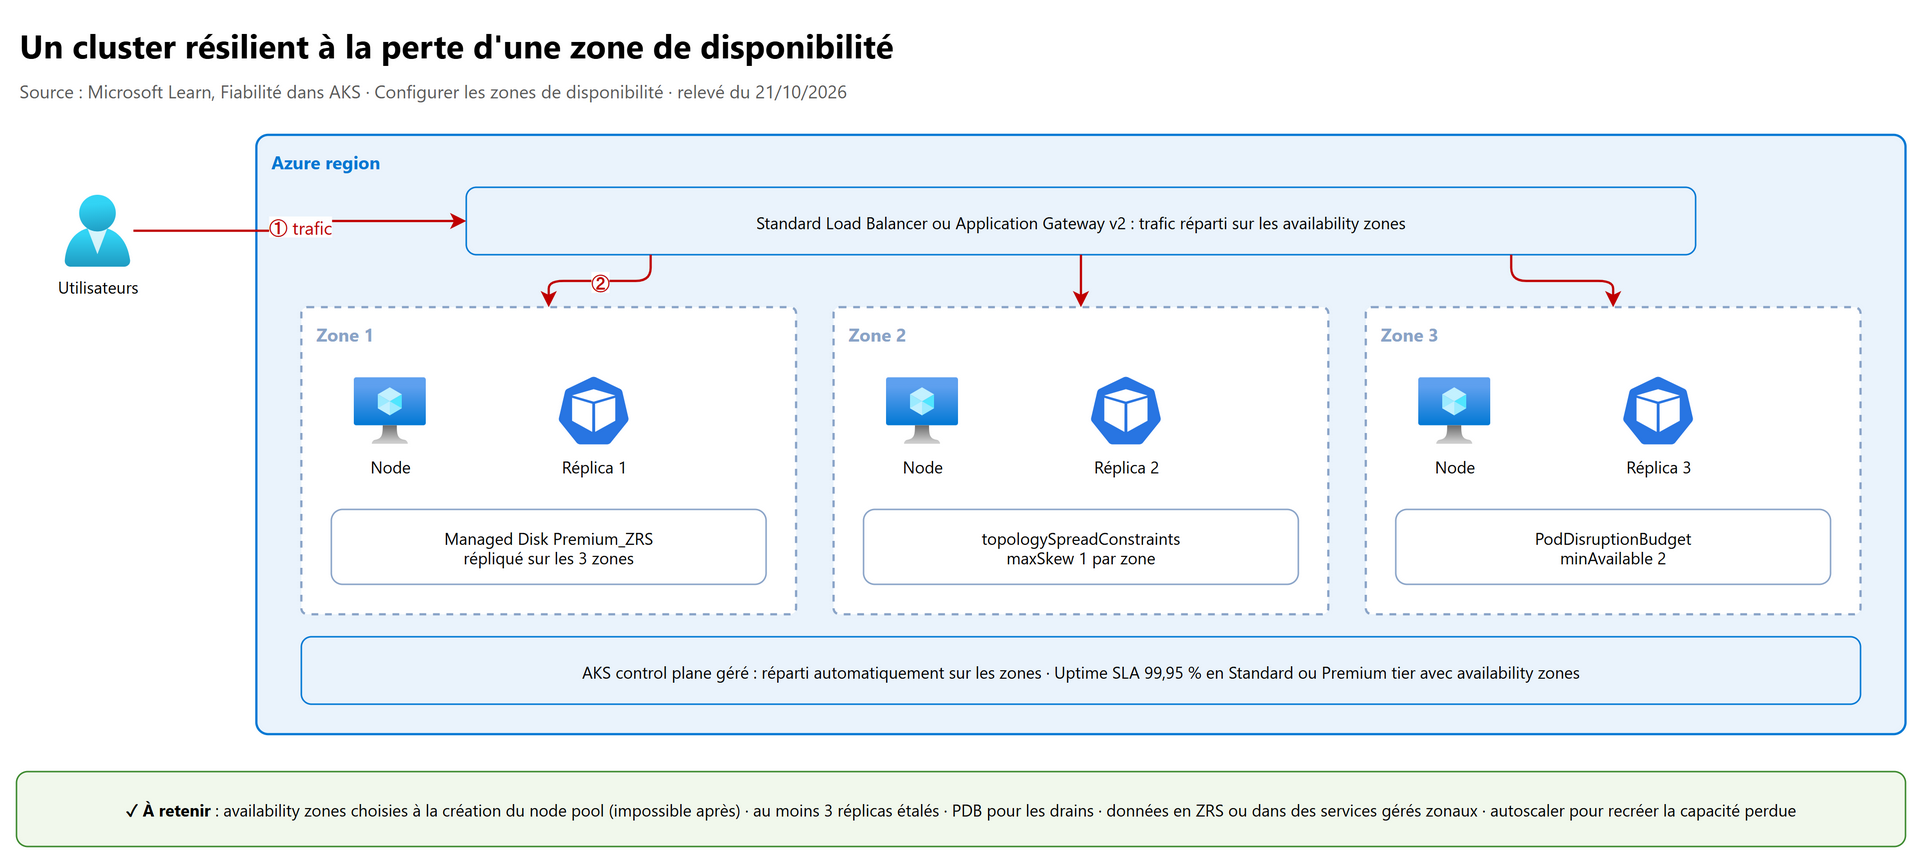
Rappel du chapitre 01, section 4.1 : Free (défaut en AKS Standard) sans SLA, Standard (défaut en AKS Automatic) avec un Uptime SLA de 99,95 % de l'API server avec zones (99,9 % sans), Premium = Standard + LTS. AKS Automatic ajoute un pod readiness SLA : 99,9 % des pods éligibles prêts en moins de 5 minutes. Le control plane est réparti automatiquement sur les zones dans une région qui en a, même si les node pools ne sont pas zonaux.
3.2 Résister à la perte d'une availability zone#
| Type de node pool | Comportement | Quand |
|---|---|---|
Zone-spanning (--zones 1 2 3) |
AKS équilibre les nodes entre les zones choisies | Cas général |
| Zone-aligned (un node pool par zone) | Chaque node épinglé à une zone ; balance-similar-node-groups=true conseillé |
Contrôle fin de la mise à l'échelle, latence entre nodes |
| Regional (aucune zone) | Aucun placement garanti : une panne de zone peut tout toucher | À éviter en production |
Les zones se choisissent à la création du node pool ou du cluster : impossible de les ajouter ou de les retirer ensuite (il faut un nouveau node pool ou un nouveau cluster). Pour que la zone serve à quelque chose :
- plusieurs réplicas (un seul réplica sur trois zones n'est pas résilient) ;
- étalement avec
topologySpreadConstraintssurtopology.kubernetes.io/zone; - autoscaling pour recréer dans les zones saines la capacité perdue (sinon les pods restent
Pending) ; - réseau et dépendances zonaux : Standard Load Balancer, Application Gateway v2, Azure Front Door, bases, Azure Managed Redis, stockage ZRS.
# Extrait de Deployment : au plus 1 réplica d'écart entre zones, et PDB associé
spec:
  replicas: 3
  template:
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        labelSelector: { matchLabels: { app: api } }
---
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: api
spec:
  minAvailable: 2        # pendant un drain, au moins 2 pods restent servis
  selector: { matchLabels: { app: api } }
3.3 PDB et sondes : les deux réglages qui sauvent ou cassent#
- Un PodDisruptionBudget limite les interruptions volontaires (drain de mise à niveau, réduction de nodes). Trop
strict (
minAvailableégal au nombre de réplicas), il bloque le drain et la mise à niveau échoue. Bonne pratique : laisser au moins un pod évinçable. - Les sondes :
startupProbepour les applications lentes à démarrer,readinessProbepour sortir un pod du trafic,livenessProbelimitée à la santé du processus. Une sonde de vivacité qui teste la base de données provoque des redémarrages en cascade dès que la base ralentit (cause fréquente deCrashLoopBackOff). - Node auto-repair : un node
NotReadyplus de 5 minutes est redémarré, puis réimagé, puis redéployé par AKS (événementsaks-auto-repair).
3.4 Les mises à niveau#
Versions : AKS prend en charge la dernière version mineure et les deux précédentes (N-2), chaque version environ un an
(community support). En Premium tier, le Long Term Support (LTS) ajoute une année (environ 24 mois au total) avec seulement les deux
derniers correctifs pris en charge : --tier premium --k8s-support-plan AKSLongTermSupport --auto-upgrade-channel patch.
Deux auto-upgrade channels, indépendants :
| Cluster auto-upgrade channel (version Kubernetes) | Effet |
|---|---|
none |
Défaut : aucune mise à niveau automatique |
patch |
Dernier correctif de la version mineure actuelle |
stable |
Dernier correctif de N-1 (défaut et seul choix en AKS Automatic) |
rapid |
Dernier correctif de la dernière version mineure |
node-image |
Legacy, à ne plus utiliser |
| Node OS upgrade channel | Effet |
|---|---|
None |
Rien n'est appliqué : vous êtes seul responsable |
Unmanaged |
Mises à jour par l'OS lui-même (Linux, vers 06 h UTC), redémarrages à gérer (kured) |
SecurityPatch |
Correctifs de sécurité testés par AKS, réimage seulement si nécessaire ; non pris en charge sur Windows |
NodeImage |
Défaut : nouvelle node image chaque semaine (sécurité + correctifs), réimage des nodes |
Planned Maintenance (maintenance windows) : trois configurations cumulables, default (composants du control plane et add-ons),
aksManagedAutoUpgradeSchedule (cluster auto-upgrade channel) et aksManagedNodeOSUpgradeSchedule (node OS upgrade channel) ; 4 heures minimum.
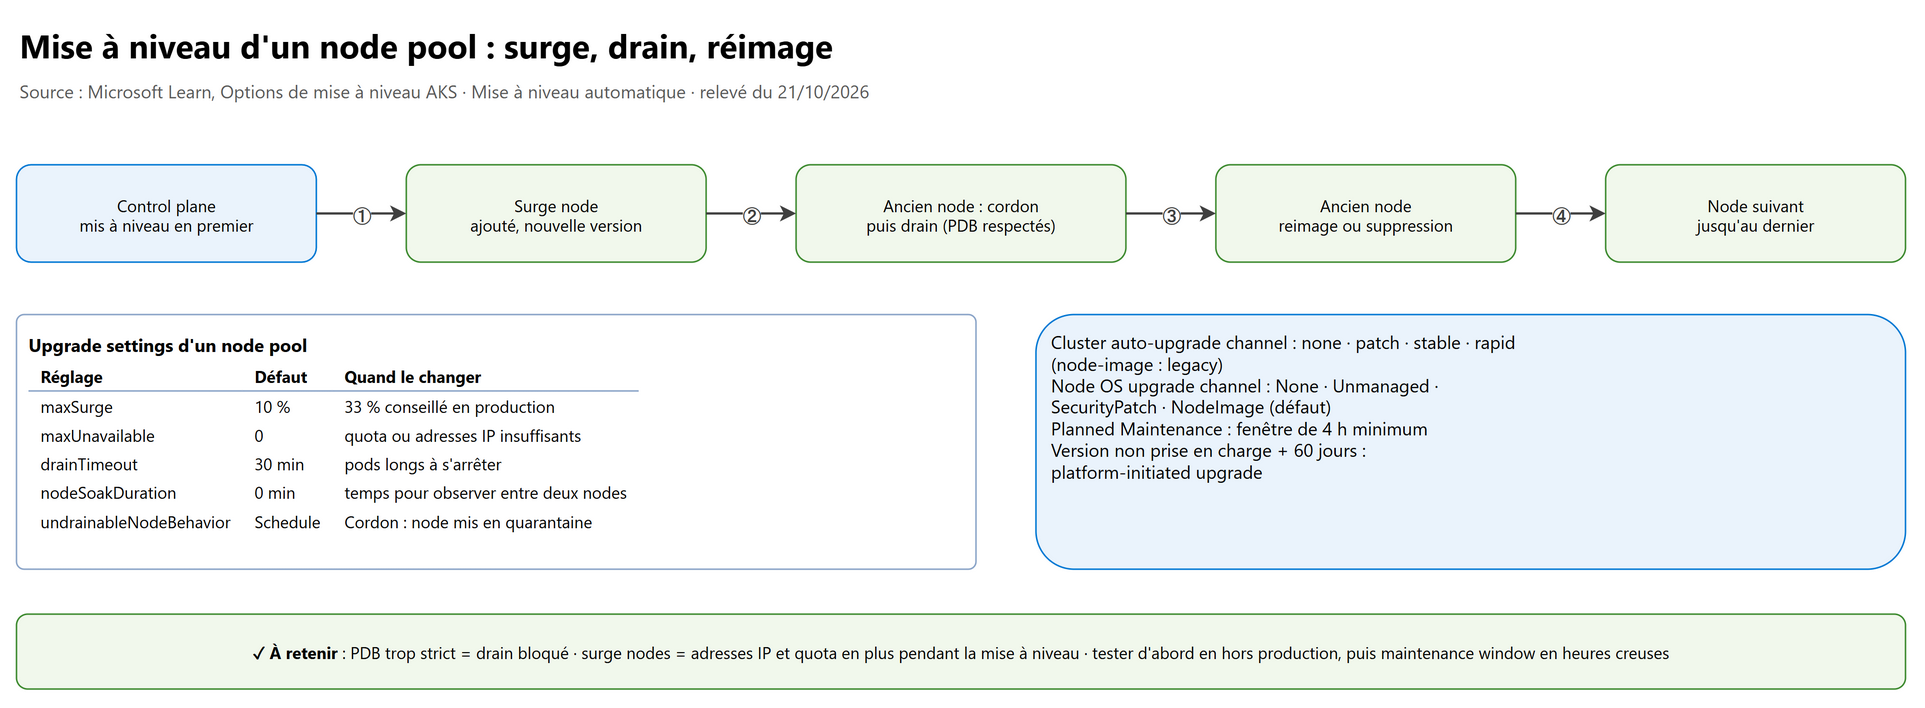
sequenceDiagram
    participant AKS as AKS
    participant CP as Control plane
    participant N as Node pool
    participant P as Pods (PDB)
    AKS->>CP: Mise à niveau de la version
    loop Par lots de maxSurge (10 % par défaut)
        AKS->>N: Ajoute un surge node (nouvelle version)
        AKS->>N: Cordon de l'ancien node
        AKS->>P: Drain (éviction en respectant les PDB, 30 min max)
        P-->>N: Pods replanifiés sur les nodes à jour
        AKS->>N: Réimage ou suppression de l'ancien node
    end
    Note over AKS,P: Node non drainable : Schedule (défaut) ou Cordon (quarantaine)
À connaître : à partir du 1er juin 2027, un cluster resté sur une version non prise en charge plus de 60 jours est mis à niveau par une platform-initiated upgrade, hors maintenance window, en pouvant passer outre un PDB. Rester sur
stableavec une maintenance window évite ce scénario.
Pour les changements risqués (version mineure, CNI, refonte), le blue-green deployment de clusters consiste à monter un nouveau cluster, à le remplir par GitOps, puis à basculer le trafic (Azure Front Door, Traffic Manager, DNS) et à garder l'ancien pour le retour arrière.
Exemple Terraform d'un cluster de production et d'un node pool applicatif (arguments vérifiés dans le registre, azurerm 5.x) :
resource "azurerm_kubernetes_cluster" "prd" {
  name                      = local.aks_name
  location                  = var.location
  resource_group_name       = var.resource_group_name
  dns_prefix                = local.aks_name
  sku_tier                  = "Standard"     # SLA 99,95 % avec zones
  automatic_upgrade_channel = "stable"       # N-1, évite la mise à niveau imposée
  node_os_upgrade_channel   = "NodeImage"

  default_node_pool {
    name                        = "system"
    vm_size                     = var.system_vm_size
    zones                       = ["1", "2", "3"]
    auto_scaling_enabled        = true
    min_count                   = 3
    max_count                   = 5
    temporary_name_for_rotation = "systemtmp"  # requis pour changer vm_size ou zones sans recréer le cluster
  }

  identity { type = "SystemAssigned" }

  auto_scaler_profile {
    balance_similar_node_groups = true
    expander                    = "least-waste"
  }

  maintenance_window_auto_upgrade {
    frequency   = "Weekly"
    interval    = 1
    duration    = 4
    day_of_week = "Sunday"
    start_time  = "02:00"
    utc_offset  = "+01:00"
  }
}

resource "azurerm_kubernetes_cluster_node_pool" "apps" {
  name                  = "apps"
  kubernetes_cluster_id = azurerm_kubernetes_cluster.prd.id
  vm_size               = var.apps_vm_size
  mode                  = "User"
  zones                 = ["1", "2", "3"]
  auto_scaling_enabled  = true
  min_count             = 3
  max_count             = 30

  upgrade_settings {
    max_surge                     = "33%"
    drain_timeout_in_minutes      = 30
    node_soak_duration_in_minutes = 5
    undrainable_node_behavior     = "Cordon"
  }
}
3.5 Résister à la perte d'une région#
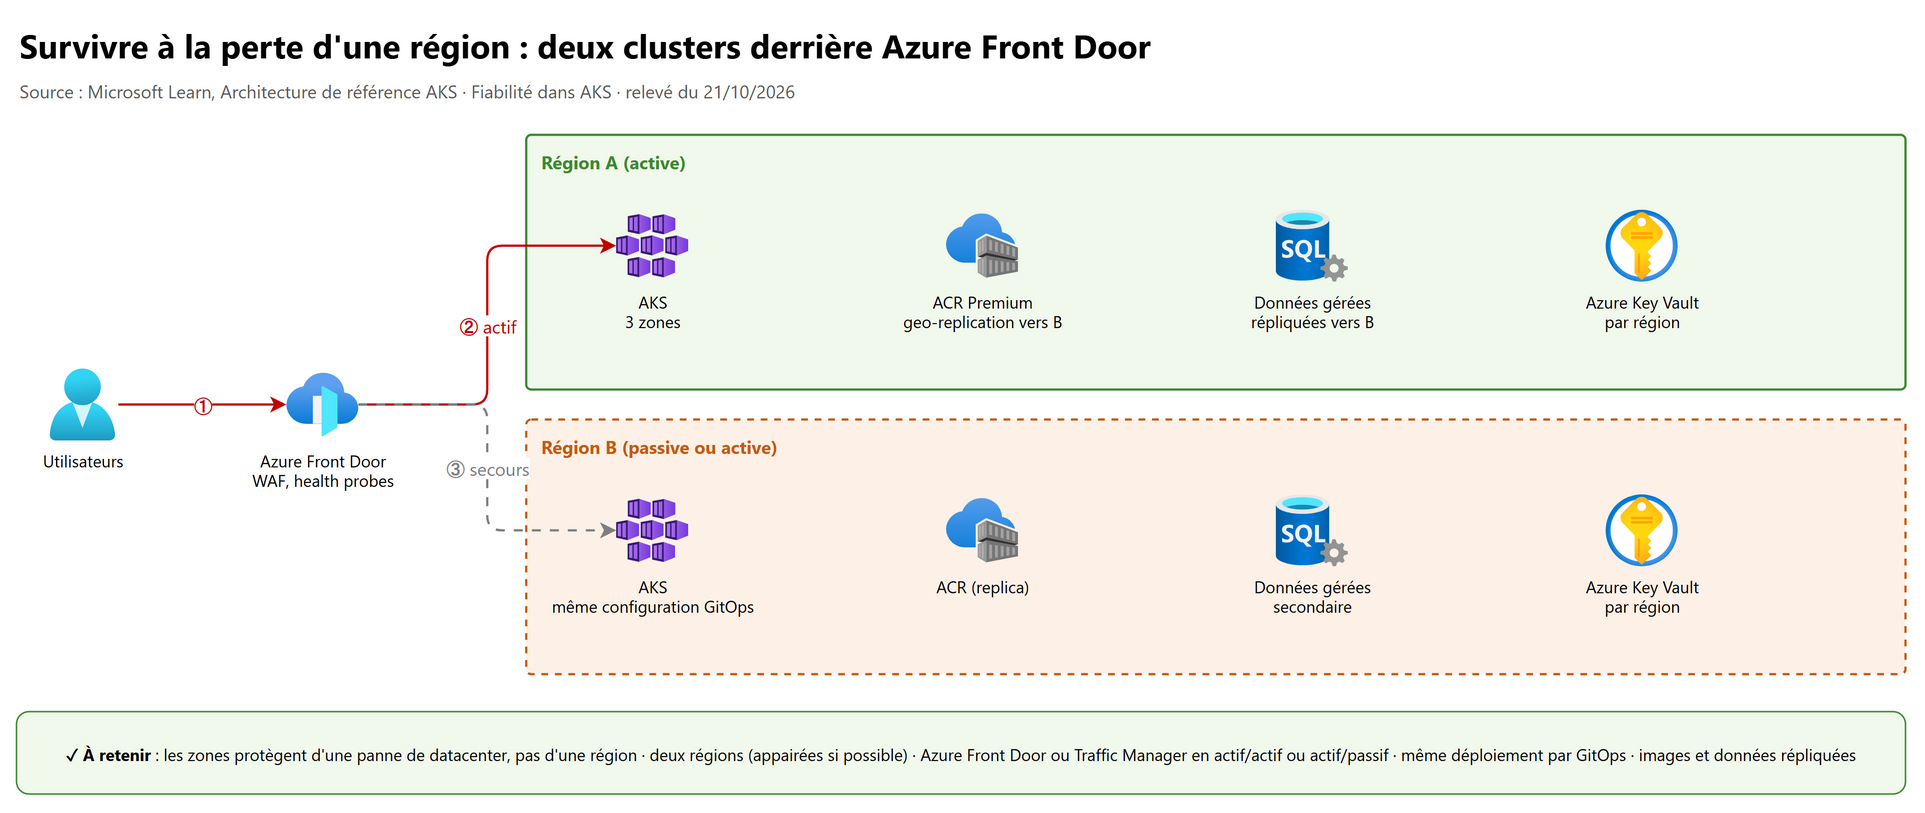
Les zones protègent d'une panne de datacenter, pas d'une région entière. Il faut alors plusieurs clusters dans plusieurs régions (appairées de préférence : Azure ne met à jour qu'une région de la paire à la fois), un équilibreur global (Azure Front Door ou Traffic Manager, en actif/actif ou actif/passif), le même déploiement sur chaque cluster (GitOps, chapitre 05), des images répliquées (Azure Container Registry Premium, geo-replication) et des données répliquées (le point dur : c'est le service de données qui fixe le RPO).
4. Erreurs fréquentes#
| Symptôme | Cause probable | Correction |
|---|---|---|
Pod Pending après bascule de zone, événement d'attachement de volume |
Managed Disk LRS lié à l'ancienne zone | ZRS, ou réplication applicative avec un volume par zone |
| PVC supprimée, données perdues | StorageClass en reclaimPolicy: Delete |
StorageClass Retain pour les données à garder, et sauvegarde |
HPA bloqué à <unknown> |
Pas de requests CPU sur les conteneurs |
Définir les requests |
| HPA et VPA se contredisent, pods qui oscillent | Même métrique CPU ou mémoire | VPA en Off, ou HPA sur une métrique personnalisée |
| Mise à niveau bloquée sur un node | PDB qui n'autorise aucune éviction | maxUnavailable: 1 dans le PDB, plus de réplicas, undrainable-node-behavior Cordon |
| Mise à niveau en échec faute d'IP ou de quota | Les surge nodes consomment adresses et vCPU | Prévoir la marge, ou maxUnavailable |
| Les pods ne s'étalent pas sur les zones | Node pool regional ou un seul réplica | Node pools zonaux, topologySpreadConstraints, 3 réplicas au moins |
| Tout le Spot node pool disparaît d'un coup | Éviction de capacité, aucune garantie | Node pool normal de repli (expander priority), charges interruptibles seulement |
5. Lab : HPA et Cluster Autoscaler#
À faire dans un abonnement de test (coût de quelques VM pendant une heure).
# 1. Cluster avec cluster autoscaler sur le node pool par défaut
az group create -n rg-lab-aks -l francecentral
az aks create -g rg-lab-aks -n aks-lab --node-count 1 \
  --enable-cluster-autoscaler --min-count 1 --max-count 4 --generate-ssh-keys
az aks get-credentials -g rg-lab-aks -n aks-lab

# 2. Application avec des requests (obligatoires pour le HPA en pourcentage)
kubectl create deployment web --image=mcr.microsoft.com/oss/nginx/nginx:1.15.5-alpine
kubectl set resources deployment web --requests=cpu=250m,memory=64Mi --limits=cpu=500m,memory=128Mi
kubectl expose deployment web --port=80

# 3. HPA : 50 % du CPU demandé, 1 à 20 réplicas
kubectl autoscale deployment web --cpu-percent=50 --min=1 --max=20

# 4. Charge, puis observation (deux terminaux)
kubectl run charge --image=busybox --restart=Never -- /bin/sh -c "while true; do wget -q -O- http://web; done"
kubectl get hpa web -w            # les réplicas montent
kubectl get pods -o wide -w       # des pods passent Pending…
kubectl get nodes -w              # … puis le cluster autoscaler ajoute des nodes

# 5. Arrêt de la charge : réplicas puis nodes redescendent (scale-down-unneeded-time : 10 min)
kubectl delete pod charge
az group delete -n rg-lab-aks --yes --no-wait
À observer et à savoir raconter : l'ordre (HPA d'abord, nodes ensuite), le délai d'arrivée d'un node, la redescente plus lente que la montée.
6. Questions d'entretien#
1. Un pod de base de données redémarre dans une autre zone et reste Pending. Pourquoi ?
Son Managed Disk est LRS, donc lié à une zone : impossible de l'attacher ailleurs. Solutions : StorageClass ZRS (
Premium_ZRS), ou base répliquée par l'application avec un volume par zone, ou mieux, un service de données géré hors du cluster.
2. Azure Disks ou Azure Files pour un CMS qui tourne sur 3 réplicas ?
Azure Files (ou Azure NetApp Files) : les 3 réplicas sur des nodes différents doivent monter le même volume, il faut du ReadWriteMany. Un Managed Disk est ReadWriteOnce, un seul node à la fois.
3. Expliquez la différence entre HPA, VPA, KEDA, Cluster Autoscaler et Node Autoprovisioning.
HPA change le nombre de pods selon des métriques ; KEDA fait pareil sur des événements et peut descendre à zéro (il crée un HPA) ; VPA ajuste les requests ; Cluster Autoscaler ajoute des nodes dans un node pool quand des pods sont en attente ; Node Autoprovisioning choisit en plus la taille de VM (Karpenter). Pas de HPA et VPA sur la même métrique.
4. Pourquoi des requests sont-elles indispensables ?
Le scheduler, le HPA en pourcentage, le Cluster Autoscaler et Node Autoprovisioning raisonnent sur les requests. Sans elles, pas de placement fiable, HPA à
<unknown>, pods en BestEffort évincés en premier.
5. Comment rendre un cluster résistant à la perte d'une zone ?
Node pools sur 3 availability zones dès la création, au moins 3 réplicas étalés (
topologySpreadConstraints), PDB, autoscaling pour recréer la capacité, stockage ZRS ou services gérés zonaux, entrée réseau zonale, Standard tier pour l'Uptime SLA de 99,95 %.
6. Comment mettez-vous à niveau un cluster de production sans coupure ?
Tester en hors production ; auto-upgrade channel
stableet node OS upgrade channelNodeImageavec maintenance windows de 4 h en heures creuses ;maxSurgeà 33 %, PDB qui laissent au moins une éviction, drain timeout adapté, node soak time ; pour les gros changements, blue-green deployment de clusters.
7. Un PDB peut-il bloquer une mise à niveau ? Que faire ?
Oui, s'il n'autorise aucune éviction : le drain attend jusqu'au délai (30 min par défaut) puis échoue. Corriger le PDB ou les réplicas ;
undrainable-node-behavior Cordonmet le node en quarantaine sans bloquer le reste ; le force upgrade existe mais casse les protections.
8. Free, Standard ou Premium tier ?
Free pour le test (pas de SLA) ; Standard pour la production (Uptime SLA 99,95 % avec zones, 5 000 nodes) ; Premium si l'on a besoin du Long Term Support (LTS, environ 24 mois par version).
9. Quand utiliser des Spot node pools ?
Charges interruptibles (lots, CI, tests, entraînement avec points de contrôle), jamais en system node pool, avec taint et toleration, un node pool normal de repli et le Cluster Autoscaler.
10. Comment sauvegardez-vous AKS ?
Le cluster lui-même par IaC et GitOps ; les volumes et objets hors Git par Azure Backup for AKS (Backup extension + Trusted Access, Operational tier puis Vault tier pour l'isolement et le Cross Region Restore) ; les données critiques dans des services gérés avec leur propre sauvegarde.
7. Fiche à retenir#
- PVC (demande) → StorageClass (type) → CSI driver → PV (ressource, 1 pour 1). Ressources dans le node resource group
MC_…. - Managed Disk = RWO, un node ; Azure Files et Blob Storage = RWX. StorageClass intégrées en
Delete;Retainpour garder. - Cluster multizone (1.29+) : StorageClass intégrées en ZRS ; un disque LRS ne change pas de zone ;
WaitForFirstConsumer. - NVMe local (Azure Container Storage) = ultra-rapide mais perdu si la VM est libérée.
- Azure Backup for AKS : Backup extension + Trusted Access ; Operational tier (RPO 4 h min.) puis Vault tier (1/jour, disques).
- Requests obligatoires ; QoS Guaranteed, Burstable, BestEffort.
- Pods : HPA, KEDA (0 → N), VPA (requests). Nodes : Cluster Autoscaler, Node Autoprovisioning (Karpenter). Rafale : virtual nodes.
- Jamais HPA + VPA sur la même métrique ; jamais HPA + ScaledObject KEDA.
- Spot node pool : pas de SLA, préavis 30 s, taint
scalesetpriority=spot, jamais node pool par défaut. - Free tier (pas de SLA) · Standard (Uptime SLA 99,95 % avec zones) · Premium (+ LTS 24 mois).
- Availability zones choisies à la création ; 3 réplicas étalés + PDB + autoscaling.
- Auto-upgrade channel
none/patch/stable/rapid; node OS upgrade channelNone/Unmanaged/SecurityPatch/NodeImage. - maxSurge 10 % par défaut (33 % conseillé), drain timeout 30 min, maintenance windows de 4 h minimum.
- Version non prise en charge + 60 jours → platform-initiated upgrade (à partir du 01/06/2027).
- Multi-région : 2 clusters, Azure Front Door ou Traffic Manager, GitOps, images et données répliquées.
Références#
Lues le 21/10/2026 :
- Options de stockage pour les applications dans AKS
- Pilotes CSI sur AKS
- Qu'est-ce qu'Azure Container Storage ?
- Bonnes pratiques pour les disques de données NVMe éphémères dans AKS
- Qu'est-ce que la sauvegarde d'Azure Kubernetes Service ?
- Restaurer AKS avec Azure Backup
- Vue d'ensemble de la mise à l'échelle AKS : HPA, VPA, autoscaler et KEDA
- Module KEDA pour AKS et KEDA avec Workload Identity
- Mise à l'échelle verticale des pods dans AKS
- Approvisionnement automatique des nœuds (NAP) et migration depuis le Cluster Autoscaler
- Ajouter un pool Spot
- Niveaux tarifaires de la gestion de cluster AKS
- Fiabilité dans AKS et Configurer les zones de disponibilité
- Bonnes pratiques de fiabilité des déploiements et des clusters
- Mise à niveau automatique d'un cluster AKS et des images d'OS des nœuds
- Maintenance planifiée et options de mise à niveau
- Support long terme (LTS) et mises à niveau initiées par la plateforme
- Architecture de référence d'un cluster AKS
- Déploiement bleu/vert de clusters AKS
- Terraform : azurerm_kubernetes_cluster et azurerm_kubernetes_cluster_node_pool
- Kubernetes : classes de QoS des pods et contraintes d'étalement