

Version : 1.1 · Date : 2026-10-21 · Domaine 1 de l'examen : Plan and manage an Azure AI solution (25 à 30 %)
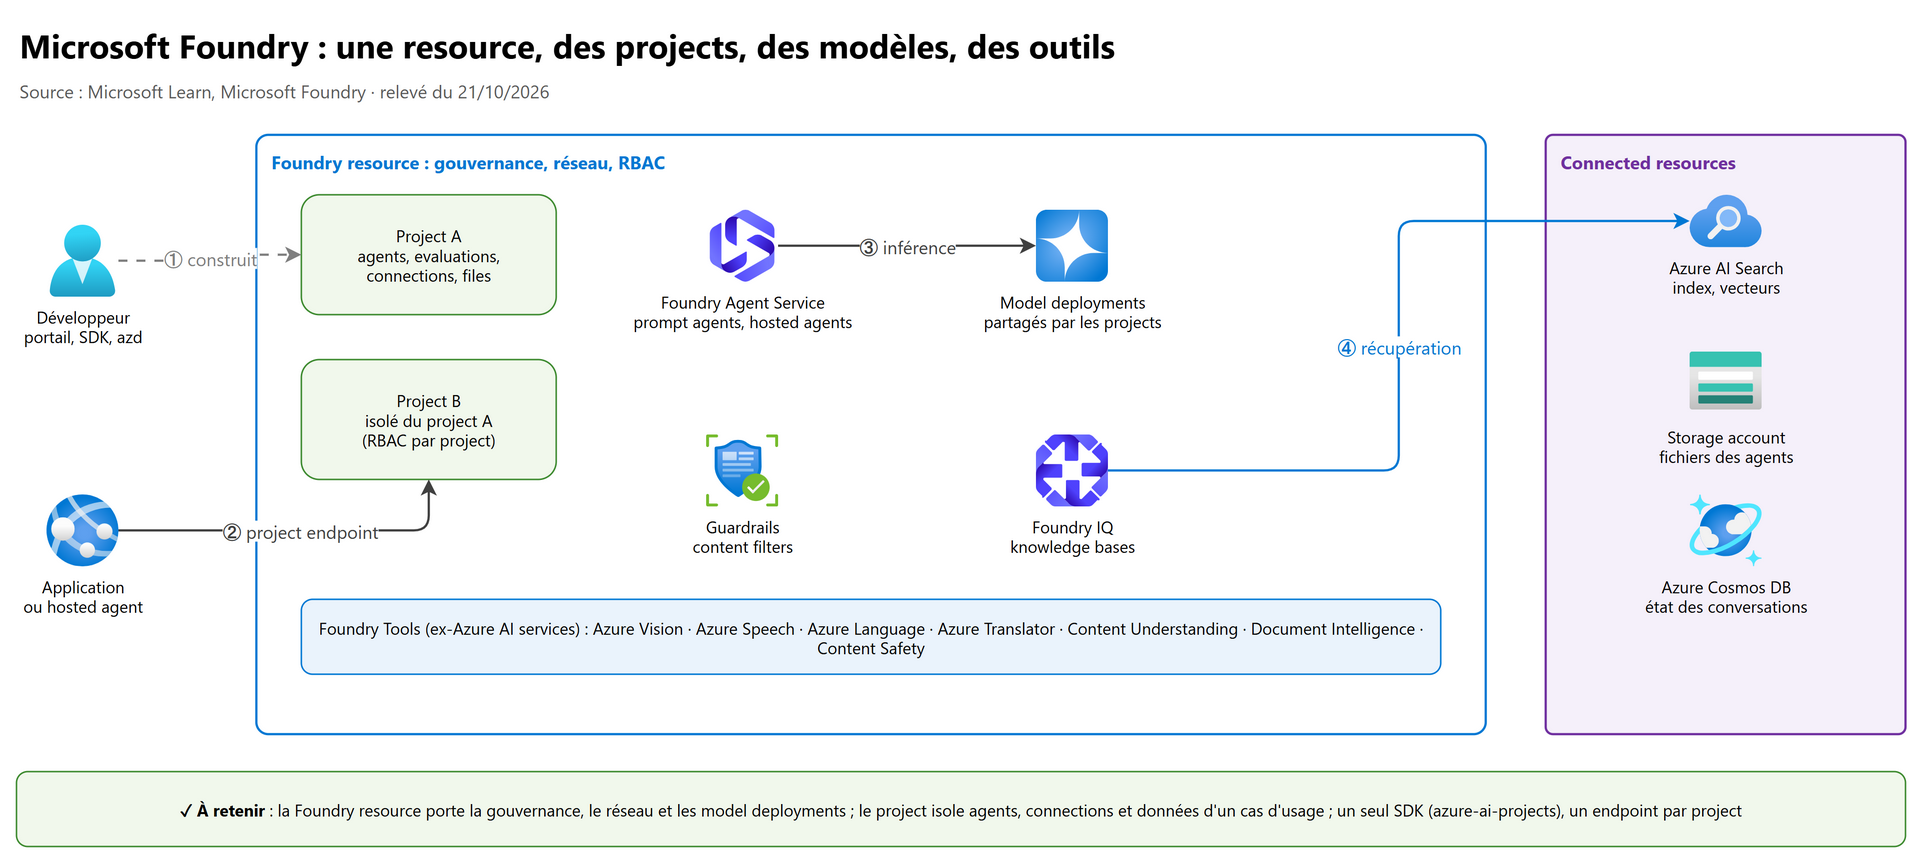
En une phrase : Microsoft Foundry réunit sous une seule Foundry resource les modèles (Foundry Models), les agents (Foundry Agent Service), les connaissances (Foundry IQ) et les outils spécialisés (Foundry Tools) ; tout l'art de ce chapitre est de choisir le bon modèle, le bon service, la bonne méthode de récupération et les bons outils pour chaque besoin.
Ce que l'examen demande#
Bloc Choose the appropriate Foundry services for generative AI and agents, repris mot pour mot du guide d'étude AI-103 (compétences mesurées au 16 avril 2026) :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| 1 | Choose an appropriate model for each task, including large language models (LLMs), small language models, multimodal models, and Foundry Tools | 2 |
| 2 | Choose the appropriate Foundry services for generative tasks, grounding, vector search, agent workflows, or multimodal processing | 3 |
| 3 | Choose an appropriate method for retrieval and indexing | 4 |
| 4 | Choose appropriate memory, tool, and knowledge integration services for agent solutions | 5 |
La section 1 pose le vocabulaire utile à tout le cours. Le déploiement (types de déploiement, quotas) est au chapitre 02, la sécurité au chapitre 03, le RAG en code au chapitre 05 et la construction d'agents au chapitre 06.
1. Les bases de l'IA générative et de Microsoft Foundry#
1.1 Le vocabulaire minimal#
| Terme | Ce qu'il faut savoir |
|---|---|
| Jeton (token) | Unité de texte traitée et facturée par un modèle ; environ 4 caractères en anglais pour les modèles OpenAI courants |
| Context window (fenêtre de contexte) | Nombre total de jetons qu'un modèle traite par requête : entrée, sortie et jetons de raisonnement partagent ce budget (ex. GPT-5 : 400 000, dont 272 000 en entrée et 128 000 en sortie) |
| Embedding (plongement vectoriel) | Vecteur numérique qui représente le sens d'un texte ou d'une image ; deux contenus proches ont des vecteurs proches |
| Grounding (ancrage) | Fournir au modèle des données de référence (documents, résultats de recherche) pour qu'il réponde à partir d'elles et non de sa mémoire d'entraînement |
| RAG (retrieval-augmented generation) | Modèle d'architecture : rechercher les passages utiles, les injecter dans l'invite, puis générer la réponse avec citations |
| Fabrication (hallucination) | Réponse plausible mais non fondée sur les données ; le grounding et les évaluations la réduisent (chapitre 04) |
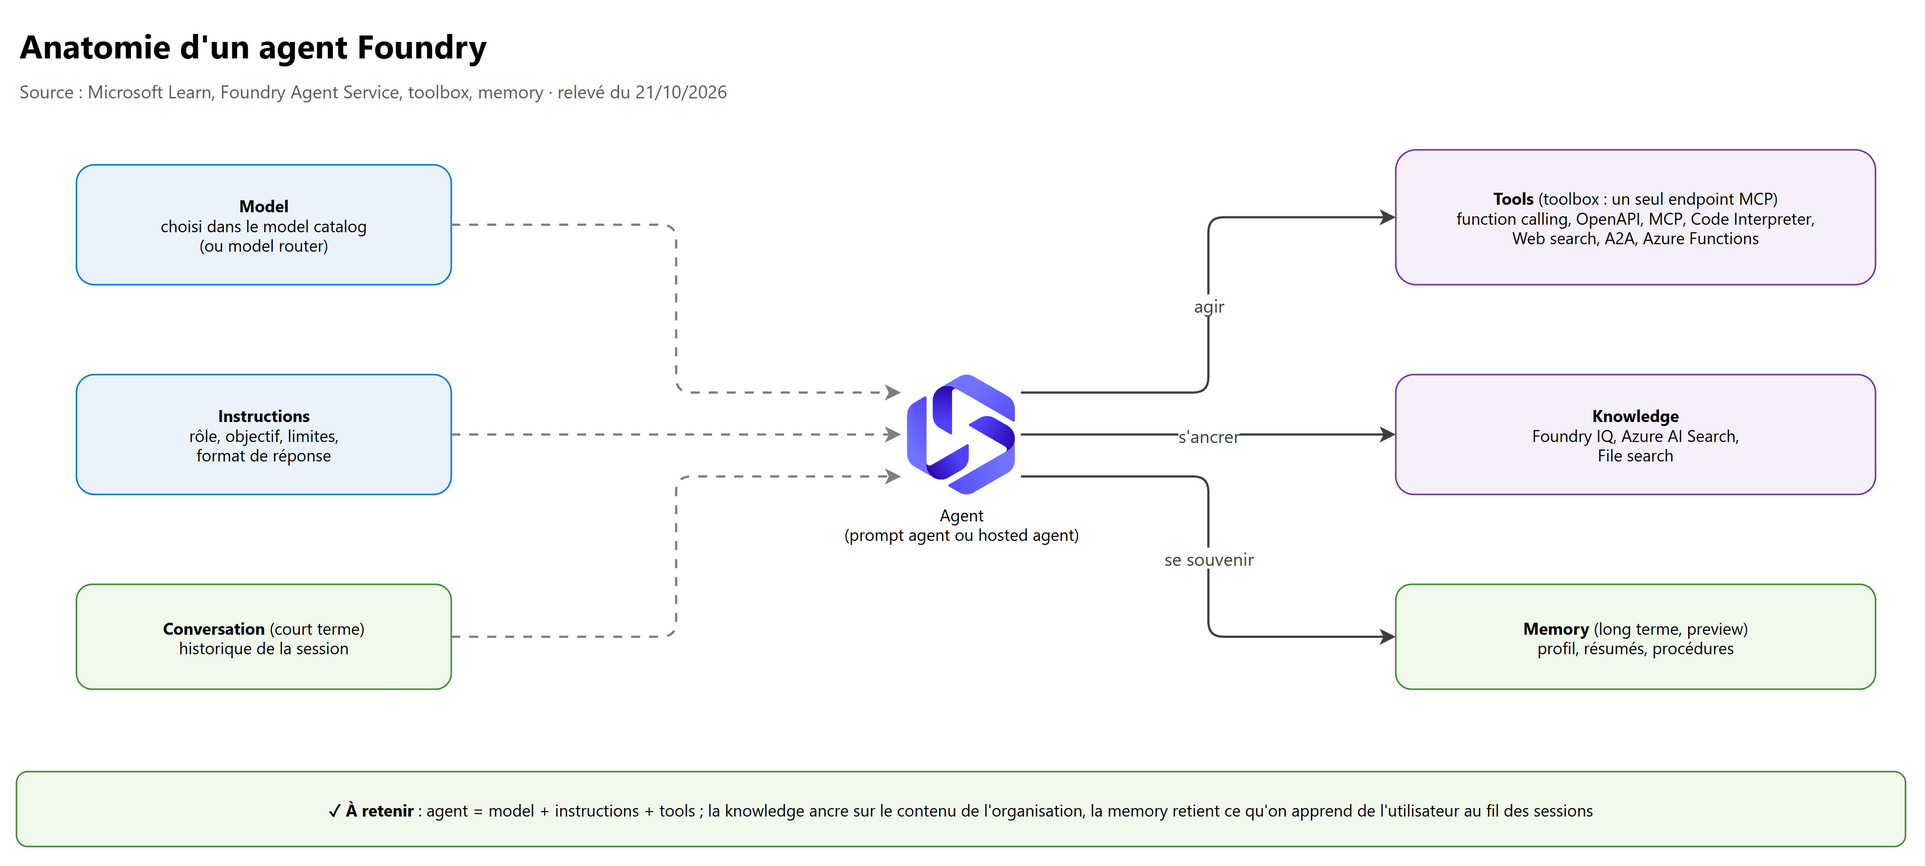
| Agent | Un modèle + des instructions + des outils, capable de raisonner sur une demande et d'agir |
| Date de coupure | Les connaissances du modèle s'arrêtent à sa date d'entraînement : pour l'actualité ou vos données, il faut une récupération |
1.2 Prompt engineering, RAG ou fine-tuning ?#
Trois techniques complémentaires pour adapter un modèle, à essayer dans cet ordre :
| Technique | Ce qu'elle change | Quand | Limite |
|---|---|---|---|
| Prompt engineering | L'invite (instructions, exemples, format) | Toujours en premier ; rapide et gratuit | Invites longues = jetons et latence |
| RAG | Le contexte fourni à chaque requête | Le modèle manque de connaissances (vos documents, données récentes) | Qualité dépendante de la récupération |
| Fine-tuning (ajustement fin) | Les poids du modèle (entraînement sur vos exemples) | Style, ton, format ou schéma constants ; meilleur usage des outils ; spécialiser un petit modèle (distillation) | Coûts d'entraînement et d'hébergement ; ne remplace pas la récupération pour l'information à jour ni les contrôles de sécurité |
Techniques de fine-tuning proposées dans Foundry : SFT (supervised fine-tuning, paires entrée/sortie : le point de départ), DPO (direct preference optimization, réponses préférées contre rejetées) et RFT (reinforcement fine-tuning, domaines à réponse objective comme les mathématiques). Microsoft conseille de commencer avec 50 à 100 exemples de qualité, puis 500 et plus pour la production.
flowchart TD
    A["Le modèle répond mal"] --> B{"Il manque des connaissances ?<br/>documents internes, données récentes"}
    B -- Oui --> R["RAG : récupération + grounding"]
    B -- Non --> C{"Problème de format, de ton,<br/>de consignes non suivies ?"}
    C -- Oui --> P["Prompt engineering d'abord<br/>instructions, exemples, structured outputs"]
    P --> D{"Toujours insuffisant, ou invite<br/>trop longue et coûteuse ?"}
    D -- Oui --> F["Fine-tuning (SFT, puis DPO ou RFT)"]
    C -- Non --> E["Changer de modèle<br/>reasoning model, modèle plus grand"]
1.3 Microsoft Foundry : ce qui a changé de nom#
Foundry consolide plusieurs services Azure. Les questions et la documentation récentes utilisent les nouveaux noms :
| Avant | Maintenant |
|---|---|
| Azure AI Studio, Azure AI Foundry | Microsoft Foundry |
| Azure AI services (Cognitive Services) | Foundry Tools (Azure Vision, Azure Speech, Azure Language, Azure Translator, Content Understanding, Document Intelligence, Content Safety…) |
| Hub + ressource Azure OpenAI + ressource Azure AI Services | Foundry resource unique, avec des projects |
| Assistants API (Agents v0.5/v1) | Responses API (Agents v2) |
Paramètre api-version mensuel |
Routes stables /openai/v1/ |
Plusieurs SDK (azure-ai-inference, AzureOpenAI()…) |
Client unifié azure-ai-projects 2.x + OpenAI() sur l'endpoint du project |
| Threads, messages, runs, assistants | Conversations, items, responses, versions d'agent |
Les projects basés sur un hub restent accessibles dans le portail Foundry (classic), qui sert encore à certains cas comme le déploiement de modèles ouverts sur managed compute (Hugging Face). Les nouveaux investissements portent sur les projects Foundry. Les agents « classic » sont dépréciés et seront retirés le 31 mars 2027.
1.4 La Foundry resource et ses projects#
| Niveau | Rôle | Ce qu'il porte |
|---|---|---|
Foundry resource (type Microsoft.CognitiveServices/accounts) |
Frontière de gouvernance, de réseau et d'identité | Model deployments, réseau privé, chiffrement, RBAC, Azure Policy, quotas |
| Project | Espace de travail isolé pour un cas d'usage | Agents, évaluations, datasets, index, fichiers, connections ; RBAC par project |
| Connected resources | Services que vous apportez | Azure AI Search, Storage account, Azure Cosmos DB (état des conversations), Key Vault, Application Insights |
Points d'examen :
- les model deployments appartiennent à la resource, pas au project : les projects de la même resource les réutilisent ;
- tous les agents d'invite d'un même project partagent la managed identity du project ; un hosted agent reçoit sa propre identité Microsoft Entra Agent ID ;
- certains Foundry Tools (Speech, Translator…) exigent encore des droits au niveau de la resource ; le fine-tuning n'est isolable que par resource ;
- en production, Microsoft recommande une resource dédiée par charge de travail (topologie « fully isolated »).
Le détail de l'infrastructure, des options de déploiement et du CI/CD est au chapitre 02.
1.5 Le model catalog#
Le model catalog (catalogue de modèles) de Foundry compte plus de 10 000 modèles, avec environ 50 nouveautés par mois : modèles de fondation, de raisonnement, petits modèles, multimodaux, spécialisés par domaine ou par industrie. Deux catégories :
| Foundry Models sold by Azure | Foundry Models from partners and community | |
|---|---|---|
| Qui héberge et vend | Microsoft, sous les Microsoft Product Terms | Hébergés par Microsoft ou en managed compute ; conditions du fournisseur |
| Support | Microsoft, SLA entreprise | Le fournisseur (Anthropic, Hugging Face…) |
| Revue IA responsable | Revue interne Microsoft, résultats dans la documentation du modèle | Validés par les fournisseurs |
| Exemples | Azure OpenAI (GPT-5.x, o-series, embeddings, gpt-image, sora), certains Llama, DeepSeek, Phi… | Claude (Anthropic), modèles ouverts Hugging Face |
| Facturation | Compteurs Azure | Azure Marketplace |
| Atout | Intégration profonde, provisioned throughput fongible | Spécialisation, accès rapide aux innovations |
Toujours votre responsabilité, quel que soit le modèle : respecter la loi, lire la model card, choisir un modèle adapté à l'usage et mettre en place les protections (dont Azure AI Content Safety).
Premier appel en Python, sans clé (DefaultAzureCredential), avec le SDK unifié :
from azure.identity import DefaultAzureCredential
from azure.ai.projects import AIProjectClient

# Format : https://<resource>.services.ai.azure.com/api/projects/<project>
project = AIProjectClient(endpoint="https://<resource>.services.ai.azure.com/api/projects/<project>",
                          credential=DefaultAzureCredential())
openai = project.get_openai_client()      # client OpenAI pointé sur l'endpoint du project

response = openai.responses.create(model="gpt-5-mini",   # nom du model deployment
                                   input="Quelle est la superficie de la France ?")
print(response.output_text)
2. Choisir un modèle pour chaque tâche#
2.1 Les critères de choix#
| Critère | Question à se poser | Où le vérifier |
|---|---|---|
| Qualité | Le modèle réussit-il ma tâche ? | Leaderboard et onglet Benchmarks, puis évaluation sur vos données |
| Latence | Interaction temps réel ou traitement différé ? | Benchmarks, tests ; un reasoning model ou un reasoning_effort élevé ajoute de la latence |
| Coût | Volume de jetons, prix par jeton, réservations | Page de prix, filtre Deployment SKU |
| Contexte | Taille des documents à injecter, historique | Fiche du modèle (context window) |
| Modalités | Texte, image en entrée, audio, génération d'image ou de vidéo | Filtre Inference tasks |
| Capacités | Tool calling, structured outputs, raisonnement | Filtre Supported features |
| Région, résidence | Le modèle est-il disponible dans ma région, en Data Zone ? | Filtre Region, tableaux de disponibilité |
| Cycle de vie | Preview, GA ou Deprecated ? | Filtre Lifecycle, calendrier de retrait |
| Licence | Conditions du fournisseur, usage commercial | Onglet License |
Dans le portail : Model catalog > View leaderboard and compare models. Chaque model card a les onglets Details, Deployments, Benchmarks et License.
2.2 Les familles de modèles#
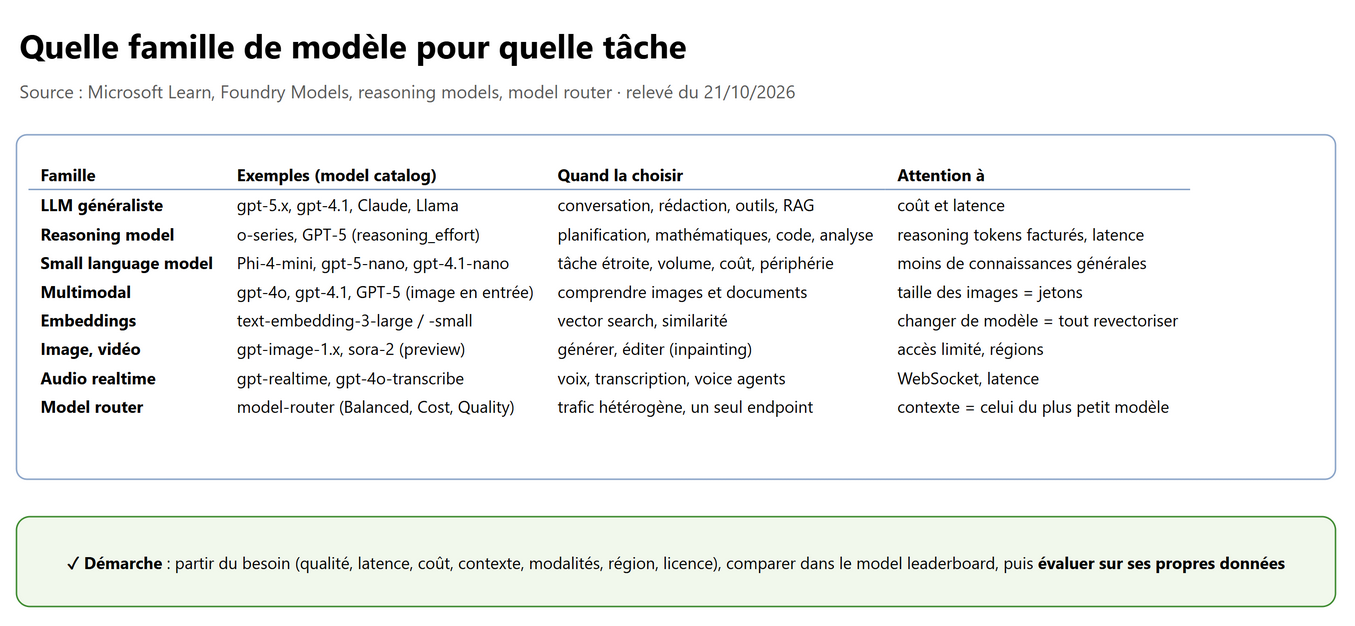
Reasoning models (modèles de raisonnement : série o, GPT-5 et suivants) : ils « réfléchissent » avant de répondre, avec des
reasoning tokens cachés mais facturés (dans completion_tokens_details). Le paramètre reasoning_effort règle l'effort ;
les valeurs dépendent du modèle (none, minimal, low, medium, high, xhigh, max) :
| Effort | Pour |
|---|---|
none |
Latence critique sans besoin de raisonnement : voix, classification, récupération rapide |
low |
Outils, planification, recherche, décisions en plusieurs étapes où vitesse et coût comptent |
medium |
Point de départ équilibré pour la plupart des charges |
high |
Raisonnement difficile, débogage complexe, planification profonde |
xhigh, max |
Recherche approfondie, tâches agentiques longues ; seulement si les évaluations le justifient |
Avec la Responses API, utiliser max_output_tokens (et non max_tokens) ; un résumé du raisonnement (reasoning.summary)
peut être demandé, mais extraire le raisonnement brut autrement n'est pas pris en charge.
response = openai.responses.create(
    model="gpt-5-mini",
    reasoning={"effort": "low"},          # moins de jetons de raisonnement, plus rapide
    input="Classe ce ticket : 'Mon VPN se coupe toutes les 10 minutes'. Réponds par une seule catégorie.",
)
Small language models (SLM, petits modèles comme Phi-4-mini, 3,8 milliards de paramètres, licence MIT) : plus rapides et moins chers à exécuter, empreinte mémoire réduite, adaptés aux tâches étroites et bien définies, aux contraintes de ressources et à la périphérie (on-device). Ils ont moins de connaissances générales qu'un LLM. Le fine-tuning permet de distiller un grand modèle dans un petit.
Multimodal : GPT-4o, GPT-4.1 et les GPT-5 acceptent des images en entrée (vision) ; les modèles audio (gpt-realtime,
gpt-4o-transcribe, gpt-audio) gèrent la parole ; gpt-image-1.x génère et édite des images ; sora-2 (preview) génère des
vidéos. Ces scénarios sont détaillés aux chapitres 08 et 09.
Embeddings : text-embedding-3-large (3 072 dimensions, le plus performant) et text-embedding-3-small (1 536 dimensions),
8 192 jetons en entrée, 2 048 éléments au plus par appel. On ne migre pas des vecteurs d'un modèle à l'autre : changer de modèle
d'embeddings oblige à tout revectoriser, et la requête doit être vectorisée avec le même modèle que l'index.
2.3 Model router : laisser Foundry choisir à chaque requête#
Model router est un modèle déployable qui analyse chaque invite (complexité, raisonnement, type de tâche, outils) et l'envoie au modèle sous-jacent le plus adapté, parmi des modèles OpenAI, DeepSeek, Meta, xAI et Anthropic.
| Mode de routage | Comportement |
|---|---|
| Balanced (défaut) | Parmi les modèles à 1-2 % de la meilleure qualité pour cette invite, prend le moins cher |
| Cost | Bande de qualité plus large (5-6 %), privilégie les modèles bon marché |
| Quality | Toujours le modèle le mieux noté, sans regarder le coût |
Points d'examen :
- model subset : vous choisissez les modèles autorisés (porte de conformité) ; les nouveaux modèles n'y entrent pas sans ajout explicite ; pour Claude, il faut d'abord déployer Claude dans votre resource ;
- failover automatique vers le modèle suivant : choisir au moins deux modèles (un seul modèle = ni routage ni bascule) ;
- la context window effective est celle du plus petit modèle du pool ;
- la limite de débit (TPM) se règle sur le déploiement du router, pas par modèle sous-jacent ;
- le champ
modelde chaque réponse indique le modèle qui a répondu : à journaliser ; - à éviter si le même modèle est exigé à chaque requête : déploiement direct. Le schéma hybride (router par défaut, déploiements directs pour les cas réglementés) est recommandé.
2.4 Un modèle ou un Foundry Tool ?#
Un LLM multimodal sait lire une image, traduire ou extraire des entités. Mais un Foundry Tool spécialisé reste souvent le meilleur choix quand il faut un résultat déterministe, mesurable et moins cher :
| Besoin | Foundry Tool | Le LLM est préférable si… |
|---|---|---|
| OCR, texte dans une image | Azure Vision (Read) | on veut interpréter, résumer ou raisonner sur l'image |
| Factures, formulaires, champs typés | Document Intelligence (modèles prebuilt et custom) | le format varie beaucoup et le schéma est simple |
| Extraction de tout média (documents, images, audio, vidéo) vers un schéma | Content Understanding (utilise lui-même des modèles génératifs, avec scores de confiance et grounding) | — |
| Entités nommées, PII, détection de langue | Azure Language (aussi exposé comme serveur MCP dans le Tool Catalog) | on veut un résumé ou une extraction libre |
| Traduction de documents ou de texte à grande échelle | Azure Translator (plus de 100 langues) | on veut adapter le ton ou le style |
| Transcription, synthèse vocale, voix personnalisée | Azure Speech | modèles audio temps réel pour une conversation naturelle |
| Détecter le contenu dangereux, les jailbreaks | Content Safety | — |
3. Choisir le bon service Foundry#
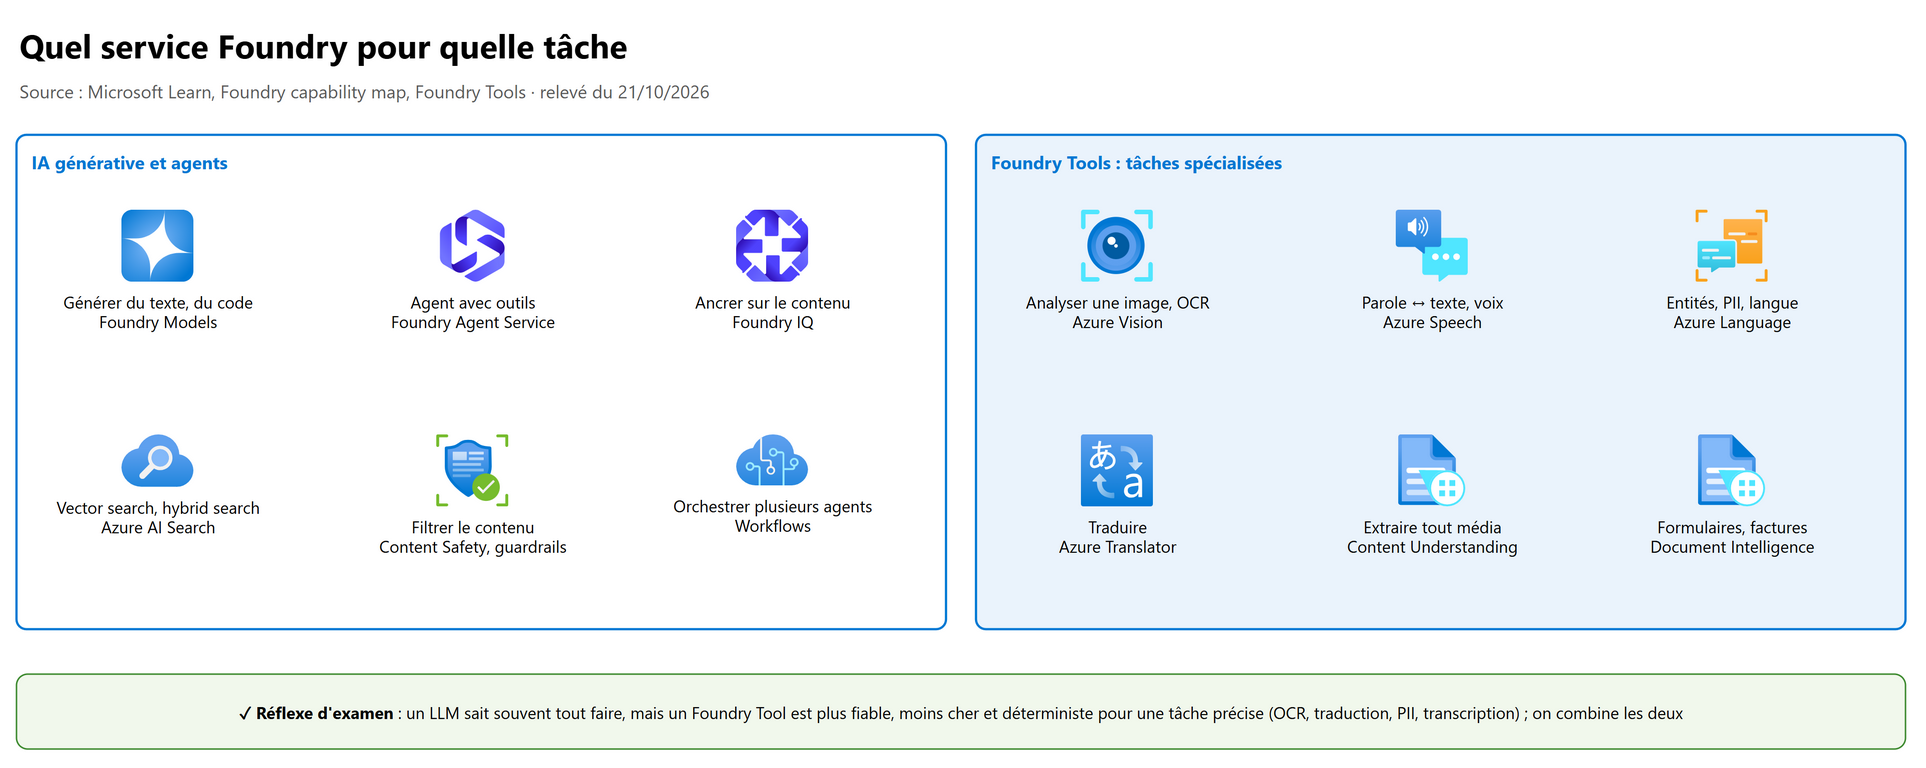
| Besoin (vocabulaire du guide) | Service Foundry | Remarque |
|---|---|---|
| Generative tasks : générer, résumer, rédiger, coder | Foundry Models (appel direct par la Responses API) | Pas besoin d'agent s'il n'y a ni outils ni orchestration |
| Grounding sur le contenu de l'entreprise | Foundry IQ (knowledge bases) ou outil Azure AI Search | Foundry IQ s'appuie sur Azure AI Search |
| Vector search | Azure AI Search (index vectoriels, hybrid search) | Aussi possible dans Azure Cosmos DB, PostgreSQL… selon l'architecture |
| Agent workflows : un agent avec outils | Foundry Agent Service (prompt agent ou hosted agent) | |
| Plusieurs agents ou étapes | Workflows de Foundry Agent Service, ou un framework (Microsoft Agent Framework, LangGraph) en hosted agent | Si un seul agent suffit, rester simple |
| Multimodal processing | Modèles multimodaux, Content Understanding, Azure Vision, Azure Speech | |
| Sécurité du contenu | Guardrails and controls, Content Safety | Chapitre 04 |
| Qualité, régressions | Evaluations, AI red teaming agent | Chapitre 04 |
| Voir ce que font les agents | Foundry Observability (tracing, monitoring) | Chapitre 07 |
| Gouverner un parc d'agents | Foundry Control Plane | Chapitre 03 |
3.1 Prompt agent, hosted agent ou Responses API ?#
| Prompt agent | Voice prompt agent (preview) | Hosted agent | Responses API (agent « éphémère ») | |
|---|---|---|---|---|
| Définition | Instructions + modèle + outils, déclaratif | Idem + paramètres audio, via Voice Live | Votre code (Agent Framework, LangGraph, OpenAI Agents SDK…) en conteneur ou .zip | Définition dans le code de votre application |
| Code d'exécution à gérer | Aucun | Aucun | Oui, votre logique | Votre application |
| Calcul | Entièrement géré | Entièrement géré | Conteneur géré par Foundry | Le vôtre |
| Identité | Managed identity du project | Idem | Agent identity Entra dédiée | Celle de votre application |
| Pour | Démarrer vite, agents de production sans orchestration personnalisée | Voix temps réel sans héberger le pipeline vocal | Orchestration personnalisée, multi-agents, protocoles spécifiques | Logique d'agent versionnée avec l'application |
On peut commencer en déclaratif (prompt agent) et passer au code (hosted agent) quand les besoins grandissent.
4. Choisir la méthode de récupération et d'indexation#
4.1 Préparer le contenu : chunking et vectorisation#
Les modèles d'embeddings et de chat ont une limite d'entrée (environ 8 000 jetons pour text-embedding-3-small) : il faut découper
(chunking) les documents pour ne rien tronquer et pour que chaque passage soit retrouvé indépendamment.
| Méthode | Principe | Dans Azure AI Search |
|---|---|---|
| Taille fixe | Blocs de taille constante avec chevauchement (overlap) | Text Split skill (pages, maximumPageLength, pageOverlapLength < la moitié de la taille) |
| Taille variable | Couper aux phrases, aux titres Markdown ou HTML | Text Split skill (sentences), Content Understanding skill |
| Sémantique | Unités de sens, respecte paragraphes et tableaux, peut franchir les pages | Content Understanding skill (semantic, preview) ; Document Layout skill pour les pipelines existants |
| Combinée | Ex. ajouter le titre du document à chaque bloc | Custom skill |
Recommandation Microsoft pour démarrer : 512 jetons (environ 2 000 caractères) avec 25 % de chevauchement (128 jetons), puis ajuster selon le contenu. Les index projections relient chaque bloc à son document parent (indexation one-to-many), et l'integrated vectorization génère les embeddings pendant l'indexation et à la requête. Les indexers extraient plus de dix sources Azure ; l'API push permet d'envoyer du contenu déjà préparé.
4.2 Les quatre méthodes de recherche#
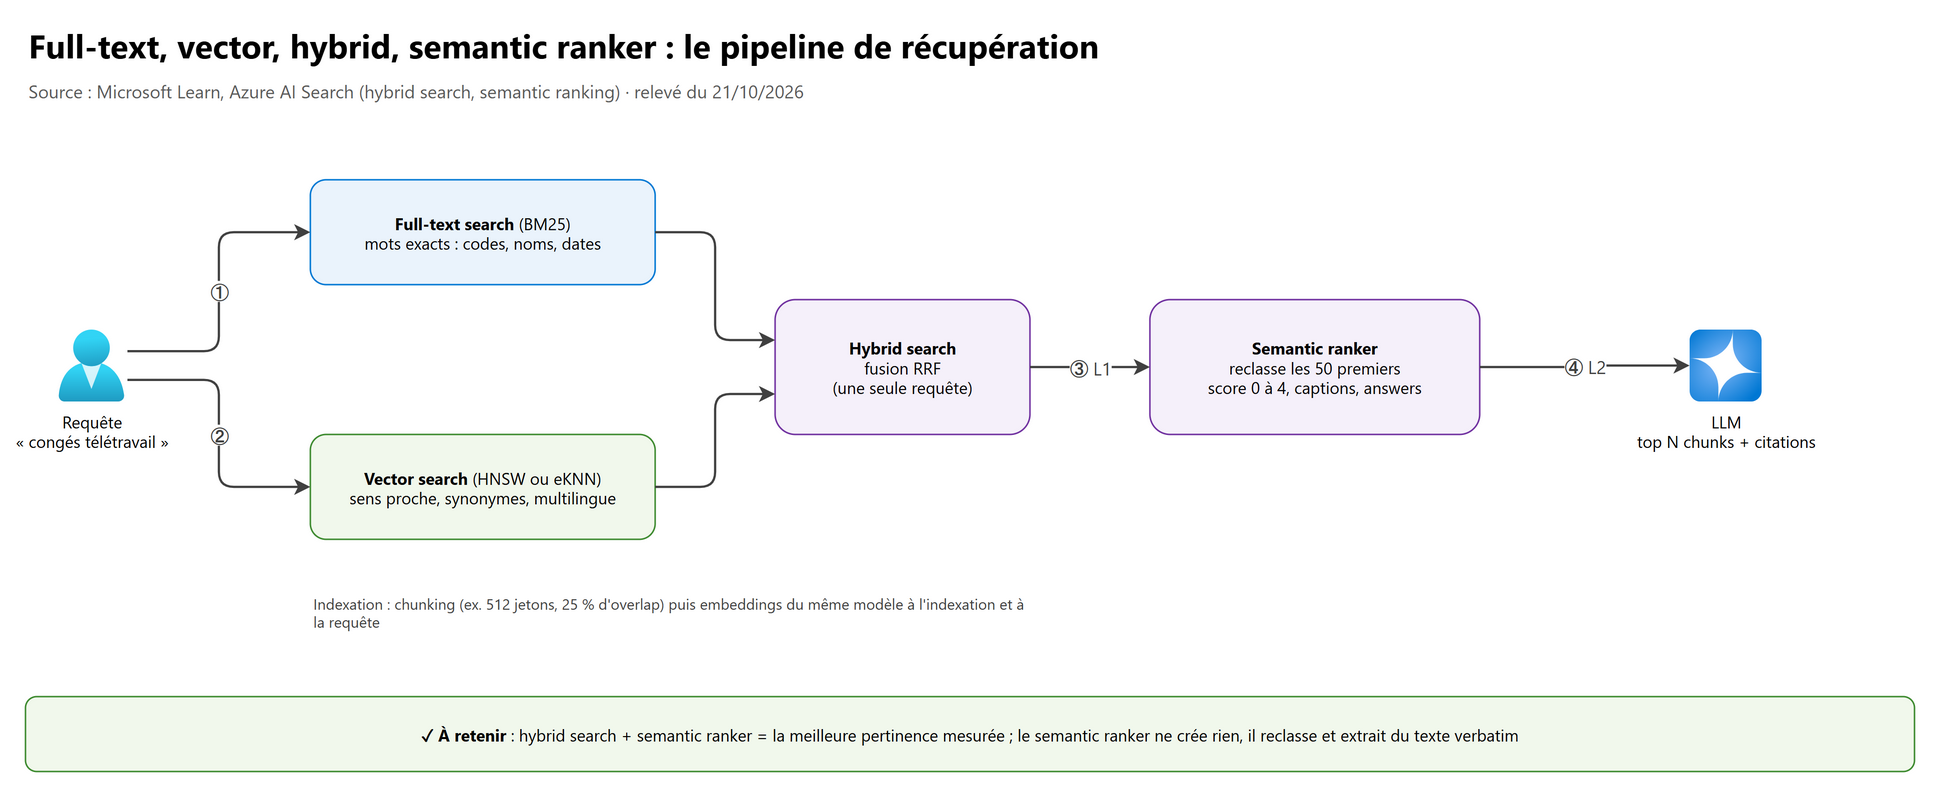
| Méthode | Algorithme | Excellente pour | Faible pour |
|---|---|---|---|
| Full-text search (plein texte) | Index inversé, score BM25 | Correspondances exactes : codes produits, jargon, dates, noms de personnes | Synonymes, paraphrases, autres langues |
| Vector search (vectorielle) | Similarité de vecteurs : HNSW (approximatif, rapide) ou eKNN (exhaustif) | Sens proche sans mots communs, contenu multilingue, images | Termes exacts, identifiants |
| Hybrid search (hybride) | Les deux en parallèle dans une seule requête (search + vectorQueries), fusion RRF (Reciprocal Rank Fusion) |
Le meilleur rappel : recommandée pour le RAG | — |
| Semantic ranker (classement sémantique) | Reclassement L2 par des modèles issus de Bing sur les 50 premiers résultats (BM25 ou RRF) | Précision : remonte les passages qui répondent vraiment | Ne cherche pas dans tout le corpus, ne crée aucun texte |
Le semantic ranker attribue un @search.rerankerScore de 0 à 4 (4 = répond complètement) et peut renvoyer des captions
et des answers extraits mot pour mot du contenu (aucune génération). Il ne traite que du texte, avec une limite d'environ
2 000 jetons par document (titre 128, mots-clés 128, contenu le reste) : d'où l'intérêt de bien découper. Query rewrite
(preview) peut générer jusqu'à 10 variantes de la requête. C'est une fonctionnalité premium, facturée en plus.
Les tests de Microsoft montrent que hybrid search + semantic ranker donne la meilleure pertinence pour le RAG. Pour un RAG, on
fixe k à 50 dans la requête vectorielle si on utilise le semantic ranker, et on évite orderby (qui écrase le classement par
pertinence).
4.3 Classic RAG ou agentic retrieval#
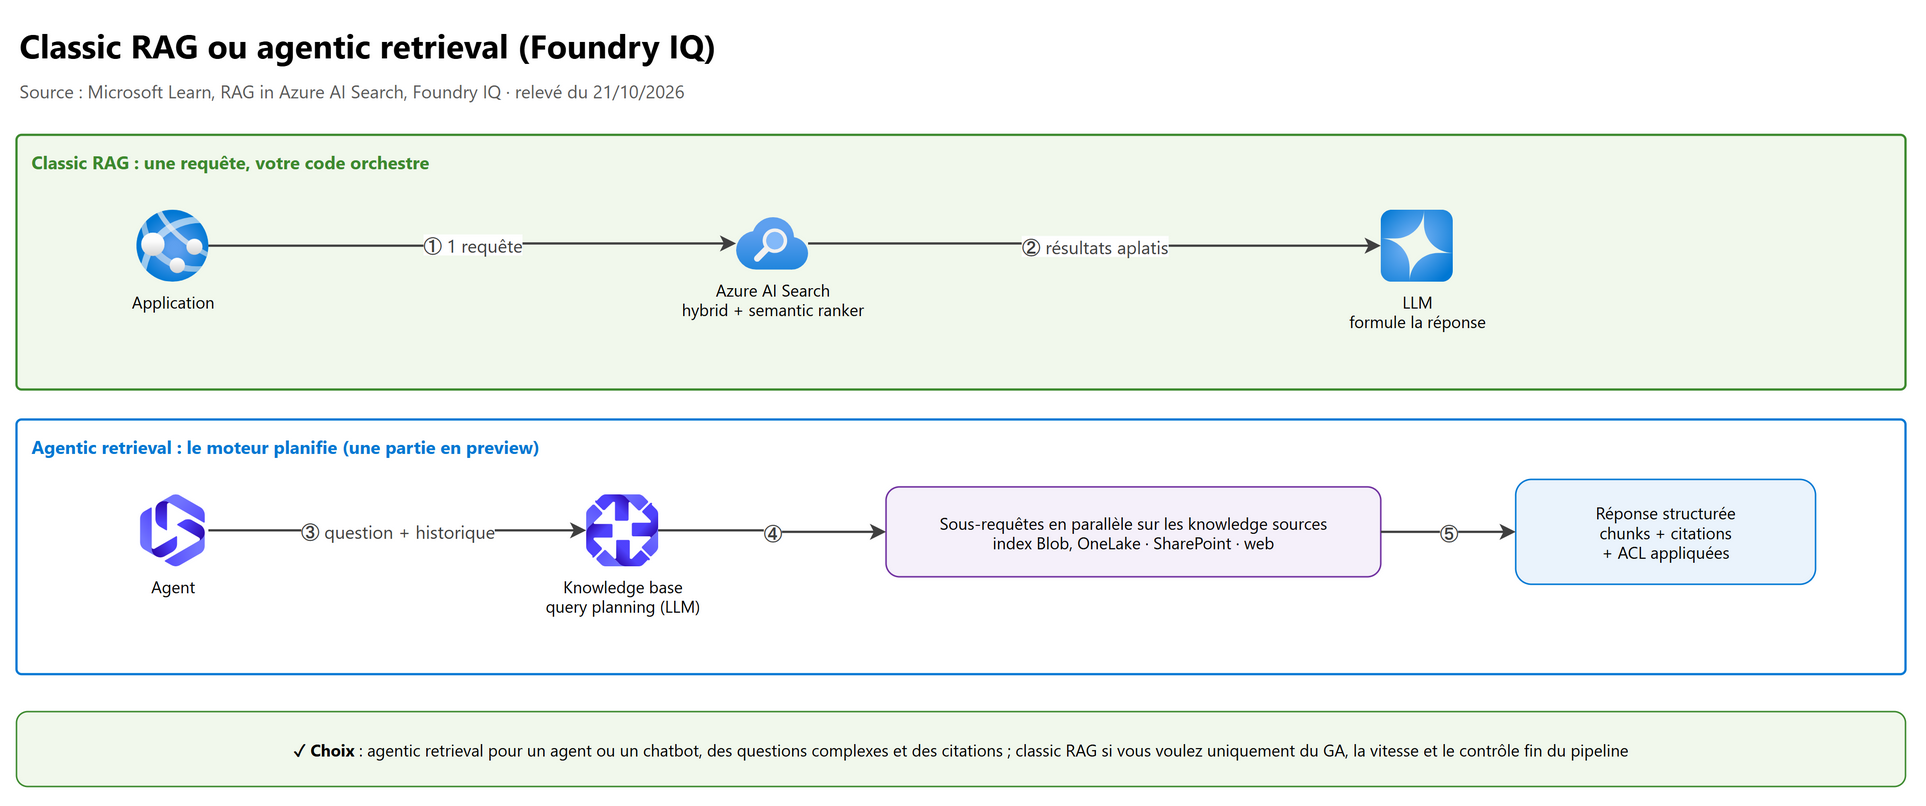
| Classic RAG | Agentic retrieval (récupération agentique) | |
|---|---|---|
| Fonctionnement | Une requête (hybride + sémantique), votre code transmet les résultats au LLM | Un LLM planifie : décompose la question en sous-requêtes, les exécute en parallèle, reclasse, renvoie une réponse structurée |
| Sources | Index Azure AI Search alimentés par indexers et skillsets | Knowledge sources multiples : index, Blob, OneLake, SharePoint distant, web (Bing) |
| Réponse | Résultats « aplatis » | Blocs pertinents + citations + journal d'activité ; synthèse de réponse en option |
| Latence | Millisecondes, architecture simple | Plus long ; retrieval reasoning effort réglable : minimal, low, medium |
| Statut | GA | REST 2026-04-01 GA : knowledge sources GA, retrieval minimal et extractive ; REST 2026-08-01-preview : query planning par LLM, answer synthesis, reasoning effort non minimal, multi-turn ; portails Azure et Foundry : preview uniquement |
| Pour | Fonctionnalités GA uniquement, vitesse, contrôle fin du pipeline, code d'orchestration existant | Agent ou chatbot, questions complexes ou conversationnelles, nouvelles implémentations |
Pour une nouvelle implémentation, Microsoft recommande de commencer par l'agentic retrieval.
4.4 Foundry IQ#
Foundry IQ est la couche de connaissances managée pour les agents. Une knowledge base regroupe des knowledge sources et les paramètres de récupération ; elle utilise l'agentic retrieval, s'appuie sur Azure AI Search et se partage entre plusieurs agents (Foundry Agent Service, Microsoft Agent Framework, Copilot Studio, ou toute application via l'API REST ou le SDK Azure AI Search).
Capacités clés :
- pipeline d'indexation généré automatiquement pour Blob et OneLake (chunking, embeddings, métadonnées, actualisation planifiée) ;
- requêtes mots-clés, vectorielles ou hybrides, sur des sources indexées et distantes (SharePoint, web) ;
- permissions respectées : synchronisation des ACL, étiquettes de confidentialité Microsoft Purview, requêtes exécutées sous l'identité Entra de l'appelant : l'agent ne renvoie que ce que l'utilisateur a le droit de voir ;
- réponses avec citations.
Foundry IQ a deux cousins : Fabric IQ (couche sémantique sur les données Fabric, OneLake, Power BI) et Work IQ (signaux de collaboration Microsoft 365). Un agent se connecte à une knowledge base par un outil MCP pointant vers l'endpoint MCP de la base.
4.5 Sécurité de la récupération (security trimming)#
Le contenu privé exposé à un LLM doit être filtré par utilisateur. Options : héritage des permissions SharePoint pour les requêtes SharePoint distantes, héritage des métadonnées de permissions Entra pour le contenu indexé depuis Azure Storage, filtres de sécurité au moment de la requête pour les autres sources, et isolation réseau par Private Endpoint. Le réseau et l'identité sont traités au chapitre 03.
5. Choisir memory, tools et knowledge pour un agent#
5.1 Les tools (outils)#
| Tool | Ce qu'il apporte | Dans une toolbox |
|---|---|---|
| Model Context Protocol (MCP) | Serveurs MCP distants (ex. Azure DevOps, serveur MCP sur Azure Functions) | Oui |
| Web search | Informations publiques et récentes | Oui |
| Azure AI Search | Interroger vos index existants | Oui |
| Code Interpreter | Exécuter du Python en bac à sable : calculs, graphiques, fichiers | Oui |
| File search | Chercher dans des fichiers chargés (vector store) | Oui |
| OpenAPI | Appeler une API décrite par une spécification OpenAPI | Oui |
| Agent-to-Agent (A2A) | Appeler un autre agent | Oui |
| Browser automation, Fabric IQ, Work IQ | Navigation web, données Fabric, signaux Microsoft 365 | Oui |
| Tool search, Skills, Reminder tool (preview) | Découverte d'outils, flux réutilisables | Oui seulement |
| Function calling | Votre fonction, exécutée côté client par votre code | Non |
| Grounding with Bing, Computer use, Image generation, SharePoint, Fabric data agent | Intégration directe à l'agent | Non |
Azure Functions (AzureFunctionTool) |
Fonction serverless appelée de façon asynchrone par Azure Queue storage (file d'entrée, file de sortie, CorrelationId) ; standard agent setup obligatoire ; en synchrone, exposer la function app comme serveur MCP ou par OpenAPI |
Non |
Toolbox (boîte à outils) : un ensemble d'outils défini une fois, exposé par un seul endpoint compatible MCP, consommable
par n'importe quel runtime (Foundry Agent Service, Agent Framework, LangGraph, GitHub Copilot). Avantages : authentification
centralisée (Microsoft Entra ID, OAuth identity passthrough), guardrails appliqués aux entrées et sorties des outils, versions
(on promeut une nouvelle version par défaut sans redéployer les agents). Tool search (preview) masque les outils et n'expose que
tool_search et call_tool, pour éviter de saturer le contexte avec des centaines de définitions. C'est la méthode recommandée
pour ajouter des outils à un agent.
Authentification des outils MCP et des connexions : clé, Microsoft Entra (managed identity de l'agent ou du project), OAuth identity passthrough (on-behalf-of : l'outil agit avec les droits de l'utilisateur) ou sans authentification.
5.2 Knowledge (connaissances)#
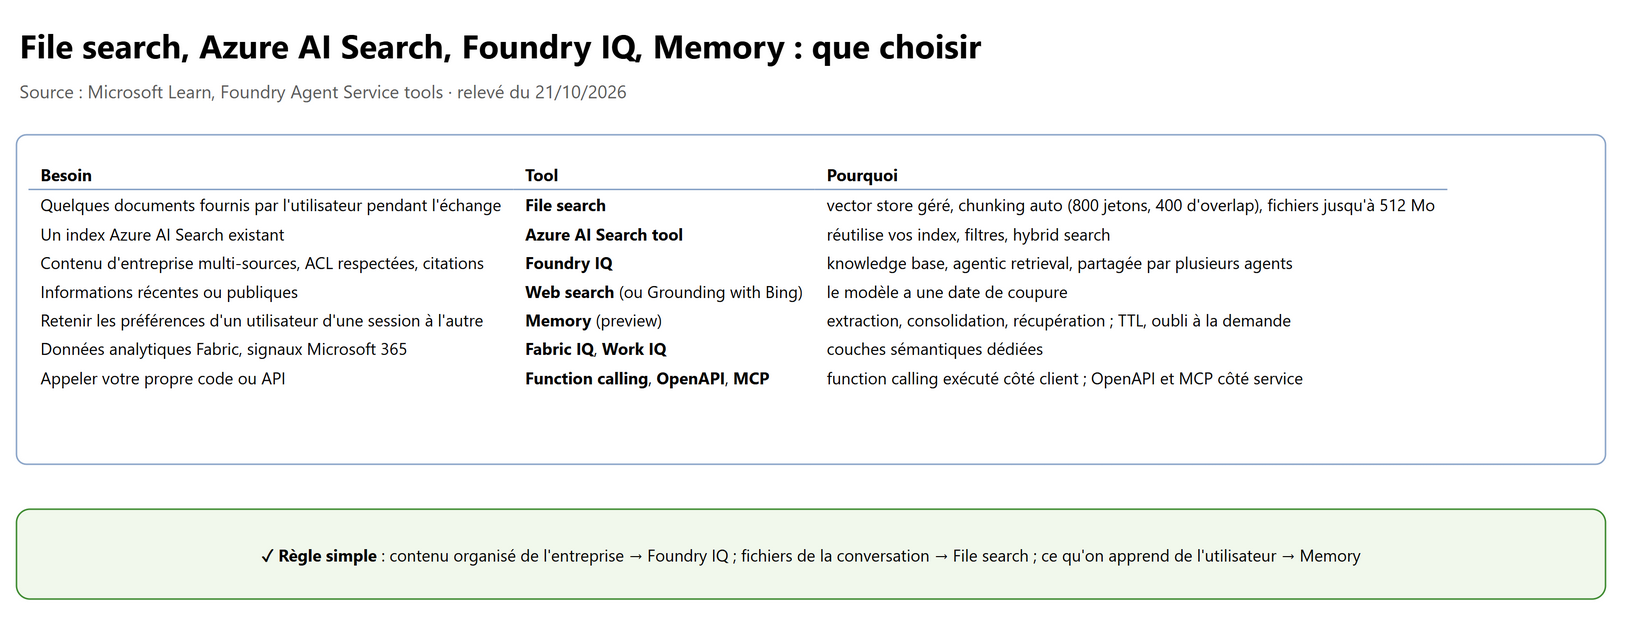
File search en détail :
- le service gère tout : analyse, chunking, embeddings, recherche hybride (mots-clés + vecteurs), réécriture et décomposition de la requête, reclassement ;
- réglages par défaut : blocs de 800 jetons, chevauchement de 400,
text-embedding-3-largeen 256 dimensions, 20 blocs au plus dans le contexte ; fichiers jusqu'à 512 Mo ; - basic agent setup : fichiers et vector store dans des ressources gérées par Microsoft ; standard agent setup : dans votre Storage account et votre Azure AI Search (contrôle total des données) ; le code est identique ;
- attendre que le vector store soit
completedavant d'interroger (helpersupload_and_poll) ; - dans une toolbox utilisée par un hosted agent, pas d'isolation par utilisateur : tous les utilisateurs du project partagent les vector stores référencés.
5.3 Memory (mémoire)#
| Mémoire à court terme | Mémoire à long terme : Memory dans Foundry Agent Service (preview) | |
|---|---|---|
| Contenu | La conversation en cours | Connaissances distillées entre les sessions |
| Gestion | Le contexte de la conversation, géré par le framework | Memory store managé : extraction, consolidation par LLM (fusion des doublons, résolution des contradictions), récupération |
| Types | — | User profile memory (préférences durables), chat summary memory (résumés), procedural memory (routines réutilisables) |
Deux façons de l'utiliser : le Memory search tool attaché à un prompt agent (cas courant, scope = {{$userId}} pour
isoler par utilisateur : l'identité vient de l'en-tête x-memory-user-id, sinon du jeton Entra {tid}_{oid} ; update_delay =
secondes d'inactivité avant la mise à jour des mémoires, 300 par défaut) ou l'API Memory Store de bas niveau (CRUD par élément, TTL par défaut au niveau du store, commandes
« retiens » ou « oublie »). Limites à connaître : modèles de chat et d'embeddings Azure OpenAI requis, pas d'intégration VNet
pour les memory stores, 100 scopes par store, 10 000 mémoires par scope. Risque principal : l'empoisonnement de la mémoire par
injection d'invite : filtrer les entrées et sorties avec Content Safety (Prompt Shields) et faire du red teaming.
Règle de Microsoft : la memory pour ce que l'agent apprend de l'utilisateur au fil du temps ; une knowledge base Foundry IQ pour le contenu organisé de l'entreprise ; File search pour les documents fournis pendant l'échange.
Exemple : un prompt agent avec File search et Memory, appelé dans une conversation :
from azure.ai.projects.models import PromptAgentDefinition, FileSearchTool, MemorySearchPreviewTool

vector_store = openai.vector_stores.create(name="ProductInfoStore")
with open("product_info.md", "rb") as f:
    openai.vector_stores.files.upload_and_poll(vector_store_id=vector_store.id, file=f)   # attend l'indexation

agent = project.agents.create_version(
    agent_name="support-produits",
    definition=PromptAgentDefinition(
        model="gpt-5-mini",
        instructions="Réponds uniquement à partir des fichiers. Si l'information manque, dis-le.",
        tools=[FileSearchTool(vector_store_ids=[vector_store.id]),
               MemorySearchPreviewTool(memory_store_name="memoire-clients", scope="{{$userId}}",
                                       update_delay=300)],   # 300 s d'inactivité avant mise à jour (défaut)
    ),
)

conversation = openai.conversations.create()
response = openai.responses.create(
    conversation=conversation.id,
    input="Quels produits Contoso sont compatibles avec mon modèle ?",
    extra_body={"agent_reference": {"name": agent.name, "type": "agent_reference"}},
)
print(response.output_text)
sequenceDiagram
    actor U as Utilisateur
    participant A as Prompt agent
    participant M as Model deployment
    participant T as Tools (File search, MCP…)
    participant Me as Memory store
    U->>A: Question (conversation)
    A->>Me: Récupère le profil (préférences)
    A->>M: Instructions + historique + profil + définitions d'outils
    M-->>A: Appel d'outil demandé
    A->>T: Exécute l'outil (identité du project ou de l'utilisateur)
    T-->>A: Résultats (passages, citations)
    A->>M: Résultats d'outil
    M-->>A: Réponse ancrée
    A-->>U: Réponse + citations
    A->>Me: Extrait et consolide les nouvelles mémoires (après inactivité)
6. Labs conseillés#
Dans un abonnement de test, avec une Foundry resource et un project créés pour l'occasion. Coût : surtout les jetons consommés, le niveau payant d'Azure AI Search (prévoir le niveau Free pour les essais de Foundry IQ) et le semantic ranker ; supprimer le groupe de ressources à la fin.
- Comparer des modèles
- Ouvrir Model catalog, filtrer par Inference tasks = chat completion et Supported features = reasoning.
- Ouvrir View leaderboard and compare models, comparer qualité, coût et débit de trois modèles.
- Déployer
gpt-5-miniet un modèle plus grand, poser la même question complexe dans le playground. - Attendu : écarts de qualité et de latence visibles ; noter le nombre de reasoning tokens dans la réponse.
- Régler le raisonnement
- Avec le code de la section 2.2, appeler le même modèle avec
reasoning={"effort": "low"}puis"high". - Attendu :
usage.output_tokens_details.reasoning_tokens(Responses API ;completion_tokens_details.reasoning_tokensen Chat Completions) augmente nettement avechigh, la latence aussi.
- Avec le code de la section 2.2, appeler le même modèle avec
- Model router
- Déployer model-router en Custom deployment, mode Cost, avec un subset de deux modèles.
- Envoyer une question simple puis une question de raisonnement.
- Attendu : le champ
modelde chaque réponse indique des modèles différents.
- Hybrid search + semantic ranker
- Créer un service Azure AI Search, utiliser Import data (new) avec vectorisation sur quelques PDF.
- Dans Search explorer, comparer une requête plein texte, une requête vectorielle et une requête hybride avec
queryType=semantic. - Attendu : la requête sémantique renvoie un
@search.rerankerScore(0 à 4) et des captions extraites du texte.
- Agent avec File search puis Foundry IQ
- Exécuter le code de la section 5.3 (sans le Memory tool si la région ne le propose pas).
- Créer une knowledge base dans l'onglet Knowledge du portail, la connecter à un agent, comparer les réponses.
- Attendu : réponses ancrées avec citations ; avec Foundry IQ, plusieurs sous-requêtes visibles dans le journal d'activité.
7. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Le modèle ignore les documents internes de l'entreprise | RAG (Foundry IQ ou Azure AI Search), pas le fine-tuning | Le fine-tuning ne sert pas à ajouter des connaissances à jour |
| Il faut un ton, un format JSON ou un style constant, et l'invite devient énorme | Fine-tuning (SFT), après avoir épuisé le prompt engineering | Réduit les exemples dans l'invite, donc jetons et latence |
| Rendre un petit modèle aussi bon qu'un grand sur une tâche précise | Distillation : fine-tuning du petit modèle sur les sorties du grand | Coût et latence réduits |
| Tâche simple à très gros volume, budget serré | SLM ou modèle « nano/mini », ou model router en mode Cost | — |
| Planification, mathématiques, code complexe | Reasoning model, reasoning_effort medium ou high |
Les reasoning tokens sont facturés : ne pas l'utiliser partout |
| Agent vocal à très faible latence | reasoning_effort = none (ou modèle realtime) |
Le raisonnement ajoute de la latence |
| Recherche de codes produits et de références exactes | Full-text (BM25), idéalement en hybrid search | Le vectoriel rate les correspondances exactes |
| Questions formulées autrement que les documents, ou dans une autre langue | Vector search (dans une requête hybride) | Similarité de sens |
| Meilleure pertinence pour un RAG | Hybrid search + semantic ranker | Mesuré par Microsoft sur des jeux de référence |
| Le semantic ranker « invente » une réponse ? | Non : captions et answers sont extraits verbatim ; il reclasse seulement les 50 premiers | Ce n'est pas un modèle génératif |
| Changer de modèle d'embeddings sur un index existant | Revectoriser tout le contenu | Les vecteurs de deux modèles ne sont pas comparables |
| Agent ou chatbot, questions complexes, besoin de citations, nouveau projet | Agentic retrieval (Foundry IQ) | Planification, sous-requêtes parallèles, citations |
| Uniquement des fonctionnalités GA, latence minimale | Classic RAG | Une partie de l'agentic retrieval est en preview |
| Les utilisateurs ne doivent voir que les documents autorisés | Foundry IQ avec ACL synchronisées et requêtes sous l'identité de l'appelant | Security trimming |
| Mémoriser les préférences d'un client d'une session à l'autre | Memory (long terme), scope par utilisateur | Une knowledge base sert au contenu organisé, pas aux préférences |
| Chercher dans les fichiers que l'utilisateur vient de joindre | File search | Plus léger que Foundry IQ |
| Interroger un index Azure AI Search existant | Azure AI Search tool | Réutilise filtres et configuration |
| Partager les mêmes outils entre dix agents, rotation centralisée des secrets | Toolbox (endpoint MCP unique) | Évite la duplication des définitions et des identifiants |
| Votre fonction métier doit s'exécuter dans votre application | Function calling | Exécutée côté client, pas par le service |
| Model router avec un seul modèle dans le subset | À éviter | Ni optimisation ni failover |
| Model router et longs documents | Choisir un subset de modèles à grande context window | Le contexte effectif est celui du plus petit modèle |
| Où sont les model deployments ? | Au niveau de la Foundry resource, partagés par les projects | Les projects isolent agents, connexions et fichiers |
| Assistants API, threads, runs dans une question récente | Remplacés par la Responses API, conversations, responses | Agents v2 |
8. Scénarios d'entraînement#
1. Une banque veut un assistant qui répond aux conseillers à partir de 20 000 procédures internes stockées dans SharePoint et Blob, en respectant les droits de chaque conseiller et en citant ses sources. Quelle approche ?
Une knowledge base Foundry IQ avec des knowledge sources SharePoint et Blob, en agentic retrieval : ACL synchronisées, requêtes sous l'identité Entra de l'appelant, réponses avec citations. L'agent s'y connecte par l'outil MCP de la knowledge base.
2. Une équipe a ajouté 40 exemples dans l'invite pour obtenir un format de rapport précis ; la latence et la facture explosent. Que proposer ?
Un fine-tuning SFT sur des paires entrée/sortie au bon format, puis éventuellement un modèle plus petit (distillation). Les exemples quittent l'invite, d'où moins de jetons et de latence. Évaluer contre la version actuelle avant de basculer.
3. Le trafic d'un chatbot mélange 60 % de questions triviales et 40 % de questions d'analyse complexes. Comment réduire le coût sans perdre en qualité sur les questions difficiles ?
Model router en mode Balanced (ou Cost si la qualité reste suffisante), avec un model subset d'au moins deux modèles approuvés. Journaliser le champ
modeldes réponses et suivre la distribution dans Azure Monitor.
4. Un moteur de recherche interne ne trouve pas « congés » quand l'utilisateur tape « vacances », mais doit aussi retrouver exactement la référence « RH-2024-017 ». Quelle configuration ?
Hybrid search (plein texte BM25 pour la référence exacte + vectoriel pour le sens), fusion RRF, puis semantic ranker pour la précision.
5. Une application doit extraire les champs de factures fournisseurs (montant, TVA, date) avec un niveau de confiance par champ, pour automatiser la saisie. Modèle génératif ou Foundry Tool ?
Un Foundry Tool : Document Intelligence (modèle prebuilt facture) ou Content Understanding (schéma de champs, scores de confiance, grounding). Plus fiable et mesurable qu'une extraction libre par LLM.
6. Un agent de voyage doit se souvenir que l'utilisateur préfère le hublot et voyage sans escale, d'une semaine à l'autre.
Memory de Foundry Agent Service (user profile memory) via le Memory search tool avec un scope par utilisateur ; récupérer le profil en début de conversation. Protéger la mémoire contre l'injection (Content Safety).
7. Dix équipes construisent des agents qui appellent les mêmes API internes (OpenAPI) et le même serveur MCP ; chaque équipe gère ses propres secrets. Comment rationaliser ?
Une toolbox : outils définis une fois, un endpoint MCP unique, authentification centralisée (Entra, OAuth passthrough), guardrails au niveau des outils, versions promues sans redéployer les agents.
8. Un développeur veut un agent sans gérer de code ni d'infrastructure, avec des instructions, un modèle et File search. Un autre a déjà un agent LangGraph complexe à héberger avec une identité dédiée. Quels types d'agents ?
Le premier : un prompt agent. Le second : un hosted agent (conteneur géré par Foundry, agent identity Entra dédiée, autoscale, observabilité).
9. Une équipe change son modèle d'embeddings de text-embedding-ada-002 vers text-embedding-3-large mais garde son index :
les résultats deviennent incohérents. Pourquoi ?
Les vecteurs de deux modèles ne sont pas comparables : il faut revectoriser tout l'index et vectoriser les requêtes avec le même modèle.
10. Une application de support sur appareil mobile doit classer des messages hors connexion.
Un SLM exécutable sur l'appareil (famille Phi) : petit, rapide, peu gourmand ; adapté à une tâche étroite.
9. Pour aller plus loin#
- Instant access (preview) : appeler certains modèles par leur nom sans créer de déploiement.
- Agent optimizer (preview) : améliore automatiquement instructions, descriptions d'outils et choix de modèle à partir d'évaluations (chapitre 07).
- Multitenancy : plusieurs schémas d'isolation des clients d'un SaaS (resource par client, project et déploiement par client, déploiement partagé) ; plus l'isolation est faible, plus l'application doit faire le travail.
- Guide d'architecture RAG du Centre des architectures Azure : conception, évaluation et prompt engineering spécifique au RAG.
- Session affinity du model router (preview) : garder les requêtes d'une même conversation sur le même modèle pour la cohérence et le cache.
10. Fiche à retenir#
- Ordre d'adaptation : prompt engineering → RAG → fine-tuning ; le fine-tuning ne remplace pas la récupération.
- Nouveaux noms : Microsoft Foundry, Foundry Tools (ex-Azure AI services), Foundry resource + projects, Responses API, SDK
azure-ai-projects. - Les model deployments sont au niveau de la resource ; le project isole agents, connexions, fichiers.
- Models sold by Azure (support Microsoft, SLA) vs partners and community (support du fournisseur, Marketplace).
- Choisir sur la qualité, la latence, le coût, le contexte, les modalités, la région, le cycle de vie, la licence ; évaluer sur ses données.
- Reasoning models : reasoning tokens facturés ;
reasoning_effortdenoneàmaxselon le modèle. - SLM : tâches étroites, volume, périphérie ; distillation par fine-tuning.
- Embeddings : 3-large (3 072 dim.), 3-small (1 536) ; changer de modèle = revectoriser.
- Model router : Balanced (défaut), Cost, Quality ; subset ≥ 2 modèles ; contexte = plus petit modèle.
- Foundry Tool plutôt que LLM pour OCR, traduction, PII, transcription, formulaires.
- Chunking : départ à 512 jetons, 25 % d'overlap ; Text Split skill, Content Understanding skill (semantic).
- BM25 = exact ; vectoriel (HNSW, eKNN) = sens ; hybride = les deux + RRF ; semantic ranker = top 50, score 0-4, verbatim.
- Classic RAG (GA, simple, rapide) vs agentic retrieval (planification, sous-requêtes, citations ; preview en partie).
- Foundry IQ : knowledge base + knowledge sources, ACL et étiquettes Purview respectées, partagée entre agents.
- File search : 800/400 jetons, 512 Mo, basic vs standard setup ; Memory (preview) : profil, résumés, procédures, pas de VNet.
- Toolbox : endpoint MCP unique, auth centralisée, versions ; function calling s'exécute côté client.
- Prompt agent (déclaratif) / hosted agent (votre code, identité dédiée) / Responses API (agent éphémère).
Références#
Toutes lues le 21/10/2026 sur Microsoft Learn :
- Guide d'étude de l'examen AI-103 (en anglais)
- Qu'est-ce que Microsoft Foundry ?
- Carte des produits et des fonctionnalités Foundry
- Microsoft Foundry architecture
- Microsoft Foundry rollout across my organization
- Vue d'ensemble des modèles Microsoft Foundry
- Foundry Models sold by Azure
- Azure OpenAI reasoning models
- Model router for Microsoft Foundry
- How model router works
- Concepts – Small and large language models
- Fine-tuning in Microsoft Foundry
- Fine-tune models with Microsoft Foundry (classic)
- What are Foundry Tools?
- What is Azure Content Understanding in Foundry Tools?
- Agents de Microsoft Foundry (Foundry Agent Service)
- Qu'est-ce que la boîte à outils dans Foundry ?
- Qu'est-ce que Foundry IQ ?
- Mémoire dans le service Microsoft Foundry Agent (préversion)
- File search tool for agents
- Génération augmentée par récupération (RAG) dans Azure AI Search
- Recherche hybride dans Azure AI Search
- Semantic ranking in Azure AI Search
- Chunk large documents for RAG and vector search
- Azure Content Understanding skill
- Information retrieval (guide RAG, Centre des architectures Azure)
- Baseline Microsoft Foundry chat reference architecture
- Multitenancy and Foundry Models