
Version : 1.1 · Date : 2026-10-22 · Domaine 3 de l'examen : Evaluate, optimize, and monitor multi-agent solutions (20 à 25 %)
En une phrase : une solution multi-agents se juge sur sa trajectoire autant que sur sa réponse ; on la valide par des humains et par des juges LLM calibrés sur ces humains, on évalue chaque composant (memory, knowledge, tools, prompts), on diagnostique la fenêtre de contexte, on borne durée, boucles et jetons, puis on trace chaque tour de bout en bout avec un seul identifiant de corrélation pour surveiller fiabilité, SLA et coûts, jusqu'au chargeback.
Ce que l'examen demande#
Domaine 3, repris mot pour mot du guide d'étude AI-500 (examen en bêta, guide relu le 22/10/2026) :
| # | Compétence mesurée (guide officiel, en anglais) | Section de ce chapitre |
|---|---|---|
| 3.1.1 | Design and implement a human review process to evaluate solutions in Foundry | 2 |
| 3.1.2 | Design and implement evaluations for memory, knowledge, tools, and prompts | 3 |
| 3.2.1 | Optimize task duration, including parallelism and rate limits | 4 |
| 3.2.2 | Diagnose context window issues, including sliding-window amnesia, summary drift, vector-only recall, and entity continuity issues | 5 |
| 3.2.3 | Design and implement continuous improvement, including large language model–as-a-judge (LLM-as-a-judge) frameworks, synthetic data generation, semantic optimization loops, and user feedback loops | 6 |
| 3.3.1 | Design a strategy for monitoring reliability, including agent health, workflow failures, trace correlation, drift detection, quality regression, and remediation | 7 |
| 3.3.2 | Design a strategy for monitoring solution and platform availability, performance, reliability, and service-level agreement adherence | 8 |
| 3.3.3 | Design and implement a strategy for optimizing token usage, including token limits, loop controls, and tool calls | 9 |
| 3.3.4 | Design a strategy for monitoring and managing cost, including usage, quotas, allocations, and chargebacks | 10 |
| 3.3.5 | Implement tracing in Foundry, including tokens, prompts, correlation IDs, alerting, and execution tracking | 11 |
Ce chapitre suppose acquises les bases vues ailleurs, qu'il ne répète pas :
- les evaluators de qualité et de sécurité : AI-103, chapitre 04 ;
- les agent evaluators et l'Agent Monitoring Dashboard pour un agent seul : AI-103, chapitre 06 ;
- quotas, 429 et coûts d'un deployment : AI-103, chapitre 03 ;
- tracing, token analytics et latency breakdown : AI-103, chapitre 07 ;
- l'évaluation en CI (quality gate) et les recurring evaluations : AI-300, chapitre 06 ;
- la lecture d'une trace par la règle de la première divergence : Claude Developer, chapitre 08.
Dans ce cours : la compaction et les stratégies de mémoire sont au chapitre 03, les motifs d'orchestration et le human-in-the-loop au chapitre 05, le déploiement progressif et l'AI Red Teaming Agent au chapitre 07.
1. Les bases à maîtriser#
1.1 Ce qui change avec plusieurs agents#
Un agent seul se juge surtout sur sa réponse. Avec plusieurs agents, trois effets s'ajoutent, et ils guident tout le chapitre :
| Effet | Conséquence pour l'évaluation et la surveillance |
|---|---|
| Les erreurs se composent : un sous-agent qui se trompe à l'étape 2 contamine toutes les suivantes | Évaluer chaque étape (process evaluation), pas seulement la réponse finale (system evaluation) |
| Le contexte voyage : résumés, handoffs, mémoire partagée | Diagnostiquer ce qui se perd entre agents (section 5) |
| Le coût et la latence se multiplient : chaque agent appelle un modèle, parfois en boucle | Borner boucles, appels d'outils et jetons ; attribuer le coût à l'agent et à l'équipe (sections 9 et 10) |
| Une requête traverse plusieurs services | Un identifiant de corrélation unique du premier au dernier span (section 11) |
Foundry range ses evaluators selon la même idée : system evaluation (Task Completion, Task Adherence, Intent Resolution, Task Navigation Efficiency, Customer Satisfaction) pour l'orchestrateur ou l'agent final, process evaluation (Tool Call Accuracy, Tool Selection, Tool Input Accuracy, Tool Output Utilization, Tool Call Success) pour chaque étape.
1.2 Préversions, rôles et prérequis#
Presque tout ce chapitre est récent. Ce qui est en preview n'a pas de SLA et peut changer avant ou après l'examen :
| Fonctionnalité | Statut au 22/10/2026 | Rôle ou prérequis |
|---|---|---|
| Tracing des prompt agents et hosted agents | GA | Application Insights connecté au project ; Log Analytics Reader pour lire |
| Tracing des workflows et des agents externes | Preview | Idem, plus instrumentation OpenTelemetry côté agent externe |
| Human evaluation (templates, preview web app) | Preview | Foundry Project Manager pour créer les templates ; Foundry User + Reader sur le compte pour les relecteurs |
| Trace annotations (builder, end user) | Preview | Écriture de télémétrie : Monitoring Metrics Publisher pour l'identité qui émet (ingestion Entra) |
| Agent evaluators Task Adherence, Task Completion, Intent Resolution, Customer Satisfaction ; composites Output Quality, Tool Use Quality | Preview | Un deployment de modèle juge |
| Tool Call Accuracy, Tool Selection, Tool Input Accuracy, Tool Output Utilization, Tool Call Success, Task Navigation Efficiency | Sans mention preview | Idem (sauf Task Navigation Efficiency : aucun modèle) |
| Recurring evaluations, alerts et métriques de l'Agent Monitoring Dashboard, cluster analysis | Preview | Identité managée du project avec Foundry User pour les règles continues |
| Agent optimizer | Récent, voir la doc avant l'examen | Un modèle d'évaluation et un modèle d'optimisation déployés |
| Chargeback par project tag | Preview | Cost Management Reader pour lire les coûts |
| Memory de Foundry Agent Service | Preview | Voir le chapitre 03 |
Les rôles Foundry ont été renommés : Foundry User, Foundry Owner, Foundry Account Owner et Foundry Project Manager remplacent Azure AI User, Azure AI Owner, Azure AI Account Owner et Azure AI Project Manager. Les identifiants de rôle n'ont pas changé : une question peut employer l'un ou l'autre nom.
2. La revue humaine dans Foundry#
2.1 Deux mécanismes complémentaires#
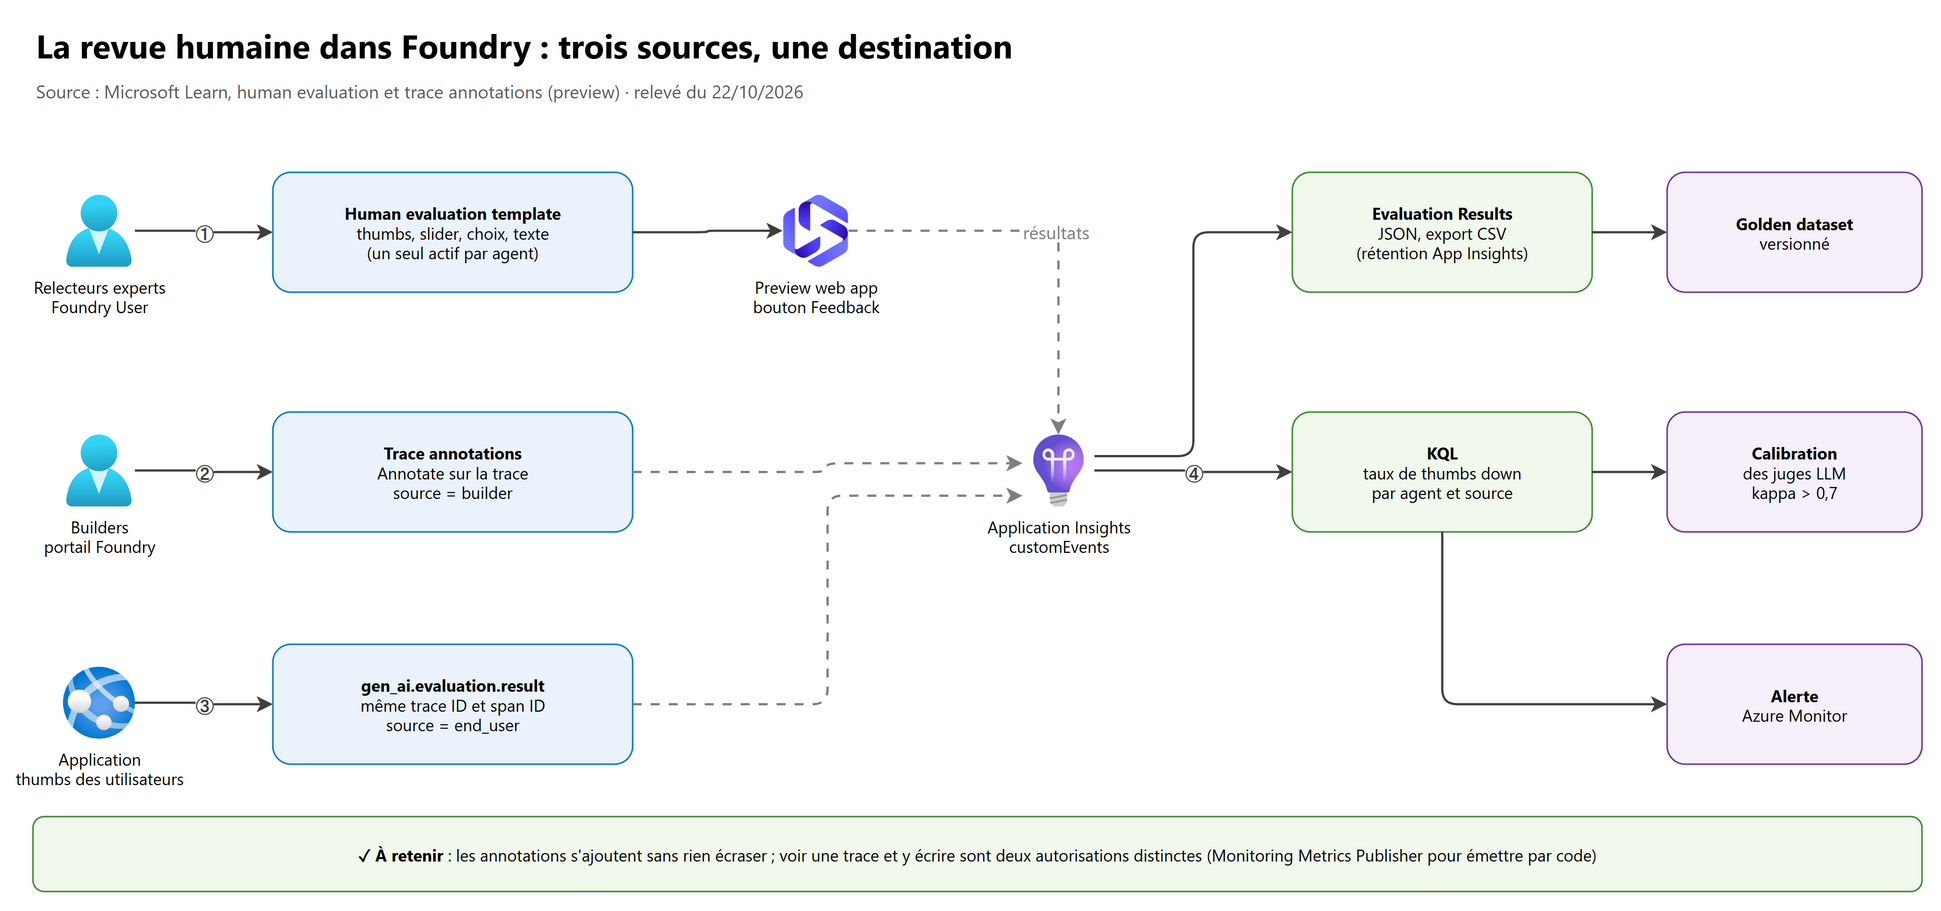
| Human evaluation (preview) | Trace annotations (preview) | |
|---|---|---|
| Qui note | Relecteurs choisis : pairs, data scientists, conformité | Builders (portail) et utilisateurs finaux (votre application) |
| Où | Preview web app de l'agent (bouton Preview de l'agent builder), bouton Feedback après chaque réponse | Page de détail d'une trace (Tracing > trace > Annotate) ou par code |
| Quoi | Un template de questions : thumbs up/down, slider (1 à 5), choix multiple, texte libre | Thumbs up/down (score 1.0 ou 0.0, label pass/fail) et explication libre ; template par défaut présent dans chaque project |
| Gestion | Plusieurs templates, un seul actif par agent ; sans template actif, pas de bouton Feedback | Les annotations s'ajoutent : aucune n'écrase les autres, plusieurs personnes peuvent noter la même trace |
| Résultats | Section Evaluation Results (JSON : horodatage, prompt, réponse, questions, réponses), export CSV | Sur la trace, filtrables par type, score, source ; requêtables en KQL |
| Stockage | Application Insights : la rétention d'Application Insights s'applique, exporter pour garder | Application Insights, table customEvents |
Les deux reposent sur Application Insights : sans ressource connectée au project, ni résultats ni annotations (délai d'ingestion jusqu'à 5 minutes). Supprimer un template supprime aussi ses résultats dans le portail.
2.2 Concevoir le processus#
La revue humaine coûte cher ; elle sert à trois choses précises, et le processus se construit à partir d'elles :
- Créer la vérité terrain : un jeu de 50 à 100 exemples étiquetés par des experts, qui sert ensuite à calibrer les juges LLM (section 6.2) et devient le cœur du dataset de régression.
- Trancher ce que la machine ne sait pas juger : conformité réglementaire, ton, cas où plusieurs juges LLM divergent.
- Remonter les signaux du terrain : le feedback des utilisateurs finaux pointe les traces à examiner.
| Décision de conception | Recommandation |
|---|---|
| Qui relit | Experts métier pour l'exactitude, conformité pour les règles, pairs pour la clarté ; rôle Foundry User seulement |
| Que relire | Un échantillon : traces notées thumbs down, traces où les juges divergent, cas limites ; pas tout le trafic |
| Comment noter | Questions fermées d'abord (thumbs, slider, choix multiple), une question libre « qu'est-ce qui aurait amélioré la réponse ? » |
| Combien de templates | Un par objectif (exactitude, conformité, ton) ; activer celui de la campagne en cours |
| Accord entre relecteurs | Faire noter une partie des cas par deux personnes : si elles ne s'accordent pas, la grille est floue |
| Où vont les résultats | Export CSV régulier (rétention), ajout au dataset versionné, calibration des juges |
Dans un flux multi-agents en production, la revue humaine peut aussi être dans la boucle : un seuil de confiance déclenche une approbation humaine avant l'action (par exemple par Power Automate et une carte Teams). Ce motif est traité au chapitre 05 ; ici, on parle de la revue après coup, pour évaluer.
2.3 Journaliser le feedback des utilisateurs#
Le feedback de l'application devient une annotation de la trace d'origine grâce à l'événement OpenTelemetry
gen_ai.evaluation.result, émis dans le même contexte de trace (même trace ID et même span ID) que la réponse notée. Les
attributs attendus :
| Attribut | Valeur |
|---|---|
gen_ai.evaluation.name |
task_completion (obligatoire pour le template thumbs up/down) |
gen_ai.evaluation.score.value / gen_ai.evaluation.score.label |
1.0 / pass ou 0.0 / fail |
gen_ai.evaluation.explanation |
Commentaire libre (optionnel) |
gen_ai.response.id |
ID de la réponse notée, par exemple chatcmpl-123 |
microsoft.gen_ai.human_evaluation.source |
end_user ou builder |
microsoft.gen_ai.evaluation.actor.type |
human (distingue d'une évaluation automatique) |
operation_Id / operation_ParentId |
Trace ID / span ID de l'interaction notée |
gen_ai.agent.id, gen_ai.agent.name, gen_ai.agent.version |
L'agent qui a produit la réponse |
# Attributs d'une annotation « thumbs down » envoyée par l'application (forme documentée par Microsoft Learn).
# L'émission elle-même (événement gen_ai.evaluation.result dans le contexte de la trace) suit l'exemple officiel
# sample_human_evaluations.py du SDK azure-ai-projects (>= 2.0.0) avec azure-monitor-opentelemetry.
feedback = {
    "gen_ai.evaluation.name": "task_completion",
    "gen_ai.evaluation.score.value": 0.0,
    "gen_ai.evaluation.score.label": "fail",
    "gen_ai.evaluation.explanation": "Le remboursement proposé ne respecte pas le plafond",
    "gen_ai.response.id": response.id,                 # réponse notée
    "microsoft.gen_ai.human_evaluation.source": "end_user",
    "microsoft.gen_ai.evaluation.actor.type": "human",
    "gen_ai.agent.name": "agent-remboursement",
}
Pannes classiques : 401 ou 403 (l'identité qui émet n'a pas Monitoring Metrics Publisher sur l'Application Insights), annotation
invisible (autre ressource Application Insights ou autre contexte de trace), annotation sur la mauvaise trace (operation_Id,
operation_ParentId, gen_ai.response.id à vérifier). Voir une trace et y écrire sont deux autorisations distinctes : ajouter
un rôle de lecture ne corrige pas une erreur d'écriture.
2.4 Exploiter les annotations en KQL#
Taux de thumbs down par source et par jour, base d'une alerte ou d'un tableau de bord :
customEvents
| where name == "gen_ai.evaluation.result"
| extend score = todouble(customDimensions["gen_ai.evaluation.score.value"]),
         eval_source = tostring(customDimensions["microsoft.gen_ai.human_evaluation.source"]),
         agent = tostring(customDimensions["gen_ai.agent.name"])
| where eval_source in ("builder", "end_user")
| summarize thumbs_up = countif(score == 1.0), thumbs_down = countif(score == 0.0), total = count()
    by eval_source, agent, bin(timestamp, 1d)
| extend taux_negatif = round(100.0 * thumbs_down / total, 1)
| order by timestamp desc
Traces notées négativement, à envoyer en revue humaine ou dans le dataset de régression :
customEvents
| where name == "gen_ai.evaluation.result"
| extend score = todouble(customDimensions["gen_ai.evaluation.score.value"]),
         explanation = tostring(customDimensions["gen_ai.evaluation.explanation"]),
         trace_id = tostring(customDimensions["trace_id"])
| where score == 0.0
| project timestamp, trace_id, operation_Id, explanation
| order by timestamp desc
3. Évaluer memory, knowledge, tools et prompts#
3.1 Un composant, une question, un evaluator#
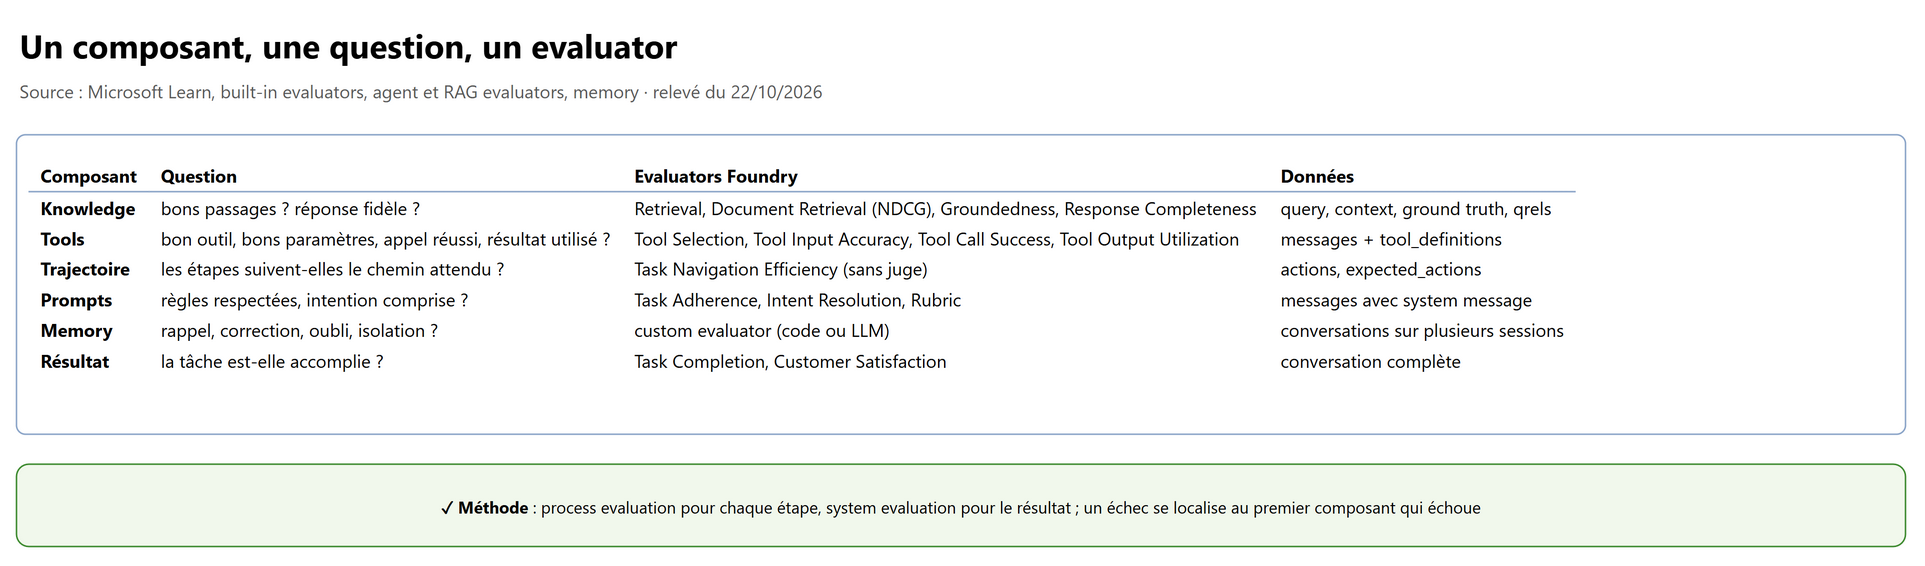
Évaluer « l'agent » ne dit pas quel composant a failli. On découpe :
| Composant | Question | Evaluators Foundry | Données nécessaires |
|---|---|---|---|
| Knowledge (RAG, Foundry IQ) | La récupération ramène-t-elle les bons passages ? La réponse s'y tient-elle ? | Retrieval (sans vérité terrain), Document Retrieval (avec qrels : Fidelity, NDCG, XDCG, Max Relevance, Holes), Groundedness (précision), Response Completeness (rappel, preview), Relevance | query, context, response, ground_truth ou étiquettes de pertinence |
| Tools | Le bon outil, les bons paramètres, un appel réussi, un résultat bien utilisé ? | Tool Selection, Tool Input Accuracy, Tool Call Success, Tool Output Utilization, Tool Call Accuracy (synthèse) ou Tool Use Quality (composite, preview) | query ou messages + tool_definitions |
| Trajectoire (orchestration) | Les étapes suivent-elles le chemin attendu ? | Task Navigation Efficiency (sans modèle juge, compare à expected_actions) |
actions ou messages, expected_actions |
| Prompts (instructions) | L'agent respecte-t-il ses règles et comprend-il l'intention ? | Task Adherence, Intent Resolution (preview), Rubric (critères pondérés, preview) | messages avec le system message |
| Memory | Se souvient-il de ce qu'il faut, oublie-t-il ce qu'il faut, sans fuite entre utilisateurs ? | Pas d'evaluator dédié : custom evaluator (code ou LLM) sur des scénarios multi-sessions | Conversations en plusieurs sessions et faits attendus |
| Résultat final | La tâche est-elle accomplie ? | Task Completion (preview, turn ou conversation), Customer Satisfaction (preview) | messages complets |
Le Document Retrieval se prête aux parameter sweeps : rejouer la même requête avec plusieurs réglages (vector ou semantic,
top_k, taille des chunks) et garder celui qui maximise NDCG. Les evaluators avec juge renvoient un score de 1 à 5 avec un seuil de
réussite par défaut de 3, les evaluators binaires renvoient Pass/Fail.
3.2 Les données d'évaluation#
| Source | Quand | Points clés |
|---|---|---|
| Golden dataset fait à la main | Toujours : c'est la référence de régression | Versionné, relu par des experts (section 2) |
| Synthetic data generation de Foundry | Avant la mise en production, trafic faible, cas limites | Deux types : Simple QnA (un tour) et Simulation seed (scénarios multi-tours qui alimentent un simulateur d'utilisateur) ; sources : définition d'agent, prompt, fichier de référence ; max_samples de 1 à 1 000 |
| Traces → dataset | Dès qu'il y a du trafic | Reflète le comportement réel ; complète le synthétique |
| Évaluer sur place | Réponses déjà stockées ou traces dans Application Insights | Pas besoin de dataset : évaluation par response ID ou sur les traces |
Bonnes pratiques officielles pour le synthétique : reprendre le system prompt de production, ancrer avec un fichier de
référence, générer d'abord un petit lot et le relire, régénérer quand les instructions changent (et versionner), écrire des
test_case_description précis pour les simulations. Le niveau d'évaluation se choisit avec evaluation_level : turn (une
réponse, avec les messages précédents comme contexte) ou conversation (l'échange entier).
3.3 Mise en œuvre : evaluators intégrés et evaluator de mémoire#
Évaluation locale avec le SDK azure-ai-evaluation (la même configuration se transpose en évaluation cloud avec
testing_criteria et builtin.<nom>, voir AI-300, chapitre 06) :
# Évaluer tools, prompts et mémoire sur un dataset JSONL (une conversation par ligne)
import os
from azure.ai.evaluation import (evaluate, IntentResolutionEvaluator, TaskAdherenceEvaluator,
                                 ToolCallAccuracyEvaluator)

model_config = {  # le modèle juge, authentifié par Microsoft Entra ID (aucune clé dans le code)
    "azure_endpoint": os.environ["AZURE_OPENAI_ENDPOINT"],
    "azure_deployment": os.environ["JUDGE_DEPLOYMENT"],
}


class MemoryRecallEvaluator:
    """Evaluator de code : le fait mémorisé en session 1 doit réapparaître en session 2, sans fait d'un autre utilisateur."""

    def __call__(self, *, response: str, expected_fact: str, forbidden_fact: str = "", **kwargs):
        rappel = expected_fact.lower() in response.lower()
        fuite = bool(forbidden_fact) and forbidden_fact.lower() in response.lower()
        return {"memory_recall": 1.0 if rappel else 0.0, "memory_leak": 1.0 if fuite else 0.0}


result = evaluate(
    data="tests/multi_session.jsonl",
    evaluators={
        "intent": IntentResolutionEvaluator(model_config=model_config),
        "adherence": TaskAdherenceEvaluator(model_config=model_config),
        "tools": ToolCallAccuracyEvaluator(model_config=model_config),
        "memory": MemoryRecallEvaluator(),
    },
    evaluator_config={"memory": {"column_mapping": {
        "response": "${data.response}",
        "expected_fact": "${data.expected_fact}",
        "forbidden_fact": "${data.forbidden_fact}"}}},
)
print(result["metrics"])
3.4 Les scénarios propres à la mémoire#
Foundry Agent Service distingue trois mémoires longues (preview) : user profile (préférences durables, à charger en début de conversation), chat summary (résumés des échanges précédents, à rechercher à chaque tour) et procedural (routines réutilisables). Les cas de test se déduisent de leur fonctionnement (extraction, consolidation, récupération) :
| Cas de test | Attendu | Ce qu'on détecte |
|---|---|---|
| Préférence donnée en session 1, question en session 2 | La préférence est appliquée | Extraction ou récupération ratée |
| Fait corrigé (« je ne suis plus allergique ») | La nouvelle valeur gagne | Consolidation qui garde l'ancien fait |
| Demande explicite d'oubli | Le fait n'est plus utilisé | Commande d'oubli non appliquée |
| Deux utilisateurs, même agent | Aucun fait de A chez B | Scope mal choisi (fuite de mémoire) |
Fait sensible exclu par user_profile_details |
Non mémorisé | Mémoire trop large (vie privée) |
| Fait plus vieux que le TTL du store | Plus rappelé | Rétention mal réglée |
3.5 Évaluer un prompt : versions et comparaison#
Un prompt d'agent se traite comme du code : versionné, évalué sur le même dataset que la version précédente, promu seulement si le score ne baisse pas (quality gate en CI, voir AI-300, chapitre 06). Dans un système multi-agents, changer le prompt de l'orchestrateur peut casser un sous-agent : lancer la suite complète (system et process evaluation) dès qu'un prompt, un modèle, un outil ou la base de connaissances change.
4. Optimiser la durée des tâches : parallélisme et limites de débit#
4.1 Trouver le chemin critique#
La durée d'un tour multi-agents est celle de son chemin critique, pas la somme de tous les appels. Le latency breakdown d'une trace (AI-103, chapitre 07) montre, span par span, si le temps part dans un modèle (jetons de sortie, reasoning), un outil (API lente), une file d'attente ou des 429 suivis de nouvelles tentatives.
| Levier | Effet | Attention |
|---|---|---|
| Paralléliser les sous-tâches indépendantes (motif concurrent, fan-out / fan-in) | Durée ≈ la plus longue branche | Plus d'appels simultanés = plus de 429 ; coût inchangé ou supérieur |
| Modèle plus petit pour les sous-agents simples, model router | Moins de latence par appel | Évaluer la qualité (AI-103, 07) |
| Réduire les jetons de sortie et l'effort de reasoning | Latence ≈ proportionnelle aux jetons générés | Réponses tronquées si trop court |
| Prompt caching (préfixe stable) | Moins de latence et de coût en entrée | Le préfixe doit être identique (AI-103, 07) |
| Streaming | Premier jeton plus tôt, durée totale identique | Perception seulement |
| Background mode, tâche asynchrone | Ne bloque pas l'appelant | Il faut sonder ou notifier |
Le piège des supersteps d'Agent Framework : les workflows s'exécutent en supersteps (modèle Pregel, Bulk Synchronous Parallel). Dans un superstep, tous les executors déclenchés tournent en parallèle, mais le workflow attend que tous finissent avant le superstep suivant. Si une branche enchaîne trois executors courts et l'autre un executor long, la branche courte attend le long à chaque barrière. Remède officiel : regrouper les étapes séquentielles d'une branche dans un seul executor.
4.2 Paralléliser sans saturer le quota#
Le débit d'un deployment est limité en TPM (jetons par minute) et RPM (requêtes par minute) ; au-delà, le service renvoie
429 avec retry-after-ms (détails dans AI-103, chapitre 03).
Avec plusieurs agents, il faut donc un parallélisme borné et des nouvelles tentatives qui respectent l'attente demandée :
# Fan-out borné vers plusieurs sous-agents : au plus 4 appels simultanés, 429 absorbés selon retry-after-ms
import asyncio
import random

from openai import RateLimitError

LIMITE = asyncio.Semaphore(4)  # à régler selon le TPM / RPM du deployment partagé


# clients : un client OpenAI asynchrone par agent, obtenu par project.get_openai_client(agent_name=...)
# (version asynchrone azure.ai.projects.aio), créé une fois au démarrage
async def appeler_sous_agent(clients: dict, agent_name: str, tache: str, essais: int = 4) -> str:
    async with LIMITE:
        for essai in range(essais):
            try:
                rep = await clients[agent_name].responses.create(input=tache)
                return rep.output_text
            except RateLimitError as e:
                attente_ms = int(e.response.headers.get("retry-after-ms", 1000 * 2 ** essai))
                await asyncio.sleep(attente_ms / 1000 + random.random())  # jitter : évite les vagues synchronisées
        raise RuntimeError(f"{agent_name} : quota encore saturé après {essais} essais")


async def fan_out(clients: dict, taches: dict[str, str]) -> dict[str, str]:
    resultats = await asyncio.gather(*(appeler_sous_agent(clients, a, t) for a, t in taches.items()),
                                     return_exceptions=True)  # une branche en échec ne fait pas tomber les autres
    return dict(zip(taches, resultats))
Au niveau de la plateforme : un deployment par classe de charge (temps réel, lot), des déploiements Global ou Data Zone pour plus de capacité, PTU pour une latence prévisible, et une AI gateway (Azure API Management) pour répartir la charge entre deployments et fixer un quota par consommateur (section 10). Les traitements différables passent en Batch ou en Flex processing (tarif réduit, latence non garantie).
5. Diagnostiquer les problèmes de fenêtre de contexte#
5.1 Les quatre pathologies nommées par l'examen#
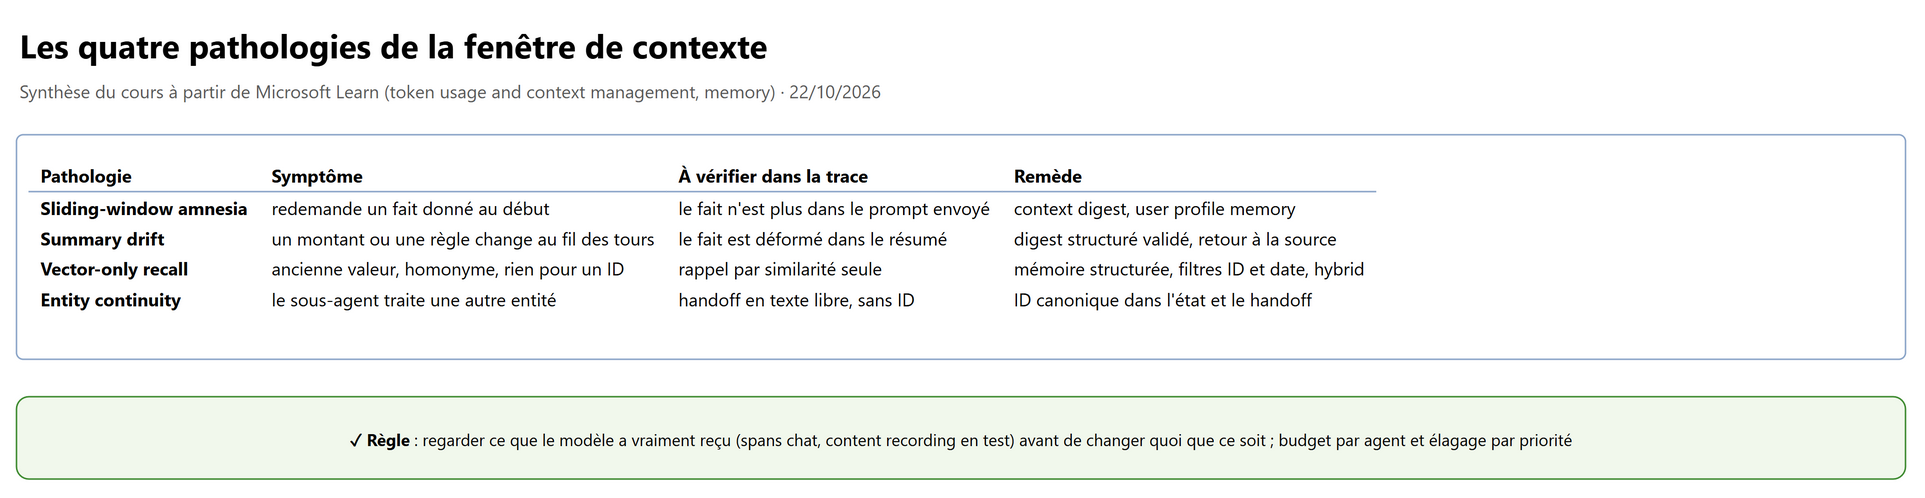
Le guide cite quatre problèmes sans que Microsoft Learn les définisse sous ces noms exacts. Les définitions ci-dessous sont une synthèse construite à partir de l'unité Learn Optimize token usage and context management (module Optimize multi-agent performance and cost in Microsoft Foundry : rolling window, digest, budgets) et de la documentation de la memory de Foundry Agent Service :
| Pathologie | Ce qui se passe | Symptôme typique | Cause |
|---|---|---|---|
| Sliding-window amnesia | La fenêtre glissante ne garde que les N derniers tours : un fait donné tôt sort du contexte | L'agent redemande le numéro de dossier donné au début | Fenêtre glissante seule, sans mémoire des faits anciens |
| Summary drift | Chaque résumé résume le résumé précédent : les détails s'érodent, des erreurs s'installent | Au 20e tour, le montant a changé ou une contrainte a disparu | Résumés en cascade sans vérification ni source |
| Vector-only recall | Seule une recherche vectorielle rappelle le passé : elle ramène ce qui ressemble à la question, pas ce qui est exact ou récent | Rappel d'une ancienne préférence au lieu de la nouvelle, d'un client homonyme, ou rien pour un identifiant | Pas de mémoire structurée (clé-valeur, profil, entités), pas de filtre par date ou par ID |
| Entity continuity issues | Une entité (client, ticket, commande) n'est pas suivie d'un agent à l'autre ou d'un tour à l'autre | Le sous-agent facturation travaille sur un autre client que l'orchestrateur ; « il » ne renvoie plus à la bonne personne | Handoff en texte libre, pas d'identifiant canonique transmis |
Les trois causes officielles de dérive du budget de jetons, selon la même unité, sont liées : context accumulation, conversation history bloat et tool result over-injection (résultats d'outils injectés en entier).
5.2 Arbre de diagnostic#
flowchart TD
    A["Réponse incohérente avec un fait donné plus tôt"] --> B{"Le fait est-il dans le prompt envoyé au modèle ?<br/>(trace, content recording en test)"}
    B -- Non --> C{"Sorti de la fenêtre glissante ?"}
    C -- Oui --> D["Sliding-window amnesia :<br/>digest clé-valeur ou user profile memory"]
    C -- Non --> E{"Présent mais déformé dans un résumé ?"}
    E -- Oui --> F["Summary drift :<br/>digest structuré, validation, retour à la source"]
    E -- Non --> G{"Rappel par recherche vectorielle seule ?"}
    G -- Oui --> H["Vector-only recall :<br/>mémoire structurée, filtres ID et date, hybrid search"]
    B -- Oui --> I{"Le fait vise-t-il la bonne entité ?"}
    I -- Non --> J["Entity continuity :<br/>ID canonique dans l'état partagé et le handoff"]
    I -- Oui --> K["Problème de prompt ou de modèle :<br/>Task Adherence, instructions"]
La règle : regarder ce que le modèle a vraiment reçu dans la trace (spans chat, attributs gen_ai.input.messages quand le
content recording est actif en environnement de test) avant de changer quoi que ce soit.
5.3 Les remèdes#
| Pathologie | Remède | Où c'est traité |
|---|---|---|
| Sliding-window amnesia | Context digest : faits clés en clé-valeur, toujours injectés ; importance filter qui garde les tours importants hors fenêtre ; user profile memory chargée en début de conversation | Unité Learn, chapitre 03 |
| Summary drift | Résumé structuré plutôt que libre ; un modèle léger vérifie que le résumé contient les faits du digest, sinon repli sur le contexte complet ; garder le lien vers la source | Unité Learn |
| Vector-only recall | Combiner mémoire structurée (profil, entités, état) et rappel sémantique ; filtres par identifiant et date ; hybrid search pour les codes et noms | Chapitre 03 |
| Entity continuity | Un identifiant canonique (ID client, ID ticket) dans l'état partagé du workflow et dans chaque message de handoff, jamais seulement un nom | Chapitre 05 |
| Dérive du budget | Budget par agent et élagage par priorité | Ci-dessous |
L'unité Learn propose un budget de contexte par agent (exemple : 2 000 jetons pour un agent de recherche simple, 4 000 pour un agent de raisonnement, 8 000 pour l'interprétation de règles complexes) et un élagage par priorité : on garde d'abord le system prompt, puis le digest, puis les résultats d'outils compressés, puis les tours importants, et enfin la fenêtre glissante (3 derniers tours, filtre d'importance au seuil de 0,75 dans l'exemple). Chaque dépassement de budget est journalisé : c'est le premier indicateur de ces pathologies.
# Assembler le contexte d'un agent sous budget, par priorité décroissante (d'après l'unité Learn)
import logging
import tiktoken

ENC = tiktoken.get_encoding("o200k_base")
BUDGETS = {"recherche": 2000, "raisonnement": 4000, "regles": 8000}


def jetons(texte: str) -> int:
    return len(ENC.encode(texte))


def assembler_contexte(agent: str, system: str, digest: str, outils: list[str], importants: list[str],
                       fenetre: list[str]) -> list[str]:
    budget, morceaux = BUDGETS[agent], []
    for bloc in [system, digest, *outils, *importants, *fenetre[-3:]]:  # ordre = priorité
        if jetons(bloc) > budget:
            logging.warning("budget de contexte dépassé pour %s : bloc élagué", agent)  # signal à surveiller
            continue
        morceaux.append(bloc)
        budget -= jetons(bloc)
    return morceaux
6. L'amélioration continue#
6.1 La boucle#
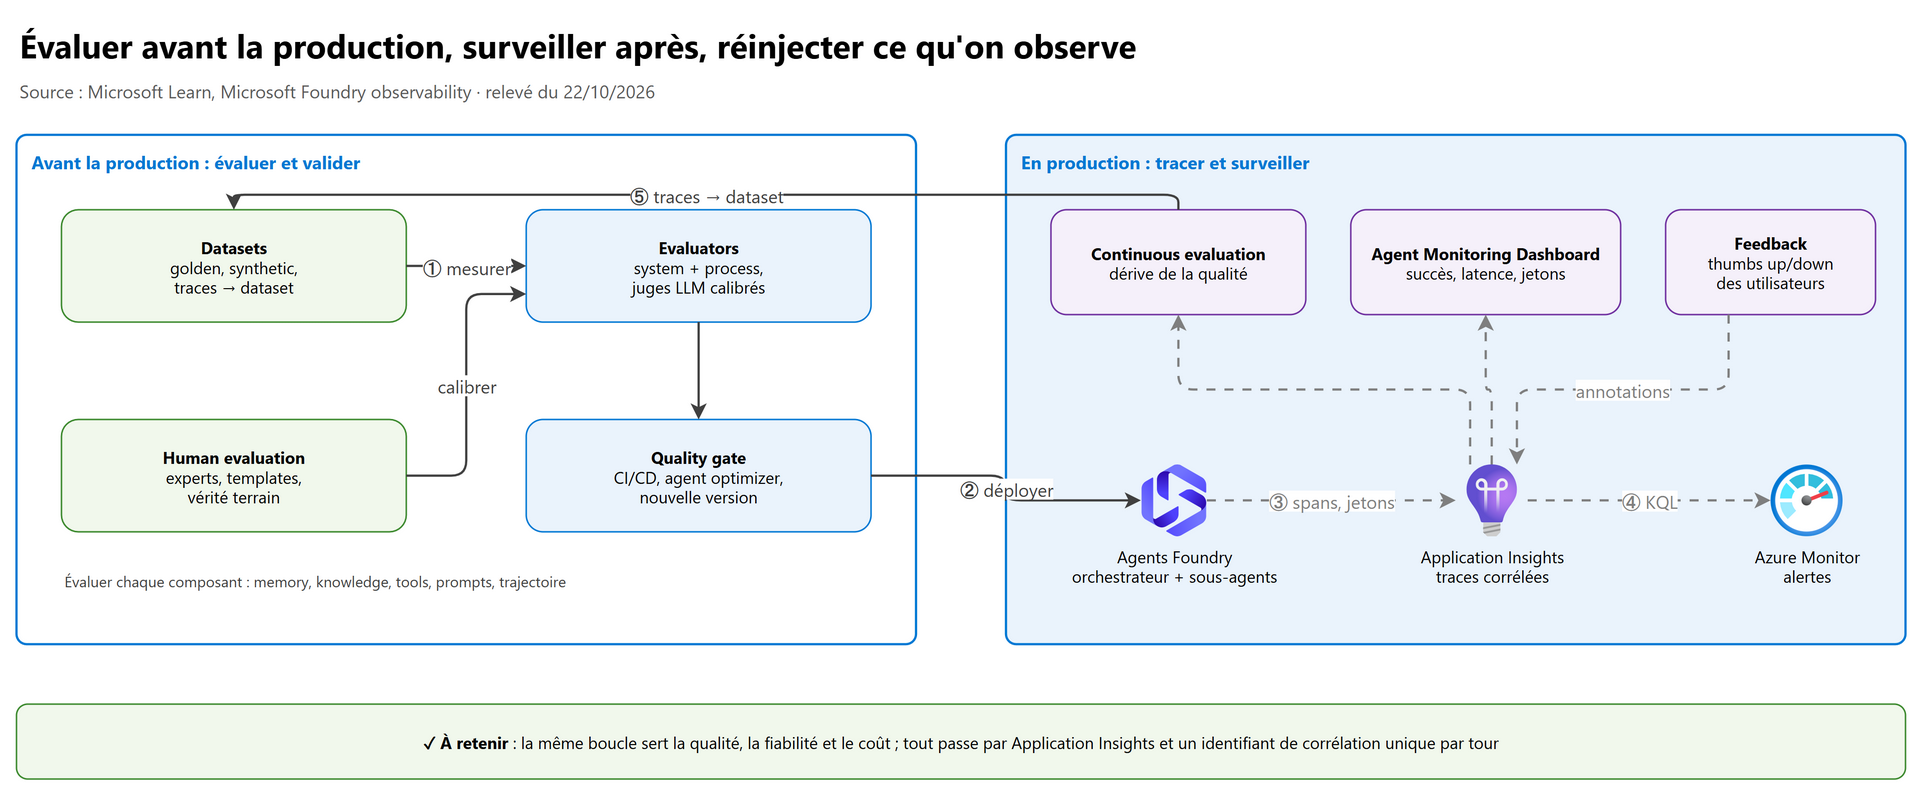
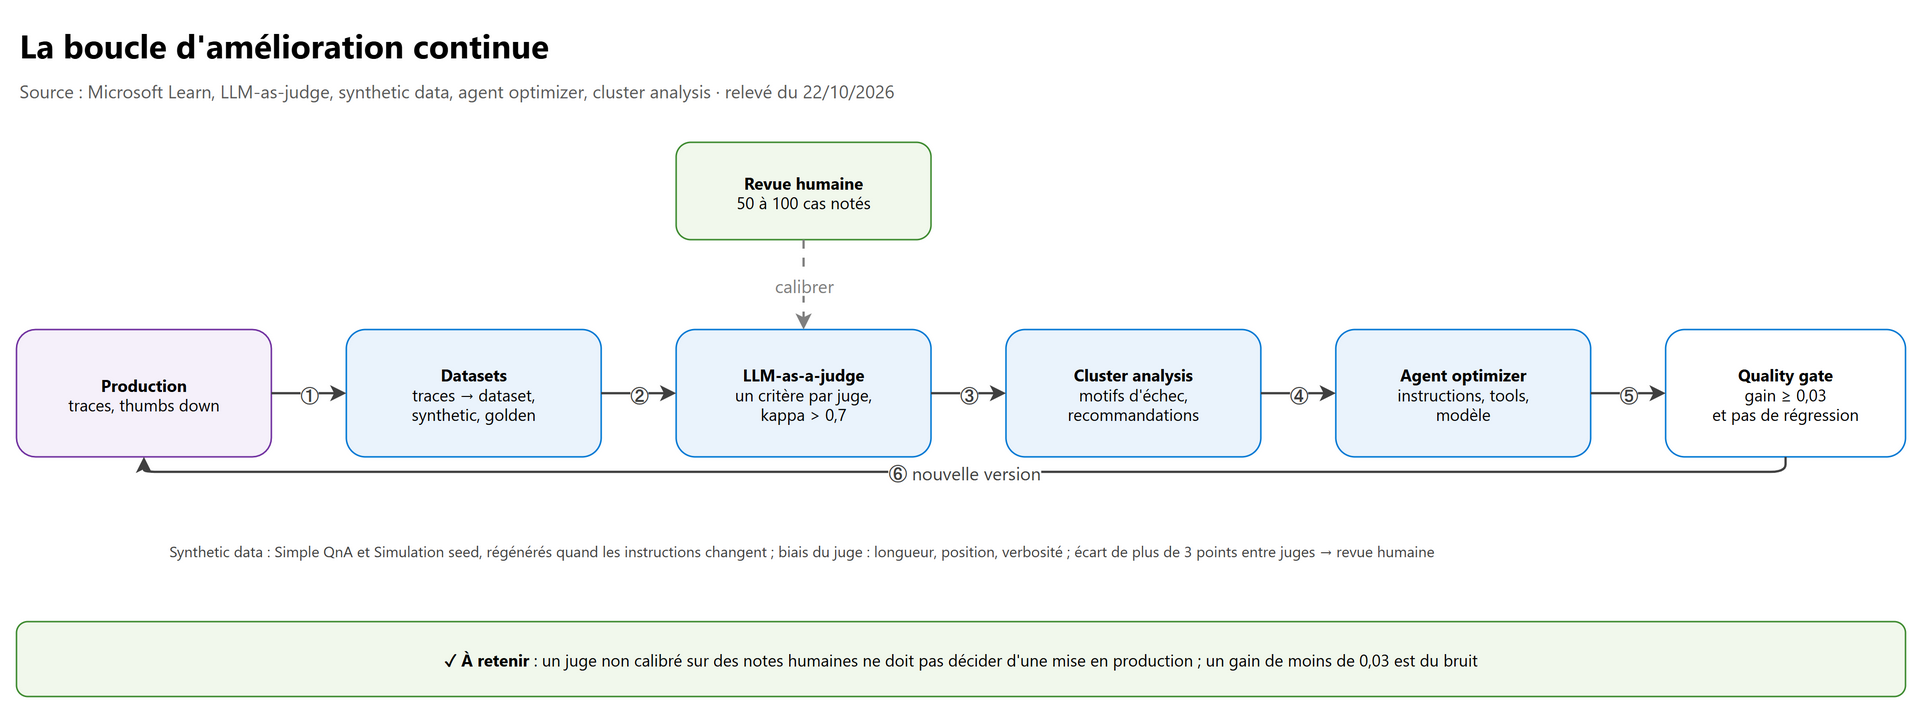
Les quatre éléments du guide (LLM-as-a-judge, synthetic data, semantic optimization loops, user feedback loops) forment une seule boucle : le feedback et les traces signalent un problème ; les datasets (réels et synthétiques) le reproduisent ; les juges le mesurent ; l'analyse et l'optimiseur proposent une correction ; le quality gate empêche la régression ; la production réalimente la boucle.
6.2 LLM-as-a-judge : concevoir un juge fiable#
L'unité Learn Implement LLM-as-judge evaluation for multi-agent systems (module Design evaluation frameworks for multi-agent solutions with Microsoft Foundry) pose les règles suivantes :
| Règle | Détail |
|---|---|
| Un juge par critère | Exactitude factuelle, accomplissement de la tâche, ton, cohérence : des juges spécialisés plutôt qu'un juge qui note tout |
| Prompt de juge en 4 parties | Rubric (barème avec exemples par niveau), contexte (question, sources), critère unique, format de sortie structuré (score + justification) |
| Biais à neutraliser | Length bias (préférer la réponse longue), position bias (préférer la première de deux réponses), verbosity bias ; remèdes : barème explicite, inverser l'ordre, réponses de longueurs variées dans la calibration |
| Calibration | Comparer le juge à 50 à 100 exemples notés par des humains ; viser un Cohen's kappa > 0,7 ; dans l'exemple de l'unité, réviser la rubric fait passer le kappa de 0,62 à 0,78 |
| Consensus | Plusieurs juges (ou modèles) ; si les scores divergent de plus de 3 points, envoyer le cas en revue humaine |
| Recalibrer | À chaque changement de modèle juge ou de rubric |
Côté Foundry, trois façons de brancher un juge : les evaluators intégrés (ils sont des juges LLM, réglés par Microsoft), les Rubric evaluators (preview, critères pondérés, score normalisé de 0 à 1) et les custom evaluators (prompt ou code).
# Juge spécialisé « respect de la politique de remboursement », avec rubric explicite et sortie JSON
import json

from openai import AzureOpenAI

RUBRIC = """Tu es un évaluateur. Critère unique : la réponse respecte-t-elle la politique fournie ?
5 = conforme et cite la règle ; 4 = conforme sans citer ; 3 = conforme mais imprécise ;
2 = un écart mineur ; 1 = contraire à la politique. La longueur ne compte pas.
Réponds en JSON : {"score": <1-5>, "raison": "<une phrase>"}"""


class PolicyJudge:
    def __init__(self, client: AzureOpenAI, deployment: str):
        self.client, self.deployment = client, deployment

    def __call__(self, *, query: str, response: str, context: str, **kwargs) -> dict:
        r = self.client.chat.completions.create(
            model=self.deployment,
            temperature=0,  # juge reproductible (sans effet sur un reasoning model)
            response_format={"type": "json_object"},
            messages=[{"role": "system", "content": RUBRIC},
                      {"role": "user", "content": f"Politique :\n{context}\n\nQuestion :\n{query}\n\nRéponse :\n{response}"}],
        )
        resultat = json.loads(r.choices[0].message.content)
        return {"policy_score": resultat["score"], "policy_reason": resultat["raison"]}
La calibration se mesure en comparant les scores du juge aux notes humaines de la section 2 (par exemple avec
sklearn.metrics.cohen_kappa_score sur les deux listes de notes).
6.3 Synthetic data generation#
Le synthétique sert à couvrir ce que la production ne montre pas encore : prélancement, cas limites, base de régression stable qui ne dérive pas avec le trafic. Il ne remplace ni les traces réelles ni la vérité terrain humaine : Microsoft recommande de combiner synthétique et traces. Les simulations multi-tours (Simulation seed) sont l'outil naturel du multi-agents : un simulateur joue l'utilisateur, les evaluators au niveau conversation notent l'échange entier.
6.4 Semantic optimization loops#
Ce que le guide appelle « boucle d'optimisation sémantique » couvre deux réalités, à ne pas confondre :
| Boucle hors ligne (optimiser l'agent) | Boucle à l'exécution (améliorer une réponse) | |
|---|---|---|
| Outil | Agent optimizer de Foundry, cluster analysis (preview) | AgentLoopMiddleware.with_judge (Agent Framework, Python, expérimental), boucle generator-critic |
| Ce qui change | Instructions, skills, descriptions d'outils, choix du modèle | La réponse du tour en cours |
| Quand | Avant une nouvelle version | À chaque requête qui le justifie |
| Coût | Une campagne d'évaluation (estimation affichée avant lancement) | Un ou plusieurs appels de juge par tour : à borner |
L'agent optimizer génère des candidats (instructions, skills, descriptions d'outils, modèle) et les évalue sur un dataset avec vos evaluators ; un eval model note, un optimization model propose. Le score composite (moyenne des scores ramenés entre 0 et 1) s'interprète ainsi : gain < 0,03 = bruit ; 0,03 à 0,10 = modéré, à déployer ; 0,10 à 0,20 = significatif ; > 0,20 = majeur (souvent un point de départ faible). Les instructions optimisées sont souvent plus longues : vérifier que le gain justifie les jetons en plus. Si tous les candidats font moins bien que la base, garder l'agent actuel. Pour un prompt agent, le candidat retenu devient une nouvelle version de l'agent.
La cluster analysis regroupe les échecs d'une évaluation par similarité sémantique, propose une cause et des recommandations ; le résultat n'est pas stocké (télécharger le CSV). La boucle à l'exécution, elle, est décrite dans AI-103, chapitre 07 (generator-critic) et doit toujours avoir un plafond d'itérations (section 9).
6.5 User feedback loops#
Le thumbs down d'un utilisateur ne corrige rien tant qu'il ne rejoint pas la boucle :
flowchart LR
    U["Thumbs down<br/>(end_user)"] --> K["KQL : traces<br/>notées négativement"]
    K --> R["Revue humaine<br/>(template actif)"]
    R --> D["Cas ajouté au<br/>dataset versionné"]
    D --> E["Évaluation +<br/>cluster analysis"]
    E --> O["Correction ou<br/>agent optimizer"]
    O --> G{"Quality gate"}
    G -- OK --> P["Nouvelle version<br/>en production"]
    G -- KO --> O
    P --> U
Le taux de feedback négatif par agent (KQL de la section 2.4) devient un indicateur suivi, avec une alerte quand il dépasse sa moyenne habituelle.
7. Surveiller la fiabilité#
7.1 Les six signaux du guide#
| Signal | Comment le mesurer | Où | Remédiation typique |
|---|---|---|---|
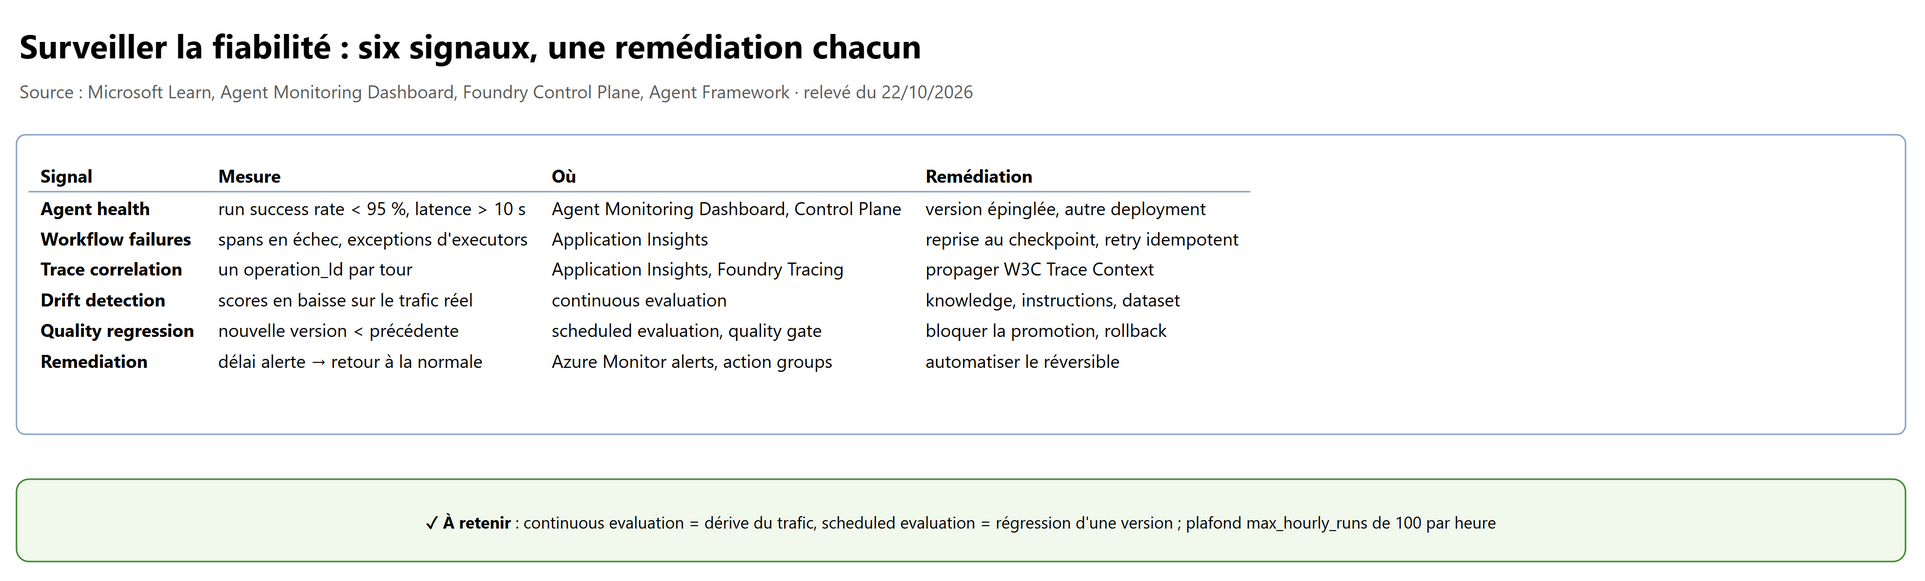
| Agent health | Run success rate (investiguer < 95 %), latence (au-delà de 10 s : throttling, outils, réseau), erreurs par agent | Agent Monitoring Dashboard (onglet Monitor de l'agent) ; parc entier dans Foundry Control Plane (Operate > Assets) ; vue Agents (Preview) d'Application Insights | Revenir à une version épinglée, basculer de modèle ou de deployment |
| Workflow failures | Spans en échec (success == false), exceptions d'executors, checkpoints non repris |
Application Insights (dependencies, exceptions), événements du workflow |
Reprise depuis le dernier checkpoint, nouvelle tentative idempotente |
| Trace correlation | Un operation_Id commun à tous les spans du tour, gen_ai.conversation.id pour la session |
Section 11 | Sans corrélation, pas de diagnostic : à corriger en premier |
| Drift detection | Scores des evaluators qui baissent dans le temps sur le trafic réel, distribution des intentions qui change | Continuous evaluation (échantillonnage du trafic) | Mettre à jour la knowledge, les instructions, le dataset |
| Quality regression | Score d'une nouvelle version inférieur à la précédente sur le même dataset | Scheduled evaluation sur golden dataset, quality gate en CI | Bloquer la promotion, rollback |
| Remediation | Délai entre l'alerte et le retour à la normale | Alertes Azure Monitor, action groups, runbooks | Automatiser ce qui est sûr, humain pour le reste |
Les recurring evaluations existent en deux types : scheduled (calendrier fixe, souvent sur un golden dataset : régression)
et continuous (échantillonnage du trafic en direct, aléatoire ou intelligent sampling : dérive). Une règle continue est
plafonnée par max_hourly_runs (100 par heure par défaut) : au-delà, les évaluations sont sautées. Détails de configuration
dans AI-300, chapitre 06.
7.2 Où regarder#
| Outil | Pour qui | Ce qu'il apporte |
|---|---|---|
| Agent Monitoring Dashboard (Foundry) | Équipe de l'agent | Token usage, latency, run success rate, scores d'évaluation, résultats de red teaming ; réglages : recurring evaluations, red team scans, alerts (preview) |
| Foundry Control Plane | Plateforme, gouvernance | Tous les agents de l'abonnement, y compris agents externes enregistrés via AI Gateway et instrumentés en OpenTelemetry vers le même Application Insights |
| Application Insights, Agents (Preview) | Exploitation | Traces d'agents, erreurs GenAI, tri par « Most tokens used », vue End-to-end transaction details simplifiée |
| Azure Managed Grafana | Exploitation | Tableaux prêts : Agent Framework, Agent Framework workflow, Foundry |
| Azure Monitor alerts | Astreinte | Alertes sur métriques ou sur requêtes KQL, action groups |
7.3 Concevoir la remédiation#
flowchart TD
    A["Alerte : run success rate < 95 %<br/>ou score d'évaluation en baisse"] --> B["Ouvrir les traces en échec<br/>(même operation_Id)"]
    B --> C{"Première divergence ?"}
    C -- "Modèle : 429, timeout" --> D["Capacité : autre deployment,<br/>spillover, PTU, réduire le parallélisme"]
    C -- "Outil : erreur, latence" --> E["Circuit breaker, fallback,<br/>désactiver l'outil (allowed_tools)"]
    C -- "Qualité : réponse fausse" --> F["Rollback vers la version épinglée<br/>puis évaluation et correction"]
    C -- "Workflow : étape bloquée" --> G["Reprise depuis le checkpoint"]
    D & E & F & G --> H["Ajouter le cas au dataset de régression"]
Une remédiation automatique se limite aux actions sûres et réversibles (basculer de deployment, couper un outil, revenir à une version épinglée) ; changer des instructions reste une décision humaine, validée par l'évaluation.
8. Disponibilité, performance et respect des SLA#
8.1 Du SLA Azure au SLO de la solution#
Les SLA de Microsoft couvrent chaque service (Foundry, Azure AI Search, Cosmos DB, Functions…), jamais votre agent. Pour la solution, on définit ses propres SLO et on les mesure :
| SLI (indicateur) | SLO (exemple) | Source |
|---|---|---|
| Disponibilité du point d'entrée | 99,9 % des requêtes sans erreur serveur sur 30 jours | Application Insights (requests), availability tests |
| Taux de succès des runs d'agent | ≥ 95 % | Agent Monitoring Dashboard |
| Latence de bout en bout | p95 < 8 s pour un tour simple | Durée du span racine |
| Qualité | ≥ 90 % de Task Completion pass sur le trafic échantillonné | Continuous evaluation |
| Fraîcheur de la knowledge | Index rafraîchi en moins de 24 h | Indexer, knowledge source |
Le SLA composite d'une chaîne de services en série est au mieux le produit des SLA de chacun : plus il y a de services indispensables sur le chemin, plus la disponibilité théorique baisse. On le remonte par la redondance (deux régions, plusieurs deployments derrière une AI gateway) et en rendant certains composants non bloquants (un outil secondaire indisponible ne doit pas faire échouer le tour). Rappel : une fonctionnalité en preview n'a pas de SLA ; un SLO qui en dépend doit le dire.
8.2 Surveiller la plateforme#
| Couche | Signal | Outil |
|---|---|---|
| Services Azure | Incidents, maintenance | Azure Service Health, Resource Health |
| Modèles | 429, latence, jetons, utilisation PTU | Metrics Azure Monitor du deployment (AI-103, 03) |
| Agents | Succès, latence, erreurs GenAI | Agent Monitoring Dashboard, Application Insights |
| Outils (MCP, API, Functions) | Disponibilité, latence, erreurs | Application Insights de chaque service, availability tests |
| Données | Échecs d'indexation, latence de recherche | Metrics et logs d'Azure AI Search |
9. Optimiser l'usage des jetons : limites, boucles et appels d'outils#
9.1 Les contrôles disponibles#
| Niveau | Contrôle | Valeur à connaître |
|---|---|---|
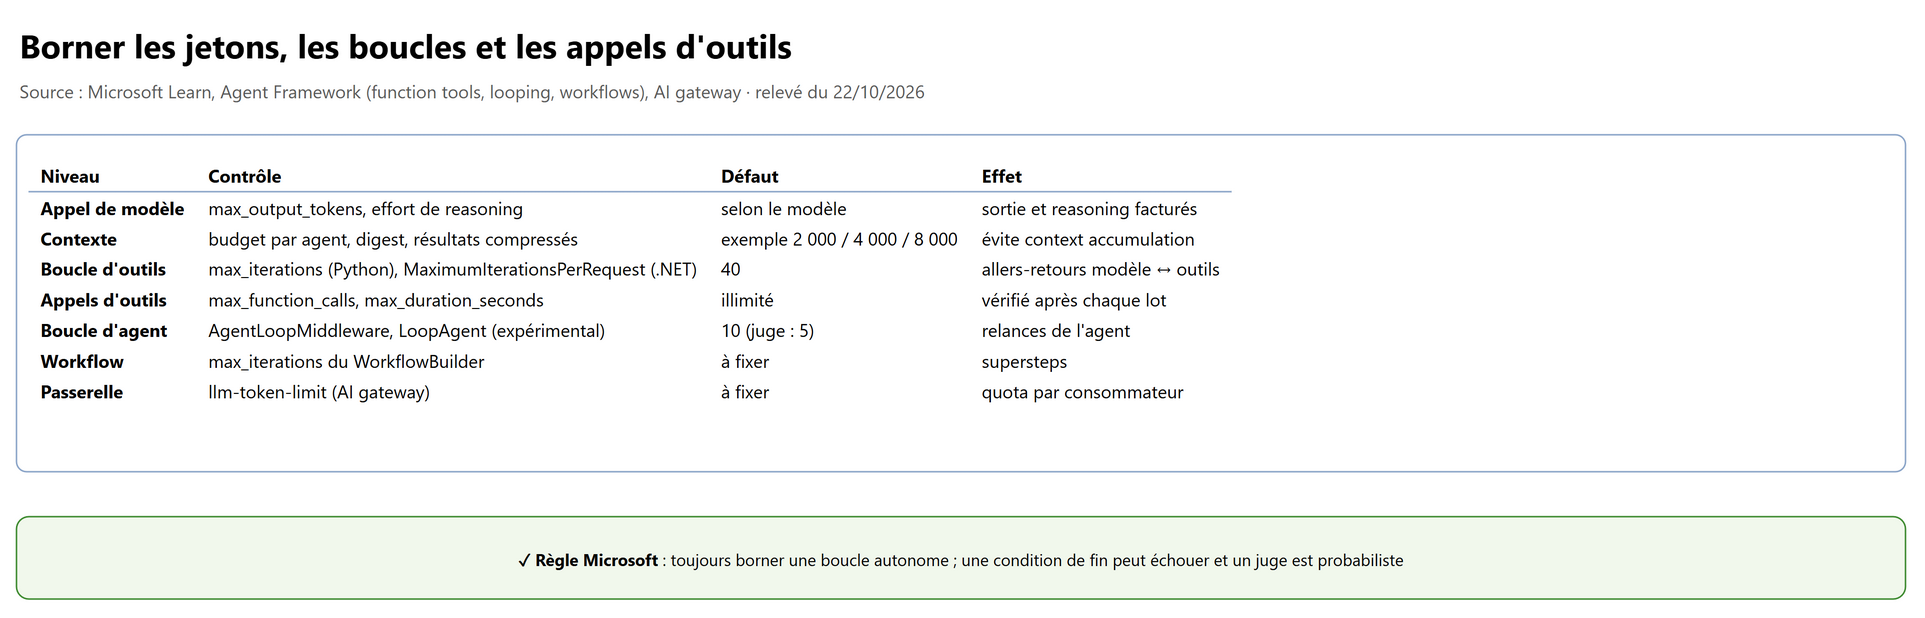
| Appel de modèle | max_output_tokens (Responses API), effort de reasoning |
Les jetons de reasoning sont facturés comme sortie |
| Contexte | Budget par agent, digest, compression des résultats d'outils (section 5.3) | Exemple Learn : 2 000 / 4 000 / 8 000 |
| Boucle d'appels d'outils (Agent Framework) | max_iterations de FunctionInvocationConfiguration (Python) ou MaximumIterationsPerRequest (.NET) |
40 allers-retours par défaut |
| Appels d'outils (Python) | max_function_calls, max_duration_seconds |
Illimités par défaut ; vérifiés après chaque lot d'appels, donc dépassement possible d'un lot |
| Boucle d'agent | AgentLoopMiddleware(max_iterations=…) (Python), LoopAgent avec LoopAgentOptions.MaxIterations (.NET), expérimental |
10 par défaut, 5 pour une boucle avec juge |
| Workflow | max_iterations du WorkflowBuilder |
Compte aussi le superstep de l'executor de départ (depuis 1.13.0) |
| Passerelle | AI gateway d'API Management : llm-token-limit (jetons par minute, quota par période et par clé) |
Coupe au niveau du consommateur, pas de l'agent |
Microsoft insiste : toujours borner une boucle autonome ; une condition de fin peut échouer, un modèle peut tourner en rond, un
juge est probabiliste. max_iterations=None seulement si la condition de fin est garantie.
# Agent Framework (Python) : borner la boucle d'outils et la boucle d'agent
from agent_framework import Agent, AgentLoopMiddleware

client.function_invocation_configuration.update({
    "max_iterations": 8,        # au lieu de 40 allers-retours
    "max_function_calls": 20,   # plafond d'appels d'outils par requête
})


def reste_a_faire(*, last_result, **kwargs):
    return "DONE" not in last_result.text  # condition de fin explicite


agent = Agent(client=client, tools=[rechercher_dossier, calculer_montant],
              middleware=[AgentLoopMiddleware(reste_a_faire, max_iterations=3)])
9.2 Les appels d'outils, source cachée de jetons#
Chaque appel d'outil renvoie un résultat réinjecté dans le contexte, puis tout le contexte repart au modèle à l'aller-retour suivant : dix appels, c'est dix fois l'historique. Les leviers :
- exposer moins d'outils à chaque agent (les définitions d'outils sont des jetons d'entrée à chaque appel) :
allowed_tools, outils par sous-agent plutôt qu'une toolbox géante ; - renvoyer des résultats courts et structurés (champs utiles, pagination), compresser ou résumer les gros résultats avant réinjection ;
- évaluer Tool Selection et Task Navigation Efficiency : un appel inutile est un coût mesurable ;
- mettre en cache les résultats d'outils déterministes (chapitre 05).
9.3 Mesurer les jetons par agent#
// Jetons par agent et par opération GenAI sur 24 h (attributs gen_ai.* des spans dans customDimensions)
dependencies
| where timestamp > ago(24h)
| where customDimensions has "gen_ai.usage.input_tokens"
| extend agent = tostring(customDimensions["gen_ai.agent.name"]),
         operation = tostring(customDimensions["gen_ai.operation.name"]),
         modele = tostring(customDimensions["gen_ai.request.model"]),
         entree = toint(customDimensions["gen_ai.usage.input_tokens"]),
         sortie = toint(customDimensions["gen_ai.usage.output_tokens"])
| summarize appels = count(), jetons_entree = sum(entree), jetons_sortie = sum(sortie),
            tours = dcount(operation_Id) by agent, modele, operation
| extend jetons_par_tour = (jetons_entree + jetons_sortie) / tours
| order by jetons_par_tour desc
Les noms d'attributs évoluent avec les SDK : découvrir ceux réellement présents avec la requête de la section 9.3 du chapitre 06 d'AI-300.
10. Surveiller et piloter les coûts : usage, quotas, allocations, chargeback#
10.1 Les quatre mots du guide#
| Mot | Ce que c'est dans Azure | Outil |
|---|---|---|
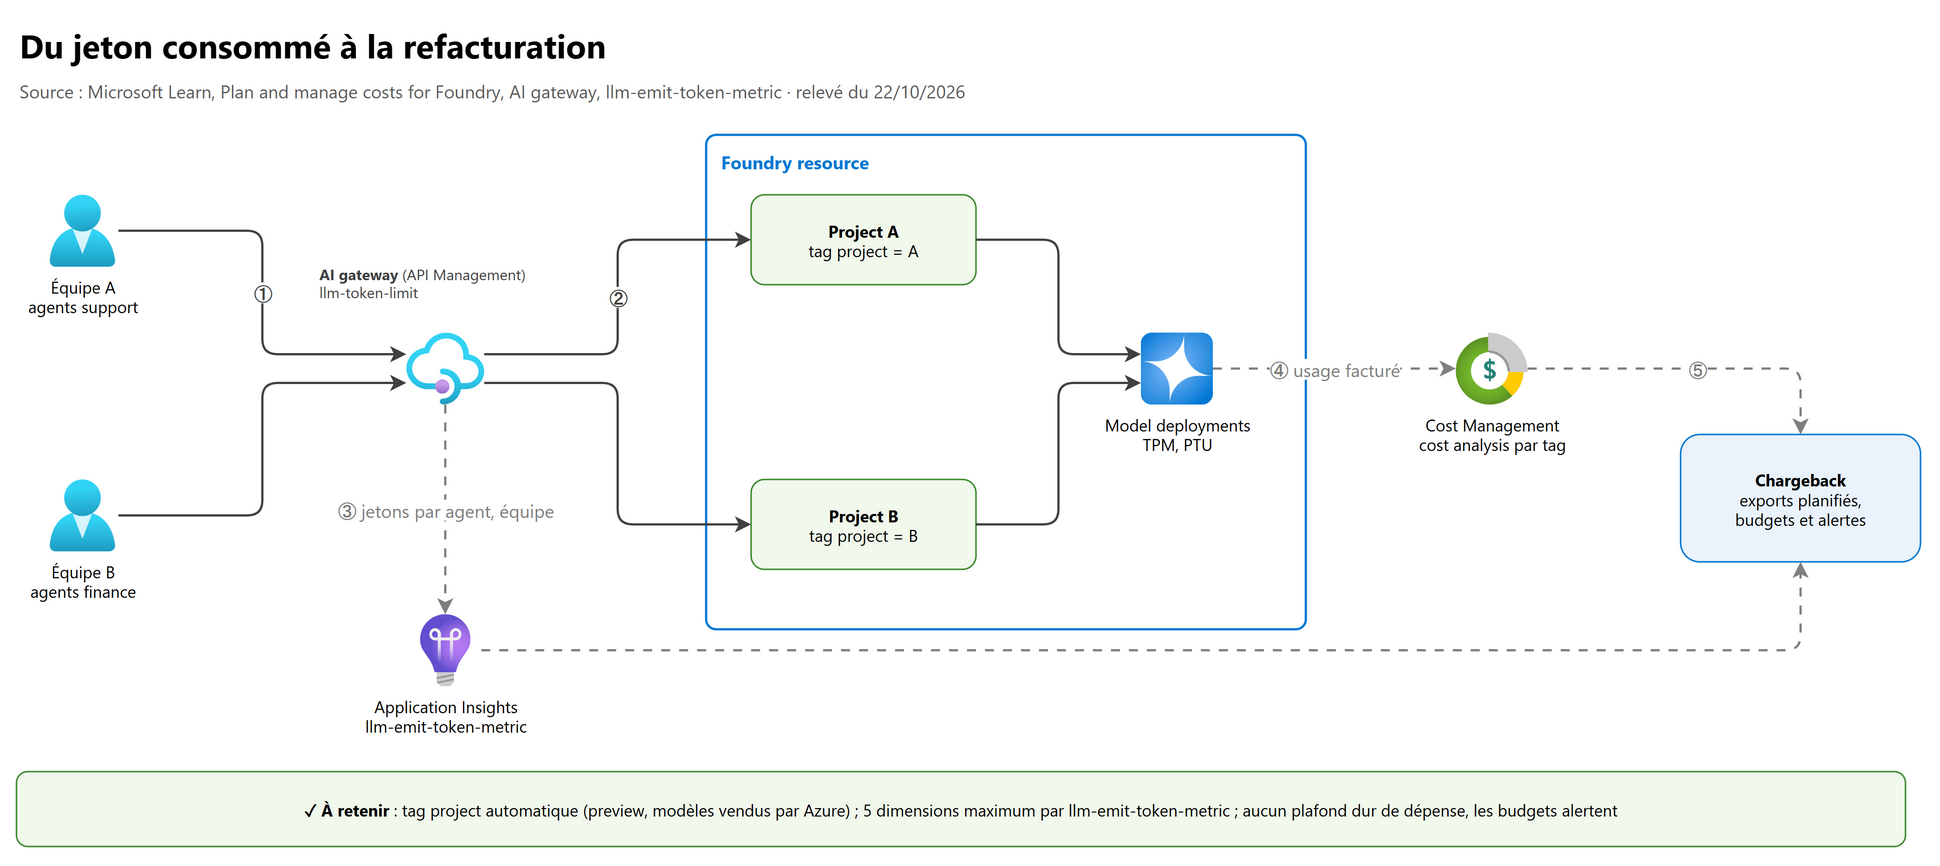
| Usage | Jetons d'entrée, de sortie et en cache, par modèle et par meter de facturation | Cost analysis groupé par Meter ; traces (section 9.3) |
| Quotas | TPM par abonnement, région, modèle et type de déploiement, réparti entre deployments ; lecture avec Cognitive Services Usages Reader sur l'abonnement | Page Quota de Foundry (AI-103, 03) |
| Allocations | Qui a droit à quoi : TPM par deployment, PTU réservés, quota de jetons par consommateur à la passerelle | Deployments, réservations, llm-token-limit |
| Chargeback (ou showback) | Refacturer le coût à l'équipe ou au métier qui l'a consommé | Tag project, dimensions de llm-emit-token-metric, exports Cost Management |
10.2 Attribuer le coût#
Trois niveaux de granularité, du plus simple au plus fin :
- Par project Foundry (preview) : chaque project est tagué automatiquement
projectsur son usage. Dans Cost analysis de la Foundry resource, filtre Tag >project. Aucun tag à poser. Limite : uniquement les modèles vendus par Azure (Azure OpenAI compris), pas encore ceux d'Azure Marketplace. - Par deployment ou ressource : Cost by resource, tags de deployment ou tags utilisateur ; au niveau de l'abonnement, Azure OpenAI se filtre par Service tier: Azure OpenAI (il est rangé sous Cognitive Services).
- Par consommateur, agent ou utilisateur : la policy
llm-emit-token-metricde l'AI gateway envoie les jetons consommés vers Application Insights avec des dimensions (au plus 5 dimensions personnalisées par policy, 100 valeurs par dimension, 1 000 séries actives par namespace ; au-delà, les données sont ignorées sans erreur).
<!-- Policy d'API Management (inbound) : jetons consommés par agent et par équipe, pour le chargeback -->
<llm-emit-token-metric namespace="llm-chargeback">
    <dimension name="API ID" value="@(context.Api.Id)" />
    <dimension name="Agent" value="@(context.Request.Headers.GetValueOrDefault("x-agent-name", "inconnu"))" />
    <dimension name="Equipe" value="@(context.Request.Headers.GetValueOrDefault("x-cost-center", "inconnu"))" />
</llm-emit-token-metric>
Prérequis : Application Insights intégré à API Management et Custom metrics (Preview) with dimensions activé dans Application Insights. Choisir des dimensions à faible cardinalité (agent, équipe, centre de coût) et non l'ID utilisateur si les utilisateurs sont nombreux : la limite de 100 valeurs ferait perdre des données.
10.3 Piloter#
- Budgets et alertes de Cost Management par abonnement ou groupe de ressources, avec filtres. Il n'existe pas de plafond dur de dépense pour Azure OpenAI : une action group peut déclencher une automatisation, à développer.
- Exports planifiés des coûts vers un storage account pour la refacturation (Excel, Power BI).
- Rapprocher l'estimation (Azure pricing calculator) et les meters réels sur un petit trafic de test, avant de fixer les budgets.
- La facture et les meters font foi : un code HTTP d'erreur ne dit pas à lui seul si la requête a été facturée.
- Leviers d'économie : modèle plus petit ou model router, prompt caching, Batch et Flex processing pour le différable, PTU si la charge est stable, bornes de la section 9 ; ne pas oublier l'hébergement horaire d'un modèle fine-tuné déployé, facturé même sans trafic, et le coût des évaluations elles-mêmes (chaque juge est un appel de modèle).
11. Le tracing dans Foundry#
11.1 Server-side ou client-side#
| Server-side tracing | Client-side tracing | |
|---|---|---|
| Activation | Connecter Application Insights au project : rien à coder | SDK azure-ai-projects + OpenTelemetry (azure-monitor-opentelemetry) dans votre code |
| Couvre | Prompt agents, hosted agents et workflows hébergés dans Foundry | Votre code autour de l'agent, frameworks (Agent Framework, Semantic Kernel natifs ; LangChain / LangGraph via le distro Microsoft OpenTelemetry), agents hébergés ailleurs |
| Rétention dans le portail | Traces des 90 derniers jours | Celle d'Application Insights |
| Statut | GA pour prompt et hosted agents ; workflows et agents externes en preview | Preview dans la doc client-side |
Commencer par le server-side, ajouter le client-side quand il faut voir sa propre logique (routage, appels d'outils locaux).
11.2 Ce que contient une trace : tokens, prompts, exécution#
Les spans suivent les OpenTelemetry GenAI semantic conventions :
Span (gen_ai.operation.name) |
Rôle | Attributs utiles |
|---|---|---|
invoke_agent |
Un agent (ou un nœud LangGraph) est appelé | gen_ai.agent.name, gen_ai.agent.id, gen_ai.conversation.id |
chat |
Un appel de modèle | gen_ai.request.model, gen_ai.usage.input_tokens, gen_ai.usage.output_tokens, gen_ai.response.id |
execute_tool |
Un appel d'outil (ou une récupération) | gen_ai.tool.name, arguments et résultat si content recording |
Les prompts et réponses (gen_ai.input.messages, gen_ai.output.messages) n'apparaissent que si le content recording
est activé : utile en développement, à désactiver en production sauf exigence de conformité, car ils peuvent contenir des
données personnelles. Ne jamais mettre de secret dans un prompt, un argument d'outil ou un attribut de span.
| Variable d'environnement | Défaut | Rôle |
|---|---|---|
AZURE_EXPERIMENTAL_ENABLE_GENAI_TRACING |
false |
Active l'instrumentation GenAI (Python, C#) |
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT |
false |
Capture prompts, réponses et arguments d'outils |
AZURE_TRACING_GEN_AI_ENABLE_TRACE_CONTEXT_PROPAGATION |
true si le tracing est actif |
Injecte les en-têtes W3C Trace Context dans les requêtes |
AZURE_TRACING_GEN_AI_TRACE_CONTEXT_PROPAGATION_INCLUDE_BAGGAGE |
false |
Ajoute l'en-tête baggage (risque de fuite de données) |
AZURE_TRACING_GEN_AI_INSTRUMENT_RESPONSES_API |
true |
Instrumente automatiquement Responses et Conversations |
OTEL_SERVICE_NAME |
(aucun) | Nom du service, visible dans cloud_RoleName : distingue les applications d'un même Application Insights |
# Client-side tracing : un span racine par tour, qui englobe tous les agents appelés
import os

os.environ["AZURE_EXPERIMENTAL_ENABLE_GENAI_TRACING"] = "true"   # avant les imports du SDK
os.environ["OTEL_SERVICE_NAME"] = "orchestrateur-remboursement"

from azure.ai.projects import AIProjectClient
from azure.identity import DefaultAzureCredential
from azure.monitor.opentelemetry import configure_azure_monitor
from opentelemetry import trace

with (DefaultAzureCredential() as cred,
      AIProjectClient(endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"], credential=cred) as project):
    configure_azure_monitor(connection_string=project.telemetry.get_application_insights_connection_string())
    tracer = trace.get_tracer(__name__)

    with tracer.start_as_current_span("tour-remboursement") as span:
        span.set_attribute("app.dossier_id", dossier_id)  # identifiant métier, jamais de donnée sensible
        with project.get_openai_client(agent_name="orchestrateur") as openai:
            reponse = openai.responses.create(input=question)
            span.set_attribute("app.response_id", reponse.id)  # pour corréler le feedback (section 2.3)
11.3 Les identifiants de corrélation#
| Identifiant | Portée | Usage |
|---|---|---|
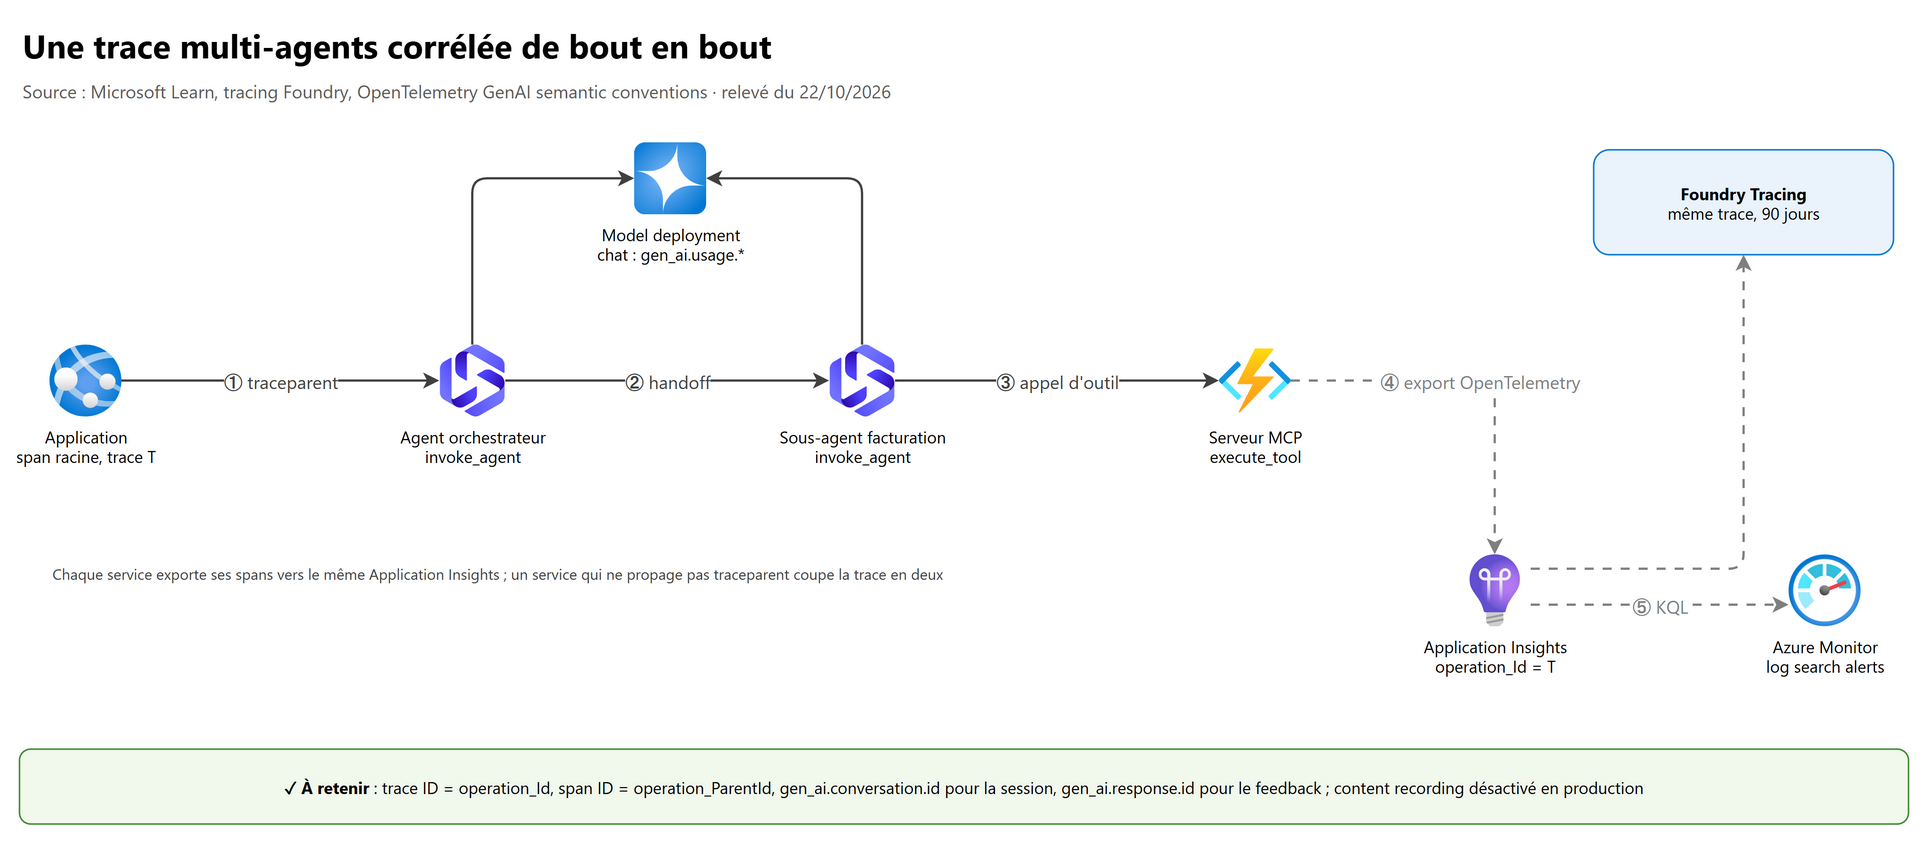
Trace ID = operation_Id dans Application Insights |
Un tour, tous services confondus | Ouvrir l'End-to-end transaction details, joindre spans, exceptions et annotations |
Span ID = operation_ParentId des enfants |
Une étape | Annoter un span précis, retrouver le parent d'un appel d'outil |
gen_ai.conversation.id |
Une conversation (plusieurs tours) | Suivre une session, relier les tours |
gen_ai.response.id |
Une réponse de modèle | Relier le feedback utilisateur à la réponse |
Identifiants métier (app.dossier_id) |
Votre domaine | Retrouver toutes les traces d'un dossier, assurer la continuité d'entité |
La propagation W3C Trace Context (traceparent) porte le trace ID d'un service à l'autre : l'orchestrateur, les sous-agents
appelés en HTTP ou en A2A, les serveurs MCP et les Azure Functions instrumentés restent dans la même trace. Un service qui ne
propage pas l'en-tête casse la chaîne : on voit deux traces au lieu d'une.
sequenceDiagram
    participant App as Application
    participant Orch as Agent orchestrateur
    participant Fact as Sous-agent facturation
    participant MCP as Serveur MCP (Functions)
    participant AI as Application Insights
    App->>Orch: tour (traceparent : trace T, span A)
    Orch->>Orch: invoke_agent + chat (jetons)
    Orch->>Fact: handoff (trace T, span B)
    Fact->>MCP: execute_tool (trace T, span C)
    MCP-->>Fact: résultat
    Fact-->>Orch: réponse
    Orch-->>App: réponse (gen_ai.response.id)
    Note over App,AI: tous les spans partagent operation_Id = T
    App->>AI: feedback utilisateur (même trace T)
11.4 Alerting et suivi d'exécution#
Toute requête KQL de ce chapitre peut devenir une log search alert d'Azure Monitor (avec action group : e-mail, Teams, webhook, runbook). Exemple : alerter quand le taux d'échec des appels d'outils d'un agent dépasse 5 % sur 15 minutes.
dependencies
| where timestamp > ago(15m)
| where tostring(customDimensions["gen_ai.operation.name"]) == "execute_tool"
| extend agent = tostring(customDimensions["gen_ai.agent.name"]),
         outil = tostring(customDimensions["gen_ai.tool.name"])
| summarize appels = count(), echecs = countif(success == false) by agent, outil
| extend taux_echec = 100.0 * echecs / appels
| where appels >= 20 and taux_echec > 5
Les alerts de l'Agent Monitoring Dashboard (preview) couvrent les cas courants sans KQL : latence, jetons, scores d'évaluation, résultats de red teaming. Le suivi d'exécution d'un workflow Agent Framework s'appuie sur ses événements (début et fin de superstep, sorties d'executors, demandes d'information humaine) et ses checkpoints : avec le tracing, on sait où un workflow s'est arrêté et d'où le reprendre. Pour lire une trace en cas d'incident, appliquer la règle de la première divergence (Claude Developer, 08).
12. Labs conseillés#
Dans un abonnement de test, avec une Foundry resource, un project, Application Insights connecté et un deployment
gpt-5-mini (ou équivalent) pour les agents et le juge. Coût : surtout les jetons (agents et juges), l'ingestion Application
Insights et, pour le lab 6, une instance API Management (préférer un niveau v2 de test). Supprimer le groupe de ressources à la fin.
- Revue humaine
- Créer un template de human evaluation (thumbs, slider, texte libre), l'activer, ouvrir la preview web app de l'agent.
- Noter cinq réponses, exporter le CSV ; annoter deux traces depuis Tracing.
- Attendu : résultats visibles sous Evaluation Results après quelques minutes ; annotations
builderdanscustomEvents.
- Évaluer les composants
- Lancer le code de la section 3.3 sur dix conversations, dont deux sur deux sessions.
- Retirer un outil des
tool_definitionsd'une ligne et relancer. - Attendu : Tool Call Accuracy baisse sur la ligne modifiée ;
memory_recallà 0 si la mémoire n'est pas branchée.
- Synthétique et juge calibré
- Générer 20 questions Simple QnA depuis la définition de l'agent, les relire.
- Noter 20 réponses à la main, puis avec le
PolicyJudgede la section 6.2 ; calculer le kappa. - Attendu : un kappa qui monte après correction de la rubric.
- Fenêtre de contexte
- Converser 15 tours avec une fenêtre glissante de 3 tours, en donnant un numéro de dossier au tour 1.
- Ajouter un digest clé-valeur et refaire.
- Attendu : l'agent oublie le numéro sans digest (sliding-window amnesia), s'en souvient avec.
- Tracing et corrélation
- Exécuter le code de la section 11.2 avec deux agents.
- Lancer la requête de jetons de la section 9.3 et créer l'alerte de la section 11.4.
- Attendu : un seul
operation_Idpour le tour ; jetons ventilés par agent.
- Chargeback (optionnel, plus coûteux)
- Placer
llm-emit-token-metricavec les dimensions agent et équipe devant le deployment. - Appeler avec deux valeurs de
x-cost-center, puis filtrer la Foundry resource par tagprojectdans Cost analysis. - Attendu : métriques séparées par équipe dans Application Insights (après activation des custom metrics with dimensions).
- Placer
13. Pièges d'examen#
| Situation dans la question | Réponse attendue | Pourquoi |
|---|---|---|
| Des experts doivent noter les réponses d'un agent avec un questionnaire (slider, choix multiple) | Human evaluation : template actif, preview web app | Les annotations de trace ne font que thumbs up/down |
| Le bouton Feedback n'apparaît pas pour les relecteurs | Aucun template actif | Un seul template actif à la fois |
| Le relecteur ne peut pas ouvrir la preview web app | Lui donner Foundry User sur le project (et Reader sur le compte) | Rôle minimal du relecteur |
| L'application envoie le feedback utilisateur : erreur 403 | Monitoring Metrics Publisher sur l'Application Insights pour l'identité émettrice | Écrire de la télémétrie ≠ lire des traces |
| Garder les résultats de revue humaine deux ans | Exporter (CSV) : ils suivent la rétention d'Application Insights | Pas de stockage long par défaut |
| Mesurer la qualité de la récupération avec des étiquettes de pertinence | Document Retrieval (NDCG, Fidelity…) | Retrieval sert quand il n'y a pas de vérité terrain |
| Vérifier qu'un agent suit le chemin d'outils attendu, sans modèle juge | Task Navigation Efficiency avec expected_actions |
Seul agent evaluator sans deployment |
| Réduire le coût d'évaluation de cinq evaluators d'outils | Tool Use Quality (composite, preview) | Un seul appel de juge |
| Valider un juge LLM avant de lui confier le quality gate | Comparer à 50–100 notes humaines, Cohen's kappa > 0,7 | Sans calibration, le juge peut être biaisé |
| Deux juges divergent fortement sur un cas | Revue humaine | Règle de consensus |
| Un juge préfère systématiquement la réponse la plus longue | Length / verbosity bias : rubric explicite, exemples de longueurs variées | Biais classiques |
| L'agent redemande une information donnée au premier tour d'une longue conversation | Sliding-window amnesia → digest ou user profile memory | La fenêtre glissante a évincé le fait |
| Un montant change au fil des résumés successifs | Summary drift → digest structuré validé | Résumé de résumé |
| La mémoire ramène l'ancienne adresse d'un client | Vector-only recall → mémoire structurée, filtre par ID et date | Similarité ≠ exactitude |
| Le sous-agent traite un autre client que l'orchestrateur | Entity continuity → ID canonique dans le handoff | Nom ambigu en texte libre |
| Un workflow parallèle n'est pas plus rapide qu'en séquentiel | Barrière des supersteps : regrouper les étapes séquentielles dans un executor | Le superstep attend tous les executors |
| Beaucoup de 429 après avoir parallélisé | Parallélisme borné + retry-after-ms + jitter, ou plus de capacité |
Le quota TPM / RPM est partagé |
| Un agent boucle sur ses outils et consomme trop | max_iterations (40 par défaut), max_function_calls, borne de AgentLoopMiddleware |
Toujours borner une boucle autonome |
| Gain de 0,02 au score composite de l'agent optimizer | Bruit, ne pas déployer pour ce seul gain | Seuil 0,03 |
| Les continuous evaluations sont sautées | max_hourly_runs atteint (100 par défaut) |
Plafond horaire |
| Détecter qu'une nouvelle version est moins bonne | Scheduled evaluation sur golden dataset, quality gate | La continuous evaluation suit la dérive du trafic |
| Refacturer à chaque équipe un Foundry resource partagé, sans rien coder | Tag project automatique (preview) dans Cost analysis |
Modèles vendus par Azure uniquement |
| Refacturer par agent ou par équipe derrière une passerelle | llm-emit-token-metric avec dimensions |
5 dimensions maximum par policy |
| Empêcher techniquement de dépasser un budget Azure OpenAI | Pas de plafond dur : budget + action group + automatisation, ou quota à la passerelle | Les budgets alertent, ils ne coupent pas |
| Chercher Azure OpenAI dans le filtre Service de Cost analysis | Service tier: Azure OpenAI (rangé sous Cognitive Services) | Classement de facturation |
| Voir les prompts dans les traces de production | Content recording désactivé par défaut ; ne l'activer qu'en test | Données personnelles |
| Deux traces au lieu d'une pour un même tour | Un service ne propage pas W3C Trace Context | La corrélation repose sur traceparent |
| Distinguer deux applications dans le même Application Insights | OTEL_SERVICE_NAME, filtre cloud_RoleName |
Attribut de ressource OpenTelemetry |
Erreur AuthorizationFailed en ouvrant les traces |
Log Analytics Reader (+ Privileged Monitoring Data Reader si tables protégées) | Lecture des logs |
14. Scénarios d'entraînement#
1. Une banque déploie un agent de conseil. La conformité exige que chaque nouvelle version soit relue par trois juristes sur 40 cas, avec une note de 1 à 5 et un commentaire, et que les résultats soient conservés cinq ans.
Human evaluation : un template (slider 1–5, texte libre) actif sur l'agent, relecteurs avec Foundry User (et Reader sur le compte) dans la preview web app ; export CSV des résultats vers un stockage d'archivage, car ils suivent la rétention d'Application Insights. Les 40 cas deviennent le golden dataset et servent à calibrer un juge LLM.
2. Les utilisateurs cliquent sur « pouce en bas », mais l'équipe ne voit rien dans Foundry. L'application envoie pourtant un événement sans erreur.
Vérifier que l'événement
gen_ai.evaluation.resultest émis dans le contexte de la trace d'origine (operation_Id,operation_ParentId,gen_ai.response.id) et vers le même Application Insights que le project, puis attendre la fin de l'ingestion. Un 401/403 aurait indiqué le rôle Monitoring Metrics Publisher manquant.
3. Un agent RAG répond juste mais oublie des éléments importants des procédures ; l'équipe dispose de réponses de référence.
Response Completeness (rappel, preview) avec
ground_truth, en plus de Groundedness (précision). Si la cause est la récupération, Document Retrieval avec étiquettes de pertinence et un parameter sweep (top_k, taille des chunks).
4. Dans un système à cinq agents, la réponse finale est souvent fausse, sans qu'on sache quel agent se trompe.
Passer de la system evaluation à la process evaluation : Tool Selection, Tool Input Accuracy, Tool Output Utilization par étape, Task Navigation Efficiency contre la trajectoire attendue, et lecture des traces corrélées par
operation_Idjusqu'à la première divergence.
5. Un workflow lance en parallèle une recherche documentaire (un executor de 20 s) et une vérification en trois executors de 2 s chacun. Le total reste proche de 26 s.
Barrière des supersteps : chaque étape de la branche courte attend la fin du superstep, donc l'executor long. Regrouper les trois vérifications dans un seul executor : les deux branches tiennent dans le même superstep, total proche de 20 s.
6. Au-delà de 25 tours, un assistant de sinistres confond le montant estimé et le montant réclamé, alors que les deux étaient corrects au début. L'historique est compressé par des résumés successifs.
Summary drift. Remplacer les résumés libres par un digest structuré (montant_estime, montant_reclame…) toujours injecté, vérifié par un modèle léger, avec repli sur le contexte complet si la vérification échoue ; journaliser les dépassements de budget.
7. L'équipe veut un juge LLM pour noter le ton des réponses dans le quality gate. Sur 80 cas notés par des humains, le kappa est de 0,58.
Ne pas brancher le juge : réviser la rubric (niveaux décrits avec exemples, critère unique, longueur neutre), vérifier les biais de longueur et de position, recalibrer jusqu'à kappa > 0,7 ; prévoir un second juge et la revue humaine en cas d'écart.
8. Un agent de recherche consomme 4 fois plus de jetons que prévu ; les traces montrent 30 appels d'outils par requête, chacun renvoyant une page entière.
Tool result over-injection et boucle trop large : baisser
max_iterationset fixermax_function_calls, renvoyer des résultats courts et structurés, réduire les outils exposés, mesurer Tool Selection et Task Navigation Efficiency.
9. Quatre équipes partagent une Foundry resource et une AI gateway. La finance veut une refacturation mensuelle par équipe et par agent.
Par équipe : un project par équipe et le tag
project(preview) dans Cost analysis, ou les exports planifiés. Par agent :llm-emit-token-metricavec dimensions Agent et Equipe (faible cardinalité). Budgets et alertes par périmètre ; pas de plafond dur, doncllm-token-limitsi une équipe ne doit pas dépasser son allocation.
10. Un incident : le taux de succès des runs passe de 98 % à 81 % en une heure, la latence monte à 14 s. Que faire, dans quel ordre ?
Ouvrir les traces en échec (même
operation_Id), chercher la première divergence : des 429 ou des timeouts côté modèle appellent une action de capacité (autre deployment, spillover, parallélisme réduit) ; une erreur d'outil appelle circuit breaker ou retrait de l'outil ; une régression de qualité après déploiement appelle le rollback vers la version épinglée. Ensuite, ajouter le cas au dataset de régression et une alerte si elle manquait.
15. Pour aller plus loin#
- AI Red Teaming Agent et scans planifiés depuis l'Agent Monitoring Dashboard : chapitre 07 et AI-103, chapitre 04.
- Évaluer des conversations simulées (Simulate conversations) pour les flux multi-tours, à partir des Simulation seeds.
- Intelligent sampling des continuous evaluations : cibler les traces les plus informatives plutôt qu'un tirage aléatoire.
- Microsoft Entra authentication for trace ingestion : ingestion de la télémétrie sans clé d'instrumentation.
- Tableaux Grafana Agent Framework et Foundry, à dupliquer et adapter (Save as).
- Agent replay et analyse de cause racine sur incident : module Debug du parcours Learn Monitor, evaluate, and operate multi-agent AI solutions in Azure.
16. Fiche à retenir#
- System evaluation (Task Completion, Task Adherence, Intent Resolution, Task Navigation Efficiency, Customer Satisfaction) pour le résultat, process evaluation (Tool Call Accuracy, Tool Selection, Tool Input Accuracy, Tool Output Utilization, Tool Call Success) pour chaque étape.
- Human evaluation (preview) : templates (thumbs, slider, choix multiple, texte), un seul actif, preview web app, Foundry User pour relire, Foundry Project Manager pour créer, export CSV.
- Trace annotations (preview) :
builder(portail) ouend_user(code), ajoutées jamais écrasées,gen_ai.evaluation.resultdanscustomEvents, même contexte de trace, Monitoring Metrics Publisher pour écrire. - Knowledge : Retrieval (sans vérité), Document Retrieval (qrels, NDCG), Groundedness (précision), Response Completeness (rappel). Seuil par défaut 3 sur 1–5.
- Memory : pas d'evaluator dédié → custom evaluator et scénarios multi-sessions (rappel, correction, oubli, scope, TTL).
- Synthetic data : Simple QnA et Simulation seed,
max_samples1–1 000, régénérer quand les instructions changent, combiner avec les traces. - Durée : chemin critique, parallélisme borné,
retry-after-ms, barrière des supersteps (regrouper les étapes d'une branche). - Contexte : sliding-window amnesia (digest), summary drift (digest structuré validé), vector-only recall (mémoire structurée), entity continuity (ID canonique) ; budget par agent, élagage par priorité.
- Juge LLM : un critère par juge, rubric en 4 parties, biais longueur / position / verbosité, 50–100 notes humaines, kappa > 0,7, écart > 3 points → humain.
- Agent optimizer : gain < 0,03 = bruit, 0,03–0,10 modéré, > 0,10 significatif ; candidat → nouvelle version. Cluster analysis non stockée.
- Fiabilité : success rate < 95 % et latence > 10 s à investiguer ; continuous = dérive, scheduled = régression ;
max_hourly_runs= 100. - SLA Azure par service, SLO à vous ; composite = produit ; preview = sans SLA.
- Boucles :
max_iterations40 (outils),max_function_callsillimité par défaut,AgentLoopMiddleware10 (juge : 5) ; toujours borner. - Coûts : usage (meters), quotas (TPM, Usages Reader), allocations (deployments, PTU,
llm-token-limit), chargeback (tagprojectpreview,llm-emit-token-metric5 dimensions) ; pas de plafond dur. - Tracing : server-side d'abord (GA prompt et hosted agents, 90 jours), spans
invoke_agent,chat,execute_tool, jetonsgen_ai.usage.*, content recording off en production. - Corrélation :
operation_Id(trace),operation_ParentId(span),gen_ai.conversation.id,gen_ai.response.id, W3C Trace Context ;OTEL_SERVICE_NAME→cloud_RoleName.
Références#
Toutes lues le 22/10/2026 sur Microsoft Learn :
- Guide d'étude de l'examen AI-500 (en anglais)
- Set up human evaluation for your agents
- Annotate traces with human feedback
- Troubleshoot evaluation and observability issues
- Built-in evaluators reference
- Agent evaluators
- Retrieval-Augmented Generation (RAG) evaluators
- Evaluation datasets in Microsoft Foundry
- Generate a synthetic evaluation dataset
- Memory in Microsoft Foundry Agent Service
- What is the agent optimizer?
- Analyze evaluation results with cluster analysis
- Monitor agents with the Agent Monitoring Dashboard
- Monitor agent health and performance across your fleet
- Monitor AI agents with Application Insights
- Set up tracing in Microsoft Foundry
- Add client-side tracing to Foundry agents
- Configure tracing for AI agent frameworks
- Trace LangChain and LangGraph apps with Microsoft Foundry and Azure Monitor
- Agent Framework : Workflow Builder & Execution (supersteps)
- Agent Framework : Agent looping
- Agent Framework : Using function tools with an agent
- FunctionInvocationConfiguration (Python)
- Plan and manage costs for Microsoft Foundry
- AI gateway in Azure API Management
- Emit metrics for consumption of large language model tokens
- Dynamic AI agents at scale pattern (évaluation par composant et de bout en bout)
- Préparer l'examen AI-500 : parcours d'apprentissage (parcours Monitor, evaluate, and operate multi-agent AI solutions in Azure : unités Optimize token usage and context management et Implement LLM-as-judge evaluation for multi-agent systems)